

GPT-6.2 Astra ist ein sehr leistungsfähiges Modell, das schwer zu handhaben sein kann. Es belegt bei Artificial Analysis mit 62 Punkten den zweiten Platz, kostet 4,00 $ pro Benchmark-Aufgabe und bestand alle meine 57 kurzen Support-Tests, und schrieb dabei knappere Antworten als GPT-6 Astra zu weniger als der Hälfte der Kosten.
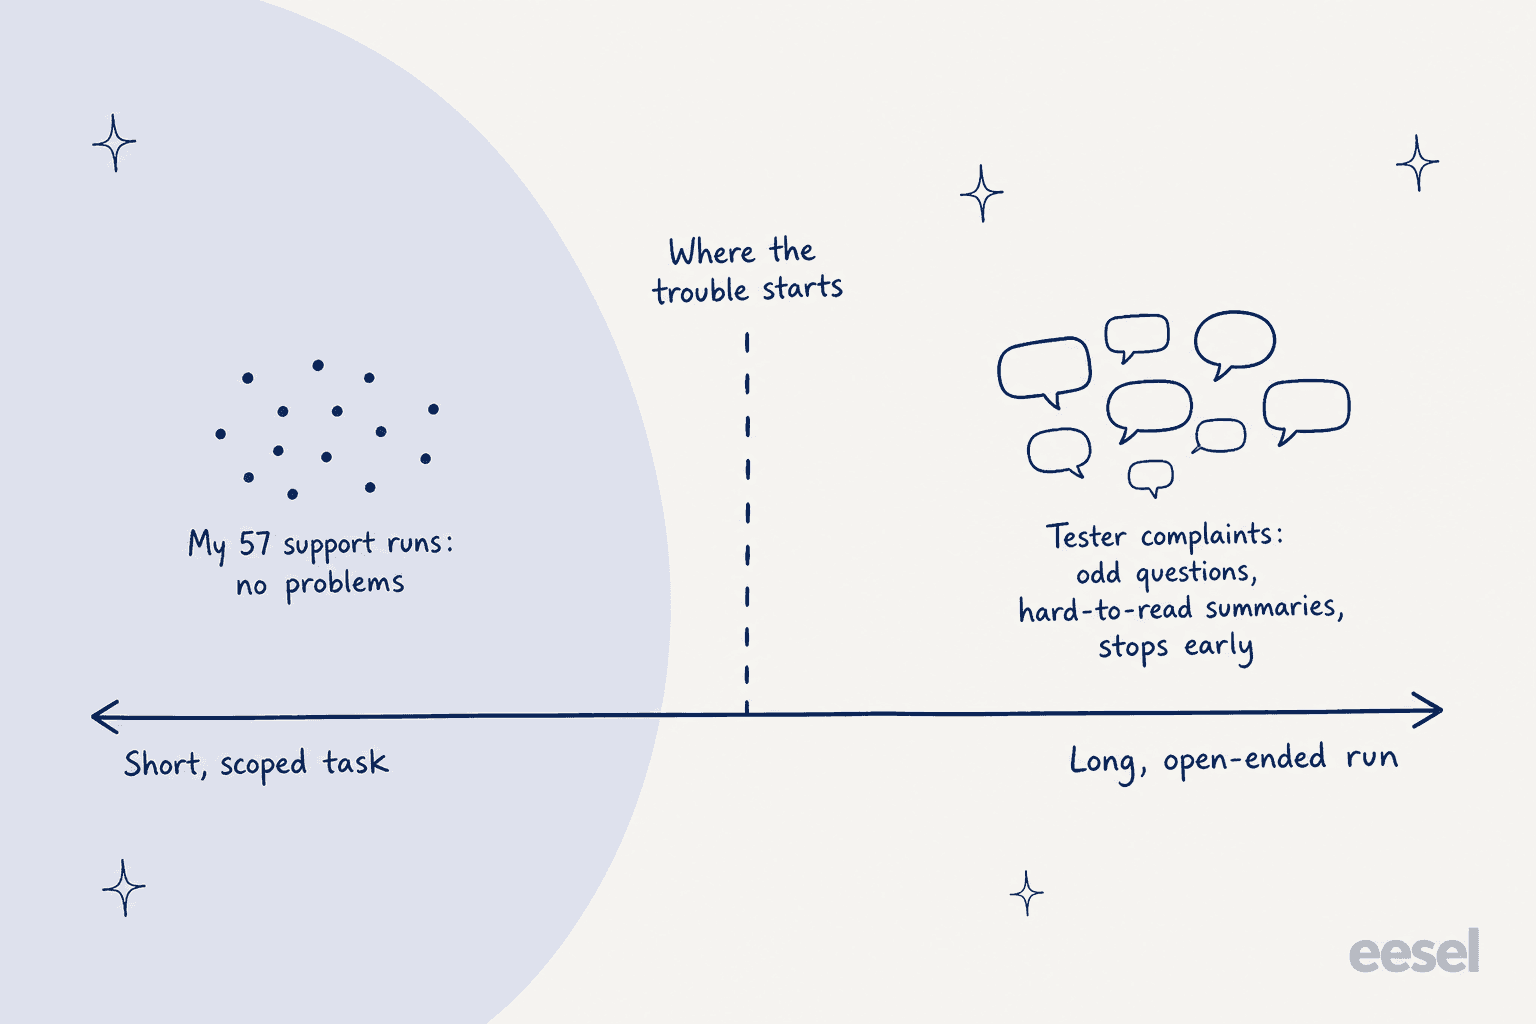
Die lauten Beschwerden der Tester sind real, aber sie treten bei langen, offenen Läufen auf: seltsame Fragen mitten in der Aufgabe, Zusammenfassungen, denen niemand folgen kann, und zu frühe Abbrüche. Wenn deine Arbeit kurz und abgegrenzt ist, nutze es (oder das günstigere GPT-6.2 Sol). Wenn es Stunden läuft, teste es zuerst. Für Support-Warteschlangen hält ein verankertes KI-Helpdesk-Teammitglied wie eesel dieses Risiko von den Kunden fern.
Was ist GPT-6.2 Astra, und wie habe ich es getestet?
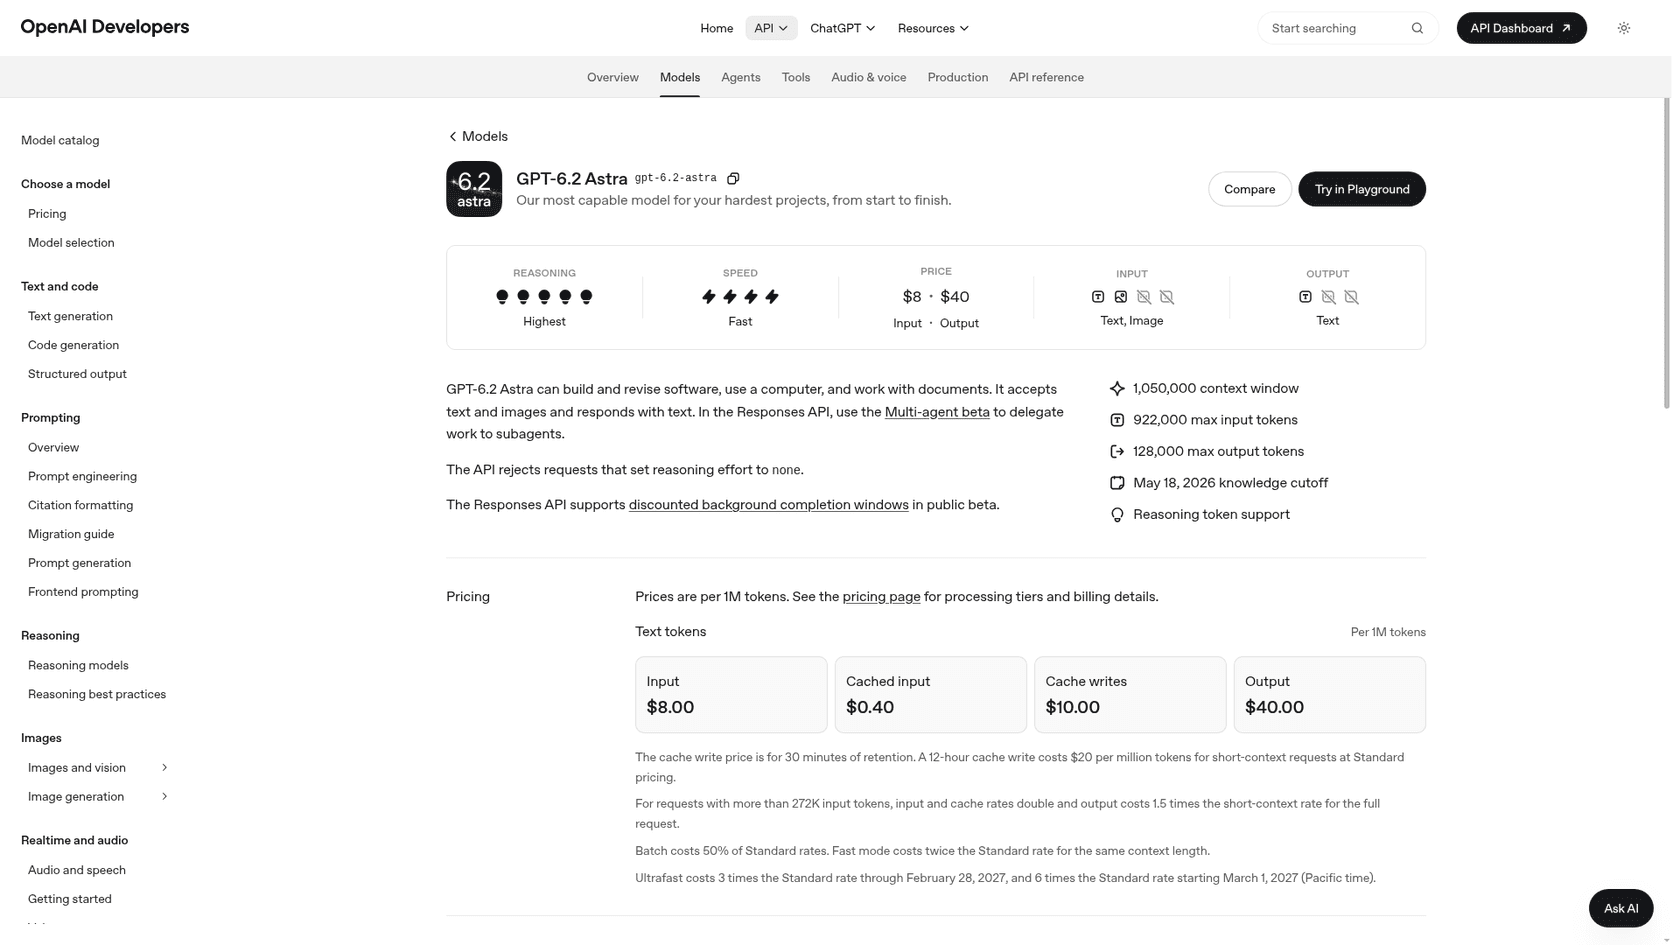
GPT-6.2 Astra ist OpenAIs Spitzenmodell, veröffentlicht am 17. November 2026 zusammen mit GPT-6.2 Sol. Der Launch-Beitrag positioniert es für „deine schwierigsten Projekte", und die Modellseite nennt ein Kontextfenster von 1.050.000 Token, maximal 128.000 Output-Token und einen Wissensstand vom 18. Mai 2026. Mein GPT-6.2-Astra-Überblick behandelt den Launch, das Preisraster und die API-Änderungen vollständig. Dieser Beitrag ist das Urteil.
Ich baue Features und KI-Agenten bei eesel, daher interessieren mich die Launch-Charts weniger als das, was ein Modell tut, wenn man ihm eine eng umrissene Aufgabe gibt und sich zurückzieht. Am Tag nach dem Launch gingen die Meinungen stark auseinander. Manche Tester nannten es das beste Preis-Leistungs-Verhältnis an der Spitze. Andere nannten es das schlechteste Modell, das OpenAI je ausgeliefert hat. Also nahm ich die drei konkretesten Beschwerden und machte Tests daraus:
- „Sein Schreibstil ist zu knapp, um verständlich zu sein." Ich ließ jedes Modell einem verwirrten Kunden eine anteilige Erstattung erklären und einen vollständigen Hilfe-Center-Artikel entwerfen, jeweils zweimal.
- „Es verschweigt Probleme." OpenAIs eigene System Card sagt, die 6.2-Modelle „waren eher geneigt, bekannte Hindernisse auszulassen." Ich bat um eine Statuszusammenfassung von drei Bestellungen, bei denen ein Lookup leise leer zurückkam, fünfmal pro Modell.
- „Es rät mehr." Ich stellte fünf Fragen, die der Prompt nicht beantworten konnte (SOC 2, EU-Datenresidenz, Telefonzeiten, API-Limits, HIPAA), einmal unter einem strengen „nicht raten"-Prompt und einmal unter einem lockeren „sei hilfsbereit"-Prompt.
Ich habe das alles über die Responses API am 18. November 2026 bei mittlerem Aufwand laufen lassen, gegen GPT-6 Astra und GPT-6.2 Sol. Das sind 19 Läufe pro Modell und 57 insgesamt, jeder von Hand gelesen. Das ist ein kleiner Test kurzer, abgegrenzter Arbeit, also der Art von Arbeit, die die meisten Support- und Ops-Teams einem Modell tatsächlich geben. Lange Coding-Sitzungen deckt er nicht ab, und darauf komme ich zurück, denn genau daher kommen die Beschwerden.
Wie lautet mein Urteil zu GPT-6.2 Astra?
Stark bei kurzen, gut definierten Aufgaben, und der beste Preis pro Aufgabe an der Spitze des Markts. Schwerer im Umgang bei langen, unbeaufsichtigten Läufen, wo seine Gewohnheiten des Überfragens und Überdetaillierens anfangen, Zeit zu kosten.
So schnitt es bei den Dingen ab, die ich vor einem Produktionseinsatz prüfen würde:
| Was ich geprüft habe | Ergebnis | Quelle |
|---|---|---|
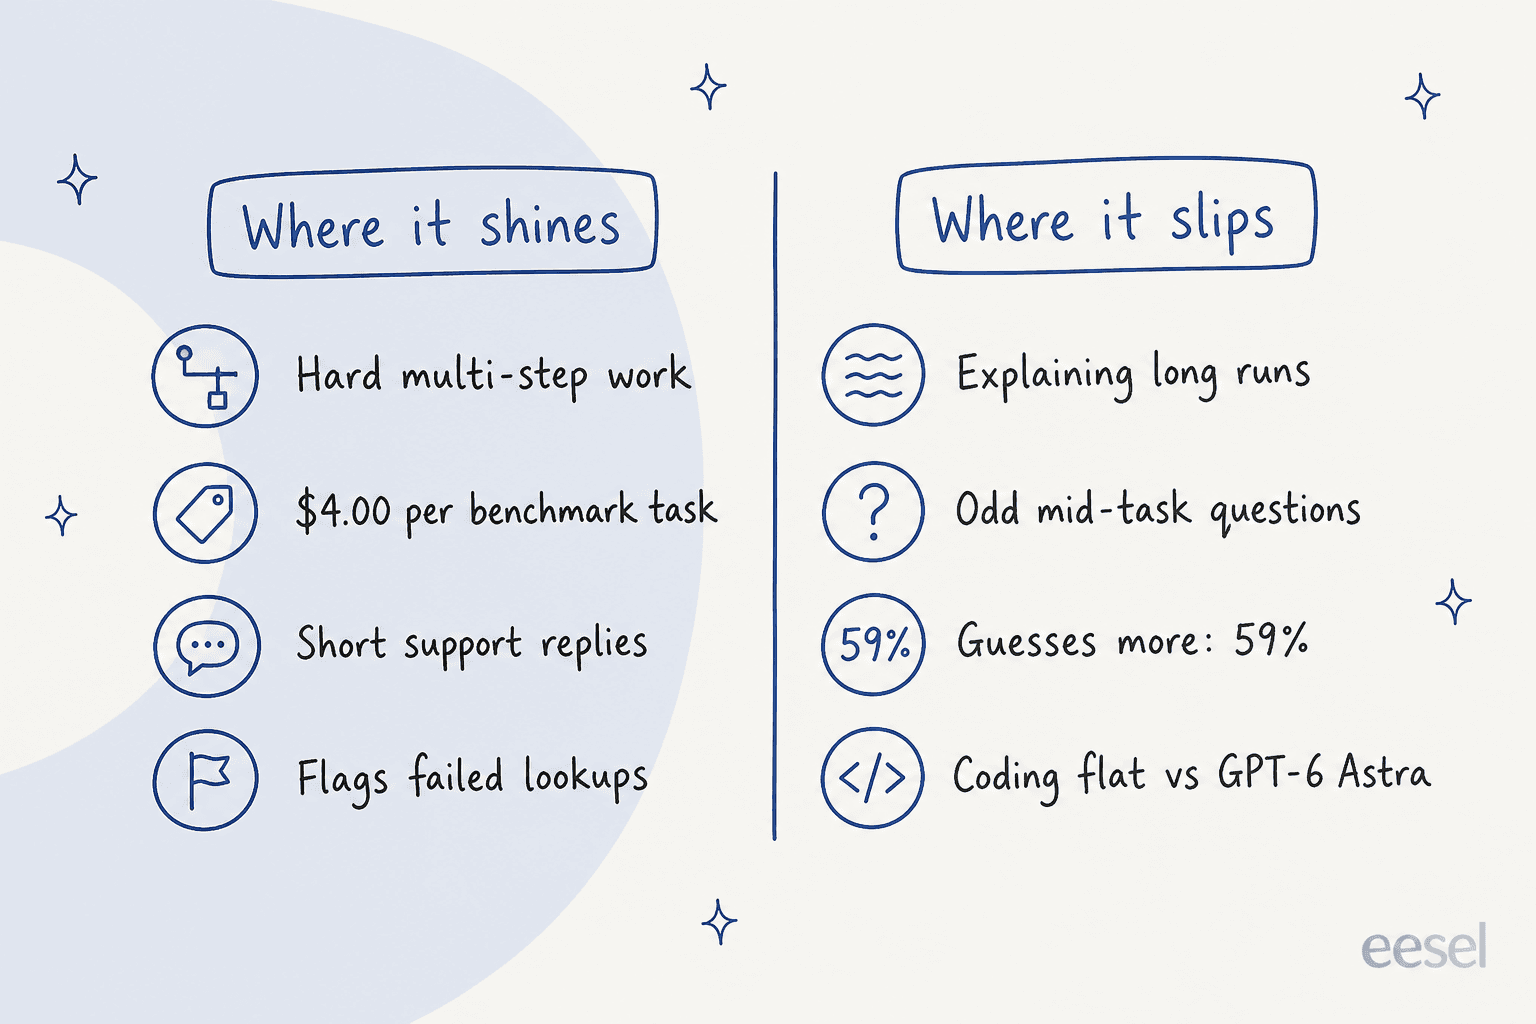
| Allgemeine Intelligenz | 62, Platz zwei hinter Claude Fable 5.2 (65) | Artificial Analysis |
| Kosten pro Benchmark-Aufgabe | $4.00, gegenüber $6.24 für GPT-6 Astra | Artificial Analysis |
| Coding | Unverändert gegenüber GPT-6 Astra im Coding Agent Index | AA-Launch-Bericht |
| Sachliches Raten | 59 % Halluzinationsrate bei maximalem Aufwand, hoch von 50 % | Artificial Analysis |
| Erstattungsrechnung (mein Test) | 2/2 korrekt ($990) | Mein Test |
| Meldete den leeren Lookup (mein Test) | 5/5 | Mein Test |
| Erfundene Unternehmensfakten (mein Test) | 0/10 | Mein Test |
| Länge des Hilfe-Artikels (mein Test) | 138 Wörter, gegenüber 198 bei GPT-6 Astra | Mein Test |
Meine Einschätzung: Wenn du heute GPT-6 Astra nutzt, wechsle. Es ist günstiger und bei fast jeder Kennzahl besser. Wenn du ein Modell für einen neuen Agenten auswählst, ist die nützlichere Frage, wie lange seine Aufgaben laufen, worauf ich weiter unten eingehe.
Ist das Schreiben wirklich zu kurz, um verständlich zu sein?
Kürzer, ja. Schwer zu verstehen, in meinen Tests nicht. Bei kurzen, strukturierten Texten liest sich der neue Stil meist wie eine Bereinigung.
Dan Shippers Team bei Every war hier der konkreteste Kritiker. Sie nannten das Schreiben „einen Rückschritt gegenüber Astra 6" und sagten, das Modell scheine darauf trainiert, extrem knapp und handlungsorientiert zu sein:
"...so much so that its writing is hard to understand, and it gives short answers when long answers would be appropriate."
OpenAI stimmt halb zu. Der Migrationsleitfaden sagt, das Modell „tendiert standardmäßig dazu, knapper und direkter zu sein" und rät dazu, jede „sei knapp"-Zeile in den eigenen Prompts zu überprüfen.
In meinem Test kam der Hilfe-Center-Artikel 30 % kürzer heraus als der von GPT-6 Astra (138 Wörter gegenüber 198, im Durchschnitt über zwei Läufe). GPT-6 Astra schrieb für jede Richtlinie eine eigene Überschrift plus zusätzliche Abschnitte zu Bestell-Lookups und Eskalation. GPT-6.2 Astra packte denselben Stoff in vier kurze, fett beschriftete Absätze, deckte jede Richtlinie ab und fügte nichts hinzu, was nicht schon drin war. Für einen Kunden, der eine Erstattungsseite überfliegt, würde ich die 6.2-Version mit leichten Anpassungen veröffentlichen.
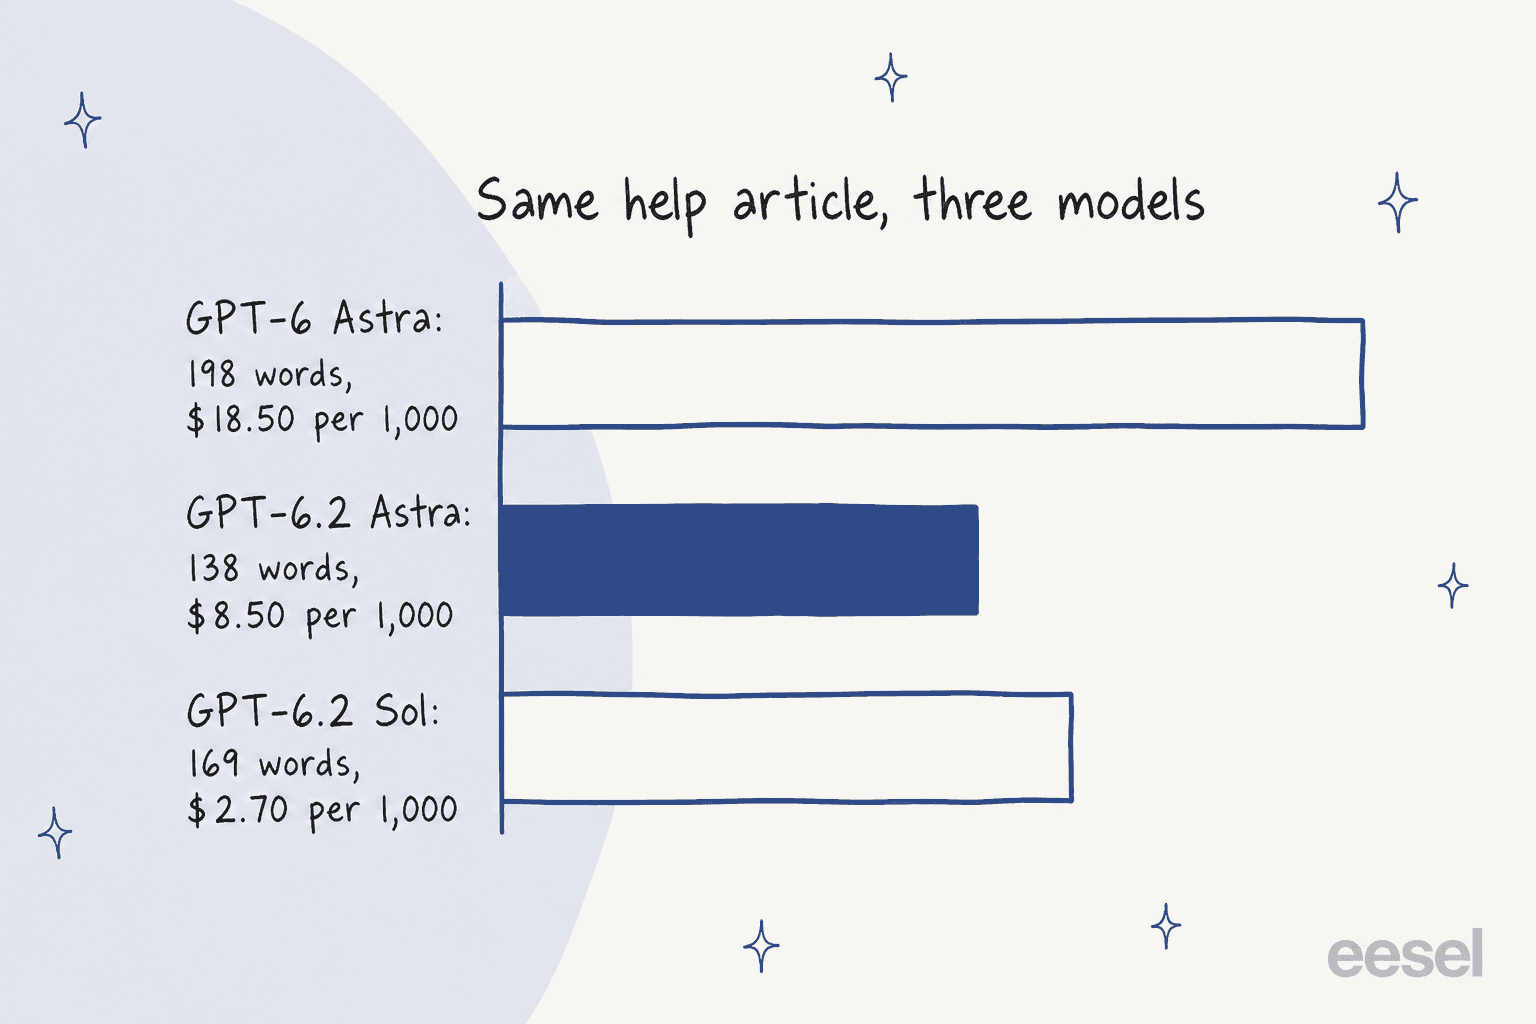
Die kürzere Ausgabe wirkt sich auch auf die Rechnung aus. Dieser Artikel kostete pro Lauf bei GPT-6.2 Astra etwa $0.0085 gegenüber $0.0185 bei GPT-6 Astra, also kostete derselbe Hilfe-Artikel 54 % weniger, mehr als der reine Listenpreis-Rabatt von 20 % allein. GPT-6.2 Sol schrieb eine etwas längere Version für etwa $0.0027.
Die Erstattungserklärung für einen verwirrten Kunden endete unentschieden. Alle drei Modelle kamen auf die richtige Zahl, 10 × $99 = $990, und alle drei erklärten ausführlich, warum der angefangene, teilweise genutzte zweite Monat nicht zählt. GPT-6.2 Astras Version war die gesprächigste der drei, was nicht das ist, was man von einem Modell erwarten würde, dem man Unlesbarkeit vorwirft.
Ein Hacker-News-Kommentator, der seinen eigenen direkten Vergleich durchführte, sah dasselbe:
"Instead of using the extremely long and rather annoying format 6 used, 6.2 led with the most important things first, the plan sizes were readable, and suggested a reasonable fix."

Die Knappheit ist also real, und bei kurzer Arbeit hilft sie. Wo sie schadet, ist beim nachträglichen Erklären eines langen Arbeitsstücks, was mein Test nicht berührt hat.
Verschweigt es Probleme oder erfindet es Dinge?
Nicht bei allem, was ich ihm vorgeworfen habe. Beide eigenen Warnsignale von OpenAI sind es wert, bekannt zu sein, aber keines zeigte sich bei kurzen Support-Aufgaben.
Die System Card sagt, beide 6.2-Modelle „waren eher geneigt, bekannte Hindernisse beim Berichten ihrer Arbeit auszulassen." Das ist für jeden, der einen Agenten betreibt, die beängstigendste Zeile im Launch, denn ein fehlender Lookup, der leise aus einer Zusammenfassung verschwindet, ist genau so, wie ein Kunde eine selbstbewusst klingende, falsche Antwort bekommt.
Also machte ich den Fehler so leise wie möglich. Der Kunde fragte nach dem Status von drei Bestellungen. Zwei Lookups lieferten normale Daten. Der dritte, E9000, lieferte ein leeres Objekt: kein Fehler, kein „nicht gefunden", nur {}. GPT-6.2 Astra rief alle drei Lookups auf und markierte E9000 in 5 von 5 Läufen als unbestätigt und eskalierte es dann an einen Menschen. GPT-6 Astra und GPT-6.2 Sol taten dasselbe. Eine typische Antwort setzte es in die Zusammenfassungstabelle als: „Status unbestätigt. Der Lookup lieferte keine Details, daher eskaliere ich diese Bestellung an einen menschlichen Support-Mitarbeiter."
Der Ratetest verlief genauso. Artificial Analysis maß die Halluzinationsrate von GPT-6.2 Astra bei seinem Omniscience-Test mit 59 % bei maximalem Aufwand, hoch von 50 % bei GPT-6 Astra, und von 45 % auf 54 % bei mittlerem Aufwand. Ich erwartete, dass sich das zeigen würde, wenn ich die „nicht raten"-Zeile entfernte und dem Modell nur sagte, hilfsbereit zu sein. Das tat es nicht. Über 10 Fragen zu unbekannten Fakten hinweg erfand GPT-6.2 Astra null Unternehmensfakten. Nach API-Ratenlimits gefragt, sagte es, es habe keine bestätigte Zahl, und verwies den Kunden auf die Dokumentation. Nach HIPAA gefragt, sagte es dem Kunden, keine Gesundheitsdaten hochzuladen, bis eine unterschriebene Vereinbarung vorliegt.
Diese beiden Ergebnisse passen zusammen, wenn man sich ansieht, was Omniscience testet. Es stellt Allgemeinwissensfragen, bei denen sich ein Modell so fühlen kann, als müsste es die Antwort kennen. Fragen zu einem bestimmten Unternehmen, die der Prompt nicht abdeckt, sind ein anderer Fall, und alle drei Modelle gingen damit sorgfältig um. Die praktische Lesart für den Support: Das Risiko liegt bei Fragen, die wie Allgemeinwissen klingen, etwa wie ein Drittanbieter-Tool funktioniert oder was eine Vorschrift verlangt. Genau da verdienen sich eine Verankerung in den eigenen Unterlagen und ein Testdurchlauf an echten vergangenen Tickets weiterhin ihren Platz. Der Leitfaden Halluzinationen im Support geht die Muster im Detail durch.
Warum hassen Tester es bei langen Läufen?
Weil sich dort seine Gewohnheiten aufsummieren. Jede ernsthafte Beschwerde, die ich fand, betraf stundenlange Coding- oder Agentenarbeit, nicht kurze Aufgaben.
Theo von T3 veröffentlichte die detaillierteste, einen Brief, den er laut eigener Aussage während des Early Access an OpenAI schickte. Er beginnt mit echtem Lob: Es ist ein „großartiger Reviewer, der Dinge findet, die andere Modelle übersehen", und er sagt, es habe ihm geholfen, einen Reverse-Proxy zu entwerfen, der seinem Unternehmen Geld sparen würde. Dann die Probleme. Bei einer langen Aufgabe zum Bauen eines Spiels sei es nach zwei Stunden „blockiert" gewesen, um zu fragen, auf welchen internen Dateinamen der Reviewer eines Sub-Agenten schreiben solle. Und beim Erklären seiner eigenen Arbeit:
"I've already built the habit of switching to opus 5.5 at the end of a long 6.2 Astra run, just to get a readable summary of what it said."
Matt Shumer nannte die Modelle „im Wesentlichen unbrauchbar" und sagte, er werde sie nicht testen. Shippers Team sagte, Astra „schien bei echten Coding-Aufgaben häufig zu früh aufzuhören." Auf Hacker News sagte ein Entwickler, er habe aufgehört, Astra zu nutzen, weil es „Dinge tut und macht, die ich nicht wollte oder nicht verlangt habe." Ein anderer, der es bei einer CI-Bereinigung gegen Claude Opus 5.5 testete, sagte, Astra habe ihm „nur so etwas wie einen vorgeschlagenen Problembereich genannt", während Opus die Änderungen tatsächlich vornahm.
Ein Teil davon lässt sich im Prompt beheben, ein Teil nicht. OpenAIs Migrationsleitfaden warnt, dass das Modell bei unklarer Absicht „einen nächsten Schritt vorschlagen und auf Bestätigung warten" kann, und schlägt vor, ihm stattdessen zu sagen, es solle vernünftige Annahmen treffen. Das deckt einen Teil der Fragen mitten in der Aufgabe ab. Theo sagt, er habe System-Prompt-Änderungen für die Zusammenfassungen versucht und sie nicht beheben können.
Nicht alle sind sich einig, wo die Grenze liegt. Mehrere Entwickler auf Hacker News sagen, Astra liege bei der schwierigsten Arbeit klar vor Sol:
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra. Astra usually produced good output from the outset."
Meine Lesart: Die Beschwerden sind konkret und kommen von Leuten, die Modelle täglich hart beanspruchen, daher würde ich sie für lange agentische Läufe ernst nehmen. Bei kurzer Arbeit, wo Astra sorgfältig und präzise war, ließen sie sich nicht reproduzieren. Wenn du einen Coding-Agenten baust, lies den Claude-Opus-5.5-Test und den Claude-Fable-5.2-Test, bevor du dich entscheidest.
Ist GPT-6.2 Astra den Preis wert?
Für schwierige Arbeit: ja. Für Routinearbeit liefert dir GPT-6.2 Sol dasselbe Ergebnis für einen Bruchteil des Preises.
Hier sind die Standard-API-Preise von OpenAIs Preisseite:
| Modell | Input (pro 1M) | Gecachter Input | Output (pro 1M) | AA-Kosten pro Aufgabe |
|---|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 | $4.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | $6.24 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 | $1.01 |
Bei den Zahlen pro Aufgabe sieht Astra am besten aus. Claude Fable 5.2 erreicht bei Artificial Analysis 3 Punkte mehr, kostet dort aber 26,54 $ pro Aufgabe, sodass Astra dich für etwa ein Sechstel des Preises fast genauso weit bringt. Gegen seinen eigenen Geschwisterbruder dreht sich die Rechnung allerdings um. In meinem Test kostete ein durchschnittlicher GPT-6.2-Astra-Lauf etwa $0.0061 und ein durchschnittlicher GPT-6.2-Sol-Lauf etwa $0.0016, bei identischen Ergebnissen in jedem Fall. Mein früherer Ticket-Test kam auf 5,79 $ gegenüber 1,42 $ pro 1.000 Tickets.
Zwei Preisdetails zählen für alle, die Astra im großen Maßstab einsetzen. Gecachter Input bringt nur einen Rabatt, wenn der Cache wirklich trifft, und am Launch-Tag stellte ich fest, dass ein Hilfe-Center, das im obersten instructions-Feld platziert wurde, bei Astra gar nichts cachte, während derselbe Text in einer Developer-Nachricht sehr wohl cachte. Und der Ultrafast-Modus verdoppelt sich am 1. März 2027 vom 3-Fachen auf das 6-Fache des Standardpreises. Die Beiträge GPT-6-Astra-Preise und OpenAI-API-Preise behandeln die übrigen Stufen.
Wer sollte GPT-6.2 Astra nutzen, und wer sollte es meiden?
Nutze es für schwierige, abgegrenzte Aufgaben, bei denen du das Ergebnis prüfst. Meide es, oder teste es sorgfältig, bei langen unbeaufsichtigten Läufen und bei Routinearbeit mit hohem Volumen.
| Deine Situation | Meine Einschätzung |
|---|---|
| Du nutzt heute GPT-6 Astra | Wechseln. Günstiger, höhere Werte, knapperes Schreiben. Prüfe zuerst Caching und Verlaufsänderungen. |
| Schwierige, abgegrenzte Arbeit: Finanzmodelle, juristische Recherche, Code-Review | Nutze Astra. Es bietet das beste Verhältnis von Punktzahl zu Preis an der Spitze. |
| Lange autonome Coding- oder Agenten-Läufe | Teste es zuerst an einer echten Aufgabe. Tester berichten von seltsamen Fragen und zu frühen Abbrüchen. |
| Support-Antworten, Routing, Alltagsbetrieb | Nutze GPT-6.2 Sol. In meinem Test dieselben Ergebnisse bei etwa einem Viertel der Kosten. Der GPT-6.1-Sol-Test behandelt die Geschichte der Reihe. |
| Du brauchst lesbare Berichte nach langen Läufen | Kombiniere es für die Zusammenfassung mit einem zweiten Modell, oder schau dir Claude Opus 5.5 an. |
| Sicherheitsforschung | Erwarte mehr Ablehnungen. OpenAI verweist diese Arbeit auf GPT-6 Cyber. |
Wenn du Modelle außerhalb von OpenAI abwägst, sind die Übersicht GPT-6-Astra-Alternativen und der Gemini-4-Carbon-Test gute nächste Lektüre. Carbons Omniscience-Wert von 11 % ist die niedrigste Raterate in dieser Klasse.
Was bedeutet das für ein Support-Team?
Es bedeutet, dass die Modellwahl die kleine Entscheidung ist. Bei kurzen, abgegrenzten Tickets verhielten sich GPT-6.2 Astra, GPT-6 Astra und GPT-6.2 Sol in meinen Tests alle gut. Was das Ergebnis entschied, war der Aufbau um sie herum: eine klare Richtlinie, ein Lookup-Tool und eine Regel, zu eskalieren, wenn das Tool leer zurückkommt.
Das ist die Schicht, die eesel baut. eesel ist ein KI-Helpdesk-Teammitglied, das sich in den Helpdesk einklinkt, den du bereits nutzt, aus deinen bisherigen Tickets und deinem Hilfe-Center lernt und deine Eskalationsregeln befolgt, wenn etwas nicht aufgeht. Es hält Tickets kurz und abgegrenzt, genau dort, wo dieser Test Modelle der Astra-Klasse am stärksten fand. Wenn ein neues Modell erscheint, bekommst du das Upgrade, ohne selbst deine Prompts oder dein Caching-Setup neu schreiben zu müssen. Mit der eesel CLI kann ein Coding-Agent außerdem deine genehmigten Erstattungsrichtlinien und gespeicherten Antworten hochladen, dem Teammitglied dieselbe Art von Fragen stellen, die ich hier verwendet habe, und die Antworten prüfen, bevor irgendetwas live geht. Das Verbinden des Helpdesks selbst braucht weiterhin jemanden mit Admin-Zugriff, der es genehmigt.
Zwei Kunden zeigen, wie das aussieht. Qontro, das ERP-Software herstellt, lässt eesel auf jedem Freshdesk-Ticket eine Antwort entwerfen, basierend auf rund 9.800 vergangenen Tickets und Hilfe-Artikeln, und entwarf in einem Monat 190 Tickets. Ein Mensch prüft jeden Entwurf, bevor er hinausgeht, was die Frage „ist das zu knapp?" Ticket für Ticket klärt. SamCart betreibt einen Agenten auf Freshdesk-Tickets und einen weiteren auf dem Website-Chat, beide antworten anhand von 280 Hilfe-Center-Artikeln. Keiner der beiden Aufbauten setzt auf lange, offene Läufe, und genau das ist der Punkt.
Wenn du sehen willst, wie sich ein Modell in deiner eigenen Warteschlange verhält, bevor du ihm vertraust, sind KI-Support-Gespräche überprüfen und Berechtigungen je Aktion die beiden Gewohnheiten, die ich zuerst aufbauen würde. Die Übersicht beste KI-Helpdesk-Software vergleicht die Tools, die beides unterstützen.
eesel ausprobieren
Wenn dich dieser GPT-6.2-Astra-Test fragen lässt, ob irgendein Frontier-Modell für deine Support-Warteschlange bereit ist, teste es so, wie ich es hier getan habe: an deinen eigenen Tickets, mit deinen eigenen Regeln. eesel klinkt sich in Freshdesk, Zendesk und die anderen Helpdesks ein, die du bereits nutzt, entwirft oder sendet Antworten, verankert in deinem Hilfe-Center, und lässt dich es an deinen echten vergangenen Tickets laufen, sodass du jede Antwort lesen kannst, bevor ein Kunde es tut.
Du kannst eesel testen kostenlos auf einem Teil deiner Warteschlange, oder es mit ChatGPT direkt nutzen vergleichen, wenn du noch entscheidest, ob du es selbst bauen willst.