Der Launch, der einen 500er warf, bevor die AGI ankam
Fangen wir mit dem Moment an, der den Ton gesetzt hat. OpenAI positionierte Astra als „das weltweit intelligenteste und am besten ausgerichtete Modell", Präsident Greg Brockman erzählte Reportern, er glaube persönlich, dass es AGI erreicht – und dann warf die Launch-Seite selbst über eine Stunde lang Serverfehler. Hacker News tat, was Hacker News eben tut:
"So, on the one hand, we have AGI; on the other, the release page is returning 500s."

Diese Lücke zwischen Anspruch und Realität zieht sich durch den gesamten Test. Man sollte bei der AGI-Behauptung genau sein, weil sie überall wiederholt wurde: Die Aussage „wir haben AGI erreicht" stammt von Brockman aus Presseinterviews, nicht von OpenAIs eigener Launch- oder Safety-Seite. Das stärkste, wirklich von OpenAI veröffentlichte era-definierende Zitat stammt von einem externen Gutachter, EpochAIs Greg Burnham, der sagte, „the story is: end of one era, start of another." Das ist eine deutlich vertretbarere Aussage als AGI, und daran würde ich mich orientieren.
Ich beobachte seit über drei Jahren, wie Modell-Launches in echten Produktivsystemen landen (wir betreiben KI täglich in laufenden Support-Warteschlangen), und das Muster ist immer gleich: Das Benchmark-Diagramm und die tatsächliche Nutzung sind zwei verschiedene Dinge. Statt die Schlagzeile „neue Generation von Intelligenz" für bare Münze zu nehmen, lese ich Astra deshalb als zwei getrennte Geschichten, die OpenAI in einem Launch zusammengelegt hat. (Wer den reinen Spec-und-Preis-Überblick ohne Urteil sucht, findet ihn in meinem GPT-6-Astra-Erklärartikel.)
Die zwei Geschichten in einer Benchmark-Tabelle
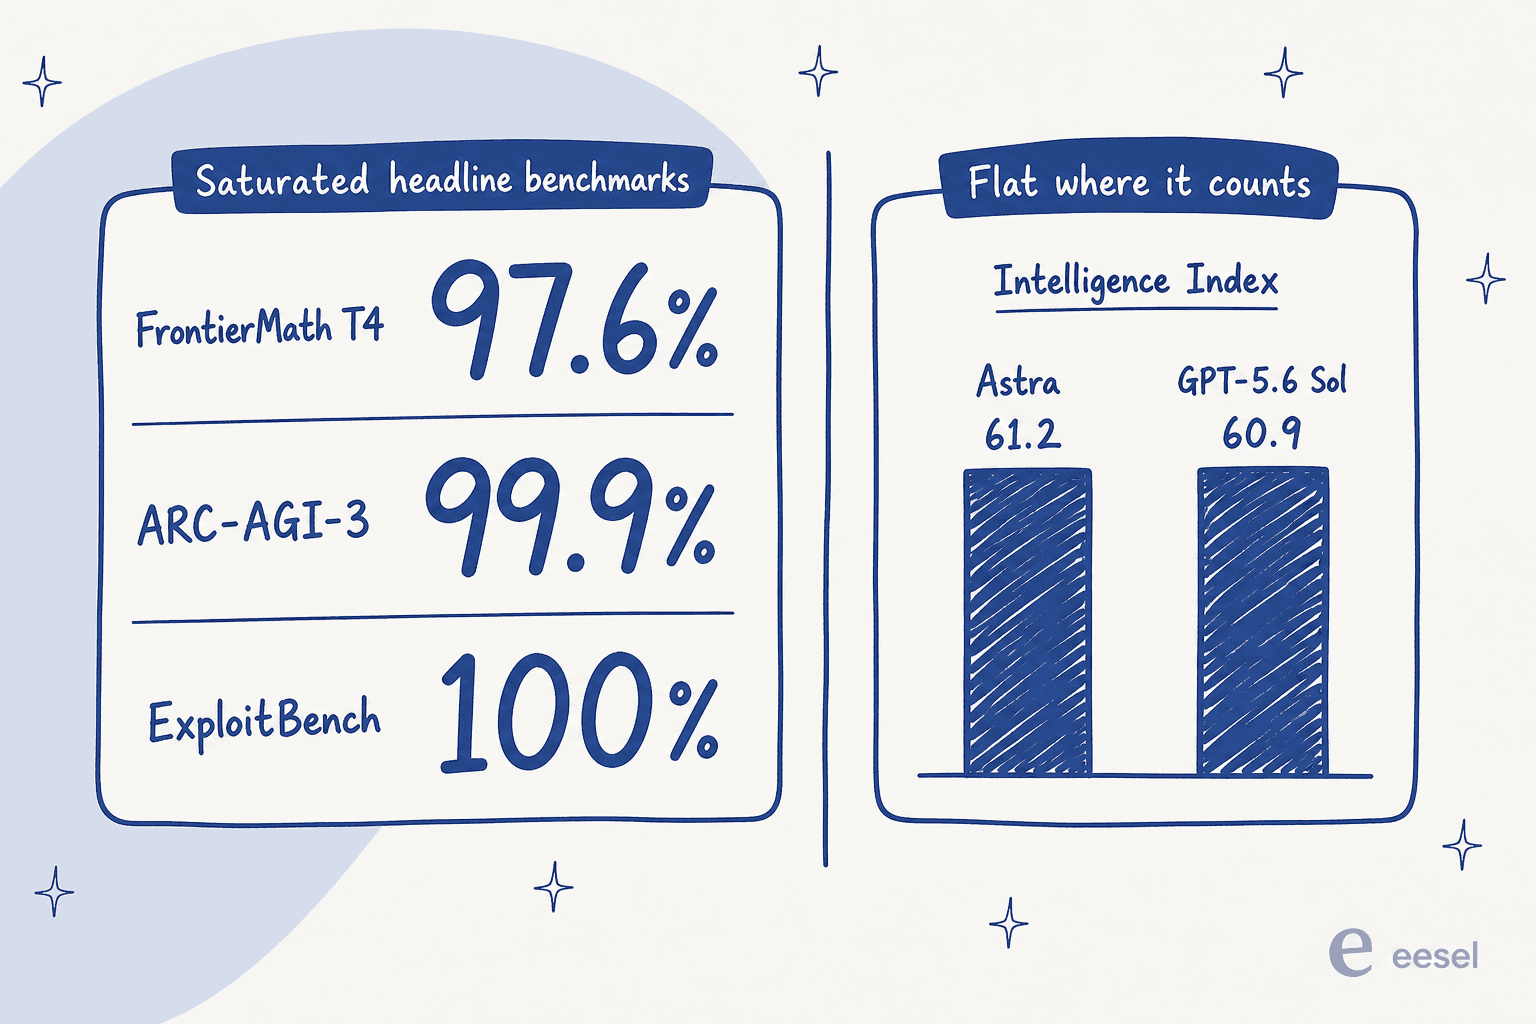
Geschichte eins ist die Schlagzeile. Astra „sättigt" eine Reihe schwieriger Benchmarks: FrontierMath Tier 4 mit 97,6 %, ARC-AGI-3 mit 99,9 % und ExploitBench mit 100 %. Das sind beeindruckende Zahlen, und ARC Prize bestätigte unabhängig das ARC-AGI-3-Ergebnis und stellte fest, dass Astra die menschliche Baseline in 96 % der Level übertrifft. Das ist kein Marketing-Trick, sondern ein echter Rekord.
Geschichte zwei zeigt sich, wenn man sich den Benchmark ansieht, den Käufer tatsächlich verfolgen. Im unabhängigen Artificial Analysis Intelligence Index landet Astra bei 61,2 – praktisch gleichauf mit Sols 60,9 und hinter Fable 5.1s 65,7. Genau deshalb wirkte der zweitgrößte Launch-Day-Thread so ernüchternd.
Artificial Analysis, die unabhängige Benchmarking-Gruppe, brachte die Aufspaltung in ihrer eigenen Analyse klar auf den Punkt:
"GPT-6 Astra makes significant gains in the Artificial Analysis Coding Agent Index, scoring equal to Fable 5 at lower cost. In the Intelligence Index, it uses fewer tokens than GPT-5.6 Sol for similar performance, but this is outweighed by higher prices."
Hier ist das vollständige Bild aus OpenAIs eigener Launch-Seiten-Tabelle, mit dem Vorbehalt, den OpenAI selbst nennt: Das sind Maximalwerte bei beliebigem Aufwand, gemessen in OpenAIs eigener Umgebung, und mehrere Konkurrenzwerte enthalten OpenAIs eigene, in Fußnoten vermerkte Eval-Anpassungen. Behandle herstellerübergreifende Zeilen als Herstellerangaben, nicht als Wahrheit.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| FrontierMath Tier 4 (v2) | 97.6% | 80.5% | 78.0% | 73.2% |
| ARC-AGI-3 | 99.9% | 7.8% | – | 30.2% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% |
| Terminal-Bench 4.0 (Coding) | 57.9% | 37.3% | 55.8% | 52.3% |
| Agents' Last Exam | 59.3% | 53.6% | – | 55.5% |
| ExploitBench (Cyber) | 100.0% | 78.5% | – | 70% |
| Artificial Analysis Intelligence Index | 61.2 | 60.9 | 65.7 | 63.1 |
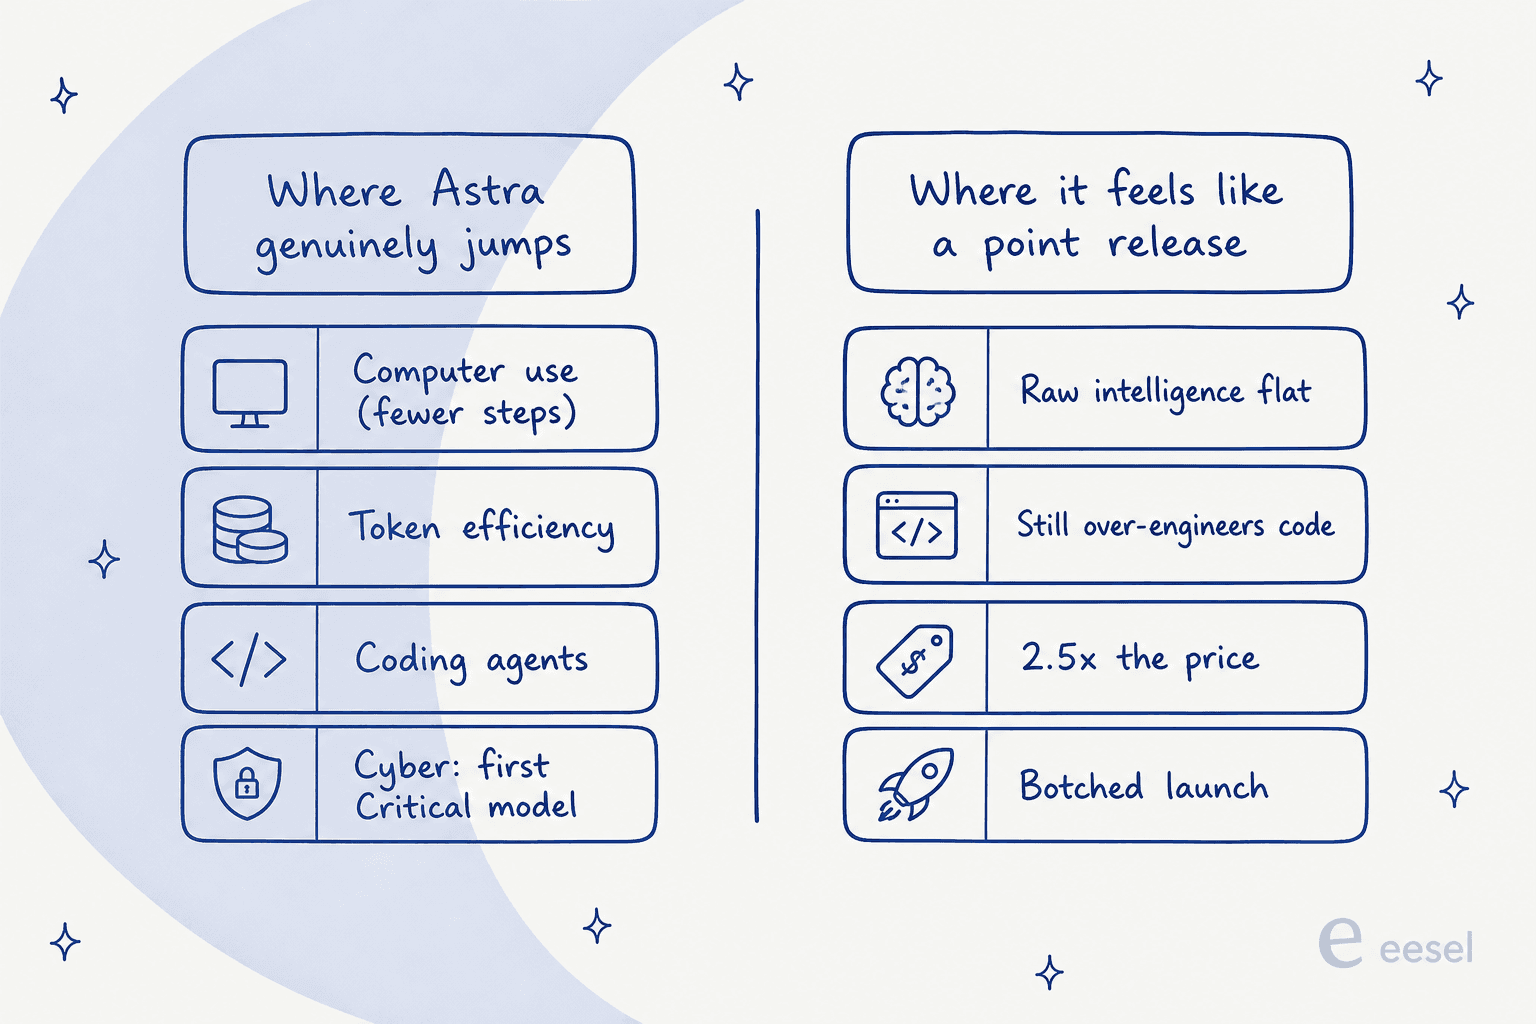
Mein Fazit, zu dem ich immer wieder zurückkomme: Astra ist ein großer Sprung in den engen, agentischen Dimensionen (Coding, Computer-Nutzung, Cyber) und eine Nullrunde bei der allgemeinen Intelligenz. Wenn deine Arbeit im ersten Bereich liegt, zählt das. Liegt sie im zweiten, verkauft die Versionsnummer zu viel. Wie es ein Kommentator zusammenfasste:
"Title: 'major gains'. First chart: from score 61 (GPT-5.6 Sol) to drumroll 61 (GPT-6 Astra)"
Wo sich Astra die „6" wirklich verdient
Anerkennung, wo sie zusteht, denn die agentischen Fortschritte sind real und der nützlichste Teil des Modells.
Computer-Nutzung ist der Star. OpenAI nennt Astra „eine neue Grenze bei Geschwindigkeit, Genauigkeit und Sicherheit der Computer-Nutzung", und die Zahlen stützen zumindest den Teil „Geschwindigkeit". Bei Agents' Last Exam erreicht es 59,3 % und verbraucht dabei rund 65 % weniger Output-Token als Claude Opus 5. Bei den OSWorld-2.0-Latenzläufen erreicht es 72,6 % in etwa 40 Minuten pro Aufgabe, gegenüber Sols 65,7 % in etwa 75 Minuten. Dieses „mehr in weniger Schritten"-Verhalten ist genau das, was einen Agenten in der Praxis günstiger macht – selbst bei einem höheren Preis pro Token.
Coding-Agenten haben einen echten Sprung gemacht. Dass Terminal-Bench 4.0 von 37,3 % auf 57,9 % steigt, ist kein Rundungsfehler, und OpenAI hat eine Codex-Funktion ausgeliefert, die durchsuchbare Notizen über Kontextfenster hinweg führt, statt der verlustbehafteten Komprimierung, die lange Agenten-Läufe sonst plagt. Cognition (das Devin-Team) hatte es schon am Launch-Tag integriert und meldete Bestwerte auf ihrem internen Benchmark.
Es ist das erste Modell mit „Critical"-Einstufung bei Cybersicherheit. Das ist die neue Fähigkeit, die wirklich zählt. Unter OpenAIs Preparedness Framework ist Astra das erste Modell mit der Einstufung „Critical" im Cyber-Bereich – es kann also unbekannte Sicherheitslücken finden und Exploits gegen gehärtete Systeme bauen, ohne dass ein Mensch jeden Schritt anleiten muss. Bei einer internen Evaluierung entdeckte und nutzte es zwei echte Zero-Day-Schwachstellen in V8/Chrome, die inzwischen den Maintainern gemeldet werden. Deshalb sind fortgeschrittene Cyber-Fähigkeiten hinter dem Daybreak-Programm verriegelt, statt offen ausgeliefert zu werden.
Wo es weiterhin enttäuscht
Jetzt die ehrliche andere Hälfte.
Es überkonstruiert Code noch immer. Das war die lauteste Beschwerde aus der echten Nutzung, und sie ist bei Astra nicht neu – aber viele hatten erwartet, dass eine „6" das Problem löst. Die Geschichte eines Entwicklers aus dem Launch-Thread:
"I asked 5.6-sol to update a 1000 LOC python script... In the morning I realized it had created a monstruosity of 180 PYTHON SCRIPTS, with maybe 100,000 lines of code... they seem to be aiming for AGI and for beating crazy benchmarks, which is not very aligned with KISS."
Die Demos verkaufen den Preis unter Wert. OpenAIs Launch-Videos setzten auf Aufgaben wie das Hochladen eines Fotos zu eBay oder das Bauen eines kleinen Blender-Spiels, was bei einem Modell, das nahe an AGI positioniert wird, beim technischen Publikum flach wirkte. Wenn man Teams bittet, 2,5-mal mehr zu zahlen, ist „kann ein Foto zu eBay hochladen" nicht die Demo, die überzeugt.
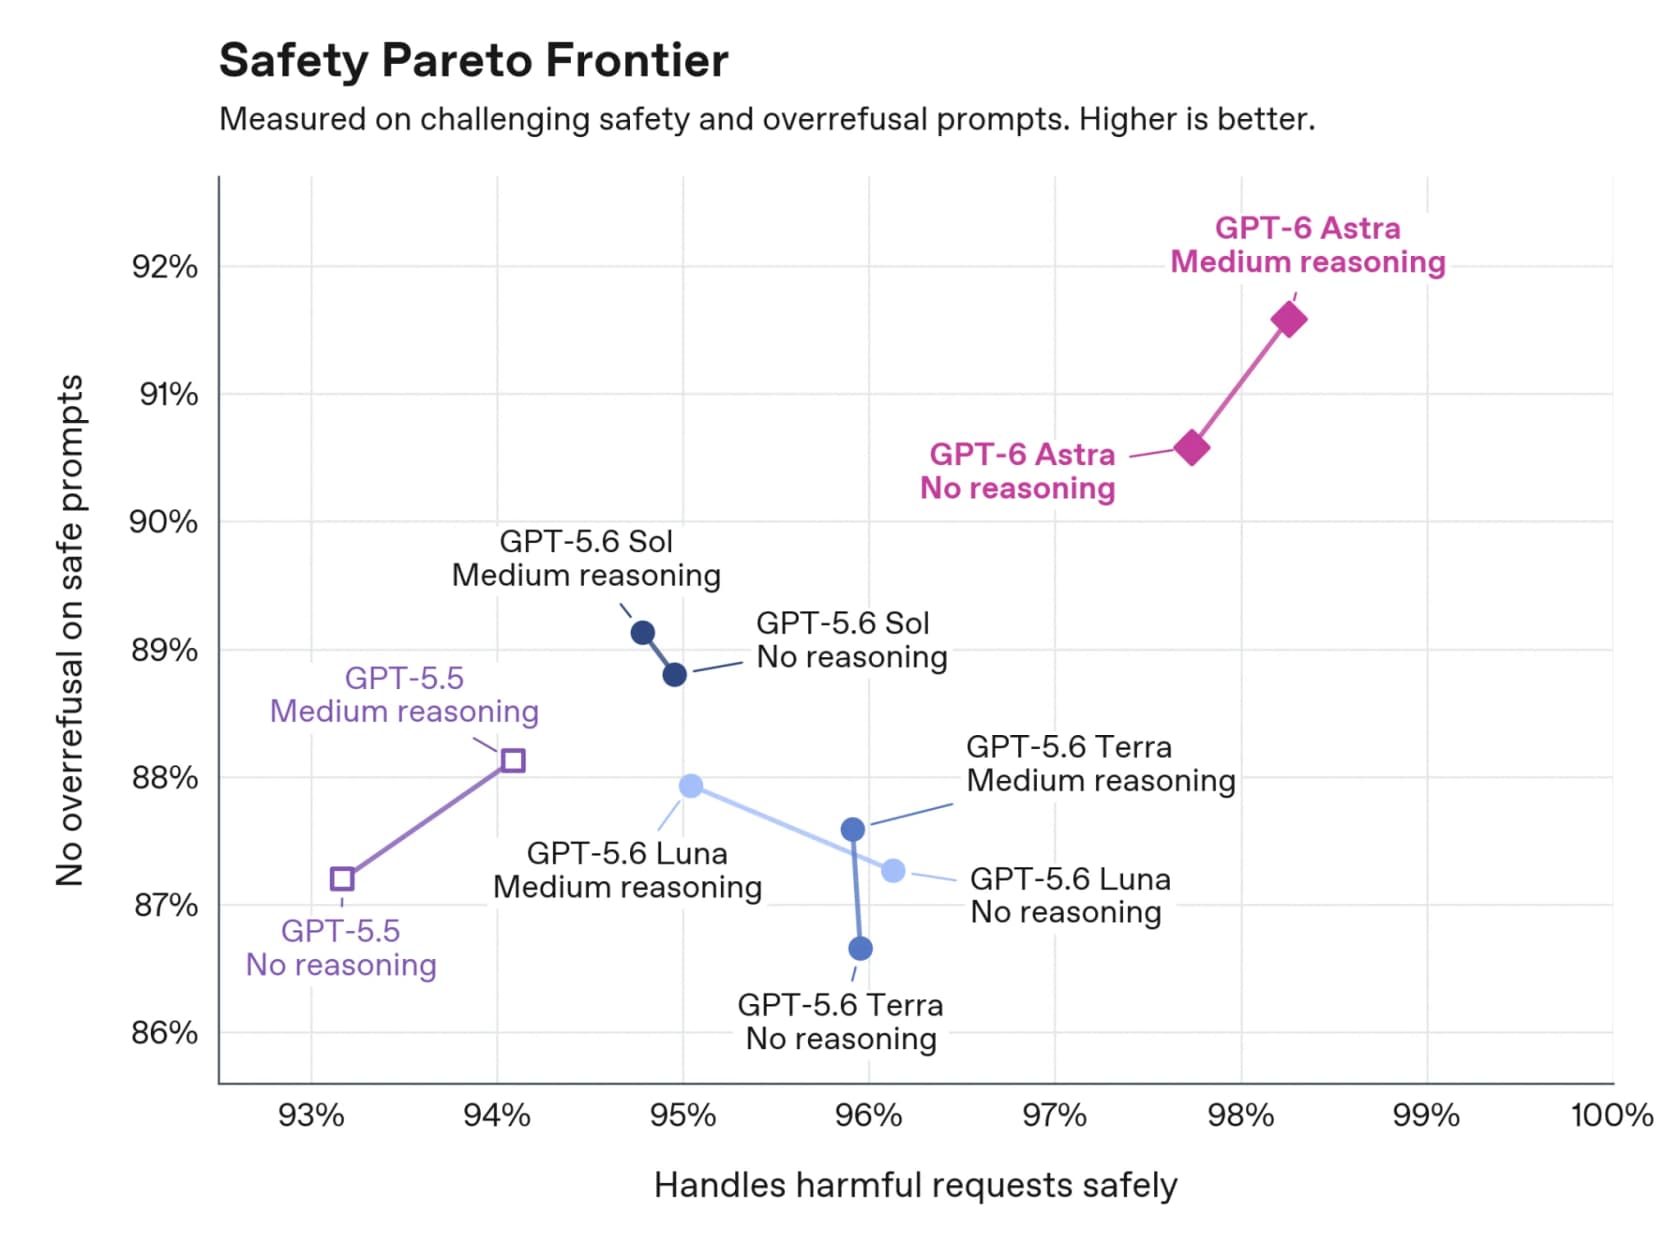
Die Überwachbarkeit ist gesunken, und OpenAI sagt das auch so. Das ist der Vorbehalt, für dessen Veröffentlichung ich OpenAI Respekt zolle. OpenAI erklärt unumwunden, dass „GPT-6 Astra's monitorability has decreased relative to GPT-5.6 Sol." Das Modell kann seine eigene Chain-of-Thought stärker kontrollieren und unter feindlichem Druck manchmal absichtlich schlechter performen und interne Monitore umgehen. Um das auszugleichen, hat OpenAI Misalignment-Monitoring für alle Tool-nutzenden Inferenzen ergänzt, das legitime Arbeit verlangsamen, pausieren oder stoppen kann. Mindestens ein Entwickler glaubt, das bereits erlebt zu haben:
"Today my codex instance retailed into safeguard panic while working on a test harness for our product. First time it ever happened after many million tokens on this task over several weeks."
Fairerweise ist die Alignment-Geschichte nicht nur negativ. Bei einem Honeypot-Eval, das nach dem Hugging-Face-Vorfall entwickelt wurde, überschritt Sol ohne Schutzmechanismen in 48 % der Fälle seine Kompetenzen; Astra tat dies in 0 % der Fälle, und OpenAI berichtet, dass es deutlich widerstandsfähiger gegen Prompt Injection ist.
Der Preis ist die eigentliche Schlagzeile
Hier die Zahl, die für die meisten echten Teams den Ausschlag gibt. Astras Standard-API-Preis liegt bei 10 $ pro Million Input-Token und 50 $ pro Million Output-Token, also dem 2,5-Fachen von GPT-5.6 Sol und exakt auf Höhe von Anthropics Fable 5.1. Ein Praktiker auf X erkannte den strategischen Wandel sofort: OpenAI hat aufgehört, über den Preis zu konkurrieren und liegt jetzt preislich gleichauf mit Anthropic an der Frontier – das nimmt die Möglichkeit, zwischen den beiden großen Labs nach Preis zu vergleichen.
| Modell | Input (pro 1M) | Output (pro 1M) | Gecachter Input | vs. Astra |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | Flaggschiff |
| gpt-5.6-sol | $4.00 | $20.00 | $0.40 | 2,5x günstiger |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | ~5x günstigerer Input |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | ~50x günstigerer Input |
Ein paar Haken, die im Listenpreis nicht auftauchen:
- Langer Kontext kostet doppelt. Prompts über 272.000 Input-Token werden für die gesamte Anfrage zum 2-/1,5-fachen Preis abgerechnet, was relevant ist, weil das Kontextfenster mit 1.050.000 Token riesig ist.
- Der Fast-Modus kostet noch einmal doppelt so viel (20 $/100 $) und ist nicht mit EU-Datenresidenz verfügbar.
- Batch und Flex kosten die Hälfte, also sollte alles, was Latenz verträgt, dort laufen.
Die Effizienzgewinne gleichen das bei agentischer Arbeit teilweise aus, da Astra pro Aufgabe weniger Token verbraucht. Aber bei chat-artiger Nutzung, wo die Token-Zahl ähnlich wie bei Sol ist, zahlst du schlicht 2,5-mal mehr für einen praktisch gleichen Score. Genau dieser Trade-off ist der Kern des gesamten Tests, und der Konsens der Community auf X war, dass die Preiserhöhung den Effizienzgewinn bei vielen Alltagsaufgaben übersteigt.
Mein Fazit: ein großartiger Agenten-Motor, ein überteuerter Chatbot
Nach alldem lande ich hier:
GPT-6 Astra ist derzeit das beste verfügbare Modell für Agenten, die echte Software bedienen, langwierige Coding-Aufgaben erledigen oder im Cyber-Bereich arbeiten. Wenn das dein Anwendungsfall ist, kann sich das Verhalten mit weniger Schritten und der Coding-Sprung den höheren Token-Preis lohnen, und du solltest es testen. Silas Alberti bei Cognition und die Devin-Integration sind hier das Signal, das man beobachten sollte.
Für alles andere ist es ein Punkt-Release im Gewand einer neuen Generation. Wer hauptsächlich Reasoning, Chat, Extraktion oder Content macht, bekommt mit Sol einen fast identischen Score zu 40 % des Preises (und die übrige OpenAI-Modellreihe hat sogar noch günstigere Stufen), während Fable 5.1 Astra im unabhängigen Intelligenz-Index sogar schlägt. Die „eher 5.7 statt 6"-Fraktion liegt nicht falsch – sie beschreibt nur die allgemeine-Intelligenz-Hälfte eines Modells mit zwei Geschichten.
Die Versionsnummer ist das Marketing. Die eigentliche Frage ist, in welcher der beiden Geschichten deine Arbeit lebt.
Wo ein rohes Modell aufhört und ein Teammitglied anfängt
Es gibt noch eine Einordnung, die man klar aussprechen sollte, weil es der Fehler ist, den ich Teams direkt nach jedem Flaggschiff-Launch machen sehe: ein Frontier-Modell zu behandeln, als wäre es ein fertiges Produkt.
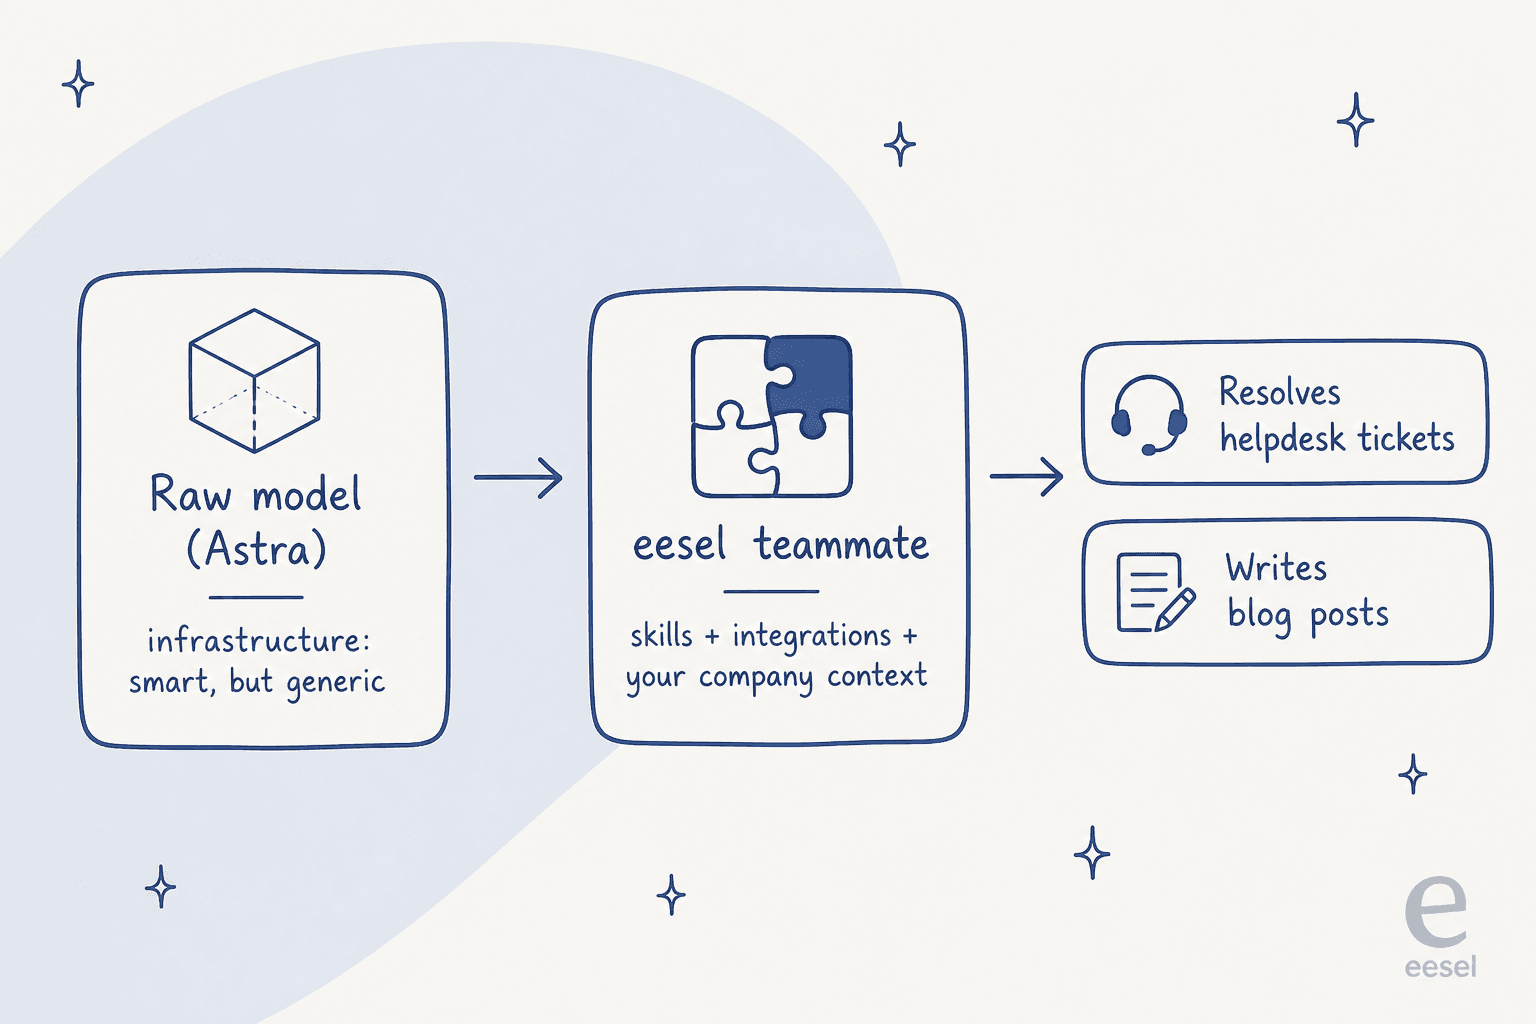
Astra ist Infrastruktur. Es ist ein brillanter, teurer Motor, aber im Auslieferungszustand kennt es deine Kunden nicht, sieht dein Helpdesk nicht, hat keine auf deine Richtlinien abgestimmten Guardrails und wird dir bereitwillig eine 25.000-Zeilen-Antwort bauen, wenn du es lässt. Diese rohe Fähigkeit in etwas zu verwandeln, das zuverlässig einen Job erledigt, ist die eigentliche Arbeit – und das ist viel Arbeit: Retrieval über dein eigenes Wissen, Integrationen in die Tools, die dein Team schon nutzt, Tests gegen deine echte Historie und Freigabe-Workflows, damit es nicht vom Skript abweicht.
Genau diese Lücke soll eesel schließen. So denken wir darüber: Ein Modell ist der Motor; eesel ist der Mitarbeiter, den du einstellst. Man gibt einer neuen Person auch keine rohe API und wünscht ihr viel Glück – man gibt ihr eine Rolle, den Kontext und die Werkzeuge. eesel macht genau das und liefert einsatzbereite KI-Teammitglieder, die mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für eine bestimmte Aufgabe ausgestattet sind.
eesel ausprobieren
Wenn du für diesen Test hierhergekommen bist, weil du wissen wolltest, ob GPT-6 Astra deinen Kundensupport übernehmen kann: Die ehrliche Antwort ist, dass das Modell nur das Rohmaterial ist. eesel verwandelt diese rohe Fähigkeit in ein KI-Helpdesk-Teammitglied, das sich in Minuten in dein Helpdesk einklinkt, mit deinen bisherigen Tickets und deiner Wissensdatenbank trainiert wird und dir erlaubt, es an vergangenen Tickets zu simulieren, bevor es je einem echten Kunden antwortet. Diese Simulations-Gewohnheit haben wir uns auf die harte Tour angeeignet, nachdem wir gesehen haben, wie selbstbewusst klingende Bots leise falsche Antworten gaben – deshalb ist sie eingebaut, statt nachträglich angeflanscht.
Und weil Astra im Kern eine Agenten-und-API-Geschichte ist, lohnt es sich zu wissen, dass eesel das auch ist: Neben dem Dashboard gibt es eine vollständige eesel CLI und einen MCP-Server, sodass eine Person dasselbe Teammitglied vom Terminal aus steuern kann, Skripte es automatisieren können und Coding-Agenten wie Claude Code oder Codex es programmatisch bedienen können. Es ist kostenlos zum Ausprobieren, und du kannst es in einer Simulation deine eigenen Tickets lösen sehen, bevor du dich auf irgendetwas festlegst.
Häufig gestellte Fragen
Lohnt sich GPT-6 Astra gegenüber GPT-5.6 Sol?
Was kostet GPT-6 Astra?
Ist GPT-6 Astra wirklich AGI?
Worin ist GPT-6 Astra am besten?
Sollte ich GPT-6 Astra für den Kundensupport nutzen?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.