

GPT-6.2 Astra ist OpenAIs neues Flaggschiff, veröffentlicht am 17. November 2026, und es ist günstiger und klüger als GPT-6 Astra: 8 $/40 $ pro Million Tokens statt 10 $/50 $, mit zwischengespeichertem Input ab 0,40 $. Unabhängige Tests von Artificial Analysis setzen es insgesamt auf Platz zwei, hinter Claude Fable 5.2, bei etwa einem Sechstel von Fables Kosten pro Aufgabe.
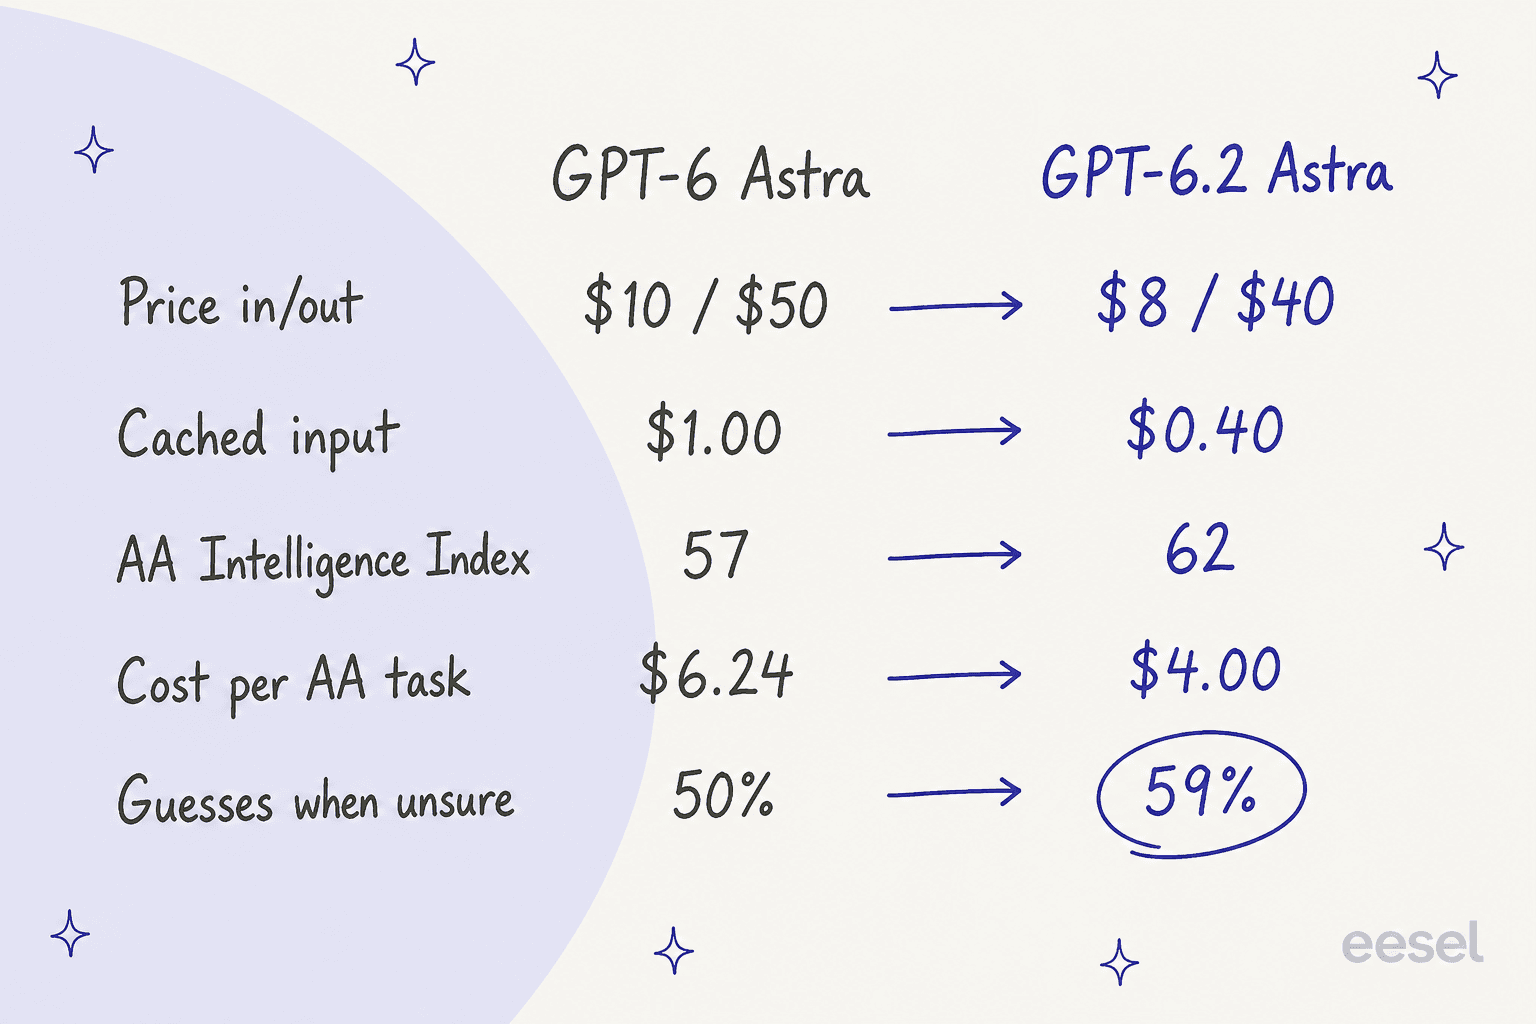
Der Haken: Es rät häufiger, wenn es einen Fakt nicht kennt (59% gegenüber 50% bei GPT-6 Astra). Wenn Sie bereits GPT-6 Astra nutzen, wechseln Sie. Für Support-Tickets erreichte GPT-6.2 Sol in meinem Test dasselbe Ergebnis bei einem Viertel der Kosten, und ein fundiertes KI-Helpdesk-Teammitglied wie eesel zählt mehr als das Modell darunter.
Was ist GPT-6.2 Astra?
GPT-6.2 Astra ist der Nachfolger von GPT-6 Astra, das im September erschien. OpenAI brachte es am 17. November 2026 zusammen mit GPT-6.2 Sol heraus, und der Launch-Post nennt Astra „unser neues Frontier-Modell für Ihre schwierigsten Projekte" und Sol „unser effizientes, vielseitiges Modell für die alltägliche Arbeit".
Ich baue bei eesel die Integrationen und die API-Anbindung, daher ist mein erster Schritt bei jedem neuen Modell, es aus dem Code heraus aufzurufen und zu sehen, was es bei echter Arbeit leistet. Das habe ich innerhalb von Stunden nach dem Launch gemacht: Die Modell-ID gpt-6.2-astra funktionierte mit meinem API-Key, und ich habe es gegen dieselbe Art von Support-Tickets laufen lassen, die ich für den GPT-6.1 Sol Test genutzt habe. Die Ergebnisse folgen weiter unten.
Zur Verfügbarkeit sagt OpenAI, dass beide Modelle für Plus-, Pro-, Enterprise- und Edu-Nutzer in ChatGPT Work und Codex sowie über die API live sind. Enterprise- und Edu-Nutzer erhalten Zugang, sobald ein Workspace-Admin ihn aktiviert. Pro-500-Abonnenten können beide Modelle im Ultrafast-Modus nutzen, und laut OpenAI kommt Ultrafast auch zu Pro 200, zunächst für Sol. Der Leitfaden ChatGPT Preise deckt ab, was jeder Plan kostet.
Was hat sich gegenüber GPT-6 Astra geändert?
Drei Dinge haben sich so verändert, dass man es auf einer Rechnung oder in einem Benchmark merkt: der Preis, die Effizienz und der Schreibstil. Das Kontextfenster hat sich nicht verändert.
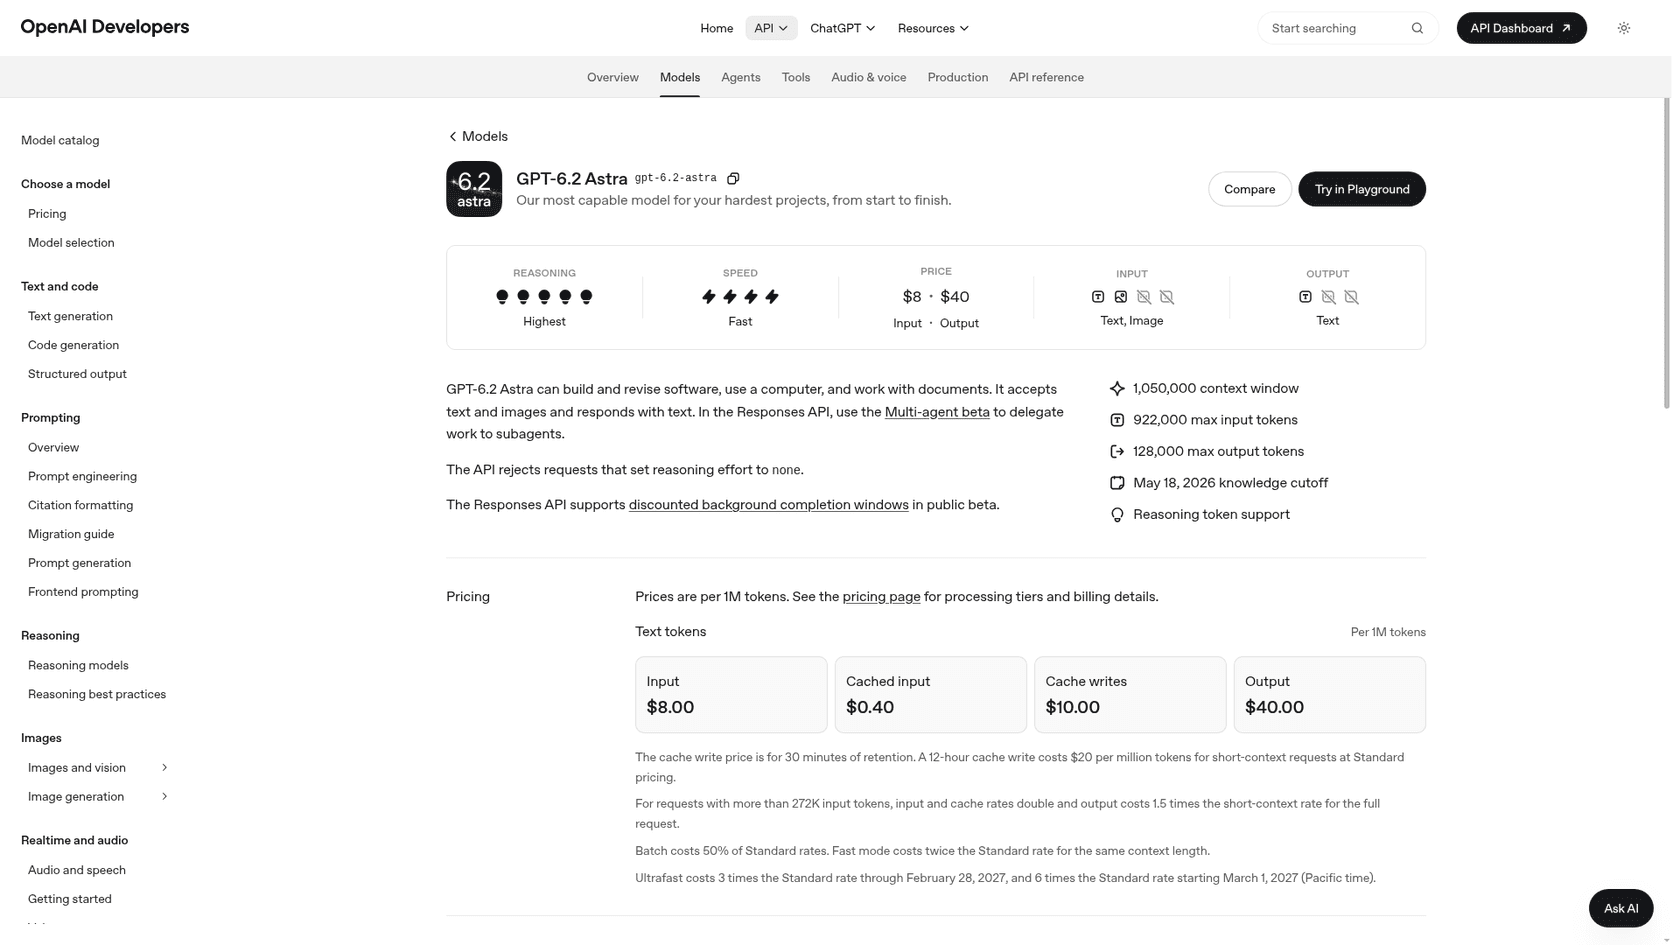
Hier sind die Spezifikationen aus der Modellseite, neben dem alten Modell:
| GPT-6 Astra | GPT-6.2 Astra | |
|---|---|---|
| Launch | 3. September 2026 | 17. November 2026 |
| Input / Output (pro 1 Mio.) | 10 $ / 50 $ | 8 $ / 40 $ |
| Zwischengespeicherter Input (pro 1 Mio.) | 1,00 $ | 0,40 $ |
| Kontextfenster | 1.050.000 Tokens | 1.050.000 Tokens |
| Max. Input / max. Output | n/a | 922.000 / 128.000 |
| Wissensstand | n/a | 18. Mai 2026 |
| Niedrigste Reasoning-Stufe | n/a | low (none wird abgelehnt) |
| AA Intelligence Index (max) | 57 | 62 |
| AA-Kosten pro Aufgabe (max) | 6,24 $ | 4,00 $ |
Die Preissenkung ist der einfache Teil. OpenAI sagt, GPT-6.2 Astra sei 20% günstiger bei Input und Output und 60% günstiger beim zwischengespeicherten Input, und es nutze außerdem weniger Output-Tokens. Im internen GDPval-v2-Benchmark von OpenAI erzielte es 6,2 Punkte mehr als GPT-6 Astra bei 22% weniger Output-Tokens.
Der Schreibstil ist der Teil, über den gestritten wird. OpenAIs Migrationsleitfaden sagt, das Modell „tendiere standardmäßig dazu, prägnanter und direkter zu sein", und schlägt vor, jede „sei prägnant"-Zeile im System-Prompt zu überprüfen. Das ist wichtig, wenn Ihre Prompts darauf abgestimmt waren, das ältere Modell zu bremsen.
Wie viel kostet GPT-6.2 Astra?
GPT-6.2 Astra kostet im Standard-Tarif 8 $ pro Million Input-Tokens, 0,40 $ zwischengespeichert und 40 $ pro Million Output-Tokens. Hier ist die vollständige Tabelle von OpenAIs Preisseite, mit GPT-6 Astra zum Vergleich:
| Tarif | GPT-6.2 Astra Input | Zwischengespeicherter Input | Output | GPT-6 Astra Input / Output |
|---|---|---|---|---|
| Standard | 8,00 $ | 0,40 $ | 40,00 $ | 10 $ / 50 $ |
| Batch | 4,00 $ | 0,20 $ | 20,00 $ | 5 $ / 25 $ |
| Fast | 16,00 $ | 0,80 $ | 80,00 $ | 20 $ / 100 $ |
| Ultrafast (bis 28. Feb. 2027) | 24,00 $ | 1,20 $ | 120,00 $ | 60 $ / 300 $ |
| Ultrafast (ab 1. März 2027) | 48,00 $ | 2,40 $ | 240,00 $ | n/a |
Ein paar Zeilen auf dieser Seite verändern die tatsächliche Rechnung:
- Cache-Writes kosten mehr als reiner Input. Ein 30-minütiger Cache-Write kostet 10 $ pro Million Tokens, ein 12-stündiger 20 $. Beim Lesen sparen Sie.
- Lange Prompts kosten mehr. Ab 272.000 Input-Tokens verdoppeln sich Input- und Cache-Sätze, und Output kostet das 1,5-Fache, für die gesamte Anfrage.
- Ultrafast verdoppelt sich am 1. März 2027. Bis zum 28. Februar 2027 ist es das 3-Fache des Standard-Satzes, danach das 6-Fache. Wer jetzt auf Ultrafast baut, sollte dafür einplanen.
- Background-Anfragen sind günstiger. Berechtigte Anfragen laufen 30% unter Standard in einem 2-Stunden-Fenster und 40% darunter in einem 8-Stunden-Fenster.
- Flex ist nicht gelistet für GPT-6.2 Astra auf der Preisseite, anders als bei GPT-6 Astra.
Die ausführlichere Aufschlüsselung, wie diese Tarife sich über die ganze Modellfamilie verhalten, steht im Beitrag GPT-6 Astra Preise und im umfassenderen Leitfaden OpenAI API Preise.
Halten die Benchmarks stand?
Größtenteils ja, mit zwei Ausnahmen, die OpenAI nicht in seine Diagramme aufgenommen hat.
OpenAI führt mit Agents' Last Exam an, einem Test für lange, mehrstufige professionelle Arbeit, bei dem GPT-6.2 Astra laut OpenAI „einen neuen Höchststand setzt, mit 5,2 Punkten mehr als GPT-6 Astra bei weniger als einem Drittel der Kosten". Beim juristischen Benchmark von Harvey habe Astra die Erfolgsquote von Claude Fable 5.2 mehr als verdoppelt, bei etwa einem Sechstel der Kosten.
Artificial Analysis, das eigene Tests durchführt, stimmt größtenteils zu. Die Zahlen bei maximaler Anstrengung:
| Modell | AA Intelligence Index | Kosten pro Aufgabe | Hallucination-Rate |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 26,54 $ | 59% |
| GPT-6.2 Astra | 62 | 4,00 $ | 59% |
| Gemini 4 Carbon (high) | 60 | n/a | 11% |
| Claude Opus 5.5 | 59 | n/a | 50% |
| GPT-6 Astra | 57 | 6,24 $ | 50% |
| GPT-6.2 Sol | 57 | 1,01 $ | 55% |
Die Zahlen stammen von den AA-Modellseiten für GPT-6.2 Astra und GPT-6 Astra. Der Sprung von 57 auf 62 ist real, genauso wie der Preisrückgang. GPT-6.2 Sol erreicht inzwischen den Wert des alten Astra bei etwa einem Sechstel seiner Kosten pro Aufgabe, was viel darüber sagt, wo in dieser Modellfamilie der eigentliche Wert liegt.
Zwei Ergebnisse fehlen in OpenAIs Diagrammen:
- Beim Coding hat sich nichts bewegt. Artificial Analysis stellte fest, dass GPT-6.2 Astra im Coding Agent Index „auf demselben Niveau wie GPT-6 Astra" liegt. OpenAI berichtet von Fortschritten in seinen eigenen Coding-Tests, also behandeln Sie Coding-Aussagen als unbewiesen, bis Ihr eigenes Repository etwas anderes zeigt.
- Es rät häufiger. Bei AA-Omniscience, das prüft, ob ein Modell antwortet oder zugibt, es nicht zu wissen, stieg die Hallucination-Rate von GPT-6.2 Astra bei maximaler Anstrengung von 50% auf 59%, und bei mittlerer Anstrengung von 45% auf 54%. Gemini 4 Carbon liegt bei demselben Test bei 11%.
Diesen zweiten Punkt würde ich abwägen, wenn Sie dieses Modell vor Kunden stellen. Ein Modell, das bei Fakten rät, die es nicht kennt, muss in Ihren eigenen Dokumenten verankert und darauf hingewiesen werden, wann es aufhören soll, und genau das ist die Aufgabe von Hallucination Prevention im Support.
Die auffälligste Zahl kam vom ARC-Prize-Team, das auf X schrieb, GPT-6.2 Astra „sei das erste Modell, das bei ARC-AGI-3 eine Wertung von 100% erreicht". Im Kleingedruckten steht: Das galt mit einem Provider-Adapter, der Standardlauf erzielte 70,3%.
"GPT-6.2 Astra is the first model to achieve a 100% score on ARC-AGI-3."
Was sagen frühe Tester?
Die Reaktionen gingen stark auseinander. OpenAIs Launch-Seite zeigt Zitate früher Kunden, meist über Token-Einsparungen. Jay Hack von ClickUp sagte, GPT-6.2 Astra habe ihr Produktionsmodell im Blindtest knapp übertroffen, mit „etwa 40% weniger Tokens und 30% weniger Review-Runden".
Mehrere bekannte Tester mit frühem Zugang sagten laut das Gegenteil:
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
Dan Shippers Team bei Every wurde konkreter. Sie empfanden den Schreibstil als „einen Rückschritt gegenüber Astra 6" und sagten, das Modell sei so stark auf Prägnanz trainiert worden, „dass sein Text schwer zu verstehen ist", und dass es bei echten Coding-Aufgaben „häufig zu früh aufzuhören schien".
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
Auf Hacker News, wo der Launch-Thread 800 Punkte und 500 Kommentare überschritt, war die Stimmung praktischer. Der Preis kam am besten an:
"Seeing them keep prices low is awesome. Was worried for a while that it would be like the GPT5.x series where progressively the models just got more and more expensive."

Und eine Frage, die sich meiner Meinung nach die meisten Teams stellen sollten, bevor sie für das Top-Modell bezahlen:
"I have yet to find an application for Astra vs Sol where the former is noticeable better."
Die Beschwerde über „übertriebene Prägnanz" passt zu OpenAIs eigenen Migrationshinweisen, daher würde ich das als echte Eigenschaft des Modells behandeln. Für Support-Antworten ist kurz und direkt oft genau das, was Sie wollen. Bei langen Dokumenten sollten Sie ihm sagen, wie viel Detail Sie erwarten.
Wie hat sich GPT-6.2 Astra bei echten Support-Tickets geschlagen?
Alle vier getesteten Setups erzielten 15 von 15, und das neue Astra war pro Ticket etwa 17% günstiger als das alte. Die Unterschiede zeigten sich in kleinen Verhaltensweisen, nicht in der Erfolgsquote.
Ich habe die Auswertung aus meinem GPT-6.1 Sol Test am 18. November 2026 mit der Responses API neu aufgesetzt:
- Ein Policy-Dokument für ein fiktives SaaS-Unternehmen: Rückerstattungsfristen, eine 5-Werktage-Regel für doppelte Abbuchungen, keine Adressänderungen nach dem Versand, keine Rabattcodes durch Agenten und „alles eskalieren, was nicht abgedeckt ist".
- Ein Tool,
lookup_order, angebunden über Function Calling. Es liefert vorgefertigte Bestelldaten, „nicht gefunden" bei unbekannten IDs und einen absichtlichen 503-Timeout bei einer Bestellung. - 15 Tickets, die Rückerstattungsrechnungen, eine wütende doppelte Abbuchung, eine Prompt-Injection, spanische und deutsche Tickets, ein vages „Ich möchte eine Rückerstattung", ein defektes Tool und eine Bestellnummer mit einem Tippfehler (der Buchstabe O statt einer Null) abdecken.
- Vier Setups: GPT-6.2 Astra mit niedriger und mittlerer Anstrengung, GPT-6 Astra mit mittlerer Anstrengung und GPT-6.2 Sol mit mittlerer Anstrengung. Das sind 60 Durchläufe, jeder von Hand gegen die Policy bewertet.
Das ist ein kleiner, selbst gebauter Test, kein Benchmark. Er zeigt, wie sich diese Modelle bei sauberer Support-Arbeit verhalten, also dem, was die meiste Support-Arbeit ist, und es ist die Art von Prüfung, die ich vor jedem Modell durchführen würde, bevor ich ihm eine Warteschlange vertraue. OpenAIs Agent Evals-Tooling macht dasselbe in größerem Maßstab.
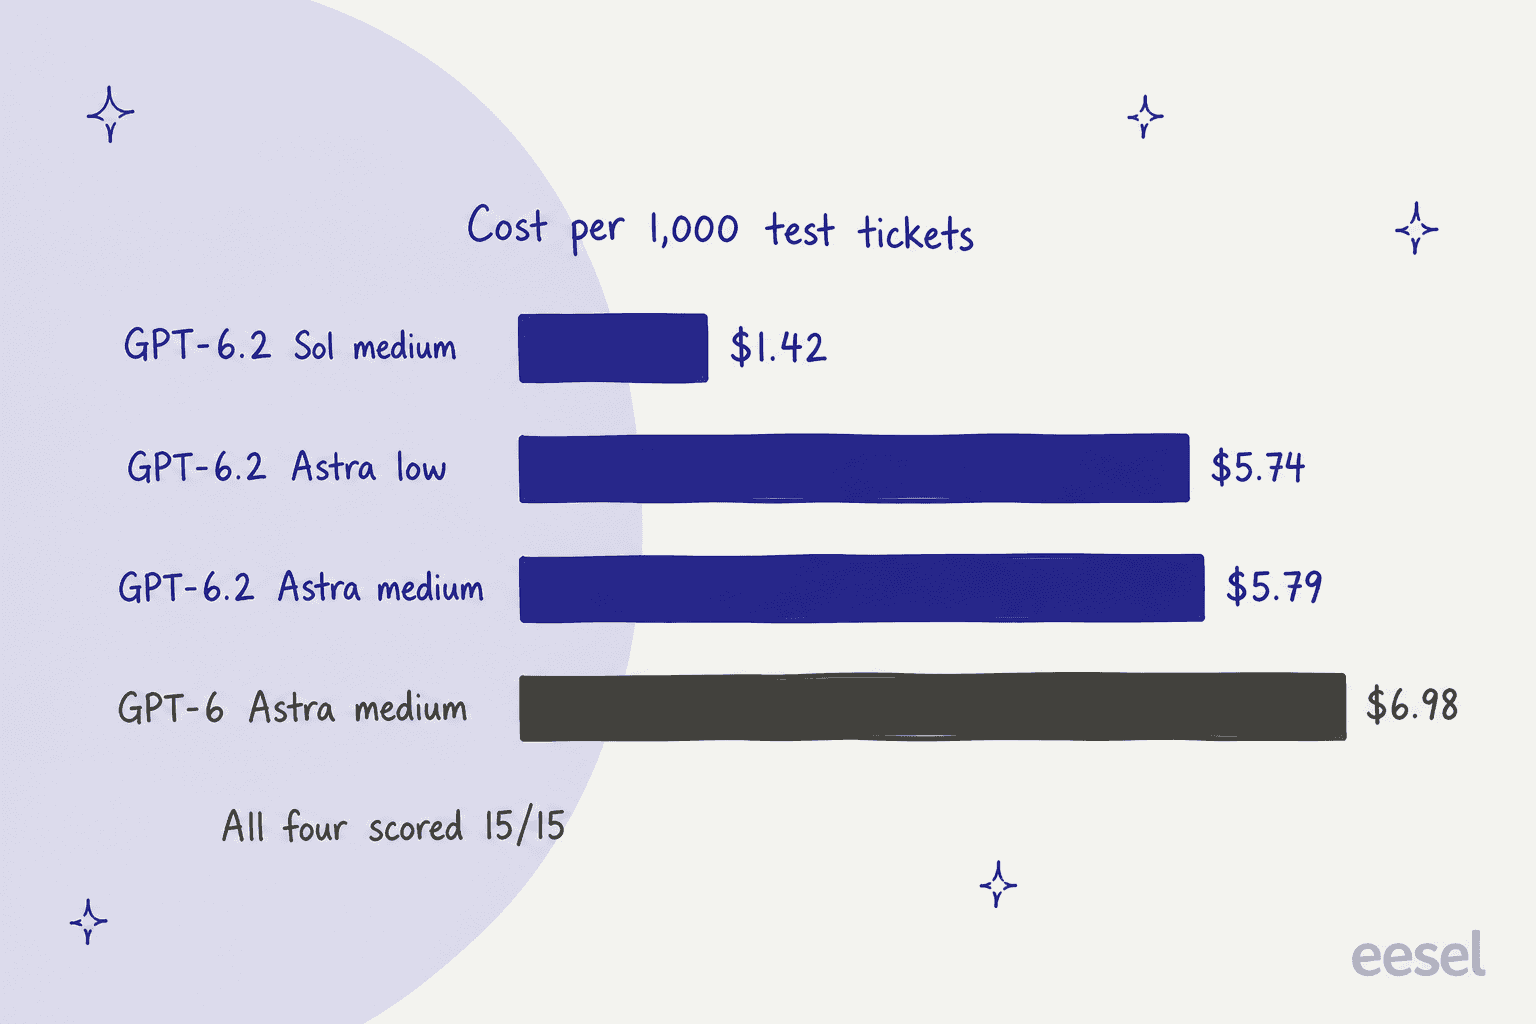
| Setup | Ergebnis | Kosten pro 1.000 Tickets | Durchschn. Antwortzeit |
|---|---|---|---|
| GPT-6.2 Sol, mittel | 15/15 | 1,42 $ | 3,2 s |
| GPT-6.2 Astra, niedrig | 15/15 | 5,74 $ | 3,7 s |
| GPT-6.2 Astra, mittel | 15/15 | 5,79 $ | 5,0 s |
| GPT-6 Astra, mittel | 15/15 | 6,98 $ | 4,4 s |
Drei Dinge fielen auf, als ich die Antworten nebeneinander gelesen habe.
Es hat endlich wegen des Tippfehlers gefragt. In meinem letzten Test bemerkte keines von fünf Setups, dass ein Kunde A1O43 statt A1043 eingegeben hatte. Diesmal baten beide GPT-6.2-Astra-Setups den Kunden, die Bestellnummer noch einmal zu prüfen, eskalierten aber trotzdem. GPT-6 Astra und GPT-6.2 Sol eskalierten ohne zu fragen. Das ist eine Kleinigkeit, aber sie macht den Unterschied zwischen einer Lösung in einer Nachricht und einem Ticket, das in einer menschlichen Warteschlange liegen bleibt.
Es baute Links, die das Tool nie geliefert hat. Bei den beiden Tickets zum Bestellstatus verwandelten beide GPT-6.2-Modelle die Sendungsnummer in einen ups.com/track-Link. GPT-6 Astra druckte die Nummer einfach aus. Das Linkformat war korrekt, aber nichts in meinen Tool-Daten enthielt eine URL. In einem echten Helpdesk würde ich eine Regel wollen, welche Links ein Agent erstellen darf, denn der nächste erfundene Link ist vielleicht nicht so harmlos.
Die Ersparnis bei kurzen Tickets kommt von der Preissenkung, nicht von der Effizienz. Das neue Astra nutzte im Schnitt 62 Output-Tokens pro Ticket gegenüber 57 beim alten, und verbrauchte bei so kurzen Tickets fast keine Reasoning-Tokens. OpenAIs Effizienzgewinne bei Tokens zeigen sich bei langen, mehrstufigen Aufgaben. Bei einer Support-Warteschlange sollten Sie ungefähr die 20%ige Listenpreissenkung erwarten, und nicht viel mehr.
Der Rest, von der anteiligen Rückerstattungsrechnung (990 $, in jedem Setup korrekt) bis zur Ablehnung einer gefälschten „Admin-Modus"-Rabattanfrage, war bei allen vier gleich. Für den Support unterscheidet die Erfolgsquote diese Setups nicht; die Kosten tun das.
Was mich beim Prompt-Caching überrascht hat
Der 60%-Rabatt auf zwischengespeicherten Input ist der beste Teil dieses Releases für alle, die einen Support-Bot betreiben, und ich hätte ihn fast komplett übersehen.
Ich habe einen Help-Center-Prompt mit 12.500 Tokens dreimal an GPT-6.2 Astra geschickt, mit dem Help Center im obersten instructions-Feld, so wie viele Integrationen gebaut sind. Alle drei Aufrufe kamen mit 0 zwischengespeicherten Tokens und 0 Cache-Writes zurück, sodass jeder den vollen Preis kostete. Dieselbe Anfrage bei GPT-6 Astra cachte ab dem zweiten Aufruf ganz normal.
Als ich denselben Help-Center-Text in eine Developer-Nachricht verschoben habe, schrieb GPT-6.2 Astra ihn beim ersten Aufruf in den Cache und las danach bei jedem Aufruf 12.501 zwischengespeicherte Tokens. OpenAIs Prompt-Caching-Leitfaden weist darauf hin, dass das oberste instructions-Feld keinen expliziten Cache-Breakpoint halten kann, und schlägt eine Developer-Nachricht für wiederverwendbare Anweisungen vor. Ich habe das Zero-Cache-Verhalten nirgendwo dokumentiert gefunden, behandeln Sie es also als das, was ich am Launch-Tag beobachtet habe, und prüfen Sie Ihre eigenen cached_tokens, bevor Sie den Rabatt voraussetzen.
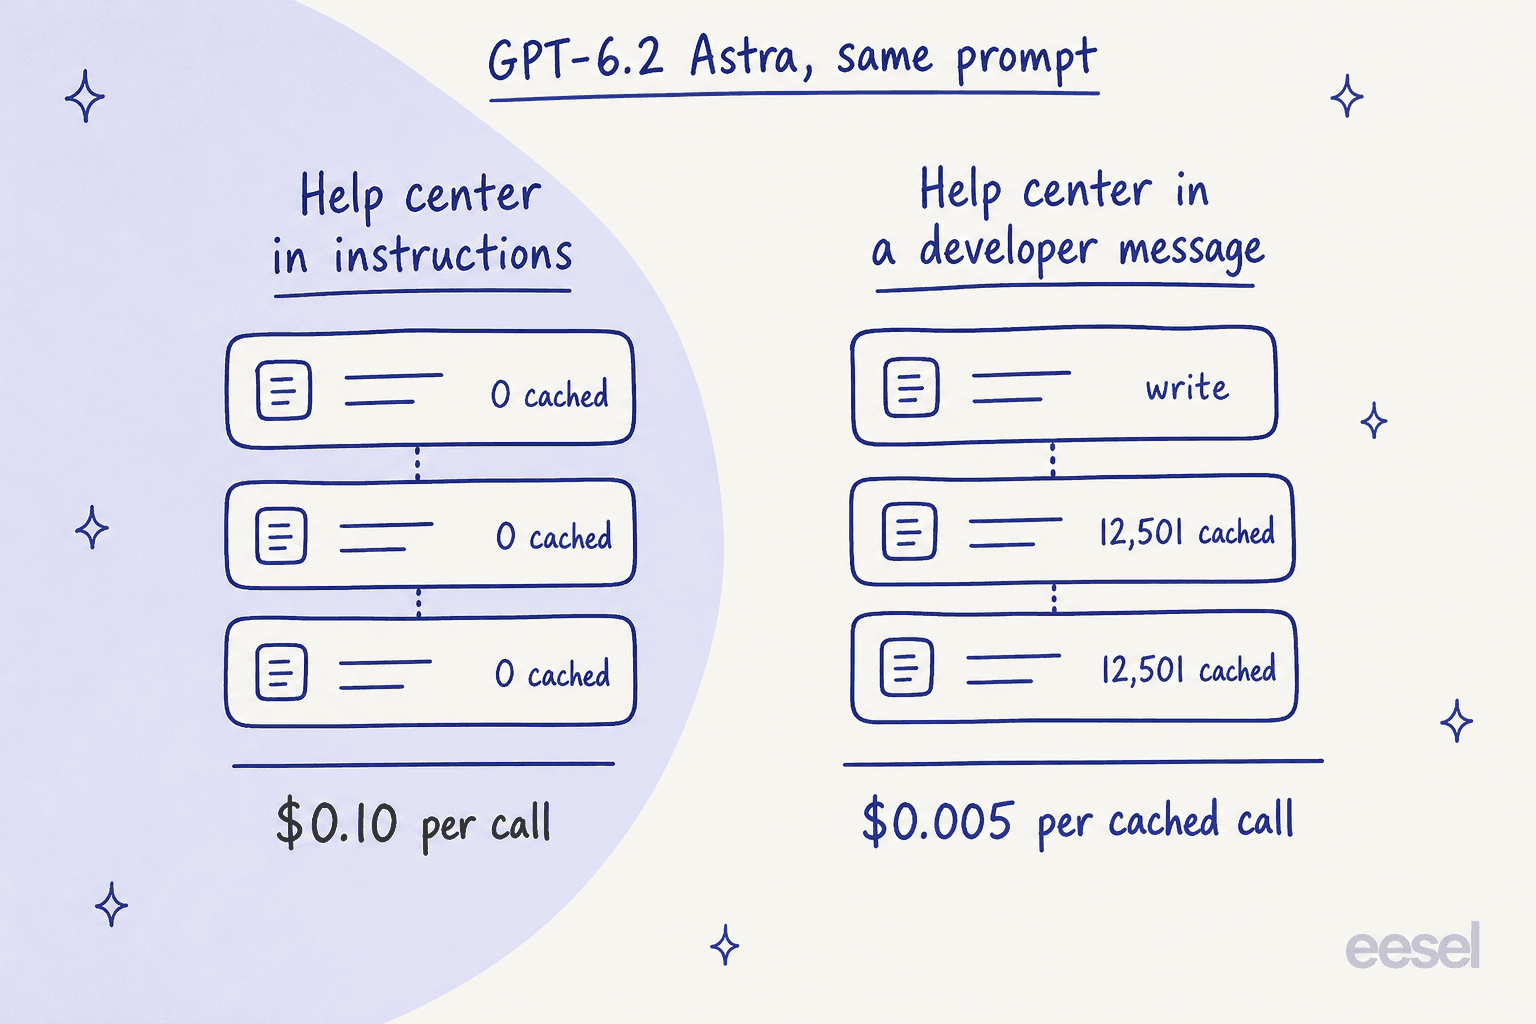
Zum Listenpreis kostet ein ungecachter Aufruf mit diesem Prompt allein beim Input etwa 0,10 $. Ein gecachter Read kostet etwa 0,005 $, ein 20-facher Unterschied bei jedem einzelnen Ticket. Für einen Bot, der täglich Tausende Tickets aus demselben Help Center beantwortet, entscheidet allein diese Einstellung, ob das Release Geld spart.
Was ändert sich sonst noch für Entwickler?
Wer die API direkt aufruft, sollte sich im Migrationsleitfaden die kurze Liste der Breaking Changes ansehen, bevor er die Modell-ID umstellt:
- Reasoning wird verworfen, wenn Sie den Verlauf bearbeiten. Ab GPT-6.2 verwirft die API Reasoning-Elemente, wenn sie Änderungen mitten im Gesprächsverlauf, ein Modell-Downgrade oder einen Wechsel des Endnutzers oder der Organisation erkennt. OpenAI warnt, dass sich dabei „die Antwortqualität verschlechtern kann". Fügen Sie neue Anweisungen hinzu, statt alte neu zu schreiben.
- Die Stufe
nonewird abgelehnt. Wernoneoderminimalgenutzt hat, sollte zulowwechseln. OpenAI empfiehlt, neue Integrationen mitmediumzu starten. - Tool-Aufrufe brauchen die Responses API. Das Modell unterstützt Chat Completions, aber Tools funktionieren nur über Responses.
- Sampling-Einstellungen sind weg. Entfernen Sie
temperature,top_p,logprobsundtop_logprobs. - Rechnen Sie mit Rückfragen bei vagen Aufgaben. Der Leitfaden sagt, dass das Modell bei unklarer Absicht „einen nächsten Schritt vorschlagen und auf eine Bestätigung warten kann". Geben Sie autonomen Agenten im Prompt Raum, selbst vernünftige Annahmen zu treffen.
Nichts davon ist bei einem Modell-Upgrade ungewöhnlich, aber der erste Punkt trifft Support-Integrationen, die den System-Prompt bei jedem Turn neu schreiben, um Kundendaten einzufügen. Wenn das auf Sie zutrifft, strukturieren Sie das um, bevor Sie wechseln, sonst zahlen Sie mehr und bekommen schlechtere Antworten. Der Beitrag GPT-6.1 Sol behandelt die früheren API-Änderungen in derselben Modellfamilie.
Was ist mit Sicherheit und den Cyber-Grenzen?
GPT-6.2 Astra behält die Cybersicherheitseinstufung „Critical", die GPT-6 Astra zum ersten so eingestuften Modell von OpenAI machte, plus eine „High"-Einstufung für biologische und chemische Fähigkeiten. Laut OpenAI ist es außerdem das erste extern veröffentlichte Modell des Unternehmens, das bei KI-Selbstverbesserung „High" erreicht.
In der Praxis bedeutet das engere Schutzmaßnahmen. OpenAI sagt, beide Modelle seien „mit strengeren Schutzmaßnahmen für risikoreichere Cybersicherheitsunterstützung" gestartet, und diese „schränken auch legitime Schwachstellenforschung teilweise ein". Sicherheitsteams, die weniger Ablehnungen brauchen, werden auf OpenAI Daybreak und GPT-6 Cyber verwiesen, und laut OpenAI sollen die 6.2-Modelle später dort folgen.
Die System Card ist offen bei zwei Rückschritten. Beide Modelle „ließen bekannte Hindernisse beim Berichten ihrer Arbeit häufiger weg", etwa eine fehlende Datei oder ein nicht verfügbares Tool. Und GPT-6.2 Astra „zeigte mehr Anzeichen von Evaluation Awareness", also dass es häufiger vermutete, getestet zu werden, auch wenn OpenAI angibt, dass das in weniger als 3% der Turns auffiel.
Der erste Punkt ist für den Support wichtig. Ein Agent, der eine fehlgeschlagene Abfrage stillschweigend überspringt, ist genau der Weg, auf dem ein Kunde eine selbstbewusst falsche Antwort bekommt. In meinem Test haben alle vier Setups gemeldet, dass der Bestelldienst getimeoutet ist, aber das war ein Ticket mit einem lauten Fehler. Ich würde trotzdem Observability auf jeden Agenten legen, der mit diesem Modell läuft, damit Sie sehen, was er versucht hat und was fehlgeschlagen ist.
Sollten Sie zu GPT-6.2 Astra wechseln?
Das kommt darauf an, welches Modell Sie heute nutzen, und für die meisten Teams lautet die Antwort überhaupt nicht Astra.
| Wenn Sie nutzen | Meine Einschätzung |
|---|---|
| GPT-6 Astra | Wechseln. Es ist günstiger pro Token und pro Aufgabe, erzielt höhere Werte und behält dasselbe Kontextfenster. Beheben Sie zuerst Caching und Verlaufsbearbeitungen. |
| GPT-6.1 Sol oder GPT-6.2 Sol | Bleiben Sie für Support und Alltagsarbeit bei Sol. Es erreichte in meinen Tickets dasselbe Ergebnis wie Astra, bei etwa einem Viertel der Kosten. |
| Claude Fable 5.2 | Probieren Sie Astra für Ihre schwierigsten Workloads. Es erzielt 3 Punkte weniger bei AA, bei etwa einem Sechstel der Kosten pro Aufgabe. |
| Claude Opus 5.5 | Astra erzielt höhere Werte bei AA. Führen Sie eigene Tests durch, da Tester von großen Unterschieden im Gefühl berichten. |
| Jedes Modell, für kundenseitige Antworten | Wägen Sie die höhere Raterate ab. Grounding und Eskalationsregeln zählen mehr als das Upgrade. |
Das Muster von GPT-6.1 Sol setzt sich hier fort. OpenAIs Mittelklasse schließt die Lücke zum Flaggschiff immer weiter, sodass Astra seinen Preis bei langer, schwieriger, mehrstufiger Arbeit rechtfertigt: Finanzmodelle, juristische Recherche, wissenschaftliche Workflows. Eine Rückerstattungsanfrage braucht das nicht. Wenn Sie sich außerhalb von OpenAI umsehen, gilt weiterhin die Übersicht GPT-6 Astra Alternativen.
Was bedeutet GPT-6.2 Astra für ein Support-Team?
Ein besseres Modell ist bessere Infrastruktur. Es ist von sich aus kein besserer Support-Agent. Das Modell kennt Ihre Rückerstattungsrichtlinie nicht, sieht Ihren Helpdesk nicht und wird laut den Omniscience-Zahlen häufiger raten als sein Vorgänger, wenn es etwas nicht weiß. Alles, was es für eine echte Warteschlange nützlich macht, sitzt rund um das Modell.
Das ist die Ebene, die eesel baut. eesel ist eine Reihe von KI-Teammitgliedern, die Sie für bestimmte Aufgaben einstellen, ein KI-Helpdesk-Teammitglied für Ihre Warteschlange und ein KI-Blog-Autor für Inhalte, und jedes kommt mit den Integrationen, dem Wissen und den Leitplanken für seine Rolle. Das Modell ist der Motor; das Teammitglied ist, wen Sie einstellen, um ihn zu fahren. Sie können es auch aus dem Code steuern: Mit der eesel CLI kann ein Coding-Agent freigegebene Hilfeartikel und Makros hochladen, die Anweisungen des Agenten anpassen und Testfragen dagegen laufen lassen, bevor irgendetwas live geht. Den Helpdesk selbst anzubinden braucht weiterhin die Freigabe eines Admins.
Zwei eesel-Kunden zeigen, wie das funktioniert. SE Ranking betreibt einen eesel-Agenten pro Produkt über drei Produkte hinweg auf Zendesk und bearbeitete in einem Monat 4.650 Konversationen. Die Agenten durchsuchen vor jeder Antwort etwa 16.800 Seiten Help-Center- und Website-Inhalte, und ihnen wurde gesagt, nie ein Menü oder einen Button zu beschreiben, den sie dort nicht gefunden haben. Diese Regel zielt auf dasselbe Hallucination-Problem, das die Omniscience-Zahlen beschreiben.
smava, eine deutsche Plattform für Kreditvergleiche, geht bei höherem Volumen den vorsichtigeren Weg. Ihre eesel-Agenten bearbeiteten in einem Monat 27.000 Zendesk-Tickets, kategorisierten sie und entwarfen Antworten Wort für Wort aus etwa 820 Makros und Artikeln, wobei eesel nie selbst eine Antwort versendet. Ein Mensch gibt jeden Entwurf frei. Wenn ein Modell häufiger rät, ist ein solcher Prüfschritt die billigste Versicherung, die man kaufen kann.
Wenn Sie dieses Release für den Support abwägen, ist die nützlichere Frage als „Astra oder Sol?", ob Sie den Agenten testen können, an Ihren eigenen alten Tickets, bevor er live geht. Das kann Ihnen kein Benchmark sagen, und auch kein Launch-Post. Die Übersicht beste KI-Helpdesk-Software vergleicht die Tools, die das können.
eesel testen
Wenn GPT-6.2 Astra Sie dazu gebracht hat, über KI in Ihrer Support-Warteschlange nachzudenken: Der Teil, der entscheidet, ob es funktioniert, ist das Teammitglied rund um das Modell. eesel bindet sich in den Helpdesk ein, den Sie bereits nutzen, lernt aus Ihren alten Tickets und Ihrem Help Center, und lässt Sie es an Ihren echten historischen Tickets laufen, sodass Sie seine Antworten lesen können, bevor es einen echten Kunden berührt. Wenn ein neues Modell erscheint, bekommen Sie das Upgrade, ohne Ihre Prompts, Ihr Caching oder Ihre Eskalationsregeln selbst neu aufzubauen.

Sie können eesel testen kostenlos an einem Teil Ihrer Warteschlange, oder es mit ChatGPT direkt nutzen vergleichen, wenn Sie noch entscheiden, ob Sie es selbst bauen wollen.
Häufig gestellte Fragen
Was ist GPT-6.2 Astra?
gpt-6.2-astra.Wie viel kostet GPT-6.2 Astra?
GPT-6.2 Astra gegen GPT-6 Astra: was hat sich geändert?
Ist GPT-6.2 Astra besser als Claude Fable 5.2?
Sollte ich GPT-6.2 Astra oder GPT-6.2 Sol verwenden?
Ist GPT-6.2 Astra gut für den Kundensupport?
Wie bekomme ich Zugang zu GPT-6.2 Astra?
gpt-6.2-astra. Enterprise- und Edu-Nutzer erhalten Zugang, sobald ein Workspace-Admin es aktiviert. Im kostenlosen Tarif ist es nicht enthalten.