
Warum überhaupt über GPT-6.1 Sol hinausschauen
Zuerst will ich 6.1 Sol fair behandeln. Es hat sich das verdient. OpenAI hat es auf der DevDay am 29. September 2026 veröffentlicht, nur sieben Tage nach GPT-6 Sol, und es hat das ältere Modell in OpenAIs Hauptpreistabelle ersetzt. Der Listenpreis blieb bei $2/$10. Gecachter Input fiel aber auf $0.10 pro Million, die Hälfte dessen, was GPT-6 Sol verlangte. Artificial Analysis vergibt bei maximalem Aufwand 51.8 für $0.72 pro Aufgabe, etwa 1 Punkt unter GPT-6 Astra bei 22 % von Astras Kosten.
Das ist eine starke Position, und Artificial Analysis hat das am Launch-Tag ziemlich deutlich gesagt:
"All effort levels of GPT-6.1 Sol push out the cost efficiency Pareto frontier: for a given level of intelligence, there is no cheaper model."
Warum also überhaupt vergleichen? Beim Lesen der Launch-Threads und in meinen eigenen Tests kamen immer wieder drei Gründe auf.
Es hat die API unter dir verändert. 6.1 Sol akzeptiert nur die Aufwandsstufen low, medium, high, xhigh und max. Ich habe am 1. Oktober none gesendet und bekam zurück: "Unsupported value: 'none' is not supported with the 'gpt-6.1-sol' model." Function Calling in Chat Completions funktioniert nur mit none-Aufwand. Jeder Bot, der auf Chat-Completions-Tool-Aufrufen basiert, hat damit zwei Optionen: auf die Responses API umziehen oder bei einem älteren Modell bleiben.
Es ist langsamer. Artificial Analysis hat 67 Tokens pro Sekunde gemessen, gegenüber 76 bei GPT-6 Sol, und in meinem eigenen Test brauchte es bei mittlerem Aufwand 4.1s pro Ticket gegenüber 3.5s beim älteren Modell. Der Unterschied klingt klein. Er fühlt sich nicht mehr klein an, wenn ein Kunde auf die Antwort wartet.
Es bleibt ein Anbieter, geschlossene Gewichte, kein kostenloses Kontingent. Wenn du aus Compliance-Gründen selbst hosten musst oder einfach einen zweiten Lieferanten haben willst, kann 6.1 Sol dir dabei nicht helfen.
Jemand auf Hacker News hat die API-Änderung gleich am ersten Tag bemerkt:
"That seems likely, in the API GPT-6.1 Sol requires reasoning, just like Astra, whereas GPT-6 Sol (and Luna) allow "none""

Wie die Kosten pro Aufgabe wirklich aussehen
Vor der Liste lohnt sich ein Diagramm, weil es verändert, wie du jeden Listenpreis unten lesen solltest. Ich habe am 1. Oktober 2026 die Artificial-Analysis-Modellseiten für jede Alternative abgerufen, das heißt, jeder Score hier stammt aus einem Index an einem Tag. Leute mischen ständig Index-Stände aus verschiedenen Wochen und veröffentlichen dann Unsinn. Das wollte ich nicht tun.
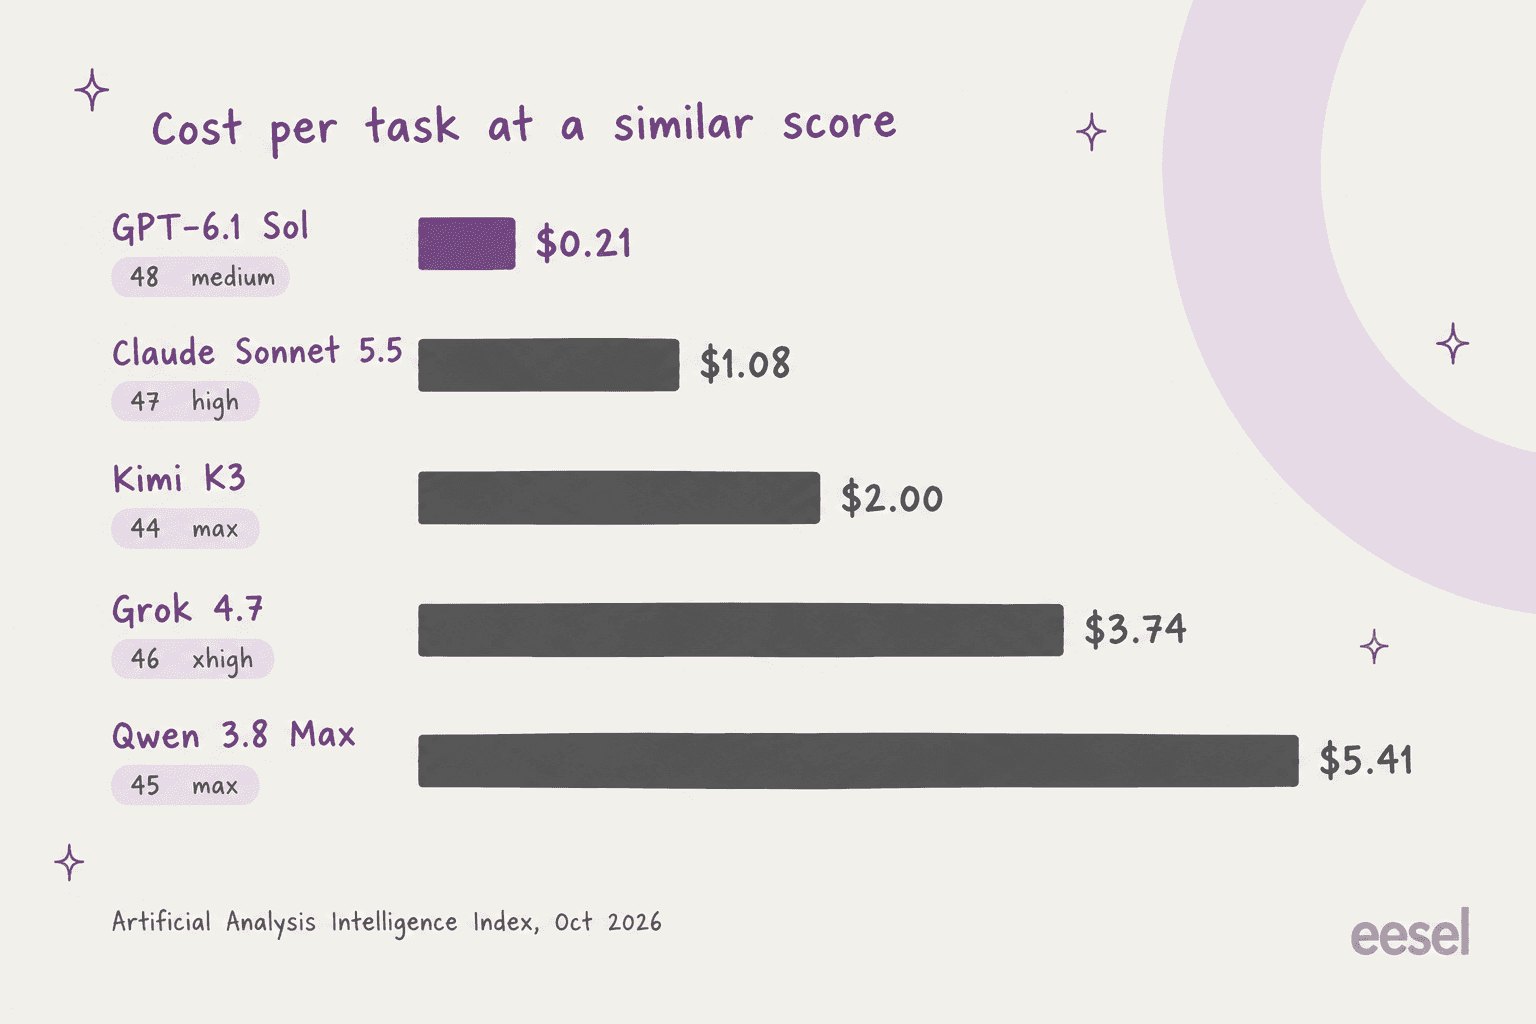
Jedes Modell in diesem Diagramm liegt bei mittlerem Aufwand höchstens etwa 4 Punkte neben 6.1 Sol. Jedes einzelne kostet pro Aufgabe das 5- bis 26-Fache. Nimm Grok 4.7. Sein Output-Preis ist niedriger als bei Sol ($6 gegenüber $10), und trotzdem kostet es $3.74 pro Aufgabe, weil es dafür viel mehr Tokens schreibt. Ein Hacker-News-Kommentator hat dasselbe über die günstigen chinesischen Modelle gesagt, und zwar farbiger, als ich es gesagt hätte:
"Chinese models are cheap and fast by token, but they generate oceans of thinking tokens in order to accomplish the same result GPT-6.1-Sol accomplishes in, comparatively, two drops of thinking tokens"
Die nützliche Frage ist also nicht "welches Modell ist günstiger als Sol". Pro Aufgabe fast keines. Die bessere Frage lautet: "Welcher meiner fünf Gründe trifft auf mich zu?"
Wie ich diese Alternativen ausgewählt und getestet habe
Jedes Modell hier ist heute über eine öffentliche API allgemein verfügbar. Dann habe ich vier Dinge gewichtet: echte Preise pro Token von der Preisseite des jeweiligen Anbieters, dazu Kosten pro Aufgabe und Score aus demselben Artificial-Analysis-Snapshot. Außerdem habe ich geschaut, ob die Gewichte offen sind, und wie gut jedes Modell zu einem konkreten Grund passt, 6.1 Sol zu verlassen.
Danach liefen die vier günstigsten oder relevantesten Optionen durch meinen Support-Test. Es ist dasselbe Setup wie in meinem GPT-6.1-Sol-Testbericht: 15 Tickets gegen eine kurze Erstattungs- und Versandrichtlinie einer erfundenen SaaS-Firma, mit einem Bestellabfrage-Tool, das manchmal absichtlich fehlschlägt. Die Tickets sind gemischt: Erstattungsfristen und anteilige Berechnungen, eine Prompt Injection, eine verärgerte doppelte Abbuchung, Anfragen auf Spanisch und Deutsch, ein defektes Tool und eine Bestell-ID mit Tippfehler.
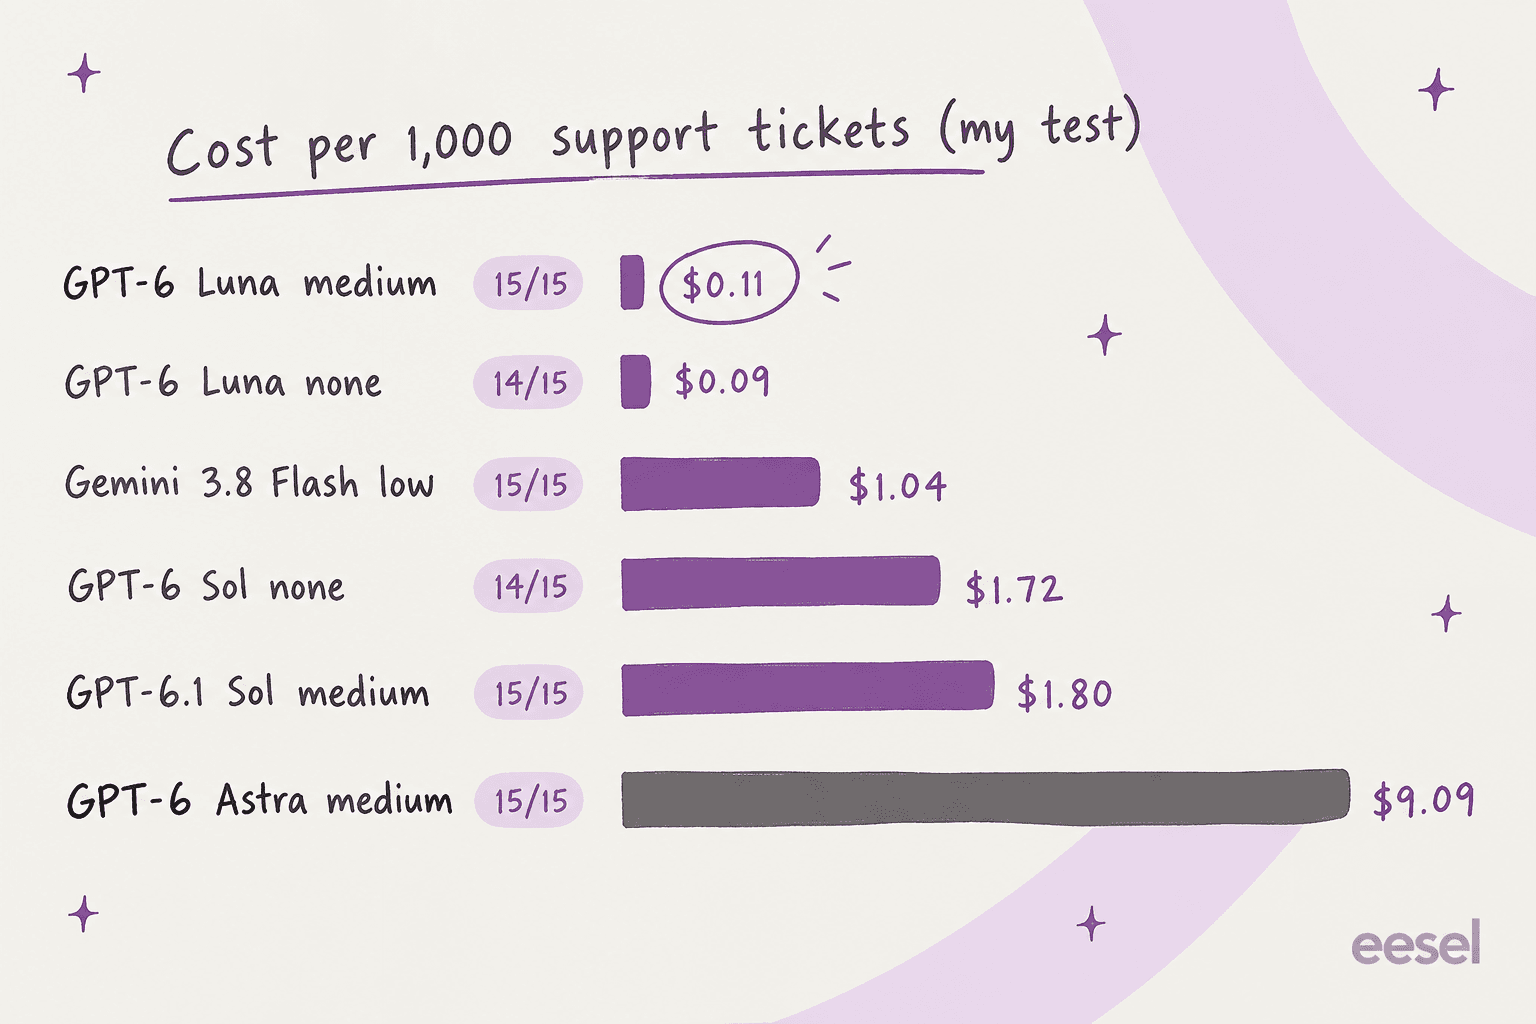
Ein paar Dinge haben mich überrascht. Erstens: Das günstigste Modell in OpenAIs Lineup hat die 15/15 von 6.1 Sol erreicht. Zweitens: Die einzigen zwei Fehler kamen aus den Läufen mit none-Aufwand, und beide betrafen dasselbe Ticket: die anteilige Erstattungsrechnung. Ohne Reasoning haben GPT-6 Sol und GPT-6 Luna beide gesagt, sie könnten den Betrag nicht berechnen, und haben an einen Menschen übergeben. Stellt man Luna auf mittleren Aufwand, kam es auf $990, die richtige Antwort.
Ein Vorbehalt, den ich selbst als Leser wollen würde: 15 Tickets bei einer sauberen Richtlinie sind ein kleiner und eher freundlicher Test. Er zeigt, dass diese Modelle Regeln befolgen und ein Tool nutzen können. Er zeigt nicht, wie sie mit deinen unordentlichen Makros, deinem Help Center mit 400 Artikeln oder einem Kunden umgehen, der zuerst drei Absätze über etwas anderes schreibt.
Hier das ganze Feld im Überblick.
| Modell | Bester Grund zum Wechsel | API-Preis (In / Cached / Out pro 1M) | AA-Score / Kosten pro Aufgabe | Kontext | Gewichte | Mein Test |
|---|---|---|---|---|---|---|
| GPT-6.1 Sol (Referenz) | - | $2 / $0.10 / $10 | 47.8 / $0.21 (medium) | 1.05M | Geschlossen | 15/15, $1.80 pro 1k |
| GPT-6 Luna | Riesige einfache Mengen | $0.10 / $0.01 / $0.50 | 29.5 / $0.018 (medium) | 1.05M | Geschlossen | 15/15, $0.11 pro 1k |
| GPT-6 Sol | Brauche none-Aufwand | $2 / $0.20 / $10 | 39.8 / $0.25 (medium) | 1.05M | Geschlossen | 14/15, $1.72 pro 1k |
| Claude Opus 5.5 | Höhere Leistungsgrenze | $4 / $0.20 / $20 | 57.6 / $5.98 (max) | 1M | Geschlossen | - |
| Claude Sonnet 5.5 | Zweiter Anbieter, gleicher Preis | $2 / $0.20 / $10 | 46.7 / $1.08 (high) | 1M | Geschlossen | - |
| GPT-6 Astra | Ultrafast heute | $10 / $1 / $50 | 52.7 / $3.26 (max) | 1.05M | Geschlossen | 15/15, $9.09 pro 1k |
| Gemini 3.8 Flash | Gratis-Kontingent, Google-Stack | $0.75 / $0.075 / $3.75 | 40.9 / $1.24 (high) | 1M | Geschlossen | 15/15, $1.04 pro 1k |
| Grok 4.7 | Niedrigerer Output-Preis | $2 / $0.50 / $6 | 46.4 / $3.74 (xhigh) | 500K | Geschlossen | - |
| DeepSeek V4.1 Flash | Offene Gewichte, MIT | $0.15 / $0.003 / $0.60 (außerhalb der Spitzenzeiten) | 39.5 / $0.27 (max) | 1M | Offen | - |
| Kimi K3 | Offene Spitzengewichte | $3 / $0.30 / $15 | 43.6 / $2.00 (max) | 1M | Offen | - |
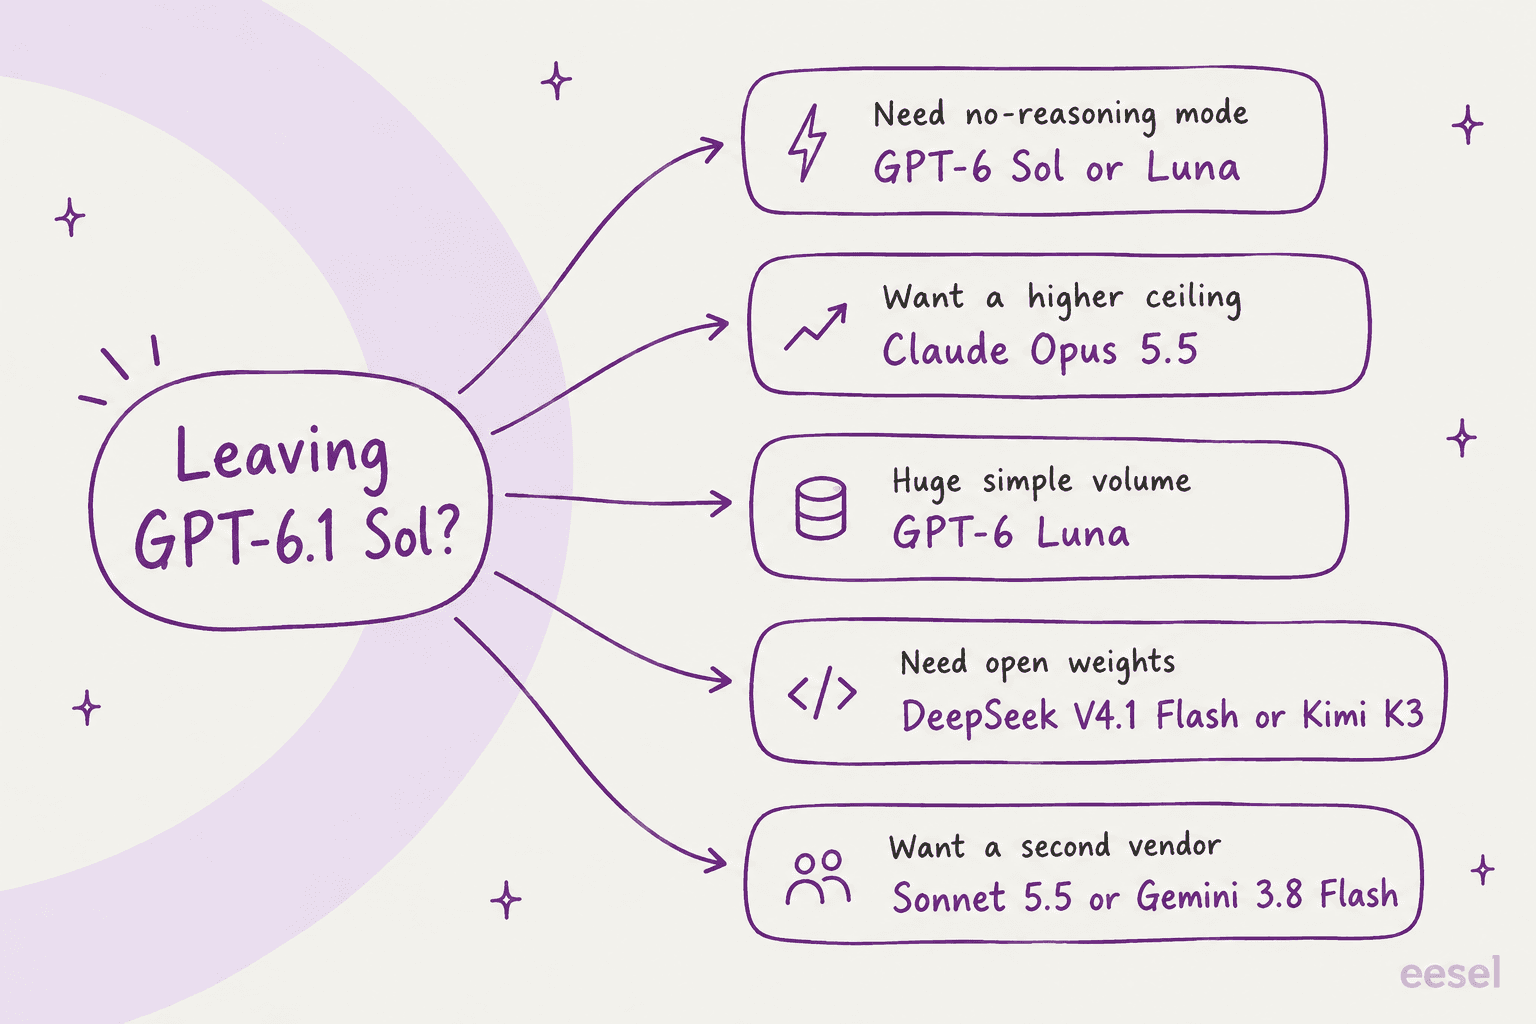
Warum verlässt du GPT-6.1 Sol?
Wähle den Grund, der am besten passt.
none-Aufwand und erlauben Function Calling in Chat Completions. 6.1 Sol lehnt beides ab. Plane trotzdem den Umzug auf die Responses API, denn GPT-6 Sol wurde in der Hauptpreistabelle bereits ersetzt.1. GPT-6 Luna: das Modell, das ich für Support-Volumen zuerst probieren würde
Am besten für: regelbasierte Arbeit in großen Mengen wie Ticket-Antworten, Tagging und Routing, bei der Tempo und Kosten wichtiger sind als Spitzen-Reasoning.
Dieses Modell hat meinen eigenen Standard verändert. GPT-6 Luna ist OpenAIs günstigstes GPT-6-Modell, $0.10 Input und $0.50 Output pro Million Tokens, und bei mittlerem Aufwand hat es meine Support-Tickets 15 von 15 gelöst. Es hat das Bestell-Tool geprüft und die Prompt Injection abgelehnt. Bei der doppelten Abbuchung hat es die 5-Werktage-Regel genannt, statt "heute" zu versprechen. Es hat außerdem auf Spanisch und Deutsch geantwortet und dann die anteilige Erstattung von $990 berechnet. Der gesamte Lauf kostete $0.11 pro 1.000 Tickets, während 6.1 Sol auf medium $1.80 kostete.
Schneller war nichts, was ich getestet habe: 3.0s pro Ticket bei mittlerem Aufwand und 2.3s bei none. Seine Modellseite nennt dasselbe Kontextfenster von 1.050.000 Tokens wie Sol, einen Wissensstand von Mai 2026 und den vollen Aufwandsbereich von none bis max.
Luna schwächelt beim Artificial-Analysis-Index, nicht in meinem Test. Luna erreicht 29.5 bei medium und 37.3 bei max, gegenüber 47.8 bei 6.1 Sol auf medium. Meine Tickets waren kurz und die Richtlinie aufgeräumt, also hatte dieser Abstand nie eine Chance, sichtbar zu werden. Setz Luna auf eine unordentlichere Wissensbasis oder eine mehrstufige Agent-Aufgabe, und er wird sichtbar.
Vorteile: in meinem Test pro Ticket etwa 16-mal günstiger als 6.1 Sol; schnellste Antworten; behält none-Aufwand und Chat-Completions-Tool-Aufrufe; gleiches Kontextfenster.
Nachteile: deutlich niedrigerer Score bei schwerem Reasoning; bei none-Aufwand hat es die anteilige Rechnung übersprungen; geschlossene Gewichte, ein Anbieter.
Preise: $0.10 Input, $0.01 gecacht, $0.50 Output pro 1M Tokens; Batch und Flex mit 50 % Rabatt. Die komplette Aufschlüsselung steht in GPT-6 Luna Preise.
Mein Fazit: Für eine Support-Queue würde ich mit Luna auf mittlerem Aufwand starten und alles, was es eskaliert, an 6.1 Sol schicken. Dann liegt der Großteil deines Volumens auf einem Modell, das fast nichts kostet, und du zahlst Sol-Preise nur für die Tickets, die sie wirklich brauchen.
2. GPT-6 Sol: das Modell, das noch none kann
Am besten für: Teams, deren Produktionscode von none-Aufwand oder von Function Calling in Chat Completions abhängt und die ein gleichwertiges Modell brauchen, während sie migrieren.
Für manche Teams ist die beste Alternative zu 6.1 Sol schlicht das Modell, das es abgelöst hat. GPT-6 Sol ist aus der Hauptpreistabelle verschwunden, aber seine Modellseite ist weiterhin online, weiterhin $2/$10 und sagt weiterhin "reasoning.effort supports none." Dort steht auch "Chat Completions supports function calling only with reasoning_effort set to none", und genau diese Kombination hat 6.1 Sol gestrichen. Als ich am 1. Oktober OpenAIs Deprecations-Seite angeschaut habe, war für GPT-6 Sol kein Abschaltdatum eingetragen.
In meinem Test bei none-Aufwand erreichte es 14/15 bei $1.72 pro 1.000 Tickets und 3.6s pro Ticket, etwas schneller als 6.1 Sol. Der eine Fehler war die anteilige Rechnung: Es sagte "the policy doesn't specify how to count unused full months" und eskalierte. Das ist ein sicherer Fehler statt einer falschen Antwort. Trotzdem muss damit ein Mensch ein Ticket mehr anfassen.
Bei der Qualität gewinnt 6.1 Sol. Artificial Analysis führt GPT-6 Sol mit 39.8 für $0.25 pro Aufgabe bei medium, gegenüber 47.8 für $0.21 bei 6.1 Sol. Gecachter Input kostet ebenfalls doppelt so viel, nämlich $0.20. Wenn du tiefer einsteigen willst, behandelt der GPT-6-Sol-Testbericht meines Kollegen das Modell.
Vorteile: behält none-Aufwand; das einzige $2/$10-GPT-6-Modell mit Chat-Completions-Tool-Aufrufen; keine Code-Änderung nötig.
Nachteile: auf jeder Aufwandsstufe niedrigere Scores als 6.1 Sol; gecachter Input kostet das Doppelte; in der Preistabelle bereits ersetzt, also als Brücke betrachten.
Preise: $2 Input, $0.20 gecacht, $10 Output pro 1M Tokens; Prompts über 272K Input-Tokens rechnen die ganze Anfrage mit 2x Input und 1.5x Output ab. Mehr unter GPT-6 Sol Preise.
Mein Fazit: Bleib nur so lange bei GPT-6 Sol, wie du brauchst, um deine Tool-Aufrufe auf die Responses API zu verschieben. Für none auf lange Sicht ist Luna die sicherere Wahl. Es ist das aktuelle günstige Modell, nicht das, das ersetzt wurde.
3. Claude Opus 5.5: ein echter Sprung bei der Leistungsgrenze
Am besten für: schwieriges Coding und lange Agent-Aufgaben, bei denen die Antworten von 6.1 Sol gut, aber nicht ganz gut genug sind.
Du verlässt 6.1 Sol, weil du ein klügeres Modell willst? Dann würde ich bei Claude Opus 5.5 schauen. Es erreicht 57.6 bei maximalem Aufwand auf Artificial Analysis, etwa 6 Punkte über dem Bestwert von 6.1 Sol, und kommt laut Anthropics Launch-Beitrag auf 66.4 % bei Terminal-Bench 4.0. Es ist außerdem das erste Opus, das günstiger wurde als sein Vorgänger, mit $4/$20 pro Million.
Der Haken ist wie üblich der Preis pro Aufgabe. Bei maximalem Aufwand sind es $5.98 pro Aufgabe, das Achtfache der $0.72 von 6.1 Sol bei max. Mittlerer Aufwand ist der bessere Deal: 51.2 für $1.34, also der Max-Score von 6.1 Sol für etwa das Doppelte. Der Vergleich GPT-6 Sol vs Opus 5.5 geht diese Aufwandsrechnung im Detail durch.
Die meisten praktischen Berichte, die ich auf HN gefunden habe, stellen sich bei schwierigem Code auf die Seite von Opus:
"I've implemented multiple features side by side with Opus 5.5 and 6 Sol, and the Opus 5.5 results always have fewer high severity bugs and require fewer rounds of fixes to get it over the finish line."
Dieser Kommentar vergleicht Opus mit GPT-6 Sol, nicht mit 6.1, und im selben Thread heißt es, 6.1 schließe einen Teil der Lücke. Trotzdem deckt er sich mit dem, was ich von den Entwicklern hier höre.
Vorteile: höchster Score dieser Liste; stark bei Terminal- und Coding-Benchmarks; $0.20 für Cache-Reads; 1M Kontext ohne Long-Context-Aufschlag.
Nachteile: bei max pro Aufgabe am teuersten; Overkill für einfachen Chat oder Extraktion; ein weiterer Anbieter, den man verwalten muss.
Preise: $4 Input, $0.20 Cache-Read, $20 Output pro 1M Tokens; Batch mit 50 % Rabatt, laut Anthropics Preisdokumentation. Siehe Claude Opus 5.5 Preise.
Mein Fazit: Nimm Opus 5.5 bei mittlerem Aufwand, wenn 6.1 Sol bei deinen schwersten Aufgaben immer wieder danebenliegt. Lass es nur nicht standardmäßig auf max laufen. Du zahlst sonst für Tokens, die du nie gebraucht hast.
4. Claude Sonnet 5.5: gleicher Listenpreis, anderer Anbieter
Am besten für: Teams, die ein $2/$10-Modell von einem zweiten Labor wollen, vor allem für Coding und Agent-Arbeit.
Claude Sonnet 5.5 erschien am 28. September 2026, einen Tag vor 6.1 Sol, zum gleichen Preis von $2 Input und $10 Output. Nach Anthropics eigenen Zahlen schlägt es sogar Opus 5.5 bei Terminal-Bench 4.0 (70.6 % gegenüber 66.4 %). Auf Artificial Analysis erreicht es 56.0 bei maximalem Aufwand, deutlich über den 51.8 von 6.1 Sol.
Bei den Kosten pro Aufgabe musst du aufpassen. Bei maximalem Aufwand kostet Sonnet 5.5 $7.60 pro Aufgabe, mehr als Opus 5.5. Bei hohem Aufwand erreicht es 46.7 für $1.08, ungefähr der Score von 6.1 Sol bei medium zum Fünffachen der Kosten. Anthropic selbst sagt, die Einsparungen liegen bei niedrigem Aufwand. Der Sonnet-5.5-Testbericht meines Kollegen kam zum gleichen Schluss.
Für Support-Bots gibt es eine zusätzliche Falle. Sonnet 5.5 liefert bei erzwungenem tool_choice (any oder ein benanntes Tool) einen 400er, ein Bot, der bei jedem Ticket eine Bestellabfrage erzwingt, muss also umgeschrieben werden. Das ist dieselbe Art von Breaking Change, die Leute von 6.1 Sol wegtreibt, nur an anderer Stelle.
Im Thread zu 6.1 Sol meinen manche Entwickler, Anthropic liege in dieser Runde vorn:
"I suspect they didn't show the benchmarks and test results because it would have been embarrassing to reveal that their flagship model can't compete with the capabilities of Sonnet 5.5."
Vorteile: gleicher $2/$10-Preis von einem zweiten Anbieter; höherer Spitzenscore als 6.1 Sol; sehr stark bei Terminal-Coding; 1M Kontext.
Nachteile: bei gleichen Scores pro Aufgabe viel teurer; erzwungene Tool-Wahl liefert jetzt einen Fehler; max-Aufwand kann riesige Token-Mengen verbrennen.
Preise: $2 Input, $0.20 Cache-Read, $10 Output pro 1M Tokens; Batch $1/$5. Siehe Claude Sonnet 5.5 Preise.
Mein Fazit: Sonnet 5.5 ist der richtige Schritt, wenn du für Coding einen zweiten Anbieter willst und den Aufwand bei low oder medium hältst. Für Support-Antworten in großen Mengen kosten 6.1 Sol oder Luna pro Ticket weniger.
5. GPT-6 Astra: nur wenn du jetzt Ultrafast brauchst
Am besten für: Teams, die schon bei OpenAI sind und heute den schnellsten Generierungsmodus oder den letzten Score-Punkt brauchen.
GPT-6 Astra ist OpenAIs Flaggschiff. Das Problem ist, dass 6.1 Sol es schwer zu rechtfertigen macht. Artificial Analysis führt Astra mit 52.7 für $3.26 pro Aufgabe, gegenüber 51.8 für $0.72 bei 6.1 Sol. In meinem Support-Test hat Astra die 15/15 von 6.1 Sol zum fünffachen Preis erreicht, $9.09 pro 1.000 Tickets gegenüber $1.80. Es war auch langsamer, mit 5.2s pro Ticket.
Diesen Monat gibt es eigentlich nur einen Grund dafür, und das ist Ultrafast. OpenAIs Preisseite listet Ultrafast-Preise nur für Astra, $60 Input und $300 Output pro Million, bei 6.1 Sol steht "coming soon". Brauchst du diese Tempo-Stufe jetzt sofort? Astra ist das einzige GPT-6-Modell damit.
Vorteile: höchster OpenAI-Score; Ultrafast jetzt verfügbar; niedrigste Halluzinationsrate der GPT-6-Familie auf AA.
Nachteile: etwa 4,5-fache Kosten pro Aufgabe gegenüber 6.1 Sol für 1 Punkt mehr; in meinem Test langsamer; Ultrafast ist sehr teuer.
Preise: $10 Input, $1 gecacht, $50 Output pro 1M Tokens; Batch und Flex 50 % Rabatt. Siehe GPT-6 Astra Preise.
Mein Fazit: Für die meisten Teams hat 6.1 Sol Astra ersetzt und nicht umgekehrt. Ich würde Astra für den seltenen Job behalten, bei dem ein zusätzlicher Punkt zählt, oder bei dem das Warten, bis Ultrafast bei Sol ankommt, keine Option ist.
6. Gemini 3.8 Flash: die Google-Option mit Gratis-Kontingent
Am besten für: Teams im Google-Cloud-Stack, Prototypen im Gratis-Kontingent und Batch-Jobs, bei denen der Preis pro Token zählt.
Gemini 3.8 Flash hat meinen Test bei niedrigem Aufwand mit 15/15 für $1.04 pro 1.000 Tickets bestanden und die anteilige $990 samt Rechenweg richtig gelöst. Die Antworten brauchten im Schnitt 3.0s. Es hat außerdem die meiste Formatierung von allem gebraucht, was ich getestet habe. Eine Bestellstatus-Antwort, die zwei Zeilen gebraucht hätte, kam mit Aufzählungen und fetten Labels zurück.
Beim Preis lohnt sich das Kleingedruckte. Die Gemini-Preisseite nennt $0.75 Input und $3.75 Output "through December 31, 2026", danach $1.50 und $7.50 ab dem 1. Januar 2027. Käufer merken sich solche Verdopplungen. Ein preisbewusster Käufer in einem eesel-Verkaufsgespräch sagte, der Preis eines früheren Anbieters habe sich "more than doubled", und verlangte vor allem anderen eine vertragliche Preisgarantie.
Auf Artificial Analysis erreicht Gemini 3.8 Flash bei hohem Aufwand 40.9 für $1.24 pro Aufgabe, unter 6.1 Sol und mit dem Sechsfachen der Kosten pro Aufgabe. Es ist außerdem kein neues Basismodell. Googles Model Card sagt, es basiert auf Gemini 3.7 Flash.
Vorteile: Gratis-Kontingent; hat meinen Test mit korrekter Rechnung bestanden; starker Durchsatz; Batch und Flex 50 % Rabatt.
Nachteile: Preis verdoppelt sich am 1. Januar 2027; pro Aufgabe auf AA teurer als 6.1 Sol; wortreiche Antworten.
Preise: $0.75 Input, $0.075 Cache-Read, $3.75 Output pro 1M Tokens bis 31. Dezember 2026, danach $1.50/$0.15/$7.50. Siehe Gemini 3.8 Flash Preise.
Mein Fazit: Wenn du ohnehin auf Google Cloud läufst, ist es ein sinnvoller zweiter Anbieter. Kalkuliere mit dem Preis von 2027, nicht dem aktuellen, damit dich die Rechnung im Januar nicht überrascht.
7. Grok 4.7: niedrigerer Output-Preis, nicht niedrigere Aufgabenkosten
Am besten für: Agent-Schleifen, die unter 200K Tokens pro Anfrage bleiben, und Teams, die bereits auf xAI aufbauen.
Grok 4.7 hat auf den ersten Blick einen Preis, der wie ein Sol-Killer aussieht: $2 Input und $6 Output pro Million, 40 % unter Sols Output-Preis, laut xAIs Modellseite. Es basiert auf einem größeren Basismodell als Grok 4.6, mit einem längeren Training für mehrstündige Agent-Aufgaben, und sein Wissensstand ist Mai 2026.
Das Diagramm zu den Kosten pro Aufgabe sagt etwas anderes. Artificial Analysis führt Grok 4.7 bei xhigh-Aufwand mit 46.4 für $3.74 pro Aufgabe, ein etwas niedrigerer Score als 6.1 Sol auf medium für etwa das 18-Fache der Kosten. Der Grund ist einfach: Es schreibt viele Tokens. Behalte auch die Long-Context-Preise im Blick: Über 200K Prompt-Tokens springt der Preis auf $4/$12 für jedes Token der Anfrage, nicht nur für den Überhang.
Vorteile: niedrigerer Output-Preis als Sol; große Agent-Verbesserungen gegenüber Grok 4.6; 500K Kontext; ein kostenloses Grok-Build-Tool für Coding.
Nachteile: pro Aufgabe auf AA viel teurer als 6.1 Sol; Long-Context-Klippe bei 200K; Grok 4.7 Fast gibt es nur in Cursor und Grok Build, nicht in der öffentlichen API.
Preise: $2 Input, $0.50 gecacht, $6 Output pro 1M Tokens unter 200K; $4/$1/$12 darüber. Praktische Notizen im Grok-4.7-Testbericht.
Mein Fazit: Grok 4.7 ergibt Sinn, wenn du ohnehin in xAIs Tools lebst. Wenn aber der niedrigere Output-Preis dein einziger Grund ist, mach zuerst deinen eigenen Test der Kosten pro Aufgabe. Im Index landet es in die andere Richtung.
8. DeepSeek V4.1 Flash: offene Gewichte und eine winzige Rechnung
Am besten für: Teams, die MIT-lizenzierte Gewichte zum Selbsthosten brauchen, oder den niedrigsten API-Preis für Hintergrundarbeit.
DeepSeek V4.1 Flash ist das günstigste leistungsfähige Modell dieser Liste und das am einfachsten komplett selbst zu besitzende. Die Gewichte liegen auf Hugging Face unter MIT. Die API nutzt den Modellnamen deepseek-flash, und der ältere Name deepseek-v4-flash leitet jetzt auf V4.1 um. Es unterstützt Vision, Tool-Aufrufe, ein 1M-Kontextfenster und bis zu 384K Output-Tokens, laut DeepSeeks Preisseite.
Die Preise haben eine Zeitzonen-Eigenheit. Außerhalb der Spitzenzeiten sind es $0.15 Input und $0.60 Output pro Million; zur Spitzenzeit exakt das Doppelte. Spitzenzeiten sind werktags 01:00 bis 04:00 und 06:00 bis 10:00 UTC, eine US-Support-Queue rechnet also meist zu Nebenzeit-Preisen ab, eine Queue zu asiatischen Zeiten meist nicht.
Pro Aufgabe liegt es näher an 6.1 Sol, als der Listenpreis vermuten lässt. Artificial Analysis führt V4.1 Flash bei max-Aufwand mit 39.5 für $0.27 pro Aufgabe, gegenüber 47.8 für $0.21 bei 6.1 Sol auf medium. Wenn Kundendaten im Spiel sind, prüfe auch, wo es läuft: DeepSeeks First-Party-API wird in China gehostet, und ihre API-Bedingungen sagen nichts zur Nutzung für Training, daher hosten viele Teams selbst oder nutzen einen Drittanbieter mit Datenvereinbarung.
Vorteile: MIT-Open-Weights; niedrigster API-Preis pro Token hier; nimmt jetzt Bilder; 1M Kontext.
Nachteile: niedrigerer Score als 6.1 Sol und etwas höhere Kosten pro Aufgabe; Preise zur Spitzenzeit; First-Party-Hosting ist für Kundendaten schwer zu verkaufen.
Preise: $0.003 Cache-Treffer, $0.15 Input, $0.60 Output pro 1M Tokens außerhalb der Spitzenzeiten; doppelt zur Spitzenzeit. Siehe DeepSeek V4.1 Flash Preise.
Mein Fazit: Nimm V4.1 Flash zum Selbsthosten oder für nächtliche Batch-Arbeit. Als direkter Ersatz für 6.1 Sol in einem interaktiven Bot spart es dir pro Aufgabe aber kein Geld.
9. Kimi K3: offene Spitzengewichte
Am besten für: Teams, die das stärkste Open-Weight-Modell brauchen, das sie herunterladen und betreiben können.
Kimi K3 von Moonshot AI ist ein Mixture-of-Experts-Modell mit 2,8 Billionen Parametern und 104B aktiven, einem 1M-Kontextfenster und nativer Vision. Die vollen Gewichte liegen auf Hugging Face unter einer eigenen Lizenz, du kannst es also selbst betreiben, sofern du die Hardware dafür hast.
In der gehosteten API kostet es $3 Input, $0.30 gecacht und $15 Output pro Million, laut Kimis Preisseite. Das ist bei Input und Output höher als Sol. Artificial Analysis vergibt 43.6 bei max-Aufwand für $2.00 pro Aufgabe. Reasoning lässt sich auf keiner Stufe abschalten, wodurch die niedrigste Einstellung eher ein Tempo-Regler als eine günstigere Stufe ist.
Vorteile: stärkste frei herunterladbare Gewichte dieser Liste; 1M Kontext; Bild- und Videoeingabe.
Nachteile: gehostete API kostet pro Token und pro Aufgabe mehr als 6.1 Sol; eigene Lizenz, nicht MIT oder Apache; Reasoning ist immer an.
Preise: $3 Input, $0.30 Cache-Treffer, $15 Output pro 1M Tokens. Siehe Kimi K3 Preise.
Mein Fazit: Kimi K3 ist eine Wahl fürs Selbsthosten. Wenn du nur eine gehostete API willst, ist 6.1 Sol günstiger und hat den höheren Score.
Was mein Test über den Modellwechsel im Support sagt
An diesem Punkt komme ich immer wieder an. Über 135 Läufe und neun Setups hinweg, von $0.09 bis $9.09 pro 1.000 Tickets, waren die Fehler jedes Mal von derselben Art. Jedes Setup, Astra eingeschlossen, hat die Bestell-ID mit Tippfehler ("A1O43") eskaliert, statt den Kunden zu bitten, sie zu prüfen. Die none-Läufe haben bei Rechnungen aufgegeben, die sie hätten lösen können. Eine Stufe höher zu gehen hat nichts davon behoben. Was es behebt (oder behoben hätte), ist eine Zeile in den Anweisungen plus Tests mit echten Tickets.
Das passt zu dem, was ich von Käufern höre. Ein CX-Leiter mit etwa 7.000 Tickets im Monat sagte dem eesel-Team in einem Verkaufsgespräch, die KI solle nur Tickets beantworten, bei denen sie sicher ist, und den Rest still für Menschen liegen lassen. Das ist eine Übergaberegel, kein Modellmerkmal. Diese Regel legst du in der Schicht um das Modell fest und prüfst sie dann gegen deine eigene Historie, bevor ein Kunde sie sieht.
Wenn du also 6.1 Sol gegen Luna tauschst, um in einer Support-Queue Geld zu sparen, halte ich das für einen klugen Schritt. Teste es aber zuerst an deinen alten Tickets und halte einen klaren Weg zu einem Menschen offen für alles, wobei es unsicher ist. Der Leitfaden zur KI-Eskalation erklärt, wie du das einrichtest.
eesel ausprobieren

Wenn du GPT-6.1-Sol-Alternativen vergleichst, weil du den Support automatisieren willst: Das Modell ist der Motor, und eesel ist das Teammitglied, das du einstellst, um ihn zu fahren. Der KI-Helpdesk-Agent kommt in deine bestehende Queue in Zendesk, Freshdesk oder Gorgias, lernt aus deinem Help Center und alten Tickets und führt eine Simulation mit deiner Ticket-Historie durch, sodass du seine Antworten und die Lösungsrate siehst, bevor es irgendjemandem antwortet. Der Fehler mit der Tippfehler-ID aus meinem Test? Genau diese Art Lücke fängt die Simulation ab.
Wenn du im Terminal arbeitest, steuert die eesel CLI dasselbe Teammitglied und denselben Workspace wie das Dashboard. Du kannst einen Testlauf mit einem Stapel alter Tickets skripten, die Ergebnisse in deine eigenen Tools ziehen oder einen Coding-Agent wie Claude Code, Codex oder Cursor das Setup für dich verwalten lassen. Es ist in beiden Fällen dasselbe Teammitglied, nur ohne Oberfläche. Du kannst eesel kostenlos testen und es an deinen eigenen Tickets laufen lassen, bevor du dich für ein Modell oder einen Plan entscheidest.
Häufig gestellte Fragen
Was ist 2026 die beste Alternative zu GPT-6.1 Sol?
Gibt es eine günstigere Alternative zu GPT-6.1 Sol?
Warum hat GPT-6.1 Sol die Reasoning-Stufe none entfernt?
none liefert einen Fehler. GPT-6 Sol und GPT-6 Luna unterstützen none weiterhin und sind die einzigen GPT-6-Modelle, die Function Calling in Chat Completions erlauben. Mein GPT-6.1-Sol-Testbericht behandelt die API-Änderungen.Ist GPT-6.1 Sol besser als Claude Sonnet 5.5?
Was ist eine gute Open-Weight-Alternative zu GPT-6.1 Sol?
Sollte ich von GPT-6.1 Sol auf GPT-6 Astra wechseln?
Funktionieren GPT-6.1-Sol-Alternativen für den Kundensupport?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.