

Was ist Cactus Whistle?
Whistle ist ein Spracherkennungsmodell von Cactus Compute, einem Startup aus San Francisco aus dem Sommer-2025-Batch von Y Combinator mit einem Team von 8 Personen. Cactus wird von CEO Roman Shemet und CTO Henry Ndubuaku geleitet, und das ganze Angebot ist KI für Geräte ohne GPU: Budget-Smartphones, Uhren, Brillen, Roboter, Autos und Boards in der Klasse von Mikrocontrollern.
Whistle ist die Sprachhälfte dieser Wette und ein gutes Beispiel dafür, wie weit kleine Sprachmodelle gekommen sind. Es erschien am 2. Oktober 2026, und der Launch-Thread auf Hacker News erreichte am 8. Oktober 549 Punkte und 121 Kommentare, weshalb es plötzlich überall auftaucht. Die Modellkarte auf Hugging Face zeigt 2.594 Downloads im ersten Monat und eine Apache-2.0-Lizenz.
Ich baue Integrationen und APIs für eesel, deshalb frage ich bei jeder Modellankündigung zuerst: Was bekommt der Entwickler bei einem Aufruf tatsächlich zurück? Bei Whistle ist die Antwort erfreulich konkret, also fangen wir damit an.
Was macht Whistle eigentlich?
Cactus nennt drei Aufgaben, alle direkt auf dem Gerät erledigt:
- Transkription. Mono-Audio mit 16 kHz, bis zu 30 Sekunden in einem Durchgang, auf Englisch, Deutsch, Französisch, Spanisch, Italienisch, Niederländisch und Polnisch. Die Sprache wird erkannt, sofern du sie nicht angibst.
- Wort-Zeitstempel. Jedes Wort mit Start, Ende und Wahrscheinlichkeit, sodass eine App Wörter hervorheben, anspringen oder ausschneiden kann.
- Sprach-Embedding. Die rohe Encoder-Ausgabe, eine Zeile pro 80 ms Audio, für Abgleich und Suche ganz ohne Transkript.
Zwei kleinere Funktionen sind wichtiger, als sie klingen. Mit Keyword Biasing übergibst du die Namen, die deine Nutzer tatsächlich sagen („Siobhan“, „Krzysztof“, deine Produktnamen), und die Suche wird in ihre Richtung gelenkt. Und Stille ergibt ein leeres Transkript statt eines erfundenen Satzes, ein direkter Seitenhieb auf eine Eigenart, für die Modelle im Whisper-Stil bekannt sind.
Diese letzte Behauptung wurde öffentlich getestet. Ein Hacker-News-Nutzer ließ Whistle über eine TV-Folge laufen und berichtete:
„Habe es an einer zufälligen TV-Folge ausprobiert, und es bleibt manchmal hängen und gibt als Standard nur ‚Thank you.' aus – an einer Stelle 60 Sekunden lang für Dialog.“

Stille wird also behandelt, aber lange, chaotische Audios, die nicht in Whistles 30-Sekunden-Fenster passen, können trotzdem Füllsätze erzeugen. Behalte das bei den Benchmarks im Hinterkopf.
Wie funktioniert Whistle unter der Haube?
Die Kurzfassung: Whistle ist ein Audio-Front-End, das an das bestehende Textmodell von Cactus, Needle, angeschlossen ist und fast alles mit ihm teilt. Needle ist das winzige Tool-Calling-Modell, das Cactus bekannt gemacht hat (der Launch im Mai auf Hacker News hieß „We Distilled Gemini Tool Calling into a 26M Model“). Needle 3 braucht je nach Tiefe jetzt 8 bis 29 MB.
Laut dem Launch-Beitrag läuft die Pipeline so ab:
- Audio wird zu 80 Log-Mel-Bins mit 10 ms Hop, 30 Sekunden entsprechen also 3.000 Frames.
- Ein Convolutional Stem reduziert das auf 375 Frames, einer pro 80 ms.
- Ein Encoder mit 8 Blöcken liest alle Frames auf einmal (er ist nicht kausal, ein Wort bei Sekunde 12 kann also ein Wort bei Sekunde 3 beeinflussen).
- Ein Decoder in Needle-Bauweise liest den Encoder in jeder Schicht über eine gated Cross-Attention, und 5 Beams wählen das Transkript aus.
Den Ingenieurtrick mag ich am meisten: Die Keys und Values des Encoders werden einmal pro Clip berechnet und von allen Beams geteilt, sodass fünf Beams fünf kurze Text-Caches kosten, nicht fünf Durchläufe über das Audio. Der Decoder ist außerdem „gestaffelt“ (laddered): Jede Tiefe ab 2 Schichten wurde als eigenes Modell trainiert, und du wählst beim Laden mit --audio-depth eine aus.
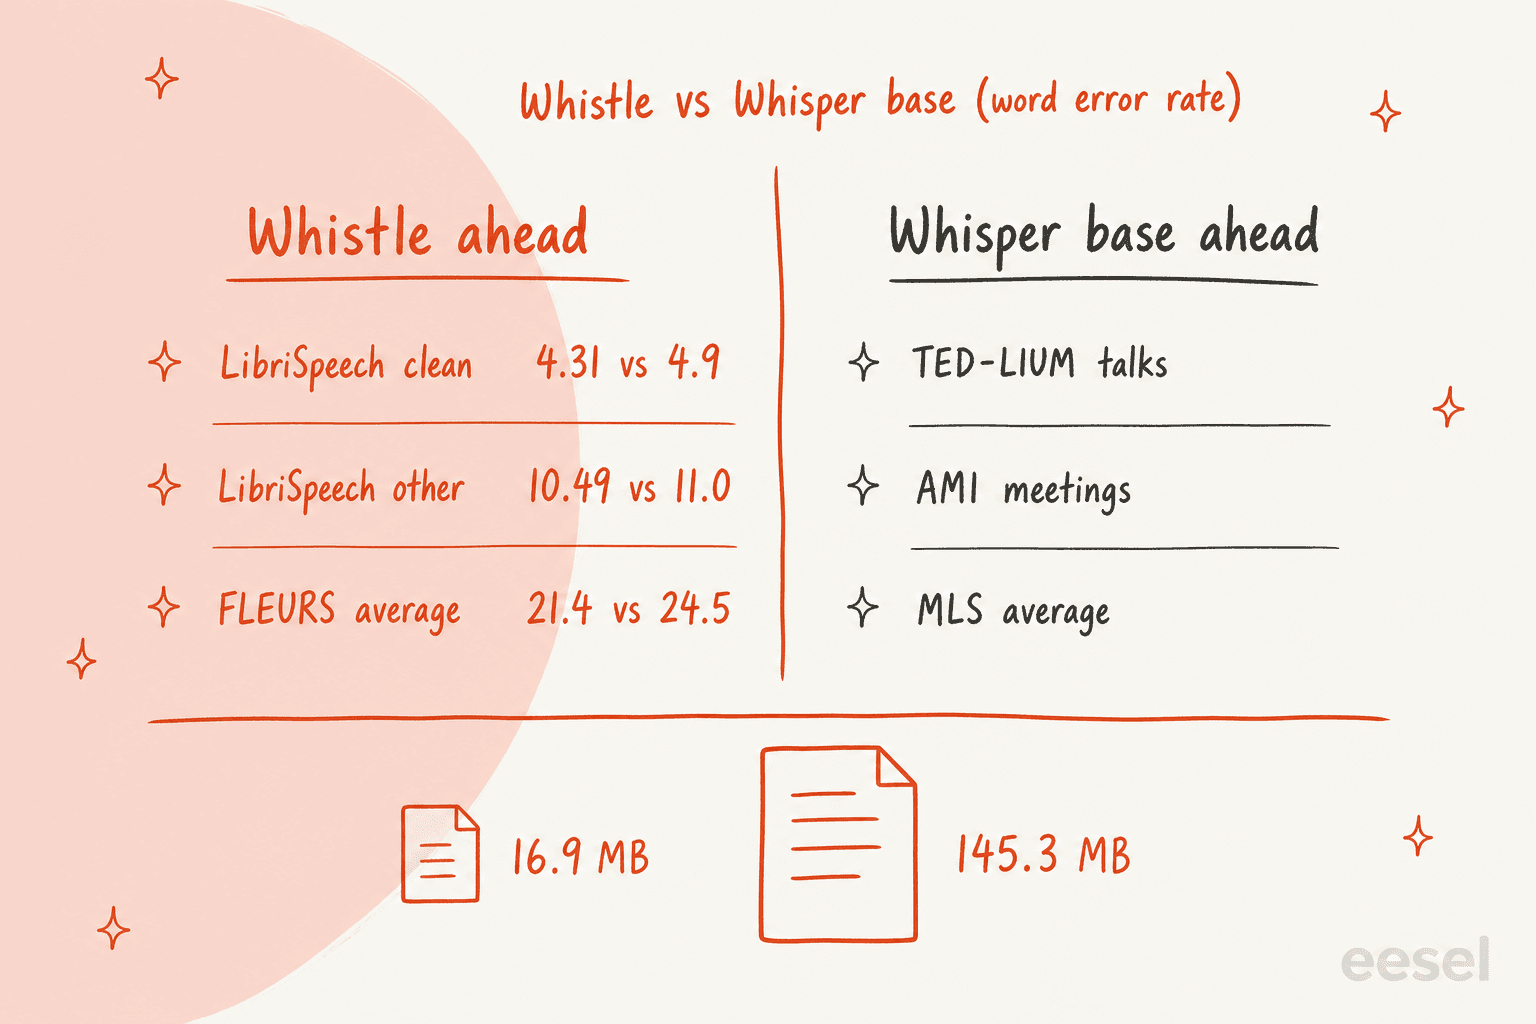
Diese gemeinsame Engine ist das eigentliche Produkt. Lade beide Modelle in dieselbe Binärdatei, und ein Aufruf nimmt Audio entgegen und gibt einen Funktionsaufruf zurück. Das ist genau das Beispiel aus dem Beitrag von Cactus:
needle --model needle3.cact --model whistle.cact --tools tools.json --audio clip.wav
{"function_calls":[{"name":"set_lights","arguments":{"room":"kitchen","on":false}}],
 "confidence":0.94,
 "audio_text":"turn off the kitchen lights",
 "audio_language":"en"}
Kein Transkript berührt je deinen App-Code. Wenn du schon einmal Realtime-Tool-Calls gegen eine Cloud-API verdrahtet hast, fällt dir auf, was hier fehlt: der Netzwerk-Roundtrip, der API-Schlüssel und die Rechnung.
Whistle-Benchmarks gegen Whisper base und Moonshine
Cactus vergleicht Whistle mit zwei Modellen: Whisper base von OpenAI (der mehrsprachige Checkpoint, 145,3 MB) und Moonshine tiny v2 (41,9 MB). Die Wortfehlerrate (WER) ist der Anteil der Wörter, die das Modell falsch erkennt, niedriger ist also besser.
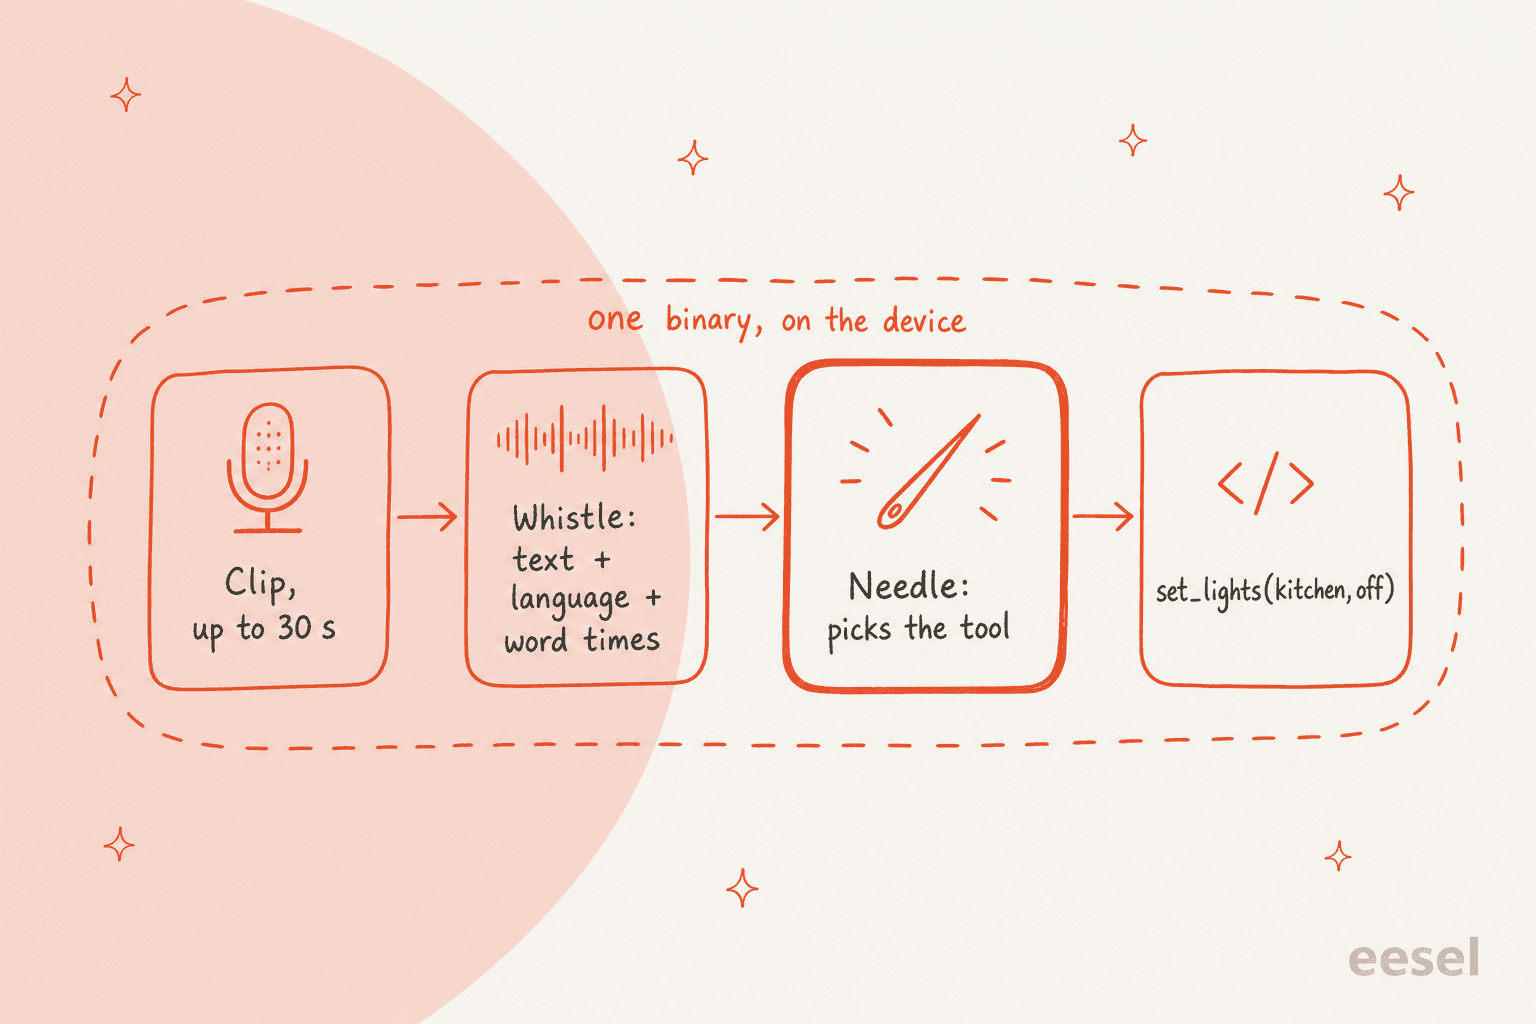
Hier das vollständige Bild der Wortfehlerrate, mit den Whistle-Werten aus der Modellkarte und den Whisper-base-Werten, die Cactus in seinem Launch-Thread auf X genannt hat:
| Benchmark | Was für Audio es ist | Whistle WER | Whisper base WER | Wer liegt vorn |
|---|---|---|---|---|
| LibriSpeech test-clean | Saubere Hörbuch-Lesung | 4,31 % | 4,9 % | Whistle |
| LibriSpeech test-other | Schwierigere Hörbuch-Lesung | 10,49 % | 11,0 % | Whistle |
| SPGISpeech | Finanz-Calls | 7,65 % | Nicht veröffentlicht | Whistle (vs. Moonshine) |
| Earnings-22 | Earnings Calls, Akzente | 19,01 % | Nicht veröffentlicht | Whistle (vs. Moonshine) |
| FLEURS (Ø über 7 Sprachen) | Vorgelesene Sätze, viele Sprachen | 21,4 % | 24,5 % | Whistle |
| TED-LIUM | Aufgezeichnete Vorträge | 7,61 % | Niedriger | Whisper base |
| AMI | Meeting-Aufnahmen | 26,07 % | Niedriger | Whisper base |
| MLS (Ø über 6 Sprachen) | Hörbücher, nicht Englisch | 24,9 % | Niedriger | Whisper base |
Der Launch-Beitrag benennt die Aufteilung klar, und das respektiere ich. Liest man die Tabelle nach Audiotyp, fällt ein Muster auf: Whistle ist bei sauberer Vorlesesprache mit einem Sprecher am stärksten und bei Meetings am schwächsten, wo Leute durcheinanderreden. Eine Fehlerrate von 26 % bei AMI heißt: etwa jedes vierte Wort ist falsch.
Bei Geschwindigkeit und Größe sieht es anders aus, und hier läuft Whistle allen davon. Zehn Sekunden Audio auf einer CPU des Apple M4 Pro:
| Whistle | Whisper base | Moonshine tiny v2 | |
|---|---|---|---|
| Dateigröße | 16,9 MB | 145,3 MB | 41,9 MB |
| Zeit bis zum ersten Token | 11,1 ms | 73,2 ms | 22,8 ms |
| Dekodiergeschwindigkeit | 1.319 Tokens/s | 266 Tokens/s | 262 Tokens/s |
| Präzision | 2 bis 4 Bit | fp32 | int8 |
Die Schlagzeile von Cactus lautet „9x weniger Dateigröße und 6x Geschwindigkeit“. Ich habe nachgerechnet: Der Größenunterschied beträgt das 8,6-Fache, der Unterschied bei der Zeit bis zum ersten Token das 6,6-Fache und beim Dekodieren etwa das 5-Fache. Faire Rundung. Whistles Zeit bis zum ersten Token wächst außerdem mit dem Clip, von 5,9 ms bei 5 Sekunden bis 36,3 ms bei 30, während Whisper alles auf 30 Sekunden auffüllt. Der Abstand ist also bei den kurzen Clips am größten, für die Whistle gebaut ist.
Einen Vergleich zieht Cactus nicht: die größeren offenen Modelle, die Leute tatsächlich auf Laptops betreiben. Auf Hacker News fragten Nutzer immer wieder nach NVIDIAs Parakeet, und die nützlichste Antwort fasste den Kompromiss gut zusammen:
„Es ist vielleicht nicht so gut wie Parakeet, aber man kommt damit zu 80 % ans Ziel.“
Was sagen Leute, nachdem sie Whistle ausprobiert haben?
Der Hacker-News-Thread ist der bisher beste Praxistest, weil Cactus auf der Launch-Seite eine Browser-Sandbox bereitgestellt hat und Hunderte Leute hineingesprochen haben. Die Reaktionen teilen sich genau entlang der Linien, die die Benchmarks vorhersagen.
Klares Englisch, kurze Sätze, Fachbegriffe: Da waren die Leute beeindruckt. Ein Entwickler stellte fest, dass es die Diktierfunktion seines eigenen Handys bei Fachjargon schlug:
„Das funktioniert viel besser als die Spracherkennung in iOS, wenn man Fachbegriffe verwendet.“
Natürliche Sprache in den anderen sechs Sprachen schnitt schlechter ab. Ein Spanischsprecher aus Madrid schrieb, es funktioniere nur beim langsamen Diktieren:
„Wenn ich einen natürlicheren, gesprächigen Rhythmus verwende (ohne Slang, ohne Abkürzungen ...), verwechselt es leicht Wörter.“
Ein polnischer Tester sagte ungefähr dasselbe, und ein weiterer Kommentator wies auf etwas hin, das die Demo nicht zeigt: Streaming-Ausgabe, während man noch spricht, worauf die meisten Live-Diktier-Apps setzen. Ein konkurrierendes Team holte auf Reddit ebenfalls aus und behauptete in seinem eigenen Benchmark, Whistle plus Needle erreiche aus roher Sprache nur 20,7 % Tool-Genauigkeit. Das ist der Test eines Rivalen, gewichte ihn also entsprechend, aber er weist in dieselbe Richtung wie alles andere hier.
Auf der Entwicklerseite hatte schon ein Entwickler Whistle innerhalb weniger Tage nach dem Launch in ein Speech-to-Text-Plugin für DeepSeek Harness eingebaut.
Die eigentliche Lehre: Das Vokabular eingrenzen
Der nützlichste Kommentar im ganzen Thread kam von jemandem, der Whistle bereits produktiv eingesetzt hatte. Er nutzte es, um einen Amazon Echo Show von Amazons Cloud abzukoppeln, und ersetzte den Standard-Sprachassistenten durch eine Hausautomation, die lokal läuft. Dazu teilte er Zahlen.
Bei freier Transkription erkannte Whistle 70 von 170 gesprochenen Befehlen richtig, gegenüber 168 beim 1,7B-Sprachmodell von Qwen auf einer RTX-5080-GPU. Dann hörte er auf, von Whistle alles transkribieren zu lassen, was ein Mensch sagen könnte, und trainierte ein winziges Netz, das Whistles Ausgabe auf eine feste Menge von Befehlsvorlagen abbildet. Sein Ergebnis: 164 von 170, mit einem Setup, das auf der CPU des Echo selbst laufen soll.
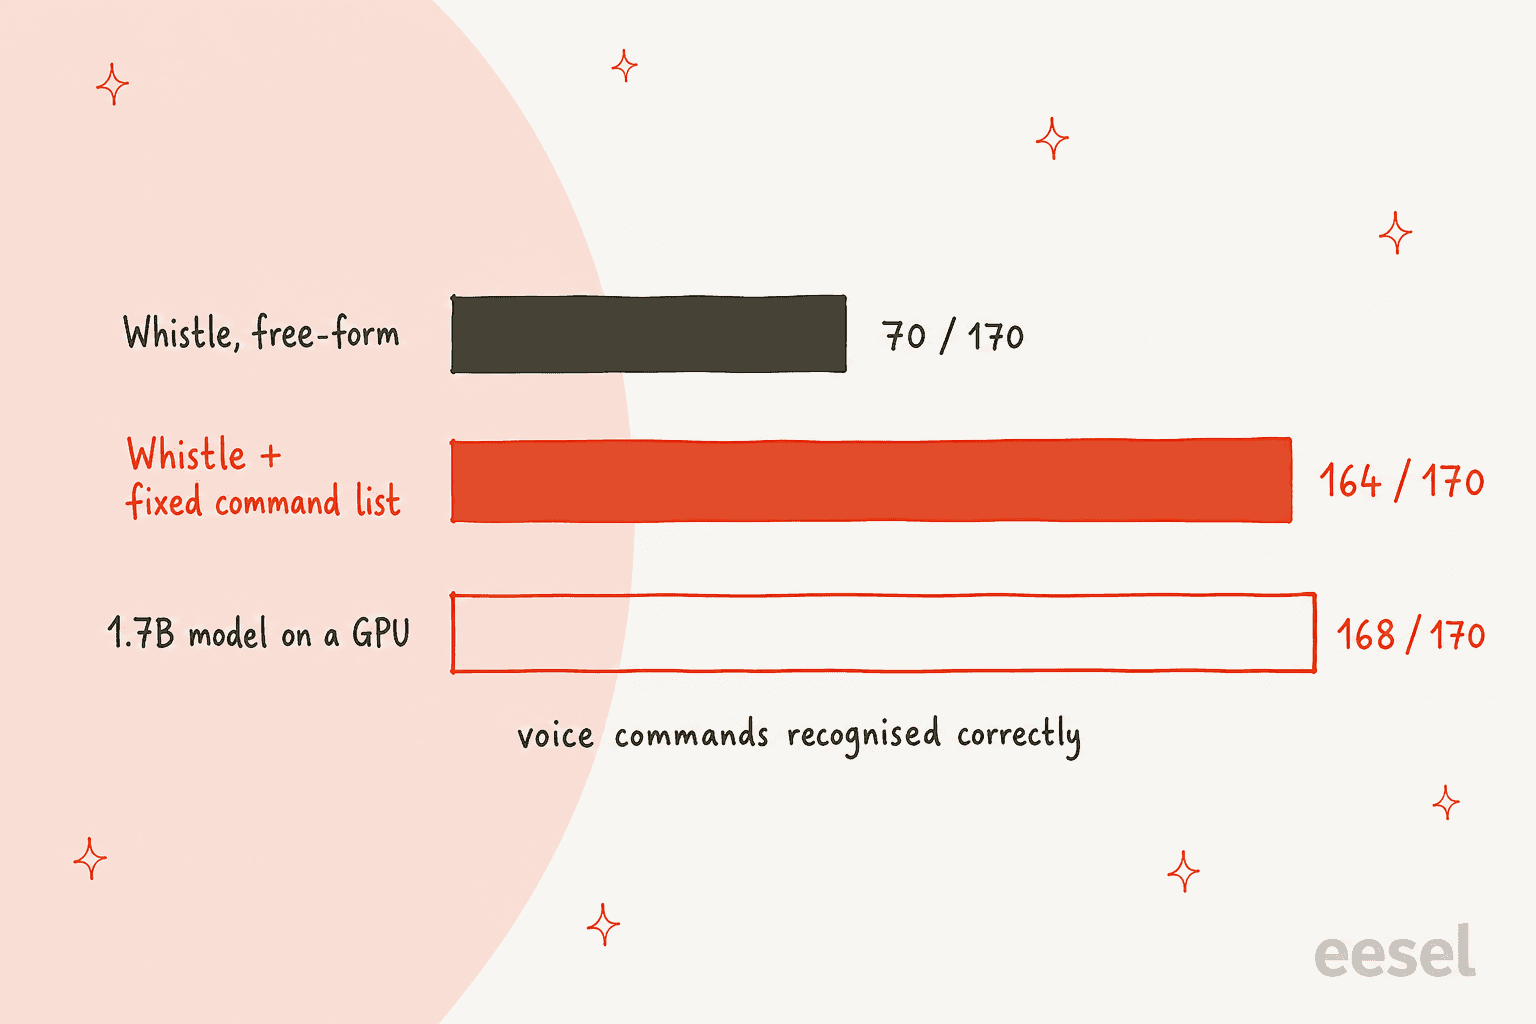
Das ist die Verschiebung, die ich mitnehmen würde. Ein 16,9-MB-Modell hat keinen Platz, um jedes Wort in sieben Sprachen zu kennen, deshalb gilt: Je genauer du ihm sagen kannst, was es erwarten soll, desto näher kommt es Modellen, die weit größer sind. Cactus hat genau dafür die Werkzeuge gebaut: Keyword Biasing für Namen und Produktbegriffe und Needles Tool-Liste, die selbst ein festes Vokabular an Aktionen ist. Derselbe Tester ließ später 208 Phrasen laufen und bekam 206 richtig, vor Vosk- und Kaldi-Setups auf demselben Satz.
Wenn du Whistle also beurteilst, indem du der Sandbox von deinem Wochenende erzählst, testest du das Falsche. Beurteile es an den 20 Befehlen, die dein Gerät wirklich verstehen muss.
Solltest du Whistle einsetzen?
So würde ich entscheiden, auf Basis der Benchmarks und der Erfahrungsberichte oben. Wähle die Aufgabe, die du im Sinn hast:
Was soll Whistle für dich tun?
So probierst du Whistle in fünf Minuten aus
Der schnellste Weg ist die Browser-Sandbox im Launch-Beitrag: Beim ersten Klick wird das 16,9-MB-Modell in den Tab geladen, und nichts verlässt deinen Rechner. Für einen echten Test braucht das Python-Paket nur eine Zeile:
pip install cactus-needle
import needle

print(needle.transcribe("clip.wav")["text"])
Von dort aus, laut Modellkarte:
word_timestamps=Trueergänzt Start, Ende und Wahrscheinlichkeit jedes Wortes.keywords=[...]lenkt die Suche auf Namen, die deine Nutzer sagen.language="de"erzwingt eine Sprache, statt sie zu erkennen.needle whistle comparelässt denselben Clip mit Zeitmessung durch Whistle, Whisper und Moonshine laufen, der nützlichste Einzelbefehl für die Entscheidung.
Die Engine wird vorkompiliert für siebzehn Zielplattformen geliefert, von macOS, Windows und Linux (einschließlich RISC-V und MIPS) bis zu Android, iOS, watchOS, tvOS und dem Browser als WebAssembly. Jeder native Plattformordner enthält eine needle-Binärdatei, eine statische Bibliothek und einen Header. Der Quellcode liegt auf GitHub. Wenn du einen vollständig lokalen Stack baust, passt es neben die Open-Source-KI-Agenten, die viele schon auf eigener Hardware betreiben.
Die Kosten sind einfach: Gewichte und Engine stehen unter Apache 2.0, und Hugging Face listet für Whistle keinen gehosteten Inferenz-Anbieter, du betreibst es also selbst. Vergleiche das mit den Preisen pro Minute bei Gemini 3.5 Transcribe oder MAI-Transcribe 2, die die richtige Wahl sind, wenn Genauigkeit bei langem, chaotischem Audio wichtiger ist als die Größe.
Wo Whistle nicht mehr das richtige Werkzeug ist
Fairerweise: Cactus hat nie behauptet, Whistle ersetze Whisper large oder einen Cloud-Transkriptionsdienst. Trotzdem sind das die Grenzen, auf die ich hinweisen würde, bevor jemand darauf aufbaut:
| Grenze | Was das in der Praxis bedeutet |
|---|---|
| Limit von 30 Sekunden pro Clip | Längeres Audio muss deine App in Stücke teilen (ein HN-Nutzer stieß sofort auf „audio limit is 30 s“) |
| Keine Streaming-Ausgabe | Der Text erscheint nach dem Ende des Clips, nicht während jemand spricht |
| 7 Sprachen | Kein Japanisch, Norwegisch, Hindi, Portugiesisch und so weiter |
| Meeting-Audio | 26,07 % WER bei AMI, hinter Whisper base |
| Sprecherlabels | Die Doku nennt keine Sprechertrennung (Diarization) |
Nichts davon sind Bugs. Es ist der Preis dafür, ein Sprachmodell in 16,9 MB unterzubringen, und Cactus veröffentlicht genug Details, damit du die Grenzen vor dem Einsatz siehst. Für die meiste Langform-Arbeit sind Otter und die Tools in meiner Liste mit Otter-Alternativen weiterhin die praktische Wahl.
Was Whistle für Kunden-Support-Teams bedeutet
Hier hole ich es zurück zu meiner eigenen Arbeit. Sprache im Support sind meist Telefonate, Voicemails und aufgezeichnete Walkthroughs, und die sind lang, haben zwei Sprecher und weichen vom Skript ab. Das ist das AMI-Ende von Whistles Benchmark-Tabelle, nicht das LibriSpeech-Ende. Für Telefon-Support-Automatisierung oder KI-Callcenter-Agenten wäre Whistle heute nicht meine Wahl für die Transkriptionsschicht. Die KI-Voice-Agents, die für Anrufe gebaut sind, nutzen aus gutem Grund größere Streaming-Modelle.
Der größere Punkt ist, dass Transkription immer günstiger und kleiner wird und nie der schwierige Teil war. In einem eesel-Verkaufsgespräch sagte eine DTC-Supplement-Marke mit Gorgias und Shopify, die etwa 7.000 Tickets im Monat bearbeitet, sie wolle per KI die Hälfte ihrer Fragen zu Bestellstatus, Abos und Produkten automatisch lösen. Das Hindernis war nicht, Sprache in Text zu verwandeln. Die Antworten lagen verstreut in SOP-Tools, veralteten Makros und Loom-Walkthroughs, die nie jemand aufgeschrieben hatte. Ein Transkript eines Loom-Videos ist nur mehr Text; jemand muss immer noch das Ticket lesen, die richtige Antwort finden und im Ton der Marke antworten.
Genau da würde ich die Linie ziehen: Whistle ist Infrastruktur, eesel ist der Mitarbeiter. Ein Modell wie Whistle hört die Wörter. Ein KI-Helpdesk-Teammate arbeitet die Warteschlange ab: Er lernt aus deiner Wissensdatenbank und früheren Tickets, entwirft oder sendet Antworten in Zendesk oder Gorgias und gibt die Tickets ab, die er nicht anfassen sollte.
Wenn bei dir bereits Anruf-Transkripte im Helpdesk landen, behandeln meine Leitfäden zum Zusammenfassen von Anruf-Transkripten und zum Schwärzen von PII in Transkripten die Schritte nach dem Sprachmodell.
Und weil Whistles ganzer Reiz darin liegt, dass du es aus dem Terminal steuerst: eesel funktioniert genauso. Mit der eesel CLI (npm i -g @eesel/cli) verbindest du einen Helpdesk, bearbeitest die Standardanweisungen des Teammates, genehmigst oder lehnst seine ausstehenden Aktionen ab und liest sein Aktivitätsprotokoll, wobei jeder Befehl JSON ausgibt und ein --dry-run-Flag den genauen Aufruf zeigt, den ein Schreibvorgang ausführen würde. Coding-Agenten wie Claude Code, Codex und Cursor können sie so bedienen wie ein Mensch, sodass derselbe Teammate, den du im Dashboard siehst, auch aus der CI heraus skriptbar ist.
eesel testen
Wenn Sprache auf deiner Roadmap steht, weil du weniger unbeantwortete Tickets willst, beginne mit dem Teil, der sie beantwortet. Der KI-Helpdesk-Teammate von eesel lässt sich in Minuten an Zendesk, Gorgias oder Freshdesk anbinden, lernt aus deinem Help Center und früheren Tickets und wird an deinen eigenen historischen Tickets getestet, bevor er einem echten Kunden antwortet. Du kannst eesel kostenlos und ohne Karte testen oder zuerst andere KI-Teammates vergleichen.
