

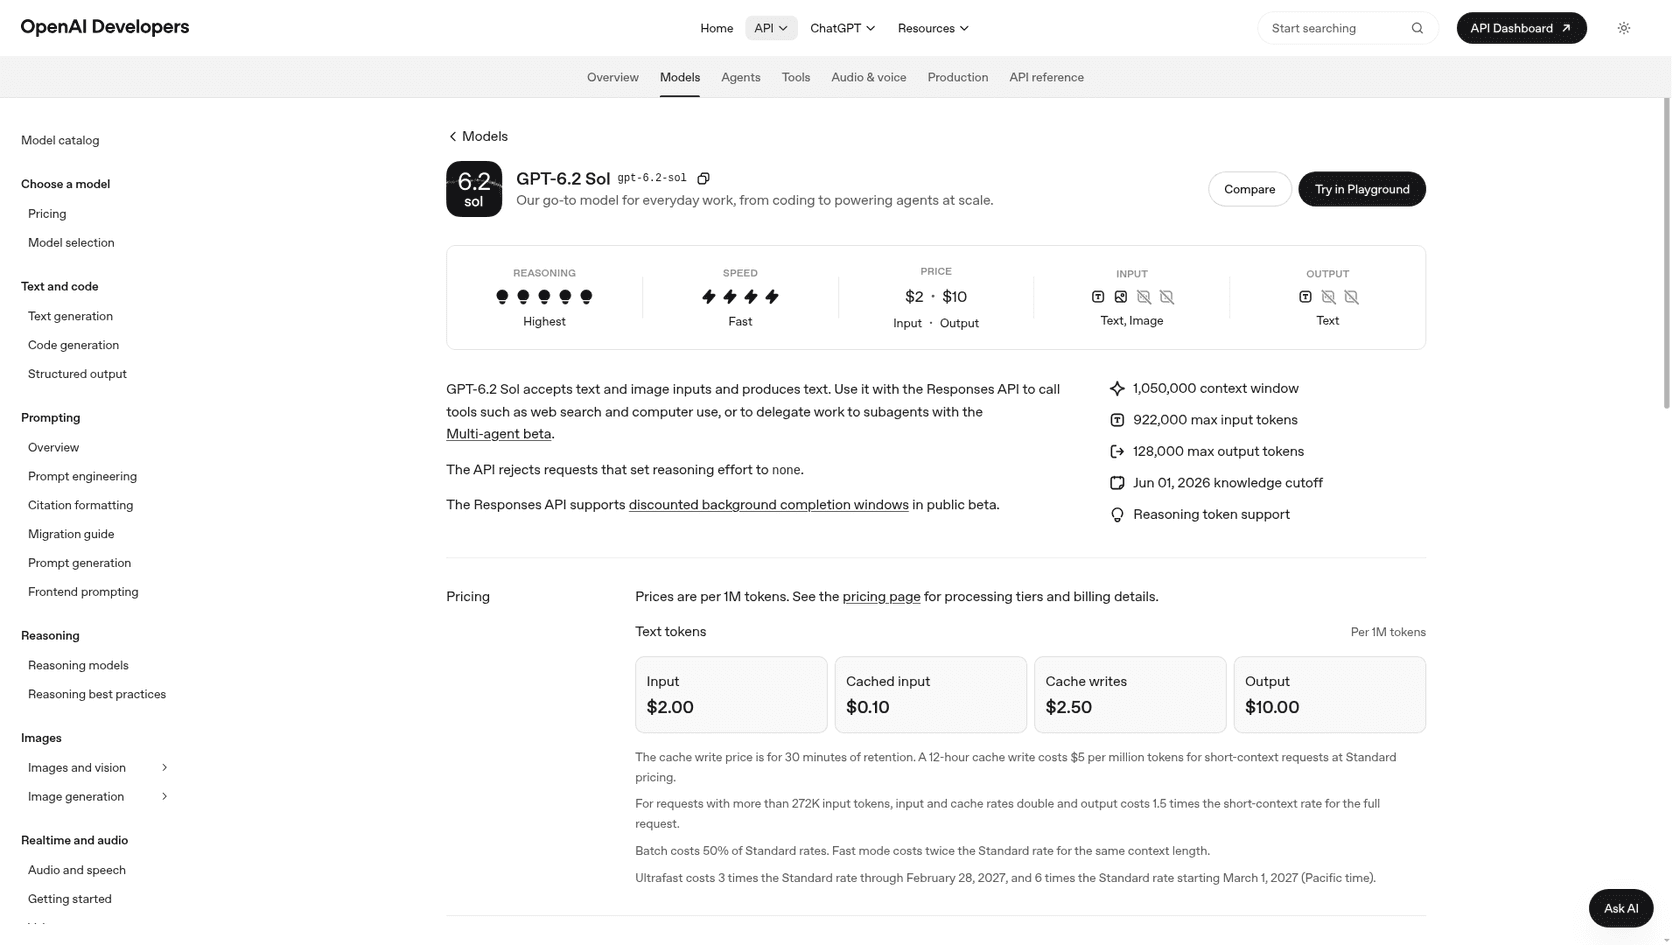
GPT-6.2 Sol ist derzeit das Modell mit dem besten Preis-Leistungs-Verhältnis, das OpenAI verkauft: $2/$10 pro Million Tokens, 57 bei Artificial Analysis, auf Augenhöhe mit dem alten GPT-6 Astra, und etwa dreimal schneller pro Aufgabe als GPT-6.1 Sol. Die Kritik ist real, aber eng begrenzt: Entwickler sagen, es überbaue Code noch immer, und Artificial Analysis maß einen Rückgang von 3 Punkten beim Coding.
In meinen 77 Testläufen hat es nie eine Firmentatsache erfunden. Seine Angewohnheit ist es, Dinge hinzuzufügen, die die Daten nie enthielten, etwa FedEx-Tracking-Links und Tageszahlen. Das ist in einem Entwurf harmlos und in einer Kundenantwort riskant. Für den Support zählt ein fundierter KI-Helpdesk-Mitarbeiter wie eesel mehr als das Modell darunter.
Was ist GPT-6.2 Sol, und wie habe ich es getestet?
GPT-6.2 Sol ist OpenAIs Alltagsmodell, erschienen am 17. November 2026 zusammen mit GPT-6.2 Astra. OpenAIs Launch-Beitrag nennt es „our efficient, versatile model for everyday work“. Es ersetzt GPT-6.1 Sol zum gleichen Preis, und die GPT-6.2-Sol-Übersicht enthält alle Details zum Launch.
Ich baue bei eesel Integrationen und API-Anbindungen, deshalb lese ich einen Modelltest so, wie ich ein API-Changelog lese: Was tut es tatsächlich, wenn mein Code es aufruft? Das können die Launch-Charts nicht beantworten, also habe ich diese Woche 77 GPT-6.2-Sol-Aufrufe über die Responses API in drei kleinen Tests laufen lassen, alle mit mittlerem Effort, wenn nicht anders angegeben:
- 15 Support-Tickets, mit niedrigem und mittlerem Effort, von Hand gegen eine Rückerstattungsrichtlinie bewertet (30 Läufe). Die Ergebnisse stehen in der GPT-6.2-Sol-Übersicht.
- 19 Läufe zu den Beschwerden über Astra: knappe Antworten, stille Tool-Fehler und erfundene Firmentatsachen. Diese liefen neben Astra im GPT-6.2-Astra-Test.
- 28 neue Läufe für diesen Test, gegen 28 bei GPT-6.1 Sol: sechs Richtlinienfragen, die jeweils zwei oder drei Fakten für eine vollständige Antwort brauchen, dreimal wiederholt, plus zwei Bestellverfolgungs-Tickets, fünfmal wiederholt.
Das ist ein kleiner, von Hand gelesener Test, kein Benchmark. Wer das auf seinem eigenen Setup nachstellen will: Die eesel CLI lässt einen Coding-Agenten einem eesel-Helpdesk-Agenten dieselben Testfragen stellen und die Antworten prüfen, bevor etwas live geht. Jeder Lauf läuft über das Richtliniendokument einer fiktiven SaaS-Firma und ein kanonisches lookup_order-Tool, gebaut mit Function Calling. Er zeigt, wie sich das Modell bei sauberer, alltäglicher Supportarbeit verhält, und das ist der Großteil des Supports.
Was ist mein Urteil zu GPT-6.2 Sol?
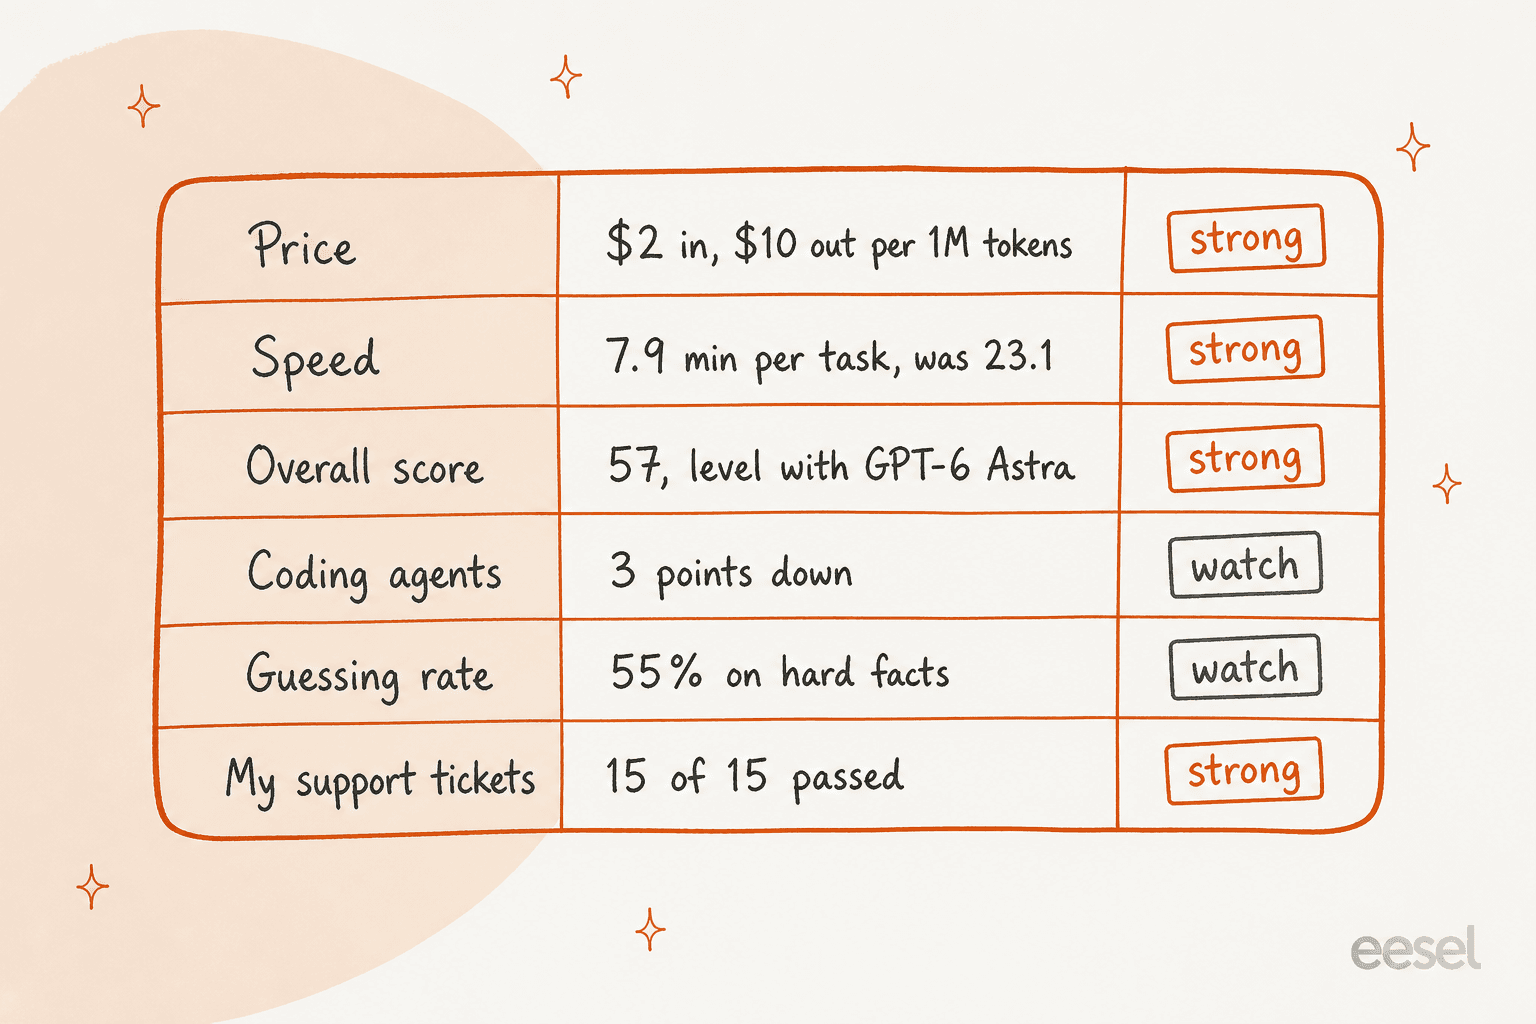
GPT-6.2 Sol ist ein sehr guter Standard für Routinearbeit zu einem Preis, den nichts in seiner Klasse erreicht, mit zwei Angewohnheiten, die man im Blick haben muss: Es überbaut Code, und es fügt Details rund um die Fakten hinzu. Hier die Bewertung:
| Was ich geprüft habe | GPT-6.2 Sol | Quelle |
|---|---|---|
| Preis pro 1 Mio. Tokens | $2 Eingabe, $0.10 zwischengespeichert, $10 Ausgabe | OpenAI-Preise |
| Intelligence Index (maximaler Effort) | 57, hoch von 55 | Artificial Analysis |
| Kosten pro Benchmark-Aufgabe (max) | $1.01, runter von $1.27 | Artificial Analysis |
| Zeit pro Benchmark-Aufgabe (max) | 7,9 Min., runter von 23,1 | Artificial Analysis |
| Coding Agent Index | 3 Punkte unter GPT-6.1 Sol | Artificial Analysis |
| Halluzinationsrate (AA-Omniscience) | 55 % | Artificial Analysis |
| Meine 15 Support-Tickets | 15/15 bei low und medium | Mein Test |
| Mehrfaktige Richtlinienantworten | 18/18 vollständig | Mein Test |
| Erfundene Firmentatsachen | 0 von 10 | Mein Test |
| Hinzugefügte Links, die das Tool nie sandte | 7 von 14 Bestellantworten | Meine Tests |
Das Upgrade von 6.1 ist leicht zu empfehlen. Gleicher Preis, ein leicht höherer Wert, und die Läufe mit maximalem Effort, die früher 23 Minuten brauchten, dauern jetzt 8. Wer bereits für GPT-6.1 Sol bezahlt, hat wenig Grund, dabei zu bleiben.
Was mögen Leute an GPT-6.2 Sol?
Das Preis-Leistungs-Verhältnis. Im Hacker-News-Launch-Thread, der 600 Kommentare überschritten hat, verteidigten jene, die den Launch verteidigten, vor allem Sol, und meist wegen der Kosten:
"Whatever you’re doing, it’s unlikely to be what most users are doing. Fable and Astra aren’t in my price range so I’m paying attention to Sol."

Der andere wiederkehrende Punkt ist, dass die höchsten Effort-Stufen den Abstand zum größeren, älteren Modell größtenteils schließen:
"6.2 Sol xhigh and max show the results comparable to Astra 6 max, and Astra 6.2 only shows any improvement on 'max' reasoning effort level."
Das passt zu Artificial Analysis, wo Sol bei 57 gegen 57 für GPT-6 Astra liegt, zu etwa 15 % der Kosten pro Aufgabe. Ein paar Entwickler beschrieben auch eine Aufteilung, die ich übernehmen würde: Ein stärkeres Modell plant, und Sol übernimmt das Volumen.
"I have hilariously started to just have an opus thread maintain Sol subagents to get the best of both worlds."
Worüber beschweren sich Leute?
Meist über das Überbauen, und fast ausschließlich bei Code. Die Beschwerde ist nicht neu zu diesem Release, was sie umso schmerzhafter macht:
"It's still overengineering especially Sol. This was the biggest complaint by everybody who has been using Sol since GPT 5.6. OpenAI is not listening to us."
Bei einer großen Codebasis maß ein Entwickler den Abstand zu Astra bei der Nacharbeit:
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
Die Zahlen stützen die Richtung, wenn auch nicht das Ausmaß. Artificial Analysis sagt, Sol „loses 3 points relative to GPT-6.1 Sol“ auf seinem Coding Agent Index, getrieben von einem Einbruch um 14 Punkte bei SWE-Atlas-QnA-AA, wo das Modell „more likely than its predecessor to omit key facts in its responses“ ist. Ein praktischer Tipp aus dem Thread: Ein anderer Entwickler fand, dass das Überbauen mit steigendem Effort schlimmer wird. Wenn Ihr Coding-Agent also immer Gerüste baut, die niemand verlangt hat, probieren Sie eine niedrigere Stufe, bevor Sie das Modell wechseln.
Dann gibt es die lautere Reaktion von Leuten mit frühem Zugang. Matt Shumer sagte auf X, er finde das Duo „essentially unusable“ und werde es nicht testen. Die meiste detaillierte frühe Kritik, zu zu knapper Schreibe und Coding-Läufen, die vorzeitig abbrechen, bezog sich auf Astra. Ich habe diese Behauptungen im Astra-Test überprüft, und bei Sol war die Schreibe in Ordnung: Sein Kunden-Hilfeartikel lag bei 168 bis 170 Wörtern und deckte jede Richtlinie ab.
Lässt GPT-6.2 Sol Fakten weg?
In meinen Tests nicht. Weil Artificial Analysis Auslassungen festgestellt hatte, schrieb ich sechs Fragen, die jeweils zwei oder drei Richtlinienfakten für eine vollständige Antwort brauchen. Kann ein Admin einen gelöschten Workspace wiederherstellen? (Ja, innerhalb von 14 Tagen, aber nur der Owner darf das.) Werden entfernte Plätze erstattet? (Nein, sie werden als Gutschrift auf der nächsten Rechnung verbucht.)
Beide Sol-Versionen beantworteten alle 18 Läufe vollständig, nachdem ich jeden von Hand gelesen hatte. Die von mir zuerst geskriptete Stichwortprüfung meldete 11 Fehltreffer bei 6.2 und 9 bei 6.1, und jeder einzelne war ein Fehlalarm, ausgelöst durch Formulierungen wie „14-day window“ oder ein geschwungenes Apostroph. Das ist eine faire Warnung zu automatisierten Evaluierungen im Allgemeinen: Ein stringvergleichender Bewerter hätte Ihnen gesagt, dass 6.2 Sol mehr Fakten auslässt, und das tut es nicht. KI-Supportgespräche überprüfen ist bei einer kleinen Stichprobe immer noch die einzige Prüfung, der ich vertraue.
Der Test zu stillen Fehlern verlief genauso. Als eine von drei Bestellabfragen ein leeres {} ohne Fehlermeldung zurückgab, markierte Sol diese Bestellung und eskalierte sie in 5 von 5 Läufen. OpenAIs System Card warnt, dass beide neuen Modelle „were more likely to omit known obstacles when reporting their work“ waren, ich würde also weiterhin Observability für jeden Agenten einplanen, der damit läuft. Bei kurzer Supportarbeit konnte ich es keinmal zum Überspringen bringen.
Erfindet GPT-6.2 Sol Dinge?
Es hat keine Fakten erfunden. Es hat aber Dinge hinzugefügt. Das ist das Nützlichste, was ich über dieses Modell gelernt habe.
Artificial Analysis setzt Sols Halluzinationsrate bei 55 %, der Anteil schwieriger Faktenfragen, die es falsch beantwortet, statt zu sagen, dass es die Antwort nicht weiß. In meinem Test, mit einer Richtlinie, die keine der Fragen abdeckte, fragte ich nach SOC-2-Audits, EU-Datenresidenz, Telefonzeiten, API-Ratenlimits und einer HIPAA-Vereinbarung. Sol erfand in 10 Läufen nichts davon, egal ob mit strengem Prompt oder lockerem „sei hilfreich“-Prompt. Mit dem lockeren Prompt sagte es, es habe „keine verifizierten Informationen“, und bot allgemeine Ratschläge an.
Die Extras zeigten sich rund um die Fakten:
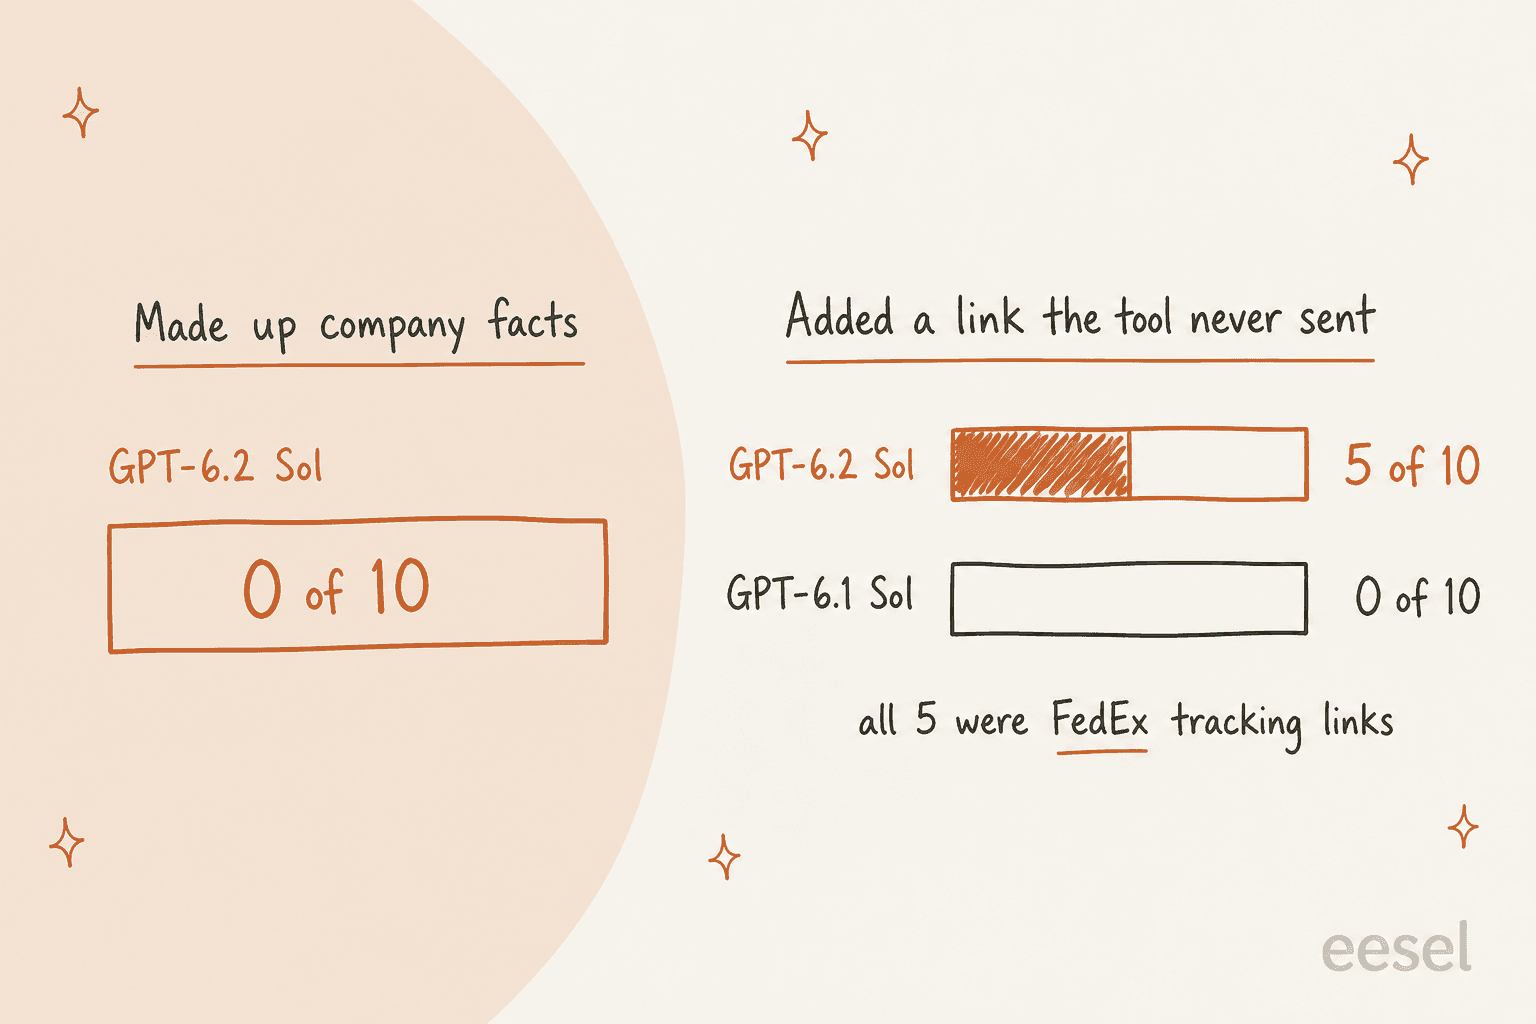
- Tracking-Links. Mein
lookup_order-Tool gibt einen Zusteller und eine Tracking-Nummer zurück, keine URL. Als ein Kunde fragte, wie er eine FedEx-Bestellung verfolgen könne, baute GPT-6.2 Sol in 5 von 5 Läufen einenfedex.com-Tracking-Link. GPT-6.1 Sol gab die Nummer jedes Mal nur für sich aus. Beim einfachen „Wo ist meine Bestellung“-UPS-Ticket erwähnte 6.2 die UPS-Tracking-Seite ohne Link. In meinem früheren Ticket-Test baute es bei mittlerem Effortups.com-Links für beide Bestelltickets, und bei niedrigem Effort keine. Über beide Tests hinweg sind das 7 Links in 14 Bestellantworten, gegenüber keinem bei 6.1. - Ungefragte Rechnerei. Bei der Frage zum gelöschten Workspace fügte 6.2 Sol in allen drei Läufen „noch etwa 5 Tage übrig“ hinzu. Das ist korrekt (14 minus 9) und hilfreich. In meinem ersten Test gab es außerdem eine Erstattung als „10/12 des Gezahlten“ an, ohne zu prüfen, wie die Richtlinie einen Teilmonat zählt, was eine als Fakt getarnte Vermutung war.
Keiner der von mir geprüften Links war falsch. Das Problem ist das Muster: Ein Modell, das aus einer Tracking-Nummer eine Zusteller-URL baut, wird eines Tages aus etwas anderem einen Link zu einem Rückgabeportal oder einer Zahlung bauen. In einer Kundenantwort ist jeder Link, den Ihre Tools nicht zurückgegeben haben, eine nicht belegte Behauptung. Die Lösung ist eine Zeile in den Anweisungen, die Links auf solche aus Tool-Ergebnissen oder dem Hilfecenter beschränkt, plus ein Test, der das prüft. KI-Support-Agent-Berechtigungen behandelt dieselbe Idee für Aktionen. Für Geld siehe Rückerstattungs-Leitplanken.
Ist GPT-6.2 Sol den Preis wert?
Ja, und das ist innerhalb von OpenAIs Produktlinie nicht einmal knapp. So viel haben meine Support-Läufe zum Standardtarif gekostet:
| Test (mittlerer Effort) | GPT-6.2 Sol | GPT-6.1 Sol | GPT-6.2 Astra |
|---|---|---|---|
| 15 Support-Tickets, pro 1.000 | $1.42 | $1.35 | $5.79 |
| Richtlinien- und Tracking-Fragen, pro 1.000 | $1.55 | $1.49 | nicht getestet |
| Ø Antwortlänge (Richtlinienfragen) | 44 Wörter | 40 Wörter | nicht getestet |
| Ø Reasoning-Tokens (Richtlinienfragen) | 4 | 9 | nicht getestet |
6.2 Sol kostet in diesen Läufen etwa 4 % bis 5 % mehr als 6.1 pro Ticket, weil seine Antworten etwas länger ausfallen. Es denkt bei leichten Fragen weniger und schreibt etwas mehr, und Ausgabe-Tokens sind, wo das Geld hingeht. Gegen GPT-6.2 Astra ist es etwa ein Viertel der Kosten für die gleiche Erfolgsquote bei Routinetickets.
Zwei Dinge bewegen die Rechnung mehr als die Modellwahl. Der Effort kommt zuerst: Artificial Analysis zählte 14,6 Millionen Ausgabe-Tokens bei mittlerem Effort gegenüber 60,9 Millionen bei max, für 53 gegenüber 57 Punkte. Dann die Rabattwege: Batch halbiert den Preis, aber für dieses Modell gibt es noch keine Flex-Stufe. Die GPT-6.2-Sol-Übersicht hat das vollständige Preisraster, inklusive des Long-Prompt-Aufschlags ab 272.000 Eingabe-Tokens.
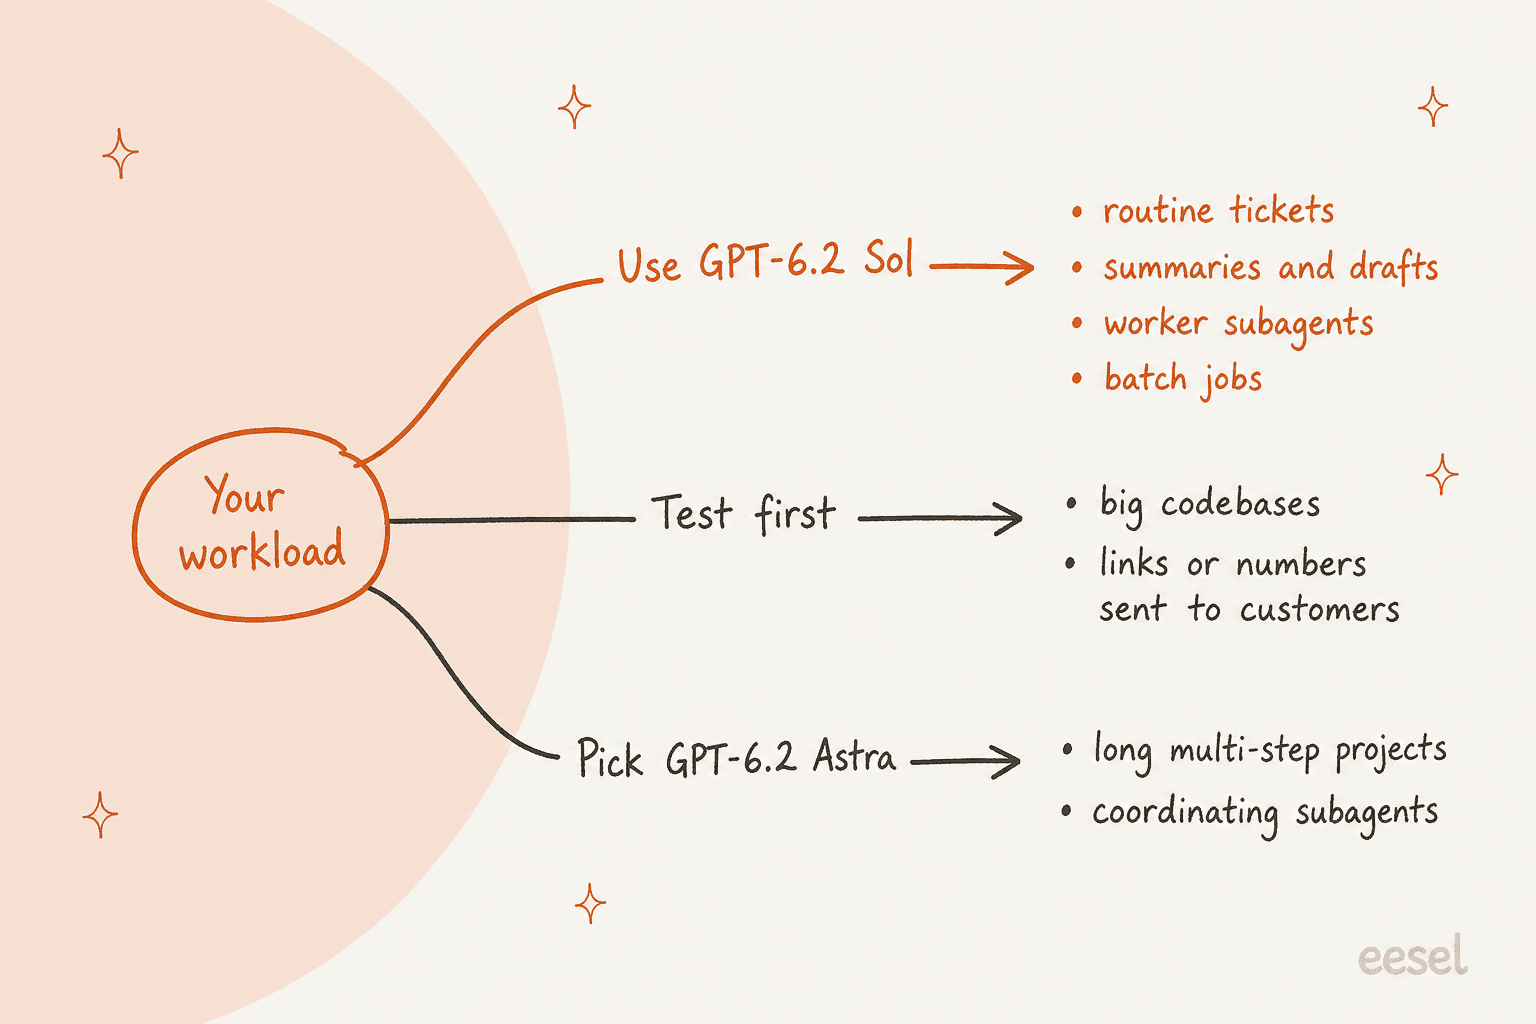
Wer sollte GPT-6.2 Sol nutzen, und wer sollte es auslassen?
Die meisten Teams sollten es zum Standard machen und die Ausnahmen herausschneiden:
| Wenn Sie... | Mein Rat |
|---|---|
| Auf GPT-6.1 Sol oder GPT-6 Sol sind | Wechseln Sie. Gleicher Preis, schneller, etwas klüger. Lassen Sie zuerst Ihre Coding-Evals erneut laufen. |
| Einen Coding-Agenten auf einem großen Repo betreiben | Testen Sie vor dem Wechsel. Der Coding-Index fiel, und die Überbau-Beschwerden sind konsistent. Behalten Sie Codex auf Astra für die schwierigen Aufgaben. |
| Support-Antworten oder Entwürfe laufen lassen | Nutzen Sie es, mit einer Regel zu Links und Zahlen und einem Testset aus Ihren eigenen Tickets. |
| Einen Orchestrator und Worker bauen | Sol als Worker, ein stärkeres Modell als Planer. |
| Mit Claude Sonnet 5.5 oder Claude Opus 5.5 vergleichen | Lassen Sie Ihre eigenen Tickets durch beide laufen. Benchmarks sagen Ihnen nichts über Ton oder Richtlinientreue. |
| Preis zuerst und offen für andere Labs | Siehe die Übersicht GPT-6.1-Sol-Alternativen und DeepSeek V4 Flash. |
Der Beitrag zum besten LLM für den Kundenservice vergleicht das breitere Feld, falls Sol nicht die richtige Wahl ist.
Was bedeutet das für ein Support-Team?
Ein günstigeres, schnelleres Modell ist bessere Infrastruktur, kein besserer Support-Agent. Mein Test zeigt die Lücke klar: Sol weiß, dass es Ihren SOC-2-Status nicht erfinden darf, wird einem Kunden aber trotzdem einen Link reichen, den Ihre Systeme nie produziert haben. Was diese Lücke schließt, ist die Ebene um das Modell herum: was es nachschlagen darf, was es sagen darf und was es an eine Person weitergibt.
STIL Classics, eine Marke für Planer und Schreibwaren auf Gorgias und Shopify, betreibt eesel mit genau dieser Regel eingebaut. Vor dem Entwurf schlägt eesel die Shopify-Bestellung, ihren Versandstatus und den Live-Lagerbestand nach, und es nennt nie ein Versanddatum, eine Lieferschätzung oder eine Produktangabe, die es nicht nachgeschlagen hat. Findet es die Bestellung nicht, markiert es das für das Team, statt es dem Kunden zu sagen. In einem Monat bereitete es rund 320 Gorgias-Tickets vor und schlug rund 230 Shopify-Bestellungen nach, und jeder Entwurf geht an eine Person zur Prüfung und zum Versand.
Das baut eesel: KI-Mitarbeiter, die Sie für bestimmte Aufgaben einstellen, einen KI-Helpdesk-Mitarbeiter für Ihre Warteschlange und einen KI-Blog-Autor für Content. Das Modell darunter kann sich von 6.1 auf 6.2 ändern, ohne dass sich Ihre Regeln mitändern müssen. Von einem Terminal aus kann ein Coding-Agent wie Claude Code oder Codex über die CLI freigegebene Makros und Hilfeartikel hochladen und die Anweisungen des Agenten verschärfen (zum Beispiel „nur Links teilen, die eine Abfrage zurückgegeben hat“). Den Helpdesk selbst anzubinden, braucht weiterhin jemanden mit Admin-Zugriff, der zustimmt.
Wenn Sie ein Modell für den Support auswählen, testen Sie es an Ihren eigenen alten Tickets, bevor es ein echtes berührt. Der Modellvergleich für Support-Tickets setzt die Zahlen in Kontext. Die Kosten-pro-Ticket-Benchmarks zeigen, wo Modellkosten in ein komplettes Ticket passen, und die Übersicht beste KI-Helpdesk-Software vergleicht die Tools, mit denen Sie diesen Test fahren können.
eesel testen
Wenn GPT-6.2 Sol Sie über KI in Ihrer Warteschlange nachdenken lässt: Der Teil, der entscheidet, ob seine Extras einen Kunden erreichen, ist der Mitarbeiter darum herum. eesel bindet sich in Ihren Helpdesk ein, lernt aus Ihren alten Tickets und Ihrem Hilfecenter und lässt Sie gegen Ihre historischen Tickets testen, damit Sie seine Antworten, Links inklusive, lesen können, bevor es live geht. Die Pläne sind feste Credit-Pakete ab 299 $ für 500 Credits, sodass sich die Rechnung nicht mit Token-Preisen oder Antwortlänge bewegt.

Sie können eesel kostenlos testen auf einem Ausschnitt Ihrer Warteschlange oder lesen, wie es sich mit der direkten Nutzung von ChatGPT vergleicht, falls Sie noch zwischen Eigenbau und Fertiglösung abwägen.