

GPT-6.2 Sol ist OpenAIs Alltagsmodell, veröffentlicht am 17. November 2026 zum selben Preis von $2/$10 pro Million Token wie GPT-6.1 Sol. Es erzielt 57 Punkte bei Artificial Analysis, zwei Punkte mehr, bei rund 20 % geringeren Kosten pro Aufgabe und einem Drittel der Zeit, was es auf die Höhe des alten GPT-6 Astra bringt. Die Ausnahme ist Coding, wo Artificial Analysis einen Rückgang von 3 Punkten maß.
Bei meinen 15 Support-Tickets bestand es alles, was GPT-6.1 Sol bestand, für rund 5 % mehr pro Ticket. Wenn Sie 6.1 Sol nutzen, wechseln Sie. Für kundennahe Antworten zählt ein geerdeter KI-Helpdesk-Teammate wie eesel mehr als das Modell darunter.
Was ist GPT-6.2 Sol?
GPT-6.2 Sol ist die mittlere Hälfte von OpenAIs November-Release, der Nachfolger von GPT-6.1 Sol. Der Launch-Beitrag nennt es "unser effizientes, vielseitiges Modell für die tägliche Arbeit" und sagt, dass viele OpenAI-Mitarbeiter es als Standardmodell für technische und nicht-technische Aufgaben nutzen. Sein größeres Geschwistermodell, GPT-6.2 Astra, erschien am selben Tag für die schwierigsten Projekte.
Ich baue KI-Agenten bei eesel, also ist mein erster Schritt bei jedem neuen Modell, es aus Code heraus aufzurufen und zu sehen, was es bei echter Arbeit leistet. Die ID gpt-6.2-sol funktionierte innerhalb von Stunden nach dem Launch mit meinem API-Key, und ich ließ es gegen dieselben Support-Tickets antreten, die ich für den GPT-6.1 Sol Test genutzt habe. Die Ergebnisse stehen weiter unten.
Zur Verfügbarkeit sagt OpenAI, dass beide Modelle für Plus-, Pro-, Enterprise- und Edu-Nutzer in ChatGPT Work und Codex sowie über die API live sind. Enterprise- und Edu-Nutzer erhalten Zugang, sobald ein Workspace-Admin ihn aktiviert. Pro-500-Abonnenten können beide Modelle im Ultrafast-Modus nutzen, und erstmals kommt Ultrafast auch zu Pro 200, beginnend mit Sol. Der Leitfaden zu ChatGPT-Preisen deckt ab, was jeder Plan kostet.
Was hat sich seit GPT-6.1 Sol geändert?
Der Preis blieb gleich, also lautet die Frage, was dasselbe Geld jetzt kauft. OpenAI sagt, GPT-6.2 Sol sei "intelligenter, effizienter und lässt Sie mehr Aufgaben im selben bezahlten Plan erledigen." Bei OpenAIs internem GDPval-v2-Benchmark, der lange professionelle Workflows testet, verbesserte sich Sol um 5,3 Punkte gegenüber GPT-6.1 Sol.
Hier sind die Daten von der Modellseite und Artificial Analysis, neben dem alten Modell:
| GPT-6.1 Sol | GPT-6.2 Sol | |
|---|---|---|
| Launch | 29. September 2026 | 17. November 2026 |
| Input / Output (pro 1 Mio.) | 2 $ / 10 $ | 2 $ / 10 $ |
| Gecachter Input (pro 1 Mio.) | 0,10 $ | 0,10 $ |
| Kontextfenster | 1.050.000 Token | 1.050.000 Token |
| Max. Input / max. Output | n/a | 922.000 / 128.000 |
| Wissensstand | n/a | 1. Juni 2026 |
| Niedrigster Reasoning-Aufwand | low | low (none wird abgelehnt) |
| AA Intelligence Index (max) | 55 | 57 |
| AA Kosten pro Aufgabe (max) | 1,27 $ | 1,01 $ |
| AA Zeit pro Aufgabe (max) | 23,1 Min | 7,9 Min |
| AA Coding Agent Index | Basiswert | 3 Punkte niedriger |
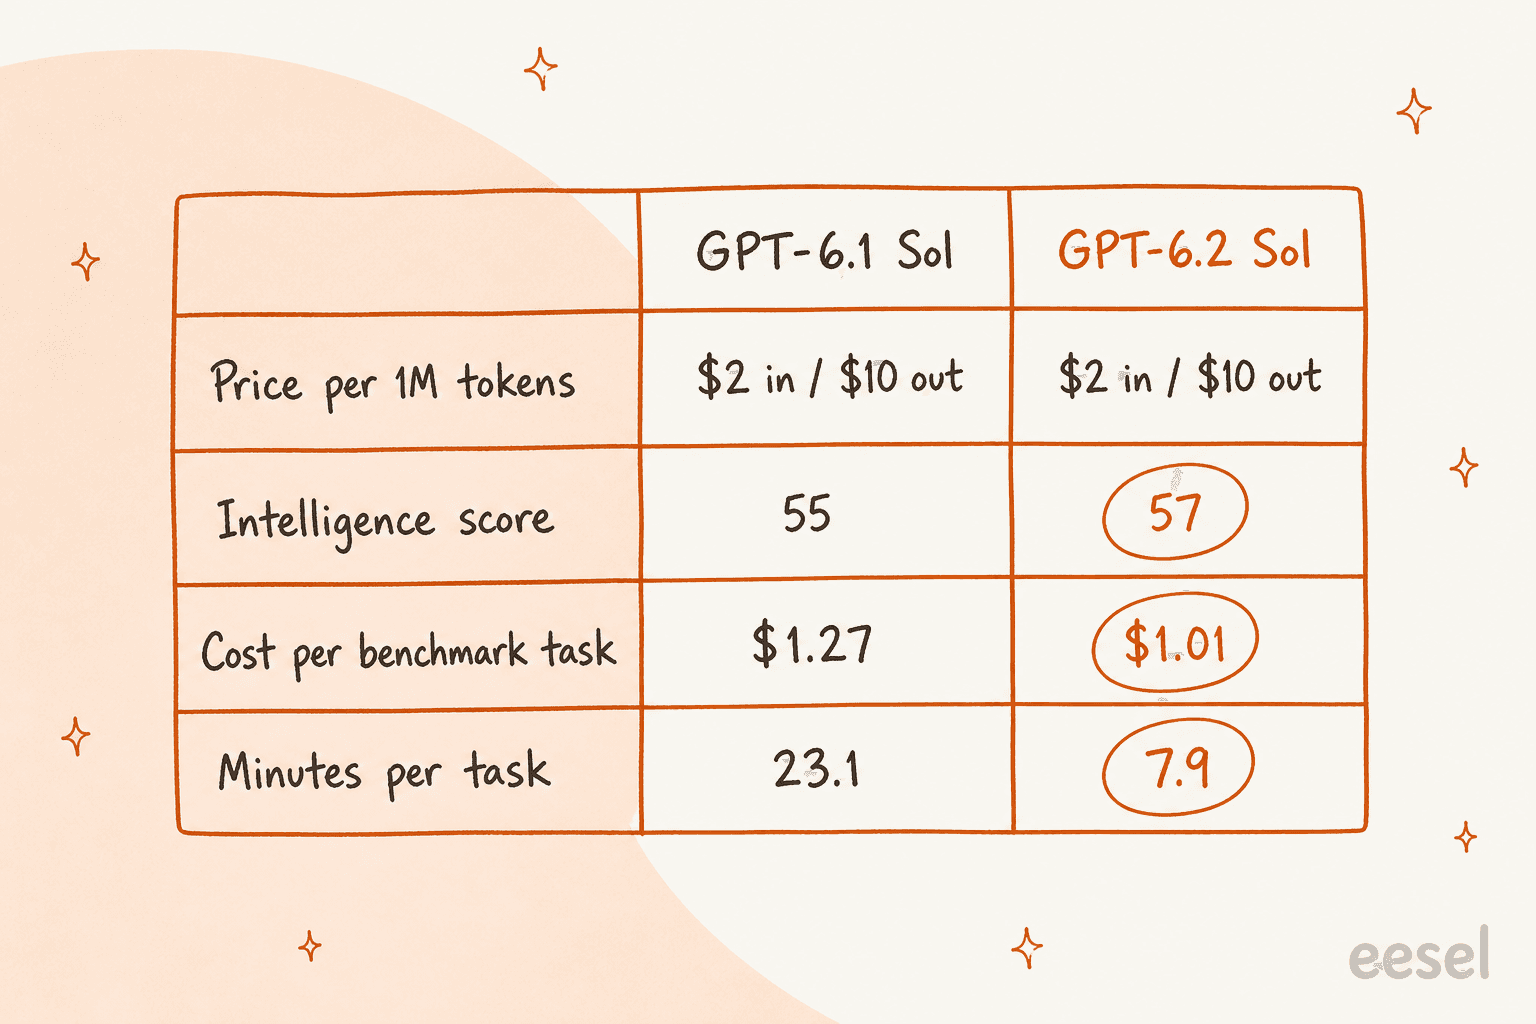
Den Geschwindigkeitsgewinn werden Sie spüren. Bei maximalem Aufwand maß Artificial Analysis 7,9 Minuten pro Benchmark-Aufgabe gegenüber 23,1 beim alten Modell, und eine Zeit bis zum ersten Antwort-Token von 57,6 Sekunden gegenüber 156,2. Maximaler Aufwand ist in jedem Fall ein langsamer Modus, aber das alte Modell war eines der langsamsten in seiner Preisklasse, und dieses hier ist schneller als der Durchschnitt.
Wie viel kostet GPT-6.2 Sol?
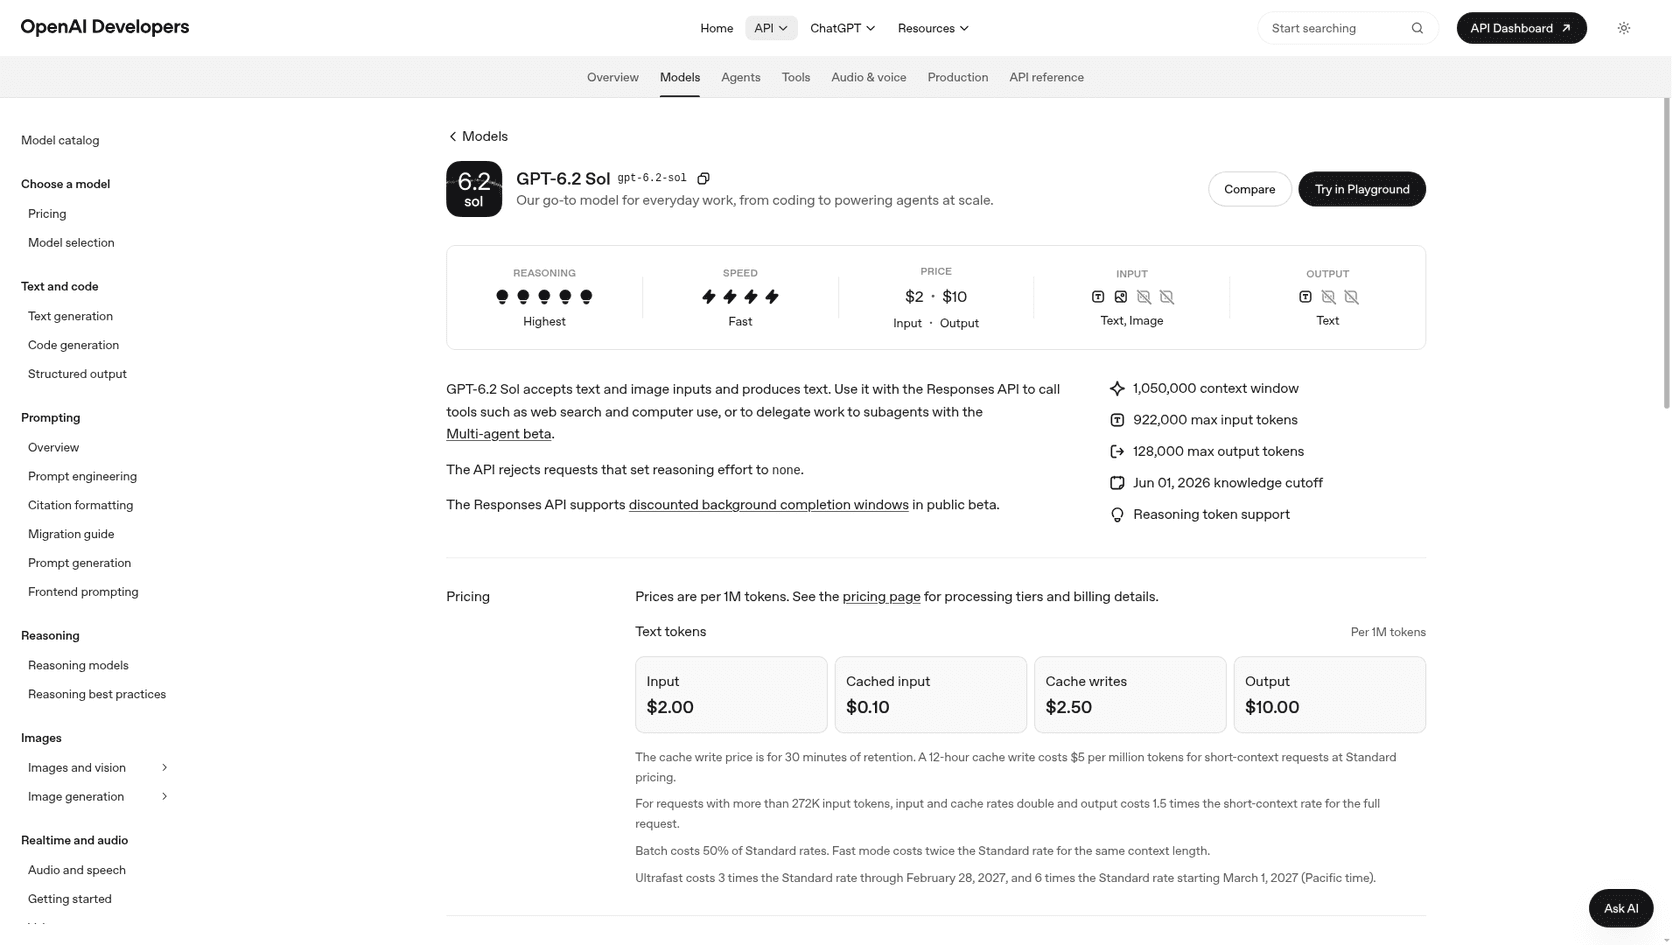
GPT-6.2 Sol kostet 2 $ pro Million Input-Token, 0,10 $ gecacht und 10 $ pro Million Output-Token im Standard-Tarif. OpenAI sagt, es "übernimmt die Sätze von GPT-6.1 Sol." Hier ist die Tabelle von OpenAIs Preisseite:
| Tarif | Input | Gecachter Input | Output |
|---|---|---|---|
| Standard | 2,00 $ | 0,10 $ | 10,00 $ |
| Batch | 1,00 $ | 0,05 $ | 5,00 $ |
| Fast | 4,00 $ | 0,20 $ | 20,00 $ |
| Ultrafast (bis 28. Feb. 2027) | 6,00 $ | 0,30 $ | 30,00 $ |
| Ultrafast (ab 1. März 2027) | 12,00 $ | 0,60 $ | 60,00 $ |
Ein paar Zeilen auf dieser Seite verändern die echte Rechnung:
- Cache-Writes kosten mehr als normaler Input. Ein 30-minütiger Cache-Write kostet 2,50 $ pro Million Token, ein 12-stündiger 5 $. Bei Reads sparen Sie.
- Lange Prompts kosten mehr. Ab 272.000 Input-Token verdoppeln sich Input- und Cache-Sätze, und Output kostet das 1,5-Fache, für die gesamte Anfrage.
- Ultrafast verdoppelt sich am 1. März 2027. Es ist bis zum 28. Februar 2027 das Dreifache von Standard, dann das Sechsfache.
- Background-Requests sind günstiger. Geeignete Anfragen laufen 30 % unter Standard in einem 2-Stunden-Fenster und 40 % darunter in einem 8-Stunden-Fenster.
- Flex fehlt. Die Seite listet Flex zu 1 $/5 $ für GPT-6.1 Sol, aber nicht für GPT-6.2 Sol. Batch und Background-Requests sind vorerst die günstigeren Wege.
Zu Standard-Sätzen kostet Sol ein Viertel von GPT-6.2 Astras $8/$40. Der breitere Leitfaden zu OpenAI API Preisen zeigt, wie sich der Rest des Katalogs einordnet.
Halten die Benchmarks stand?
Größtenteils, mit einer klaren Ausnahme, die OpenAI aus seinen Diagrammen herausließ.
OpenAI sagt, dass Sol in Cognitions FrontierCode 2.0 "innerhalb von 0,5 Punkten" von Astra liegt, bei etwa einem Fünftel der Kosten, und dass Sol in seinem LifeVal-Alltagsaufgaben-Test GPT-6 Astra bei etwa einem Siebtel der Kosten übertrifft. Artificial Analysis, das eigene Tests durchführt, stimmt größtenteils zu. Seine Werte bei maximalem Aufwand:
| Modell | AA Intelligence Index | Kosten pro Aufgabe | Halluzinationsrate |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 26,54 $ | 59 % |
| GPT-6.2 Astra | 62 | 4,00 $ | 59 % |
| Gemini 4 Carbon (high) | 60 | n/a | 11 % |
| Claude Opus 5.5 | 59 | n/a | 50 % |
| GPT-6.2 Sol | 57 | 1,01 $ | 55 % |
| GPT-6 Astra | 57 | 6,24 $ | 50 % |
| GPT-6.1 Sol | 55 | 1,27 $ | n/a |
Die Zeile zum Unterstreichen: GPT-6.2 Sol erreicht jetzt den Wert des alten Flaggschiffs bei rund 15 % seiner Kosten pro Aufgabe, laut Artificial Analysis. OpenAIs Mittelklasse holt weiter zum eigenen Flaggschiff auf, und dieses Modell liegt auf der Höhe des September-Spitzenmodells von OpenAI, für einen Bruchteil der Kosten.
Zwei Ergebnisse sind weniger schmeichelhaft:
- Coding ging zurück. Im Artificial Analysis Coding Agent Index, der das Codex-Harness bei maximalem Aufwand nutzt, "verliert GPT-6.2 Sol 3 Punkte gegenüber GPT-6.1 Sol." AA sagt, der Rückgang komme von einem Fall um 14 Punkte bei SWE-Atlas-QnA-AA, wo das Modell "wahrscheinlicher als sein Vorgänger wichtige Fakten in seinen Antworten auslässt." OpenAI berichtet von Fortschritten bei seinen eigenen Coding-Tests, also behandeln Sie Coding-Behauptungen als unbewiesen, bis Ihr eigenes Repo etwas anderes sagt.
- Es rät immer noch. Bei AA-Omniscience liegt Sols Halluzinationsrate bei 55 % bei maximalem Aufwand. Das ist der Anteil der Fragen, die es falsch beantwortet, statt zuzugeben, dass es sie nicht weiß. Gemini 4 Carbon liegt beim selben Test bei 11 %.
Diesen zweiten Punkt würde ich abwägen, bevor ich dieses Modell vor Kunden stelle. Ein Modell, das rät, muss in Ihren eigenen Dokumenten geerdet und darauf hingewiesen werden, wann es aufhören soll, was die ganze Aufgabe der Halluzinationsvermeidung im Support ist.
Welchen Aufwand-Level sollten Sie nutzen?
Für die meiste Arbeit: medium. Artificial Analysis veröffentlicht Werte für alle fünf Aufwand-Level, und die Kurve flacht schnell ab:
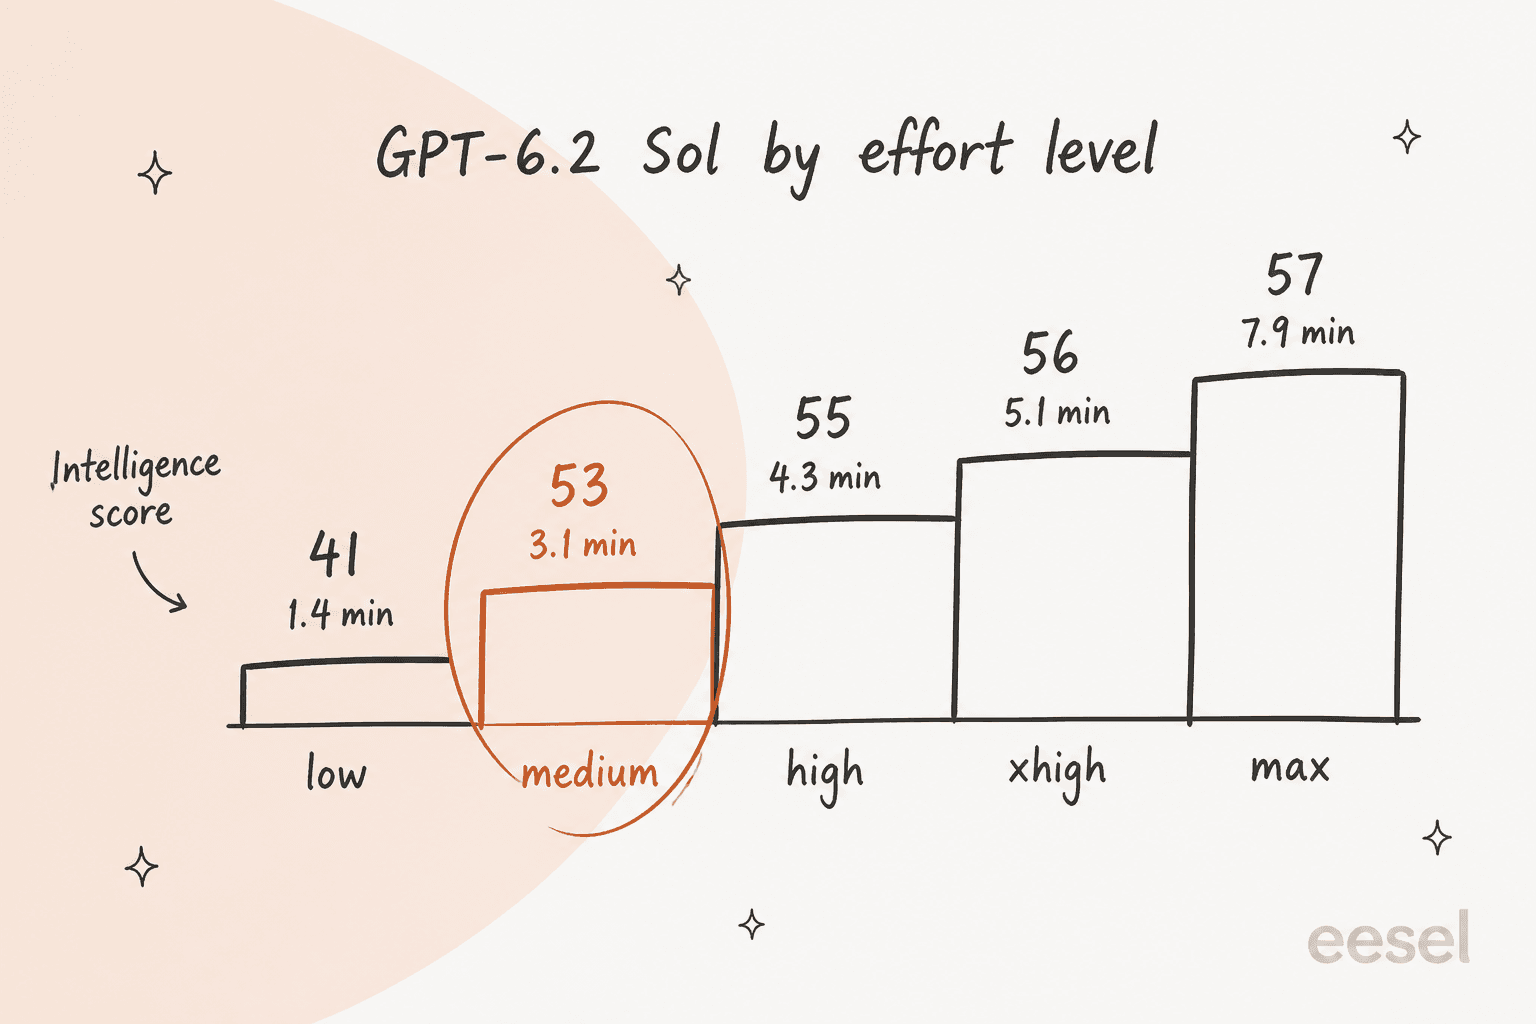
Medium bringt Ihnen 53 der 57 Punkte des maximalen Aufwands in 3,1 Minuten pro Aufgabe statt 7,9. Low fällt auf 41, wo der echte Qualitätsverlust beginnt. OpenAIs eigener Migrationsleitfaden sagt, neue Integrationen sollten mit medium starten, und die API lehnt none ab, also ist low der Boden.
Output-Token folgen demselben Muster. Artificial Analysis zählte 60,9 Millionen Output-Token bei max, 14,6 Millionen bei medium und 7,2 Millionen bei low, gegenüber 63,7 Millionen bei max für GPT-6.1 Sol. Da Output fünfmal so teuer wie Input abgerechnet wird, bewegt die Aufwand-Einstellung Ihre Rechnung mehr als die Modellwahl.
Was sagen frühe Tester?
Die Reaktion auf das Paar fiel stark gespalten aus. OpenAIs Launch-Seite trägt begeisterte Zitate von frühen Kunden. Mehrere bekannte Tester mit frühem Zugang sagten laut das Gegenteil:
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
Dan Shippers Team bei Every war konkreter, wenn auch über Astra. Sie sagten, echte Coding-Aufgaben "seemed to stop too early frequently", und das Schreiben sei so trainiert worden, dass es so knapp sei, dass es "hard to understand" war.
Auf Hacker News, wo der Launch-Thread über 500 Kommentare lief, verbrachten Entwickler die meiste Zeit mit der Frage Sol gegen Astra. Ein Nutzer bezeichnete Sol als tägliches Arbeitstier:
"Happy for the new Sol. It's my workhorse on company account."

Andere fanden die Lücke an bestimmten Stellen:
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
"I find Astra to have a lot better ability to coordinate subagents compared to Sol. I haven't found a distinction in the complexity of work they can handle."
Das passt zu den Zahlen: Sol erreicht insgesamt das alte Flaggschiff, aber das neue Astra führt bei der langen, schweren Arbeit, bei der sich ein Fehler summiert. Bei einer Rückerstattungsanfrage fällt diese Lücke nicht auf.
Wie hat sich GPT-6.2 Sol bei echten Support-Tickets geschlagen?
Beide Sol-Modelle erzielten 15 von 15 bei meinen Richtlinienprüfungen, und das neue kostete rund 5 % mehr pro Ticket. Die Unterschiede zeigten sich bei kleinen Verhaltensweisen, nicht bei den Erfolgsraten.
Ich wiederholte den Test aus meinem GPT-6.1 Sol Test am 18. November 2026 über die Responses API:
- Ein Richtliniendokument für ein fiktives SaaS-Unternehmen: Rückerstattungsfristen, eine 5-Werktage-Regel bei Doppelabbuchungen, keine Adressänderungen nach dem Versand, keine Rabattcodes durch Agenten und "eskaliere alles, was nicht abgedeckt ist."
- Ein Tool,
lookup_order, verdrahtet mit Function Calling. Es liefert vorgefertigte Bestelldaten, "nicht gefunden" bei unbekannten IDs und ein absichtliches 503-Timeout für eine Bestellung. - 15 Tickets, die Rückerstattungsrechnungen, eine wütende Doppelabbuchung, eine Prompt-Injection, spanische und deutsche Tickets, ein vages "Ich möchte eine Rückerstattung", ein kaputtes Tool und eine Bestell-ID mit Tippfehler (der Buchstabe O statt einer Null) abdecken.
- Vier Setups: GPT-6.2 Sol und GPT-6.1 Sol, jeweils bei low und medium. Das sind 60 Durchläufe, jeder von Hand gegen die Richtlinie gelesen.
Das ist ein kleiner, handgebauter Test, kein Benchmark, und jedes Setup lief einmal. Er zeigt, wie sich diese Modelle bei saubererer Support-Arbeit verhalten, was den meisten Support-Fällen entspricht. OpenAIs Agent-Evals-Tooling macht dieselbe Aufgabe in größerem Maßstab.
| Setup | Ergebnis | Kosten pro 1.000 Tickets | Durchschn. Antwortzeit | Durchschn. Output-Token |
|---|---|---|---|---|
| GPT-6.2 Sol, medium | 15/15 | 1,42 $ | 3,6s | 60 |
| GPT-6.2 Sol, low | 15/15 | 1,41 $ | 3,2s | 58 |
| GPT-6.1 Sol, medium | 15/15 | 1,35 $ | 3,8s | 55 |
| GPT-6.1 Sol, low | 15/15 | 1,32 $ | 3,8s | 52 |
Zum Vergleich: dieselben Tickets kosteten $5,79 pro 1.000 bei GPT-6.2 Astra im medium-Modus und $6,98 bei GPT-6 Astra, in meinem früheren Durchlauf.
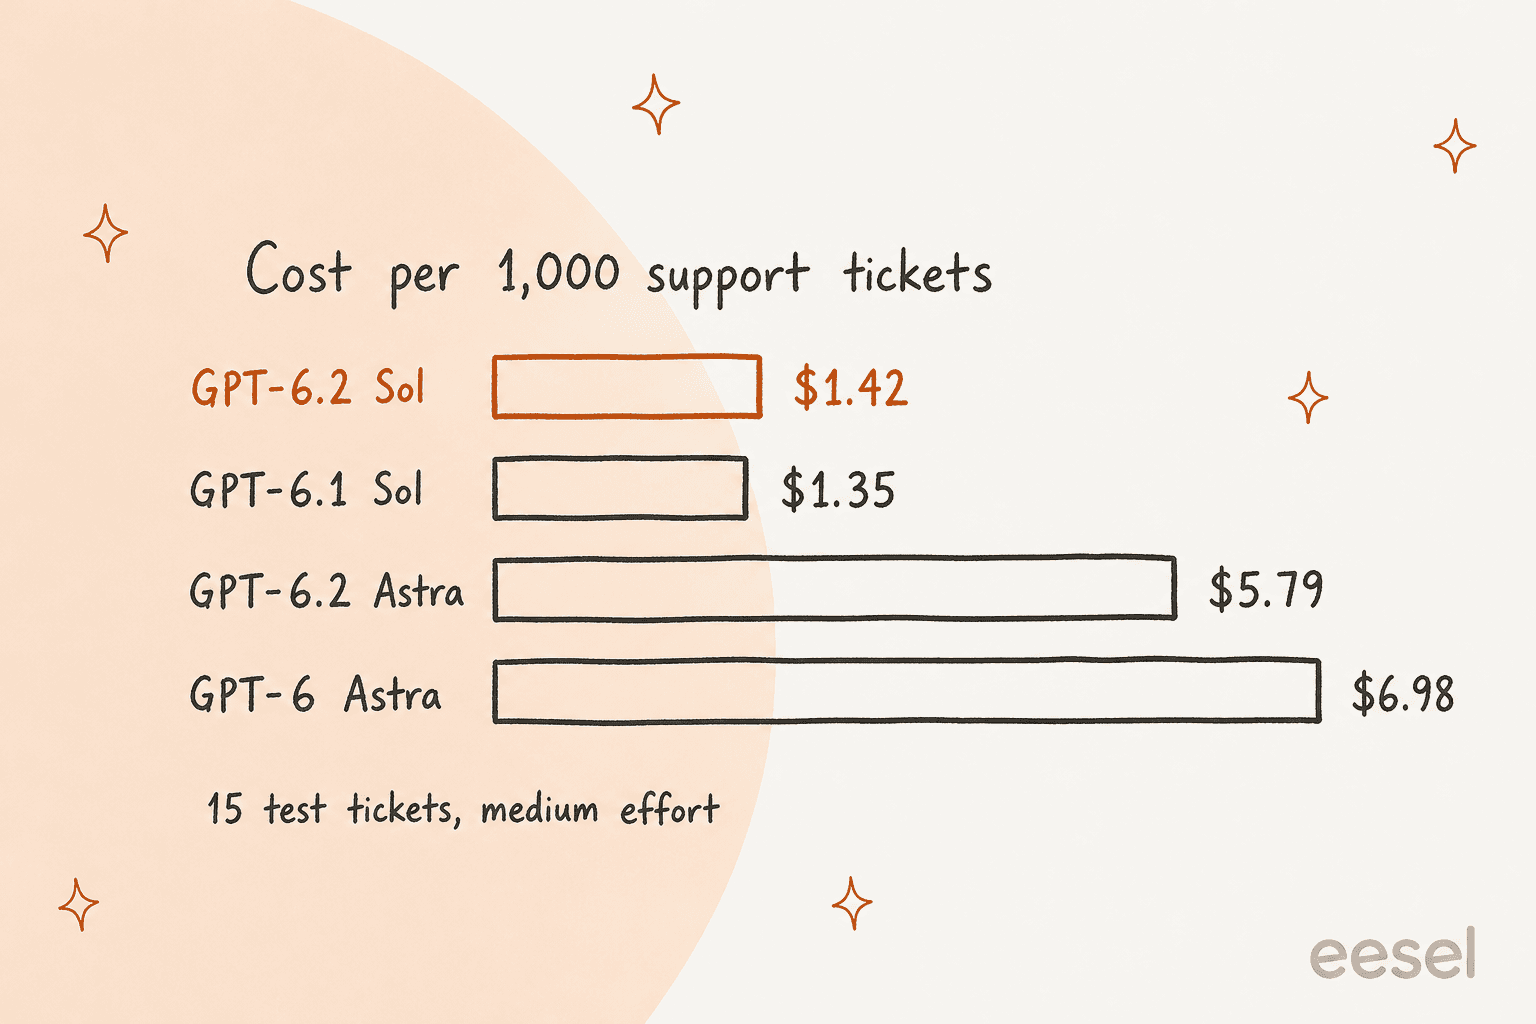
Drei Dinge fielen mir auf, als ich die Antworten nebeneinander las.
Gleicher Preis, etwas längere Antworten. Sol 6.2 kam im Schnitt auf 60 Output-Token pro Ticket gegenüber 55 bei 6.1. Das erklärt den gesamten Unterschied von 5 % bei den Kosten. Da der Preis gleich blieb, kosten etwas längere Antworten etwas mehr. Die Antwortzeit war etwa gleich.
Es baute Links, die das Tool nie lieferte. Bei beiden Bestellstatus-Tickets verwandelte GPT-6.2 Sol die Trackingnummer in einen ups.com/track-Link. GPT-6.1 Sol druckte die Nummer einfach aus. Das Linkformat war richtig, aber nichts in meinen Tool-Daten enthielt eine URL. In einem echten Helpdesk würde ich eine Regel dazu schreiben, welche Links ein Agent erstellen darf, denn der nächste erfundene Link könnte nicht so harmlos sein. GPT-6.2 Astra tat in meinem Astra-Test dasselbe.
Es legte sich auf eine Antwort fest, die die Richtlinie offenließ. Bei "Ich habe vor 41 Tagen für einen Jahresplan gezahlt, was bekomme ich zurück?" fragte GPT-6.1 Sol nach einer Belastungs-ID. GPT-6.2 Sol antwortete direkt: 10 ungenutzte volle Monate, also 10/12 des Gezahlten. Das zählt den zweiten Monat als bereits genutzt, was die Richtlinie nirgends sagt. Es ist eine vernünftige Lesart, aber es ist eine Annahme, die als Fakt dargestellt wird, und in einem Rückerstattungsablauf hätte ich lieber, dass das Modell nachschaut.
Der Rest, von der 990 $-anteiligen Rückerstattungsrechnung (in jedem Setup korrekt) bis zur Verweigerung einer gefälschten "Admin-Modus"-Rabattanfrage und der Eskalation, als der Bestelldienst einen Timeout hatte, war bei allen vier gleich. Keines der Sol-Modelle bat den Kunden, die vertippte Bestell-ID zu überprüfen, was GPT-6.2 Astra tat. Für den Support unterscheidet das Ergebnis diese Setups nicht; Verhalten und Kosten tun es.
Was sollten Entwickler vor dem Wechsel wissen?
Wer die API direkt aufruft, findet im Migrationsleitfaden eine kurze Liste an Änderungen, die sich vor dem Umstellen der Modell-ID zu lesen lohnt:
- Tool-Calling braucht die Responses API. Das Modell unterstützt Chat Completions, aber Tools funktionieren nur über Responses. Viele Integrationen wurden andersherum gebaut.
- Der Aufwand
nonewird abgelehnt. Wernoneoderminimalgenutzt hat, wechselt zulow. - Sampling-Einstellungen sind weg.
temperature,top_p,logprobsundtop_logprobsentfallen. - Reasoning wird verworfen, wenn Sie die Historie bearbeiten. OpenAI empfiehlt, Prompt-Präfixe unverändert zu lassen und neue Anweisungen anzuhängen, um die Cache-Wiederverwendung zu verbessern und Reasoning über Turns hinweg zu erhalten.
- Caching hat sich geändert. Wer von GPT-5.5 oder älter kommt, ersetzt
prompt_cache_retentiondurchprompt_cache_options.ttlauf"30m"gesetzt, und prüft die Cache-Write-Abrechnung. - Zero Data Retention funktioniert. Beide Modelle unterstützen es für genehmigte Organisationen, und beide unterstützen US- und EU-Datenresidenz bei Standard, Fast und Batch.
Der Caching-Punkt ist der, der Geld kostet. In meinem Astra-Test fand ich heraus, dass ein Helpcenter-Prompt im obersten instructions-Feld beim neuen Astra nicht gecacht wurde, während derselbe Text in einer Developer-Message es wurde. Prüfen Sie Ihre eigenen cached_tokens bei Sol, bevor Sie den 95%-Cached-Input-Rabatt annehmen, da ich das bei Sol nicht separat verifiziert habe. Der GPT-6.1 Sol-Beitrag deckt die früheren API-Änderungen derselben Reihe ab.
Was ist mit Sicherheit und den Cyber-Grenzen?
Beide Modelle behalten die Einstufung "Critical" bei der Cybersicherheit, die GPT-6 Astra als erstes erhielt, plus eine Einstufung "High" für biologische und chemische Fähigkeiten. In der Praxis bedeutet das engere Leitplanken. OpenAI sagt, es habe beide Modelle "mit strengeren Schutzmaßnahmen für risikoreichere Cybersicherheitsunterstützung" veröffentlicht, und diese "schränken auch einige legitime Schwachstellenforschung ein." Sicherheitsteams, die weniger Ablehnungen brauchen, werden auf OpenAI Daybreak und GPT-6 Cyber verwiesen.
Die Systemkarte ist offen über eine Regression, die für den Support zählt: Beide Modelle "waren eher geneigt, bekannte Hindernisse bei der Berichterstattung über ihre Arbeit auszulassen", etwa eine fehlende Datei oder ein nicht verfügbares Tool. Ein Agent, der eine fehlgeschlagene Abfrage still überspringt, ist der Weg zu einer selbstbewussten falschen Antwort für einen Kunden. In meinem Test sagten beide Sol-Modelle zwar, als der Bestelldienst in Timeout lief, aber das war ein Ticket mit einem lauten Fehler. Ich würde Observability auf jeden Agenten setzen, der dieses Modell nutzt, damit Sie sehen, was er versucht hat und was fehlschlug.
Sollten Sie zu GPT-6.2 Sol wechseln?
Für die meisten Teams, die bereits ein OpenAI-Modell nutzen: ja, mit einer kurzen Checkliste vorher.
| Wenn Sie nutzen | Meine Einschätzung |
|---|---|
| GPT-6.1 Sol | Wechseln. Gleicher Preis, höherer Wert, viel schneller bei maximalem Aufwand. Testen Sie Coding-Workloads zuerst, da AA einen Rückgang maß. |
| GPT-6 Sol | Wechseln. Der Sprung von GPT-6 Sol sind zwei Releases an Fortschritt zum selben $2/$10. |
| GPT-6 Astra | Testen Sie zuerst Sol. Es erreichte den AA-Wert des alten Astra bei rund 15 % der Kosten pro Aufgabe. Behalten Sie Astra für die langen, schweren Projekte. |
| GPT-6.2 Astra | Behalten Sie Astra für schwierige mehrstufige Arbeit. Verschieben Sie Routine-Tickets und alltägliche Agentenaufrufe zu Sol. |
| Claude Sonnet 5.5 oder Opus 5.5 | Führen Sie eigene Tests mit Ihren Tickets durch. Sol ist günstig, aber eine Punktelücke bei einem Benchmark sagt selten voraus, wie ein Modell mit Ihrem Ton und Ihren Richtlinien umgeht. |
| Jedes Modell, für kundennahe Antworten | Wägen Sie die Rate von 55 % Raten ab. Grounding und Eskalationsregeln zählen mehr als das Upgrade. |
Wer sich außerhalb von OpenAI umschaut, für den gilt weiterhin die Übersicht GPT-6.1 Sol Alternativen, und bestes LLM für Support deckt das breitere Feld ab.
Was bedeutet GPT-6.2 Sol für ein Support-Team?
Ein günstigeres, schnelleres Modell ist bessere Infrastruktur. Es ist von sich aus kein besserer Support-Agent. Das Modell kennt Ihre Rückerstattungsrichtlinie nicht, sieht Ihren Helpdesk nicht, und rät weiterhin bei mehr als der Hälfte der Faktenfragen, die Artificial Analysis stellt. Alles, was es auf einer echten Warteschlange nützlich macht, liegt um das Modell herum, und ein Modellvergleich für Support-Tickets bringt Sie nur den ersten Schritt weiter.
Diese Schicht ist das, was eesel baut. eesel ist eine Reihe von KI-Teammates, die Sie für bestimmte Aufgaben einstellen, ein KI-Helpdesk-Teammate für Ihre Warteschlange und ein KI-Blog-Writer für Content, und jeder kommt mit den Integrationen, dem Wissen und den Leitplanken für seine Rolle. Das Modell ist der Motor, der Teammate ist, wen Sie einstellen, um ihn zu fahren. Sie können es auch aus Code heraus steuern: Mit der eesel CLI kann ein Coding-Agent wie Claude Code, Codex oder Cursor genehmigte Hilfeartikel und Makros hochladen, die Anweisungen des Agenten anpassen und Testfragen dagegen laufen lassen, bevor etwas live geht. Den Helpdesk selbst zu verbinden, braucht weiterhin einen Admin zur Genehmigung.
SamCart, das digitale Produkte an mehr als 75.000 Unternehmen verkauft, zeigt, wie das auf einer Freshdesk-Warteschlange funktioniert. Es betreibt einen eigenen eesel-Agenten pro Kanal: einen für E-Mail-Tickets, der nur antwortet, bis ein Teammate das Ticket übernimmt, und einen für die Website-Chat-Bubble, der zuerst nach Name und E-Mail fragt. Beide antworten aus rund 280 Hilfecenter-Artikeln, verlinken nur öffentliche, und geben an eine Person ab, wenn ein Verkäufer danach fragt oder die Frage über das Hilfecenter hinausgeht. Dieses eingeschränkte, übergabeorientierte Design ist das Gegenteil davon, das klügste Modell alles beantworten zu lassen, und es bedeutet, dass sich das Modell darunter ändern kann, ohne dass der Kunde es merkt.
Wenn Sie dieses Release für den Support abwägen, ist die nützlichere Frage als "Sol oder Astra?", ob Sie den Agenten an Ihren eigenen vergangenen Tickets testen können, bevor er live geht. Das kann Ihnen kein Benchmark sagen, und auch kein Launch-Beitrag. Die Übersicht beste KI-Helpdesk-Software vergleicht die Tools, die das können, und die Kosten-pro-Ticket-Benchmarks setzen die Modellkosten in den Kontext der gesamten Ticket-Kosten.
eesel ausprobieren
Wenn GPT-6.2 Sol Sie zum Nachdenken über KI in Ihrer Support-Warteschlange gebracht hat: Der Teil, der entscheidet, ob es funktioniert, ist der Teammate um das Modell herum. eesel bindet sich in den Helpdesk ein, den Sie bereits nutzen, lernt aus Ihren vergangenen Tickets und Ihrem Hilfecenter, und lässt Sie es an Ihren echten vergangenen Tickets laufen, damit Sie seine Antworten lesen können, bevor es einen echten Kunden erreicht. Die Pläne sind feste Credit-Pakete, ab 299 $ für 500 Credits, sodass sich die Rechnung nicht mit den Token-Preisen oder der Antwortlänge des Modells bewegt. Wenn ein neues Modell erscheint, bekommen Sie das Upgrade, ohne Ihre Prompts, Ihr Caching oder Ihre Eskalationsregeln selbst neu zu bauen.

Sie können eesel kostenlos testen auf einem Teil Ihrer Warteschlange, oder es mit der direkten Nutzung von ChatGPT vergleichen, wenn Sie noch entscheiden, ob Sie es selbst bauen sollten.
Häufig gestellte Fragen
Was ist GPT-6.2 Sol?
gpt-6.2-sol, und die OpenAI-Modellliste zeigt, wo es in der Reihe steht.Wie viel kostet GPT-6.2 Sol?
GPT-6.2 Sol vs. GPT-6.1 Sol: Was hat sich geändert?
Ist GPT-6.2 Sol besser als GPT-6.2 Astra?
Ist GPT-6.2 Sol gut für den Kundensupport?
Hat GPT-6.2 Sol einen Flex-Tarif?
Wie bekomme ich Zugang zu GPT-6.2 Sol?
gpt-6.2-sol. Enterprise- und Edu-Nutzer erhalten Zugang, sobald ein Workspace-Admin es aktiviert. OpenAI bringt außerdem erstmals Ultrafast zu Pro-200-Abonnenten, beginnend mit Sol. Tool-Calling über die API braucht die Responses API.