

Subvocal ist eine Brille eines Y-Combinator-Startups, die lautlos mit dem Mund geformte Wörter in Text umwandelt. Sie richtet sich an Menschen, die KI-Tools diktieren, bei der Arbeit aber nicht laut sprechen können. Mit einer erstattungsfähigen Anzahlung von 199 $ reservieren Sie eine Brille für 499 $, die im Q1 2027 ausgeliefert werden soll. Das Versprechen steht, aber die Belege fehlen noch: keine Angaben zur Genauigkeit, keine technischen Daten, nur mit Cloud, nur auf Englisch. Reservieren Sie sie, wenn Sie von Anfang an dabei sein möchten und warten können. Wenn Ihr eigentlicher Engpass das Schreiben von Support-Antworten ist, spart ein KI-Teammitglied wie eesel, das diese für Sie entwirft, mehr Zeit.
Was ist Subvocal?
Subvocal ist ein Wearable für lautlose Sprache, eine neue Art der Eingabe für multimodale KI, von The Subvocal Company, einem dreiköpfigen Startup aus San Francisco im Herbstjahrgang 2026 von Y Combinator. Sie tragen die Brille, formen Wörter mit dem Mund, ohne einen Laut von sich zu geben, und der Text erscheint auf Ihrem Computer. Der Slogan auf der YC-Unternehmensseite lautet "Talk to your computer without talking."
Die Vorstellung schlug hohe Wellen. Die Ankündigung auf X von CEO Aarush Yadav am 30. Oktober erhielt 26,277 Likes und rund 12 million Aufrufe, und der Show-HN-Thread erreichte einige Tage später etwa 497 Punkte und 270 Kommentare. Im selben Beitrag erklärte Yadav, das Unternehmen habe 1,3 Mio. $ von YC und Afore Capital eingesammelt.
Die beiden Gründer sind Aarush Yadav (CEO) und Arnav Kumar (CTO), beide Informatikstudenten an der Georgia Tech. Laut einem Porträt des Honors Program der Georgia Tech begann Yadav nach dem TreeHacks-Hackathon in Stanford im Februar 2026 mit der Arbeit und sammelte innerhalb weniger Wochen die ersten $500k von Afore ein.
Ich entwickle bei eesel das Produkt weiter, deshalb lese ich Produktvorstellungsseiten wie eine Spezifikation: Was ist zugesagt, was ist ein Ziel und was ist eine Demo? Subvocal unterscheidet ehrlich zwischen diesen Dingen, wenn man das Kleingedruckte liest. Im YC-Vorstellungsbeitrag steht ganz offen: "the hardware currently looks a lot worse than the product we intend to ship."
Ein wissenswertes Detail: Die Form des Produkts hat sich schnell verändert. Das Georgia-Tech-Porträt vom April 2026 beschreibt "a wearable that sits behind your ear" mit einem Prototyp auf Buchstabenebene, der 30 Wörter pro Minute schaffte. Sechs Monate später ist es eine Brille mit angegebenen 200+. Das ist für ein Hardware-Startup in dieser frühen Phase normal und auch der Grund, warum das endgültige Produkt noch einmal anders aussehen könnte.
Wie funktioniert Subvocal?
Subvocal erfasst die Muskeln, mit denen Sie sprechen, nicht Ihre Stimme und auch nicht Ihr Gesicht per Kamera. Im YC-Vorstellungsbeitrag heißt es: "We send low-power radio waves through the face and measure how they change as your muscles move. Our models then decode those signals directly into text."
Auf Hacker News ergänzte der Gründer weitere Details:
"They emit radio waves, similar to Bluetooth, that pass through your face. As they cross the tongue, lips and soft palate, they're modulated by silent mouthing. We train foundation models on this data to decode these perturbations to text."

Einige Fakten von Subvocals eigenen Seiten zeigen, wie die Nutzung aussehen würde:
- Keine Kameras. In den FAQ auf der Startseite steht: "There's no video or camera-based lip reading."
- Sie müssen es bewusst tun. Es "only decodes words you intentionally articulate", liest also weder Ihre Gedanken noch ist es ständig aktiv.
- Zuerst die Kalibrierung. Zur Einrichtung gehört "a short personal calibration process." Im Demovideo mit Dave von YC bedeutete das, 20 Sätze vorzulesen.
- Cloud erforderlich. Auf die Frage, ob es offline funktioniert, antwortete der Gründer auf Hacker News: "Yes, it requires internet access."
- Nur Englisch. Weitere Sprachen sind laut einer anderen Antwort des Gründers "after shipping" geplant.
Warum Funk und keine Kamera? Die Antwort des Gründers ist die hilfreichste technische Aussage der gesamten Vorstellung: "Speech has 40 phonemes, but only about 12 to 15 visemes," was bedeutet, dass viele Laute von außen identisch aussehen (zum Beispiel P und B). Wie es der Gründer formulierte, erreicht kamerabasiertes Lippenlesen eine Fehlerrate, die "too high to be product ready but just low enough to make for a good demo." ist. Die Erfassung von Zunge und weichem Gaumen von innen soll diese Grenze überwinden.
Die genaue Hardware ist nicht öffentlich bekannt. Subvocals Stellenanzeige für Head of Sensing nennt RF-Sensorik, EMG, EEG und mmWave als mögliche technische Ansätze und erklärt: "For competitive and IP reasons, we are not publicly disclosing the exact architecture of our current system yet." Auf Subvocals eigenen Seiten wird das Wort Radar nie verwendet. Dort steht "RF sensing" und "radio waves."
Wie schnell ist Subvocal wirklich?
Subvocal gibt 200+ Wörter pro Minute an. Auf der Startseite heißt es, das Produkt "decodes almost-invisible subtle, silent mouthing into text at 200+ WPM," und diese Zahl wurde in jeder Schlagzeile wiederholt.
Zur Einordnung stellte der Gründer auf Hacker News Tippen und Sprechen gegenüber: "Most people type at 40-50 WPM. Developers can often type at 70-100 WPM. Meanwhile, most people can talk at 120-200 WPM."
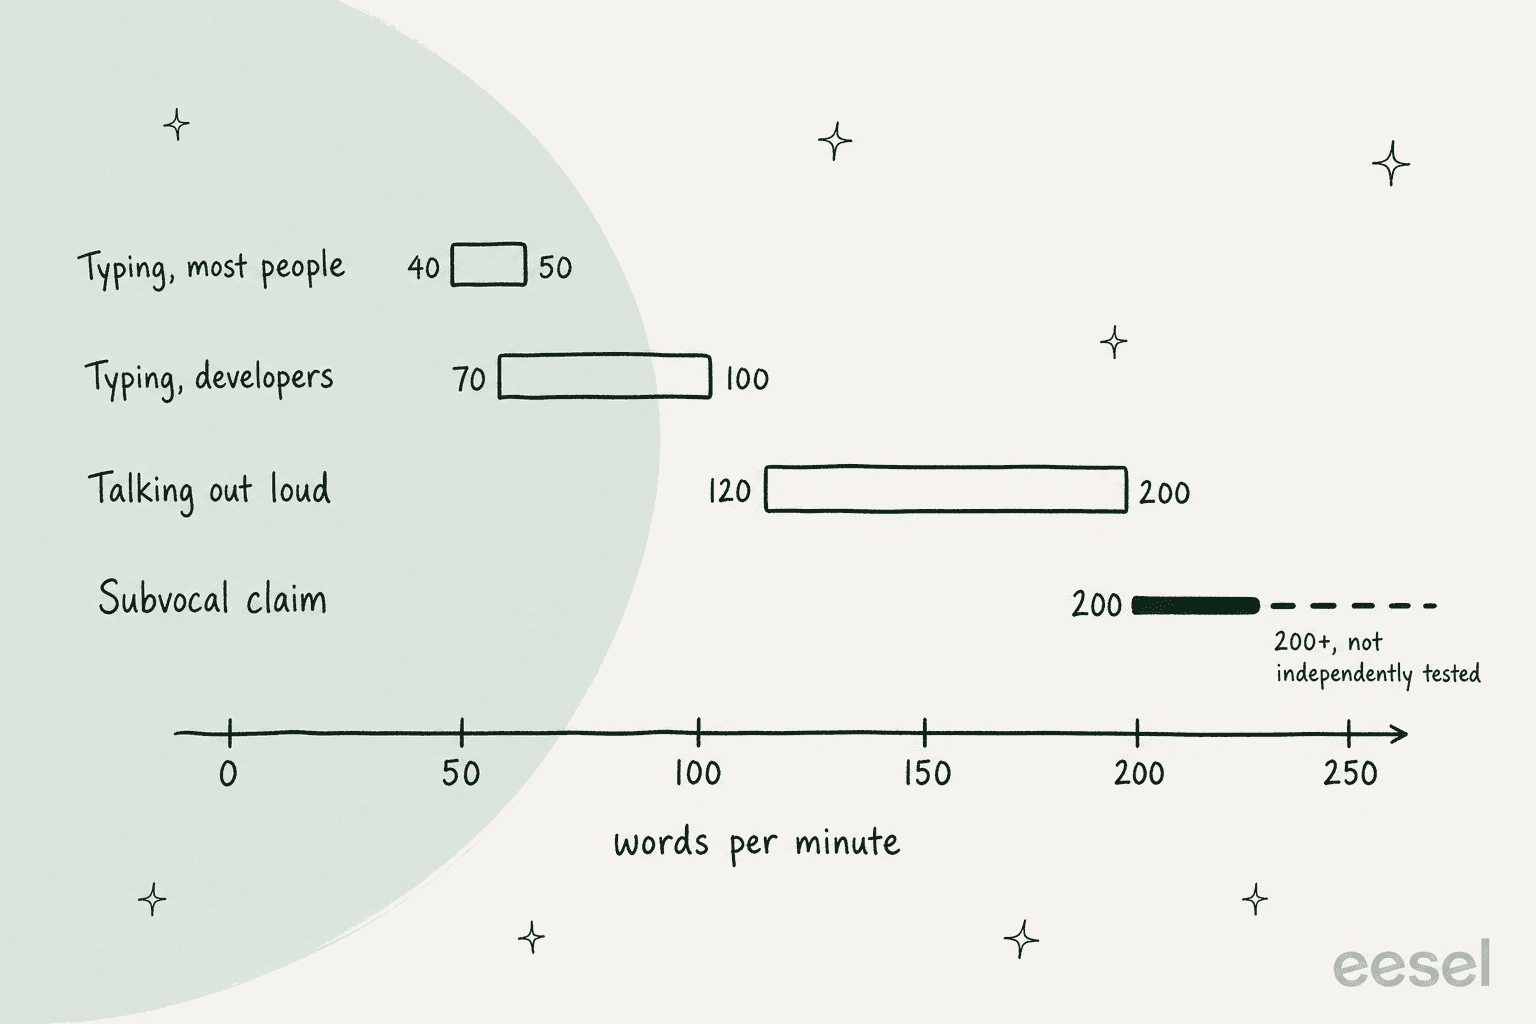
So betrachtet lautet die Behauptung, dass lautloses Formen von Wörtern am oberen Ende normaler Sprechgeschwindigkeit liegt, ein gewagter Anspruch für einen Prototyp. Geschwindigkeit bedeutet außerdem nichts ohne Genauigkeit, und genau da liegt die Lücke. Subvocal hat keine Fehlerrate veröffentlicht. Auf der Startseite steht "it can occasionally get something wrong," und im Vorstellungsbeitrag "a reasonably low error rate even at a small dataset scale." Die einzige kursierende Zahl stammt von einem Zuschauer des Demovideos:
"I am so glad to see an unpolished early look and an honest evaluation of about five percent error rate in the YouTube video."
Das ist die Einschätzung einer einzelnen Person anhand einer einzigen Demo, betrachten Sie sie also als groben Eindruck und nicht als Benchmark. Vergleichen Sie das mit Speech-to-Text-Modellen wie Nemotron 3.5 Transcribe oder Voxtral 3, für die öffentliche, überprüfbare Wortfehlerraten vorliegen.
Im größten Unterthread auf Hacker News ging es gar nicht um Genauigkeit. Sondern darum, ob Sprechen überhaupt für alle schneller ist:
"Do most people talk faster than they can type? It's the opposite for me - I also read aloud slower than I can read in my head."
Meine Einschätzung: Wenn Sie bereits viel mit Wispr Flow oder ChatGPT Voice diktieren, wissen Sie, ob Sprechen für Sie schneller ist. Wenn nicht, wird Subvocal Sie vermutlich nicht dazu bekehren.
Wie viel kostet Subvocal?
Subvocal kostet zum Early-Bird-Preis $499 pro Brille, reservierbar mit einer erstattungsfähigen Anzahlung von $199. Auf der Vorbestellseite stehen die $499 neben durchgestrichenen $699, und der YC-Vorstellungsbeitrag nennt das "a special $200 early bird discount on the final price."
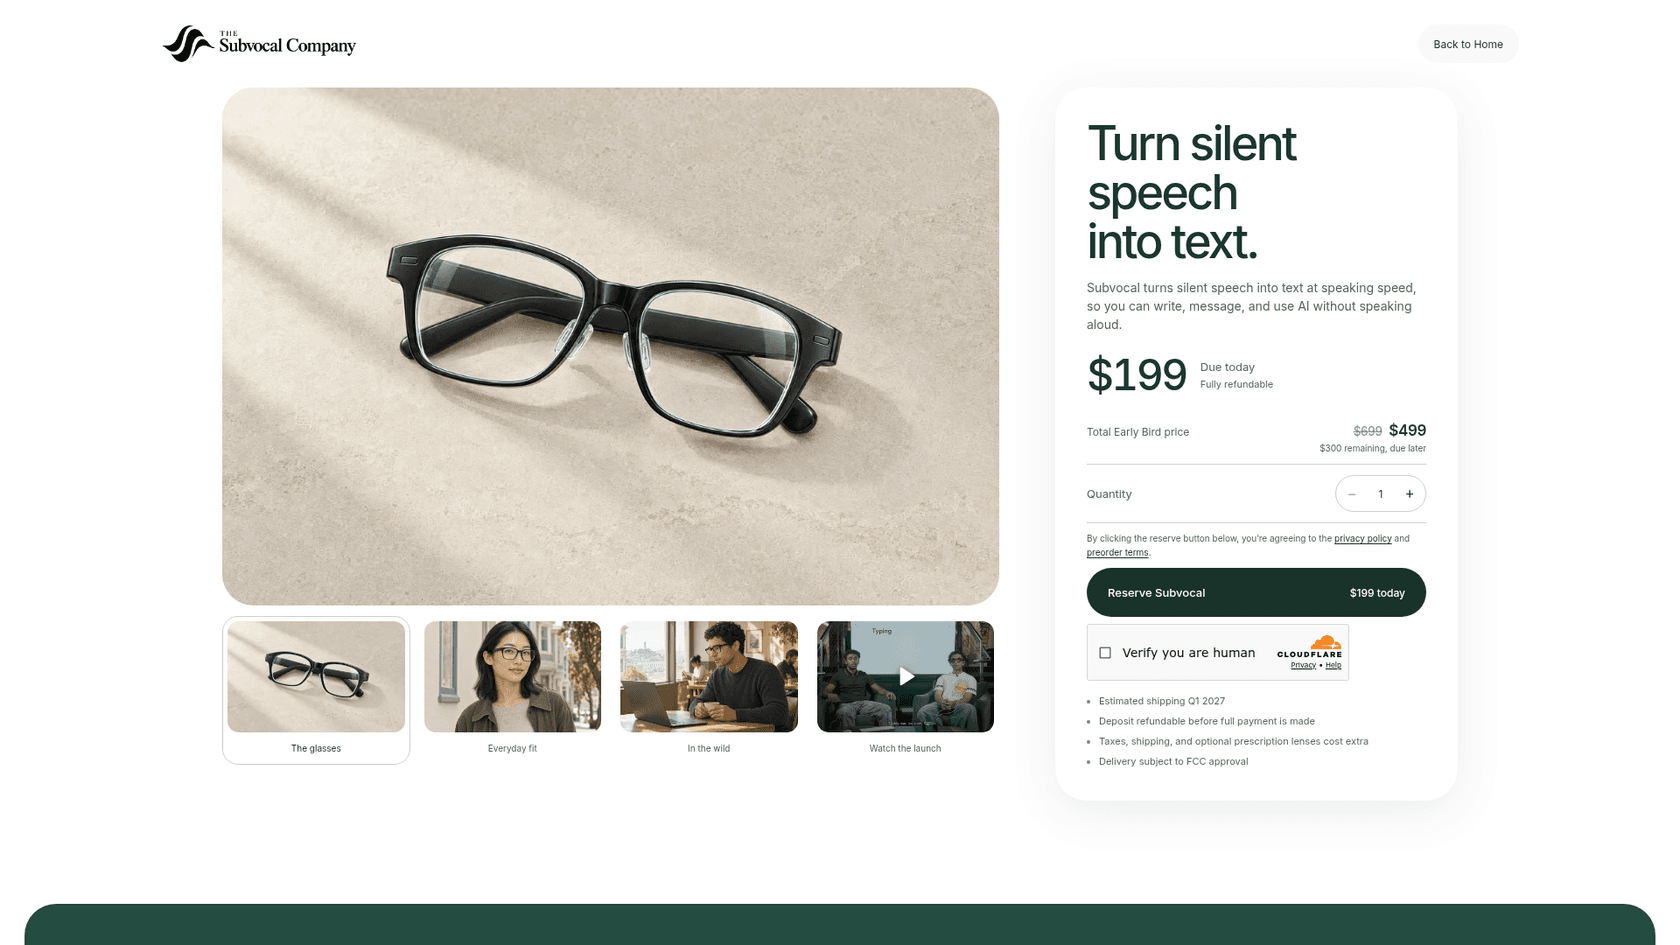
Hier sind sämtliche Zusagen aus den Vorbestellbedingungen:
| Punkt | Was Subvocal sagt |
|---|---|
| Heutige Anzahlung | $199 pro Brille, vor der Schlusszahlung vollständig erstattungsfähig |
| Early-Bird-Preis | $499 pro Brille ($699 durchgestrichen angezeigt) |
| Später fälliger Restbetrag | $300 pro Brille |
| Wie der Restbetrag eingezogen wird | Niemals automatisch. Sie erhalten eine E-Mail und haben 30 Tage Zeit zu zahlen |
| Nicht enthalten | Steuern, Versand, Korrektionsgläser, optionales Zubehör |
| Erstattungen | Jederzeit vor der Schlusszahlung, keine Stornogebühr, innerhalb von 7 Werktagen eingeleitet |
| Empfehlungsgutschrift | $100 Rabatt auf Ihren Restbetrag, wenn 3 Personen über Ihren Link reservieren |
| Voraussichtlicher Versand | Q1 2027, "not a guaranteed delivery date", vorbehaltlich der FCC-Zulassung |
| Wer bestellen kann | Nur US-Lieferadressen, Käufer 18+ |
| Technische Daten | Nicht veröffentlicht. "Final specifications are still being developed" |
| Rückgaberegelung und Garantie | Noch nicht veröffentlicht, werden vor der Schlusszahlung mitgeteilt |
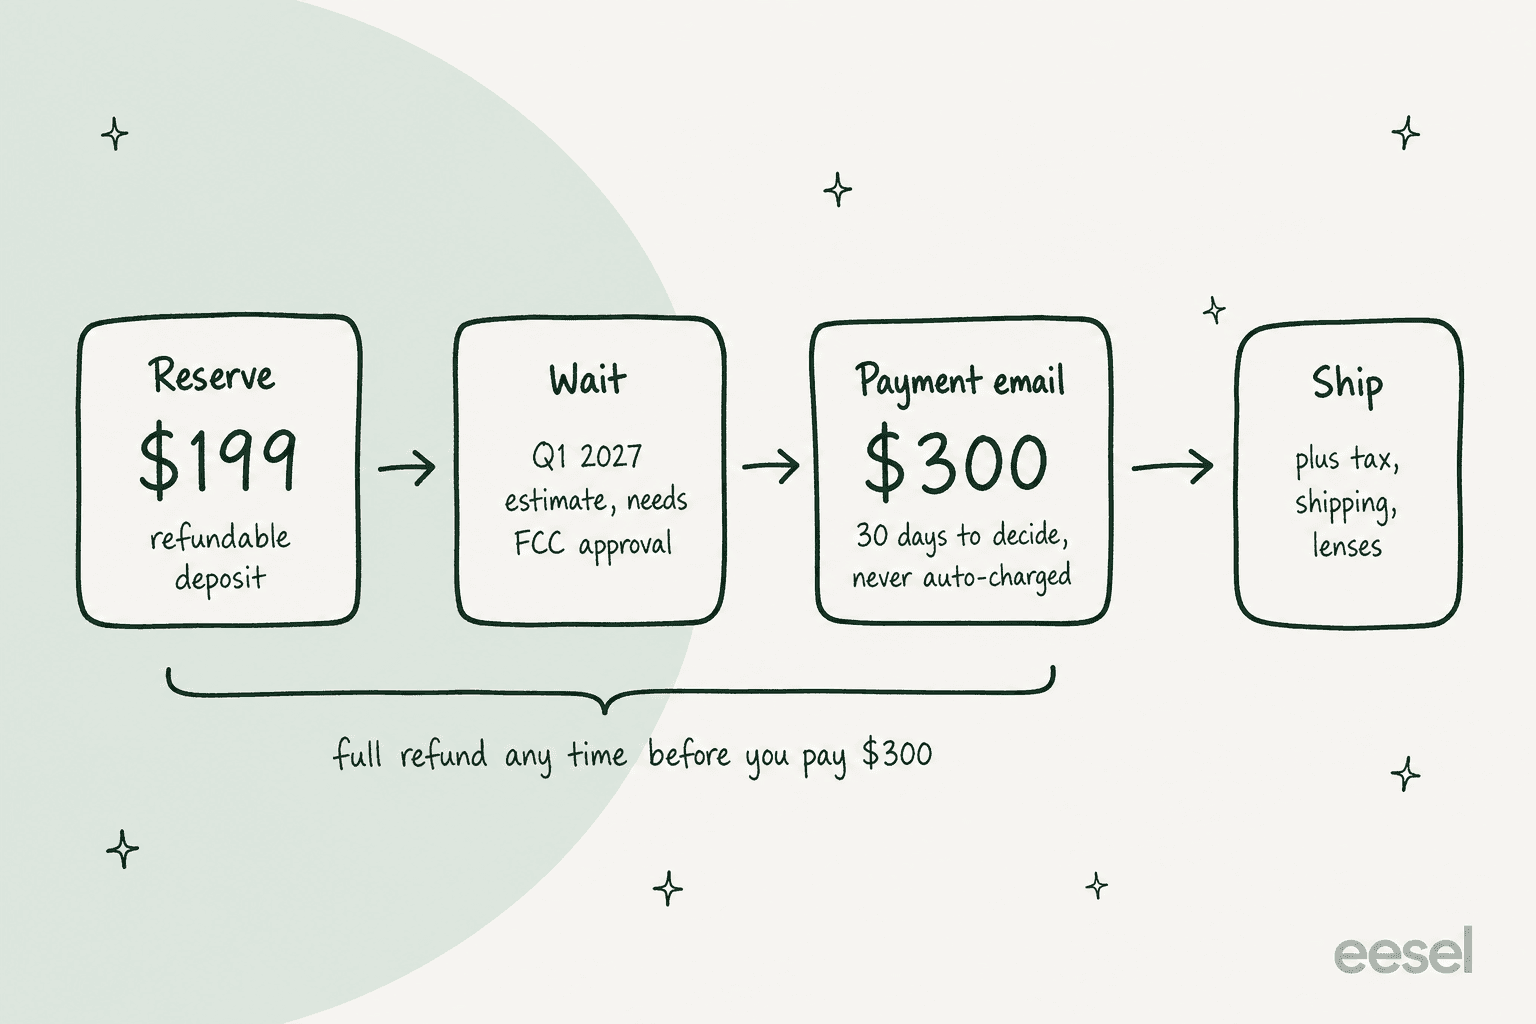
Die Bedingungen sind käuferfreundlicher als die meisten Hardware-Vorbestellbedingungen, die ich gelesen habe. Es wird nichts abgebucht, ohne dass Sie sich für die Zahlung entscheiden, und wenn Subvocal das Produkt wesentlich verändert, können Sie stornieren und Ihre Anzahlung zurückerhalten. Die tatsächlichen Kosten der Reservierung bestehen darin, dass Ihre $199 einige Monate bei einem Startup liegen und Sie darauf setzen, dass das endgültige Produkt der Demo entspricht.
Was auf der Seite fehlt, ist genauso wichtig: keine Akkulaufzeit, kein Gewicht, keine Kompatibilitätsliste. Laut FAQ wird es für "ChatGPT, Claude, Cursor, Slack, email, documents, messaging, and anywhere else you'd normally type," entwickelt, aber das ist ein Ziel und keine getestete Liste.
Wie unterscheidet sich Subvocal von AlterEgo, EchoSpeech und Metas Neural Band?
Subvocal ist nicht das erste Gerät für lautlose Eingabe, und die Antworten nach dem Motto „Das gibt es doch schon“ ließen nicht lange auf sich warten. Der Unterschied besteht darin, dass es auf frei formulierten Text mit einer normal aussehenden Brille abzielt, was derzeit keiner der anderen Anbieter verkauft.
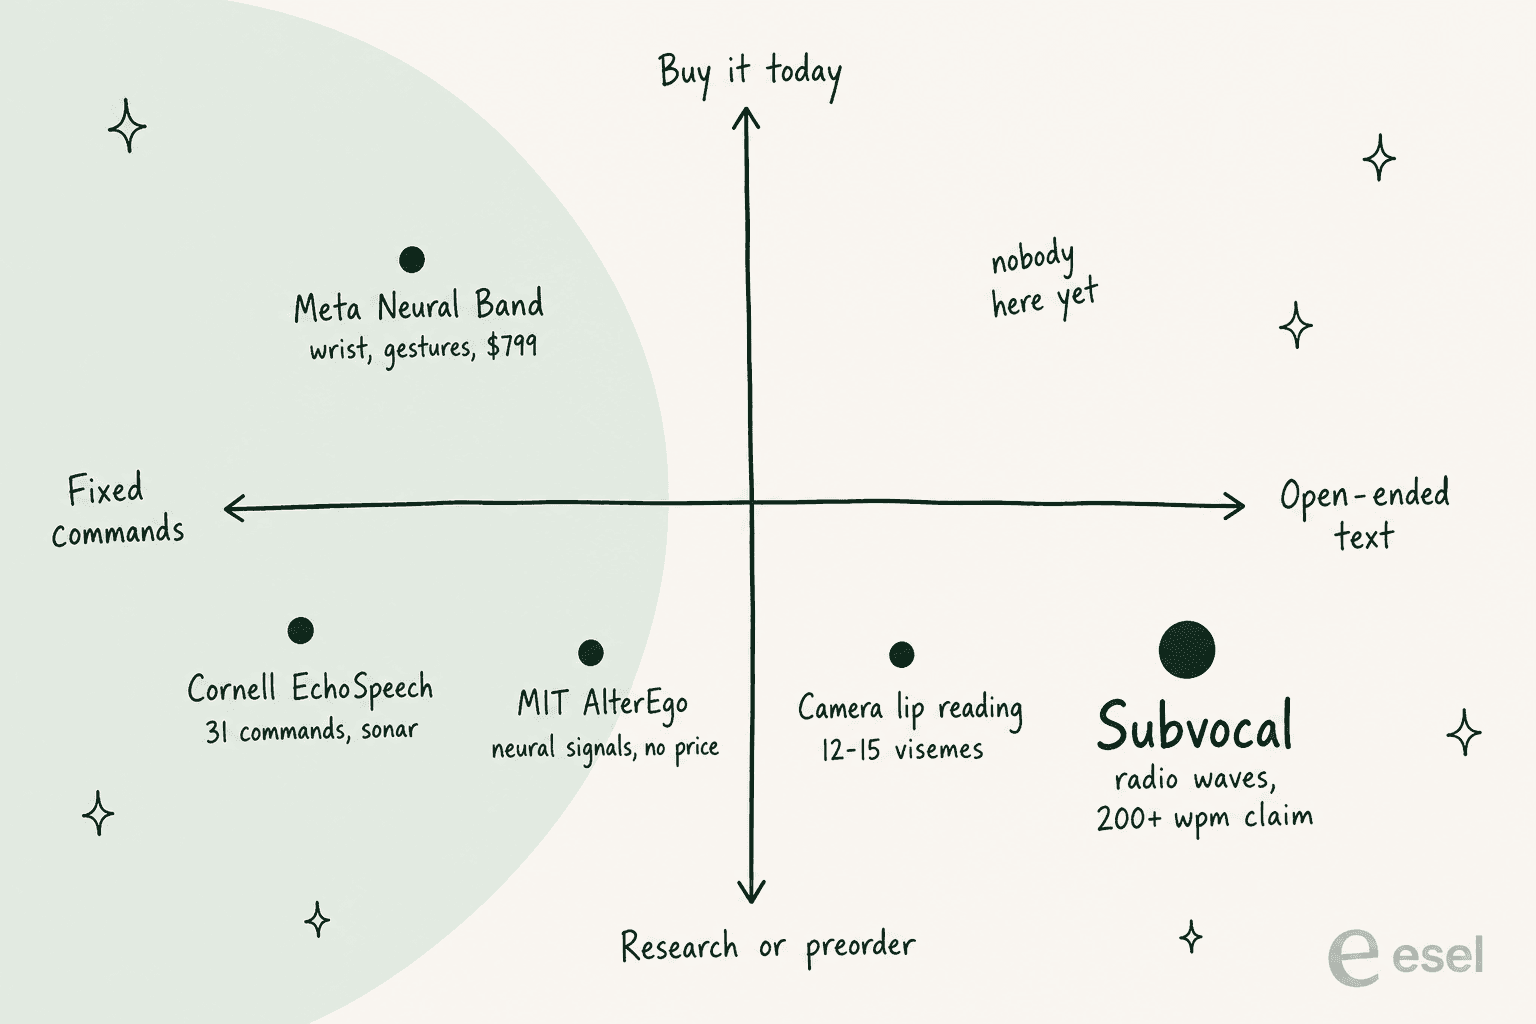
| Produkt | Wie es Signale erfasst | Was es ausgibt | Kann man es kaufen? |
|---|---|---|---|
| Subvocal | Radiowellen durch das Gesicht, ausgehend von einer Brille | Frei formulierter Text, laut Anbieter 200+ Wörter pro Minute | Vorbestellung, $499, voraussichtlich Q1 2027 |
| MIT AlterEgo | Neuronale Signale bei innerer Artikulation | Lautlose Sprache, laut Anbieter ohne sichtbare Bewegung | Nein. Anfang 2025 ausgegründet, auf alterego.io ist nur eine Registrierung möglich |
| Cornell EchoSpeech | Sonar über winzige Lautsprecher und Mikrofone an einer Brille | Bis zu 31 Befehle bei etwa 95 % Genauigkeit | Nein. Forschungsprototyp von 2023 |
| Meta Ray-Ban Display + Neural Band | EMG-Armband, das Fingermuskeln erfasst | Gesten, Handschrifterkennung für später angekündigt | Ja, ab $799 zur Markteinführung |
Der engste Verwandte ist Cornells EchoSpeech, das ebenfalls in einem Brillengestell sitzt und ebenfalls ohne Kamera auskommt. Seine Grenzen sind der Vergleichspunkt: Es erkannte eine feste Auswahl von 31 Befehlen, lief dafür aber ohne Cloud auf dem Smartphone und hielt mit einer Akkuladung etwa 10 Stunden durch.
AlterEgo geht bei der Unauffälligkeit weiter und behauptet, ganz ohne von außen sichtbare Bewegung auszukommen, während Subvocals eigene FAQ sagen, dass jemand aus der Nähe "may notice slight movement." Metas Armband ist das einzige Produkt, das Sie kaufen können, aber es erfasst Ihre Finger, nicht Ihren Mund. Es ist Teil einer breiteren Entwicklung von Metas KI-Produkten hin zu Wearables. Subvocals eigentliche Konkurrenz ist heute also kein anderes Gerät für lautlose Sprache. Es sind Diktiersoftware und Ihre Tastatur.
Was sagen die Leute über Subvocal?
Die Reaktionen gingen in drei Richtungen: Begeisterung bei Menschen, die den ganzen Tag KI diktieren, Zweifel daran, ob das Produkt real ist, und Unbehagen beim Gedanken, es in der Öffentlichkeit zu tragen.
Die Begeisterten sind überwiegend Menschen, die bereits mit Programmieragenten wie Claude Code und Codex sprechen und auf dieselbe Hürde stoßen, die Subvocals Startseite beschreibt: "control your coding agents without annoying your coworker":
"I already dictate a lot of my agent instructions. The problem is that you can't do that in an office or on a plane. This could fix it."
Die Skeptiker hatten zwei Argumente. Eines war, dass die Produktbilder generiert aussehen, woraufhin ein Moderator eingriff, um die beiden Fragen voneinander zu trennen:
"They're taking pre-orders. Obviously the product doesn't exist yet. The tech is real."
Das andere war, dass es sich leicht kopieren lasse. Ein Beitrag von Joe Blau mit der Aussage "I recreated subvocal in 9 minutes with one prompt for AirPods Pro 3" erhielt 10,199 Likes. In einer Antwort des Gründers auf Hacker News sagte Yadav, solche Ansätze führten nur zu etwas wie "a 5 word classifier", was ungefähr auch dem Stand von EchoSpeechs Forschung mit festen Befehlen entspricht.
Dann ist da die menschliche Seite. Wörter lautlos mit dem Mund zu formen klingt einfach, bis man es ausprobiert:
"For the ones thinking this is great, have you actually tried to talk without making sounds? I don't think it is an intuitive action at all and I became self-conscious about not making a sound rather than talking like I normally would."
Auch Datenschutz kam zur Sprache, vor allem weil die Dekodierung in der Cloud läuft:
"Can this be made to work offline, without a cloud server? I wouldn't want my words to be passed through an API"
Und der hoffnungsvollste Thread drehte sich um Barrierefreiheit, von Menschen, denen Tippen oder Sprechen schwerfällt:
"This is also neat thing to have with people struggling with typing (RSI, injuries, disabilities)... people find they're hurting their vocal chords pretty quickly."
Ich denke, für diese letzte Gruppe könnte Subvocal am meisten bewirken. Gleichzeitig ist sie die Gruppe, die am dringendsten eine veröffentlichte Genauigkeitsangabe braucht, bevor sie $499 ausgibt.
Sollten Sie Subvocal vorbestellen?
Bestellen Sie Subvocal vor, wenn Sie täglich KI-Tools diktieren, an einem Ort arbeiten, an dem Sie nicht laut sprechen können, und bereit sind, mindestens bis Q1 2027 zu warten. Die $199 sind erstattungsfähig, bis Sie sich entscheiden, den Rest zu zahlen, Ihr Risiko ist also Zeit, nicht Geld.
Verzichten Sie vorerst darauf, wenn:
- Es vom ersten Tag an funktionieren muss. Weder technische Daten noch Garantiebedingungen noch eine Genauigkeitsangabe sind bislang öffentlich.
- Sie außerhalb der USA leben. Kostenpflichtige Vorbestellungen sind nur in den USA möglich.
- Sie mit sensiblen Texten arbeiten. Es braucht die Cloud, und die Datenschutzhinweise zu Sensordaten wurden noch nicht veröffentlicht. Die aktuelle Datenschutzerklärung deckt nur die Website und Vorbestellungen ab.
- Sie bisher nicht diktieren. Probieren Sie zuerst eine kostenlose Diktierfunktion oder Wispr Flow aus. Wenn lautes Sprechen Sie nicht schneller macht, wird lautloses Sprechen es auch nicht tun.
Hardware von einem dreiköpfigen Team hat einen langen Weg von der Demo bis ins Verkaufsregal vor sich, wie frühere KI-Geräte wie der Rabbit R1 gezeigt haben. Subvocals Bedingungen sind zumindest so formuliert, dass Sie Ihre Anzahlung zurückbekommen und aussteigen können, wenn dieser Weg länger wird.
Ist Tippgeschwindigkeit für Support-Teams wichtig?
Weniger, als Sie denken würden. Subvocal ist eine schnellere Möglichkeit, Wörter in einen Computer einzugeben, und die Gründer stellen es in den Kontext des Wandels hin zu KI-Agenten, bei dem "our job moves upstream, to structured and detailed prompting." Nennen Sie es Prompt Engineering unter anderem Namen. Das ist eine nachvollziehbare Einschätzung dazu, wohin sich Wissensarbeit entwickelt. Für einen Support-Mitarbeiter ist Tippen allerdings nicht der langsame Teil einer Antwort. Das Suchen nach der Bestellung, der Richtlinie und dem letzten Gespräch ist es, und genau das treibt die durchschnittliche Bearbeitungszeit nach oben.
Diese Lücke füllt ein KI-Helpdesk-Teammitglied. Es funktioniert wie Agent Assist, nur einen Schritt weitergedacht: Es recherchiert und schreibt den Entwurf, bevor ein Mensch das Ticket öffnet. Lesson Pro, eine Gruppe von Marken für Privatunterricht auf Zendesk, setzt eesel so ein: In einem Monat bearbeitete es etwa 1,900 Tickets, hinterließ rund 1,700 interne Notizen mit Kontext und nächsten Schritten und entwarf etwa 560 Antworten, die ein Mensch freigeben und versenden konnte. Niemand in diesem Team muss 200 Wörter pro Minute tippen, denn der erste Entwurf ist bereits geschrieben.
Dasselbe Muster zeigt sich auch außerhalb des Supports. SamCart setzt einen eesel-Agenten für Freshdesk-Tickets und einen weiteren im Website-Chat ein, die jeweils auf Basis der 280 Helpcenter-Artikel antworten. Wenn Sie die umfassendere Idee interessiert, erfahren Sie hier, wie sich KI-Teammitglieder von Tools unterscheiden, die Sie selbst bedienen müssen, und was ein KI-Mitarbeiter im Alltag tatsächlich tut.
Und wenn Ihnen Subvocals Vision gefällt, mit Programmieragenten zu sprechen, bietet eesel eine CLI, die genau für diese Art von Nutzer entwickelt wurde. Sie bringt dasselbe eesel-Teammitglied in Ihr Terminal: Sie können mit ihm chatten, Ihren Helpdesk verbinden, Wissen hochladen, Automatisierungen einrichten und zurückgehaltene Aktionen freigeben, ohne das Dashboard zu öffnen. Jeder Befehl gibt JSON aus, sodass ein Programmieragent wie Claude Code, Cursor oder Codex die gesamte Einrichtung für Sie übernehmen kann. Alles, was dort eingerichtet wird, erscheint auch im Dashboard. Ob Sie die Anweisung tippen, aussprechen oder eines Tages lautlos mit dem Mund formen, die Arbeit landet bei einem Teammitglied, das Ihr Helpcenter bereits kennt.
Testen Sie eesel
Subvocal macht das Schreiben schneller. eesel reduziert, wie viel Ihr Team schreiben muss. Sein KI-Helpdesk-Teammitglied lässt sich in Zendesk, Freshdesk und andere Helpdesks einbinden, lernt aus Ihren bisherigen Tickets und Ihrem Helpcenter und entwirft oder versendet Antworten, je nachdem, wie viel Sie ihm zutrauen. Sie können es anhand Ihrer eigenen historischen Tickets simulieren, bevor es mit einem echten Kunden in Kontakt kommt. Testen Sie eesel kostenlos und sehen Sie, wie viele Ihrer Antworten es geschrieben hätte.
