

MAI Code 2 ist Microsofts neues Coding-Modell innerhalb von GitHub Copilot, zum Preis von $0.50/$2.50 pro Million Token bis zum 17. Mai 2027. Microsofts eigene Tests ergeben 98 % von GPT-6.1 Sols Punktzahl bei 40 % der Kosten pro Aufgabe, aber diese Kostenangabe nutzt den Promo-Preis. Zum Listenpreis von $1/$5 kosten dieselben Aufgaben etwa 81 % von dem, was Sol verlangt.
Es ist also heute eine gute Standardwahl für routinemäßige Multi-File-Arbeit in Copilot. Behalten Sie ein größeres Modell für lange, schwere Repo-Aufgaben, wo es gegenüber Claude Opus 5.5 bei SWE Atlas um 14 Punkte zurückliegt.
Was ist MAI Code 2?
MAI Code 2 ist ein Coding-Modell, das Microsoft AI von Grund auf trainiert und am 17. November 2026 auf der Ignite vorgestellt hat. Der Launch-Beitrag positioniert es für „alltägliche Enterprise-Coding-Aufgaben" und sagt, es „glänzt beim Produktionsreifmachen von Code, tiefem Debugging, Implementierungen über mehrere Dateien, repo-weitem Reasoning und UI". Ein kleinerer Geschwister-Release, MAI Code 2 Flash, erschien am selben Tag für routinemäßige, hochvolumige Änderungen.
Es ist die zweite Generation von Microsofts eigener Coding-Modellreihe. MAI-Code-1-Flash kam im Juni in GitHub Copilot, und MAI Code 1.1 Flash folgte im August. Der Sprung dieses Mal betrifft Größe und Umfang. Laut der Model Card erhalten beide neuen Modelle ein Kontextfenster von 1.050.000 Token (922.000 Eingabe, 128.000 Ausgabe) und fünf Reasoning-Effort-Stufen, von niedrig bis maximal.
Ich bin Engineer bei eesel, und mein Alltag dreht sich meist um Integrationen und API-Arbeit, also lebe ich in einem Editor mit einem KI-Modell im Seitenpanel. Ich arbeite außerdem an eesels KI-Agenten, die auf echten Support-Warteschlangen laufen, und mit der eesel CLI kann ein Coding-Agent in genau diesem Editor freigegebene Hilfeartikel zu einem eesel-Agenten hochladen, dessen Anweisungen anpassen und Testfragen durchspielen, bevor irgendetwas live geht. Wenn also ein neues Coding-Modell erscheint, ist die Frage, die mich interessiert, einfach: Was kostet eine normale Aufgabe, und wo bricht es ab?
Was ist der Unterschied zwischen MAI Code 2 und MAI Code 2 Flash?
Die beiden Modelle teilen die Arbeit nach Schwierigkeitsgrad auf. Microsofts GitHub-Changelog beschreibt MAI Code 2 als Allzweckmodell, „ideal für komplexe Aufgaben wie tiefes Debugging, Implementierungen über mehrere Dateien, Refactoring und repo-weites Reasoning". Flash sei „ein leichtgewichtiges, kosteneffizientes Coding-Modell, optimiert für den alltäglichen Entwicklungsalltag".
| MAI Code 2 | MAI Code 2 Flash | |
|---|---|---|
| Gebaut für | Änderungen über mehrere Dateien, tiefes Debugging, repo-weites Reasoning | Schnelle Änderungen, Code-Erklärungen, routinemäßige Fixes |
| Aktive Parameter | 77 Milliarden (insgesamt etwa 2,8 Billionen) | 12 Milliarden (insgesamt etwa 398 Milliarden) |
| Kontextfenster | 1.050.000 Token | 1.050.000 Token |
| Promo-Preis pro 1 Mio. Token (Eingabe/Ausgabe) | $0.50 / $2.50 | $0.05 / $0.25 |
| Copilot-Pläne | Pro, Pro+, Max, Business, Enterprise | Gleich, plus Free und Student |
| Microsoft Foundry | Noch nicht | Preview mit beschränktem Zugang |
| Microsofts Vergleich | GPT-6.1 Sol, Claude Opus 5.5 | GPT-6 Luna, Claude Haiku 5.5 |
Die Parameterzahlen stammen aus Abschnitt 1 der Model Card. Die Zusammenfassungstabelle der Karte selbst nennt „80B aktiv" für MAI Code 2, behandeln Sie die genaue Zahl also als ungefähr. In jedem Fall sind beide sparse Mixture-of-Experts-Modelle, was bedeutet, dass nur ein Teil des Netzwerks pro Token läuft. Dieses Design hilft, den Preis niedrig zu halten.
Eine Sache, die ich nicht erwartet hätte: Flash schlägt sein großes Geschwistermodell bei einem Benchmark. Bei SWE Atlas erreicht Flash 44,8 % gegenüber 43,1 % bei MAI Code 2, laut dem Launch-Beitrag. Es ist eine kleine Lücke, aber sie zeigt, dass der Vorsprung des größeren Modells nicht durchgängig ist.
Wie viel kostet MAI Code 2?
In GitHub Copilot kostet MAI Code 2 $0.50 pro Million Input-Token und $2.50 pro Million Output-Token, bis zum 17. Mai 2027. Danach verdoppelt sich der Preis auf $1.00 und $5.00, laut GitHubs Preis-Dokumentation. Copilot rechnet das in AI-Credits ab, wobei ein Credit einem Cent entspricht.
| Modell | Input (pro 1 Mio.) | Cached Input (pro 1 Mio.) | Output (pro 1 Mio.) |
|---|---|---|---|
| MAI Code 2, Promo bis 17. Mai 2027 | $0.50 | $0.025 | $2.50 |
| MAI Code 2, ab 17. Mai 2027 | $1.00 | $0.05 | $5.00 |
| MAI Code 2 Flash, Promo | $0.05 | $0.005 | $0.25 |
| MAI Code 2 Flash, ab 17. Mai 2027 | $0.10 | $0.01 | $0.50 |
| GPT-6.1 Sol (bis 272K) | $2.00 | $0.10 | $10.00 |
| GPT-6.2 Sol (bis 272K) | $2.00 | $0.10 | $10.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| GPT-6 Luna (bis 272K) | $0.10 | $0.01 | $0.50 |
| Claude Haiku 5.5 (bis 100K) | $0.10 | $0.01 | $0.50 |
Alle Zeilen stammen von derselben GitHub-Seite. Wer einen jährlichen Copilot Pro- oder Pro+-Plan hat, der noch auf der alten anfragebasierten Abrechnung läuft, findet die Legacy-Multiplikatoren: 1x für MAI Code 2 und 0.33x für Flash. Die vollständige Planübersicht steht im Leitfaden zu GitHub-Copilot-Preisen.
Was kostet eine Coding-Aufgabe wirklich?
Preise pro Token sind nur die halbe Rechnung. Die andere Hälfte ist, wie viele Token ein Modell verbraucht, um eine Aufgabe abzuschließen, und Microsoft hat auch das veröffentlicht. Bei maximalem Reasoning-Effort, gemittelt über vier Benchmarks, listet der Launch-Beitrag diese Kosten pro Aufgabe:
| Modell | Durchschnittliche Erfolgsquote | Kosten pro Aufgabe (Microsoft) | Kosten pro Aufgabe zum Listenpreis (eigene Rechnung) |
|---|---|---|---|
| MAI Code 2 | 63,2 % | $0.309 (Promo-Preis) | $0.618 |
| GPT-6.1 Sol | 64,1 % | $0.761 | $0.761 |
| Claude Opus 5.5 | 65,3 % | $6.306 | $6.306 |
| MAI Code 2 Flash | 61,0 % | $0.052 (Promo-Preis) | $0.104 |
| GPT-6 Luna | 55,1 % | $0.080 | $0.080 |
| Claude Haiku 5.5 | 53,9 % | $0.319 | $0.319 |
Die Flash-Zeilen sind über drei Benchmarks gemittelt, nicht vier, da Microsofts Tabelle für das kleine Modell FrontierCode auslässt. Meine Spalte zum Listenpreis verdoppelt einfach Microsofts Zahl, weil sich jeder MAI-Preis am 17. Mai 2027 verdoppelt und die Token-Zahl pro Aufgabe gleich bleibt.
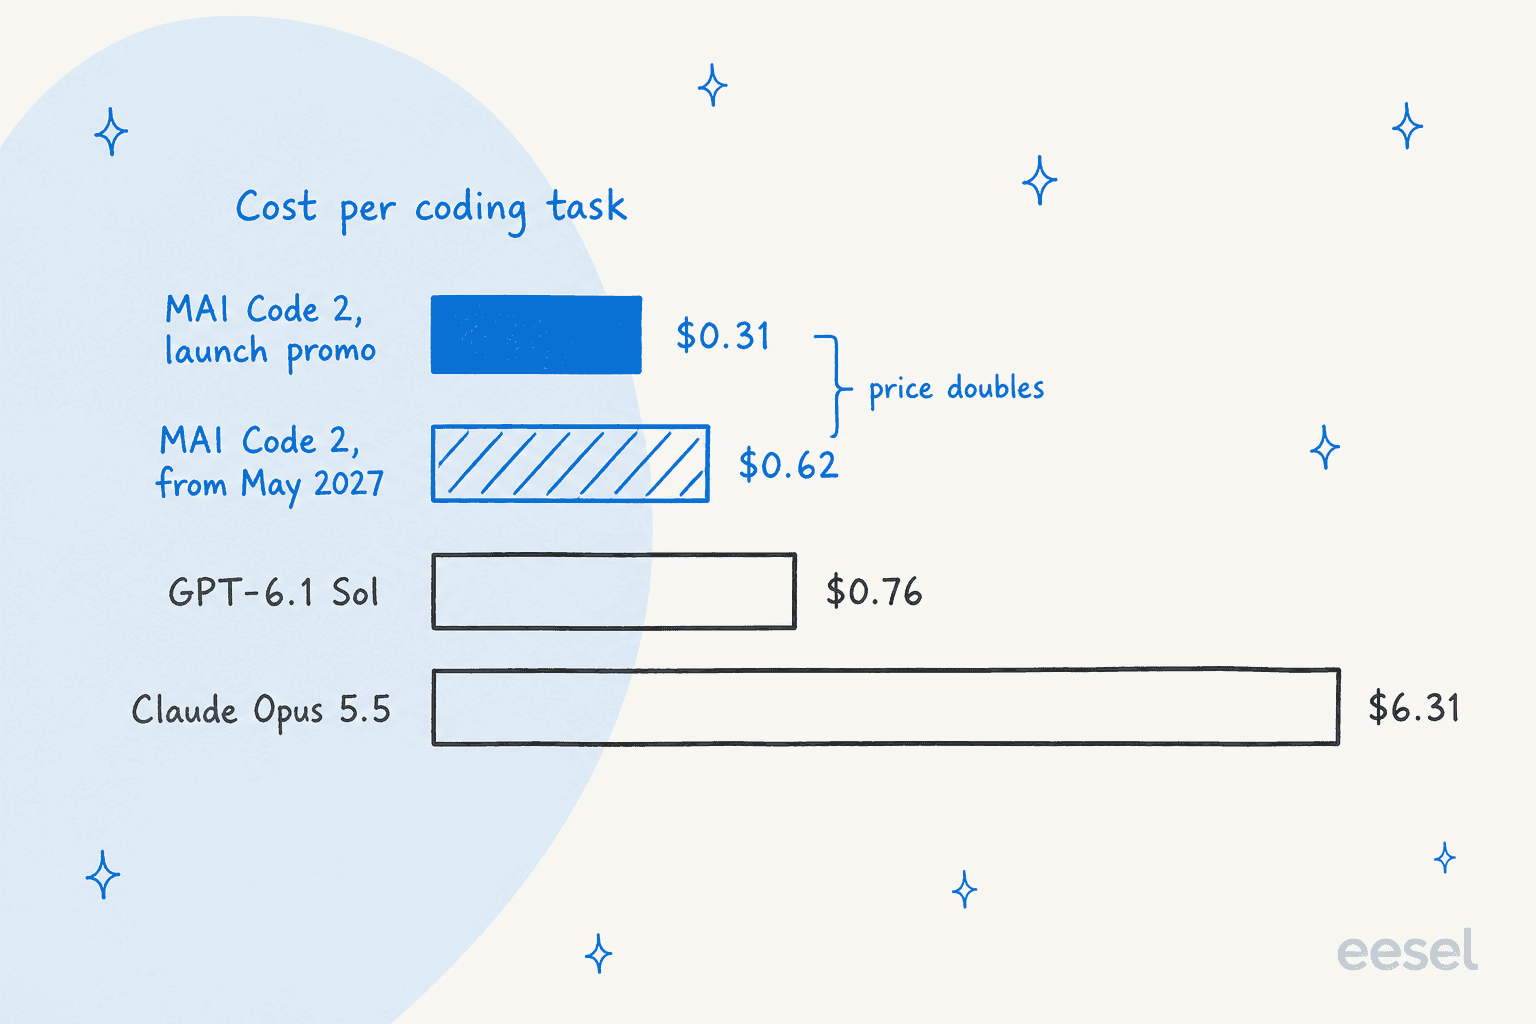
Das ist der Teil, den die meiste Launch-Berichterstattung auslässt. MAI Code 2s Preis pro Token liegt während der Promo bei einem Viertel von GPT-6.1 Sol, aber seine Kosten pro Aufgabe liegen bei 40 % von Sol. Diese Lücke bedeutet, dass MAI Code 2 in Microsofts eigenen Durchläufen etwa 1,6-mal so viele Token pro Aufgabe verbraucht hat wie Sol. Sobald die Promo endet, frisst dieser Token-Appetit den Großteil des Rabatts auf, und aus der „40 % der Kosten"-Schlagzeile werden etwa 81 %.
Ein Kommentator auf Hacker News stellte die naheliegende Frage zur Promo:
"The promotional period lasts until May 2027. Why not just make the price lower if they'll be irrelevant by the time the "real" price kicks in?"

Ein fairer Punkt. Sechs Monate sind in diesem Markt eine lange Zeit, und das Modell, mit dem man im Mai 2027 vergleicht, wird wahrscheinlich nicht mehr GPT-6.1 Sol sein.
Halten die MAI-Code-2-Benchmarks stand?
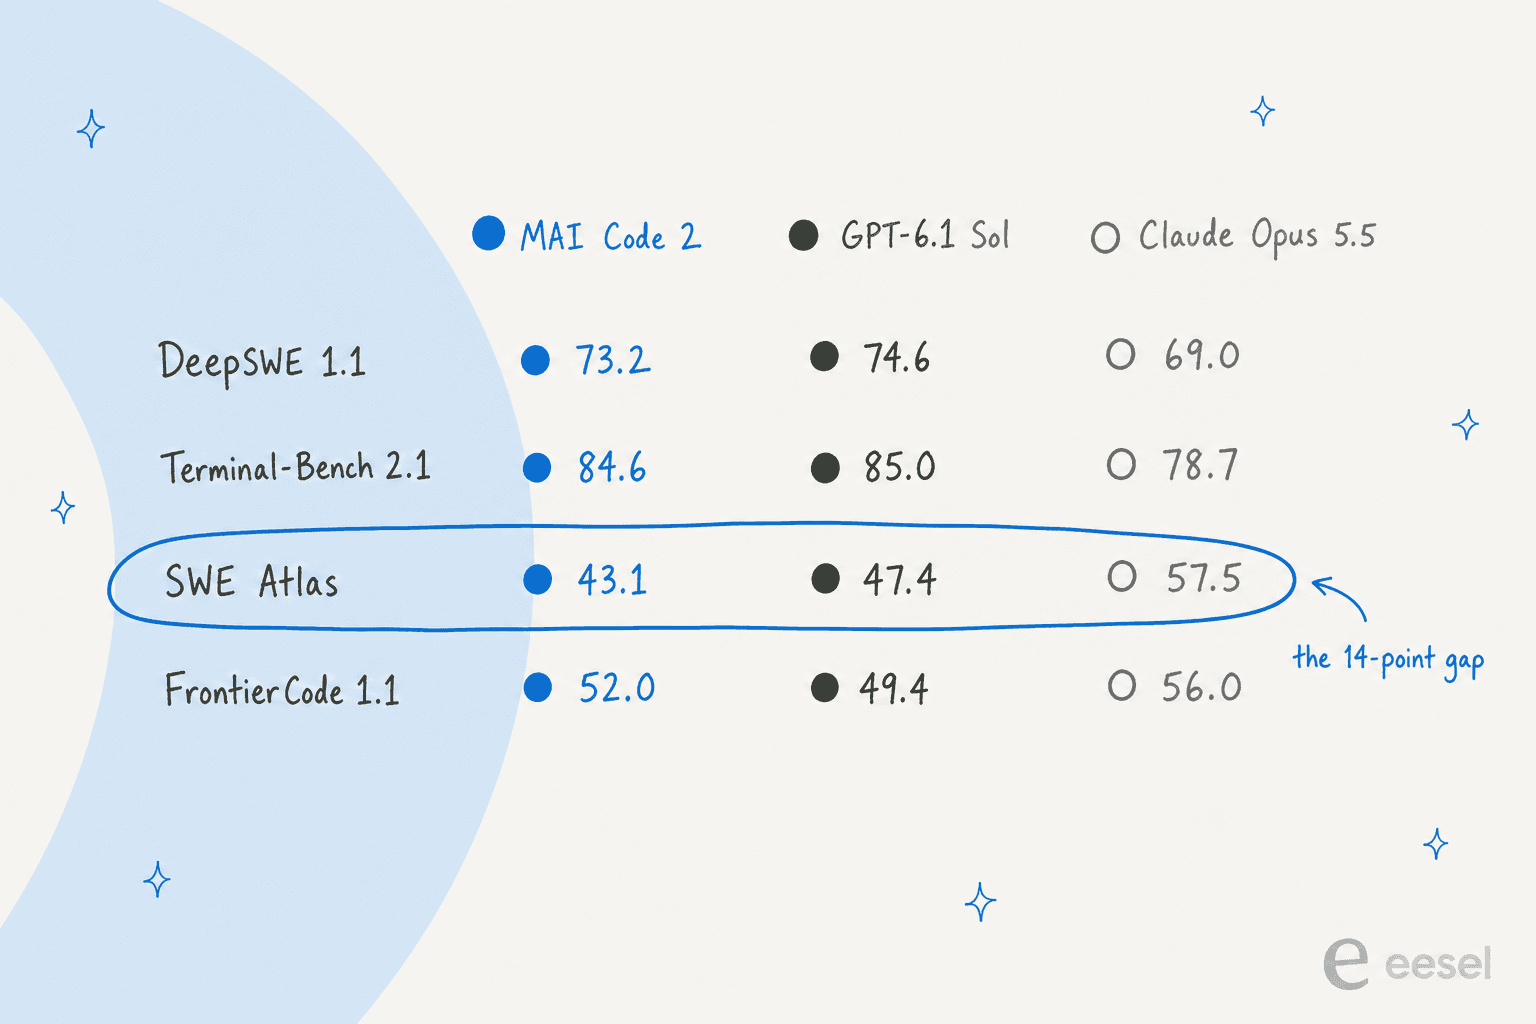
Größtenteils, mit drei Vorbehalten, die man kennen sollte, bevor man der 98-%-Schlagzeile vertraut. Hier ist Microsofts vollständige Tabelle, alle bei maximalem Reasoning-Effort, aus dem Launch-Beitrag:
| Benchmark | MAI Code 2 | GPT-6.1 Sol | Claude Opus 5.5 | Wer hat ihn ausgeführt |
|---|---|---|---|---|
| DeepSWE 1.1 | 73,2 % | 74,6 % | 69,0 % | Microsoft |
| Terminal-Bench 2.1 | 84,6 % | 85,0 % | 78,7 % | Microsoft |
| SWE Atlas | 43,1 % | 47,4 % | 57,5 % | Microsoft |
| FrontierCode v1.1 | 52,0 % | 49,4 % | 56,0 % | Artificial Analysis |
| Durchschnitt | 63,2 % | 64,1 % | 65,3 % |
Vorbehalt 1: Microsoft hat drei der vier Tests selbst ausgeführt. DeepSWE, Terminal-Bench und SWE Atlas liefen auf MSBench, Microsofts interner Evaluationsplattform, über die Copilot CLI ohne Subagenten. Nur FrontierCode kam von einer externen Partei. Das macht die Zahlen nicht falsch, aber niemand Unabhängiger hat sie bisher nachgerechnet. Als ich am 18. November nachsah, hatte Artificial Analysis noch keine Modellseite für MAI Code 2.
Vorbehalt 2: Der Durchschnitt verdeckt eine echte Lücke. MAI Code 2 schlägt Opus 5.5 bei DeepSWE und Terminal-Bench. Bei SWE Atlas erreicht es 43,1 % gegenüber 57,5 % bei Opus, eine Lücke von 14,4 Punkten. Wenn Ihre Arbeit nach langen, weitläufigen Repo-Änderungen aussieht, zählt diese Zeile mehr als der Durchschnitt.
Vorbehalt 3: Die Vergleiche sind etwas veraltet. Microsoft hat gegen GPT-6.1 Sol verglichen, am selben Tag, an dem OpenAI GPT-6.2 Sol veröffentlichte. Der Leitfaden zu GPT-6.2 Sol deckt diese Veröffentlichung ab. Hacker News hat es bemerkt:
"They are comparing to Sol 6.1's API prices. With Sol 6.2, and especially if you consider subsidization from Codex subscriptions, it's probably no longer on the Pareto frontier."
Andere wiesen auf die Benchmark-Versionen hin. Ein Kommentator merkte an, dass Terminal-Bench „derzeit bei 4 steht (was deutlich schwerer ist)" und FrontierCode „bei 2.0", während Microsoft 2.1 und 1.1 angab. Alle drei Modelle wurden auf denselben Versionen getestet, die Rangfolge bleibt also bestehen, aber die absoluten Zahlen werden auf den neueren Tests niedriger aussehen.
Ein Ergebnis würde ich für bare Münze nehmen: Bei Frontend-Arbeit bevorzugten blinde Prüfer MAI Code 2s Ausgabe gegenüber GPT-6 Sol in 64 % der Fälle, über 258 Prüfer hinweg. UI-Qualität lässt sich mit einer Wahl des Benchmarks schwer fälschen, und es ist genau die Art von Alltagsaufgabe, für die Microsoft es gebaut haben will.
Wie bekommt man Zugang zu MAI Code 2?
Derzeit nur über GitHub Copilot und sonst nirgends. Beide Modelle sind allgemein verfügbar, nicht in Preview, laut dem GitHub-Changelog.
- Pläne: MAI Code 2 steht auf Copilot Pro, Pro+, Max, Business und Enterprise. Flash kommt zusätzlich auf Free und Student, aber diese Pläne erreichen es nur über die automatische Modellauswahl.
- Wo: der Modell-Picker in VS Code, Visual Studio, JetBrains, Xcode, Eclipse, der Copilot CLI, dem Cloud-Agenten, der Copilot-App, github.com und GitHub Mobile.
- Admins: Auf Business und Enterprise sind neue Modelle standardmäßig aktiviert, sofern ein Admin die globale Standardeinstellung nicht abgeschaltet hat. Das ist eine Änderung gegenüber MAI Code 1.1 Flash, das im August standardmäßig deaktiviert war.
- API: Nur Flash steht in Microsoft Foundry, als Preview mit beschränktem Zugang und ohne veröffentlichten Preis. MAI Code 2 selbst ist dort nicht verfügbar.
- Demnächst: Microsoft nennt OpenRouter, Vercel, Hermes, Open Code und Kilo, ohne Termine.
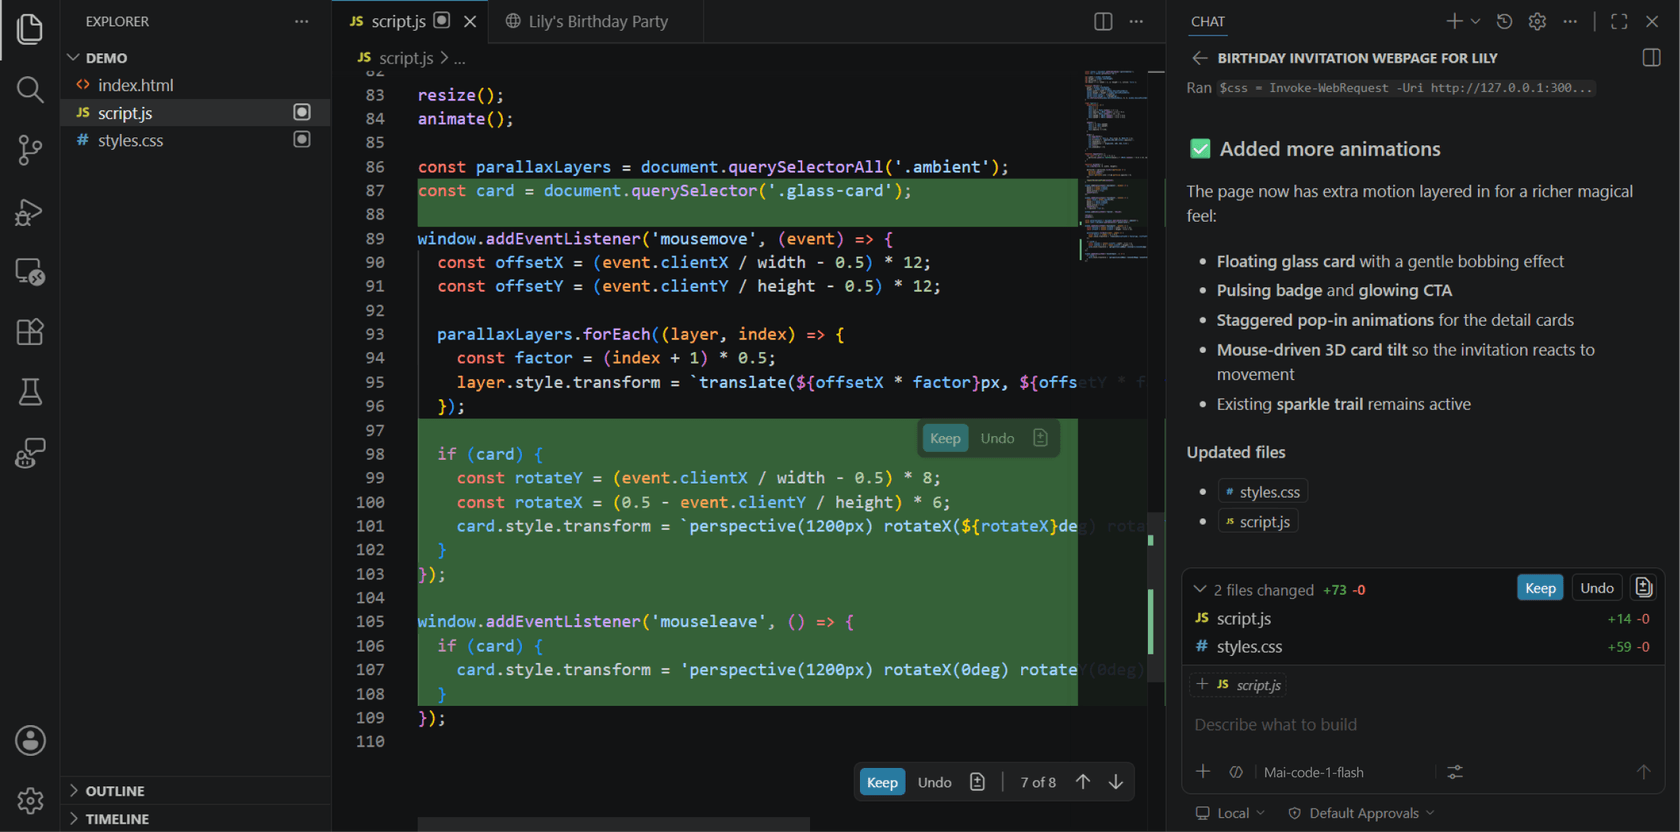
Dieser Screenshot stammt vom früheren MAI-Code-1-Flash-Launch, aber der Ablauf ist für MAI Code 2 derselbe: Copilot-Chat öffnen, das Modell unten auswählen und wie gewohnt arbeiten. Wenn Sie Admin sind, prüfen Sie jetzt Ihre Modell-Policy. Ein Modell, das Ihr Team nicht geprüft hat und das standardmäßig auftaucht, ist einen fünfminütigen Blick wert.
Der Zugang ist die Schwachstelle für alle außerhalb von Copilot. Wer auf rohen APIs baut oder in Claude Code oder OpenAI Codex lebt, kann MAI Code 2 noch nicht einbinden. Ein Hacker-News-Nutzer brachte den Frust auf den Punkt:
"What annoys me a lot about MSFT releases are, that is not possible to find how to use these models and where to try them. I didn't hear anyone in my circle using MAI models, none."
Ist MAI Code 2 Open Source?
Nein. Die Model Card sagt, „die Modellgewichte werden nicht verteilt, und die Modelle laufen auf Microsoft-Azure-GPU-Infrastruktur". Manche frühen Berichte nannten es ein kleines Open-Weights-Modell unter einer MIT-Lizenz. Das scheint vom microsoft/MAI-Code-Repo zu kommen, das MIT-lizenziert ist, aber nur ein README und Issue-Vorlagen für Feedback enthält.
Für Unternehmen, die Kontrolle über die Gewichte wollen, hat Microsoft am selben Tag MAI Licensed Weights angekündigt. Es erlaubt einem Unternehmen, MAI-Modelle in seiner eigenen Azure-Umgebung zu betreiben und feinabzustimmen, und ist „demnächst verfügbar" über Microsoft-Account-Teams. Die Partnerzitate auf der Modellseite stammen aus diesem Weg. AT&T gibt an, seine angepasste Version von Flash habe GPT-6.1 Sol bei Standard-5G-Netzwerkanalyse übertroffen, „bei 50-mal geringeren Kosten", laut der Modellseite. Das sind aber abgestimmte Modelle, nicht das, was Sie in Copilot auswählen werden.
Was sagen Entwickler zu MAI Code 2?
Der Launch-Thread auf Hacker News erreichte 278 Punkte und 131 Kommentare an einem Tag. Der meiste Wirbel drehte sich um Benchmarks und Abrechnung, nicht um das Modell selbst, da fast niemand bereits echte Zeit damit verbracht hatte.
Die häufigste Beschwerde galt dem Vergleichsaufbau:
"While showing MAI Code 2 at a 50% promotional discount, and comparing to Max reasoning effort for Opus 5.5 and 6.1 Sol..."
Die zweite galt Copilots Abrechnung. Seit GitHub im Juni auf nutzungsbasierte Abrechnung umgestellt hat, hilft ein günstiges Modell nur, wenn Ihre Credits auch reichen:
"I think they won't help if they're billed at the announced rate on your Copilot quota. Microsoft would need to do something like Devin does and offer its own models with separate limits."
Das Interesse war aber real, vor allem bei Leuten, die Modellwahl bereits als Kostenhebel behandeln:
"Price and performance look good based on benchmarks. Am definitely interested in trying this to see given a lot of my workload of actual coding is handed over to Haiku/Luna right now."
Dieser letzte Kommentar deckt sich mit meiner Einschätzung. Am meisten profitieren diejenigen, die Modellwahl bereits als Kostenhebel behandeln. Wer zwischen Copilot, Cursor und einem Terminal-Coding-Tool abwägt, hat mit MAI Code 2 einen Grund, sich Copilot noch einmal anzusehen, aber keinen Grund, allein deswegen zu wechseln.
Worauf sollten Sie achten?
Microsoft ist ungewöhnlich offen über die Grenzen, was ich zu schätzen weiß. Der Launch-Beitrag sagt, beide Modelle seien „ausdrücklich noch nicht auf schwerere Probleme abgestimmt, wie grundlegende Wissenschaftsforschung und sehr langfristige agentische Arbeit". Die Model Card ergänzt ein paar weitere Punkte:
- Lange Sitzungen driften ab. „In langen agentischen Sitzungen können die Modelle Tool-Aufrufe wiederholen, die vorhandene Codebasis zu wenig nutzen, von Anweisungen abweichen oder aufhören, bevor ihre Arbeit vollständig überprüft ist." Wer lange autonome Agenten aus einer Coding-CLI heraus betreibt, sollte die Ausgabe prüfen.
- Nur Englisch. „Zum Release ist das Modell ausschließlich für englische Code-Produktion optimiert." Kommentare und Dokumentation in anderen Sprachen können schwächer ausfallen.
- Mehr Aufwand ist nicht immer besser. Die Karte sagt, ein höherer Reasoning-Effort „verbessert die Ergebnisse nicht immer". Starten Sie bei mittel und steigern Sie nur, wenn eine Aufgabe fehlschlägt.
- Alignment. Microsoft bewertet beide Modelle als „ähnlich im Alignment wie GPT-5.6 Sol, aber weniger ausgerichtet als GPT-6". Behalten Sie Ihre üblichen Review-Gates für alles, was es committet.
- Ihre Prompts könnten es trainiert haben. Laut der Data Card nutzte das Post-Training Konversationskontexte von Copilot-Free-, Pro- und Pro+-Nutzern, die nicht widersprochen hatten. Wenn Ihnen das wichtig ist, prüfen Sie Ihre Copilot-Dateneinstellungen.
Die Karte bewertet beide Modelle zudem als „Hoch" beim Risiko für offensiven Cybereinsatz sowie chemischen, biologischen, radiologischen und nuklearen Missbrauch und gibt an, dass sie mit einem Klassifizierer ausgeliefert werden, der solche Anfragen filtert. Das ist bei einem frontier-nahen Modell inzwischen Standard und betrifft normale Coding-Arbeit nicht.
Sollten Sie MAI Code 2 nutzen?
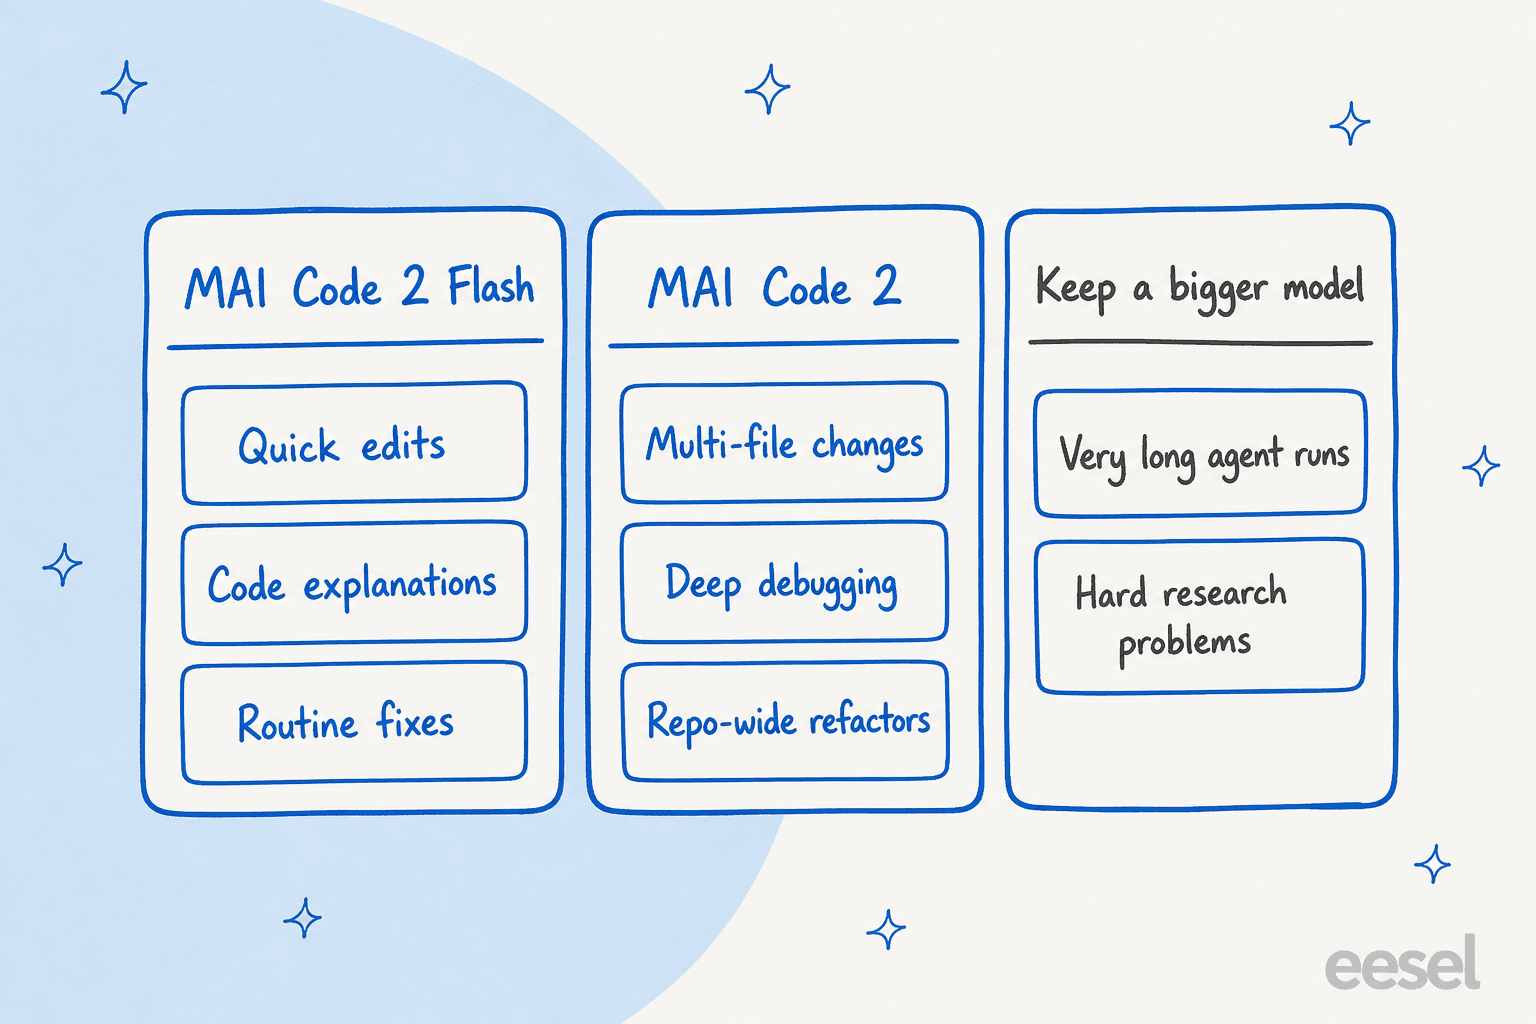
Wenn Sie auf Copilot sind und der Großteil Ihrer Arbeit aus klar umrissenen Änderungen besteht: ja, zumindest während die Promo läuft. So würde ich die Arbeit aufteilen:
| Wenn Sie nutzen | Meine Einschätzung |
|---|---|
| GPT-6.1 Sol oder GPT-6.2 Sol in Copilot | Probieren Sie MAI Code 2 für routinemäßige Multi-File-Arbeit. Ähnliche Werte bei etwa 40 % der Kosten pro Aufgabe bis Mai 2027. Nach der Preisverdopplung erneut prüfen. |
| Claude Opus 5.5 | Behalten Sie Opus für lange, schwere Repo-Aufgaben, wo es bei SWE Atlas um 14 Punkte führt. Verschieben Sie klar umrissene Fixes zu MAI Code 2 und sparen Sie dabei etwa 95 %. |
| GPT-6 Luna oder Claude Haiku 5.5 | Probieren Sie Flash. Es erreichte sechs bis sieben Punkte mehr und kostet während der Promo weniger pro Aufgabe. Zum Listenpreis kostet es mehr pro Aufgabe als Luna. |
| Claude Code, Codex oder rohe APIs | Warten Sie. MAI Code 2 ist außerhalb von Copilot noch nicht erreichbar, und Flash ist in Foundry nur Preview. |
| Lange autonome Agenten | Bleiben Sie bei einem größeren Modell. Microsoft sagt, es sei nicht für sehr lange agentische Arbeit abgestimmt. |
Wenn Sie Coding-Tools breiter abwägen, gehen die Übersicht zu den besten KI-Coding-Assistenten und der Leitfaden zu Copilot-Alternativen über ein einzelnes Modell hinaus. Microsofts andere eigene Modelle, wie MAI-Transcribe-2 für Sprache und Decision 1, folgen demselben Muster: eine enge Aufgabe zu einem niedrigen Preis.
Was bedeutet MAI Code 2 für ein Support-Team?
Ein günstigeres Coding-Modell ist günstigere Infrastruktur. Es ist kein Support-Mitarbeiter. MAI Code 2 kennt Ihre Rückerstattungsrichtlinie nicht, sieht Ihr Helpdesk nicht, und Microsoft hat es auf das Schreiben von englischem Code abgestimmt, nicht auf das Beantworten von Kunden. Wer Support-Automatisierung baut, für den ist das Modell nur ein Teil der Aufgabe. Der Rest ist Wissen, Tonfall, Schutzmechanismen und Übergaberegeln, die ein Modellvergleich für den Support allein nicht klären kann.
Das ist die Schicht, die eesel baut. MAI Code 2 ist Infrastruktur; eesel ist der Mitarbeiter. Sie stellen ein KI-Helpdesk-Mitglied für Ihre Warteschlange ein, oder einen KI-Blog-Autor für Content, und jedes kommt mit den Integrationen, dem Unternehmenswissen und den Grenzen für seine Rolle. Wo ein Coding-Modell tatsächlich hilft, ist beim Aufbau rundherum: Ein Entwickler kann Copilot oder Claude Code auf die eesel CLI richten, um freigegebenes Wissen zu laden und Antworten zu testen, während das Anbinden des Helpdesks selbst weiterhin einen Admin braucht, der es freigibt.
SE Ranking zeigt, wie das in der Praxis aussieht. Das SEO-Softwareunternehmen betreibt drei Produkte mit einem Support-Team, also betreibt es drei eesel-Agenten, einen pro Produkt, auf drei Zendesk-Verbindungen. Zwischen dem 8. August und dem 8. September 2026 bearbeiteten diese Agenten 4.650 Konversationen, beantworteten 2.100 Live-Chats als Erste und griffen auf etwa 16.800 Seiten an Wissen zurück. Nichts davon hängt davon ab, welches Modell gerade angesagt ist, und das ist der Punkt: Das Modell darunter kann sich ändern, ohne dass der Kunde es merkt.
Wer Tools für diese Aufgabe vergleicht, findet in der Übersicht zur besten KI-Helpdesk-Software einen breiteren Überblick, und die Kosten-pro-Ticket-Benchmarks stellen Modellpreise neben die vollen Kosten eines Tickets.
eesel ausprobieren
Wenn MAI Code 2 Sie zum Nachdenken bringt, was günstige Modelle für Ihre Support-Warteschlange bewirken können, beginnen Sie mit dem Teil, der entscheidet, ob es funktioniert: dem Mitarbeiter rund um das Modell. eesel bindet sich in das Helpdesk ein, das Sie bereits nutzen, lernt aus Ihren vergangenen Tickets und Ihrem Hilfecenter und lässt Sie es gegen echte historische Tickets laufen, damit Sie seine Antworten lesen können, bevor ein Kunde eine davon sieht. Die Pläne sind feste Credit-Pakete ab 299 $ für 500 Credits, sodass Ihre Rechnung nicht schwankt, wenn sich der Token-Preis eines Modells im Mai verdoppelt.

Sie können eesel kostenlos ausprobieren auf einem Teil Ihrer Warteschlange, oder es mit der direkten Nutzung von ChatGPT vergleichen, wenn Sie noch unentschlossen sind, ob Sie es selbst bauen sollen.