Die 8 besten GPT-Live-1-Alternativen für Voice-KI im Jahr 2026

Kurnia Kharisma

Katelin Teen
Zuletzt bearbeitet September 11, 2026
GPT-Live-1 ist das natürlichste Voice-Modell, das ich bisher genutzt habe, und sein API-Preis von $0.05/Min. gilt nur für die Sprachschicht. Das Reasoning-Modell im Backend und das Agent-Harness werden separat abgerechnet, der Listenpreis ist also eine Untergrenze, nicht die Rechnung. Genau deshalb ist die Suche nach Alternativen sinnvoll: Sie wählen nicht nur eine Stimme, sondern eine ganze Abrechnungsform.
Ich habe die letzten gut drei Jahre damit verbracht, KI in Live-Support-Warteschlangen einzusetzen, und eines lehrt diese Erfahrung: Eine flüssige Stimme ist nicht dasselbe wie eine richtige Antwort. Ein Modell, das menschlich klingt und selbstbewusst die falsche Richtlinie nennt, ist schlimmer als ein holpriges, das eskaliert. Diese Liste bewertet deshalb auch die unspektakulären Punkte: wie abgerechnet wird, was bei einer Übergabe passiert und ob das Tool tatsächlich den richtigen Endzustand erreicht.
Die acht Alternativen teilen sich sauber in zwei Gruppen: Single-Model-Speech-to-Speech-Engines, die sich wie GPT-Live-1 austauschen lassen, und Builder-Plattformen, die den ganzen Agenten für Sie zusammenbauen. Gemini Live und Nova Sonic sind die architektonisch nächsten Treffer; ElevenLabs, Vapi und Retell sind der schnellste Weg zum Start. Und wenn Ihr eigentliches Problem das Lösen von Tickets statt das Annehmen von Anrufen ist, lautet die ehrliche Antwort, dass keines davon ein Helpdesk ist, eine Lücke, auf die ich am Ende zurückkomme.
Warum überhaupt über GPT-Live-1 hinausschauen
GPT-Live-1 ist sehr gut. Es startete am 10. September 2026 in der API, nachdem es zuerst in ChatGPT erschienen war, und ersetzt die alte Kette aus Speech-to-Text, Reasoning und Text-to-Speech durch ein einziges Full-Duplex-Modell, das gleichzeitig zuhört und spricht. OpenAI maß einen Sprung von 30 Punkten im Full Duplex Bench gegenüber GPT-Realtime-2.1, und zusammen mit GPT-6 Astra liegt es auf Platz eins bei Tau3. In einem frühen Rollout reduzierte die Sprach-App Speak Unterbrechungen um fast 80 % gegenüber ihrem alten rundenbasierten System.

Warum also vergleichen? Drei Gründe tauchen immer wieder auf. Erstens ist GPT-Live-1 bewusst kein Reasoning-Modell und sagt das auch selbst: Es gibt schwieriges Denken an ein Backend wie Astra oder ein Drittanbieter-Modell ab, und diese zweite Rechnung geht auf Ihre Kosten. Ein Kommentator auf Hacker News sagte es deutlich:
"GPT-Live isn't a particularly intelligent model. It needs to handoff for reasoning and more complex tasks. You shouldn't expect its responses to be as reliable as a frontier model."

Zweitens möchten Sie vielleicht eine andere Preisform, eine selbst gehostete Option oder eine bestimmte Sprachauswahl. Drittens wollen Sie den Agenten vielleicht gar nicht selbst bauen, dann nimmt Ihnen eine Voice-Agent-Plattform mehr Arbeit ab. So gliedern sich die acht.
Die besten GPT-Live-1-Alternativen im Überblick
| Tool | Typ | Architektur | Abrechnungseinheit | Listenpreis | Sprachen | Kostenloser Tarif |
|---|---|---|---|---|---|---|
| GPT-Live-1 | Voice-Modell | Single Speech-to-Speech | Pro Minute + Tokens | $0.05/Min. Sprachschicht | Mehrere | Über ChatGPT |
| Gemini Live | Voice-Modell | Single Native Audio | Pro Token | ~$0.005/Min. Audio-Eingang | 70+ | Ja (AI Studio) |
| Amazon Nova Sonic | Voice-Modell | Single Speech-to-Speech | Pro Token | Nicht als $/Min. veröffentlicht | 7 (Nova 2) | AWS Free Tier |
| Grok Voice | Voice-Modell | Single Speech-to-Speech | Pro Minute | $0.08/Min. pauschal | Mehrere | Nein |
| Cartesia Sonic | Voice-Modell + Plattform | TTS-Modell + Line-Runtime | Pro Credit | Kostenlos bis $299/Monat | 44 | Ja (20k Credits) |
| Deepgram | Plattform | STT + LLM + TTS-Pipeline | Pro Minute | $0.056/Min. alles inklusive | Mehrsprachig | $200 Guthaben |
| ElevenLabs | Plattform | Pipeline + Agents | Pro enthaltener Minute | ~$0.08/enthaltene Min. | 31+ (Agents) | 15 kostenlose Min. |
| Vapi | Plattform | Orchestrator | Pro Minute | ~$0.105/Min. zusammengebaut | Mehrere | Testguthaben |
| Retell AI | Plattform | Orchestrator | Pro Minute | ~$0.135/Min. gebaut | Mehrere | Testguthaben |
Ein Wort dazu, wie ich bewertet habe. Die fünf Tools auf Modellebene sind API-first, die meisten haben also kein Produkt-Dashboard für einen Screenshot, und ich habe nicht so getan, als gäbe es eines: Diese Einträge beginnen mit Architektur und Preisen statt mit einem UI-Bild. Die drei Builder-Plattformen haben echte Konsolen, deshalb beginnen diese mit einer echten Aufnahme. Die Preise sind die vom Anbieter selbst veröffentlichten Tarife, Stand September 2026.

Drop-in-Voice-Modelle (architektonisch am nächsten an GPT-Live-1)
Das sind die direkten Austauschkandidaten. Wie GPT-Live-1 sind es Modelle, die Sie aus Ihrem eigenen Code aufrufen, und die meisten führen die gesamte Unterhaltung über ein Modell statt über eine Kette.
1. Google Gemini Live API
Was es ist. Googles native Echtzeit-Audio-API, der direkteste Rivale von GPT-Live-1 unter den großen Labs. Sie streamt über einen WebSocket, beherrscht Barge-in und unterstützt mit dem Gemini-2.5-Flash-Native-Audio-Modell auch affektiven Dialog und proaktives Audio.
Stärken. Die Breite ist die Geschichte. Gemini Live unterstützt 70+ Sprachen, Function Calling mit eingebauter Google-Suche, und es lässt sich direkt in Vertex AI und AI Studio einbinden. Wenn Ihr Stack bereits auf Google Cloud läuft, ist die Integration kurz. Zum Bauen gibt es einen echten kostenlosen Tarif.
Grenzen. Sitzungen sind begrenzt: Reines Audio läuft etwa 15 Minuten und Audio plus Video etwa 2 Minuten, bevor Sie Kontextfenster-Kompression zur Verlängerung brauchen. Google veröffentlicht keinen Wert für die Zeit bis zum ersten Audio, die Latenz müssen Sie also selbst messen, statt sie von der Seite abzulesen.
Preise. Tokenbasiert. Mit Gemini 2.5 Flash Native Audio kostet es $3.00 pro 1M Audio-Eingabe-Tokens und $12.00 pro 1M Audio-Ausgabe-Tokens. Die neuere Variante Gemini 3.1 Flash Live kommt auf etwa $0.005/Min. Eingang und $0.018/Min. Ausgang, was für ein großes Lab günstig ist.
Am besten für. Teams, die bereits auf Google Cloud sind und eine niedrige Minutenuntergrenze und die größte Sprachabdeckung wollen.
2. Amazon Nova Sonic
Was es ist. AWS' einheitliches Speech-to-Speech-Modell auf Amazon Bedrock. Wie GPT-Live-1 verschmilzt es Sprachverstehen und Spracherzeugung in einem einzigen Modell statt in einer Pipeline, mit bidirektionalem Streaming, Function Calling und RAG-Wissensanbindung.
Stärken. Es ist die Wahl für den Unternehmenseinkauf. Es lebt in Bedrock und erbt damit AWS IAM, VPC und Abrechnung, und es geht gut mit Unterbrechungen und Hintergrundgeräuschen um. Das aktuelle Nova 2 Sonic bietet 7 Sprachen und ein Kontextfenster von bis zu 1M Tokens.
Grenzen. Zwei Dinge sind zu prüfen. Das ursprüngliche Nova Sonic v1 erreicht am 14. September 2026 das Support-Ende, nehmen Sie für Neues also Nova 2 Sonic. Und AWS veröffentlicht keinen einfachen Dollar-pro-Minute-Preis: Sie werden nach Sprach- und Text-Tokens auf der Bedrock-Preisseite abgerechnet, was die Prognose zu einer Tabellenübung macht. Auch die Regionen sind begrenzt.
Preise. Abgerechnet nach Sprach-Tokens plus separaten Text-Tokens auf Bedrock. Es wird kein Listenpreis in $/Min. veröffentlicht, rechnen Sie also Ihr eigenes Volumen durch, bevor Sie sich festlegen.
Am besten für. AWS-native Teams, die ein einzelnes S2S-Modell unter ihren bestehenden Sicherheits- und Abrechnungskontrollen wollen.
3. Grok Voice (Think Fast 2)
Was es ist. xAIs Echtzeit-Speech-to-Speech-Modell. Von der ganzen Liste hat es die Preisform, die der entspricht, was Käufer wirklich wollen: pauschal und vorhersehbar.
Stärken. Grok Voice wird mit pauschal $0.08/Min. abgerechnet, und die unabhängige Messung von Artificial Analysis beziffert die echten Kosten pro Stunde auf $4.80, genau der Listenpreis. Das ist wichtig, weil tokenbasierte Konkurrenten einen Eingangspreis nennen, der nur ein Bruchteil der realen Gesamtkosten sein kann. Es ist außerdem schnell, mit etwa 0,70 s bis zum ersten Audio, und liegt nahe an der Spitze der Qualitäts-und-Geschwindigkeits-Grenze.
Grenzen. Es gibt harte operative Obergrenzen: standardmäßig 10 gleichzeitige Sitzungen pro Team, maximal 120 Minuten pro Sitzung und eine einzige Region us-east-1. Telefonie kostet auf einer bereitgestellten Nummer $0.01/Min. extra. Und im supportspezifischen Benchmark tau-Voice erreicht selbst die beste Konfiguration nur etwa 56,5 % gelöste Aufgaben, ein nützlicher Realitätscheck gegenüber den Containment-Versprechen der Anbieter.
Preise. Pauschal $0.08/Min., die gemessenen Stundenkosten entsprechen dem Listenpreis. Kein Mengenrabatt und keine Prioritätsspur für Voice.
Am besten für. Teams, die eine vorhersehbare, nachprüfbare Minutenrechnung höher gewichten als den absolut niedrigsten Token-Preis.
4. Cartesia Sonic
Was es ist. Cartesia baut die Sonic-Familie latenzarmer Voice-Modelle und liefert 2026 auch Line, eine Code-first-Plattform zum Bauen von Voice-Agents darauf. Es ist also Modellanbieter und zunehmend auch Builder.
Stärken. Latenz und Kontrolle. Sonic-3.6 wirbt mit Audio unter 90 ms bis zum ersten Byte, 44 Sprachen und Stimmklonen aus einem 10-Sekunden-Clip. Line ist eine entwicklerfreundliche Runtime mit CLI und GitHub-basierten Deployments, passend für Teams, die ihren Voice-Agenten in der Versionskontrolle halten wollen.
Grenzen. Abgerechnet wird in Credits statt Minuten, ein anderes Denkmodell: TTS kostet einen Credit pro Zeichen, Sie müssen also auf Ihre eigene Last umrechnen, um zu vergleichen. Eine selbst gehostete Option ist nicht veröffentlicht, gehen Sie also von der Cloud aus, es sei denn, Sie haben einen Enterprise-Vertrag.
Preise. Kostenlos mit 20.000 Credits/Monat, Pro $5/Monat für 100k Credits, Startup $49/Monat für 1,25M und Scale $299/Monat für 8M. Das ergibt je nach Tarif grob $37 bis $50 pro 1M Zeichen.
Am besten für. Latenzkritische Projekte und Entwickler, die einen Code-first-Workflow wollen. Wenn es Ihnen speziell um die Stimmqualität geht, geht unser Vergleich Cartesia versus ElevenLabs tiefer.
5. Deepgram Voice Agent API
Was es ist. Deepgram ist die Pipeline-Wahl. Die Voice Agent API bündelt Deepgrams eigenes Nova Speech-to-Text und Aura Text-to-Speech und lässt Sie ein eigenes LLM dazwischen einsetzen. Es ist ausdrücklich eine konfigurierbare STT-LLM-TTS-Pipeline, kein einzelnes Modell.
Stärken. Sie bekommen Kontrolle auf Komponentenebene: LLM tauschen, STT abstimmen, bei Bedarf selbst hosten. Barge-in und Function Calling sind eingebaut, neue Konten erhalten $200 Guthaben, und der All-in-Minutenpreis ist tatsächlich veröffentlicht, was seltener ist, als es sein sollte.
Grenzen. Die Pipeline-Form ist der Kompromiss. Jede Übergabe zwischen den Stufen fügt gegenüber einem einzelnen Modell etwas Latenz und etwas Anfälligkeit hinzu, und das LLM in der Mitte ist eine separate Rechnung, die Deepgram nicht stellt. Beachten Sie auch die Preisänderung: Deepgrams veröffentlichte Preise steigen nach dem 12. September 2026.
Preise. Der Standard-Tarif kostet $0.056/Min. pay-as-you-go und Advanced $0.122/Min., beide steigen nach dem 12. September. Darunter kostet Nova-3 STT $0.0048/Min. und Aura-2 TTS $0.030 pro 1.000 Zeichen.
Am besten für. Teams, die jede Stufe des Stacks selbst besitzen und ihr eigenes Reasoning-Modell mitbringen wollen.

Voice-Agent-Plattformen (den ganzen Agenten zusammenbauen)
Wenn Sie Modelle nicht selbst verdrahten möchten, bekommen Sie bei diesen dreien Builder, Telefonie und Orchestrierung sofort mit. Der Preis dafür ist, dass Sie diese Bequemlichkeit im Minutenpreis bezahlen.
6. ElevenLabs
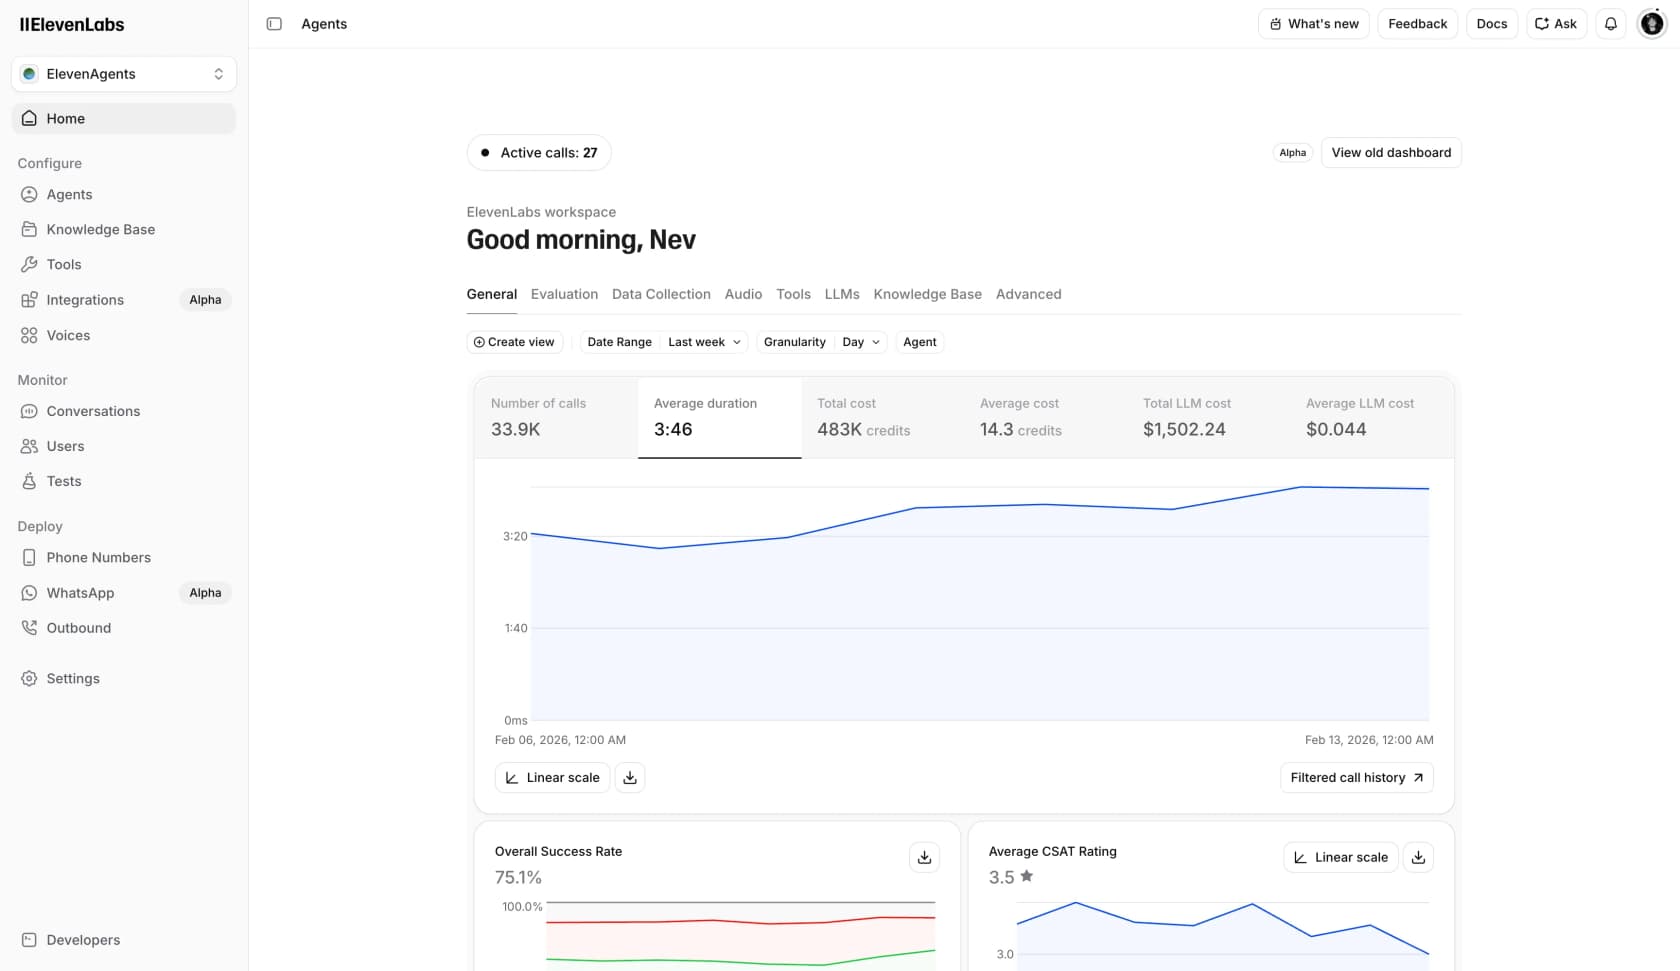
Was es ist. Der bekannteste Name in der Voice-KI. Neben dem TTS-Katalog bietet ElevenLabs eine vollständige Agents-Plattform mit Konsole, Analysen und Telefonie.
Stärken. Stimmqualität und Feinschliff sind ausgezeichnet, und die Agents-Konsole zeigt echte Betriebskennzahlen wie Erfolgsquote und CSAT, statt sie zu verstecken. Von den dreien lässt es sich am leichtesten einem Stakeholder vorführen.
Grenzen. Abgerechnet wird mit vorausbezahlten Minuten, die verfallen, was schwankende oder geringe Nutzung bestraft: Sie kaufen ein Kontingent, und ungenutzte Minuten werden nicht übertragen. Oberhalb der 12.375 Minuten pro Monat des Business-Tarifs gibt es nur Angebote auf Anfrage, und RAG-Speicher wird separat berechnet.
Preise. Jeder kostenpflichtige Tarif ergibt fast genau $0.08 pro enthaltener Minute: Starter $6/75 Min., Creator $22/275, Pro $99/1.238, Scale $299/3.738, Business $990/12.375. Der kostenlose Tarif enthält 15 Agent-Minuten. Unsere vollständige Aufschlüsselung der ElevenLabs-Preise enthält die Tarifrechnung, und die Übersicht der ElevenLabs-Bewertungen zeigt die Nutzerreaktionen.
Am besten für. Teams, die Stimmqualität an erste Stelle setzen und ein stetiges, vorhersehbares Minutenvolumen haben. Wenn Sie vergleichen, ist die Liste der ElevenLabs-Alternativen die nächste gute Station.
7. Vapi
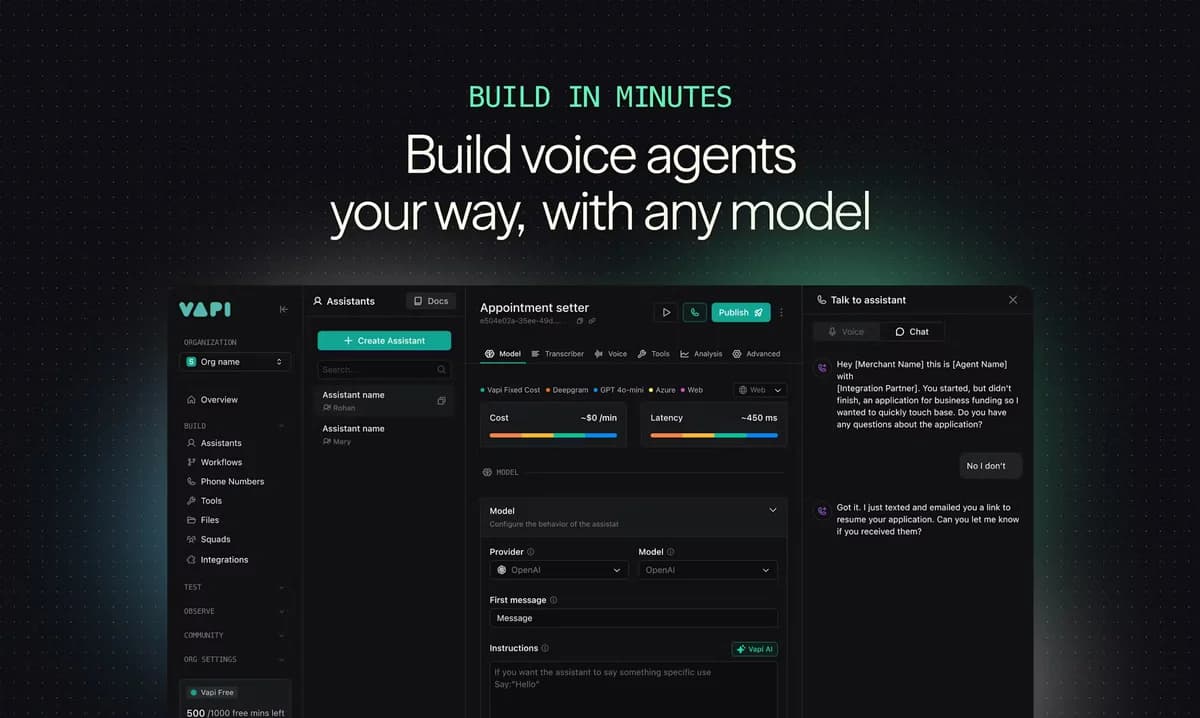
Was es ist. Vapi ist ein reiner Orchestrator. Sie bringen die Modelle mit, und Vapi übernimmt Telefonie, Gesprächswechsel und Verbindungslogik, damit Sie schnell einen Voice-Agenten aufsetzen können.
Stärken. Tempo bis zum funktionierenden Prototyp. Der Assistant-Builder ist übersichtlich, die Modellauswahl offen, und für viele Teams ist Vapi der schnellste Weg von der Idee zur Telefonnummer, die antwortet.
Grenzen. Zwei Dinge sind abzuwägen. Vapis eigene Orchestrierungsgebühr macht einen großen Teil der realistischen Minutenkosten aus, der zusammengebaute Preis steigt also, sobald Sie ein gutes STT, LLM und TTS darunter legen. Die Wissensbasis funktioniert nur per Datei-Upload mit ausschließlich Gemini-Retrieval, es gibt keine Ticketing-Integrationen, und Tests werden zu Produktionspreisen abgerechnet.
Preise. Etwa $0.105/Min. zusammengebaut, wobei Vapis eigene Gebühr rund 48 % einer realistischen Minute ausmacht.
Am besten für. Entwickler, die maximale Modellflexibilität wollen und die Integrationsarbeit selbst übernehmen können.
8. Retell AI
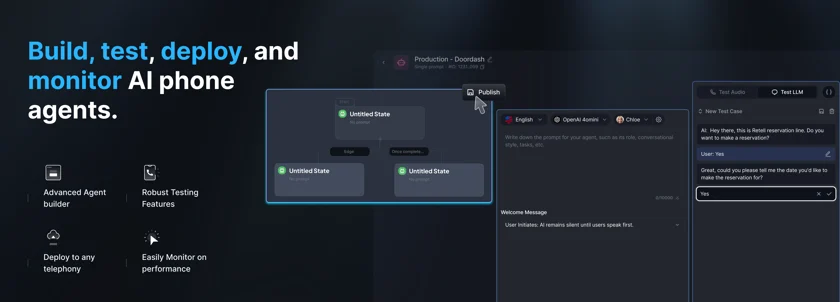
Was es ist. Retell ist eine Orchestrierungsplattform, die klar auf telefonbasierte Agenten zielt, mit einem Conversation-Flow-Builder und integrierter QA.
Stärken. Es ist produktionsorientiert, mit Anrufanalysen, einer Test-Suite und Warm-Transfer-Handling. Für einen einfachen ausgehenden oder eingehenden Telefon-Anwendungsfall ist es eine fähige, meinungsstarke Wahl.
Grenzen. Der additive Stack summiert sich. Retells eigene Voice-Infrastruktur kostet unvermeidbare $0.055/Min., und das Einschalten von KI-QA für $0.10/Min. addiert rund 74 % obendrauf. Die Helpdesk-Anbindung ist dünn: Zendesk ist als "coming soon" aufgeführt, und es gibt kein natives Freshdesk, Gorgias oder Front. Der Zähler endet außerdem bei der Weiterleitung, alles, was ein Mensch übernimmt, liegt also außerhalb von Retells Umfang, und die eigene FAQ beantwortet "can AI replace call center agents?" mit einem klaren "No."
Preise. Etwa $0.135/Min. für einen realistischen Support-Aufbau, rund $675/Monat bei 5.000 Minuten. Die Komponenten des Stacks finden Sie auf der Seite zu den Retell-AI-Preisen, und in den Retell-AI-Bewertungen sehen Sie, wie es sich in der Praxis schlägt.
Am besten für. Telefon-first-Teams, die eine speziell gebaute Voice-Agent-Plattform wollen und mit begrenzten Helpdesk-Integrationen leben können. Die Liste der Retell-Alternativen deckt die nächsten Nachbarn ab.
Die ehrliche Lücke: Keines davon löst Ihre Tickets
Das ist der Punkt, auf den ich nach Jahren mit KI in Support-Warteschlangen immer wieder zurückkomme. Jedes Tool auf dieser Liste ist Voice-Infrastruktur. Es ist ein Modell oder ein Builder, der ein Modell zu einer Telefonleitung zusammensetzt. Es ist der Mund, nicht der Mitarbeiter. Sie müssen ihm weiterhin Wissen geben, es mit Ihren Systemen verbinden, entscheiden, was es tun darf, und klären, was passiert, wenn ein Anrufer ein Problem hat, das es nicht lösen kann.

Und für die meisten Support-Teams liegt der Großteil der Arbeit gar nicht am Telefon. Er liegt in E-Mail, Live-Chat, Slack und dem Help Center, wo ein Kunde ein Problem beschreibt und die richtige, richtlinienkonforme Antwort erwartet. Genau diese Aufgabe erledigt eesel. Ich möchte ehrlich sein: eesel ist kein Voice-Tool, ich werde also nicht so tun, als konkurriere es am Telefon mit GPT-Live-1. Wenn Sie Voice brauchen, kombinieren Sie eines der acht oben.
Was eesel dagegen ist: ein einsatzbereites KI-Helpdesk-Teammitglied. Es dockt an Ihr Helpdesk an, lernt aus Ihren vergangenen Tickets und Dokumenten und beginnt, Konversationen auf den Kanälen zu lösen, die Sie bereits betreiben. Zwei Unterschiede zum Voice-Stack sind hier wichtig:
- Sie zahlen pro Ticket, nicht pro Minute. Ein Voice-Modell berechnet die Zeit in der Leitung, egal ob das Problem gelöst wird; die eesel-Tarife beginnen bei $299/Monat für 500 Credits, und 1 Credit deckt ein Ticket oder einen Chat ab, egal wie lange er dauert, der Zähler folgt also Tickets, nicht Sendezeit. Die Kostenrechnung für Support-Automatisierung sieht anders aus, wenn Sie pro Ticket statt pro Sendezeit zahlen.
- Es simuliert auf Ihren echten historischen Tickets, bevor es einem Kunden überhaupt antwortet. Die Narben hinter dieser Funktion sind echt: Ich habe gesehen, wie selbstsicher klingende Bots stillschweigend falsche Antworten gaben, deshalb wird jeder eesel-Rollout vorab an Tausenden Ihrer eigenen vergangenen Tickets trocken getestet, und Sie sehen das erwartete Verhalten vor dem Go-live.
Es gibt auch etwas für die Entwickler unter den Lesern. Weil es in diesem Beitrag so viel um APIs und Bauen geht, ist es wichtig zu wissen, dass eesel nicht nur über das Dashboard bedienbar ist. Die eesel-CLI steuert dasselbe Teammitglied und denselben Workspace über ein Terminal: Ein Mensch kann sie von Hand ausführen, ein Skript kann sie automatisieren, und ein Coding-Agent wie Claude Code, Codex oder Cursor kann sie direkt bedienen, neben MCP und Webhooks. So wie Sie ein Voice-Modell per Skript ansteuern würden, können Sie also auch das Support-Teammitglied skripten: eine Wissensquelle verbinden, eine Änderung der Anweisungen vorschlagen, eine Simulation ausführen und das JSON-Ergebnis prüfen, alles von der Kommandozeile. Es ist der agentische Weg in einen Support-Agenten, nicht nur ein Chatfenster.
Wenn Ihre eigentliche Frage lautete: "Wie beantworte ich mehr Support-Konversationen korrekt?" und nicht: "Wie füge ich eine Stimme hinzu?", dann lohnt sich dieses Tool.
Wie Sie wählen
Passen Sie das Tool an die tatsächliche Aufgabe an, nicht an die Demo:
- Sie wollen den engsten GPT-Live-1-Ersatz. Beginnen Sie mit Gemini Live oder Nova Sonic. Beide sind einzelne S2S-Modelle mit großem Lab im Rücken.
- Sie wollen eine vorhersehbare Rechnung. Grok Voice mit pauschal $0.08/Min. oder Deepgram mit veröffentlichten $0.056/Min. alles inklusive sind am leichtesten zu prognostizieren.
- Sie wollen starten, ohne zu bauen. ElevenLabs, Vapi oder Retell geben Ihnen heute Konsole und Telefonie.
- Ihnen sind Latenz oder Code-first-Kontrolle wichtig. Cartesias Sonic und Line passen dazu.
- Ihre eigentliche Aufgabe ist das Lösen von Tickets, nicht das Annehmen von Anrufen. Ein textbasierter KI-Helpdesk-Agent bewegt Ihre Zahlen mehr als jedes Voice-Modell, und Sie können die Kosten eines KI-Agenten gegen menschliche Agenten abwägen, bevor Sie sich festlegen.
Eine letzte Anmerkung aus der Praxis, passend zu diesem HN-Thread. Stimmqualität ist inzwischen im Grunde gelöst, und alle auf dieser Liste klingen gut. Das Schwierige bleibt, richtig zu liegen. Ein weiterer Tester fasste die Angewohnheit des aktuellen Modells gut zusammen:
"The new gpt-live feature tends to interrupt with 'human' sounding injections like 'hmm', 'huh' a bit too much for my liking. Also its crutch is to start by paraphrasing what I just said."
Wählen Sie die Stimme, die zu Ihrem Stack und Ihrem Budget passt. Stecken Sie dann Ihre echte Energie in den Teil, der entscheidet, ob Kunden ihr vertrauen: die Antwort darunter.
Häufig gestellte Fragen
Was ist die beste GPT-Live-1-Alternative?
Das hängt von der Aufgabe ab. Für einen direkten Austausch gegen ein einzelnes Modell sind Google Gemini Live und Amazon Nova Sonic architektonisch am nächsten dran. Wenn Sie einen Agenten lieber in einem visuellen Builder zusammenstellen, kommen Sie mit ElevenLabs, Vapi und Retell schneller ans Ziel. Grok Voice und Deepgram liegen mit pauschalen Minutenpreisen dazwischen.
Was kostet GPT-Live-1 im Vergleich zu den Alternativen?
GPT-Live-1 kostet in der API $0.05 pro Minute, allerdings nur für die Sprachschicht, das Reasoning-Modell im Backend wird separat abgerechnet. Das ist einer der niedrigsten Werte, aber nicht die ganze Rechnung. Den vollständigen Stack finden Sie in der Aufschlüsselung der GPT-Live-1-Preise. Deepgram startet bei $0.056/Min. alles inklusive, Grok Voice kostet pauschal $0.08/Min., und ElevenLabs kommt auf etwa $0.08 pro enthaltener Minute.
Gibt es eine kostenlose GPT-Live-1-Alternative?
Mehrere haben kostenlose Einstiegsangebote. Deepgram gibt neuen Konten $200 Guthaben, Cartesia hat einen kostenlosen Tarif mit 20.000 Credits pro Monat, Gemini Live hat einen kostenlosen Tarif in Google AI Studio, und ElevenLabs enthält 15 kostenlose Agent-Minuten. Keines davon ersetzt einen produktiven Voice-Einsatz, aber zum Bauen und Testen reichen sie aus.
Was ist der Unterschied zwischen einer Single-Model-Voice-KI und einer kaskadierten Pipeline?
Ein einzelnes Speech-to-Speech-Modell wie GPT-Live-1, Nova Sonic oder Gemini Live hört und spricht mit nur einem Modell, sodass Unterbrechungen und Timing natürlich wirken. Eine kaskadierte Pipeline verbindet Speech-to-Text, ein LLM und Text-to-Speech miteinander, was besser konfigurierbar ist, aber an jeder Stufe eine Übergabe hinzufügt. Deepgram, Vapi und Retell setzen auf den Pipeline-Ansatz.
Welche GPT-Live-1-Alternative eignet sich am besten für den Kundensupport?
Speziell für eine Telefonleitung bindet eine Builder-Plattform wie Retell oder Vapi die Sprache am schnellsten in Ihren Stack ein, auch wenn den meisten noch tiefe Helpdesk-Anbindungen fehlen. Wenn die eigentliche Aufgabe darin besteht, Tickets über E-Mail, Chat und Slack zu lösen statt am Telefon, passt ein textbasierter KI-Helpdesk-Agent besser. Unsere Übersicht über KI-Voice-Unternehmen zeigt die Telefon-first-Optionen.
Kann ich GPT-Live-1 für ein telefonbasiertes Callcenter nutzen?
Ja. GPT-Live-1 bekam beim API-Start Telefonie-Unterstützung, sodass Sie einen Full-Duplex-Agenten für Telefonanrufe einsetzen können. Wenn Sie lieber einen speziell dafür gebauten Stack möchten, vergleichen Sie die Optionen für KI-Callcenter-Agenten und lesen Sie unsere Einschätzung zu den echten Kosten von Agent versus Mensch, bevor Sie eine Warteschlange umstellen.
Ersetzt eines dieser Voice-Modelle menschliche Support-Mitarbeiter?
Nicht allein. Selbst die eigene FAQ von Retell beantwortet "can AI replace call center agents?" mit einem klaren "No." Voice-Modelle sind bei flüssiger Konversation am stärksten und dabei am schwächsten, zuverlässig zur richtigen Endantwort zu kommen. Deshalb kombinieren die meisten Teams sie mit einem Reasoning-Modell und einer Übergabe an Menschen. Unser Beitrag zu KI vs. menschlicher Kundensupport zeigt, wo die Grenze verläuft.