Die 9 besten Meta Muse Wonder Alternativen 2026, nach Aufgabe und Preis

Kira

Katelin Teen
Zuletzt bearbeitet October 14, 2026
Warum überhaupt über Muse Wonder hinausschauen
Ich beginne mit dem, was Meta richtig gemacht hat, denn das ist einiges. Muse Wonder ist die erste Frontier-Modellfamilie der Meta Superintelligence Labs, veröffentlicht am 12. Oktober. Die größere Variante, Wonder Full, landete am Starttag im Artificial-Analysis-Index auf Platz zwei. Das API-Modell hat ein Kontextfenster von 1.048.576 Tokens, nimmt Text, Bild, Video, Audio und PDF an und kommt mit einer klaren Preisliste: kein Aufschlag für langen Kontext und vom ersten Tag an 3.000 Anfragen pro Minute. Der Muse-Wonder-Test meines Kollegen behandelt das ausführlich.
Die Gründe, anderswo zu suchen, sind konkret und alle überprüfbar:
- Das Modell, das Sie kaufen können, ist nicht das Modell im Diagramm. In Metas eigener Benchmark-Tabelle gewinnt Wonder Full 6 von 14 Zeilen. Das einfache Wonder, das einzige in der API, gewinnt 1 (MemoryBench).
- Es kostet Frontier-Preise. Meta hat früher alle unterboten. Mit
$4/$20entspricht Wonder jetzt auf den Cent Opus 5.5 und kostet doppelt so viel wie GPT-6.1 Sol. - Es ist eine Vorschau. Die Modell-Doku kennzeichnet es als Preview, der Sicherheitsbericht ist „bald verfügbar“, und ein früher Tester meldete Zuverlässigkeitsprobleme der API.
"It's ok, intelligent, almost SOTA, but way too expensive [0], and some issues with API failing sometimes at the moment."

Ich baue bei eesel Funktionen und KI-Agenten, und das Modell darunter ist der Teil von eesels Stack, von dem ich am ehesten erwarte, dass er sich ändert. Das ist keine Ahnung. In einem Verkaufsgespräch sagte ein B2B-Hardware-Support-Team mit rund 250 Tickets im Monat dem Vertriebsteam von eesel, dass es sein KI-Support-Tool ersetzen müsse. Der Grund hatte nichts mit dem Preis zu tun: Der Anbieter hatte sein Geschäftsmodell geändert, und das Team war zur Migration gezwungen. Ein Preview-Modell ist genau der Ort, an dem solche Änderungen ohne große Vorwarnung passieren. Ich würde Wonder deshalb als eine Option zum Testen behandeln, nicht als Plattform zum fest Verdrahten.
Gleicher Preis, andere Punktzahl
Das ist die eine Grafik aus diesem Beitrag, die Sie sich merken sollten. Beim Output-Preis pro Million Tokens liegt Muse Wonder gleichauf mit Opus 5.5. Im Artificial-Analysis-Index, wie in Metas eigener Launch-Grafik gezeigt, liegt es sechs Punkte darunter.
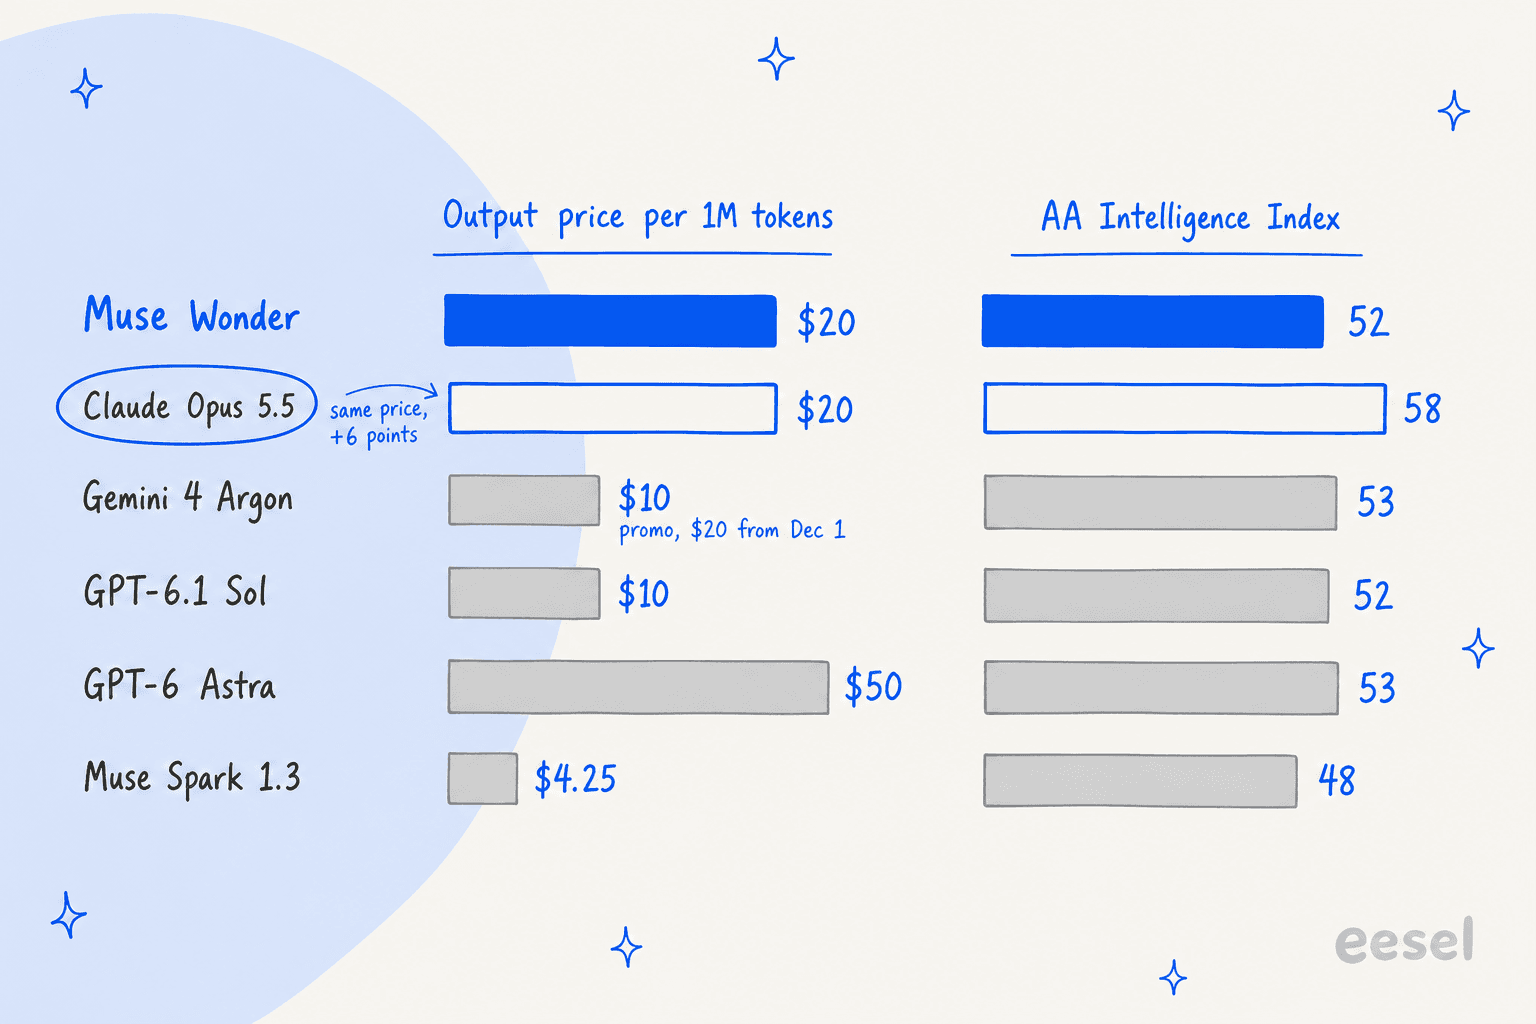
Beim Lesen der Zeilen fallen drei Dinge auf. Opus 5.5 ist dieselbe Rechnung für 6 Punkte mehr. GPT-6.1 Sol ist dieselbe Punktzahl für den halben Output-Preis. Und GPT-6 Astra verlangt das 2,5-Fache von Wonders Preis für einen zusätzlichen Punkt. Benchmarks sind nicht alles (Wonders MemoryBench-Ergebnis ist echt, und Meta hat ihn für lange Agent-Läufe gebaut), aber bei identischen Preisen liegt die Beweislast beim Modell mit der niedrigeren Punktzahl.
Ein HN-Kommentator brachte den Vergleich mit Sol auf den Punkt:
"sol 6.1 is 50% cheaper than this. sol pricing$2.00 output $10.00 dont know why the f people downvote for saying sol pricing."
Die Muse-Wonder-Alternativen im Überblick
Die Preise sind Standard-API-Preise pro Million Tokens von der jeweiligen Preisseite des Anbieters, geprüft am 14. Oktober 2026. Die Index-Werte stammen aus Metas Launch-Grafik (12. Oktober), sofern das Modell dort vorkommt, sonst von den Modellseiten von Artificial Analysis.
| Modell | Am besten für | Input / gecacht / Output pro 1M | AA Intelligence Index | Kontext / max. Output | Offene Gewichte | Trainiert standardmäßig mit Ihren Daten | Kostenloses Kontingent | Wo erhältlich |
|---|---|---|---|---|---|---|---|---|
| Muse Wonder (Basis) | Lange Agent-Läufe, Memory | $4 / $0.20 / $20 | 52 | 1M / nicht veröffentlicht | Nein | Nein (API) | Nein | Meta Model API, OpenRouter, Muse Code |
| Claude Opus 5.5 | Gleiche Rechnung, höhere Punktzahl | $4 / $0.20 / $20 | 58 | 1M / 128K | Nein | Nein | Nein | Claude API, Bedrock, Vertex, Foundry |
| Gemini 4 Argon | Lange Dokumente, bis Dez. günstiger | $2 / $0.10 / $10, danach $4 / $0.20 / $20 | 53 | 1M einheitlich / bis 1M | Nein | Nein (kostenpflichtig) | Nein | Gemini API, AI Studio |
| Muse Wonder Full | Metas Bestes, Coding in Muse Code | $50 oder $200 pro Monat | 56 | 1M / nicht veröffentlicht | Nein | Ja (Contributor-Modus) | Nein | Nur Muse Code Power oder Max |
| GPT-6.1 Sol | Wonders Punktzahl zum halben Preis | $2 / $0.10 / $10 | 52 | 1.05M / 128K | Nein | Nein | Nein | OpenAI API, ChatGPT Work, Codex |
| GPT-6 Astra | OpenAIs Top-Stufe, Ultrafast | $10 / $1 / $50 | 53 | 1.05M / 128K | Nein | Nein | Nein | OpenAI API, kostenpflichtige ChatGPT-Tarife |
| Claude Sonnet 5.5 | Coding zum halben Opus-Preis | $2 / $0.10 / $10 | 56 (max), 47 (high) | 1M / 128K | Nein | Nein | Nein | Claude API, Clouds |
| Muse Spark 1.3 | Hohes Volumen, bei Meta bleiben | $1.25 / $0.15 / $4.25 | 48 | 1M / nicht veröffentlicht | Nein (versprochen) | Nur bei der Contributor-Variante | Nein | Meta Model API, Muse Code |
| Gemini 3.8 Flash | Günstige Batch-Arbeit, kostenloses Kontingent | $0.75 / $0.075 / $3.75 | 41 (high) | 1M / 64K | Nein | Nur im kostenlosen Kontingent | Ja | Gemini API, AI Studio |
| DeepSeek V4.1 Flash | Offene Gewichte, niedrigste Rechnung | $0.15 / $0.003 / $0.60 außerhalb der Stoßzeiten | 39.5 (max) | 1M / 384K | Ja, MIT | Bedingungen sagen dazu nichts | Nein | DeepSeek API, Self-Hosting |
Sie wissen nicht, welche Zeile zu Ihnen passt? Wählen Sie den Grund, der Ihrem Interesse an Wonder am nächsten kommt.
Wofür wollten Sie Muse Wonder?
Wählen Sie den Grund, der Ihrem am nächsten kommt.
Wie ich diese Alternativen ausgewählt habe
Ich bin von der Shortlist ausgegangen, die ein KI-Assistent einem Käufer nennt, der fragt, womit man Wonder vergleichen soll, und habe dann jeden Namen gegen Primärquellen geprüft. Diese Shortlist stützte sich auf GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, Wonder Full und ein günstiges Gemini Flash. Zwei davon mussten korrigiert werden. Gemini 4 Argon war gerade erst erschienen, und das vorgeschlagene Flash-Modell, Gemini 3.5 Flash, ist veraltet, Anfragen werden inzwischen an 3.6 Flash geleitet. Deshalb habe ich das aktuelle 3.8 Flash verwendet.
Dann habe ich die Modelle ergänzt, die ein Wonder-Käufer beim Preis wirklich abwägt: GPT-6.1 Sol und Claude Sonnet 5.5 zu $2/$10, Metas eigenes Muse Spark 1.3 und eine Option mit offenen Gewichten. Jeder Preis unten stammt am 14. Oktober von der Preisseite des Anbieters. Jeder Benchmark kommt entweder vom Anbieter oder von Artificial Analysis, und ich sage jeweils, von wem.
Was ich nicht getan habe: neun Modelle für diesen Beitrag durch meinen eigenen Test-Harness laufen zu lassen. Wonder ist drei Tage alt, und ein fairer Vergleich braucht Ihre Aufgaben, nicht meine. Der letzte Abschnitt gibt Ihnen daher den Test mit fünf Aufgaben, den ich laufen lassen würde, und jeder Eintrag unten nennt, welche dieser Aufgaben er gewinnen sollte.
1. Claude Opus 5.5: dieselbe Rechnung für eine höhere Punktzahl
Am besten für: Teams, die ein Frontier-Modell zu $4/$20 wollten und das mit der höheren Punktzahl zu diesem Preis suchen.
Claude Opus 5.5 ist der direkteste Tausch auf dieser Liste, weil sich an Ihrem Budget nichts ändert. Anthropics Preisdokumentation nennt $4 Input, $20 Output und $0.20 für einen Cache-Treffer, dieselben drei Zahlen wie bei Wonder. Der Unterschied ist die Punktzahl: 58 im Artificial-Analysis-Index gegenüber 52 bei Wonder, und beim Start von Wonder Platz eins in diesem Index.
Metas eigene Tabelle spricht für Opus. Opus 5.5 gewinnt 6 der 14 Zeilen, darunter Computernutzung (OSWorld 81.8 gegenüber 72.6 bei Wonder), Terminal-Coding (59.6 gegenüber 52.0) und Programmieren von Grund auf. Letzteres ist die größte Lücke der ganzen Tabelle: ProgramBench 70.5 für Opus 5.5, 50.0 für das einfache Wonder. Wonder hält sich bei Memory und langfristigem Coding: Es schlägt Opus 5.5 bei DeepSWE (78.8 gegenüber 74.2) und SWE-Marathon (53.1 gegenüber 46.3).
Auch die praktischen Extras zählen. Opus 5.5 läuft auf der Claude API sowie auf Bedrock, Vertex und Foundry, Batch halbiert den Preis auf $2/$10, und Anthropics Standardaufwand ist jetzt „medium“, der bei Artificial Analysis 51 Punkte für $1.34 pro Aufgabe erreicht. Der Opus-5.5-Test geht tiefer auf die Aufwandsstufen ein.
Vorteile: gleicher Preis wie Wonder; 6 Punkte höher im Index; führt in Metas Tabelle bei Computernutzung, Terminal und Coding von Grund auf; auf drei großen Clouds verfügbar.
Nachteile: Erzwungenes tool_choice (any oder ein benanntes Tool) gibt einen Fehler zurück, was relevant ist, wenn Ihr Agent darauf setzt; maximaler Aufwand kostet bei Artificial Analysis etwa $5.98 pro Aufgabe; keine offenen Gewichte.
Preise: $4 Input, $0.20 Cache-Treffer, $20 Output pro 1M Tokens; Cache-Schreiben 5 Minuten $5, 1 Stunde $8; Batch $2/$10; Fast-Modus $8/$40. Die vollständige Tabelle steht in den Opus-5.5-Preisen.
Mein Fazit: Wenn Sie Wonder für $4/$20 produktiv einsetzen wollten, setzen Sie zuerst Opus 5.5 ein und lassen Wonder bei Ihren eigenen Aufgaben dagegen antreten. Bei gleichem Preis bekommt das Modell mit der höheren Punktzahl den Vorzug.
2. Gemini 4 Argon: bis Dezember der halbe Preis von Wonder
Am besten für: lange Dokumente, lange Agent-Läufe und Teams, die die niedrigste Rate erfundener Antworten im Frontier-Feld wollen.
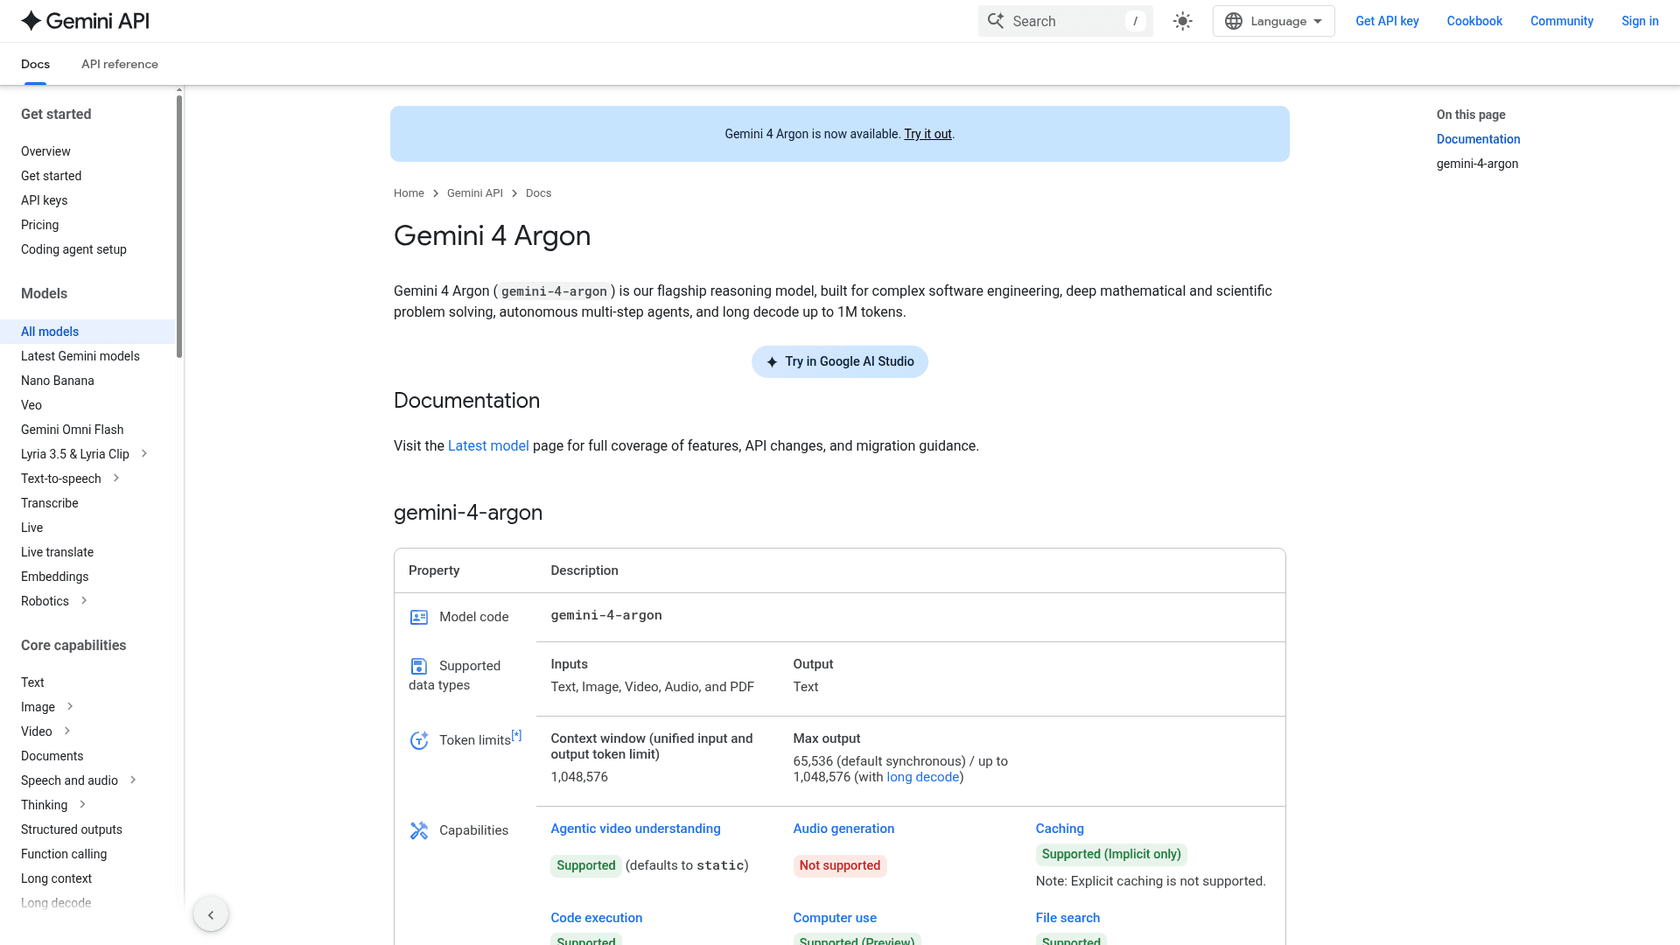
Am Starttag von Wonder lobte ein HN-Kommentator Wonder dafür, „available unlike Gemini 4 Argon“ zu sein. Das hielt einen Tag. Googles Changelog zeigt, dass gemini-4-argon am 13. Oktober allgemein über die Gemini API verfügbar wurde, und inzwischen ist es auch in AI Studio. Der Gemini-4-Argon-Test entstand, als es noch nur auf Einladung zugänglich war; die Fakten unten stammen aus Googles aktueller Doku.
Interessant ist der Preis. Googles Preisseite nennt $2 Input, $0.10 gecacht und $10 Output bis 30. November, dann $4, $0.20 und $20 ab 1. Dezember, also genau die Preiskarte von Muse Wonder. Etwa sieben Wochen lang bekommen Sie also ein Modell mit 53 Punkten im Index (ein Punkt über Wonder) zum halben Preis, danach zum gleichen Preis.
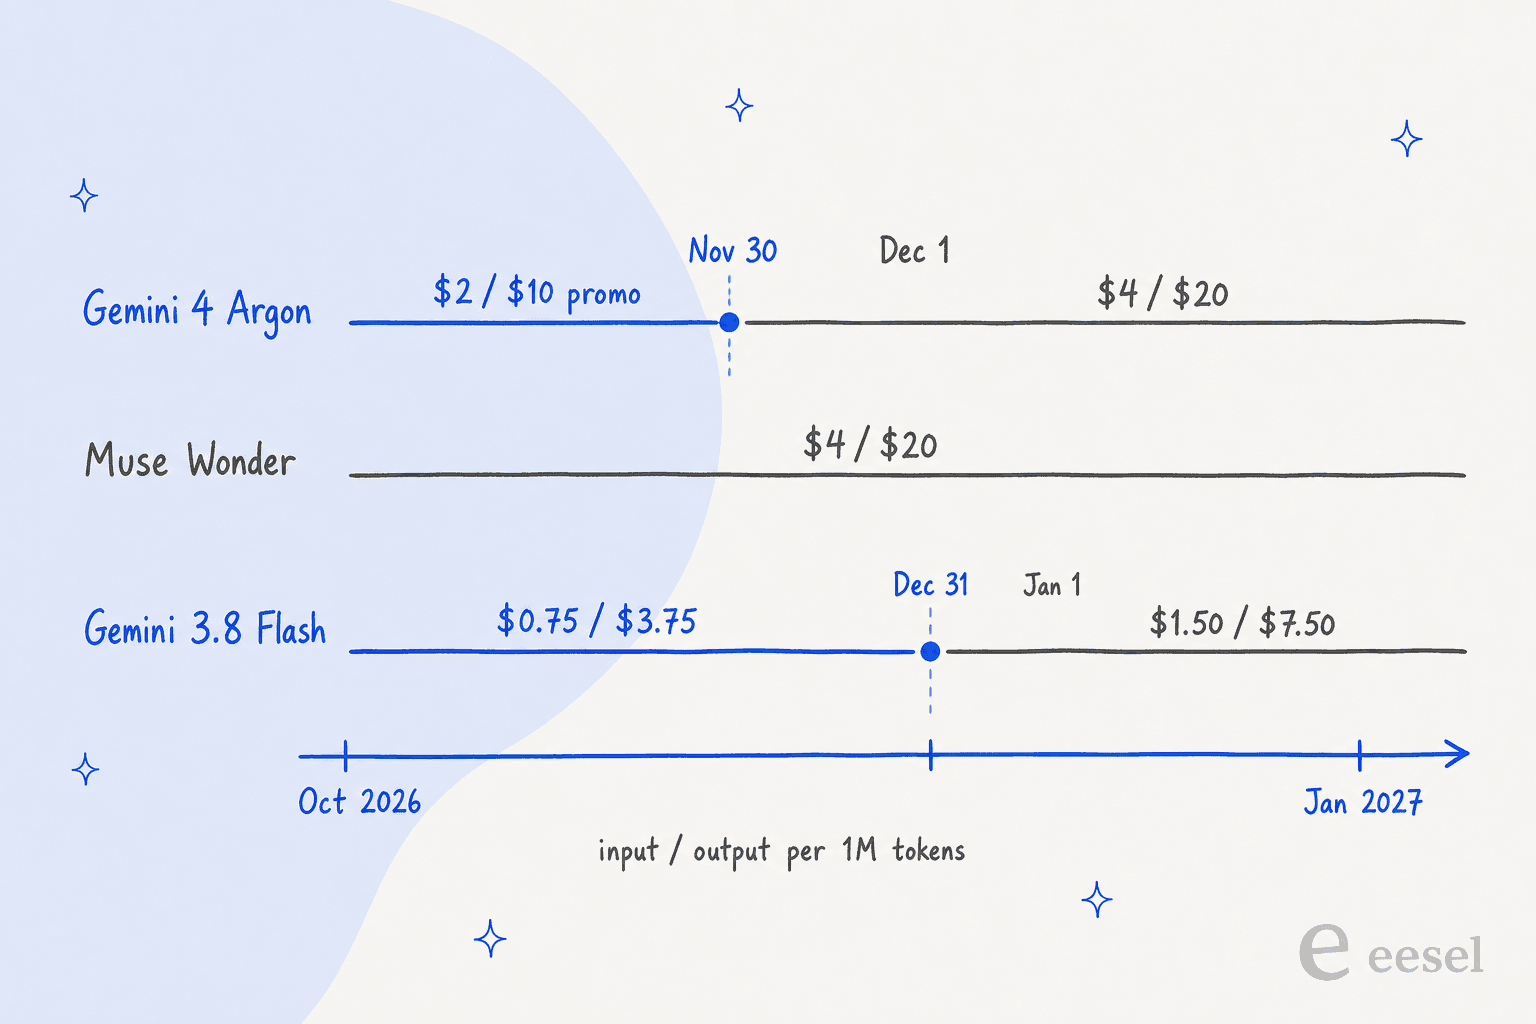
Am besten kann Argon lange Arbeit. Die Modellseite nennt ein einheitliches Fenster von 1.048.576 Tokens, standardmäßig 65.536 Output-Tokens und mit Long Decode bis zu 1.048.576, dazu Computernutzung in der Vorschau, Code-Ausführung, Dateisuche und Search Grounding. Bei Artificial Analysis liegt die Halluzinationsrate bei 15%, der niedrigste Wert aller Frontier-Modelle, die ich geprüft habe. Googles eigene Benchmark-Tabelle sieht es bei Finanz-, Rechts- und Business-Workflow-Aufgaben vorn, allerdings sind das Googles Läufe, nicht die AA-Versionen aus Metas Tabelle.
Vorteile: bis 30. November halber Preis von Wonder; ein Punkt höher im Index; niedrigste Halluzinationsrate im Frontier-Feld; Long Decode bis 1M Output-Tokens; Batch und Flex zum halben Preis.
Nachteile: Die Aktion endet am 1. Dezember; explizites Context Caching wird nicht unterstützt (nur implizites); kein kostenloses Kontingent; es schreibt viel, bei Artificial Analysis etwa $1.99 pro Aufgabe zum Aktionspreis.
Preise: $2 / $0.10 / $10 bis 30. November, danach $4 / $0.20 / $20; Batch und Flex $1 / $5 (danach $2 / $10); Priority $3.60 / $18. Siehe Gemini 4 Argon Preise.
Mein Fazit: Wenn lange Dokumente und Genauigkeit der Grund waren, warum Sie Wonder wollten, testen Sie Argon jetzt, solange es günstig ist. Planen Sie aber den Preis ab 1. Dezember ein, denn danach ist es ein direktes $4/$20-Duell mit Wonder und Opus 5.5.
3. Muse Wonder Full: das Upgrade innerhalb der Familie
Am besten für: einzelne Entwickler und kleine Teams mit langen Coding-Projekten, juristischen Entwürfen oder Finanzrecherche in Metas Coding-Agent.
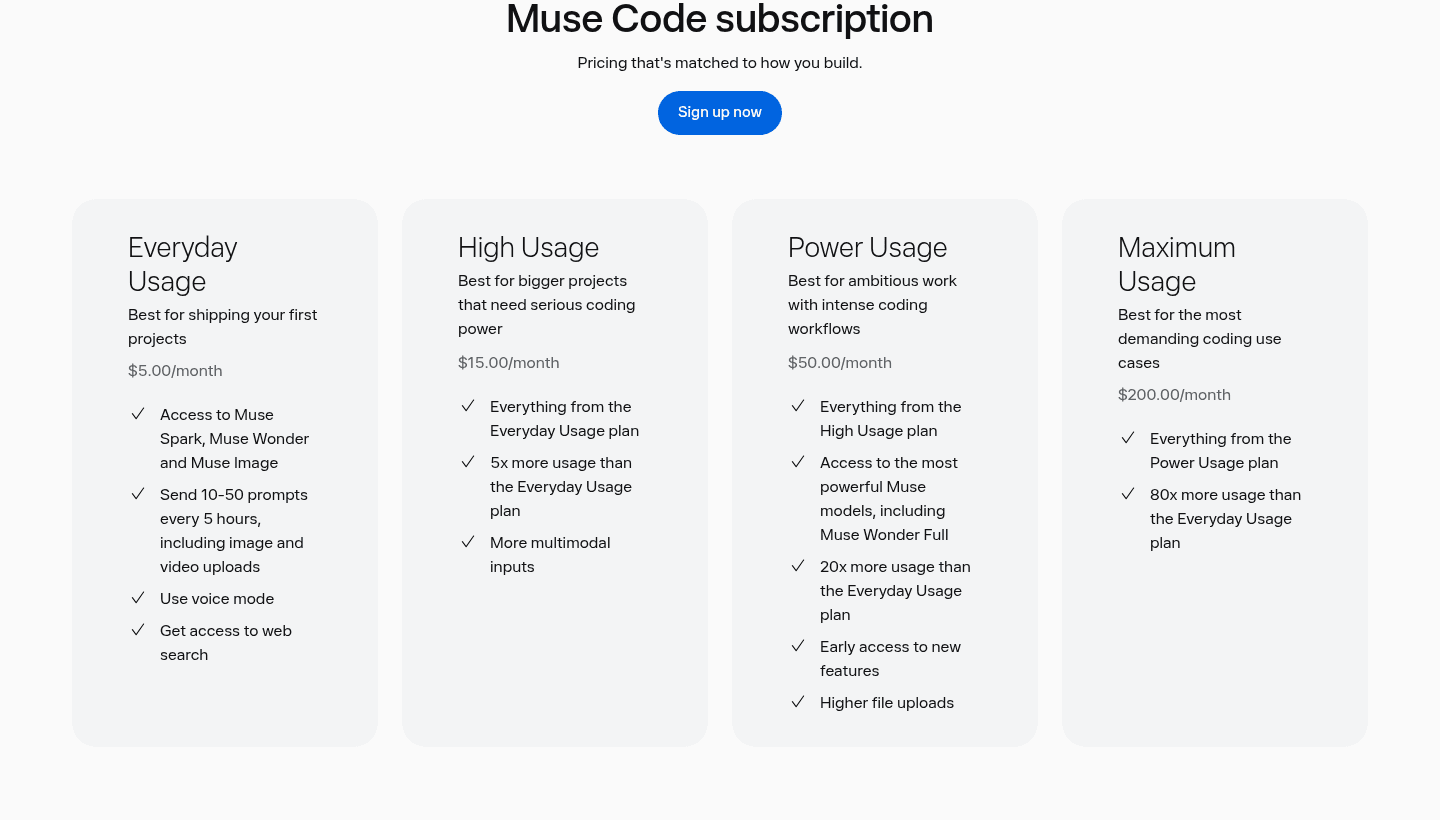
Wenn Ihnen Wonder wegen Metas Launch-Grafik gefallen hat, ist Wonder Full das Modell, das sie verdient hat. Es erreicht 56 im Index, beim Start hinter Opus 5.5 auf Platz zwei, und gewinnt 6 von Metas 14 Zeilen: den internen Gesamtwert, Recht (13.1 gegenüber 4.2 bei Opus 5.5), Finanzen, Business-Workflows, DeepSWE und SWE-Marathon (57.5 gegenüber 46.3). Kein anderes Modell in diesem Beitrag führt bei so vielen langen, dokumentenlastigen Aufgaben.
Der Haken ist der Zugang. Full gibt es nur im Muse-Code-Tarif Power Usage für $50 im Monat und Maximum Usage für $200. Es hat keinen Token-Preis, und laut Metas Modell-Doku wählt die Einstellung „max“ beim einfachen Wonder es nicht aus. Ein Abo-Schlüssel funktioniert zudem nur in der Muse-Code-CLI, Sie können also nicht den Traffic Ihres Produkts darüber laufen lassen.
"Super interesting that they're not even making Wonder Full available outside of their own coding harness, and thus not providing an API price to use in comparisons."
Zwei weitere Dinge sollten Sie vor dem Bezahlen wissen. Laut Abo-Doku starten die Tarife im Contributor-Modus, der Meta erlaubt, mit Ihren Prompts, Ihrem Code und Ihren Dateien zu trainieren, bis Sie ihn abschalten. Und die Tarife gelten ab 18 Jahren, ohne Erstattung und mit regional unterschiedlicher Verfügbarkeit; ein Kommentator berichtete, das Abo gebe es vorerst nur in Nordamerika.
Vorteile: Metas stärkstes Modell; führt bei Recht, Finanzen, Workflows und sehr langem Coding; fester Monatspreis statt Abrechnung pro Token.
Nachteile: nur im Abo, nur in Muse Code; Contributor-Modus standardmäßig an; regional begrenzt; nicht für den Betrieb einer App nutzbar.
Preise: Power Usage $50/Monat (20x Everyday-Nutzung) oder Maximum Usage $200/Monat (80x). Die günstigeren Tarife Everyday ($5) und High ($15) enthalten nur das einfache Wonder. Mehr in den Muse-Code-Preisen.
Mein Fazit: Wenn Sie Wonder für Ihr eigenes Coding wollten, überspringen Sie die API und zahlen Sie $50 für Full, mit abgeschaltetem Contributor-Modus ab Tag eins. Wenn Sie Wonder in einem Produkt wollten, ist Full keine Option, schauen Sie dann auf Punkt 1 und 2. Der Beitrag zu den Muse-Code-Alternativen behandelt die anderen Coding-Agenten im gleichen Budget.
4. GPT-6.1 Sol: Wonders Punktzahl zum halben Preis
Am besten für: Produktions-Apps, bei denen Wonders Qualitätsniveau reicht und die Rechnung zählt.
GPT-6.1 Sol erreicht in Metas eigener Launch-Grafik 52, genau wie Wonder. OpenAIs Preisseite nennt $2 Input, $0.10 gecacht und $10 Output, in jeder Zeile genau die Hälfte von Wonder. Für ein Produktteam ist das der sauberste Tausch auf dieser Liste: gleiches Benchmark-Niveau, halbe Rechnung.
Pro Aufgabe ist es ebenfalls effizient. Artificial Analysis maß 6.1 Sol bei maximalem Aufwand mit etwa $0.72 pro Aufgabe, und xhigh schlägt max bei seinem Coding-Agent-Index. Es hat ein Kontextfenster von 1.050.000 Tokens, 128.000 maximale Output-Tokens sowie Datenresidenz in den USA und der EU. OpenAIs eigene Aussage auf der DevDay war, dass es bei DeepSWE mit GPT-6 Astra mithält, zu etwa einem Fünftel der Kosten.
Der Unterschied zu Wonder liegt in der API-Form. 6.1 Sol hat keinen Aufwand none oder minimal, und Chat Completions funktioniert nur ohne Tool-Aufrufe; Agenten sollten daher die Responses API nutzen. Prompts über 272K Input-Tokens werden zu einem höheren Satz abgerechnet.
Vorteile: gleicher Index-Wert wie Wonder zum halben Preis; günstig pro Aufgabe; starke Ergebnisse bei Coding-Agenten; EU-Datenresidenz.
Nachteile: kein Aufwand none; Tool-Aufrufe brauchen die Responses API; lange Prompts über 272K kosten mehr; keine offenen Gewichte.
Preise: $2 / $0.10 / $10 pro 1M Tokens, Cache-Schreiben $2.50; über 272K Input $4 / $0.20 / $15; Batch und Flex $1 / $5. Aufschlüsselung in den GPT-6.1-Sol-Preisen.
Mein Fazit: Wenn Sie Wonder als solides Arbeitspferd statt als Aushängeschild nutzen wollten, ist das hier das Richtige. Lassen Sie Ihre Aufgaben durch beide laufen, und wenn Wonder nicht klar gewinnt, gewinnt der halbe Preis.
5. GPT-6 Astra: OpenAIs Top-Stufe zum 2,5-Fachen von Wonders Preis
Am besten für: Teams, die bereits auf OpenAI setzen und dessen Top-Modell oder die Ultrafast-Geschwindigkeitsstufe brauchen.
GPT-6 Astra war der erste Name auf der Shortlist des KI-Assistenten, und es ist ein starkes Modell: ein Fenster von 1.050.000 Tokens, integrierte gehostete Shell, Apply-Patch, Computernutzung und MCP sowie der Bestwert in Metas Zeile GDP.pdf für professionelle Arbeit (34.2). Es ist außerdem das erste Modell, das OpenAI bei Cybersicherheit als „Critical“ eingestuft hat, mit eingeschränkter fortgeschrittener Cyber-Nutzung.
Die Zahlen sprechen aber nicht für es als Wonder-Ersatz. Es erreicht in Metas Grafik 53, einen Punkt über Wonder, kostet aber $10 Input und $50 Output pro Million Tokens, das 2,5-Fache von Wonders Preis. Wonder Full schlägt es in 11 von 14 Zeilen von Metas Tabelle. Bei Artificial Analysis kostet Astra mit maximalem Aufwand etwa $3.26 pro Aufgabe.
Das Einzige, was nur Astra aktuell hat, ist Ultrafast. OpenAIs Preisseite nennt Ultrafast-Preise nur für Astra, mit $60 Input und $300 Output pro Million Tokens. Wenn Ihr Produkt diese Geschwindigkeitsstufe diesen Monat braucht, ist es die einzige Option der GPT-6-Familie.
Vorteile: OpenAIs stärkstes Modell; integrierte Agent-Tools; Bestwert bei GDP.pdf in Metas Tabelle; die einzige Ultrafast-Option.
Nachteile: das 2,5-Fache von Wonders Preis für einen weiteren Index-Punkt; lange Prompts über 272K werden mit $20 / $75 abgerechnet; Wonder Full übertrifft es in den meisten Zeilen von Meta.
Preise: $10 / $1 / $50 pro 1M Tokens; Batch und Flex $5 / $25; Fast $20 / $100; Ultrafast $60 / $300. Siehe GPT-6 Astra Preise.
Mein Fazit: Allein wegen der Qualität würde ich nicht von Wonder auf Astra wechseln. Wählen Sie es, wenn Sie OpenAI standardisieren und Ultrafast brauchen oder wenn Ihre eigenen Tests es bei professionellen Dokumenten vorn sehen.
6. Claude Sonnet 5.5: halb so teuer wie Opus, beim Coding nah dran
Am besten für: Coding-Agenten und Tool-lastige Apps, die Anthropic-Qualität zum halben Opus-Preis wollen.
Claude Sonnet 5.5 kostet $2 Input und $10 Output, die Hälfte von Wonder, und Anthropics Preisdokumentation nennt jetzt für den Cache-Treffer $0.10, die Hälfte von Wonders $0.20. Bei maximalem Aufwand erreicht es bei Artificial Analysis 56, über dem einfachen Wonder. In Anthropics Launch-Zahlen schlägt es sogar Opus 5.5 bei Terminal-Bench 4.0 (70.6 gegenüber 66.4).
Der Haken ist der Aufwand. Die 56 gibt es bei maximalem Aufwand, wo Artificial Analysis etwa $7.60 pro Aufgabe maß, mehr als bei Opus 5.5. Bei hohem Aufwand erreicht es 47 für $1.08, und Anthropic selbst sagt, die Ersparnis zeige sich bei niedrigem und mittlerem Aufwand. Mein Sonnet-5.5-Test fand es bei „medium“ großartig und bei „max“ eine Falle.
Es kam außerdem mit Breaking Changes: Erzwungenes tool_choice gibt einen Fehler zurück, thinking: disabled gibt einen Fehler zurück, und Thinking-Blöcke sind an das Modell gebunden, sodass der Gesprächsverlauf nur angehängt werden darf.
Vorteile: halber Token-Preis von Wonder, mit günstigerem Cache-Treffer; starkes Terminal-Coding; gleiches 1M-Fenster und 128K Output wie Opus.
Nachteile: maximaler Aufwand kostet pro Aufgabe mehr als Opus 5.5; Breaking Changes in der API seit Sonnet 5; keine erzwungene Tool-Nutzung.
Preise: $2 / $0.10 / $10 pro 1M Tokens; Cache-Schreiben 5 Minuten $2.50, 1 Stunde $4; Batch $1 / $5. Aufschlüsselung in den Sonnet-5.5-Preisen.
Mein Fazit: Ein guter Wonder-Ersatz für Coding-Agenten, wenn Sie es bei niedrigem oder mittlerem Aufwand lassen. Wenn Sie merken, dass Sie es auf „max“ drehen, wechseln Sie stattdessen zu Opus 5.5.
7. Muse Spark 1.3: Metas eigene Antwort für Volumen
Am besten für: Arbeit mit hohem Volumen und Latenzempfindlichkeit, für Teams, die bei Metas API bleiben wollen.
Das ist die Alternative, die Meta selbst empfiehlt. Die Modell-Doku bewirbt Wonder für lange, komplexe Aufgaben und verweist bei hohem Volumen, Latenz- oder Kostenempfindlichkeit auf Muse Spark. Muse Spark 1.3 kostet $1.25 Input, $0.15 gecacht und $4.25 Output pro Million Tokens, weniger als ein Viertel von Wonders Output-Preis, und erreicht in Metas Grafik 48.
Regelmäßige Nutzer bewerten es für den Preis gut:
"I've been a regular user of muse spark 1.3 ... and I can tell you one thing for sure that this model, muse-spark-1.3 in xhigh mode, is between sol-6-medium and high."
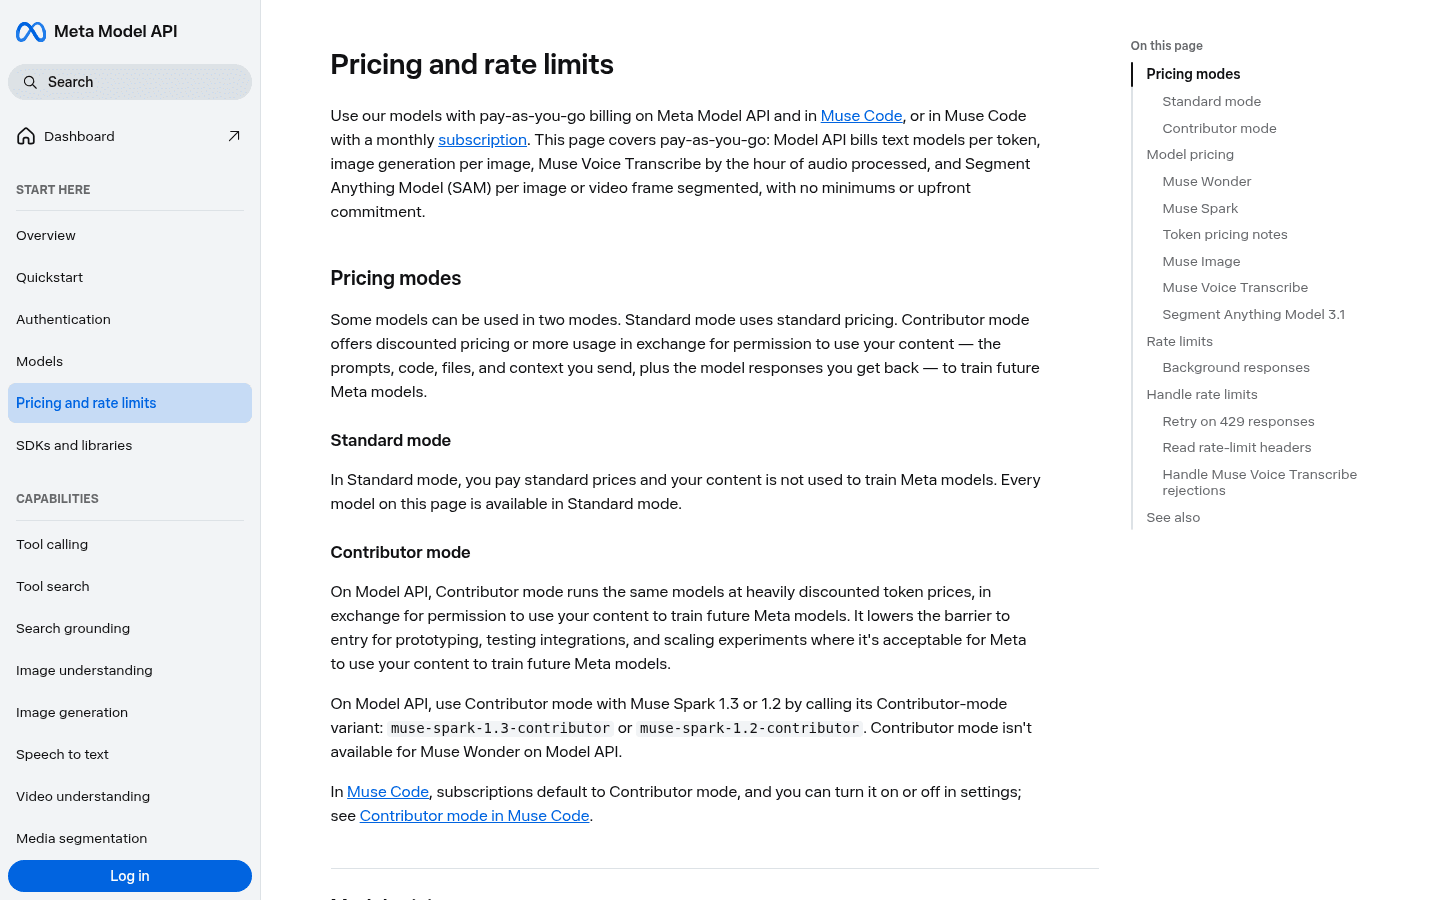
Spark hat auch etwas, das Wonder nicht hat: eine Contributor-Variante in der API. Metas Preisseite erklärt, dass muse-spark-1.3-contributor zu stark reduzierten Preisen läuft (rund $0.10/$0.20), wenn Meta dafür mit Ihren Inhalten trainieren darf. Der Contributor-Modus ist für Wonder in der API nicht verfügbar. Für Prototypen ist das ein guter Tausch, für Kundendaten ein schlechter. Noch etwas: Spark 1.3 ist wortreich und braucht etwa 120 Millionen Output-Tokens für den Artificial-Analysis-Index gegenüber einem Median von 72 Millionen.
Vorteile: weniger als ein Viertel von Wonders Output-Preis; gleiche API, gleicher Anbieter, leicht dazwischen zu routen; optionaler Contributor-Rabatt für nicht sensible Arbeit.
Nachteile: 4 Punkte unter Wonder im Index; wortreich, was die Ersparnis auffrisst; die für Spark versprochenen offenen Gewichte sind nicht erschienen.
Preise: Standard $1.25 / $0.15 / $4.25 pro 1M Tokens; Contributor-Variante etwa $0.10 / $0.20 mit Training auf Ihren Daten. Siehe Muse Spark 1.3 Preise.
Mein Fazit: Das clevere Meta-Setup ist Routing statt Auswahl: Spark für den Großteil der Anfragen, Wonder für die langen, schweren. Wenn der Großteil Ihres Traffics einfach ist, senkt allein das die Rechnung deutlich.
8. Gemini 3.8 Flash: die günstige Option mit kostenlosem Kontingent
Am besten für: Batch-Jobs, Prototypen und kostenorientierte Pipelines, bei denen niemand auf das erste Token wartet.
Das ist der Platz „Tempo und Kosten“, den der KI-Assistent mit Gemini 3.5 Flash besetzt hat, das Google inzwischen als veraltet markiert hat. Das aktuelle Modell, Gemini 3.8 Flash, kostet $0.75 Input und $3.75 Output pro Million Tokens, etwa ein Fünftel von Wonders Preis, und es ist das einzige Modell auf dieser Liste mit kostenlosem Kontingent. Google hat außerdem 3.7 Flash am 8. Oktober als veraltet markiert und leitet dessen Anfragen an 3.8.
Bei Artificial Analysis erreicht es bei hohem Aufwand 41, deutlich unter Wonder, für etwa $1.24 pro Aufgabe. Zwei Haken. Erstens verdoppelt sich der Preis am 1. Januar 2027 auf $1.50/$7.50. Zweitens maß Artificial Analysis eine Zeit bis zum ersten Token von 13,30 Sekunden, es passt also schlecht zu allem, worauf ein Mensch wartet, etwa einem Chat-Widget.
Zum kostenlosen Kontingent sagt Googles Preisseite, dass Ihre Inhalte zur Verbesserung der Produkte verwendet werden; im kostenpflichtigen Kontingent nicht.
Vorteile: etwa ein Fünftel von Wonders Preis; kostenloses Kontingent zum Testen; Batch und Flex zum halben Preis; 1M-Fenster.
Nachteile: weit unter Wonder im Index; langsames erstes Token; der Preis verdoppelt sich am 1. Januar; das kostenlose Kontingent trainiert mit Ihren Daten.
Preise: $0.75 / $0.075 / $3.75 pro 1M Tokens bis 31. Dezember, danach $1.50 / $0.15 / $7.50; Batch und Flex mit 50 % Rabatt. Siehe Gemini 3.8 Flash Preise.
Mein Fazit: Gut für den nächtlichen Batch-Job, für den Sie sonst bei Wonder zu viel gezahlt hätten. Kein Ersatz für Wonders schwere Aufgaben und nichts für Live-Einsatz.
9. DeepSeek V4.1 Flash: offene Gewichte und die kleinste Rechnung
Am besten für: Teams, die offene Gewichte oder die niedrigstmöglichen Kosten pro Token brauchen.
Muse Wonder hat keine offenen Gewichte, und Meta hat die Gewichte, die es für Muse Spark versprochen hat, noch immer nicht veröffentlicht. Wenn Sie ein Modell brauchen, das Sie selbst betreiben können, ist DeepSeek V4.1 Flash hier die stärkste Option: Gewichte unter MIT-Lizenz auf Hugging Face, ein 1M-Kontextfenster und bis zu 384K Output-Tokens.
Die gehostete API ist sehr günstig. DeepSeeks Preisseite nennt für deepseek-flash $0.15 Input und $0.60 Output pro Million Tokens außerhalb der Stoßzeiten und $0.30/$1.20 zu Stoßzeiten (wochentags morgens UTC). Das sind außerhalb der Stoßzeiten etwa 3 % von Wonders Output-Preis. Artificial Analysis bewertet es bei maximalem Aufwand mit 39,5 für etwa $0.27 pro Aufgabe.
Die Nachteile sind real. Die Halluzinationsrate bei Artificial Analysis liegt bei 96%, der höchste Wert, den ich bei einem aktuellen Modell gesehen habe, es braucht also strenge Verankerung in Quellen. Die gehostete API verarbeitet Daten in China, und die Bezahlbedingungen sagen nicht, ob Ihre Daten zum Training genutzt werden. Self-Hosting löst die Datenfrage, braucht aber für ein Modell mit 552B Parametern ernsthafte Hardware.
Vorteile: offene Gewichte unter MIT; niedrigster Preis auf dieser Liste; starke Ergebnisse beim Tool-Einsatz für die Kosten; 384K maximaler Output.
Nachteile: 12,5 Punkte unter Wonder im Index; sehr hohe Halluzinationsrate; Datenbedenken bei der gehosteten API; aufwendig selbst zu hosten.
Preise: außerhalb der Stoßzeiten $0.003 Cache-Treffer, $0.15 Input, $0.60 Output pro 1M Tokens; zu Stoßzeiten doppelt. Siehe DeepSeek V4.1 Flash Preise. Kimi K3 ist die andere Option mit offenen Gewichten, für $3/$15.
Mein Fazit: Wählen Sie es für offene Gewichte oder die Massenverarbeitung nicht sensibler Texte. Halten Sie es von allem fern, wo eine selbstsichere falsche Antwort teuer wird.
So testen Sie Ihre Shortlist: dieselben fünf Aufgaben für jeden Finalisten
Das ist der Teil, den die Benchmark-Tabellen nicht für Sie erledigen können. Wählen Sie zwei oder drei Finalisten von oben aus und lassen Sie dieselben fünf Aufgaben durch jeden laufen, plus Wonder selbst. Notieren Sie für jeden Lauf drei Zahlen: bestanden oder durchgefallen, Kosten und Sekunden.
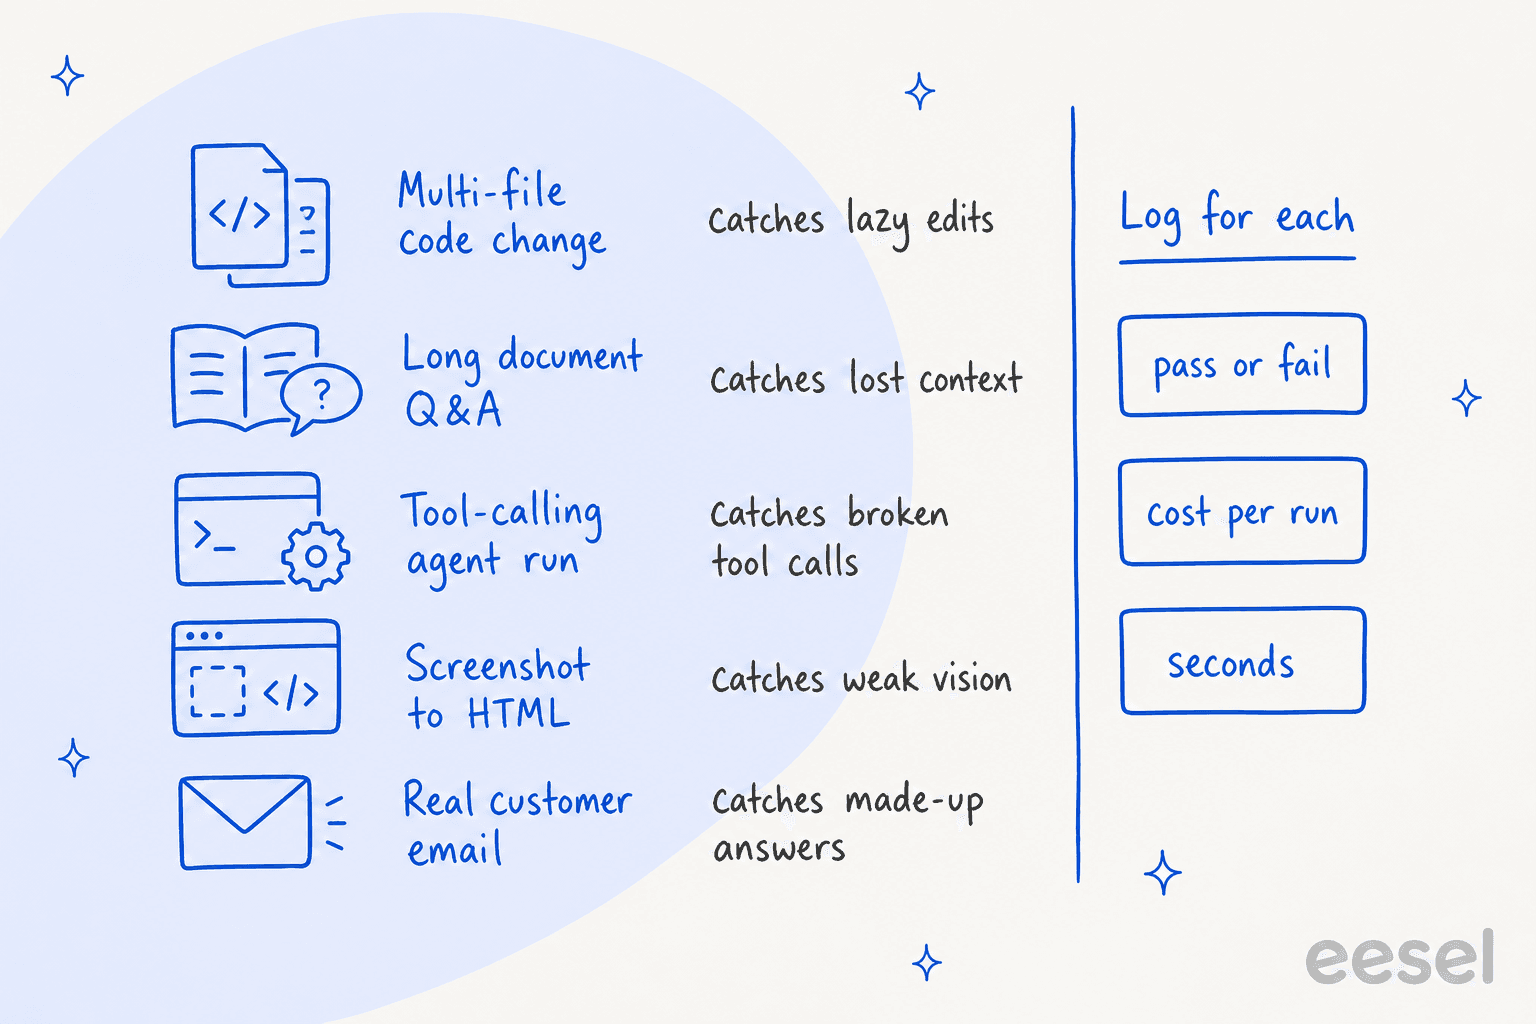
Jede Aufgabe soll einen bestimmten Fehler aufdecken. Und jeder Finalist hat eine Aufgabe, die er gewinnen sollte, wenn seine Benchmarks ehrlich sind:
| Finalist | Was ich zuerst testen würde | Zentrale Frage |
|---|---|---|
| Claude Opus 5.5 | Screenshot zu HTML, Codeänderung über mehrere Dateien | Schlägt Wonder es bei irgendetwas zum gleichen Preis? |
| Gemini 4 Argon | Fragen zu einem langen Dokument | Bleibt es über 500K Tokens genau, und ergibt der Dezember-Preis noch Sinn? |
| Muse Wonder Full | Codeänderung über mehrere Dateien in Muse Code | Sind $50 im Monat gegenüber dem einfachen Wonder es wert? |
| GPT-6.1 Sol | Lauf eines Agenten mit Tool-Aufrufen | Reicht die Qualität zum halben Preis für die Produktion? |
| Muse Spark 1.3 oder Gemini 3.8 Flash | Die einfachsten 80 % Ihres echten Traffics | Kann das günstige Modell die meisten Anfragen übernehmen? |
Die Aufgabe Screenshot zu HTML ist nicht ohne Grund dabei. Ein Entwickler führte sie am Starttag aus und fand das einfache Wonder deutlich schwächer als Opus 5.5, näher an Sonnet oder Haiku. Genau so eine Lücke findet ein einstündiger Test und versteckt eine Benchmark-Tabelle.
Halten Sie den Test klein genug, um ihn zu wiederholen. Modellpreise und -versionen ändern sich alle paar Wochen (bei Argon am 1. Dezember, bei Flash am 1. Januar), und der günstigste Weg, beim richtigen Modell zu bleiben, ist, dieselben fünf Aufgaben bei jeder Neuerscheinung erneut laufen zu lassen.
Was ein Modellwechsel für ein Support-Team bedeutet
Wenn Sie Entwickler sind, ist der Test oben Ihr nächster Schritt. Wenn Sie Support-Leiter sind und über die Berichte zum Wonder-Start hier gelandet sind, lautet die ehrliche Antwort anders: Das Modell ist der kleinste Teil eines KI-Support-Agenten.
Welches Modell Sie auch wählen, jemand muss es noch mit Ihrem Helpdesk verbinden, seine Antworten innerhalb Ihres freigegebenen Wissens halten, entscheiden, wann es an einen Menschen übergibt, und belegen, dass es richtig liegt, bevor ein Kunde es sieht. Das sind die Aufgaben, die ich die meiste Zeit baue, und keine davon ändert sich, wenn sich das Modell ändert. Die Notizen zu Muse für den Kundensupport und Muse für Zendesk zeigen, wie viel Verbindungsarbeit ein rohes Modell braucht.
Deshalb zählen die Halluzinationswerte von DeepSeek und Gemini Flash oben im Support mehr als beim Code. Eine falsche Codezeile lässt einen Test fehlschlagen. Eine falsche Erstattungsregel erreicht einen Kunden. Wenn Sie es ohnehin selbst bauen, vergleicht der Leitfaden zum besten Modell für Support-Tickets Modelle speziell für diese Aufgabe, und die Erklärung zu KI-Agenten vs. Chatbots zeigt, was die Agent-Ebene hinzufügt.
eesel ausprobieren
Muse Wonder und jedes Modell auf dieser Liste sind Infrastruktur; eesel ist der Mitarbeiter. eesel ist eine Plattform für KI-Teammitglieder, auf der Sie einsatzbereite Teammitglieder für bestimmte Aufgaben einstellen, und heute sind das zwei Rollen: ein KI-Helpdesk-Teammitglied und ein KI-Blog-Autor. Jedes läuft auf Frontier-Modellen, sodass Sie von Modell-Upgrades profitieren, ohne jeden Monat einen neuen Modellvergleich zu starten.
Das Helpdesk-Teammitglied wird an Zendesk, Freshdesk oder Gorgias angebunden, lernt aus Ihren früheren Tickets und Ihrem Help Center und antwortet nur aus dem, was Sie freigegeben haben. Bevor es jemandem antwortet, können Sie es gegen Ihre historischen Tickets laufen lassen und sehen, was es gesagt hätte. Die Tarife sind eine monatliche Pauschale, bei der ein Ticket einem Credit entspricht, ab $299 im Monat für 500 Credits, mit 100 kostenlosen Credits zum Start, laut eesel-Preisseite.

Da Sie wahrscheinlich Entwickler sind, wenn Sie bis hierher gelesen haben, lohnt sich ein Blick auf die eesel CLI. Sie ist ein npm-Paket (@eesel/cli), das dasselbe Teammitglied und denselben Workspace wie das Dashboard steuert, aus Ihrem Terminal, einem Skript oder einem Coding-Agenten wie Claude Code. eesel activity listet auf, was das Teammitglied getan hat, und lässt Sie jeden Lauf im Detail lesen, eesel approvals list zeigt Aktionen, die auf einen Menschen warten, und --dry-run gibt den genauen Aufruf aus, den eine Änderung auslösen würde, ohne ihn zu senden. Jeder Befehl gibt JSON aus, und Ihr Workspace funktioniert auch als MCP-Server, sodass ein Agent ihn genauso verwalten kann wie Sie. Die Anleitung zum Verwalten von Agenten über das Terminal führt Sie durch alles.
Wenn Ihnen Wonder aufgefallen ist, weil Sie KI in Ihrer Support-Warteschlange arbeiten lassen wollen, sparen Sie sich die Modellsuche und testen Sie eesel mit Ihren eigenen Tickets.