Die 7 besten Gemini-4-Neon-Alternativen 2026, bepreist nach Kosten pro Aufgabe

Kira

Katelin Teen
Zuletzt bearbeitet 19. November 2026
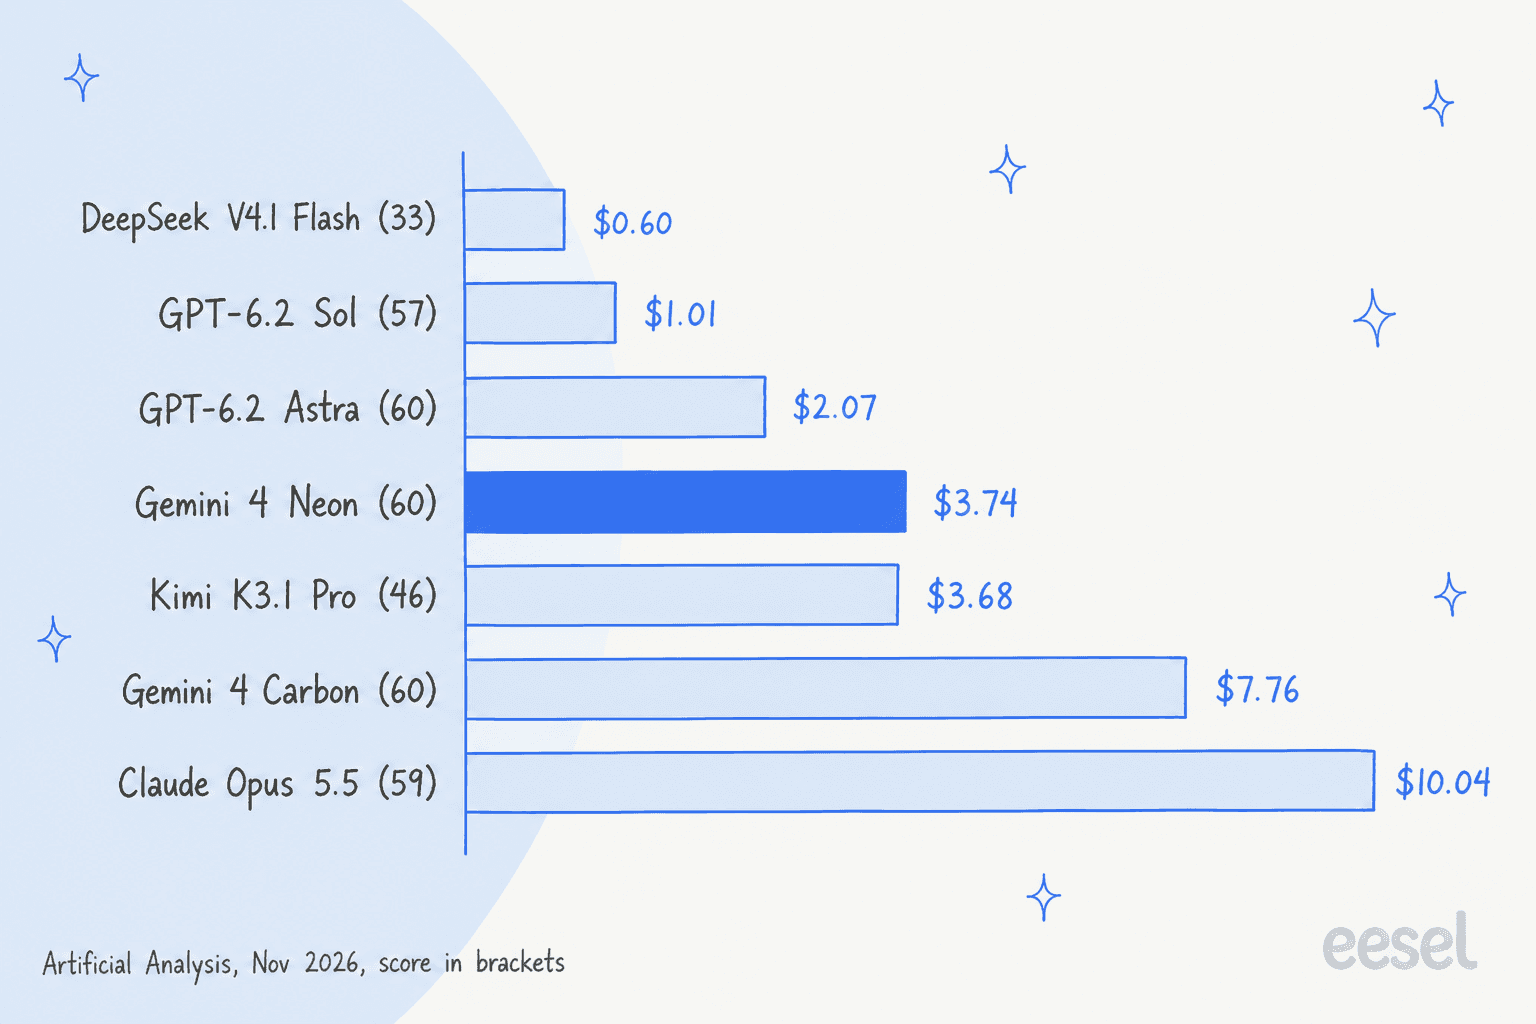
Die beste Gemini-4-Neon-Alternative ist GPT-6.2 Sol: Artificial Analysis bewertet es mit 57,3 für $1,01 pro Aufgabe, gegenüber Neons 59,6 für $3,74. Astra erreicht Neons Score für $2,07, Opus 5.5 kostet $10,04, und Carbon, Kimi K3.1 Pro und DeepSeek gewinnen bei Ehrlichkeit, offenen Gewichten oder Massenpreisen. Neons Vorteil ist, dass es bei 14 % der unbeantwortbaren Fragen falsch rät, nicht bei 55 %. Für einen Support-Bot trifft ein eesel-Helpdesk-Teammitglied diese Entscheidung für Sie und testet sie an Ihren vergangenen Tickets.
Warum suchen Leute nach Gemini-4-Neon-Alternativen?
Gemini 4 Neon ist das mittlere Modell von Googles Gemini-4-Familie, veröffentlicht am 18. November 2026. Es kostet $3 Input und $15 Output pro Million Token, hat ein Kontextfenster von 1.048.576 Token und keine kostenlose Stufe. Mein Neon-Test befand es als starkes Modell: etwa die Hälfte von Carbons Kosten pro Aufgabe, und ungewöhnlich bereit, "Ich weiß es nicht" zu sagen.
Die Gründe, sich umzusehen, drehen sich alle um die Rechnung und den Stack. Neon schreibt viele Token, kostet also mehr pro Aufgabe als OpenAIs Modelle, und ein Hacker-News-Leser bemerkte das am Launch-Tag:
"That looks to me like OpenAI equals or beats everything Google offers at half the price."

Andere wollen einen Anbieter, der nicht Google ist, offene Gewichte zum selbst hosten, oder ein Modell, das im Live-Chat schneller ist. Das sind unterschiedliche Aufgaben, daher habe ich die Alternativen nach Aufgabe sortiert und eine Zahl unter alle gestellt: Kosten pro Aufgabe.
Wenn Sie eines dieser Modelle an Support-Fragen testen möchten, ohne einen eigenen Testaufbau zu bauen, lässt der eesel CLI einen Coding-Agenten freigegebene Hilfe-Artikel und Makros zu einem eesel-Helpdesk-Teammitglied hochladen, dann Testfragen stellen und die Antworten prüfen, bevor irgendetwas live geht. Den Helpdesk selbst zu verbinden braucht weiterhin die Freigabe eines Admins.
Wie ich diese Alternativen ausgewählt habe
Ich bin von dem ausgegangen, was ein Käufer sieht. Ich habe ChatGPT in einem neuen Chat gefragt, welche Alternativen für eine App gegen Gemini 4 Neon verglichen werden sollten. Es nannte sechs, in dieser Reihenfolge: GPT-6.2 Astra, Claude Opus 5.5, GPT-6.2 Sol, Gemini 4 Carbon, Kimi K3 und DeepSeek V4.1 Flash. Es riet dem Fragenden außerdem, "Kosten pro erfolgreicher Aufgabe" zu vergleichen, sowie Tool-Aufrufe, JSON-Gültigkeit, Latenz und Wiederholungen, nicht den Preis pro Million Token. Ich bin diesem Rahmen gefolgt und habe Claude Sonnet 5.5 hinzugefügt, weil es sich den Preis von Sol teilt, sich aber sehr anders verhält.
Für jedes Modell habe ich drei Dinge genutzt, alle am 19. November 2026 geprüft:
- Die eigenen Seiten des Anbieters: Preise, Modellseite, Kontextfenster und Tool-Unterstützung, jeweils im Abschnitt unten verlinkt. Jeder Preis in diesem Beitrag stammt von diesen Seiten, nicht von Dritten.
- Artificial Analysis: seine Ergebnisse je Einstellung für Score, Kosten pro Aufgabe, Minuten pro Aufgabe und Halluzinationsrate. Eine "Aufgabe" ist eine Benchmark-Aufgabe aus seinem Intelligence Index, nicht eines Ihrer Tickets.
- Hacker News: die Launch-Threads für Neon, Astra und Sol, in denen Entwickler ihre eigenen Kosten und Zeiten gepostet haben.
Ich habe Neon nicht selbst getestet, da ich keinen Google-Schlüssel dafür habe. Ich habe letzte Woche einen Test mit 90 Durchläufen auf Astra und Sol zum Support gemacht und nutze diese Ergebnisse, wo sie zutreffen. Behandeln Sie das Ranking als Shortlist und nutzen Sie dann den Testabschnitt, um es an Ihrer Arbeit zu prüfen.
Was sagen die Kosten pro Aufgabe über Neons Alternativen?
Der Preis pro Token ist nur die halbe Geschichte. Die Rechnung ist Preis multipliziert mit der Anzahl der geschriebenen Token, und Denk-Token zählen als Output. Artificial Analysis veröffentlicht beide Hälften, daher ist dies die Tabelle, mit der ich anfangen würde:
| Modell und Einstellung | Index-Score | Kosten pro Aufgabe | Minuten pro Aufgabe | Output-Token pro Aufgabe | Falsch bei Unsicherheit |
|---|---|---|---|---|---|
| Gemini 4 Neon high (Standard) | 59,6 | $3,74 | 14,8 | 90.188 | 14 % |
| Gemini 4 Neon medium | 54,9 | $1,90 | 8,3 | 50.000 | 16 % |
| GPT-6.2 Astra max | 62,1 | $4,00 | 13,7 | 41.029 | 59 % |
| GPT-6.2 Astra high | 60,1 | $2,07 | 5,9 | 17.828 | 58 % |
| GPT-6.2 Sol max | 57,3 | $1,01 | 8,5 | 40.360 | 55 % |
| GPT-6.2 Sol high | 54,9 | $0,56 | 4,6 | 20.160 | 60 % |
| Claude Opus 5.5 max | 59,1 | $10,04 | 24,5 | 173.313 | 50 % |
| Claude Opus 5.5 medium (API-Standard) | 48,2 | $2,45 | 6,9 | 43.817 | 67 % |
| Claude Sonnet 5.5 max | 54,5 | $10,02 | 32,6 | 285.387 | 43 % |
| Claude Sonnet 5.5 high (API-Standard) | 41,5 | $1,64 | 7,2 | 58.421 | 64 % |
| Gemini 4 Carbon high | 60,0 | $7,76 | 37,2 | 122.768 | 11 % |
| Kimi K3.1 Pro | 46,5 | $3,68 | 39,4 | 72.239 | 37 % |
| DeepSeek V4.1 Flash 1017 max | 32,6 | $0,60 | 13,7 | 138.962 | 64 % |
Alles in der Tabelle wurde am 19. November 2026 von Artificial Analysis abgelesen. "Falsch bei Unsicherheit" ist dessen AA-Omniscience-Halluzinationsrate, bei der niedriger besser ist. Die Modellseiten:
- Gemini 4 Neon und Gemini 4 Carbon
- GPT-6.2 Astra
- Claude Opus 5.5
- Claude Sonnet 5.5
- Kimi K3.1 Pro
- DeepSeek V4.1 Flash 1017
Vier Dinge fallen auf:
- Gleicher Score, unterschiedliche Rechnung. Astra bei high erreicht 60,1 für
$2,07, das sind45 %weniger als Neons$3,74für 59,6. Opus 5.5 bei max kostet$10,04für 59,1, etwa das 2,7-Fache von Neon. - Sol bei high erreicht Neon bei medium. Beide erzielen 54,9 Punkte, aber Sol kostet
$0,56und Neon$1,90. - DeepSeek ist pro Aufgabe nicht günstig. Sein Input-Preis ist 13-mal niedriger als Sols, trotzdem kostet eine Aufgabe
$0,60gegenüber Sol highs$0,56, bei einem Score von 32,6 gegenüber 54,9. Es schreibt dafür 138.962 Token. - Neon ist das ehrliche Modell. Mit
14 %schlägt nur Carbon es unter den Modellen oben, die nahe 60 punkten. Sol, Astra und Opus raten bei 50 % bis 59 % der unbeantwortbaren Fragen falsch.
Der Grund ist die Ausführlichkeit, und das ist der Teil des Mechanismus, den Leute überspringen. Output-Token sind die teure Seite jeder Preiskarte, und jedes Modell hat seine eigene Gewohnheit, wie viele es schreibt, bevor es antwortet:
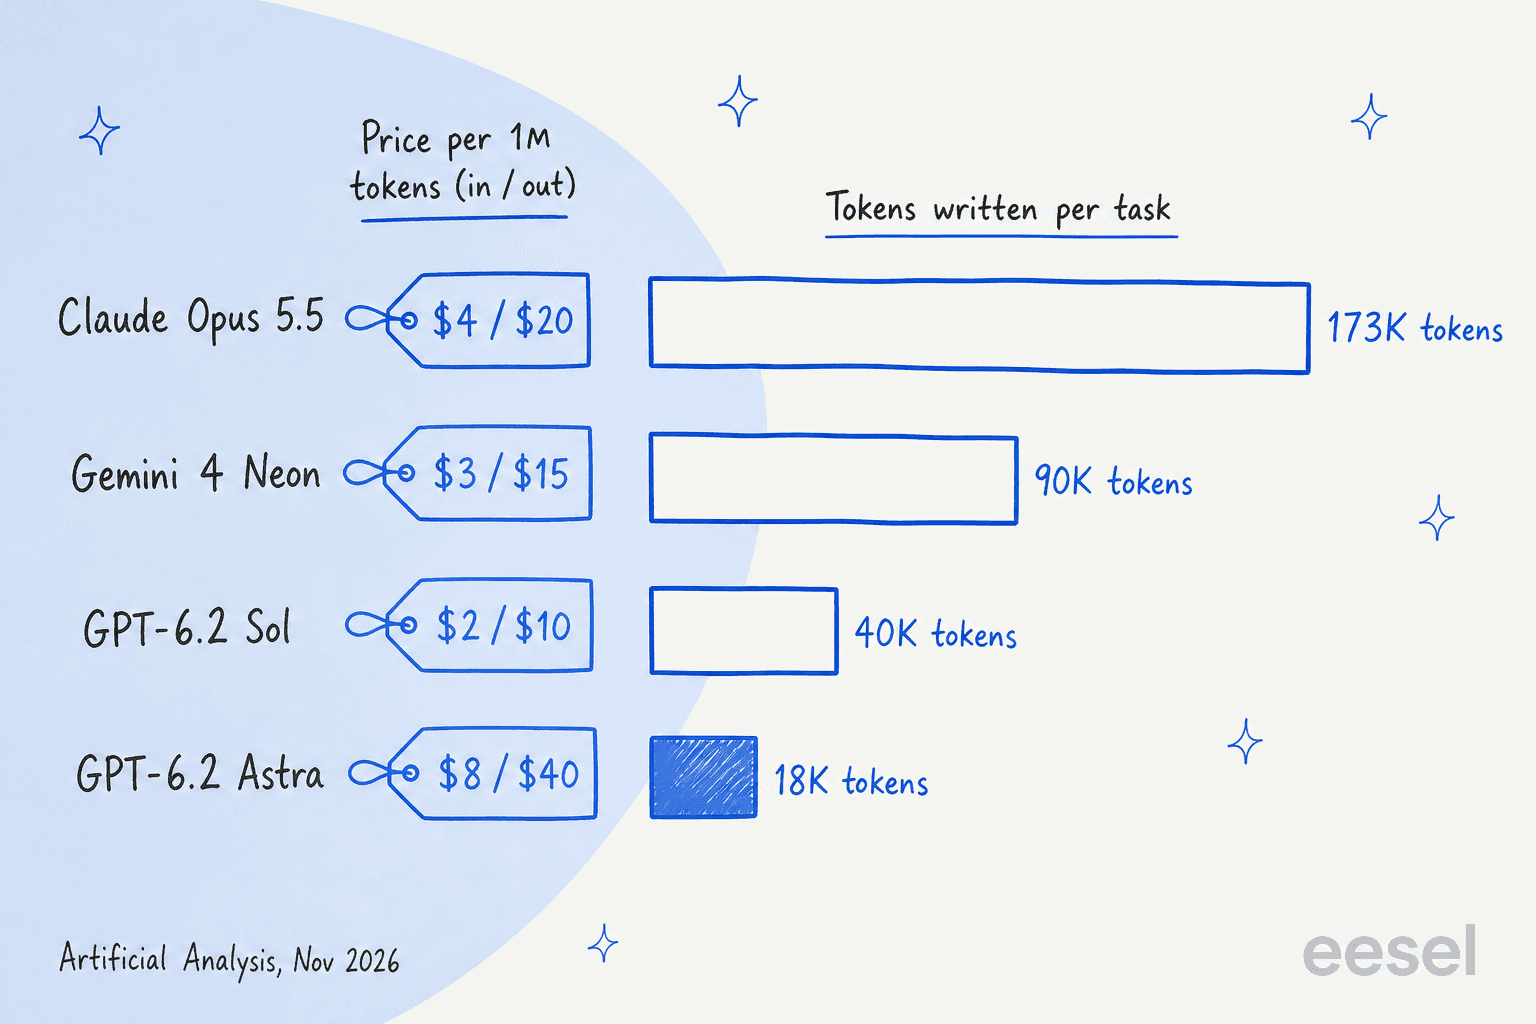
Das Diagramm nutzt die Einstellung mit dem höchsten Score jedes Modells für Opus und Sol, und die Standardeinstellung high für Neon und Astra. Astra hat den teuersten Preis der vier und die günstigste Gewohnheit: Es schreibt etwa ein Fünftel von dem, was Neon für den gleichen Score schreibt. Deshalb sage ich Leuten, sie sollen keine Preiskarten vergleichen.
Gemini-4-Neon-Alternativen im Überblick
Hier ist alles andere, was ein Käufer fragt, aus den eigenen Dokumenten jedes Anbieters:
| Modell | Preis pro 1M (Ein-/Ausgabe) | Gecachter Input | Kontext | Bester Score (Einstellung) | Kostenlose API-Stufe | Offene Gewichte | Datenresidenz-Option |
|---|---|---|---|---|---|---|---|
| Gemini 4 Neon (Referenz) | $3 / $15 | $0,15, nur implizit | 1.048.576 | 61,4 (xhigh) | Keine | Nein | Region global, us oder eu auf Googles Enterprise-Plattform |
| GPT-6.2 Astra | $8 / $40 | $0,40 | 1.050.000 | 62,1 (max) | Keine gelistet | Nein | Regionale Endpunkte, +10 % |
| GPT-6.2 Sol | $2 / $10 | $0,10 | 1.050.000 | 57,3 (max) | Keine gelistet | Nein | Regionale Endpunkte, +10 % |
| Claude Opus 5.5 | $4 / $20 | $0,20 | 1M | 59,1 (max) | Kostenlose Test-Credits für neue Nutzer | Nein | Nur US-Inferenz, +10 % |
| Claude Sonnet 5.5 | $2 / $10 | $0,10 | 1M | 54,5 (max) | Kostenlose Test-Credits für neue Nutzer | Nein | Nur US-Inferenz, +10 % |
| Gemini 4 Carbon | $2 / $10 bis 30. Nov., dann $4 / $20 | $0,10, dann $0,20, nur implizit | 1.048.576 | 60,0 (high) | Keine | Nein | Für Carbon nicht geprüft (der Neon-Leitfaden listet global, us, eu) |
| Kimi K3.1 Pro | $2 / $10 | $0,20 | 1.048.576 | 46,5 | Keine gelistet | Ja, unter Moonshots eigener Lizenz | Nicht dokumentiert auf der Preisseite |
| DeepSeek V4.1 Flash | $0,15 / $0,60 außerhalb der Stoßzeit, $0,30 / $1,20 zur Stoßzeit | $0,003 außerhalb der Stoßzeit, $0,006 zur Stoßzeit | 1M | 32,6 (max) | Keine gelistet | Ja, MIT | Nicht dokumentiert auf der Preisseite |
Zwei Hinweise. "Keine gelistet" heißt, dass die Preisseite des Anbieters keine kostenlose API-Stufe erwähnt, nicht dass ich bestätigt habe, dass es keine gibt. Und Carbons Preis verdoppelt sich am 1. Dezember, was wichtig ist, weil Artificial Analysis seine Kosten pro Aufgabe zum höheren Dezember-Preis berechnet.
Was würde jede Alternative im Monat kosten?
Kosten pro Aufgabe ist eine Benchmark-Zahl, und Ihre Aufgabe ist kleiner. Dieser Rechner skaliert die Artificial-Analysis-Kosten pro Aufgabe danach, wie groß Ihre Aufgabe im Vergleich zu einer Benchmark-Aufgabe ist, multipliziert mit Ihrem Volumen, und behält nur die Einstellungen, die den Score erreichen, den Sie brauchen. Es ist eine Schätzung, nutzen Sie sie also, um die Größenordnung der Lücke zu sehen, und messen Sie dann Ihre eigene Arbeit.
Bei den Standardwerten, 10.000 kurzen Ticketantworten im Monat und einer Score-Grenze von 55, kostet Sol max etwa $505 im Monat und Neon high etwa $1.870. Ziehen Sie die Score-Grenze auf 60, fällt Sol heraus, was der ehrliche Tausch ist: Sie zahlen für die letzten fünf Punkte.
1. GPT-6.2 Astra
Am besten für: Teams, die Neons Score wollen und bereit sind, dafür eine niedrigere Rechnung zu zahlen.
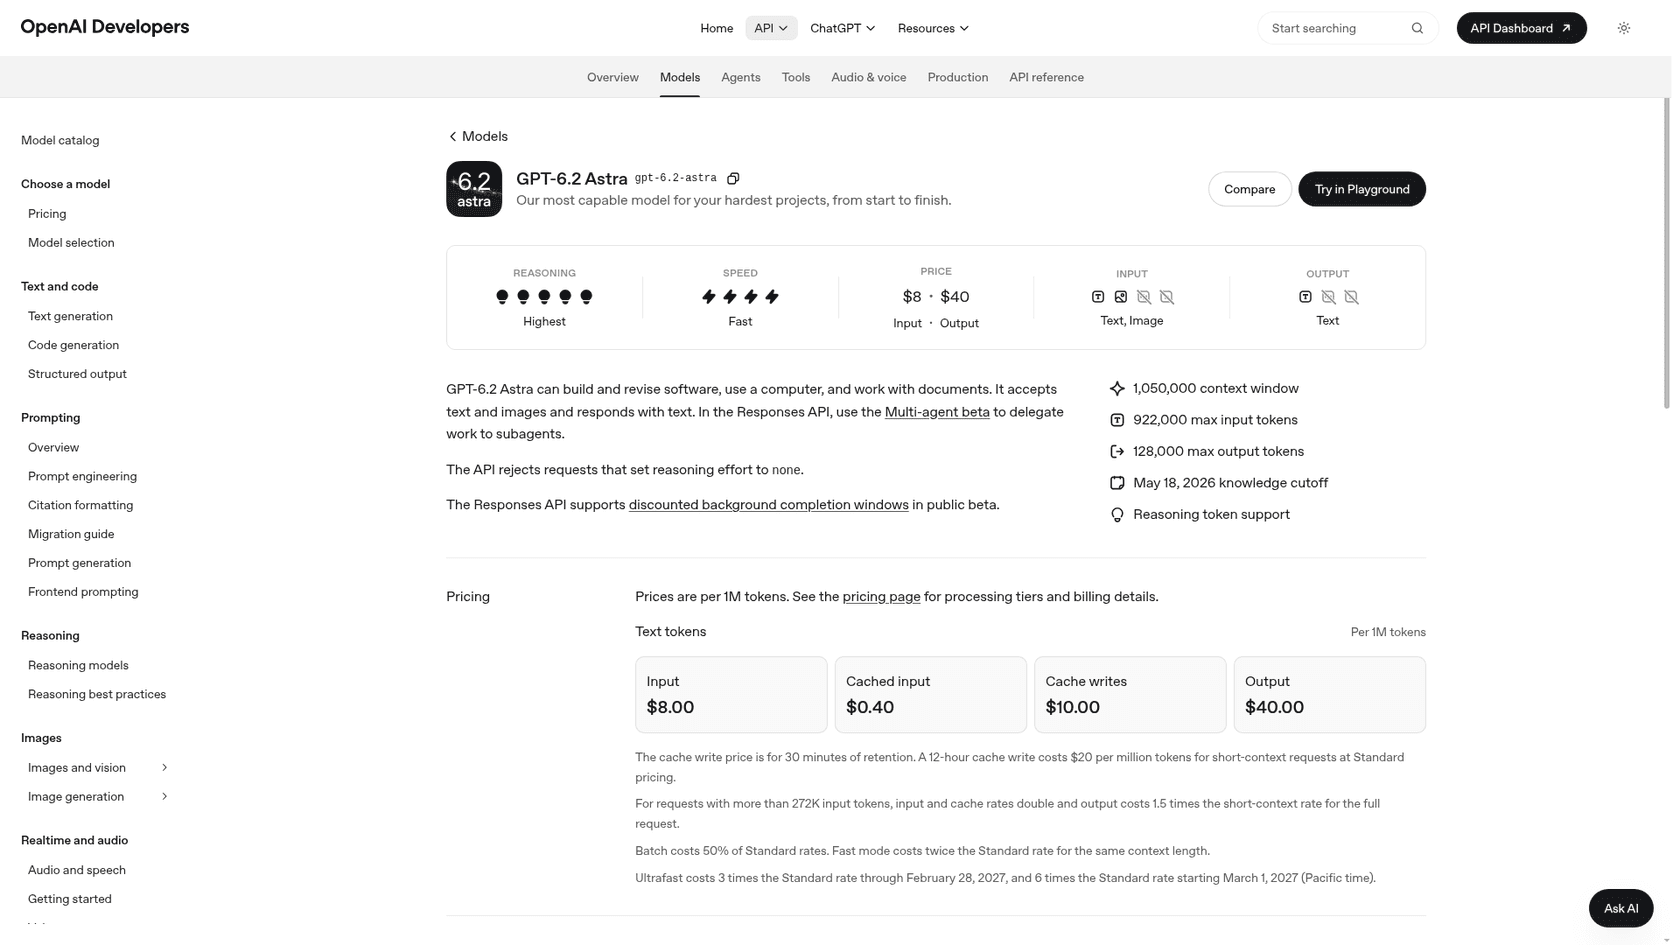
GPT-6.2 Astra ist OpenAIs Top-Modell, veröffentlicht am 17. November 2026, einen Tag vor Neon. Es hat ein 1.050.000-Token-Kontextfenster, 128.000 maximale Output-Token und einen Wissensstand von Mai 2026, und die API lehnt den Reasoning-Effort none ab. Sein Preis ist mit $8 Input und $40 Output pro Million Token happig, das 2,7-Fache von Neons Input-Rate.
Bei der Rechnung ist Astra jedoch das Modell, das Neon auf dessen eigenem Terrain schlägt. Bei hohem Effort erreicht es 60,1 für $2,07 pro Aufgabe und ist in 5,9 Minuten fertig, gegenüber Neons 14,8. Es schafft das, indem es 17.828 Token schreibt, wo Neon 90.188 schreibt. Bei max klettert es auf 62,1, knapp über Neons bestem Wert von 61,4, für $4,00. Mein eigener Test mit 90 Durchläufen im Support aus dem Astra-Alternativen-Leitfaden fand die gleiche Gewohnheit: Der Effort-Level bewegte die Kosten bei kurzen Tickets kaum, von $5,75 auf $6,57 pro 1.000 Tickets von niedrigem bis hohem Effort.
Ein Hacker-News-Leser führte einen Spielbenchmark durch, der zeigt, wie sich das in der Praxis auswirkt:
"GPT-6.2 Astra scored 92 in 6.6 min for $2.04, vs Kimi K3.1 Pro (93 in 11.5 min for $0.68)"
Vorteile
- Erreicht Neons Score für etwa 45 % weniger pro Aufgabe und ist mehr als doppelt so schnell
- Gleiches 1.050.000-Token-Fenster und die Responses-API, die viele Teams bereits nutzen
- Gecachter Input bei
$0,40, mit Batch zum halben Standardtarif
Nachteile
- Riet bei 58 % der unbeantwortbaren Fragen in AA-Omniscience falsch, gegenüber Neons 14 %, braucht also eine Weiterleitungsregel, die nicht davon abhängt, dass das Modell selbst ablehnt
- Anfragen über 272K Input-Token verdoppeln die Input-Rate und heben den Output auf das 1,5-Fache des Standardtarifs an
- Der Listenpreis wirkt in jeder Tabellenkalkulation teuer, die Token pro Aufgabe überspringt
Preise: $8 Input, $0,40 gecacht und $40 Output pro Million Token zum Standardtarif, laut OpenAIs Preisseite. Regionale Verarbeitung erhöht den Preis um 10 %. Siehe GPT-6.2-Astra-Preise für die Stufen.
Fazit: das Modell, das ich zuerst ausprobieren würde, wenn Sie Neon-Niveau-Scores wollen und Ihre Rechnung zählt. Überspringen Sie es, wenn das Modell selbst ablehnen soll, wenn es unsicher ist, denn genau dort ist Neon besser.
2. GPT-6.2 Sol
Am besten für: die niedrigste Rechnung, die immer noch in den hohen 50ern punktet.
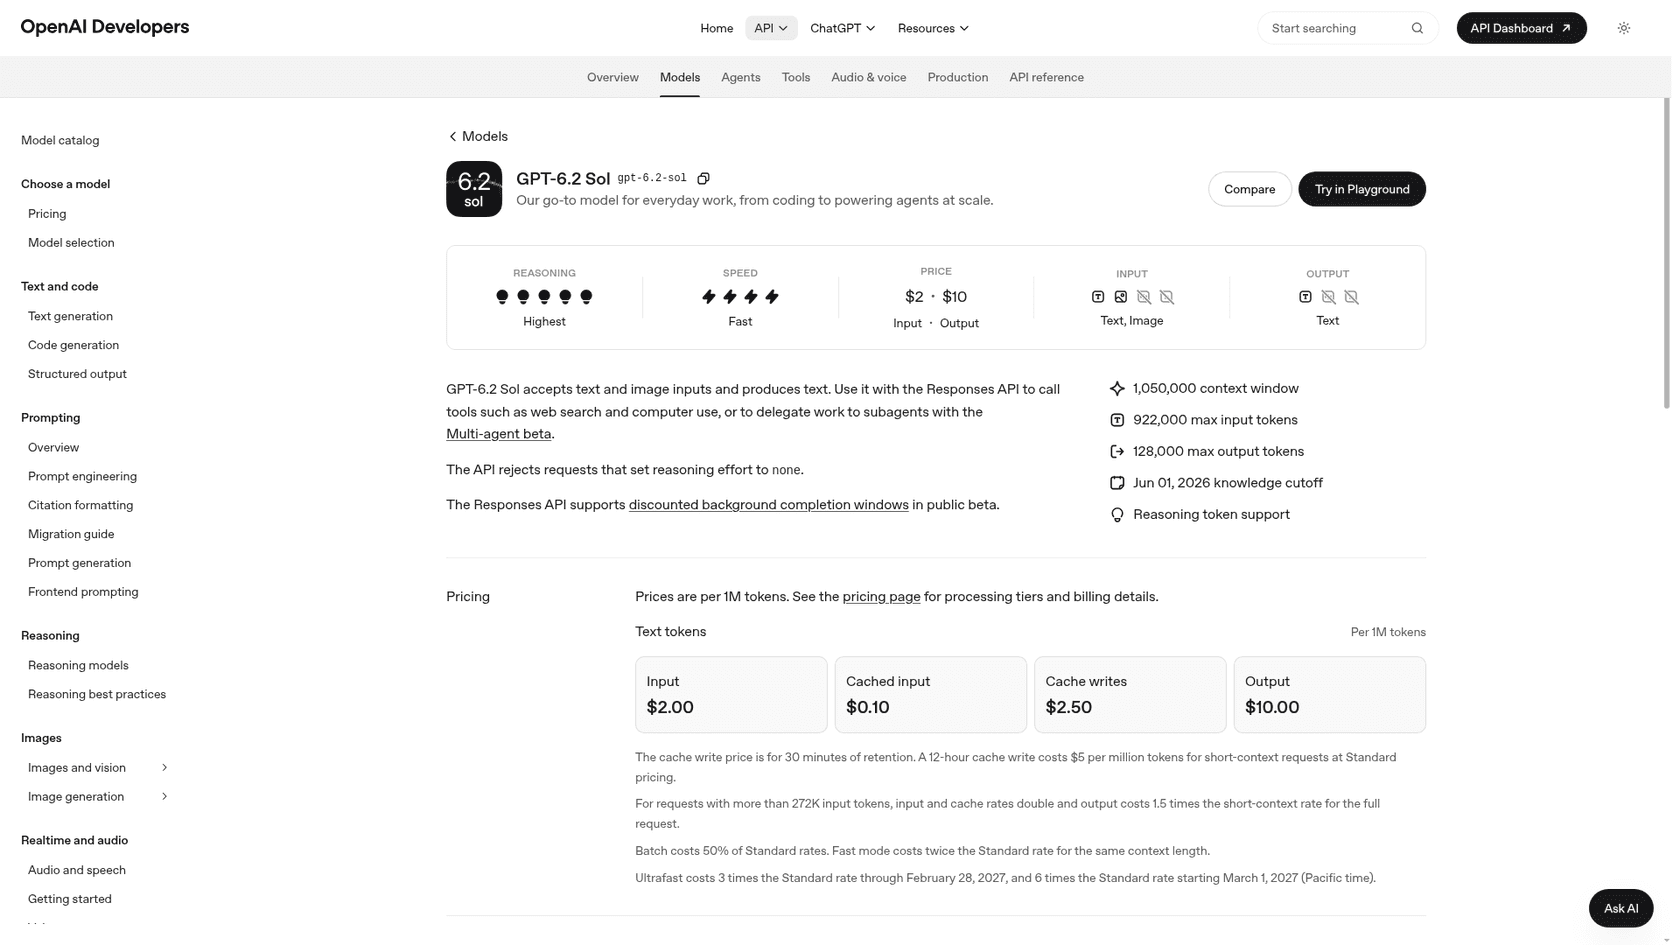
GPT-6.2 Sol ist OpenAIs Alltagsmodell, mit dem gleichen 1.050.000-Token-Fenster wie Astra, einem Wissensstand von Juni 2026 und $2 Input und $10 Output pro Million Token. Artificial Analysis bewertet es mit 57,3 bei maximalem Effort für $1,01 pro Aufgabe, und 54,9 bei hohem Effort für $0,56. Diese zweite Zahl ist die, zu der ich immer wieder zurückkomme: der gleiche Score wie Neon bei medium, zu weniger als einem Drittel der Kosten.
In meinem eigenen Test beantwortete Sol alle 45 Durchläufe korrekt über niedrigen, mittleren und hohen Effort, einschließlich einer anteiligen Rückerstattung, die jedes Mal $990 ergab, einer Prompt-Injection, die ein höfliches Nein bekam, und spanischer und deutscher Tickets, die in der Sprache des Kunden beantwortet wurden. Die Kosten lagen bei $1,42, $1,40 und $1,54 pro 1.000 Tickets, etwa ein Viertel von Astras. Die Meinung an der Front ist bei den schwierigeren Fällen geteilt:
"OpenAI's models require constant reprompting for me."
Dieser Leser bevorzugte Sonnet 5.5, und es ist eine faire Warnung, dass ein günstiges Modell Ihrem Prompt mehr abverlangt.
Vorteile
$0,56bis$1,01pro Aufgabe, das günstigste Modell hier, das über 54 punktet- Schnell: 4,6 bis 8,5 Minuten pro Aufgabe auf Artificial Analysis
- Gleiche API-Oberfläche wie Astra, sodass Sie zwischen beiden routen können
Nachteile
- Falsch bei 55 % bis 60 % der unbeantwortbaren Fragen, es wird also antworten, wenn es weiterleiten sollte
- Cache-Writes werden separat mit
$2,50pro Million Token für ein 30-minütiges Halten abgerechnet, die gecachte Rate ist also kein geschenktes Geld - Die API lehnt den Reasoning-Effort
noneab
Preise: $2 Input, $0,10 gecacht und $10 Output pro Million Token, laut OpenAIs Preisseite. Batch halbiert das. Der Sol-Preisleitfaden hat die Details.
Fazit: mein Standard für die meisten Workloads. Fangen Sie hier an und wechseln Sie zu Astra oder Neon nur für die Aufgaben, bei denen es sichtbar scheitert.
3. Claude Opus 5.5
Am besten für: lange Coding- und Agenten-Sitzungen auf einem Anthropic-Stack.
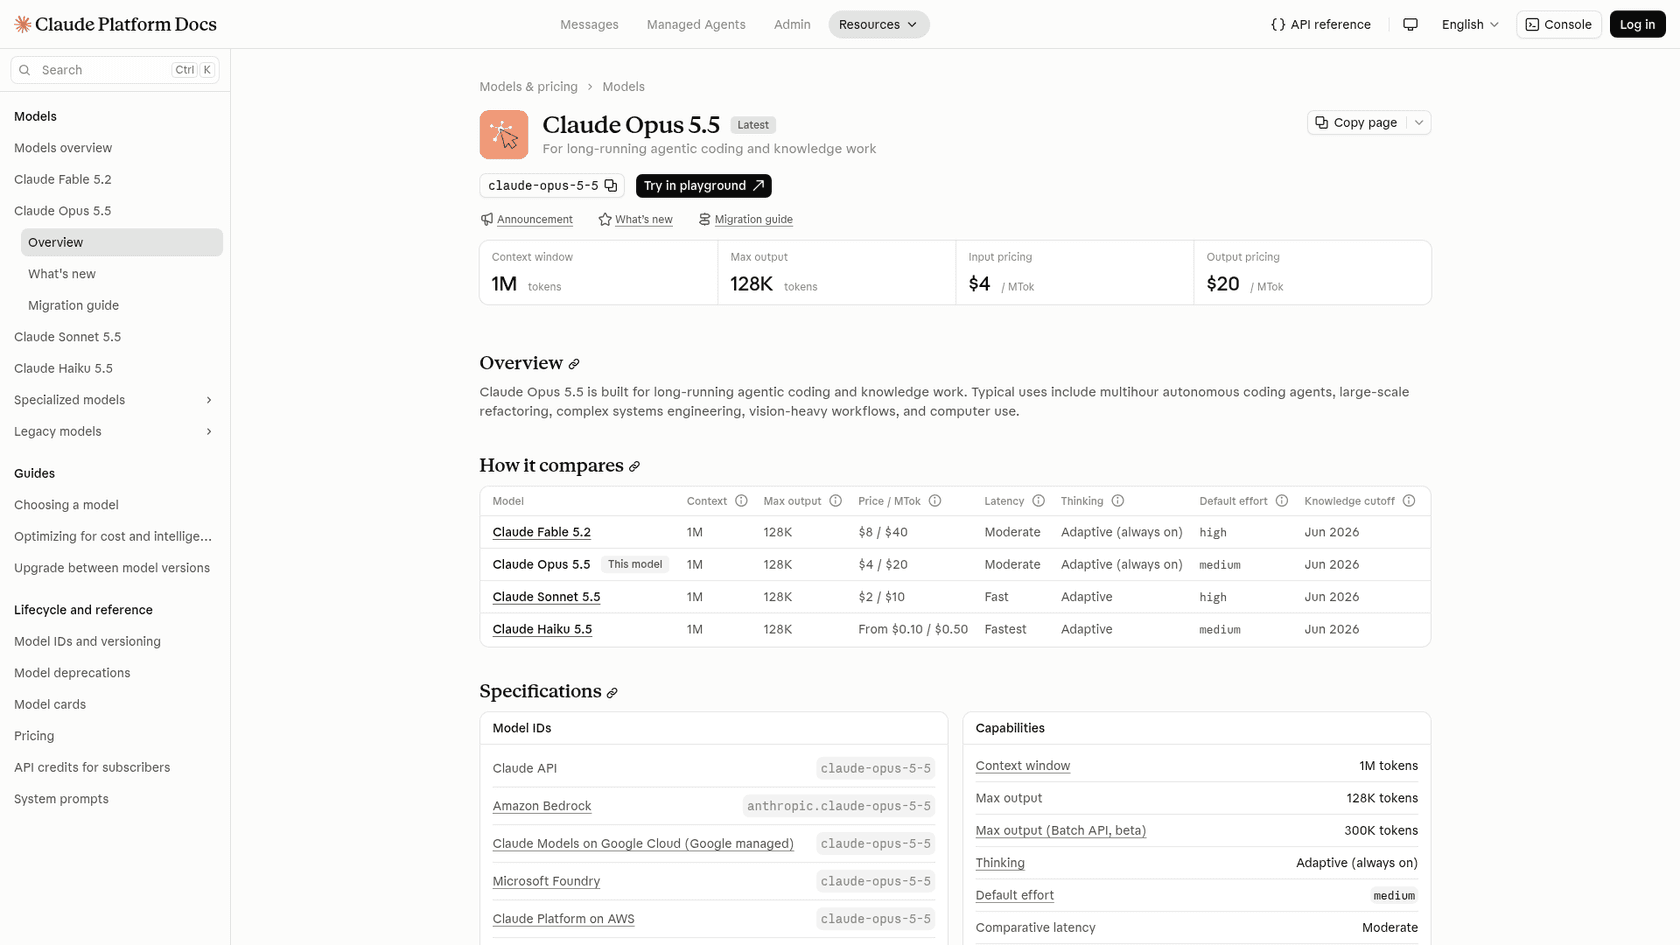
Claude Opus 5.5 kam am 22. September 2026 heraus, zu $4 Input und $20 Output pro Million Token, mit einem 1M-Token-Fenster, 128K maximalem Output, immer aktivem adaptivem Denken und einem Standard-Effort von medium. Es läuft auf der Claude-API, Amazon Bedrock, Google Cloud und Microsoft Foundry. Googles eigene Vergleichstabelle in der Neon-Modellkarte sieht Opus leicht vor Neon bei Terminal-Bench 4.1 und FrontierCode 2.0, das ist also der stärkste Coding-Rivale auf der Liste.
Der Haken ist die Gewohnheit, die ich vorhin beschrieben habe. Bei maximalem Effort schreibt Opus 173.313 Token pro Aufgabe, und das macht aus einem halb so teuren Listenpreis die teuerste Zeile in der Tabelle: $10,04 pro Aufgabe für 59,1, gegenüber Neons $3,74 für 59,6. Beim API-Standard medium sind es $2,45 für 48,2, ein schwächerer Score als Neon medium mit 54,9 zu einem höheren Preis. Ein Hacker-News-Leser stellte es zwei Monate später trotzdem an die Spitze des Feldes:
"Every day I'm just more and more amazed at Opus 5.5 and how ahead it was."
Vorteile
- Gecachter Input bei
$0,20, und Batch zum halben Preis - Anthropics Preisseite listet nur US-Inferenz über
inference_geofür einen Aufpreis von 10 % - Stark bei langen Coding-Sitzungen, wo Googles eigene Tabelle ihm den Vorteil gibt
Nachteile
$10,04pro Aufgabe bei max, etwa das 2,7-Fache von Neon für den gleichen Score- Anthropics Preisseite listet für Opus 5.5 nur
autoundnoneals Tool-Choice, testen Sie also jeden Agenten, der ein bestimmtes Tool erzwingt - Riet bei max in 50 % der unbeantwortbaren Fragen falsch, und bei medium in 67 %
Preise: $4 Input, $0,20 gecachter Lesezugriff und $20 Output pro Million Token, laut Anthropics Preisseite. Der Fast-Modus kostet $8 und $40. Siehe Opus-5.5-Preise.
Fazit: Wählen Sie es, wenn Sie bereits auf Anthropic setzen und Ihre Jobs lange Coding-Sitzungen sind. Überspringen Sie es, wenn Kosten pro Aufgabe Ihre Einschränkung sind, und lesen Sie zuerst meinen Opus-5.5-Test.
4. Claude Sonnet 5.5
Am besten für: Anthropic-Shops, die kurze Tool-Durchläufe mit niedrigem Effort fahren.
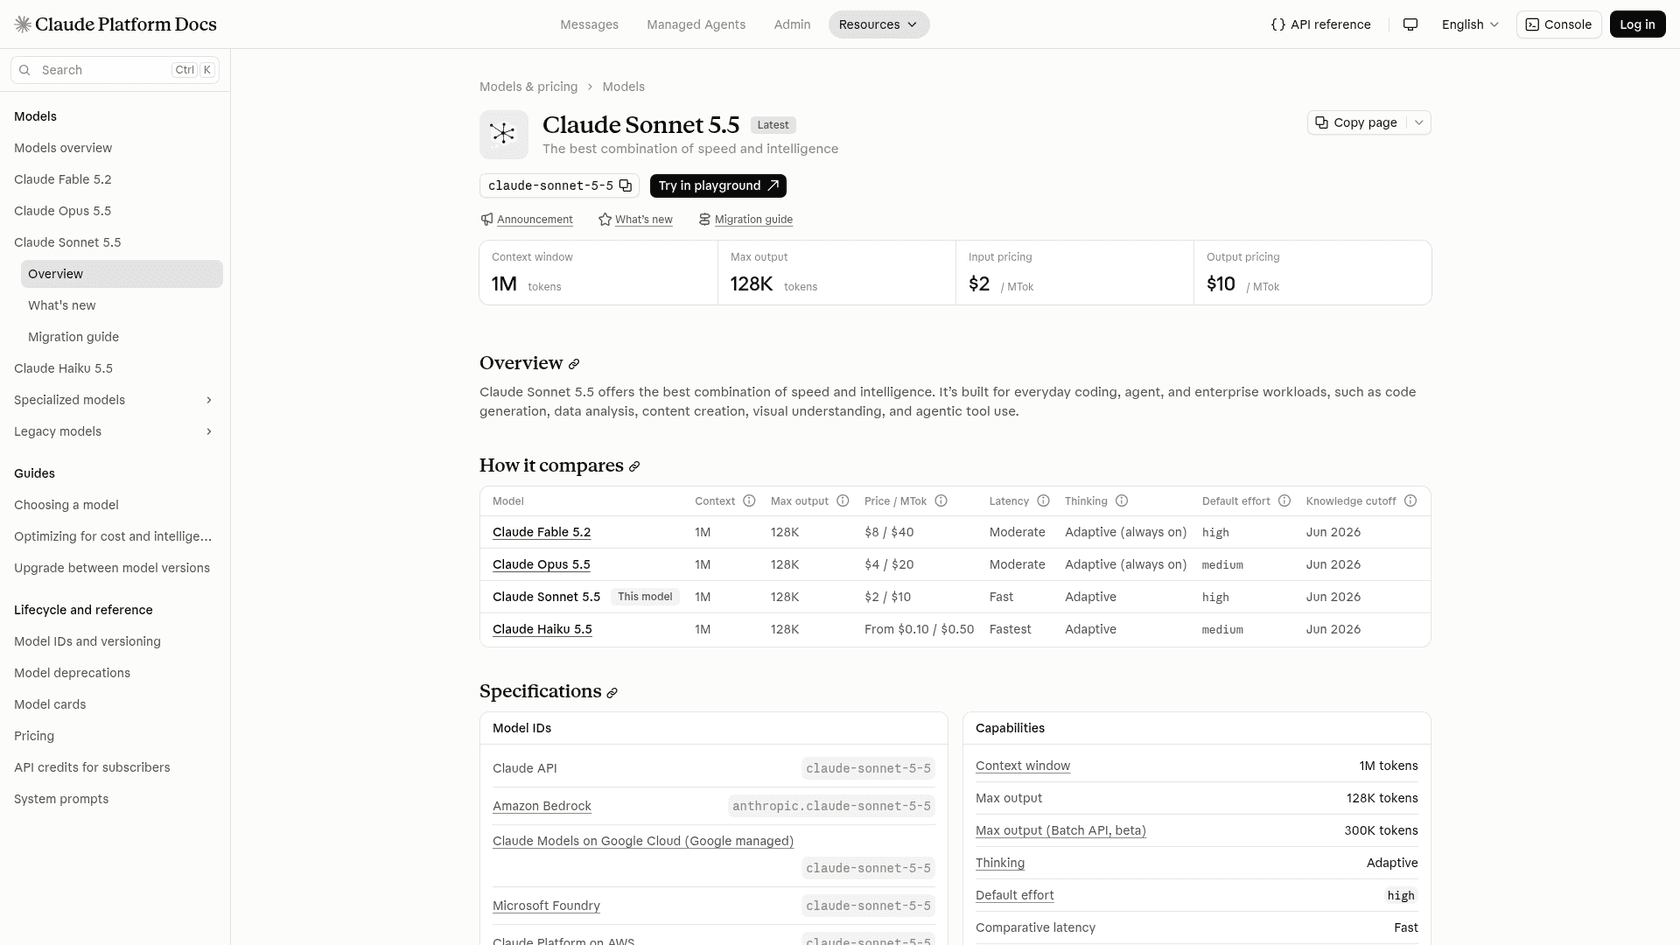
Claude Sonnet 5.5 hat das gleiche $2- und $10-Preisschild wie Sol, ein 1M-Token-Fenster, einen Wissensstand von Juni 2026 und einen API-Standard-Effort von high. Das ist die Falle. Auf Artificial Analysis kostet es $10,02 pro Aufgabe bei max für 54,5, das Zehnfache von Sol, weil es 285.387 Token schreibt und 32,6 Minuten braucht. Beim Standard high kostet es $1,64 für 41,5, und Neon low schlägt das bei beiden Werten mit $0,75 für 44,1.
Es gibt einen Lichtblick. Sonnet 5.5 riet bei max in 43 % der unbeantwortbaren Fragen falsch, besser als Sol, Astra oder Opus, aber weit hinter Neon.
Vorteile
- Gecachter Input bei
$0,10, und eine niedrigere Halluzinationsrate als das OpenAI-Paar - 1M-Token-Kontext, 128K maximaler Output, und die gleichen Plattformen wie Opus
- Passt zu Teams, die bereits rund um Anthropics Tools gebaut haben
Nachteile
- Der Score schwankt von 41,5 bei high auf 54,5 bei max, während die Kosten von
$1,64auf$10,02schwanken - Gleiche Auflistung von
autoundnoneals Tool-Choice wie Opus auf Anthropics Preisseite - Das langsamste der Mainstream-Modelle bei max, mit 32,6 Minuten pro Aufgabe
Preise: $2 Input, $0,10 gecachter Lesezugriff und $10 Output pro Million Token, laut Anthropics Preisseite. Batch kostet $1 und $5. Siehe Sonnet-5.5-Preise.
Fazit: Wählen Sie es nur, wenn Anthropic eine feste Vorgabe ist und Sie es bei niedrigem oder mittlerem Effort fahren. Andernfalls erledigt Sol den gleichen Job günstiger, und mein Sonnet-5.5-Test erklärt die Effort-Falle.
5. Gemini 4 Carbon
Am besten für: Teams, die die wenigsten erfundenen Antworten wollen und dafür zahlen.
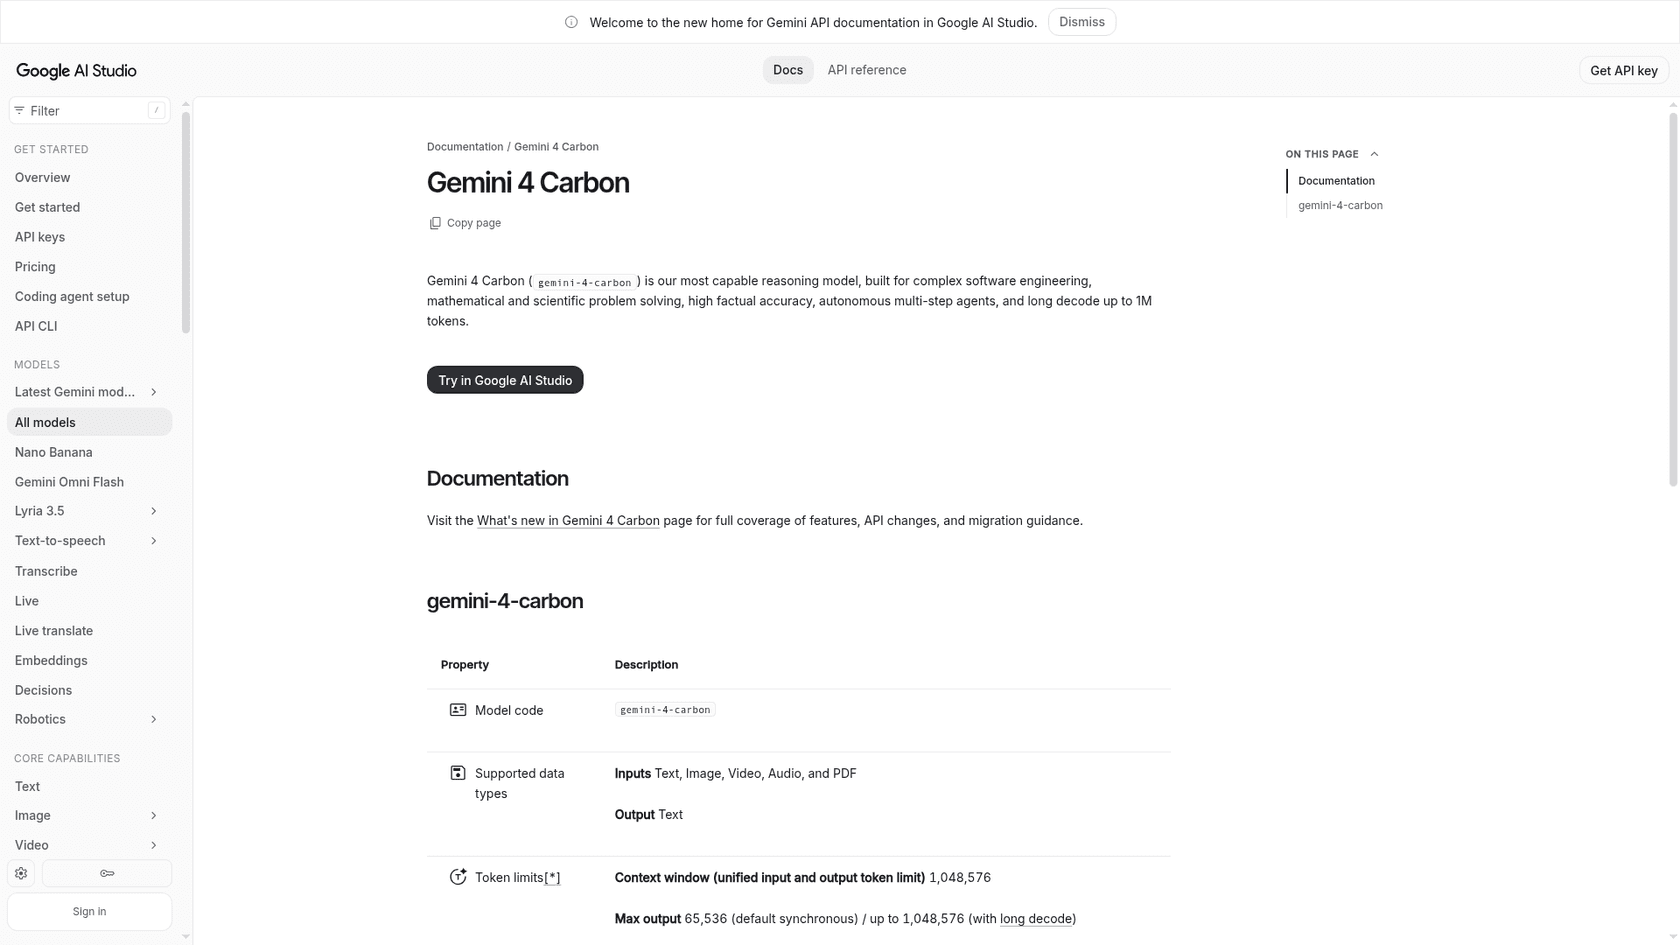
Gemini 4 Carbon ist das Modell, aus dem Neon abgeleitet wurde, und Google beschreibt es als sein leistungsfähigstes Reasoning-Modell, gebaut für Software-Entwicklung, Wissenschaft und lange mehrstufige Agenten. Es ist jetzt auf der Gemini-API mit ausschließlich kostenpflichtiger Preisgestaltung: $2 Input und $10 Output bis zum 30. November 2026, dann $4 und $20 ab dem 1. Dezember, mit gecachtem Input bei $0,10, der auf $0,20 steigt.
Carbons Fall ist die Ehrlichkeit. Bei mittlerem Effort riet es bei 4 % der unbeantwortbaren Fragen falsch, und bei hohem Effort bei 11 %, gegenüber Neons 14 %. Sein Problem sind die Kosten. Bei high erreicht es 60,0 für $7,76 pro Aufgabe, mehr als das Doppelte von Neons $3,74 für den gleichen Score, und es braucht 37,2 Minuten. Ein Hacker-News-Tester maß die gleiche Langsamkeit aus einem anderen Blickwinkel:
"I've tested 75 models so far, and Gemini 4 Carbon is 68th/75 in terms of slowness"
Vorteile
- Die niedrigste Halluzinationsrate auf der Liste: 4 % bei medium, 11 % bei high
- 1.048.576-Token-Fenster und langes Decoding bis zu etwa 1M Output-Token
- Gleicher Google-Stack wie Neon, die Migration ist also nur ein Modellnamenwechsel
Nachteile
$7,76pro Aufgabe bei high, das Doppelte von Neon für den gleichen Score, sobald die Aktion endet- Langsam: 29,6 bis 37,2 Minuten pro Aufgabe, mit einem langen Ausläufer, den der HN-Tester sah
- Keine kostenlose Stufe
Preise: $2 Input und $10 Output bis zum 30. November, dann $4 und $20, laut Googles Preisseite. Vergleichen Sie es mit meiner Übersicht Carbon-Alternativen.
Fazit: Wählen Sie es, wenn falsche Antworten Sie mehr kosten als Zeit, und budgetieren Sie mit dem Dezember-Preis. Andernfalls gibt Ihnen Neon den gleichen Score für halbes Geld.
6. Kimi K3.1 Pro
Am besten für: Teams, die offene Gewichte von einem Nicht-US-Anbieter wollen.
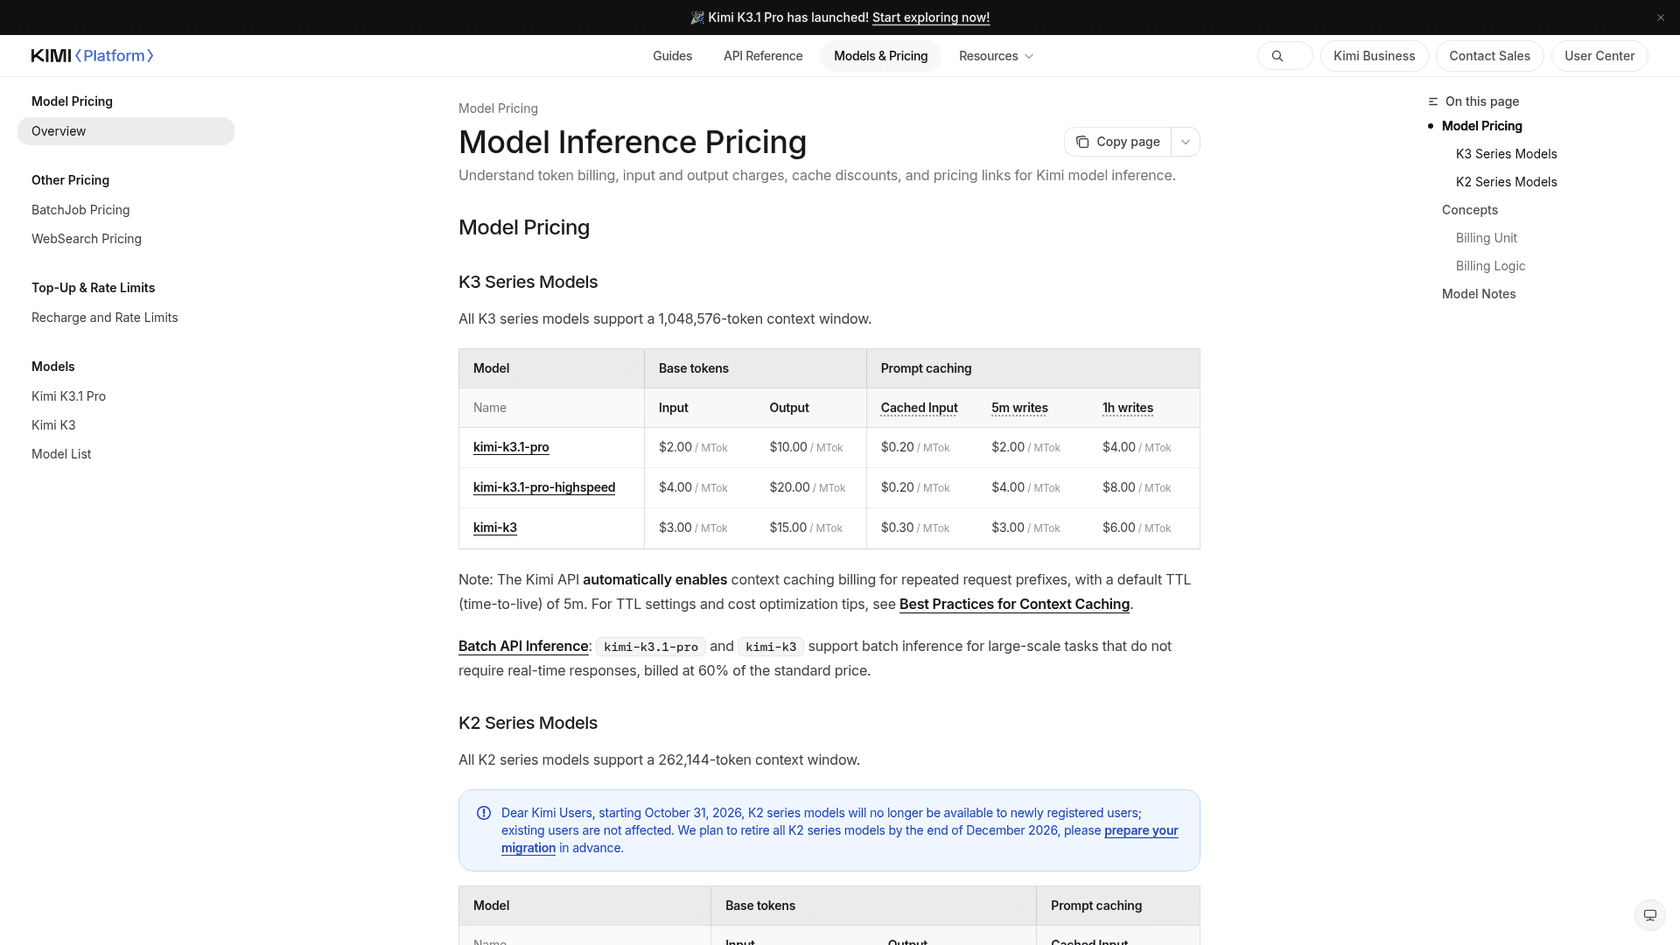
ChatGPT nannte Kimi K3, aber das Modell, das ich heute testen würde, ist Kimi K3.1 Pro, das weniger kostet als das ältere Kimi K3 mit $2 Input und $10 Output pro Million Token, mit gecachtem Input bei $0,20. K3 kostet weiterhin $3 und $15. K3.1 Pro hat ein 1.048.576-Token-Fenster und eine highspeed-Version zu $4 und $20. Artificial Analysis führt es als Open-Weights-Modell mit 2,8T Parametern und 104B aktiven Parametern.
Beim Score hinkt es: 46,5, gegenüber Neon medium mit 54,9. Es braucht außerdem 39,4 Minuten pro Aufgabe und kostet $3,68, Neon medium schlägt es also bei Score, Kosten und Geschwindigkeit. Das Preisargument beruht auf einer anderen Art von Aufgabe. Das oben zitierte PacBench-Ergebnis hatte Kimi bei $0,68 gegenüber Astras $2,04 bei einem Coding-Spielzeug, bei engen Jobs kann es also viel günstiger sein, als das Leaderboard vermuten lässt.
Vorteile
$2/$10pro Million Token und offene Gewichte unter Moonshots eigener Lizenz- Batch-Inferenz zu 60 % des Standardpreises, laut der Kimi-Preisseite
- Riet bei 37 % der unbeantwortbaren Fragen falsch, besser als Sol, Astra und Opus
Nachteile
- 46,5 auf dem Index, weit unter Neon, Astra und Opus
- 39,4 Minuten pro Aufgabe, das langsamste Modell in meiner Tabelle
- Kein regionaler Endpunkt auf der Preisseite dokumentiert
Preise: $2 Input, $0,20 gecacht und $10 Output pro Million Token für kimi-k3.1-pro, laut Kimis Preisseite. Mein Beitrag Kimi-K3.1-Pro-Preise deckt die Pläne ab.
Fazit: Wählen Sie es, wenn offene Gewichte oder Anbieter-Vielfalt der Punkt sind. Überspringen Sie es für schweres Reasoning, und lesen Sie zuerst meinen Kimi-K3.1-Pro-Test.
7. DeepSeek V4.1 Flash
Am besten für: Massenklassifizierung und Routing zum niedrigsten Listenpreis.
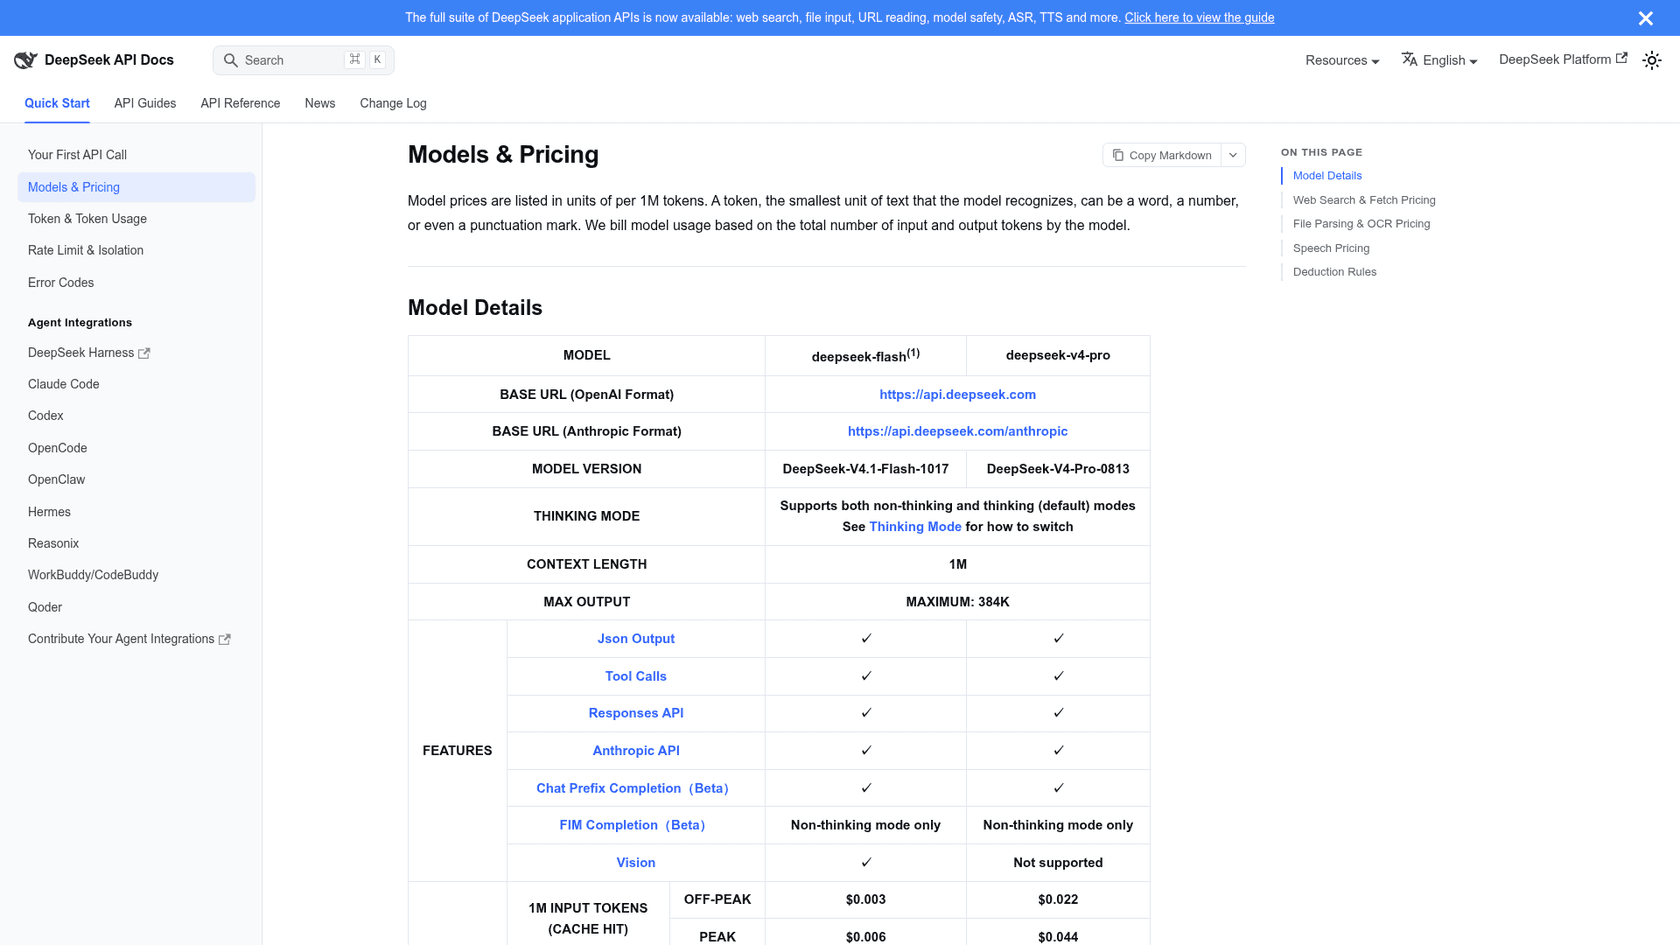
Das aktuelle Modell ist DeepSeek V4.1 Flash, das DeepSeeks Dokumentation als deepseek-flash mit DeepSeek-V4.1-Flash-1017 listet. Es kostet $0,15 Input bei einem Cache-Miss und $0,60 Output pro Million Token außerhalb der Stoßzeit, und das Doppelte zur Stoßzeit (01:00 bis 04:00 und 06:00 bis 10:00 UTC an Wochentagen). Cache-Treffer kosten $0,003. Es hat ein 1M-Token-Fenster, 384K maximalen Output, JSON-Output, Tool-Aufrufe, Bildverarbeitung und ein Parallelitätslimit von 2.500.
Artificial Analysis bewertet es mit 33 bei max für $0,60 pro Aufgabe, berechnet zur Stoßzeit-Rate, außerhalb der Stoßzeit also etwa die Hälfte nach meiner Rechnung. Die Überraschung ist, dass günstige Token keine günstige Aufgabe ergaben: Es schreibt 138.962 Token, Sol high bei 54,9 kostet also etwa das Gleiche. Ein Kommentator im Launch-Thread hatte ein anderes Budget im Kopf:
"I don't think it beats Deepseek v4.1 Flash 1017 at cost per task."
Er hat recht bei den Token-Preisen und, für leichte Arbeit, bei den Rechnungen. Die Gewichte sind MIT-lizenziert, Sie können es also selbst hosten.
Vorteile
$0,15/$0,60außerhalb der Stoßzeit, und$0,003bei Cache-Treffern- MIT-lizenzierte offene Gewichte, 552B gesamt und 16B aktiv laut Artificial Analysis
- JSON-Output und Tool-Aufrufe auf der Preisseite gelistet
Nachteile
- Index-Score 32,6, es ist also ein Triage-Modell, kein Reasoning-Modell
- Riet bei max in 64 % der unbeantwortbaren Fragen falsch
- Kein regionaler Endpunkt oder Datenverarbeitungsbedingungen auf der Preisseite, fragen Sie also nach, bevor Sie Kundendaten senden
Preise: $0,15 Input (Cache-Miss), $0,003 Cache-Treffer und $0,60 Output außerhalb der Stoßzeit, laut DeepSeeks Preisseite. Siehe DeepSeek-V4.1-Flash-Preise für die Rechnung zur Stoßzeit und außerhalb davon.
Fazit: Wählen Sie es für Klassifizierung und Routing, wo ein Score von 33 reicht. Überspringen Sie es für alles Kundenorientierte ohne einen Menschen im Loop.
Welche Gemini-4-Neon-Alternative sollten Sie wählen?
Hier ist die Entscheidung, wie ich sie treffen würde, nach Aufgabe:
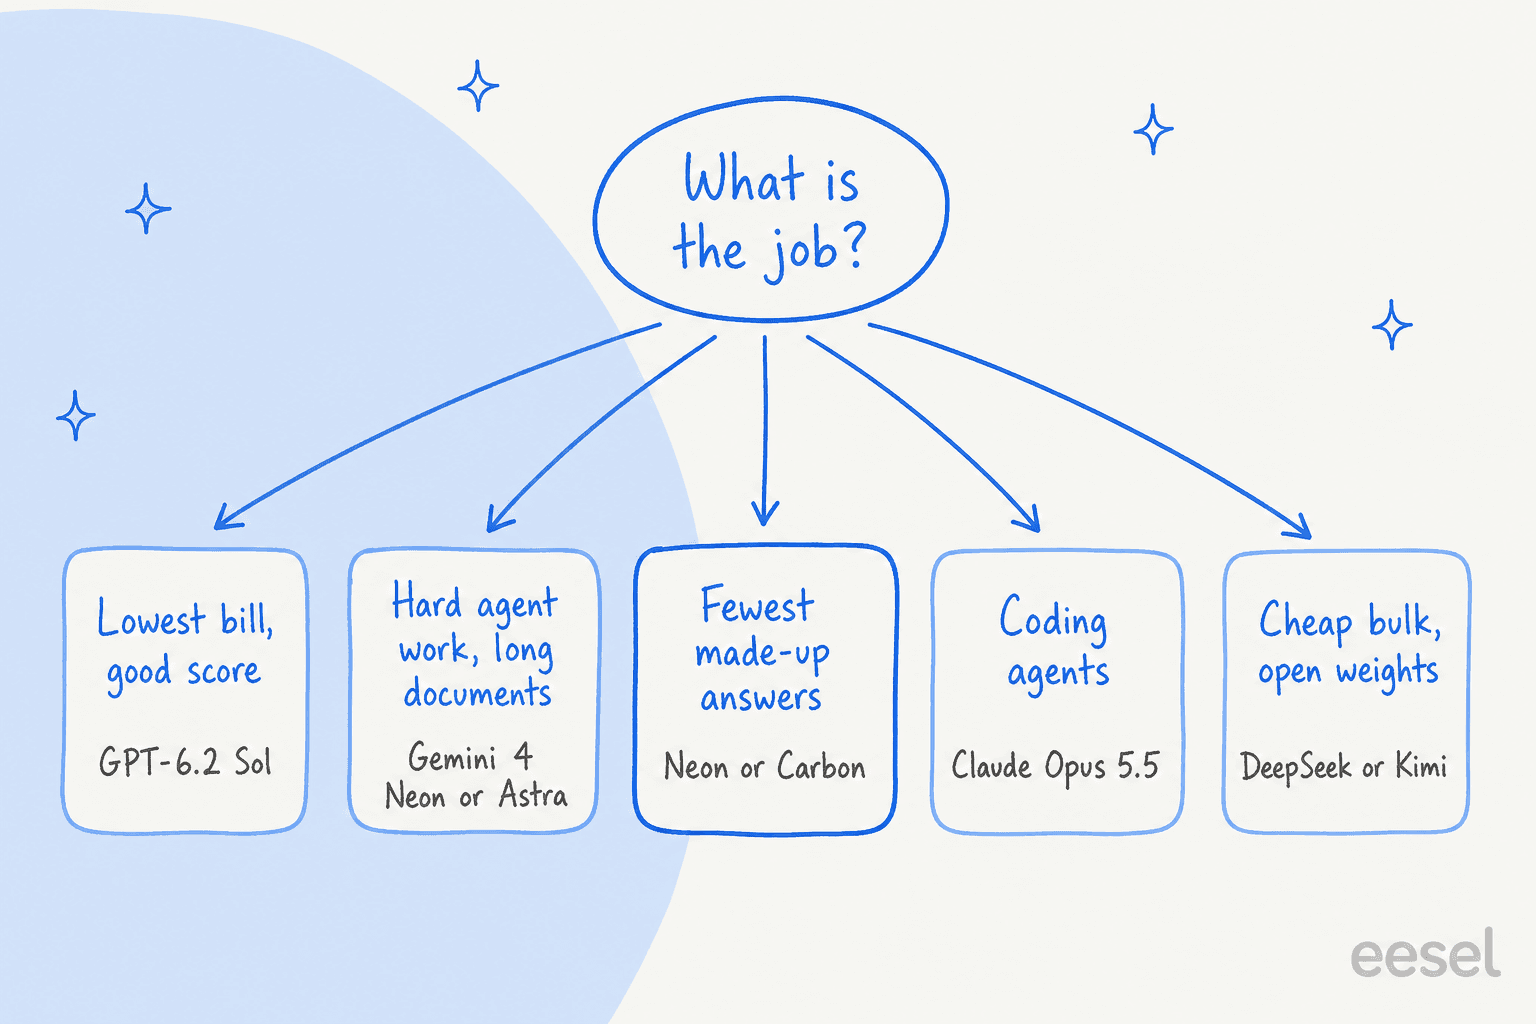
| Wenn Ihre Aufgabe ... ist | Meine Wahl | Warum |
|---|---|---|
| niedrigste Rechnung mit einem Score in den hohen 50ern | GPT-6.2 Sol | $0,56 bis $1,01 pro Aufgabe |
| Neons Score zu niedrigeren Kosten | GPT-6.2 Astra high | 60,1 für $2,07 |
| schwere Agenten und sehr lange Dokumente | Neon bei high, oder Astra | Neons Zeilen für langen Kontext führen in Googles eigener Tabelle |
| ein Modell, das bei Unsicherheit ablehnt | Neon oder Carbon | 14 % und 4 % bis 11 % falsch bei Unsicherheit |
| lange Coding-Sitzungen auf Anthropic | Claude Opus 5.5 | starkes Coding, aber $10,04 pro Aufgabe bei max |
| offene Gewichte oder ein Nicht-US-Anbieter | Kimi K3.1 Pro | $2/$10, Score 46,5 |
| Triage und Routing in großem Volumen | DeepSeek V4.1 Flash | $0,60 pro Aufgabe, MIT-Gewichte |
| Live-Chat | Neon medium oder Hydrogen | 8,3 Minuten statt 14,8 |
Meine Gesamteinschätzung: routen, nicht wechseln. Schicken Sie die meisten Aufgaben an Sol, schicken Sie die, die ein stärkeres Modell brauchen, an Astra oder Neon, und behalten Sie eine niedrigere Stufe für Triage. Wenn Sie noch zwischen Familien abwägen, geht mein Vergleich ChatGPT gegen Gemini weiter. Die Übersicht Gemini-Alternativen deckt den Rest von Googles Reihe ab, und der Leitfaden OpenAI-API gegen Gemini-API deckt die Plattformen ab.
Wie testen Sie Alternativen an Ihrer eigenen Arbeitslast?
Eine Leaderboard-Aufgabe ist nicht Ihre Aufgabe. Das sind die fünf Prüfungen, die ich durchführen würde, bevor ich echten Traffic umleite, in der Reihenfolge, in der ich sie durchführen würde:
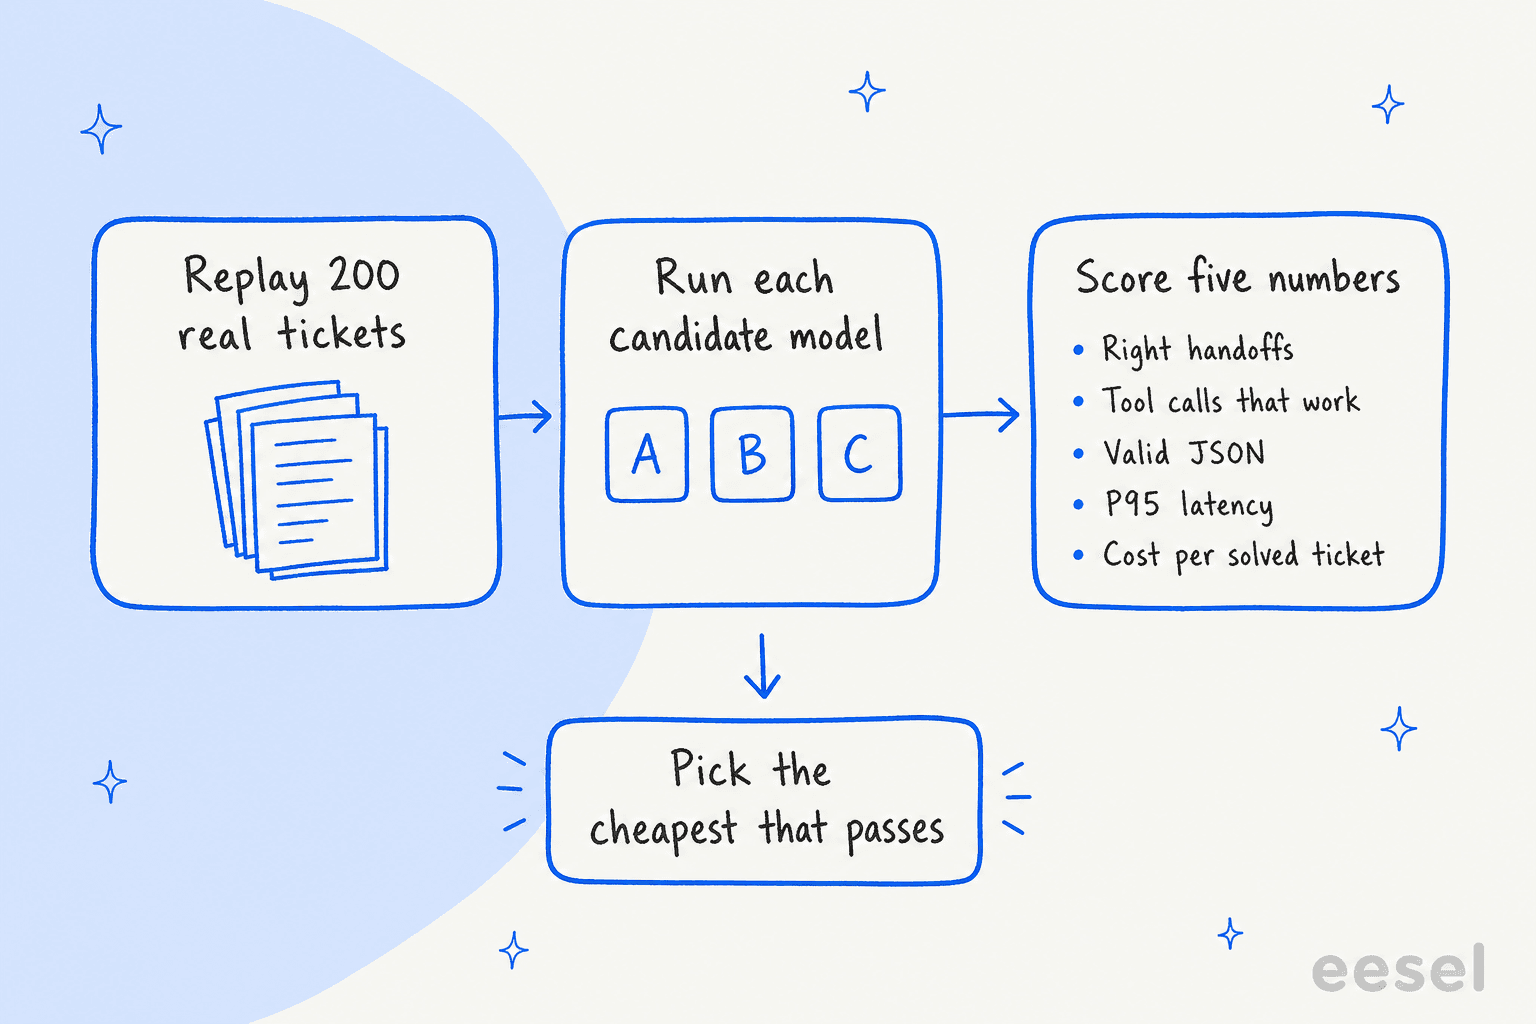
- Tool-Aufrufe. Spielen Sie Aufgaben mit Ihren echten Tool-Definitionen ab und zählen Sie drei Dinge: das richtige gewählte Tool, Argumente, die valide sind, und keinen Aufruf, wenn keiner nötig ist. Wenn Ihr Agent ein bestimmtes Tool erzwingt, testen Sie diesen Modus zuerst. Anthropics Preisseite listet für Opus 5.5 und Sonnet 5.5 nur
autoundnoneals Tool-Choice, ein Design, das sich auf das Erzwingen eines Tools verlässt, braucht also eine Prüfung vor einer Migration. Mein Leitfaden zum OpenAI Function Calling deckt die OpenAI-Seite ab. - Strukturierter Output. Messen Sie den Anteil der Antworten, die ohne Reparaturschritt gegen Ihr Schema parsen. DeepSeeks Preisseite listet JSON-Output als unterstützt, und OpenAIs JSON-Modus hat eigene Regeln, spielen Sie also das gleiche Schema durch jeden Kandidaten. Eine ungültige Antwort von fünfzig wird zu einer Wiederholung und Kosten.
- Latenz, am Rand. Zeichnen Sie Median und P95 für die Zeit bis zum ersten Token und bis zum Abschluss auf. Der oben genannte HN-Tester maß bei Carbon einen Median von 5 Sekunden bis zum Start, mit einem Aufruf bei 50 Sekunden und einem Timeout. Mediane verschleiern das, und Kunden spüren den Rand. Artificial Analysis maß außerdem 56,5 Sekunden bis zum ersten Antwort-Token für Neon bei xhigh, messen Sie also jeden Effort-Level, den Sie nutzen wollen.
- Wiederholungen. Zählen Sie Timeouts, Rate-Limit-Fehler und fehlerhafte Outputs pro 100 Aufrufe, und nutzen Sie dann
Kosten pro Versuch x (1 + Wiederholungsrate)als Ihre echten Kosten. Das ist die Zahl, die ein günstiges Modell wieder mit einem teuren verbindet. - Falsche Antworten gegen Weiterleitungen. Säen Sie etwa 20 Tickets, deren Antwort nicht in Ihren Dokumenten steht, und zählen Sie, wie oft jedes Modell trotzdem antwortet. Das ist das gleiche Verhalten, auf das die AA-Omniscience-Zahlen hindeuten, nur an Ihrem Inhalt gemessen.
Stellen Sie dann alles auf eine Zeile: Kosten pro gelöstem Ticket = Gesamtausgaben / ohne menschliche Korrektur korrekt gelöste Tickets. Das ist die Zahl, nach der Sie ranken sollten, und es ist die modellbezogene Version der Kosten pro Ticket. Führen Sie jeden Kandidaten an den gleichen 200 Tickets aus, bei zwei Effort-Levels, zweimal. Mein Test mit 90 Durchläufen auf Astra und Sol zeigte, dass der Effort-Level die Kosten bei kurzen Tickets kaum bewegte, was geändert hat, welchen Effort-Level ich einsetzen würde.
Was bedeutet das für einen Support-Agenten?
Wenn Ihr Ziel ein Support-Bot ist, sind diese sieben Modelle der Motor, nicht der Agent. Was der Agent weiß, wann er weiterleiten muss und ob ihn jemand getestet hat, bevor er live ging, entscheidet, wie er sich verhält, und eine selbstsichere falsche Antwort auf eine Rückerstattungsfrage kostet mehr als eine Weiterleitung. eesel setzt seit Jahren KI auf lebende Support-Warteschlangen, und die Lehre, die haften blieb, ist, jeden Rollout an historischen Tickets zu simulieren, bevor der Agent einem Kunden antwortet.
So läuft smava, ein deutscher Kreditvergleichsanbieter, mit eesel in einem Zendesk. Zwischen dem 8. August und dem 8. September 2026 bearbeiteten drei Agenten etwa 27.000 Tickets: einer kategorisierte etwa 14.600, einer entwarf etwa 15.300 Antworten aus 820 Makros und Hilfe-Artikeln, und markenspezifische Agenten bereiteten kundenfertige Antworten vor. Jeder Agent hat eine Aufgabe und eine Liste von Dingen, die er niemals tun darf, und ein Mensch gibt den Entwurf frei, bevor irgendetwas versendet wird. SamCart teilt die Arbeit nach Kanal: ein Agent für Freshdesk-Tickets und ein anderer für den Website-Chat, beide antworten aus den gleichen 280 Hilfe-Center-Artikeln.
Keine der beiden Geschichten handelt davon, das beste Modell auszuwählen. Sie zeigen, dass das Modell eine Einstellung innerhalb eines Designs ist, und das Design umfasst Wissen, Weiterleitungsregeln und Tests. Wenn Sie Modelle an Ihrer eigenen Warteschlange vergleichen wollen, simulieren Sie den Agenten an vergangenen Tickets, und beobachten Sie die Weiterleitungsrate genauer als die Genauigkeit. Mein Leitfaden KI-Support-Agenten-Benchmarking listet die Zahlen, die ich verfolge, und KI-Kundenservice-Kosten zeigt, was eine Warteschlange insgesamt kostet.
eesel ausprobieren
Wenn Sie ein Modell wählen, weil Sie bessere Antworten in Ihrer Warteschlange wollen, ist das eesel-KI-Helpdesk-Teammitglied der Mitarbeiter, der auf dem Modell sitzt, das Sie auch immer wählen. Es lernt aus Ihren vergangenen Tickets und Ihrem Hilfe-Center, leitet an einen Menschen weiter, wenn Ihre Dokumente keine Antwort haben, und kann an Ihrer echten Ticket-Historie getestet werden, bevor es irgendjemandem antwortet. Es funktioniert innerhalb von Zendesk und Freshdesk, und dort würde ich anfangen, wenn die eigentliche Frage für einen Support-Rollout "welches Modell" ist.
Die Preisgestaltung ist ein fester monatlicher Credit-Plan, mit einem kostenlosen Plan von 100 Credits ohne Kreditkarte, eine Preisänderung bei einem Modell bewegt also nicht Ihre Rechnung. Probieren Sie eesel aus an einem Teil Ihrer Warteschlange.