GPT-6-Cyber-Alternativen: 8 Optionen und wie man wirklich Zugang bekommt

Rama Adi

Katelin Teen
Zuletzt bearbeitet 6. November 2026
Die beste GPT-6-Cyber-Alternative für die meisten Security-Teams ist Claude Opus 5.5 über Anthropics Cyber Verification Program. Dessen Red-Team-Stufe hat 34 von 50 offensiven Aufgaben ohne Blockade abgeschlossen, genauso wie das Modell mit abgeschalteten Schutzmaßnahmen, zu 4 $/20 $ pro 1 Mio. Token, ein Fünftel der 20 $/100 $ von GPT-6 Cyber. Wer nur eigenen Code prüft, sollte OpenAIs eigenem Rat folgen: mit Daybreak Blue starten, nicht mit Red. GPT-6 Cyber ist nur die richtige Wahl, wenn man Exploits gegen entfernte Ziele braucht und auf eine zweite Freigabe warten kann.
Warum suchen Menschen nach Alternativen zu GPT-6 Cyber?
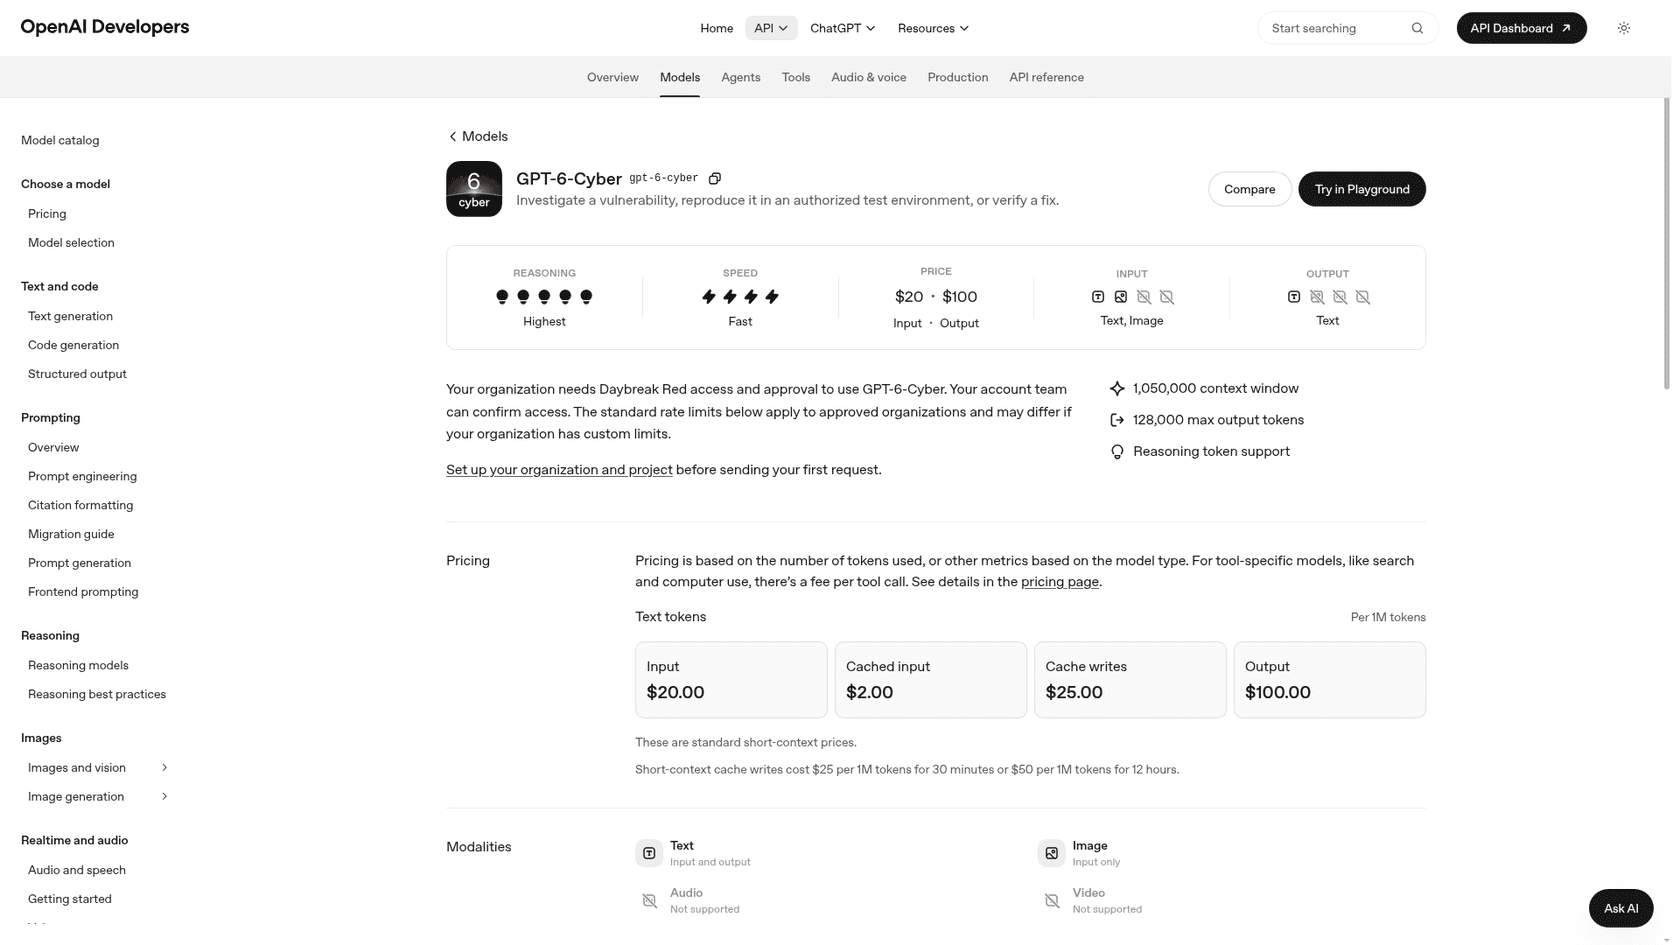
OpenAI brachte GPT-6 Cyber am 5. November 2026 heraus, und auf dem Papier ist es das stärkste Cyber-Modell, zu dem je jemand Zahlen veröffentlicht hat. Bei ExploitGym erreicht es 48,5 %, gegenüber 32,1 % bei GPT-5.6 Cyber. Bei OpenAIs neuem RemoteExploitBench verweigerte GPT-6 Astra unter Daybreak Blue jede Aufgabe, während GPT-6 Cyber 95 % abschloss.
Drei Dinge schicken Menschen noch am selben Tag auf die Suche nach Alternativen:
- Die Sperre ist eine doppelte Sperre. Der Daybreak-Zugangsleitfaden sagt, GPT-6 Cyber braucht Daybreak Red plus eine separate GPT-6-Cyber-Freigabe, und der Launch-Beitrag sagt, es startet mit "einer ausgewählten Gruppe" von Red-Kunden.
- Der Preis hat sich verdoppelt. OpenAIs API-Preisliste nennt für
gpt-6-cyber20 $ Eingabe und 100 $ Ausgabe pro 1 Mio. Token. Das ist doppelt so viel wie GPT-6 Astra, das bereits der teuerste Standardtarif auf der Liste war. - Es ist als Critical eingestuft. OpenAI klassifiziert das Modell unter seinem Preparedness Framework als Critical im Bereich Cybersicherheit, und der Red-API-Zugang verlangt standardmäßig eine IP-Allowlist.
Ich bin Rama und baue die Integrationen und APIs hinter eesels KI-Teammates. Der Großteil meiner Woche geht in die Anbindung von Modellen an reale Systeme, und meiner Erfahrung nach dauert der Zugangs-Papierkram meist länger als der Code. Das ist die Brille, durch die diese Liste entstanden ist. Ein Modell, für das man dieses Quartal keine Freigabe bekommt, hilft nicht, egal wie hoch sein Score ist. Aus demselben Grund liefert eesel die eesel CLI aus: Ein KI-Coding-Agent kann freigegebenes Wissen in ein eesel-Teammate laden und dessen Antworten vom Terminal aus testen, während die Anbindung des Helpdesks selbst weiter auf die Freigabe eines Admins wartet.
Die Reaktion der Community am Launch-Tag sagte dasselbe:
"What's the point of delaying Daybreak Blue availability, when high-impact CVEs are being dropped several times a week?"

Wie ich diese GPT-6-Cyber-Alternativen ausgewählt habe
Vor dem Schreiben habe ich ChatGPT die Frage gestellt, die ein Security-Lead stellen würde, und geprüft, welche Seiten es dafür gelesen hat. Es ging direkt zu Anthropics Cyber Verification Program, Claude Mythos und Google CodeMender. Es teilte die Aufgabe außerdem in zwei: das Lesen des eigenen Quellcodes und das Angreifen bereits laufender Systeme. Diese Trennung habe ich übernommen, weil sie entscheidet, welche Sperre man passieren muss.
Jeder Punkt unten wurde am 6. November 2026 gegen die eigenen Seiten des Anbieters geprüft. Ich habe sie nach Folgendem bewertet:
- Zugang: wer sich bewerben kann und wie lange die Prüfung dauert.
- Preis: der veröffentlichte Preis pro Token oder pro Platz, von der eigenen Seite des Anbieters.
- Aufgabenpassung: Quellcode-Review oder Exploits gegen Live-Ziele.
- Belege: vom Anbieter veröffentlichte Benchmarks, mit dem Vorbehalt, dass Labore meist an ihren eigenen Benchmarks testen.
- Datenbedingungen: Aufbewahrungsregeln, weil inzwischen jedes Cyber-Programm welche verlangt.
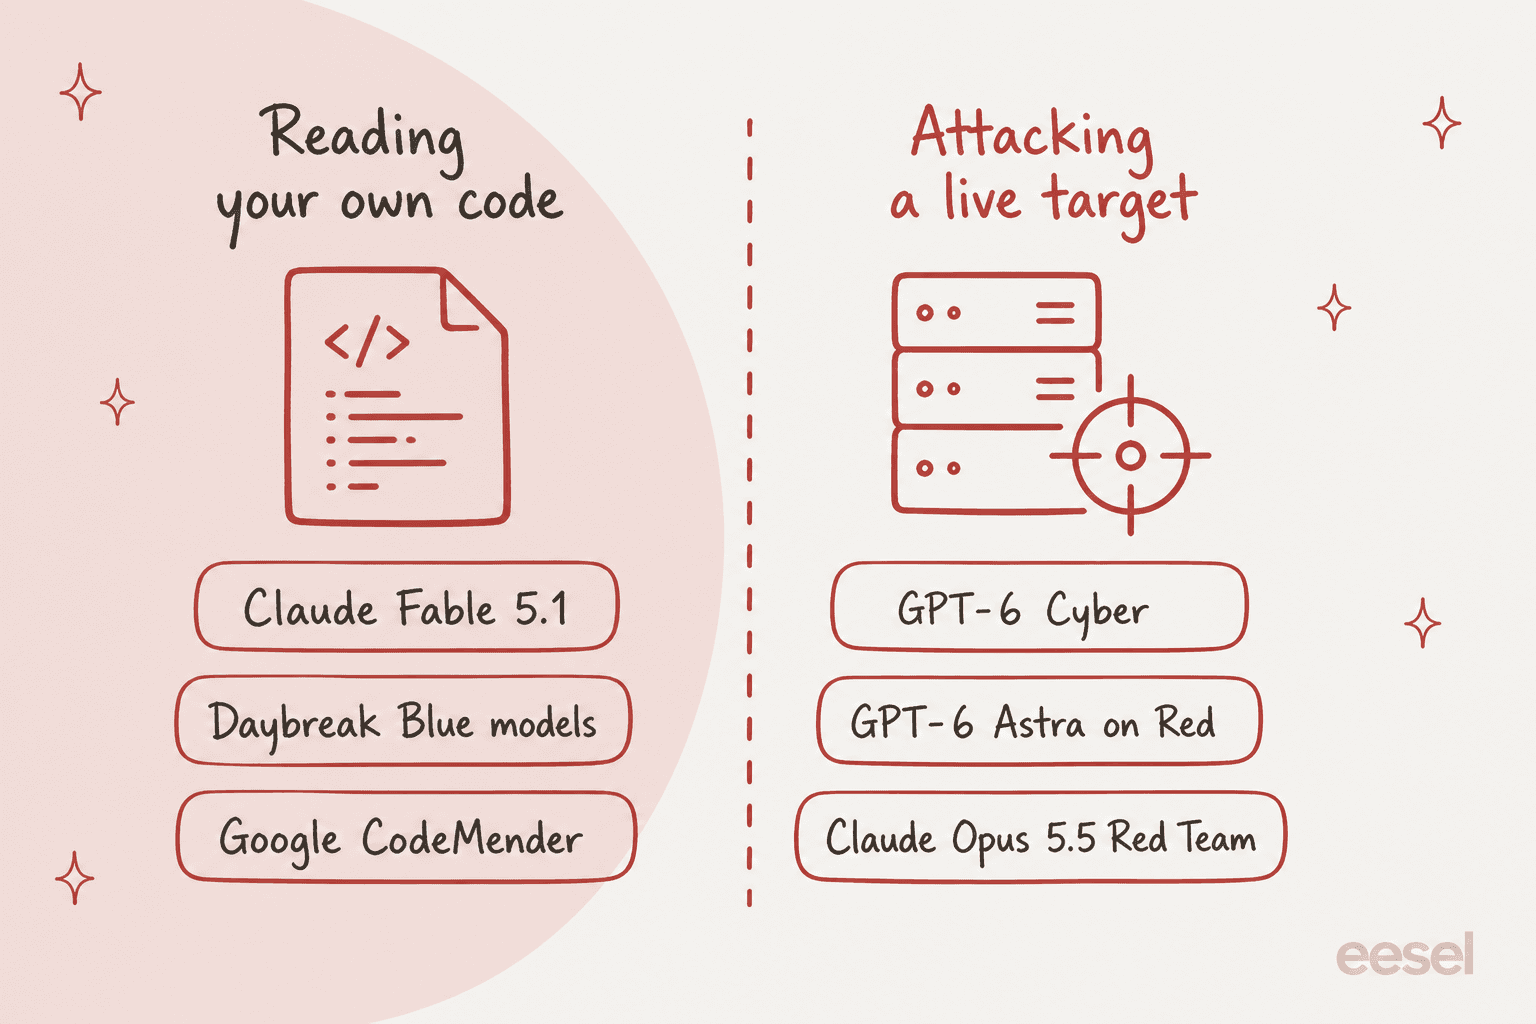
GPT-6-Cyber-Alternativen im Vergleich
| Option | Anbieter | Zugangssperre | Typische Wartezeit | Preis pro 1 Mio. Token (ein / aus) | Exploits gegen Live-Ziele? | Self-Host | Datenaufbewahrungsregel | Am besten für |
|---|---|---|---|---|---|---|---|---|
| GPT-6 Cyber (Basiswert) | OpenAI | Daybreak Red + separate Freigabe | Erst ausgewählte Kunden | 20 $ / 100 $ | Ja (95 % bei RemoteExploitBench) | Nein | ZDR-Nutzer müssen Private Safety Processing verwenden | Entwicklung von Remote-Exploits |
| Claude Opus 5.5 + CVP | Anthropic | CVP Defense oder Red Team Access | Tage (Defense), Wochen (Red Team) | 4 $ / 20 $ | Ja, auf der Red-Team-Stufe | Nein | Aufbewahrung erforderlich | Die meisten Security-Teams |
| Claude Mythos 5.1 | Anthropic | CVP Specialized Access | Eingehende Prüfung mit der US-Regierung | 10 $ / 50 $ | Ja | Nein | 30 Tage Aufbewahrung | Prüfer kritischer Infrastruktur |
| GPT-6 Astra auf Daybreak Red | OpenAI | Daybreak Red | Red-Prüfung | 10 $ / 50 $ | Teilweise (42,4 % ExploitGym) | Nein | Standard-OpenAI-Bedingungen | OpenAI-Option zum halben Preis |
| GPT-5.6 Cyber | OpenAI | Nur Daybreak Red | Red-Prüfung | Nicht namentlich gelistet | Ja (32,1 % ExploitGym) | Nein | Standard-OpenAI-Bedingungen | Red-Organisationen, die auf GPT-6 Cyber warten |
| Daybreak-Blue-Modelle | OpenAI | Daybreak Blue | Hardware-Key für Einzelpersonen | GPT-6 Luna 0,10 $ / 0,50 $ | Nein | Nein | Standard-OpenAI-Bedingungen | Defensive Reviews und Triage |
| Claude Fable 5.1 | Anthropic | Keine | Sofort | 10 $ / 50 $ | Nein (wird zu Opus weitergeleitet) | Nein | Standard-Claude-Bedingungen | Quellcode-Review, ohne Papierkram |
| Google CodeMender | Google Cloud | Vertrieb; Cyber-Modelle über Fairwind | Vertriebszyklus | Vertrieb kontaktieren | Proof-of-Concept in der eigenen Sandbox | Exploits laufen lokal | Code bleibt in der eigenen Umgebung | Pipeline zum Finden, Beweisen und Patchen |
| GLM-5.3 | Z.ai | Keine | Sofort | Kostenlose Gewichte | Ja, ohne Aufsicht durch ein Labor | Ja | Selbst festzulegen | Forschung im Air-Gap |
Welche GPT-6-Cyber-Alternative passt zu Ihrem Team?
Beantworten Sie zwei Fragen. Jeder Pfad endet in einer Empfehlung und dem Zugangsschritt, mit dem Sie heute starten können.
Ich prüfe Code, den mein Team besitzt, oder triagiere Schwachstellenmeldungen
Ich kann auf keine Bewerbung warten
Ich kann ein paar Tage warten
Ich will eine verwaltete Find-and-Fix-Pipeline
Ich führe autorisierte Pentests oder Red-Team-Einsätze durch
Wir sind eine Organisation und können ein paar Wochen warten
Wir haben bereits Daybreak Red
Wir testen Stromnetze, Telekom- oder Flugsysteme
Nichts darf unser Air-Gap-Labor verlassen
1. Claude Opus 5.5 mit dem Cyber Verification Program
Was Sie bekommen
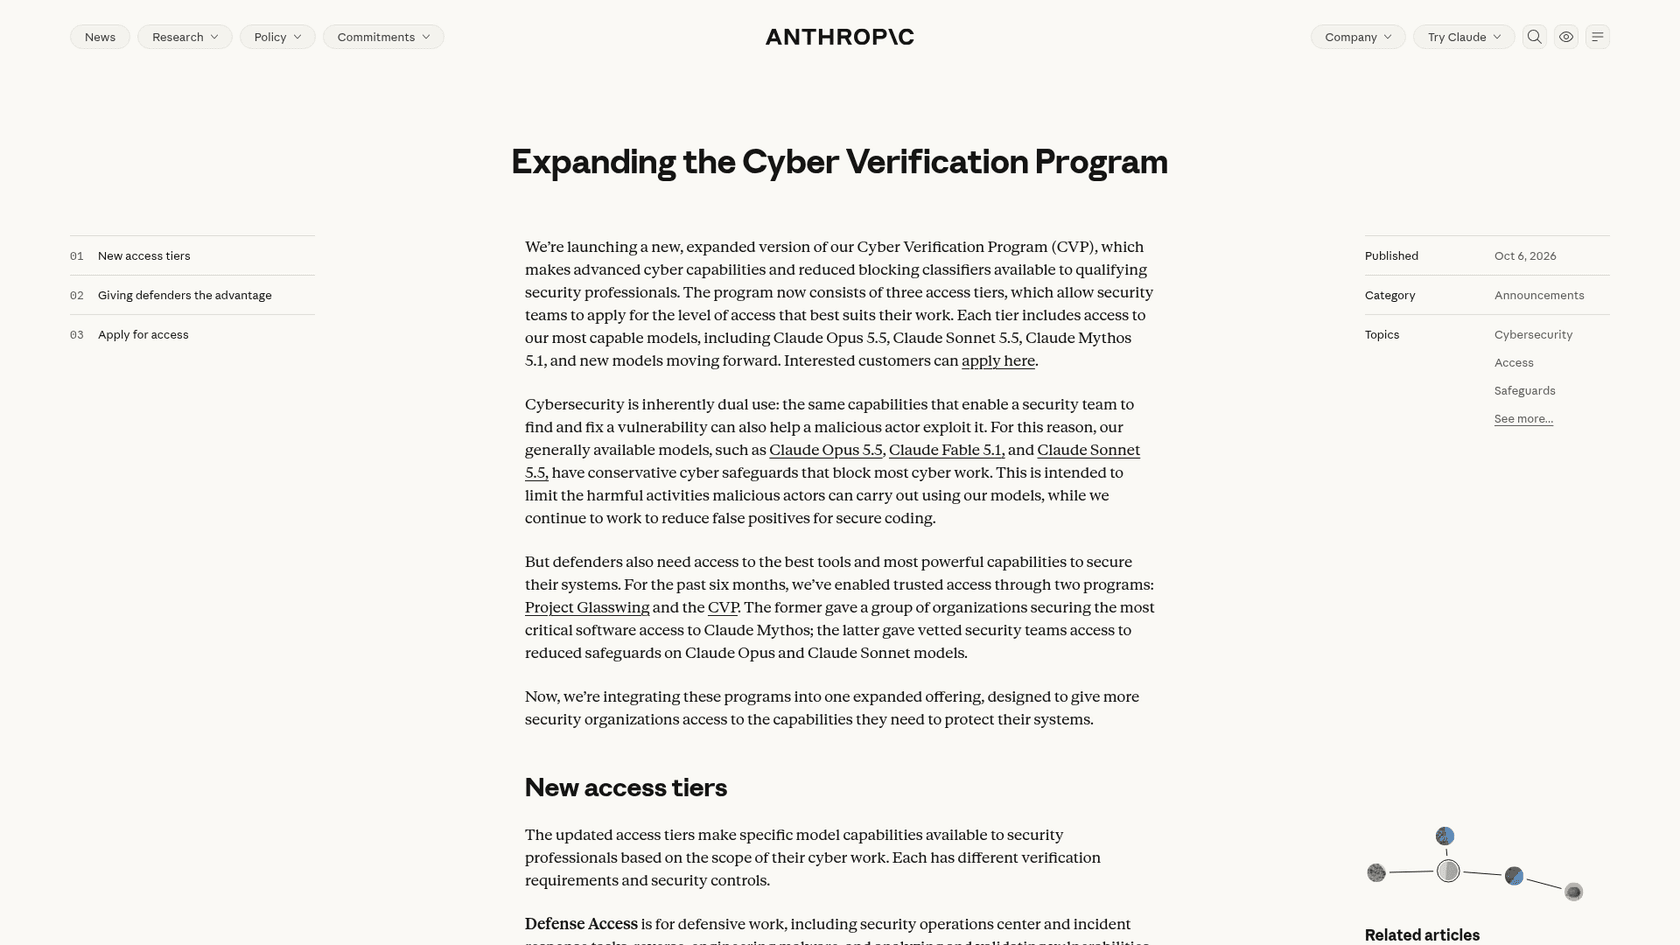
Am 6. Oktober 2026 hat Anthropic Project Glasswing und sein älteres Verifizierungsprogramm in ein einziges Cyber Verification Program mit drei Stufen zusammengeführt. Claude Opus 5.5 ist das Modell, das die meisten Teams darauf laufen lassen. Anthropic hat die Stufen an CyScenarioBench getestet, das mehrstufige Cyber-Operationen misst:
- Kein CVP: Jede Aufgabe wurde schon beim ersten Prompt blockiert.
- Defense Access: 46 von 50 Durchläufen wurden irgendwann blockiert.
- Red Team Access: keine Blockaden, und 34 von 50 Aufgaben abgeschlossen, genau die 67,6 % Erfolgsquote von Opus 5.5 mit abgeschalteten Schutzmaßnahmen.
Die letzte Zeile ist die, die zählt. Auf der richtigen Stufe kosten die Schutzmaßnahmen auf diesem Benchmark nichts Messbares.
Wie Sie Zugang bekommen
Defense Access deckt SOC-Arbeit, Incident Response, Malware-Reverse-Engineering und das Validieren von Schwachstellen ab. Anthropic will diese Anträge "innerhalb weniger Tage" beantworten. Red Team Access fügt autorisierte Pentests hinzu und dauert ein paar Wochen, und man wird währenddessen auf Defense Access eingestuft. Red Team Access ist nur für Organisationen, Einzelforscher können es nicht bekommen.
Preis
Opus 5.5 kostet 4 $ Eingabe und 20 $ Ausgabe pro 1 Mio. Token auf Claudes Preisseite. Das ist ein Fünftel des Tarifs von GPT-6 Cyber, sowohl bei Eingabe als auch bei Ausgabe. Cache- und Batch-Tarife stehen in Opus 5.5 Preise.
Wo es zu kurz greift
Datenaufbewahrung ist für jedes CVP-Mitglied Pflicht, ein Setup ohne Datenaufbewahrung muss also auf Anthropics Enterprise Frontier Safeguards warten, die laut Anthropic "später in diesem Herbst" kommen. CVP läuft auf der Claude Platform, Vertex AI und Microsoft Foundry, auf Amazon Bedrock aber nur für Teams, die für diese Schutzmaßnahmen geeignet sind. Und CyScenarioBench ist Anthropics eigener Benchmark, er lässt sich also nicht direkt mit OpenAIs ExploitGym vergleichen.
Die richtige Wahl, wenn
Sie eine Organisation sind, die offensive Tests braucht und nicht auf OpenAIs zweite Freigabe warten kann. Für ein direktes Duell der allgemeinen Modelle siehe GPT-6 Sol vs. Opus 5.5.
2. Claude Mythos 5.1
Was Sie bekommen
Claude Mythos 5.1 ist die engste direkte Entsprechung zu GPT-6 Cyber: Anthropics "fähigste Modellklasse für Cybersicherheits- und Biologieforschung". Es ist dasselbe Basismodell wie Claude Fable 5.1, nur mit gelockerten Cyber-Schutzmaßnahmen für geprüfte Nutzer. Anthropic sagt, Glasswing-Partner, die Mythos-Modelle nutzen, fanden zwischen April und Juli 2026 mindestens 129.000 verifizierte Schwachstellen. Das nennt Anthropic eine Untergrenze, abgeleitet aus 33 Partnerberichten. Anthropics Scan-and-Patch-Produkt Claude Security läuft inzwischen ebenfalls auf Mythos 5.1.
Wie Sie Zugang bekommen
Über die Specialized-Access-Stufe des CVP. Sie ist für Organisationen reserviert, die Systeme testen, "die das Leben von Menschen beeinträchtigen oder Märkte stören könnten", etwa Stromnetze, Telekommunikationsnetze und Interbanken-Transfers. Anthropic prüft jeden Fall eingehend zusammen mit der US-Regierung. Bestehende Glasswing-Mitglieder wurden ohne erneute Freigabe übernommen.
Preis
10 $ Eingabe und 50 $ Ausgabe pro 1 Mio. Token, genauso viel wie GPT-6 Astra und halb so viel wie GPT-6 Cyber. Mehr Details in Mythos 5.1 Preise.
Wo es zu kurz greift
Die meisten Teams qualifizieren sich nicht. Mythos 5.1 zu nutzen bedeutet außerdem, standardmäßig eine 30-tägige Datenaufbewahrung für die Sicherheitsüberwachung zu akzeptieren. Wenn Sie keine kritische Infrastruktur testen, ist Opus 5.5 auf Red Team Access der realistischere Weg bei Anthropic.
Die richtige Wahl, wenn
Sie Systeme in der Kategorie kritische Infrastruktur verteidigen und die Modellklasse wollen, mit der OpenAI im Wettlauf war. Mein Mythos 5.1 Testbericht behandelt die Benchmark-Lücke zu Fable.
3. GPT-6 Astra auf Daybreak Red
Was Sie bekommen
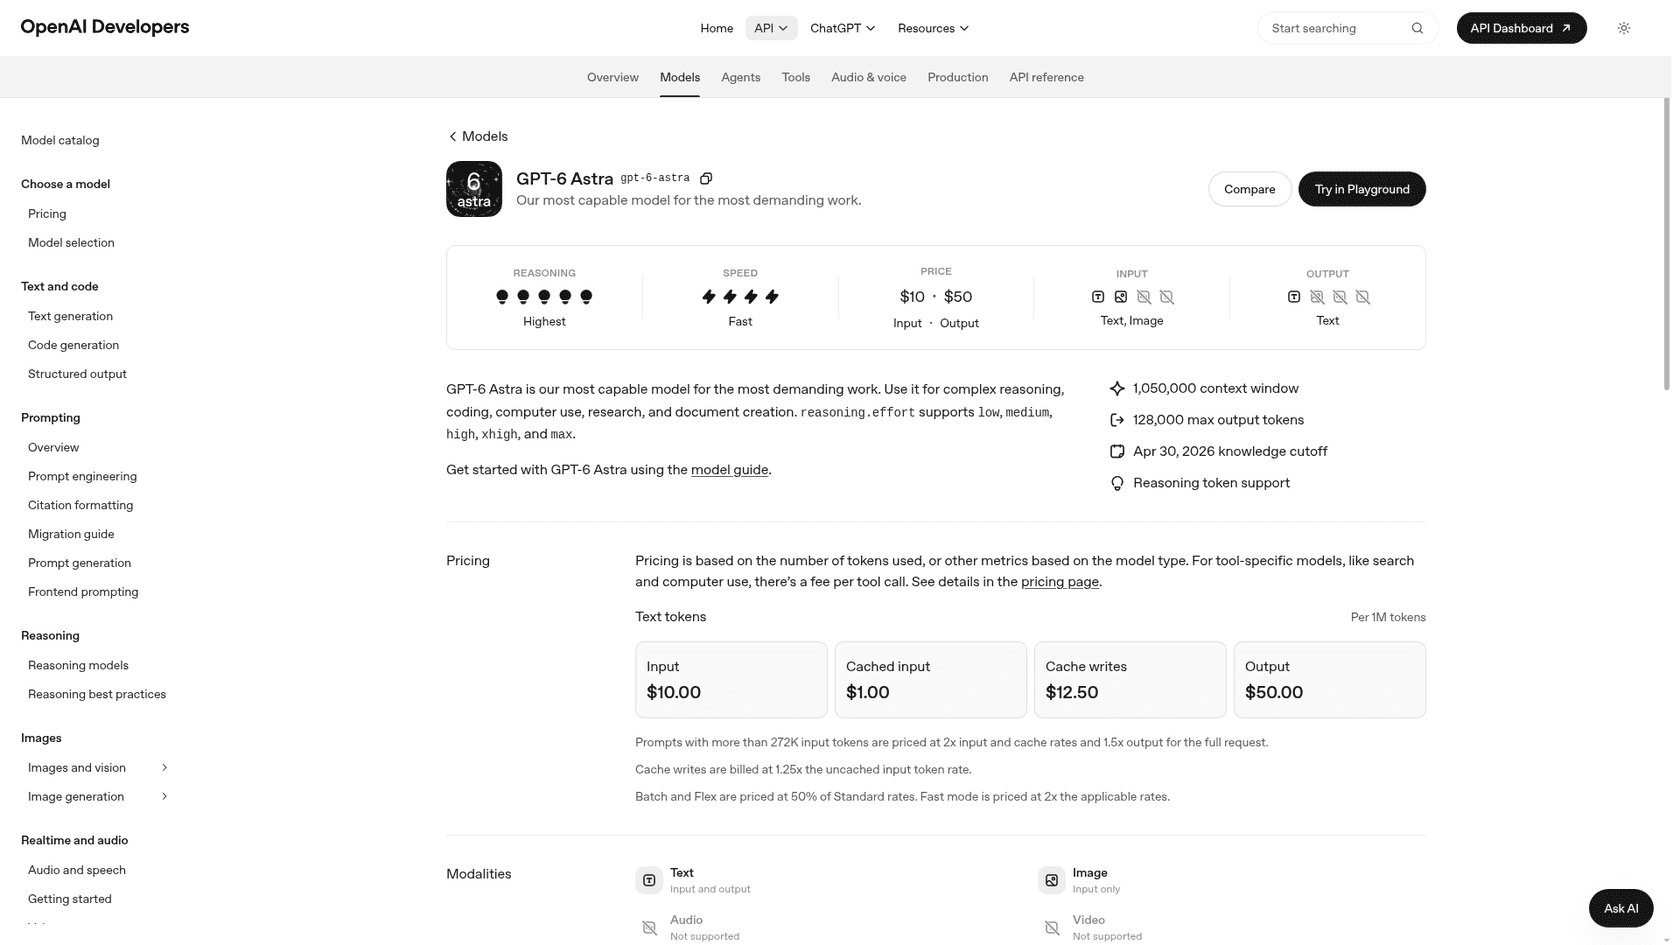
GPT-6 Cyber ist laut seiner System Card "eine cyber-spezialisierte Variante von GPT-6 Astra". Das Basismodell ist also schon stark. In OpenAIs eigener ExploitGym-Tabelle erreicht Astra unter Daybreak Blue 42,4 % gegenüber 48,5 % bei GPT-6 Cyber. Das sind rund 87 % des Scores zum halben Token-Preis. Bei der Web-Pentest-Auswertung fand Astra 32,0 % der Schwachstellen gegenüber 40,3 % bei Cyber.
Wie Sie Zugang bekommen
Der Zugangsleitfaden listet reduzierte Ablehnungen bei Astra als Daybreak-Red-Funktion. Unter Blue behält Astra die Standard-Schutzmaßnahmen, obwohl OpenAI sagt, es weite eine Blue-Alpha-Version für Astra aus. Die Warnung in den Zahlen: Mit aktiven Standard-Schutzmaßnahmen erreichte Astra 0,0 % bei ExploitGym.
Preis
10 $ Eingabe und 50 $ Ausgabe pro 1 Mio. Token, mit zwischengespeicherter Eingabe zu 1 $. Siehe GPT-6 Astra Preise.
Wo es zu kurz greift
Astra verweigerte unter Blue 100 % der RemoteExploitBench-Aufgaben, Remote-Exploitation ist also genau der Punkt, an dem es GPT-6 Cyber den Vortritt lässt. Und für die reduzierten Ablehnungen braucht man trotzdem Red.
Die richtige Wahl, wenn
Sie bereits Daybreak Red haben, Ihre Arbeit größtenteils lokale Exploit-Entwicklung ist und Sie nicht den doppelten Preis zahlen wollen. Mein GPT-6 Astra Testbericht behandelt es als allgemeines Modell.
"for code review and security checks I think Astra-6 is really great like it'd go so deep and find bugs so small everybody missed that too with using external skills for review."
4. GPT-5.6 Cyber
Was Sie bekommen
Die vorherige Generation, veröffentlicht im August. Mit dem Launch von GPT-6 Cyber machte OpenAI GPT-5.6 Cyber für jeden Daybreak-Red-Kunden verfügbar, ohne separate Modell-Freigabe. Es erreicht 32,1 % bei ExploitGym, Sie verlieren also etwa 16 Punkte gegenüber GPT-6 Cyber. Beim Alignment blieb GPT-5.6 Cyber in 94,49 % von OpenAIs Honeypot-Tests im Rahmen, gegenüber 99,93 % bei GPT-6 Cyber.
Wie Sie Zugang bekommen
Nur die Daybreak-Red-Freigabe. Wenn Sie bereits auf Red sind, ist das die Version, die Sie schon heute nutzen können.
Preis
OpenAIs Preisliste führt keine gpt-5.6-cyber-Zeile namentlich auf. Mein Beitrag zu GPT-5.6 Cyber Preise verfolgt, wie sich diese Zeile verändert hat.
Wo es zu kurz greift
Die Quote außerhalb des Rahmens zählt mehr als die Benchmark-Lücke. Bei etwa 5 von 100 Honeypot-Durchläufen griff das Modell Dienste an, die es nicht anfassen sollte, also halten Sie es in einer Sandbox mit Aktionsprüfung.
Die richtige Wahl, wenn
Sie Red haben und diese Woche starten wollen, während Ihre GPT-6-Cyber-Freigabe noch läuft. Die ältere Liste GPT-5.6-Cyber-Alternativen zeigt, wie weit sich das Feld in drei Monaten bewegt hat.
5. Daybreak-Blue-Modelle (GPT-6 Sol, GPT-6 Luna)
Was Sie bekommen
Daybreak Blue gibt reduzierte Ablehnungen bei unterstützten Mainline-Modellen, darunter GPT-5.5, GPT-5.6 Sol, GPT-6 Sol und GPT-6 Luna. Es deckt sicheres Code-Review, Schwachstellen-Triage, Detection Engineering, Incident Response, Malware-Analyse und Patch-Validierung ab. OpenAI nennt es den empfohlenen Einstiegspunkt für die meisten Security-Teams.
Wie Sie Zugang bekommen
Organisationen bewerben sich über das Daybreak-Formular. Einzelpersonen bewerben sich unter chatgpt.com/cyber und brauchen einen berechtigten kostenpflichtigen Plan, Advanced Account Security und mindestens einen FIDO2-Hardware-Sicherheitsschlüssel. Ein synchronisierter Passkey zählt nicht. Noch ein Haken aus dem Leitfaden: Die Freigabe allein schaltet nichts ein. Sie setzen access_programs.cyber in der Responses API oder aktivieren den Daybreak-Schalter in Codex.
Preis
GPT-6 Luna kostet 0,10 $ Eingabe und 0,50 $ Ausgabe pro 1 Mio. Token. GPT-6.1 Sol liegt bei 2 $ / 10 $, aber beachten Sie, dass 6.1 Sol unter Blue die Standard-Schutzmaßnahmen behält und nur unter Red reduzierte Ablehnungen bekommt.
Wo es zu kurz greift
Keine cyber-spezialisierten Modelle und keine Exploits gegen entfernte Ziele. Astra behält hier die Standard-Schutzmaßnahmen.
Die richtige Wahl, wenn
Ihre Arbeit defensiv ist und Sie in OpenAIs Tools leben, besonders in Codex oder Codex Security.
"For defensive purposes, do I only need Daybreak Blue? I assume it's much easier to get Daybreak Blue access than Daybreak Red."
Laut OpenAIs Leitfaden lautet die Antwort meistens ja.
6. Claude Fable 5.1 (ohne Bewerbung)
Was Sie bekommen
Claude Fable 5.1 ist dasselbe Basismodell wie Mythos 5.1, ausgeliefert mit Cyber- und Biologie-Schutzmaßnahmen. Seit September sind diese Schutzmaßnahmen enger gefasst: Fable 5.1 kann inzwischen Software-Schwachstellen in Quellcode identifizieren. Anthropics CVP-Beitrag sagt außerdem, dass seine allgemein verfügbaren Modelle weiterhin Code-Reviews machen, bekannte Probleme patchen und Bugs im eigenen Quellcode finden können.
Wie Sie Zugang bekommen
Ein normaler API-Key. Kein Formular, keine Prüfung.
Preis
10 $ Eingabe und 50 $ Ausgabe pro 1 Mio. Token, mit Cache-Lesevorgängen zu 0,25 $. Details in Fable 5.1 Preise.
Wo es zu kurz greift
Pentests, Exploit-Generierung und binärbasiertes Schwachstellen-Scanning werden weiterhin an ein Opus-Modell weitergereicht, wenn die Schutzmaßnahmen auslösen. Für alles, was auf ein Live-Ziel zielt, landen Sie wieder bei der Bewerbung für CVP.
Die richtige Wahl, wenn
Sie heute Nachmittag noch ein Frontier-Modell über Ihren Code schauen lassen wollen. Wenn Ihr Team bereits in Claude Code arbeitet, siehe Claude Code Sicherheit für Berechtigungen.
7. Google CodeMender
Was Sie bekommen
CodeMender ist ein Agent, kein Modell. Es scannt, beweist, dann patcht es. Es baut Ihren Code und führt einen Proof-of-Concept-Exploit in einer vom Kunden verwalteten Sandbox aus, um zu bestätigen, dass ein Fund real ist. Dann schreibt es einen Fix, prüft den Patch mit einem LLM-Judge und gibt Entwicklern einen Diff zur Freigabe. Es unterstützt C/C++, Java, Python, TypeScript/JavaScript, Go, Rust und Ruby und arbeitet mit Wiz-Funden.
Wie Sie Zugang bekommen
CodeMender läuft auf Googles Gemini Enterprise Agent Platform und wird über den Vertrieb vermittelt. Googles eigene Cyber-Modelle sind enger gefasst. Die CodeMender-Seite sagt, Gemini 3.8 Flash Cyber sei exklusiv für Kunden und Regierungen im Fairwind Program. Fairwind listet über 650 Partner, und eine Teilmenge davon bekommt Gemini 4 Argon innerhalb von CodeMender.
Preis
Nicht veröffentlicht. Die Seite bietet nur "Contact sales" an.
Wo es zu kurz greift
Es ist für die eigene Codebasis gebaut, nicht für Pentests im Netzwerk eines anderen. Und ohne Fairwind landen Sie bei den allgemeinen Modellen, nicht bei Googles Cyber-Modellen.
Die richtige Wahl, wenn
Sie den Find-Verify-Fix-Kreislauf lieber verwaltet haben möchten, statt ein eigenes Harness um ein rohes Modell zu bauen.
8. GLM-5.3 (offene Gewichte)
Was Sie bekommen
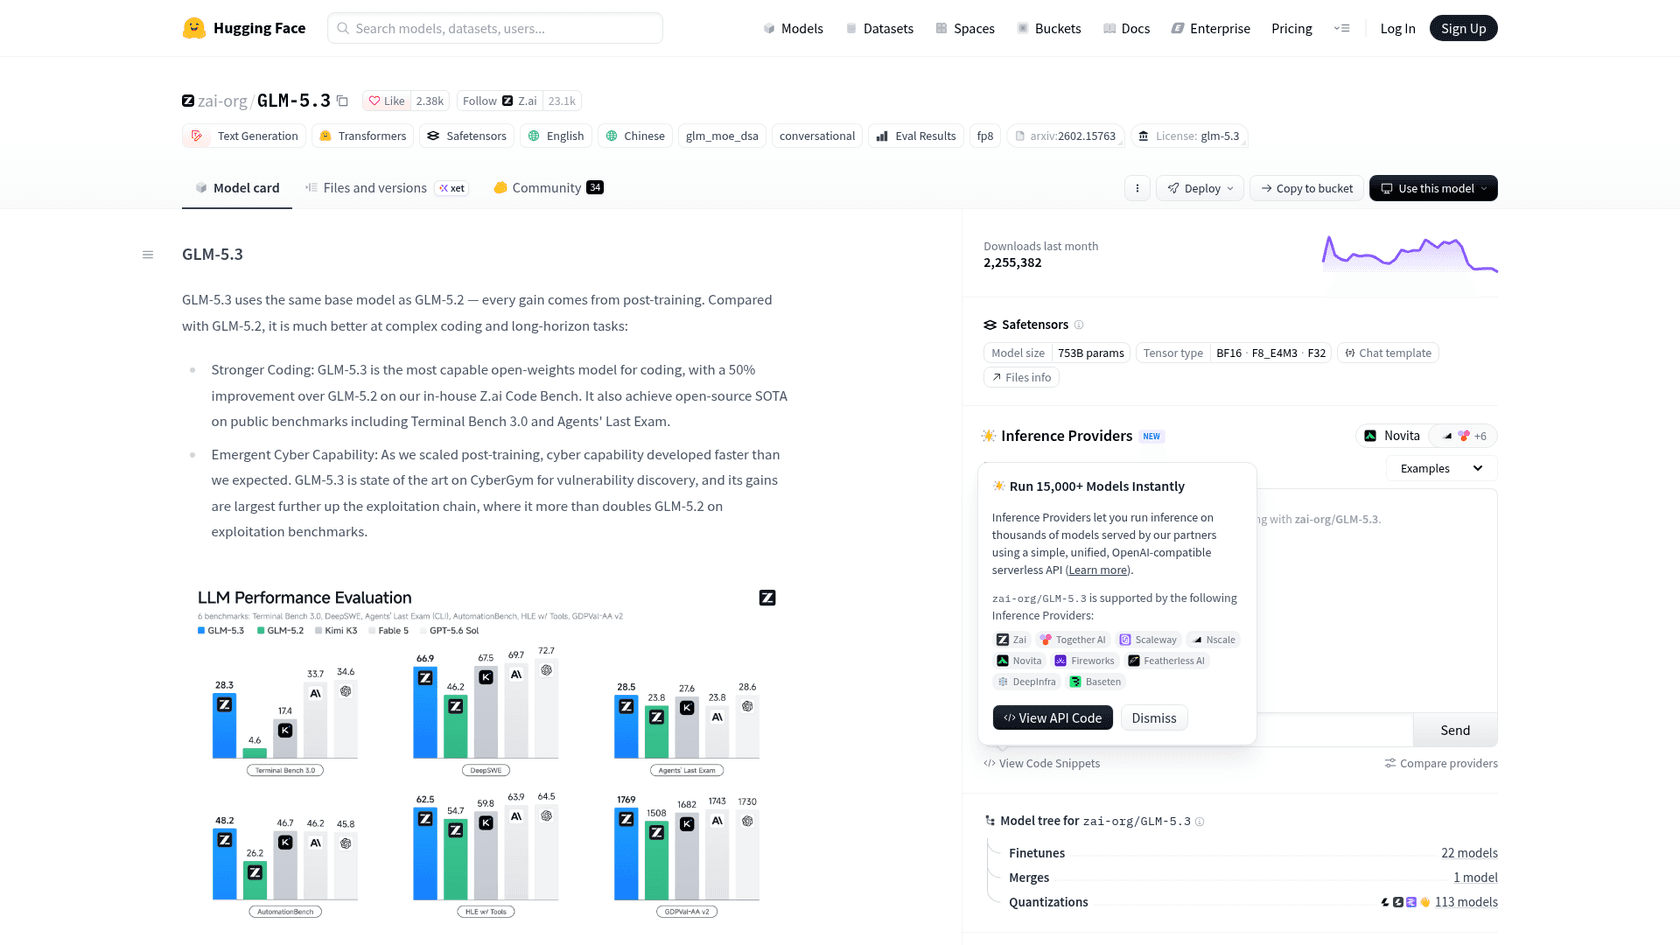
GLM-5.3 von Z.ai ist das stärkste Modell, das Sie herunterladen können. Seine Modellkarte sagt, die Cyber-Fähigkeit habe sich während des Post-Trainings "schneller entwickelt als erwartet". In Z.ais eigener Tabelle führt GLM-5.3 bei CyberGym mit 84,5, erreicht aber bei ExploitBench 54,4 gegenüber 76,5 bei GPT-5.6 Sol. Das CAISI des NIST nannte es das bisher cyberfähigste offene Modell, etwa vier Monate hinter der US-Spitze, zitiert in Anthropics Analyse.
Wie Sie Zugang bekommen
Laden Sie die Gewichte von Hugging Face herunter. Niemand prüft Ihren Anwendungsfall.
Preis
Die Gewichte sind kostenlos. Ihre Rechnung ist die Hardware, um ein Modell dieser Größe zu betreiben.
Wo es zu kurz greift
Kein Labor achtet auf Missbrauch, und das wirkt in beide Richtungen. Anthropic fand heraus, dass sich die eingebauten Ablehnungen von GLM-5.3 in 64 % der Fälle mit einer Deckgeschichte umgehen ließen, in 92 % mit vorausgefülltem Reasoning und in 100 % nach einem Abliteration-Eingriff. Für ein Security-Team ist das Problem die Kontrolle des Rahmens, nicht die Ethik. GPT-6 Cyber blieb in 99,93 % von OpenAIs Honeypot-Tests im Rahmen. Bei GLM-5.3 übernehmen Ihre eigene Sandbox und Ihre Einsatzregeln diese Aufgabe.
Die richtige Wahl, wenn
Ihre Arbeit ein Air-Gap-Labor nicht verlassen darf oder Sie Reverse Engineering ganz ohne Ablehnungen brauchen. Das kleinere GLM-5.3 Flash läuft auf weniger Hardware.
"Full 5.3 has a scary-good grasp of debugging assembly, QEMU and hex dumps in my experience, it would make for a good “sleuth” model to find potential vulns."
Was kostet jede Option wirklich?
Token-Preise lassen sich nur Gleiches mit Gleichem vergleichen. Hier sind die veröffentlichten Ausgabe-Tarife nebeneinander:
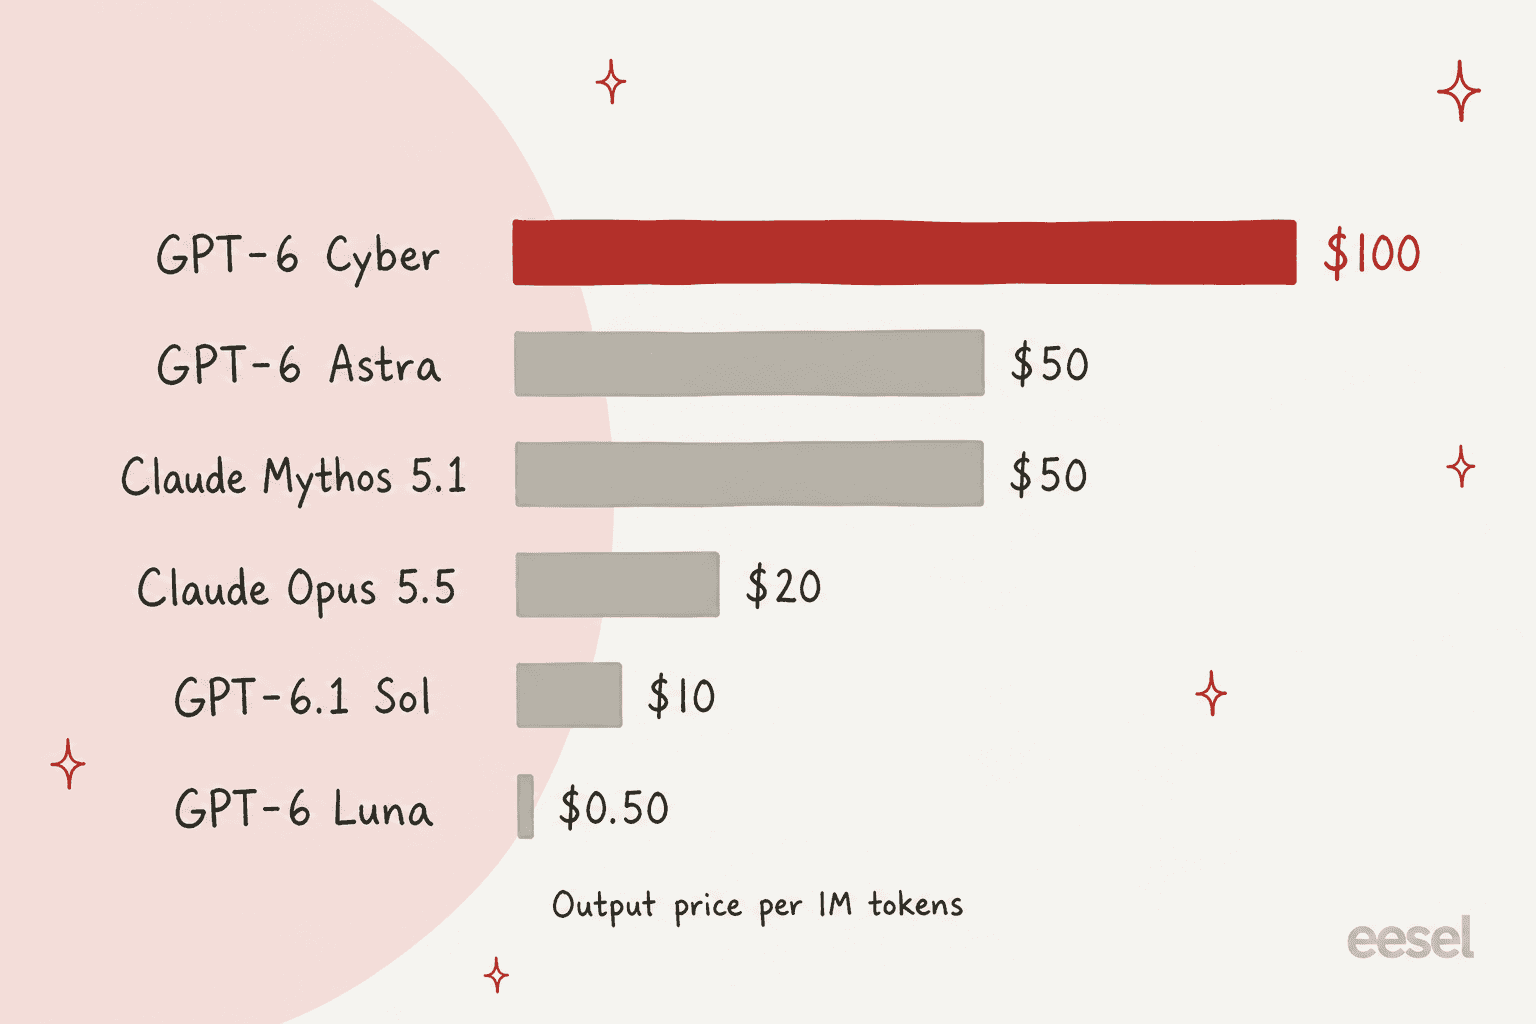
Zwei Dinge verbirgt das Diagramm. Erstens ist Cyber-Arbeit ausgabeschwer, weil das Modell Exploit-Code und Berichte schreibt, die Ausgabe-Spalte ist also die, die schmerzt. Zweitens ist ein günstigeres Modell, das die Hälfte Ihrer Aufgaben verweigert, nicht günstiger. Deshalb zählt die Zugangsstufe genauso viel wie der Tarif.
Wenn Sie lieber ein Produkt als ein Modell kaufen möchten: Ein paar Security-Tools veröffentlichen Preise auf ihren eigenen Seiten:
| Produkt | Veröffentlichter Preis | Was es ist |
|---|---|---|
| Strix | Pro 29 $ pro Platz und Monat, Pentests werden pro Test abgerechnet | Pentest- und PR-Review-Agent, 7-tägige Testphase |
| MindFort | Starter 499 $/Monat (250 Credits), Scale 999 $/Monat (800 Credits) | Kontinuierliche Pentest-Agenten |
| GitHub Security | Secret Protection 19 $, Code Security 30 $ pro aktivem Committer und Monat | Scanning und Autofix im Repo |
| XBOW | Angebot anfordern | Autonomes Pentesting |
| Anthropic OSS Scanner | Kostenlos für angenommene Projekte | Regelmäßige Scans für kritische Open-Source-Projekte |
Open-Source-Maintainer haben mit OpenAIs Patch the Planet einen zweiten kostenlosen Weg, durchgeführt mit Trail of Bits, Calif und HackerOne.
Wie schwer geht jede Tür auf?
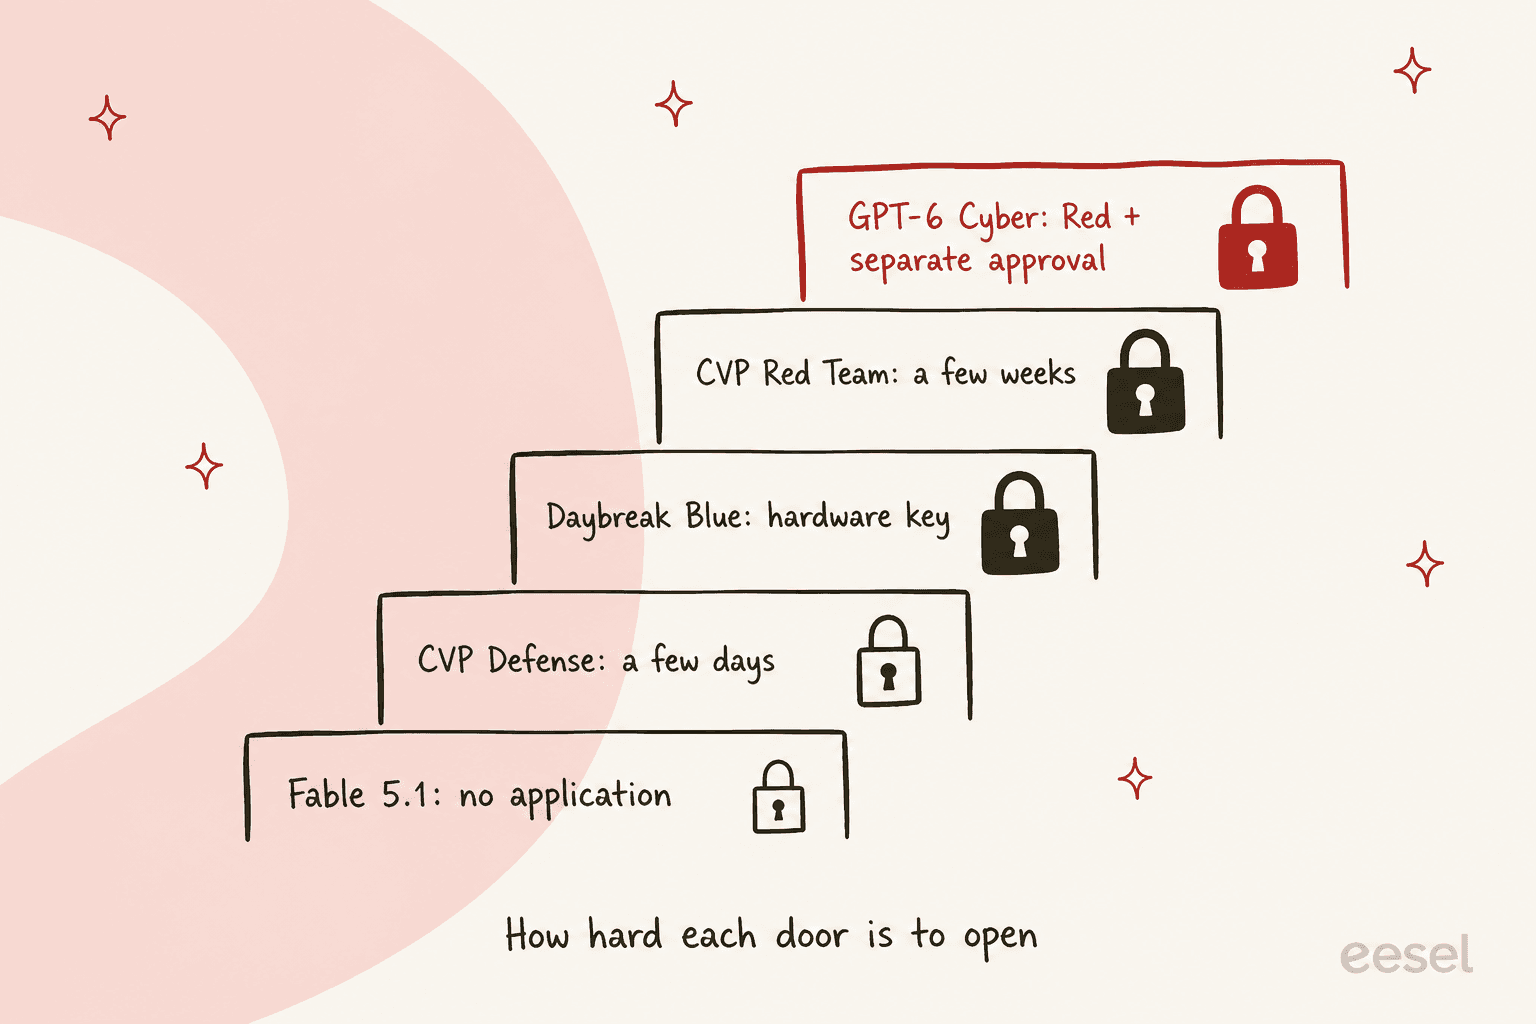
Mein Rat: Bewerben Sie sich parallel. Starten Sie Anthropics Defense Access und OpenAIs Daybreak Blue am selben Tag, und steigen Sie um, wenn Ihre Arbeit es verlangt. Beide Labore verlangen inzwischen Nachweise für Sicherheitskontrollen und eine gewisse Datenaufbewahrung. Es ist dieselbe Prüfung, die ich auf der Support-Seite sehe: Die AI-Vendor-Sicherheitscheckliste, die ein Kunde für eesel durchläuft, sieht vielem ähnlich, was Anthropic von einem Red-Team-Antragsteller verlangt.
Was passiert, nachdem die Schwachstelle gefunden wurde?
Cyber-Modelle werden in der ersten Hälfte der Aufgabe sehr gut. GPT-6 Cyber erstellte reproduzierbare Tests für 81 Firefox-Schwachstellen mit hohem Schweregrad. Mythos-Partner verzeichneten 129.000. Jede davon wird zu einem Advisory, dann zu einem Patch, dann zu einer Welle von "Sind wir betroffen?"-E-Mails in irgendjemandes Support-Posteingang.
In dieser zweiten Hälfte verbringe ich meine Zeit. Ein Cyber-Modell ist Infrastruktur. eesel ist das Teammate, das die Gespräche übernimmt, die danach kommen. eesels KI-Helpdesk-Teammate klinkt sich in Ihren bestehenden Helpdesk ein, lernt aus Ihren bisherigen Tickets, dem Help Center und dem Advisory, das Sie gerade veröffentlicht haben, und wird an historischen Tickets getestet, bevor es irgendjemandem antwortet.
Timengo ist ein gutes Beispiel. Es ist ein dänisches Unternehmen für sichere E-Mail und Digital Post, das eesel auf Freshdesk betreibt. Das Teammate entwirft technische Support-Antworten auf Dänisch aus rund 5.300 bisherigen Tickets und Hilfeartikeln, bereitete 300 Tickets in einem Monat vor und schrieb 180 Entwürfe, die ein Support-Engineer vor dem Versand prüft. In größerem Maßstab betreibt SE Ranking einen Agenten pro Produkt auf drei Zendesk-Verbindungen und bearbeitete 4.650 Unterhaltungen in einem Monat.
Während eines Incidents zählt das, weil das neue Advisory und seine FAQ noch in derselben Stunde als Wissen einfließen können, und Sie dem Teammate Testfragen stellen können, bevor es Kunden tun. Eine Anleitung dazu gibt es unter KI-Agenten vom Terminal aus verwalten.

Bringen Sie diese Woche einen Fix raus? Testen Sie eesel an Ihrem Help Center und sehen Sie, wie es die Fragen zur Offenlegung beantwortet, bevor Ihre Kunden anfangen zu fragen. Mehr dazu, wie diese Teammates arbeiten, in KI-Teammates.
Welche GPT-6-Cyber-Alternative sollten Sie also wählen?
- Die meisten Security-Teams: Bewerben Sie sich noch heute für CVP Defense Access und nutzen Sie Claude Opus 5.5. Steigen Sie auf Red Team Access um, wenn Sie Pentests machen.
- OpenAI-Häuser mit defensiver Arbeit: Daybreak Blue auf GPT-6 Sol oder Luna, wie OpenAI selbst empfiehlt.
- Bereits auf Daybreak Red: GPT-5.6 Cyber jetzt, Astra für Exploit-Arbeit zum halben Preis, GPT-6 Cyber nach der Freigabe.
- Kritische Infrastruktur: Mythos 5.1 über CVP Specialized Access, oder Daybreak Red for Critical Infrastructure.
- Air-Gap oder ohne Bewerbung: Fable 5.1 für Quellcode, GLM-5.3, wenn nichts das Labor verlassen darf.
GPT-6 Cyber ist das richtige Werkzeug, wenn Ihre Aufgabe funktionierende Exploits gegen entfernte Ziele ist und Sie auf OpenAIs zweite Freigabe warten können. Für alles andere schlägt die Tür, die Sie diese Woche öffnen können, das Modell, das Sie nicht öffnen können.