

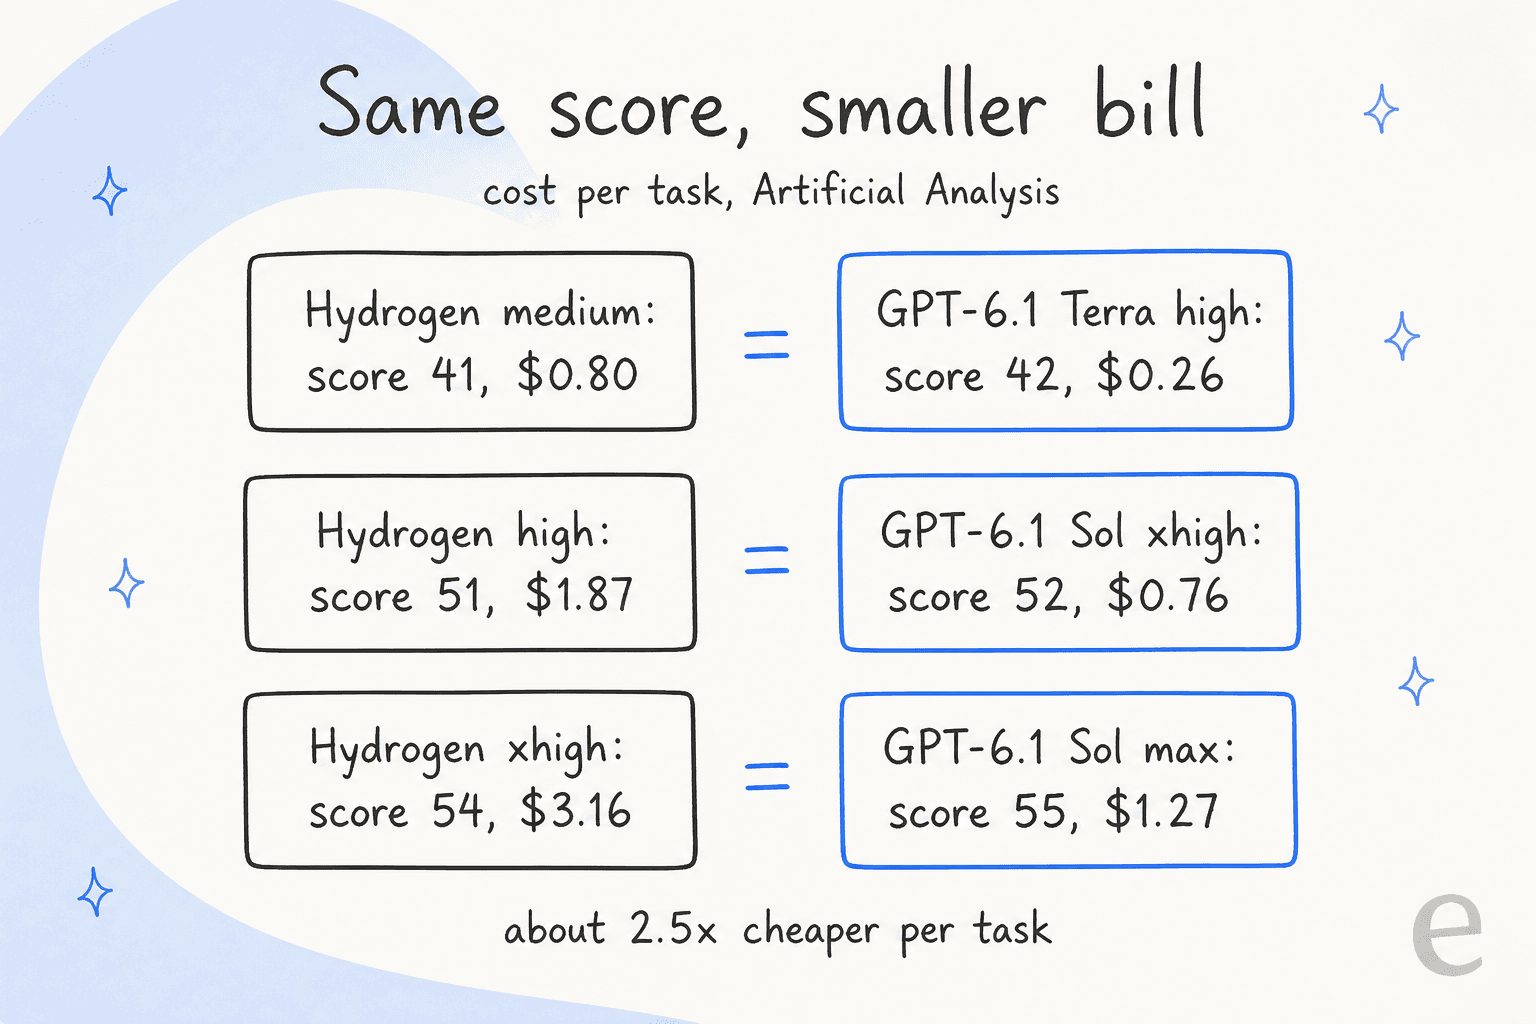
Die beste Gemini 4 Hydrogen Alternative für die meisten Builder ist GPT-6.1 Sol bei xhigh-Aufwand. Es kostet pro Token mehr als Hydrogen, aber Artificial Analysis bewertet es mit 52 für $0,76 pro Aufgabe, während Hydrogen auf seiner Standardstufe high 51 für $1,87 erreicht. Hydrogen denkt viel nach, bevor es antwortet, und Sie bezahlen für jeden einzelnen dieser Tokens.
Wählen Sie Claude Sonnet 5.5 für Coding- und Computer-Use-Agenten, DeepSeek V4.1 Flash für die kleinste Rechnung, und Gemini 4 Carbon nur für die schwierigsten Probleme. Wenn Sie einen Support-Agenten bauen, ist eesel ein fertiges Helpdesk-Teammitglied, das auf Modellen wie diesen aufsetzt, und seine CLI lässt einen Coding-Agenten Ihre Hilfeartikel laden und seine Antworten testen, bevor er live geht.
Warum überhaupt über Gemini 4 Hydrogen hinausschauen?
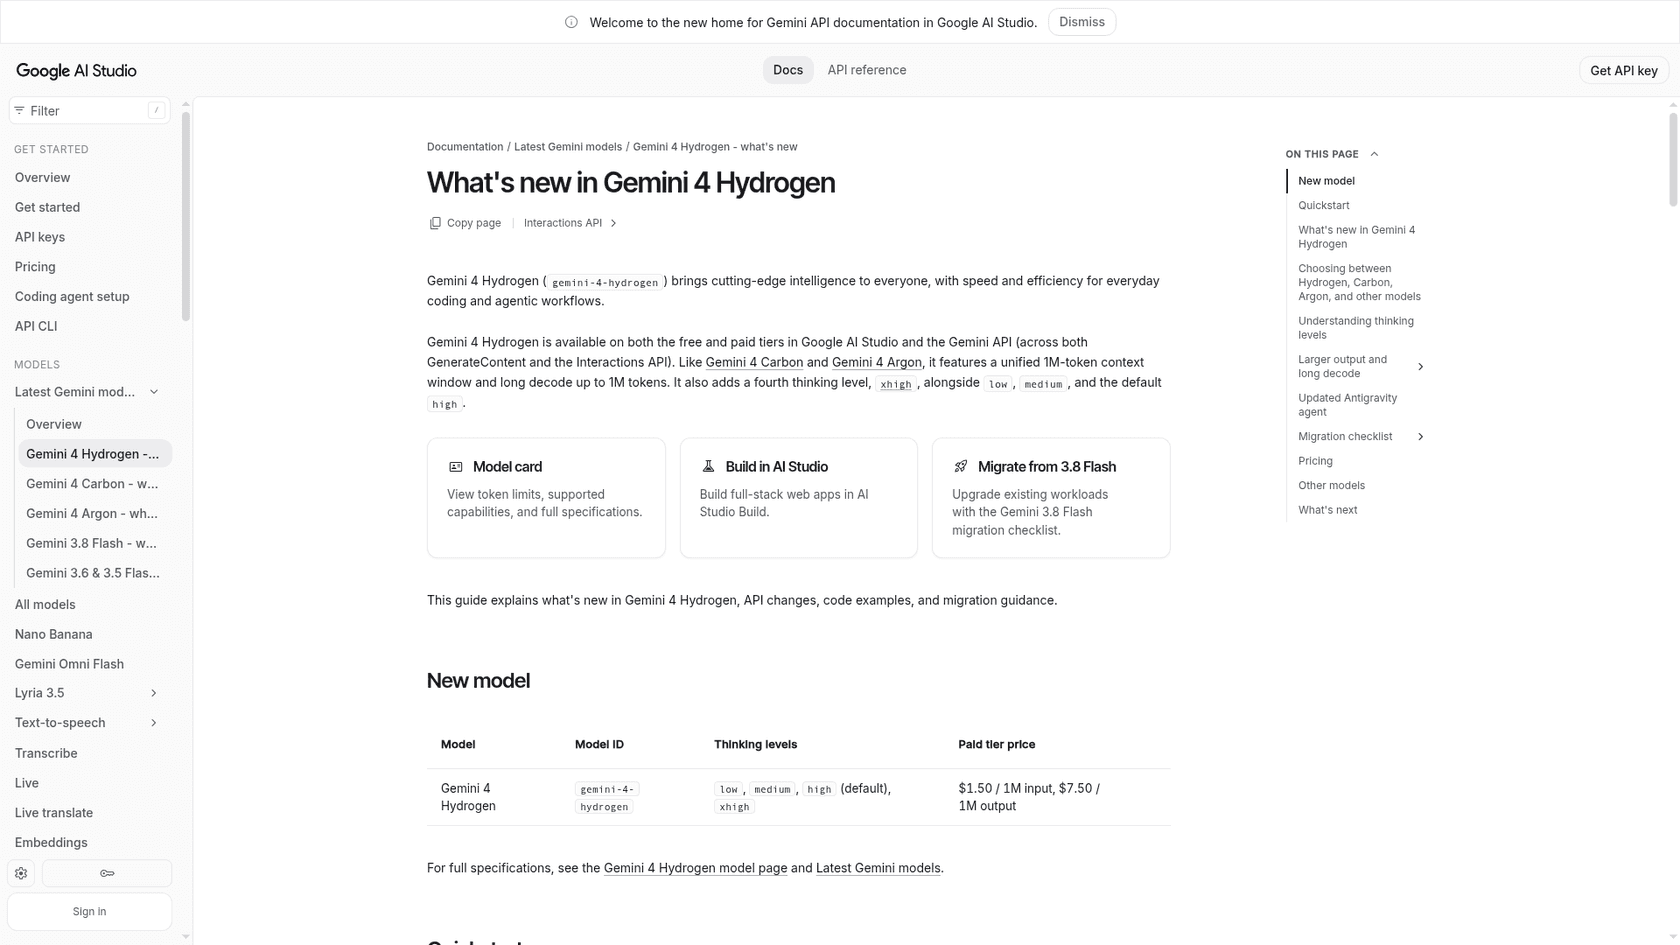
Ich beginne mit dem guten Teil, denn davon gibt es viel. Gemini 4 Hydrogen startete am 12. November 2026 bei $1,50 pro Million Input-Tokens und $7,50 pro Million Output, flach bepreist über sein gesamtes 1-Millionen-Token-Fenster. Es hat eine ratenbegrenzte kostenlose Stufe, nimmt Text, Bilder, Audio, Video und PDFs, und bei niedrigem und mittlerem Denken ist es schnell: 1,3 und 3,7 Minuten pro Intelligence-Index-Aufgabe auf Artificial Analysis. Google berichtet außerdem, es sei 2,5-mal schneller als Gemini 3.8 Flash in seiner Standardeinstellung, laut dem Launch-Beitrag.
Builder gehen trotzdem auf die Suche, und meiner Erfahrung nach aus einem von vier Gründen:
- Die Rechnung steigt bei hohem Denken schnell. Der Token-Preis ändert sich nie, aber die Kosten pro Aufgabe tun es. Artificial Analysis setzt Hydrogen bei
$0,29pro Aufgabe auf low,$0,80auf medium,$1,87auf high (Standard) und$3,16auf xhigh. Das ist eine 11-fache Spanne beim selben Modell, weil AA es am oberen Ende als "very verbose" beschreibt. - Coding und Computer-Use hängen hinter Claude zurück. Googles eigene Modellkarte sieht Sonnet 5.5 vorn bei Terminal-Bench 4.1 (
63,9%vs.57,0%) und OSWorld-2.1 (83,9%vs.77,6%). - Migration bricht Dinge. Laut Googles Migrationshinweisen ignoriert Hydrogen
temperature,top_pundtop_k, lehnt die Denkstufeminimalab, verzichtet auf explizites Context-Caching und kannMALFORMED_FUNCTION_CALLzurückgeben, wenn Sie es ohne deklarierte Tools zu rohen JSON-Tool-Calls auffordern. - Googles Preise bewegen sich weiter. Mehr dazu unten, denn das verändert die Rechnung für jeden, der auf Gemini 3.8 Flash läuft.
Der Hacker-News-Launch-Thread hat den Zielkonflikt gut eingefangen:
"My TL;DR is: seems like a better choice than Sonnet in areas outside of coding, and at high reasoning it's smarter than Terra but somewhat more expensive."

Was passiert als Nächstes mit den Gemini-Preisen?
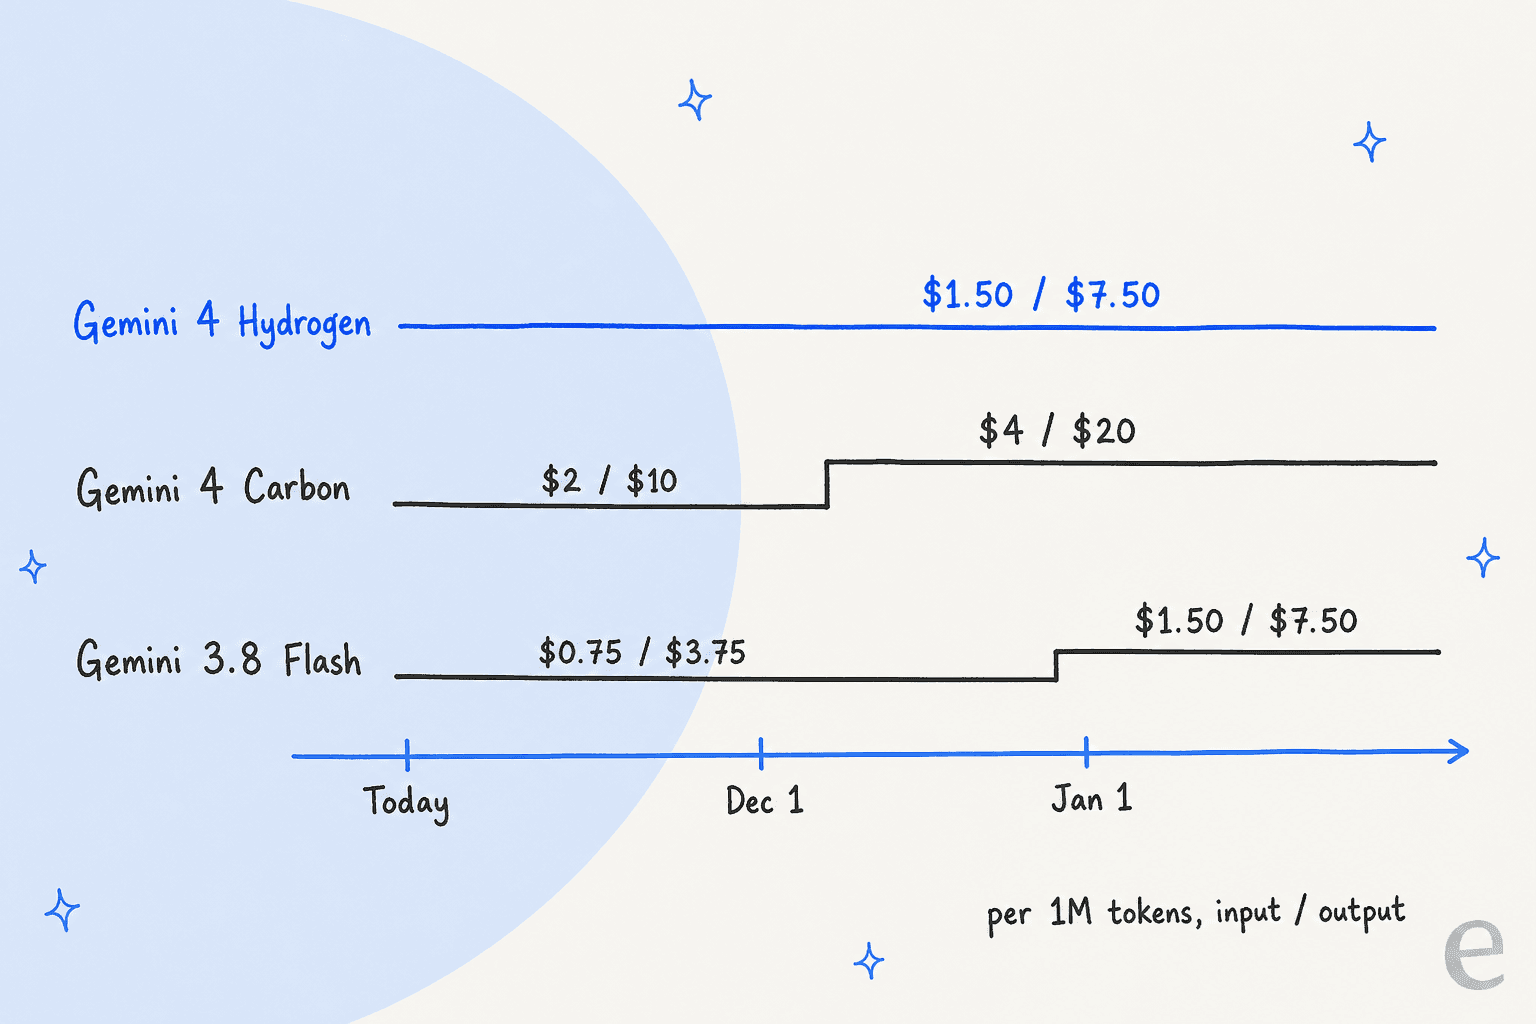
Zwei Google-Preisänderungen stehen in den nächsten sieben Wochen an. Gemini 4 Carbon geht von $2/$10 auf $4/$20 am 1. Dezember 2026, und Gemini 3.8 Flash geht von $0,75/$3,75 auf $1,50/$7,50 am 1. Januar 2027, beides laut der Gemini API Preisseite. Ab Januar haben Flash und Hydrogen den gleichen Listenpreis, weshalb Google Hydrogen als empfohlenes Upgrade bezeichnet.
Ein Flash-Nutzer im Launch-Thread hatte diese Rechnung schon gemacht:
"If this is Google's strategy we'll have to migrate to Luna, because costs are already high for our workload on 3.8 Flash"
Ich höre die gleiche Sorge von Support-Teams. Ein B2B-Hardware-Team, mit dem ich sprach, war schon einmal davon betroffen, dass die Preise eines früheren KI-Anbieters sich "mehr als verdoppelt" hatten, und bat um einen Jahresvertrag, nur um die Rate festzuschreiben. Preisrisiko ist ein echter Grund, ein zweites Modell bereitzuhalten.
Wie ich diese ausgewählt und bepreist habe
Ich baue die Integrationen und APIs, die eesels KI-Agenten mit Helpdesks verbinden, also verbringe ich viel Zeit damit, Modelle unter einem laufenden Agenten auszutauschen. Hier ist die Lektion, die sich ständig wiederholt: ein günstiger Token kann eine teure Aufgabe ergeben. Deshalb wird jede Wahl unten danach bewertet:
- Listenpreis pro 1 Mio. Tokens, abgelesen am 13. November 2026 von der eigenen Preisseite jedes Anbieters.
- Kosten pro Aufgabe, Score und Zeit pro Aufgabe von Artificial Analysis, das dieselbe Intelligence-Index-Suite bei jedem Modell laufen lässt und erfasst, was jedes tatsächlich ausgegeben hat, inklusive Denk-Tokens. Ich vermerke die Aufwandsstufe in Klammern, weil ein Modell je nach dieser Einstellung überall auf der Skala landen kann.
- Eine monatliche Rechnung für einen Käufer: ein Agent, der 1 Million Anfragen pro Monat sendet, jede mit 2.000 Input-Tokens und 300 Output-Tokens. Das sind 2 Milliarden Input- und 300 Millionen Output-Tokens, vor Caching oder Denk-Tokens. Es ist ein Boden, keine Prognose.
Ich habe außerdem eine frische ChatGPT-Suche mit der Frage gestartet, die ein Builder eingeben würde. Die Shortlist war Claude Sonnet 5.5, GPT-6.1 Terra, GPT-6.1 Sol, Claude Opus 5.5 und DeepSeek, und als entscheidende Zahl wurde "Kosten pro erfolgreicher Aufgabe" genannt. Ich habe alle fünf behalten und dann Gemini 4 Carbon, Kimi K3.1 Pro und GPT-6 Luna ergänzt, um die Routen desselben Anbieters, offener Gewichte und des Budgets abzudecken.
Gemini 4 Hydrogen Alternativen im Vergleich
| Modell | Input / Output pro 1 Mio. | Gecachter Input | Kontext | Offene Gewichte | AA Score (Stufe) | AA Kosten pro Aufgabe | AA Zeit pro Aufgabe | Monatliche Rechnung (Beispielkäufer) |
|---|---|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen (Referenz) | $1.50 / $7.50 | $0.075 | 1M | Nein | 51 (high) | $1.87 | 8.3 min | $5,250 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | Nein | 52 (xhigh) | $0.76 | 9.8 min | $7,000 |
| GPT-6.1 Terra | $1 / $5 | $0.05 | 1.05M | Nein | 42 (high) | $0.26 | 4.2 min | $3,500 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | Nein | 55 (max) | $10.02 | 33.0 min | $7,000 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | Nein | 48 (medium) | $2.45 | 7.2 min | $14,000 |
| Gemini 4 Carbon | $2 / $10, dann $4 / $20 ab 1. Dez. | $0.10 | 1M | Nein | 58 (medium) | $4.68 | 23.8 min | $7,000, dann $14,000 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 Nebenzeit | $0.003 | 1M | Ja (MIT) | 33 (max) | $0.60 | 15.1 min | $480 |
| Kimi K3.1 Pro | $2 / $10 | $0.20 | 1M | Ja | 46 | $3.68 | 38.3 min | $7,000 |
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | 1.05M | Nein | 28 (max) | $0.15 | 11.6 min | $350 |
Lesen Sie die letzten drei Spalten vor der ersten. Beim Listenpreis wirkt Hydrogen günstiger als Sol. Pro Aufgabe leistet Sol für etwa 40% der Kosten etwas bessere Arbeit, und in ähnlicher Zeit. Die Scores, Kosten und Zeiten stammen von der Artificial-Analysis-Seite jedes Modells vom 13. November 2026.
Was würde jedes einzelne Sie pro Monat kosten?
Geben Sie ein, wie viele Agent-Aufgaben Sie pro Monat ausführen, und wählen Sie eine Größe. Der Rechner multipliziert mit den Artificial-Analysis-Kosten pro Aufgabe jedes Modells, berücksichtigt also Denk-Tokens, die die Listenpreis-Rechnung oben außen vor lässt. AAs Aufgaben sind lange agentische Jobs, behandeln Sie die Summen also als Vergleich zwischen Modellen, nicht als Ihre genaue Rechnung.
1. GPT-6.1 Sol
Am besten für: Builder, die Hydrogen-Niveau-Arbeit für weniger pro Aufgabe wollen und mit OpenAIs API-Form leben können.
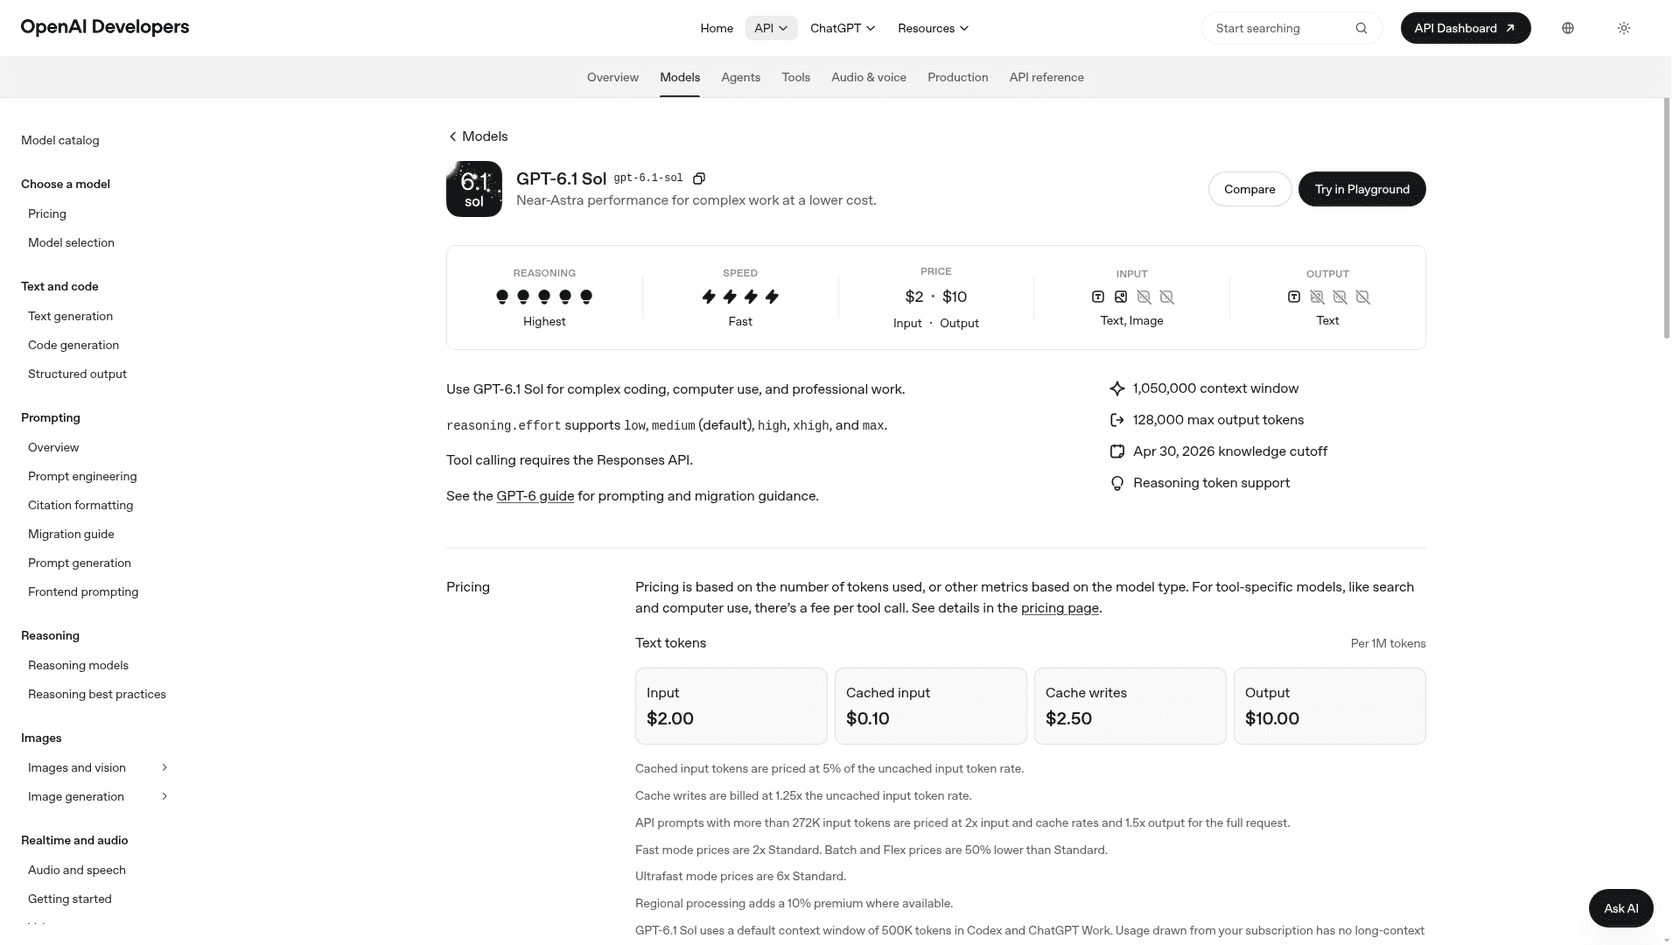
GPT-6.1 Sol ist OpenAIs zweite Stufe, unter GPT-6 Astra. OpenAI beschreibt es als "Near-Astra performance for complex work at a lower cost", und pro Aufgabe ist es auf dieser Liste das Nächste an einem direkten Upgrade von Hydrogen.
Vorteile
- Bei xhigh erreicht es
52für$0,76pro Aufgabe in9,8Minuten. Hydrogen bei high erreicht51für$1,87in8,3Minuten. - Bei max erreicht es
55für$1,27, günstiger als Hydrogen bei xhigh (54,$3,16). - Fünf Aufwandsstufen, von
lowbismax, Sie können es also genauso abstimmen, wie Sie Hydrogens Denkstufe abstimmen würden.
Nachteile
- Tool-Calling erfordert die Responses API, eine Gemini-förmige Integration braucht also echte Überarbeitung.
- Keine kostenlose Stufe, und Prompts über 272K Input-Tokens kosten 2x Input und 1,5x Output für die gesamte Anfrage.
- Sein Wissensstand endet am 30. April 2026.
Preise: $2 Input, $0,10 gecacht, $10 Output pro 1 Mio. Tokens auf der OpenAI Preisseite. Batch und Flex kosten die Hälfte.
Mein Fazit: Wenn Sie Hydrogen gerade auf xhigh stellen wollten, probieren Sie zuerst Sol bei xhigh. Pro Aufgabe ist es der günstigere Weg zum gleichen Score. Der GPT-6.1 Sol Test hat einen praktischen Support-Ticket-Test.
2. GPT-6.1 Terra
Am besten für: schnelle, günstige Arbeit, bei der Hydrogen auf low oder medium schon gut genug ist.
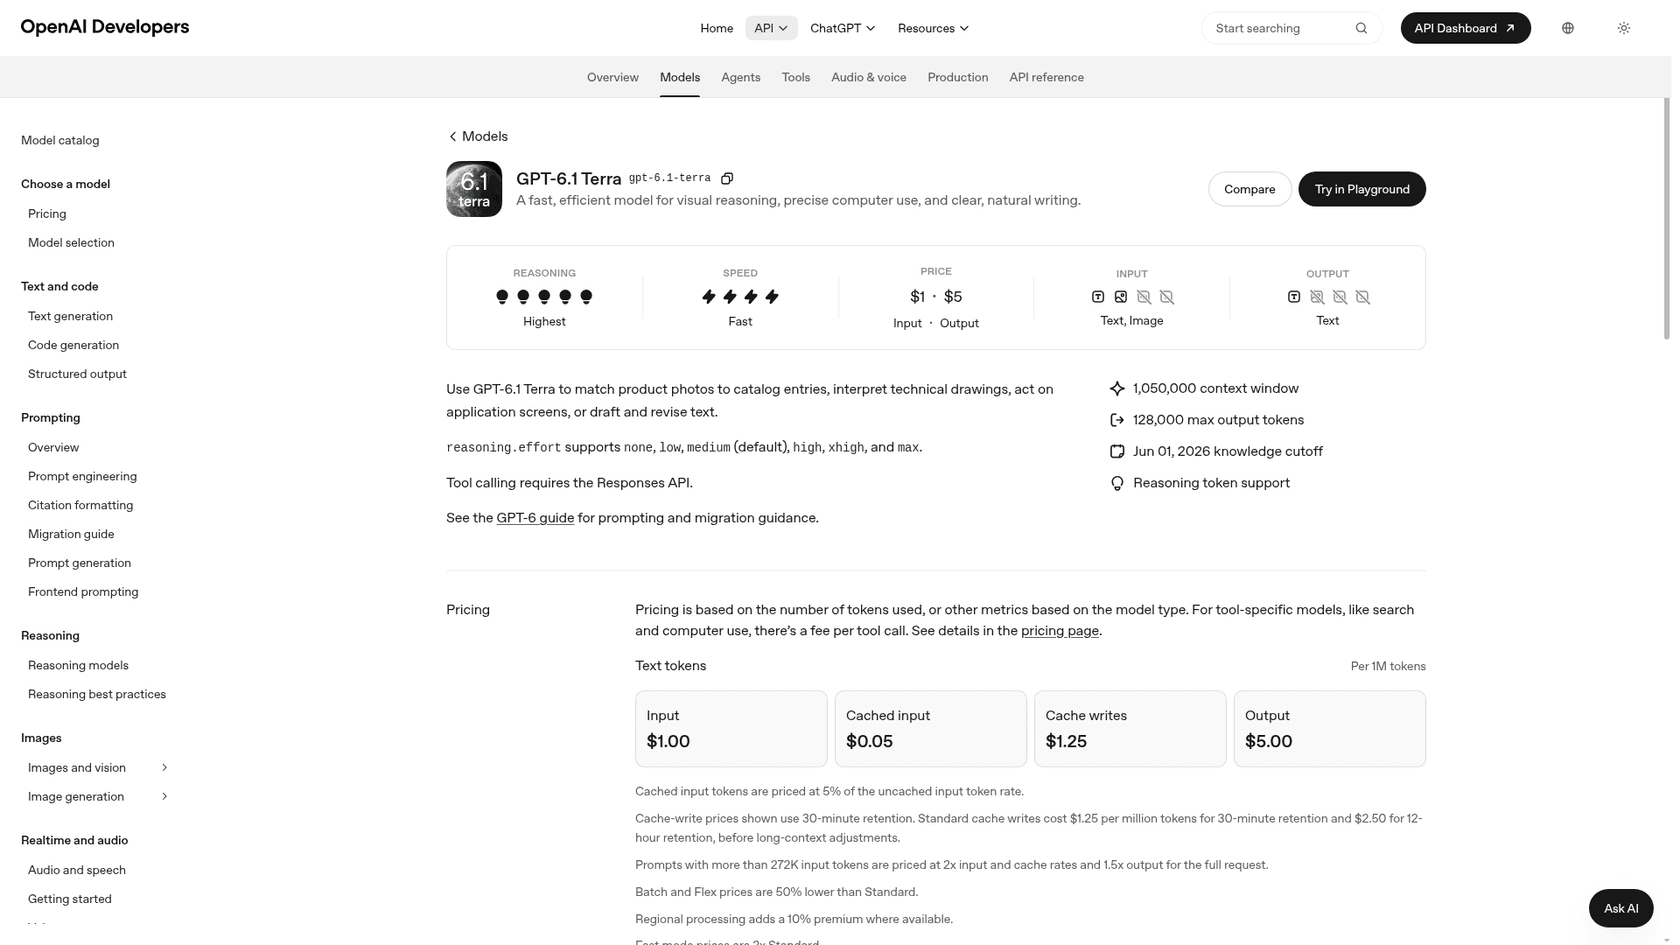
GPT-6.1 Terra ist eine Stufe unter Sol und Hydrogens direktester Rivale. Google hat es sogar in die eigene Vergleichstabelle aufgenommen, wo Hydrogen bei 8 von 9 gemeinsamen Zeilen gewinnt.
Vorteile
- Bei high erreicht es
42für$0,26pro Aufgabe in4,2Minuten. Hydrogen bei medium erreicht41für$0,80in3,7Minuten. Das ist etwa ein Drittel der Kosten für den gleichen Score. - Es hat eine
none-Aufwandsstufe für einen Fast-Path ohne Denken, den Hydrogen nicht bietet. - Der Listenpreis liegt bei Input und Output ein Drittel unter Hydrogens.
Nachteile
- Googles Tabelle sieht Hydrogen vorn bei SWE-sweep (
13,5%vs.5,8%) und AutomationBench (76,1%vs.60,2%). - Es auf max zu treiben (
51,$0,96,14,2Minuten) ist langsamer als Hydrogen bei high. - Gleiche Responses-API-Anforderung für Tool-Calls wie Sol.
Preise: $1 Input, $0,05 gecacht, $5 Output pro 1 Mio. Tokens, laut der OpenAI Preisseite.
Mein Fazit: der Tausch für hochvolumigen, mittelschweren Traffic. Für schwere Aufgaben steigen Sie auf Sol um, statt Terra zu maximieren. Der GPT-6.1 Terra Test zeigt, wie es bei echten Tickets abschnitt.
3. Claude Sonnet 5.5
Am besten für: Coding-Agenten, Terminal-Arbeit und Computer-Use.
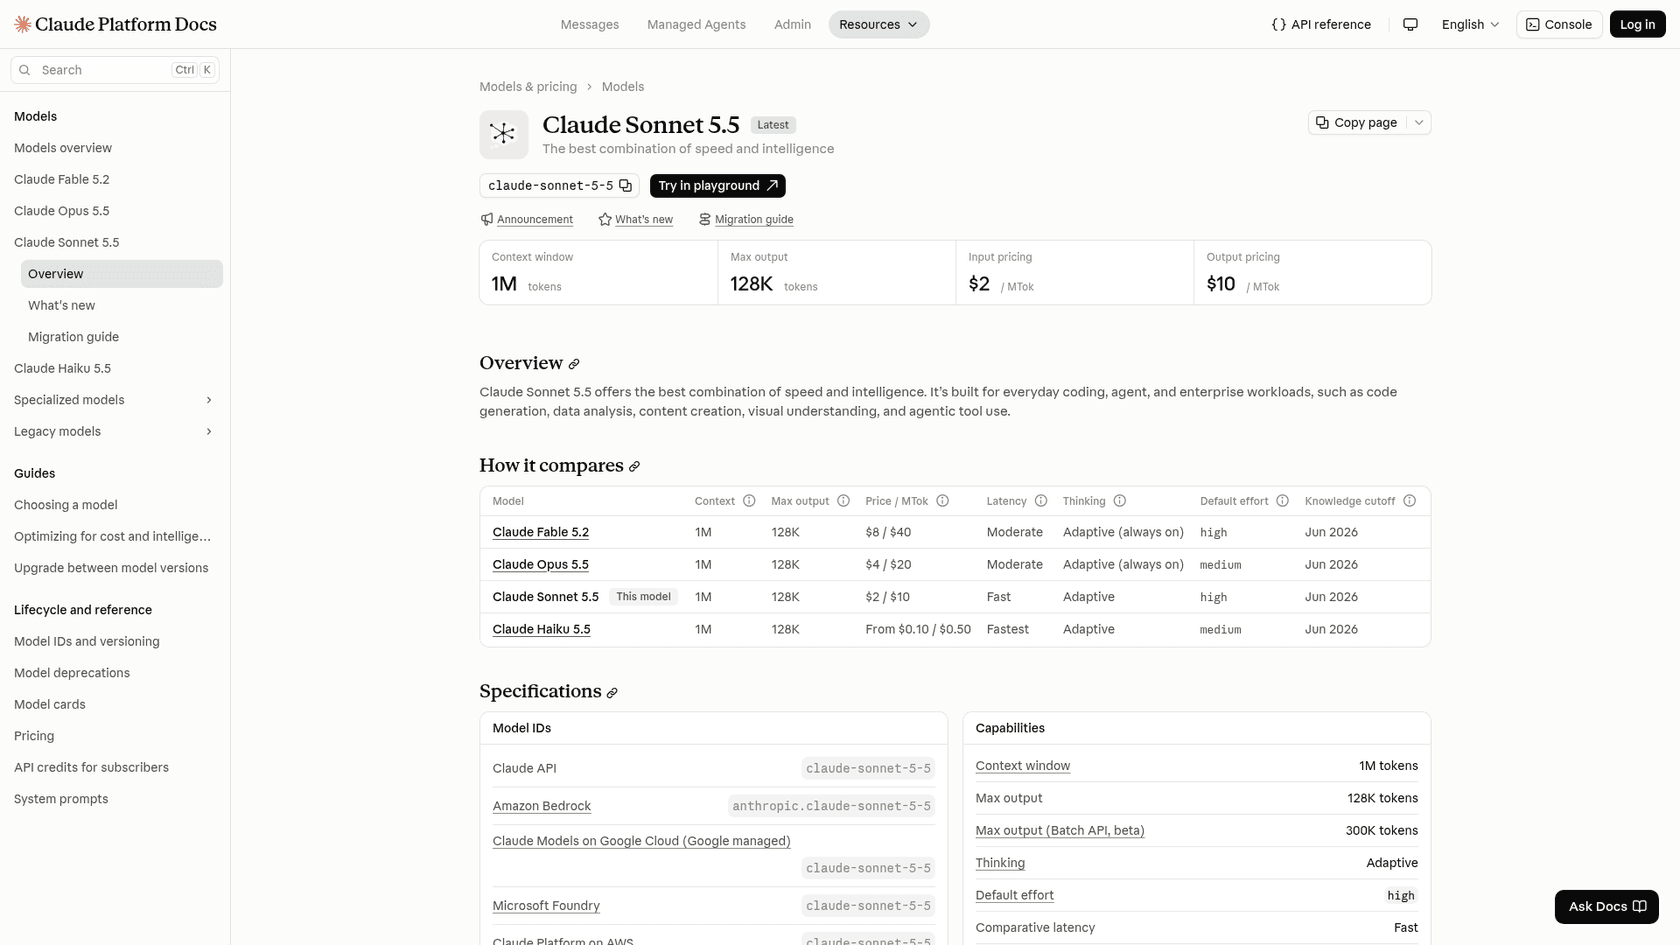
Claude Sonnet 5.5 ist Anthropics mittleres Modell, das Anthropic als "the best combination of speed and intelligence" bezeichnet. ChatGPT stufte es als Top-Hydrogen-Alternative ein, und Googles eigene Zahlen erklären, warum es im Gespräch ist.
Vorteile
- Es schlägt Hydrogen bei den beiden Agent-Zeilen, die für Coding-Tools am wichtigsten sind: Terminal-Bench 4.1 (
63,9%vs.57,0%) und OSWorld-2.1 (83,9%vs.77,6%), laut Googles Modellkarte. - Bei max erreicht es
55, über Hydrogens Bestwert (54bei xhigh). - Flache Preise über das gesamte 1M-Fenster, und Cache-Reads bei
$0,10.
Nachteile
- Bei max kostet es
$10,02pro Aufgabe und braucht33Minuten auf Artificial Analysis. Bei medium fällt es auf$0,78, aber der Score fällt auf31. - Hydrogen gewinnt Googles SWE-sweep (
13,5%vs.3,1%) und HLE-Diamond (58,8%vs.53,3%) Zeilen. - Strikte API: ein nicht-standardmäßiges
temperatureund erzwungenestool_choicegeben beide Fehler zurück, behandelt im Sonnet 5.5 Test.
Preise: $2 Input, $0,10 Cache-Read, $10 Output pro 1 Mio. Tokens auf Anthropics Preisseite. Batch halbiert es.
Mein Fazit: wählen Sie es, wenn der Agent Code schreibt oder einen Computer bedient. Für allgemeine Wissensarbeit ist Hydrogen der bessere Kauf, was zu dem passt, was der HN-Thread schlussfolgerte.
4. Claude Opus 5.5
Am besten für: lange laufende Agenten, bei denen es richtig zu machen wichtiger ist als die Rechnung.
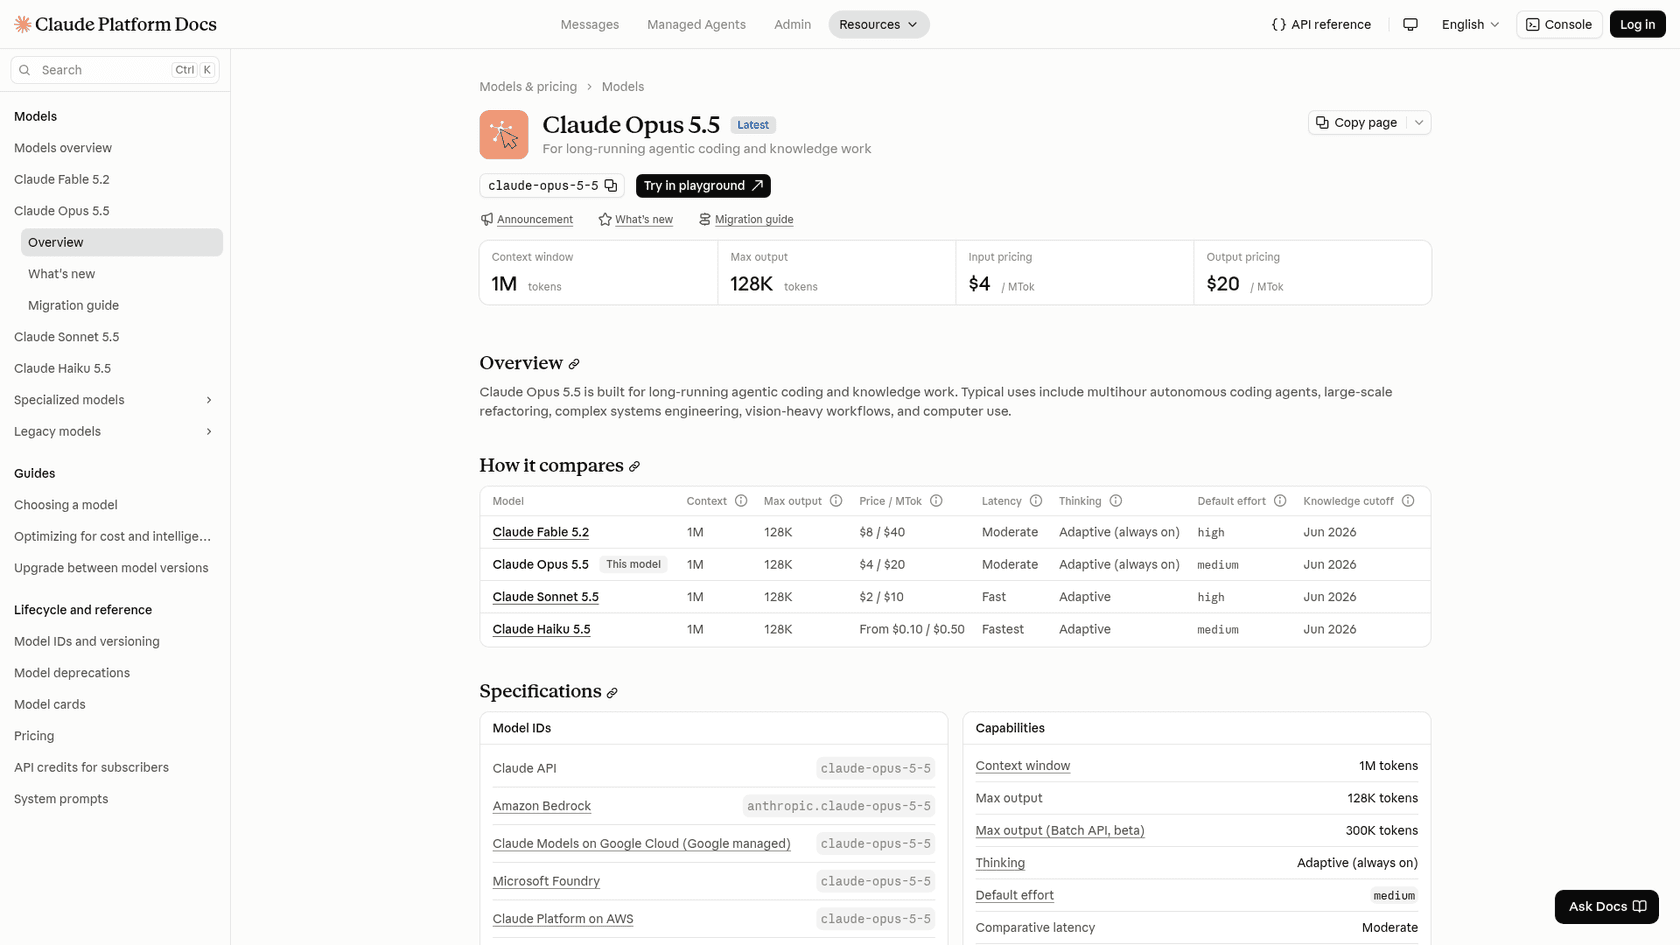
Claude Opus 5.5 ist Anthropics größeres Modell, gebaut "for long-running agentic coding and knowledge work". Es ist hier pro Token die teuerste Wahl, gehört also als Eskalationsziel auf diese Liste, nicht als Standard.
Vorteile
- Bei max erreicht es
59auf Artificial Analysis, den zweithöchsten Score in diesem Vergleich nach Carbon bei high. - Bei medium, seiner Standardstufe, erreicht es
48für$2,45in7,2Minuten. - Cache-Reads kosten
$0,20, nur 5% des Input-Preises, was Agenten hilft, die einen langen System-Prompt erneut senden.
Nachteile
$4/$20Listenpreis, die Beispielrechnung liegt also bei$14.000, fast das 3-Fache von Hydrogen.- Bei max,
$10,04pro Aufgabe und25,2Minuten. - Denken ist immer an, was Anthropic als "Adaptive (always on)" listet, und wird als Output abgerechnet.
Preise: $4 Input, $0,20 Cache-Read, $20 Output pro 1 Mio. Tokens auf Anthropics Preisseite. Fast-Modus ist $8/$40.
Mein Fazit: ein Planer, kein Arbeiter. Lassen Sie Opus planen oder prüfen, und etwas Günstigeres die Schritte erledigen. Der Opus 5.5 Test hat die Zahlen nach Aufwandsstufe.
5. Gemini 4 Carbon
Am besten für: Teams, die bei Google bleiben und mehr Reasoning brauchen, als Hydrogen bietet.
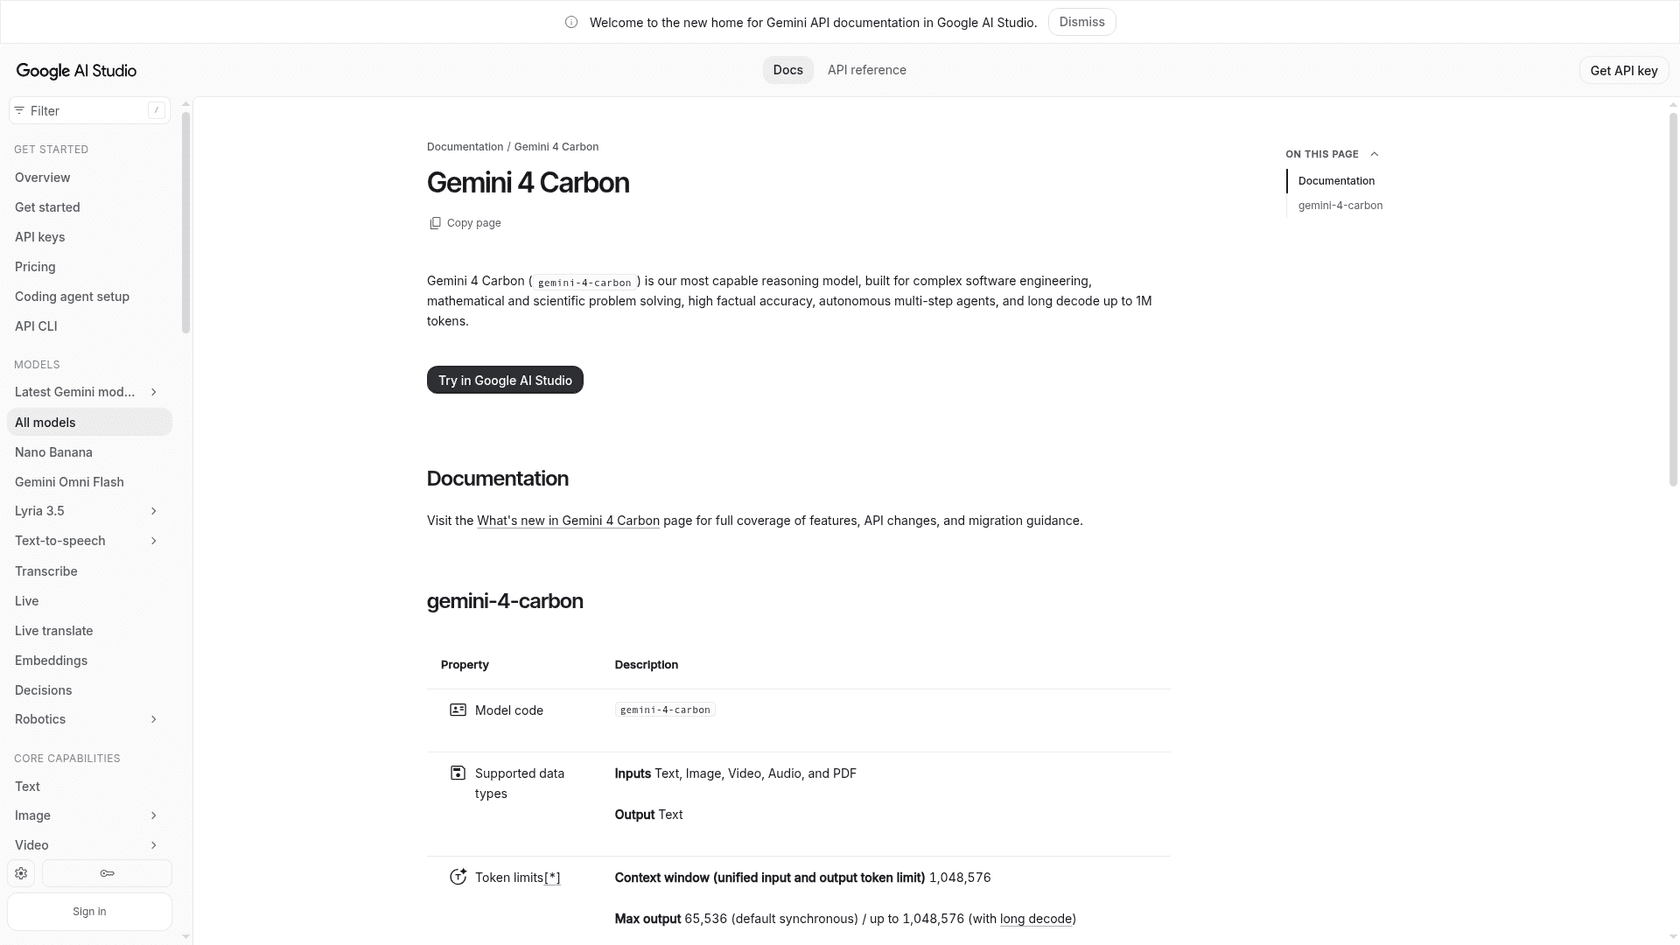
Gemini 4 Carbon ist Hydrogens größeres Geschwistermodell und erreichte am 10. November 2026 die allgemeine Verfügbarkeit. Gleiche API und gleiche Inputs, der geringste Aufwand für einen Wechsel auf dieser Liste.
Vorteile
- Bei medium erreicht es
58auf Artificial Analysis, und60bei high, der höchste Score in diesem Vergleich. - Sie behalten das Gemini SDK, das Search-Grounding und die multimodalen Inputs, die Sie bereits aufgebaut haben.
- Googles Orchestrator in Antigravity kombiniert Carbon fürs Planen mit Hydrogen für die Ausführung, was die vorgesehene Aufteilung zeigt.
Nachteile
$4,68pro Aufgabe bei medium,$5,48bei high, und23,8bis27,4Minuten pro Aufgabe.- Der Preis verdoppelt sich am 1. Dezember 2026 auf
$4/$20, und es gibt keine kostenlose Stufe. - Es ist standardmäßig auf medium und begrenzt auf high, es gibt also kein xhigh.
Preise: $2 Input, $0,10 gecacht, $10 Output pro 1 Mio. Tokens bis zum 30. November 2026, danach $4/$0,20/$20, laut der Gemini API Preisseite. Mehr im Gemini 4 Carbon Test.
Mein Fazit: leiten Sie Ihre schwersten 10% hierhin und behalten Sie Hydrogen für den Rest. Alles nach dem 1. Dezember an Carbon zu schicken, ist eine hohe Rechnung für ein paar Punkte Score.
6. DeepSeek V4.1 Flash
Am besten für: die niedrigste Rechnung, und Teams, die offene Gewichte wollen.
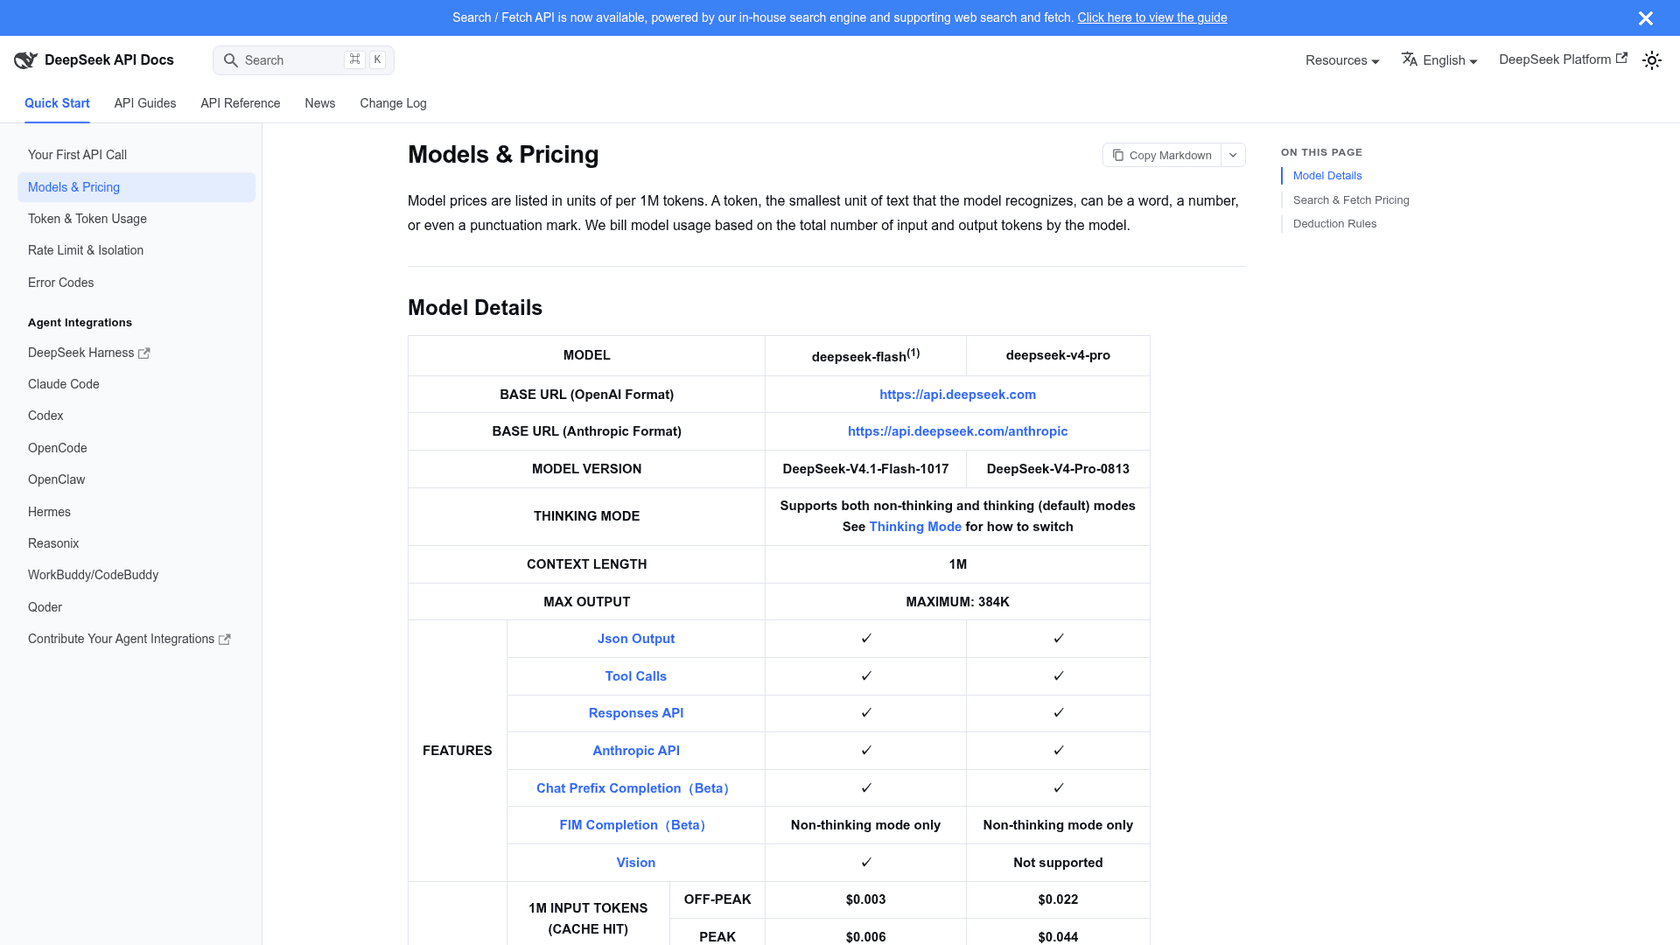
DeepSeek V4.1 Flash wird auf DeepSeeks API als deepseek-flash aufgerufen, und der alte Name deepseek-v4-flash leitet jetzt auch dorthin weiter. Es ist das einzige Modell hier, das weniger als ein Zehntel von Hydrogens Listenpreis kostet.
Vorteile
$0,15/$0,60pro 1 Mio. Tokens in der Nebenzeit, die Beispielrechnung liegt also bei$480gegenüber Hydrogens$5.250.- MIT-lizenzierte Gewichte, Sie oder ein Hosting-Anbieter können es also außerhalb Chinas betreiben.
- Vision-Input, Tool-Calls, JSON-Output, und sowohl OpenAI-Format- als auch Anthropic-Format-Endpunkte.
Nachteile
- Es erreicht
33bei max auf Artificial Analysis, deutlich unter Hydrogen bei medium (41). - Spitzenzeiten (
01:00bis04:00und06:00bis10:00UTC, werktags) verdoppeln den Preis. - Auf DeepSeeks eigener Plattform gehen Ihre Daten an ein Unternehmen mit Sitz in China, prüfen Sie das also zuerst gegen Ihre Datenregeln.
Preise: $0,15 Input, $0,003 Cache-Hit, $0,60 Output pro 1 Mio. Tokens in der Nebenzeit; $0,30/$0,006/$1,20 zur Spitzenzeit, laut DeepSeeks Preisseite.
Benchmarks erzählen hier nicht die ganze Geschichte. Ein Builder, der direkte Agent-Tests gemacht hat, postete das:
"Right now DeepSeek Flash 4.1 Flash has a 64% win rate against GPT 6.1 Sol. Small data still, but it has 33 wins vs. 18 losses"
Mein Fazit: einen Vergleichstest wert für jeden hochvolumigen Job, bevor Sie Hydrogen-Raten bezahlen. Der DeepSeek V4.1 Flash Preise Leitfaden behandelt die Spitzenzeit-Rechnung.
7. Kimi K3.1 Pro
Am besten für: Teams, die ein großes Open-Weight-Modell brauchen und auf Antworten warten können.
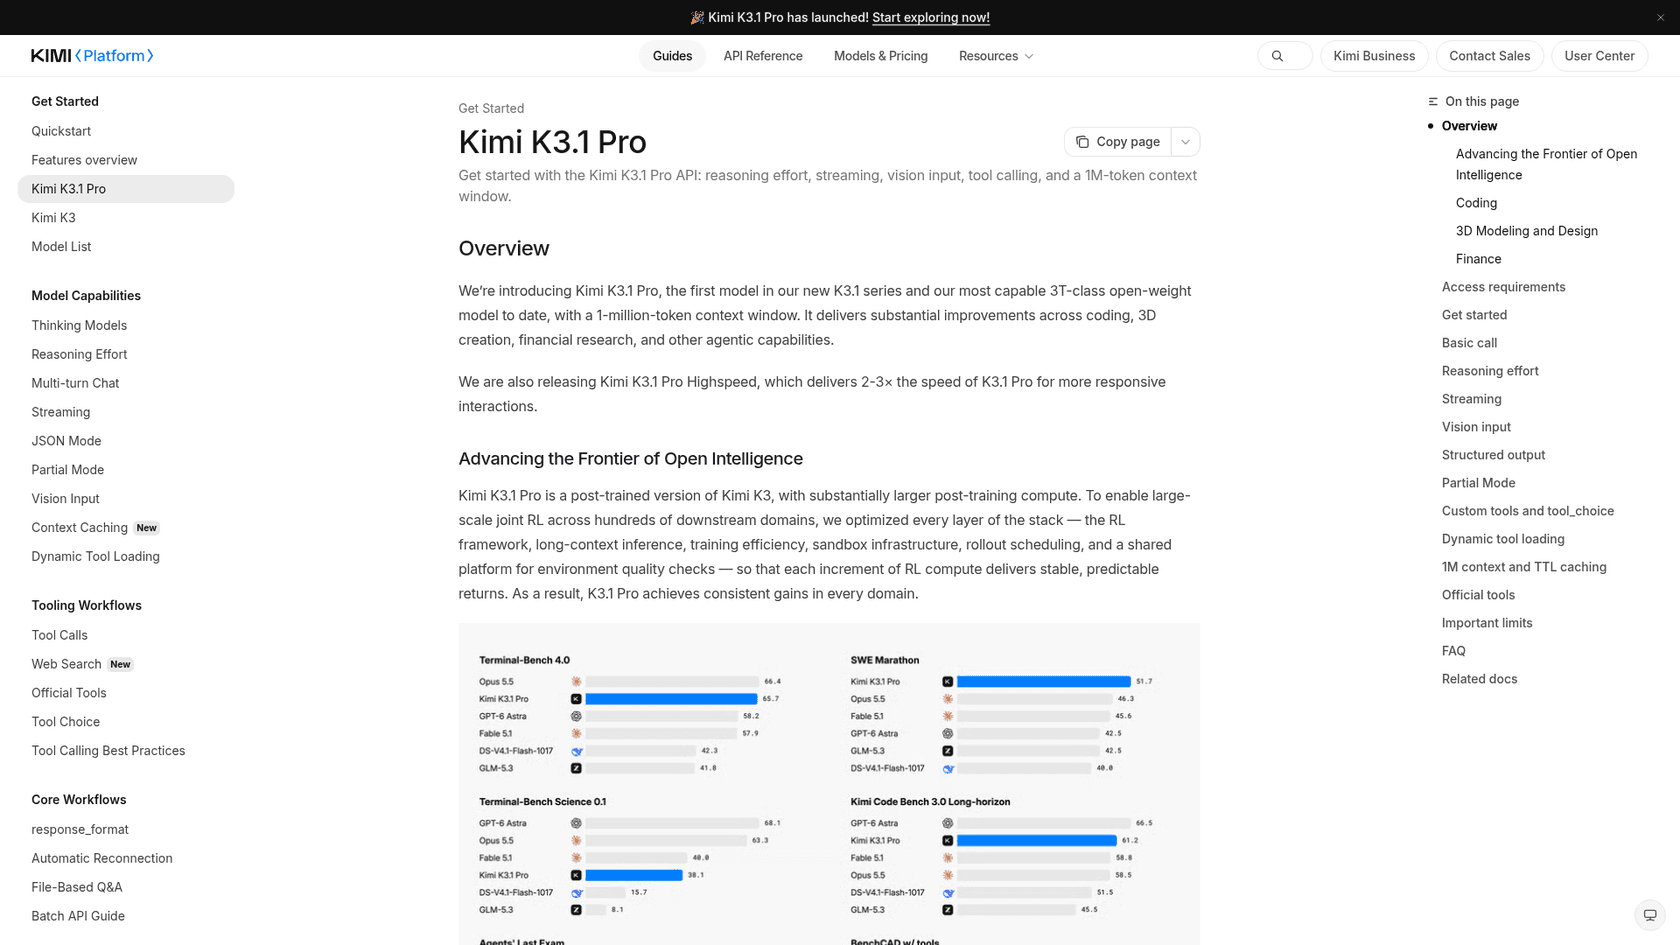
Kimi K3.1 Pro ist Moonshot AIs Flaggschiff, in seinen Docs beschrieben als "our most capable 3T-class open-weight model to date". Seine Gewichte sind jetzt auf Hugging Face.
Vorteile
- Artificial Analysis stuft es als Erstes von 28 Open-Weight-Modellen seiner Größenklasse ein, bei
46. - 1.048.576-Token-Kontext, Bild-Input, und Batch-Inferenz bei 60% des Standardpreises.
- Eine Highspeed-Version (
$4/$20) läuft laut Moonshot 2- bis 3-mal schneller.
Nachteile
$3,68pro Aufgabe und38,3Minuten auf Artificial Analysis, was es für ein Open-Weight-Modell als langsam und teuer markiert.- AA maß eine Zeit bis zum ersten Antwort-Token von
172Sekunden bei etwa31Tokens pro Sekunde. - Gleicher
$2/$10Listenpreis wie Sol, mit niedrigerem Score.
Preise: $2 Input, $0,20 Cache-Hit, $10 Output pro 1 Mio. Tokens auf Moonshots Preisseite.
Mein Fazit: eine Wahl, wenn offene Gewichte die Anforderung sind, keine Ersparnis gegenüber Hydrogen. Wenn Sie nur Günstig brauchen, gewinnt DeepSeek. Der Kimi K3.1 Pro Test geht tiefer.
8. GPT-6 Luna
Am besten für: Triage, Tagging und Routing beim niedrigstmöglichen Preis.
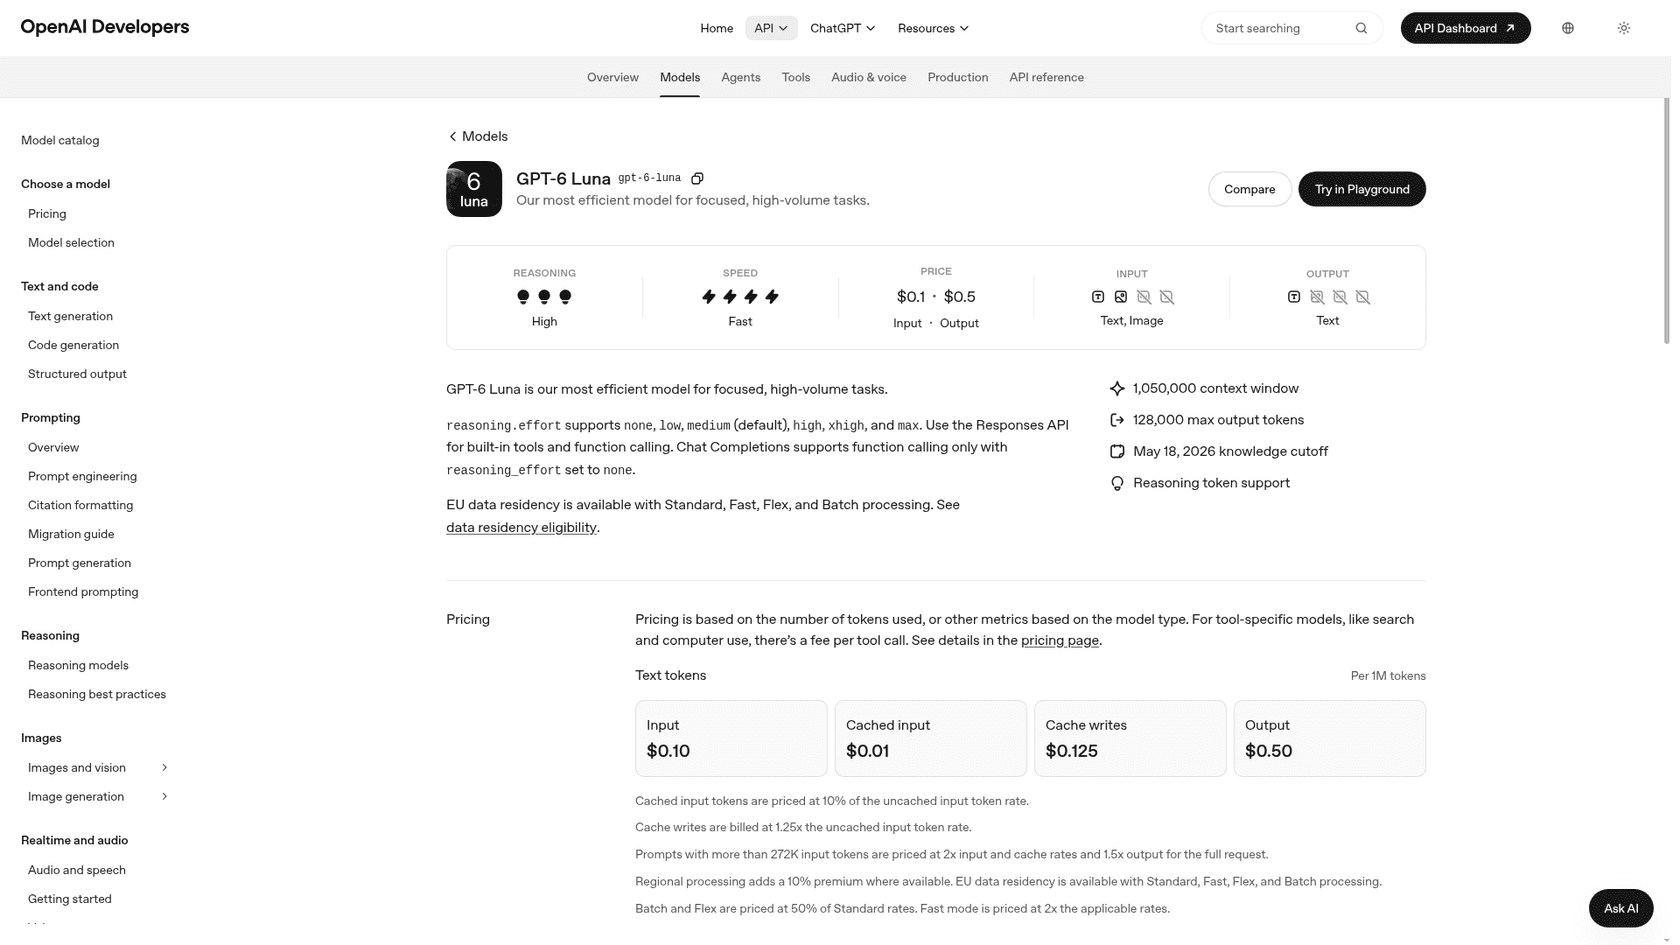
GPT-6 Luna ist OpenAIs kleinstes Modell, "our most efficient model for focused, high-volume tasks". Hier schauten Gemini 3.8 Flash Nutzer zuerst hin, als Hydrogen zum doppelten aktuellen Flash-Preis landete.
Vorteile
$0,10/$0,50pro 1 Mio. Tokens, die Beispielrechnung liegt also bei$350.$0,15pro Aufgabe bei max-Aufwand auf Artificial Analysis, am günstigsten auf dieser Liste.- Unterstützt Chat-Completions-Function-Calling, wenn der Aufwand auf
nonesteht, was das Portieren einfachen Routing-Codes leichter macht.
Nachteile
- Es erreicht
28bei max, weit unter Hydrogen selbst bei medium. - Gleicher Long-Prompt-Aufschlag wie die anderen OpenAI-Modelle über 272K Input-Tokens.
- Kein Modell für mehrstufige Agentenarbeit allein.
Preise: $0,10 Input, $0,01 gecacht, $0,50 Output pro 1 Mio. Tokens auf der OpenAI Preisseite.
Mein Fazit: die Eingangstür eines geroutet Setups, kein vollständiger Hydrogen-Ersatz. Lassen Sie es Anfragen sortieren und die schwierigen nach oben weiterreichen.
Welche Gemini 4 Hydrogen Alternative sollten Sie wählen?
Gehen Sie davon aus, warum Sie gehen, nicht von der Bestenliste. Jeder Grund zeigt auf ein anderes Modell:
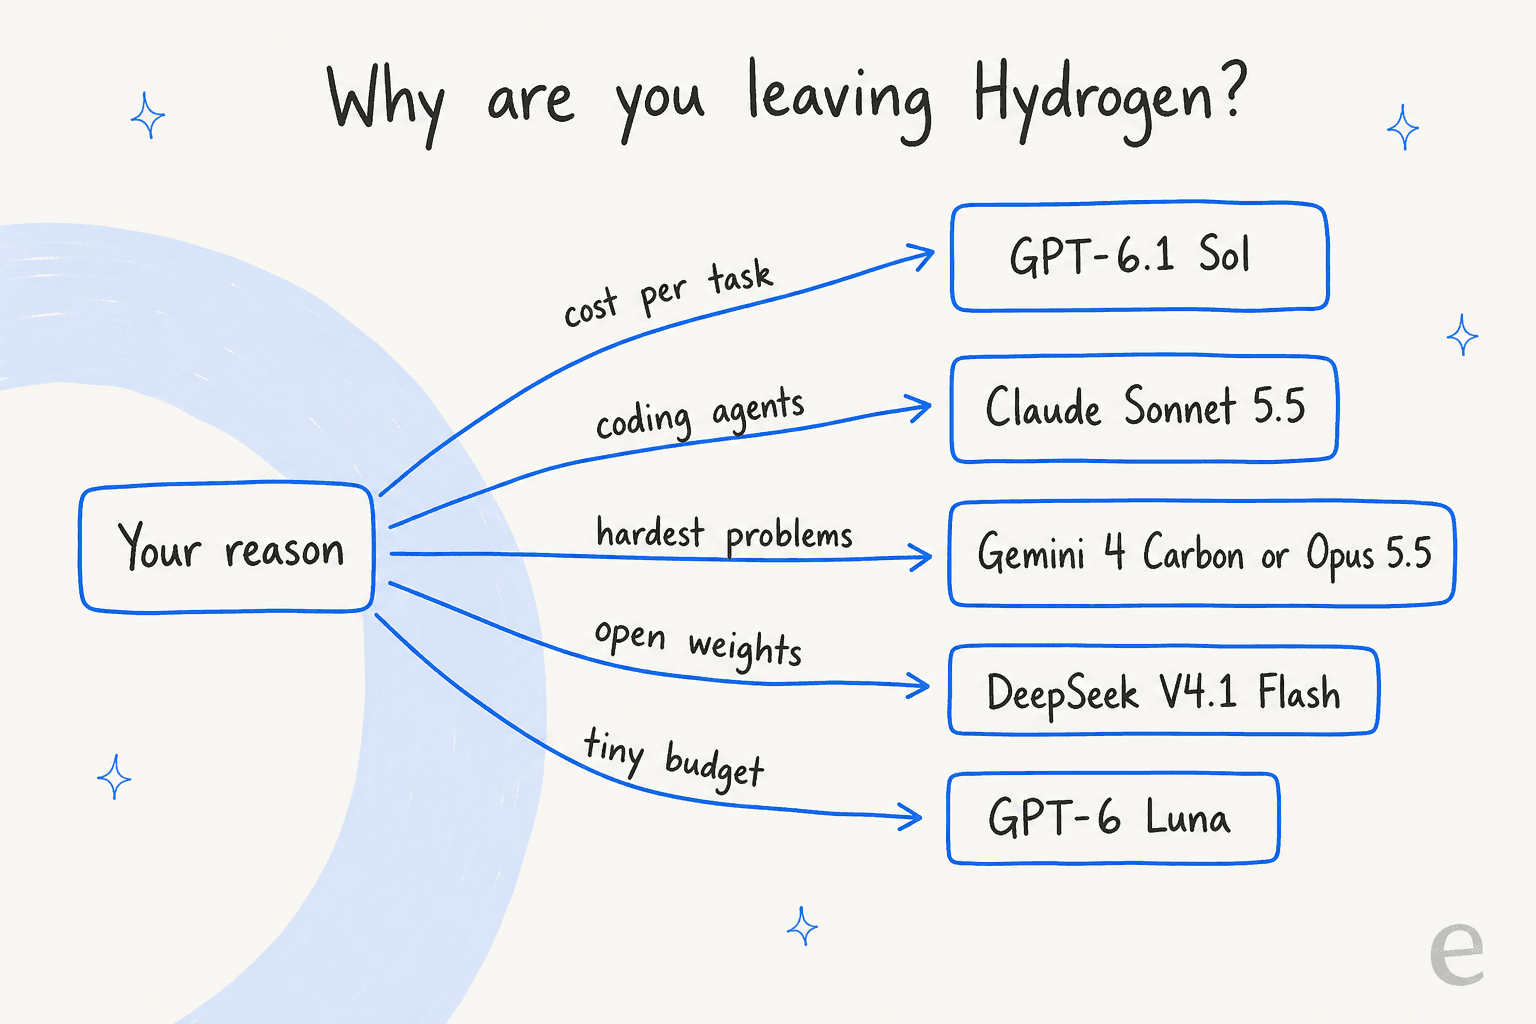
| Wenn Ihr Grund ist... | Wahl | Warum |
|---|---|---|
| Die Rechnung bei high oder xhigh | GPT-6.1 Sol | 52 für $0.76 vs. Hydrogens 51 für $1.87 |
| Schnelle, günstige Arbeit auf mittlerem Niveau | GPT-6.1 Terra | 42 für $0.26 vs. Hydrogen mediums 41 für $0.80 |
| Coding- oder Computer-Use-Agenten | Claude Sonnet 5.5 | Gewinnt Terminal-Bench 4.1 und OSWorld-2.1 in Googles eigener Tabelle |
| Schwerste Probleme, bei Google bleiben | Gemini 4 Carbon | 58 bei medium, gleiche API |
| Schwerste Probleme, egal welcher Anbieter | Claude Opus 5.5 | 59 bei max, niedriger Cache-Read-Preis |
| Niedrigste Rechnung | DeepSeek V4.1 Flash | $480 vs. $5,250 bei der Beispielrechnung |
| Offene Gewichte am oberen Ende | Kimi K3.1 Pro | Bestes Open-Weight-Modell seiner Klasse auf AA |
| Triage und Routing | GPT-6 Luna | $0.15 pro Aufgabe |
Sie müssen sich auch nicht auf eines festlegen. Ein Kommentator im Launch-Thread beschrieb das Setup, das ich für die meisten Agenten empfehlen würde:
"I have found it a good subagent workhorse for code implementation, with some higher level model doing the spec and review."
Das ist Hydrogen als Arbeiter und etwas wie Carbon oder Opus als Planer, dieselbe Aufteilung, die Google in Orchestrator eingebaut hat. Wenn die Rechnung das Problem ist, tauschen Sie den Arbeiter gegen Sol oder Terra aus und behalten die Struktur.
Wie testen Sie eine Alternative vor dem Wechsel?
Benchmarks ordnen Modelle nach den Aufgaben eines anderen. Bevor Sie Produktions-Traffic umziehen, führen Sie Ihre eigenen aus:
- Ziehen Sie 50 bis 100 echte Anfragen aus Ihren Logs, einschließlich der unangenehmen.
- Testen Sie jeden Kandidaten auf zwei Aufwandsstufen, weil die Stufe die Kosten mehr bewegt als das Modell.
- Messen Sie die Kosten pro erfolgreicher Aufgabe, Wiederholungen eingerechnet, nicht Kosten pro Million Tokens.
- Prüfen Sie die Migrationsfallen: Hydrogen ignoriert Sampling-Einstellungen, Claude lehnt nicht-standardmäßiges
temperatureab, und OpenAI will für Tool-Calls die Responses API. Ein auf eines abgestimmter Prompt überträgt sich nicht unverändert. - Halten Sie ein Fallback-Modell angeschlossen, damit die nächste Preisänderung oder der nächste Ausfall ein Konfigurationswechsel ist, kein Rewrite.
Googles eigener Rat für Hydrogen sagt dasselbe: führen Sie Ihre Evaluierungen "at all four levels" durch, bevor Sie sich festlegen.
Wenn das Modell für eine Support-Warteschlange ist
Viele Leute, die Hydrogen-Alternativen vergleichen, bauen eigentlich einen Support-Bot. Ich verbringe seit Jahren damit, KI-Agenten in Live-Helpdesks einzubinden, und das Modell ist selten das, was zuerst bricht; die Regeln darum sind es. Die Fehler, die ich sehe, sind ein Bot, der etwas verspricht, das er nicht kann, oder der nicht übergibt, wenn er sollte. Ein größeres Modell behebt das nicht. Klare Eskalationsregeln und Antworten, die in Ihrem eigenen Help Center und vergangenen Tickets verankert sind, tun das, und genau so halten Sie KI-Halluzinationen niedrig, egal welches Modell die Worte schreibt.
SE Ranking ist ein gutes Beispiel für diese Schicht. Es betreibt drei Produkte auf Zendesk mit einem eesel-Agenten pro Produkt, der aus etwa 16.800 Wissensseiten antwortet, und bearbeitete 4.650 Konversationen in einem Monat. Rückerstattungen, Testverlängerungen und Anfragen nach einer Person gehen mit bereits gesammelten Details ans Team. Swiftreg, ein Verkäufer privater Nummernschilder, beantwortet etwa 2.100 Zendesk-Tickets im Monat aus Live-Bestelldaten, nach Regeln, die das eigene Team geschrieben hat. Keines der beiden Setups hängt davon ab, welches Modell diese Woche am schnellsten ist.
Wenn Sie lieber von einem Terminal aus arbeiten: die eesel CLI steuert dasselbe Teammitglied wie das Dashboard. Ein Coding-Agent wie Claude Code kann genehmigtes Wissen hochladen, etwa exportierte Hilfeartikel und gespeicherte Antworten, die Anweisungen des Agenten anpassen und Testfragen stellen, um die Antworten zu prüfen, bevor etwas live geht. Das Verbinden des Helpdesks selbst braucht weiterhin jemanden mit Admin-Zugang, der es genehmigt, und hochgeladenes Wissen ist nicht dasselbe wie getestetes, der Testschritt bleibt also.
eesel testen
Hydrogen, Sol und Sonnet sind Motoren. Wenn Sie Support-Automatisierung bauen, ist eesel das KI-Helpdesk-Teammitglied, das die Arbeit auf Modellen wie diesen erledigt. Es klinkt sich in den Helpdesk ein, den Sie bereits nutzen, sei es Zendesk, Freshdesk oder ein anderer, lernt aus Ihren vergangenen Tickets, Makros und dem Help Center, und folgt den Übergaberegeln, die Sie festlegen. Bevor es jemandem antwortet, können Sie es gegen Ihre echten vergangenen Tickets laufen lassen und seine Antworten mit dem vergleichen, was Ihr Team gesendet hat.
Die Preise sind ein fester monatlicher Credit-Tarif: ein Ticket oder Chat ist ein Credit, ab $299 im Monat für 500 Credits. Es gibt keine Pro-Token-Gebühr, Ihre Rechnung bewegt sich also nicht, wenn Google oder OpenAI ihre ändern. Sie können eesel testen kostenlos mit 100 Credits für 7 Tage an einem Teil Ihrer Warteschlange.