

Gemini 4 Neon kostet $3.00 pro 1M Input-Tokens und $15.00 pro 1M Output-Tokens, ohne Gratis-Tarif, und Thinking-Tokens werden als Output abgerechnet. Der Listenpreis verschleiert die echte Rechnung: Auf Artificial Analysis kostet eine Aufgabe $0.75 bei low, $1.90 bei medium, $3.74 beim Standard high und $6.44 bei xhigh. Batch und Flex halbieren den Satz, Priority schlägt 80% auf, und ein Cache-Treffer senkt den Input auf $0.15. Carbons Einführungspreis von $2/$10 endet am 30. November, das Argument für Neon statt Carbon beginnt also am 1. Dezember.
Der eesel CLI lässt einen Coding-Agenten freigegebene Hilfeartikel zu einem eesel Helpdesk-Teammate hochladen und seine Antworten an vergangenen Tickets testen, so würde ich die Kosten und das Verhalten jedes Modells prüfen, bevor es einem Kunden antwortet.
Wie ich Gemini 4 Neon bepreist habe
Alles mit einem Dollarzeichen stammt von Googles Preisseite, die ich am 19. November 2026 gelesen habe, einen Tag nach dem Launch, einschließlich der Batch-, Flex- und Priority-Tabs. Die Caching-Regeln stammen aus Googles Caching-Dokumentation, die Stufen-Definitionen aus der Flex-Inferenz-Seite. Die Kosten pro Aufgabe stammen von Artificial Analysis, wo eine "Aufgabe" eine Benchmark-Aufgabe aus ihrem Index ist, keines deiner Tickets oder Pull Requests.
Ich habe Neon nicht an meiner eigenen Workload laufen lassen. Die Monatsbeispiele unten nutzen Token-Zahlen, die ich gewählt und als Annahmen gekennzeichnet habe, setze also deine eigenen in den Rechner ein. Der erste Neon-Erklärartikel ist hier, und die Launch-Day-Review deckt die Qualitätsseite ab. Dieser Beitrag geht nur um das Geld.
Was kostet Gemini 4 Neon pro Million Tokens?
Neon wird pro Million Tokens auf vier Service-Stufen abgerechnet. Googles Seite nennt einen Preis für das gesamte 1,048,576-Token-Kontextfenster, ohne höheren Satz für lange Prompts.
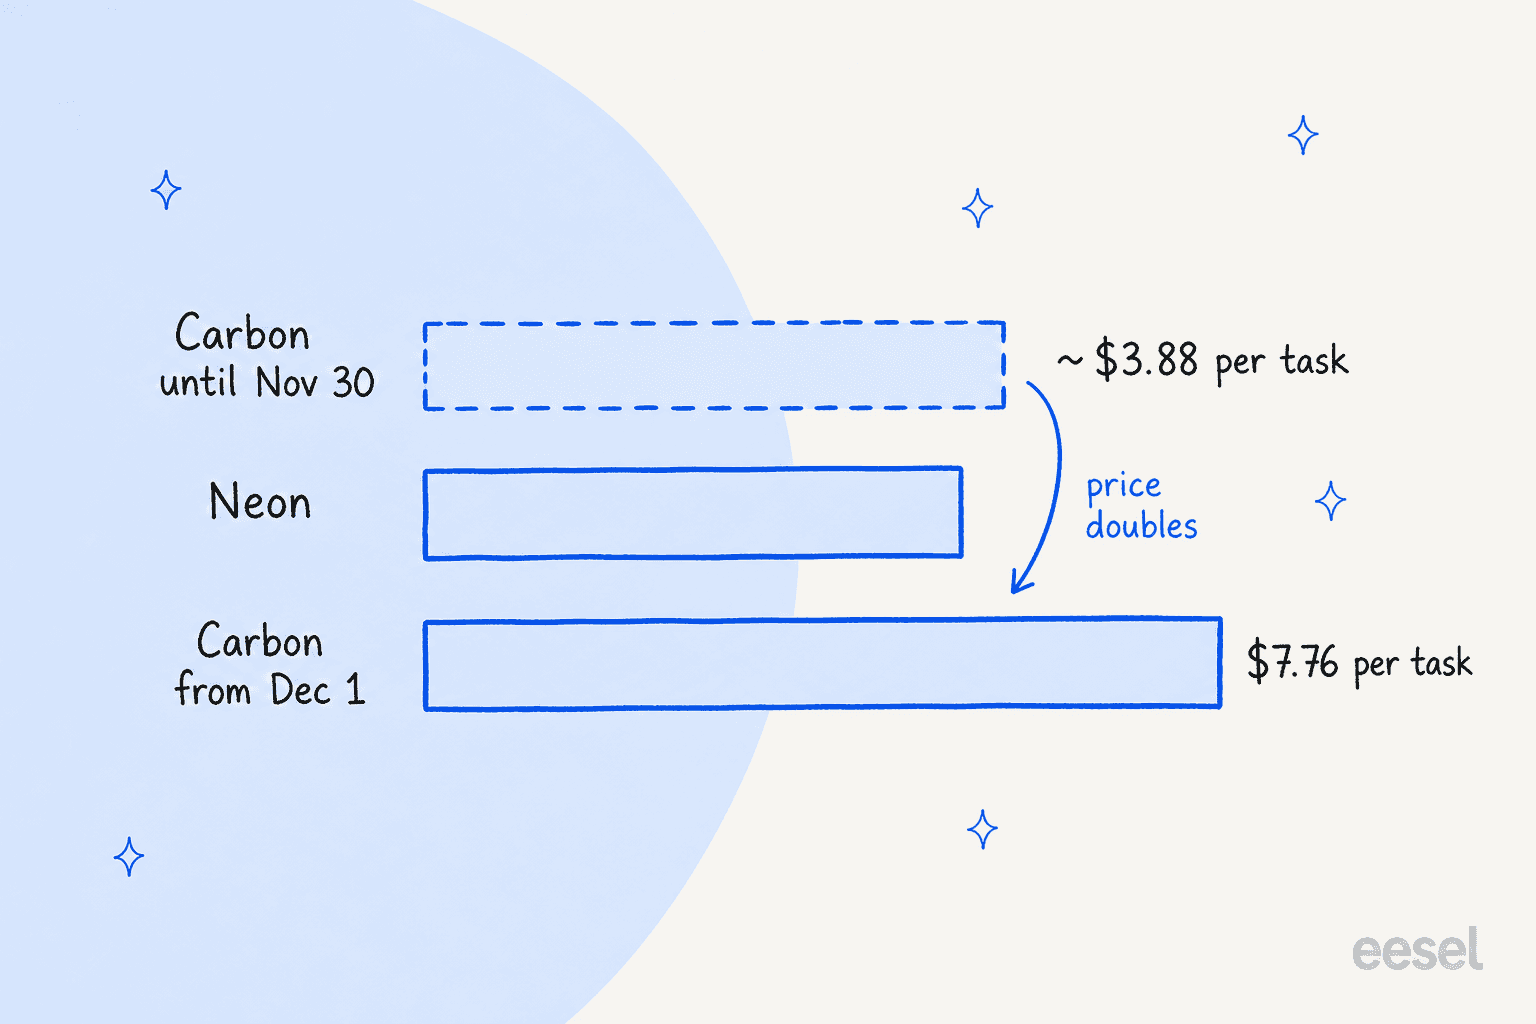
| Stufe | Input | Output (inkl. Thinking) | Gecachter Input | Geschwindigkeit und Zuverlässigkeit |
|---|---|---|---|---|
| Batch | $1.50 | $7.50 | $0.075 | Asynchron, bis zu 24 Stunden |
| Flex (Preview) | $1.50 | $7.50 | $0.075 | Synchron, Ziel 1 bis 15 Minuten, Best Effort |
| Standard | $3.00 | $15.00 | $0.15 | Sekunden bis Minuten |
| Priority | $5.40 | $27.00 | $0.27 | Sekunden, nicht drosselbar |
Drei Details, die ich nicht überspringen würde:
- Kein Gratis-Tarif. Die Free-Spalte zeigt "Not available", und Google gibt an, dass jeder Token gezählt und abgerechnet wird. Gemini 4 Hydrogen hat einen, das ist also der günstigere Ort zum Prototypen.
- Priority ist am teuersten. Google beschreibt sie als 75 bis 100% teurer als Standard. Bei Neon zeigt die Seite
$5.40und$27.00, was80%mehr ist. - Flex ist ein Schnäppchen mit Haken. Es kostet dasselbe
$1.50/$7.50wie Batch, ist aber eine Preview-Funktion mit Best-Effort-Verfügbarkeit. Google nennt als Zielgruppe für die Ersparnis "non-production evals, background agents, and data enrichment", und ich würde darauf keine kundenseitige Antwort stützen.
Du erreichst Neon über die bezahlte Gemini API oder, laut Googles What's-new-Seite, über Google AI Pro und Ultra Pläne in AI Studio. Abo-Zugang wie Google AI Ultra ist eine andere Rechnung als die API, daher lasse ich ihn hier aus der Rechnung heraus.
Was kostet Gemini 4 Neon wirklich pro Aufgabe?
Preise pro Token sagen dir den Satz, nicht die Rechnung, denn ein Modell, das länger denkt, schreibt mehr Output-Tokens. Hier sind Artificial Analysis' Daten pro Einstellung für Neon:
| Thinking-Level | Index-Score | Kosten pro Aufgabe | Minuten pro Aufgabe | Output-Tokens pro Aufgabe |
|---|---|---|---|---|
| low | 44.1 | $0.75 | 3.7 | 21,726 |
| medium | 54.9 | $1.90 | 8.3 | 50,000 |
| high (Standard) | 59.6 | $3.74 | 14.8 | 90,188 |
| xhigh | 61.4 | $6.44 | 21.5 | 141,631 |
Die Punktzahl pro Dollar fällt schnell. Von medium zu high zahlst du $1.84 mehr für 4.7 Index-Punkte. Von high zu xhigh zahlst du $2.70 mehr für 1.8 Punkte und wartest 6.7 Minuten länger. Googles eigene Empfehlung ist, deine Evaluierungen auf allen vier Leveln laufen zu lassen und "pick the lowest thinking_level that meets your quality bar", was der richtige Weg ist, diese Tabelle zu lesen.
Hier ist der Teil, den ich am nützlichsten fand. Multipliziere die Output-Tokens mit $15, und high kommt auf etwa $1.35 der $3.74, rund 36%. Die übrigen $2.39 sind Input, der Kontext, den ein Agent bei jedem Turn erneut liest. Ich nehme an, dass Artificial Analysis zum Listenpreis abrechnet, behandle die Aufteilung also als grobe Richtschnur. Aber sie zeigt für jedes Level in dieselbe Richtung: Bei Agenten-Arbeit ist die Input-Seite die größere Rechnung, und die Cache-Rate zählt mehr als der Output-Preis.
Ist Gemini 4 Neon günstiger als Carbon?
Ab dem 1. Dezember ja, um etwa die Hälfte. Bis dahin ist es fast ein Gleichstand.
Gemini 4 Carbon und Argon tragen auf Googles Seite einen Einführungspreis: $2.00 Input und $10.00 Output "through November 30, 2026", danach $4.00 und $20.00 ab dem 1. Dezember. Neons Zeile hat kein Enddatum und keine Stufe.
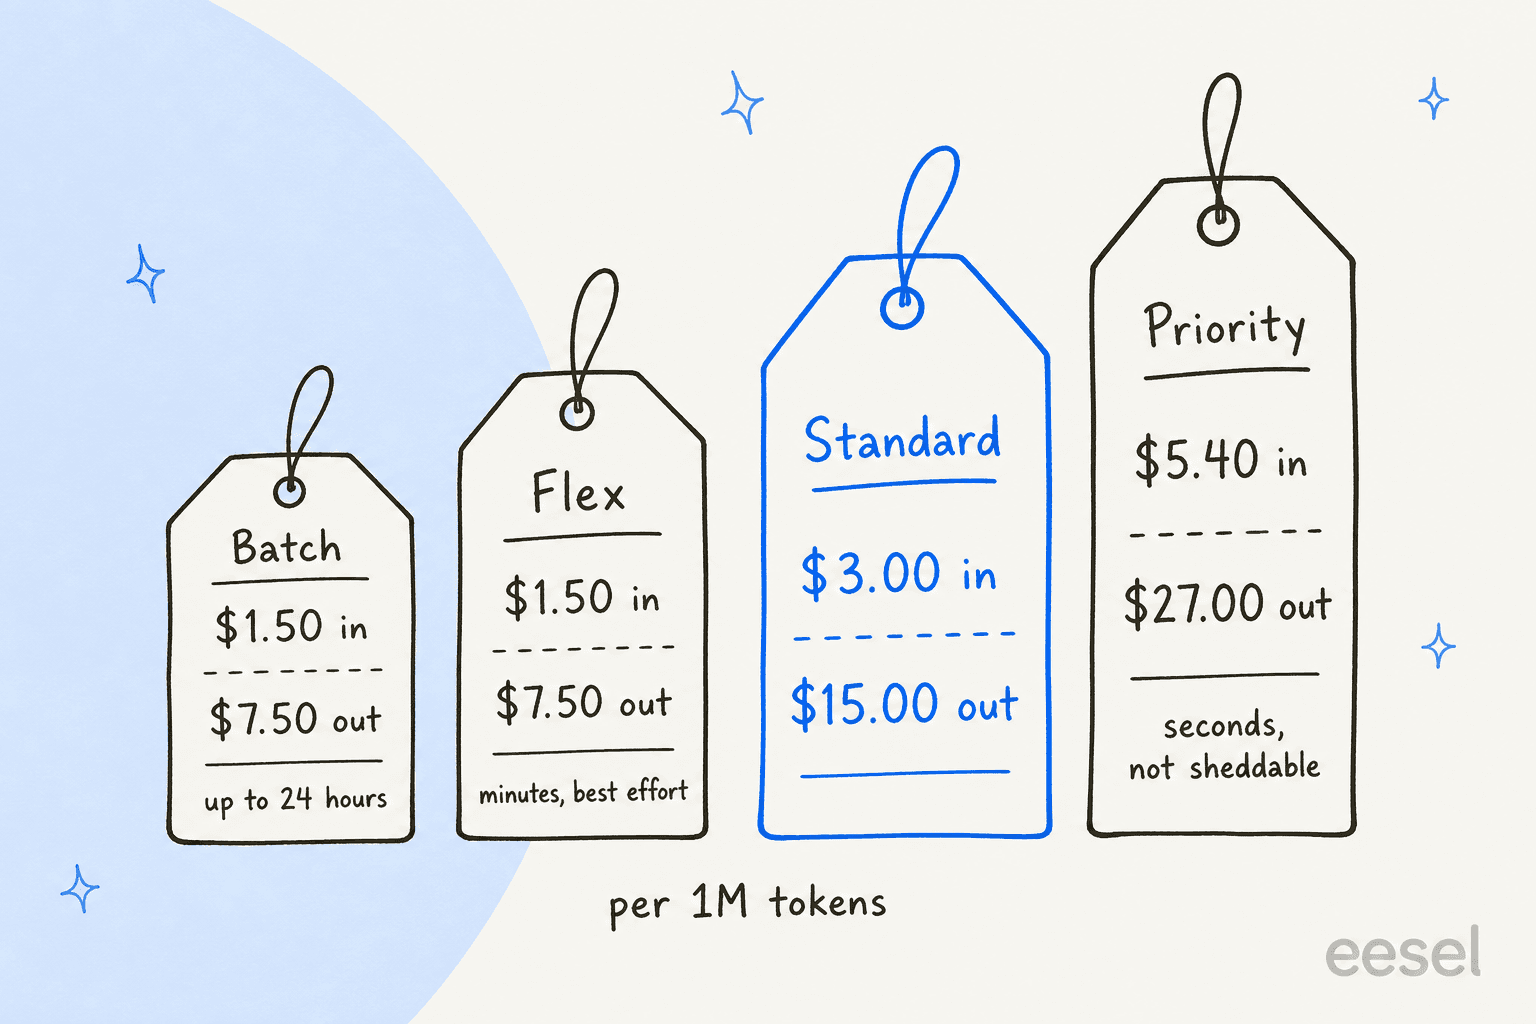
Die Artificial-Analysis-Kosten für Carbon, $7.76 pro Aufgabe, sind zum Dezemberpreis berechnet. Carbons Seite sagt, Carbon "costs $4.00 per 1M input tokens and $20.00 per 1M output tokens". Beide Sätze verdoppeln sich am 1. Dezember, dieselbe Arbeit kostet also bis dahin halb so viel. Nach meiner Rechnung sind das etwa $3.88 pro Aufgabe bis zum 30. November, gegen Neons $3.74.
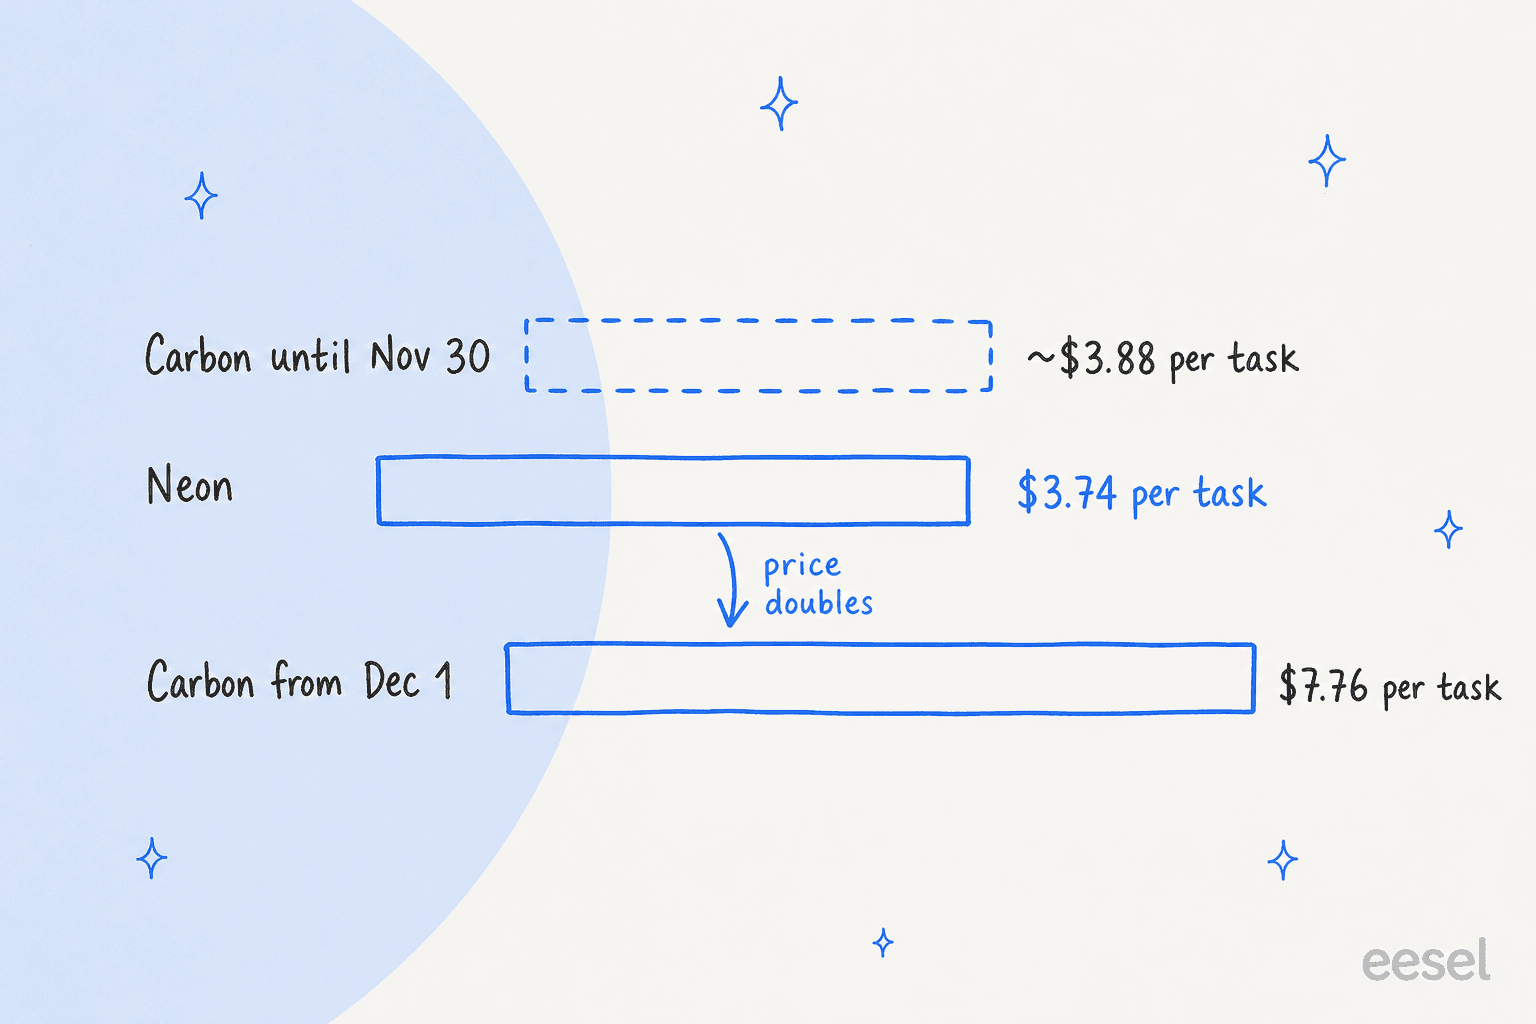
Die $3.88 sind meine Schätzung, keine Zahl von einem der beiden Unternehmen. Sie geht davon aus, dass Carbon vor und nach der Preisänderung dieselbe Menge Tokens pro Aufgabe schreibt, was sie sollte, weil das Modell unverändert ist. Googles eigene Launch-Behauptung sind 32% geringere Kosten pro Aufgabe als Carbon, und der Dezember-Listenpreis macht die Lücke noch größer als das.
Was ich tun würde: Wenn du Carbon jetzt testest, budgetiere zum Dezemberpreis, nicht zur Aktion. Ein Hacker-News-Leser erkannte die unbequeme Positionierung am Launch-Tag:
"So it's better and cheaper than the recently released Carbon? So Carbon is already deprecated, or?"

Es ist nicht deprecated. Es ist so bepreist, dass es bis zum Monatsende eine Aktion bleibt, und Neon ist das Modell mit dem stabilen Preis. Meine Carbon-Review zeigt, wo Carbon noch gewinnt, und der Argon-Preise-Beitrag zeigt, dass es Carbons Preisstufen teilt.
Wie schneidet Neon im Vergleich zu Astra, Sol und Opus bei den Kosten ab?
Preislich nicht gut. Pro Aufgabe ist Neon teurer als OpenAIs Modelle und günstiger als Anthropics Top-Einstellung, deren Sätze im Leitfaden zu Anthropic API Preise stehen. Hier sind dieselben Artificial-Analysis-Daten, jeweils in der bestbewerteten oder Standard-Einstellung des Modells:
| Modell und Einstellung | Index-Score | Kosten pro Aufgabe |
|---|---|---|
| GPT-6.2 Sol max | 57.3 | $1.01 |
| GPT-6.2 Astra high | 60.1 | $2.07 |
| Gemini 4 Neon high | 59.6 | $3.74 |
| Gemini 4 Hydrogen xhigh | 53.9 | $3.16 |
| Gemini 4 Carbon high (Dezemberpreis) | 60.0 | $7.76 |
| Claude Opus 5.5 max | 59.1 | $10.04 |
Astras Preis pro Token ist höher als der von Neon, trotzdem ist es pro Aufgabe günstiger, weil es etwa 17,800 Tokens schreibt, wo Neon etwa 90,200 schreibt. Eine günstigere Preistabelle heißt nicht gleich ein günstigeres Modell, und ein Hacker-News-Leser brachte die Käufer-Sicht unverblümt auf den Punkt:
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
Preislich allein stimme ich zu. Neons Stärke ist seine niedrige Halluzinations-Rate, die ich in der Review behandelt habe. Wenn deine Frage der Preis ist, sind die GPT-6.2 Sol Review, meine breitere Übersicht zu Gemini-Alternativen und der Vergleich OpenAI gegen Gemini API die besseren Startpunkte.
Wie viel spart Caching bei Neon?
Ein Cache-Treffer wird mit $0.15 pro Million Tokens abgerechnet statt $3.00, also 95% weniger auf diesen Tokens. Der Haken: Du kannst es nicht ein- oder ausschalten oder steuern. Googles Dokumentation sagt, explizites Caching werde für Gemini-4-Modelle nicht unterstützt, und implizites Caching "is enabled by default". Drei Regeln entscheiden, ob du den Rabatt bekommst:
- Das Minimum sind 4,096 Tokens. Kürzere Prompts treffen den Cache nie.
- Die Reihenfolge zählt. Google sagt, du sollst "large and common contents at the beginning of your prompt" setzen und ähnliche Präfixe zeitlich nahe beieinander senden.
- Agenten-Loops haben eine Untergrenze. Bei Multi-Turn-Nutzung cacht Gemini die gesamte vorherige Anfrage nur, wenn die neue Anfrage mindestens 2,050 Tokens hinzufügt. Bei kleineren Ergänzungen "re-processes the last 2,050 tokens of the previous request at the standard input rate". Die meisten Agenten-Turns reißen diese Latte, ein geschwätziger Bot mit kurzen Antworten aber vielleicht nicht.
Hier ist, was das bei einem langen Dokument wert ist. Angenommen, du lädst ein 500,000-Token-Vertragsbündel und stellst 100 Fragen, jede mit 2,000 Tokens beantwortet. Das sind meine Annahmen, zu Standard-Sätzen bepreist:
| Szenario | Input-Kosten | Output-Kosten | Summe für 100 Fragen |
|---|---|---|---|
| Jede Frage ungecacht | $150.00 | $3.00 | $153.00 |
| Erste ungecacht, 99 Cache-Treffer | $1.50 + $7.43 | $3.00 | $11.93 |
Das ist eine Ersparnis von 92%, aber nur, wenn jede Folgefrage den Cache trifft, was implizites Caching nicht garantiert. Lies usage.total_cached_tokens bei deinen ersten Läufen, um zu sehen, was du wirklich bekommst, bevor du darauf planst.
Was kostet ein realistischer Monat?
Das hängt von drei Zahlen ab, die du selbst kontrollierst: Tokens rein, Tokens raus und Cache-Anteil. Ich habe einen Rechner gebaut, in den du deine eigenen einsetzen kannst. Er bepreist dieselbe Workload auf Neon, Hydrogen und beiden Carbon-Preisen.
Die Standardwerte sind meine beispielhafte Support-Ticket-Workload: 5,000 Anfragen im Monat, 6,000 Input-Tokens je mit einem 75%-gecachten Präfix, und 1,500 Output-Tokens inklusive Thinking. Bei Standard sind das etwa $0.028 pro Anfrage und $138 im Monat auf Neon. Dasselbe Ticket kostet etwa $0.014 auf Hydrogen und, ab Dezember, etwa $0.037 auf Carbon.
Drei weitere Workloads, nach derselben Methode:
| Workload (meine Annahmen) | Neon, Standard | Dasselbe auf Batch oder Flex |
|---|---|---|
| 5,000 Support-Antworten, 6,000 ein (75% gecacht), 1,500 aus | $138 | $69 |
| 5,000 Support-Antworten, keine Cache-Treffer | $202 | $101 |
200 Agenten-Aufgaben bei high, zu Artificial Analysis' $3.74 | $748 | $374 (meine Halbierung) |
Die Zeile ohne Cache ist die, auf die man schauen sollte. Es ist dieselbe Logik wie bei den Kosten pro Ticket, wo die Einheit, durch die du teilst, mehr zählt als der Schlagzeilen-Satz. Den Cache zu verlieren fügt der Support-Rechnung 46% hinzu, und es passiert leise, wenn dein Prompt unter 4,096 Tokens liegt oder sich dein System-Prompt bei jeder Anfrage ändert.
Was taucht sonst noch auf einer Neon-Rechnung auf?
Vier Dinge liegen außerhalb des Token-Satzes.
- Search Grounding. Google gibt 5,000 kostenlose Suchanfragen im Monat, geteilt über alle Gemini-3-Modelle und neuer, danach berechnet es
$14pro 1,000 Anfragen, mit einer Tagesobergrenze von 1,500 Anfragen. Google gibt auch an, dass ein Prompt mehrere Suchen auslösen kann, und jede wird abgerechnet. Dasselbe gilt für Maps Grounding. - Tool-Overhead. Google sagt, jeder Token, den das Modell verarbeitet, wird abgerechnet, "including thinking tokens and internal tool system instructions and function declarations when using grounding". Lange Tool-Listen sind ebenfalls Input-Tokens.
- Output, den du nicht gelesen hast. Thinking-Tokens werden abgerechnet, selbst wenn du nur eine kurze Antwort siehst. Setze
max_output_tokenshoch genug, dass das Limit einen Reasoning-Lauf nicht abschneidet, aber behalte die Usage-Felder im Blick. - Langes Decoding. Der Output kann über 65,536 Tokens bis zum vollen Fenster laufen, und jeder dieser Tokens kostet
$15pro Million.
Welche Neon-Stufe und welches Level sollte ich wählen?
Wähle die günstigste Kombination, die deine Qualitätsanforderung erfüllt, und messe dann eine Woche lang. Meine Ausgangspunkte:
- Live-Kundenchat oder ein interaktives Coding-Tool: Standard bei
medium. Priority kostet80%mehr und kauft nur Zuverlässigkeit. - Nächtliche Evals, Backfills, Datenanreicherung: Batch für alles, was einen Tag warten kann, Flex für alles, das die Antwort in Minuten braucht. Beide sind
50%günstiger. - Eine harte Agenten-Aufgabe, bei der
highnicht ausreicht:xhigh, für 1.8 mehr Index-Punkte und72%höhere Kosten pro Aufgabe. Zuerst testen. - Qualität spielt kaum eine Rolle: nutze Gemini 3.8 Flash oder Hydrogen. Neon ist nicht das Modell für günstige Arbeit.
Wenn du ein Modell für einen Support-KI-Agenten wählst, ist die Token-Rechnung die kleinere Entscheidung. Mein Leitfaden zu KI-Kundenservice-Kosten stellt die Modell-Zeile neben Software, Personal und Review-Zeit, die normalerweise überwiegen. Swiftreg, ein britischer Händler für private Kennzeichen, ließ zwei eesel-Agenten auf Zendesk laufen und bearbeitete zwischen dem 8. August und dem 8. September 2026 etwa 2,100 Tickets, wobei 1,494 öffentliche Antworten gesendet wurden. Seine Agenten antworten aus Live-Bestellabfragen, die das Team geschrieben hat, und tragen feste Regeln dazu, was an einen Menschen gehen muss. Dieses Setup, nicht das Modell, entscheidet, ob eine Antwort richtig ist, und es lohnt sich, an vergangenen Tickets zu simulieren, bevor du für ein besseres Modell bezahlst. Meine Liste der besten KI-Modelle für Support-Tickets ist die nächste Station.
Wenn dein Team im Terminal arbeitet, lässt der eesel CLI einen Coding-Agenten exportierte Hilfeartikel und Makros hochladen, die Anweisungen des Agenten anpassen und Testfragen stellen, bevor es live geht. Das Verbinden des Helpdesks selbst braucht weiterhin jemanden mit Admin-Zugang, der es genehmigt. Das breitere Muster steht in meinem Beitrag zu agentischen Coding-CLIs.
Mein Urteil zu den Gemini 4 Neon Preisen
Neon ist fair bepreist und nicht günstig. Der Satz ist stabil, die Stufen sind klar, und eine halbpreisige Batch- oder Flex-Spur ist für Hintergrundarbeit nützlich. Aber die Kosten pro Aufgabe hängen davon ab, welches Thinking-Level du wählst und ob deine Prompts den Cache treffen, also miss beides, bevor du dich festlegst. Wenn du es gegen Carbon abwägst, warte bis zum 1. Dezember, um die Listenpreise zu vergleichen, und wenn Kosten pro Aufgabe deine einzige Einschränkung sind, sind GPT-6.2 Astra und Sol günstiger. Für das Gesamtbild starte mit der Übersicht Gemini Preise, dann dem Vergleich ChatGPT gegen Gemini.
eesel ausprobieren
Wenn du ein Modell bepreist, weil du bessere Antworten in deiner Warteschlange willst, gibt dir der eesel KI-Helpdesk-Teammate das ohne eine Modell-Entscheidung. Er lernt aus deinen vergangenen Tickets und deinem Help Center, gibt an einen Menschen ab, wenn die Antwort nicht in deinen Docs steht, und du kannst ihn an echter Ticket-Historie testen, bevor er irgendjemandem antwortet. Er funktioniert innerhalb von Zendesk, Freshdesk und anderen Helpdesks, wie im Zendesk-Beispiel unten.
Die Preisgestaltung ist ein fester monatlicher Credit-Plan, mit einem kostenlosen Plan von 100 Credits und ohne Kreditkarte, sodass eine Preisänderung eines Modells deine Rechnung nicht verschiebt. Probiere eesel aus an einem Teil deiner Warteschlange.