

Gemini 4 Neon ist das Google-Modell, das ich für schwere Agenten- und Langdokument-Arbeit einsetzen würde, auf high ausgeführt: Artificial Analysis bewertet es mit 59,6 Punkten für $3,74 pro Aufgabe, etwa die Hälfte der $7,76 von Carbon bei gleicher Punktzahl. Es ist nicht der günstigste Weg zu dieser Punktzahl. OpenAIs Astra erreicht 60,1 Punkte für $2,07, und Neon schreibt fünf- bis sechsmal so viele Tokens pro Aufgabe. Sein wirklicher Vorteil ist Ehrlichkeit: Es lag bei 14% der Fragen, die es nicht beantworten konnte, mit einer falschen Vermutung daneben, gegenüber 54% bis 61% bei Sol und Astra.
Die eesel CLI lässt einen Coding-Agenten freigegebene Hilfeartikel zu einem eesel Helpdesk-Teammitglied hochladen und dessen Antworten an deinen eigenen Tickets testen, genau so würde ich jedes Modell prüfen, bevor es einem Kunden antwortet.
Wie ich Gemini 4 Neon getestet habe
Ich habe Neon noch nicht durch meine eigene Testsuite laufen lassen, daher stammt jede Zahl unten aus drei Quellen, die ich am Starttag, dem 19. November 2026, prüfen konnte:
- Googles eigene Seiten: der Launch-Post, die Modellkarte und die Preisseite.
- Artificial Analysis: Ich habe die Ergebnisse pro Einstellung für Neon, Carbon, Hydrogen, Sol, Astra und Opus 5.5 von deren Modellseiten gelesen. Der Index ist eine Suite aus 9 Bewertungen, eine „Aufgabe" unten bedeutet also eine Benchmark-Aufgabe, nicht eines deiner Tickets.
- Der Launch-Thread auf Hacker News, der am Tag der Eröffnung die 460-Punkte-Marke überschritten hat.
Ich habe versucht, Reddit und X für Nutzerstimmen zu laden, aber keine der beiden Seiten hat funktioniert, daher stammen alle Community-Zitate von Hacker News. Wenn deine eigene Arbeitslast anders aussieht als ein Benchmark, behandle mein Urteil als Shortlist, nicht als Ergebnis. Der Neon-Erklärartikel behandelt Modell-ID, Zugang und Migration, daher halte ich das hier kurz.
Was ist Gemini 4 Neon, in einem Absatz?
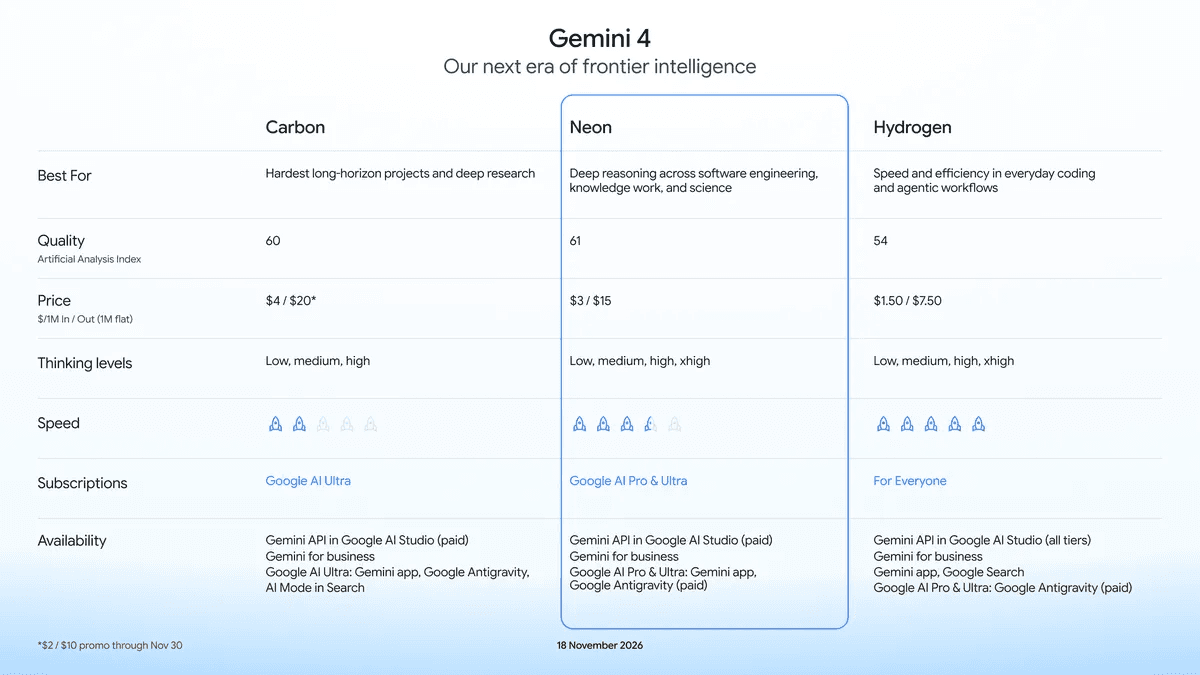
Neon ist das mittlere Modell von Googles Gemini-4-Familie, veröffentlicht am 18. November 2026 als gemini-4-neon. Google gibt an, dass es von Carbon abgeleitet ist, dessen 1.048.576-Token-Fenster teilt und vier Denkstufen hat: low, medium, high (die Standardeinstellung) und xhigh. Es kostet $3 pro Million Input-Tokens und $15 pro Million Output-Tokens, ohne kostenlose Stufe. Google nennt es die Balance aus „Tiefe und Effizienz", und die eigene Grafik platziert es zwischen Hydrogen und Carbon:
Ist Gemini 4 Neon gut bei den schweren Aufgaben?
Ja, und die Belege sind stärker als bei den meisten Behauptungen am Starttag, weil die Rangliste und Googles eigene Tabelle übereinstimmen. Artificial Analysis setzt Neon bei 61,4 auf xhigh und 59,6 auf high, vor Opus 5.5 mit 59,1 und Sol mit 57,3 (ihre jeweils besten Einstellungen). Googles selbst berichtete Tabelle zeigt, woher der Vorsprung kommt:
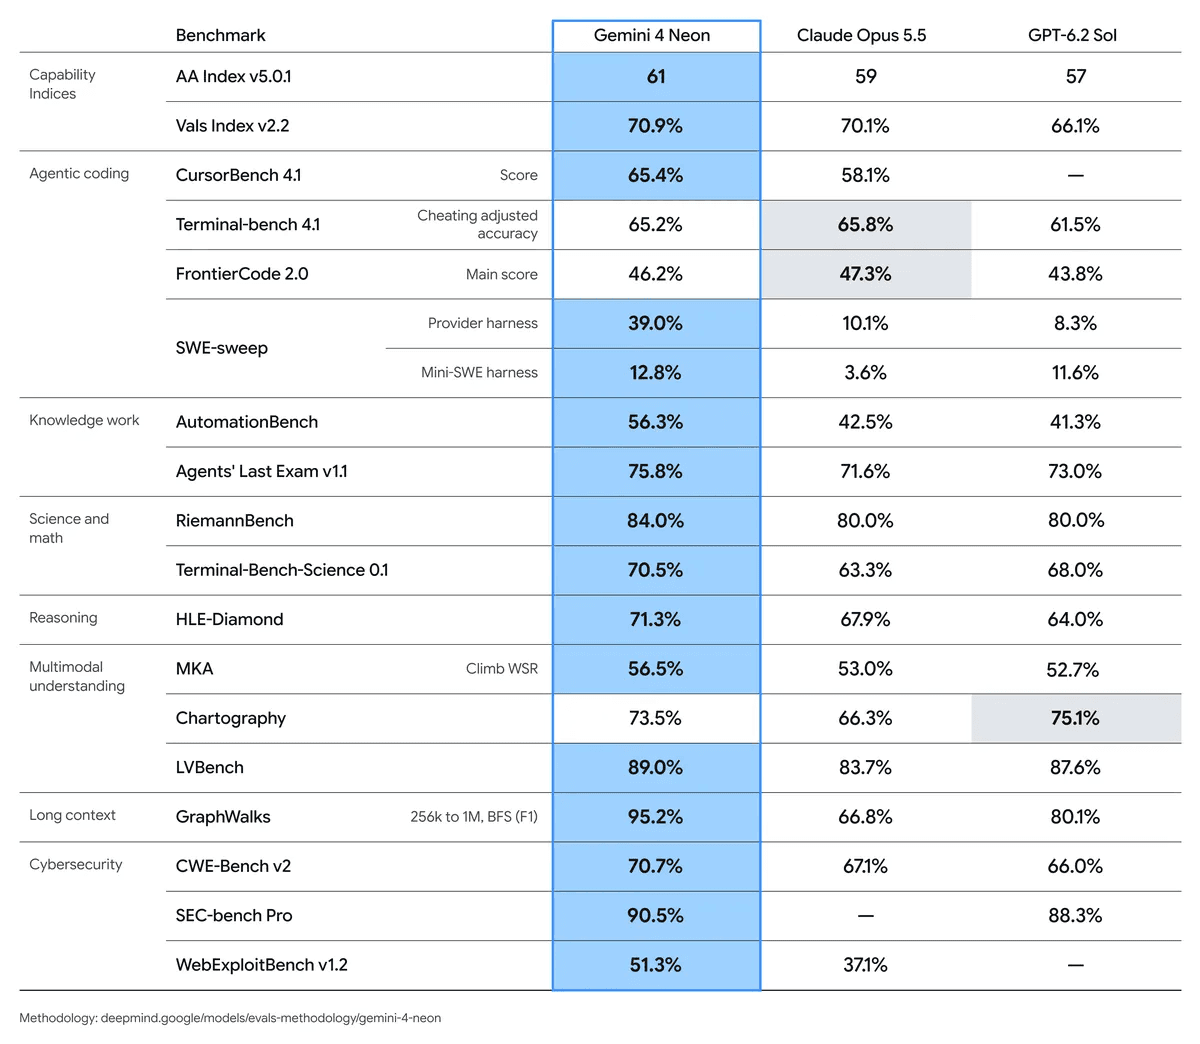
Wenn man die Spalten liest statt der fett markierten Zellen:
- Wissensarbeit-Agenten: AutomationBench
56.3%gegenüber42.5%bei Opus 5.5 und41.3%bei Sol. - Langer Kontext: GraphWalks von 256k bis 1M Tokens,
95.2%gegenüber66.8%und80.1%. Wenn deine Aufgabe lautet „ein sehr langes Dokument lesen und präzise antworten", ist das die Zeile, die zählt. - Coding, gemischt: Opus 5.5 liegt bei Terminal-Bench 4.1 leicht vorn (
65.8%gegenüber65.2%) und bei FrontierCode 2.0 (47.3%gegenüber46.2%). Neons SWE-Sweep-Vorsprung von39.0%nutzt Antigravitys eigenen Test-Harness, darauf würde ich mich nicht verlassen.
Das sind Googles Zahlen, von Google ausgewählt. Die unabhängigen sind die Artificial-Analysis-Zeilen unten, und sie erzählen eine interessantere Geschichte als die Schlagzeilen-Punktzahl.
Wie viel kostet Neon pro Aufgabe bei jeder Einstellung?
Der Preis pro Token verschleiert den Großteil der Rechnung, weil Denk-Tokens als Output abgerechnet werden. Hier sind Artificial Analysis' Daten pro Einstellung für Neon neben seinen Geschwistermodellen, wie ich sie am 19. November gelesen habe:
| Einstellung | Indexpunktzahl | Kosten pro Aufgabe | Minuten pro Aufgabe | Output-Tokens pro Aufgabe |
|---|---|---|---|---|
| Neon low | 44,1 | $0,75 | 3,7 | 21.726 |
| Neon medium | 54,9 | $1,90 | 8,3 | 50.000 |
| Neon high (Standard) | 59,6 | $3,74 | 14,8 | 90.188 |
| Neon xhigh | 61,4 | $6,44 | 21,5 | 141.631 |
| Carbon high | 60,0 | $7,76 | 37,2 | 122.768 |
| Hydrogen xhigh | 53,9 | $3,16 | 15,2 | 154.406 |
| Opus 5.5 max | 59,1 | $10,04 | 24,5 | 173.313 |
| Astra high | 60,1 | $2,07 | 5,9 | 17.828 |
| Sol max | 57,3 | $1,01 | 8,5 | 40.360 |
Drei Dinge fallen auf:
- Neon schlägt Carbon auf dessen eigenem Terrain. Auf high erreicht es Carbons Punktzahl innerhalb eines halben Punktes für 52% weniger Kosten und 60% weniger Zeit. Google behauptet 32% niedrigere Kosten pro Aufgabe gegenüber Carbon, nach diesen Daten ist der echte Abstand also größer als die Werbeaussage.
- High ist der Sweet Spot. Der Wechsel von medium zu high bringt 4,7 Indexpunkte für $1,84 mehr. Der Wechsel von high zu xhigh bringt 1,8 Punkte für $2,70 mehr und 6,7 zusätzliche Minuten.
- Astra ist das Problem. Bei derselben Punktzahl kostet Astra $2,07 pro Aufgabe und ist in 5,9 Minuten fertig. Astras Preis pro Token ist höher ($8 Input, $40 Output), trotzdem ist es pro Aufgabe etwa 45% günstiger, weil es 17.828 Tokens schreibt, wo Neon 90.188 schreibt.
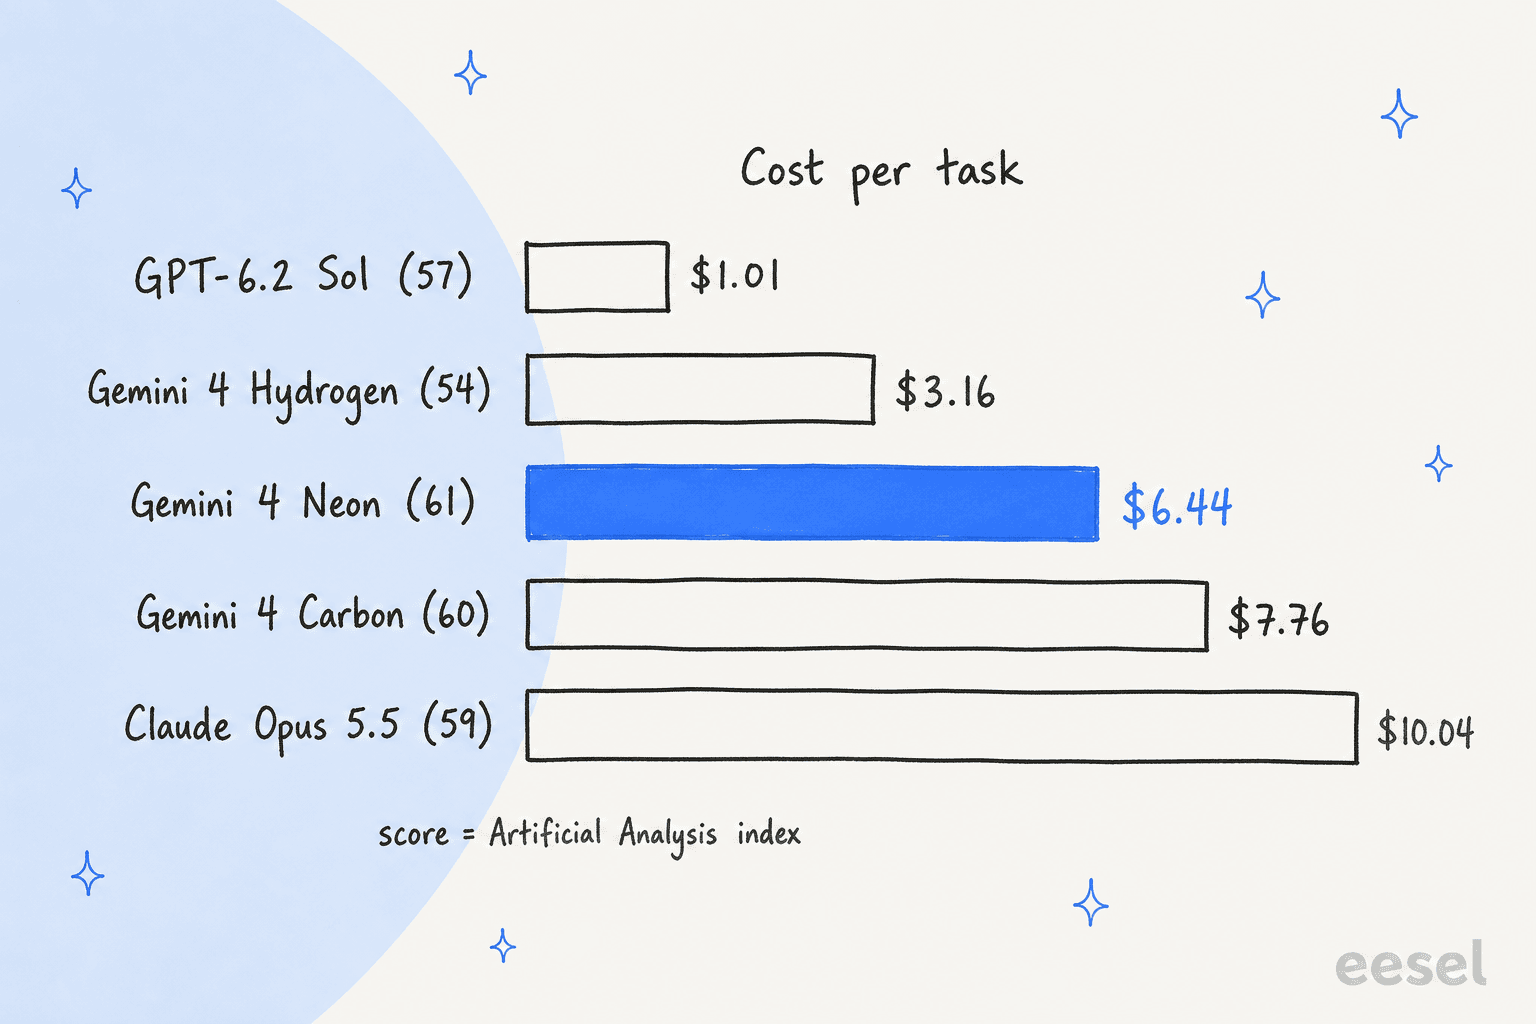
Das Diagramm nutzt die beste Einstellung jedes Modells, was der faire Weg ist, um zu vergleichen „was kann dieses Modell maximal leisten", und der unfaire Weg, um zu vergleichen „was sollte ich bezahlen". Für die zweite Frage nutze die Tabelle.
Halluziniert Gemini 4 Neon weniger als Sol und Opus?
Das ist der Befund, der meine Sicht auf das Modell verändert hat. Im AA-Omniscience-Test von Artificial Analysis, der bewertet, wie oft ein Modell eine falsche Antwort gibt, statt abzulehnen, wenn es etwas nicht weiß, setzt sich die Gemini-4-Familie deutlich vom Rest ab:
| Modell und Einstellung | Halluzinationsrate (niedriger ist besser) | Korrekt beantwortete Fragen |
|---|---|---|
| Gemini 4 Argon high | 4% | 48% |
| Gemini 4 Carbon medium | 4% | 49% |
| Gemini 4 Hydrogen xhigh | 8% | 50% |
| Gemini 4 Carbon high | 11% | 58% |
| Gemini 4 Neon high | 14% | 59% |
| Gemini 4 Neon xhigh | 14% | 60% |
| Claude Opus 5.5 max | 50% | 66% |
| GPT-6.2 Sol max | 55% | 62% |
| GPT-6.2 Astra high | 58% | 66% |
| Claude Fable 5.2 high | 58% | 77% |
Neon sagt weit häufiger „ich weiß es nicht" als Opus, Sol oder Astra, und das zahlt es mit roher Genauigkeit: 59% bis 60% korrekt gegenüber 66% bei Astra und 77% bei Fable 5.2. Unter Googles eigenen Modellen rät es außerdem eher als Carbon medium, Argon oder Hydrogen.
Ob dieser Tausch gut ist, hängt von der Aufgabe ab. Für einen Recherche-Agenten, der immer eine Antwort liefern muss, sind die zusätzlichen Ablehnungen Reibung. Für einen kundenorientierten Agenten, der übergeben soll, wenn er unsicher ist, kommt ein Modell, das ablehnt, näher an das, was man will, und es ist das Verhalten, auf das ich zuerst achte. Ein Vorbehalt, den ich laut sagen will: AA-Omniscience ist ein Allgemeinwissenstest. Er misst nicht, wie sich ein Modell mit deinem Helpcenter verhält, teste also an deinen eigenen Tickets, bevor du es glaubst.
Wo bleibt Gemini 4 Neon hinter den Erwartungen zurück?
Ich habe sechs echte Grenzen gefunden, geordnet danach, wie sehr sie mich stören würden:
- Es ist geschwätzig. Auf xhigh hat es über den gesamten Index 283 Millionen Output-Tokens geschrieben, gegenüber 60,9 Millionen bei Sol. Output-Tokens sind die mit $15, deine Rechnung bewegt sich also mit den Gewohnheiten des Modells, nicht nur mit der Preisliste.
- Die höchste Einstellung ist langsam. Artificial Analysis hat auf xhigh 56,5 Sekunden bis zum ersten Antwort-Token gemessen und danach 110 Tokens pro Sekunde. Carbon braucht 73 Sekunden und 55 Tokens pro Sekunde, Neon ist also schneller als Carbon, aber oberhalb von
mediumkein Live-Chat-Modell. - Astra und Sol sind pro Aufgabe günstiger. Pro Token ist Neon günstiger als Astra. Pro Aufgabe nicht, wie die Tabelle zeigt. Sol max erreicht 57,3 Punkte für $1,01, das ist 6,4-mal günstiger als Neon xhigh.
- Es ist weniger präzise, wenn es antworten sollte. Siehe die Halluzinationstabelle: Der Tausch ist Vorsicht gegen Korrektheit.
- Der Zugang hat Bedingungen. Es gibt keine kostenlose API-Stufe, und die Antigravity-FAQ untersagt laut Zitat eines Hacker-News-Lesers Drittanbieter-Tools die Nutzung von Abo-Zugang. Dafür nannten sie es einen Dealbreaker:
"I'd like to keep my Gmail account, so Google can keep their model and will not get my business."

Ein anderer Leser wies auf den Workaround hin, nämlich einfache API-Keys:
"You can't use subsidized tokens in 3rd party apps. Although they just suspend your Gemini account now, not your google account."
- Der Sicherheitsbericht steht noch aus. Googles Modellkarte besagt, dass der vollständige Bericht in den kommenden Tagen erscheint, ich würde also jede regulierte Arbeitslast zurückhalten, bis er vorliegt.
Welches Modell schlägt Neon für deine Aufgabe?
So würde ich die Entscheidung heute treffen:
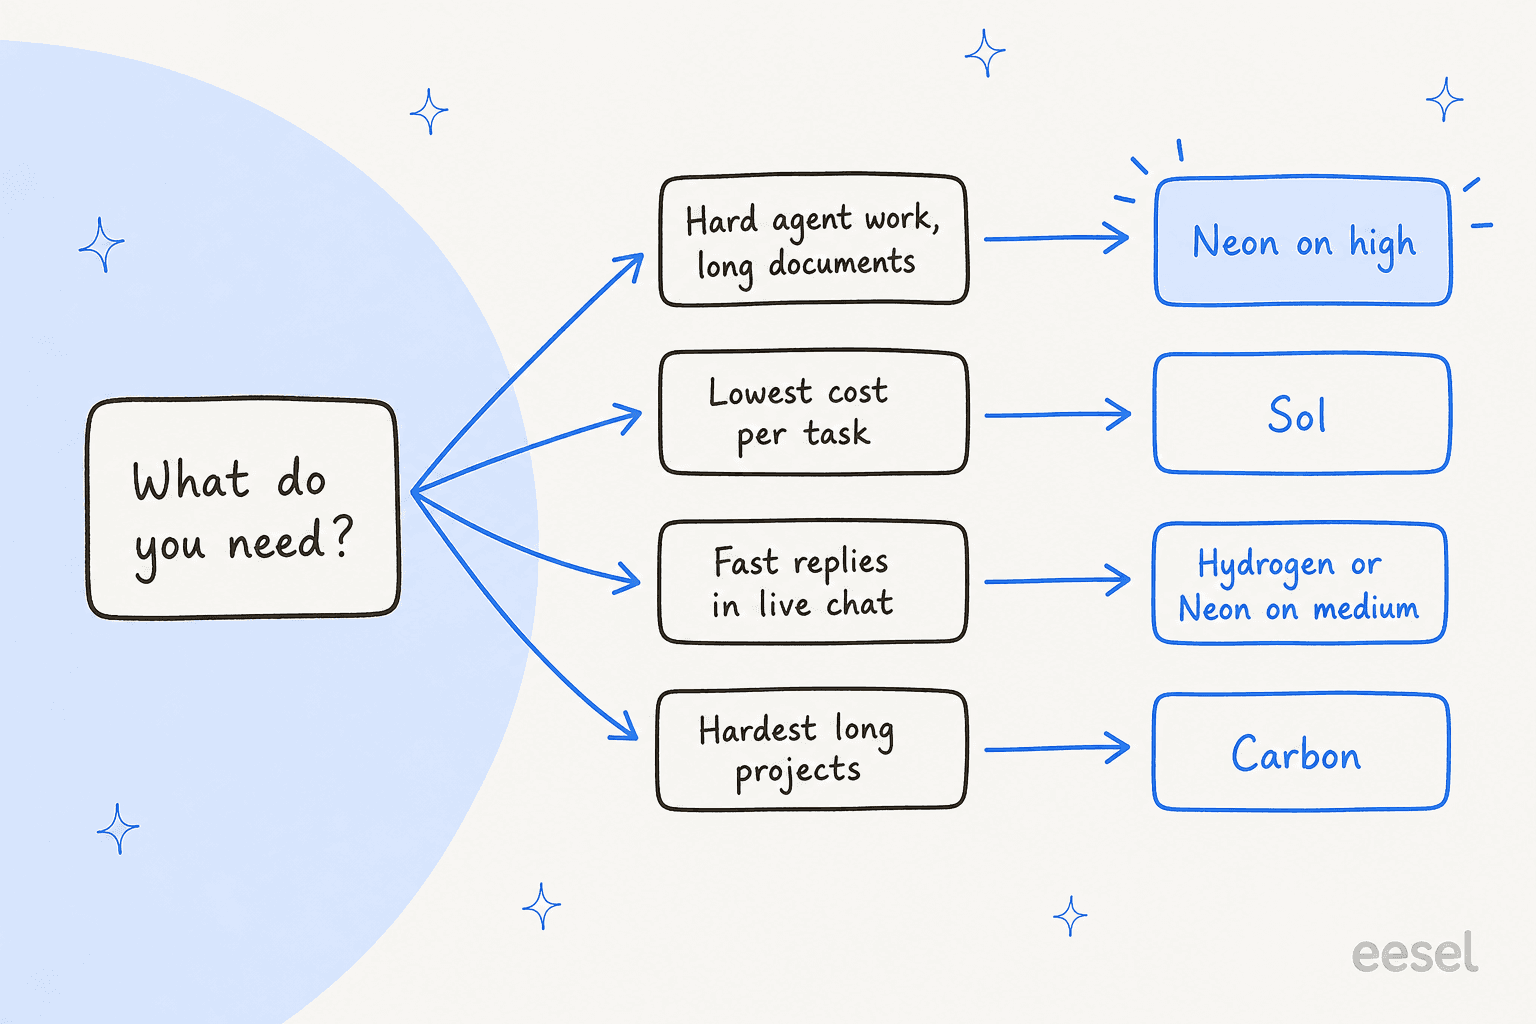
Die Gabel verbirgt den interessanten Teil, nämlich dass Kosten und Halluzination in entgegengesetzte Richtungen ziehen. Hier also die Daten in einem Tool. Lege die niedrigste Indexpunktzahl fest, die du akzeptierst, und die höchste Halluzinationsrate, die du tolerierst, und es listet jede Artificial-Analysis-Einstellung auf, die ich erfasst habe und die beide Grenzwerte erfüllt, günstigste zuerst:
Probiere die Extreme aus. Verlange eine Punktzahl von 55 ohne Halluzinationsgrenze, und Sol xhigh gewinnt preislich mit $0,65. Setze bei derselben Punktzahl eine Obergrenze von etwa 20% an, und Neon high ist die günstigste Antwort mit $3,74, mit Carbon medium als der vorsichtigeren Option bei 4%. Senke die Punktzahl auf 54, und Neon medium übernimmt bei $1,90. Die Gemini-4-Familie ist der einzige Ort, an dem man eine hohe Punktzahl und eine niedrige Fehlerquote zusammen bekommt, und das ist der ehrliche Fall für Neon.
Wie schneidet Neon im Vergleich zu Carbon, Hydrogen, Astra, Sol und Opus ab?
| Modell | Preis pro 1M in/out | Bester Einstellungs-Score | Kosten pro Aufgabe (beste) | Halluzinationsrate | Mein Fazit in einem Satz |
|---|---|---|---|---|---|
| Gemini 4 Neon | $3 / $15 | 61,4 | $6,44 | 14% | Bestes Gemini für schwere Arbeit; lass es auf high laufen |
| Gemini 4 Carbon | $4 / $20 nach der Aktion | 60,0 | $7,76 | 11% | Neon ersetzt es für die meiste Arbeit |
| Gemini 4 Hydrogen | $1,50 / $7,50 | 53,9 | $3,16 | 8% | Die Standardwahl für kleine Aufgaben |
| GPT-6.2 Astra | $8 / $40 | 62,1 | $4,00 | 59% | Höhere Punktzahl, weniger Tokens, rät mehr |
| GPT-6.2 Sol | $2 / $10 | 57,3 | $1,01 | 55% | Mit Abstand am günstigsten pro Aufgabe |
| Claude Opus 5.5 | $4 / $20 | 59,1 | $10,04 | 50% | Neon erreicht dasselbe für etwa ein Drittel der Kosten |
Carbons Listenpreis beträgt $4/$20 ab dem 1. Dezember und $2/$10 bis zum 30. November, was es nur für ein paar weitere Tage günstiger pro Token macht als Neon. Das ändert nichts an der Rechnung pro Aufgabe, weil Carbon deutlich länger nachdenkt.
Was sagen die Leute über Gemini 4 Neon?
Der Launch-Thread auf Hacker News überschritt die 460-Punkte-Marke. Die nützlichste Antwort verglich Neon mit seinen Rivalen auf Vals und ordnete den Preis dann ein:
"Latency is by far the best for the level of quality. It's about 2x more expensive than Sol 6.2, but significantly better and faster. You get what you pay for."
Der Abstand pro Token zu Sol beträgt das 1,5-Fache, nicht das Doppelte, und pro Benchmark-Aufgabe liegt er je nach Einstellung zwischen dem 1,9- und 6,4-Fachen. "You get what you pay for" stimmt also bei der Qualität, ist aber teurer, als es klingt. Ein anderer Leser deutete denselben Preis als Verlust:
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
Nach den Artificial-Analysis-Zahlen stimmt das in etwa bei den Kosten pro Aufgabe und nicht bei der Halluzination, weshalb ich die beiden in diesem Test getrennt behandle. Ein dritter Kommentator, der lange Agenten-Aufgaben testet, war weniger an der Punktzahl interessiert:
"Argon and Carbon both made such discoveries such as "it would seem that i need to be pointing at an enemy to shoot them". Its almost entertaining to read, its like its discovering the world on first principles."
Dieser Nutzer startete dieselbe Aufgabe gerade auf Neon, als er postete, es gibt also noch kein Urteil. Und ein Leser fasste zusammen, was sich viele von Google wünschen:
"Hydrogen has already became my default for 80% of small tasks. If Neon is as fast but smarter that would honestly be very cool"
Nach den Daten ist Neon auf high um 8,8 Punkte klüger als Hydrogen, kostet aber doppelt so viel pro Aufgabe ($3,74 gegenüber $1,87). Das sind einzelne Kommentatoren, keine Umfrage, und ich konnte für mehr weder Reddit noch X erreichen.
Wer sollte Gemini 4 Neon verwenden?
| Du bist... | Mein Rat |
|---|---|
| Jemand, der Carbon oder Argon für schweres Coding oder Analysen einsetzt | Wechsle zu Neon auf high und vergleiche. Gleiche Punktzahl, etwa halbe Kosten und Zeit. |
| Jemand, der für Opus 5.5 auf max bezahlt | Teste Neon high. Die Punktzahl ist gleich, die Rechnung etwa ein Drittel. |
| Jemand, der einen Planer- und Worker-Agenten baut | Neon plant, Hydrogen führt aus. |
| Jemand, der sehr lange Dokumente liest | Neon, laut Googles GraphWalks-Zeile und den AA-Wissensarbeit-Ergebnissen. |
| Jemand, der Kosten pro Aufgabe über alles optimiert | Überspringe Neon. Nutze Sol oder Astra. |
| Jemand, der eine Live-Chat-Antwort baut | Neon höchstens auf medium, oder Hydrogen. |
| Jemand, der eine kostenlose Stufe braucht | Hydrogen. Neon hat keine. |
| Jemand, der für einfache Aufgaben Gemini 3.8 Flash nutzt | Bleib dabei. Neon ist überdimensioniert und geschwätziger. |
Wenn du dich zwischen Familien entscheidest, gehen mein Vergleich ChatGPT gegen Gemini und die Zusammenstellung der Gemini-Alternativen weiter in die Breite. Meine umfassendere Einschätzung zu dieser Modellklasse steht im Beitrag zu frontier AI.
Was bedeutet dieser Test für Support-Teams?
Ein Support-Agent ist ein Ort, an dem das Ergebnis „lieber ablehnen als raten" mehr zählt als die Schlagzeilen-Punktzahl. Eine selbstsichere falsche Antwort auf eine Rückerstattungsfrage kostet mehr als eine Übergabe an einen Menschen. Aber das Modell ist nur ein Teil. Was der Agent weiß, wann er übergeben muss und ob ihn vor dem Start jemand getestet hat, entscheidet darüber, wie er sich verhält.
Das ist das Muster, nach dem smava, ein deutsches Kreditvergleichsunternehmen, eesel in einem Zendesk betreibt. Zwischen dem 8. August und dem 8. September 2026 bearbeiteten drei eesel-Agenten etwa 27.000 Tickets: einer kategorisierte rund 14.600 davon, einer entwarf etwa 15.300 Antworten aus 820 Makros und Hilfeartikeln, und markenspezifische Agenten bereiteten kundenfertige Antworten vor. Jeder Agent hat eine Aufgabe und eine Liste von Dingen, die er niemals tun darf, und Menschen genehmigen jeden Entwurf, bevor er versendet wird. SamCart teilt es genauso auf: ein Agent für Freshdesk-E-Mail, ein anderer für den Website-Chat, jeder mit seinem eigenen Ton.
Die Modellwahl ist eine Einstellung innerhalb dieses Designs, nicht das Design selbst. Wenn du Modelle an deiner Warteschlange vergleichen willst, simuliere den Agenten an vergangenen Tickets und beobachte die Übergaberate, nicht nur die Genauigkeit. Mein Leitfaden welches LLM am besten ist behandelt die Prüfungen, die ich durchführen würde, und KI-Kundenservice-Kosten zeigt, was eine Warteschlange insgesamt kostet.
Wenn dein Team im Terminal baut, lässt die eesel CLI einen Coding-Agenten die wiederholbaren Teile erledigen: exportierte Hilfeartikel und Makros hochladen, die Anweisungen des Agenten anpassen und Testfragen stellen, bevor es live geht. Das Verbinden des Helpdesks selbst braucht weiterhin die Freigabe eines Admins. Siehe agentische Coding-CLIs und den Leitfaden zu einem KI-Agenten-MCP-Server dafür, wie diese Tools mit Modellen wie Neon zusammenarbeiten.
Mein Fazit zu Gemini 4 Neon
Verwende es, wenn du ohnehin für Carbon oder Opus 5.5 bezahlen wolltest, lass es auf high laufen und messe die Kosten pro Aufgabe, nicht pro Token. Überspringe es, wenn die Kosten pro Aufgabe deine einzige Einschränkung sind, denn Sol und Astra sind günstiger, oder wenn du eine kostenlose Stufe brauchst. Sein bestes Merkmal ist nicht die Punktzahl von 61,4. Es ist, dass ein so leistungsfähiges Modell so selten falsch rät, was es wert ist, vor einer Entscheidung getestet zu werden.
eesel ausprobieren
Wenn du ein Modell auswählst, weil du bessere Antworten in deiner Warteschlange willst, gibt dir das eesel KI-Helpdesk-Teammitglied das, ohne dass du dich für ein Modell entscheiden musst. Es lernt aus deinen vergangenen Tickets und deinem Helpcenter, übergibt an einen Menschen, wenn die Antwort nicht in deiner Doku steht, und du kannst es an echter Ticket-Historie testen, bevor es irgendjemandem antwortet. Es funktioniert innerhalb von Zendesk und Freshdesk, und es ist das Erste, was ich für einen KI-Rollout im Kundensupport ausprobieren würde.
Die Preisgestaltung ist ein fester monatlicher Credit-Plan, mit einem kostenlosen Plan von 100 Credits und ohne Kreditkarte, sodass eine Preisänderung bei einem Modell deine Rechnung nicht verändert. Probiere eesel aus an einem Teil deiner Warteschlange.