Die 8 besten Alternativen zu Meta Muse Spark Open 2026 im Vergleich: Lizenz, Preis und Hardware

Rama Adi

Katelin Teen
Zuletzt bearbeitet October 18, 2026
Warum Teams über Muse Spark Open hinausschauen
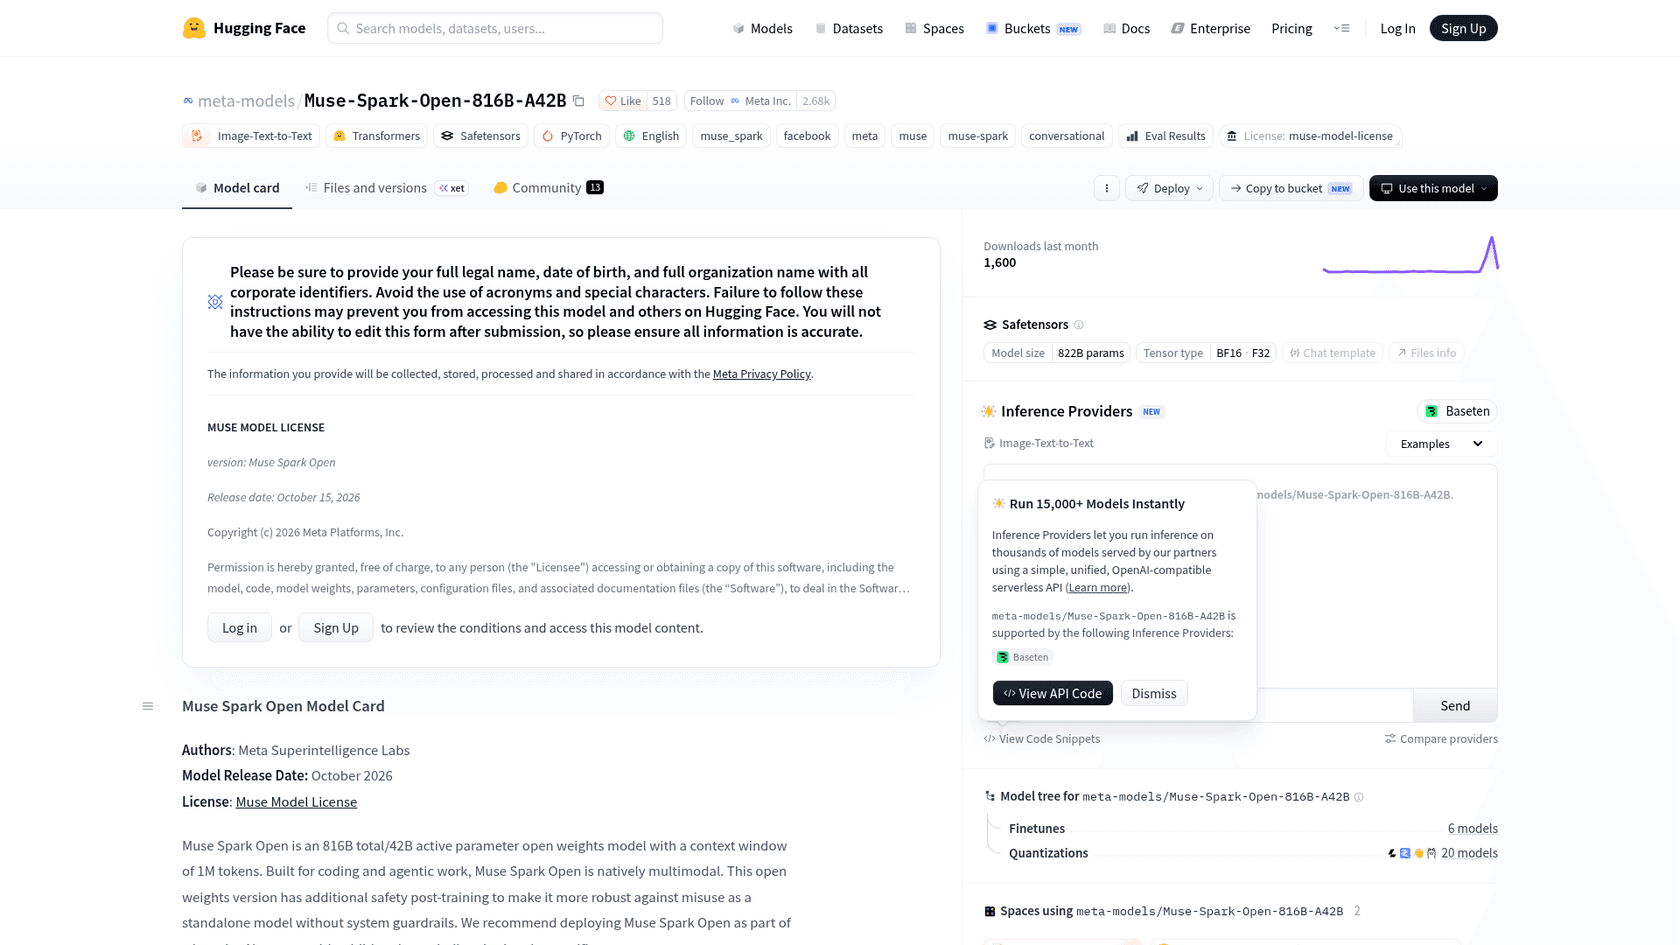
Meta hat Muse Spark Open am 15. Oktober 2026 veröffentlicht, und es ist ein ernstzunehmendes Modell. Es ist ein Mixture-of-Experts mit 816B Parametern und 42B aktiven pro Token, einem Kontextfenster von 1M Tokens und nativer Eingabe von Text, Bild, Audio und Video, laut Metas Research-Blog. Es ist außerdem das erste Modell seiner Klasse, das auf einem Schreibtisch läuft: zwei M5 Ultra Mac Studios, mit Apples MLX bei 24,99 Tokens pro Sekunde.
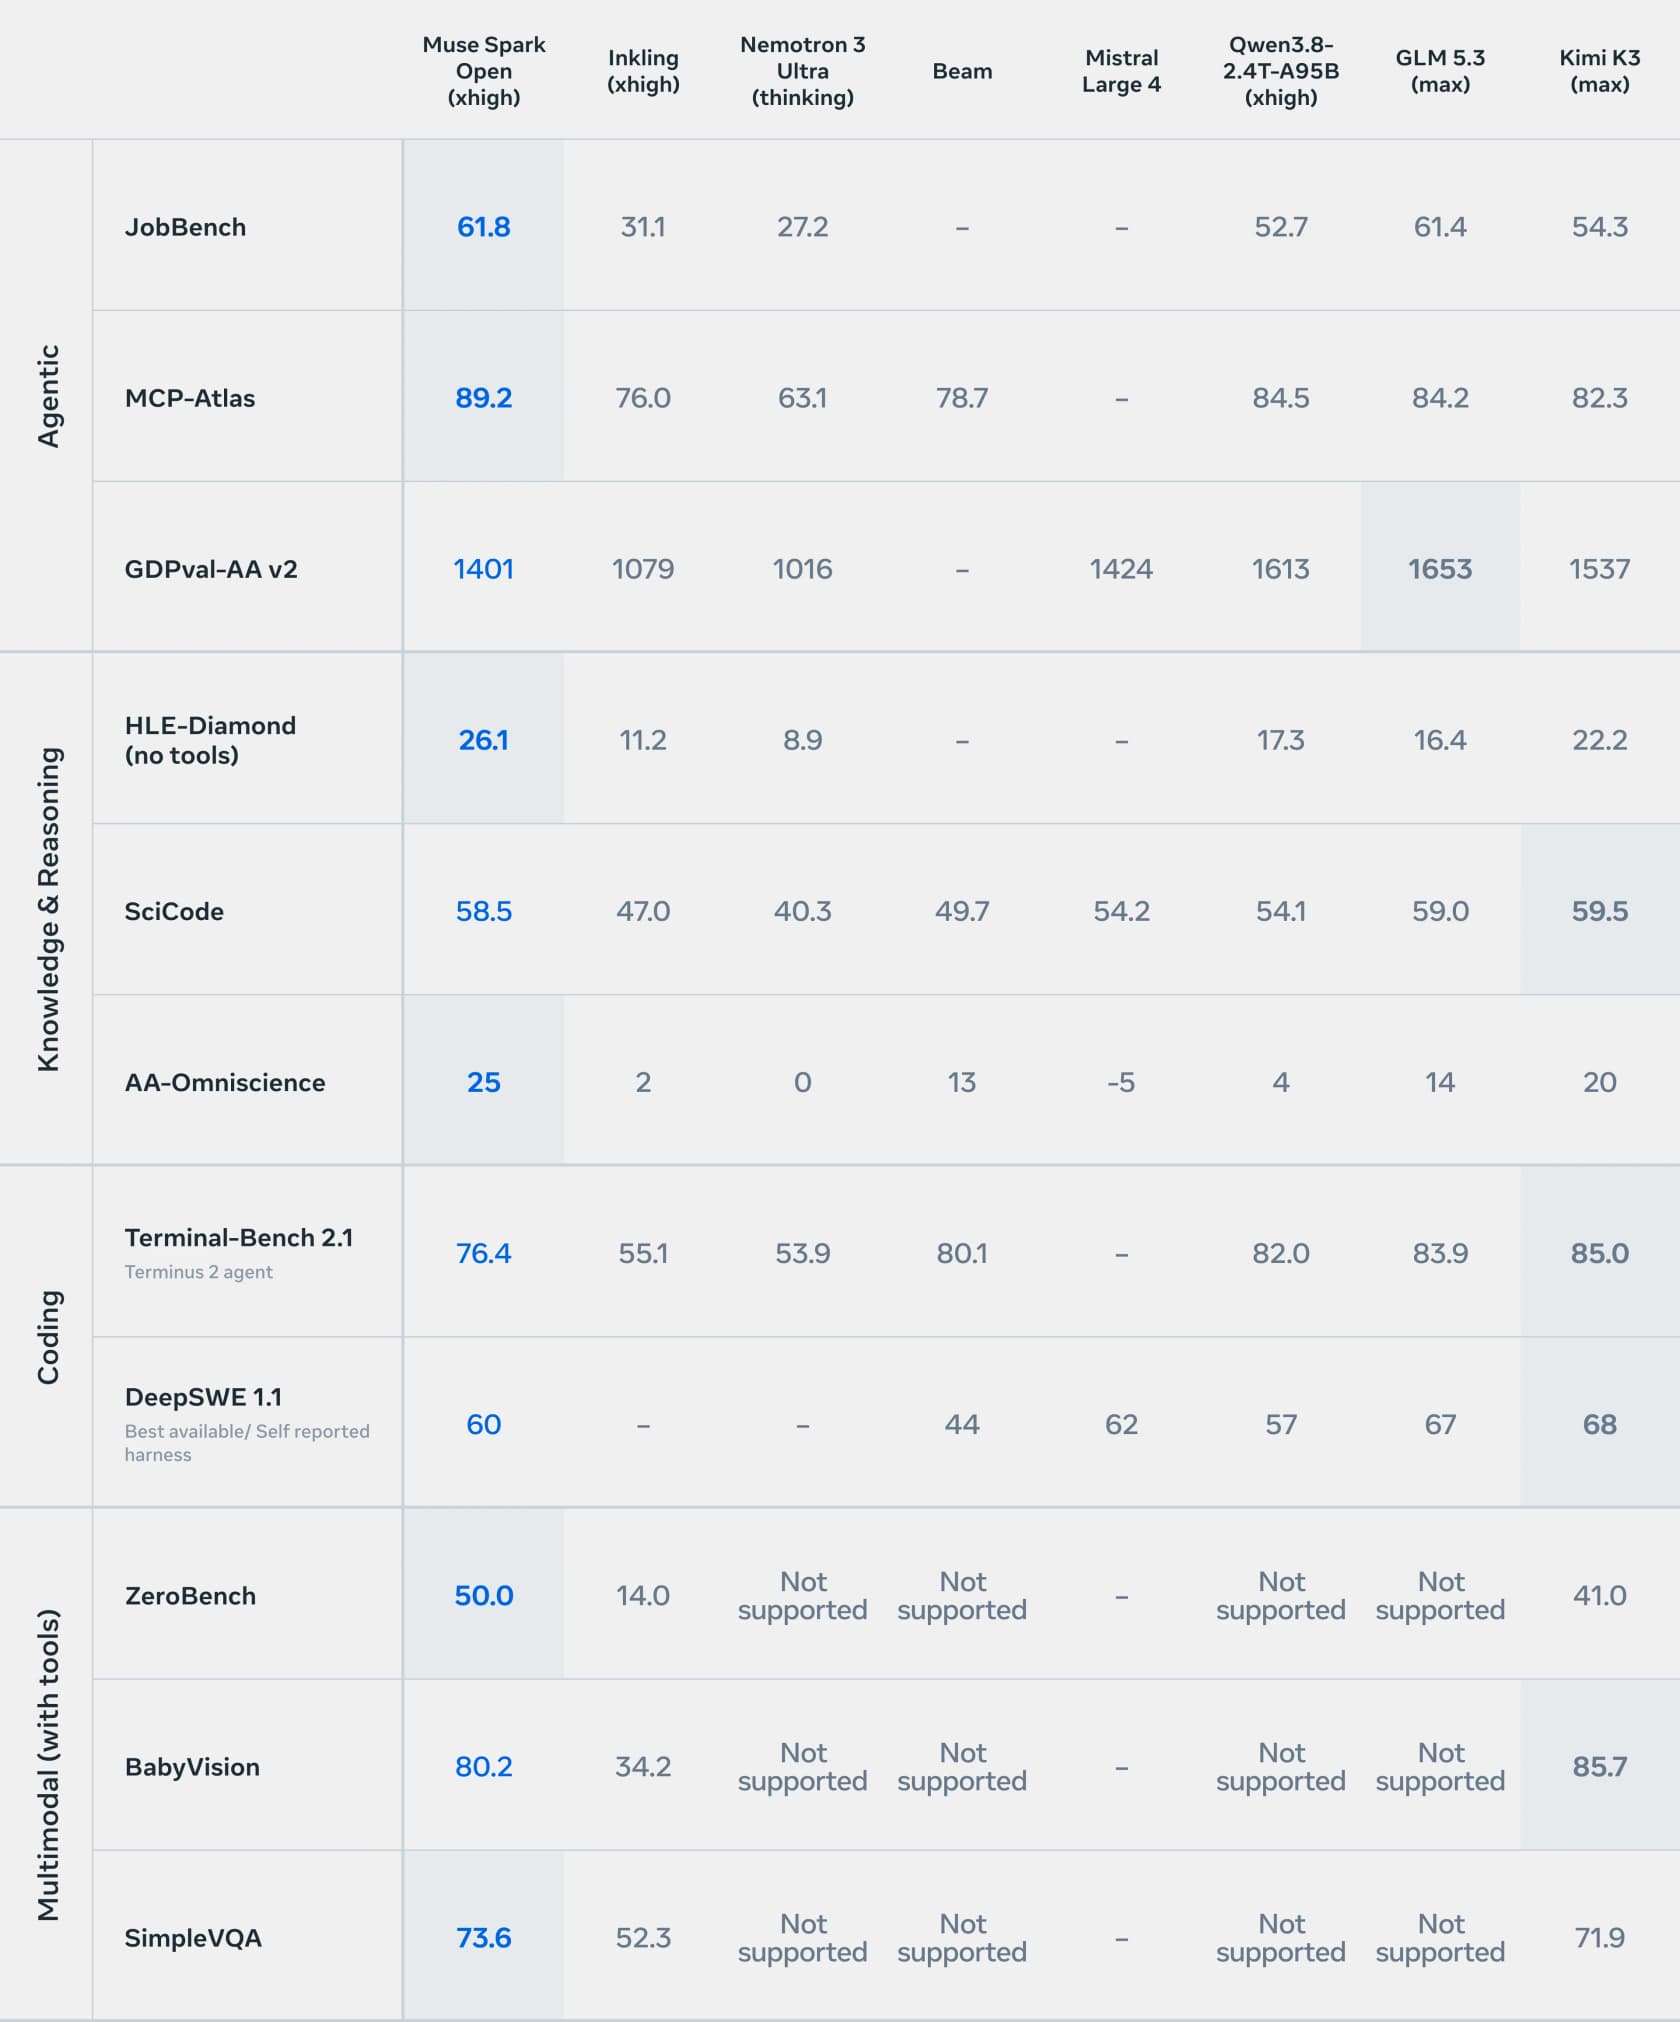
Ich baue bei eesel Integrationen und APIs, deshalb lese ich bei jedem neuen Modell zuerst die Lizenz und die Preisliste, bevor ich mir das Benchmark-Diagramm ansehe. Muse Spark Open hat hier echte Stärken. Es führt laut Metas Modellkarte vor seinen Mitbewerbern bei MCP-Atlas (89,2), JobBench (61,8) und HLE-Diamond (26,1), und es erreicht bei StrongREJECT eine 0,5, während jedes andere Modell der Tabelle zwischen 62,9 und 86,4 liegt. Für einen Agenten, der den ganzen Tag Tools aufruft und schädliche Anfragen ablehnen muss, ist das ein deutlicher Vorsprung.
Aber vier Dinge tauchen immer wieder auf, wenn Leute sich nach Alternativen umsehen:
- Die Punktzahl. Metas eigene Tabelle setzt Muse Spark Open im Artificial Analysis Intelligence Index bei 39, hinter GLM 5.3 (45), Kimi K3 (44) und Qwen3.8 (40). Auch beim Coding liegt es zurück: 60 bei DeepSWE gegenüber 68 für Kimi K3.
- Die Lizenz. Die Muse Model License verlangt, dass Sie in jedem Produkt, das es nutzt, in jeder Größe "prominently display 'Built with Muse Spark Open'". Anbieter von Modell-Hosting mit über 20 Millionen Dollar Umsatz brauchen zusätzlich eine separate Vereinbarung mit Meta.
- Der Preis. Jeder Host auf OpenRouter berechnet 1,25 $ für Input und 4,25 $ für Output pro Million Tokens, dieselbe Preisliste wie beim geschlossenen Muse Spark 1.3. Offene Gewichte senken die Preise bei Hosts normalerweise. Hier nicht.
- Zu viele Ablehnungen. Bei FORTRESS liegt der Over-Refusal-Wert von Muse Spark Open bei 17,4, gegenüber 2,7 bei Kimi K3 und 3,2 bei GLM 5.3. Das Sicherheitstraining, das es schwer jailbreakbar macht, lässt es auch zu mehr harmlosen Anfragen Nein sagen.
Der Launch-Thread auf Hacker News kam auf dieselben zwei Punkte:
"The model license requires large inference providers to contact Meta separately to obtain a license to serve the model. I know we've seen this before with other large models, but it's still a bit irritating. The usual effect of separate licensing is decreased price competition from public providers (like we saw with Kimi K3)."

"Well, this is much better than nothing -- we should be grateful that whatever the market conditions and corporate incentives, a major lab is releasing a capable open-weight model. But still very far behind DeepSeek and GLM. Even on consumer hardware, Qwen 3.8 27B is going to compare favorably to this."
Wie ich diese Alternativen ausgewählt habe
Vor dem Schreiben habe ich ChatGPT gefragt, womit ein Entwickler Muse Spark Open vergleichen sollte, und die ausgeführten Suchen protokolliert. Es ging direkt zu "best open-weight language models 2026 Qwen DeepSeek Kimi GLM" und kam mit sechs Namen zurück: GLM 5.3, Kimi K3, Qwen3.8, DeepSeek V4, Mistral Large 4 und gpt-oss-120b. Ich habe alle sechs behalten und die zwei anderen offenen Modelle aus Metas eigener Vergleichstabelle ergänzt, Nemotron 3 Ultra und Inkling.
Jede Alternative hier musste drei Regeln erfüllen:
- Die Gewichte sind heute herunterladbar, oder der Anbieter hat ein datiertes öffentliches Versprechen abgegeben (nur Mistral Large 4 fällt in diese Kategorie, und ich weise darauf hin).
- Die Preise stammen von der Seite des Anbieters selbst, oder von der eigenen Preisseite eines genannten Hosts, wenn das Labor das Modell nicht direkt verkauft.
- Die Punktzahlen stammen möglichst aus einer Quelle. Ich nutze Metas Vergleichstabelle, weil sie jedes Modell durch dieselbe Testumgebung geschickt hat, und ich sage es dazu, wenn eine Zahl von woanders kommt.
Ich habe jedes Modell mit denselben vier Fragen verglichen: worin es Muse Spark Open schlägt, wo es zurückfällt, was es kostet und was die Lizenz von Ihnen verlangt.
Alternativen zu Muse Spark Open auf einen Blick
| Modell | Hersteller | Parameter gesamt / aktiv | Kontext | Eingabetypen | Lizenz | Auflagen | Punktzahl in Metas Tabelle | Gehosteter Preis, In / Out pro 1M | Mindestanforderung Self-Hosting | Reasoning abschaltbar |
|---|---|---|---|---|---|---|---|---|---|---|
| Muse Spark Open (Referenz) | Meta | 816B / 42B | 1M | Text, Bild, Audio, Video | Muse Model License | "Built with"-Hinweis in jedem Produkt; Vereinbarung für Modell-Hosts über 20 Mio. $ Umsatz | 39 | 1,25 $ / 4,25 $ | 2 Mac Studios (M5 Ultra) | Nein |
| GLM 5.3 | Z.ai | 744B / 40B | 1M | Nur Text | GLM-5.3 License (MIT-ähnlich) | Sicherheitsprüfung nur für Modell-Hosts über 10 Mrd. $ Umsatz | 45 | 1,40 $ / 4,40 $ | Nicht angegeben | Nein |
| Kimi K3 | Moonshot AI | 2,8T / 104B | 1M | Text, Bild, Video | Kimi K3 License (MIT-ähnlich) | "Kimi K3" anzeigen ab 100 Mio. Nutzern oder 20 Mio. $/Monat; Vereinbarung für Modell-Hosts über 20 Mio. $ | 44 | 3,00 $ / 15,00 $ | Nicht angegeben (2,8T Parameter) | Nein |
| Qwen3.8 2.4T | Alibaba | 2,4T / 95B | 262K nativ, bis zu 1M | Nur Text (offene Basis) | Qwen3.8 License | Namen anzeigen ab 100 Mio. Nutzern oder 20 Mio. $/Monat; Lizenz für Modell-Hosts über 50 Mio. $ | 40 | 2,00 $ / 6,00 $ (Qwen3.8 Max) | Nicht angegeben | Nein (offene Basis) |
| DeepSeek V4.1 Flash | DeepSeek | 552B (8B / 16B aktiv) | 1M | Text, Bild | MIT | Copyright-Hinweis beibehalten | Nicht in der Tabelle | 0,15 $ / 0,60 $ außerhalb der Stoßzeiten | Nicht angegeben | Ja |
| gpt-oss-120b | OpenAI | 117B / 5,1B | 128K | Nur Text | Apache 2.0 | Hinweise bei Weitergabe | Nicht in der Tabelle | 0,15 $ / 0,60 $ (Together) | 1 x 80-GB-GPU | Nein (niedrig / mittel / hoch) |
| Mistral Large 4 | Mistral AI | 1,05T / 52B | 1M | Text, Bild | Noch nicht benannt | Gewichte Ende Oktober erwartet | 38 | 0,68 $ / 2,09 $ (Aktionspreis) | Nicht angegeben | Hybridmodell |
| Nemotron 3 Ultra | NVIDIA | 550B / 55B | Bis zu 1M (262K in der Konfiguration) | Nur Text | OpenMDW-1.1 | Hinweise bei Weitergabe | 23 | 0,50 $ / 2,20 $ (DeepInfra) | 8 x H200 | Ja |
| Inkling | Thinking Machines Lab | 975B / 41B | 1M | Text, Bild, Audio | Apache 2.0 + Nutzungsrichtlinie | Nutzungsrichtlinie (KI-Offenlegung) | 26 | 1,00 $ / 4,05 $ | 600GB+ (NVFP4) | Aufwandssteuerung |
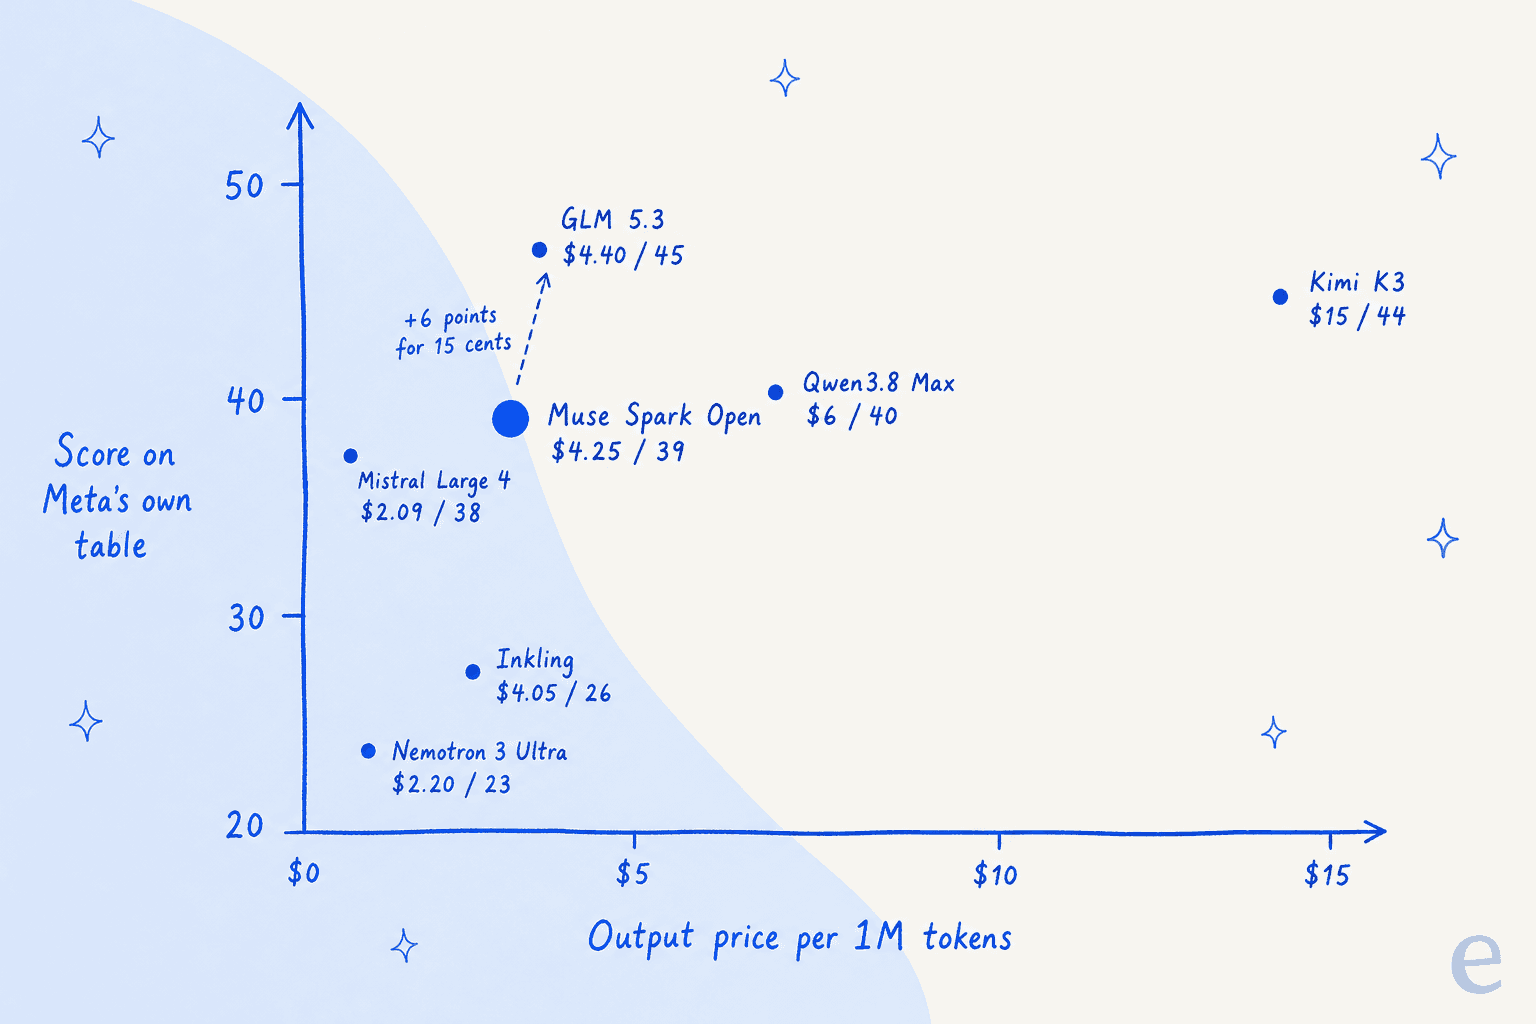
Das Diagramm ist das ganze Argument in einem Bild. Muse Spark Open liegt bei Preis und Punktzahl im Mittelfeld. GLM 5.3 sitzt fast direkt darüber. Kimi K3 erkauft sich ein paar Punkte mit einer viel höheren Rechnung, und Mistral Large 4 ist bei ungefähr gleicher Punktzahl günstiger, aber vorerst nur über eine Preview-API.
Welche Alternative passt zu Ihrem Grund für den Wechsel?
Die meisten verlassen Muse Spark Open nicht für "ein besseres Modell" im Allgemeinen. Sie gehen aus einem ganz bestimmten Grund. Wählen Sie Ihren, und die passende Empfehlung erscheint darunter.
Wählen Sie den Grund, der Sie von Muse Spark Open wegtreibt, und sehen Sie die Alternative, die ich zuerst testen würde. Alle Zahlen stammen von den unten genannten Anbieterseiten und aus Metas Tabelle.
1. GLM 5.3
Am besten für: Teams, die ein direktes Upgrade gegenüber Muse Spark Open zu fast gleichem Preis und mit leichterer Lizenz wollen.
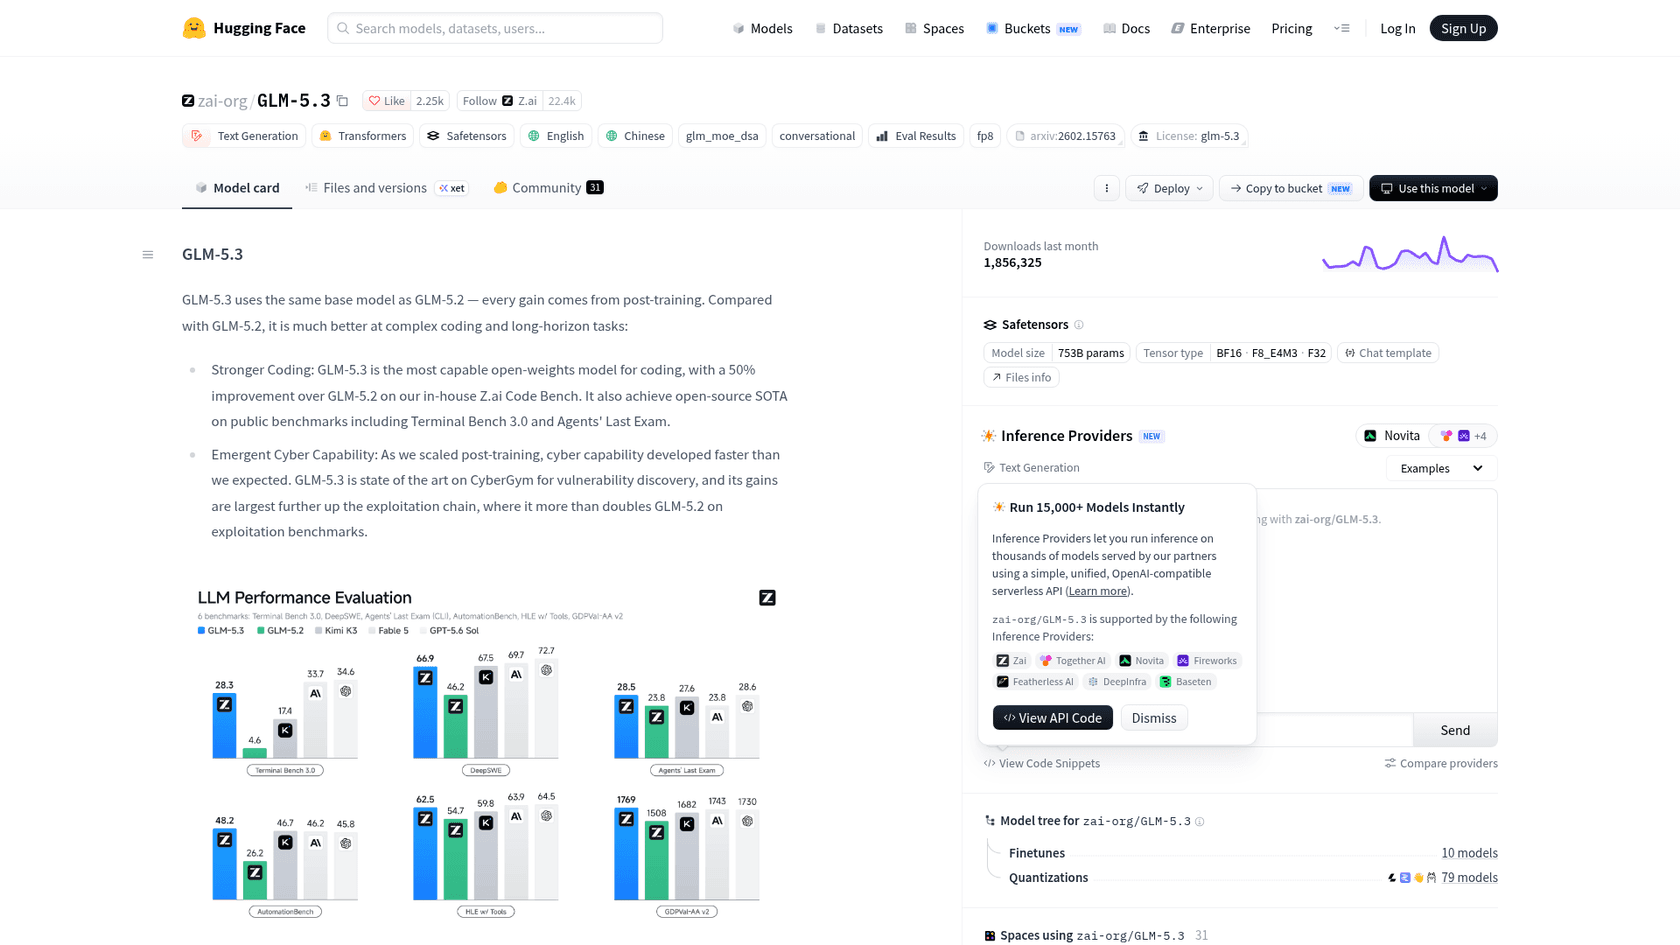
GLM 5.3 ist Z.ais Flaggschiff, gestartet am 14. August 2026. Es ist ein Mixture-of-Experts mit 744B Parametern und 40B aktiven, laut Z.ais GLM-5-Download-Tabelle, mit 1M Tokens Kontext und bis zu 128K Tokens Ausgabe. Es ist dasselbe Basismodell wie GLM-5.2, und die Modellkarte sagt "every gain comes from post-training." Verwechseln Sie es nicht mit dem kleineren GLM 5.3 Flash, das eine andere 320B-Basis hat.
Worin es Muse Spark Open schlägt. In Metas eigener Tabelle hat GLM 5.3 die höchste Intelligence-Index-Punktzahl aller offenen Modelle (45 vs. 39), den besten GDPVal-AA-v2-Wert (1653 vs. 1401) und liegt vorn bei HLE mit Tools (62,5 vs. 61,0), DeepSWE (67 vs. 60) und Terminal-Bench 2.1 (83,9 vs. 76,4). Es lehnt außerdem weit weniger harmlose Anfragen ab (FORTRESS Over-Refusal 3,2 vs. 17,4).
Wo es zurückfällt. Es ist reines Text-Modell, also gibt es keine Bild-, Audio- oder Videoeingabe. Reasoning lässt sich nicht abschalten; die Z.ai-Dokumentation sagt "disabling reasoning is no longer supported," und die Aufwandsstufen sind niedrig, hoch und max. Bei MCP-Atlas verliert es gegen Muse Spark Open (84,2 vs. 89,2) und lässt sich viel leichter jailbreaken (StrongREJECT 62,9 vs. 0,5).
"Feels dumber than GLM 5.3 (only open model I use extensively). But is really fast (fireworks.ai)."
Preis und Lizenz. Z.ais Preisseite listet GLM 5.3 mit 1,40 $ pro Million Input-Tokens, 0,26 $ gecached und 4,40 $ Output, unverändert seit dem Launch. Das sind bei Input und Output jeweils 15 Cent mehr als bei Muse Spark Open. Die GLM-5.3 License ist MIT-ähnlich mit einer Bedingung: Ein Modell-Hosting-Unternehmen, dessen Konzernumsatz 10 Milliarden Dollar übersteigt, muss Z.ais Sicherheitsprüfung durchlaufen. Produkte, die das Modell in eine Funktion einbetten, sind von dieser Definition ausgenommen, und es gibt keine Anzeigepflicht.
| Tarif | Input pro 1M | Gecachter Input pro 1M | Output pro 1M |
|---|---|---|---|
| GLM 5.3 | 1,40 $ | 0,26 $ | 4,40 $ |
| GLM 5.3 FlashX | 0,37 $ | 0,075 $ | 1,25 $ |
| GLM 5.3 Flash | 0,15 $ | 0,03 $ | 0,50 $ |
Fazit: Das ist die Alternative, die ich zuerst testen würde. Wenn Sie keine multimodale Eingabe brauchen, bietet GLM 5.3 eine höhere Punktzahl, weniger Ablehnungen und eine lockerere Lizenz für 15 Cent mehr pro Million Tokens. Lassen Sie es nur aus, wenn Bilder, Audio oder die Genauigkeit beim Tool-Calling der Kern Ihres Workloads sind.
2. Kimi K3
Am besten für: Coding-Agenten und multimodale Arbeit, bei denen Qualität wichtiger ist als die Token-Rechnung.
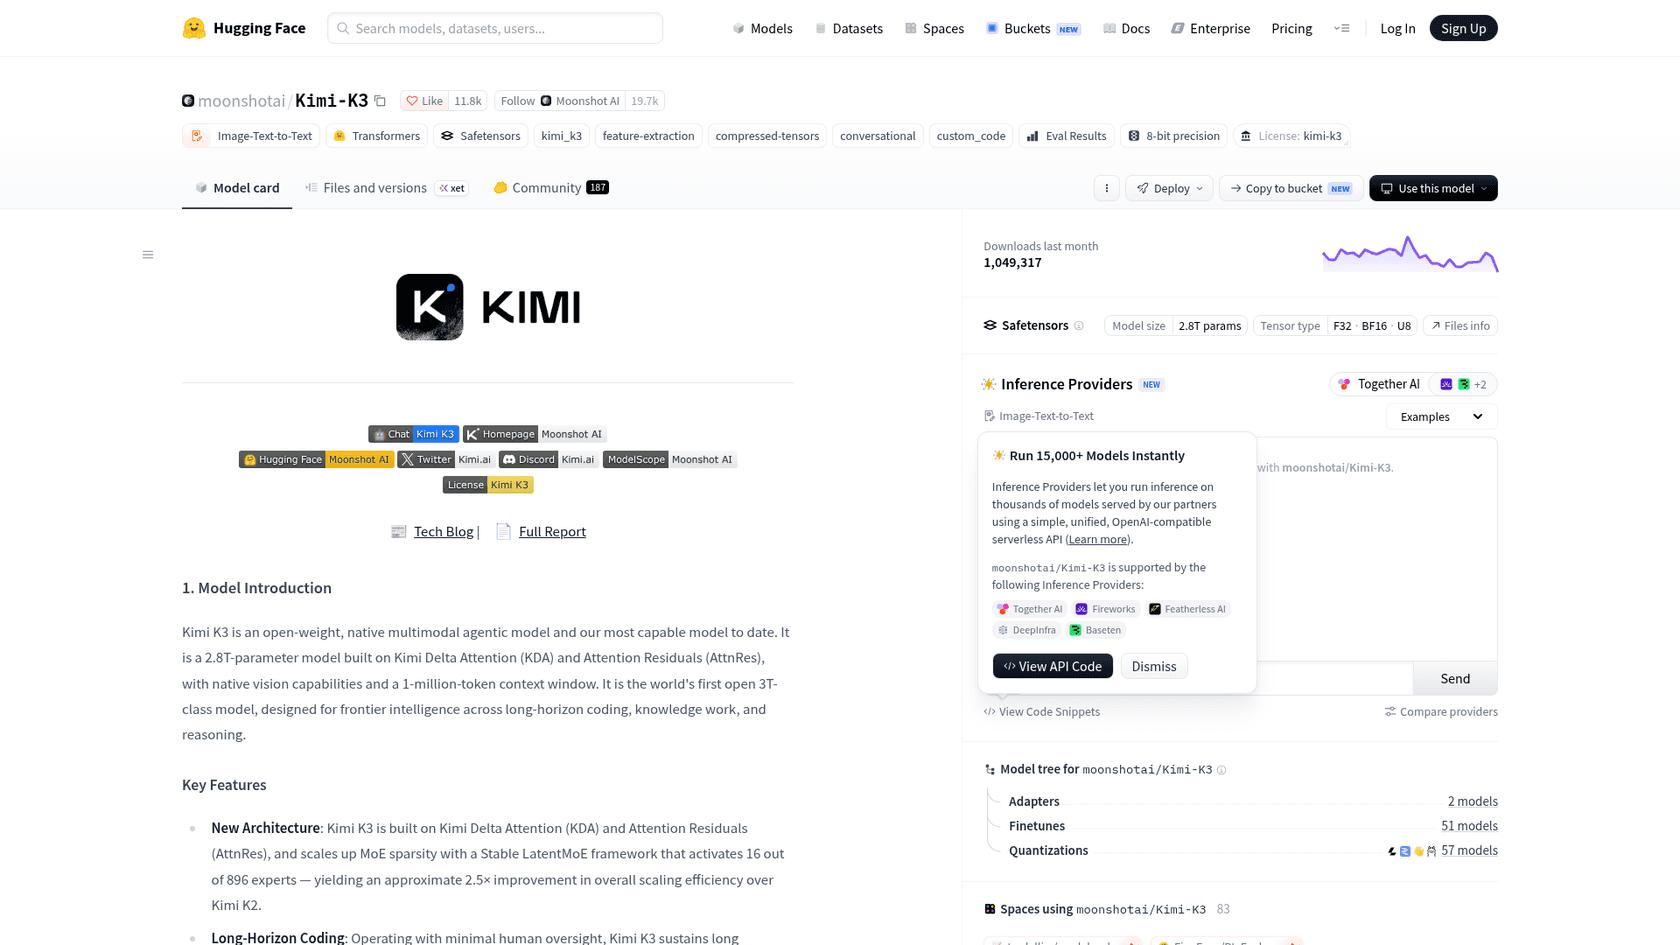
Kimi K3 ist das Flaggschiff von Moonshot AI, veröffentlicht im Juli 2026 mit Gewichten auf Hugging Face. Es ist das größte Modell hier: 2,8T Parameter insgesamt, 104B aktiv, 896 Experten, von denen 16 pro Token ausgewählt werden. Es liest Text, Bilder und Video nativ und hat 1M Tokens Kontext, mit einer Ausgabe, die laut K3-Quickstart bis zu 1.048.576 Tokens konfigurierbar ist.
Worin es Muse Spark Open schlägt. Kimi K3 ist in Metas Tabelle der Coding-Spitzenreiter: DeepSWE 68 vs. 60, SWE-Atlas-QnA 66 vs. 58, Terminal-Bench 2.1 85,0 vs. 76,4. Es gewinnt außerdem bei OSWorld Verified (84,8 vs. 80,4), Toolathlon (76,5 vs. 72,8) und beim Video-Benchmark VideoMMEv2 (65,4 vs. 61,5). Es hat mit 2,7 den niedrigsten Over-Refusal-Wert des Feldes.
Wo es zurückfällt. Muse Spark Open schlägt es bei MCP-Atlas (89,2 vs. 82,3), JobBench (61,8 vs. 54,3) und Sicherheit. Metas Karte berichtet, dass Kimi K3 in Metas internem Cyber-Benchmark nur 75,5 % der Jailbreaks abgelehnt hat, gegenüber 99,2 % bei Muse Spark Open. Reasoning lässt sich nicht abschalten, und die API akzeptiert keine öffentlichen Bild-URLs, nur base64 oder hochgeladene Datei-IDs.
Preis und Lizenz. Moonshots Preisseite listet 3,00 $ pro Million Input-Tokens, 0,30 $ gecached und 15,00 $ Output, pauschal über den gesamten 1M-Kontext. Ein neues Detail: Cache-Schreibvorgänge werden jetzt separat abgerechnet, mit 3,00 $ pro Million für einen 5-Minuten-Cache und 6,00 $ für einen 1-Stunden-Cache. Die Kimi K3 License ähnelt beim Thema Hosting der von Muse Spark Open (eine separate Vereinbarung für Modell-Hosting-Unternehmen mit über 20 Millionen Dollar pro Jahr), aber ihre Anzeigepflicht greift erst ab 100 Millionen monatlichen Nutzern oder 20 Millionen Dollar Monatsumsatz.
"I believe it's because they are below $20 Million revenue limit (which Kimi K3's license has) So we won't see any price decrease unless Kimi changes the license of K3"
Fazit: Kimi K3 ist die Wahl, wenn Coding-Werte das Projekt entscheiden. Es kostet das 3,5-Fache des Output-Preises von Muse Spark Open, deshalb würde ich es nur für die Aufgaben nehmen, die es brauchen, und alles andere an etwas Günstigeres leiten. Meine Aufschlüsselung der Kimi K3 Preise enthält die Kostenrechnung.
3. Qwen3.8
Am besten für: Teams, die eine Modellfamilie wollen, die von einem einzelnen Mac bis zum gehosteten Flaggschiff skaliert.
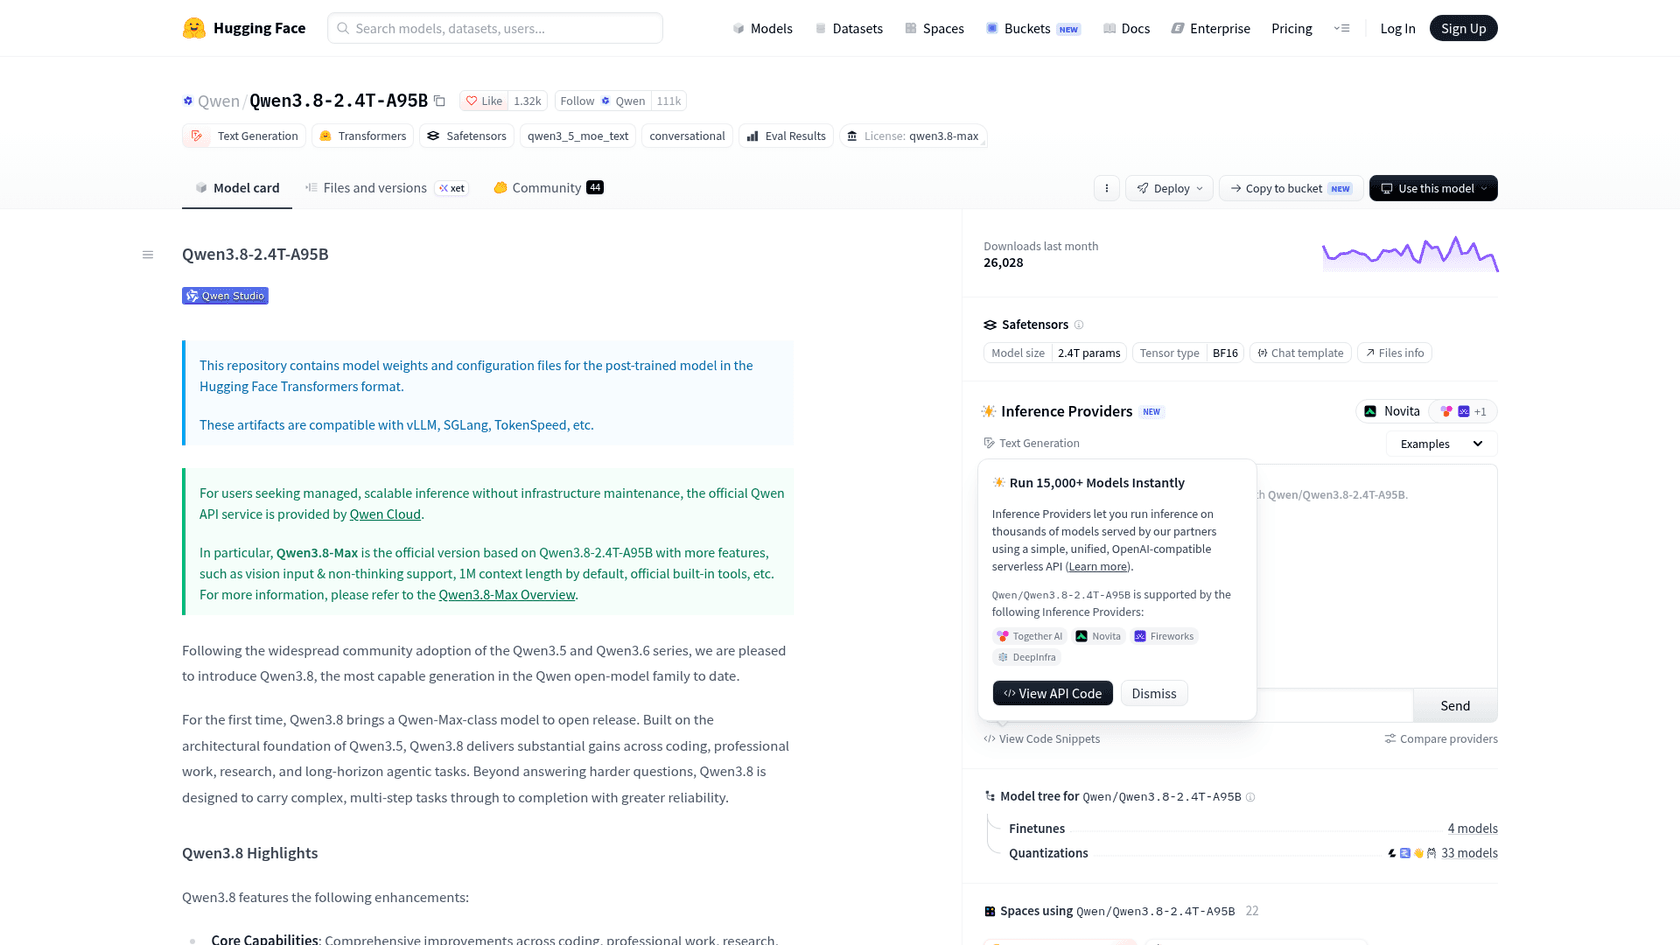
Qwen3.8 besteht eigentlich aus zwei offenen Veröffentlichungen. Das große Qwen3.8-2.4T-A95B ist ein Mixture-of-Experts mit 2,4T Parametern und 95B aktiven. Sein Kontext beträgt nativ 262.144 Tokens, erweiterbar auf etwa 1M. Das kleine Qwen3.8-27B ist ein dichtes 27B-Modell, das Bilder und Video liest und sich das Thinking pro Anfrage abschalten lässt. Das gehostete Qwen3.8 Max basiert auf der großen Basis, ergänzt um Vision, einen Non-Thinking-Modus und eingebaute Tools.
Worin es Muse Spark Open schlägt. In Metas Tabelle erreicht die offene 2.4T-Basis im Intelligence Index 40 Punkte (einen Punkt vorn), teilt sich mit Kimi K3 den besten GPQA-Diamond-Wert (93,5 vs. 89,0) und schlägt Muse Spark Open bei Terminal-Bench 2.1 (82,0 vs. 76,4), SWE-Atlas-QnA (62 vs. 58) und GDPVal-AA v2 (1613 vs. 1401). Das 27B-Modell ist die eigentliche Überraschung: Apples MLX-Benchmarks zeigen, dass es bei einem Kontext von 65.536 Tokens mit bis zu 68 GB Speicher auf einen Mac Studio passt.
Wo es zurückfällt. Die offene 2.4T-Basis ist enger gefasst, als viele erwarten. Die Modellkarte sagt, sie "is a text-only model that requires thinking mode for all interactions," also gehören die Vision- und Non-Thinking-Funktionen nur zum gehosteten Max. Sie liegt bei MCP-Atlas (84,5 vs. 89,2), JobBench (52,7 vs. 61,8) und HLE-Diamond (17,3 vs. 26,1) hinter Muse Spark Open.
"From running small models like Qwen3.8-27B to large models like Qwen3.8-2.4T. I can tell you that small models will never be enough or match up. Everyone will want the smartest model, not just a good enough model."
Preis und Lizenz. Alibaba verkauft die offene Basis nicht direkt. Der gehostete Weg ist Qwen3.8 Max auf QwenCloud für 2 $ Input und 6 $ Output pro Million Tokens, mit impliziten Cache-Treffern für 0,25 $. Das 27B-Modell hat jetzt eine eigene Hosting-Seite mit 0,50 $ Input und 3 $ Output. Die 2.4T-Basis erscheint unter der Qwen3.8 License, mit einer Anzeigepflicht ab 100 Millionen monatlichen Nutzern oder 20 Millionen Dollar Monatsumsatz und einer separaten Lizenz für Modell-Hosting- oder KI-Arbeitsassistenten-Unternehmen über 50 Millionen Dollar. Das 27B-Modell steht schlicht unter Apache 2.0.
| Modell | Input pro 1M | Gecachter Input pro 1M | Output pro 1M | Lizenz |
|---|---|---|---|---|
| Qwen3.8 Max (gehostet) | 2,00 $ | 0,25 $ (implizit) | 6,00 $ | Nur gehostet |
| Qwen3.8-27B (gehostet) | 0,50 $ | 0,10 $ (implizit) | 3,00 $ | Apache 2.0 |
| Qwen3.8-2.4T-A95B | Self-Hosting oder Drittanbieter | k. A. | k. A. | Qwen3.8 License |
Fazit: Qwen3.8 ist die Wahl für die ganze Familie. Nutzen Sie das 27B-Modell dort, wo Sie ein kleines Muse-Modell auf einem Laptop oder einem Mac eingesetzt hätten, und das gehostete Max, wenn Sie das große brauchen. Wenn Sie die 2.4T wegen der offenen Gewichte wollen, denken Sie daran, dass sie nur Text kann. Für direkte Vergleiche siehe Qwen3.8 Max vs. Kimi K3.
4. DeepSeek V4.1 Flash
Am besten für: Workloads mit hohem Volumen, bei denen die Token-Kosten alles entscheiden.
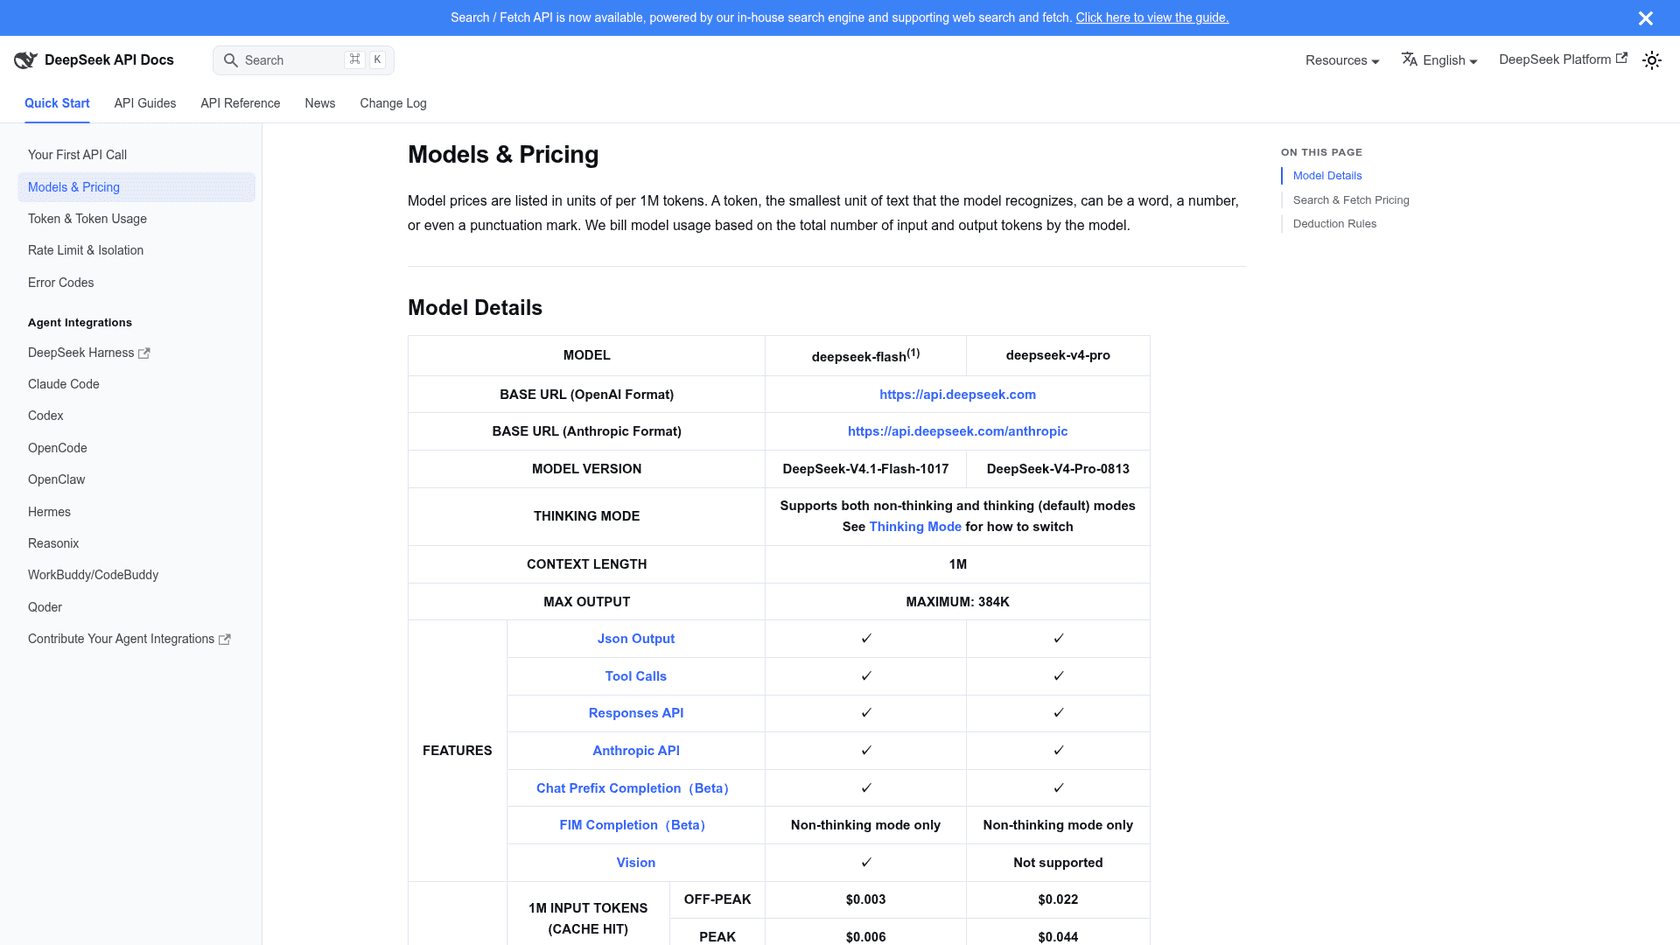
DeepSeek V4.1 Flash startete am 10. September 2026 und erhielt am 17. Oktober ein Update: DeepSeek-V4.1-Flash-1017, das DeepSeek als mit "stronger benchmark performance, faster task completion, and shorter outputs than the previous version" beschreibt. Es ist ein Mixture-of-Experts mit 552B Parametern und einer ungewöhnlichen Aufteilung: 8B aktive Parameter zum Lesen der Eingabe und 16B zum Schreiben der Ausgabe, laut den Launch-Notizen. Es hat 1M Kontext, bis zu 384K Output-Tokens und Vision-Eingabe.
Worin es Muse Spark Open schlägt. Beim Preis, und zwar deutlich. Und auf DeepSeeks eigener Karte für das 1017-Release steigt DeepSWE v1.1 auf 77,0, was jedes Modell in Metas Tabelle schlagen würde, wobei das eine Herstellerzahl aus einer anderen Testumgebung ist. DeepSeek ist nicht in Metas Vergleich enthalten. Ein Kommentator im Launch-Thread zu Muse Spark Open verwies darauf, dass Artificial Analysis das vorherige V4.1 Flash auf dieselbe Punktzahl wie Muse Spark Open setzt:
"Crucially, it's about the same as DeepSeek v4.1 Flash, and about 10x more expensive to run...
No thanks..."
Wo es zurückfällt. Reasoning-Tokens werden als Output abgerechnet, und Thinking ist standardmäßig aktiv, sodass ein günstiger Preis bei langen Antworten trotzdem zu einer hohen Rechnung werden kann. Die Bedingungen der bezahlten API sagen nichts dazu, ob DeepSeek mit Ihren Eingaben trainiert, und es gibt keine veröffentlichte Zero-Retention-Option, was relevant ist, wenn Sie Kundendaten an die API des Herstellers schicken wollen. Wer die MIT-Gewichte selbst oder über einen Drittanbieter hostet, umgeht diese Frage.
Preis und Lizenz. Die DeepSeek-Preisseite nennt zwei Tarife. Stoßzeiten sind werktags 01:00-04:00 und 06:00-10:00 UTC; alles andere ist Off-Peak zum halben Preis.
| Tarif | Input bei Cache-Treffer pro 1M | Input bei Cache-Fehlschlag pro 1M | Output pro 1M |
|---|---|---|---|
| Off-Peak | 0,003 $ | 0,15 $ | 0,60 $ |
| Peak | 0,006 $ | 0,30 $ | 1,20 $ |
Die Gewichte stehen unter MIT: Copyright-Hinweis beibehalten, mehr nicht. Keine Umsatzschwellen, keine Anzeigepflicht.
"I've been using DS v4.1 Flash daily for nearly a month now on Agent Swarm experiments. I've tested it against GLM-5.3-flash and Opus 5.5. DS 4.1 comes out tops for me. Opus 5.5 is still the smartest, but DS 4.1's speed and price more than make up for the "intelligence" gap."
Fazit: Wenn Sie Muse Spark Open millionenfach pro Tag aufrufen wollten, lassen Sie dasselbe Testset zuerst auf DeepSeek V4.1 Flash laufen. Bei 0,60 $ pro Million Output-Tokens außerhalb der Stoßzeiten ist es etwa 7x günstiger, unter der permissivsten Lizenz dieser Liste. Siehe DeepSeek V4.1 Flash Preise für die Rechnung zu Stoßzeiten.
5. gpt-oss-120b
Am besten für: Teams, die auf einer GPU selbst hosten müssen, und alle, die eine günstige Referenz wollen, gegen die sie größere Modelle testen.
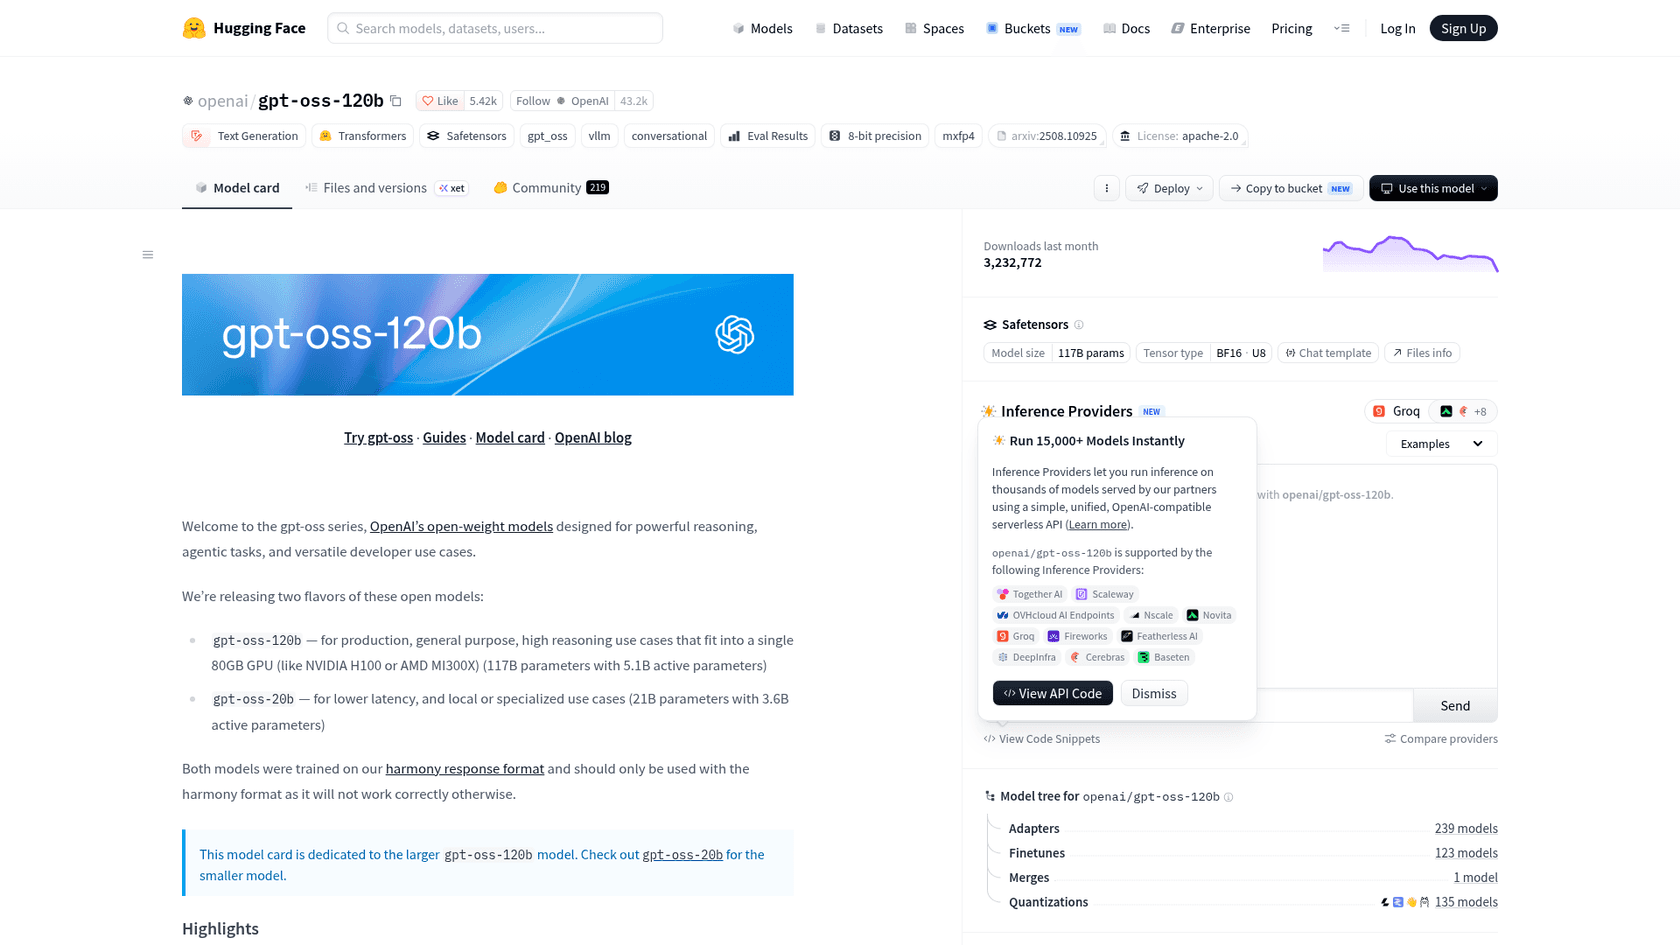
gpt-oss-120b ist OpenAIs Open-Weight-Modell von August 2025. Es hat 117B Parameter insgesamt, davon nur 5,1B aktiv pro Token, und ist so quantisiert, dass es "on a single 80GB GPU (like NVIDIA H100 or AMD MI300X)" läuft, laut Modellkarte. Es kann nur Text, hat 128K Kontext und drei Reasoning-Stufen (niedrig, mittel, hoch), die im System-Prompt gesetzt werden.
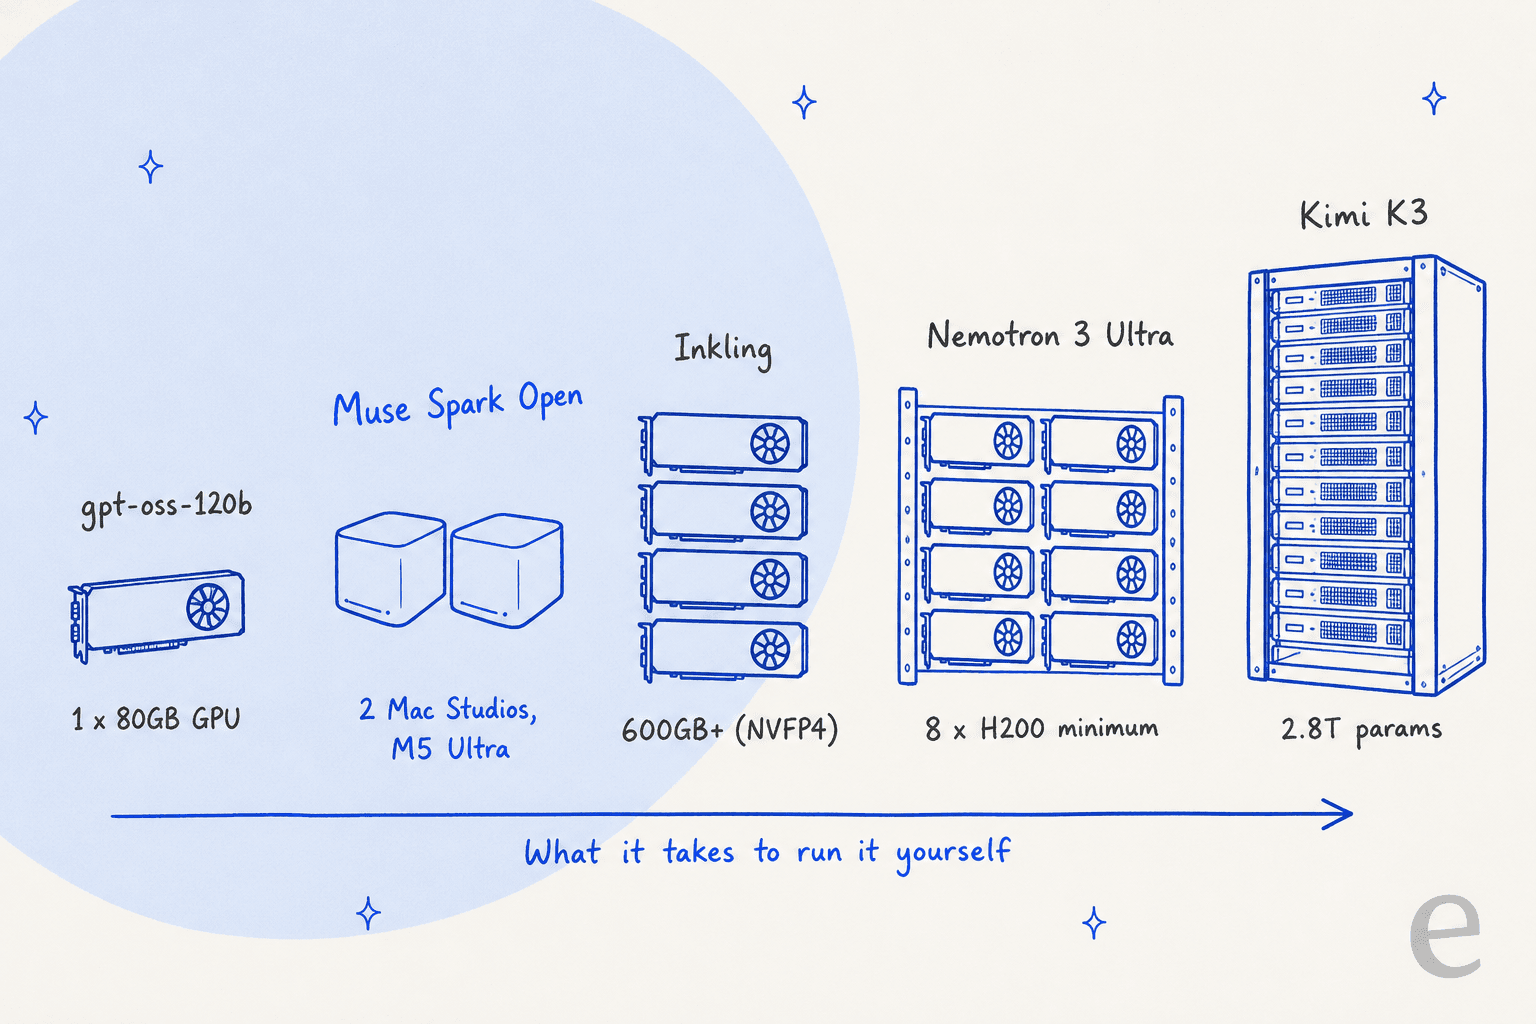
Worin es Muse Spark Open schlägt. Bei Hardware und Kosten. Muse Spark Open braucht laut Apple zwei Mac Studios mit jeweils bis zu 512 GB Speicher; gpt-oss-120b braucht eine Karte. Damit ist es die eine Alternative hier, die ein kleines Team realistisch auf einem eigenen Server oder in einem privaten Cloud-Konto betreiben kann.
Wo es zurückfällt. Es ist 14 Monate alt, und OpenAI hat seither kein neueres gpt-oss-Modell veröffentlicht; die späteren Releases sind Sicherheitsklassifikatoren. Es steht nicht in Metas Vergleichstabelle, und der 128K-Kontext ist ein Achtel von dem bei Muse Spark Open. Außerdem funktioniert es nur mit OpenAIs Harmony-Antwortformat richtig; die Karte sagt, es "will not work correctly otherwise."
"The finding that flips the usual story is the sparse-MoE reversal: on gpt-oss-120b the A100 comes in cheaper per output token than the H100, because the workload is latency-tolerant and the MXFP4 experts fit in 80GB."
Preis und Lizenz. OpenAI verkauft es nicht, daher stammen die gehosteten Preise von Anbietern. Together AIs Preisseite listet 0,15 $ Input und 0,60 $ Output pro Million Tokens, derselbe Preis wie DeepSeeks Off-Peak-Tarif. Die Lizenz ist Apache 2.0, und die Nutzungsrichtlinie besteht aus einer Zeile darüber, sich an das Gesetz zu halten.
Fazit: gpt-oss-120b wird Muse Spark Open bei schwierigen Agentenaufgaben nicht erreichen, und ich würde nichts anderes behaupten. Aber es ist das richtige Kontrollmodell: Lassen Sie Ihre Evaluation zuerst darauf laufen, und Sie wissen, wie viel von Muse Spark Open's zusätzlicher Größe Sie tatsächlich nutzen. Hosts wie Together AI und Groq bieten es beide an.
6. Mistral Large 4
Am besten für: Europäische Teams, die ein in der EU trainiertes und gehostetes Modell wollen und ein paar Wochen auf Gewichte warten können.
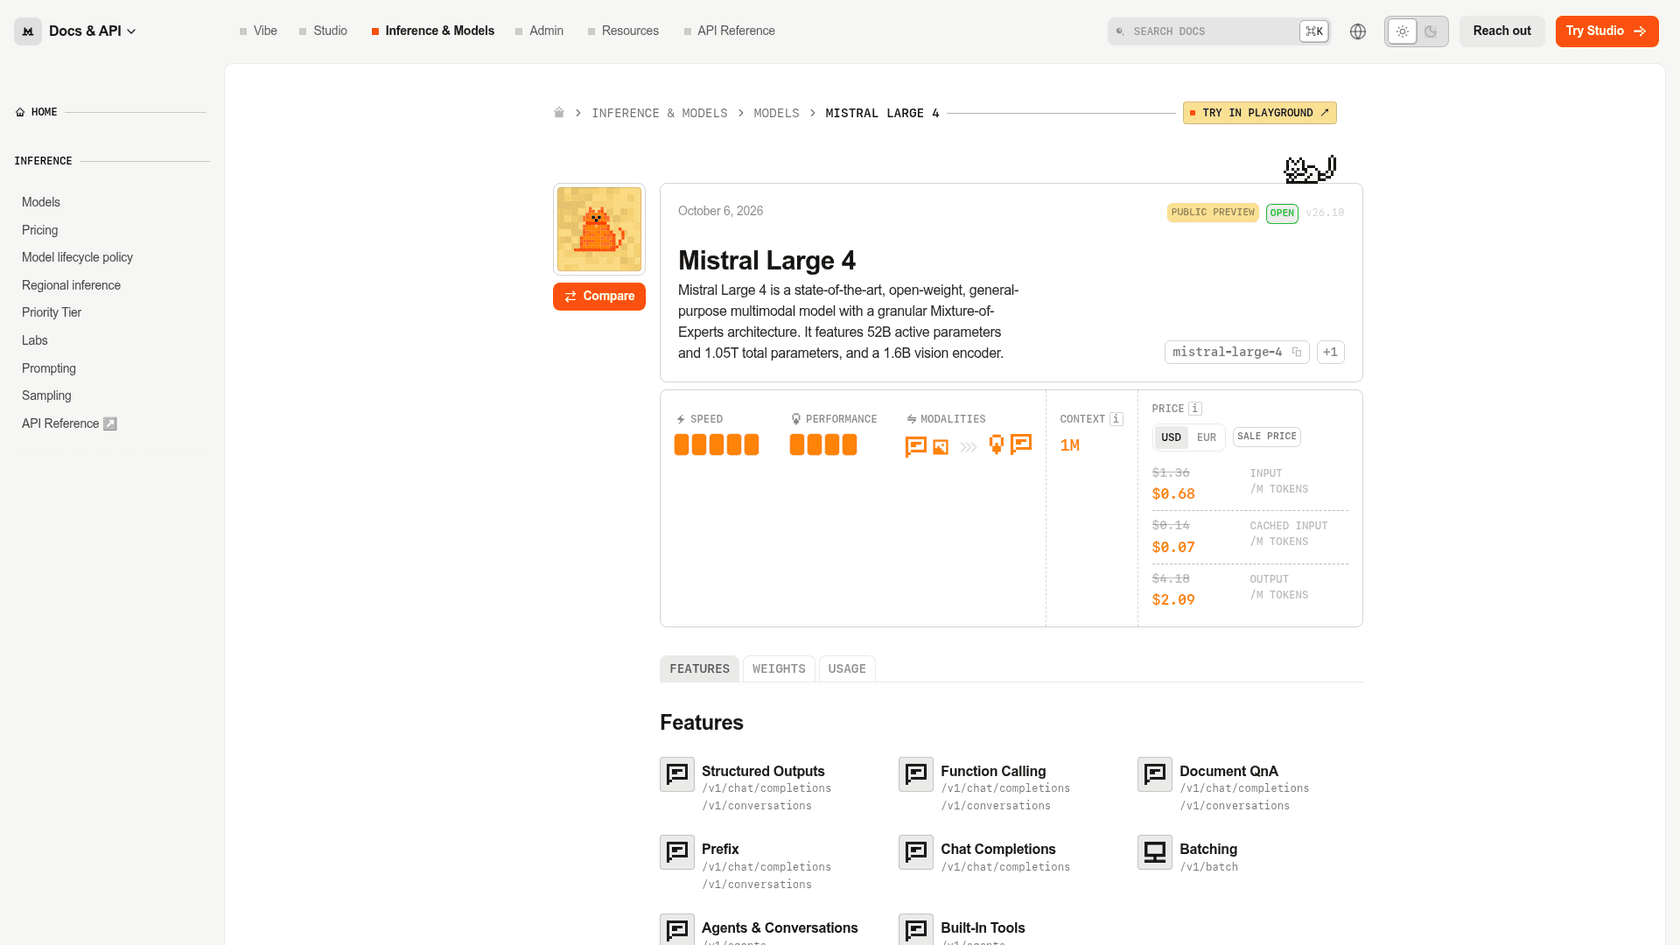
Mistral Large 4 ging am 6. Oktober 2026 in die öffentliche Preview. Die Modellkarte nennt 1,05T Parameter insgesamt, 52B aktiv und einen 1,6B-Vision-Encoder, mit 1M Kontext. Mistral hat es laut Launch-Beitrag auf 3.800 NVIDIA-Grace-Blackwell-GPUs in eigenen europäischen Rechenzentren trainiert.
Worin es Muse Spark Open schlägt. Beim Preis und beim europäischen Aspekt. Es erreicht in Metas Tabelle 38 Punkte, einen Punkt hinter Muse Spark Open, bei halbem Output-Preis während der Aktion. Es liegt außerdem knapp vorn bei DeepSWE (62 vs. 60), SWE-Atlas-QnA (59 vs. 58) und GDPVal-AA v2 (1424 vs. 1401).
Wo es zurückfällt. Stand 18. Oktober sind die Gewichte nicht veröffentlicht. Es gibt kein Mistral-Large-4-Repository auf Hugging Face, und der Launch-Beitrag sagt weiterhin "we will release the weights by the end of the month." Es wurde keine Lizenz benannt, also würde ich nicht von Apache 2.0 ausgehen. Sein AA-Omniscience-Wert in Metas Tabelle ist -5, der einzige negative Wert im Feld, gegenüber 25 bei Muse Spark Open.
"I created a brand new programming language to test LLM models on. It looks like Mistral Large 4 fares about as well as Kimi K3 and Claude Sonnet 5.5. Though it is much slower than Sonnet 5.5 and more expensive than both of those."
Preis und Lizenz. Mistrals Preisseite zeigt einen 50-%-Rabatt ohne Enddatum: 0,68 $ Input, 0,07 $ gecached und 2,09 $ Output pro Million Tokens, gegenüber einem Listenpreis von 1,36 $, 0,14 $ und 4,18 $. Die Lizenz ist nicht angekündigt.
Fazit: Eine faire Wahl, wenn EU-Training und -Hosting Pflicht sind, und der Aktionspreis schlägt Muse Spark Open heute. Aber es ist noch keine Open-Weight-Alternative. Schauen Sie nach dem 31. Oktober wieder vorbei, bevor Sie einen Self-Hosting-Plan darauf aufbauen. Mein Beitrag zu den Mistral Large 4 Preisen verfolgt die Aktion.
7. Nemotron 3 Ultra
Am besten für: Teams, die nicht nur die Gewichte, sondern auch die Trainingsdaten und das Rezept brauchen, unter einer permissiven US-Lizenz.
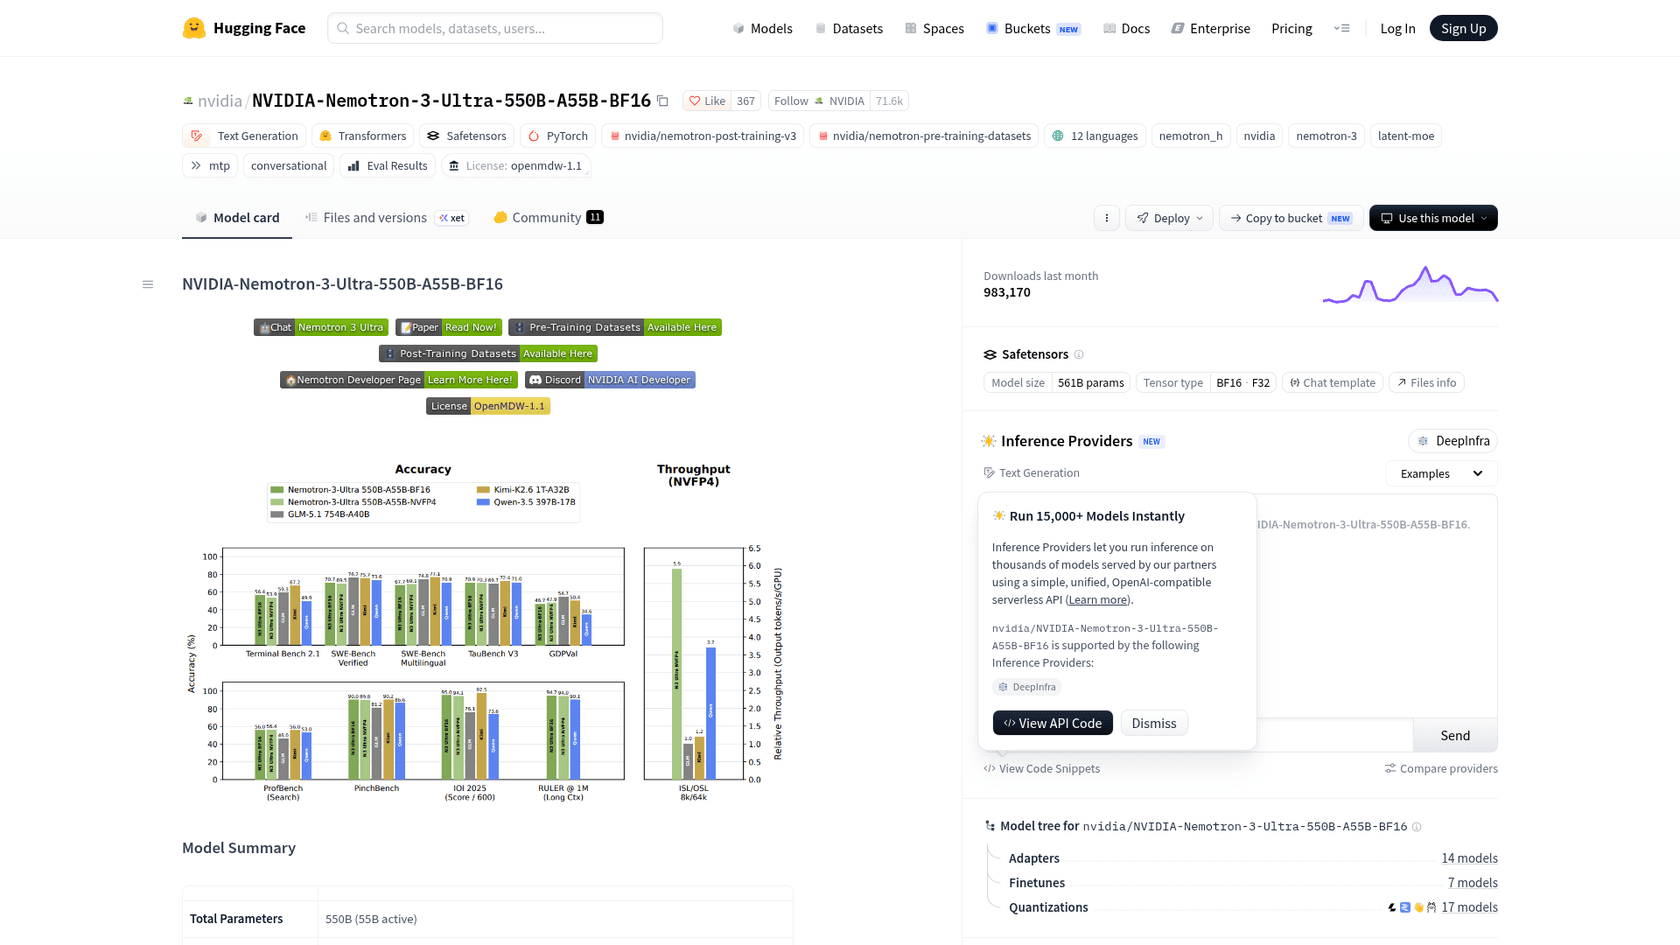
Nemotron 3 Ultra ist NVIDIAs größtes offenes Modell, veröffentlicht am 4. Juni 2026. Es hat 550B Parameter insgesamt mit 55B aktiven, eine Mischung aus Mamba-2-Schichten, Attention und Mixture-of-Experts. Es kann nur Text, und Reasoning wird im Chat-Template ein- oder ausgeschaltet.
Worin es Muse Spark Open schlägt. Bei der Offenheit. NVIDIA veröffentlicht die Pre-Training- und Post-Training-Datensätze, die RL-Umgebungen und einen technischen Bericht. Wenn Sie einem Prüfer erklären müssen, was in ein Modell eingeflossen ist, ist dies das einzige in der Liste, bei dem das geht. Auch die Lizenz ist leichter.
Wo es zurückfällt. Bei der Leistungsfähigkeit. Es erreicht in Metas Tabelle 23 Punkte, den niedrigsten Wert hier, und liegt bei jedem Benchmark, in dem beide vorkommen, hinter Muse Spark Open, darunter MCP-Atlas (63,1 vs. 89,2) und Terminal-Bench 2.1 (53,9 vs. 76,4). Die Karte sagt "up to 1M tokens," aber die ausgelieferte Konfiguration steht auf 262.144. Die Mindest-Hardware ist 8x H200 oder 16x H100.
"Each of the Nemotron 3 models were briefly competitive when they launched, but never exceptional, and less competitive with each scale up. The fact that it took so long for Nemotron 3 Ultra to launch really hampered its competitiveness. The Nemotron 3 series is extremely open about training recipes and training data, far more open than most open weight models, and that is valuable."
Preis und Lizenz. NVIDIAs Build-Seite bietet einen Test-Endpunkt ohne Preis pro Token. DeepInfra listet 0,50 $ Input, 0,10 $ gecached und 2,20 $ Output pro Million Tokens. Die Lizenz ist OpenMDW-1.1: Lizenz und Hinweise bei der Weitergabe beibehalten, und sie "does not impose any restrictions or obligations" auf Ausgaben.
Fazit: Wählen Sie Nemotron 3 Ultra wegen der Transparenz, nicht wegen eines klügeren Modells. Wenn Ihr Rechts- oder Forschungsteam die Trainingsdaten kennen muss, ist es die klare Wahl. Wenn Sie einfach die besten Antworten brauchen, nicht.
8. Inkling
Am besten für: Produkte mit Audio und Text, die ein Apache-2.0-Modell eines US-Labors wollen.
Inkling ist das erste Modell von Thinking Machines Lab, veröffentlicht am 15. Juli 2026. Es ist ein Mixture-of-Experts mit 975B Parametern und 41B aktiven, einem Kontext von 1M laut Modellkarte und Eingabe in Text, Bildern und 16-kHz-Audio. Ein kleineres Inkling Small (276B, 12B aktiv) folgte am 30. Juli.
Worin es Muse Spark Open schlägt. Bei der Lizenzklarheit: Die Gewichte stehen unter Apache 2.0, ohne Produkthinweis und ohne Umsatzklausel. Thinking Machines betreibt außerdem Tinker, eine gehostete Fine-Tuning-Plattform, sodass das Tuning mit eigenen Daten ein unterstützter Weg ist und kein Wochenendprojekt.
Wo es zurückfällt. Es erreicht in Metas Tabelle 26 Punkte, und Muse Spark Open schlägt es bei jedem gemeinsamen Benchmark, oft deutlich (JobBench 61,8 vs. 31,1, MCP-Atlas 89,2 vs. 76,0). Und obwohl die Gewichte unter Apache 2.0 stehen, verlinkt die Hugging-Face-Karte eine separate Acceptable Use Policy, die laut eigener Aussage jeden bindet, der herunterlädt. Sie verlangt, Nutzern zu sagen, dass sie mit einer KI sprechen, wo das wesentlich ist, was die meisten Support-Teams ohnehin tun.
"Very nice, multi modal, largest open weight model that supports audio. Would be interesting to see how good the audio capability is."
Preis und Lizenz. Der Preis ist gesunken. Die Serverless-Inference-Beta von Thinking Machines listet Inkling jetzt mit 1,00 $ Input, 0,17 $ gecached und 4,05 $ Output pro Million Tokens, Stand 14. Oktober, mit dem Hinweis "not yet recommended for intensive production use." Together AI berechnet dasselbe. Inkling Small kostet 0,30 $ Input und 1,20 $ Output.
Fazit: Inkling ist die Wahl, wenn Sie Audio-Eingabe unter Apache 2.0 brauchen. Muse Spark Open nimmt ebenfalls Audio an und erzielt viel höhere Werte, also entscheidet, ob der Hinweis "Built with Muse Spark Open" für Ihr Produkt funktioniert. Für einen genaueren Blick siehe meinen Inkling Review.
Das Kleingedruckte der Lizenzen im Vergleich
Die meisten Vergleiche hören bei den Benchmarks auf. Bei offenen Gewichten entscheidet die Lizenz, ob Sie überhaupt ausliefern dürfen, deshalb hier jede Verpflichtung auf einen Blick.
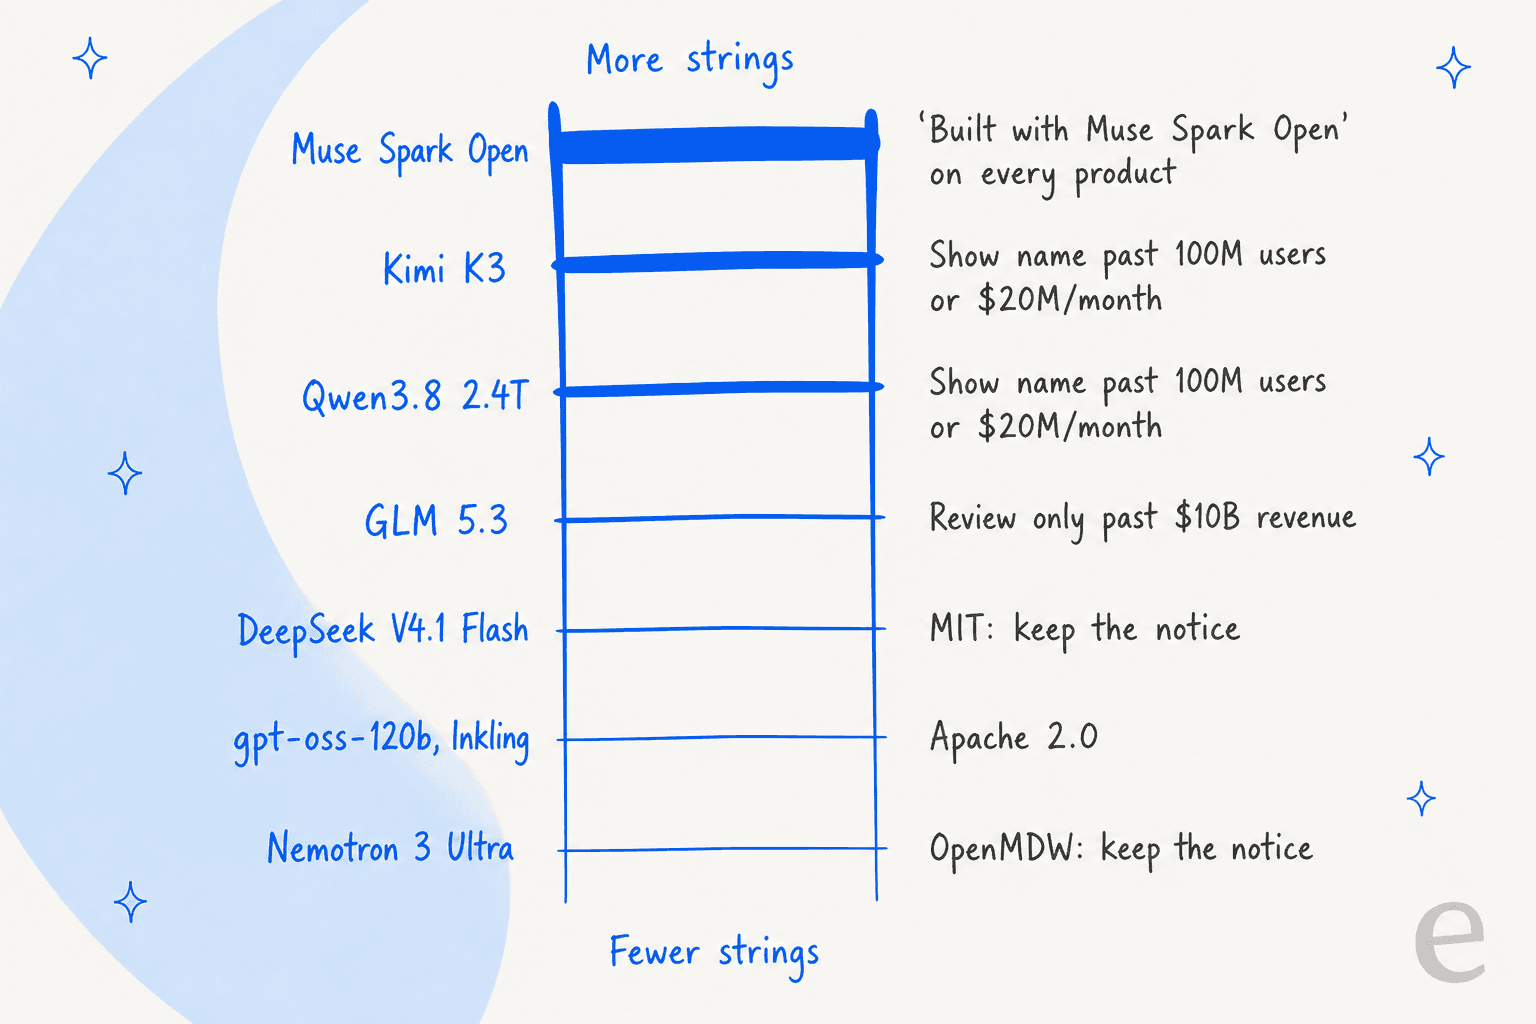
Überrascht hat mich, wie ungewöhnlich Metas Anzeigepflicht ist. Kimi K3 und Qwen3.8 verlangen ebenfalls, den Namen des Modells zu zeigen, aber erst ab 100 Millionen monatlichen Nutzern oder 20 Millionen Dollar Monatsumsatz. Muse Spark Open ist das einzige Modell hier, das von Tag eins an einen Hinweis in jedem Produkt verlangt. Seine Hosting-Klausel ist der von Kimi K3 ähnlich (20 Millionen Dollar pro Jahr), während GLM 5.3 die Schwelle bei 10 Milliarden Dollar setzt und nur eine Sicherheitsprüfung verlangt.
Nichts davon ist für ein typisches Produkt ein Ausschlusskriterium. Eine Zeile "Built with Muse Spark Open" in Ihrer Dokumentation oder im Einstellungsmenü erfüllt Metas Klausel. Aber wenn Sie für Kunden White-Label anbieten oder Inferenz weiterverkaufen, lesen Sie die Klausel mit Ihrem Anwalt, bevor Sie sich entscheiden.
Wie Sie zwischen ihnen wählen
Nachdem ich alle acht durchgearbeitet habe, ist das die Reihenfolge, in der ich für die meisten Teams testen würde:
- Beginnen Sie mit GLM 5.3 als direktem Ersatz. Gleiche Preisklasse, höhere Punktzahl, leichtere Lizenz.
- Fügen Sie DeepSeek V4.1 Flash als Kostencheck hinzu. Wenn es Ihre Evaluation besteht, haben Sie Ihre Rechnung gerade um etwa das 7-Fache gesenkt.
- Fügen Sie gpt-oss-120b als Untergrenze hinzu. Wenn es auch besteht, brauchen Sie für diese Aufgabe wahrscheinlich kein 700B+-Modell.
- Holen Sie Kimi K3 nur für die Coding- oder Vision-Aufgaben dazu, an denen die anderen scheitern.
- Behalten Sie Muse Spark Open für Tool-intensive Agenten, bei denen sein Vorsprung bei MCP-Atlas und die Jailbreak-Resistenz zählen, besonders bei allem Kundennahen, das sauber ablehnen muss.
Der Schritt, den die meisten Teams überspringen, ist die Evaluation selbst. Benchmarks sind Durchschnittswerte; Ihr Workload ist es nicht. Lassen Sie 100 Ihrer eigenen echten Aufgaben durch jeden Kandidaten auf einem Host wie Fireworks AI oder Baseten laufen, bevor Sie sich festlegen, und bewerten Sie sie jeweils gleich.
Wenn das Modell für den Kundensupport gedacht ist, ist das Modell die kleinere Entscheidung
Viele, die 2026 offene Gewichte evaluieren, tun das für einen Support-Bot. Allen sage ich dasselbe: Das Modell ist Infrastruktur. Der Mitarbeiter ist alles, was darauf aufbaut.
eesel betreibt seit Jahren KI in echten Support-Warteschlangen, und der Fehler, der am meisten wehgetan hat, hatte nichts mit der Modellwahl zu tun. Einige zahlende Kunden hatten einen Bot, der, wenn er in ihrer Wissensdatenbank nichts Relevantes fand, die Lücke aus den allgemeinen Trainingsdaten des Modells füllte und selbstbewusst falsche Antworten an echte Kunden schickte. Der Wechsel auf ein Modell mit höherer Punktzahl behebt das nicht. Ein harter Fallback, Grounding auf Ihren eigenen Quellen und Tests mit echten Tickets vor dem Launch tun es. Deshalb wird heute jeder eesel-Rollout gegen historische Tickets simuliert, bevor er irgendjemandem antwortet.
Wenn Sie also für ein Helpdesk zwischen GLM 5.3 und Muse Spark Open wählen, gibt es einen kürzeren Weg. Das KI-Helpdesk-Teammitglied von eesel verbindet sich mit Zendesk, Freshdesk oder Gorgias, lernt aus Ihren bisherigen Tickets und Ihrem Help Center und zeigt Ihnen, wie es die Tickets des letzten Monats beantwortet hätte, bevor es live geht. Eine ehrliche Einschränkung: eesel läuft auf gehosteten Frontier-Modellen von OpenAI, Anthropic und Google (aufgeführt auf der Sicherheitsseite), nicht auf diesen offenen Gewichten. Wenn das Self-Hosting des Modells eine harte Anforderung ist, passt eesel also nicht.
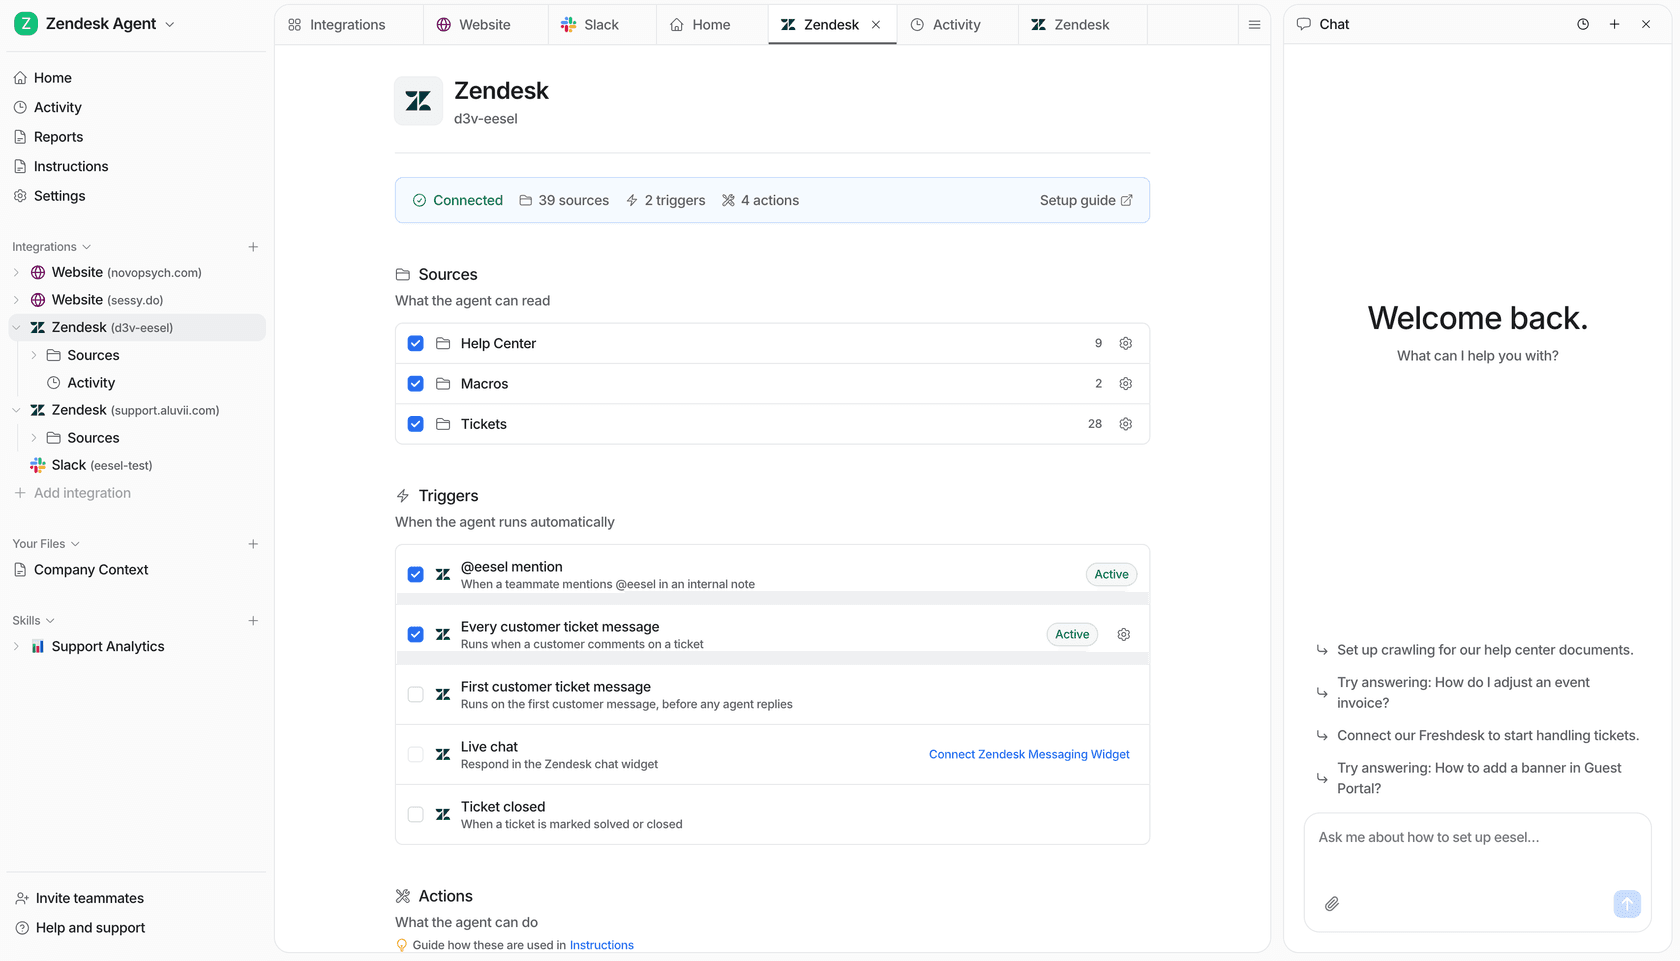
Wenn Sie zu den Teams gehören, die Modelllizenzen vergleichen, werden Sie es wahrscheinlich auch per Code steuern wollen. Die eesel CLI (@eesel/cli auf npm) betreibt dasselbe Teammitglied und denselben Workspace aus einem Terminal: Verbinden Sie ein Helpdesk mit eesel integrations connect, lesen und bearbeiten Sie die Standardanweisungen mit eesel instructions, genehmigen oder lehnen Sie ausstehende Aktionen mit eesel approvals ab und prüfen Sie mit eesel activity, was es getan hat. Jeder Befehl gibt JSON aus, Schreibbefehle unterstützen --dry-run, und Headless-Tokens funktionieren in CI, sodass ein Skript oder ein Coding-Agent wie Claude Code es genauso bedienen kann wie Sie. Jeder Workspace ist außerdem ein MCP-Server, was ich in MCP für den Kundensupport behandle.
Und wenn Ihr Open-Weight-Projekt eher um Inhalte als um Tickets geht: eesels anderes Teammitglied ist ein KI-Blog-Autor, der Beiträge wie diesen recherchiert, entwirft und illustriert.
eesel ausprobieren
Muse Spark Open, GLM 5.3 und die anderen sind Motoren. Wenn Sie eigentlich eine KI brauchen, die Ihre Kunden beantwortet, ist eesel ein Support-Teammitglied, das Ihr Help Center und Ihre bisherigen Tickets bereits kennt, in Minuten in Ihr bestehendes Helpdesk einsteigt und sich an den Tickets des letzten Monats beweist, bevor es ein Live-Ticket anfasst. Testen Sie eesel kostenlos, oder sehen Sie in meinem Überblick über die besten KI-Kundensupport-Agenten, wie Teams es vergleichen.