9 beste llama.cpp-Alternativen 2026, nach Hardware und Workload

Rama Adi

Katelin Teen
Zuletzt bearbeitet 14. November 2026
Die besten llama.cpp-Alternativen sind vLLM oder SGLang für viele Nutzer auf einem GPU-Server, MLX-LM auf einem Mac mit Apple Silicon und ExLlamaV3 für das meiste Modell auf einer einzelnen NVIDIA-Karte. Ollama, LM Studio, Jan und LocalAI sind freundlicher, aber sie laufen weiterhin auf llama.cpp darunter, sie ändern also die App, nicht die Engine. Mit llama.cpp bei v1.0.0 ist eine Person an einer Maschine oft besser dran, zu bleiben. Wenn das Ziel KI auf Support-Tickets ist, macht eesel das mit gehosteten Modellen, und seine CLI lässt einen Coding-Agenten Hilfeartikel hochladen und Antworten zuerst testen.
Warum suchen Leute nach llama.cpp-Alternativen?
Meist weil sie aus der Aufgabe herausgewachsen sind, für die llama.cpp gebaut wurde, nicht weil es schlechter wurde. llama.cpp ist die C/C++-Engine, die das Ausführen von Modellen auf gewöhnlicher Hardware normal gemacht hat, und sie ist immer noch die breiteste: Das Projekt-README listet Backends für CUDA, Metal, HIP, Vulkan, SYCL, reine CPU und mehr als ein Dutzend weitere, mit GGUF-Quantisierung von 1,5-Bit bis 8-Bit und CPU-plus-GPU-Offload für Modelle, die größer sind als dein VRAM. Es steht bei 135.056 GitHub-Stars unter MIT-Lizenz, und am 13. November 2026 veröffentlichte es v1.0.0, sein erstes Semver-Release, mit FP8-KV-Caches, einem Host-Memory-Cache für Mixture-of-Experts-Modelle und einer neu gestalteten Web-UI.
Ich arbeite an eesels Integrationen und APIs, also geht die meiste Zeit mit lokalen Engines in die langweiligen Teile: die API, die sie anbieten, wie sie sich bei mehreren Anfragen gleichzeitig verhalten, und was kaputtgeht, wenn man das Modell wechselt. Das prägt diese Liste. Ich habe die Docs, Release-Notes und Repos jedes Projekts dafür gelesen und Community-Berichte von Hacker News gesammelt, aber ich habe nicht alle neun auf einer Maschine benchmarkt, also behandle jede Geschwindigkeitsaussage unten als ihre, nicht meine.
Die Gründe, die Leute für den Wechsel nennen, bündeln sich in vier:
- Viele Nutzer gleichzeitig. llama.cpp ist großartig für eine Person und okay für wenige. Ein Team, das denselben Server trifft, ist der Punkt, an dem Batching-Engines die Nase vorn haben.
- Mac-Geschwindigkeit. Auf Apple Silicon ist Apples eigenes MLX-Framework oft der schnellere Weg.
- Spitzengeschwindigkeit auf einer bestimmten GPU. Engines mit Kerneln, die für die Hardware eines Herstellers geschrieben wurden, können eine portable Engine auf dieser Hardware schlagen.
- Eine App statt eines Builds. Nicht jeder will mit CMake kompilieren und Flags übergeben.
Die ersten drei sind echte Engine-Wechsel. Der vierte meist nicht, und das ist der Teil, den die meisten Vergleichsposts auslassen.
"While I think that llama.cpp is an outstanding project - a one-stop-shop to get almost any model to run on almost any hardware, you get a lot more speed from specialised inference engines with kernels made for your hardware."

Ist Ollama wirklich eine Alternative zu llama.cpp?
Nicht auf Engine-Ebene. Ollama, LM Studio, Jan und LocalAI laufen alle auf llama.cpp darunter für GGUF-Modelle, und mehrere von ihnen fügen MLX auf Macs hinzu. Sie ändern, wie du installierst, herunterlädst und Modelle verwaltest. Sie ändern nicht, wie Tokens erzeugt werden.
Die Beweise stehen auf ihren eigenen Seiten. Ollamas v0.40.16-Release-Notes listen "Updated llama.cpp". LM Studios Homepage sagt, es läuft "with MLX and llama.cpp under the hood." Jans API-Server-Docs beschreiben "local models powered by llama.cpp or MLX." LocalAI listet llama.cpp als eines von mehr als 80 Backends, direkt neben vLLM und MLX. Und das llama.cpp-Team bietet jetzt seine eigene Llama-Desktop-App an, einen 1-MB-Download für Mac und Windows.
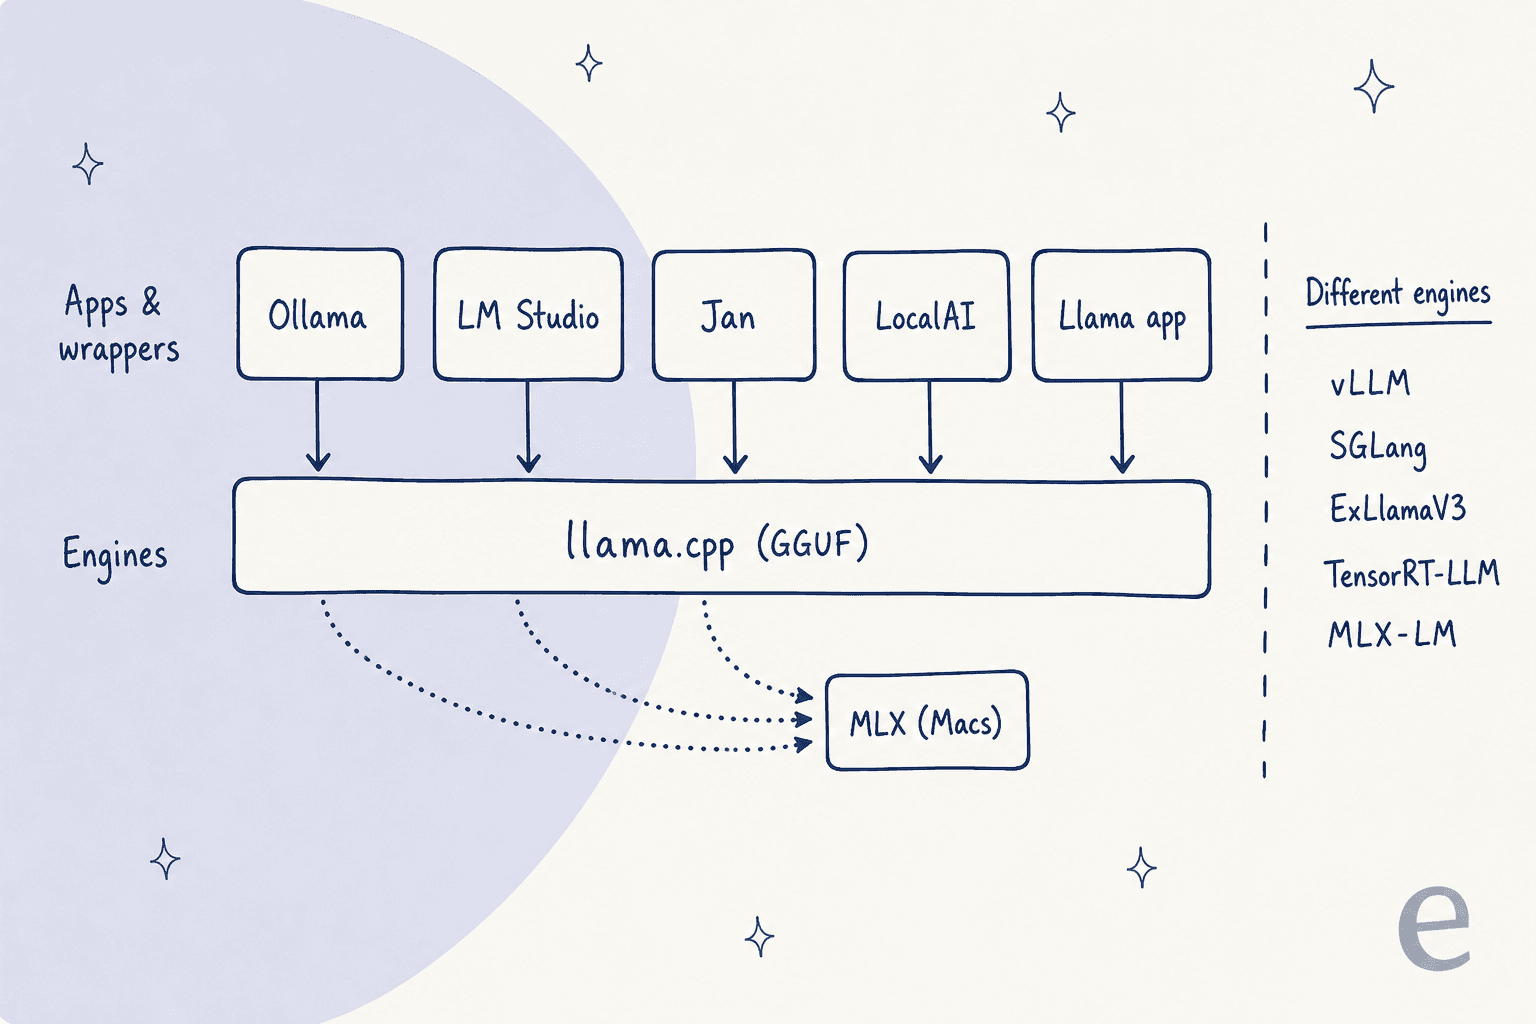
Diese Aufteilung entscheidet, wo du nachsehen solltest. Wenn du llama.cpp verlässt, weil dich Builds und Flags ermüden, ist eine App darüber die richtige Lösung, und du behältst alles, was schon funktioniert. Wenn du gehst, weil es für deinen Workload zu langsam ist, hilft dir eine App über derselben Engine nicht, und du willst eine der fünf in der rechten Spalte.
"There's also been some controversy over not giving proper credit to llama.cpp which ollama is/was a wrapper around."
Wie ich diese Alternativen ausgewählt habe
Ich bin von dem ausgegangen, was Käufer tatsächlich fragen. Als ich "What are the best llama.cpp alternatives?" in einem neuen Chat an ChatGPT stellte, nannte es neun Projekte und teilte sie in Inference-Engines und lokale LLM-Plattformen auf, also sind alle neun hier. Dann habe ich jedes gegen fünf Dinge geprüft:
- Engine oder Wrapper. Ersetzt es llama.cpps Inference, oder umhüllt es sie?
- Hardware und OS. NVIDIA, AMD, Apple Silicon, CPU; Linux, Windows, macOS.
- Modellformat. GGUF, MLX-Gewichte, EXL3 oder Hugging-Face-Safetensors.
- Serving. Eine OpenAI-kompatible API, und ob es viele Anfragen gut bündelt.
- Pflege. Neuestes Release-Datum, Lizenz und Stars aus dem GitHub-Repo jedes Projekts am 15. November 2026.
So reihen sie sich ein:
| Tool | Typ | Läuft llama.cpp darunter? | Hardware | OS | Hauptmodellformat | OpenAI-kompatible API | Viele Nutzer gleichzeitig | Lizenz | GitHub-Stars | Neuestes Release | Bezahlstufe |
|---|---|---|---|---|---|---|---|---|---|---|---|
| vLLM | Engine | Nein | NVIDIA, AMD, Intel, CPU, TPU über Plugin | Linux (WSL auf Windows) | Safetensors; GGUF experimentell | Ja, plus Anthropic-API | Stark | Apache-2.0 | 96.936 | v0.33.0 | Keine |
| SGLang | Engine | Nein | NVIDIA, AMD, TPU, Intel, Ascend, Mac über MLX | Hauptsächlich Linux | Safetensors; GGUF auf NVIDIA | Ja | Stark | Apache-2.0 | 38.874 | v0.5.23 | Keine |
| MLX-LM | Engine | Nein | Nur Apple Silicon | macOS | MLX-Gewichte | OpenAI-ähnlich, einfach | Leicht | MIT | 7.656 | v0.32.2 | Keine |
| ExLlamaV3 | Engine | Nein | NVIDIA; AMD 7900 und neuer | Linux, Windows | EXL3 | Über TabbyAPI | Dynamisches Batching | MIT (TabbyAPI AGPL) | 1.825 | v1.6.7 | Keine |
| TensorRT-LLM | Engine | Nein | NVIDIA-Rechenzentrums-GPUs | Linux | Safetensors, FP8/FP4 | Ja | Stark | NVIDIA Open Source | ~15.100 | v1.2.1 stable | Keine |
| Ollama | App + Server | Ja, plus MLX | NVIDIA, AMD, Apple | macOS, Windows, Linux | GGUF | Teilmenge, plus Anthropic-API | Moderat | MIT | 186.973 | v0.40.16 | Cloud ab 20 $/Monat |
| LM Studio | Desktop-App | Ja, plus MLX | NVIDIA, AMD, Apple Silicon | macOS (M-Serie), Windows, Linux | GGUF, MLX | Ja, plus Anthropic-API | Moderat | App geschlossen; Tools MIT | 5.427 (lms-CLI) | Bionic 1.2.0 | Cloud ab 20 $/Monat |
| Jan | Desktop-App | Ja, plus MLX | NVIDIA, AMD, Apple | macOS, Windows, Linux | GGUF | Ja | Leicht | Apache 2.0 | ~45.700 | v0.8.8 | Keine |
| LocalAI | API-Server | Ja, unter 80+ Backends | CPU, NVIDIA, AMD, Intel, Apple, Jetson | Linux, macOS, Docker, Kubernetes | GGUF und mehr | Ja, plus Anthropic-API | Moderat | MIT | ~50.400 | v4.12.1 | Keine |
Welche llama.cpp-Alternative passt zu deiner Hardware?
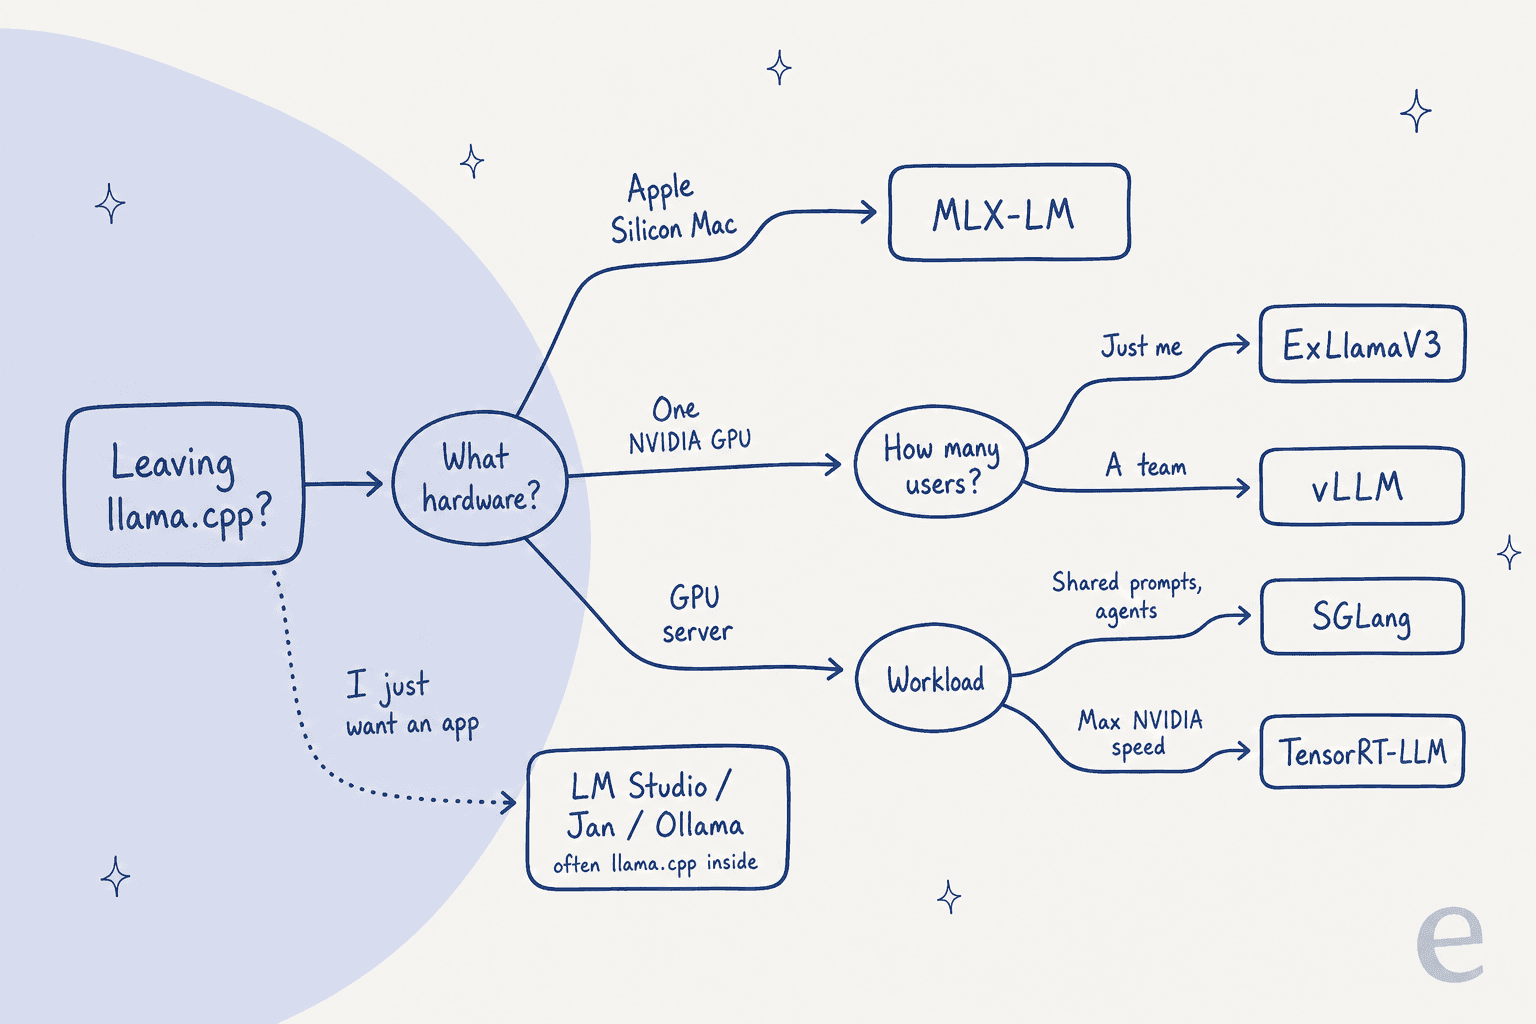
Fang bei der Maschine an, dann bei der Anzahl der Nutzer. Ein Mac zeigt auf MLX-LM. Eine NVIDIA-Karte zeigt auf ExLlamaV3 für dich allein oder vLLM für ein kleines Team. Ein GPU-Server zeigt auf SGLang für Agenten-Workloads mit geteilten Prompts, oder auf TensorRT-LLM, wenn du das letzte Stück Geschwindigkeit auf NVIDIA-Hardware willst. Wenn du einfach nur eine schönere App willst, nimm LM Studio, Jan oder Ollama und akzeptiere, dass llama.cpp weiterhin die Arbeit macht.
Die eine nützlichste Frage ist, wie viele Leute das Modell gleichzeitig treffen. llama.cpp hat parallele Slots und einen OpenAI-kompatiblen llama-server, aber Engines, die um Continuous Batching gebaut sind, halten den Durchsatz hoch, wenn gleichzeitige Anfragen sich stapeln, auf Kosten eines langsameren Starts und weniger Flexibilität bei quantisierten Dateien.
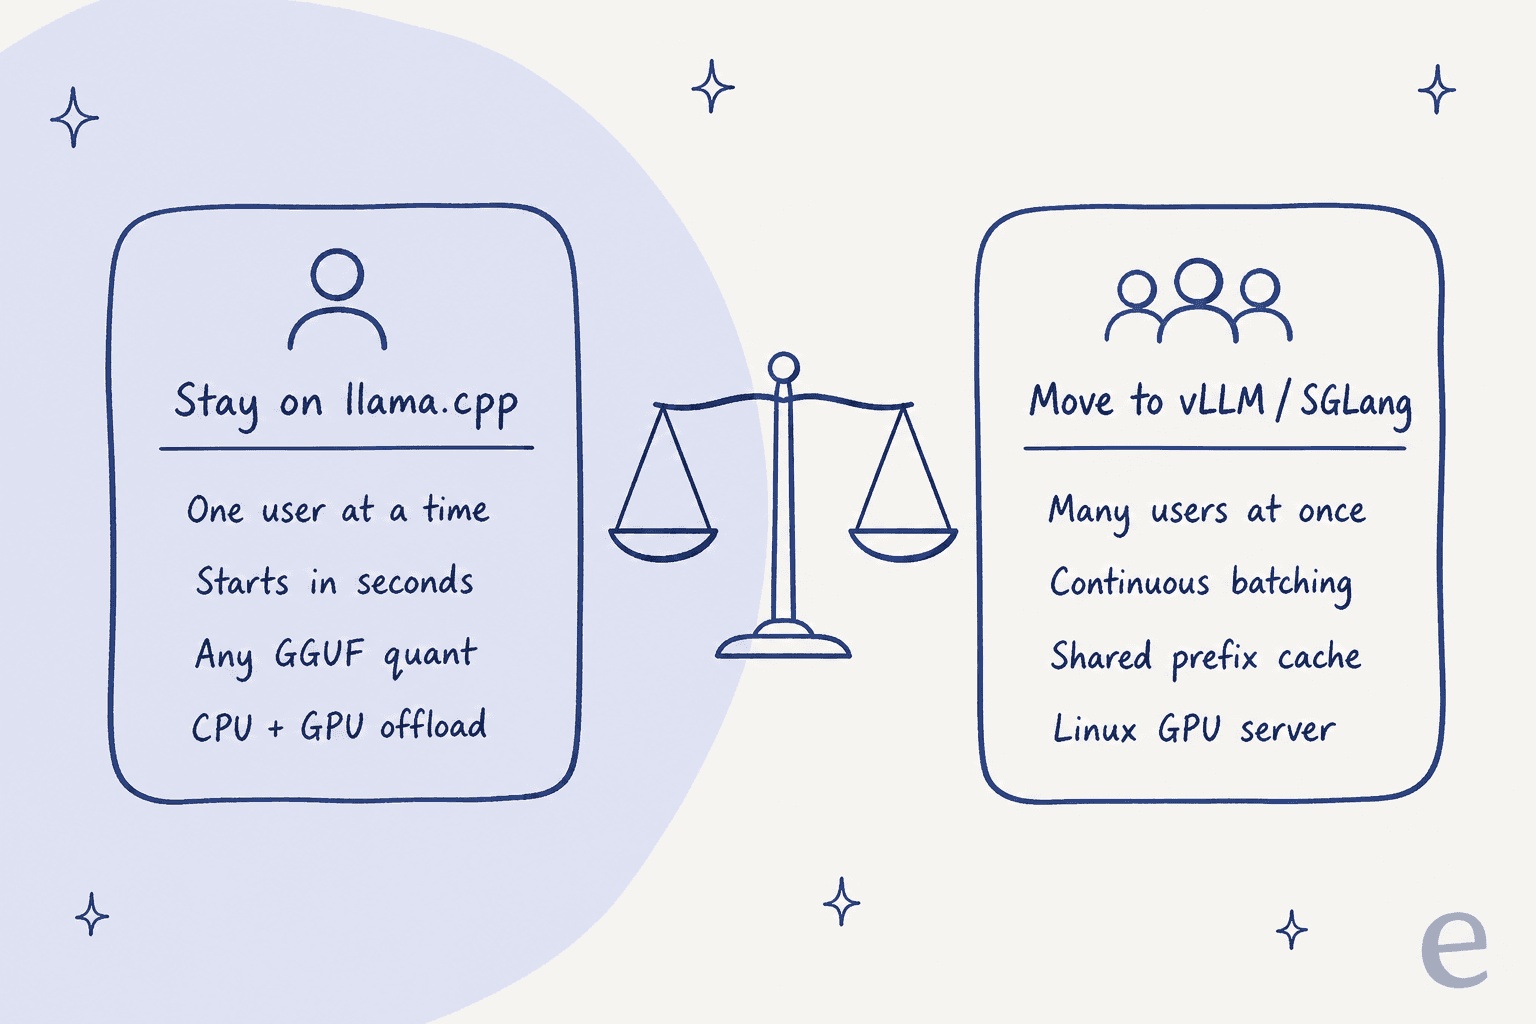
"IME vLLM is quite a bit faster than llama.cpp but where it really wipes the floor with it is in batching concurrent load. The downside is that it is dramatically less flexible in terms of tweaking. It gives you very few options for running quantized weights."
1. vLLM
Am besten für: das Servieren eines Modells an viele Nutzer von einem Linux-GPU-Server.
vLLM beschreibt sich selbst als "a fast and easy-to-use library for LLM inference and serving." Es begann an der Sky Computing Lab der UC Berkeley und zählt heute über 2.000 Mitwirkende. Wenn du einen Namen in der "llama.cpp für Server"-Diskussion gehört hast, ist es dieser.
Was es besser macht als llama.cpp
- Gleichzeitiger Traffic. PagedAttention, Continuous Batching, Chunked Prefill und Prefix-Caching sind alle für viele Anfragen gleichzeitig gebaut.
- Große Deployments. Tensor-, Pipeline-, Daten-, Experten- und Kontext-Parallelismus, um ein Modell über GPUs und Maschinen zu verteilen.
- API-Abdeckung. Ein OpenAI-kompatibler Server, plus eine Anthropic-Messages-API und gRPC, sodass Tools wie Claude Code darauf zeigen können.
- Hardware-Spanne für Server. NVIDIA, AMD ROCm 6.3+, Intel XPU und CPU, mit TPU, Gaudi und Ascend über Plugins.
Wo es schwächelt
- Nur Linux. Der GPU-Installationsguide sagt "vLLM does not support Windows natively" und verweist auf WSL. Apple Silicon läuft nur über ein Community-vLLM-Metal-Plugin.
- GGUF ist ein Seiteneingang. Die GGUF-Docs bezeichnen es als "highly experimental and under-optimized", und es braucht jetzt ein separates Plugin. Wenn deine Modell-Bibliothek aus GGUF-Dateien besteht, plane, Safetensors-Versionen herunterzuladen.
- Langsamer Start. Es kompiliert beim Laden optimierte CUDA-Graphen, was schadet, wenn du Modelle oft wechselst.
"We use all kinds of different models other than Qwen3, and vLLM startup when switching models is prohibitively slow (several times slower than llama.cpp, which is already 5 sec)"
Kosten
Kostenlos unter Apache-2.0. Installiere mit uv pip install vllm und serviere mit vllm serve <model>. Die eigentlichen Kosten sind eine Linux-Box mit einer unterstützten GPU und jemand, der sie betreibt.
Fazit
Nimm vLLM, wenn ein Team, eine App oder eine Agenten-Flotte sich ein Modell teilt und Durchsatz wichtiger ist als Startzeit. Überspring es, wenn du auf Windows oder einem Mac bist, oder wenn du den ganzen Tag zwischen GGUF-Modellen wechselst.
2. SGLang
Am besten für: Agenten-Workloads, die dieselben langen Prompts erneut senden.
SGLang ist ein Open-Source-Inference-Framework, "optimized for agentic workloads, large-scale serving, and RL rollouts," betrieben von der gemeinnützigen Organisation LMSYS. Seine Docs führen mit "low-latency, high-throughput inference with RadixAttention, prefix caching, and multi-GPU parallelism."
Was es besser macht als llama.cpp
- Wiederverwendung geteilter Präfixe. RadixAttention hält geteilte Prompt-Präfixe im Cache, was sich auszahlt, wenn ein Agent bei jedem Aufruf denselben Systemprompt und dieselbe Tool-Liste sendet.
- Tag-eins-Modellrezepte. Die Docs führen Cookbook-Seiten für neue Releases wie Kimi K3.1 Pro, plus ein Tag-eins-Rezept für Qwen3.8-Flash-Next.
- Breite Beschleuniger-Liste. NVIDIA von RTX-30-Karten bis GB300, AMD Instinct, Google TPU, Intel Arc und Xeon, Huawei Ascend, und Macs über MLX.
- OpenAI-kompatibel. Die Docs sagen, es sei "compatible with Hugging Face and OpenAI APIs."
Wo es schwächelt
- CUDA 13 erforderlich. Die Installationsseite sagt, CUDA-12-Wheels wurden nach 0.5.19 eingestellt, ältere Treiber-Stacks brauchen also ein Update.
- Linux-first. Der Haupt-Installationsguide zielt auf Linux mit NVIDIA-GPUs ab; der Mac-Weg braucht macOS 14+ und ein Umgebungs-Flag.
- Speicher-Offload. Nutzer berichten, dass das Auslagern von Gewichten und KV-Cache in den System-RAM schwächer ist als bei llama.cpp.
"My own experience shows that both weight and KV cache offload to ram on sglang and vllm is unavailable or unusable."
Kosten
Kostenlos unter Apache-2.0. uv pip install --prerelease=allow sglang oder das lmsysorg/sglang-Docker-Image.
Fazit
Nimm SGLang statt vLLM, wenn dein Traffic aus Agenten und RAG-Pipelines mit langen, wiederholten Präfixen besteht. Wenn du KI-Agenten mit MCP baust, ist das der größte Teil deines Traffics. Überspring es für eine einzelne Desktop-GPU, auf der das Modell ohne Offload nicht passt.
3. MLX-LM
Am besten für: das Ausführen und Feinabstimmen von Modellen auf einem Mac mit Apple Silicon.
MLX-LM ist Apples "Python package for generating text and fine-tuning large language models on Apple silicon with MLX." Es baut auf MLX auf, Apples Array-Framework rund um Unified Memory.
Was es besser macht als llama.cpp
- Mac-Geschwindigkeit bei vielen Modellen. Hacker-News-Nutzer behandeln MLX als die Basis, die man schlagen muss, auf Apple Silicon. Ein Nutzer maß etwa 50 Tokens pro Sekunde mit MLX gegen etwa 41 mit llama.cpp auf demselben 8B-Modell in LM Studio.
- Feinabstimmung integriert. LoRA, QLoRA und vollständiges Fine-Tuning, auch auf quantisierten Modellen, plus verteilte Inference über mehrere Macs.
- Eine große fertige Bibliothek. Tausende konvertierte Modelle in der MLX Community auf Hugging Face, und
mlx_lm.convert -q, um eigene zu quantisieren.
"On a Mac the baseline I'd want is MLX, not llama.cpp. llama.cpp isn't the fast path on Apple Silicon for most models people run locally, so a speedup over llama.cpp could still be slower than mlx_lm."
Wo es schwächelt
- Nur Mac. Kein Linux- oder Windows-GPU-Pfad in diesem Paket.
- Einfacher Server.
mlx_lm.serverspricht eine OpenAI-ähnliche API, aber seine eigenen Server-Notizen sagen, es "is not recommended for production as it only implements basic security checks." - Kein GGUF. Du nutzt Gewichte im MLX-Format, dein bestehender GGUF-Ordner trägt also nicht über.
- Nicht immer zuverlässiger. Ein Nutzer wechselte zurück zu llama.cpp, nachdem ein MLX-Setup sich ständig wiederholt hatte.
Kosten
Kostenlos unter MIT. pip install mlx-lm, dann mlx_lm.chat.
Fazit
Nimm MLX-LM, wenn du auf einem M-Serie-Mac bist und Geschwindigkeit oder lokales Fine-Tuning willst. Wenn du dieselbe Engine mit einer GUI willst, nutzen LM Studio, Ollama und Jan alle MLX auf Macs. Überspring es für alles, was auf Linux-Servern laufen muss.
4. ExLlamaV3
Am besten für: das meiste Modell auf eine einzelne NVIDIA-Consumer-GPU zu quetschen.
ExLlamaV3 ist "an inference library for running local LLMs on modern consumer GPUs, with flexible quantization and parallel inference." Es ersetzt ExLlamaV2, dessen README jetzt als archiviert markiert ist und auf V3 verweist. TabbyAPI ist der offizielle Server darüber.
Was es besser macht als llama.cpp
- Qualität pro Gigabyte. Sein EXL3-Format, basierend auf QTIP, unterstützt fraktionale Bitraten und 2- bis 8-Bit-Cache-Quantisierung, sodass du ein Modell genau auf deinen VRAM zuschneiden kannst.
- Multi-GPU zu Hause. Tensor- und Experten-Parallelismus über Consumer-Karten, plus CPU-Offload für große Mixture-of-Experts-Modelle.
- Aktiv. v1.6.7 erschien am 13. November 2026, mit Commits an den meisten Tagen.
"ExllamaV3 4.0bpw fits in 12.5G of VRAM and beats IQ4_XS according to the measurements here"
Wo es schwächelt
- NVIDIA first. Es braucht CUDA 12.4 oder neuer. AMD-Unterstützung ist neu und auf die Radeon-RX-7900-Serie fokussiert. Es gibt keinen Mac-Pfad.
- Konvertierung nötig. Modelle müssen zu EXL3 konvertiert werden; es lädt kein GGUF.
- Hobby-Server-Maßstab. TabbyAPIs README sagt, es "is not meant to run on production servers", und es ist AGPL-3.0.
Kosten
Kostenlos. ExLlamaV3 ist MIT, TabbyAPI ist AGPL-3.0. Vorgefertigte Wheels auf der Releases-Seite vermeiden, dass man das CUDA-Toolkit für pip install exllamav3 braucht.
Fazit
Nimm ExLlamaV3, wenn du eine oder zwei RTX-Karten hast und das größte Modell willst, das passt, nur für dich. Überspring es für geteiltes Produktions-Serving oder alles, was nicht NVIDIA ist.
5. TensorRT-LLM
Am besten für: maximalen Durchsatz auf NVIDIA-Rechenzentrums-GPUs.
TensorRT-LLM ist NVIDIAs Open-Source-Bibliothek "for accelerating and optimizing inference performance of the latest large language models (LLMs) on NVIDIA GPUs", jetzt auf PyTorch mit einer Python-LLM-API aufgebaut.
Was es besser macht als llama.cpp
- Niedrigpräzisions-Formate auf neuen Karten. Natives FP4 auf B200 und FP8 auf H100 und neuer, was laut NVIDIA "can double performance and halve memory consumption compared to 16-bit floating point" kann.
- Serving-Funktionen. In-Flight-Batching, Paged-KV-Cache mit Block-Reuse, Speculative Decoding (EAGLE, MTP, NGram), LoRA und disaggregiertes Serving in Beta.
- NVIDIAs Stack. Die Docs sagen, es klinkt sich in NVIDIA Dynamo und Triton Inference Server ein, und
trtllm-servebietet einen OpenAI-kompatiblen Endpunkt.
Wo es schwächelt
- NVIDIA-Rechenzentrums-Hardware. Unterstützte GPUs reichen von Ampere A100 über Hopper bis Blackwell. Es ist kein Laptop-Tool.
- Release-Takt. Das neueste stabile Release ist v1.2.1 vom 20. April 2026, die Docs sind schon bei 1.4.0-Release-Candidates.
- Schwereres Setup. Der schnellste Weg ist NVIDIAs NGC-Container.
"Some GPUs are still better than others like Nvidia GPUs are still the best for token throughput (via TensorRT-LLM), but AMD GPUs are competitive (via vLLM) and even CPUs can run LLMs at decent speeds (via Llama.cpp)."
Kosten
Kostenlos, keine Bezahlstufe. Die Kosten sind die H100- oder B200-Klasse-Hardware, für die es gebaut ist, oder die Cloud-Stunden. Teams, die nur Durchsatz brauchen, finden manchmal eine gehostete Engine wie Groq günstiger als den eigenen Betrieb.
Fazit
Nimm TensorRT-LLM, wenn du NVIDIA-Rechenzentrums-GPUs besitzt und die Serving-Kosten pro Token deine Hauptkennzahl sind. Überspring es auf Consumer-Hardware, wo vLLM oder ExLlamaV3 einfacher sind.
6. Ollama
Am besten für: das einfachste lokale Modell-Setup, mit optionalen Cloud-Modellen.
Ollama bezeichnet sich selbst als "the most popular way to build with open models", und seine Zahlen stützen den Popularitäts-Teil: 186.973 GitHub-Stars und, laut eigener Startseite, 9 Mio.+ monatliche Installationen.
Was es besser macht als llama.cpp
- Null Build. Ein Install-Skript oder Installer auf macOS, Windows und Linux, plus ein Docker-Image.
- Modell-Bibliothek.
ollama runlädt von ollama.com/library, mit Modellen wie Kimi K3 und DeepSeek V4 Flash. - Agenten-Anbindung.
ollama launchverdrahtet ein lokales Modell mit Claude Code, Codex, OpenCode und anderen, und es hat OpenAI- und Anthropic-kompatible Endpunkte. - MLX auf Macs. Sein Repo trägt jetzt einen MLX-Runner neben llama.cpp.
"When I read the llama.cpp repo and see I have to build it, vs ollama where I just have to get it, the choice is already made."
Wo es schwächelt
- Dieselbe Engine. Für GGUF-Modelle ist es immer noch llama.cpp, das wird also kein Durchsatzproblem lösen.
- Teilweise OpenAI-API. Die Kompatibilitäts-Docs sagen, es "supports a subset of the OpenAI API."
- Weniger Stellschrauben. Manche Nutzer wechseln zurück zu llama.cpp, sobald sie feinere Kontrolle wollen, jetzt, wo es einfacher zu installieren ist.
Kosten
Lokal kostenlos. Cloud-Pläne auf der Ollama-Preisseite stehen unten.
| Plan | Preis | Was du bekommst |
|---|---|---|
| Pay as you go | 0 $ Abo | Nutzung pro Token in der Cloud, 3 gleichzeitige Anfragen |
| Pro | 20 $/Monat (200 $/Jahr) | 60 $ Nutzungs-Credits im Monat, größere Pro-Modelle |
| Max | 100 $/Monat | 300 $ Nutzungs-Credits im Monat, 10 gleichzeitige Anfragen |
| Team (Early Access) | 500 $/Monat | Unbegrenzte Nutzer, 1.000 $ geteilte Credits |
| Enterprise | Individuell | Modellzugriffskontrollen, Budgets pro Nutzer und Key |
Fazit
Nimm Ollama, wenn du lokale Modelle in fünf Minuten laufen haben willst und sie in Coding-Agenten einbinden willst. Überspring es, wenn dein Grund, llama.cpp zu verlassen, Geschwindigkeit war, denn du würdest dieselbe Engine behalten.
7. LM Studio
Am besten für: eine ausgefeilte Desktop-App, mit der du auch Modelle nach VRAM auswählen kannst.
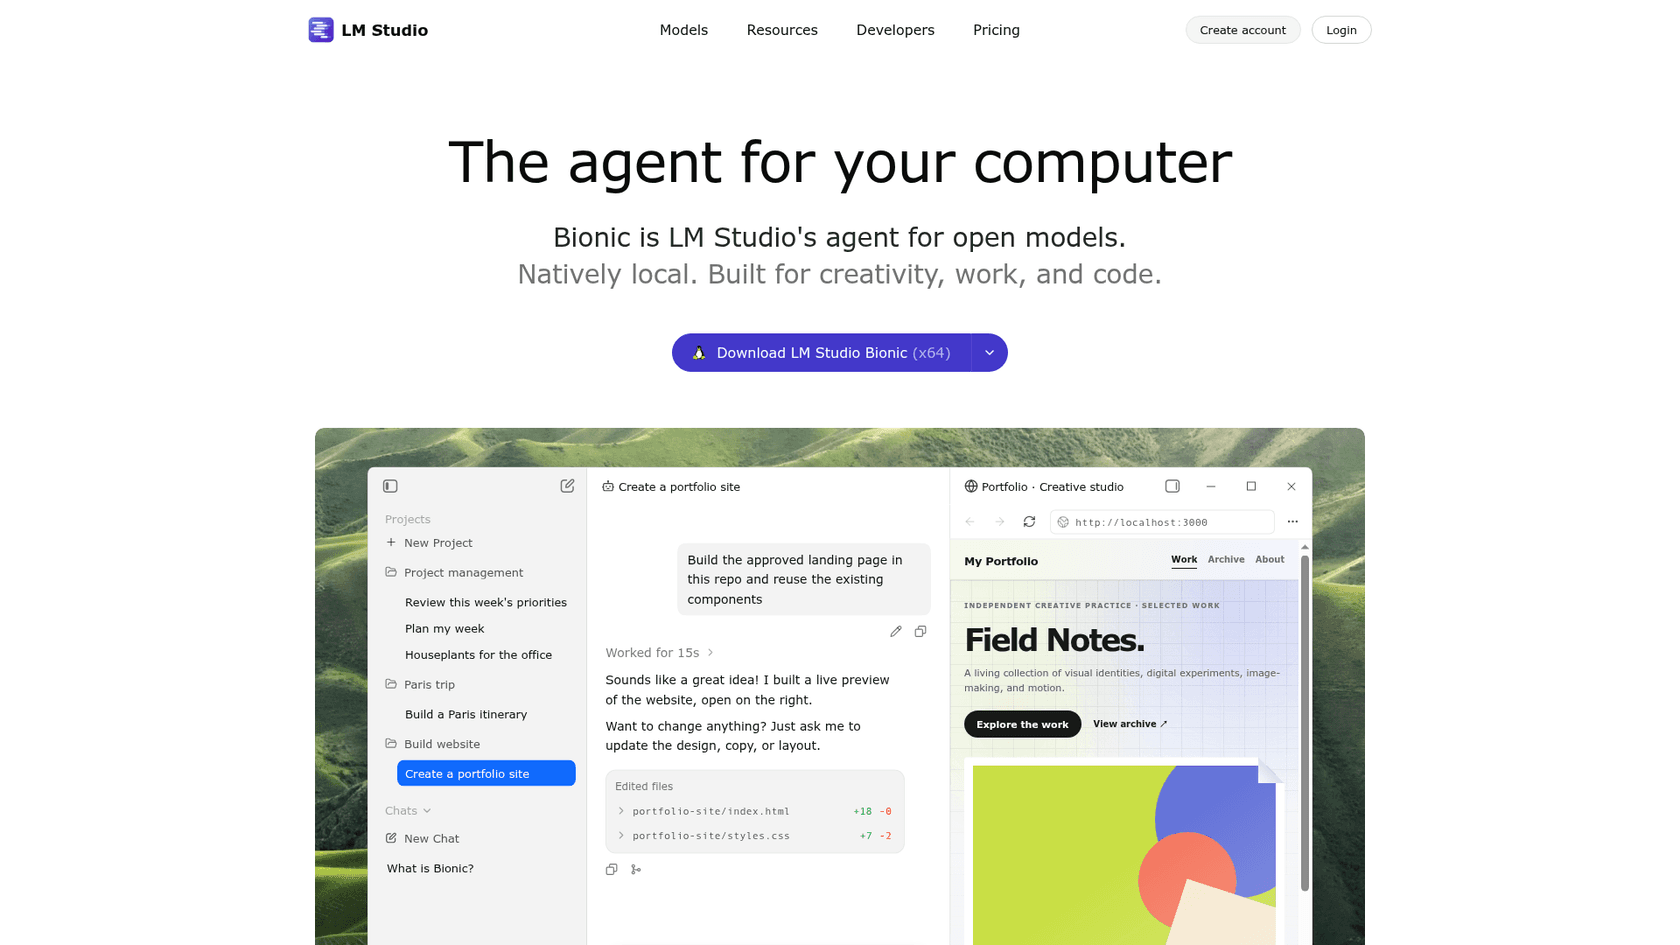
LM Studio ist von einer Modell-Chat-App zu "Bionic" gewachsen, das es als "LM Studio's agent for open models. Natively local." bezeichnet. Darunter läuft es, in eigenen Worten, "with MLX and llama.cpp under the hood."
Was es besser macht als llama.cpp
- Modell-Entdeckung. Die Suche zeigt, was auf deine Hardware passt, bevor du herunterlädst.
- Beide Engines auf einem Mac. GGUF über llama.cpp-Erweiterungspakete und MLX über die eigene oMLX-Engine, je Modell gewählt.
- Entwickler-Oberfläche. OpenAI- und Anthropic-kompatible Endpunkte, TypeScript- und Python-SDKs, die
lms-CLI, undllmster, ein kopfloser Daemon für Server und CI, der ohne GUI läuft.
"LM Studio's model search is pretty good at showing what models will fit in your VRAM."
Wo es schwächelt
- Closed-Source-App. Die Desktop-App unterliegt LM Studios eigenen Bedingungen; nur die CLI und SDKs sind MIT auf GitHub.
- Hinkt llama.cpp nach. Es bündelt vorkompilierte Engine-Pakete, Unterstützung für brandneue Modelle kann also ein paar Tage später ankommen.
- Keine Intel-Macs. macOS braucht Apple Silicon und macOS 14+.
Kosten
Lokal kostenlos. Laut der LM-Studio-Preisseite kostet Bionic+ 20 $/Monat für US-gehostete offene Modelle und Websuche, Pro kostet 100 $/Monat für das 5-Fache der Nutzungslimits, und Team-Billing hat keinen gelisteten Preis.
Fazit
Nimm LM Studio, wenn du die beste GUI für lokale Modelle willst, besonders auf einem Mac, wo es automatisch zwischen GGUF und MLX wechselt. Überspring es, wenn du eine Open-Source-App oder den allerneuesten llama.cpp-Build am ersten Tag brauchst.
8. Jan
Am besten für: eine Open-Source-Desktop-App im ChatGPT-Stil, die lokal bleibt.
Jan ist eine Open-Source-Desktop-App für macOS, Windows und Linux. Ihre Docs sagen, "the llama.cpp engine is built into Jan and updates together with the app", mit MLX auf Apple Silicon.
Was es besser macht als llama.cpp
- Open Source und freundlich. Apache 2.0, etwa 45.700 Stars, eine Chat-Oberfläche und ein Modell-Hub, der beim ersten Start ein Standardmodell herunterlädt.
- Lokal plus Cloud in einem Fenster. OpenAI-, Anthropic- oder Google-Keys neben lokalen Modellen hinzufügen, plus MCP-Server und Websuche.
- Eine lokale API. Ein OpenAI-kompatibler Server unter
127.0.0.1:1337/v1.
"its open source, has a simple chat interface, it uses llama.cpp, it lets you search for models and downloads them, and it supports .gguf so youre not locked in if you want to use the models with another program later on"
Wo es schwächelt
- Dieselbe Engine. Wie Ollama und LM Studio ändert es nicht die Inference-Geschwindigkeit.
- Intel-Macs. Seine gebündelte llama.cpp-Engine lädt ab v0.8.5 keine Modelle auf Intel-Macs.
- Neuere Funktionen in Preview. Cowork, der autonome Task-Modus, ist noch als Preview markiert.
Kosten
Kostenlos. Keine Bezahlstufe; seine gehostete Plattform wird als demnächst angekündigt gelistet.
Fazit
Nimm Jan, wenn du die Bequemlichkeit von LM Studio mit einer Open-Source-Lizenz willst. Überspring es, wenn du Server-taugliches Serving brauchst.
9. LocalAI
Am besten für: eine selbst gehostete API, die Text, Bilder, Sprache und mehr abdeckt.
LocalAI ist eine MIT-lizenzierte, selbst gehostete Engine für Text-, Vision-, Sprach-, Bild- und Videomodelle, mit "more than 80 backends", darunter llama.cpp, vLLM, MLX und whisper.cpp.
Was es besser macht als llama.cpp
- Eine API für viele Modelltypen. OpenAI-kompatibel, plus Anthropic- und ElevenLabs-Formate, eine Realtime-API und eingeschränkte Grammatiken.
- Steckbare Backends. Jedes Backend ist sein eigenes Image, das nur geladen wird, wenn ein Modell es braucht, und das Team baut einige selbst, wie vllm.cpp.
- Hardware-Streuung. CPU, NVIDIA CUDA 12 und 13, AMD ROCm, Intel, Apple Metal, Vulkan und Jetson.
Wo es schwächelt
- Meist ein Router. Für GGUF-Textmodelle ist llama.cpp weiterhin die Engine, die die Arbeit macht.
- Neue Funktionen in Dev-Builds. Agenten, Dateien, Sandbox und Team-Logins sind ab v4.12.1 nur in Entwicklungs-Builds.
- Mehr bewegliche Teile. Ein Container pro Backend ist flexibel, aber schwerer als eine Binärdatei.
"And if you want to use WSL, then I'd suggest using something like LocalAI which gives you a lot more control and support for additional formats (GGML, GGUF, GPTQ, ONNX, etc)."
Kosten
Kostenlos. Installation per Skript, Docker, einer macOS-App oder Kubernetes.
Fazit
Nimm LocalAI, wenn du einen OpenAI-ähnlichen Endpunkt für ein Home-Lab oder eine interne Plattform willst, die mehr als Chat bedient. Überspring es, wenn du nur Textmodelle betreibst, wo die reine Engine einfacher ist.
Wann solltest du bei llama.cpp bleiben?
Wenn du eine Person an einer Maschine bist, besonders bei gemischter oder ungewöhnlicher Hardware. Keine Alternative hier deckt so viele Backends ab, von Vulkan auf AMD-Laptops bis Snapdragon und Huawei Ascend. Neue Modellarchitekturen landen auch meist zuerst dort: v1.0.0 fügte am Release-Tag Kimi-K3.1-Pro und Ripple-65B hinzu, und llama-server gibt dir schon eine OpenAI-kompatible API, eine Web-UI und MCP-Tools. Der llama.cpp-Guide meines Kollegen behandelt das v1.0.0-Setup im Detail.
Die zwei größten Beschwerden sind auch kleiner als früher. Builds sind jetzt optional mit der Llama-App und Homebrew- oder Winget-Installationen, und der neue MoE-Cache in v1.0.0 verdoppelte in einem Test im Release die Geschwindigkeit, von 24,2 auf 47,6 Tokens pro Sekunde bei Qwen3.8-Flash-Next, wobei die meisten Experten-Misses auf der CPU behandelt wurden (PR #30966).
"I have been using llama.app, which is the desktop interface built on top of llama.cpp by the same people. It is an alternative to Ollama that might interest people who want to switch given Ollama's reputation and previous decisions."
Wenn du Modelle hauptsächlich betreibst, um Coding-Agenten anzutreiben, bleib, außer du hast einen Bottleneck gemessen. Ein Agent, der auf Tool-Calls wartet, braucht selten das Batching einer Server-Engine. Dasselbe gilt für Open-Source-Agenten, die du zu Hause betreibst.
Was kostet ein Wechsel von llama.cpp wirklich?
Jede Engine auf dieser Liste ist freie Software, der Preis ist also Hardware und Zeit. Ein paar Faustregeln aus den Docs oben:
- vLLM, SGLang und TensorRT-LLM bedeuten einen Linux-GPU-Server und jemanden, der CUDA, Treiber und Container aktuell hält. SGLang braucht schon CUDA 13.
- MLX-LM kostet nichts extra, wenn du bereits einen M-Serie-Mac mit genug Unified Memory hast.
- ExLlamaV3 bedeutet, Modelle zu EXL3 zu konvertieren und einen Modell-Ordner getrennt von deinen GGUF-Dateien zu halten.
- Ollama und LM Studio sind lokal kostenlos und verlangen nur für ihre Cloud-Modelle, ab 20 $/Monat.
Wenn du keins davon selbst betreiben willst, verwandelt gehostete Inference wie Together AI die Hardware-Rechnung in eine Pro-Token-Rechnung. Verfolge sie trotzdem mit einem LLM-Tracking-Tool, denn lokale Modelle sind nur günstiger, wenn die Box ausgelastet bleibt.
Wo passt eesel hin, wenn du KI auf Support-Tickets willst?
Viele Leute landen bei llama.cpp, weil sie eine KI wollen, die Kunden antwortet, ohne Daten überallhin zu schicken. Eine Inference-Engine ist die Infrastruktur dafür, nicht die fertige Aufgabe. Du müsstest trotzdem die Helpdesk-Anbindung, die Wissens-Synchronisierung, das Testen, die Übergabe an Menschen und das Reporting selbst bauen. Das ist die Arbeit, die eesel macht: eine Engine betreibt ein Modell; eesel ist der Kollege, der die Support-Arbeit macht.
eesels KI-Helpdesk-Kollege reiht sich in deine bestehende Warteschlange in Zendesk oder Freshdesk ein, antwortet aus deinem Hilfe-Center und vergangenen Tickets, und wird an historischen Unterhaltungen getestet, bevor er einem echten Kunden antwortet. SE Ranking betreibt einen eesel-Agenten pro Produkt über drei Produkte auf Zendesk und bearbeitet 4.650 Unterhaltungen im Monat aus rund 16.800 Seiten Wissen, wobei Rückerstattungen und Anfragen nach einer Person an das Team weitergegeben werden. Orosoft, das Software für die Edelmetallindustrie baut, nutzt es stattdessen als Co-Pilot: Support-Mitarbeiter erwähnen eesel in einem Freshdesk-Ticket und bekommen einen Entwurf, der auf etwa 6.100 vergangenen Tickets basiert.
Wenn du dich bereits im Terminal wohlfühlst, wird dir die eesel-CLI gefallen. Ein Coding-Agent wie Claude Code oder Codex kann sie nutzen, um freigegebenes Wissen wie exportierte Hilfeartikel und Makros hochzuladen, die Anweisungen des Agenten anzupassen und Testfragen zu stellen, um die Antworten zu prüfen, bevor irgendetwas live geht. Das Verbinden des Helpdesks selbst braucht noch jemanden mit Admin-Zugriff, der es genehmigt.
eesel testen
Wenn das Modell auf deinem Schreibtisch dazu gedacht war, irgendwann Kunden zu antworten, bringt dich eesel dorthin, ohne eine Engine auszuwählen oder eine GPU zu kaufen. Es klinkt sich in Minuten in deinen Helpdesk ein, lernt aus deinen vergangenen Tickets und wird zuerst an alten Unterhaltungen getestet, so wie SE Ranking es über drei Produkte betreibt. Sieh dir zuerst die Preise an, wenn du willst. Wenn du bereit bist, teste eesel kostenlos.