Grok-Bot-Alternativen 2026: 8 Agenten, die du wirklich prüfen kannst

Riellvriany Indriawan

Katelin Teen
Zuletzt bearbeitet October 14, 2026
Ich arbeite in der Support-Queue von eesel. Als Grok Bot startete, war mein erster Gedanke deshalb nicht „wie schlau ist das?“. Er war eher: Das Ding schickt an einem Dienstag etwas Falsches raus, wie finde ich das überhaupt bis Donnerstag heraus? Die Dokumentation von xAI ist dabei ehrlich, und die ehrliche Antwort lautet: noch nicht. "Spend and usage are on the dashboard today. An audit view of Bot actions is coming."
Dieser Vergleich bewertet Agenten also nicht danach, wie clever sie sind. Geprüft werden drei Dinge, die ein Käufer vor jeder Unterschrift selbst verifizieren kann. Kannst du es am letzten Monat testen, bevor es diesen Monat anfasst? Kannst du hinterher belegen, was es getan hat? Kannst du es von dem fernhalten, was es nie berühren darf? Die Antwort von Grok Bot lautet hier: nein, noch nicht, teilweise. Das ist für 200 $/Monat eine echte Lücke, und dieselbe Lücke schließen die meisten der acht Optionen unten.
Kurzfassung: Wenn die Arbeit deine Support-Queue ist, ist eesel AI die Option, die deine eigene Ticket-Historie nachspielt und dir eine Genauigkeitszahl liefert, bevor ein Kunde irgendetwas sieht, ab 299 $/Monat für 500 Credits statt einer Platzlizenz. Für allgemeine Wissensarbeit gibt es Claude in Chrome, das alles in deinem eigenen Browser hält, mit einem Plan, den du vorher freigibst. Und wenn dir Belege am wichtigsten sind, sind n8n und Manus die beiden, die ein echtes Laufprotokoll führen.
Warum sich Leute schon jetzt nach einer Grok-Bot-Alternative umsehen
Zuerst fair zu Grok Bot: Was es gut kann, kann es besser als fast alle anderen. Seine ganze Design-Wette, eine Oberfläche so zu bedienen wie ein Mensch, ist genau das, womit es Tools ohne saubere API erreicht. Das ist eine echte Fähigkeit, und es lohnt sich, das klar zu sagen. Alles andere auf dieser Liste braucht eine API oder einen Connector, bevor es dir überhaupt helfen kann, und viele interne Tools haben nie einen bekommen. Grok Bot läuft einfach an diesem Problem vorbei. Ein ehrlicher Nachfahre von Call-Center-RPA, nur mit einem viel besseren Gehirn darunter.
Die Schmerzpunkte, die Leute woanders suchen lassen, haben aber nichts mit dem Gehirn zu tun.
Der Eintritt kostet 200 $. Cursor Ultra kostet 200 $/Monat und Cursor Premium Teams 120 $ pro Platz, ohne kostenlose Stufe und ohne veröffentlichte Testdauer. Seltsamerweise ist der Team-Tarif pro Platz günstiger als der Einzeltarif. Alle vier Ebenen dieser Rechnung habe ich in der Aufschlüsselung zu den Grok-Bot-Preisen durchgesehen. Kurz gesagt ist der Listenpreis die Eintrittsgebühr, nicht die tatsächlichen Kosten.
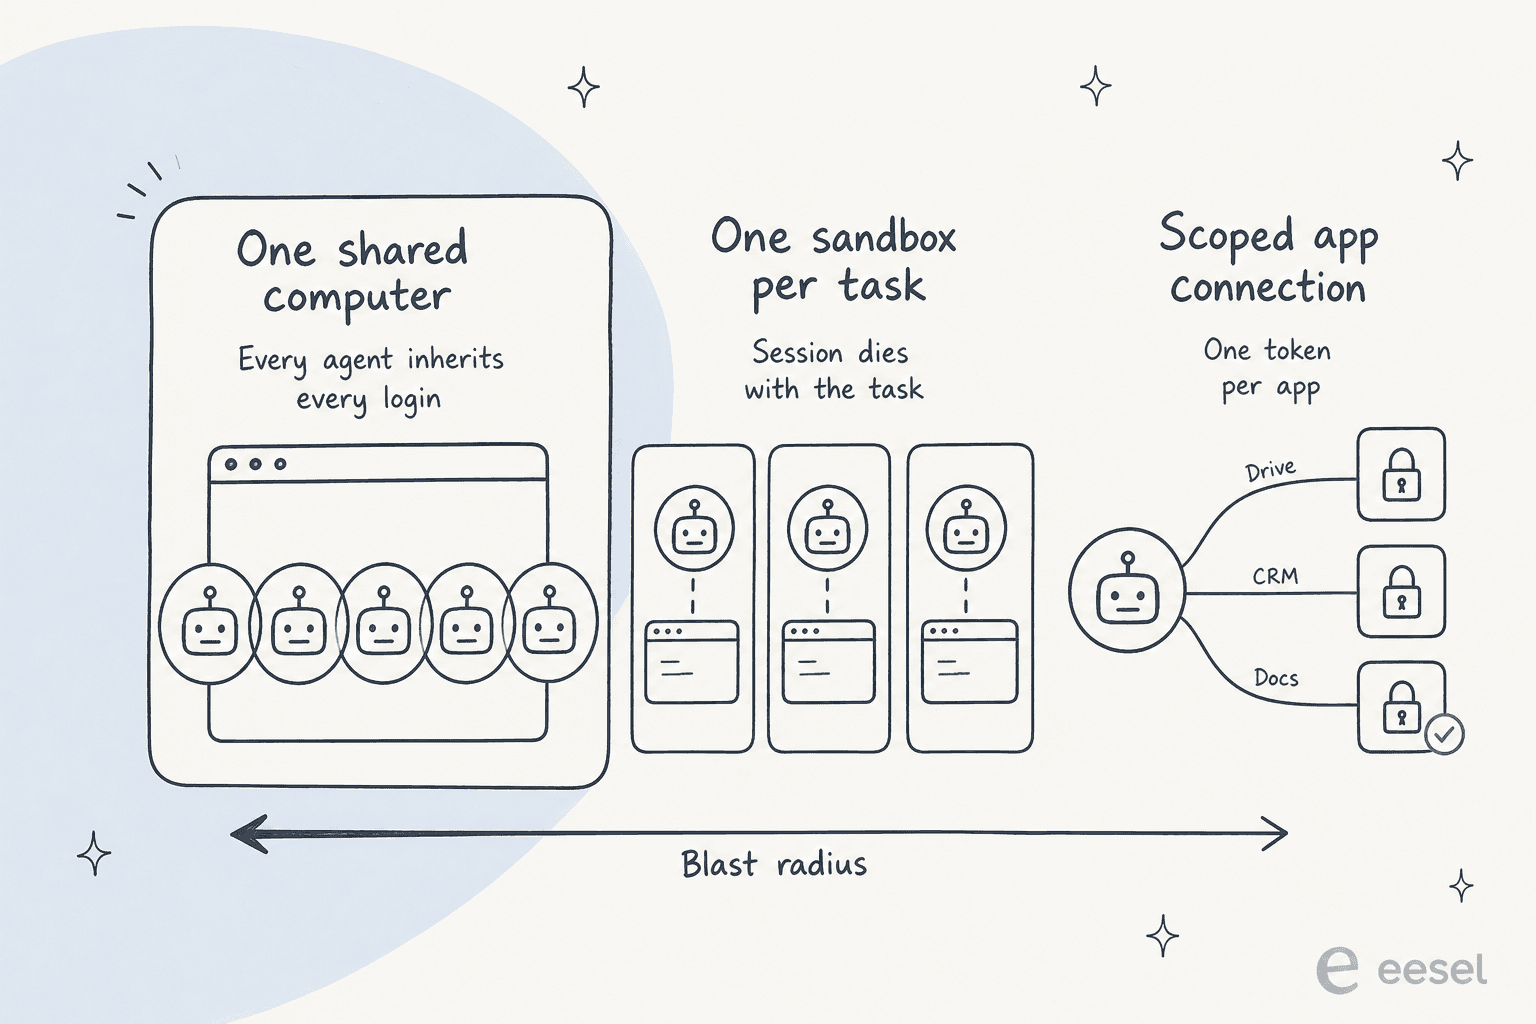
Alle deine Bots teilen sich einen Computer. Das überrascht die meisten, und es kommt von xAI selbst, nicht von Kritikern. Die Dokumentation sagt es klar: "All of your Bots share one cloud computer assigned to your user account. Files, browser sessions, and command line credentials on that computer are available across your Bot roster." Dann, zweimal auf derselben Seite: "Do not use separate Bots as a security boundary." Meldest du einen Bot in deinem Helpdesk an, erbt plötzlich jeder andere Bot diese Sitzung ebenfalls. Löschst du einen Bot, bleiben die Anmeldungen bestehen.
Die schärfste Erklärung, warum das wichtig ist, kam am Starttag von Hacker News:
"By hijacking a real person's credentials, that person becomes the accountability sink. Very neat. Very deliberate."

Es gibt keinen Testlauf. Ebenfalls aus der Dokumentation, wieder wörtlich: "A test run performs real work. It can navigate websites, change files, and call connected tools." Die einzige Möglichkeit herauszufinden, ob der Bot deinen Prozess versteht, ist also, ihn loszulassen und deinen Prozess wirklich ausführen zu lassen.
Nichts ist zertifiziert. Kein SOC 2, kein ISO 27001, keine DSGVO, kein HIPAA, kein Aufbewahrungsfenster, keine Datenresidenz, auch keine benannten Unterauftragsverarbeiter. Sicherheit wird pauschal auf die Bedingungen von Cursor verschoben, und Grok Bot "requires data storage and does not support Legacy Privacy Mode", das heißt, es gibt keine Option ohne Datenspeicherung, auf die du zurückfallen könntest, wenn du eine brauchst.
Und die eine Aufgabe, mit der es wirbt, wurde nicht wirklich geliefert. Das Beispiel-Prompt auf x.ai/bot lautet "Sign in to Zendesk so I can work the support queue." Keine der acht ausgelieferten Rollen, Sales Outbound, Talent Scout, Paid Media, Expense Manager, Product Performance, Bug Reproduction, Account Health, Chief of Staff, ist überhaupt eine Support-Rolle. Mir fiel das auf, weil es zufällig mein Job ist, und es ist eine seltsame Wahl, damit die Produktseite zu eröffnen.
Die drei Fragen, die ich stellen würde, bevor ich einem Agenten einen Login gebe
Ich beobachte seit einigen Jahren, wie KI-Agenten Live-Support-Queues bearbeiten, und der Fehler, der mir im Gedächtnis geblieben ist, ist nicht ein Bot, der ausgefallen ist. Es ist ein Bot, der völlig in Ordnung klang und dabei falsch lag. Der Agent eines eesel-Kunden, dessen Wissensdatenbank zu der Frage nichts Relevantes enthielt, füllte die Lücke aus seinen eigenen Trainingsdaten und schickte selbstsicher erfundene Behauptungen an echte Menschen. Ein anderer sagte Kunden „ja, wir unterstützen Ihr Automodell“ für Marken, die gar nicht in der Datenbank standen, nur weil im Hilfecenter stand, dass das Unternehmen alle Modelle unterstützt. Beides sieht in einem Log nicht wie ein Fehler aus, es sieht aus wie gute Antworten.
Deshalb gehen die drei Fragen unten um Belege, nicht um Fähigkeiten. Eine flüssige falsche Antwort bleibt unsichtbar, solange nichts sie ans Licht zwingt.
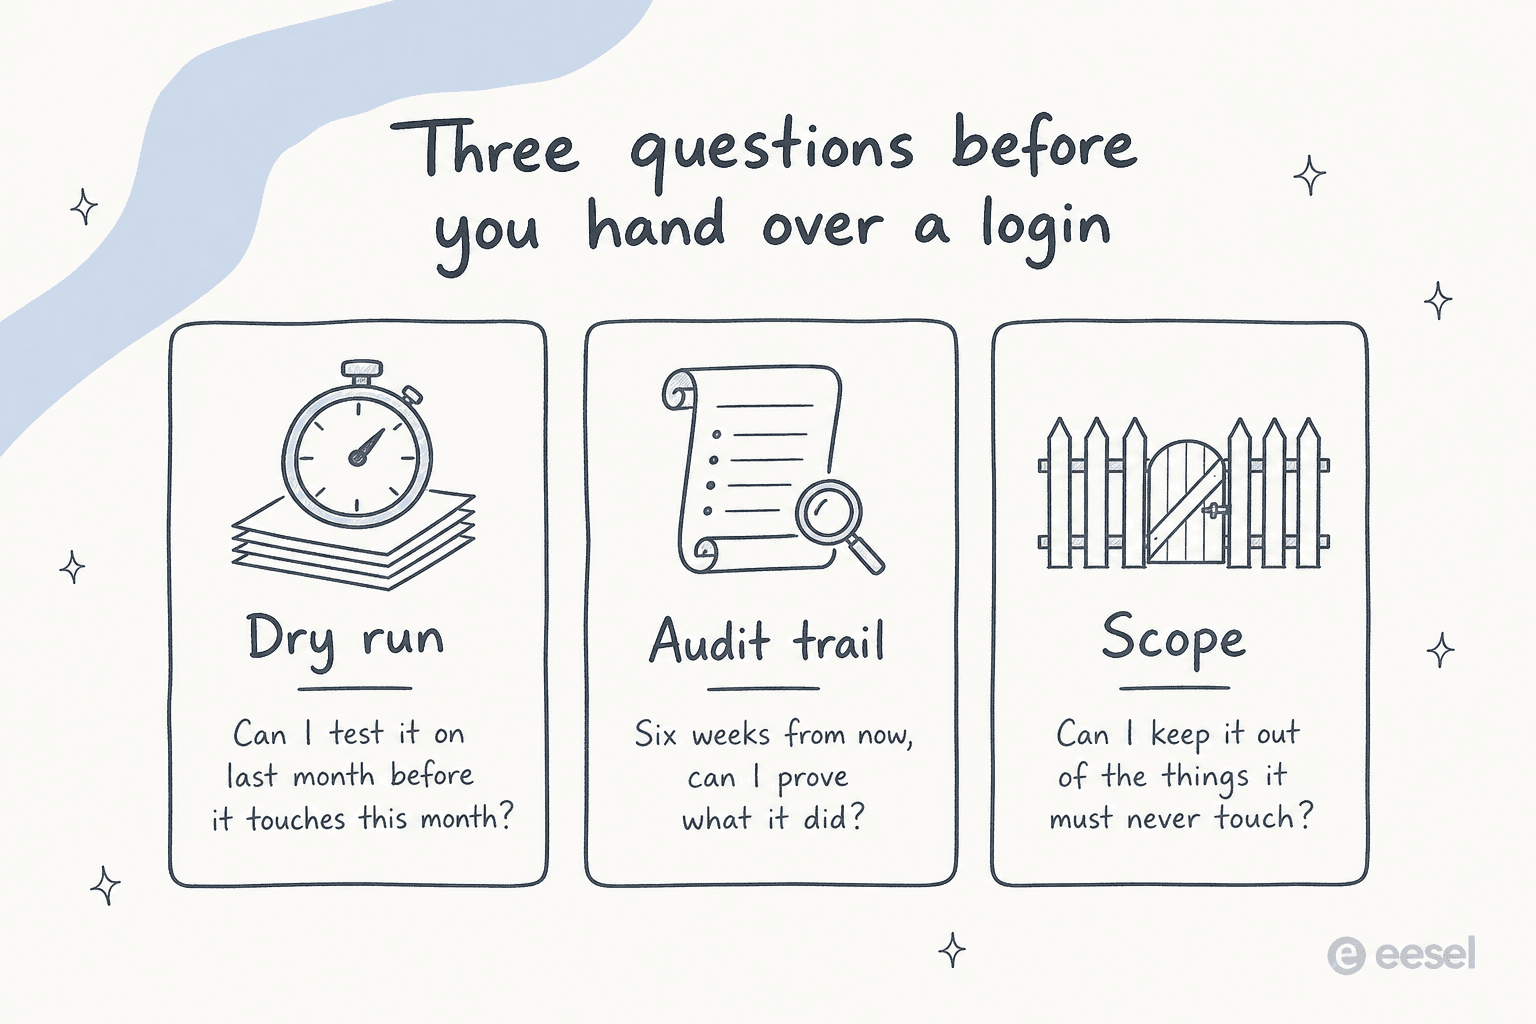
1. Kannst du es am letzten Monat testen, bevor es diesen Monat anfasst?
Nicht „hat es eine Sandbox“ und auch nicht „kann ich ihm beim Arbeiten zusehen“. Kannst du es auf Daten richten, die bereits passiert sind, und eine echte Zahl herausbekommen? Diese Zahl ist im Grunde das ganze Argument. Bei einem E-Commerce-Posteingang habe ich diesen Replay laufen lassen, und er lieferte 93 % Genauigkeit beim Triagieren, 100 % bei der Spam-Erkennung und eine Fehlerquote von 7 % bei Fakten in den Entwürfen. Ich kannte alle diese Zahlen, bevor ein einziger Kunde etwas sah, und genau diese 7 % sind der Grund, warum der Rollout im Entwurfsmodus startete, statt sofort live zu gehen.
Nur drei der acht Tools unten können etwas nachspielen, das bereits passiert ist. Die meisten bieten stattdessen eine Live-Bestätigungsabfrage, und das ist ein anderes Produkt: Sie fängt die Aktion ab, die du gerade beobachtest, nicht das Muster, das dir noch nicht aufgefallen ist.
2. Kannst du in sechs Wochen belegen, was es getan hat?
Freigabeabfragen fühlen sich wie die Antwort an, sind es aber nicht, wegen einer Zeile in der Dokumentation von xAI, die ich für den wichtigsten Satz der ganzen Seite halte: "An approval controls the proposed action. It does not reverse work already completed."
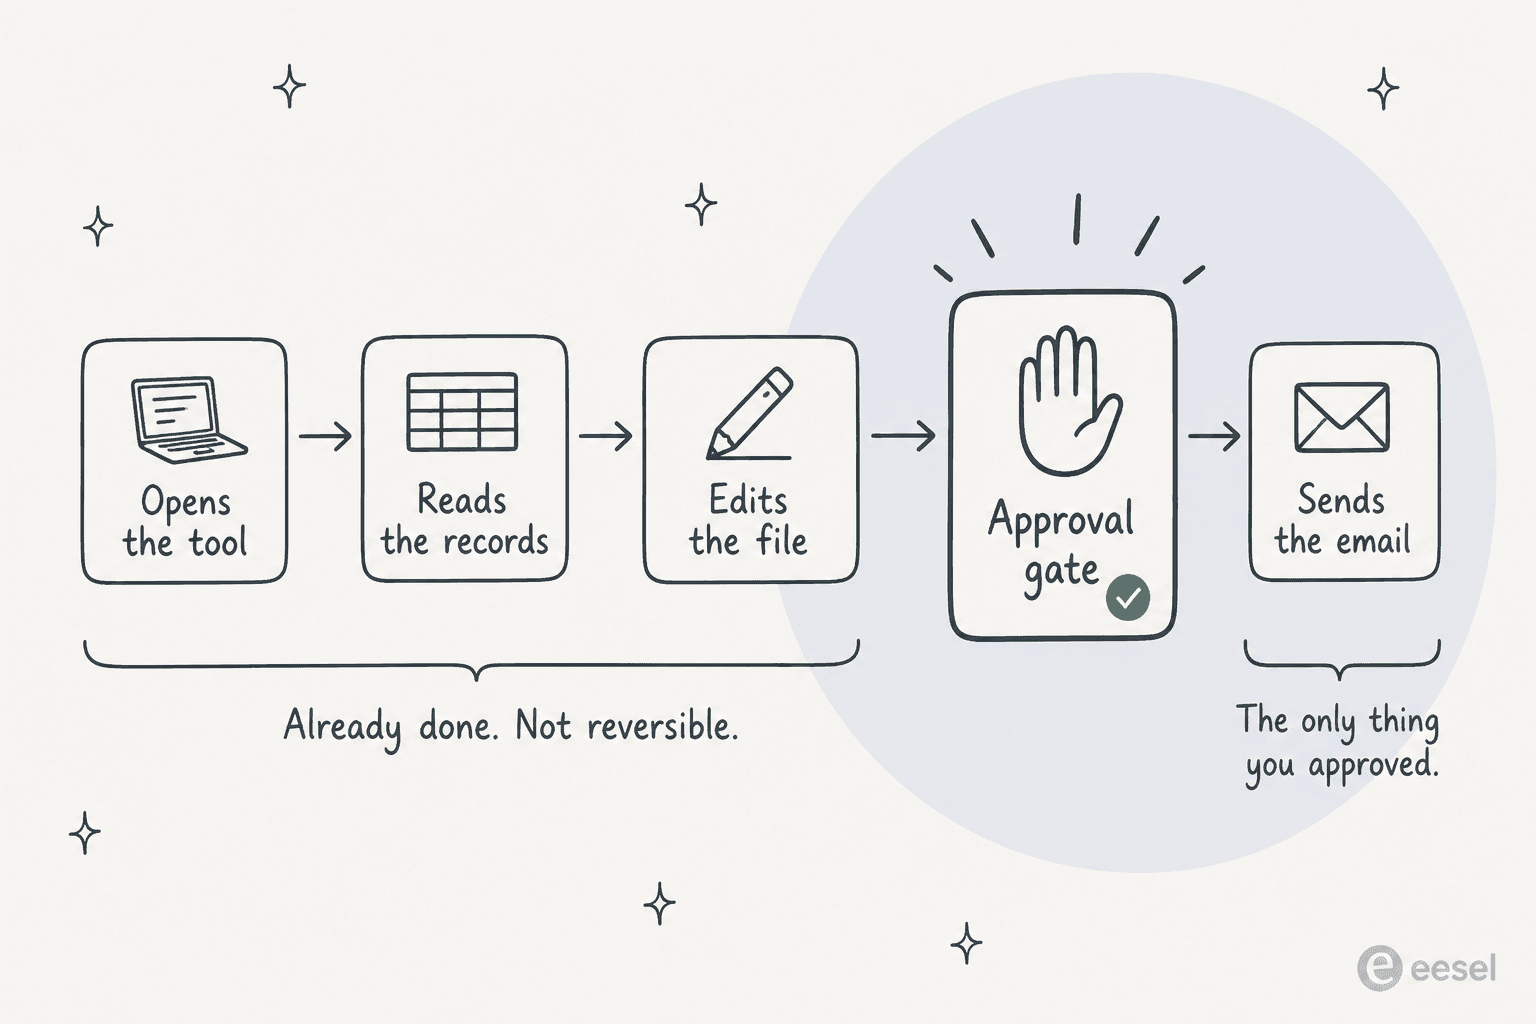
Bis eine Freigabekarte überhaupt erscheint, hat der Agent schon Dinge geöffnet, gelesen und geändert. Du gibst den letzten Schritt einer Kette frei, nicht die Kette selbst. Das Einzige, was diese Kette hinterher rekonstruieren kann, ist ein Log, und „kommt bald“ ist kein Log, jedenfalls noch nicht. Das ist auch ungefähr der Unterschied zwischen einem KI-Copilot und einem vollständig autonomen Agenten: Beim Copilot ist der Mensch, der auf Senden gedrückt hat, die Aufzeichnung.
Außerdem erwähnenswert: Die Freigaben von Grok Bot sind vom Nutzer verfasster Freitext, keine vom Produkt erzwungene Liste gefährlicher Aktionen. Die Dokumentation sagt dir, du sollst die Grenze selbst in Prosa schreiben, und die sieben vorgeschlagenen Kategorien ("Prefer explicit boundaries for:") sind nur ein Ratschlag. Es gibt auch eine optionale Regel-Engine namens Auto Review, und xAIs eigener Hinweis dazu ist erfrischend deutlich: Sie "is model-based and should complement, not replace, least privilege and explicit approval boundaries." Ein LLM, das ein anderes LLM beurteilt, also.
3. Kannst du es von allem fernhalten, was es nie berühren darf?
Das entscheidet, ob ein Support-Team einen Agenten überhaupt ausliefern kann, und es ist der Grund, warum ich immer wieder auf den Zugriffsumfang statt auf Intelligenz zurückkomme. Ein CX-Leiter bei einer Nahrungsergänzungsmarke, der rund 7.000 Tickets pro Monat in Gorgias bearbeitet, hat es besser formuliert, als ich es könnte:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Die ganze Anforderung war im Grunde, dass die KI den Großteil der Queue gar nicht anfasst. Ein anderer Admin wollte etwas noch Engeres: nur antworten, wenn sie ausdrücklich per @ erwähnt wird, nie auf jede einzelne Kundennachricht. Eine gespeicherte Browser-Sitzung, angemeldet als Mensch, hat für keine der beiden Einschränkungen einen Platz. Ausschluss nach Ticket-Typ und ein Konfidenz-Schwellenwert sind Eigenschaften einer Integration, nicht eines Logins.
Jemand auf Hacker News machte denselben Punkt, nur strukturell:
"AI Session Hijacking is such a dead end and I think this will be the thing that kills it. Just register these things in the IDP and let them sign into their own accounts."
Jede Option mit Grok Bot vergleichen
Bevor es zu den einzelnen Vorstellungen geht, hier derselbe Vergleich an einer Stelle. Wähle das Tool, das du gerade abwägst, und seine Antworten erscheinen neben denen von Grok Bot, bei den vier Dingen, die einen Blick wert sind.
Die 8 besten Grok-Bot-Alternativen 2026
Jeder Eintrag unten folgt derselben Form: für wen es ist, was es wirklich ist, wie es die drei Fragen beantwortet, was es kostet, Vorteile, Nachteile, dann mein Fazit. Zuerst aber die Tabelle, für alle, die nur überfliegen.
| Tool | Am besten für | Wo die Arbeit läuft | Testlauf | Laufprotokoll | SOC 2 | ISO 27001 | HIPAA | Kostenlose Stufe | Einstiegspreis | Abrechnungseinheit |
|---|---|---|---|---|---|---|---|---|---|---|
| Grok Bot | Oberflächen ohne API | Geteilter Cloud-Computer | Nein | Kommt bald | Nein | Nein | Nein | Nein | 200 $/Monat | Platz + wöchentliche Tokens |
| eesel AI | Support-Queues | Helpdesk-Integration | Simulation auf vergangenen Tickets | Activity + Reports | In Arbeit | Nein | Auf Anfrage | 100 kostenlose Credits | 299 $/Monat (500 Credits) | Credit (1 pro Ticket oder Chat) |
| Claude | Arbeit im eigenen Browser | Dein Chrome-Profil | Nein, Planfreigabe | Berechtigungsverlauf | Ja | Ja | Nicht in Chrome | Nein (Chrome ist kostenpflichtig) | 17 $/Monat | Pro Nutzer |
| ChatGPT Work | Ergebnisse + Connectors | OpenAI-Cloud, lokal auf dem Desktop | Nein, Aktionsbestätigung | Nur auf Aufgabenebene | Ja | Enterprise | Nicht veröffentlicht | Eingeschränkt auf dem Desktop | 20 $/Monat | Pro Nutzer, Credits |
| Manus | Recherche und Artefakte | Isolierte VM pro Aufgabe | Nein, Kostenbestätigung | Aufgabenverlauf + Replay | Ja | Ja | Nein | Nein | 20 $/Monat | Credits |
| Lindy | No-Code-Business-Agenten | Gehostete OAuth-Integrationen | Test Mode | Task History | Ja | Nein | Ja, BAA im Enterprise | 7 Tage Test | 29,99 $/Platz | Credits, gemeinsamer Pool |
| Zapier Agents | Größte App-Abdeckung, 9.000+ Apps | Infrastruktur von Zapier | Preview + Test Zap | Activity-Seite, Läufe löschbar | Ja, plus SOC 3 | Nein | Nein | Ja, 400 Aktivitäten | Kostenlos, dann 33,33 $/Monat | Aktivität |
| n8n | Teams, die Belege wollen | Dein Server oder EU-Cloud | Test workflow | Tab Executions | Ausgerichtet, SOC 3 öffentlich | Nein | Nein | Ja, selbst gehostet | 20 $/Monat | Workflow-Ausführung |
| Tasklet AI | Günstige Always-on-Automatisierungen | Sandbox pro Thread | Nein | Thread-Transkript | Ja | Nein | Nein | Ja | 25 $/Monat | Credits |
1. eesel AI
Am besten für: ein Support- oder Ops-Team, das einen Agenten in dem Helpdesk arbeiten lassen will, den es schon hat, und ihn vorher an der eigenen Ticket-Historie testen möchte, bevor er einem echten Kunden antwortet.
Ich arbeite hier, nimm die Begeisterung also entsprechend, und prüf die Links auch selbst. Was ich dir sagen kann, ist, warum die Bauweise hier anders ist. eesel AI bekommt keinen Desktop und meldet sich nie wie ein Mensch irgendwo an. Es wird als Integration über die API mit deinem Helpdesk verbunden und trägt eine benannte Liste dessen, was es darf: eine öffentliche Antwort schreiben, eine interne Notiz schreiben, das Ticket taggen, einer Gruppe zuweisen, Felder aktualisieren. Weil das einzelne, eng gefasste Aktionen sind und keine Klicks auf einem Bildschirm, erscheinen sie als sichtbare Ereignisse im Verlauf des Tickets selbst und respektieren alles, was an Zendesk-Triggern, Automatisierungen, SLA-Richtlinien und Geschäftszeiten bereits konfiguriert ist.

Die drei Fragen. Testlauf: ja, und das ist das Feature, mit dem ich einsteigen würde. Die Simulation spielt den Agenten über deine vergangenen Tickets ab und meldet die Abdeckung pro Thema, du siehst also „Erstattungsrichtlinie, 28 %“, schließt die Lücke und siehst, wie es vor dem Launch auf 91 % steigt. Audit-Trail: Die Activity-Ansicht filtert nach freigegeben, abgelehnt und ausstehend, jede Zeile verlinkt auf das betroffene Ticket, und Reports weist Freigabe- und Ablehnungsnutzung pro Tool aus. Zugriffsumfang: Konfidenzbasiertes Routing schickt Antworten mit niedriger Konfidenz als Entwurf an einen Menschen, statt sie zu senden, und ganze Ticket-Typen kannst du von der KI fernhalten.
Preise. Ein fester Monatspreis ohne Platzgebühr. 100 kostenlose Credits zum Start ohne Karte, dann Tarife ab 299 $/Monat für 500 Credits, wobei 1 Credit ein Ticket oder Chat ist, egal wie viele Nachrichten darin stecken. Blogbeiträge kosten 4,00 $ pro Stück. Wer ein Jahr im Voraus zahlt, bekommt zwei Monate gratis. SSO und MFA sind Add-ons ab 199 $/Monat, HIPAA auf Anfrage, und wenn die Credits ausgehen, kannst du Überschreitung mit einem von dir gesetzten Limit aktivieren.
Vorteile
- Die Simulation an echten historischen Tickets ist der einzige Testlauf auf dieser Liste, der eine Genauigkeitszahl liefert statt eines grünen Hakens.
- Abgerechnet in einer Einheit, in der Support-Leiter ohnehin denken: 1 Credit pro Ticket. Rückfragen und interne Schritte innerhalb eines Tickets verbrauchen keine zusätzlichen Credits.
- Aktionen erben die bestehenden Regeln des Helpdesks, nichts umgeht also deine Eskalations-Wege.
Nachteile
- SOC 2 Type II ist zertifiziert, und ein Käufer, der den Bericht braucht, kann ihn anfordern.
- HIPAA gibt es nur auf Anfrage statt self-serve, und bezahlte Tarife beginnen bei 299 $/Monat.
- Es ist kein Allzweck-Arbeitsagent und gibt auch nicht vor, einer zu sein. Es meldet sich nicht bei einem beliebigen SaaS-Tool ohne API an und klickt für dich herum, und genau dafür ist Grok Bot da.
Mein Fazit: Wenn die Arbeit aus Tickets besteht, ist das die richtige Wahl, und der Replay entscheidet es, nicht der Preis. Wenn die Arbeit etwas anderes als Tickets ist, spring zum nächsten Eintrag, denn Enge ist hier das ganze Design.
2. Claude (Anthropic)
Am besten für: Wissensarbeit, die in deinen eigenen Konten stattfinden soll, mit einem Plan, den du freigibst, bevor sich etwas bewegt.
Claude ist nicht wirklich ein einzelnes Agenten-Produkt, und das verwirrt diesen Vergleich, bis man es auseinandernimmt. Claude in Chrome ist eine Browser-Erweiterung, die Seiten liest, klickt und navigiert, bei denen du schon angemeldet bist. MCP-Connectors lassen Claude externe Tools über eine API aufrufen. Agent Skills bündeln die Abläufe, denen es folgt. Anthropics eigener Satz auf der Chrome-Seite beschreibt das Design am klarsten: Es "reads the page you're signed in to, then clicks, types, and fills forms while you decide what happens next."
Das ist im Grunde die entgegengesetzte Form des Schadensradius wie bei einer geteilten Cloud-Maschine. Eine Installation, der Browser einer Person, die eigenen Cookies dieser Person. Und Connectors "inherit each person's permissions from the connected service", das heißt, Claude kann nichts sehen, was das zugrunde liegende Konto nicht ohnehin sehen könnte. Beide Wege in einen Helpdesk habe ich in Claude mit deinem Helpdesk verbinden beschrieben.
Die drei Fragen. Testlauf: keine Simulation, aber das stärkste Freigabemodell hier. Drei benannte Berechtigungsmodi (Manually approve, Automatically approve, Skip all approvals) lassen sich pro Unterhaltung umschalten, und im Modus Manually approve nennt Claude einen Plan mit den Seiten, die es anfasst, und "will not deviate from the stated plan without requesting your permission first." Geschützte Aktionen brauchen immer eine Freigabe, und eine feste Liste wird ganz abgelehnt: Käufe, Kontoerstellung, Umgang mit Karten und Ausweisen, endgültiges Löschen. Audit-Trail: Das ist die Schwachstelle. Der veröffentlichte Verlauf ist ein „Berechtigungsverlauf“ pro Nutzer, welche Seiten du freigegeben hast, kein Protokoll dessen, was Claude angeklickt hat. Audit-Logs für die ganze Organisation gibt es im Enterprise-Tarif. Zugriffsumfang: Admins können eine Allowlist auf Seitenebene erzwingen, und Anthropics eigener Rat ist, restriktiv zu beginnen.
Preise. Free enthält kein Chrome und begrenzt eigene Connectors auf einen. Pro kostet 17 $/Monat bei jährlicher Zahlung oder 20 $ monatlich. Max kostet 100 $ oder 200 $/Monat für 5x und 20x Nutzung. Team kostet 20 $ pro Platz jährlich mit standardmäßig aktiviertem Chrome, Enterprise 20 $ pro Platz plus Nutzung zu API-Preisen, mit standardmäßig deaktiviertem Chrome, bis ein Admin es aktiviert. Mein Beitrag zu den Claude-Cowork-Preisen behandelt das größere Agenten-Paket.
Vorteile
- Das klarste veröffentlichte Berechtigungsmodell auf dieser Liste, mit dokumentiertem Standard pro Oberfläche und einem Plan, den du vor Arbeitsbeginn siehst.
- SOC 2 Type 2 und ISO 27001 beide veröffentlicht, mehr als die meisten Agenten-Produkte vorweisen können.
- Günstigster ernsthafter Einstieg mit 17 $/Monat, und das Modell darunter ist Claude Opus 5.
Nachteile
- Kein admin-seitiges Log pro Aktion für Chrome, eine Sitzung hinterher zu rekonstruieren heißt also, die Unterhaltung zu lesen.
- Alles, was auf der Seite sichtbar ist, gelangt in die Unterhaltung, und Anthropic sagt klar, dass "Claude can't filter sensitive content out of what it sees." In einer Queue voller Kartennummern ist das wichtig.
- Nicht verfügbar für HIPAA-pflichtige Organisationen, mit ausdrücklicher Empfehlung, es nicht auf regulierten Seiten zu verwenden.
Mein Fazit: Die beste Allzweck-Wahl, wenn der Agent in deinem eigenen Browser leben soll statt im Rechenzentrum eines anderen, und die, die ich einem nicht technischen Kollegen ohne Sorge geben würde. Lass sie aber aus, wenn dir ein Audit-Log wichtiger ist als Freigaben oder wenn du reguliert bist. Für die Support-spezifische Version desselben Zielkonflikts siehe Claude-Kundenservice-Alternativen.
3. ChatGPT Work (OpenAI)
Am besten für: Teams, die schon in ChatGPT arbeiten und lange mehrstufige Aufgaben und fertige Dokumente am Ende wollen.
Zuerst eine Korrektur, die man kennen sollte, bevor man weitersucht: "ChatGPT agent" gibt es nicht mehr. Das Hilfecenter von OpenAI sagt jetzt "ChatGPT agent is no longer available. Use ChatGPT Work for longer, multi-step tasks and finished deliverables. For supported browser workflows, see Using cloud browser in ChatGPT." Womit du Grok Bot heute also wirklich vergleichst, ist ChatGPT Work plus ein separater Cloud-Browser, nicht der alte Agent-Modus von früher.
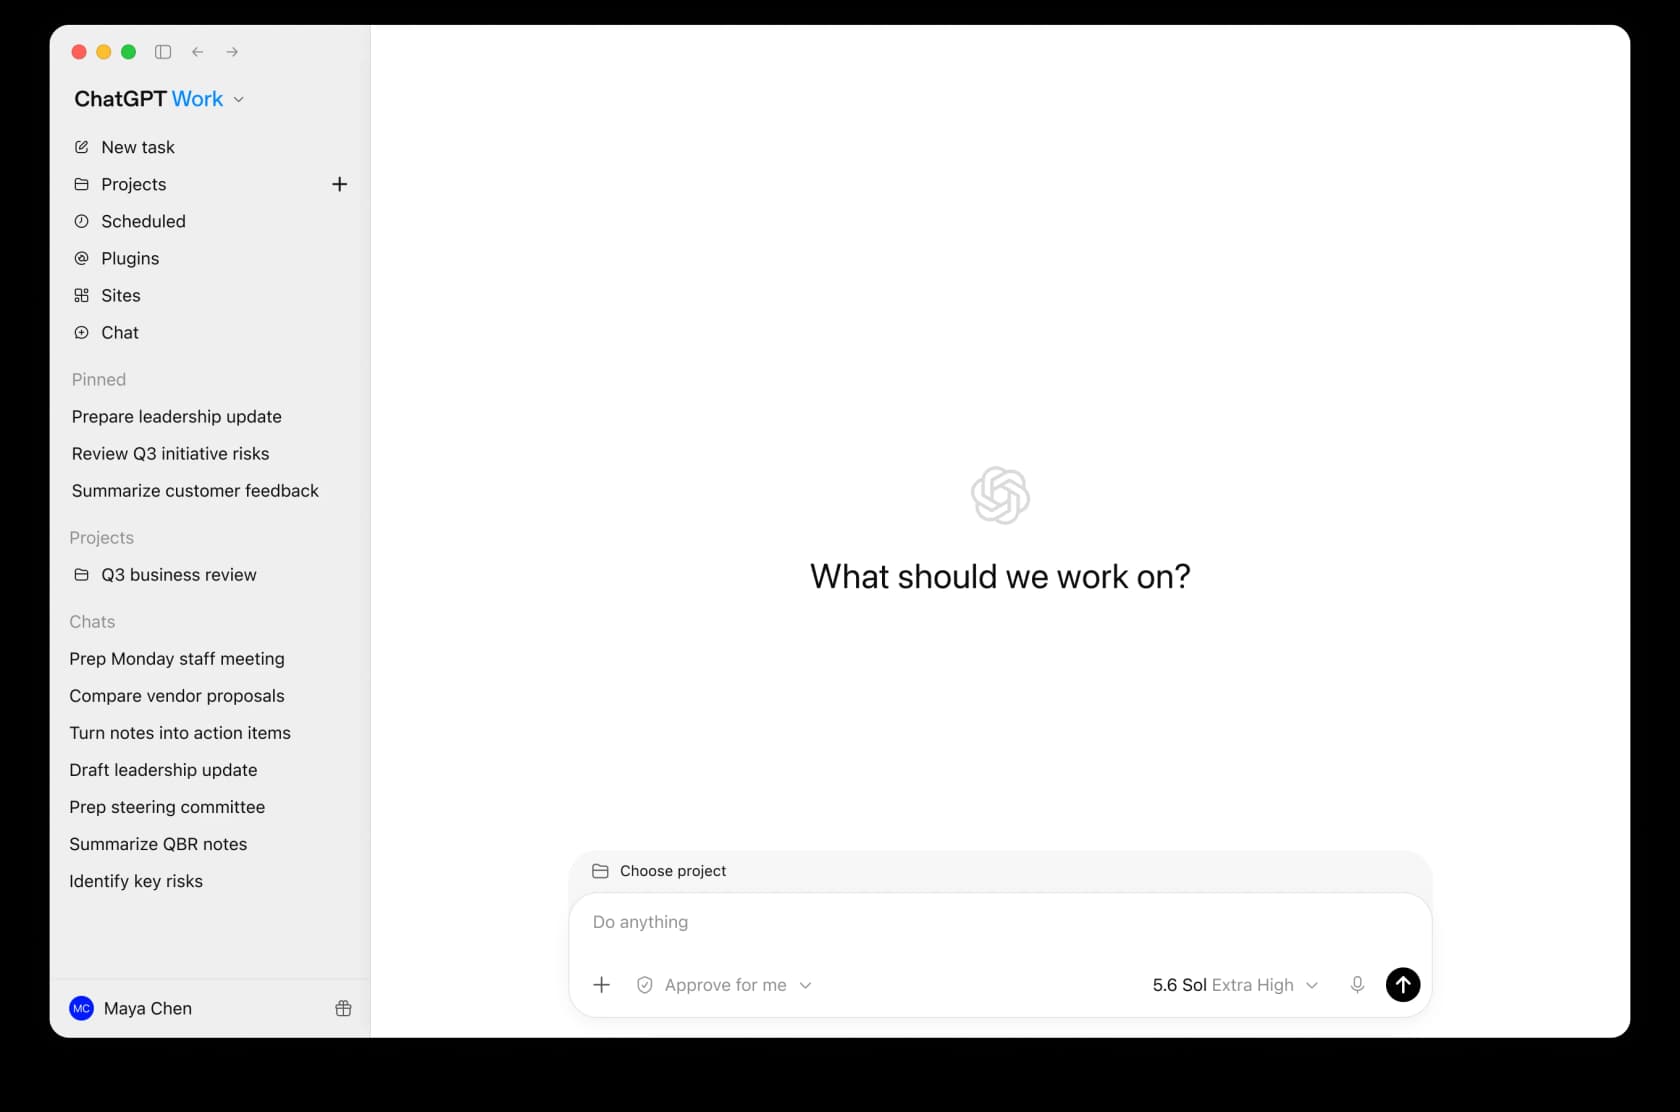
Die Trennung ist für den Schadensradius sehr wichtig. Work läuft im Web und auf dem Handy in der Cloud, und in der Desktop-App kann es mit Erlaubnis lokale Dateien und Desktop-Apps anfassen. Der Cloud-Browser ist eine separate Remote-Sitzung, und beim Start "does not accept credentials, use autofill or password managers, sign in to websites, or complete payments. If a site requires one of those steps, the task stops." Das ist exakt das Gegenteil des ganzen Designs von Grok Bot, und je nach Aufgabe ist es entweder das Sicherste auf dieser Liste oder ein glatter Ausschlussgrund.
Die drei Fragen. Testlauf: keiner veröffentlicht. Das Gate ist eine Live-Bestätigung bei allem, was OpenAI als "important action" einstuft, definiert als eine, die "could have a meaningful effect outside ChatGPT, expose sensitive information, or be difficult to undo", und die Standard-Berechtigungsstufe ist Important actions. Audit-Trail: dünn auf eine bestimmte Weise, die ein Zitat wert ist, weil es dieselbe Form hat wie die Lücke von Grok Bot. Für Enterprise gilt: "conversations involving agent tasks will appear in Compliance API logs, but individual agent actions (such as virtual computer usage, app requests, chain of thought) will not." Connector-Aufrufe werden protokolliert, Browser-Schritte nicht. Zugriffsumfang: echte Eindämmung auf Workspace-Ebene, mit standardmäßig ausgeschaltetem Agentenzugriff, RBAC nach Rolle und Domain-Sperrlisten.
Noch etwas zur Isolation: Cookies "persist across sessions for convenience, just like a regular browser", der Remote-Browser wird also standardmäßig nicht pro Aufgabe zurückgesetzt.
Preise. Free bekommt begrenztes Work nur auf dem Desktop. Go für 8 $/Monat schließt den Cloud-Browser aus. Plus kostet 20 $/Monat, Pro ab 100 $/Monat, Business 25 $ pro Nutzer monatlich oder 20 $ jährlich, Enterprise individuell. Work folgt jetzt der Credit-Struktur von Codex statt eines festen Nachrichtenlimits, OpenAI veröffentlicht also kein festes Aufgabenlimit mehr. Bei Enterprise-Workspaces muss Enterprise Key Management eingeschaltet sein, bevor Work überhaupt läuft.
Vorteile
- Die Bestätigungsliste ist konkret und benannt statt vage, und sie greift standardmäßig.
- Echte Admin-Eindämmung: standardmäßig aus, RBAC-gesteuert, Domain-Sperrlisten.
- Standardmäßig kein Training mit Geschäftsdaten in Business, Enterprise und Edu, auch nicht mit Daten, die in Agenten-Sitzungen berührt wurden.
Nachteile
- Die Compliance API sagt dir, dass eine Aufgabe lief, nicht, was sie im virtuellen Computer getan hat.
- Cookies bleiben zwischen Läufen bestehen, eine Sitzung gilt also nicht nur für eine Aufgabe, sofern du sie nicht löschst.
- Kein veröffentlichter Testlauf oder historischer Replay, nur eine Echtzeitabfrage bei der Aktion selbst.
Mein Fazit: Die richtige Wahl, wenn deine Firma schon auf ChatGPT standardisiert hat und das Ergebnis ein Dokument ist. Dass der Cloud-Browser Logins grundsätzlich ablehnt, ist die interessanteste Design-Entscheidung auf dieser ganzen Liste, und wenn du Grok Bot gerade deshalb erwogen hast, weil es sich irgendwo anmeldet, ist das hier nicht dein Ersatz. Passende Lektüre: ChatGPT mit Zendesk und mein Beitrag zu ChatGPT Work.
4. Manus
Am besten für: offene Arbeit, die du sonst einem Freelancer geben würdest, wenn dir das Ergebnis wichtig ist und du nachspielen können willst, wie es entstanden ist.
Manus nimmt ein Ziel in normaler Sprache, führt die ganze mehrstufige Aufgabe selbst aus und gibt dann etwas Fertiges zurück: einen Bericht, eine Website, ein Deck, einen Batch-Datenabzug. Ein Hinweis, den ältere Berichterstattung falsch hat: Manus war 2026 zeitweise mit Meta verbunden, aber laut eigener Mitteilung vom 11. August 2026 wird es "soon return to operating as an independent company." Mein Beitrag zu Manus AI hat mehr Hintergrund dazu.
Die drei Fragen. Wo es läuft, ist die Schlagzeile: Manus Sandbox ist "a fully isolated cloud virtual machine that Manus allocates for each task. Each Sandbox runs in its own environment, does not affect other tasks, and can execute in parallel." Das ist die direkte architektonische Antwort auf den einen geteilten Computer von Grok Bot. Testlauf: keine Simulation. Wide Research zeigt eine Nutzungsschätzung und "requires confirmation before executing", das begrenzt Kosten und Umfang, nicht die Korrektheit. Audit-Trail: der beste auf dieser Liste, und das Feature, das ich klauen würde. Der Aufgabenverlauf protokolliert jede Aktion, und ein teilbarer Replay-Link spielt einen Lauf Schritt für Schritt ab. Ein Rezensent auf LinkedIn sagte es gut: "one thing that I love about Manus is it's got a replay function so you can see what it did decision making wise and action wise behind the scenes."
Preise. Standard 20 $/Monat für 4.000 Credits plus 300 pro Tag. Customizable 40 $/Monat für 8.000. Extended 200 $/Monat für 40.000 und einen kostenlosen Cloud Computer. Team und Enterprise laufen über den Vertrieb. Die Abrechnungseinheit ist der Credit, und Manus veröffentlicht keinen festen Satz, was einer kauft, was die wiederkehrende Beschwerde ist:
"Manus AI agent is super expensive. I feel like the pricing model needs some adjustment because it's really costly. They give you only 1,000 credits at a time, which is not enough, especially for heavy tasks."

Vorteile
- Eine isolierte VM pro Aufgabe, eine außer Kontrolle geratene Aufgabe kann also nicht in eine andere hineingreifen.
- Replay-Links sind ein echtes Audit-Artefakt, das du jemand anderem schicken kannst.
- Drei unabhängige Zertifizierungen in einem öffentlichen Trust Center: SOC 2 Type II, ISO 27001:2022, ISO 27701:2019.
Nachteile
- Kein Testlauf an deinen eigenen Daten, nur eine Kostenbestätigung vor dem Batch-Modus.
- Kein veröffentlichter Satz pro Credit, die echten Kosten eines wiederkehrenden Jobs sind also erst nach dem Lauf bekannt.
- Kein HIPAA-Anspruch, und grenzüberschreitende Übermittlungen stützen sich auf SCCs statt auf eine formale DSGVO-Zertifizierung.
Mein Fazit: Bei 20 $/Monat gegenüber 200 $ bei Grok Bot, mit Isolation pro Aufgabe und einem echten Replay, ist Manus der engste Eins-zu-eins-Ersatz für einen Einzelnutzer mit allgemeiner Arbeit. Siehe Manus-AI-Alternativen, falls das Credit-Modell dein Stolperstein ist.
5. Lindy
Am besten für: ein kleines Team, das einen No-Code-Agenten will, der mit Gmail, Slack und Calendar verbunden ist, mit standardmäßig aktivierten Freigaben.
Lindy ist im Grunde ein Baukasten: Trigger wählen, den Job in normaler Sprache beschreiben, und der Agent liest den Kontext über alle verbundenen Apps und handelt danach. Das meiste läuft über gehostete OAuth-Integrationen zu angeblich über 1.000 Apps, der Schadensradius ist hier also, was an Berechtigungen vergeben wurde. Wenn es keine API gibt, steuert ein separater Computer Use-Skill, ab Pro, stattdessen einen Browser auf einem von Lindy gehosteten Computer, mit einer Option Incognito Computer, die nichts speichert, und einer Schaltfläche Take Control mitten im Lauf, falls etwas schiefgeht.
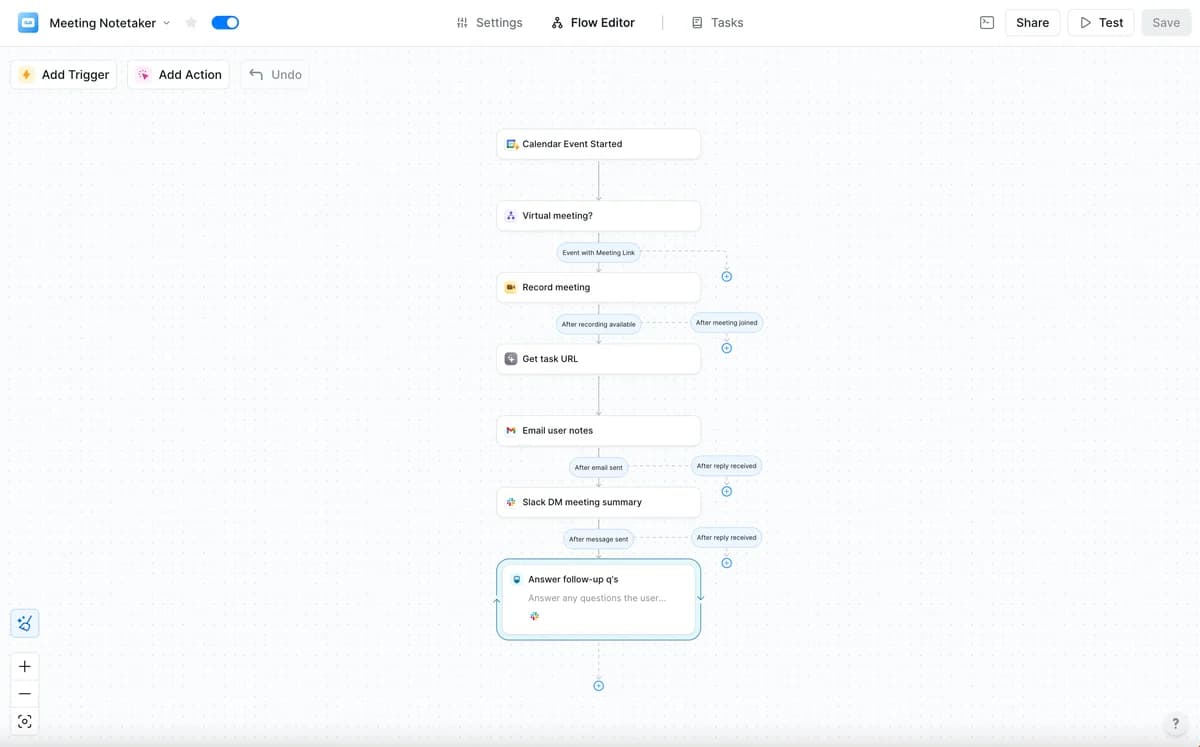
Die drei Fragen. Testlauf: ja, ein benannter Test Mode. Du klickst im Flow-Editor auf Test, führst den Workflow aus, und Lindy zeigt, wo und warum er hängen geblieben ist, mit einer Abkürzung zum fehlgeschlagenen Schritt. Audit-Trail: Task History pro Agent, Block für Block aufklappbar, plus eine Aktion Get Task Details, die Ein- und Ausgaben, Zeitstempel und Status jedes Blocks liefert. Die Dokumentation nennt "generate detailed audit logs" als Anwendungsfall, was die ehrliche Darstellung ist: Du hast die Bausteine, das Audit-Log-Feature auf Compliance-Niveau gibt es im Enterprise. Zugriffsumfang: Jede Aktion mit Wirkung nach außen (E-Mail senden, Ticket aktualisieren, in einen Kanal posten, ein Dokument veröffentlichen) wartet standardmäßig auf menschliche Freigabe, reine Lesezugriffe nicht.
Preise. Seit meinem letzten Blick neu bepreist, jetzt pro Platz. Plus 29,99 $ pro Nutzer für 3.000 Credits, Pro 99,99 $ für 15.000, Max 199,99 $ für 35.000, Enterprise individuell. Credits werden im Workspace gepoolt, monatlich zurückgesetzt und nicht übertragen. Ist der Pool leer, pausiert Lindy, statt Überschreitung abzurechnen. 7 Tage Test. Beachte, dass Browser-Steuerung die Stufe für 99,99 $ braucht.
Vorteile
- Freigabe-Gates sind standardmäßig aktiv, statt etwas, woran man sich beim Konfigurieren erinnern muss.
- Die Beobachtbarkeit auf Blockebene ist gut genug, um darauf ein eigenes Qualitätsscoring aufzubauen.
- Starkes Signal bei der Bedienbarkeit: 4,9/5 aus 171 G2-Bewertungen, mit Bedienbarkeit als meistgenanntem Pluspunkt bei 125 Nennungen.
Nachteile
- Die Credit-Preise sind die häufigste Beschwerde auf G2, 42-mal als Expensive markiert, und Rezensenten beschreiben, dass sie vor dem Lauf nicht wissen, was eine Aufgabe kostet.
- Computer Use ist auf die Stufe für 99,99 $ beschränkt, Aufgaben ohne API brauchen also den zweiten Tarif darüber.
- Formale Audit-Logs und SSO gibt es nur im Enterprise.
Eine kleine Spitze eines Rezensenten genau gegen die Oberfläche, um die es in diesem Beitrag geht:
"'Testing' side tab reloads on changes, back log available but non-intuitively under 'tasks' at top"

Mein Fazit: Die beste Antwort, wenn du das „Team aus Kollegen“-Gefühl von Grok Bot willst, aber mit bereits vorhandenen Freigaben und einem Laufprotokoll, und es dich nicht stört, pro Platz zu zahlen. Siehe Lindy AI für einen längeren Blick oder No-Code-Agent-Builder, falls du diese Kategorie vergleichst.
6. Zapier Agents
Am besten für: die größte App-Abdeckung auf dieser Liste und der sicherste Einstieg, weil die Automatisierung ein Workflow bleibt, den du lesen kannst.
Zapier Agents werden in natürlicher Sprache beschrieben, mit deinen Live-Daten verbunden und handeln nach Zeitplan, auf Abruf oder per Trigger, je nachdem, was passt. Sie nutzen genau dieselben OAuth-Verbindungen, die deine Zaps schon verwenden, Zapier hält also die Zugangsdaten einmal pro App, und der Agent ruft die vorhandenen Trigger und Aktionen dieser App auf, statt sich durch eine Oberfläche zu klicken. Der Connector-Graph ist hier das eigentliche Verkaufsargument: über 9.000 Apps.
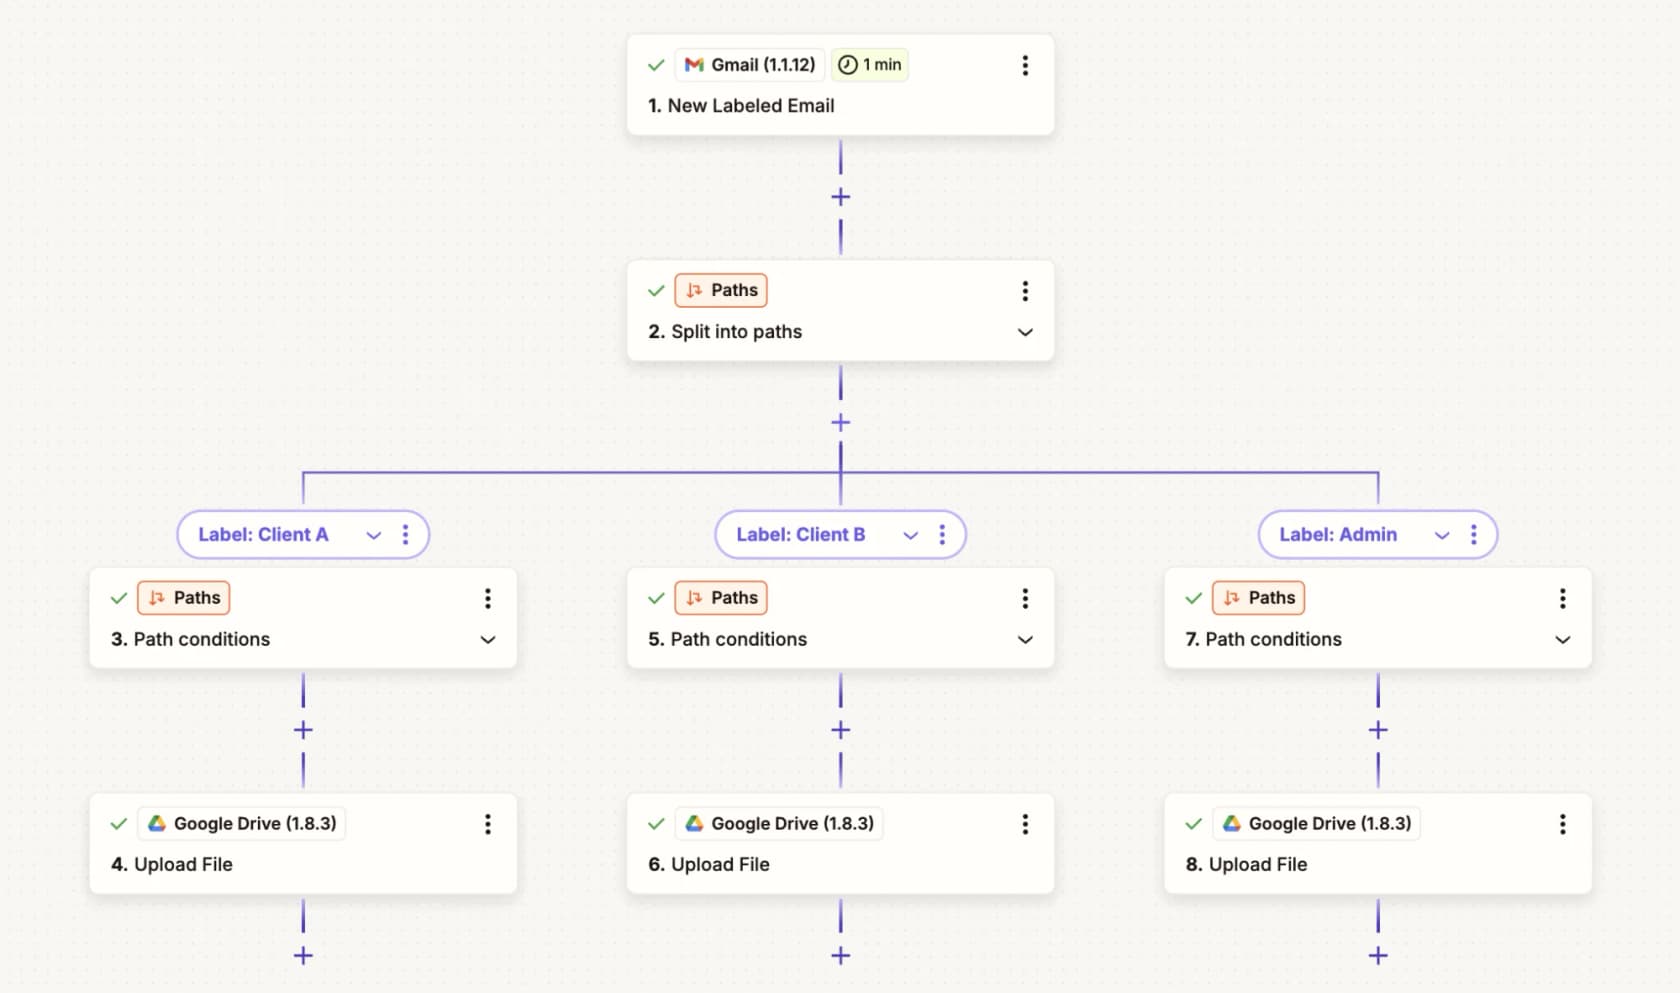
Kauf aber mit offenen Augen, was eines betrifft: Das eigenständige Agents-Produkt wird in „AI by Zapier“ überführt, einen Schritt im normalen Zap-Editor, und Enterprise-Testkonten mussten bis zum 15. August 2026 migrieren oder auf ein kostenloses Agents-Konto zurückfallen. Die Oberflächen unten bewegen sich also unter dir.
Die drei Fragen. Testlauf: ja, und er überlebt die Migration. Im alten Builder gilt: "until you publish, your agent only runs during testing." Im neuen Flow sind es zwei Schritte, Preview, um nur den KI-Schritt an Beispieldaten auszuführen und zu sehen, welche Tools er aufrufen würde, dann Test Zap für den ganzen Workflow. Der Vorbehalt kommt von Zapier selbst: "Full-Zap tests currently consume tasks the same way production runs do. Zapier is working on a fix for this." Audit-Trail: Das eigenständige Produkt hat eine Activity-Seite mit Laufstatus, genutzten Apps und Zeitstempeln. Sie ist nicht manipulationssicher, weil jeder Nutzer mit Zugriff einen bestimmten Lauf löschen kann und das Löschen eines Agenten dessen Verlauf entfernt. Nach der Migration landet jeder Lauf stattdessen im normalen Zap-Verlauf, wo du "review which tools were called, what data was passed, which model tier was used, and how many tasks it consumed" kannst, ein echtes Upgrade. Zugriffsumfang: das, was der OAuth-Verbindung gewährt wurde, plus eine Kontrolle für eingeschränkte Apps im Enterprise.
Preise. Hier lag die vorherige Version meiner eigenen Notizen falsch, deshalb sorgfältig formuliert. Agents rechnen über einen separaten Aktivitätszähler ab, nicht über den gemeinsamen Zap-Task-Pool. Eine Aktivität sind "actions your agent takes in behaviors or in chat, browsing the web, or looking up information from attached knowledge." Agents Free kostet dauerhaft 0 $ mit 400 Aktivitäten pro Monat. Agents Pro kostet 33,33 $/Monat bei jährlicher Zahlung (400 $ im Voraus) für 1.500. Enterprise ist individuell und ergänzt organisationsweites Teilen und Enterprise-Audit-Logs. Sobald ein Agent ein AI-by-Zapier-Schritt wird, wird er wie alles andere nach Tasks abgerechnet.
Vorteile
- Über 9.000 Apps, mehr Reichweite als alles andere hier ohne Browser.
- Aktionen laufen über verwaltete OAuth-Verbindungen auf Zapiers Infrastruktur statt über eine anfällige UI-Schicht.
- Ein echter Test-Schritt vor der Veröffentlichung, im alten wie im neuen Builder, nichts geht also direkt in die Produktion.
Nachteile
- Das Aktivitätslog ist pro Lauf löschbar und verschwindet mit dem Agenten, es ist also eine Debugging-Aufzeichnung, keine Audit-Aufzeichnung.
- Das Produkt wird gerade in AI by Zapier überführt, du musst die Oberfläche also innerhalb von ein, zwei Releases neu lernen.
- Testläufe im neuen Flow verbrauchen echtes Task-Kontingent, Testen ist also weder kostenlos noch frei von Nebenwirkungen.
Der Beta-Rahmen plus der Jahrespreis hat mindestens einen Käufer verärgert:
"Zapier agents dont seem ready for prime time... They label Agents as a beta feature, so I don't expect it to be perfect, but they still charged me $400 for it."
Mein Fazit: Ein vernünftiger erster Schritt, wenn bei dir schon Zaps laufen, denn ein Agent, der im Kern ein Workflow ist, lässt sich lesen, vergleichen und jederzeit abschalten. Ich würde warten, bis sich die Migration zu AI by Zapier beruhigt hat, bevor ich etwas Tragendes darauf baue, und ich würde diese Activity-Seite nicht als Audit-Trail zählen, solange jeder Kollege einen Lauf nach Belieben löschen kann. Lesenswert neben AgentKit vs. Zapier, wenn es um die Klebeschicht geht.
7. n8n
Am besten für: ein technisches Team, das die Infrastruktur selbst besitzen und genau sehen will, was jeder Tool-Aufruf getan hat, und dabei akzeptiert, die Test-Umgebung selbst zu bauen.
n8n ist eine Workflow-Plattform mit einsehbarem Quellcode (source-available), visuelle Canvas, und du kannst echtes JavaScript oder Python direkt einfügen. Der AI-Agent-Knoten ist im Grunde ein Tools Agent im LangChain-Stil, den du selbst verdrahtest: Chat-Modell, Tools, Speicher, auf Wunsch ein Vektorspeicher. Das ist mehr Arbeit als ein fertiger Agent, klar, aber genau das ist der Punkt.
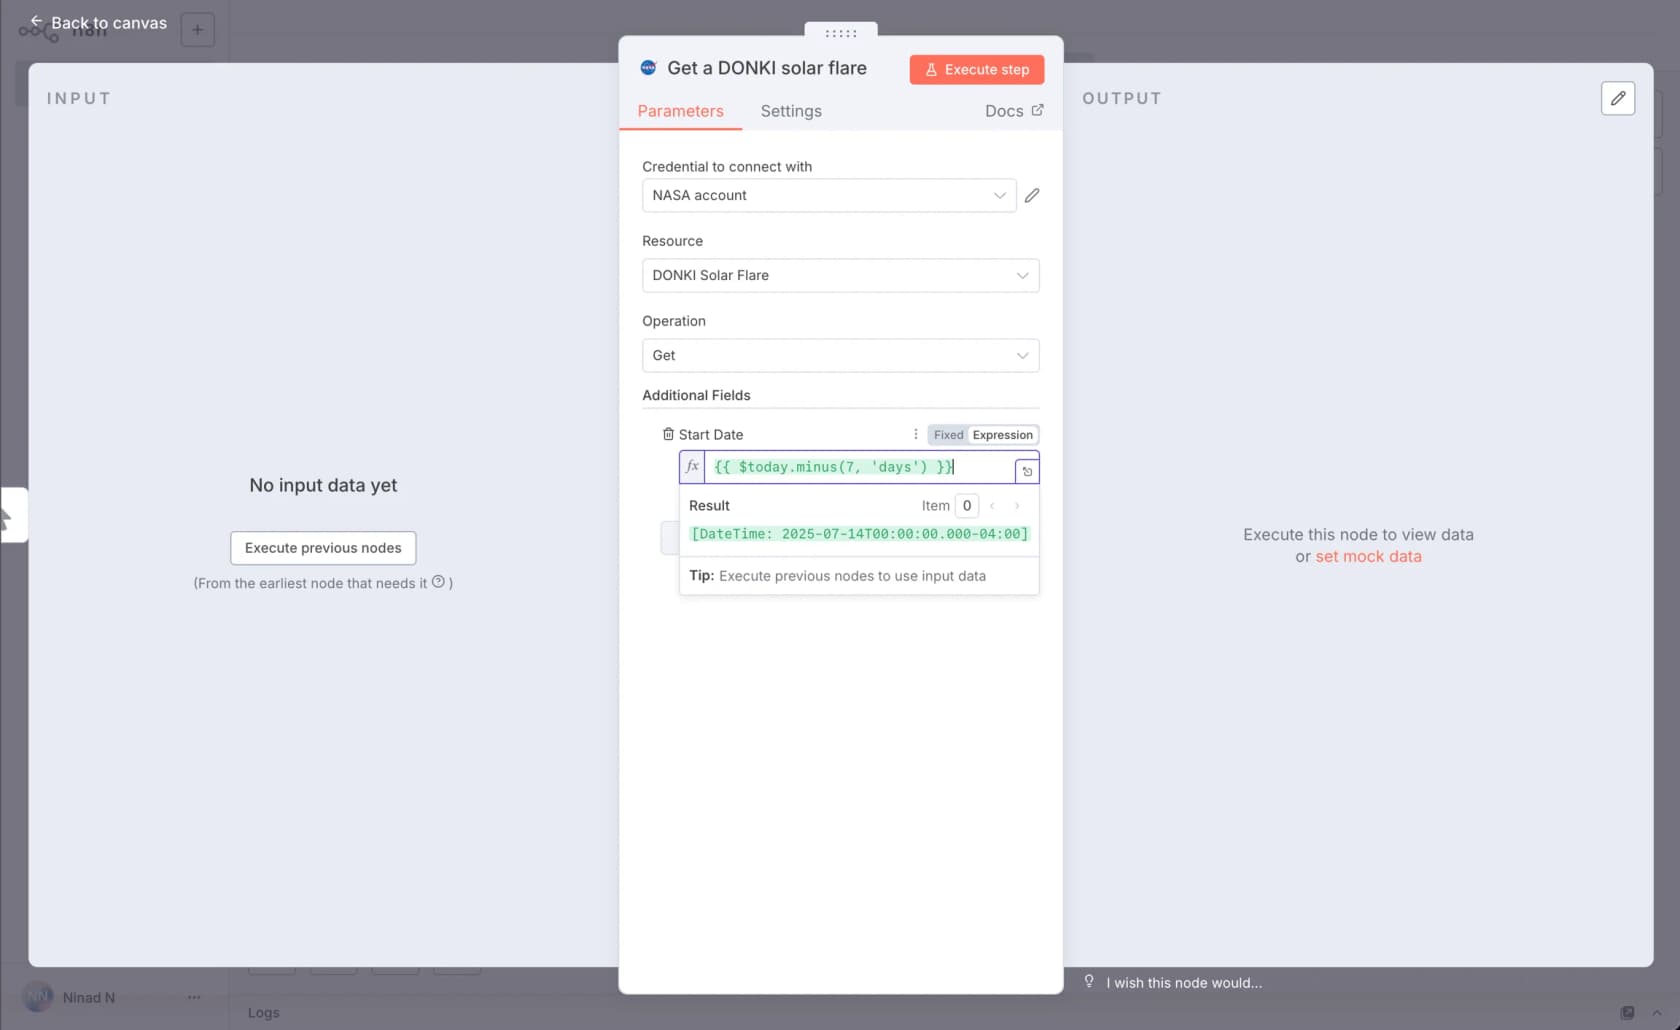
Die drei Fragen. Wo es läuft, bestimmst du: Selbsthosting per Docker oder npm unter der Sustainable Use License, die Fair-Code ist und keine OSI-Open-Source-Lizenz, oder n8n Cloud auf Azure in der EU. Testlauf: Test workflow auf der Canvas und Execute step an einem Knoten, und manuelle Läufe zählen nicht gegen dein Kontingent. Sei aber nüchtern: Ein manueller Lauf ruft weiterhin echte APIs mit echten Zugangsdaten auf, sofern du die Daten nicht pro Knoten mockst, er ist also eine echte Ausführung und keine Sandbox. Audit-Trail: die besten Belege hier. Jeder Lauf ist eine Execution im Tab Executions, mit Status, Zeitangaben und der genauen Ein- und Ausgabe jedes Knotens. Aufbewahrung: 7 Tage im Starter, 30 im Pro, unbegrenzt im Enterprise, und Enterprise ergänzt Log-Streaming an ein SIEM.
Preise. Die Community Edition ist selbst gehostet dauerhaft kostenlos. Starter 20 $/Monat für 2.500 Ausführungen, Pro 50 $/Monat für 10.000, Business 800 $/Monat für 40.000, Enterprise individuell, alle jährlich abgerechnet. Die Einheit ist klar benannt: "An execution is a single run of your entire workflow. It doesn't matter how many steps are in the workflow or how much data it processes, it's still a single execution." Nutzer sind in jedem Tarif unbegrenzt.
Vorteile
- Ein- und Ausgabe pro Knoten bei jedem Lauf, das ist der Unterschied zwischen „der Agent hat etwas getan“ und einem debugbaren Trace.
- Volles Selbsthosting, sensible Daten verlassen also nie deine Infrastruktur. Ein G2-Rezensent lobte genau das: Es "allowed our team to automate sensitive customer data workflows without sending that data to a third-party cloud."
- Abrechnung nach Ausführungen heißt, ein KI-Workflow mit 200 Schritten kostet genauso viel wie einer mit zwei.
Nachteile
- Workflows und Zugangsdaten der Community Edition haben nur einen Besitzer, ein Team bekommt also ohne Bezahlung keine gemeinsame Sicht.
- Kein historischer Replay für KI-Agenten. Einen zu testen heißt, selbst einen Evaluierungsdatensatz in einer Datentabelle oder Google Sheet aufzubauen.
- Die Abrechnung nach Ausführungen schlägt bei Chat- und Polling-Mustern zu, wo jede Interaktion ein eigener Lauf ist:
"Zapier → Make → n8n is the classic pilgrimage. If something keeps breaking, it's usually just one trigger that isn't set the way you think. Check the execution logs- 99% of the time the answer is hiding there."
Mein Fazit: Wenn dein Grund, Grok Bot zu verlassen, ist, dass du nicht belegen kannst, was es getan hat, ist n8n die Antwort, und der Preis dieser Antwort ist Entwicklungszeit, schlicht und einfach. Es gibt einen echten Weg über die Zendesk-n8n-Integration, wenn du die Queue selbst verdrahten willst, und AgentKit vs. n8n behandelt auch den Vergleich der Klebeschicht.
8. Tasklet AI
Am besten für: günstige Always-on-Automatisierungen über gängige Tools hinweg, wenn Preis und Breite wichtiger sind als Papierkram.
Tasklet, gebaut von den Mitgründern von Firebase, macht aus einem Satz in normaler Sprache eine wiederkehrende Automatisierung statt nur einer einmaligen Antwort. Jeder Agent bekommt eine eigene isolierte Sandbox auf Google Cloud und startet nach Zeitplan, bei einem App-Ereignis oder über einen Webhook, läuft also weiter, lange nachdem du den Laptop geschlossen hast. Die Reichweite kommt auf zwei Wegen: direkte API- und MCP-Aufrufe gegen angeblich über 3.000 Integrationen, plus ein Computer-use-Browser in der Sandbox, der durch Web-Oberflächen klickt und ein Login-Profil pro Thread behält.
Die drei Fragen. Testlauf: nichts Strukturiertes. Testen heißt, im Thread zu fragen oder das Detailfenster der Automatisierung über das Blitzsymbol zu öffnen. Audit-Trail: auch kein benanntes Log; das Thread-Transkript ist die Aufzeichnung, und die Trust-Seite beschreibt interne Zugriffskontrollen von Tasklet, kein kundenseitiges Aktionslog. Zugriffsumfang: Das Schönste hier ist, dass das Teilen Zugriff von Zugangsdaten trennt, ein Kollege kann also eine geteilte Stripe- oder CRM-Verbindung nutzen, ohne je den Schlüssel zu sehen.
Preise. Free ist echt: keine Karte, 300 Bonus-Credits pro Tag, unbegrenzte Agenten und Integrationen, begrenzt auf 10 Ausführungen pro Automatisierung. Starter 25 $/Monat für 10.000 Credits, Pro 100 $/Monat für 40.000, Custom ab 250 $/Monat für 100.000 und ein Schieberegler bis 4.000.000. Es gibt keinen veröffentlichten Satz pro Credit und keine genannte Regel für Überschreitung.
Vorteile
- Eine echte kostenlose Stufe ohne Karte, was in der oberen Hälfte dieser Liste sonst nichts bietet.
- Sehr breite Reichweite: über 3.000 eingebaute Integrationen plus jede HTTP-API oder jeder MCP-Server, auch private interne.
- Geteilte Verbindungen lassen Kollegen einen Login nutzen, ohne die Zugangsdaten zu sehen.
Nachteile
- Kein Dollar-Satz pro Credit oder Task und keine Regel für Überschreitung, die echten Kosten einer wiederkehrenden Automatisierung sind also erst nach dem Lauf bekannt.
- Kein strukturierter Testlauf und kein benanntes Laufprotokoll, dieselbe Lücke, die Grok Bot schwer auslieferbar macht.
- SOC 2 ist die einzige attestierte Zertifizierung. DSGVO ist als in Arbeit gelistet, und es gibt weder ISO 27001, HIPAA noch eine Residenz-Option.
Mindestens ein namentlich genannter Anwender ist zufrieden:
"If AI agents have seemed theoretical or inaccessible to you, you should definitely try Tasklet. I've been using Tasklet for a few weeks now and it has already been transformative to my day-to-day life. [...] I now have 20+ agents running. [...] I've wanted this for years. [...] Incredible product."

Mein Fazit: Der günstigste Weg herauszufinden, ob ein Always-on-Agent überhaupt hilft, und ich würde dort gern eine Idee testen. Ich würde ihn aber nicht für etwas Kundennahes einsetzen, bis die Audit-Seite mit der Zahl der Integrationen mithält.
Was ich wirklich wählen würde
Wenn dir ein Satz reicht: Wähle danach, auf welche der drei Kontrollen du nicht verzichten kannst, nicht danach, welcher Agent am besten demonstriert.
- Die Arbeit ist deine Support-Queue. eesel AI, weil es das Einzige ist, das deine eigenen Tickets nachspielt und dir zuerst eine Zahl gibt. Ein Tarif ab 299 $/Monat schlägt 200 $ pro Platz, sobald du ein paar Plätze hast, und der Vergleich KI vs. menschliche Kosten ist die andere Hälfte dieser Rechnung.
- Du brauchst vor allem Belege. n8n, wenn du Entwickler hast, Manus, wenn nicht. Executions mit Daten pro Knoten oder ein Replay-Link, den du jemandem schicken kannst.
- Du willst allgemeine Arbeit in deinen eigenen Konten. Claude in Chrome, für 17 $/Monat, mit einem Plan, den du freigibst, bevor es loslegt.
- Du hast auf ChatGPT standardisiert. ChatGPT Work, und wisse, dass sein Cloud-Browser sich nirgends anmeldet.
- Du willst Kollegen mit bereits aktiven Freigaben. Lindy, wenn Preise pro Platz für dich funktionieren.
- Du betreibst schon Zaps. Zapier Agents, weil ein Agent, der im Kern ein lesbarer Workflow ist, sich abschalten lässt. Warte vorher die Migration zu AI by Zapier ab.
- Du testest, ob das überhaupt hilft. Die kostenlose Stufe von Tasklet oder selbst gehostetes n8n.
- Das Tool, das du automatisieren musst, hat keine API und wird nie eine haben. Dann ist Grok Bot weiterhin die Antwort, und der ehrliche Rat ist, ihm eigene Konten statt deiner zu geben, die lokale Ausführung auf dem Computer auf „nie erlaubt“ zu lassen und den geteilten Computer als eine einzige Sicherheitsgrenze statt als mehrere zu behandeln. Das rät dir auch die Dokumentation.
Was ich nicht tun würde: eines davon zu kaufen, nur weil es sich nach Zukunft anfühlt. Der Abstand zwischen einem KI-Agenten und einem Chatbot ist nicht Intelligenz, sondern wer die Verantwortung trägt, wenn etwas schiefgeht. Wähle das, bei dem du diese Frage laut beantworten kannst, ohne zusammenzuzucken.
eesel an deiner Support-Queue ausprobieren
Wenn du hier gelandet bist, weil das Beispiel-Prompt von Grok Bot davon sprach, eine Zendesk-Queue zu bearbeiten, und du eigentlich die Version wolltest, die ein Support-Leiter ohne Bauchweh abnehmen kann, ist das eesel AI. Es verbindet sich über die Integration, nicht über einen Browser-Login, mit Zendesk, Freshdesk, Gorgias oder Front, lernt aus deinen vergangenen Tickets und deinem Hilfecenter und beantwortet dann nur die Tickets, bei denen es sich wirklich sicher ist.
Den Replay würde ich ehrlich gesagt zuerst testen. Richte ihn auf den letzten Monat, sieh dir die Abdeckung pro Thema an, schließe die Lücken, die sich zeigen, und starte, sobald die Zahl eine ist, die du in einem Meeting ohne Schweißausbruch vertreten würdest. Jede danach ausgeführte Aktion erscheint in Activity als freigegeben, abgelehnt oder ausstehend, mit der Freigabenutzung pro Tool, sodass „was hat die KI am Dienstag getan“ tatsächlich eine Antwort hat.

Es startet mit 100 kostenlosen Credits und ohne Karte, die Simulation zu starten kostet dich also gar nichts. eesel ausprobieren.