

Qwen 3.8 Flash Next ist ein tolles Spielzeug und eine wackelige Produktionsabhängigkeit. Es ist Alibabas Open-Weight-Vorschau der Qwen4-Architektur, die Qwen selbst als absichtlich untertrainiert bezeichnet, über nur einen einzigen API-Anbieter verfügbar und wortreich genug, um die Output-Rechnung aufzublähen. Wenn Ihnen also Preis und Geschwindigkeit gefallen haben, Sie aber etwas Ausgereifteres brauchen, hier die Anlaufstellen:
- Der fertige Open-Weight-Zwilling: GLM 5.3 Flash, das die Community als produktionsreif betrachtet und in der Aktion mit $0.075/$0.25 anbietet.
- Der Budget-Boden: DeepSeek V4 Flash (MIT-Lizenz) oder selbst gehostetes Granite 4.2 8B, gehostet für $0.06/$0.25.
- In der Familie bleiben: Qwen 3.8 Max, das stabile, gehostete große Geschwistermodell.
- Verwaltet und multimodal: Gemini 3.7 Flash oder GPT-5.6 Luna, wenn Sie die Zuverlässigkeit eines großen Anbieters wollen.
Und der wichtigste Punkt, wenn Sie für den Support nach "günstiger KI" suchen: Das Modell sind die einfachen 10 %. Aus einem dieser Modelle etwas zu machen, das tatsächlich Tickets löst, sind die anderen 90 %, und das ist Aufgabe einer Plattform, keine Modellentscheidung.
Warum Teams von Qwen 3.8 Flash Next weiterziehen
Ich baue bei eesel KI-Agenten und beobachte daher, wie sich die Ebene der günstigen Modelle alle paar Wochen erneuert. Qwen 3.8 Flash Next war einer der lautesten Launches des Sommers. Der Hacker-News-Thread erreichte 698 Punkte, und r/LocalLLaMA führte einen Megathread mit über 650 Kommentaren. Die Begeisterung ist echt: Sparse Activation und eine auslagerbare 51B-N-Gram-Tabelle ermöglichen es, ein 125B-Modell auf einem Laptop mit Unified Memory zu betreiben.
Liest man aber hinter die Launch-Grafiken, ergibt sich eine klare Liste von Gründen für einen Wechsel. Das ist die ehrliche Version dessen, worauf Sie sich einlassen:
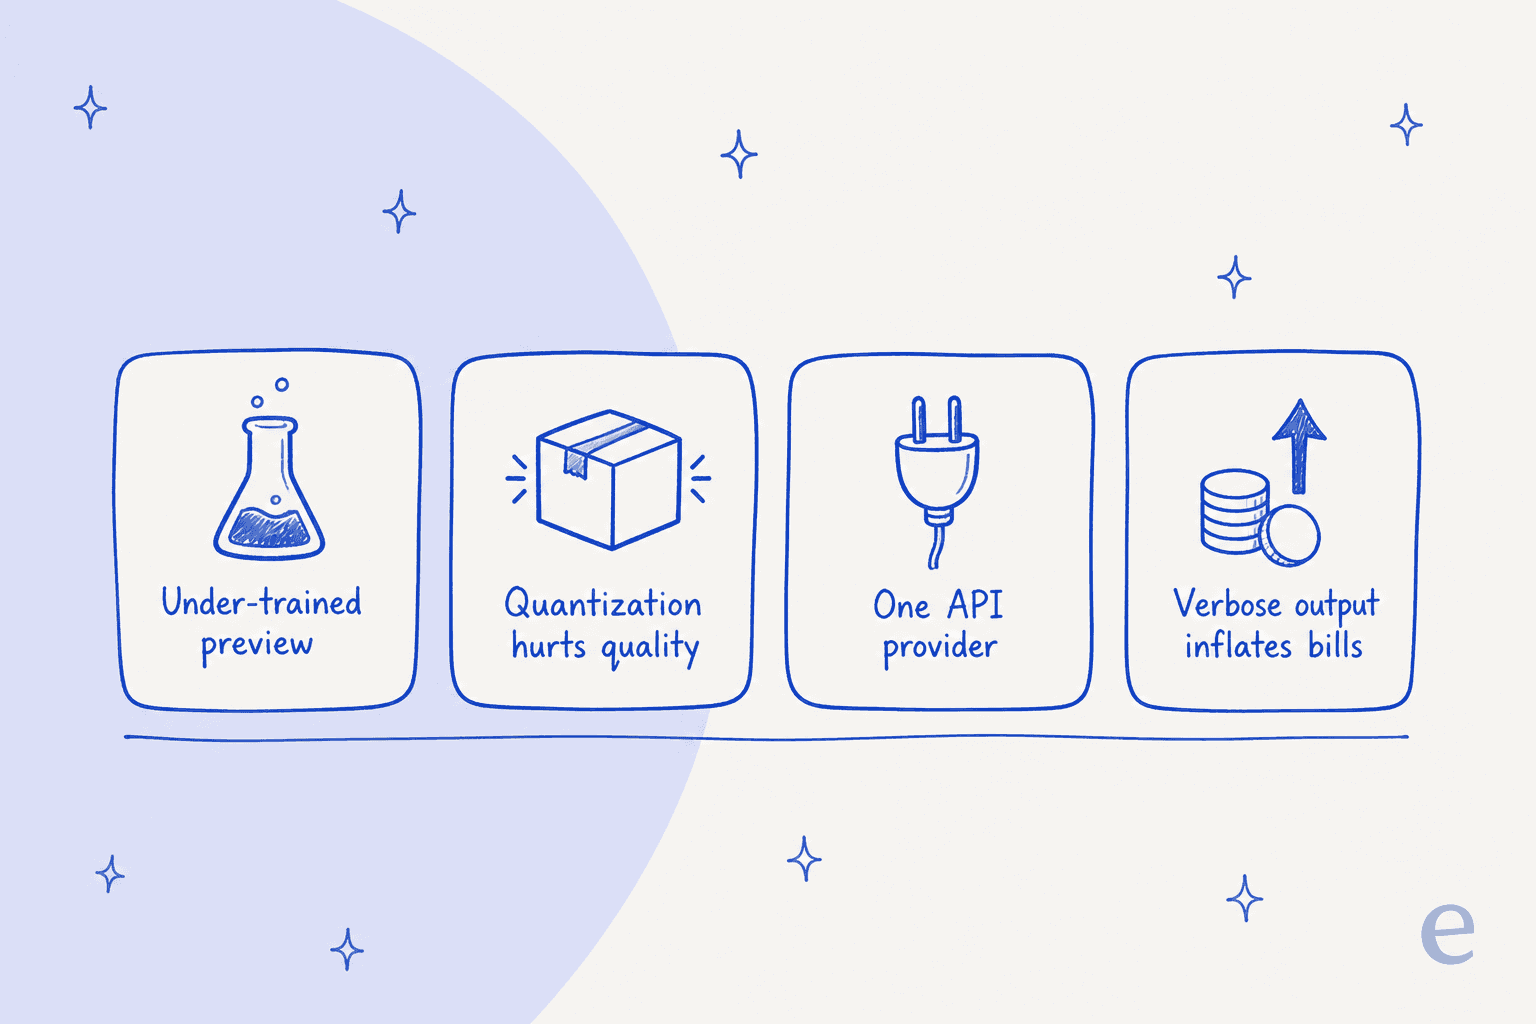
Die klarste Stimme dazu, was "Next" wirklich bedeutet, kam aus dem Launch-Thread:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

Dann gibt es die Quantisierungssteuer. Simon Willison ließ es auf einem DGX Spark mit mehreren Reasoning-Stufen laufen und zog am Ende das kleinere Dense-Modell vor, was er auf die niedrige Bit-Quantisierung schob, die nötig ist, damit es passt. Hinzu kommt, dass die gehostete Qwen3.8-Flash-API derzeit nur einen Anbieter hat, Alibaba Cloud International, es gibt also kein Failover. Und unabhängige Tests von Artificial Analysis bescheinigen "very verbose": Es verbrennt 200M Output-Tokens, um seinen Index abzuschließen, gegenüber einem Median von 110M, was jede Output-lastige Rechnung unmerklich aufbläht.
Nichts davon macht es zu einem schlechten Modell. Es macht es zu einer Vorschau. Wenn Sie in diesem Quartal etwas brauchen, auf das Sie sich verlassen können, landen genau dieselben Leute bei den folgenden acht.
Wie ich diese Alternativen ausgewählt habe
Ich habe die Shortlist auf Modelle beschränkt, die mindestens eines der vier oben genannten Probleme von Flash Next lösen, und wo es sie gibt, habe ich unabhängige Zahlen den Herstellertabellen vorgezogen. Konkret musste jede Wahl eine Hürde nehmen:
- Echte, nachprüfbare Preise. Ein veröffentlichter Preis pro Token oder freie offene Gewichte, nicht "Kontakt zum Vertrieb".
- Ein Release, das sich fertig anfühlt, oder ein ehrlicher Hinweis, wo das nicht der Fall ist.
- Ein überprüfbarer unabhängiger Wert, wo einer existiert (meist der Intelligence Index von Artificial Analysis), damit ich nicht nur einen Launch-Blog zitiere.
- Eine eigene Aufgabe. Keine zwei Picks sind "dasselbe, nur etwas günstiger", jeder gewinnt in einem anderen Anwendungsfall.
Was ich nicht getan habe: so zu tun, als wäre ein Benchmark ein Support-Agent. Dazu am Ende mehr.
Alternativen zu Qwen 3.8 Flash Next im Überblick
Hier die gesamte Shortlist an einem Ort. Die Preise sind gehostete API-Preise pro 1M Tokens (Input/Output); jedes Open-Weight-Modell lässt sich außerdem kostenlos selbst hosten, wenn Sie die Hardware haben.
| # | Modell | Am besten für | Typ | Kontext | Preis Ein/Aus (pro 1M) | Lizenz |
|---|---|---|---|---|---|---|
| 1 | GLM 5.3 Flash | Fertiger Open-Weight-Zwilling | Offen + gehostet | 1M | $0.075 / $0.25 (Aktion) | Offene Gewichte |
| 2 | DeepSeek V4 Flash | Budget-Boden, MIT | Offen + gehostet | 1M | $0.22 / $0.66 (Nebenzeit) | MIT |
| 3 | Qwen 3.8 Max | In der Qwen-Familie bleiben | Offen + gehostet | 1M | $2.00 / $6.00 | Qwen-Lizenz |
| 4 | Kimi K3 | Agentische Arbeit über lange Zeiträume | Offen + gehostet | 1M | $3.00 / $15.00 | Offene Gewichte |
| 5 | Gemini 3.7 Flash | Verwaltet und multimodal | Gehostet | ~1M | $0.75 / $3.75 (Aktion) | Geschlossen |
| 6 | GPT-5.6 Luna | Zuverlässigkeit im geschlossenen Ökosystem | Gehostet | Groß | $0.20 / $1.20 | Geschlossen |
| 7 | Granite 4.2 | Enterprise / On-Prem | Offen + gehostet | 128K | $0.06 / $0.25 (Replicate 8B) | Apache 2.0 |
| 8 | LongCat 2.0 | Großer MIT-MoE als Wildcard | Offen + gehostet | 256K | $0.30 / $1.20 (Aktion) | MIT |
Ein kurzes Rechenbeispiel, denn die Listenpreise verschleiern die echte Lücke. Angenommen, eine monatliche agentische Last umfasst 50M Input- und 15M Output-Tokens. Mit der Aktion von GLM 5.3 Flash sind das etwa $7.50; mit Granite 4.2 8B über Replicate ungefähr $6.75; mit dem gehosteten Qwen3.8-Flash selbst etwa $14.55; mit Gemini 3.7 Flash fast $94; und mit Kimi K3 rund $375. Gleiche Aufgabe, ein Faktor 50. Bei den Output-Tokens, nicht den Input-Tokens, vergraben Reasoning-Modelle unauffällig die Kosten.
1. GLM 5.3 Flash, der fertige Open-Weight-Zwilling
Am besten für: Teams, denen die günstige Open-Weight-Klasse von Flash Next gefiel, die aber etwas brauchen, das sich schon fertig anfühlt.
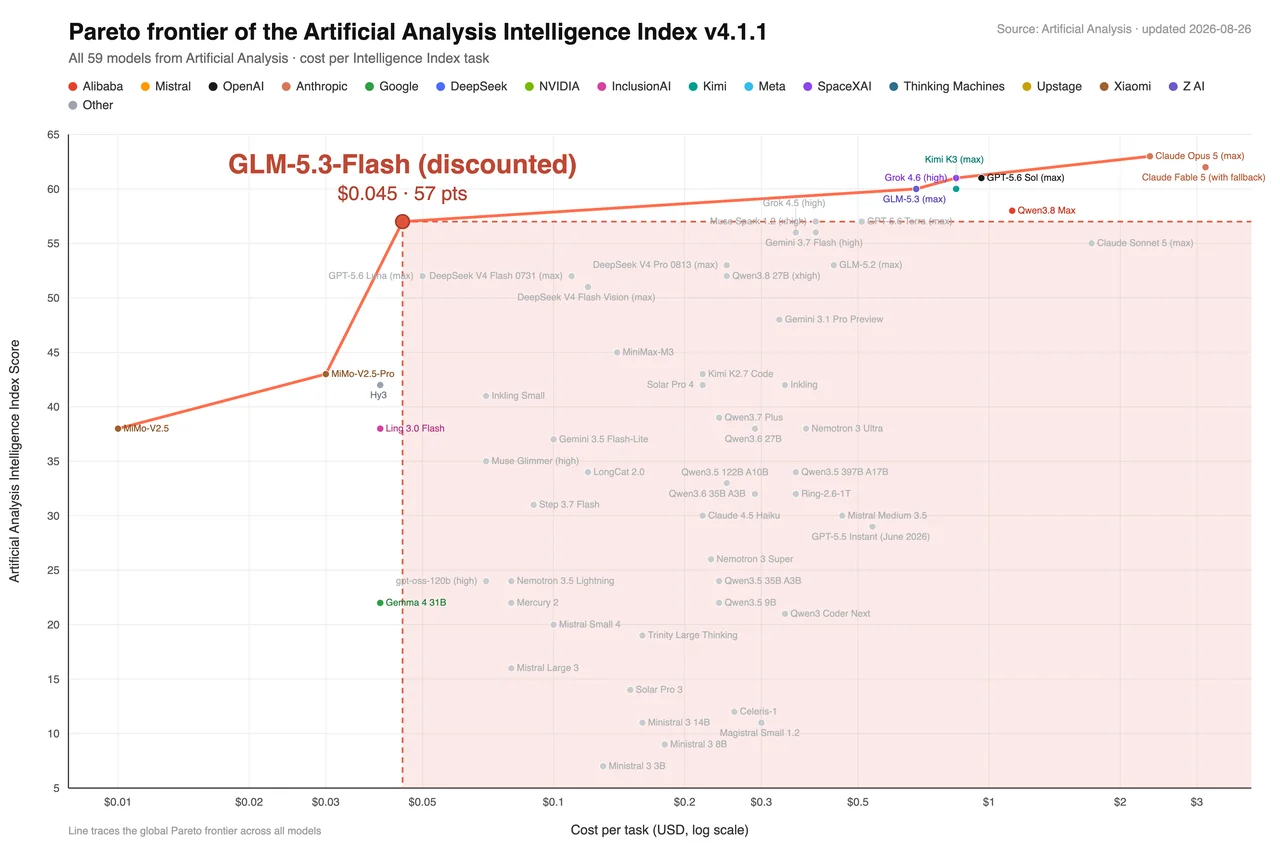
Das ist das Modell, auf das die Community Flash-Next-Tüftler immer wieder hinweist, und das aus gutem Grund. GLM 5.3 Flash von Z.ai (Zhipu) startete in derselben Woche, am 26. August 2026, als erstes nativ multimodales GLM-5-Modell: 320B insgesamt mit 18B aktiv in einer Mixture-of-Experts-Architektur, 1M-Token-Kontext und offene Gewichte auf Hugging Face. Unter dem Codenamen "ox-alpha" lag es kurz auf Platz eins von OpenRouter nach Token-Volumen.
Entscheidend: Es punktet wie ein fertiges Modell. Artificial Analysis gibt ihm einen Intelligence Index von 57 bei etwa $0.045 pro Aufgabe, und frühe Tester waren deutlich beim Wert:
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Vorteile: produktionstauglich trotz des niedrigen Preises, wirklich multimodal, offene Gewichte und ein eigener GLM Coding Plan für $18/$80/$168 im Monat, wenn Sie in einer IDE leben.
Nachteile: Es kann nur denken, Sie können das Reasoning also nicht abschalten, um Latenz zu sparen, und die First-Party-API ist langsam (etwa 49 Tokens/Sekunde), weshalb Vielnutzer für mehr Tempo über Anbieter wie Databricks gehen.
Preise: Aktion $0.075 Input / $0.25 Output pro 1M (Liste $0.15/$0.50), gecachter Input $0.015, die Aktion läuft bis 9. September 2026.
Fazit: Wenn Sie das Flash-Next-Erlebnis ohne den Vorschau-Hinweis wollen, fangen Sie hier an. Es ist das Nächste an einem direkten Upgrade auf dieser Liste.
2. DeepSeek V4 Flash, der Budget-Boden
Am besten für: Preisbewusste, die außerdem eine freizügige Lizenz wollen.
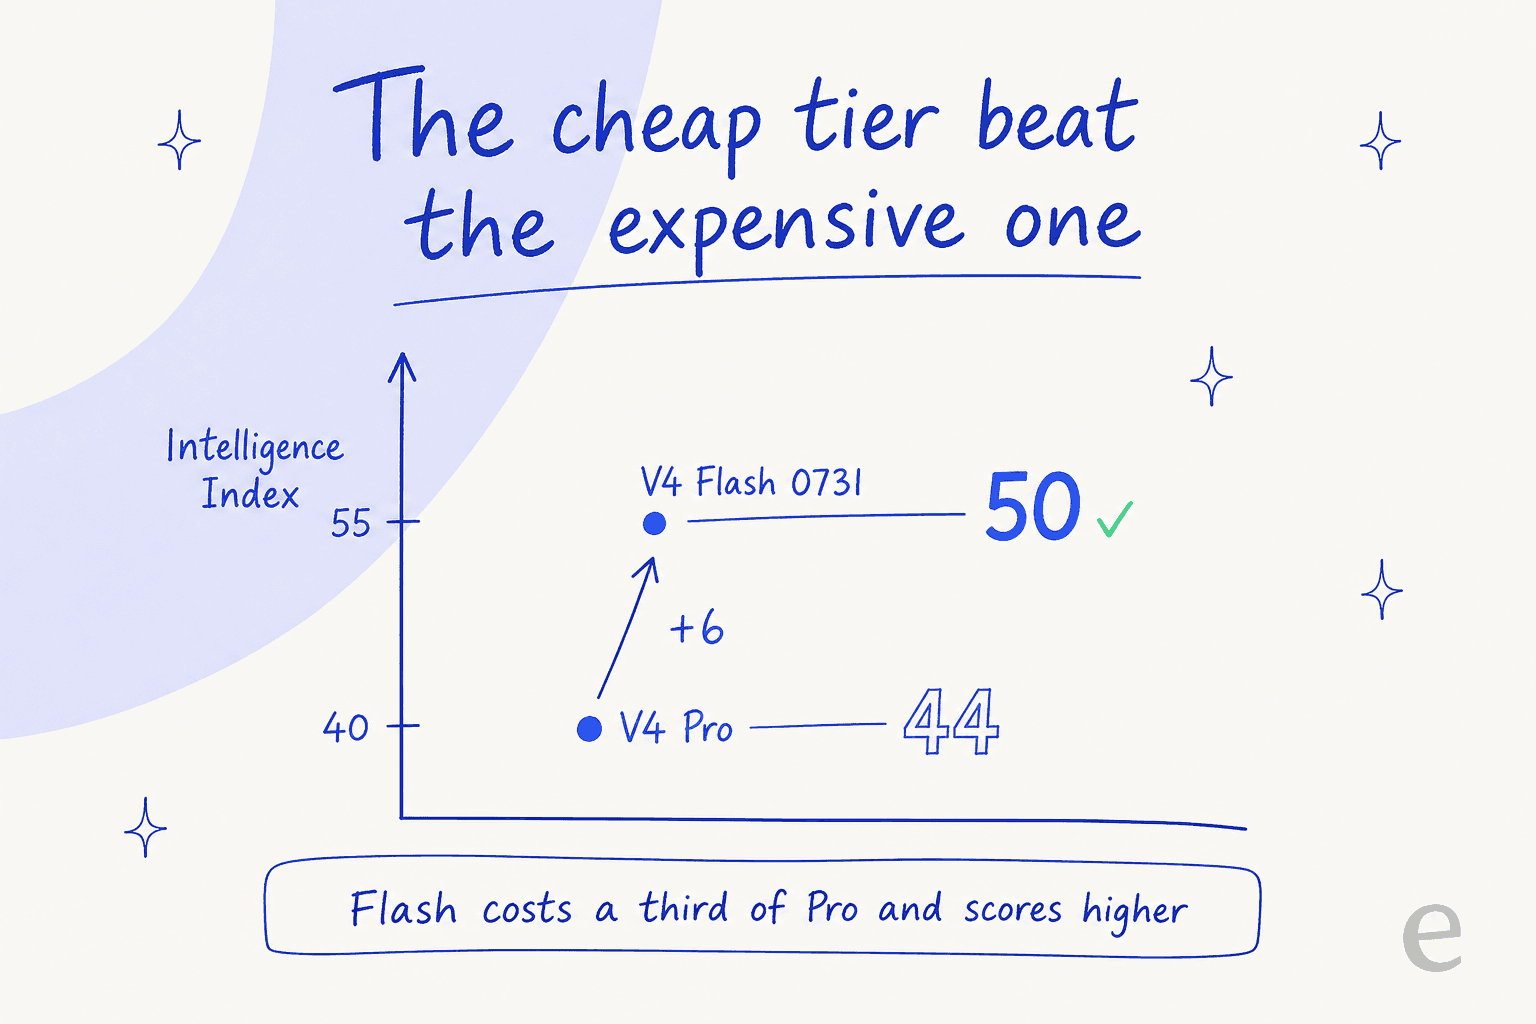
DeepSeek V4 Flash ist ein MoE mit 284B insgesamt und 13B aktiv, 1M Kontext und, für diese Klasse ungewöhnlich, echten offenen MIT-Gewichten (rund 167GB, mit Dutzenden Community-Quants). Der Partytrick, den die Leute lieben: Unabhängige Tests sehen die günstigere Flash-Stufe bei agentischen Langzeitaufgaben tatsächlich vor dem teureren V4 Pro, ein Punkt, den ein leitender Ingenieur gut zusammenfasste:
"DeepSeek V4 Flash is the most cost effective model we've tested... Pro is slower and smarter in one-shot reasoning problems, but less effective with tools and therefore less performant in long horizon agentic tasks."
Es gibt zwei ehrliche Haken. DeepSeek hat im August 2026 die Preise angepasst und erhebt nun einen Spitzen-/Nebenzeit-Aufschlag, mit Spitzenzeiten von 01:00-04:00 und 06:00-10:00 UTC. Eine US- oder EU-Warteschlange wird also meist zur Nebenzeit abgerechnet, ein Batch-Job in chinesischen Geschäftszeiten zahlt dagegen das Doppelte. Und es halluziniert mehr, als Ihnen lieb ist; ein Nutzer sagte es deutlich:
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
Vorteile: die niedrigsten realen Kosten pro Token aller gehosteten Modelle hier, MIT-Gewichte und ein starkes Tool-Use-Profil.
Nachteile: wortreich (etwa 210M Output-Tokens für den Index), nur Text (kein Bild-Input dokumentiert), und die Bedingungen der bezahlten API schweigen zur Nutzung für Training, es ist also keine Drop-in-Lösung für Kundendaten. Den ganzen Vergleich finden Sie in unserem Beitrag DeepSeek vs Kimi K3.
Preise: Nebenzeit/Spitze, Cache-Miss-Input $0.22/$0.44, Output $0.66/$1.32, Cache-Hit-Input ab $0.007.
Fazit: der Preis-Leistungs-Sieger, solange Sie die Output-Tokens einplanen und Kundendaten vom First-Party-Endpunkt fernhalten.
3. Qwen 3.8 Max, die Wahl für alle, die in der Familie bleiben
Am besten für: Leute, die das Qwen-Ökosystem mögen, aber das fertige, gehostete Flaggschiff statt einer Vorschau brauchen.
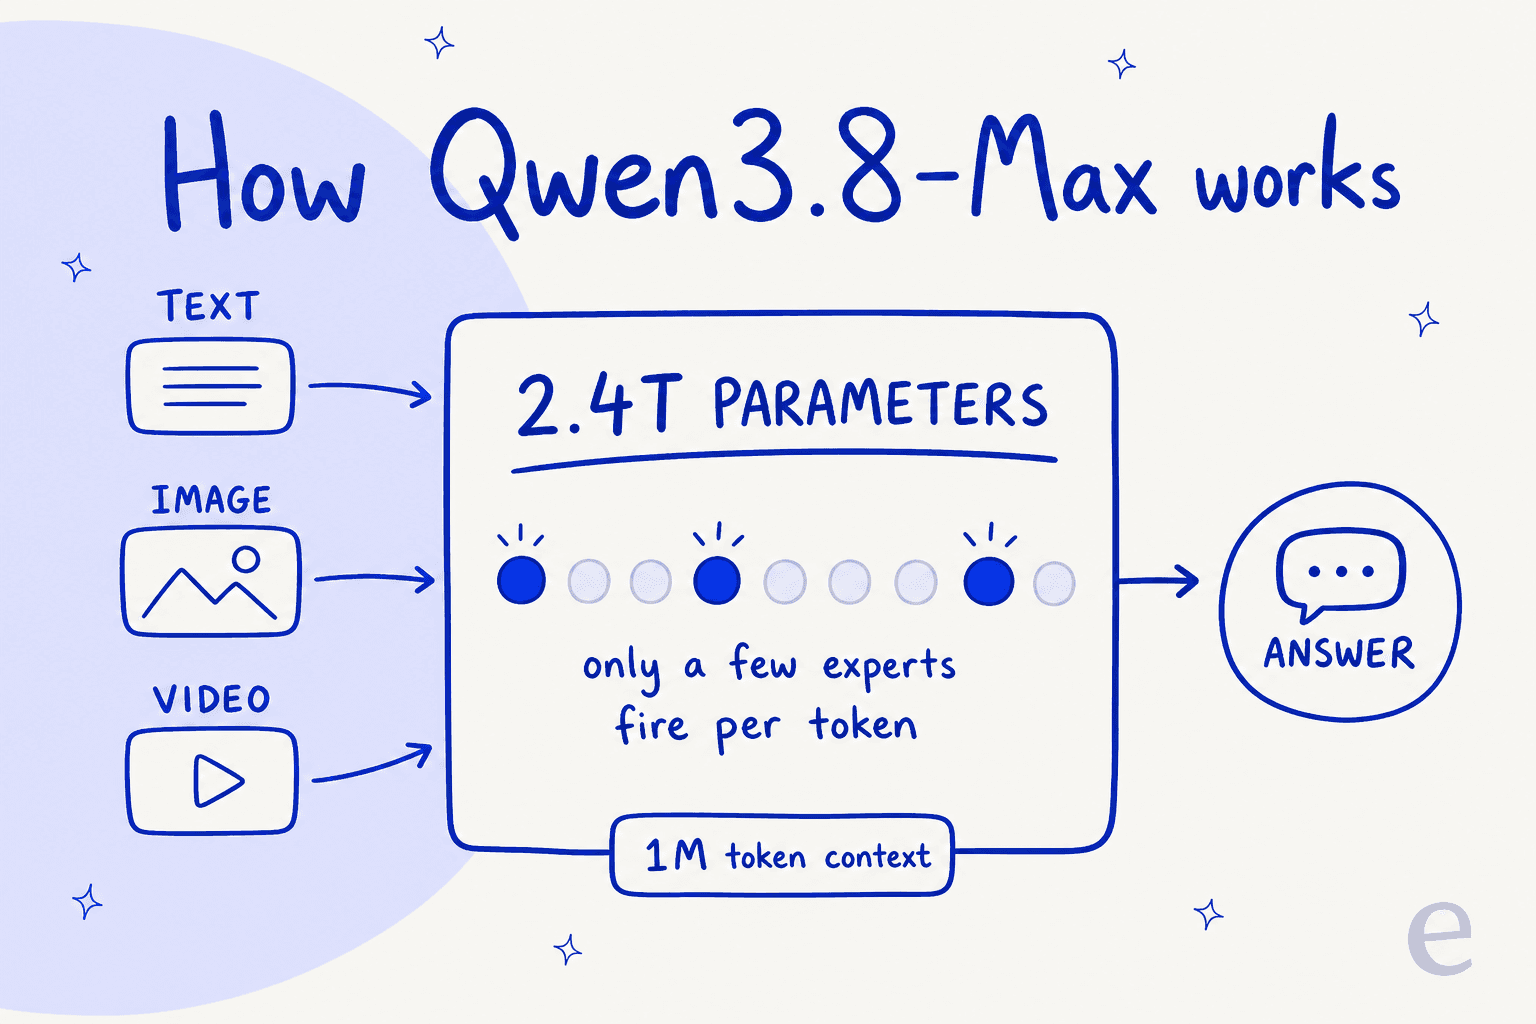
Wenn Flash Next die Research-Vorschau ist, ist Qwen 3.8 Max das ausgelieferte Produkt. Es wurde am 2. August 2026 allgemein verfügbar: ein MoE mit 2.4T insgesamt und 95B aktiv, 1M Kontext, 131,072 maximaler Output und gehostete Extras, die der offenen Basis fehlen (Vision-Input, ein Non-Thinking-Modus und eingebaute Tools). Auch die Gewichte erschienen im August, allerdings unter der Qwen-Lizenz statt Apache.
Im unabhängigen Ranking schlägt es sich gut: Artificial Analysis listet es auf Rang 6 mit einem Intelligence Index um 58 bei etwa $1.13 pro Aufgabe, und in der LMArena liegt es bei Text in den Top fünf und bei Vision auf Platz zwei. Wenn Sie eine einzige Zahl wollen: lassen Sie es. Der automatisierte Gesamtwert und die menschliche Präferenz zeigen leicht in unterschiedliche Richtungen, was selbst eine nützliche Erinnerung ist, keinem einzelnen Benchmark zu vertrauen.
Vorteile: stabil, gehostet, wirklich multimodal, und Sie bleiben in Tooling, das Sie von Flash Next eventuell schon nutzen.
Nachteile: eine Größenordnung teurer als die Flash-Stufe, und die offenen Gewichte sind nicht funktionsgleich mit der gehosteten Version.
Preise: $2 Input / $6 Output pro 1M, implizite Cache-Lesezugriffe für $0.25.
Fazit: die dramafreie Wahl für Qwen-Fans, die Produktionsstabilität wichtiger finden als den Tiefstpreis von Flash. Wenn Sie unschlüssig sind, führt unser Zugangs-Guide durch die Wege.
4. Kimi K3, die Wahl für agentische Langzeitaufgaben
Am besten für: komplexe, mehrstufige Agentenläufe, bei denen Leistung wichtiger ist als Kosten.
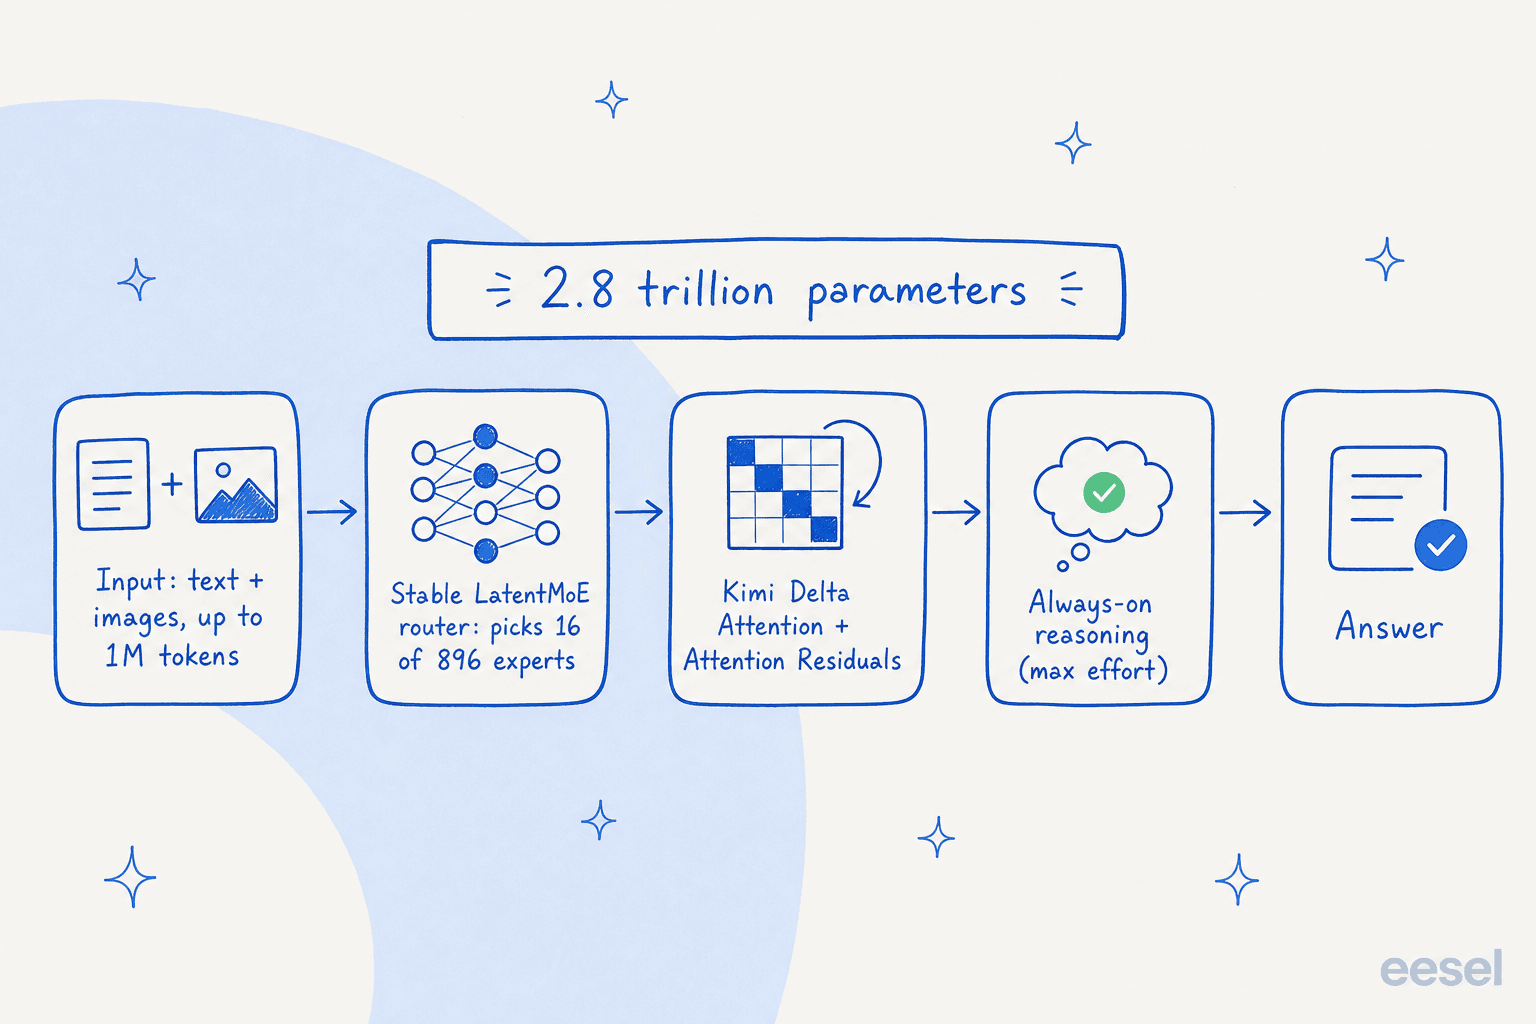
Moonshots Kimi K3 ist das Schwergewicht dieser Liste: 2.8T Parameter insgesamt mit 104B aktiv, 1M Kontext, native Vision und offene Gewichte, die am 27. Juli 2026 pünktlich erschienen. Sein Artificial-Analysis-Intelligence-Index von 57 bringt es insgesamt auf Platz vier, und es ist ein wirklich starkes agentisches und Coding-Modell.
Der Haken ist der Preis. K3 kostet $3 Input / $15 Output pro 1M, im selben Bereich wie ein geschlossenes Frontier-Modell und etwa das 50-Fache des Output-Preises von DeepSeek V4 Flash. Das Reasoning lässt sich außerdem nicht abschalten, sodass selbst ein einfacher Aufruf die Denksteuer zahlt; die niedrigste Aufwandsstufe schneidet schlechter ab und kostet pro Aufgabe mehr als DeepSeek. Das ist keine Budget-Alternative zu Flash Next, sondern eine Leistungs-Alternative.
Vorteile: agentische Spitzenleistung, riesiger Kontext, offene Gewichte und native Vision.
Nachteile: Frontier-Preise, dauerhaft aktives Reasoning, und die Vision-API lehnt öffentliche Bild-URLs ab (nur Base64 oder eine Datei-ID).
Preise: $3 Input / $15 Output pro 1M, Cache-Hit-Input $0.30.
Fazit: Greifen Sie zu K3, wenn die Aufgabe schwer genug ist, um die Rechnung zu rechtfertigen. Für alltägliche günstige und schnelle Arbeit ist es das falsche Werkzeug.
5. Gemini 3.7 Flash, die verwaltete multimodale Wahl
Am besten für: Teams, die die Zuverlässigkeit eines großen Anbieters, starken multimodalen Input und kein Self-Hosting wollen.
Wenn Ihnen das ganze Self-Hosting wie ein Hobby vorkommt, für das Sie keine Zeit haben, ist Gemini 3.7 Flash die verwaltete Antwort. Es wurde am 13. August 2026 allgemein verfügbar und ist mit 340 Tokens/Sekunde das schnellste Modell, das Artificial Analysis je gemessen hat (Rang #1 von 188). Die kaufentscheidende Erkenntnis: Die gewählte Reasoning-Stufe beeinflusst Kosten und Qualität stark. Bei low erreicht es 50.9 im Index bei $0.16 pro Aufgabe; bei high sind es 56.0, aber der Preis springt auf $0.40. Den Standard medium zu belassen, bedeutet meist, zu viel zu zahlen.
Zwei Einschränkungen halten es ehrlich. Google hat die Denkstufe minimal entfernt, die ältere Flash-Modelle zum günstigsten Boden für OCR und Klassifizierung machte. Und die Halluzinationsrate ist auf 64.5 % gestiegen, von 55.6 % bei 3.6 Flash, obwohl die Genauigkeit besser wurde, genau die Art Dinge, die Sie vor dem Release erwischen wollen.
Vorteile: verwaltet und zuverlässig, Spitzen-Durchsatz, starke Werte bei Langkontext und Computer-Nutzung und ein Aktionspreis, der heute dem von 3.6 Flash entspricht.
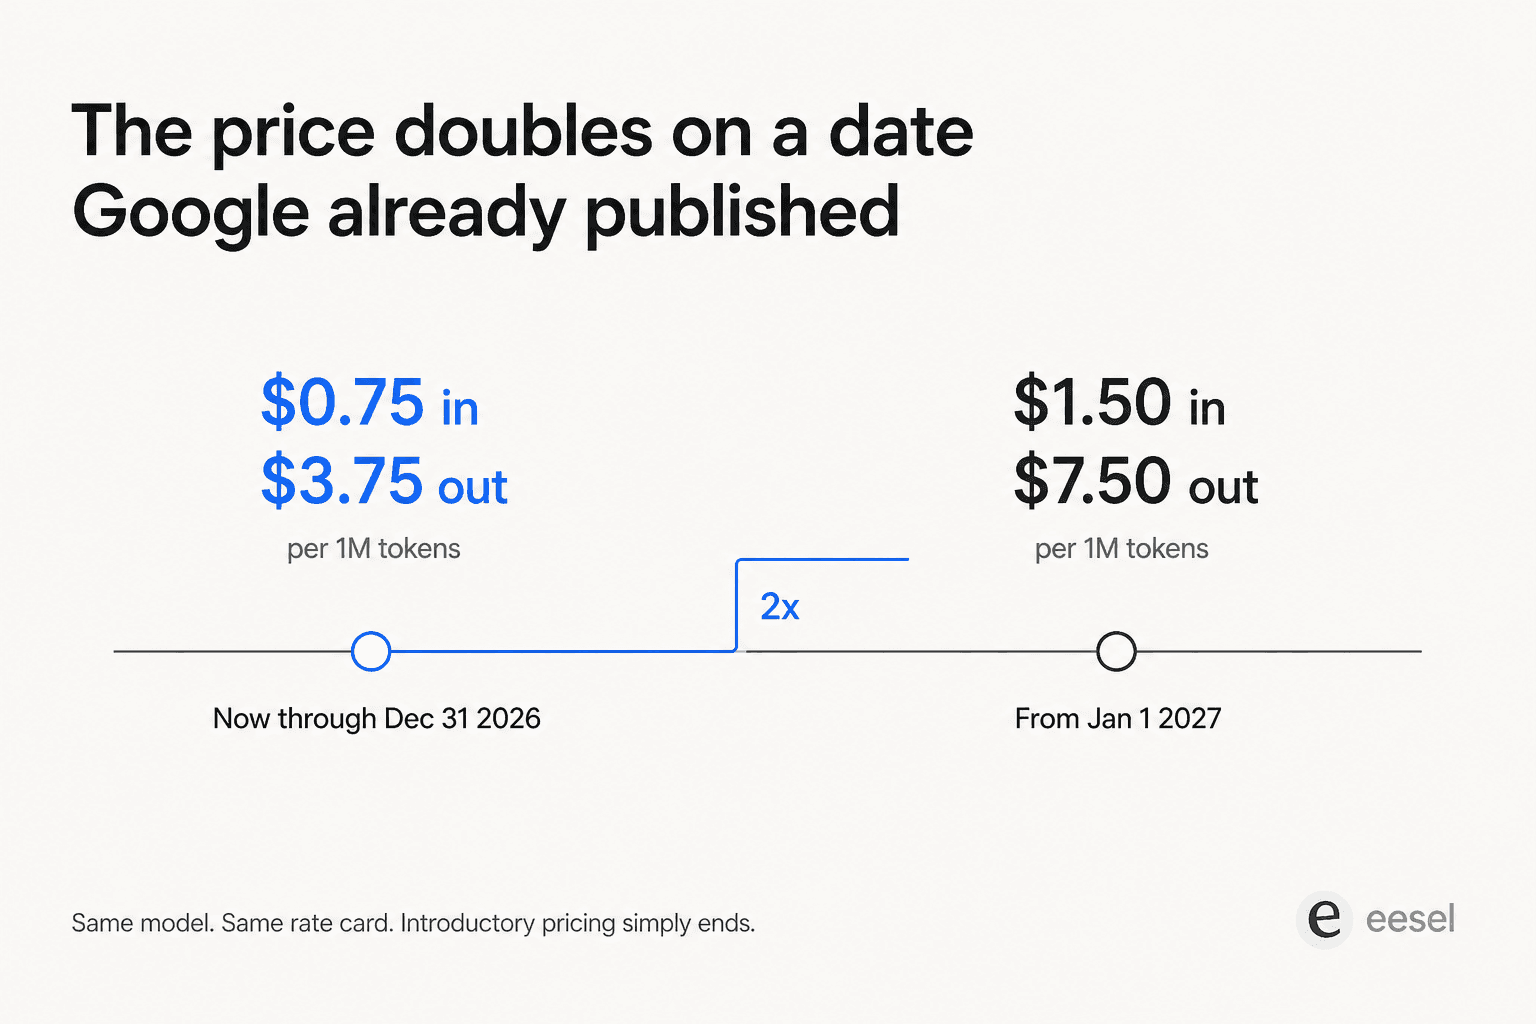
Nachteile: geschlossene Gewichte, eine höhere Halluzinationsrate als beim Vorgänger und ein Preis, der sich im Januar 2027 verdoppelt.
Preise: $0.75 Input / $3.75 Output pro 1M als Einführungspreis bis 31. Dezember 2026, danach $1.50 / $7.50.
Fazit: die Wahl, wenn Sie lieber eine Plattform bezahlen, als eine GPU zu betreuen. Lassen Sie nur den Aufwandsregler nicht auf dem Standard.
6. GPT-5.6 Luna, die Zuverlässigkeits-Wahl im geschlossenen Ökosystem
Am besten für: Teams, die bereits auf OpenAI standardisiert sind und eine günstige Stufe wollen, ohne den Stack zu verlassen.
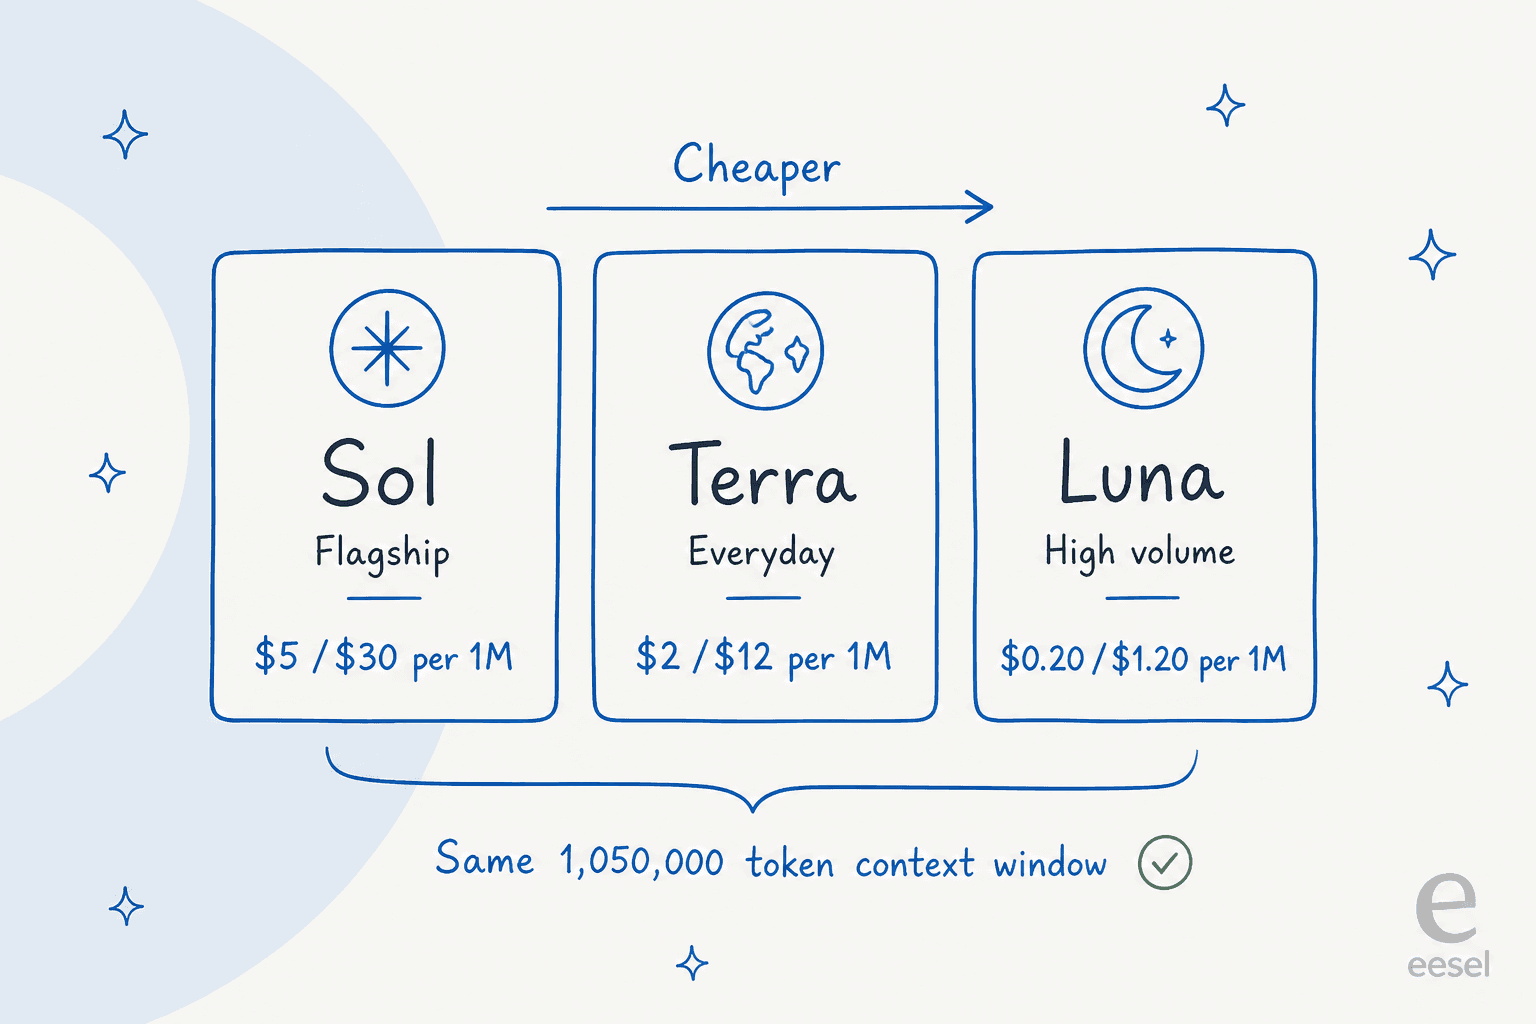
Luna ist die Budget-Sprosse der GPT-5.6-Leiter (die anderen beiden sind Terra und das Flaggschiff Sol). Mit $0.20 Input / $1.20 Output pro 1M ist es preislich konkurrenzfähig zu den chinesischen Open-Weight-Modellen und liefert Ihnen dazu OpenAIs Tooling, SDKs und Zuverlässigkeit. Für ein Team, dessen Infrastruktur bereits die OpenAI-API voraussetzt, sind die gesparten Wechselkosten real.
Der Kompromiss ist der, den jedes geschlossene Modell hier mitbringt: keine Gewichte, kein Self-Hosting, und OpenAI erhebt eine Langkontext-Stufe, die den Preis jenseits des Kurzkontext-Fensters verdoppelt (Luna steigt auf $0.40/$1.80). Anthropic und Google erheben diesen Schritt nicht, prüfen Sie also, ob Ihre Kontextlängen die Grenze überschreiten.
Vorteile: ein vertrauenswürdiger Anbieter, ein ausgereiftes Ökosystem und eine wirklich günstige Einstiegsstufe.
Nachteile: geschlossene Gewichte, ein 2-facher Langkontext-Aufschlag und weniger Offenheit als die Modelle, mit denen es preislich konkurriert.
Preise: $0.20 Input / $1.20 Output pro 1M bei Kurzkontext; $0.40 / $1.80 bei Langkontext; gecachter Input $0.02.
Fazit: der vernünftige günstige Standard, wenn Sie bereits ein OpenAI-Haus sind und das Ökosystem höher gewichten als offene Gewichte.
7. IBM Granite 4.2, die Enterprise-/On-Prem-Wahl
Am besten für: Unternehmen, die freizügige Lizenzen, Standard-Hardware und fundiertes Tool-Calling brauchen.
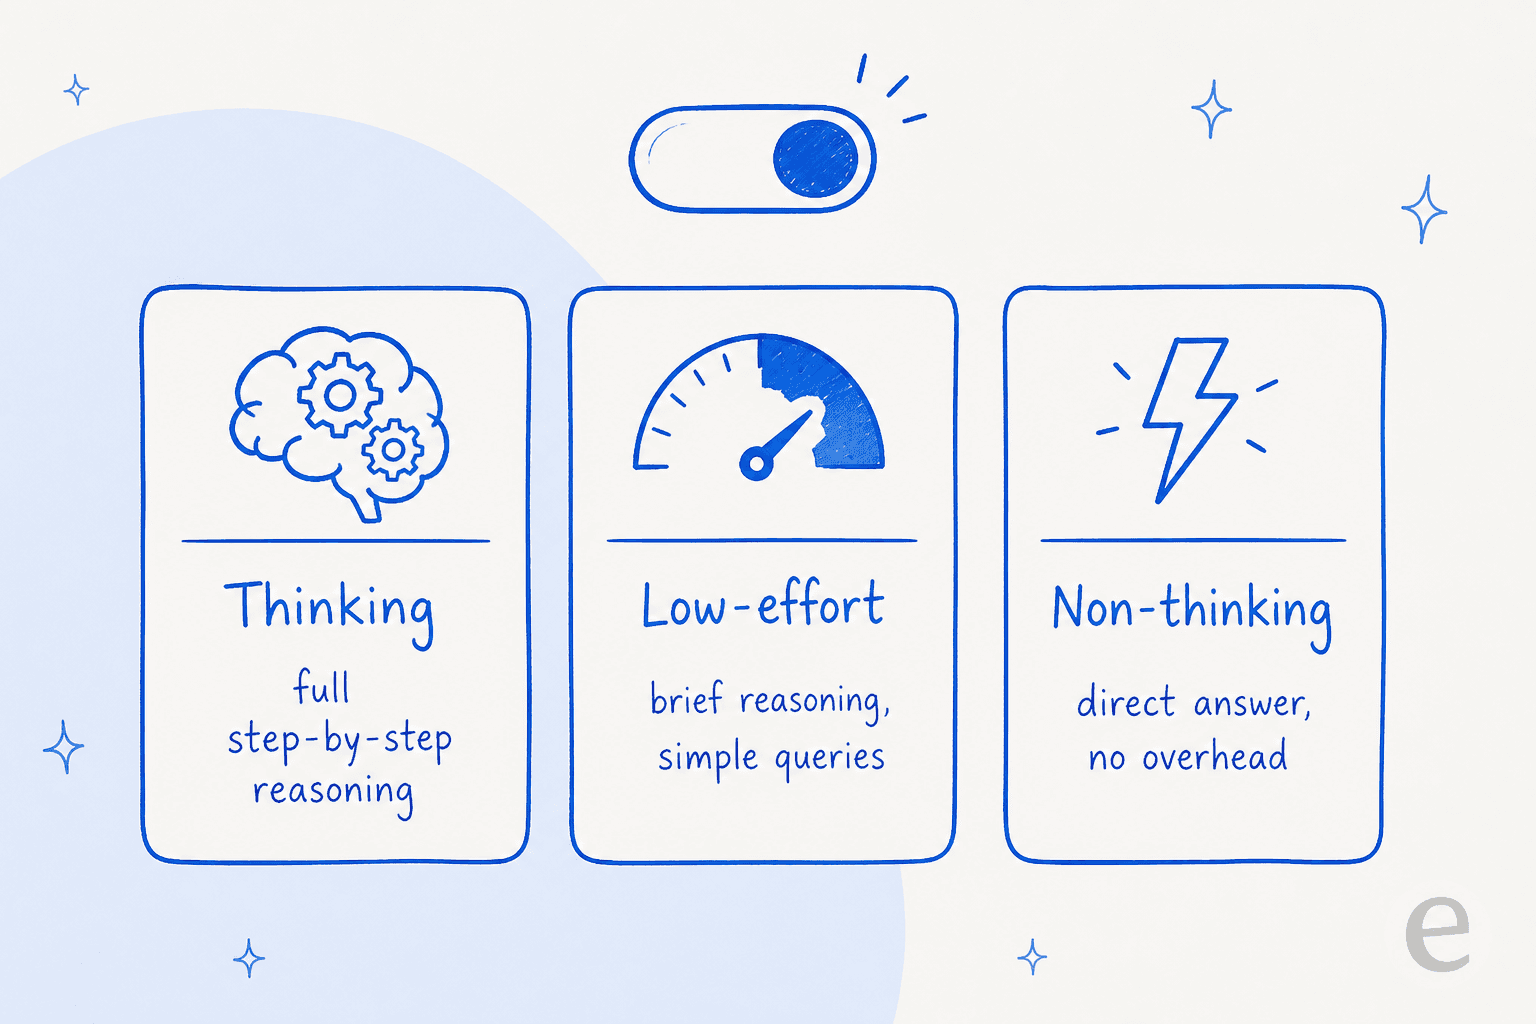
Granite 4.2 ist das Modell, das Ihre Rechts- und Sicherheitsteams tatsächlich freigeben werden. IBM lieferte es am 25. August 2026 als drei dichte Apache-2.0-Modelle aus (3B, 8B und ein 30B-Flaggschiff) mit 128K Kontext und, anders als bei Flash Next, umschaltbarem Reasoning: volles Denken, geringer Aufwand oder ganz aus. Es ist auf fundierte Extraktion und Tool-Calling statt auf Benchmark-Siege getrimmt, und Tester mögen die Praxistauglichkeit:
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
Seien Sie sich klar darüber, was es nicht ist. Es führt keine Coding-Bestenlisten an, und dieselbe Community sagt das direkt: "Qwen still wins on raw capability, especially for coding." Außerdem gibt es eine Speicher-Eigenheit: Der 5.3GB-Download des 8B-Modells wächst auf etwa 27GB, sobald der KV-Cache geladen ist, planen Sie Ihre GPU entsprechend.
Vorteile: echtes Apache 2.0 (nicht nur "Weights verfügbar"), umschaltbares Reasoning, aktuelle Trainingsdaten und schnell auf bescheidener Hardware.
Nachteile: Es liegt beim reinen Coding hinter Qwen, IBMs Benchmarks vergleichen meist mit früheren Granite-Versionen statt mit den chinesischen Spitzenmodellen, und der Speicheranstieg beim Laden überrascht Leute.
Preise: Self-Hosting kostenlos (8B ist ein 5.3GB-Download); der günstigste bestätigte gehostete Preis ist Replicates 8B für $0.06 Input / $0.25 Output pro 1M.
Fazit: die unternehmenssichere Wahl. Wenn Lizenzierung und On-Prem-Kontrolle wichtiger sind als die letzten Benchmark-Punkte, ist Granite schwer zu schlagen.
8. LongCat 2.0, die Wildcard unter den großen MIT-MoE-Modellen
Am besten für: Abenteuerlustige, die ein sehr großes MIT-lizenziertes MoE wollen und das Tooling aushalten.
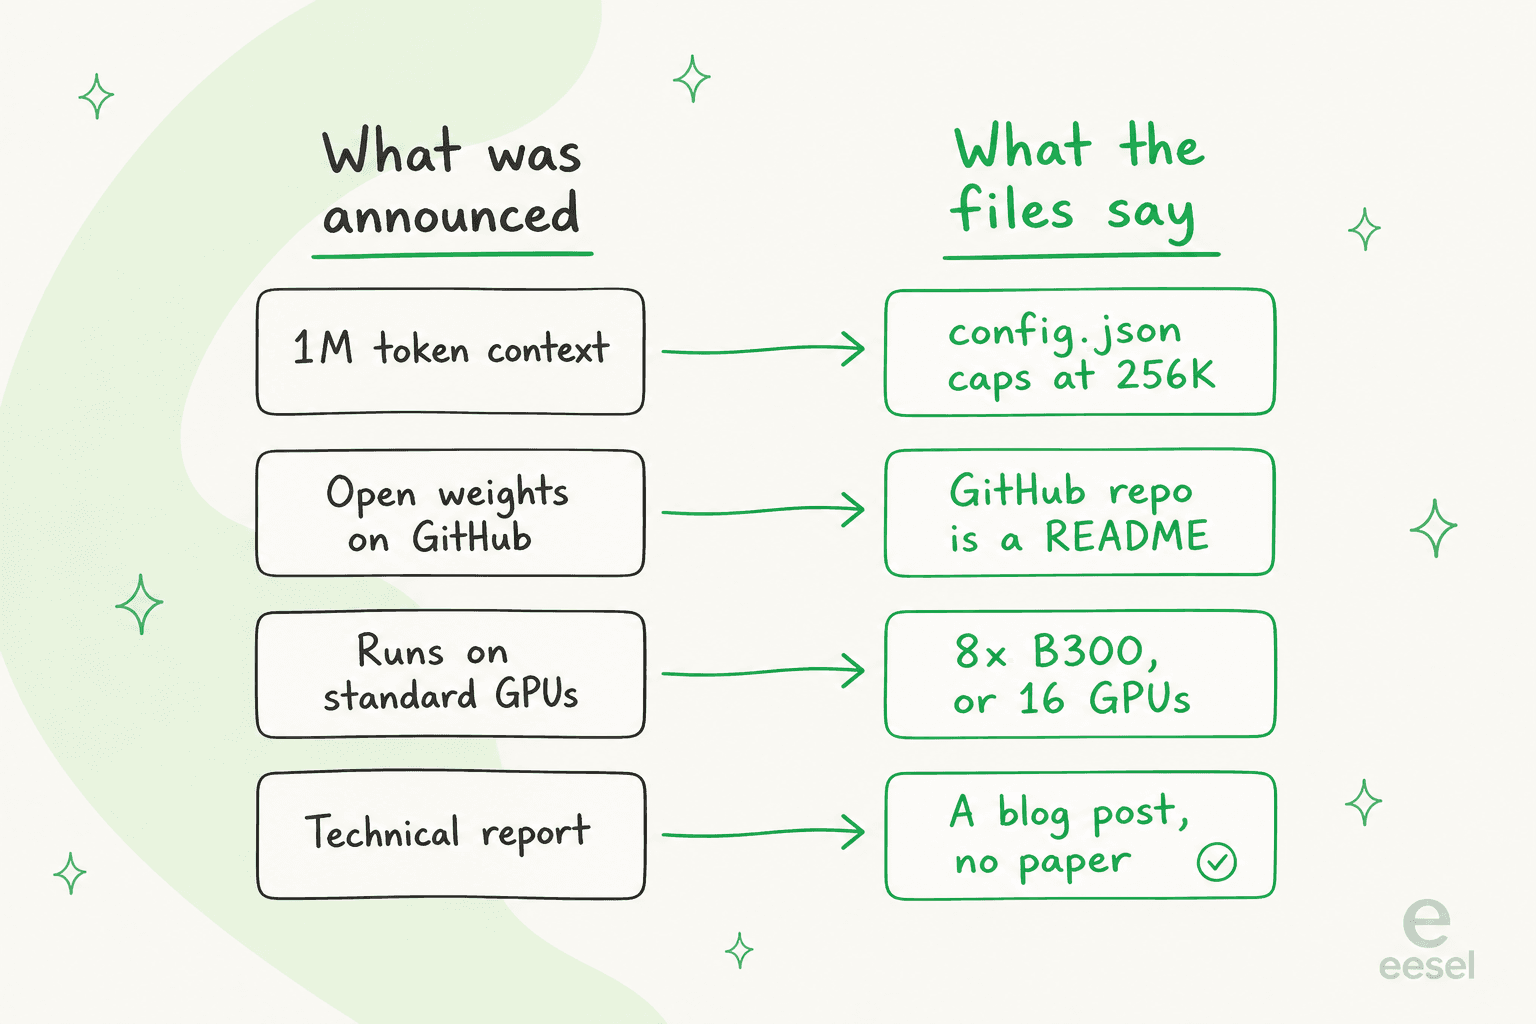
Meituans LongCat 2.0 ist der architektonische Cousin der DeepSeek-Familie: ein 1.6T-MoE mit etwa 48B aktiv pro Token, schlichten MIT-Gewichten und Aktionspreisen, die die meisten dieser Liste unterbieten. Es ist wirklich leistungsfähig, mit einem selbst gemessenen SWE-bench Pro von 59.5, das GPT-5.5 knapp übertrifft.
Aber es kommt mit den meisten Sternchen von allem hier, und alle sind überprüfbar. Der beworbene "1M Kontext" ist eine Trainingsbehauptung; die ausgelieferte Config begrenzt die Positionen auf 256K. Das GitHub-Repo besteht nur aus einer README ohne Paper, SGLang ist die einzige Engine, und Self-Hosting braucht realistisch 8x B300-GPUs, da es kein GGUF für Ollama oder LM Studio gibt. Die Zahlung außerhalb des chinesischen Festlands läuft über Alipay oder WeChat Pay, nicht per Karte. Und speziell für den Support schweigt die Plattform-FAQ zu Datenspeicherung und Training, was der eigentliche Blocker ist, nicht der Preis.
Vorteile: wirklich groß und leistungsfähig, saubere MIT-Lizenz und aggressive Aktionspreise.
Nachteile: dünnes Tooling, ein echter 256K-Kontext (nicht 1M), ein brutaler Self-Hosting-Bedarf, umständliche Zahlung und keine Zusagen zum Umgang mit Daten.
Preise: Aktion $0.30 Input / $1.20 Output pro 1M (Liste $0.75/$2.95), keine Staffelung nach Kontextlänge.
Fazit: eine faszinierende Wildcard für Forschende, aber die Lücken bei Tooling und Datenhandhabung machen es zum am schwersten produktiv einsetzbaren Modell dieser Liste.
Welche Alternative sollten Sie wählen?
Wenn Sie diese gegen die zwei Dinge abgleichen, die Sie wirklich von Flash Next vertrieben haben, "Ist es fertig?" und "Will ich es selbst betreiben?", sortiert sich die Shortlist schnell.
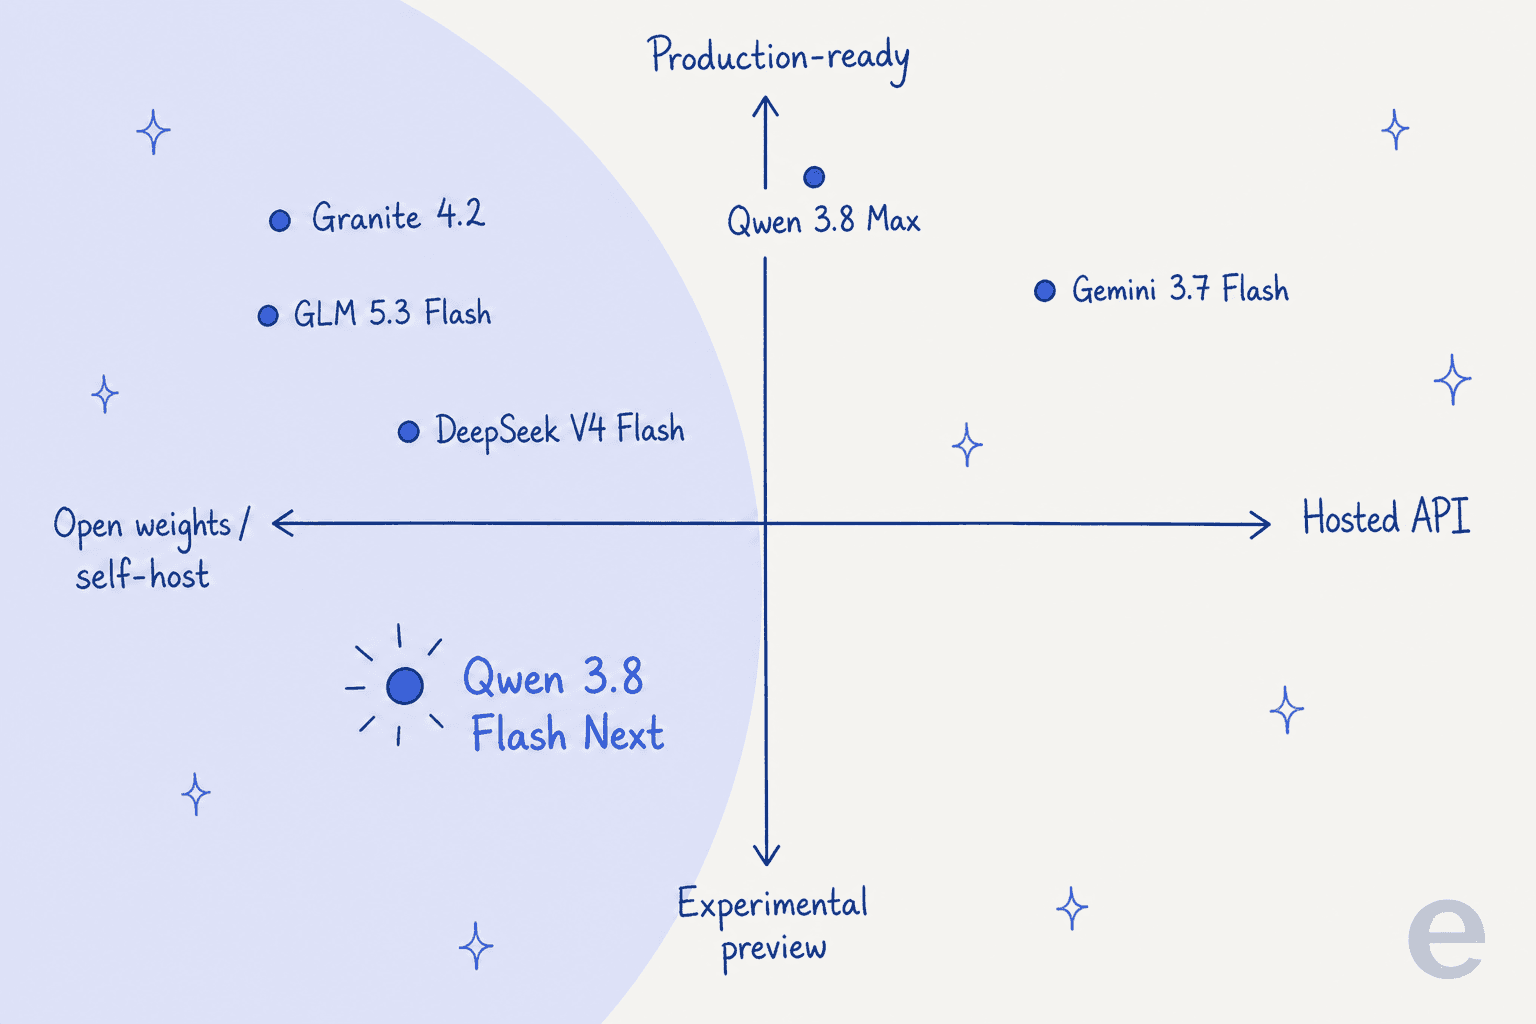
Schnelle Entscheidungen:
- Dasselbe wollen, nur fertig? GLM 5.3 Flash.
- Die günstigste echte Rechnung? DeepSeek V4 Flash oder selbst gehostetes Granite 4.2.
- In Qwens Welt bleiben, aber stabil? Qwen 3.8 Max.
- Keine GPU anfassen wollen? Gemini 3.7 Flash oder GPT-5.6 Luna.
- Enterprise-Lizenzierung und On-Prem nötig? Granite 4.2.
Das Muster hinter alldem
Das muss ich Teams, die bei einem Beitrag wie diesem ankommen, immer wieder sagen. Jedes Modell oben ist eine Komponente. Ein rohes Modell nimmt Tokens entgegen und gibt Tokens aus. Es kennt Ihre Erstattungsrichtlinie nicht, kann die Bestellhistorie eines Kunden nicht lesen, entwirft keine Antwort in Ihrem Helpdesk und hat keine Ahnung, ob seine selbstsichere Antwort stimmt. Das Modell ist Infrastruktur; das, was die Arbeit erledigt, ist der Mitarbeiter.
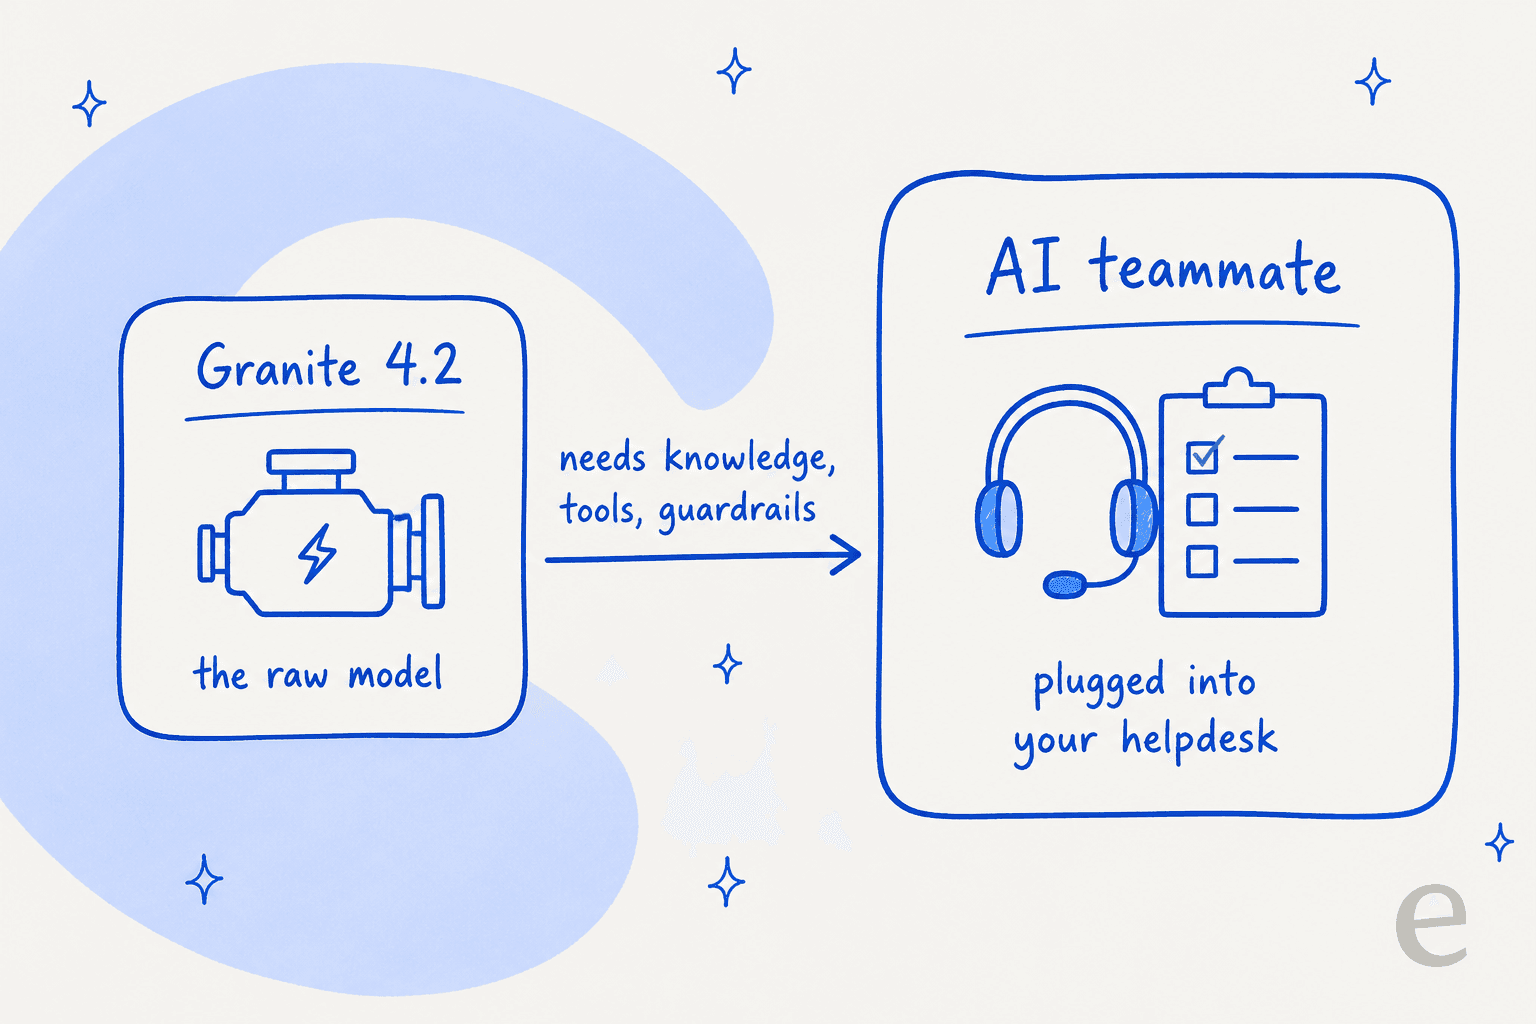
Deshalb ist "Welches günstige Modell soll ich für den Support nutzen?" die falsche erste Frage. Das Modell auszuwählen sind die einfachen 10 %. Die 90 %, die entscheiden, ob Tickets tatsächlich gelöst werden, sind die Schicht drumherum: Retrieval über Ihre Wissensdatenbank, Aktionen in Ihrem Helpdesk, Leitplanken und Tests an echter Historie, bevor etwas einen Kunden erreicht. Das gilt, egal ob darunter Flash Next, GLM 5.3 Flash oder ein KI-Mitarbeiter läuft, den Sie selbst bauen.
eesel ausprobieren
Wenn Sie hier gelandet sind, weil Sie ein günstiges Modell für den Support abwägen, lautet der ehrliche Rat: Hören Sie auf, nach einem Modell zu suchen, und fangen Sie an, mit Ihren eigenen Tickets zu testen. Genau diese Mitarbeiter-Schicht baue ich bei eesel: eine Plattform für KI-Teammitglieder, auf der Sie einsatzbereite Teammitglieder für bestimmte Aufgaben einstellen, derzeit ein KI-Helpdesk-Teammitglied und einen KI-Blogautor. Jedes bringt die Fähigkeiten, Integrationen und den Unternehmenskontext für seine Rolle mit, sodass das darunter laufende Modell zum Implementierungsdetail wird und nicht Ihr Problem ist.

Den Teil, den ich am stärksten hervorheben würde, ist das Testen, denn ein brandneues Vorschau-Modell wie Flash Next gehört genau hinter ein Gate. Das eesel-Helpdesk-Teammitglied simuliert jeden Rollout an Ihren historischen Tickets, bevor es je einen Live-Kunden berührt. So sehen Sie die Lösungsquote und die genauen Antworten, die es bei echten vergangenen Gesprächen gesendet hätte, und entscheiden dann, was Sie automatisieren. Wählen Sie das Modell, das Ihren Benchmark gewinnt; beweisen Sie es nur zuerst an Ihren eigenen Tickets. Das Ausprobieren ist kostenlos.