
Kimi K2.7 Code Preise auf einen Blick
Hier der Teil, weswegen Sie hier sind. Das sind die offiziellen Sätze von Moonshots Preisseite, pro 1 Million Tokens:
| Modell | Input (Cache-Treffer) | Input (Cache-Fehltreffer) | Output | Kontextfenster |
|---|---|---|---|---|
kimi-k2.7-code (Standard) | 0,19 $ | 0,95 $ | 4,00 $ | 262.144 Tokens |
kimi-k2.7-code-highspeed | 0,38 $ | 1,90 $ | 8,00 $ | 262.144 Tokens |
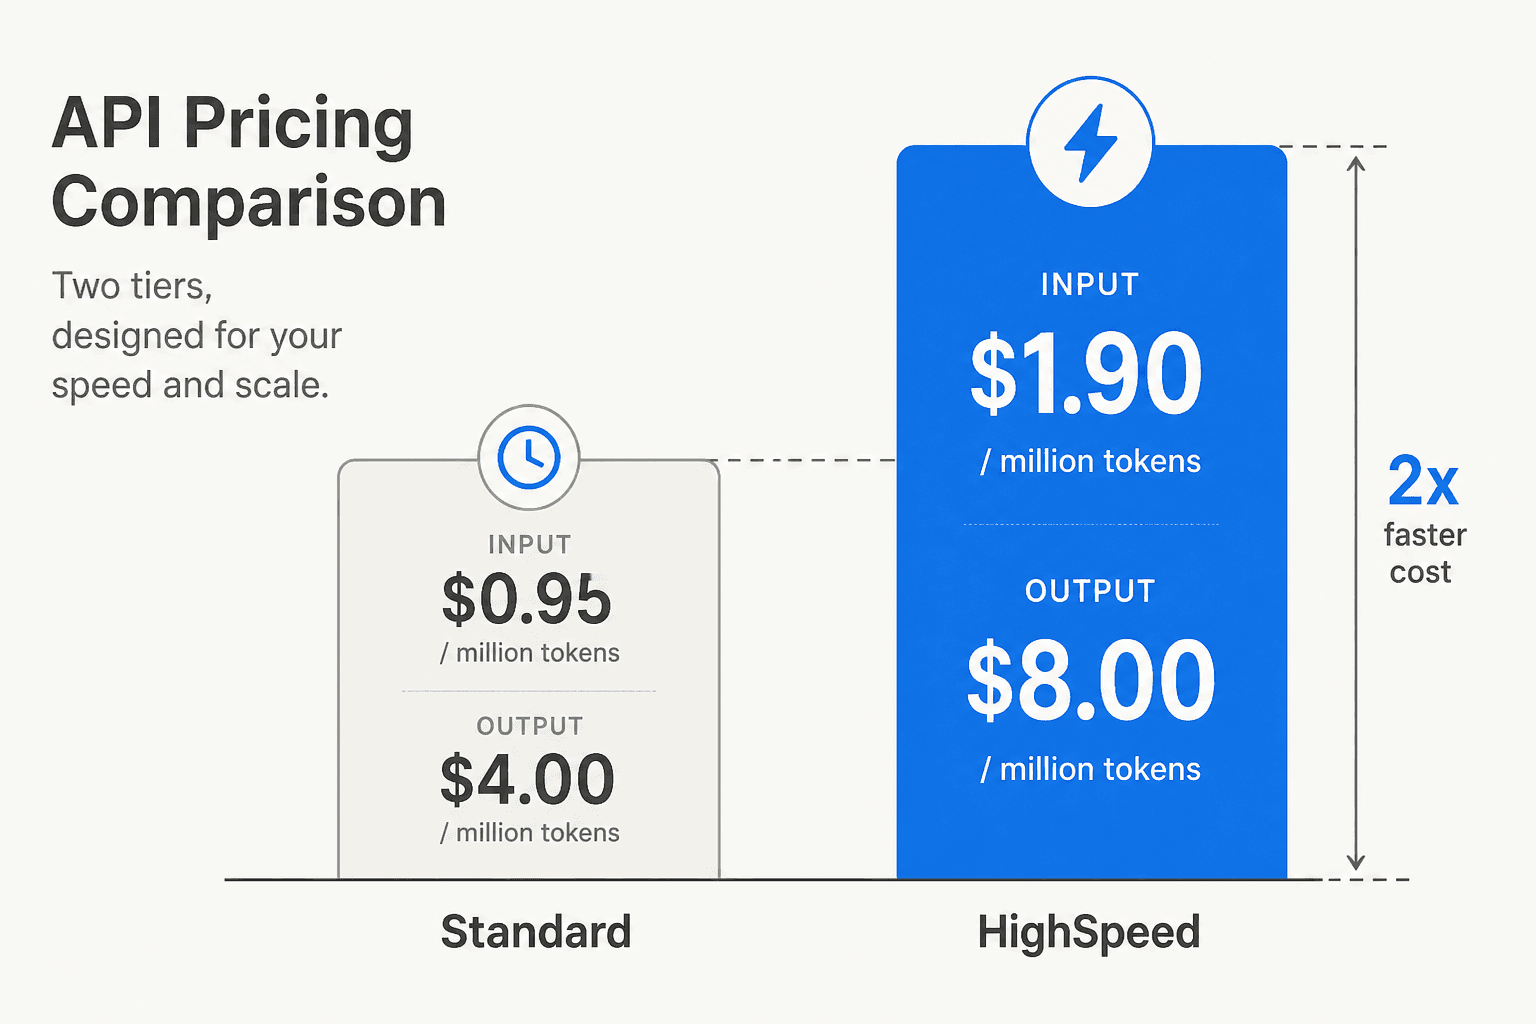
Ein paar Details, die die Tabelle allein nicht verrät. Moonshot bepreist sowohl Input- als auch Output-Tokens bei jedem Chat-Completion-Aufruf, und wenn Sie ein Dokument hochladen und dessen extrahierten Text in einen Prompt einfügen, zählt dieser Text ebenfalls als abgerechneter Input - der Extraktionsschritt selbst ist vorübergehend kostenlos, nur der Completion-Aufruf wird berechnet. Es gibt keine kostenlose API-Stufe, eine kumulative Aufladung von 1 $ ist die Eintrittskarte, bevor die API überhaupt auf eine einzige Anfrage antwortet. HighSpeed ist kein anderes Modell, sondern dieselben Gewichte auf Durchsatz optimiert (rund 180 Tokens/Sekunde, bis zu 260 bei kurzen Kontexten), und Moonshot bepreist diese Geschwindigkeit pauschal mit dem Doppelten jeder Stufe.
Der Haken: Ratenlimits richten sich danach, wie viel Sie bezahlt haben, nicht nach einem Pauschalkontingent
Das ist das strukturelle Detail, das bestimmt, wie sich die Preise für ein echtes Konto tatsächlich auswirken. Moonshots Ratenlimits skalieren mit der kumulativen Aufladung, nicht mit einer festen Obergrenze pro Schlüssel:
| Stufe | Kumulative Aufladung | Parallelität | Anfragen/Min | Tokens/Min | Tokens/Tag |
|---|---|---|---|---|---|
| Tier0 | 1 $ | 1 | 3 | 500.000 | 1.500.000 |
| Tier1 | 10 $ | 50 | 200 | 2.000.000 | Unbegrenzt |
| Tier2 | 20 $ | 100 | 500 | 3.000.000 | Unbegrenzt |
| Tier3 | 100 $ | 200 | 5.000 | 3.000.000 | Unbegrenzt |
| Tier4 | 1.000 $ | 400 | 5.000 | 4.000.000 | Unbegrenzt |
| Tier5 | 3.000 $ | 1.000 | 10.000 | 5.000.000 | Unbegrenzt |
Bei 1 $ sind Sie auf Tier0: eine gleichzeitige Anfrage, drei Anfragen pro Minute, eine Tagesobergrenze von 1,5 Mio. Tokens. Das ist ein Proof-of-Concept-Limit, kein Produktionslimit - eine einzelne MCP-Tool-Calling-Schleife mit über 4.000 Schritten (genau die langlaufende Arbeitslast, für die K2.7 Code gebaut ist) stößt fast sofort an Tier0s Parallelitätsgrenze. Moonshot gibt zwar einen 5-$-Gutschein aus, sobald man 5 $ kumulative Aufladung überschreitet, aber das ist ein einmaliger Anreiz-Bonus, kein wiederkehrendes Freikontingent. Alles jenseits von Tier5 bedeutet, direkt an api-service@moonshot.ai für eine individuelle Vereinbarung zu schreiben.
Wie es sich gegen Opus 4.8 schlägt, und wo Drittanbieter Moonshots eigenen Preis unterbieten
Moonshots eigene Modellkarte stellt K2.7 Codes Preise neben Claude Opus 4.8, und die Lücke ist die Kennzahl, mit der jeder Launch-Beitrag geworben hat:
| Modell | Lizenz | Parameter | Kontext | Input / 1 Mio. | Output / 1 Mio. |
|---|---|---|---|---|---|
| Kimi K2.7 Code | Modifizierte MIT (offen) | 1T gesamt / 32B aktiv | 256K | 0,95 $ | 4,00 $ |
| Claude Opus 4.8 | Geschlossen | Nicht offengelegt | 1M | 5,00 $ | 25,00 $ |
| Qwen3-Coder-480B-A35B | Offen (Qwen-Lizenz) | 480B / 35B aktiv | 256K | Je nach Host | Je nach Host |
Opus 4.8 kostet mehr als das 5-Fache pro Token und liefert keine offenen Gewichte, hat dafür aber ein deutlich größeres Kontextfenster von 1 Mio. Tokens und führt laut Moonshots eigener Benchmark-Tabelle weiterhin bei den meisten der sechs veröffentlichten Coding-Evals gegenüber K2.7 Code. Der einzige Punkt, an dem K2.7 Code Opus 4.8 tatsächlich klar schlägt, ist MCP Mark Verified (81,1 vs. 76,4) - ein echter Kopf-an-Kopf-Sieg bei einem Tool-Calling-Benchmark, kein bloßer Trostpreis fürs günstigere Modell.
Moonshots eigener Satz von 0,95 $/4,00 $ ist auch nicht die günstigste Art, dieses Modell zu betreiben. OpenRouters Anbietertabelle listet mehr als ein Dutzend Drittanbieter-Hosts, die dieselben offenen Gewichte bereitstellen:
| Anbieter (via OpenRouter) | Input / 1 Mio. | Output / 1 Mio. | Cache-Read / 1 Mio. | Uptime |
|---|---|---|---|---|
| DeepInfra | 0,74 $ | 3,50 $ | 0,15 $ | 99,86 % |
| Inceptron | 0,75 $ | 3,15 $ | 0,15 $ | 99,76 % |
| ModelRun | 0,85 $ | 3,75 $ | 0,16 $ | 99,71 % |
| Moonshot AI (offiziell) | 0,95 $ | 4,00 $ | 0,19 $ | 99,59 % |
| Together | 0,95 $ | 4,00 $ | 0,19 $ | 99,84 % |
DeepInfra unterbietet Moonshots eigenen Preis bei Input-Tokens um rund 20-25 %, bei nahezu gleicher Uptime. Das ist der direkte Vorteil offener Gewichte: Weil jeder das Modell hosten kann, hat der offizielle Anbieter nicht dieselbe Preismacht wie ein geschlossenes Lab. OpenRouters eigener 30-Tage-gewichteter Durchschnitt über alle Hosts hinweg, nach Berücksichtigung von Cache-Treffern, kommt auf rund 0,38 $/Mio. Input und 4,13 $/Mio. Output - eine Erinnerung daran, dass der Listenpreis in jeder dieser Tabellen eine Obergrenze ist, nicht das, was eine gut gecachte Arbeitslast tatsächlich zahlt.
Self-Hosting: die echte Null-Dollar-Option
Wenn weder Moonshots eigener Satz noch OpenRouters Rabatt günstig genug sind, gehören die Gewichte Ihnen zum Betreiben. Kimi K2.7 Code erscheint unter einer modifizierten MIT-Lizenz, die sowohl Code als auch Gewichte abdeckt, direkt herunterladbar von Hugging Face - 870.022 Downloads im letzten Monat zum Zeitpunkt meiner Prüfung, eine wirklich große Adoptionszahl für offene Gewichte. Self-Hosting bedeutet, dass die einzigen Kosten Ihre eigene Rechenleistung sind, keine Pro-Token-Gebühr an Moonshot.
Der Haken ist die Größe. Volle BF16-Präzision belegt rund 595 GB auf der Festplatte - ein Server-Deployment, kein Laptop-Modell. Community-Quantisierung verkleinert diese Lücke erheblich: r/unsloth veröffentlichte eine Dynamic-2-Bit-Quantisierung, die das Modell auf rund 325 GB schrumpft (eine Reduktion um 48 %) und dabei mit über 40 Tokens/Sekunde auf Consumer-Hardware mit passendem RAM/VRAM läuft, mithilfe von Inferenz-Engines wie vLLM, SGLang oder KTransformers. Das ist eine echte Option, nur eine, bei der man eine Token-Rechnung gegen eine Hardware-Rechnung eintauscht.
Die Lücke zwischen der "30 % günstiger"-Behauptung und dem, was echte Konten bezahlen
Das ist der Teil, der tatsächlich verändert, wie Sie jede der obigen Preistabellen lesen sollten. Moonshots Schlagzeilen-Effizienzbehauptung lautet, dass K2.7 Code rund 30 % weniger Reasoning-Tokens verbraucht als K2.6 - "weniger Überdenken", in der Formulierung des Unternehmens - was die Output-Hälfte der Rechnung schrumpfen lassen sollte, da Reasoning-Tokens bei den meisten Preiskarten als Output abgerechnet werden.
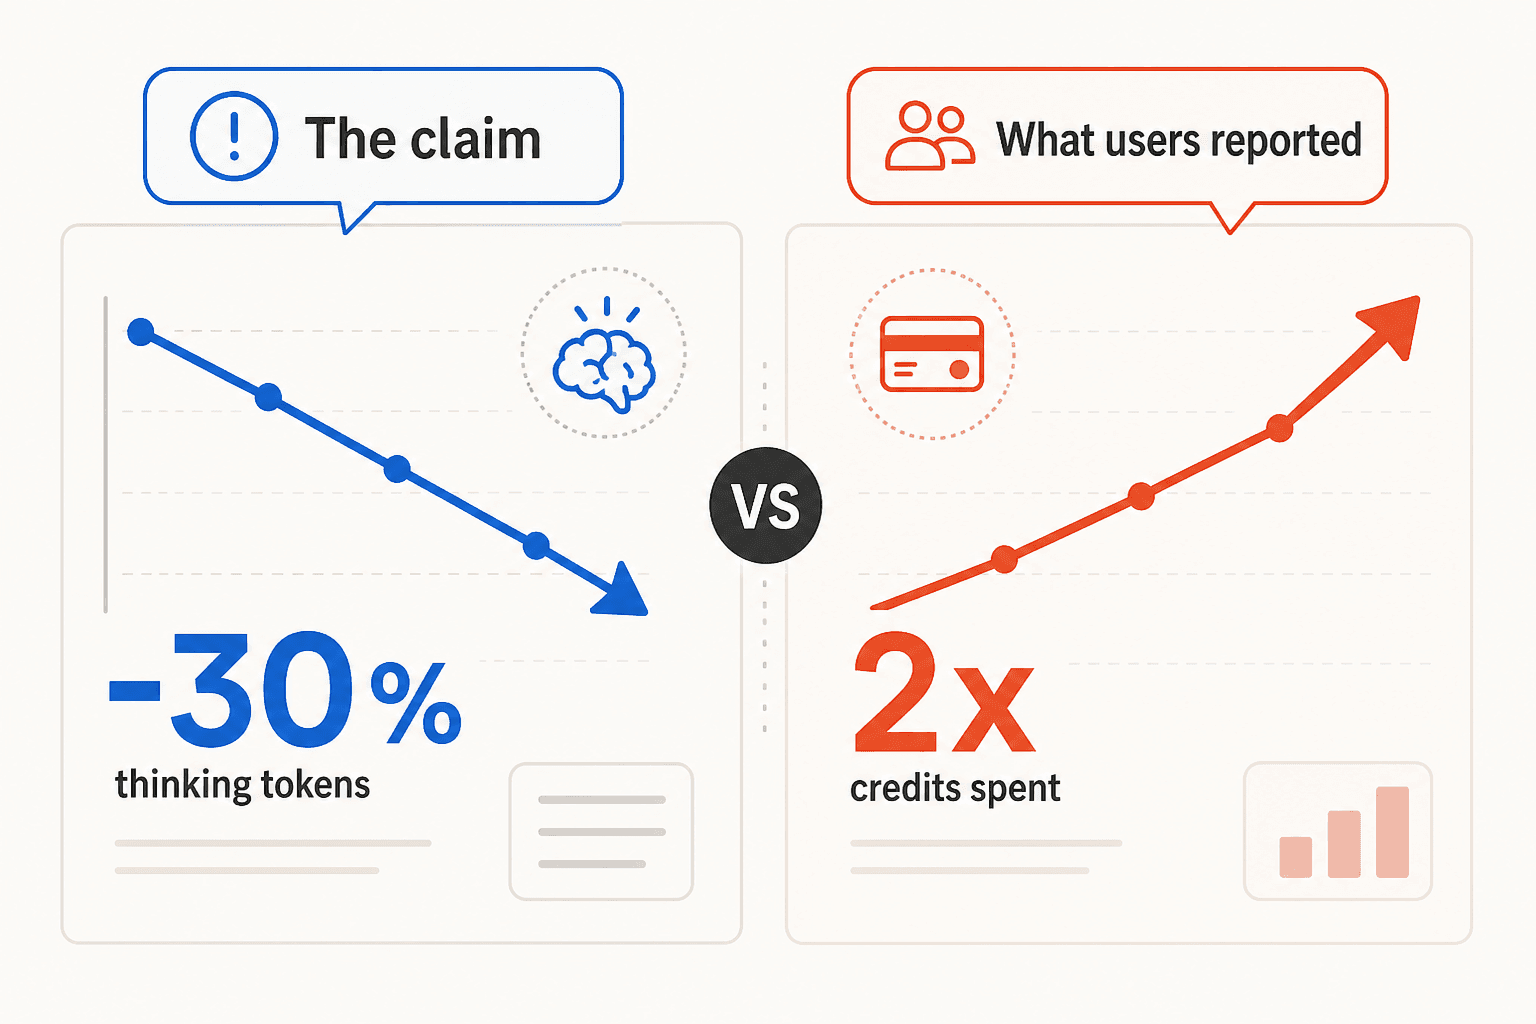
Reddit erzählt eine andere Geschichte. Ein Thread mit dem Titel "Kimi 2.7 Code is good, but it thinks forever and consumes way too much limit" fasst die zentrale Beschwerde in einer Überschrift zusammen, und die meistgelesene Antwort mildert das nicht ab:
"Bei mir dasselbe: Ich verbrauche Tokens doppelt so schnell..."

Ein separater Thread, "Does the new Kimi K2.7 use up your credits twice as fast?", beschreibt einen kostenpflichtigen Plan, der "1 % pro komplexer" Aufgabe verbraucht, in einem Tempo, das der Poster so nicht erwartet hatte. Nicht alle sind sich einig, warum - ein Thread, "Do you think the increase in consumption of Kimi 2.7 is due to...", stellt es als offene Frage zwischen Infrastrukturproblemen, Modell-Regressionen oder, wie es ein Kommentator unverblümt ausdrückte, "purer Gier seitens Moonshot" dar. Konsistent über die Threads hinweg ist die Richtung: echte Nutzung, die der offiziellen Effizienzbehauptung entgegenläuft, nicht mit ihr übereinstimmt.
MarkTechPosts eigenes Kostenrechner-Beispiel ist eine nützliche Veranschaulichung dessen, wie die behaupteten Einsparungen aussehen sollten, auch wenn echte Konten davon nichts sehen. Angenommen 50.000 Input-Tokens und 8.000 Output-Tokens pro Durchlauf, eine Cache-Trefferquote von 50 % und 1.000 Durchläufe pro Monat, wobei Reasoning 40 % des Outputs ausmacht:
- Input-Kosten: ~28,50 $/Monat
- Output-Kosten: ~32,00 $/Monat
- Geschätzte monatliche Gesamtkosten: ~60,50 $/Monat
- Geschätzte Einsparung durch die 30-%-Reasoning-Token-Kürzung: ~3,84 $/Monat, verglichen mit derselben Arbeitslast bei K2.6-typischem Reasoning
Das ist eine echte, aber bescheidene Ersparnis auf dem Papier, bei einer moderaten Arbeitslast, wenn die Effizienzbehauptung hält. Bei den Reddit-Threads oben hält sie nicht für alle, was bedeutet, dass der ehrliche Weg, für K2.7 Code zu budgetieren, darin besteht, es zum Token-Verbrauch der K2.6-Ära zu kalkulieren und jede Ersparnis als Bonus zu behandeln, nicht als Basiswert.
Token-Preise vs. Bezahlung pro Ergebnis
Hier die Neurahmung, mit der ich Sie zurücklasse, eine, zu der ich immer wieder zurückkomme, nachdem ich Jahre damit verbracht habe, KI in echten Warteschlangen laufen zu sehen statt nur in Benchmarks. Kimi K2.7 Codes Preisgestaltung ist wirklich gut, wenn Sie ein Entwickler mit einem Coding-Agenten und einigermaßen vorhersehbarem Token-Volumen sind - Sie können eine monatliche Rechnung in einem vernünftigen Rahmen prognostizieren, und Sie haben drei Wege, weniger zu zahlen (offizieller Satz, OpenRouter oder Self-Hosting). Aber wenn der Grund, warum Sie auf einer Seite zu "Preisen für Coding-Modelle" gelandet sind, eigentlich der ist, dass Sie KI für etwas wie Kundensupport budgetieren wollen, ist Pro-Token-Abrechnung die falsche Einheit überhaupt, und die Community-Threads oben sind genau der Grund dafür.
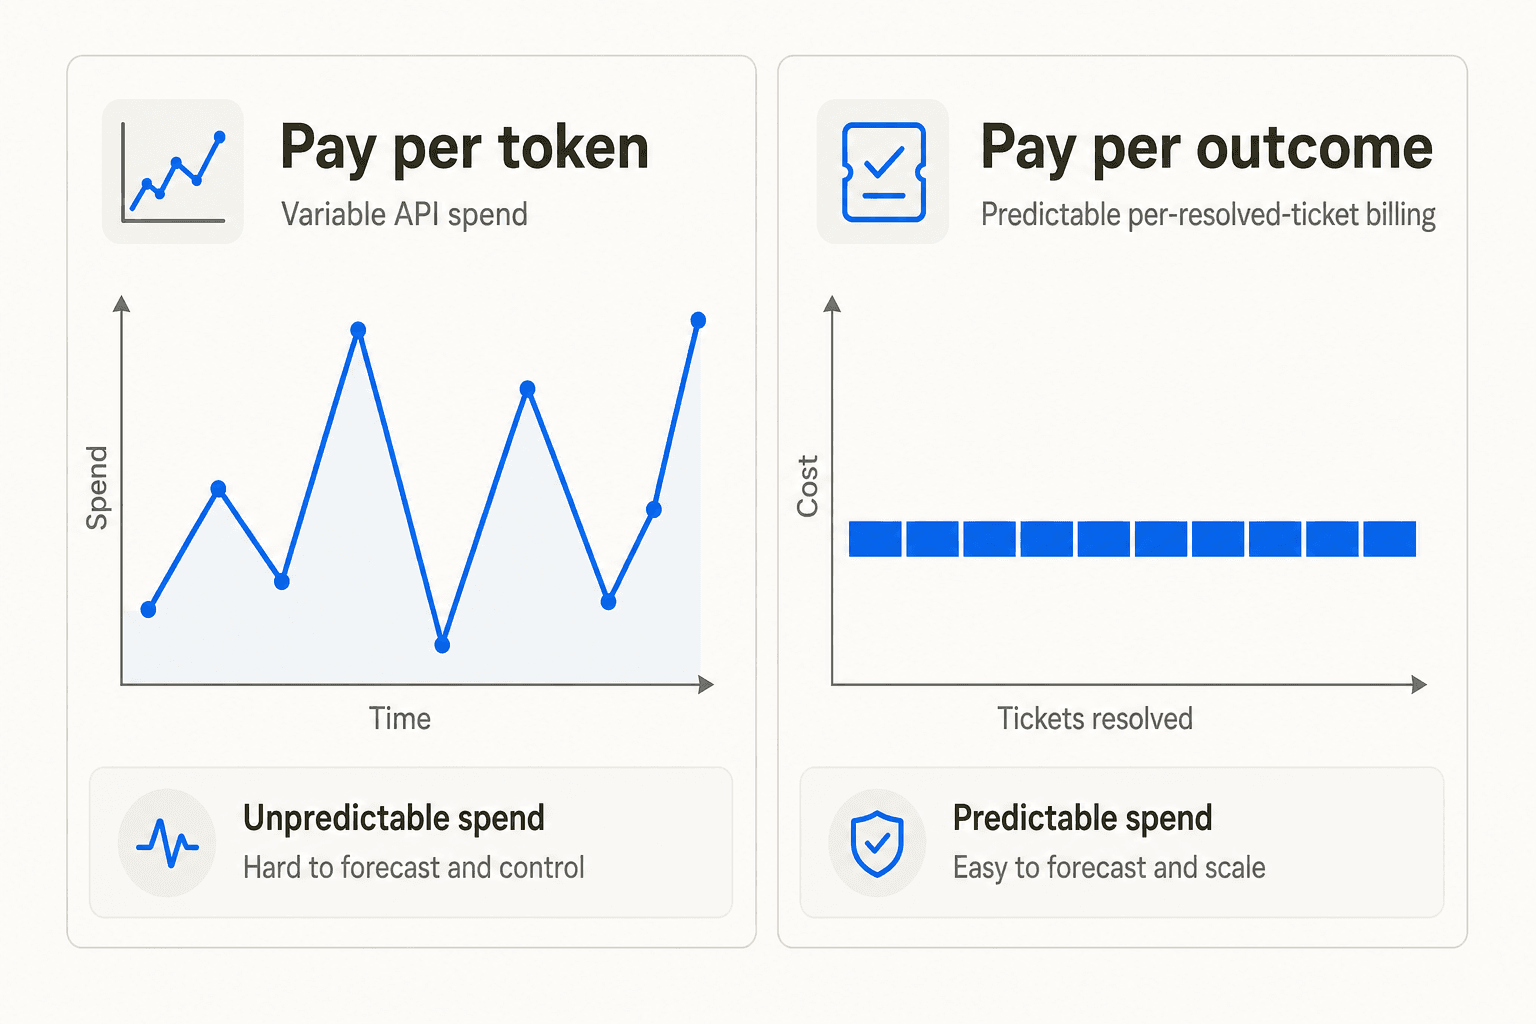
Ein Ticket, das mit drei schnellen Tool-Aufrufen gelöst wird, und ein Ticket, das zwölf braucht, kosten unter Token-Abrechnung völlig unterschiedliche Beträge, und ein Modell-Update - wie von K2.6 zu K2.7 - kann stillschweigend verdoppeln, was ein "gelöstes" Gespräch kostet, ohne dass jemand eine Einstellung ändert. Genau diese Unvorhersehbarkeit lässt Teams bei KI-Support-Einführungen stocken: Man kann keine Zahl ins nächstjährige Budget schreiben, wenn sich die Zahl jedes Mal ändert, wenn der Anbieter ein Modell ausliefert, das anders "denkt", und ein Modell, das verpflichtend immer nachdenkt, bevor es antwortet - was bei K2.7 Code der Fall ist, der Thinking-Modus lässt sich nicht abschalten - ist eine weitere Variable, die sich darauf aufstapelt.
eesel ausprobieren
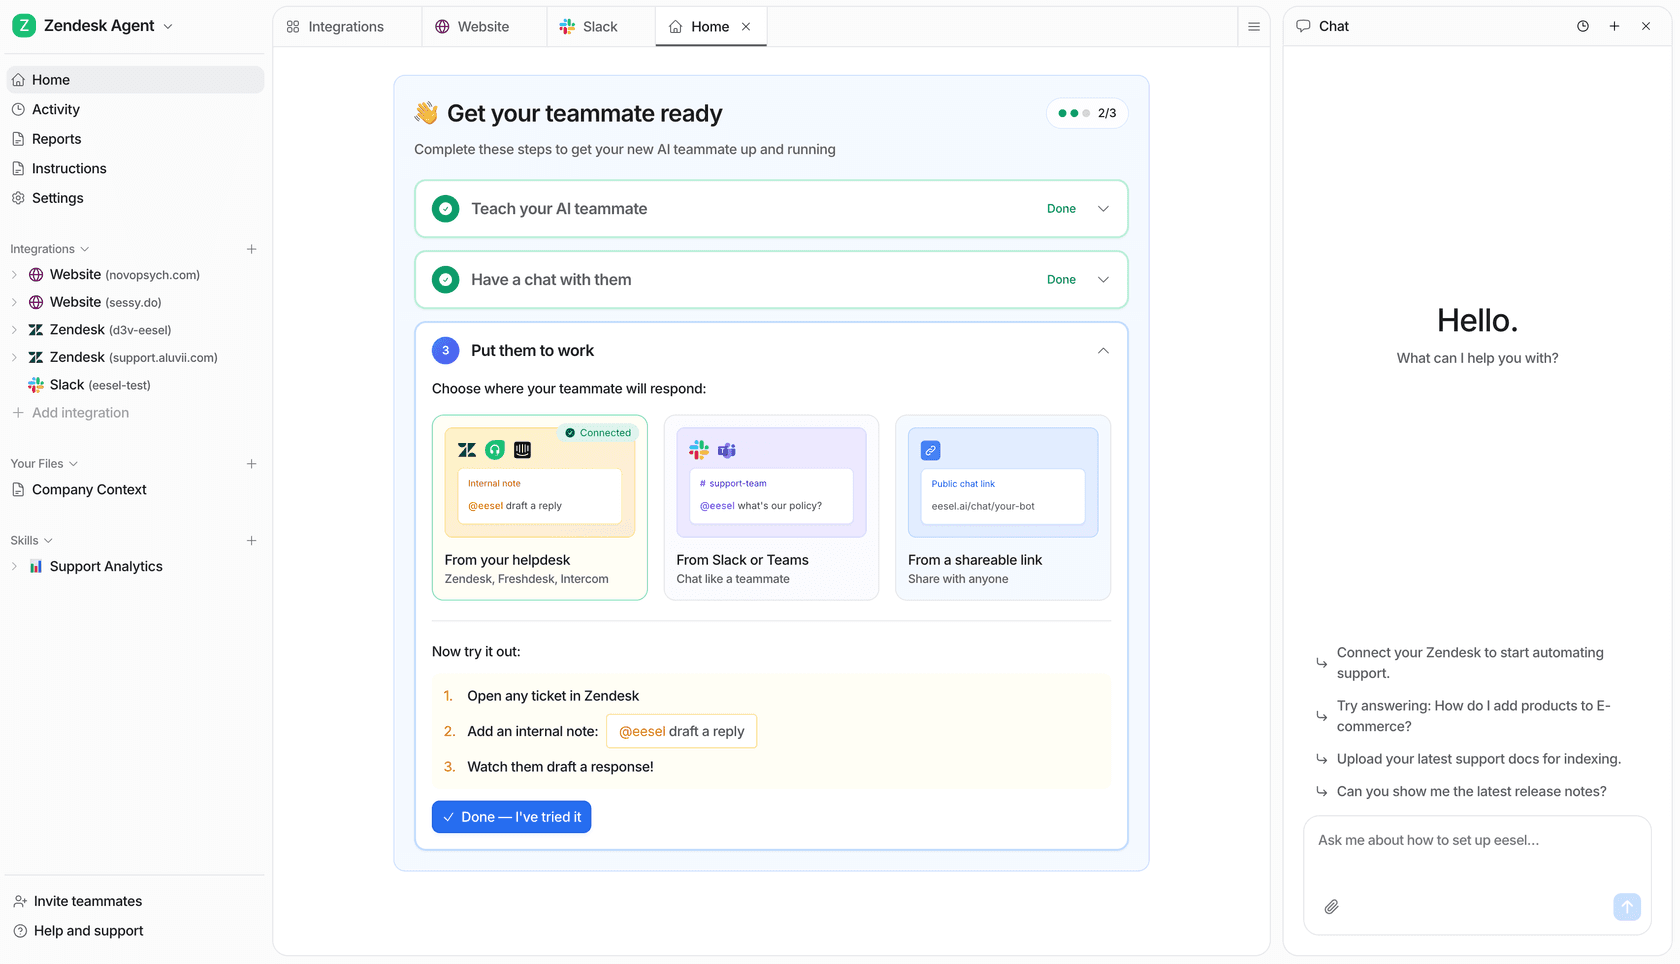
Wenn Sie so weit gekommen sind, weil Sie KI-Preise für Kundensupport statt für einen Coding-Agenten abwägen, lohnt sich dieser Teil besonders. eesel ist ein KI-Support-Teammitglied, das unter der Haube auf Frontier-Modellen läuft, aber Sie behalten nie einen Token-Zähler im Blick: Es wird pro gelöstem Ticket bepreist, ab 0,40 $ pro Ticket, ohne Sitzgebühren und ohne Plattform-Mindestbetrag, sodass ein Backend-Modell-Update Ihre Rechnung nicht heimlich verändert. Es bindet sich in Ihren bestehenden Helpdesk ein (Zendesk, Freshdesk, Front und über 100 weitere), lernt vom ersten Tag an aus Ihrer echten Tickethistorie, und Sie können es gegen vergangene Tickets simulieren, um die echte Lösungsrate und die echten Kosten zu sehen, bevor es je einem echten Kunden antwortet.
Häufig gestellte Fragen
Wie viel kostet Kimi K2.7 Code?
Moonshots eigene API bepreist das Standardmodell kimi-k2.7-code mit 0,95 $ pro 1 Mio. Input-Tokens (0,19 $ bei einem Cache-Treffer) und 4,00 $ pro 1 Mio. Output-Tokens. Die HighSpeed-Variante liegt exakt beim Doppelten jedes Satzes: 1,90 $ / 8,00 $. Vor dem API-Zugriff ist eine Mindestaufladung von 1 $ des Kontos erforderlich. Die vollständige Aufschlüsselung finden Sie in unserem Kimi K2.7 Code Erklärartikel.
Ist Kimi K2.7 Code kostenlos nutzbar?
Über Moonshots API nicht, nein. Es gibt keine kostenlose API-Stufe, nur eine Mindestaufladung von 1 $, um die niedrigste Ratenlimit-Stufe freizuschalten. Kostenlos ist es beim Self-Hosting: Die Gewichte erscheinen unter einer modifizierten MIT-Lizenz auf Hugging Face, sodass Sie das Modell selbst betreiben und nur für Ihre eigene Rechenleistung zahlen können.
Warum sagen manche Nutzer, Kimi K2.7 Code koste mehr als Kimi K2.6?
Moonshot wirbt mit rund 30 % weniger Reasoning-Tokens als bei K2.6, was die Rechnung eigentlich senken sollte. Mehrere Reddit-Threads berichten das Gegenteil: Nutzer, die ihr wöchentliches Guthaben-Limit schneller aufbrauchen und das Modell so beschreiben, dass es "doppelt so schnell Tokens verbraucht." Unser Kimi K2.7 Code Review geht dieser Lücke zwischen Behauptung und echter Nutzung genauer nach.
Ist Kimi K2.7 Code günstiger als Claude Opus 4.8 oder GPT-5.5?
Auf dem Papier ja, mit deutlichem Abstand. Claude Opus 4.8 listet 5,00 $ Input / 25,00 $ Output pro 1 Mio. Tokens, mehr als das 5-Fache von Kimi K2.7 Codes offiziellem Satz. GPT-5.5s Preise stehen nicht in Moonshots eigener Vergleichstabelle, aber unsere GPT-5.6 Preisaufschlüsselung zeigt, dass OpenAIs Flaggschiff-Stufe ähnlich wie Opus bepreist ist. Kimis Benchmark-Werte liegen bei den meisten Aufgaben hinter beiden, der Vergleich ist also 'bepreist für das, was man bekommt', nicht 'bepreist für dasselbe'.
Kann ich Kimi K2.7 Code günstiger betreiben als zu Moonshots eigenem Satz?
Ja, auf zwei Wegen. Drittanbieter-Hosts auf OpenRouter wie DeepInfra unterbieten Moonshots eigenen Listenpreis bei Input-Tokens um rund 20-25 %, meist allerdings bei geringerem Durchsatz. Oder Sie hosten die offenen Gewichte kostenlos selbst (nur Rechenkosten) - volle Präzision benötigt rund 595 GB, aber Community-2-Bit-Quantisierung bringt eine nutzbare Version auf etwa 325 GB herunter. Weitere Optionen finden Sie in unserem Überblick zu Kimi K2.7 Code Alternativen.

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.