Kurzfassung
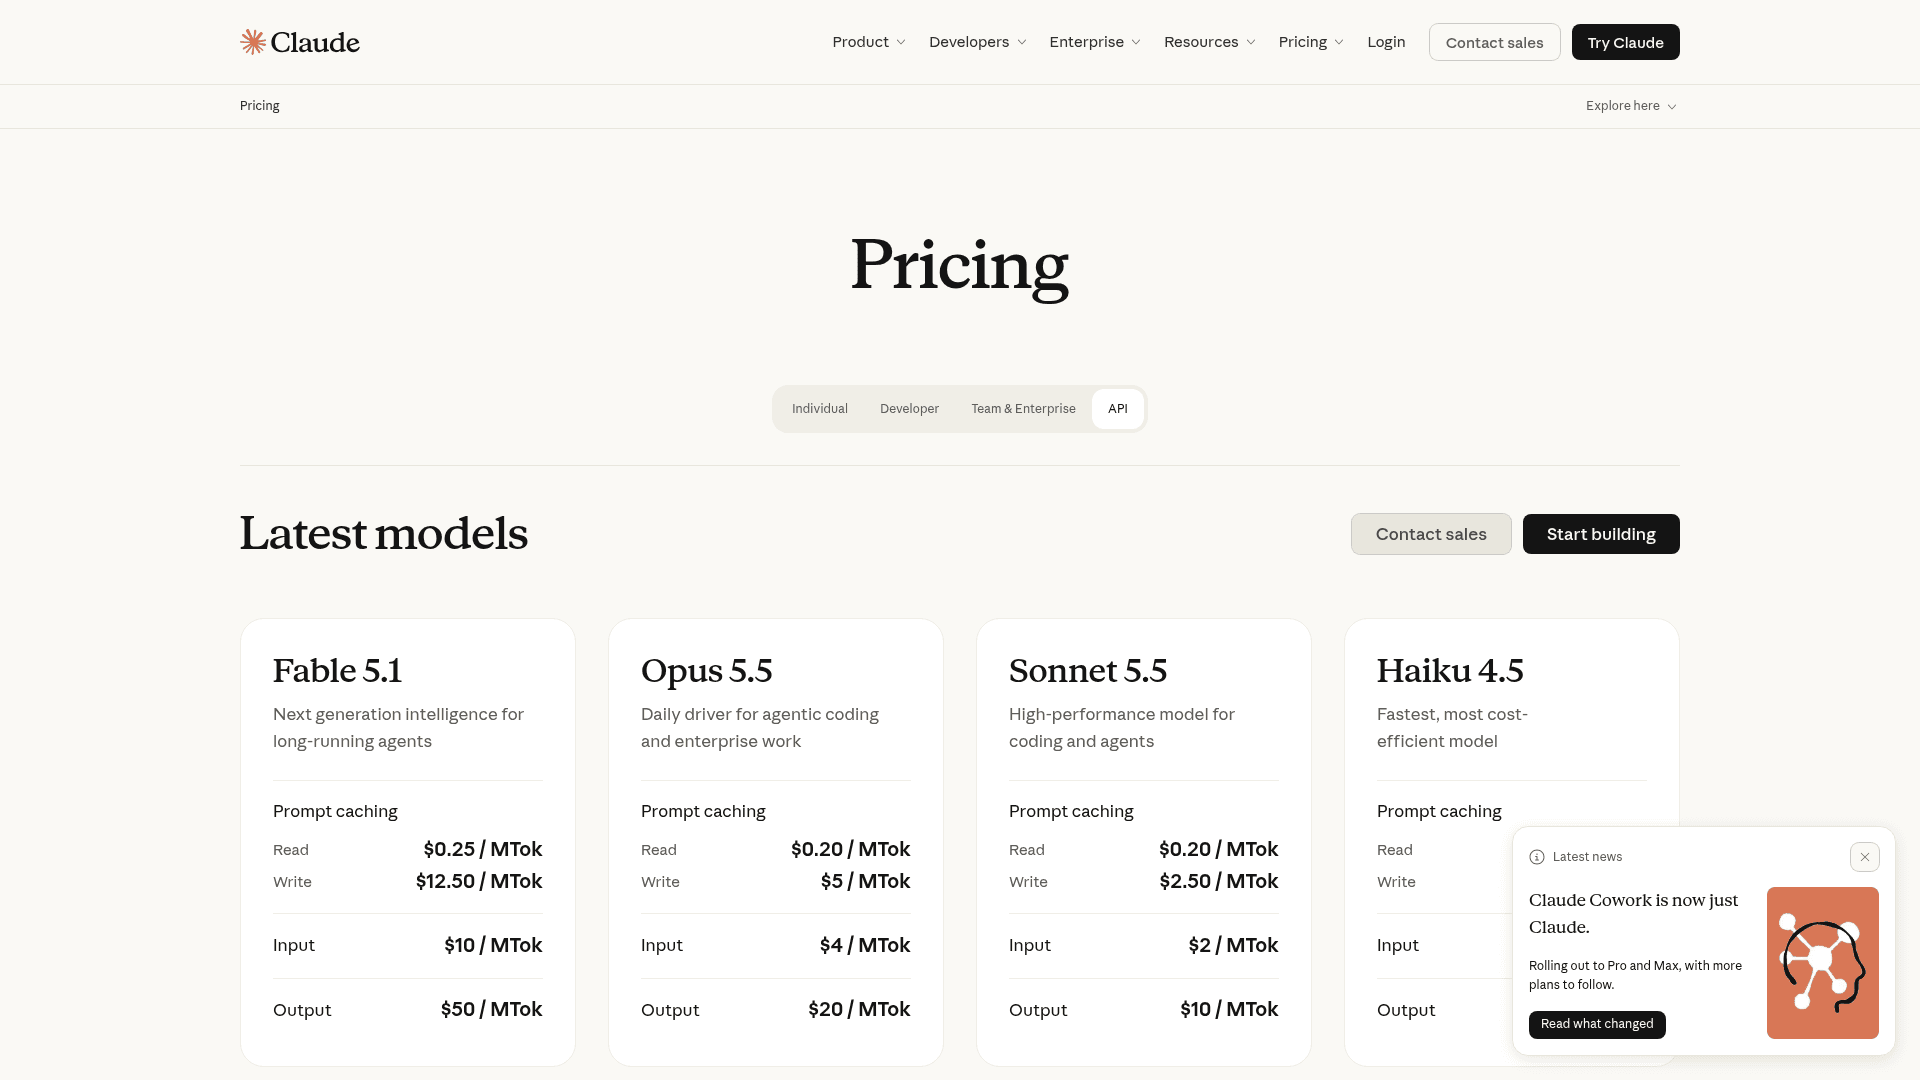
Claude Sonnet 5.5 kostet 2 $ pro Million Input-Tokens und 10 $ pro Million Output-Tokens, genauso viel wie Sonnet 5 und exakt die Hälfte von Claude Opus 5.5 bei Input, Output, Cache-Schreibvorgängen und Batch. Es gibt keinen Long-Context-Aufschlag im gesamten 1M-Fenster, und das Modell ist im kostenlosen Claude-Plan enthalten.
Der Haken ist die eine Position, die nicht zum halben Preis zu haben ist. Cache-Lesezugriffe kosten bei Sonnet 5.5 und Opus 5.5 gleichermaßen 0,20 $ pro Million. In den Tests von Artificial Analysis machten Cache-Lesezugriffe bei Max-Effort 40 % der Rechnung von Sonnet 5.5 aus, und bei dieser Einstellung kostete es 7,60 $ pro Aufgabe gegenüber 5,98 $ bei Opus 5.5. Bei Low und Medium ist Sonnet 5.5 die günstige, schnelle Option, als die es sich präsentiert. Oberhalb von High erreicht Opus 5.5 bei Medium meist denselben Score für weniger Geld.
Bei eesel schreibe ich den Integrationscode, der diese API-Aufrufe abschickt, deshalb lese ich Preislisten nach der Zeile, die am Ende auf der Rechnung steht. Wenn Sie Sonnet 5.5 für eine Support-Warteschlange kalkulieren: eesel betreibt Modelle wie dieses in einem KI-Helpdesk-Teammitglied, das pro bearbeitetem Ticket abrechnet, sodass der Effort-Regler nie auf Ihrer Rechnung auftaucht.
Claude Sonnet 5.5 Preise im Überblick
Claude Sonnet 5.5 wurde am 28. September 2026 veröffentlicht, und Anthropic hat den Preis gleich gelassen. Das ist die komplette API-Preisliste aus der Claude-Preisdokumentation, pro Million Tokens, neben den zwei nächsten Geschwistern:
| Preis pro 1M Tokens | Claude Sonnet 5.5 | Claude Opus 5.5 | Claude Haiku 4.5 |
|---|---|---|---|
| Input | $2 | $4 | $1 |
| Output (inkl. Thinking) | $10 | $20 | $5 |
| 5-Minuten-Cache-Schreibvorgang | $2.50 | $5 | $1.25 |
| 1-Stunden-Cache-Schreibvorgang | $4 | $8 | $2 |
| Cache-Lesezugriff | $0.20 | $0.20 | $0.10 |
| Batch Input / Output | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Fast Mode | Nicht angeboten | $8 / $40 | Nicht angeboten |
| Kontextfenster | 1M | 1M | 200K |
| Max. Output | 128K (300K in der Batch-Beta) | 128K (300K in Batch) | 64K |
| Long-Context-Aufschlag | Keiner | Keiner | k. A. |
Einige Details in dieser Tabelle sind wichtiger, als sie zunächst wirken:
- Thinking wird als Output abgerechnet. Sonnet 5.5 nutzt adaptives Thinking, daher kostet jeder Reasoning-Token 10 $ pro Million, genau wie die Antwort.
- Der API-Standard-Effort ist
high, laut Modellübersicht. Die Claude-Apps und Claude Code verwenden standardmäßig Medium. Diese eine Einstellung verändert Ihre Rechnung stärker als alles andere auf dieser Seite. - Der minimal cachebare Prompt hat 512 Tokens, sodass sich selbst ein kurzer Support-System-Prompt cachen lässt.
- Der Tokenizer ist gegenüber Sonnet 5 unverändert, derselbe Text ergibt also dieselbe Token-Anzahl. Jede Ersparnis entsteht, weil das Modell weniger schreibt, nicht durch freundlicheres Zählen.
Wenn Sie von der Vorgängergeneration kommen: Am Listenpreis hat sich gegenüber den Sonnet 5 Preisen nichts bewegt, und er liegt weiterhin unter den 3 $ und 15 $ von Claude Sonnet 4.6. Anthropics Argument ist, dass die Rechnung trotzdem sinkt, weil das Modell dieselbe Arbeit mit weniger Tokens erledigt.
Halber Preis von Opus bei jeder Position außer einer
Hier ist der Teil, den die meisten Preiszusammenfassungen auslassen. Sonnet 5.5 kostet bei Input, Output, Cache-Schreibvorgängen und Batch exakt die Hälfte von Claude Opus 5.5. Bei Cache-Lesezugriffen ist es überhaupt nicht günstiger.
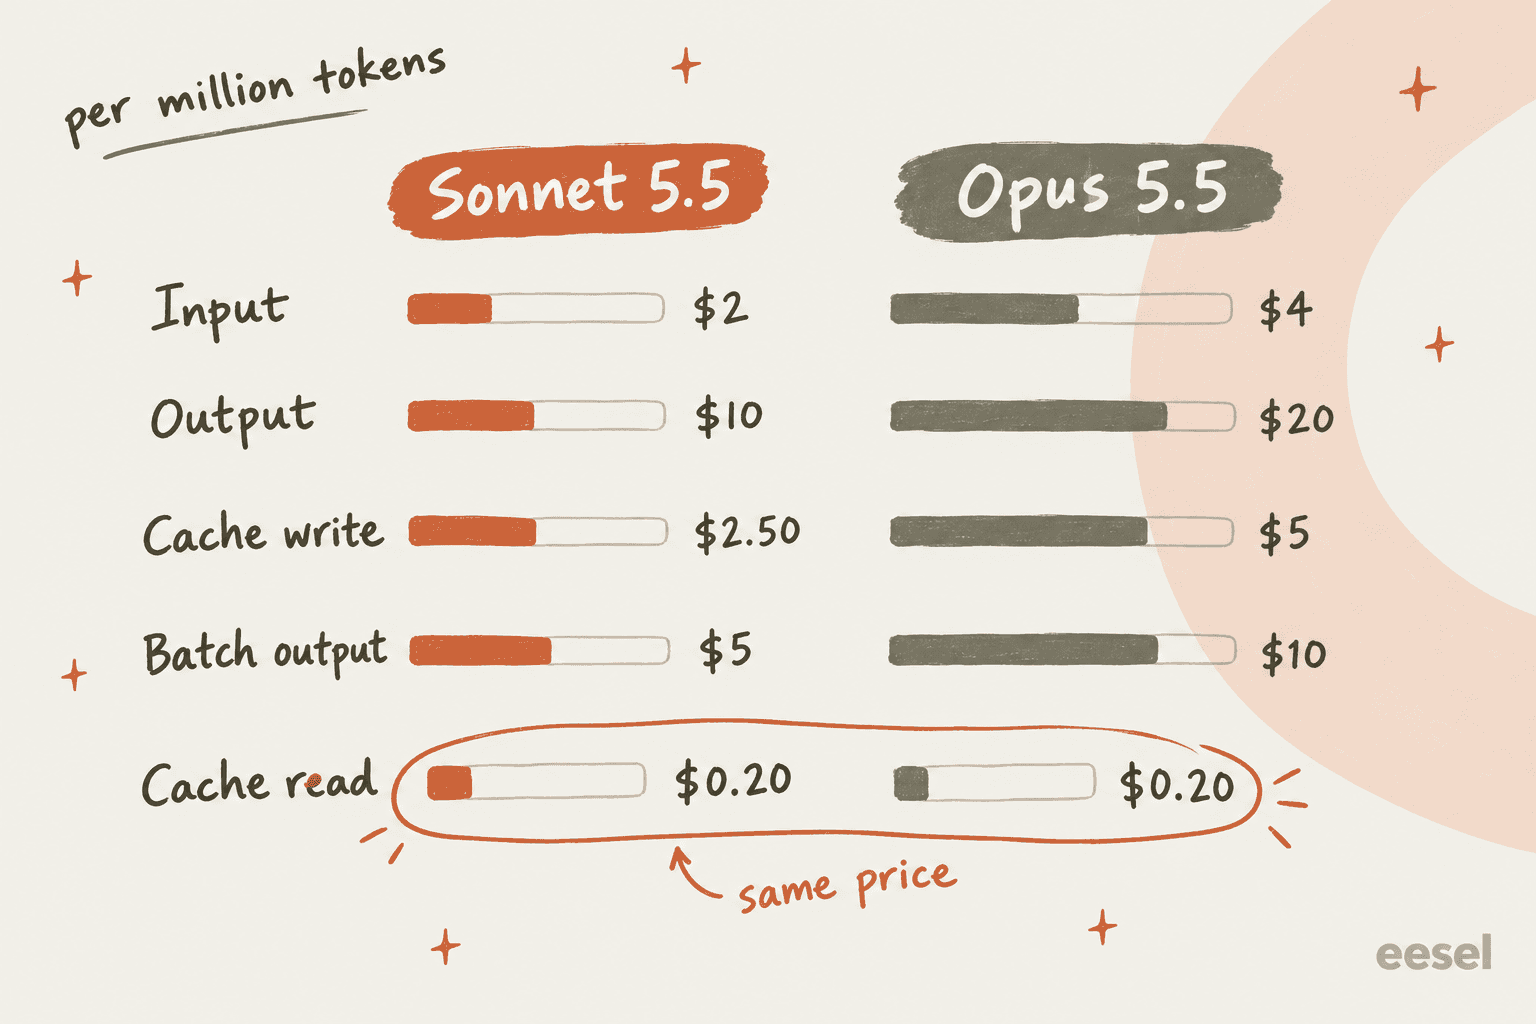
Das kam daher, dass Opus 5.5 einen ungewöhnlich günstigen Cache bekommen hat. Sein Cache-Lese-Multiplikator beträgt 0,05x des Inputs, während Sonnet den üblichen Wert von 0,1x nutzt, laut Prompt-Caching-Tabelle. Opus-Input kostet 4 $, 0,05x ergibt also 0,20 $. Sonnet-Input kostet 2 $, 0,1x ergibt ebenfalls 0,20 $. Dieselbe Zahl auf zwei Wegen.
Für einen Chatbot, der einen Prompt sendet und eine Antwort bekommt, spielt das kaum eine Rolle, für einen Agenten dagegen sehr wohl. Jeder Durchlauf einer Agent-Schleife sendet die gesamte bisherige Unterhaltung erneut, und bei aktiviertem Caching wird der Großteil davon als Cache-Lesezugriff abgerechnet. Je länger die Sitzung läuft, desto größer wird diese Position, und sie ist die eine Position, bei der die Wahl des kleineren Modells nichts spart.
Die Community hat es am Launch-Tag bemerkt:
"Cache read is the same as Opus as well where most agentic workflow cost comes from. Not quite sure where this fits well."

Was ein realer Lauf tatsächlich kostet
Eine Preisliste nennt den Preis eines Tokens. Sie sagt nicht, wie viele Tokens ein Modell braucht, um eine Aufgabe zu erledigen, und genau hier wird Sonnet 5.5 interessant. Artificial Analysis hat seinen Intelligence Index bei jeder Effort-Stufe laufen lassen und die gemessenen Kosten pro Aufgabe veröffentlicht.
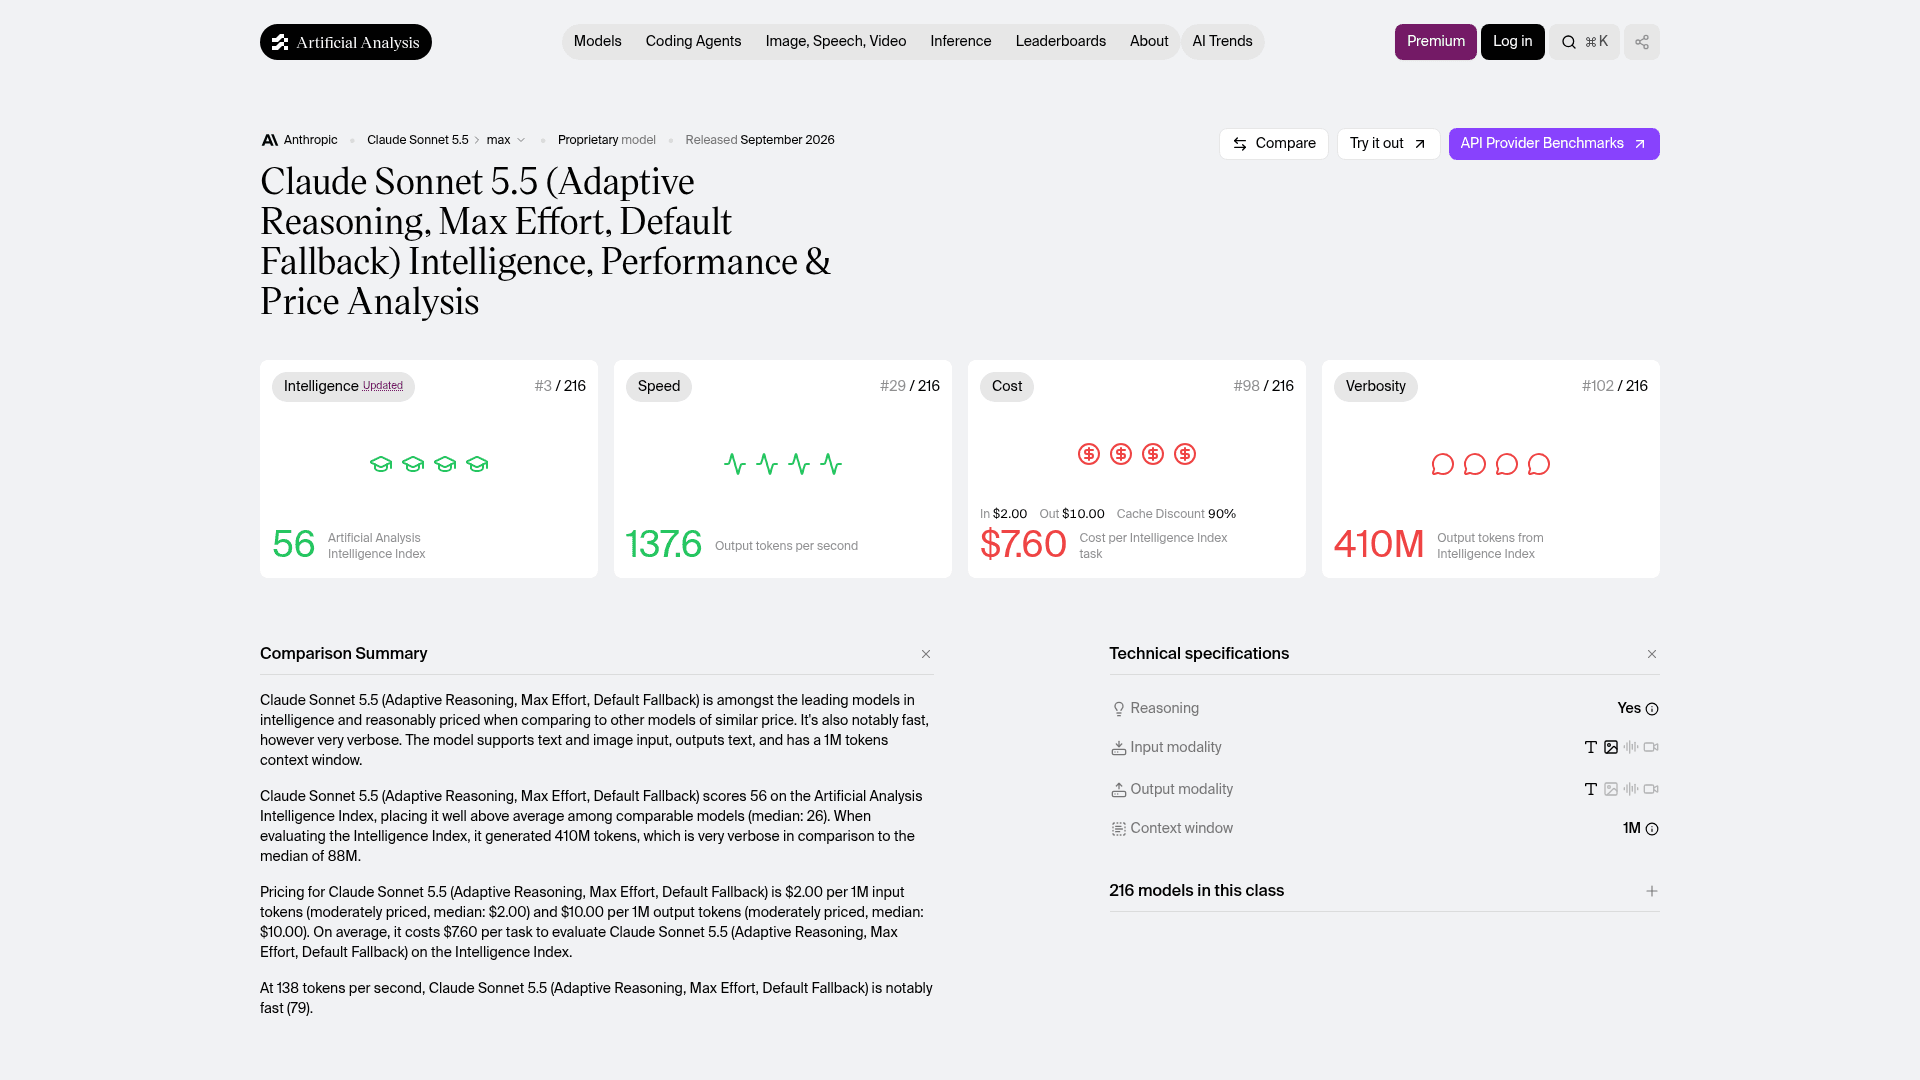
Die Seite ist bei den Kosten deutlich. Bei Max-Effort erzeugte Sonnet 5.5 über den Index hinweg 410M Output-Tokens gegenüber einem Klassenmedian von 88M, und AAs eigene Zusammenfassung nennt es "very verbose". Hier die komplette Stufenleiter von AAs Sonnet-5.5-Seite, neben den passenden Zeilen von der Opus 5.5 Seite:
| Effort | Sonnet 5.5 Score | Sonnet 5.5 Kosten pro Aufgabe | Output-Tokens pro Aufgabe | Opus 5.5 Score | Opus 5.5 Kosten pro Aufgabe |
|---|---|---|---|---|---|
| Low | 36 | $0.41 | 13.9k | 42 | $0.55 |
| Medium | 41 | $0.59 | 19.5k | 51 | $1.34 |
| High | 47 | $1.08 | 34.5k | 54 | $1.82 |
| Xhigh | 52 | $2.74 | 73.7k | 56 | $3.46 |
| Max | 56 | $7.60 | 192.8k | 58 | $5.98 |
Liest man die Sonnet-Spalte von oben nach unten, verdoppeln sich die Kosten ab Medium ungefähr mit jeder Stufe, und von Xhigh auf Max verdreifachen sie sich fast. Liest man quer, kippt das Muster um High herum. Sonnet 5.5 bei Max-Effort kostet pro Aufgabe 27 % mehr als Opus 5.5 bei Max, und das bei zwei Punkten weniger Score. Es benötigte dort 193k Output-Tokens pro Aufgabe, gegenüber 119k bei Opus.
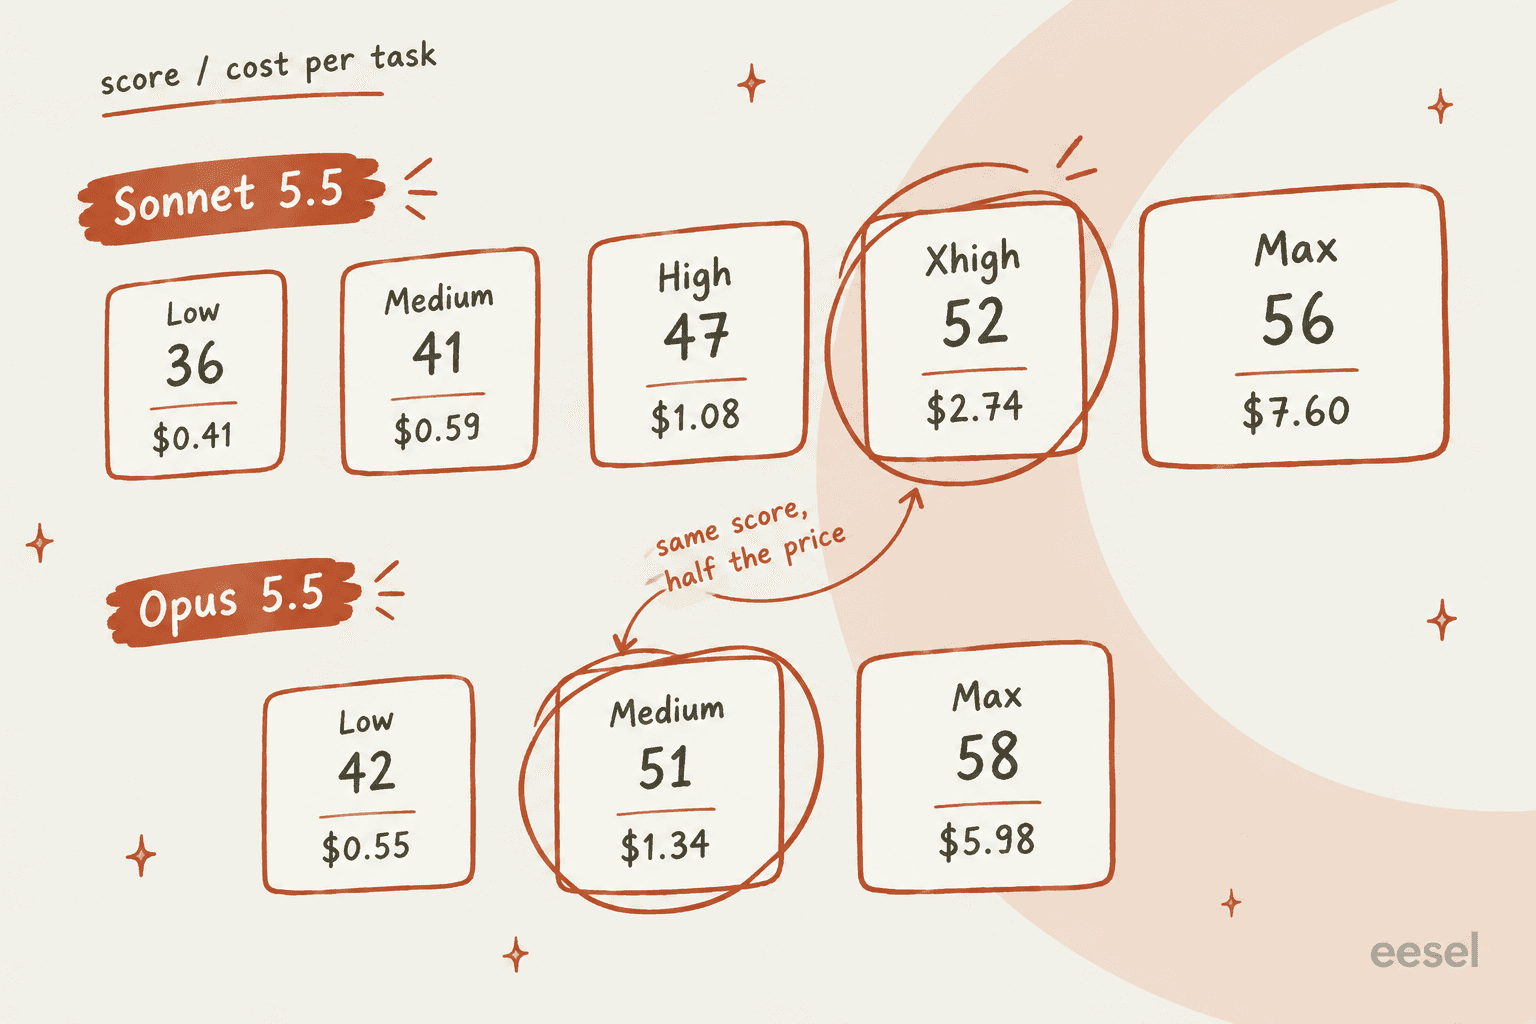
Das Paar, das ich mir am genauesten ansehen würde, ist Sonnet Xhigh gegen Opus Medium. Sie erreichen 52 und 51, und Opus kostet 1,34 $ gegenüber 2,74 $ bei Sonnet. Wenn Sie Sonnet 5.5 über High hinaus hochdrehen, um die nötige Qualität zu bekommen, zahlen Sie am Ende mehr, als das größere Modell in seiner Standardeinstellung kosten würde.
Das ist auch die ehrliche Lesart von Anthropics eigener Aussage "bis zu 30 % weniger pro Aufgabe". Der Launch-Beitrag sagt, Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings, where it costs less per task. At higher settings, it can perform comparably at a similar cost." Die AA-Zahlen bestätigen das genau.
Wohin das Geld bei einer Agent-Rechnung fließt
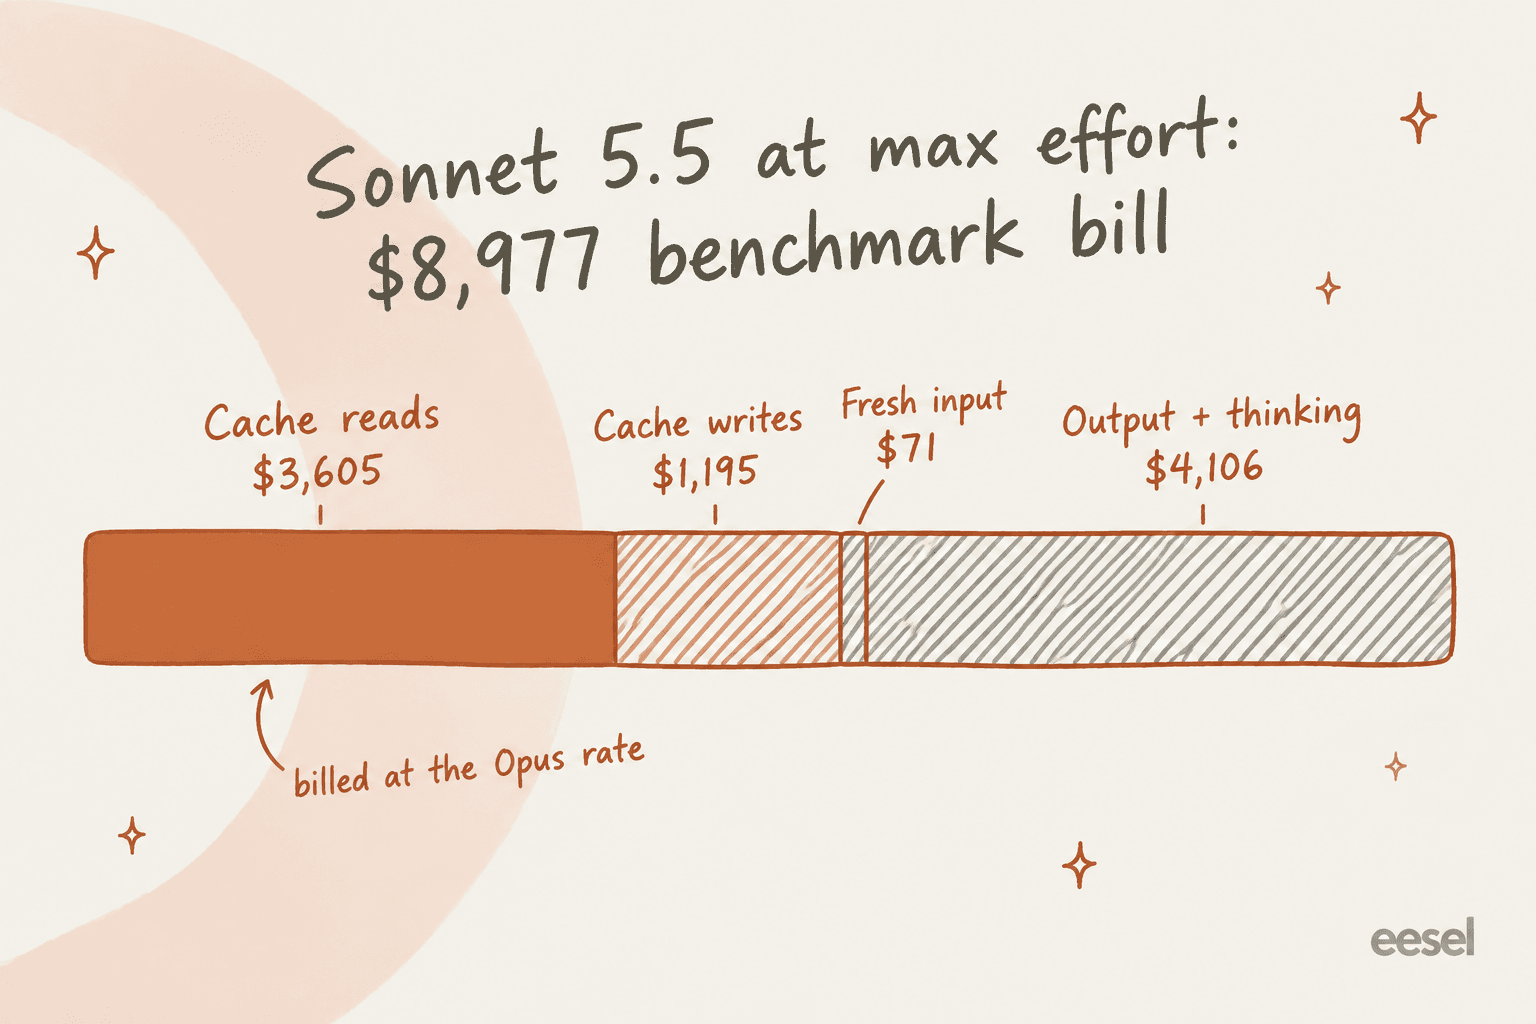
AA schlüsselt außerdem die Kosten jedes Laufs nach Token-Art auf, und hier hört die Cache-Lese-Position von vorhin auf, theoretisch zu sein. Beim vollständigen Max-Effort-Lauf des Intelligence Index belief sich die Rechnung von Sonnet 5.5 auf 8.977 $:
| Position | Sonnet 5.5 bei Max | Anteil | Sonnet 5.5 bei Medium | Anteil |
|---|---|---|---|---|
| Cache-Lesezugriffe | $3,605 | 40% | $180 | 26% |
| Cache-Schreibvorgänge | $1,195 | 13% | $155 | 22% |
| Frischer Input | $71 | 1% | $70 | 10% |
| Output und Thinking | $4,106 | 46% | $295 | 42% |
| Gesamt | $8,977 | $701 |
Zwei Dinge fallen daran auf. Frischer Input, die Position, die die meisten meinen, wenn sie "Input-Tokens" hören, ist fast nichts, weil nahezu jeder Input-Token in einem Agent-Lauf ein Cache-Lesezugriff oder ein Cache-Schreibvorgang ist. Und Cache-Lesezugriffe, die Position ohne Sonnet-Rabatt, wachsen von einem Viertel der Rechnung bei Medium auf 40 % bei Max, weil längeres Thinking mehr Durchläufe und mehr erneutes Lesen bedeutet.
Stellt man beide Modelle beim selben Lauf nebeneinander, schließt sich die Lücke, was dieselbe Geschichte ist, die der ältere Vergleich Opus 5 vs Sonnet 5 erzählt hat. Bei Medium kostete der Index-Lauf mit Sonnet 5.5 701 $ gegenüber 1.627 $ bei Opus 5.5, Sonnet lag also bei 43 % der Opus-Rechnung. Bei Max kostete Sonnet 8.977 $ gegenüber 8.708 $ bei Opus. Halber Listenpreis, 3 % mehr auf der Rechnung.
Durchgerechnete Beispiele für drei Workload-Formen
Benchmarks sind die Workload von jemand anderem, deshalb hier die Rechnung nach Preisliste für drei gängige Formen, nur mit den veröffentlichten Preisen. Betrachten Sie die Token-Zahlen als Illustration und setzen Sie im Rechner unten Ihre eigenen ein.
1. Ein Support-Antwort-Bot. Jede Antwort sendet 8.000 Input-Tokens, davon 6.000 als gecachter System-Prompt und Hilfeartikel, und bekommt 1.500 Tokens zurück, Thinking eingeschlossen.
- Sonnet 5.5: 0,004 $ frischer Input + 0,0012 $ Cache-Lesezugriffe + 0,015 $ Output = etwa 2 Cent pro Antwort, oder 202 $ pro 10.000 Tickets
- Opus 5.5: 0,008 $ + 0,0012 $ + 0,03 $ = etwa 3,9 Cent, oder 392 $ pro 10.000
- Haiku 4.5: 0,002 $ + 0,0006 $ + 0,0075 $ = etwa 1 Cent, oder 101 $ pro 10.000
Der Output dominiert hier, deshalb schlägt Sonnets halber Preis beim Output fast vollständig durch. Das ist die Form, bei der Sonnet 5.5 eindeutig der bessere Kauf gegenüber Opus ist. Einen weiteren Blick auf die Kosten von KI-Support jenseits des Modells bietet der Leitfaden zu den Kosten für KI im Kundenservice.
2. Eine lange Agent-Sitzung. Stellen Sie sich einen Coding- oder Ops-Agenten vor, der 30 Durchläufe macht, in jedem einen Kontext von 60.000 Tokens aus dem Cache neu liest, 3.000 frische Tokens hinzufügt und 2.000 schreibt.
- Sonnet 5.5: 0,36 $ Cache-Lesezugriffe + 0,18 $ frischer Input + 0,60 $ Output = 1,14 $
- Opus 5.5: 0,36 $ + 0,36 $ + 1,20 $ = 1,92 $
Angenommen, Sonnet braucht nun 40 Durchläufe, wo Opus 25 braucht, was der Richtung der AA-Token-Zahlen bei höherem Effort entspricht. Dann kostet Sonnet 0,48 $ + 0,24 $ + 0,80 $ = 1,52 $ und Opus 0,30 $ + 0,30 $ + 1,00 $ = 1,60 $. Das "halb so teure" Modell liegt jetzt nur noch 8 Cent unter dem teuren.
3. Ein nächtlicher Batch-Job. Sie extrahieren Felder aus 10.000 Dokumenten mit je 20.000 Input-Tokens und 1.000 Output-Tokens, und nichts braucht eine Antwort in Echtzeit.
- Sonnet 5.5 im Batch: 200 $ Input + 50 $ Output = 250 $
- Opus 5.5 im Batch: 400 $ + 100 $ = 500 $
- Haiku 4.5 im Batch: 100 $ + 25 $ = 125 $
Es gibt kein erneutes Lesen aus dem Cache und keine Agent-Schleife, daher gilt das Verhältnis 2:1 ziemlich sauber. Batch lässt sich laut Preisdokumentation außerdem mit Prompt Caching kombinieren.
Berechnen Sie Ihre eigene Monatsrechnung
Legen Sie die Token-Anzahl pro Aufgabe für Ihre Workload fest und sehen Sie, was jedes Modell pro Monat kostet. Cache-Schreibvorgänge sind der Einfachheit halber ausgelassen, da sie bei warmem Cache nur einen kleinen Anteil einer gleichmäßigen Workload ausmachen.
Wenn Sie das Agent-Preset überrascht, ist das die Cache-Lese-Position bei der Arbeit. Bei 1,8M gecachten Tokens pro Sitzung zahlen Sonnet und Opus für das erneute Lesen dieselben 0,36 $, und nur die Output-Position hält sie noch auseinander.
Effort ist der Preisregler, und der API-Standard ist high
Anthropic lässt Sie den Effort pro Anfrage einstellen, und er ist der größte einzelne Hebel bei einer Sonnet-5.5-Rechnung. Simon Willison hat denselben SVG-Prompt bei jeder Stufe laufen lassen und die Kosten im Launch-Thread gepostet:
| Effort | Kosten für einen Prompt | Zeit |
|---|---|---|
| Low | 1,6 Cent | 10s |
| Medium | 1,8 Cent | 11s |
| High | 2,3 Cent | 17s |
| Xhigh | 5,7 Cent | 41s |
| Max | $1.28 | 15m 40s, und es ist gescheitert |
Bei Max hat das Modell in seinen Worten "burned through 128,000 thinking tokens (taking 15 minutes to do that) and ran out before it had produced the final SVG". Das ist ein 80-facher Kostensprung von Low auf Max für ein schlechteres Ergebnis.
Mein praktischer Rat, als jemand, der diese Aufrufe in Produktionscode einbaut:
- Setzen Sie den Effort bei jeder Anfrage explizit. Der API-Standard ist
high, nicht das Medium aus den Apps, daher startet eine naive Integration eine Stufe oberhalb der günstigen Zone. - Starten Sie bei Low für Routinearbeit wie Klassifizierung, Tagging und kurze Antworten, und gehen Sie nur dort höher, wo Ihre Evals eine echte Lücke zeigen.
- Behandeln Sie Xhigh und Max als Signal, das Modell zu wechseln. Oberhalb von High schlägt Opus 5.5 bei Medium Sonnet tendenziell bei Score und Preis.
- Wiederholen Sie Ihre Effort-Tests, wenn Sie von Sonnet 5 migrieren. Anthropic hat die Stufen auf der Seite What's new neu kalibriert, alte Einstellungen lassen sich also nicht übertragen.
Der Vorteil ist am unteren Ende des Reglers groß. AA maß Sonnet 5.5 bei Medium mit einem Score von 41 für 0,59 $ pro Aufgabe, gegenüber Claude Sonnet 5 bei Max mit einem Score von 38 für 5,09 $. Das ist ein besseres Ergebnis für etwa ein Neuntel der Kosten, also genau die Upgrade-Geschichte, die Anthropic verkauft, und sie hält stand.
Rabatte, Zusatzoptionen und die kleineren Posten
Neben dem Effort verändern vier Modifikatoren den Preis pro Token, alle aus der Claude-Preisdokumentation:
| Modifikator | Wirkung auf Sonnet 5.5 | Hinweise |
|---|---|---|
| Prompt Caching | Lesezugriffe zu $0.20 (0,1x), Schreibvorgänge zu $2.50 (5 Min.) oder $4 (1 Stunde) | Lohnt sich nach einem Lesezugriff beim 5-Minuten-Cache |
| Batch API | 50 % Rabatt: $1 Input, $5 Output | Kombinierbar mit Caching; 300K Output mit Beta-Header |
| US-only-Inferenz | 1,1x auf jede Token-Kategorie | Einstellbar mit inference_geo: "us" |
| Fast Mode | Nicht verfügbar | Nur Opus 5.5, zu $8 / $40 |
Die Tool-Gebühren kommen zu den Tokens hinzu. Web Search kostet 10 $ pro 1.000 Suchanfragen, Web Fetch kostet nichts extra, und Code Execution ist kostenlos, wenn es zusammen mit Web Search oder Fetch genutzt wird, sonst gibt es 1.550 kostenlose Container-Stunden im Monat und danach 0,05 $ pro Stunde. Sonnet 5.5 fügt 286 System-Prompt-Tokens hinzu, sobald Tools vorhanden sind. Sitzungen mit Claude Managed Agents kosten zusätzlich 0,08 $ pro laufender Sitzungsstunde on top der Standard-Token-Tarife.
Ein leicht zu übersehender Kostenpunkt: Erzwungene Tool-Nutzung (tool_choice auf any oder ein benanntes Tool gesetzt) liefert bei Sonnet 5.5 laut Migrationshinweisen jetzt einen 400-Fehler. Das ist kein Preis, aber wenn Ihr Support-Bot davon abhing, ist der Umbau ein realer Kostenpunkt des Wechsels. Der Hub-Beitrag geht alle fünf Breaking Changes durch.
Claude Free, Pro, Max, Team und Enterprise
Wenn Sie Sonnet 5.5 in den Claude-Apps statt in der API nutzen, zahlen Sie pro Seat, nicht pro Token. Von der Claude-Preisseite:
| Plan | Preis | Zugang zu Sonnet 5.5 | Hinweise |
|---|---|---|---|
| Free | $0 | Ja | Anthropic sagt "anyone can chat with Claude using Sonnet 5.5" |
| Pro | $17/Monat bei jährlicher Abrechnung, $20 monatlich | Ja | Ergänzt Opus und Nutzungs-Credits |
| Max 5x / 20x | Ab $100/Monat | Ja | 5x oder 20x Pro-Nutzung, bevorzugter Zugang |
| Team Standard | $20/Seat/Monat jährlich, $25 monatlich | Ja | Für 2 bis 150 Personen |
| Team Premium | $100/Seat/Monat jährlich, $125 monatlich | Ja | 5x die Nutzung des Standard-Seats |
| Enterprise | $20/Seat/Monat plus Nutzung zu API-Tarifen | Ja | Die Nutzung wird zu den oben genannten Token-Tarifen abgerechnet |
Zwei Dinge verschieben hier die Rechnung. Bei Free und Pro ist Sonnet das Modell, das die meisten tatsächlich nutzen werden, und kostenlose Nutzer bekommen jetzt Sonnet 5.5. Bei Enterprise ist die Seat-Gebühr nur der Anfang, denn die Nutzung wird zu denselben API-Tarifen abgerechnet wie in diesem gesamten Beitrag. Der Claude-Preisleitfaden und die Claude-Pro-Aufschlüsselung behandeln die Nutzungslimits, und der Leitfaden zu den Claude Code Preisen deckt die Entwicklerseite ab, wo Medium der Standard-Effort ist.
Ein Entwickler hat am Launch-Tag die Aufteilung zwischen Abo und API gut auf den Punkt gebracht:
"Sonnet 5.5 might not be useful or necessary in a Claude Code session but it could be good value in the API when you pay per token."
Bedrock, Google Cloud und Foundry
Sonnet 5.5 wurde am ersten Tag auf allen großen Clouds veröffentlicht, als anthropic.claude-sonnet-5-5 auf Amazon Bedrock und claude-sonnet-5-5 auf Google Cloud und Microsoft Foundry, laut Modellübersicht. Wie abgerechnet wird, hängt davon ab, welchen Zugang Sie nutzen:
- Amazon Bedrock und Google Cloud werden vom Partner betrieben. Sie stellen Ihnen ihre eigenen veröffentlichten Tarife direkt in Rechnung, prüfen Sie also die Bedrock-Preise, bevor Sie Gleichstand annehmen. Google veröffentlicht ebenfalls eigene Vertex-AI-Tarife.
- Claude Platform on AWS und Claude in Microsoft Foundry werden von Anthropic betrieben. Sie bewerten Ihre Nutzung zu den Standard-Anthropic-Preisen, wenden einen verhandelten Rabatt an und rechnen in Claude Consumption Units zu je 0,01 $ um, nachträglich stündlich über den Marketplace abgerechnet.
- US-only-Inferenz trägt denselben 1,1x-Multiplikator bei der First-Party-API, Claude Platform on AWS und Foundrys US-Data-Zone-Deployments.
Wenn Sie Claude bereits über eine Cloud betreiben, decken der Bedrock-Leitfaden und der Vertex-AI-Leitfaden die Einrichtung ab.
Wie sich Sonnet 5.5 preislich gegenüber GPT-6 Sol und Gemini 3.8 Flash schlägt
Der auffälligste Vergleich liegt nicht innerhalb von Anthropics Portfolio. GPT-6 Sol hat eine identische Headline-Preisliste: 2 $ Input, 10 $ Output, 0,20 $ gecachter Input, 2,50 $ Cache-Schreibvorgang, laut der Aufschlüsselung der GPT-6 Sol Preise.
| Pro 1M Tokens | Claude Sonnet 5.5 | GPT-6 Sol | Gemini 3.8 Flash |
|---|---|---|---|
| Input | $2 | $2 | $0.75 (steigt am 1. Jan. 2027 auf $1.50) |
| Output | $10 | $10 | $3.75 (steigt auf $7.50) |
| Cache-Lesezugriff | $0.20 | $0.20 | $0.075 |
| Long-Context-Aufschlag | Keiner bis 1M | Höherer Tarif ab 272K Input | Keiner |
| AA-Kosten pro Aufgabe (Einstellung) | $1.08 (high) | $1.05 (max) | Nicht vergleichbar |
| AA Intelligence Index | 47 (high) | 48 (max) | Nicht vergleichbar |
Die AA-Zeilen verraten es. Sonnet 5.5 bei High und GPT-6 Sol bei Max landen bei nahezu demselben Score für nahezu dieselben Kosten pro Aufgabe. Der Unterschied liegt eher an den Rändern: Sonnet hat keinen Long-Context-Aufschlag, ein Support-Agent, der eine große Wissensbasis in den Kontext lädt, überschreitet also keine Preisklippe, Sol dagegen ab 272K. Geminis AA-Zahlen stammen aus einer früheren Version des Index, deshalb habe ich sie aus dem direkten Vergleich herausgelassen, und die Gemini 3.8 Flash Preise verdoppeln sich im Januar. Der Drei-Wege-API-Vergleich geht weiter, wenn Sie einen Anbieter statt eines Modells auswählen.
Bei Support-Tickets im Speziellen hängt die Rangfolge weniger vom Preis ab als von der Zuverlässigkeit bei Ihren eigenen Daten, weshalb das Modell-Ranking für Support-Tickets die Genauigkeit an die erste Stelle setzt.
Was Entwickler zum Preis sagen
Die Reaktion am Launch-Tag auf Hacker News drehte sich meist darum, wo es gegenüber Opus liegt. Die skeptische Sicht:
"I feel like sonnet is priced too close to opus right now. If Sonnet 5.5 were half its current price it would make sense to use."
Die nüchterne Sicht, die zur AA-Stufenleiter oben passt:
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost."
Und die begeisterte, von einem Nutzer, der es bei niedrigerer Einstellung mit OpenAIs Flaggschiff vergleicht:
"Sonnet 5.5 medium scores better than gpt 5.6 Sol high and is less than 1/5 the cost Absolutely bonkers"

Das Muster, bei dem die Leute immer wieder landeten, war ein geteiltes Setup: Sonnet 5.5 bei Low oder Medium übernimmt als Sub-Agent die Arbeit mit hohem Volumen, während Opus 5.5 orchestriert oder die schwierigen Teile abschließt. Wenn keines von beidem passt, zeigt die Übersicht der Claude-Alternativen andere Wege. Das passt zur Preisgestaltung, denn Sonnets Rabatt ist bei output-lastigen Aufrufen mit kurzem Kontext real und verblasst bei langen, cache-lastigen Schleifen.
Sind 2 $ und 10 $ für Claude Sonnet 5.5 es wert?
Ja, bei Low und Medium Effort, und dort würde ich nicht zögern. Es schlägt den besten Score von Sonnet 5 für einen Bruchteil der Kosten, es kostet bei der Output-Position, die chatartige Workloads dominiert, die Hälfte von Opus, und es hat keinen Long-Context-Aufschlag. Für einen Support-Antwort-Bot, einen Klassifikator, einen Entwurfsschritt oder einen nächtlichen Batch-Job ist es meine Standardwahl.
In zwei Fällen ist es ein schwächerer Kauf. Wenn Ihre Workload eine lange Agent-Schleife ist, fressen Cache-Lesezugriffe den Rabatt auf, weil sie bei beiden Modellen dasselbe kosten. Und wenn Sie Xhigh oder Max brauchen, um die gewünschte Qualität zu erreichen, ist Opus 5.5 bei Medium für denselben Score meist günstiger. Testen Sie Sonnet zuerst bei Low, messen Sie, und entscheiden Sie dann, ob sich die Lücke für 1,34 $ pro Aufgabe lohnt.
Wenn die Aufgabe eine Support-Warteschlange ist, gehört eine weitere Kostenposition in die Rechnung: die Planung von Ausgaben, die sich mit Effort und Volumen verändern. Ein Interessent in den Sales-Calls von eesel erreichte an einem einzigen Testtag 200 Interaktionen und machte sich sofort Sorgen um die Kosten pro Interaktion im großen Maßstab. Token-Rechnungen machen diese Sorge schwerer zu beantworten, weil dasselbe Ticket je nach Einstellung 1,6 Cent oder 1,28 $ kosten kann.
eesel testen, für eine feste Rechnung pro Ticket
Sonnet 5.5 ist der Motor. Wenn Sie beantwortete Tickets wollen, ist eesel der Mitarbeiter: ein KI-Helpdesk-Teammitglied, das sich in Zendesk, Freshdesk, Gorgias und Ihre anderen Tools einklinkt, aus Ihren früheren Tickets und Ihrem Help Center lernt und sich an historischen Tickets simulieren lässt, bevor es einem echten Kunden antwortet. Sie wählen nie eine Effort-Stufe und beobachten keine Cache-Lesezugriffe. Die eesel Preise sind ein fester monatlicher Credit-Plan, bei dem ein bearbeitetes Ticket oder ein Chat einen Credit kostet, ab 299 $ für 500 Credits, mit einer kostenlosen Stufe von 100 Credits zum Ausprobieren.
Wenn Sie im Terminal arbeiten, steuert das eesel CLI dasselbe Teammitglied. Sie können Integrationen verbinden und seine Standardanweisungen bearbeiten sowie Aktionen genehmigen oder ablehnen und sein Aktivitätsprotokoll als JSON lesen. Coding-Agenten wie Claude Code können es über den MCP-Server des Workspace ebenfalls ausführen.

eesel testen und sehen, was Ihre Warteschlange pro Ticket statt pro Token kostet.
Häufig gestellte Fragen
Was kostet Claude Sonnet 5.5 pro Million Tokens?
Ist Claude Sonnet 5.5 teurer als Claude Sonnet 5?
Kostet Claude Sonnet 5.5 die Hälfte von Claude Opus 5.5?
Wie betreibe ich Claude Sonnet 5.5 am günstigsten?
Kann ich Claude Sonnet 5.5 kostenlos nutzen?
Berechnet Claude Sonnet 5.5 Aufpreise für langen Kontext?
Was kostet Claude Sonnet 5.5 auf Amazon Bedrock oder Google Cloud?
Was würde Claude Sonnet 5.5 für einen Kundensupport-Bot kosten?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.