

Kurzfassung
Claude Haiku 5.5 kostet 0,10 $ pro Million Input-Tokens und 0,50 $ pro Million Output-Tokens, das entspricht GPT-6 Luna und liegt 90 % unter Haiku 4.5. Dieser Preis gilt nur, solange der Prompt einer Anfrage höchstens 100.000 Tokens umfasst. Darüber kostet jede Zeile der Rechnung das 5-Fache (0,50 $ ein, 2,50 $ aus), gecachte Tokens zählen zur Grenze, und Haiku 5.5 ist das einzige aktuelle Claude-Modell mit dieser Preislogik.
Zwei weitere Dinge bestimmen die echten Kosten pro Aufgabe. Der neue Tokenizer macht aus demselben Text etwa 30 % mehr Tokens als bei Haiku 4.5, und der Aufwand (Effort) bestimmt, wie viel Denken du bezahlst: Dieselbe Benchmark-Suite kostete bei Low 34 $ und bei Max 330 $. Batch halbiert alles, und Cache-Reads kosten ein Zehntel des Inputs.
Für ein Support-Team ist Haiku 5.5 eine sehr günstige Triage-Engine, wenn die Prompts kurz bleiben. 20.000 Tickets im Monat zu taggen kostet etwa 12 $, ein Antwort-Bot, der pro Ticket 120k Tokens Kontext lädt, etwa 1.300 $. Wenn du gar nicht um die Grenze herum bauen willst: Das KI-Helpdesk-Teammate von eesel übernimmt Triage und Antworten direkt in deinem Helpdesk für feste 299 $ im Monat bei 500 Tickets.
Claude Haiku 5.5 Preise auf einen Blick
Mir ist aufgefallen, was Leute nach einem Modellstart suchen. Die Suchanfrage lautet „Claude Haiku 5.5 Preise“, aber das Snippet bei Google beantwortet 0,10 $ und 0,50 $ bereits. Gefragt ist also eigentlich, was ein Monat davon kostet, und das hängt bei Haiku 5.5 von einer Zahl mehr als von allem anderen ab: wie lang deine Prompts sind.
Claude Haiku 5.5 erschien am 7. Oktober 2026 mit der Modell-ID claude-haiku-5-5. Unten die vollständige API-Preisliste aus der Preisdokumentation von Anthropic, pro Million Tokens:
| Posten | Prompt bis 100.000 Tokens | Prompt über 100.000 Tokens |
|---|---|---|
| Input | 0,10 $ | 0,50 $ |
| Output (inklusive Thinking) | 0,50 $ | 2,50 $ |
| Cache-Read (Treffer oder Refresh) | 0,01 $ | 0,05 $ |
| 5-Minuten-Cache-Write | 0,125 $ | 0,625 $ |
| 1-Stunden-Cache-Write | 0,20 $ | 1,00 $ |
| Batch-Input | 0,05 $ | 0,25 $ |
| Batch-Output | 0,25 $ | 1,25 $ |
Und so schneidet es neben den Modellen ab, mit denen du es tatsächlich vergleichen würdest:
| Modell | Input | Output | Cache-Read | Lange Prompts |
|---|---|---|---|---|
| Claude Haiku 5.5 | 0,10 $ | 0,50 $ | 0,01 $ | 5-Fache bei jeder Zeile ab 100k |
| Claude Haiku 4.5 | 1,00 $ | 5,00 $ | 0,10 $ | Einheitlich, 200k Kontextlimit |
| Claude Sonnet 5.5 | 2,00 $ | 10,00 $ | 0,10 $ | Einheitlich bis 1M |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | 0,20 $ | Einheitlich bis 1M |
| Claude Fable 5.1 | 10,00 $ | 50,00 $ | 0,25 $ | Einheitlich bis 1M |
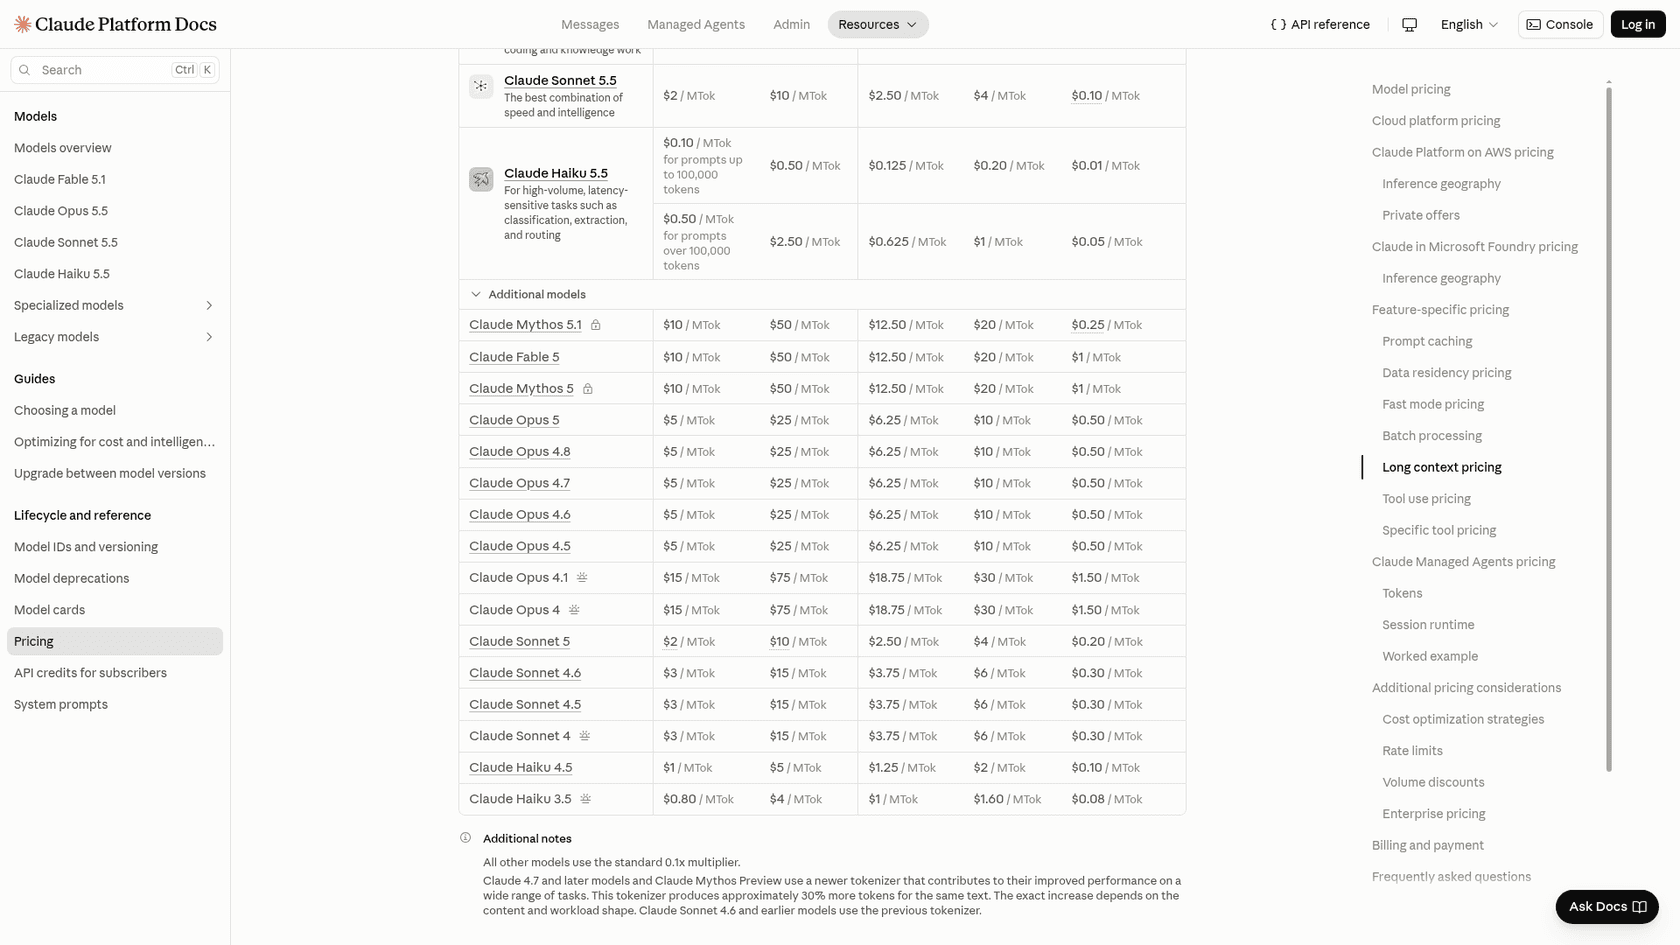
Einiges steht nicht in der Tabelle, das ist erwähnenswert. Für Haiku 5.5 gibt es keinen Fast Mode (er gilt nur für Opus-Modelle), und laut Migrationsleitfaden wird auch Priority Tier nicht unterstützt. Inferenz nur in den USA kostet bei jeder Token-Kategorie das 1,1-Fache, genau wie bei anderen Claude-Modellen ab 4.6. Das Gesamtbild über alle Anthropic-Modelle findest du in meinem Leitfaden zu Anthropic API pricing.
Die 100k-Grenze gilt pro Anfrage, und Caching bringt dich nicht darunter
Jedes andere aktuelle Claude-Modell enthält inzwischen das volle 1M-Kontextfenster zu einem einzigen Preis. Die Preisseite sagt das recht direkt: Claude-Modelle ab 4.6 „(except Claude Haiku 5.5)“ berechnen eine Anfrage mit 900k Tokens zum selben Preis pro Token wie eine mit 9k. Haiku 5.5 ist hier die Ausnahme, und die Dokumentation nennt drei Regeln, die über deine Rechnung entscheiden.
- Die Prompt-Länge zählt jedes Input-Token. Also Cache-Reads und auch Cache-Writes, nicht nur der frische Text.
- Jede Anfrage wird für sich bepreist. Eine lange Anfrage schiebt deine anderen Anfragen nicht in eine höhere Stufe, und frühere Anfragen behalten den Preis, zu dem sie abgerechnet wurden.
- Eine Anfrage über der Grenze zahlt für alles die höheren Preise. Input und Output wechseln zum 5-fachen Tarif, und der Cache ebenso, selbst wenn der größte Teil des Prompts ein Cache-Treffer ist.
Die dritte Regel übersehen die meisten. Caching versteckt keine Tokens vor dem Zähler. Wenn dein Agent 120.000 Tokens Verlauf in eine Anfrage zieht, zahlt er 0,05 $ pro Million für den gecachten Teil statt 0,01 $, dann 2,50 $ pro Million für seinen Output statt 0,50 $.
So wirkt sich das auf eine einzelne Anfrage aus. Ein Prompt mit 90k Tokens und 1.000 Output-Tokens kostet 0,0095 $. Füge 20.000 Prompt-Tokens hinzu, und dieselbe Anfrage kostet 0,0575 $.
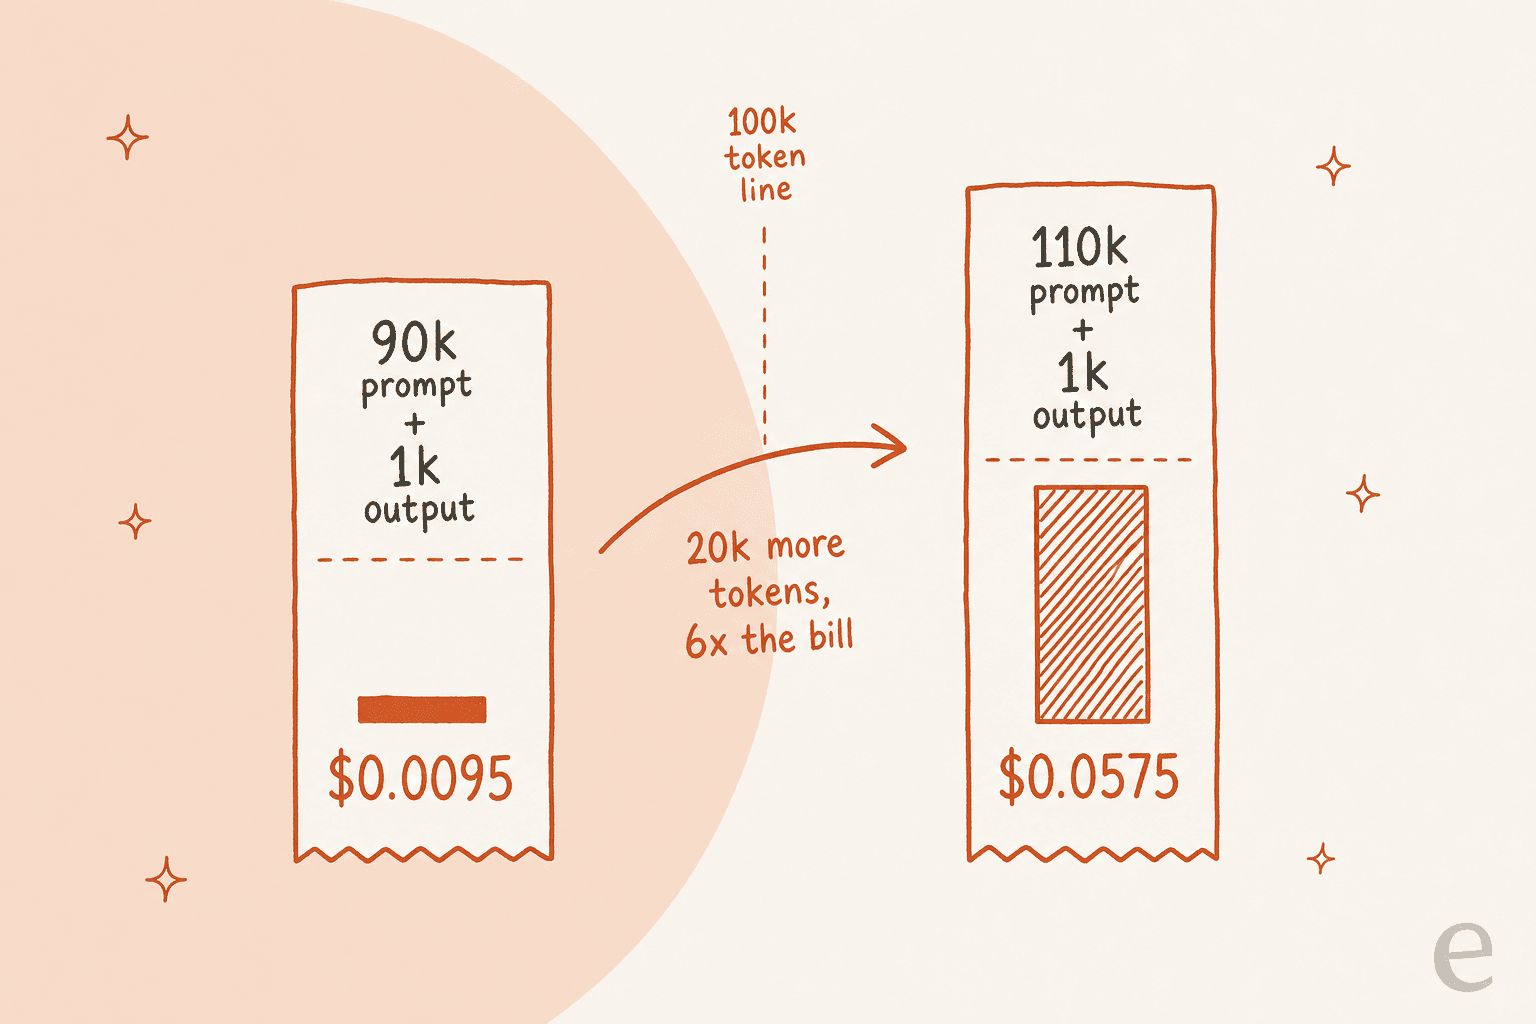
20k zusätzliche Tokens machen eine Anfrage also etwa 6-mal teurer. Nicht 22 % teurer, was man allein aufgrund der Token-Zahl erwarten würde. Der Hacker-News-Thread zum Launch griff das schon nach wenigen Minuten auf:
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value and as noted in this article, that is apparently the vast majority of Haiku use."

Den Teil mit der „großen Mehrheit“ liefert Anthropic selbst. Im Launch-Beitrag steht, dass Prompts bis 100.000 Tokens rund 90 % der Anfragen an Haiku 4.5 ausmachten. Wenn dein Traffic so aussieht, greift die Grenze selten, aber bei Agents solltest du sie zuerst messen.
Deine Tokens sind etwa 30 % größer geworden
Der zweite versteckte Kostenfaktor steckt im Tokenizer. Auf der Seite What's new von Anthropic steht, dass derselbe Eingabetext bei Haiku 5.5 rund 30 % mehr Tokens erzeugt als bei Haiku 4.5. Simon Willison hat einen langen Prompt mit seinem Claude Token Counter gemessen und kam auf etwa das 1,25-Fache, was er „a hidden price increase“ nannte.
Das verändert den Headline-Rabatt ziemlich stark. Pro Wort Text statt pro Token:
| Vergleich mit Haiku 4.5 | Senkung des Listenpreises | Senkung pro Wort, bei 1,3x Tokens |
|---|---|---|
| Prompts bis 100k Tokens | 90 % | etwa 87 % |
| Prompts über 100k Tokens | 50 % | etwa 35 % |
Es verschiebt auch die Grenze selbst. Nach meiner Rechnung passt in 100.000 Haiku-5.5-Tokens ungefähr der Text, der bei Haiku 4.5 77.000 Tokens waren. Jeder Haiku-4.5-Prompt über etwa 77k Tokens landet nach der Migration über der Grenze, und der Migrationsleitfaden rät genau deshalb, Prompts mit model auf claude-haiku-5-5 neu zu zählen.
Der Abstand zu OpenAI ist noch größer. Ein Kommentator schätzte, dass 100K Claude-Tokens etwa „~60-65K modern GPT tokens“ entsprechen, dasselbe Dokument erreicht also Haikus Grenze lange bevor es die 272k-Grenze von GPT-6 Luna erreicht. Anthropics eigene Nettozahl, die den Tokenizer schon einrechnet, lautet, dass Haiku 5.5 im Schnitt „around 75% less to run“ kostet als Haiku 4.5. Das ist die ehrliche Zahl zum Planen, nicht die 90 %. Haiku 4.5 ist auf der Deprecations-Seite weiterhin als aktiv gelistet, die Abschaltung erfolgt frühestens am 15. Oktober 2026, du hast also Zeit zu messen, bevor du wechselst. Wenn du es in Claude Code nutzt, behandelt mein Leitfaden zu Claude Code Haiku den Wechsel.
Der Aufwand ist der andere Preisregler
Haiku 5.5 ist das erste Haiku mit einer Effort-Einstellung, und der API-Standard ist medium. Thinking-Tokens werden als Output berechnet, und über high lässt sich das Denken nicht mehr ganz abschalten, der Aufwand entscheidet also, wie viele dieser 0,50-$-Output-Tokens du pro Antwort kaufst.
Artificial Analysis hat seinen Intelligence Index auf jeder Stufe laufen lassen. Die Kosten des gesamten Laufs zeigen die Spreizung am deutlichsten:
| Effort | Intelligence Index | Kosten für den Index-Lauf | Genutzte Output-Tokens |
|---|---|---|---|
| Low | 29,4 | 34,31 $ | 32M |
| Medium (API-Standard) | 34,5 | 56,36 $ | 54M |
| High | 37,8 | 94,07 $ | 97M |
| Xhigh | 41,2 | 157,58 $ | 180M |
| Max | 43,4 | 330,25 $ | 440M |
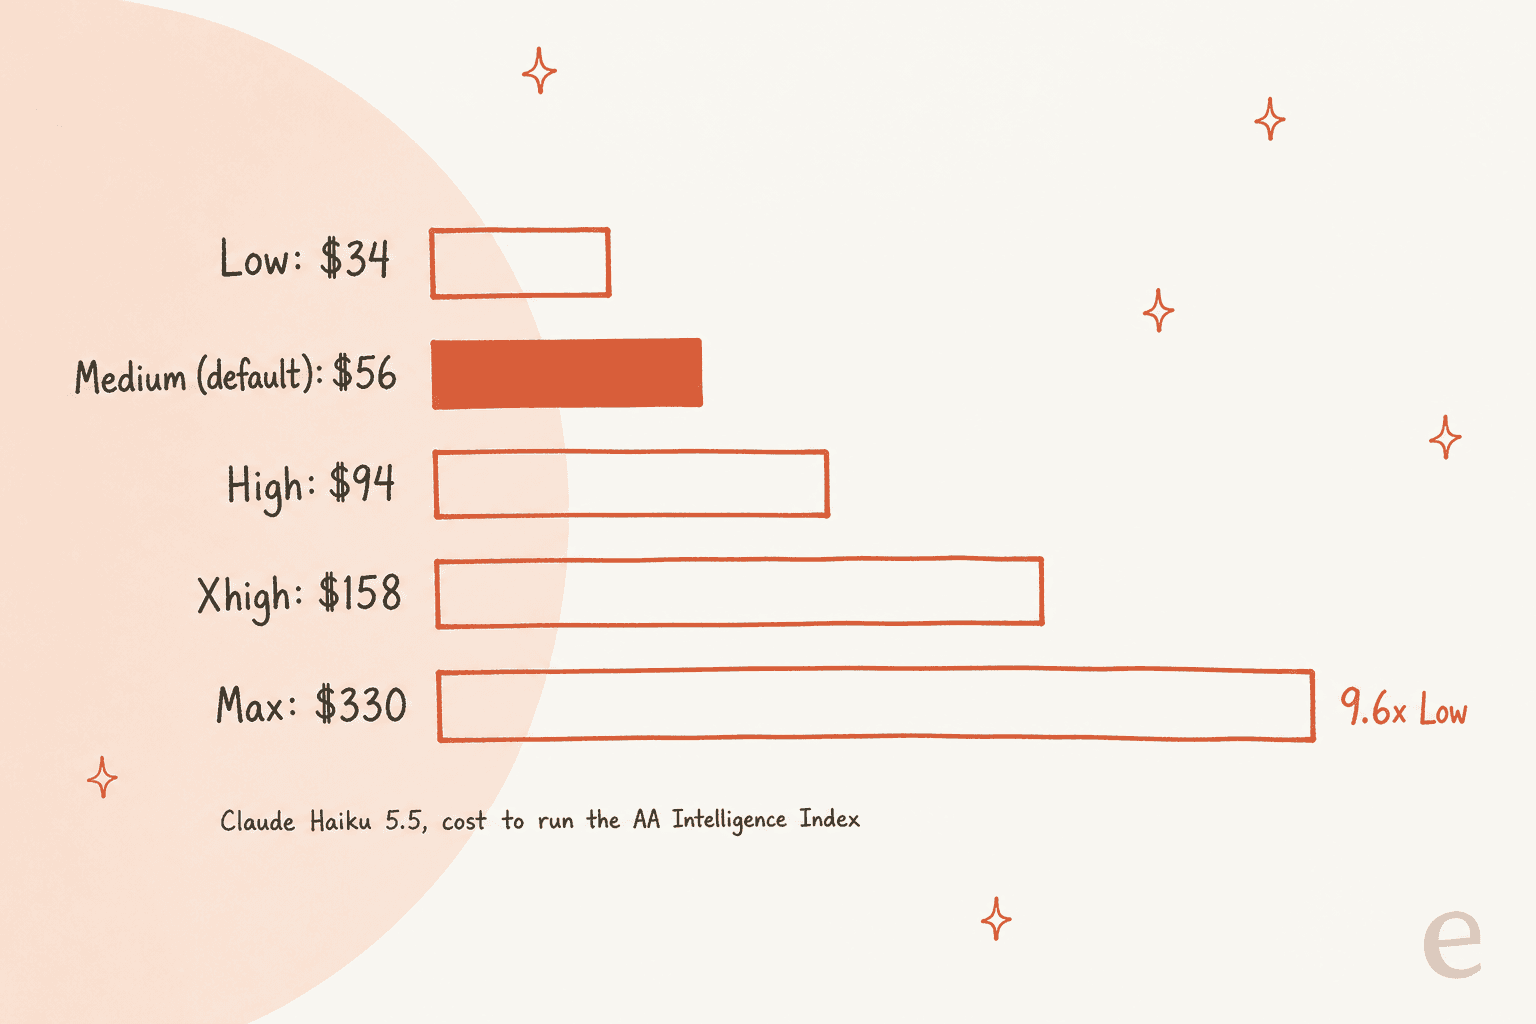
Max kostet das 9,6-Fache von Low für dieselben Aufgaben, für einen Zugewinn von 14 Punkten auf dem Index. AA maß bei Max etwa 162k Output-Tokens pro Aufgabe und nannte das Modell „very verbose“. Zum Listenpreis ergibt das 0,21 $ pro Aufgabe bei Max, wobei diese Zahlen den Tarif unter 100k nutzen, da AA anmerkt, dass die gestaffelte Preisgestaltung noch nicht abgebildet ist.
Ein kleinerer Test zeigt dasselbe Muster. Simon Willison hat seinen üblichen Pelikan auf jeder Stufe gezeichnet: Low kostete 0,0936 Cent und dauerte 7 Sekunden, Max dagegen 5 Minuten 9 Sekunden und kostete 3,3826 Cent. Ab Medium war der Fahrradrahmen richtig.
Meine Haltung ist einfach. Für Ticket-Tagging und Routing oder kurze Zusammenfassungen beginnst du bei Low und gehst erst höher, wenn ein Testset Genauigkeitsverluste zeigt. Für eine Antwort, die eine Richtlinie durchdenken muss, ist Medium nicht ohne Grund der Standard. Max würde ich bei Haiku selten bezahlen.
Ein HN-Kommentator las die AA-Zahlen so, dass Haiku bei Max pro Aufgabe etwa so viel kostet wie GPT-6.1 Sol bei Medium, ein deutlich stärkeres Modell. Dann ist es besser, auf Sonnet 5.5 mit geringerem Aufwand umzusteigen. Mein Leitfaden zur Modellauswahl erklärt, wann sich der Umstieg lohnt.
Was ein Support-Team tatsächlich zahlt
Support-Triage ist der Workload, den Anthropics Launch-Beitrag direkt nennt, mit Klassifizierung und Routing sowie „live customer support“. Hier habe ich auch gesehen, dass das günstigste Modell die nützlichste Arbeit leistet. In einem eesel-Test mit echtem Zendesk-Traffic aus einem E-Commerce-Postfach mit etwa 1.000 Tickets im Monat waren 22 % der eingehenden Tickets Spam, und der Triage-Durchlauf erreichte 93 % Genauigkeit mit 100 % Spam-Erkennung und null Fehlalarmen. Das ist eine Aufgabe, die ein kleines Modell übernehmen sollte, und sie braucht keine langen Prompts. Meine Übersicht der besten KI für Ticket-Triage behandelt die Tools dafür, und der Leitfaden zu den Kosten von KI im Kundenservice stellt die Modellrechnung neben das übrige Budget.
Hier zwei Workloads bei 20.000 Tickets im Monat, jeweils aus der Preisliste berechnet. Die Token-Zahlen sind Annahmen, setze im Rechner unten deine eigenen ein. Cache-Writes sind weggelassen, da ein warmer Cache dafür wenig ausgibt.
Ticket-Tagging und Routing (unter der Grenze)
Jede Anfrage enthält einen System-Prompt mit 2.500 Tokens samt Tag-Liste plus ein Ticket mit 1.500 Tokens und liefert etwa 400 Tokens mit Label und kurzer Begründung zurück.
| Setup | Pro Ticket | Pro Monat (20.000 Tickets) |
|---|---|---|
| Haiku 5.5, ohne Caching | 0,0006 $ | 12,00 $ |
| Haiku 5.5, System-Prompt gecacht | 0,000375 $ | 7,50 $ |
| Haiku 5.5, gecacht plus Batch | etwa 0,00019 $ | etwa 3,75 $ |
| Haiku 4.5, gleicher Text (weniger Tokens) | 0,0046 $ | 92 $ |
| Sonnet 5.5, ohne Caching | 0,012 $ | 240 $ |
Bei dieser Größe ist die Modellrechnung praktisch ein Rundungsfehler. Geld kostet alles drumherum, etwa die Anbindung an den Helpdesk, das Schreiben der Tag-Regeln und das Prüfen der falschen Labels. Die Leitfäden zu KI-Ticket-Klassifizierung, Ticket-Routing und Claude mit deinem Helpdesk verbinden decken diese Seite ab.
Antworten entwerfen mit Wissensdatenbank-Kontext (über der Grenze)
Jetzt ein Antwort-Bot. Jede Anfrage lädt 80.000 Tokens Hilfecenter-Artikel und Makros, die zwischen Tickets gleich bleiben, plus 40.000 Tokens Ticketverlauf und Bestelldaten und schreibt eine Antwort mit 2.000 Tokens samt Thinking. Das sind 120k Tokens Prompt, also über der Grenze.
| Setup | Pro Ticket | Pro Monat (20.000 Tickets) |
|---|---|---|
| Haiku 5.5, 120k-Prompt, ohne Caching | 0,065 $ | 1.300 $ |
| Haiku 5.5, 120k-Prompt, 80k gecacht | 0,029 $ | 580 $ |
| Haiku 5.5, auf 95k gekürzt, ohne Caching | 0,0105 $ | 210 $ |
| Haiku 5.5, auf 95k gekürzt, 80k gecacht | 0,0033 $ | 66 $ |
| Sonnet 5.5, 120k-Prompt, 80k gecacht | 0,108 $ | 2.160 $ |
| GPT-6 Luna, 120k-Prompt, 80k gecacht | 0,0058 $ | 116 $ |
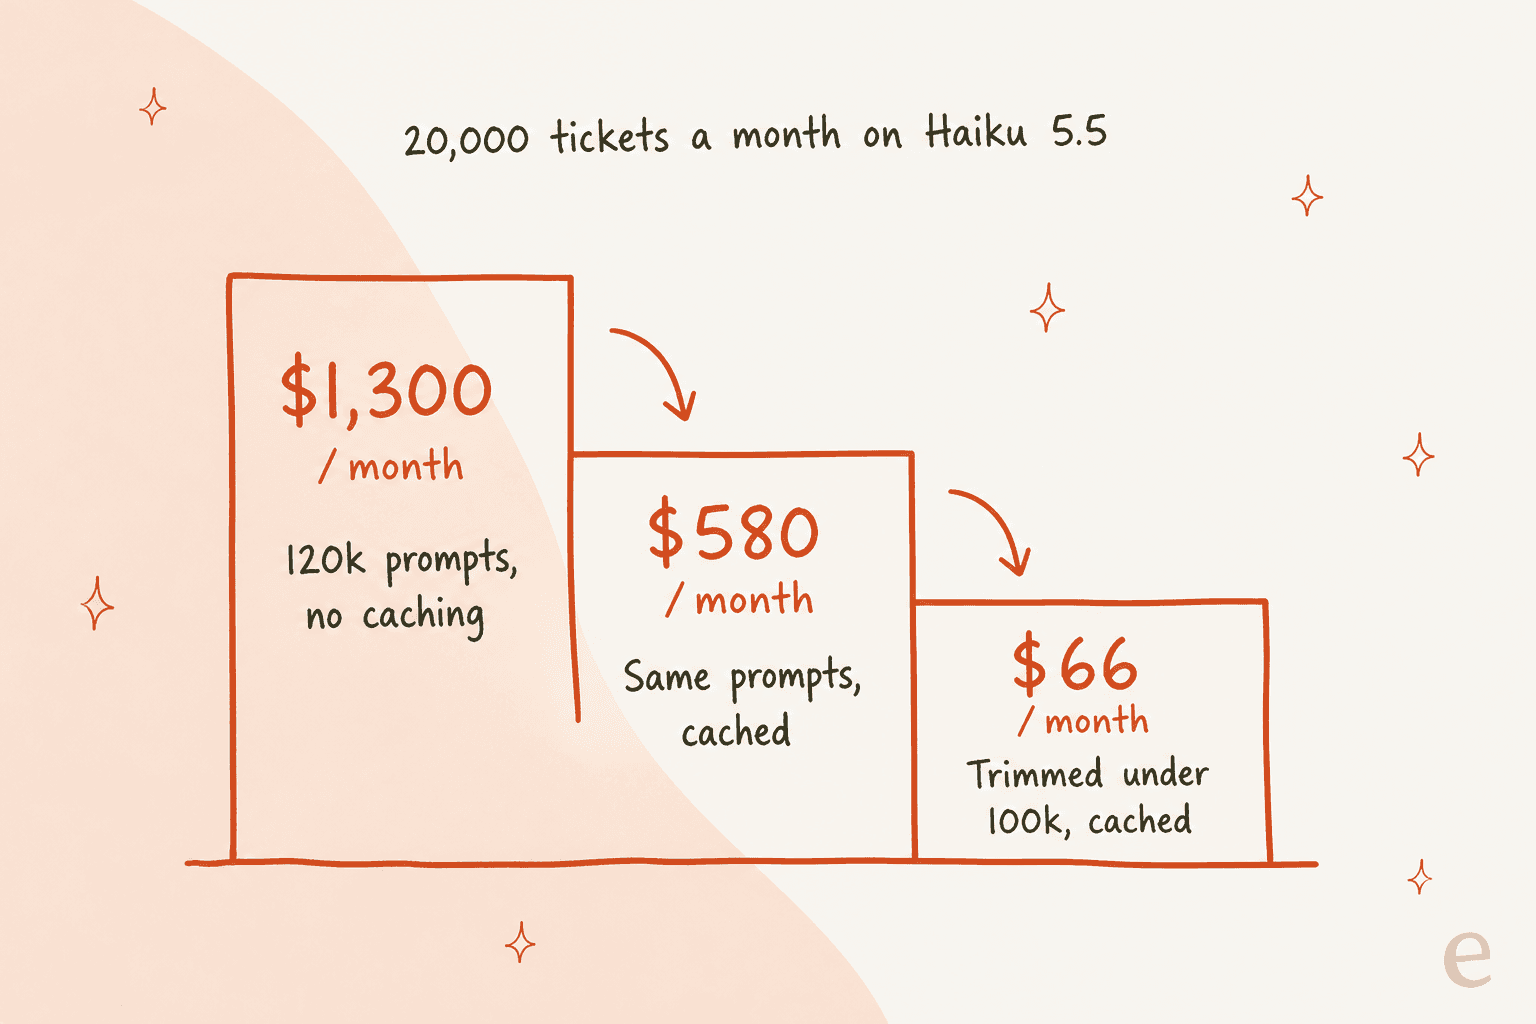
Caching allein senkt die Rechnung um mehr als die Hälfte. 25k Tokens Prompt zu kürzen senkt sie noch einmal um das 9-Fache, von 580 $ auf 66 $. Das Kürzen ist meist einfach Retrieval, das seinen Job macht: die fünf relevantesten Hilfeartikel ziehen statt einer ganzen Kategorie und alten Ticketverlauf zusammenfassen, statt ihn einzufügen. Haiku ist selbst gut in diesem Zusammenfassungsschritt, zum günstigen Tarif.
Die Luna-Zeile nutzt dieselben Token-Zahlen, was Claude schmeichelt, da OpenAI für denselben Text weniger Tokens zählt. Lunas Preis steigt erst ab 272k Tokens, bei diesem Muster bleibt es also deutlich unter Haiku. Mehr dazu im Vergleich unten und in meiner Aufschlüsselung zu GPT-6 Luna pricing.
Schätze deine eigene Haiku-5.5-Rechnung
Wähle ein Preset oder gib eigene Zahlen ein. Der Balken zeigt, wo dein Prompt im Verhältnis zur 100k-Grenze liegt, die Zeilen vergleichen denselben Workload auf Haiku 4.5 und Sonnet 5.5, mit GPT-6 Luna ebenfalls dabei.
Zwei Dinge zum Ausprobieren. Setze den Prompt im Reply-Preset erst auf 99.000 und dann auf 101.000 und sieh zu, wie der Monatswert springt. Schalte dann Batch ein, das jede Zeile halbiert, aber nur für Arbeit passt, die bis zu 24 Stunden warten kann, etwa nächtliches Tagging eines Rückstands oder wöchentliche Ticket-Zusammenfassungen.
Batch, Caching und die kleineren Posten
Diese Hebel kommen laut Preisdokumentation zum Grundpreis dazu:
| Hebel | Was er bei Haiku 5.5 bewirkt | Worauf du achten solltest |
|---|---|---|
| Batch API | 50 % Rabatt auf Input und Output, beide Stufen | Asynchron, also nicht für Live-Chat |
| 5-Minuten-Cache-Write | 1,25x Input, rentiert sich nach einem Cache-Read | Cache läuft ab, wenn wenig Traffic anfällt |
| 1-Stunden-Cache-Write | 2x Input, rentiert sich nach zwei Cache-Reads | Lohnt sich bei stetigem Tagestraffic |
| Cache-Read | 0,1x Input (0,01 $ oder 0,05 $) | Zählt weiterhin zur 100k-Grenze |
| Inferenz nur in den USA | 1,1x bei jeder Token-Kategorie | Globales Routing ist der Standard |
| Tool-Use-System-Prompt | 286 zusätzliche Input-Tokens (auto, none) | Runter von 496 bei Haiku 4.5 |
| Websuche | 10 $ pro 1.000 Suchen, plus Tokens | Ergebnisse erhöhen die Input-Tokens |
| Browser-Use-Toolset | Etwa 6.600 Input-Tokens pro Anfrage | Screenshots werden als Bild-Input berechnet |
Die Modifikatoren multiplizieren sich, ein gecachter Read in einem Batch-Job kostet also die Hälfte des Cache-Preises. Bei einem so günstigen Modell zählt der Tool-Overhead mehr, als man denkt. Ein Browser-Use-Agent startet jede Anfrage etwa 6.600 Tokens näher an der Grenze, bevor er auch nur eine Seite gelesen hat.
Haiku 5.5 im Vergleich mit Haiku 4.5, Sonnet 5.5 und den günstigen Konkurrenten
Der Preis pro Token ist nur die halbe Wahrheit. Tokenizer unterscheiden sich, ebenso wie viel jedes Modell pro Aufgabe schreibt. Diese Tabelle stellt die Listenpreise neben die Kosten pro Aufgabe des Intelligence Index von AA, die die Ausführlichkeit einrechnen:
| Modell | Input / Output pro 1M | Preissprung | AA-Kosten pro Aufgabe |
|---|---|---|---|
| Claude Haiku 5.5 | 0,10 $ / 0,50 $ | 5x ab 100k Prompt | 0,21 $ (Max) |
| GPT-6 Luna | 0,10 $ / 0,50 $ | 2x Input, 1,5x Output ab 272k | 0,07 $ (Max) |
| Gemini 3.5 Flash-Lite | 0,30 $ / 2,50 $ | Keiner angegeben | 0,19 $ |
| GLM-5.3 Flash | 0,15 $ / 0,50 $ | Keiner angegeben | 0,25 $ |
| DeepSeek V4.1 Flash | 0,15 $ bis 0,30 $ / 0,60 $ bis 1,20 $ | Spitzenzeiten kosten das 2-Fache | Nicht gemessen |
| Claude Haiku 4.5 | 1 $ / 5 $ | 200k Kontextlimit | Nicht gemessen |
| Claude Sonnet 5.5 | 2 $ / 10 $ | Einheitlich bis 1M | Nicht gemessen |
Die Preise stammen von der jeweiligen Preisseite des Anbieters, und die vollständige OpenAI-Preisliste steht in meinem Leitfaden zu OpenAI API pricing.
Wenn dich Gemini 3.8 Flash reizt, bedenke, dass sich sein Preis laut Googles Preisseite am 1. Januar 2027 verdoppelt.
Der sauberste Praxisvergleich, den ich finden konnte, kam von einem Entwickler, der denselben Klassifizierungsjob auf beiden laufen ließ:
"I compared the costs between luna and haiku for some classification work. Luna comes out a fair amount cheaper due to more efficient tokenization and less outputs."
Seine Zahlen: Haiku 5.5 verbrauchte 11.893.643 Input-Tokens und kostete synchron 0,42 $, GPT-6 Luna verbrauchte für dieselbe Arbeit 7.903.468 Input-Tokens und kostete 0,31 $. Gleicher Listenpreis, doch Haikus Rechnung fiel 35 % höher aus. Der Data-Analytics-Benchmark von Plotly erzählte Ähnliches, Luna schnitt „a bit better“ ab bei etwa 30 % von Haikus Kosten.
Warum also mehr für Haiku zahlen? Tempo, und in einigen Tests auch Qualität. AA maß je nach Effort-Stufe 137 bis 243 Output-Tokens pro Sekunde, und ein Kommentator berichtete von etwa doppeltem Durchsatz gegenüber Luna auf OpenRouter. Anthropic nennt es sein schnellstes Modell bei Standardgeschwindigkeit, weshalb es Live-Kundensupport als passenden Einsatz nennt. Ein langsamer Bot kostet dich mehr an Zeit menschlicher Agenten als jede Token-Zeile. Mein Beitrag zu Haiku-5.5-Alternativen geht tiefer darauf ein, wann du wechseln solltest, und der Dreifach-API-Vergleich zeigt, wie du einen Anbieter auswählst.
Gegenüber Anthropics eigenen Modellen zählt der Schritt nach oben mehr. Sonnet 5.5 kostet das 20-Fache des Inputpreises von Haiku mit kurzen Prompts, aber nur das 4-Fache von Haiku über der Grenze, und es hat gar keine Grenze. Wenn die meisten deiner Anfragen zwischen 100k und 400k Tokens liegen, lass beide durch den Rechner oben laufen, bevor du annimmst, dass Haiku gewinnt. Die Aufschlüsselung zu Sonnet 5.5 pricing (und das ältere Sonnet 5 pricing) behandelt auch die Senkung des Cache-Read am selben Tag von 0,20 $ auf 0,10 $, die Sonnet 5.5 laut Anthropic bei den meisten agentischen Aufgaben etwa 20 % günstiger macht.
Haiku 5.5 im Claude-Tarif oder mit API-Guthaben nutzen
Wenn du nur mit Haiku chatten willst, zahlst du gar nicht pro Token, und mein Leitfaden zu Claude pricing vergleicht die Tarife im Detail. Die Claude-Tarifseite listet Haiku in Free, Pro, Max und Team. Pro kostet 17 $ im Monat bei jährlicher Abrechnung (20 $ monatlich), Max beginnt bei 100 $, und die Team-Plätze kosten 20 $ Standard oder 100 $ Premium pro Platz bei jährlicher Abrechnung.
Neu sind die API-Guthaben. Zusammen mit Haiku 5.5 begann Anthropic, Max- und Team-Abonnenten ein monatliches Guthaben für die Claude Platform zu geben:
| Tarif | Monatliches API-Guthaben |
|---|---|
| Max 5x | 100 $ |
| Max 20x | 200 $ |
| Team, Standard-Platz | 20 $ pro Platz |
| Team, Premium-Platz | 100 $ pro Platz |
| Team-Pool-Obergrenze | 500 $ pro Monat |
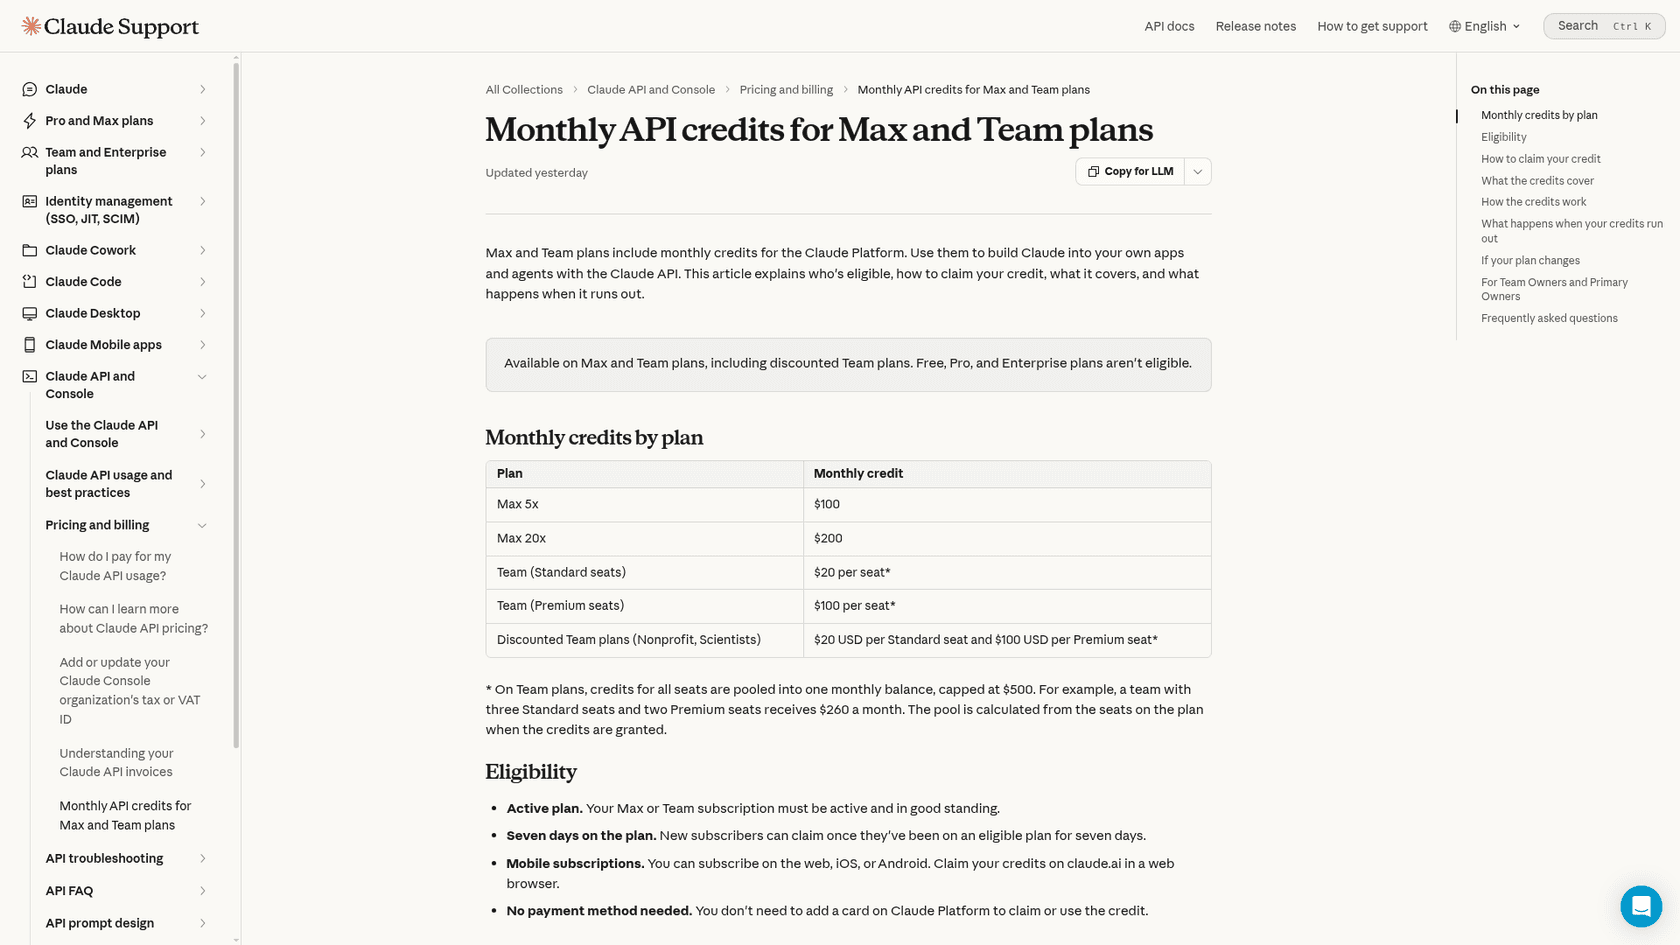
Der Hilfeartikel nennt die Regeln. Free, Pro und Enterprise sind nicht berechtigt, und du musst sieben Tage im Tarif sein. Guthaben verfallen am Monatsende, das solltest du im Kopf behalten, und sie decken die API plus Batches, Managed Agents und das Agent SDK ab, außerdem claude -p mit einem API-Key. Sie decken weder das interaktive Claude Code noch die Nutzung auf Bedrock, Vertex AI oder Foundry ab.
Bei Haiku 5.5 reicht dieses Guthaben weit. Nach meiner Rechnung kauft man für 100 $ etwa 1 Milliarde Input-Tokens mit kurzen Prompts oder 200 Millionen Output-Tokens im Monat. Der gecachte Tagging-Workload von oben würde mit dem Guthaben eines Monats Max 5x etwa ein Jahr laufen. Ein Nebenprojekt oder internes Tool kann komplett im Guthaben leben, solange es unter der Grenze bleibt.
Was Entwickler zum Preis sagen
Der Launch-Thread teilte sich an einer Frage: Passt deine Arbeit in 100k Tokens?
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."
Die andere Seite sieht die Grenze als fairen Tausch für Subagent-Arbeit:
"I would mostly use Haiku in task or explorer subagents. I'm not saying I stay under that on every task, but I do have quite a few sessions that cap out well below that, so that price difference would be very meaningful."
Und ein Kommentator verstand die ganze Struktur eher als Preismanöver denn als technisches Limit:
"I'd consider the 100k a "promotional price" to match Luna's token pricing while delivering noticeably more intelligence."
Das Letzte ist Spekulation, und Anthropic hat nicht gesagt, dass es sich ändern wird. Dennoch ist es ein guter Grund, kein Kostenmodell zu bauen, das nur funktioniert, wenn Haiku bei Prompts jeder Größe 0,10 $ kostet.
Lohnt sich Claude Haiku 5.5 bei diesem Preis?
Für kurze Jobs mit hohem Volumen: ja, eindeutig. Klassifizierung und Tagging, Routing, Extraktion, kurze Zusammenfassungen: Das passt alles unter 100k Tokens, kostet Cents pro tausend Aufrufe und läuft obendrein schnell. Von Haiku 4.5 kommend ist es die einfachste Kostensenkung im Claude-Lineup, etwa 87 % pro Wort Text. Wenn du Claude für Zendesk oder ein selbstgebautes Triage-Skript nutzt, ist das das Modell, das du zuerst umstellen solltest. Der Leitfaden zu Claude für den Kundensupport enthält das Setup.
Bei Agents mit langem Kontext ist es knapper. Über der Grenze kostet Haiku pro Token ein Viertel von Sonnet 5.5, ohne Obergrenze dafür, wie oft du sie überschreitest, und GPT-6 Luna bleibt bis 272k günstiger. Miss deine Prompt-Größen, bevor du migrierst, und gestalte das Retrieval dann nach Möglichkeit so, dass du unter der Grenze bleibst.
Das vollständige Qualitätsbild steht in meinem Haiku 5.5 Review, wo der HN-Thread auch Entwickler enthält, die bei eigenen Evals Rückschritte gegenüber Haiku 4.5 melden. Ein günstigeres Modell, das Prompt-Überarbeitung braucht, ist erst günstiger, wenn die Überarbeitung erledigt ist.
Übergib die Triage-Warteschlange lieber eesel
Wenn du Haiku 5.5 wegen deiner Support-Warteschlange bepreist, ist die Token-Rechnung der kleinste Teil der Arbeit, ein Punkt, den meine Aufschlüsselung zu Kosteneinsparungen im KI-Support mit echten Zahlen belegt. Du brauchst trotzdem die Helpdesk-Integration und die Tag-Regeln, dann eine Möglichkeit, an vergangenen Tickets zu testen, und jemanden, der beobachtet, was falsch läuft. Diese Arbeit nimmt dir eesel ab.
Das KI-Helpdesk-Teammate von eesel kommt in den Helpdesk, den du schon hast, etwa Zendesk, Freshdesk oder Gorgias, lernt aus deinen vergangenen Tickets, taggt und routet dann Tickets, entwirft Antworten oder beantwortet sie.
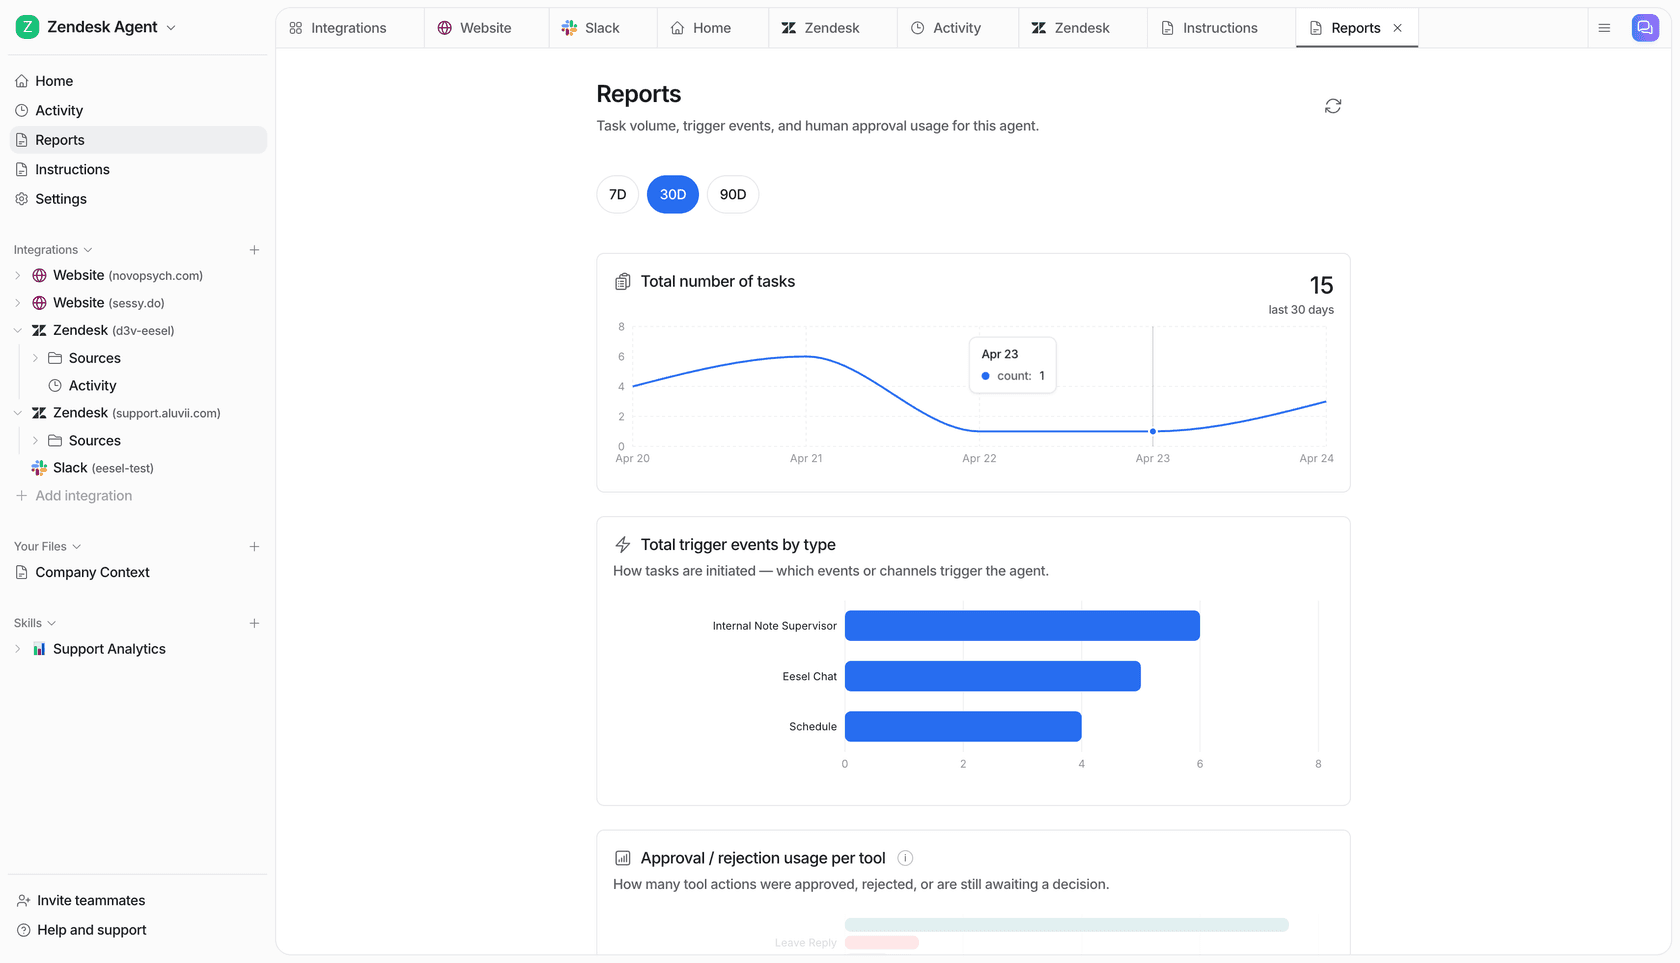
Bevor es einen echten Kunden berührt, würde ich es gegen deine historischen Tickets laufen lassen, und diese Simulation ist eingebaut. Was es tut, kannst du in der Berichtsansicht verfolgen:
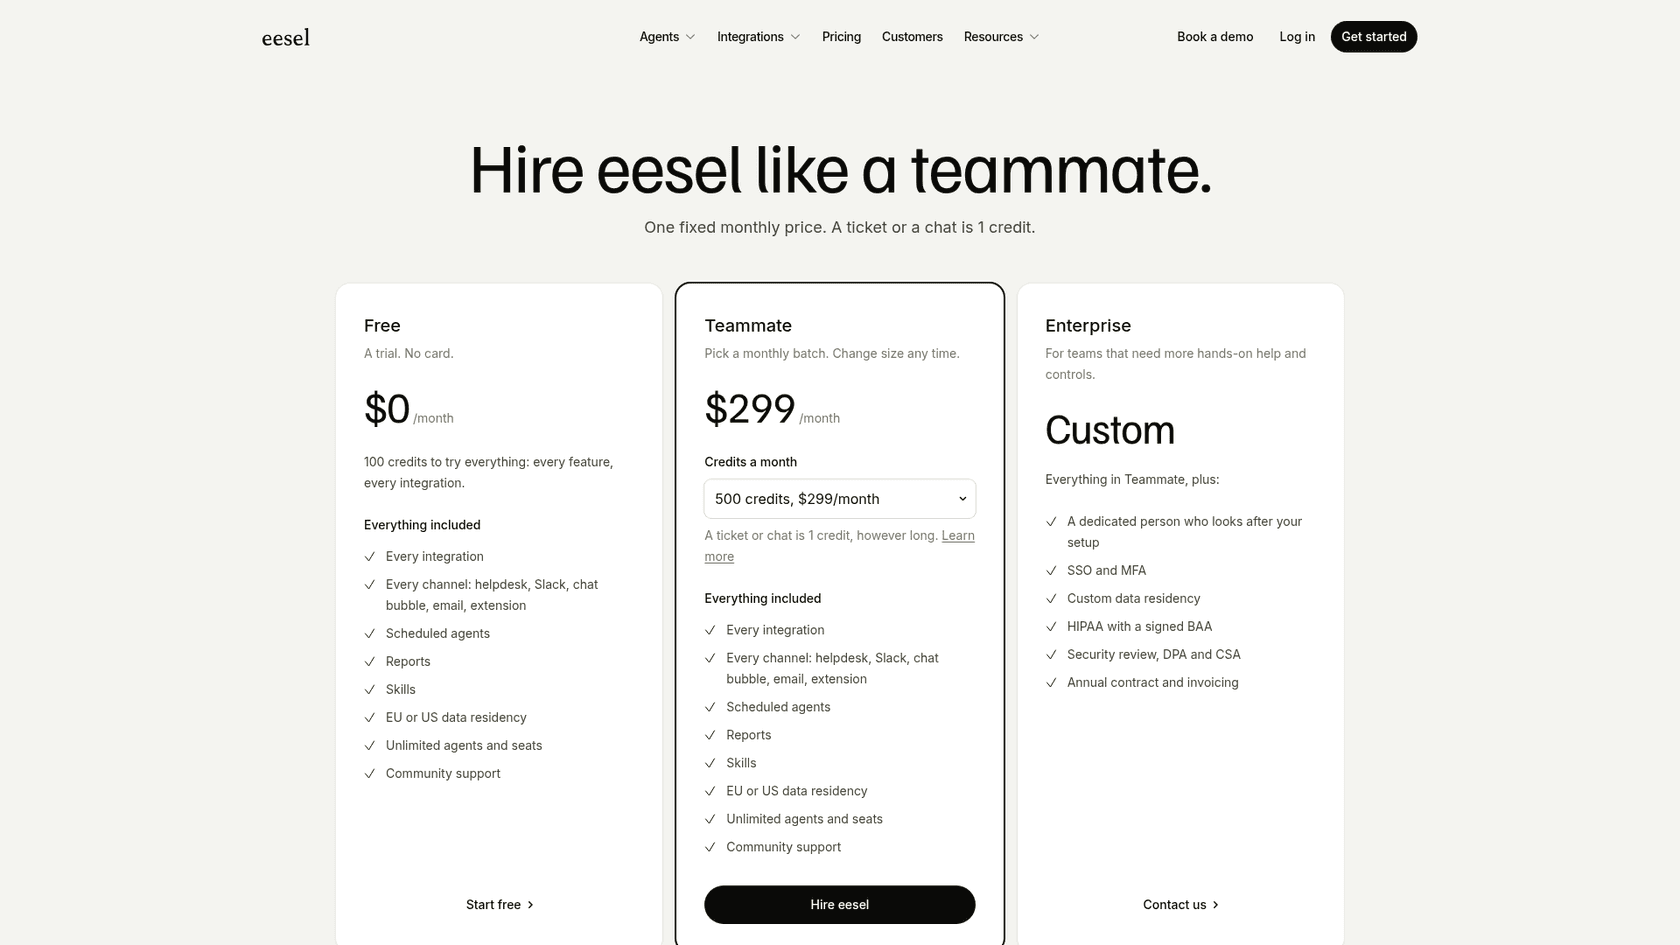
Die Preisgestaltung ist das Gegenteil eines Token-Zählers. Ein Ticket oder Chat ist ein Credit, egal wie lange er läuft, ein Thread mit 120k Tokens kostet also dasselbe wie eine Frage mit zwei Zeilen. Tarife beginnen bei 299 $ im Monat für 500 Credits und reichen bis 1.749 $ für 5.000, mit einer kostenlosen Testphase von 100 Credits und ohne Karte. Planbarkeit zählt mehr, als es klingt. Ein eesel-Testnutzer auf Gorgias sah seinem Agent bei 12 Test-Chats zu, die gut liefen, und bat dann um Kündigung, sobald er die Abrechnungsseite erreichte. Vergleiche das mit nutzungsbasierten Tools wie Zendesk AI pricing, wo sich die Rechnung mit jeder Lösung bewegt.
Um ehrlich zur Passung zu sein: Wenn du nur ein Tagging-Skript brauchst und Ingenieure hast, ist die rohe Haiku-5.5-API mit 12 $ im Monat günstiger, und du solltest sie nutzen. eesel lohnt sich, wenn du das ganze Teammate willst, von der Triage bis zu den Antworten, ohne die Pipeline selbst zu bauen. Wenn du den Support lieber über die Kommandozeile automatisieren möchtest, steuert die eesel CLI dasselbe Teammate, sodass du oder ein Coding-Agent seine Anweisungen und Freigaben sowie das Aktivitätsprotokoll skripten könnt. Teste eesel kostenlos an einem Ausschnitt deiner echten Tickets und sieh dir die Triage an, bevor du eine Zeile Code schreibst.