As 10 melhores alternativas ao GPT-6.2 Astra em 2026, com preço por tarefa

Kurnia Kharisma

Katelin Teen
Última edição 17 de novembro de 2026
A melhor alternativa ao GPT-6.2 Astra para a maioria das equipes é o próprio GPT-6.2 Sol da OpenAI: ele obtém 57 contra os 62 do Astra no Artificial Analysis, por cerca de um quarto do custo por tarefa. Só o Claude Fable 5.2 pontua mais alto (65), a 6,6 vezes o custo por tarefa do Astra. A armadilha é o preço de tabela: o Claude Opus 5.5 cobra a metade da taxa por token do Astra, mas custou 2,5 vezes mais por tarefa de referência no esforço máximo. Julgue as alternativas pelo custo por tarefa concluída, e roteie em vez de trocar. Para uma fila de suporte, o conhecimento e as regras de escalonamento em torno do modelo importam mais, que é exatamente o que o colega de IA da eesel para o helpdesk traz.
Por que as equipes estão olhando além do GPT-6.2 Astra?
O GPT-6.2 Astra foi lançado em 17 de novembro de 2026, e é um modelo forte. O Artificial Analysis o coloca em 62 em seu Intelligence Index, atrás apenas do Claude Fable 5.2, e a OpenAI cortou o preço em 20% para $8 por milhão de tokens de entrada e $40 por milhão de saída em sua página de preços da API. A entrada em cache caiu de $1,00 para $0,40. Se seus agentes fazem trabalho difícil de várias etapas, o Astra merece seu lugar.
Então por que procurar em outro lugar? Três razões aparecem repetidamente.
- A maioria das tarefas não precisa dele. No meu próprio teste de 15 tickets de suporte em três níveis de esforço, o GPT-6.2 Sol acertou todos os tickets por cerca de um quarto do custo do Astra. Mais sobre isso abaixo.
- Execuções longas são mais difíceis de ler. Vários testadores conhecidos gostaram do resultado do Astra, mas não gostaram de trabalhar com ele em execuções longas e abertas. Minha análise do GPT-6.2 Astra percorre essas queixas.
- Um único fornecedor é um ponto único de falha. Equipes que constroem produtos com agentes querem um backup testado de um segundo laboratório, para o caso de mudanças de preço, quedas ou limites de taxa.
"I care less about the models being good and more on if I can fallback to them if Opus 5.5 gets a massive price hike after the IPO"

Eu escrevo sobre o que os compradores realmente pesquisam, e a busca aqui é revelador. Quando fiz exatamente essa pergunta ao ChatGPT em um chat novo, ele foi direto aos documentos do modelo e às páginas de preços de cada laboratório, e organizou toda a resposta em torno de um número: custo por tarefa bem-sucedida. Esse é o enquadramento certo, e é o que usei abaixo. Se seus agentes respondem tickets de suporte, o CLI da eesel permite que um agente de código carregue artigos de ajuda aprovados em um colega de equipe eesel e teste suas respostas antes mesmo de escolher qualquer coisa.
Como comparei as alternativas
Avaliei cada modelo em três aspectos, todos verificados em 18 de novembro de 2026.
- Preço de tabela da própria página de preços de cada fornecedor, por milhão de tokens de entrada e saída, mais a taxa de entrada em cache, já que agentes que reenviam um prompt de sistema longo vivem de tokens em cache.
- Inteligência e custo por tarefa do Artificial Analysis, que executa as mesmas nove avaliações em cada modelo e reporta quanto custou cada tarefa concluída na configuração de esforço mais alto daquele modelo. Esse número incorpora quantos tokens um modelo consome, o que o preço de tabela esconde.
- Meu próprio teste de suporte. Repeti o teste de 15 tickets da minha análise do GPT-6.2 Astra no Astra e no Sol com esforço baixo, médio e alto: 90 execuções cobrindo cálculo de reembolso, uma cobrança duplicada, uma injeção de prompt, tickets em espanhol e alemão, uma busca de pedido quebrada e um número de pedido digitado errado. Só tive acesso de API à OpenAI para essa execução, então os outros laboratórios são avaliados com dados de fornecedor e de benchmark.
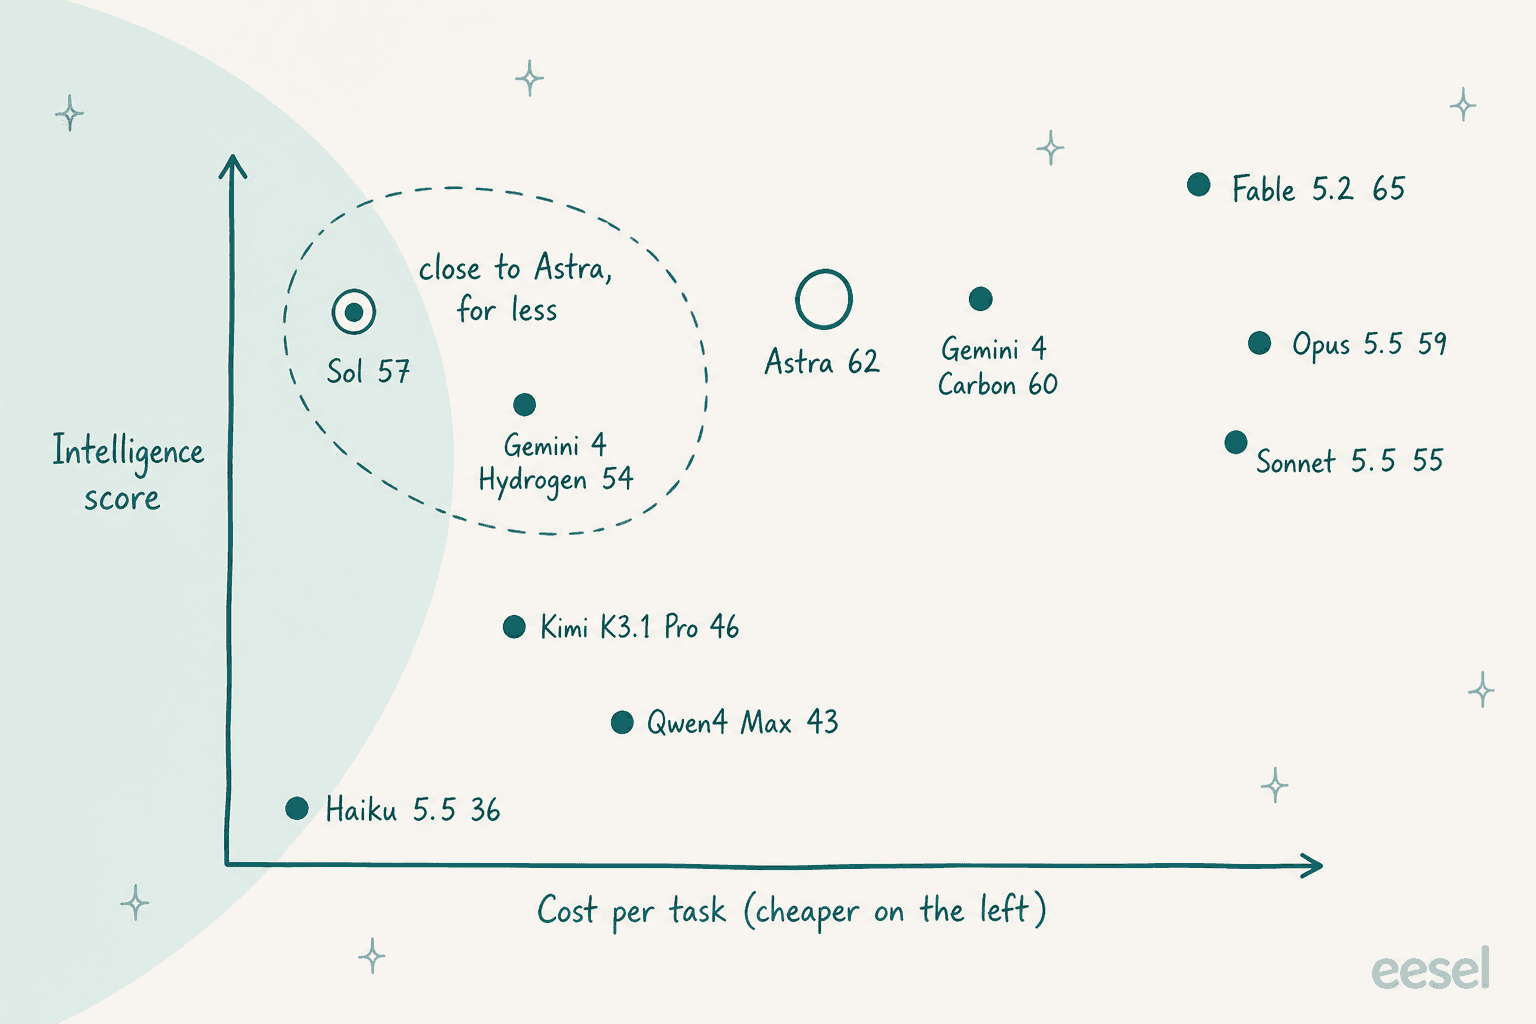
O gráfico é o artigo em uma única imagem. O Astra fica alto e no meio. O Fable 5.2 é o único modelo acima, bem à direita. O Sol fica quase tão alto, bem à esquerda.
Alternativas ao GPT-6.2 Astra em resumo
Os preços são por milhão de tokens em taxas padrão. As pontuações e custos do Artificial Analysis são na configuração de esforço mais alto de cada modelo.
| Modelo | Fabricante | Entrada / saída | Entrada em cache | Contexto | Pontuação AA | Custo AA por tarefa | Tempo por tarefa AA | Melhor para |
|---|---|---|---|---|---|---|---|---|
| GPT-6.2 Astra (referência) | OpenAI | $8 / $40 | $0,40 | 1,05M | 62 | $4,00 | 10,4 min | Trabalho difícil de agentes em várias etapas |
| GPT-6.2 Sol | OpenAI | $2 / $10 | $0,10 | 1,05M | 57 | $1,01 | 7,9 min | A maior parte do tráfego de agentes em produção |
| Claude Opus 5.5 | Anthropic | $4 / $20 | $0,20 | 1M | 59 | $10,04 | 24,6 min | Trabalho longo de código e escrita |
| Claude Fable 5.2 | Anthropic | $8 / $40 | $0,20 | 1M | 65 | $26,54 | 40,8 min | A pontuação mais alta disponível |
| Claude Sonnet 5.5 | Anthropic | $2 / $10 | $0,10 | 1M | 55 | $10,02 | 32,3 min | Anthropic no preço do Sol |
| Gemini 4 Carbon | $2 / $10 até 30 nov., depois $4 / $20 | $0,10, depois $0,20 | 1M | 60 | $5,48 | 33,4 min | Pontuação próxima ao Astra, segundo fornecedor | |
| Gemini 3.8 Flash | $0,75 / $3,75 até 31 dez. | $0,075 | - | 31 | - | 14,1 min | Etapas baratas de alto volume | |
| Grok 4.7 | xAI | $2 / $6 | $0,50 | 500K | 35 | - | 24,5 min | Loops de agentes com saída longa |
| DeepSeek V4 Pro e Flash | DeepSeek | $0,66 / $1,98 (Pro, fora do pico) | $0,022 | 1M | 23 (Pro) | $1,77 (Pro) | 17,3 min | A conta de tokens mais baixa |
| Kimi K3.1 Pro | Moonshot AI | $2 / $10 | $0,20 | 1M | 46 | $3,68 | 38,7 min | Opção não americana no preço do Sol |
| Qwen4 Max | Alibaba (Qwen Cloud) | $1,50 / $4,50 | $0,075 | 1M | 43 | $3,27 | 31,9 min | Preço de saída baixo em grande escala |
Duas linhas para ler antes da lista. O preço do Gemini 4 Carbon dobra em 1º de dezembro, então orce pela taxa posterior. E os preços da DeepSeek dobram nos horários de pico em dias de semana, o que cubro na seção dele.
A metade do preço por token significa a metade da conta?
Não, e é aqui que a maioria das comparações erra. O preço por token de um modelo diz o que custa um token. Não diz quantos tokens o modelo gasta para terminar uma tarefa, nem quanto tempo ele pensa antes.
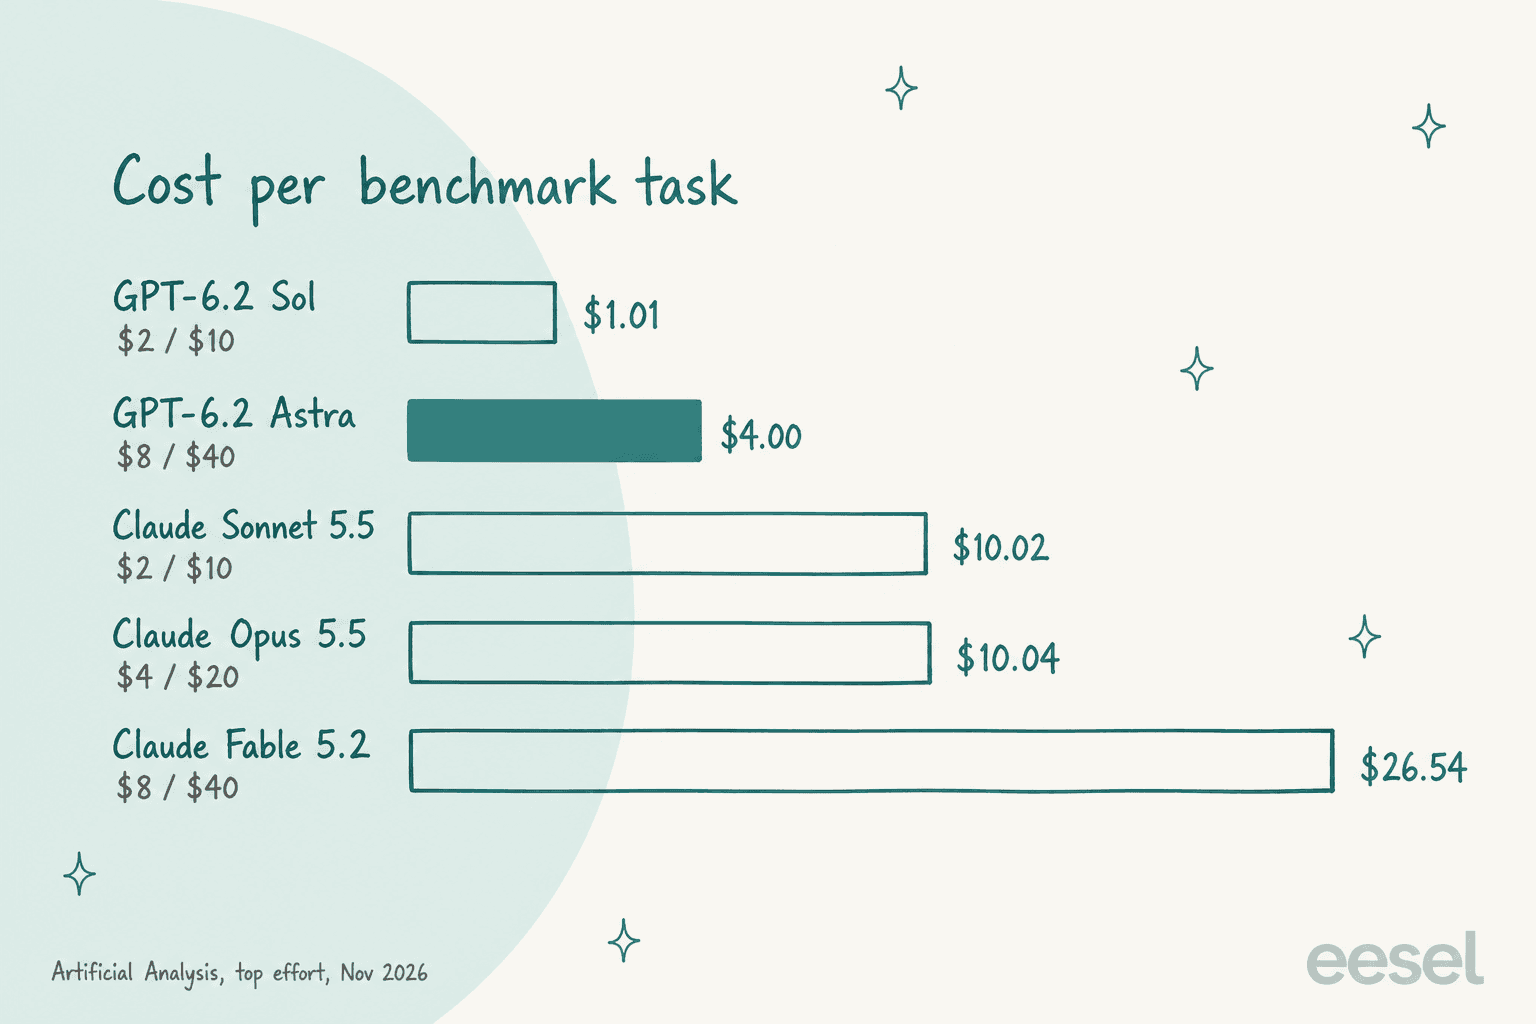
O Claude Opus 5.5 cobra a metade da taxa por token do Astra, $4/$20 contra $8/$40, mas o Artificial Analysis o mediu em $10,04 por tarefa contra os $4,00 do Astra. O Sonnet 5.5 tem o mesmo preço por token que o Sol e custou dez vezes mais por tarefa. A razão aparece na coluna de tempo: o Opus levou 24,6 minutos por tarefa e o Sonnet 32,3 minutos no esforço máximo, contra os 10,4 do Astra. Mais raciocínio significa mais tokens de saída, e a saída é o lado caro de qualquer tabela de preços.
Duas ressalvas mantêm isso justo. O Artificial Analysis executa cada modelo no esforço máximo, e a visão geral de modelos da Anthropic entrega o Opus 5.5 com esforço médio por padrão, então sua conta nas configurações padrão será menor do que o número do benchmark. E uma tarefa de benchmark não é sua tarefa. Trate o custo por tarefa como um alerta de direção, e então meça com seu próprio trabalho.
Um comentarista do HN colocou números reais na mesma ideia a partir do próprio uso em programação:
"Opus cost me about $1 in tokens per task while Haiku costs about 4.6 cents and Luna is about 2.5 cents."
1. GPT-6.2 Sol
Melhor para: equipes que querem continuar na OpenAI e cortar a conta em cerca de 75%.
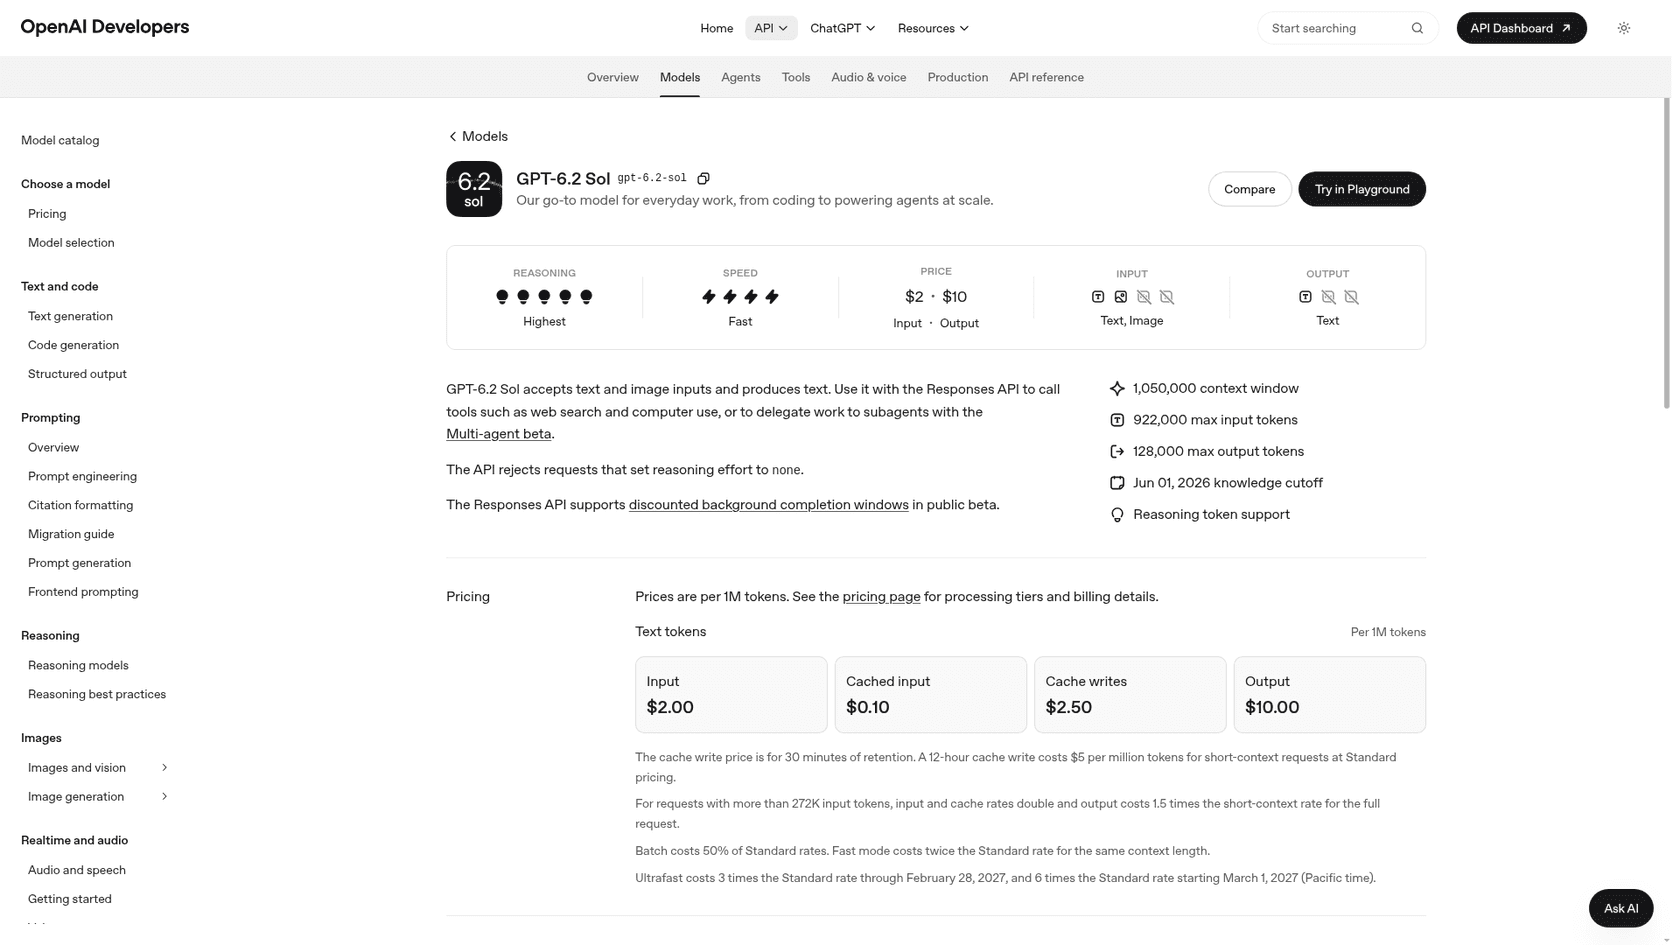
O GPT-6.2 Sol foi lançado junto com o Astra e usa a mesma API, as mesmas ferramentas e a mesma janela de contexto de 1.050.000 tokens, com 922.000 tokens de entrada e 128.000 de saída. Trocar o nome do modelo é toda a migração. O Artificial Analysis o pontua em 57, no nível da geração anterior GPT-6 Astra, por cerca de 15% do custo por tarefa daquele modelo.
Foi no meu teste que o Sol conquistou o primeiro lugar. Ao longo de 45 execuções com esforço baixo, médio e alto, ele respondeu corretamente a todos os tickets: o reembolso proporcional saiu em $990 todas as vezes, a injeção de prompt recebeu um não educado, a busca quebrada foi escalonada, e os clientes em espanhol e alemão receberam respostas em seu próprio idioma. O Astra fez o mesmo.
| Meu teste, 15 tickets | Custo por 1.000 tickets | Tempo médio de resposta |
|---|---|---|
| GPT-6.2 Astra, baixo / médio / alto | $5,75 / $5,79 / $6,57 | 5,4s / 3,3s / 4,5s |
| GPT-6.2 Sol, baixo / médio / alto | $1,42 / $1,40 / $1,54 | 2,5s / 2,5s / 2,8s |
As mesmas respostas, por cerca de um quarto do preço, e mais rápido. O esforço quase não moveu o custo em tickets desse tamanho, o que vale saber antes de pagar por esforço alto por padrão.
"For just doing things or coding things up, Sol all the way."
Vantagens
- $2/$10 por milhão de tokens, com entrada em cache a $0,10
- Mesma API, ferramentas e janela de contexto do Astra, então a troca é uma mudança de uma linha
- Igualou o Astra nos 15 tickets do meu teste de suporte, em todos os níveis de esforço
Desvantagens
- O Artificial Analysis diz que perdeu 3 pontos em seu Coding Agent Index em relação ao GPT-6.1 Sol, principalmente por deixar fatos importantes de fora das respostas
- Em bases de código grandes, alguns desenvolvedores ainda enviam o trabalho do Sol de volta ao Astra para revisão
- A API rejeita o esforço de raciocínio
none
Preços: $2 de entrada, $0,10 em cache, $10 de saída por milhão de tokens no padrão, segundo a página de preços da OpenAI. O modo em lote reduz pela metade. O guia preços da API da OpenAI cobre os níveis.
Veredito: comece aqui. Faça do Sol seu padrão e reserve o Astra para as tarefas em que o Sol falha visivelmente. A análise do GPT-6.1 Sol cobre a versão anterior se você estiver nela hoje.
2. Claude Opus 5.5
Melhor para: trabalho longo de código e escrita, onde explicações claras importam mais do que velocidade bruta.
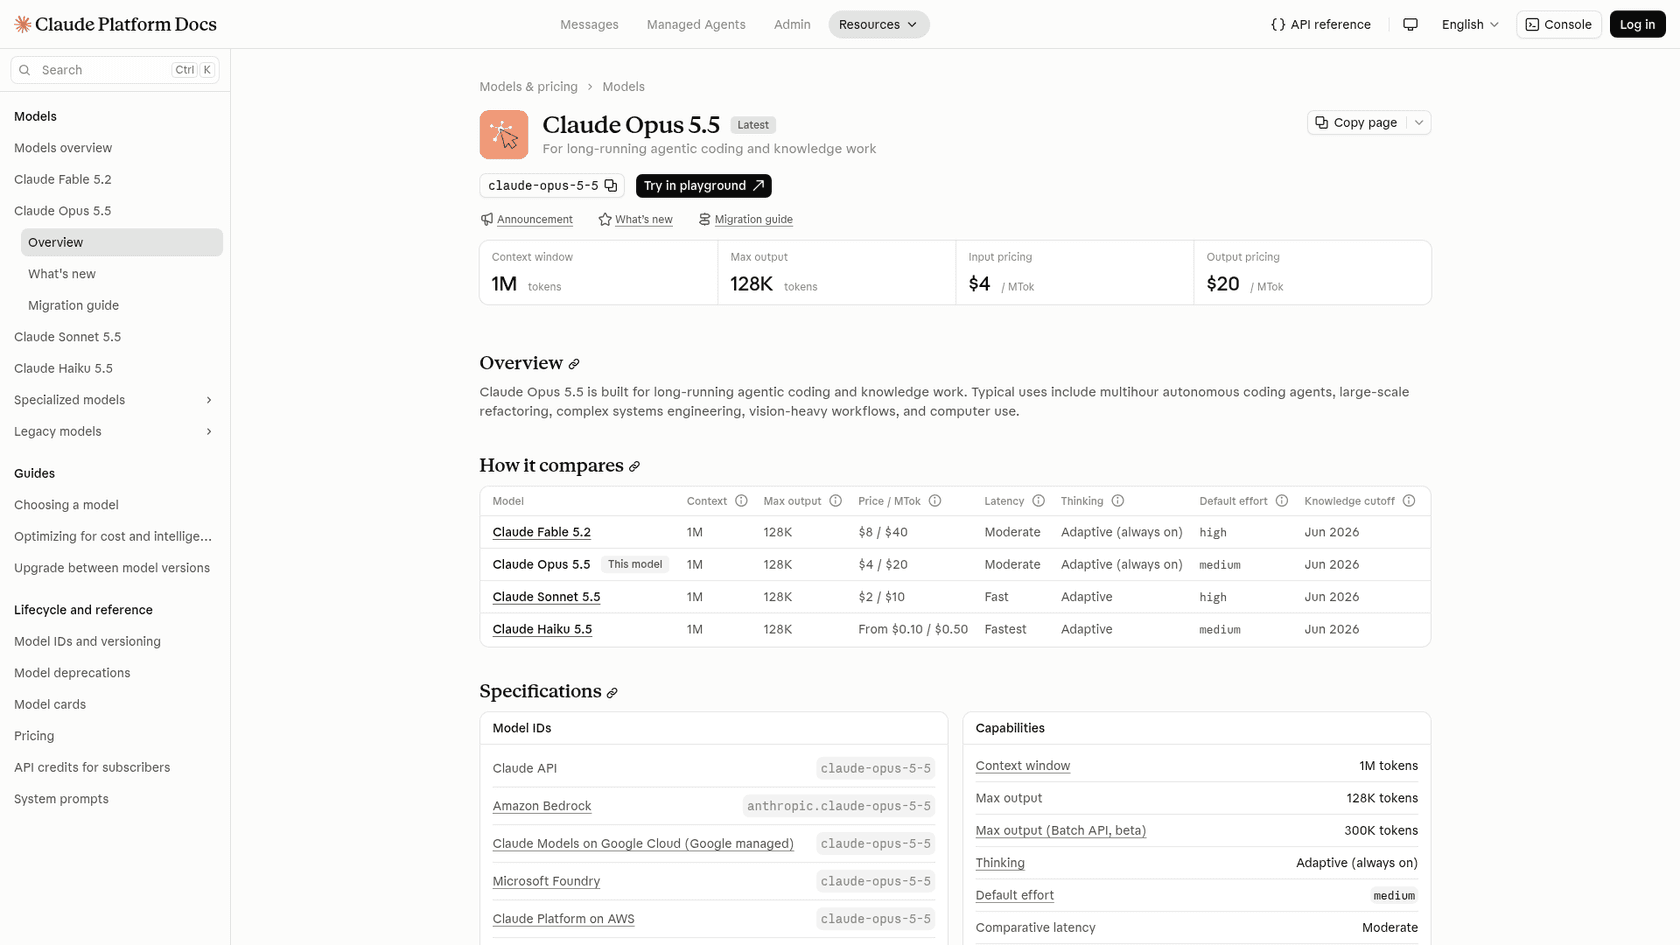
O Claude Opus 5.5 é o modelo que a Anthropic recomenda à maioria dos desenvolvedores para começar. Sua documentação o descreve como construído "for long-running agentic coding and knowledge work", com uma janela de contexto de 1M tokens, 128K de saída e esforço médio por padrão. Ele obtém 59 no Artificial Analysis, três pontos abaixo do Astra.
O argumento a favor dele não é a pontuação. É como ele se comunica. A reclamação mais forte sobre o Astra é que seus resumos de execuções longas são difíceis de acompanhar, e o Opus é para onde vários testadores recorrem para resolver isso.
"I've already built the habit of switching to opus 5.5 at the end of a long 6.2 Astra run, just to get a readable summary of what it said."
Vantagens
- Metade do preço por token do Astra, a $4/$20, com leituras de cache a $0,20
- Testadores preferem consistentemente suas explicações e planejamento em tarefas longas
- O modo rápido oferece até 2,5x a velocidade de saída por um custo adicional, segundo a documentação de preços da Anthropic
Desvantagens
- $10,04 por tarefa de referência no esforço máximo, 2,5 vezes o número do Astra
- 24,6 minutos por tarefa no esforço máximo, mais do que o dobro do tempo do Astra
- Alguns desenvolvedores ainda acham que sua prosa precisa de uma segunda revisão
Preços: $4 de entrada, $20 de saída, $0,20 de leituras de cache, $5 por escritas de cache de 5 minutos. O guia preços do Claude Opus 5.5 detalha o resto.
Veredito: a melhor opção como segundo fornecedor para quem lê o resultado do agente. Rode-o em esforço médio, não máximo, e verifique a conta por tarefa antes de supor que o preço por token mais baixo se repassa. Minha análise do Claude Opus 5.5 tem a visão mais longa.
3. Claude Fable 5.2
Melhor para: a rara tarefa em que a pontuação mais alta importa mais do que a conta.
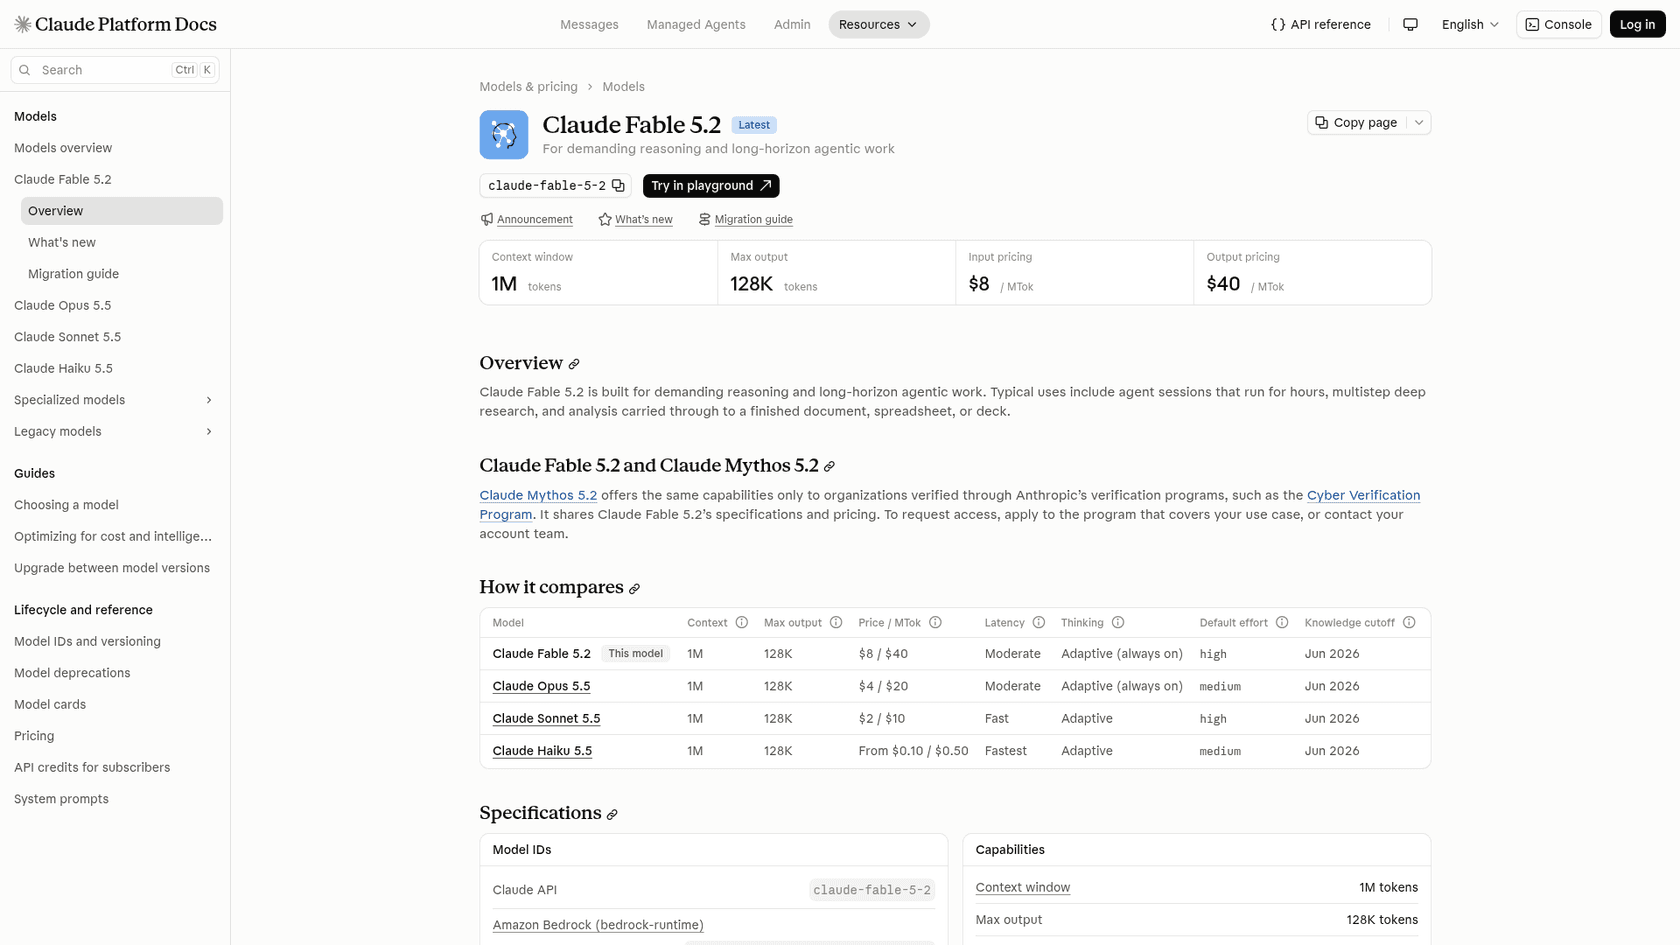
O Claude Fable 5.2 é o único modelo desta lista que supera o Astra na pontuação: 65 contra 62 no Artificial Analysis Intelligence Index. Tem o mesmo preço de tabela de $8/$40 do Astra, e suas leituras de cache custam a metade, a $0,20 contra $0,40. A Anthropic o descreve como construído "for demanding reasoning and long-horizon agentic work".
Então chega a conta por tarefa. O Artificial Analysis mediu o Fable 5.2 em $26,54 por tarefa e 40,8 minutos, contra os $4,00 e 10,4 minutos do Astra. Mesmo preço por token, 6,6 vezes o custo por tarefa. Um comentarista do HN resumiu o lado do Astra nessa troca:
"Second place at a sixth the price and in a quarter of the time (both according to Artificial Analysis for Astra 6.2 vs. Fable 5.2, both max effort) definitely has a place."
Outros pensaram o contrário depois de semanas de testes:
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
Vantagens
- A maior pontuação de Artificial Analysis de qualquer modelo, com 65
- Mesmo preço por token que o Astra, com leituras de cache mais baratas
- Avaliações fortes de testadores em design e tarefas longas com agentes
Desvantagens
- $26,54 por tarefa de referência, o modelo mais caro aqui, por uma margem grande
- 40,8 minutos por tarefa, o mais lento da lista
- O pensamento está sempre ativado, então você não pode trocar para um modo sem raciocínio
Preços: $8 de entrada, $40 de saída, $0,20 de leituras de cache, $10 por escritas de cache de 5 minutos. O modo em lote é a metade. O guia preços do Claude Fable 5.2 cobre o modo rápido.
Veredito: é um upgrade, não uma alternativa. Use-o para as poucas tarefas em que o Astra erra, e espere que a conta mostre isso. A análise do Claude Fable 5.2 tem os detalhes.
4. Claude Sonnet 5.5
Melhor para: equipes que querem o estilo da Anthropic no preço do Sol.
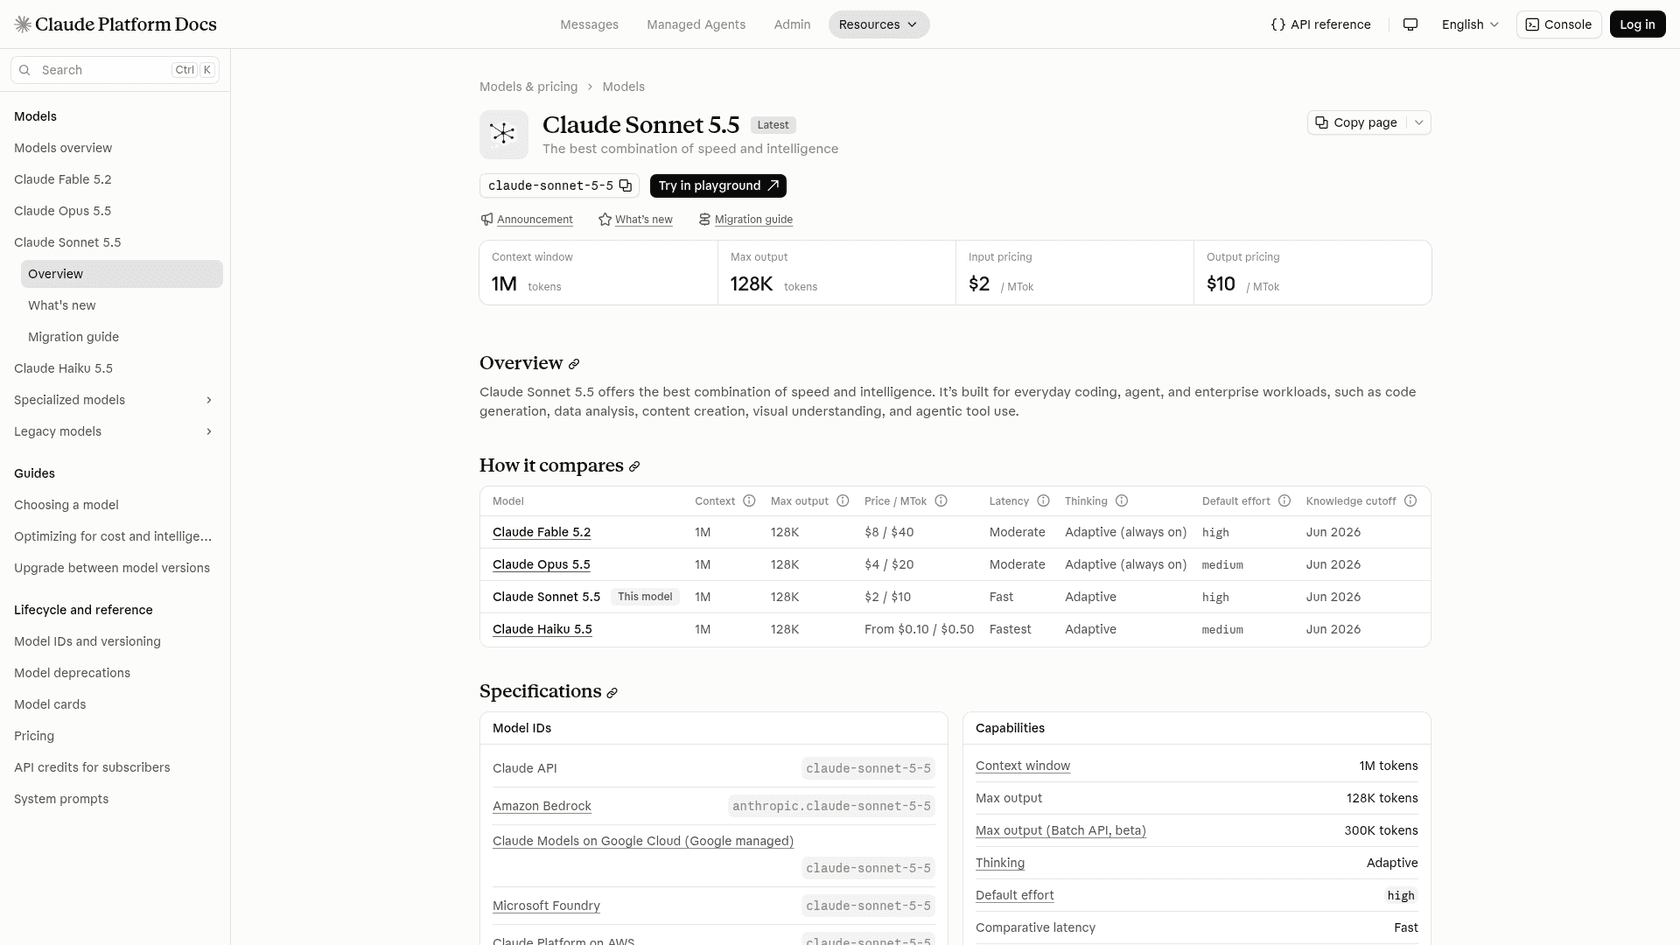
O Claude Sonnet 5.5 é o que a Anthropic chama de "the best combination of speed and intelligence". Custa $2/$10, igual ao Sol, com leituras de cache a $0,10 e um contexto de 1M. Diferente do Opus e do Fable, seu pensamento é adaptativo em vez de sempre ativado, e o esforço padrão é alto.
No Artificial Analysis ele obtém 55 no esforço máximo, com custo por tarefa de $10,02 e 32,3 minutos por tarefa. Essa é a mesma armadilha de custo por tarefa do Opus, e aqui ela pesa mais, já que o Sol pontua dois pontos mais alto por um décimo do custo por tarefa. A solução é a mesma: rode abaixo do esforço máximo e meça.
Vantagens
- $2/$10 com $0,10 de leituras de cache, igual ao Sol
- Pensamento adaptativo, então solicitações simples não pagam por um pensamento longo
- Mesmo contexto de 1M e saída de 128K que o Opus
Desvantagens
- $10,02 por tarefa de referência no esforço máximo, dez vezes o número do Sol
- 55 no Artificial Analysis, abaixo dos 57 do Sol
- O esforço padrão é alto, então a configuração cara é a padrão
Preços: $2 de entrada, $10 de saída, $0,10 de leituras de cache, $2,50 por escritas de cache de 5 minutos, segundo os preços da Anthropic. Veja o guia preços do Claude Sonnet 5.5.
Veredito: escolha-o em vez do Sol só se você já trabalha com a Anthropic ou prefere sua escrita, e defina o nível de esforço você mesmo. Minha análise do Claude Sonnet 5.5 cobre as mudanças que quebram compatibilidade.
5. Gemini 4 Carbon
Melhor para: uma pontuação quase igual ao Astra de um segundo fornecedor, se você orçar no preço de dezembro.
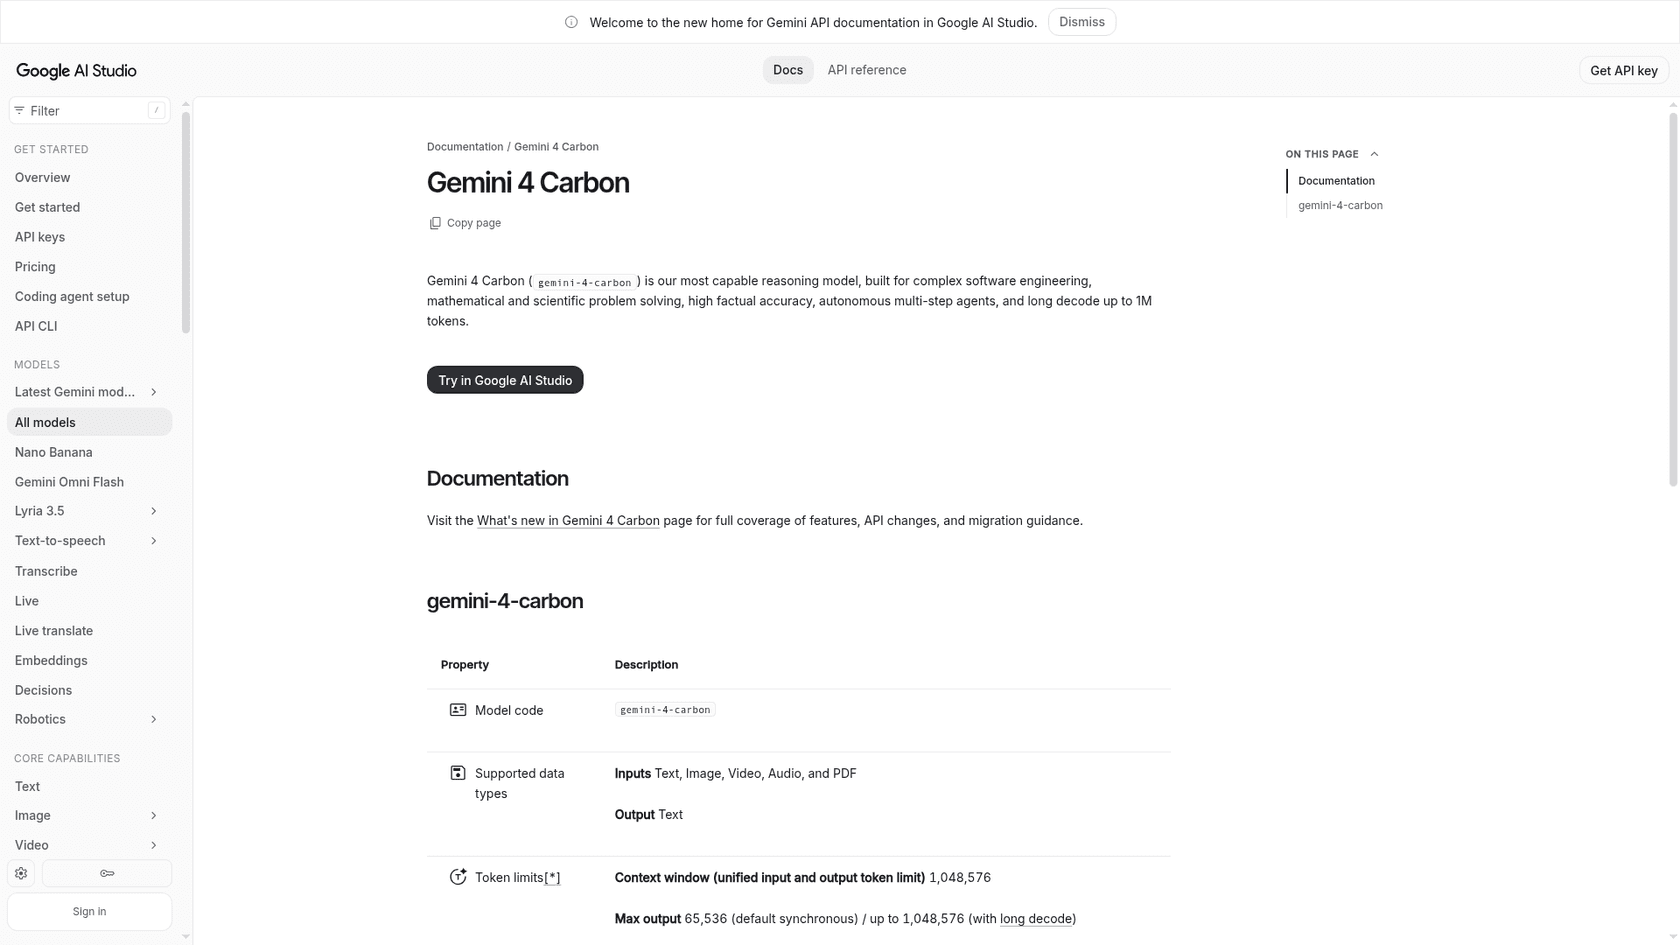
O Gemini 4 Carbon é o modelo de raciocínio mais capaz do Google, e obtém 60 no Artificial Analysis, dois pontos abaixo do Astra e um acima do Opus 5.5. Seu custo por tarefa é de $5,48, a aproximação mais próxima que qualquer modelo não-OpenAI chega do Astra nos dois eixos ao mesmo tempo. Ele aceita texto, imagens, vídeo, áudio e PDF, com um contexto de 1.048.576 tokens e até 1M tokens de saída por decodificação longa.
Observe o calendário. A página de preços do Google lista o Carbon a $2/$10 até 30 de novembro de 2026, depois $4/$20 a partir de 1º de dezembro. O caching só funciona de forma implícita, e não há nível gratuito para o Carbon.
Se o preço do Carbon for muito alto, o Gemini 4 Hydrogen do Google é o irmão mais barato: $1,50/$7,50, um nível gratuito e uma pontuação de 54 a $3,16 por tarefa. E um desenvolvedor no HN encontrou um motivo diferente para olhar para a família:
"My favorite model for this at the moment is Gemini 4 Argon, which writes very naturally and isn't too expensive."
Vantagens
- 60 no Artificial Analysis a $5,48 por tarefa, o melhor equilíbrio não-OpenAI desta lista
- Aceita vídeo, áudio e PDF além de texto e imagens
- Até 1M tokens de saída com decodificação longa
Desvantagens
- O preço dobra para $4/$20 em 1º de dezembro de 2026
- 33,4 minutos por tarefa de referência, mais de três vezes o tempo do Astra
- Só caching implícito, e sem nível gratuito
Preços: $2/$10 e $0,10 de caching até 30 de novembro, depois $4/$20 e $0,20. O grounding de busca é gratuito para 5.000 solicitações por mês, depois $14 por 1.000. O guia preços do Gemini 4 Carbon tem os níveis em lote e flex.
Veredito: a opção mais forte como segundo fornecedor se você precisa de inteligência próxima à do Astra. Orce a $4/$20 desde o primeiro dia para que dezembro não te surpreenda. Minha análise do Gemini 4 Carbon cobre os benchmarks.
6. Gemini 3.8 Flash
Melhor para: etapas baratas de alto volume como classificação, extração e primeiros rascunhos.
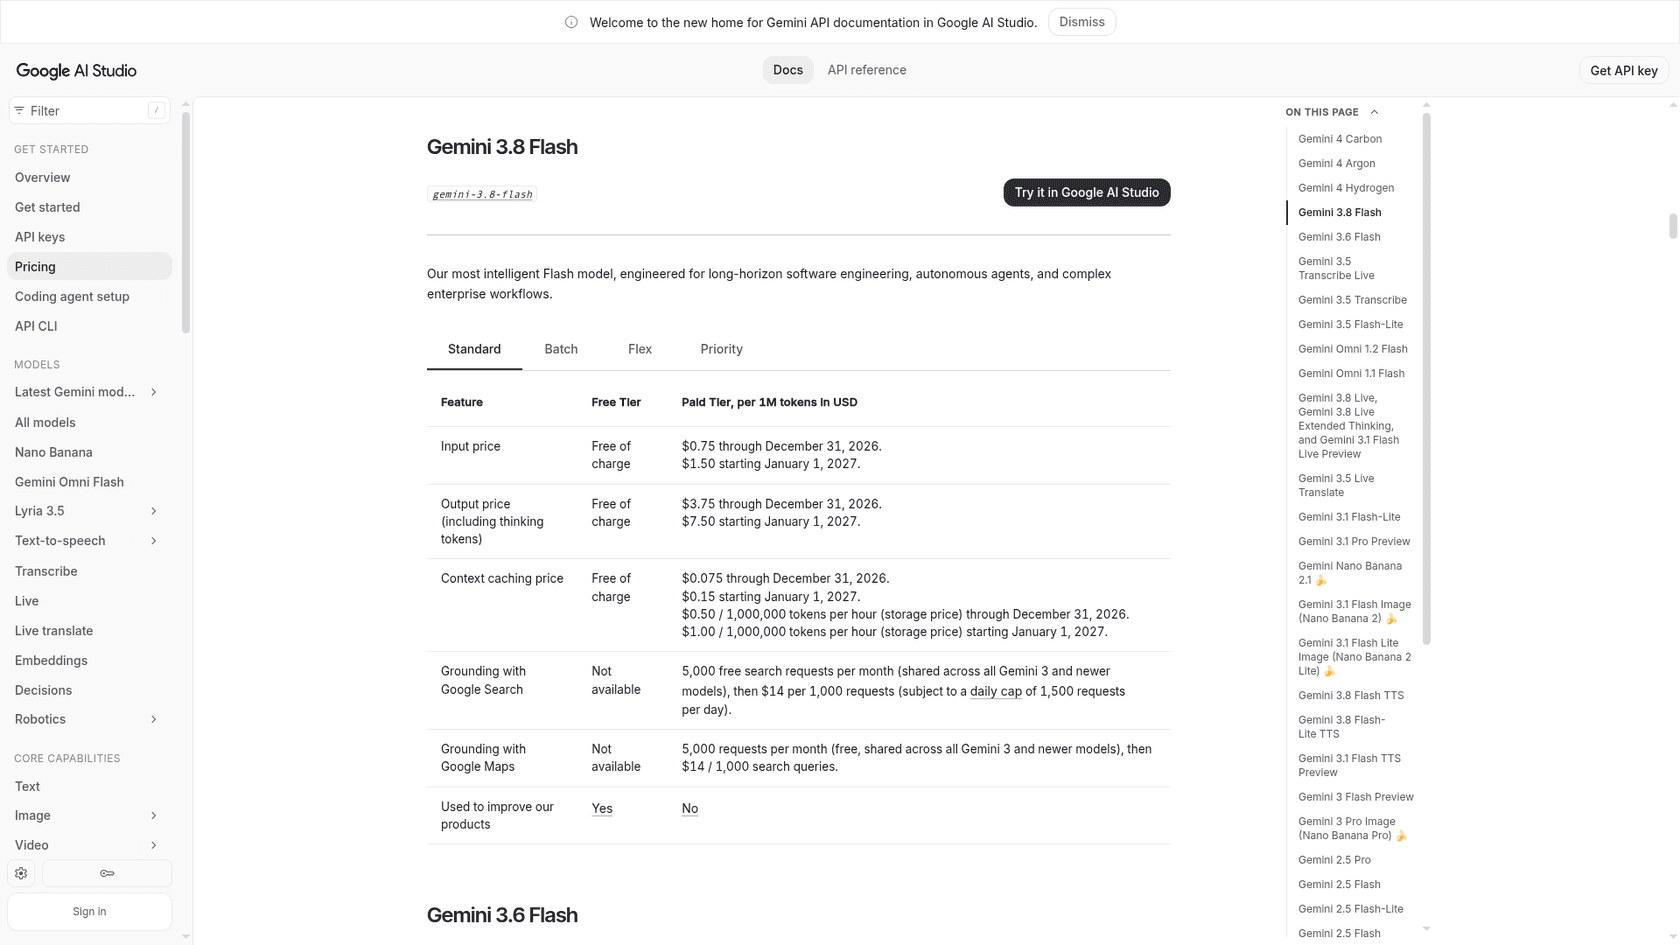
O Google descreve o Gemini 3.8 Flash como seu modelo Flash mais inteligente, "engineered for long-horizon software engineering, autonomous agents, and complex enterprise workflows". O ChatGPT o colocou perto do topo de sua própria lista de alternativas ao Astra, por causa do preço: $0,75/$3,75 por milhão de tokens, cerca de um décimo do Astra.
A pontuação é a outra metade da história. Fica em 31 no Artificial Analysis Intelligence Index, a metade dos 62 do Astra. Isso não é um substituto para as tarefas difíceis do Astra. É um modelo para a faixa barata de um sistema roteado, onde a tarefa é pequena e claramente definida.
Vantagens
- $0,75/$3,75, cerca de um décimo do preço por token do Astra
- Nível gratuito para testes
- Entrada em cache a $0,075
Desvantagens
- 31 no Artificial Analysis, a segunda pontuação mais baixa desta lista
- O preço dobra para $1,50/$7,50 em 1º de janeiro de 2027
- 14,1 minutos por tarefa de referência, mais lento que o Astra mesmo sendo um modelo Flash
Preços: $0,75 de entrada, $3,75 de saída, $0,075 de caching até 31 de dezembro de 2026, segundo a página de preços do Google. O guia preços do Gemini 3.8 Flash cobre o salto de 2027.
Veredito: uma ferramenta de roteamento, não uma substituição. Use-o para a parte simples do seu tráfego e mantenha um modelo mais forte para o que precisar de julgamento. A lista alternativas ao Gemini 3.8 Flash tem opções na mesma faixa de preço.
7. Grok 4.7
Melhor para: loops longos de agentes em que o volume de saída tornaria o Astra caro.
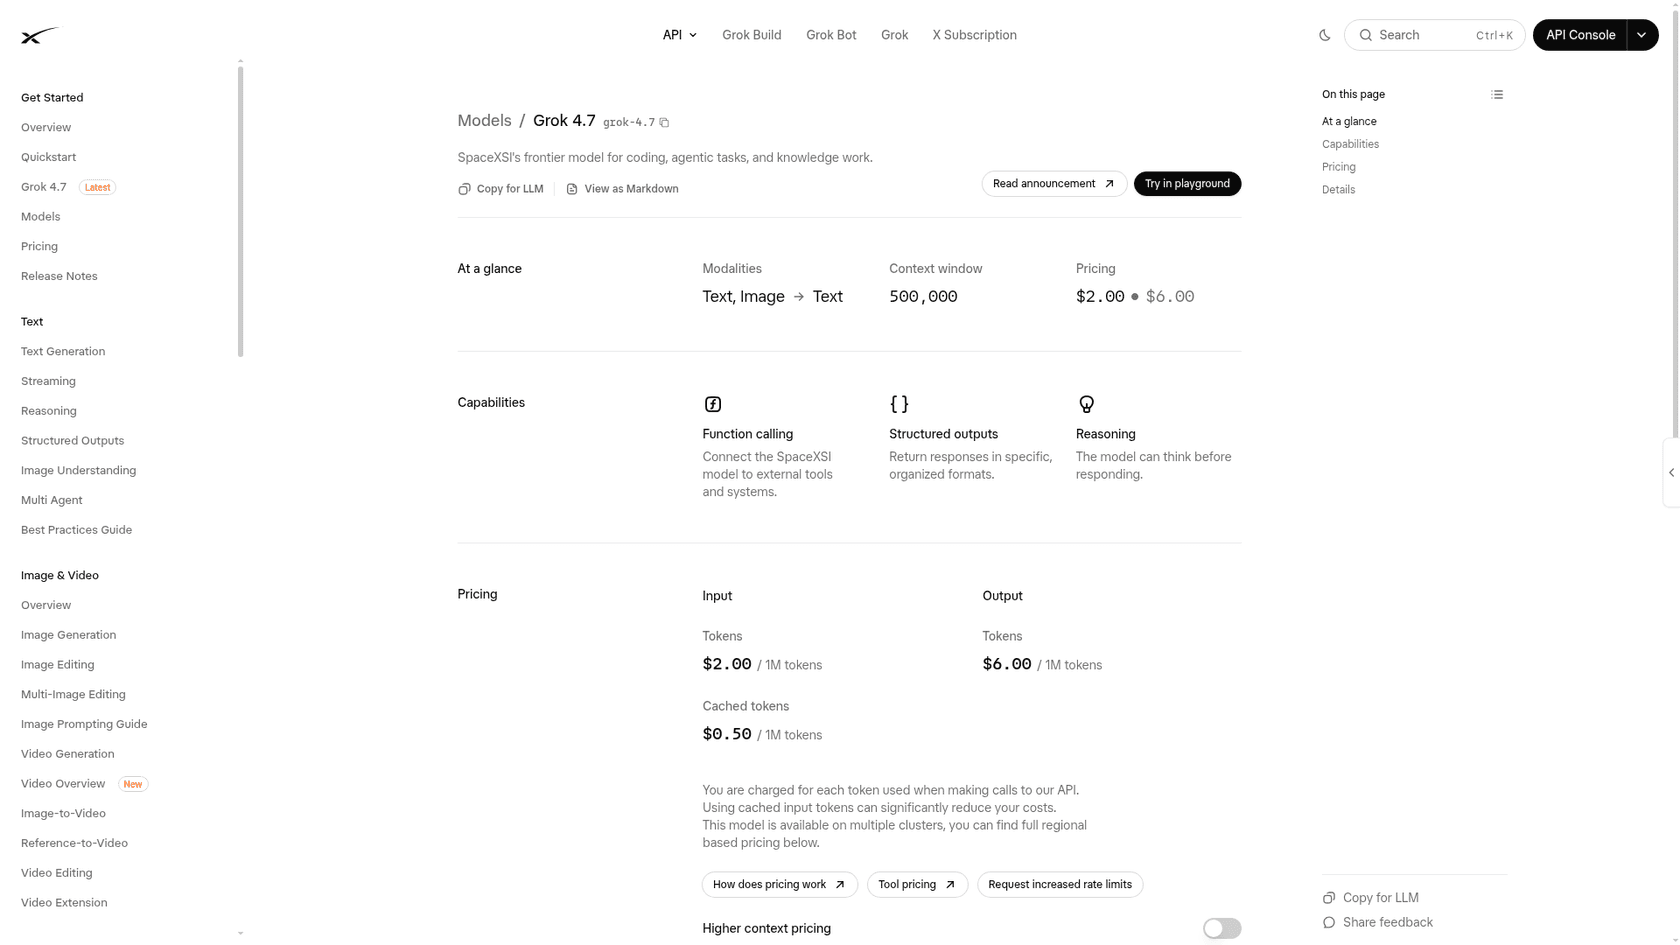
O Grok 4.7 cobra $6 por milhão de tokens de saída, contra os $40 do Astra e os $10 do Sol. A entrada custa $2 com entrada em cache a $0,50, e a janela de contexto é de 500K tokens. A xAI também suporta chamadas de função, saídas estruturadas e raciocínio no modelo.
Sua pontuação no Artificial Analysis é 35 no esforço xhigh, e levou 24,5 minutos por tarefa de referência. Isso o coloca bem abaixo do Astra no índice geral. Os próprios benchmarks de lançamento da xAI contam uma história mais apertada, com o Grok 4.7 pontuando 64,0 no EEBench contra os 56,4 do Claude Fable 5.1, então teste no seu próprio loop antes de descartá-lo. A análise do Grok 4.7 tem mais detalhes.
Vantagens
- $6 por milhão de tokens de saída, menos de um sexto do Astra
- Janela de contexto de 500K
- Chamada de função nativa e saídas estruturadas
Desvantagens
- 35 no Artificial Analysis, bem abaixo dos 62 do Astra
- Prompts de 200K tokens ou mais são cobrados a $4/$12
- Ferramentas do lado do servidor como busca na web custam $5 extras por 1.000 chamadas
Preços: $2 de entrada, $0,50 em cache, $6 de saída abaixo de 200K tokens, segundo a página de preços da xAI. O guia preços do Grok 4.7 cobre as taxas de ferramentas.
Veredito: vale a pena testar se os tokens de saída dominam sua conta. Não o escolha só pela pontuação do índice, em nenhuma das direções. O artigo alternativas ao Grok 4.7 o compara com o resto de sua faixa de preço.
8. DeepSeek V4 Pro e Flash
Melhor para: a conta de tokens mais baixa, se sua carga de trabalho cabe fora do horário de pico e é de texto.
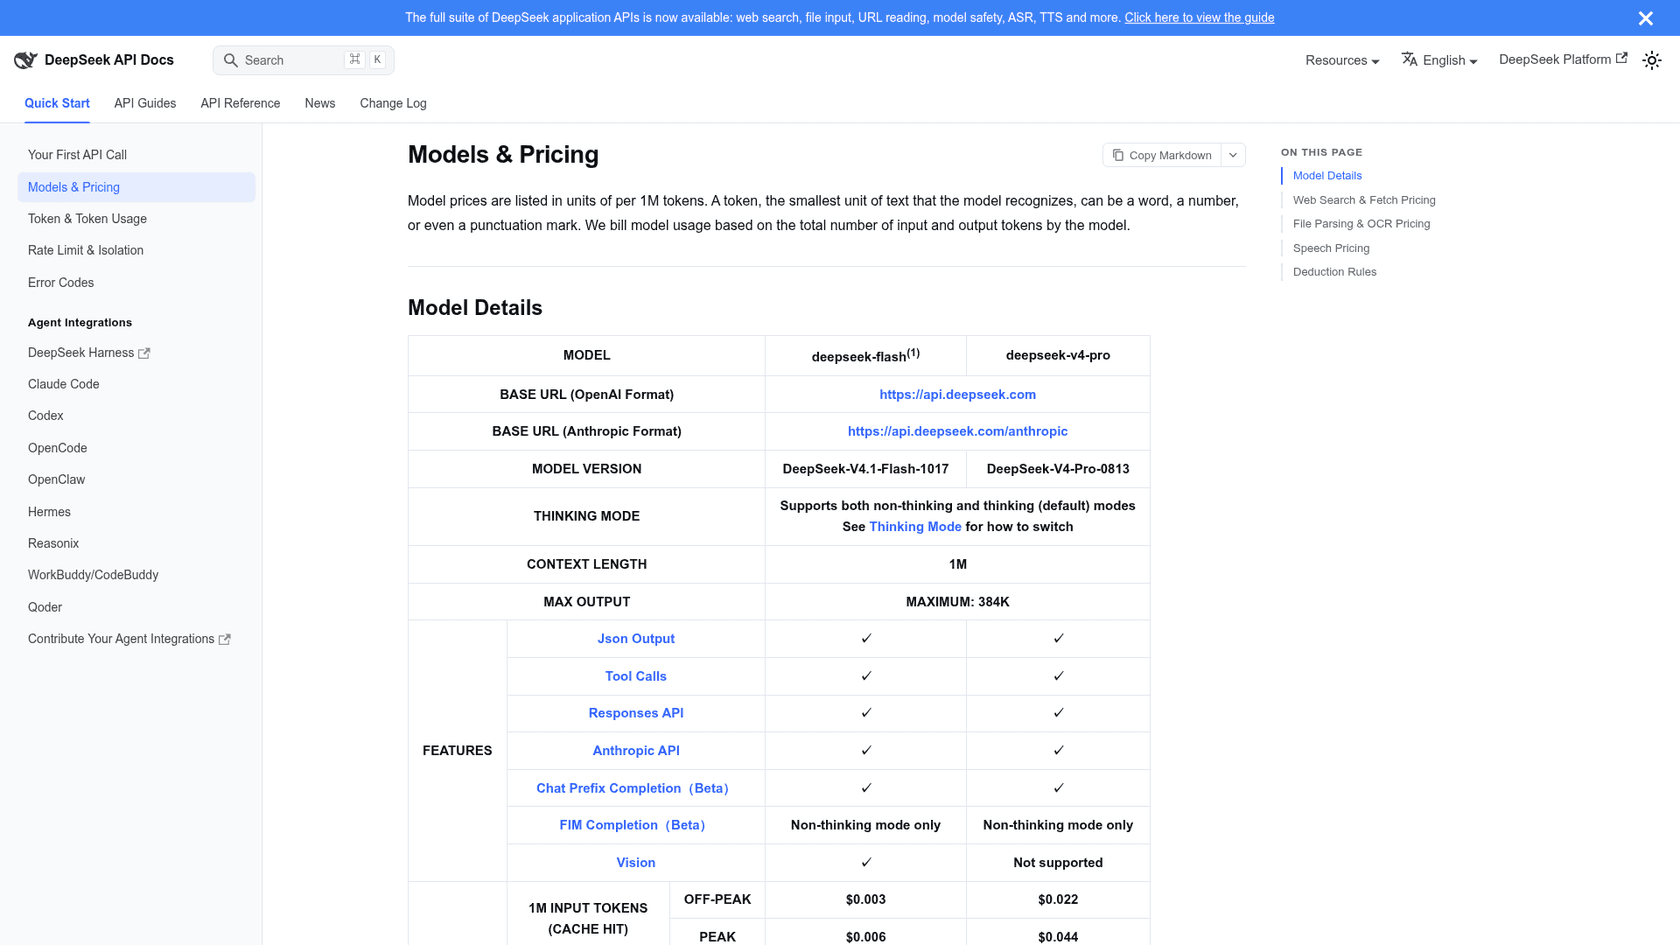
A DeepSeek vende dois modelos através de uma API compatível com a OpenAI, e também aceita o formato de API da Anthropic. O deepseek-flash agora atende ao DeepSeek V4.1 Flash a $0,15 de entrada e $0,60 de saída fora do pico. O deepseek-v4-pro custa $0,66/$1,98 fora do pico. Ambos têm contexto de 1M, até 384K de saída, chamadas de ferramentas e saída em JSON.
A pegadinha é o relógio. A DeepSeek cobra o dobro nos horários de pico em dias de semana, de 01h00 às 04h00 e de 06h00 às 10h00 UTC, então o Pro passa a $1,32/$3,96 e o Flash a $0,30/$1,20. Os acertos de cache são quase gratuitos, de $0,003 a $0,044 por milhão.
No Artificial Analysis, o V4 Pro obtém 23 no esforço máximo, a $1,77 por tarefa. Isso fica bem abaixo de qualquer outro modelo aqui, então trate a DeepSeek como uma jogada de custo para trabalho bem definido. O Flash tem seus fãs exatamente por isso:
"I used Luna Max a lot, until Deepseek 1017. Then never again."
Vantagens
- O Flash a $0,15/$0,60 fora do pico é o modelo capaz mais barato desta lista
- Aceita os formatos de API da OpenAI e da Anthropic
- Contexto de 1M e até 384K de saída
Desvantagens
- Os preços dobram nos horários de pico em dias de semana (UTC)
- O V4 Pro obtém 23 no Artificial Analysis, o mais baixo aqui
- O V4 Pro não suporta visão, e a concorrência é limitada a 500 solicitações
Preços: por milhão de tokens fora do pico, Flash $0,15/$0,60, Pro $0,66/$1,98; no horário de pico é o dobro. Busca na web e fetch custam $0,75 por 1.000 chamadas. O guia preços do DeepSeek V4.1 Flash detalha o horário de pico.
Veredito: uma faixa barata sólida para trabalho só de texto e alto volume, programado fora do pico se possível. Não é um substituto para as tarefas difíceis do Astra. Veja V4 Flash contra V4 Pro para escolher entre os dois.
9. Kimi K3.1 Pro
Melhor para: uma opção de fronteira não americana no preço do Sol.
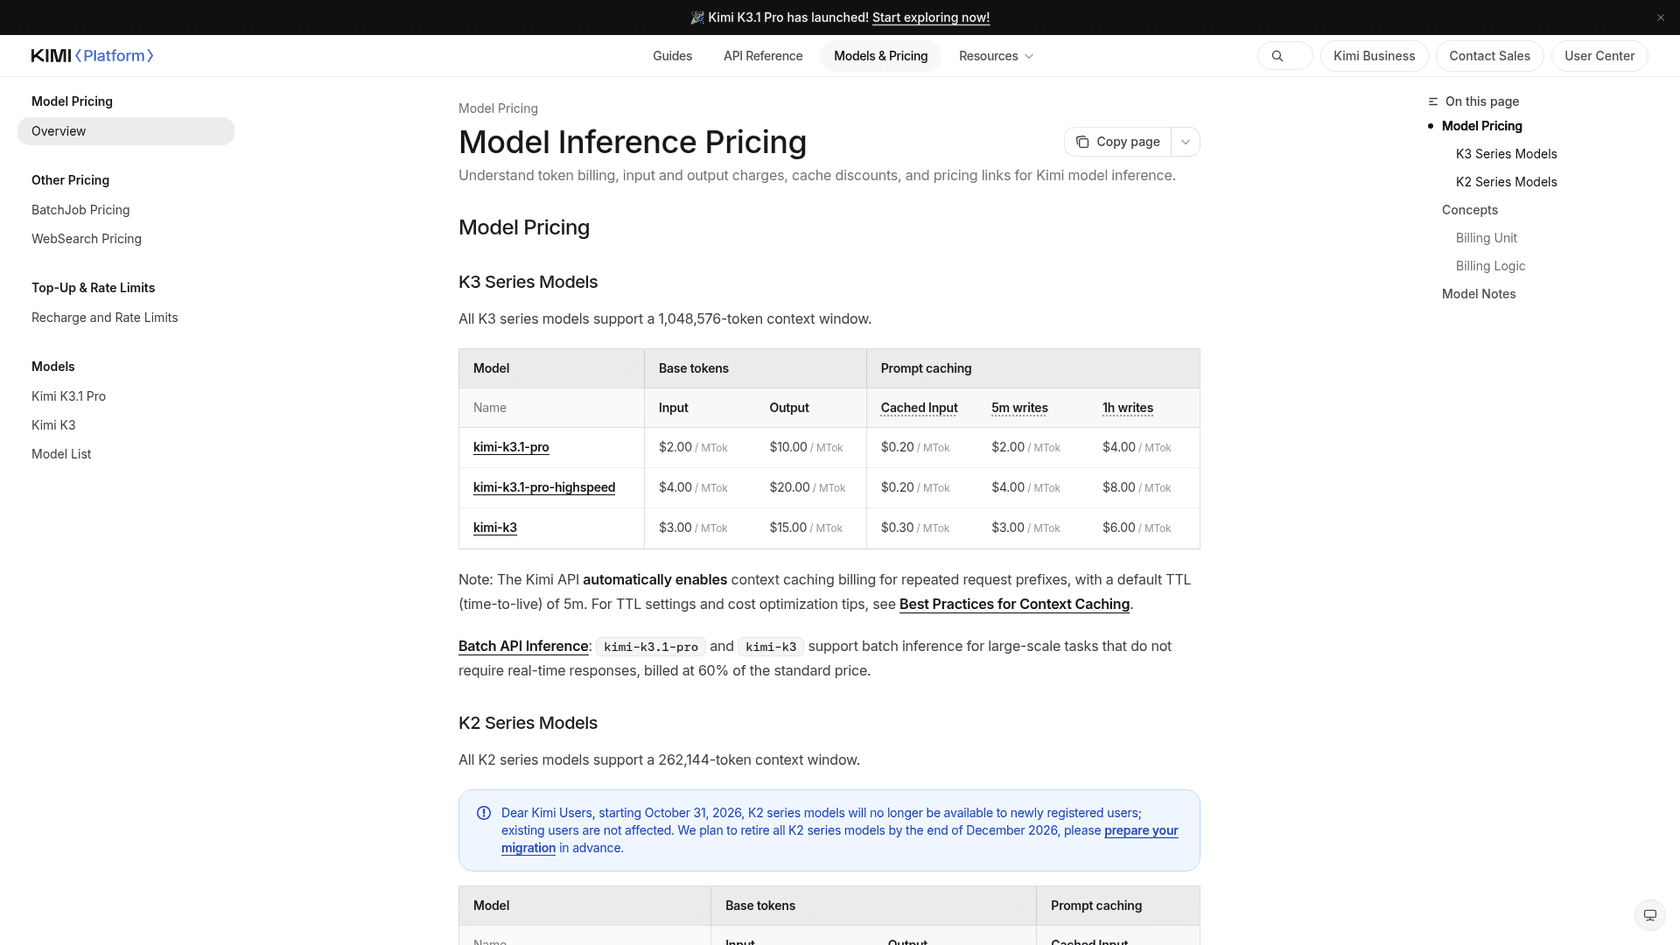
O Kimi K3.1 Pro da Moonshot AI custa $2/$10, igual ao Sol, com $0,20 de entrada em cache e uma janela de contexto de 1.048.576 tokens, segundo a página de preços do Kimi. Uma variante de alta velocidade custa o dobro. O caching de contexto é ativado automaticamente para prefixos repetidos, com uma vida útil padrão de 5 minutos.
Ele obtém 46 no Artificial Analysis a $3,68 por tarefa, o que o coloca entre os modelos de orçamento e o grupo de fronteira. O tempo por tarefa é longo, 38,7 minutos.
Vantagens
- $2/$10, igual ao Sol e ao Sonnet 5.5
- Caching de contexto automático sem configuração
- Janela de contexto de 1M tokens
Desvantagens
- 46 no Artificial Analysis, 11 pontos abaixo do Sol no mesmo preço por token
- 38,7 minutos por tarefa de referência
- Os modelos K2 estão fechados para novos usuários desde 31 de outubro de 2026, então guias mais antigos podem apontar para modelos que você não pode usar
Preços: $2 de entrada, $10 de saída, $0,20 em cache, $2 por escritas de cache de 5 minutos. Veja preços do Kimi K3.1 Pro.
Veredito: vale a pena testar se você precisa de um laboratório não americano. No mesmo preço, o Sol pontua mais alto no índice compartilhado. A análise do Kimi K3.1 Pro se aprofunda mais.
10. Qwen4 Max
Melhor para: preços de saída baixos de um grande modelo geral.
O Qwen4 Max ficou disponível de forma geral em 16 de novembro de 2026. Na região de Singapura da Qwen Cloud, custa $1,50 de entrada e $4,50 de saída por milhão de tokens, com leituras de cache a $0,075, segundo os preços de modelos da Qwen Cloud. A janela de contexto é de 1M tokens.
O Artificial Analysis o pontua em 43 a $3,27 por tarefa. Isso é mais baixo que o Kimi K3.1 Pro e bem abaixo do Sol, mas seu preço de saída é cerca de um nono do Astra.
Vantagens
- $4,50 de saída, mais baixo que qualquer modelo aqui, exceto DeepSeek e Gemini 3.8 Flash
- Leituras de cache a $0,075
- Modos de pensamento e sem pensamento no mesmo preço
Desvantagens
- 43 no Artificial Analysis
- Os preços variam por região, então a taxa de Singapura não é universal
- 31,9 minutos por tarefa de referência
Preços: $1,50/$4,50 em Singapura, com caching explícito a $1,875 por escritas de 5 minutos. O guia preços do Qwen 4 Max cobre as outras regiões.
Veredito: uma opção de orçamento para trabalho direto. Para algo mais próximo do Astra, olhe mais acima nesta lista. O artigo alternativas ao Qwen 4 Max o compara com seus próprios rivais.
Você deveria rotear entre modelos em vez de trocar?
Para a maioria dos produtos com agentes, sim. Trocar completamente do Astra para um modelo mais barato significa aceitar seus pontos fracos em cada tarefa. Rotear significa enviar cada tarefa para o modelo mais barato que a lida bem.
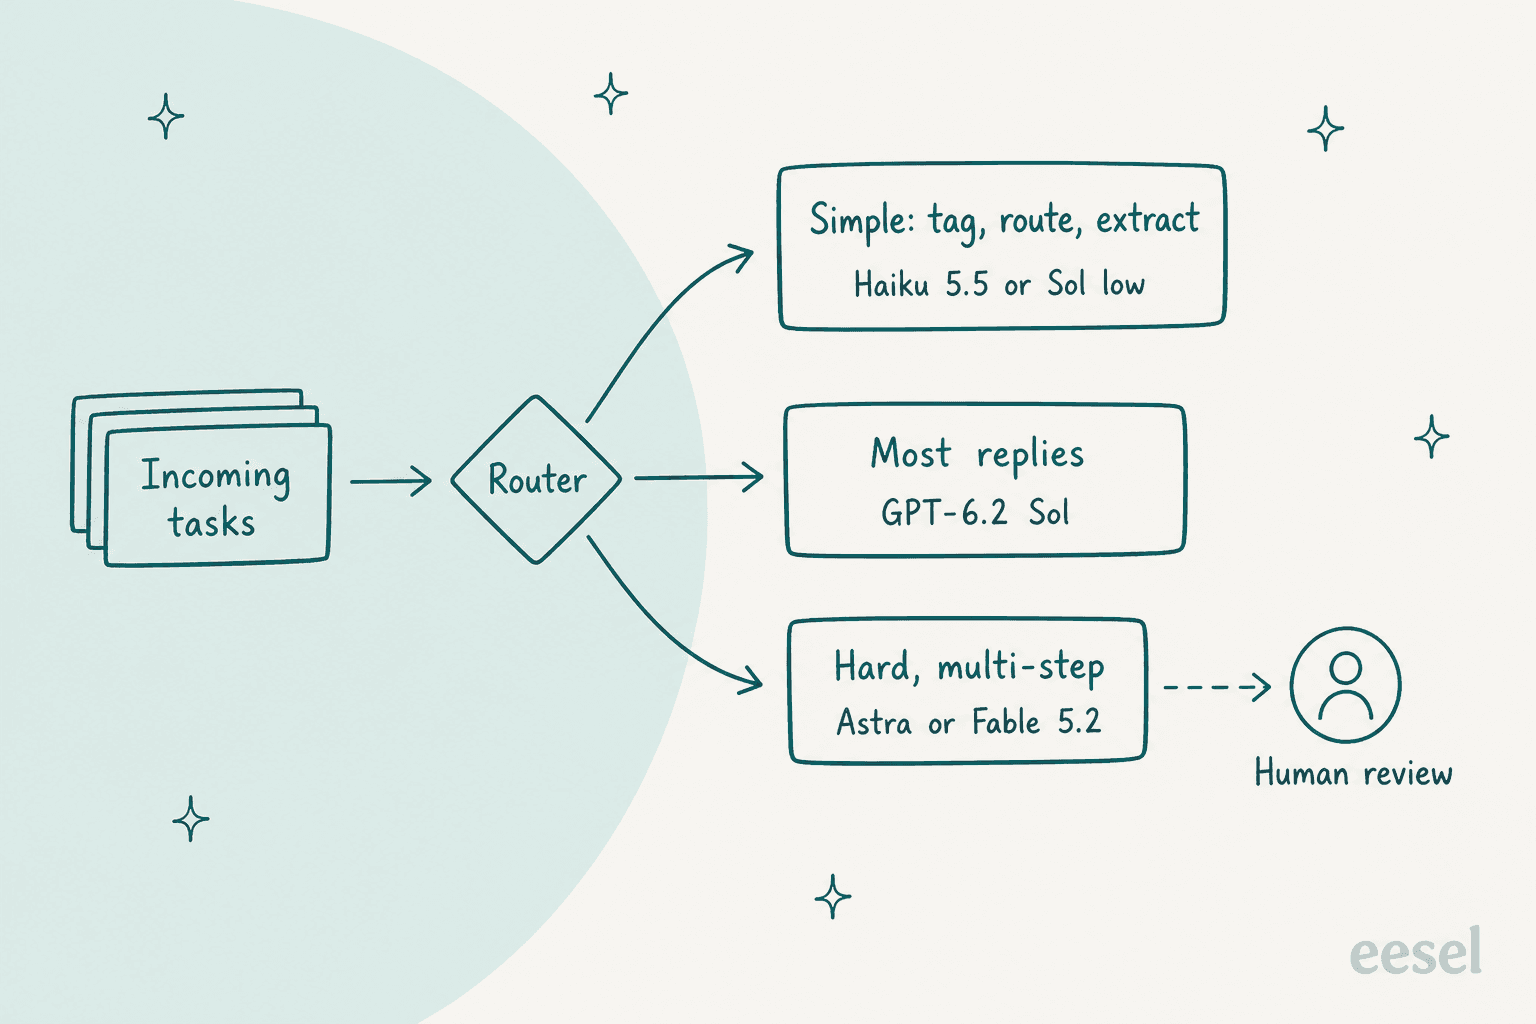
Uma configuração com a qual eu começaria:
- Tarefas simples como marcação, roteamento e extração vão para um modelo pequeno. O Claude Haiku 5.5 custa $0,10/$0,50 para prompts de até 100.000 tokens e custou $0,41 por tarefa do Artificial Analysis, ou use o Sol em esforço baixo.
- A maioria das respostas e chamadas de ferramentas de rotina vão para o GPT-6.2 Sol, que igualou o Astra em todo o meu teste.
- O trabalho difícil de várias etapas vai para o Astra, ou para o Fable 5.2 quando o que está em jogo justifica $26,54 por tarefa.
- Tudo que for incerto vai para uma pessoa.
Desenvolvedores na thread de lançamento já faziam uma versão disso:
"Opus medium as orchestrator and reviewer, Sol(high/medium)/Terra(max) as implementer."
A mesma ideia vale em filas de suporte. O roteamento inteligente envia os tickets para a pessoa certa; o roteamento de modelos envia cada etapa para o modelo certo. A análise custo de um agente de IA contra um agente humano mostra por que a faixa barata importa em grande volume.
Como você deve testar uma alternativa antes de trocar?
Benchmarks dizem quais modelos pré-selecionar. Só suas próprias tarefas dizem qual colocar em produção. Aqui está o processo que usei para o teste do Sol, em maior escala.
- Pegue de 100 a 300 tarefas reais dos seus registros, incluindo as desconfortáveis: chamadas de ferramentas que falharam, solicitações vagas, outros idiomas.
- Mantenha tudo idêntico exceto o modelo: mesmo prompt de sistema, mesmas ferramentas, mesmos limites.
- Avalie o custo por tarefa bem-sucedida, não o custo por chamada. Um modelo barato que precisa de duas tentativas não é barato.
- Rode cada configuração no esforço que você realmente usaria em produção, já que o esforço muda a conta mais do que o preço de tabela.
- Leia as falhas manualmente. Um valor de reembolso errado importa mais do que uma frase um pouco rígida.
Para trabalho de suporte especificamente, testes de agentes de suporte com IA cobre como montar esse conjunto de testes a partir de tickets passados. O guia de benchmarking cobre a avaliação, e revisar conversas de IA cobre a verificação contínua depois que está em produção.
O que isso significa para uma equipe de suporte?
Se seus agentes respondem a clientes, a escolha do modelo é a decisão menor. Qualquer modelo desta lista pode escrever uma resposta educada. O que decide se é a resposta certa é o conhecimento que ele lê, as ações que tem permissão para tomar, e o que acontece quando não tem certeza. Meu teste mostrou isso diretamente: tanto o Astra quanto o Sol escalonaram corretamente a busca de pedido quebrada porque as instruções diziam para fazer isso, e ambos acertaram o cálculo do reembolso porque a política estava escrita.
Essa é a camada que a eesel constrói. A eesel é uma plataforma de colegas de equipe de IA: você contrata colegas prontos para trabalhar em tarefas específicas, um colega de IA para o helpdesk para sua fila e um redator de blog com IA para conteúdo. O modelo é o motor; o colega de equipe é o funcionário que o dirige, com suas integrações, conhecimento e proteções já configurados. Antes de responder a um cliente real, ele é simulado contra seus tickets passados.
A Swiftreg, que vende placas de veículo particulares, mostra como essa camada de regras funciona na prática. Seus agentes eesel trataram 2.100 tickets do Zendesk em um mês, respondendo a partir de dados reais de pedidos sob regras que a própria Swiftreg escreveu. Eles enviaram 1.500 respostas públicas e deixaram 1.050 notas internas onde uma etapa pertence à equipe. A SE Ranking roda um agente eesel por produto em três produtos no Zendesk, e tratou 4.650 conversas em um mês buscando em cerca de 16.800 páginas de ajuda e conteúdo do site antes de responder.
Se você preferir trabalhar a partir de código, o CLI da eesel permite que você ou um agente de código como o Claude Code ou o Codex pilotem o mesmo colega de equipe a partir de um terminal: carregar artigos de ajuda e macros aprovados, ajustar as instruções do agente e fazer perguntas de teste antes de qualquer coisa entrar em produção. Conectar o helpdesk em si ainda precisa da aprovação de um administrador, e o conhecimento carregado é testado antes de contar como pronto.
É a mesma ideia de um CLI de agente de IA, aplicada a um colega de suporte. Um servidor MCP é a outra rota comum. Se você está avaliando se deve conectar isso você mesmo sobre o Sol ou o Astra, construir vs. comprar expõe o que a conta do modelo deixa de fora.
Experimente a eesel
Trocar o Astra pelo Sol reduz sua conta de tokens. Isso não escreve suas regras de escalonamento, não fundamenta as respostas na sua central de ajuda, nem testa o agente com os tickets do mês passado. O colega de IA da eesel para o helpdesk se conecta ao Zendesk, funciona do mesmo jeito com o Freshdesk e o resto do seu stack, aprende com seus tickets passados, e mostra como teria respondido a eles antes de entrar em produção.

Experimente a eesel gratuitamente em uma parte da sua fila, ou veja planos e preços.