Por que as pessoas estão olhando além do GPT-6 Astra
Deixa eu ser justo primeiro com o GPT-6 Astra, porque é um modelo genuinamente impressionante. Ele traz uma janela de contexto de 1.050.000 tokens, um shell hospedado, apply-patch, uso de computador e suporte a MCP nativamente, segundo a página do modelo da OpenAI. Nos benchmarks agênticos o salto é real: a OpenAI reporta que o Terminal-Bench 4.0 subiu para 57,9% vindo dos 37,3% do Sol, e é o primeiro modelo que a OpenAI classificou como "Crítico" para cibersegurança sob seu Preparedness Framework. Se você está construindo agentes autônomos de programação ou pipelines de uso de ferramentas de longa duração, isso é relevante.
Aqui está o problema, e é o motivo pelo qual você está lendo isto. A OpenAI precificou o Astra em $10 por milhão de tokens de entrada e $50 por milhão de saída, 2,5x os $4/$20 que o GPT-5.6 Sol custava. Por esse dinheiro, você esperaria um salto equivalente em inteligência. Você não recebe isso. O índice independente de Inteligência da Artificial Analysis coloca o Astra em 61,2 contra os 60,9 do Sol, o que está dentro da margem de ruído. A observação mais afiada no Hacker News foi que isso parece "mais 5.7 do que 6", e o número confirma isso (nós exploramos isso na nossa análise do GPT-6 Astra).

Há mais alguns motivos pelos quais as equipes estão pesquisando outras opções:
- Não está no nível gratuito. O Astra é somente Plus/Pro/Business/Enterprise e API, e no Enterprise vem desativado por padrão por workspace. (Se você está mapeando a lista mais ampla de modelos da OpenAI, o Astra fica no topo dela.)
- A monitorabilidade caiu. A OpenAI observa francamente na ficha do sistema que o modelo pode influenciar sua própria cadeia de pensamento, então eles adicionaram um monitoramento de desalinhamento que pode pausar o uso legítimo de ferramentas.
- Prompts longos custam mais. Solicitações acima de 272K tokens são cobradas a 2x a entrada e 1,5x a saída, então a janela de contexto de destaque do Astra não tem preço fixo como algumas concorrentes têm.
Nada disso torna o Astra ruim. Isso o transforma em um especialista pelo qual você está pagando preços de carro-chefe. Então vamos ver o que mais existe por aí.
Alternativas ao GPT-6 Astra de relance
Aqui está todo o campo lado a lado. Os preços são por milhão de tokens na API padrão de cada fornecedor, e os scores de inteligência vêm do índice da Artificial Analysis (eles mudam semana a semana, então trate-os como uma referência aproximada, não como verdade absoluta).
| Modelo | Entrada / saída ($/M) | Contexto | Índice de inteligência (aprox.) | Pesos abertos? | Melhor para |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 / $50 | 1,05M | ~61 | Não | Agentes autônomos, programação, ciber |
| Claude Fable 5.1 | $10 / $50 | 1M | ~66 | Não | Maior capacidade medida |
| Claude Opus 5 | $5 / $25 | 1M | ~61 | Não | Troca mais próxima, metade do preço de saída |
| Claude Sonnet 5 | $2 / $10 | 1M | ~53 | Não | Custo-benefício em produção de alto volume |
| Gemini 3.8 Flash | $0.75 / $3.75 | 1M | ~59 | Não | Mais barato hospedado, trabalhos em lote |
| Kimi K3 | $3 / $15 | 1M | ~57 | Sim | Capacidade com pesos abertos |
| Qwen 3.8 Max | $2 / $6 | 1M | ~58 | Parcial | Base aberta + forte preferência humana |
| DeepSeek V4 Flash | ~$0.22-0.44 / $0.66-1.32 | 1M | ~50 | Sim (MIT) | Mais barato por tarefa, auto-hospedável |
| Grok 4.6 | $2 / $6 | 500K | ~54 | Não | Rápido, fluxos nativos da xAI |
Uma palavra rápida sobre como eu leria essa tabela. Preço de tabela e custo por tarefa não são a mesma coisa. Um modelo que queima o dobro dos tokens de saída para terminar um trabalho pode custar mais do que um modelo "mais caro" que chega lá numa única passada. Então use a tabela para pré-selecionar e depois rode seus prompts reais em dois ou três finalistas para medir a conta de verdade. O melhor modelo de IA para tickets de suporte raramente é o de maior número de benchmark, e qual LLM vence geralmente depende dos seus dados.

1. Claude Opus 5
Melhor para: equipes que querem capacidade nível Astra sem a conta do Astra.
O Claude Opus 5 é a troca um-para-um mais natural desta lista. Ele iguala a janela de contexto de 1M do Astra, e a Anthropic cobra a janela inteira em tarifas padrão sem penalidade de contexto longo, então uma solicitação de 900K tokens custa o mesmo por token que uma de 9K. No índice da Artificial Analysis ele fica bem ao lado do Astra (ambos por volta de 61), e por um período ele ocupou sozinho o primeiro lugar.
A peculiaridade interessante é o seletor de esforço. O Opus 5 ativa o raciocínio por padrão e permite subir o esforço de raciocínio até max, onde reside boa parte de sua qualidade, mas também onde vai o custo. O consenso da comunidade é que o Opus 5 gasta aproximadamente o dobro dos tokens de saída do Opus 4.8 no mesmo nível de esforço, então o custo por tarefa subiu mesmo com o preço de tabela igual.

Aqui está uma opinião real de um desenvolvedor após a troca:
"Opus 5 matched Fable 5 on my agent tasks, and it was faster and cheaper to run."

- Prós: metade do preço de saída do Astra, preço fixo para 1M de contexto, raciocínio de ponta, cota própria de limite de taxa.
- Contras: o raciocínio vem ativado por padrão e não pode ser desligado acima do esforço
high, e o consumo de tokens por tarefa pode subir rápido. - Preços: $5 de entrada / $25 de saída por milhão; modo rápido $10/$50; lote com 50% de desconto; leituras de cache $0.50.
Veredito: se você está deixando o Astra porque a relação preço-qualidade te incomodou, comece por aqui. Você tem essencialmente o mesmo nível de inteligência pela metade do custo de saída. Fique de olho no seletor de esforço, porque um hábito de esforço max pode apagar a economia silenciosamente.
2. Claude Fable 5.1
Melhor para: o modelo mais capaz que você pode comprar pelo preço do Astra.
Se o problema do Astra é cobrar preço de carro-chefe por um score praticamente estagnado, o Claude Fable 5.1 é a resposta direta: custa exatamente os mesmos $10/$50 e lidera o índice de inteligência com cerca de 65,7, vários pontos à frente do Astra. Ele fica acima do Opus 5 na própria linha de produtos da Anthropic e lidera todos os testes que a Anthropic publicou no lançamento, incluindo o Terminal-Bench-Science, onde mais que dobrou o score anterior.
Dois detalhes tornam essa compra genuinamente diferente do Astra. Primeiro, as leituras de cache caíram 75% para $0.25 por milhão, mais barato por token que os $0.50 do Opus 5, o que faz diferença rápido em cargas de trabalho agênticas que releem um system prompt grande. Segundo, o Fable 5.1 agora estampa uma marca d'água estatística em sua saída para cumprir a Lei de IA da UE, algo que algumas equipes adoram pela rastreabilidade e outras acham estranho. Vale saber disso antes de se comprometer.
- Prós: maior inteligência medida da lista pelo preço do Astra, leituras de cache muito baratas, preço fixo para 1M de contexto, prosa e programação fortes.
- Contras: mesmo $50/M de saída do Astra (essa não é a opção barata), alguns relatos de recusas falso-positivas em código próprio relacionado a segurança, e a marca d'água na saída não vai agradar a todos.
- Preços: $10 de entrada / $50 de saída; leitura de cache $0.25; lote $5/$25; não está em nível gratuito.
Veredito: se você ia pagar preço de Astra de qualquer forma, o Fable 5.1 te dá mais capacidade medida pela mesma tarifa. É a alternativa de "mesmo dinheiro, mais modelo".
3. Claude Sonnet 5
Melhor para: trabalho de produção de alto volume onde valor por tarefa vence capacidade máxima.
Nem todo trabalho precisa de um carro-chefe. O Claude Sonnet 5 é o cavalo de batalha da família Claude 5 a $2/$10 por milhão, um quinto do preço de saída do Astra, e a Anthropic confirmou em agosto de 2026 que essa é a tarifa padrão permanente, não uma promoção que vai expirar. Ele marca cerca de 53 no índice de inteligência, mais baixo que os carros-chefe, mas suficiente para classificação, roteamento, resumo e a longa cauda de geração rotineira.
O detalhe a observar são os turnos por tarefa. Mais barato por token nem sempre significa mais barato por trabalho, porque um modelo menor às vezes precisa de mais idas e vindas para chegar ao mesmo resultado. Ainda assim, numa tarefa bem delimitada, o Sonnet 5 é um dos melhores modelos em valor por token que você pode apontar para o tráfego de produção.
- Prós: uma fração do preço do Astra, 1M de contexto a preço fixo, rápido, genuinamente bom em tarefas do dia a dia.
- Contras: não é um raciocinador de fronteira, e pode consumir turnos extras em trabalhos ambíguos.
- Preços: $2 de entrada / $10 de saída por milhão; leitura de cache $0.20; lote com 50% de desconto.
Veredito: o modelo que eu escolheria para os 80% do tráfego que não precisam de um carro-chefe. Combine com o Opus 5 ou o Fable 5.1 para os 20% difíceis e você tem uma estrutura de custo que o Astra não alcança.
4. Google Gemini 3.8 Flash
Melhor para: trabalhos em lote baratos e de alto rendimento onde ninguém está esperando a resposta.
O Gemini 3.8 Flash é o modelo hospedado mais barato aqui que ainda entra na conversa de fronteira, a $0.75 de entrada / $3.75 de saída até o fim de 2026 (dobra para $1.50/$7.50 em 1º de janeiro de 2027, então planeje isso). Ele marca cerca de 59 no índice de inteligência e tem um nível gratuito, que o Astra não tem.
Uma ressalva honesta que a maioria das coberturas ignora: a Artificial Analysis mede seu tempo até o primeiro token em 13,30 segundos contra uma mediana de classe de cerca de 3 segundos, mesmo com sua taxa de transferência bruta entre os primeiros modelos testados. Taxa de transferência não é responsividade. Isso o torna excelente para pipelines de lote noturnos e o desqualifica para qualquer coisa que um humano esteja esperando ativamente, como uma resposta de chat ao vivo. A própria Google sugere ficar no 3.7 Flash mais antigo para cargas de trabalho focadas em eficiência, já que o 3.8 "trabalha mais" e pode usar mais tokens.
- Prós: opção hospedada mais barata, nível gratuito, entrada multimodal enorme (texto, imagem, áudio, vídeo, PDF), taxa de transferência muito alta.
- Contras: tempo lento até o primeiro token, o preço dobra em janeiro de 2027, e duas métricas de segurança regrediram levemente em relação ao 3.7.
- Preços: $0.75 / $3.75 por milhão até 31 dez 2026, depois $1.50 / $7.50; lote e Flex com 50% de desconto.
Veredito: um excelente modelo de lote e processamento offline a um preço que os carros-chefe não conseguem igualar. Só não o coloque na frente de um cliente vendo um indicador de "digitando".
5. Kimi K3
Melhor para: equipes que querem forte capacidade com pesos abertos que possam auto-hospedar.
O Kimi K3 é o carro-chefe da Moonshot AI, um modelo mixture-of-experts de 2,8 trilhões de parâmetros com 104B ativos, e seus pesos abertos foram lançados no prazo, na data prometida, o que nem todo laboratório consegue. Ele marca cerca de 57 no índice de inteligência, superando carros-chefe mais antigos como o Opus 4.8, e tem visão nativa (embora só aceite base64 ou IDs de arquivo, não URLs públicas de imagens).
O preço é a surpresa: a $3/$15 por milhão, ele está na mesma faixa do Claude Sonnet, não a jogada de fundo de poço que a era K2 acostumou as pessoas a esperar. O raciocínio está sempre ativado e não pode ser desligado em nenhum nível de esforço, então é um controle de latência, não um nível de custo. Se seu motivo para querer o K3 é auto-hospedagem, os pesos abertos são o ponto principal; se você vai só usar a API hospedada, a conta de valor é menos óbvia frente ao Sonnet 5.
- Prós: pesos genuinamente abertos, benchmarks fortes, visão nativa, 1M de contexto.
- Contras: preço hospedado é de nível médio, não econômico, o raciocínio não pode ser desativado, URLs públicas de imagens não são aceitas.
- Preços: $3 de entrada / $0.30 de acerto de cache / $15 de saída por milhão.
Veredito: a melhor escolha desta lista se pesos abertos forem um requisito obrigatório e você realmente for rodá-los. Só como API hospedada, o Sonnet 5 geralmente ganha em valor.
6. Qwen 3.8 Max
Melhor para: um bom curinga com uma base aberta permissiva e scores de preferência humana entre os cinco primeiros.
O Qwen 3.8 Max da Alibaba entrou em disponibilidade geral em agosto de 2026, um MoE de 2,4T de parâmetros com 95B ativos, precificado em $2 de entrada / $6 de saída por milhão. Ele marca cerca de 58 no índice de inteligência, e nos rankings de preferência humana da LMArena ele é genuinamente forte, entre os cinco primeiros em texto e os dois primeiros em visão, então o índice automatizado e os votos humanos às cegas apontam em direções ligeiramente diferentes. Quando discordam, eu não confiaria em nenhum dos números sozinho e testaria.

Na questão dos pesos abertos, é um "sim" parcial. O checkpoint pesado Qwen3.8-2.4T-A95B foi lançado sob uma licença Qwen restrita, enquanto um modelo permissivo Apache-2.0 de 27B é o que você realmente pode reutilizar livremente. O Max hospedado também não é equivalente em recursos à base aberta, já que adiciona entrada de visão, um modo sem raciocínio e ferramentas embutidas.
- Prós: preço hospedado baixo, rankings de topo em preferência humana, 1M de contexto, um modelo aberto menor e permissivo.
- Contras: os pesos grandes estão sob licença restrita, as versões hospedada e aberta diferem, e a residência de dados fica na China na API de primeira parte.
- Preços: $2 de entrada / $6 de saída por milhão; leitura de cache implícita $0.25.
Veredito: um curinga legitimamente forte e barato, especialmente se você valoriza qualidade de preferência humana acima de scores de benchmark. Leia a licença com cuidado antes de planejar auto-hospedar o modelo grande.
7. DeepSeek V4 Flash
Melhor para: cargas de trabalho de alto volume onde custo por tarefa é o jogo todo.
Se sua prioridade é gastar o mínimo possível por token, nada aqui chega perto do DeepSeek V4 Flash. Na tabela de preços ao vivo, ele fica em torno de $0.22-$0.44 por milhão de entrada e $0.66-$1.32 de saída, dependendo do horário de pico ou fora de pico. Como a janela de pico da DeepSeek (01:00-04:00 e 06:00-10:00 UTC) coincide com o horário comercial chinês, uma fila dos EUA ou da UE é cobrada majoritariamente na tarifa mais barata fora de pico, uma peculiaridade real (embora frágil) que vale a pena conhecer.

Duas coisas para manter a honestidade. Primeiro, "barato" e "bom" são execuções diferentes dos mesmos pesos: os próprios números da DeepSeek mostram uma grande diferença entre a qualidade sem raciocínio e a de esforço máximo, e os tokens de raciocínio são cobrados na tarifa de saída, então a configuração econômica não é a que lidera as tabelas. Segundo, quanto a dados de clientes, os termos da API paga são omissos sobre uso para treinamento em vez de proibi-lo explicitamente, não há opção de retenção zero publicada, e os dados ficam na RPC sob a lei chinesa. Então é um motor de custo fantástico para trabalho de alto volume não sensível, e não um substituto direto para dados regulados de clientes.
- Prós: de longe o mais barato, pesos abertos licenciados sob MIT (~167GB), 1M de contexto, 384K de saída máxima.
- Contras: a configuração econômica fica atrás em qualidade, uso de tokens verboso, apenas texto (sem entrada de imagem documentada), e termos de tratamento de dados não adequados a dados sensíveis.
- Preços: fora de pico / pico, por milhão: entrada ~$0.22 / $0.44, saída ~$0.66 / $1.32; entrada de acerto de cache uma fração de centavo.
Veredito: o campeão de custo-benefício, com grande margem. Use-o para classificação, extração e resumo em massa em dados não sensíveis. Mantenha PII de clientes fora da API de primeira parte até que os termos e a residência de dados estejam alinhados com seus requisitos.
8. Grok 4.6
Melhor para: equipes já no ecossistema xAI que querem respostas rápidas e uma janela de contexto grande.
O Grok 4.6 fecha a lista a $2 de entrada / $6 de saída por milhão para prompts abaixo de 200K tokens, com uma janela de contexto de 500K. É rápido, e se você já está construindo sobre a xAI ou quer busca ao vivo em X/web integrada, é uma escolha sensata. Uma coisa que a tabela de preços deixa clara: solicitações de contexto longo (prompts em 200K ou acima) reprecificam toda a solicitação para $4/$12, não apenas o excedente, então um prompt grande custa mais do que a tarifa de destaque sugere.
O Grok também mede coisas além de tokens: busca web, busca no X e execução de código custam $5 por 1.000 chamadas, e busca de anexos de arquivo custa $10 por 1.000. Os preços efetivos medidos pela OpenRouter são a leitura mais afiada do mundo real aqui, mostrando uma média de entrada bem abaixo do $2 de tabela graças a uma taxa de acerto de cache de ~90%, com a saída ligeiramente acima da tabela porque parte do tráfego cai no nível de contexto longo. Se a área de compras forçar você para um marketplace de nuvem, note que Azure e Bedrock só chegam a gerações mais antigas do Grok, então você não consegue o 4.6 lá.
- Prós: rápido, 500K de contexto, busca ao vivo nativa, preço efetivo frequentemente abaixo da tabela graças a bom caching.
- Contras: solicitações de contexto longo reprecificam o prompt inteiro, medidores extras por chamada para busca e ferramentas, sem desconto de lote no 4.6.
- Preços: $2 / $6 por milhão (≤200K); $4 / $12 para prompts ≥200K; medidores de ferramentas/busca à parte.
Veredito: um modelo sólido e rápido com uma vantagem real se você quiser busca embutida ou já estiver no mundo da xAI. A reprecificação de contexto longo e os medidores por chamada significam que você deveria modelar seu uso real antes de assumir que é a opção barata.
A parte que toda comparação de modelos deixa passar: um modelo não é um colega de equipe
Aqui está o que eu gostaria que alguém tivesse me dito antes de passar uma semana fazendo benchmark. Se você está escolhendo um modelo para responder tickets de suporte, escrever posts de blog ou rodar qualquer fluxo de trabalho de negócio real, o modelo é apenas o motor. É inteligência bruta sem a menor ideia de qual é sua política de reembolso, qual view do Zendesk deveria olhar, ou quando deveria parar e perguntar a um humano.
Todo modelo desta lista, incluindo o Astra, tem a mesma lacuna. Os scores de conhecimento da Artificial Analysis não passam de 50 em 100, o que é uma forma elegante de dizer que nenhum modelo aqui conhece seu negócio. Para transformar um modelo em algo que realmente faz um trabalho, você precisa envolvê-lo com sua central de ajuda e tickets passados, conectá-lo às suas ferramentas, e colocar salvaguardas, testes e aprovações ao redor dele. Esse é o trabalho por trás de qualquer IA para atendimento ao cliente de verdade, e é o mesmo trabalho não importa qual modelo vença seu benchmark.

É aqui também que a conversa de preços vira. Pagar $50 por milhão de tokens de saída dói mais quando você está gastando isso nos 80% rotineiros de tickets que qualquer modelo de nível médio conseguiria resolver. A estrutura mais inteligente é deixar outra coisa decidir quando uma pergunta difícil realmente precisa de um carro-chefe, e pagar pelo resultado em vez de pelos tokens. Essa é a diferença entre alugar um motor e contratar um colega de equipe de IA, e isso também muda o custo comparado a um agente humano.
Experimente a eesel
O motivo pelo qual eu sempre volto ao enquadramento "motor vs. colega de equipe" é que é isso que a gente constrói. A eesel é uma plataforma de colegas de equipe de IA: em vez de te entregar um modelo bruto e uma chave de API, você contrata um colega de equipe pronto para trabalhar em uma função específica, como o colega de helpdesk de IA que entra na sua fila de suporte ou o redator de blog de IA. Cada um chega já sabendo usar o modelo, suas integrações e o contexto da sua empresa, então não é você quem fica colando o GPT-6 Astra no Zendesk às 2 da manhã.

Duas coisas importam para quem está comparando custos de modelos. Primeiro, a eesel cobra por ticket a $0.40, não por token, então você fica isolado exatamente dessa guerra de preços da qual este post trata; seja o melhor modelo o Astra, o Opus 5 ou algo mais barato no mês que vem, seu custo por conversa resolvida não oscila. Segundo, como o Astra é fundamentalmente uma história de agente e API, vale saber que a eesel expõe o mesmo colega de equipe através de uma verdadeira interface de linha de comando e servidor MCP: você pode operá-lo pelo terminal, roteirizá-lo em CI, ou conectá-lo via MCP a um agente de programação como o Claude Code e operá-lo sem interface gráfica. A documentação diz literalmente que tudo que você pode fazer no painel, você pode fazer pelo terminal.
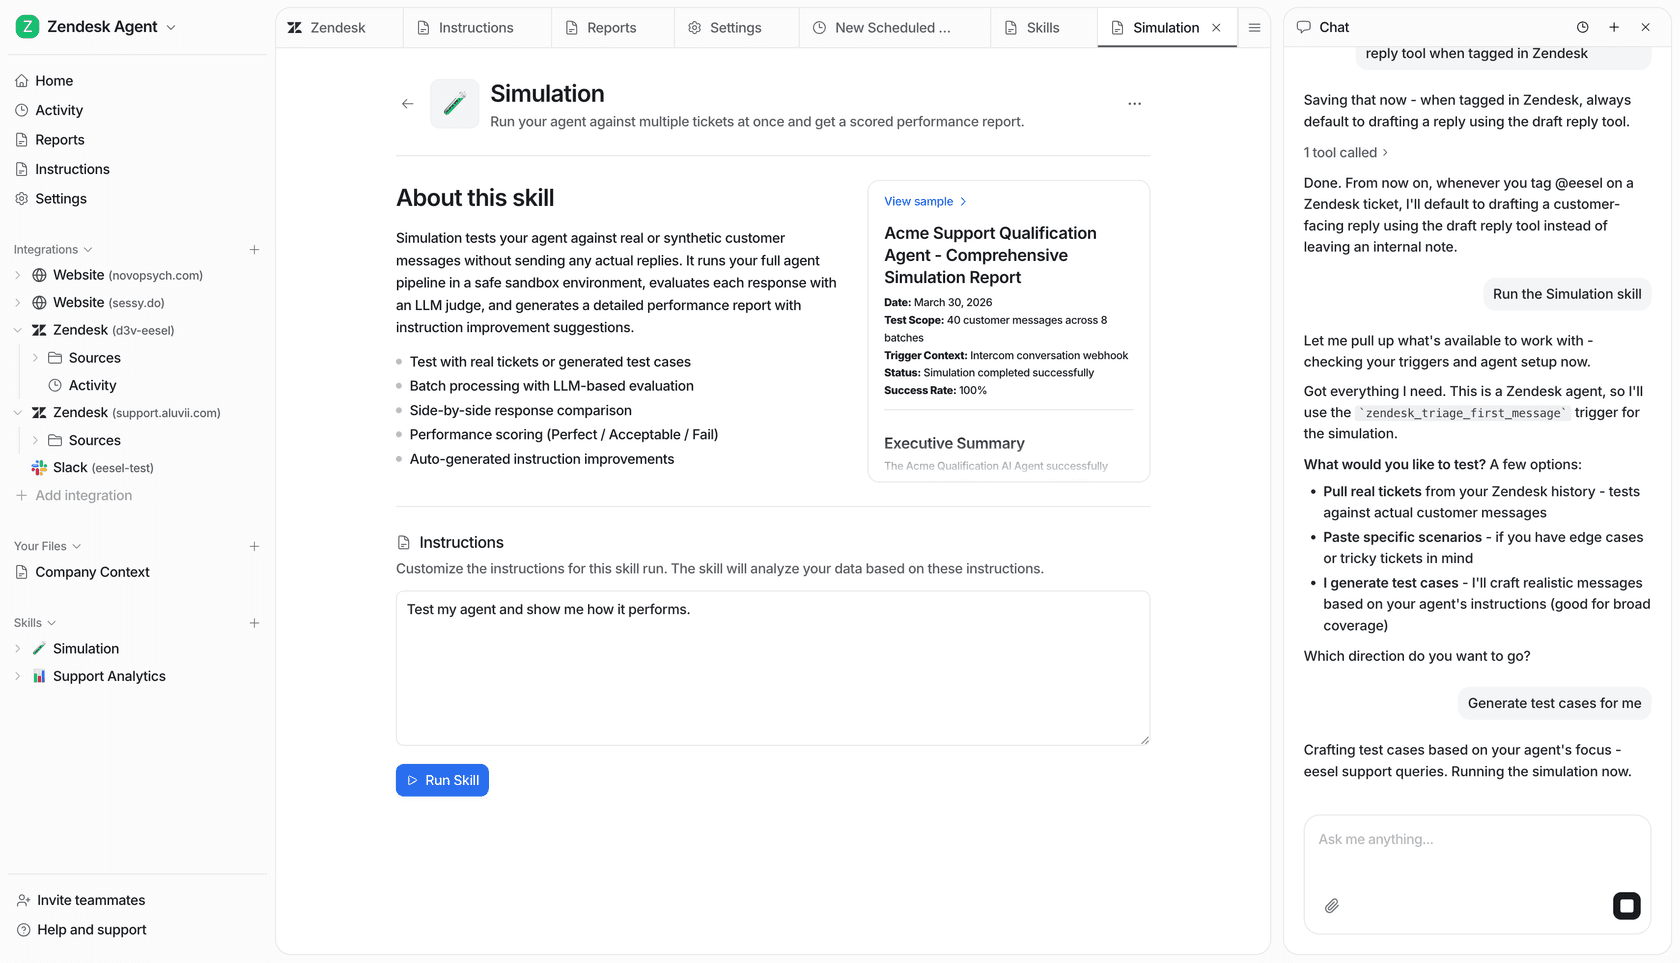
Antes de ir ao ar, a eesel pode simular o colega de equipe contra seus tickets passados e avaliar as respostas comparando com o que sua equipe realmente enviou, para que você encontre as lacunas numa execução segura em vez de na frente de um cliente. Você pode começar com $50 de uso grátis e sem cartão de crédito. Se você está decidindo em qual modelo construir seu suporte, essa é a camada que faz a escolha do modelo importar muito menos. Experimente a eesel de graça.
Perguntas frequentes
Qual é a melhor alternativa ao GPT-6 Astra?
Quanto custa o GPT-6 Astra comparado às alternativas?
Existe uma alternativa mais barata ao GPT-6 Astra para atendimento ao cliente?
Quais alternativas ao GPT-6 Astra têm pesos abertos?
O que acontece se eu simplesmente esperar o preço cair em vez de trocar?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.