O que é o Claude Fable 5.1?
Eu construo os agentes de IA no eesel, então um novo modelo de fronteira não é para mim uma corrida abstrata de benchmarks, é o motor sobre o qual meus colegas de equipe rodam. Quando a Anthropic lançou o Fable 5.1 em 1º de setembro de 2026, a primeira coisa que fiz foi ler o que realmente mudou por trás do marketing, e há uma história genuína além de "nosso novo modelo lidera as tabelas".
O Claude Fable 5.1 é o modelo de disponibilidade geral mais capaz da Anthropic, apresentado em sua página de produto como o modelo mais avançado do mundo para codificação e trabalho de conhecimento. É o sucessor do Fable 5 e fica no topo absoluto da família Claude 5, acima do Claude Opus 5. O ID do modelo na API é claude-fable-5-1.
Algumas especificações que vale a pena fixar antes de mais nada:
- Janela de contexto: uma janela de 1M de tokens, tanto padrão quanto máxima, com preço fixo por token em toda a janela (sem camada de sobretaxa para contexto longo).
- Saída máxima: 128 mil tokens.
- Thinking: o thinking adaptativo está sempre ativo, e você ajusta sua profundidade com um parâmetro
effortque por padrão é alto. - Disponibilidade: a API, Amazon Bedrock, Google Cloud Vertex AI e Microsoft Foundry, além dos planos Pro, Max, Team e Enterprise. Não está disponível no nível gratuito.
Também existe o Claude Mythos 5.1, o mesmo modelo subjacente com salvaguardas mais permissivas, disponível apenas para participantes do Project Glasswing (ciberdefensores e cientistas da vida verificados). Para quase todo mundo, o Fable 5.1 é o que você realmente vai chamar.
Uma observação honesta enterrada nas próprias orientações da Anthropic: elas recomendam começar com o Opus 5 para a maioria das cargas de trabalho e só recorrer ao Fable 5.1 quando o Opus 5 em esforço mais alto ainda não for suficiente, ou para os projetos de longo prazo mais ambiciosos. É um toque revigorante de "não pague demais pelo nosso carro-chefe", e isso deveria moldar como você pensa sobre esse modelo. É uma ferramenta especializada, não a escolha padrão.
O que realmente mudou desde o Fable 5
Aqui está a parte que considero genuinamente inteligente, e não é um número de benchmark. O Fable 5.1 mantém idêntica cada tarifa base do Fable 5 e, discretamente, torna 75% mais barato justamente o medidor que domina as contas agênticas.
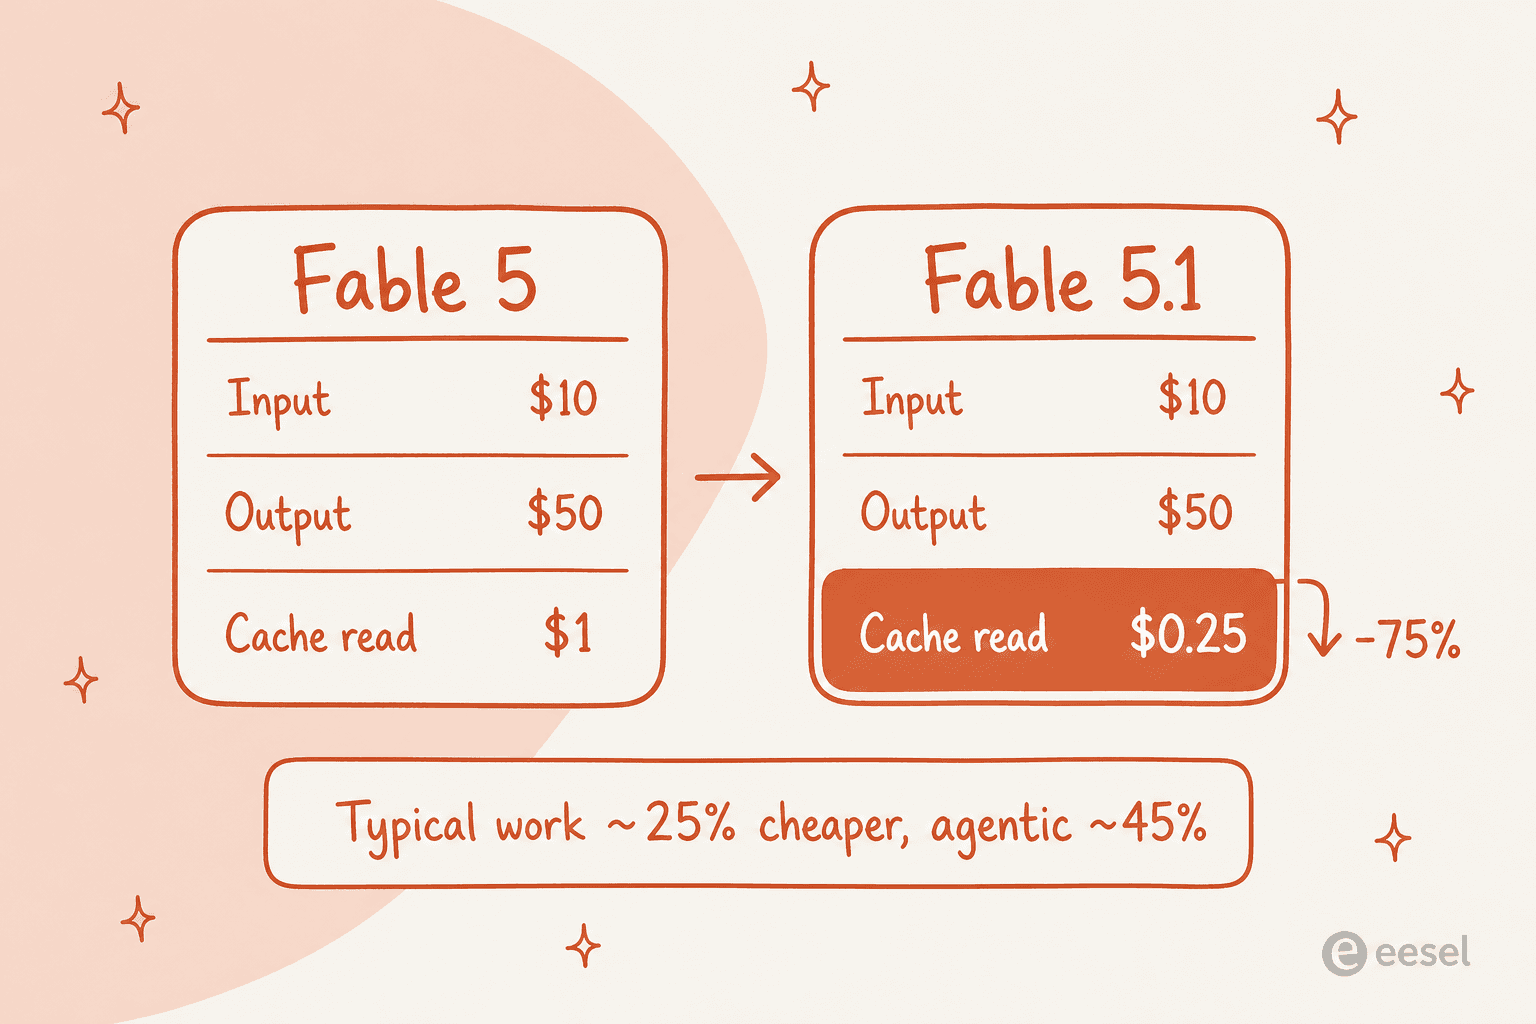
As leituras de cache caíram de US$ 1 para US$ 0,25 por milhão de tokens. Se você nunca rodou um loop de agente que realmente importa, isso parece um erro de arredondamento. Não é. Uma sessão agêntica longa relê o mesmo prefixo em cache (seu prompt de sistema, sua base de código, seu histórico de tickets) a cada etapa, então as leituras de cache se acumulam muito mais rápido do que a entrada nova. A Anthropic mediu quatro semanas de uso real de agosto de 2026 e estimou a economia efetiva em cerca de 25% em cargas de trabalho típicas e até 45% nas altamente agênticas.
O desenvolvedor Lance Martin expôs o ângulo do valor com clareza no dia do lançamento:
"Fable 5.1 at low effort is often competitive with Opus and Sonnet on $ / task while scoring higher. on CursorBench 3.2.0, Fable 5.1 at low effort is at parity w/ Fable 5 at high effort at a third of the cost."
Além do preço, os ganhos de capacidade se concentram em seis áreas, segundo a documentação: codificação agêntica em sessões de várias horas, trabalho de conhecimento (documentos, planilhas, apresentações), pesquisa em múltiplas etapas, visão em PDFs densos e gráficos, raciocínio ao longo de toda a janela de 1M, e uso de computador. O desempenho multilíngue está no mesmo nível do Fable 5, não é uma área de ganho, e é bom que a Anthropic diga isso em vez de sugerir que tudo melhorou.
Duas outras mudanças importam para quem constrói sobre ele:
- Uma marca d'água de texto (nova). Toda saída de texto agora carrega a marca d'água estatística de texto da Anthropic para conformidade com o AI Act da UE. Não adiciona tokens nem caracteres ocultos, mas torna a saída identificável como gerada pelo Claude.
- Mudanças significativas na API. O uso forçado de ferramentas acabou (um
tool_choicedeanyoutoolagora retorna um erro 400), os blocos de thinking ficam vinculados ao modelo, e editar turnos anteriores invalida o thinking. Se você está construindo sua própria CLI de codificação agêntica ou loop de ferramentas, leia as notas de migração antes de atualizar.
Preços do Claude Fable 5.1
Vamos colocar toda a tabela de preços em um só lugar. Todos os preços são por milhão de tokens (MTok), em USD, retirados da documentação de preços da plataforma.
| Medidor | Claude Fable 5.1 | Claude Fable 5 (anterior) |
|---|---|---|
| Entrada base | $10 | $10 |
| Saída | $50 | $50 |
| Leituras de cache | $0.25 | $1 |
| Escritas de cache de 5 min | $12.50 | $12.50 |
| Escritas de cache de 1 hora | $20 | $20 |
| Batch (entrada / saída) | $5 / $25 | $5 / $25 |
A única linha que mudou foi a de leituras de cache. Todo o resto é idêntico ao Fable 5. Também há inferência exclusiva nos EUA a 1,1x para cargas de trabalho que precisam permanecer nos EUA.
Onde isso deixa o Fable 5.1 em relação ao restante da linha atual?
| Modelo | Entrada | Leitura de cache | Saída |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $0.25 | $50 |
| Claude Opus 5 | $5 | $0.50 | $25 |
| Claude Sonnet 5 | $2 | $0.20 | $10 |
O Fable 5.1 continua sendo o Claude atual mais caro em entrada e saída base, 2x o Opus 5 e 5x o Sonnet 5. Mas note que sua leitura de cache de US$ 0,25 é, na verdade, mais barata por token do que a do Opus 5, de US$ 0,50. Esse é todo o objetivo da mudança: tornar um modelo carro-chefe econômico para as releituras repetitivas que definem o trabalho de agentes.
Um exemplo prático. Digamos que um agente relê um contexto em cache de 150 mil tokens a cada uma de 1.000 chamadas de ferramenta em uma sessão longa. São 150M de tokens de leitura de cache. No Fable 5, isso custa US$ 150; no Fable 5.1, o mesmo trabalho custa US$ 37,50. Multiplique isso por toda uma frota de agentes rodando o dia todo e o truque de "mesmo modelo, cache mais barato" deixa de parecer um erro de arredondamento.
Uma ressalva da comunidade: mesmo nos planos de consumidor mais altos, as pessoas relatam atingir limites de uso rapidamente com modelos de classe Fable, o que é uma questão separada da tabela de preços por token. Para os valores exatos das assinaturas Pro, Max e Team, confira diretamente claude.com/pricing e nosso detalhamento de preços do Claude Pro para o ângulo do consumidor.
Se você está comparando entre fornecedores, nossos guias de preços do Gemini, preços do GPT-5.3 Codex e visão geral do Gemini usam a mesma abordagem.
O que o Claude Fable 5.1 realmente consegue fazer
A Anthropic relata que o Fable 5.1 lidera todos os benchmarks listados. Aqui estão os que dizem algo relevante, todos produzidos com as salvaguardas de produção ativadas (mais sobre essa ressalva abaixo).
| Benchmark (o que mede) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 (pesquisa agêntica) | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 (codificação agêntica) | 55.8% | 42.0% | 52.3% | 37.3% |
| AutomationBench (fluxos de trabalho empresariais) | 31.4% | 17.1% | 26.9% | 19.6% |
| OSWorld 2.0, parcial (uso de computador) | 77.9% | 72.9% | 75.4% | - |
| Humanity's Last Exam, com ferramentas | 65.0% | 63.8% | 63.6% | - |
| CursorBench 3.2.0 (codificação agêntica) | 73.4% | 70.5% | 70.0% | 67.2% |
Os saltos mais notáveis são Terminal-Bench-Science (de 24.7% para 52.6%, mais que o dobro) e AutomationBench (de 17.1% para 31.4%). Ambos apontam na mesma direção: esse modelo ficou muito melhor em trabalho longo e autodirigido.
Agora a parte honesta, porque tabelas de benchmark do dia de lançamento sempre merecem uma pitada de desconfiança. Um comentarista do Hacker News disse em voz alta o que muitos pensam calados:
"There are hundreds of benchmarks. You just need to pick a favorable dozen on release day."

Justo. O que mais me convenceu do que a tabela foram as execuções reais e verificáveis de longo horizonte no anúncio. A Ramp o deixou rodar sem supervisão por 38 horas em um problema de machine learning, onde ele diagnosticou um resultado anterior como um artefato de rotulagem, corrigiu e iniciou seis experimentos noturnos em paralelo. A Millennium disse que ele encontrou a causa de uma falha que ocorria uma vez a cada milhão de execuções e que nenhum engenheiro ou modelo tinha decifrado em quatro a cinco anos. E no benchmark de agentes de navegador mais difícil da Browserbase, ele completou 82% das tarefas contra 74% do Opus 5 e 57% do Fable 5, usando menos tokens. Esse é o tipo de resultado que uma pontuação de benchmark não consegue transmitir por completo.
Profissionais que o testaram ecoaram a história da codificação:
"I've tested Claude Fable 5.1 over the last week. Everyone should try this model... this model is delight to work with and has the depth of the Fable models. I really trust this model"
Se você está avaliando-o lado a lado com outros modelos de codificação, nosso panorama dos melhores assistentes de codificação com IA, dos principais agentes de IA e das alternativas ao GPT-5.3 Codex é um bom ponto de partida para calibrar expectativas.
Como funciona a configuração de esforço
A coisa mais útil para entender sobre o Fable 5.1 na prática não é um benchmark, é o controle effort.
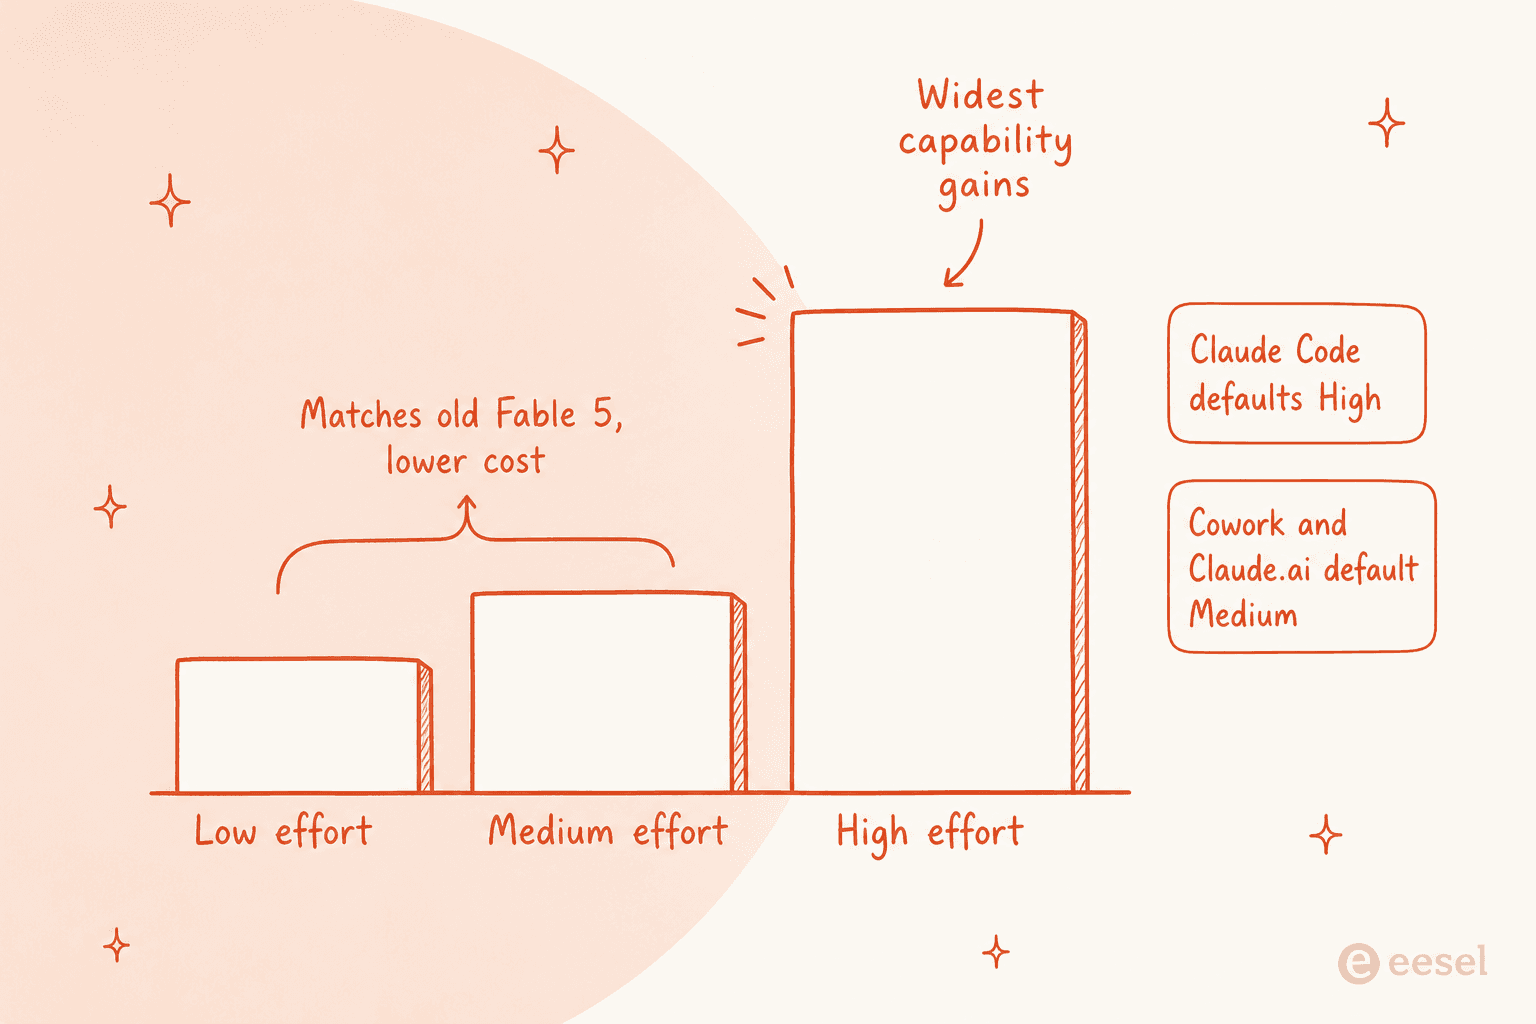
O thinking adaptativo está sempre ativo, e effort controla o quanto dele você recebe. O objetivo de design declarado pela Anthropic é que, em esforço baixo ou médio, o Fable 5.1 iguale ou supere o Fable 5 a um custo muito menor; a diferença em relação ao Fable 5 é maior no esforço alto. Os padrões diferem conforme a superfície: alto no Claude Code, médio no Claude Cowork e no Claude.ai. Assim, o mesmo modelo pode ser um cavalo de batalha econômico ou um especialista de profundidade máxima dependendo de um único parâmetro, o que é exatamente o que faz as leituras de cache mais baratas valerem a pena.
Isso não é uma vitória clara para todos, porém. Um desenvolvedor que trabalha com linguagens menos comuns rebateu:
"I write a lot of Rust and Lean, Fable 5 is in my experience better at both. Cost/performance is a different story."
Isso é um lembrete útil: "lidera todos os benchmarks" é uma média, e sua carga de trabalho pode estar na cauda onde o modelo anterior ainda vence em qualidade bruta. Teste em suas próprias tarefas antes de migrar, do mesmo jeito que abordaria qualquer decisão de otimização de LLM.
A pegadinha: salvaguardas e confiança
Tento ser justo com toda ferramenta sobre a qual escrevo, e isso vale nos dois sentidos: a maior reclamação recorrente sobre o Fable 5.1 no dia do lançamento não foi a capacidade, foram as recusas.
A Anthropic realmente tornou as salvaguardas mais precisas. Usuários do Claude Code podem esperar cerca de 60% menos intervenções de salvaguarda cibernética por sessão em relação ao Fable 5, e as salvaguardas de biologia agora disparam 85% menos em perguntas escolares inofensivas. Quando uma consulta é sinalizada, ela é redirecionada para um modelo Opus e você não é cobrado pelos preços do Fable por isso. Essas são melhorias reais e mensuráveis.
Mas desenvolvedores ainda encontram falsos positivos, às vezes no próprio código:
"Fable is useless. Me: 'Find my security problems in my own code. This is code I own. I'm doing this under authorization of the CEO/CTO of our company.' Fable: 'yeah, no.'"
"The main issue was that Fable was unpredictable and prone to false positives by the safeguards... it still seems completely unable to understand its own guardrails and will readily reason itself into triggering them."
Some a isso a nova marca d'água e os blocos de thinking vinculados ao modelo, e há uma corrente real de pessoas que sentem que o modelo está confiando menos nelas à medida que fica mais capaz. Se essa troca vale a pena depende inteiramente do seu trabalho; uma equipe de segurança defensiva sente isso muito mais do que alguém que redige documentos. É um fato a ser ponderado, não um fator decisivo para a maioria.
Onde o Fable 5.1 se encaixa se você lidera suporte ou escreve conteúdo
Aqui está a reformulação que eu defenderia, e é o que mais de três anos colocando IA em filas de suporte ao vivo nos ensinaram no eesel: você não contrata um modelo, você contrata um colega de equipe que usa um.
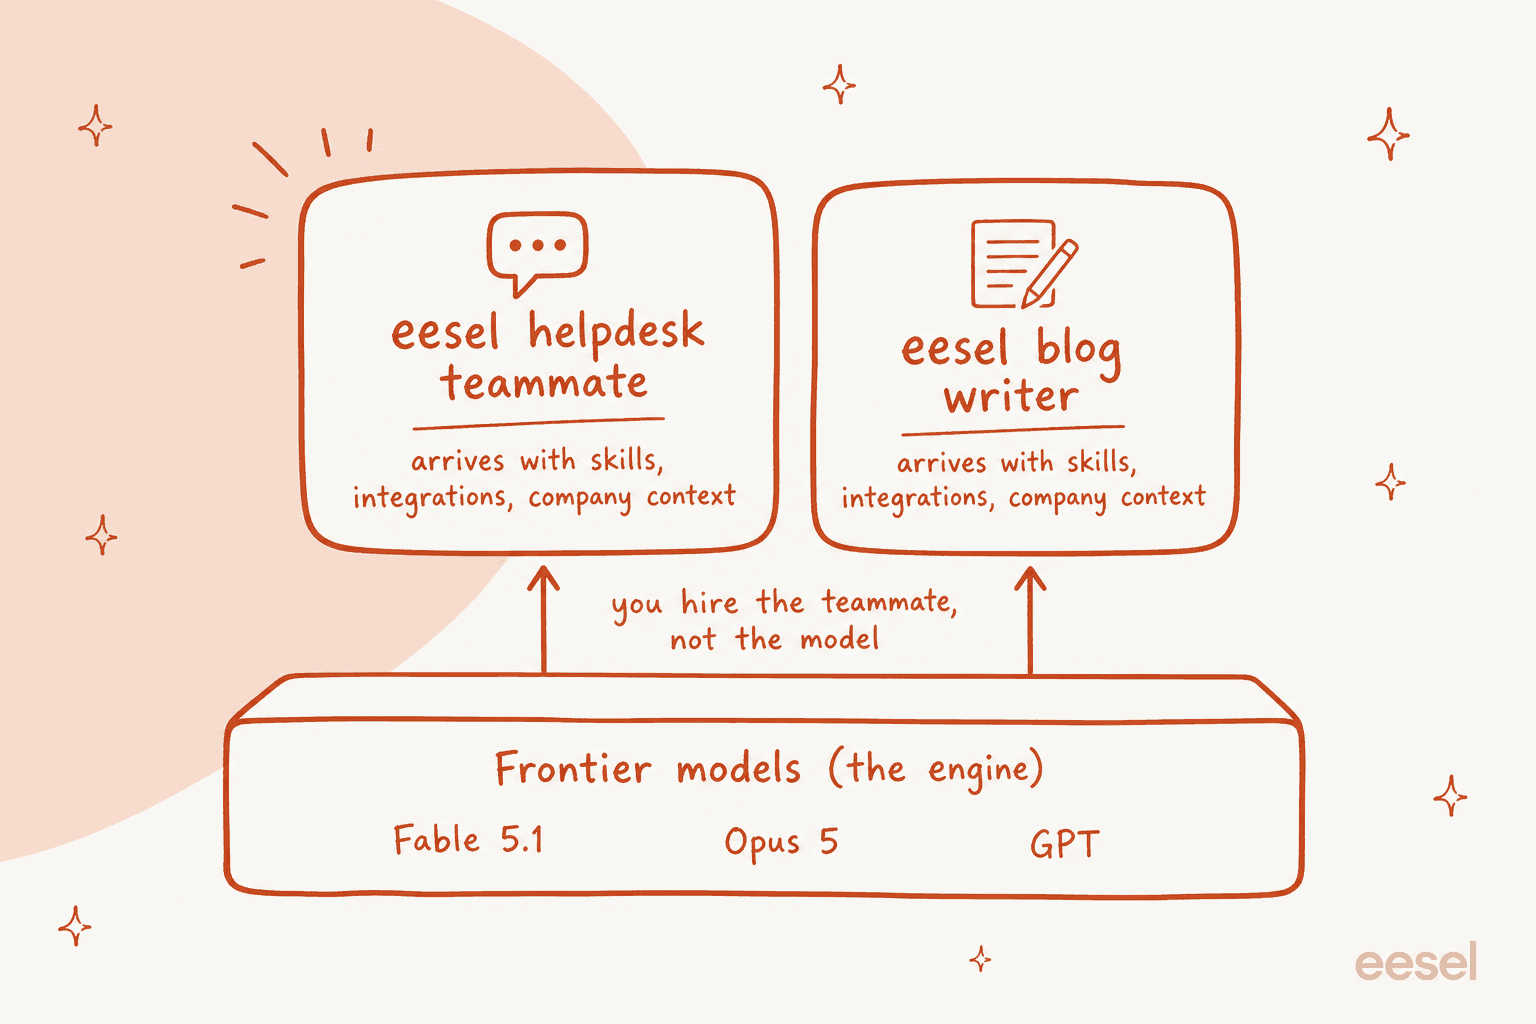
O Fable 5.1 é infraestrutura, o motor bruto. Um gestor de suporte não quer escrever um loop de ferramentas, conectar recuperação sobre tickets antigos, lidar com recusas e administrar um orçamento de tokens, ele quer tickets resolvidos. Essa lacuna entre um modelo de fronteira e uma solução funcional é exatamente onde um produto como o eesel vive. Nosso agente de helpdesk com IA roda sobre modelos de fronteira como este, mas chega já treinado na sua central de ajuda e nos tickets anteriores, conectado ao helpdesk que você já usa.

E porque já vimos bots de voz confiante darem respostas erradas tranquilamente, todo lançamento do eesel é simulado contra seus tickets históricos antes de tocar em um cliente real, para que você veja como ele vai realmente se sair. Essa é uma proposta bem diferente de chamar você mesmo o claude-fable-5-1. Se você está avaliando opções, nossos guias sobre a melhor IA de atendimento ao cliente e a automação de IA para atendimento ao cliente mostram o que procurar, e construir um GPT de suporte personalizado mostra o caminho DIY se você preferir ir pelo modelo bruto.
Se você está mapeando a categoria primeiro, nossos guias sobre o melhor software de helpdesk com IA, os chatbots de atendimento ao cliente com IA e um copiloto de IA para suporte traçam o panorama.
O lado do conteúdo tem a mesma forma. A escrita do Fable 5.1 melhorou de verdade, a Canva chamou de "o destaque é a escrita" e avaliadores da Glean preferiram suas respostas em cerca de 2 para 1 em relação ao Fable 5. Mas uma prosa melhor de um modelo bruto ainda não faz pesquisa de palavras-chave, não posiciona links internos nem busca fontes reais.
Essa estrutura é o verdadeiro trabalho, por isso um redator de blog com IA supera uma simples janela de chat para trabalho de publicação, e por isso nosso panorama de ferramentas de redação de blog com IA existe.
Sobre o fluxo de trabalho em si, já exploramos a automação de blog com IA, a redação de IA em formato longo e o verdadeiro custo de um redator de blog com IA.
Experimente o eesel para suporte e conteúdo
O eesel é uma plataforma de colegas de equipe de IA: em vez de um modelo bruto, você contrata colegas prontos para trabalhar em funções específicas. O colega de helpdesk com IA entra na sua fila de suporte, e o redator de blog com IA pesquisa e redige conteúdo SEO, ambos rodando sobre modelos de fronteira como o Fable 5.1, mas chegando com as habilidades, integrações e contexto da empresa para a função.
A diferença em relação a conectar um modelo você mesmo é que o eesel entra no ar em minutos sobre as ferramentas que você já usa, treina com seu conhecimento existente e permite simular um colega de equipe com dados reais do passado antes de ir ao ar. Você pode experimentar o eesel gratuitamente, sem cartão de crédito e sem ligação de vendas, e ver como ele responde aos seus próprios tickets ou redige seus próprios posts antes de se comprometer.
O Fable 5.1 é um motor notável. A maioria das equipes só quer o trabalho pronto que ele torna possível, e essa é a parte que nós construímos.
Perguntas frequentes
Quanto custa o Claude Fable 5.1?
Qual é a diferença entre o Claude Fable 5.1 e o Fable 5?
O Claude Fable 5.1 é melhor que o Claude Opus 5?
Posso usar o Claude Fable 5.1 para atendimento ao cliente?
O Claude Fable 5.1 coloca marca d'água em seus textos?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.