O que o Fable 5.1 realmente é
Deixe-me ser preciso sobre o que foi lançado, porque os nomes ficam confusos rápido. O Claude Fable 5.1 é o sucessor do Fable 5 e o topo da linha da Anthropic. O ID do modelo na API é claude-fable-5-1. Também existe o Mythos 5.1, o mesmo modelo subjacente com salvaguardas mais leves, disponível apenas para participantes aprovados do Project Glasswing (ciberdefensores e cientistas da vida). Quando você vir um número de benchmark, ele é do Fable 5.1, a menos que o Mythos seja mencionado explicitamente.
As especificações são de ponta: uma janela de contexto de 1M de tokens com preço fixo por token em toda a janela, saída máxima de 128k, e pensamento adaptativo que fica sempre ativo e é ajustado por um parâmetro effort (padrão alto). A Anthropic o posiciona para "raciocínio exigente e trabalho agêntico de longo horizonte", e a orientação da própria empresa é reveladora: comece com o Opus 5 para a maioria dos trabalhos, e recorra ao Fable 5.1 apenas quando o Opus 5 em esforço mais alto ainda não for suficiente. É uma orientação incomumente honesta, e foi o quadro ao qual eu voltava sempre durante os testes.
Como engenheiro que passa a maior parte dos dias conectando modelos a um produto real, o que me importa não é o ranking, é se o modelo aguenta uma execução longa, bagunçada e com várias ferramentas sem que eu precise ficar vigiando. É exatamente aí que o Fable 5.1 mira.
O único número que mudou: o preço
Aqui está o preço, porque uma análise que diz apenas "a partir de $10" não está fazendo seu trabalho direito.
| Métrica | Fable 5.1 | Fable 5 | Mudança |
|---|---|---|---|
| Entrada (por MTok) | $10 | $10 | inalterado |
| Saída (por MTok) | $50 | $50 | inalterado |
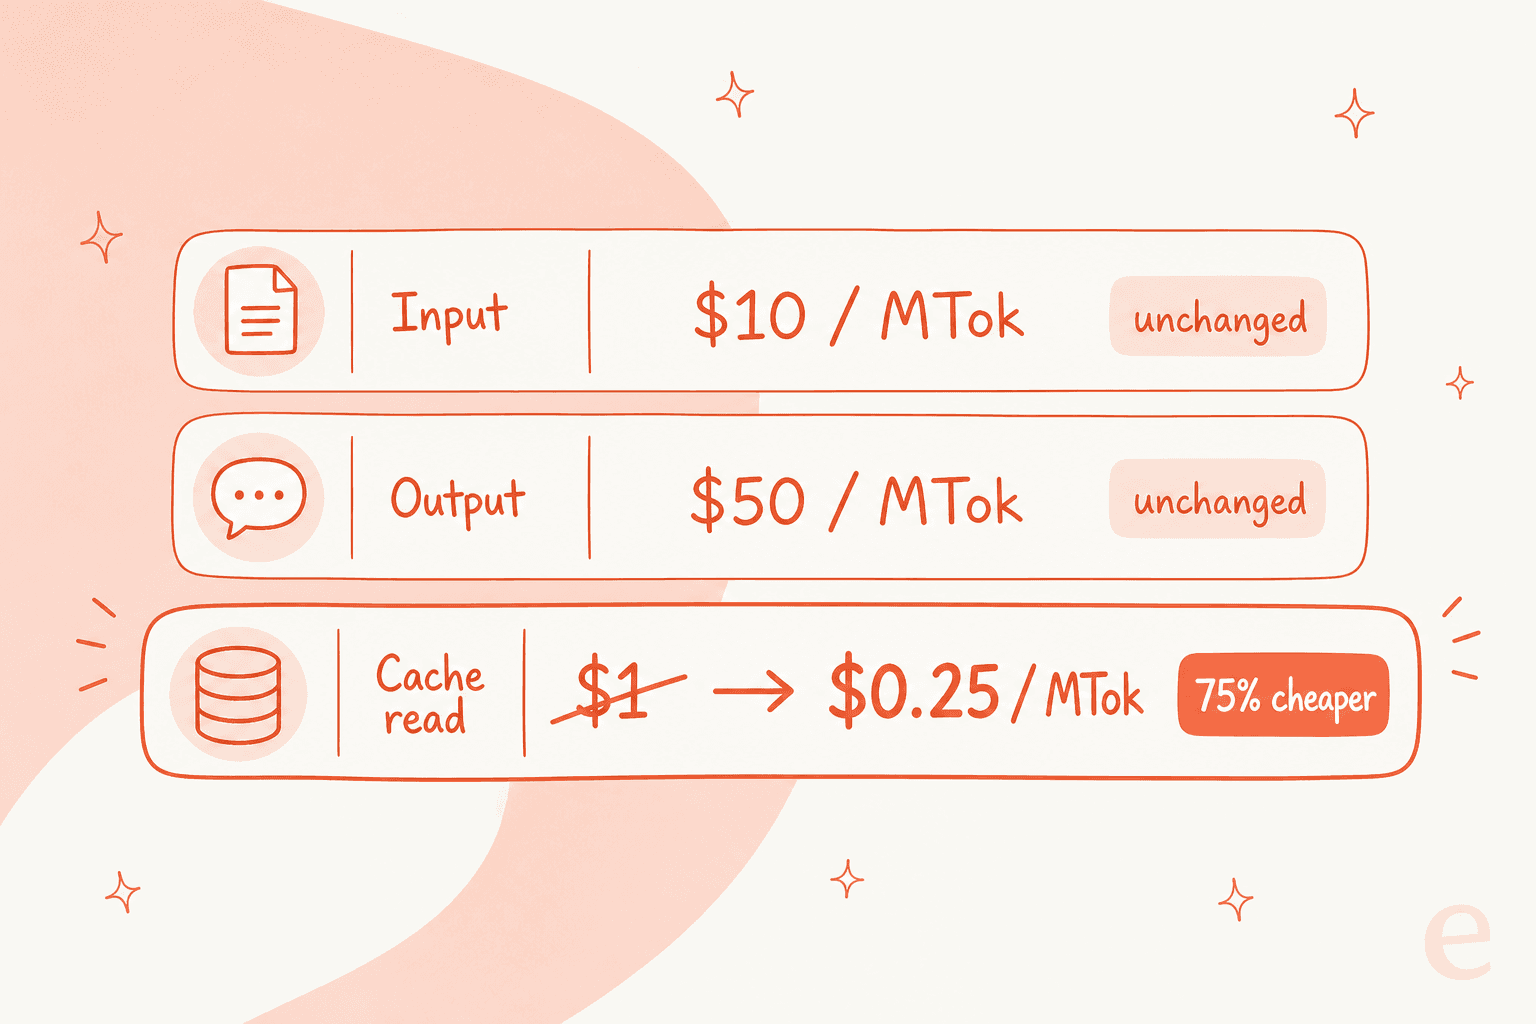
| Leitura de cache (por MTok) | $0,25 | $1,00 | 75% mais barato |
| Escrita de cache, 5 min (por MTok) | $12,50 | $12,50 | inalterado |
| Escrita de cache, 1h (por MTok) | $20 | $20 | inalterado |
| Entrada / saída em lote (por MTok) | $5 / $25 | $5 / $25 | inalterado |
O corte nas leituras de cache é toda a história em termos de custo. A Anthropic estima que ele reduz o custo de uma carga de trabalho típica em cerca de 25% e de uma altamente agêntica em até 45%, porque execuções agênticas releem o mesmo contexto em cache a cada turno. Para contextualizar, a leitura de cache de $0,25 do Fable 5.1 é, na verdade, mais barata por token do que a do Opus 5, de $0,50, mesmo que a entrada base do Opus 5 custe metade do preço. Se sua carga de trabalho depende muito de cache, a conta pende mais para o Fable do que as taxas de destaque sugerem.
Duas ressalvas que vale a pena conhecer antes de orçar. A inferência exclusiva nos EUA carrega um multiplicador de 1,1x, e o Fable 5.1 não está no nível gratuito, é preciso ter Pro, Max, Team ou Enterprise. O lançamento também provocou a alfinetada esperada entre modelos concorrentes, quando uma conta no X apontou que "o Fable 5.1 cobra 6 vezes mais que o GPT-5.6 Sol". Isso é verdade no preço de tabela, e é a comparação errada se o seu trabalho for uma longa execução agêntica em que a eficiência de tokens e a taxa de sucesso decidem a conta real.
Os benchmarks, e o quanto confiar neles
No papel, o Fable 5.1 arrasa. A Anthropic relata que ele lidera todas as avaliações que publica, e os dois maiores saltos em relação ao Fable 5 merecem atenção.
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
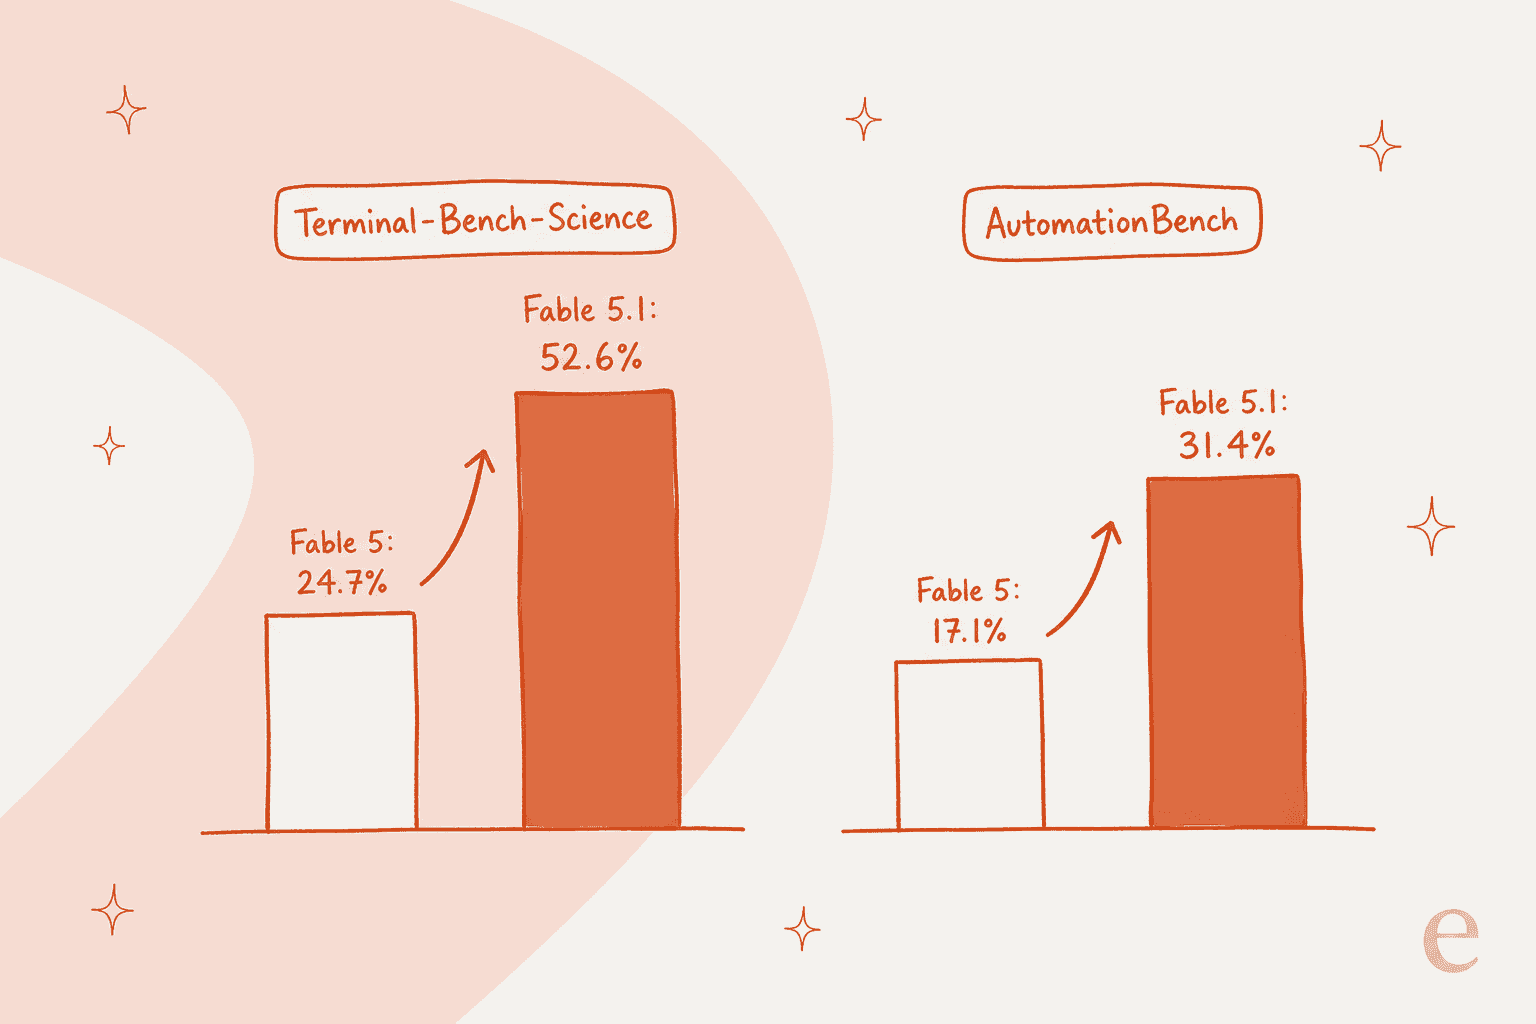
| Terminal-Bench-Science (ciência agêntica) | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 (codificação agêntica) | 55,8% | 42,0% | 52,3% | 37,3% |
| GDPval-AA v2 (trabalho de conhecimento, Elo) | 1853 | 1723 | 1824 | 1711 |
| AutomationBench (fluxos de trabalho empresariais) | 31,4% | 17,1% | 26,9% | 19,6% |
| CursorBench 3.2.0 (codificação agêntica) | 73,4% | 70,5% | 70,0% | 67,2% |
| Humanity's Last Exam (com ferramentas) | 65,0% | 63,8% | 63,6% | - |
| OSWorld 2.0 partial (uso de computador) | 77,9% | 72,9% | 75,4% | - |
O salto no Terminal-Bench-Science, de 24,7% para 52,6%, é o que chama a atenção: a pesquisa científica agêntica mais que dobrou. O quase dobro do AutomationBench importa mais para o comprador médio, já que é um indicador de fluxos de trabalho empresariais bagunçados.
Agora a parte honesta, que a página de marketing majoritariamente enterra. Todos esses números do Fable 5.1 foram produzidos com as salvaguardas de produção ativadas, e a Anthropic observa que, onde as salvaguardas intervieram, o Fable 5.1 pontuou zero nessas tarefas, então o teto real de capacidade (aproximado pelo Mythos 5.1, com salvaguardas mais leves, que atinge 60,9% no Terminal-Bench 4.0) é mais alto. E há um erro padrão de aproximadamente 3,5 a 4,5 pontos no benchmark de ciência. Os benchmarks aqui são um sinal direcional, não uma régua.
O reflexo de ceticismo da comunidade é saudável, e eu compartilho dele:
"Como é possível que todos os modelos da xAI, OpenAI, Anthropic, Qwen etc. vençam todos os benchmarks a cada lançamento? Amanhã todos os anteriores (exceto a Anthropic, claro) vão subir o número da versão e estar no topo do HN vencendo todos os benchmarks."

Por isso, dou mais peso às execuções de clientes divulgadas pela Anthropic do que ao ranking. A Ramp relatou uma única execução não supervisionada de 38 horas que diagnosticou um resultado ruim de ML como um artefato de rotulagem e iniciou seis experimentos durante a noite. A Millennium disse ter encontrado a causa de uma falha de um em um milhão que nenhum engenheiro ou modelo tinha decifrado em quatro a cinco anos. A Browserbase o colocou em 82% das tarefas no seu benchmark de agentes de navegador mais difícil, contra 74% do Opus 5 e 57% do Fable 5, usando menos tokens. Esse é o tipo de resultado de longo horizonte que uma linha de benchmark não consegue capturar.
No que ele é realmente bom
Três coisas se destacaram, e apenas uma delas está em um ranking.
A escrita é a surpresa. Por anos, a reclamação mais frequente sobre o Claude era que sua prosa parecia um memorando de compliance. O Fable 5.1 é a primeira versão em que isso se inverte, e a reação foi imediata:
"Como um usuário fervoroso do Claude Code que migrou para o GPT 5.6 Sol em vez do Opus 5 por causa da prosa difícil de ler, isso me deixa feliz. Eu amo o produto de vocês, mas os modelos atuais são muito difíceis de usar se você precisa trocar de contexto com frequência. Brevidade é essencial."
A Glean disse que seus avaliadores preferiram as respostas do Fable 5.1 numa proporção de aproximadamente 2 para 1 em relação ao Fable 5 em conhecimento cotidiano e redação, e a Canva chamou a escrita de "o destaque". Se você escreve para viver, essa é a melhoria que importa mais do que qualquer pontuação de codificação.
A codificação se mantém em sessões longas. Essa é a promessa e, na maior parte, ela se cumpre. A SpaceXAI (Cursor) o chamou de o modelo mais capaz que já rodaram no CursorBench 3.2, especialmente ao verificar o próprio trabalho, e a Red Hat disse ter encontrado a causa raiz de cada build quebrado que testaram. As demonstrações de um único prompt inundaram o X no dia do lançamento, o que é divertido, mas prova menos do que o trabalho tedioso (encontrar a causa raiz de uma falha de build é o teste de verdade).
As execuções agênticas permanecem nos trilhos. A Every resumiu o ângulo da eficiência como "inteligência do Fable, preço do Opus, velocidade do Sonnet", medindo cerca do dobro da velocidade do Opus 5 usando cerca de metade dos tokens. Um desenvolvedor capturou a versão prática:
"um prompt, 43 minutos, $2,96 - o claude fable 5.1 escreveu um mundo de 1.660 linhas"
Onde ele falha
Uma análise justa nomeia os limites, e o Fable 5.1 tem dois reais.
As recusas ainda são o maior ponto de dor. Isso apareceu repetidamente no dia do lançamento, e não é a reclamação usual de "a IA é cautelosa demais", são desenvolvedores incapazes de fazer trabalho legítimo de segurança no próprio código:
"O Fable é inútil. Eu: "Encontre os problemas de segurança no meu próprio código. Este é um código que eu possuo. Estou fazendo isso sob autorização do CEO/CTO da nossa empresa." Fable: "é, não.""
A própria posição da Anthropic é que as salvaguardas cibernéticas agora são mais precisas, com usuários do Claude Code devendo ver cerca de 60% menos intervenções por sessão do que no Fable 5, e o Fable 5.1 agora consegue identificar vulnerabilidades de forma defensiva. Mas testes de invasão, geração de exploits e varredura de binários ainda são redirecionados para os modelos Opus, e os falsos positivos no próprio código são reais. Um testador resumiu o problema de confiança sem rodeios: ele "ainda parece completamente incapaz de entender suas próprias barreiras e acaba se convencendo a acioná-las."
A marca d'água é um ponto de atrito de confiança. O Fable 5.1 adiciona uma marca d'água estatística de texto em cada saída, para conformidade com a Lei de IA da UE. Ela não adiciona tokens ou caracteres ocultos e não codifica quem você é, mas significa que a Anthropic consegue identificar o texto que o modelo produziu, e alguns usuários ficam incomodados com isso:
"Atenção: a impressão digital do Claude (marca d'água) já está ativa com o Fable 5.1. Isso significa que a Anthropic consegue identificar o texto gerado pelo modelo."

Se requisitos de procedência importam para a sua organização, isso é um recurso. Se você estava contando com uma saída indetectável, é um fator eliminatório. De qualquer forma, saiba que ela existe. Há também algumas mudanças de API que quebram compatibilidade em relação ao Fable 5 que vale a pena revisar se você constrói sobre a API: o uso forçado de ferramentas acabou (um tool_choice de any ou tool agora retorna um 400), os blocos de pensamento são vinculados ao modelo, e a chamada paralela de ferramentas é mais variável.
Quem realmente deveria recorrer a ele
O veredito honesto, por tipo de usuário:
- Você roda trabalhos de agentes longos e autônomos. Sim. Esse é exatamente o terreno natural do modelo, e o corte nas leituras de cache é o que torna execuções de horas de duração acessíveis. Recorra a ele.
- Você escreve ou faz trabalho intenso de conhecimento. Sim, forte, em qualidade. O salto na prosa é real e os resultados em apresentações/planilhas são os melhores que a Anthropic já lançou.
- Você faz codificação e chat do dia a dia. Provavelmente não, pelo menos não por padrão. O Opus 5 é mais barato e a própria Anthropic diz para começar por ali. Suba para o Fable 5.1 quando o Opus 5 em esforço alto travar.
- Você faz pesquisa de segurança. Teste as recusas contra o seu fluxo de trabalho real primeiro. A precisão melhorou, mas os falsos positivos no seu próprio código são uma reclamação atual.
- Você só quer um agente de suporte ou um redator de conteúdo que funcione. Você está comprando na camada errada, mais sobre isso a seguir.
Um modelo não é um colega de equipe
Aqui está a reformulação que quero que você leve consigo, porque é aí que a maioria das perguntas "qual modelo devo comprar" saem dos trilhos. O Fable 5.1 é um motor espetacular. Não é um funcionário. Ele não tem ideia do que seu produto faz, não consegue ver sua central de ajuda nem seus últimos 10.000 tickets, não tem integrações, e não tem como ser testado contra o seu próprio histórico antes de tocar em um cliente real. Comprar acesso a um modelo puro para resolver um problema de suporte ou conteúdo é como contratar a pessoa mais inteligente do mundo e depois entregar a ela zero contexto, zero ferramentas e zero integração.
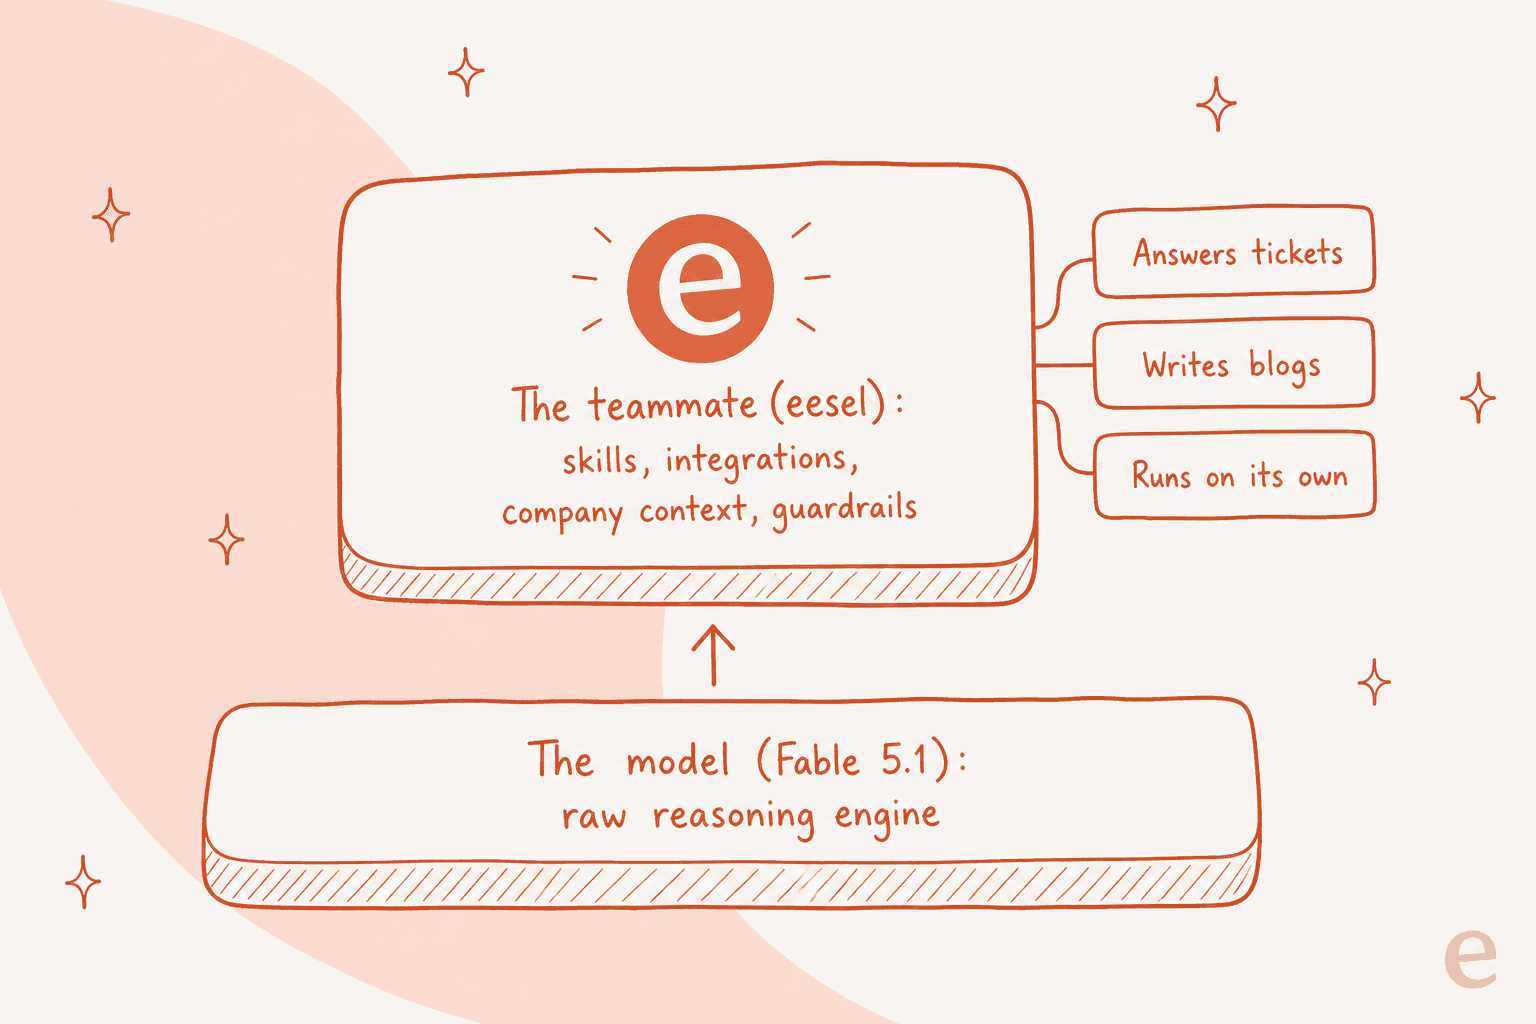
Essa lacuna entre "modelo puro" e "colega de equipe pronto" é o motivo pelo qual a eesel existe. A ideia é simples: você não contrata um modelo, você contrata um colega de equipe pronto para trabalhar em uma função específica. O portfólio atual é um colega de equipe de helpdesk de IA que entra na sua fila de suporte existente, e um redator de blog de IA, e cada um já chega com as habilidades, integrações e contexto da empresa que sua função precisa, rodando sobre um modelo de ponta por baixo.
E, como é totalmente amigável a agentes, você não fica preso a um painel. A CLI da eesel permite que uma pessoa opere o mesmo colega de equipe pelo terminal, permite que scripts o automatizem, e permite que agentes de codificação como Claude Code ou Cursor o operem programaticamente, com MCP e webhooks junto. Se você gostou do que o Fable 5.1 faz dentro do Claude Code, é assim que você aponta essa mesma energia para o seu espaço de suporte em vez de um repositório novo.
Experimente a eesel
Se você chegou até aqui tentando descobrir qual modelo usar para rodar seu suporte ao cliente, a pergunta melhor é qual colega de equipe contratar. A eesel é uma plataforma de colegas de equipe de IA: o colega de equipe de helpdesk de IA se conecta a ferramentas como Zendesk, Freshdesk ou Gorgias em minutos, aprende com seus tickets passados e sua central de ajuda e, crucialmente, permite que você o simule em tickets passados antes que ele responda a um cliente, para que você veja a taxa de resolução e as respostas antecipadamente, em vez de simplesmente apertar um botão e torcer.
Essa etapa de simular antes de lançar é exatamente o que um modelo puro como o Fable 5.1 não consegue te dar, e é por isso que escolher o modelo é a parte fácil, e escolher o colega de equipe é a que realmente decide o seu resultado. Você pode experimentar a eesel gratuitamente.
Perguntas frequentes
Quanto custa o Claude Fable 5.1?
O Claude Fable 5.1 é melhor que o Opus 5?
O que mudou no Claude Fable 5.1 em relação ao Fable 5?
O Claude Fable 5.1 recusa demais?
Eu preciso do Fable 5.1 para rodar um agente de suporte de IA?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.