Você consegue mesmo obter o Claude Mythos 5.1?
Comece por aqui, porque para a maioria dos leitores essa é a pergunta inteira.
Verificação de acesso ao Claude Mythos 5.1
Escolha a descrição mais próxima da sua equipe. Cada resposta é retirada das próprias páginas de acesso da Anthropic, com data de setembro de 2026.
Quem é você?
Talvez, mas ainda não hoje
O Cyber Verification Program é o caminho. Ele já concede salvaguardas cibernéticas reduzidas em modelos de classe Opus e Sonnet, e a Anthropic diz que o acesso à classe Mythos se juntará a ele em breve. As candidaturas passam pelo portal do CVP.
Use hoje: Fable 5.1. Ele agora identifica vulnerabilidades de software no código-fonte, e usuários do Claude Code veem cerca de 60% menos intervenções de salvaguardas cibernéticas por sessão do que no Fable 5.
Só por convite
O Life Sciences Verification Program é uma beta apenas por convite, construída com o governo dos EUA, que relaxa as salvaguardas de biologia para P&D profissional. Os primeiros participantes já estão inscritos; uma inscrição mais ampla é prometida, mas sem cronograma.
Use hoje: Fable 5.1, cujas salvaguardas de biologia agora são acionadas 85% menos em perguntas benignas de biologia elementar e medicina. Consultas de ciências biológicas em nível de pesquisa ainda são encaminhadas para o Opus.
Pergunte à sua equipe de conta
O Claude Mythos 5.1 está listado na API da Claude, Amazon Bedrock, Google Cloud e Microsoft Foundry, e a documentação diz para solicitar acesso através da sua equipe de conta da Anthropic, AWS ou Google Cloud. A disponibilidade ainda é restrita a um conjunto de organizações dos EUA.
Use hoje: Fable 5.1 na mesma plataforma, com as Enterprise Frontier Safeguards chegando em fases neste outono e retenção de dados zero disponível para clientes elegíveis enquanto isso.
Não, e é improvável que isso mude logo
Não há caminho de autoatendimento para o Mythos 5.1. Ambos os programas são organizacionais, verificados e restritos aos EUA. Nem cartão de crédito nem nível de uso te colocam neles.
Use hoje: Fable 5.1 pelo teto, ou Opus 5 a US$ 5 de entrada e US$ 25 de saída, que é o que a própria documentação da Anthropic recomenda como ponto de partida para a maioria das cargas de trabalho.
Não, e você não vai querer
O espaço extra do Mythos 5.1 está em cibersegurança e biologia. Nenhum dos dois aparece em um pedido de reembolso ou um ticket de WISMO. Ele também é o modelo mais lento e mais caro da família, numa fila onde o que o cliente sente é a latência.
Use hoje: Sonnet 5 ou Opus 5 atrás de uma camada que realmente conheça o seu produto. A lacuna numa fila de suporte é grounding e testes, não o nível bruto do modelo.
O que o Claude Mythos 5.1 realmente é
Claude Mythos 5.1 é o modelo de fronteira de classe Mythos da Anthropic, lançado em 1º de setembro de 2026 com o ID de modelo claude-mythos-5-1. Seu status na documentação diz "Active (invite only)", e a desativação está comprometida para não antes de 1º de setembro de 2027.
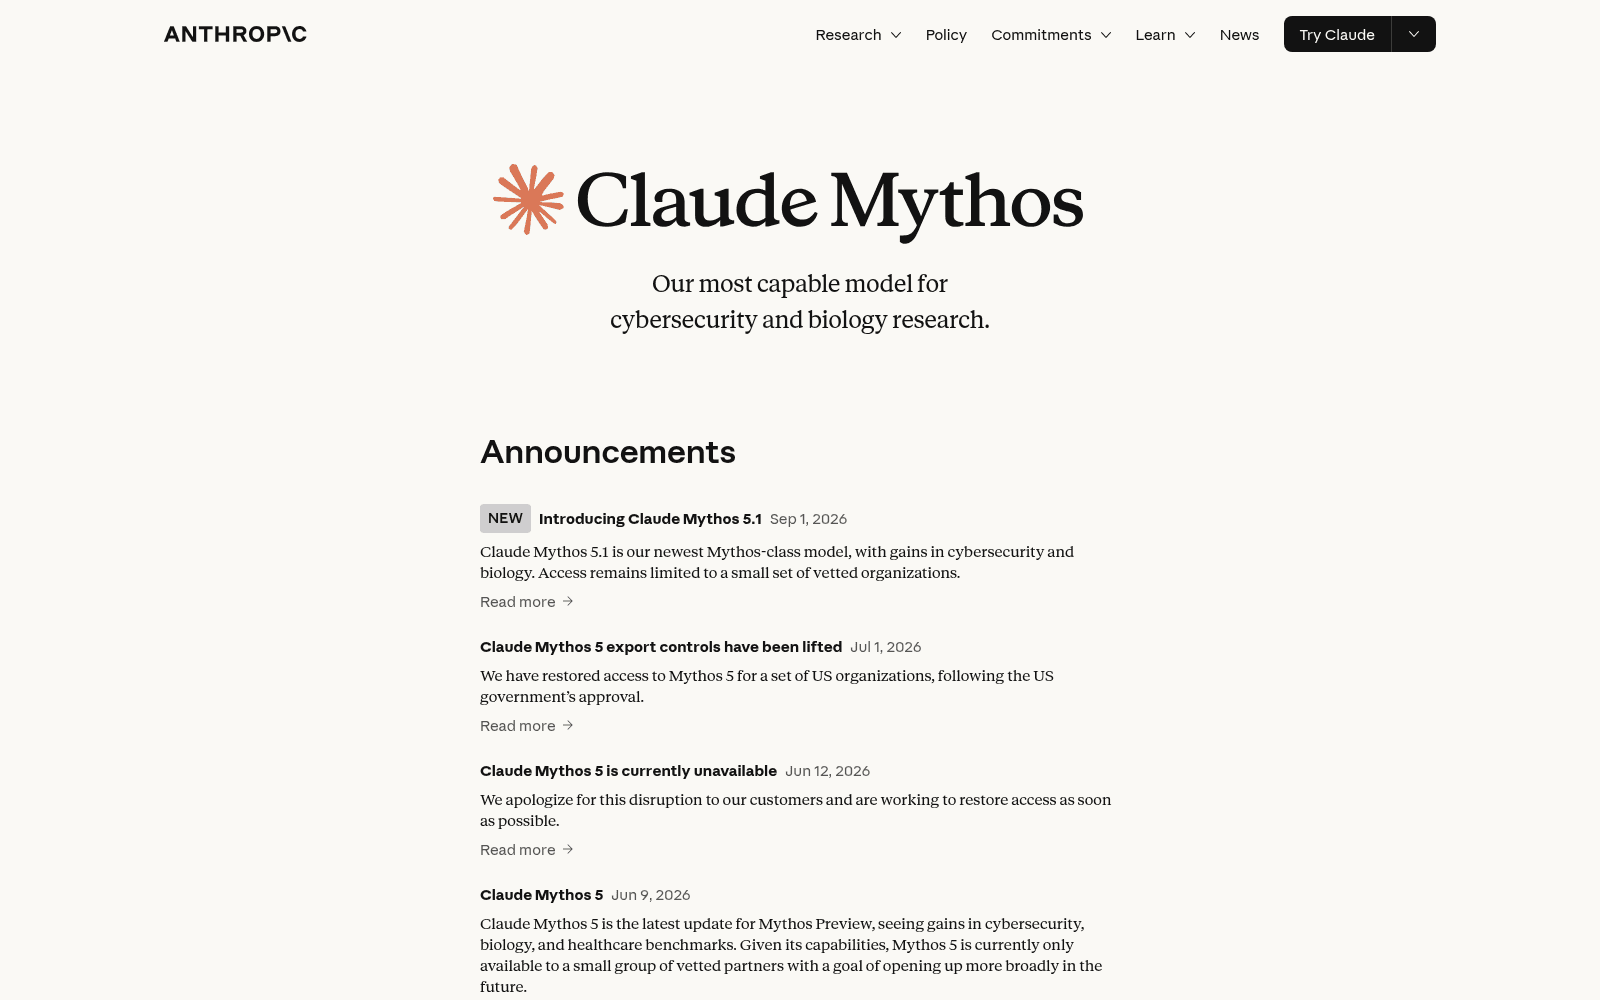
A linha Mythos começou como o Claude Mythos Preview, o modelo não lançado que a Anthropic usou para lançar o Project Glasswing em abril de 2026. O Mythos 5 veio em seguida, em 9 de junho, ficou indisponível em 12 de junho, e teve seus controles de exportação suspensos em 1º de julho após aprovação do governo dos EUA. O Mythos 5.1 é a terceira entrada dessa linha, e a primeira que chega junto com um gêmeo de disponibilidade geral.
Aqui está a ficha técnica, retirada da página do modelo em vez do texto de marketing.
| Especificação | Claude Mythos 5.1 |
|---|---|
| ID do modelo | claude-mythos-5-1 |
| Lançamento | 1º de setembro de 2026 |
| Status | Ativo, apenas por convite |
| Janela de contexto | 1M de tokens |
| Saída máxima | 128K tokens |
| Thinking | Adaptativo, sempre ativo |
| Esforço padrão | high |
| Corte de conhecimento | Junho de 2026 |
| Latência comparativa | Mais lento |
| Entrada / saída | Texto e imagens, para texto |
| Preço de entrada | $10 / MTok |
| Preço de saída | $50 / MTok |
| Leitura de cache | $0.25 / MTok |
| Plataformas | Claude API, Bedrock, Google Cloud, Microsoft Foundry |
| Desativação | Não antes de 1º de setembro de 2027 |
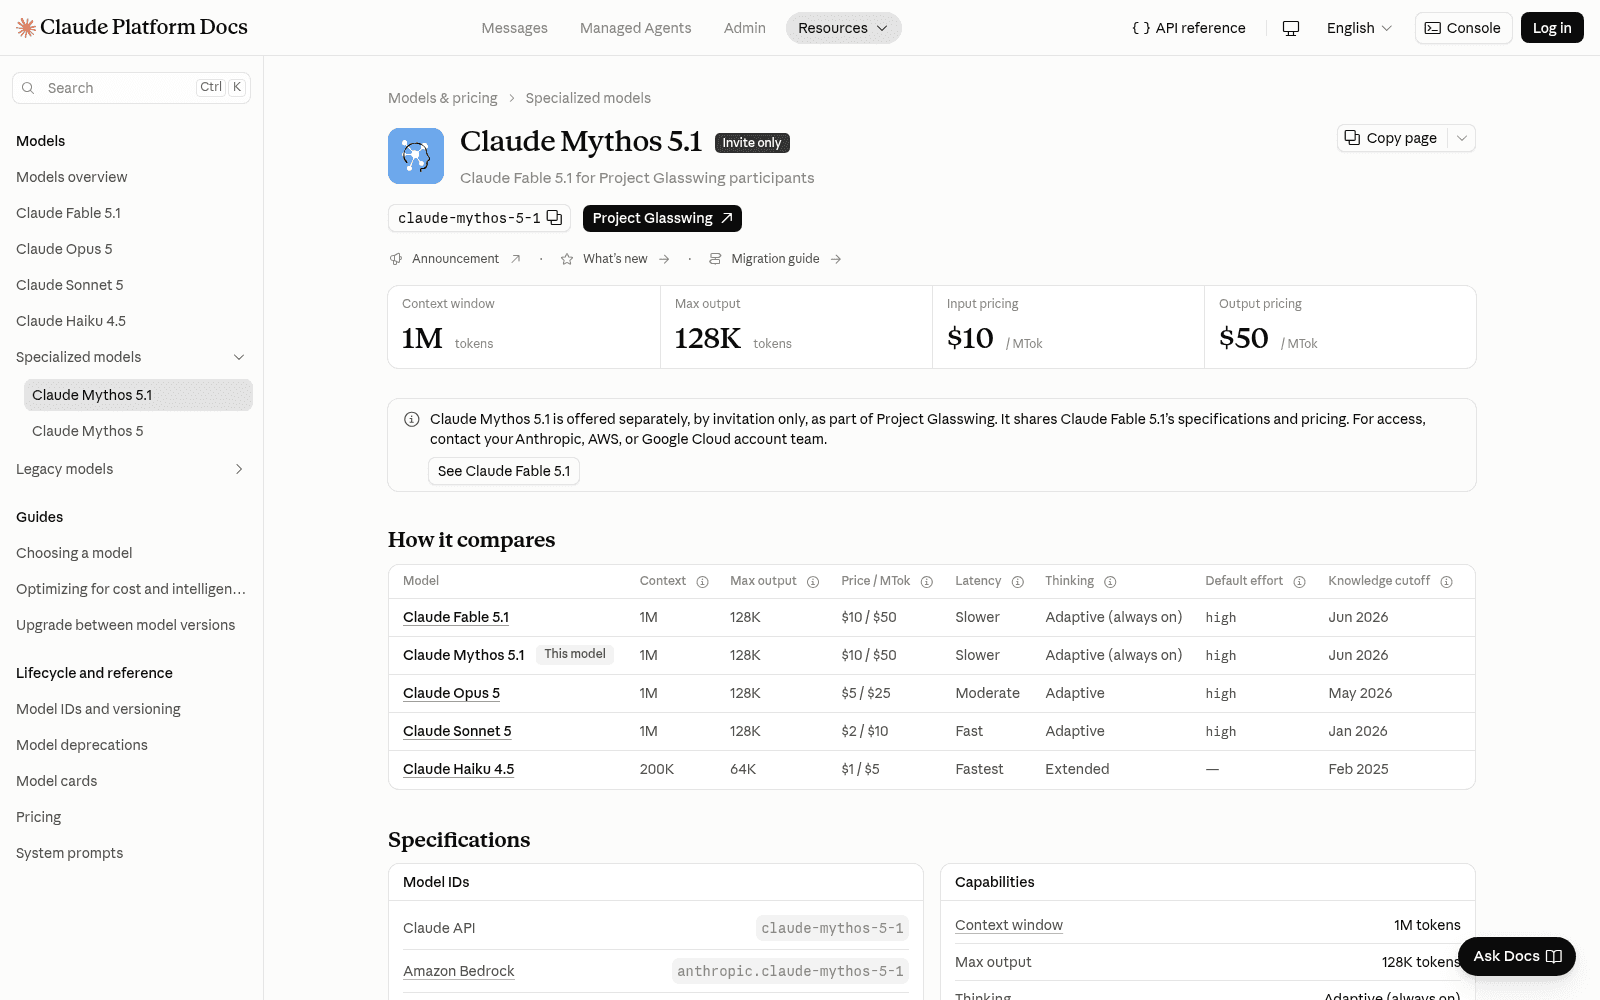
Uma linha que vale a pena ler duas vezes: usar o Mythos 5.1 exige aceitar por padrão uma política de retenção de dados de 30 dias para monitoramento de segurança. Esse é um fato real de aquisição, e é o espelho da história de retenção zero que a Anthropic conta do lado do Fable.
Mythos 5.1 e Fable 5.1 são um modelo com duas fechaduras
Esta é a parte que confunde quase todo mundo, incluindo a thread do Hacker News no dia do lançamento:
"Claude Mythos 5.1 is identical to Fable 5.1, but it offers more permissive safeguards for vetted individuals and organizations"
Then why does it have separate datapoints for Terminal Bench, and score higher? Something doesn't add up here??

Faz sentido sim, e a resposta é mecânica em vez de misteriosa. A Anthropic avalia o Fable 5.1 com as salvaguardas de produção ativadas. Quando essas salvaguardas são acionadas numa tarefa de benchmark, a tarefa não simplesmente falha; ela é passada para um modelo diferente. Tarefas de cibersegurança foram concluídas pelo Opus 4.8, tarefas de biologia pelo Opus 5, e no OSWorld 2.0 as tarefas com intervenção pontuaram um zero absoluto. Então o número publicado do Fable 5.1 é o número de todo o sistema com salvaguardas, não dos pesos.
O Mythos 5.1 são esses mesmos pesos com os classificadores de cibersegurança e biologia afrouxados. Essa é toda a diferença.
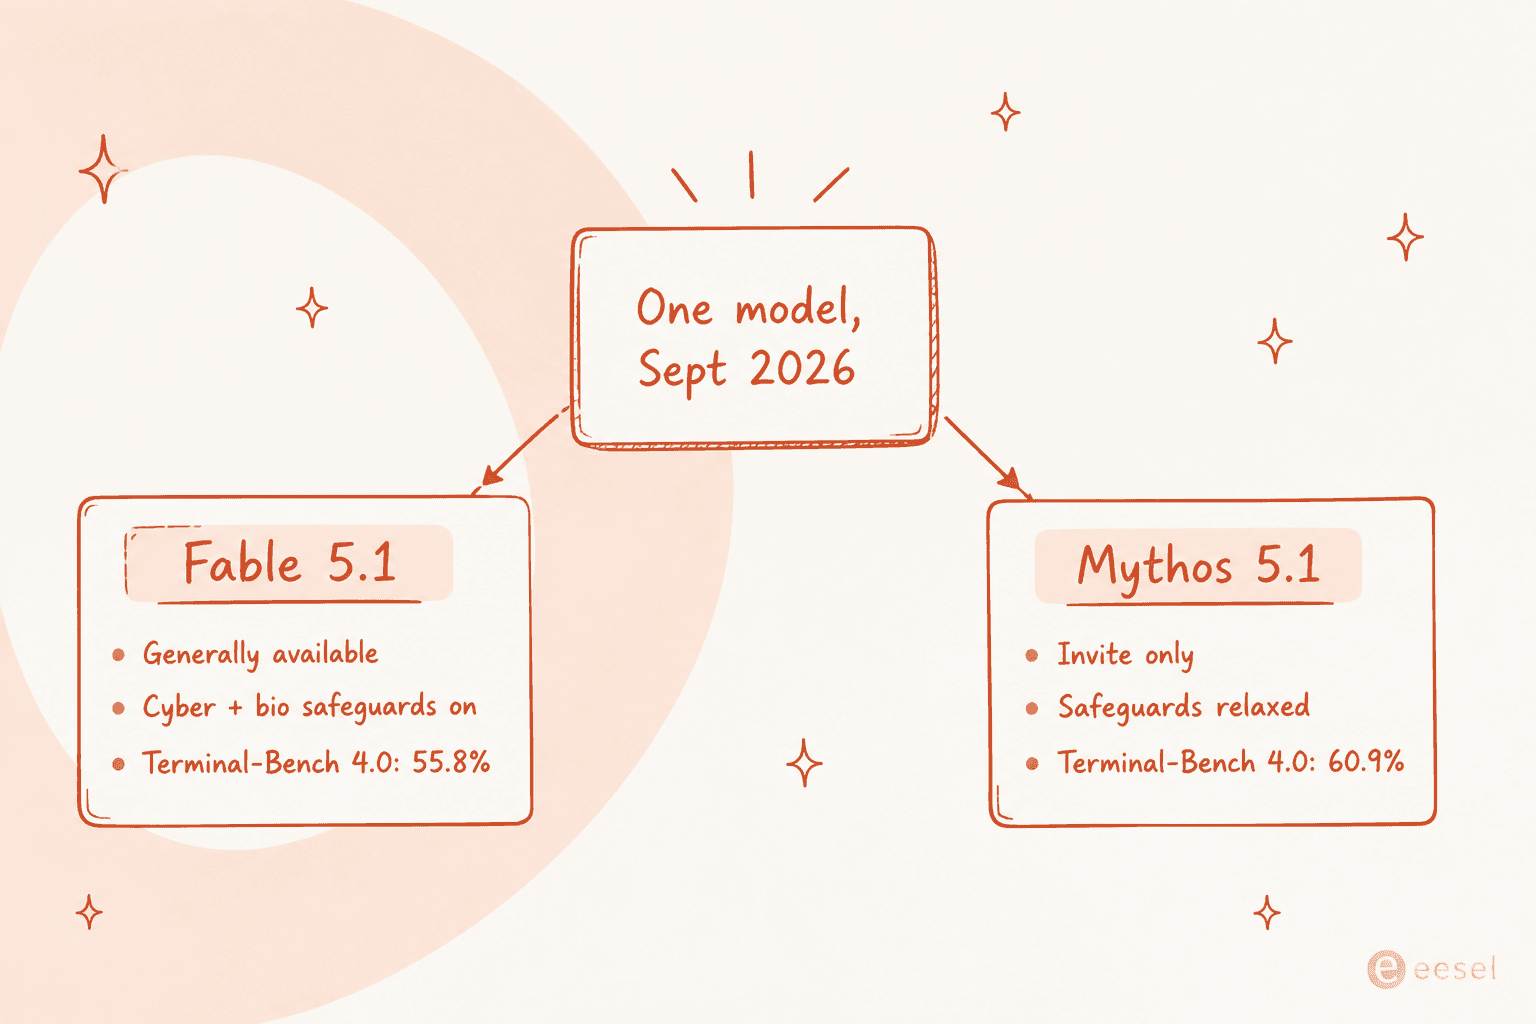
A Anthropic é explícita ao dizer que espera que a lacuna diminua. O post de lançamento observa que a diferença no Terminal-Bench reflete as salvaguardas cibernéticas anteriores, menos precisas, e que com as melhorias do Fable 5.1 lançadas no mesmo dia, a diferença entre os dois modelos deve ficar bem menor.
O que realmente mudou do lado do Fable vale a pena saber mesmo que você nunca chegue a usar o Mythos:
- O Fable 5.1 agora pode ser usado para identificar vulnerabilidades de software no código-fonte, algo que as salvaguardas anteriores bloqueavam.
- Usuários do Claude Code devem ver cerca de 60% menos intervenções de salvaguardas cibernéticas por sessão.
- As salvaguardas de biologia são acionadas 85% menos em perguntas benignas de biologia elementar e medicina do que as que foram lançadas com o Fable 5.
- Trabalho de duplo uso ainda é redirecionado para modelos Opus: testes de penetração, geração de exploits e varredura de vulnerabilidades baseada em binários.
Esse último ponto é o limite honesto. O Fable 5.1 vai ler seu código-fonte e te dizer onde está o bug. Ele não vai escrever o exploit para você.
Os benchmarks, e o que realmente importa
A Anthropic publicou os números do Fable 5.1 e do Mythos 5.1 lado a lado com o Fable 5, Opus 5 e GPT-5.6 Sol. As pontuações abaixo são do Fable 5.1, a menos que a linha diga outra coisa.
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% (60.9% Mythos 5.1) | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 (strict) | 41.7% | 36.1% | 39.6% | not published |
| Humanity's Last Exam (tools) | 65.0% | 63.8% | 63.6% | not published |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
O destaque é o Terminal-Bench-Science, que mais do que dobrou em relação ao Fable 5. Tudo o mais é um passo mais modesto, e a thread de lançamento percebeu isso:
The price reduction comes from the cache read pricing falling from $1/M to $0.25/M, which means that Fable 5.1 now costs half of Opus's cache read costs ($0.5/M).
Essa leitura é justa nas linhas de codificação e menos justa na linha de ciência, onde um salto de 27,9 pontos não é um artefato de arredondamento. A Anthropic anota em nota de rodapé um erro padrão de 3,5 a 4,5 pontos por modelo nesse benchmark, o que ainda assim deixa a lacuna bem fora do ruído.
As demonstrações científicas por trás disso são a parte que eu realmente registraria em print. O Mythos 5.1 projetou ligantes de proteína que superaram as melhores entradas nas competições da Adaptyv Bio em 10 vezes na afinidade de ligação para três alvos, com uma taxa de acerto perto de 50% em 12 alvos, onde 10 a 15% é o típico. Ele também escreveu kernels de GPU que aceleraram sete modelos open-source de genômica e proteínas em até 2,5 vezes com resultados idênticos, cortando o custo estimado de GPU em análises de todo o genoma entre 30 e 60%. Separadamente, o Fable 5.1 construiu um novo mapa de elevação de alta resolução para um terço de Vênus a partir de dados de radar Magellan de 30 anos atrás.
Nada disso é um caso de uso de suporte. Tudo isso é o motivo pelo qual o modelo está atrás de uma porta.
Preços: o corte na leitura de cache é a verdadeira notícia
Mythos 5.1 e Fable 5.1 têm a mesma tabela de preços. A entrada custa US$ 10 por milhão de tokens, a saída US$ 50 por milhão. Isso não mudou desde o Fable 5.
O que mudou foi a linha de leitura de cache, e mudou bastante.
| Medidor | Fable 5 / Mythos 5 | Fable 5.1 / Mythos 5.1 |
|---|---|---|
| Entrada base | $10 / MTok | $10 / MTok |
| Saída | $50 / MTok | $50 / MTok |
| Escrita de cache de 5 minutos | $12.50 / MTok | $12.50 / MTok |
| Escrita de cache de 1 hora | $20 / MTok | $20 / MTok |
| Leitura de cache | $1.00 / MTok | $0.25 / MTok |
| Entrada / saída em lote | $5 / $25 | $5 / $25 |
Todo outro modelo da Claude precifica um acerto de cache em 0,1x a entrada base. O Fable 5.1 e o Mythos 5.1 o precificam em 0,025x, e a documentação da Anthropic aponta isso numa nota de rodapé como a única exceção da família. É também, como a thread acima observou, metade do que custa uma leitura de cache no Opus 5, num modelo que tem o dobro do preço base.
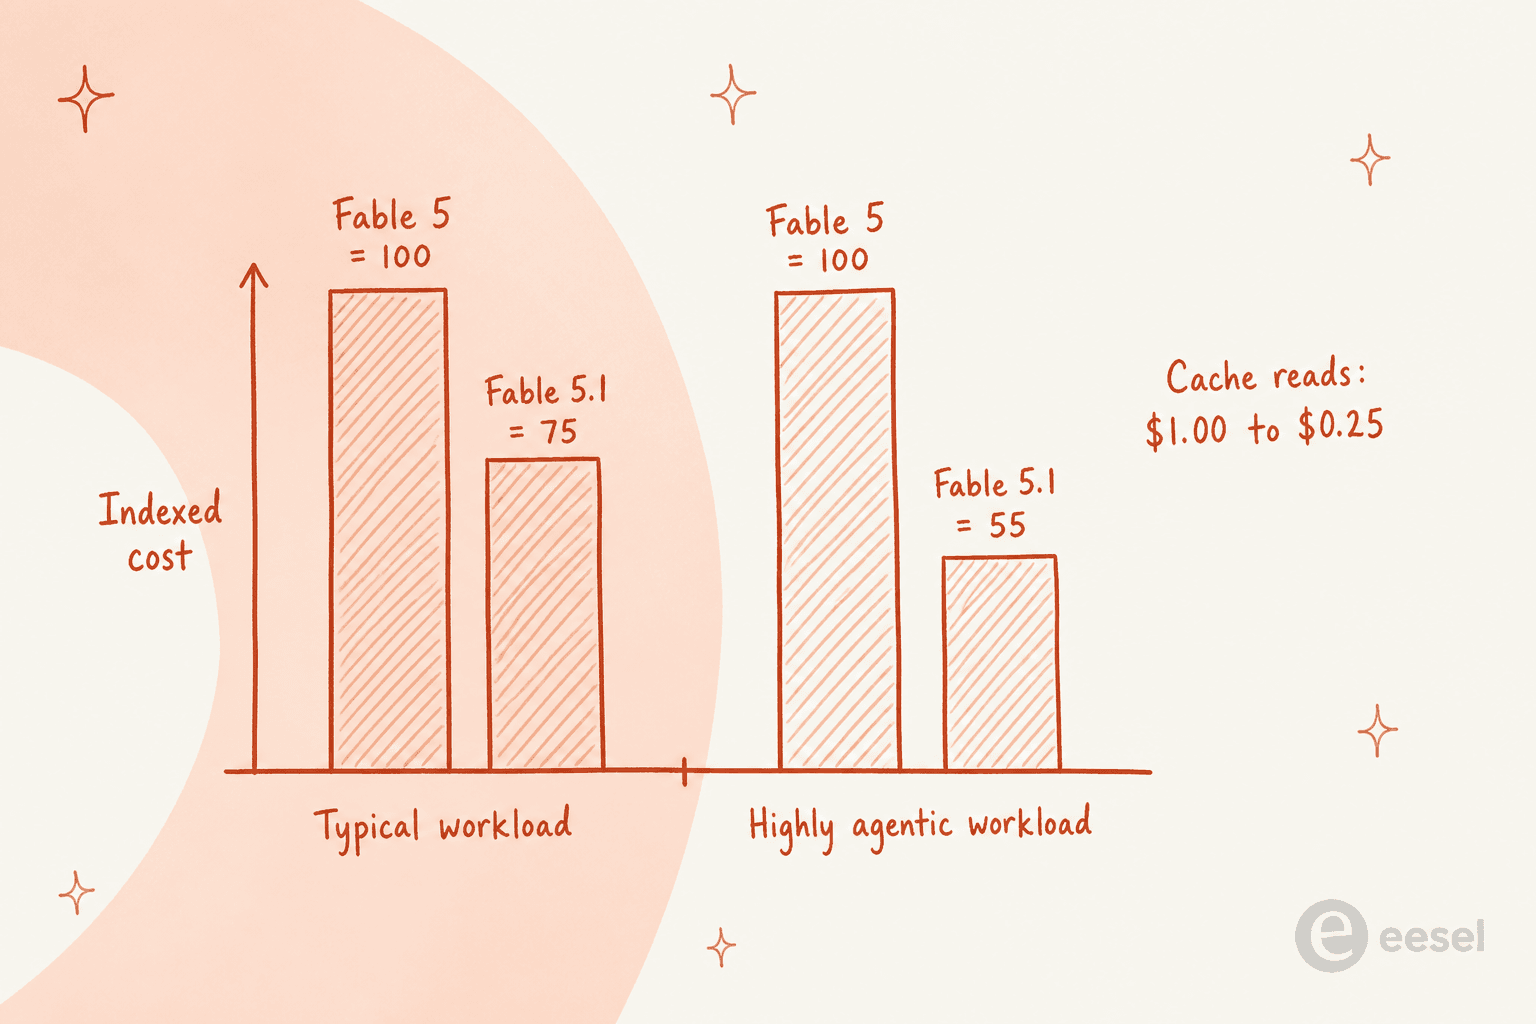
A Anthropic mediu isso ao longo de quatro semanas de uso real em agosto de 2026 com esforço padrão. Cargas de trabalho típicas no Claude Enterprise, Claude Code e na API ficam cerca de 25% mais baratas. Trabalho agêntico intensivo em contexto e ferramentas, onde as leituras de cache são a maior parte da fatura, fica cerca de 45% mais barato.
A consequência prática é uma mudança de planejamento, não apenas uma fatura menor:
"Cache reads now cost 75% less, or $0.25 per million tokens." For me, at a typical 95% cache hit rate, I think my optimal context window size before autocompaction goes from ~200K to ~400K tokens. Great for longer horizon tasks.
Esse é todo o sentido da mudança. Numa execução agêntica longa, a transcrição é relida a cada turno, então o medidor de leitura de cache é o que se acumula. Se você tem comprimido o contexto de forma agressiva para manter a fatura baixa, a conta para isso acabou de mudar. A tabela de preços mais ampla da família está no meu detalhamento dos preços da API da Anthropic, e o lado da assinatura está nos preços da Claude.
Uma coisa que o corte de preço não muda: contexto longo ainda é cobrado de forma linear. O Claude 4.6 e modelos posteriores incluem a janela inteira de 1M nas tarifas padrão, então uma requisição de 900 mil tokens é cobrada na mesma taxa por token que uma de 9 mil.
Como o acesso realmente funciona
Dois programas, ambos verificados, ambos restritos aos EUA hoje.
Cyber Verification Program. O CVP atualmente fornece salvaguardas cibernéticas reduzidas em certos modelos de classe Opus e Sonnet para trabalho de segurança defensiva. A Anthropic diz que o acesso à classe Mythos se juntará a ele em breve, o que é uma promessa, não uma data. As candidaturas passam pelo portal de programas da Anthropic.
Life Sciences Verification Program. O LSVP é uma beta apenas por convite, desenvolvida com o governo dos EUA, que relaxa as salvaguardas de biologia para pesquisa e desenvolvimento profissional, mantendo todas as outras salvaguardas em vigor. Os primeiros participantes já estão inscritos, e a Anthropic diz que planeja expandir para a comunidade mais ampla de ciências biológicas.
Clientes empresariais existentes têm uma terceira porta: a documentação diz para contatar sua equipe de conta da Anthropic, AWS ou Google Cloud. E o Claude Security, o produto de varredura de código da Anthropic, agora roda sobre o Mythos 5.1, que é a única forma de usar o modelo sem ser convidado diretamente para ele.
O motivo de tudo isso está no anúncio do Glasswing de abril de 2026. O Mythos Preview encontrou milhares de vulnerabilidades de dia zero em praticamente todo sistema operacional e navegador importante, incluindo uma falha remota de 27 anos no OpenBSD e um defeito de 16 anos no FFmpeg que testes automatizados haviam encontrado cinco milhões de vezes sem detectar. A Anthropic comprometeu US$ 100 milhões em créditos de uso e US$ 4 milhões em doações, e trouxe doze parceiros de lançamento mais 40 outras organizações de infraestrutura, expandindo para cerca de 150 organizações em mais de quinze países até junho.
No lado da segurança, a própria avaliação da Anthropic é que o Mythos 5.1 tem as capacidades cibernéticas mais fortes de qualquer modelo que já lançou, ainda está na categoria de risco mais baixa do seu Frontier Compliance Framework, e fica abaixo do próximo nível de risco na Responsible Scaling Policy. Ele é implantado com as mesmas salvaguardas de biologia do Mythos 5.
Três mudanças que vão quebrar a integração de alguém
Vale a pena sinalizar mesmo que o Mythos em si esteja fora de alcance, porque essas mudanças afetam o Fable 5.1 também.
- Uso forçado de ferramenta retorna um erro. Se o seu código define
tool_choicecomoanyou uma ferramenta nomeada, essa chamada agora falha. Essa é a mudança que mais provavelmente vai chamar a atenção de alguém. - Blocos de thinking estão vinculados ao modelo que os produziu. Modelos anteriores não conseguem ler blocos de thinking do Fable 5.1 ou do Mythos 5.1, e editar um turno anterior os invalida.
- A anti-destilação muda a edição de múltiplos turnos. Novas contas de API criadas a partir do dia do lançamento em diante não podem mais editar manualmente o contexto anterior da Claude preservando a transcrição do seu thinking anterior. Contas existentes não são afetadas por enquanto, mas a mudança se aplica a todos nos lançamentos de modelos futuros.
Há também uma mudança de conformidade com um rastro longo. Para atender ao Código de Prática sobre Transparência de Conteúdo Gerado por IA da Lei de IA da UE, modelos lançados após 2 de agosto de 2026 carregam uma marca d'água de texto, com uma API de detecção em prévia privada para reguladores, pesquisadores e empresas obrigadas. A Anthropic diz que ela é invisível sem a API de detecção e não carrega nenhuma informação sobre o usuário ou suas conversas. Foi o que mais gerou polêmica na thread de lançamento, o que vale a pena saber se o seu pipeline de conteúdo tem uma opinião sobre proveniência. Minhas notas sobre conteúdo de IA e E-E-A-T cobrem o lado da publicação disso.
O que usar no lugar, por tarefa
Quase todo mundo lendo isso está escolhendo entre modelos que consegue realmente usar. Aqui está como eu dividiria isso.
- Teto de fronteira, disponível hoje. Fable 5.1. Mesmos pesos do Mythos 5.1, mesmo preço, sem lista de espera. Contexto em o que é o Claude Fable 5 e o relançamento do Fable 5.
- Cavalo de batalha padrão. Opus 5 a US$ 5 de entrada e US$ 25 de saída. A própria documentação da Anthropic ainda diz para começar a maioria das cargas de trabalho por aqui e subir só quando suas avaliações ficarem aquém. A análise do Opus 5 tem meu veredito, e os preços do Opus 5 têm as tabelas.
- Trabalho sensível à latência. Sonnet 5 a US$ 2 de entrada e US$ 10 de saída, com a mesma janela de 1M. Os preços do Sonnet 5 e a análise do Sonnet 5 vão mais fundo.
- Agentes de codificação. O nível de esforço mexe na sua fatura mais do que o nível do modelo. A seleção de modelo do Claude Code e os preços do Claude Code são os dois que vale a pena ler.
- Orquestração de longa duração. Claude Managed Agents cobra o tempo de execução da sessão além dos tokens, algo que o corte na leitura de cache não afeta.
- Pesando todo o campo. Alternativas ao Claude e alternativas ao Opus 5, se você não estiver preso à Anthropic, além de GPT-5.6 versus Claude para o confronto direto.
Se a tarefa são conversas com clientes em vez de código ou pesquisa, a questão do nível é praticamente irrelevante. Meu resumo do melhor modelo para tickets de suporte percorre a real relação de custo-benefício, e modelos de IA personalizados cobre quando vale a pena treinar o seu próprio.
O que um modelo de fronteira não resolve numa fila de suporte
Quero ser cuidadoso aqui, porque os resultados do Mythos 5.1 são reais e a ciência é difícil de contestar. Mas há um padrão de falha que já vi vezes suficientes para dar um nome a ele.
Uma equipe lê um post de lançamento, atualiza o modelo por trás do seu bot de suporte, e espera que a taxa de resolução se mova. Não se move. O que move a taxa de resolução é se o modelo consegue ver o conhecimento certo, se ele sabe quando parar e transferir, e se alguém o testou contra tickets reais antes de um cliente vê-lo. Nenhum desses é problema de nível de modelo.
A metade de confiança nisso é a que custa dinheiro. Como uma líder de CX de uma marca de suplementos DTC colocou numa call de vendas:
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Isso é um problema de escopo e controle, e uma pontuação de 60,9% no Terminal-Bench não tem nada a dizer sobre isso. Nem o caminho de construir por conta própria, onde muitas equipes acabam depois de um lançamento como esse. Karel, da GENERAL BYTES, colocou a relação de custo-benefício de forma clara:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
A chave de API é a parte barata. A recuperação de informação, os limites de permissão, as regras de escalonamento, o arcabouço de avaliação, e a manutenção de todos os quatro conforme o seu produto muda são a parte cara. Esse trabalho não fica mais barato só porque as leituras de cache ficaram.
Onde a eesel se encaixa
A eesel vende colegas de equipe de IA, não um modelo. O colega de equipe de IA para helpdesk entra na fila que você já opera, lê a central de ajuda e os tickets passados que você já tem, e responde dentro do escopo que você define. O redator de blog com IA faz o mesmo trabalho para conteúdo. Ambos chegam com as integrações e o contexto de empresa para sua função, que é exatamente a camada que um modelo de fronteira cru não traz.

A coisa específica que eu apontaria, dado o tema deste post: antes de um colega de equipe da eesel responder a um único cliente real, ele roda contra os seus próprios tickets históricos para que você veja o que ele teria dito. Esse é o teste real que ninguém tem num lançamento de modelo, e é a diferença entre lançar uma melhoria e lançar um palpite. Ele se conecta ao Zendesk, Freshdesk, Gorgias, Front, Help Scout e HubSpot em minutos, e é grátis para testar.
Correr atrás do Mythos 5.1 para uma fila de suporte é otimizar a única variável que nunca foi a limitação. Conectar a Claude ao seu helpdesk é uma tarde mais útil, e usar a Claude para suporte é a versão honesta do que isso te dá.
Meu veredito sobre o Claude Mythos 5.1
É o modelo mais capaz que a Anthropic já lançou, não está disponível para você, e a versão que está disponível para você é o mesmo modelo. Isso é algo incomum de se poder escrever, e é o fato mais útil deste post.
Se você é um defensor cibernético ou um cientista de ciências biológicas, candidate-se, porque os resultados científicos justificam a burocracia. Se você é qualquer outra pessoa, o lançamento que importa é o preço de leitura de cache do Fable 5.1, que silenciosamente tornou o trabalho agêntico com muito contexto cerca de 45% mais barato. Isso vai mudar mais sistemas de produção neste trimestre do que um modelo trancado jamais vai mudar.
Perguntas frequentes
O que é o Claude Mythos 5.1?
claude-mythos-5-1. É o mesmo modelo subjacente que o Fable 5.1, entregue com salvaguardas de cibersegurança e biologia mais frouxas, e é oferecido apenas por convite através do Project Glasswing. O artigo anterior sobre o Claude Mythos explica como a família começou.Quanto custa o Claude Mythos 5.1?
Como eu consigo acesso ao Claude Mythos 5.1?
Qual é a diferença entre o Claude Mythos 5.1 e o Claude Fable 5.1?
O Claude Mythos 5.1 está disponível na Bedrock ou no Google Cloud?
claude-mythos-5-1 em cada uma. Estar na plataforma não é o mesmo que conseguir chamá-lo, já que o convite ainda é necessário.O que devo usar no lugar do Claude Mythos 5.1?
O Claude Mythos 5.1 tem uma janela de contexto de 1M?
high. A Anthropic cobra a janela inteira nas tarifas padrão, então uma requisição de 900 mil tokens custa o mesmo por token que uma de 9 mil. O tamanho da janela de contexto do Claude Code explica o que isso significa no dia a dia.É seguro usar o Claude Mythos 5.1 com dados de clientes?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.