Resumo rápido
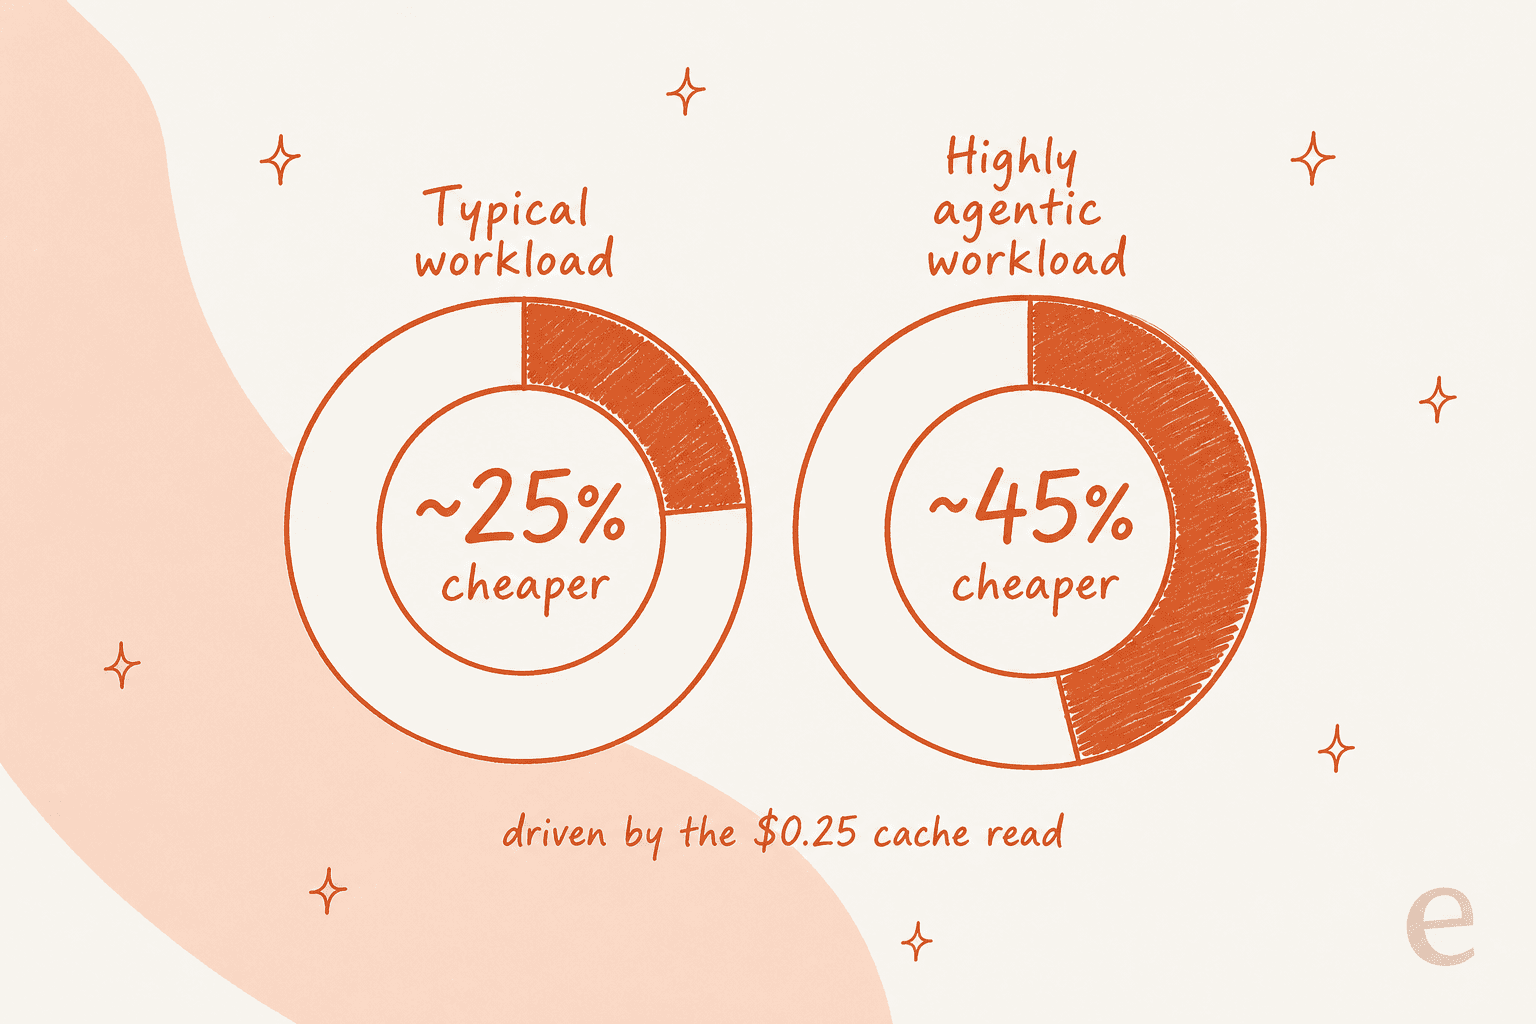
O Claude Mythos 5.1 custa US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída, exatamente igual ao Fable 5.1, porque são o mesmo modelo com salvaguardas diferentes. As tarifas base não mudaram desde o Fable 5. A única mudança real é a leitura de cache do prompt, que cai para US$ 0,25 por milhão de tokens (2,5% da entrada base, contra 10% em qualquer outro modelo Claude). A própria estimativa da Anthropic é de cerca de 25% mais barato em cargas de trabalho típicas e até 45% mais barato nas altamente agênticas.
A pegadinha: você provavelmente não consegue rodar o Mythos 5.1. Ele é restrito aos EUA, trancado atrás de uma verificação cyber ou de life sciences, e força retenção de dados de 30 dias. O modelo que você pode rodar, o Fable 5.1, é idêntico, então o preço em que você deveria realmente se basear é o do Fable 5.1. E se você está calculando isso para trabalho de suporte ou conteúdo em vez de acesso bruto à API, um colega de equipe com preço por resultado como o eesel elimina totalmente o cálculo por token.
O preço, direto ao ponto
Aqui está a tabela de preços completa do Claude Mythos 5.1. Todo número abaixo também se aplica, ao centavo, ao Fable 5.1, um ponto ao qual vou voltar.
| Medidor | Preço (por milhão de tokens) | Notas |
|---|---|---|
| Entrada base | US$ 10,00 | Sem alteração em relação ao Fable 5 |
| Saída base | US$ 50,00 | Sem alteração em relação ao Fable 5 |
| Entrada batch | US$ 5,00 | 50% de desconto, Message Batches API |
| Saída batch | US$ 25,00 | 50% de desconto |
| Escrita de cache (5 minutos) | US$ 12,50 | 1,25x a entrada base |
| Escrita de cache (1 hora) | US$ 20,00 | 2x a entrada base |
| Leitura de cache | US$ 0,25 | 2,5% da entrada base, a grande mudança |
Vale a pena citar as especificações por trás desses números para você conseguir dimensionar uma fatura: contexto de 1M de tokens, saída máxima de 128K, thinking adaptativo sempre ativo, uma configuração de esforço high por padrão e um corte de conhecimento de junho de 2026. O Mythos 5.1 roda na API da Claude, Amazon Bedrock, Google Cloud e Microsoft Foundry, e essas plataformas definem suas próprias tarifas regionais por cima.
Note o que não está aqui: sem taxa por assento, sem mínimo mensal, sem níveis de plano. Isso é precificação bruta de modelo cobrada por token, então seu custo real é uma função de quanto texto entra, quanto sai e quanto da entrada você consegue servir a partir do cache. Essa última variável é o jogo inteiro deste lançamento.
A leitura de cache é a verdadeira notícia
Todo outro modelo Claude atual precifica um acerto de cache em 10% da sua tarifa base de entrada. O Mythos 5.1 e o Fable 5.1 o precificam em 2,5%. Em um modelo de entrada de US$ 10, isso é US$ 0,25 por milhão de tokens em vez de US$ 1,00.
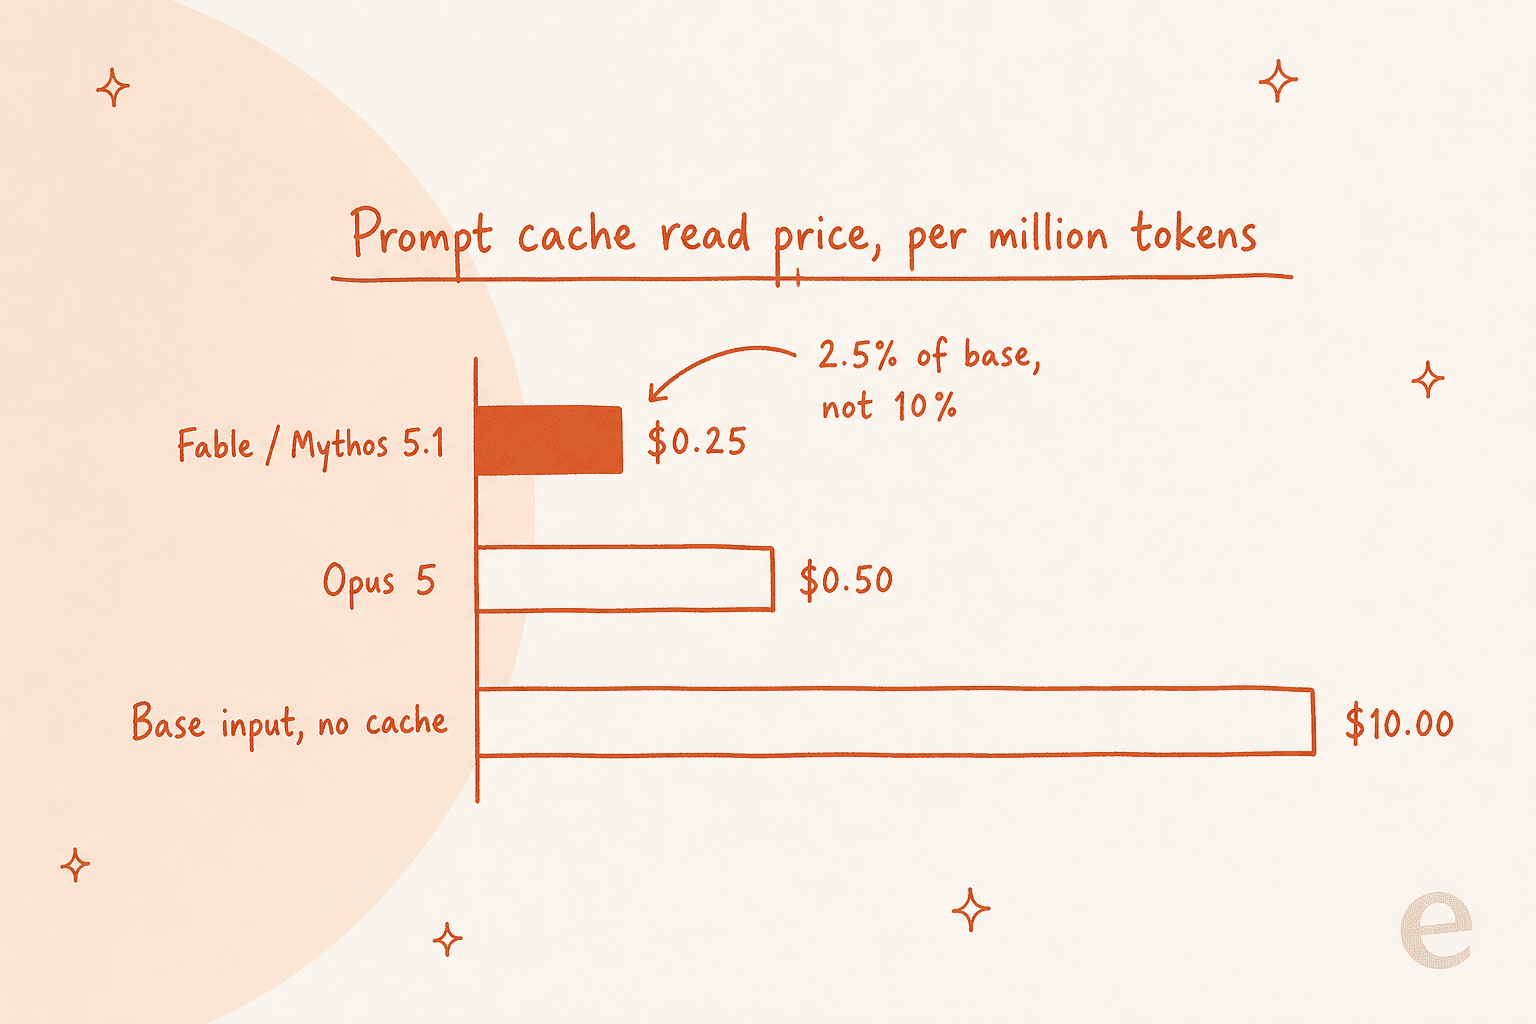
O número que faz as pessoas olharem duas vezes: uma leitura de cache do Mythos 5.1 custa a metade de uma leitura de cache do Opus 5 (US$ 0,25 vs. US$ 0,50), mesmo que o Mythos custe o dobro por token de entrada base. A Anthropic está basicamente dizendo: a parte cara é pensar sobre tokens novos, e reler tokens que já foram processados deveria ser quase de graça.
Isso importa por causa de onde os tokens vão em um agente real. Uma CLI de programação ou um agente de suporte de longa duração reenvia toda a sua transcrição a cada turno. O turno 20 pode carregar um milhão de tokens de contexto, quase todos um acerto de cache. Quando a leitura de cache cai 4x, o item dominante desse tipo de fatura cai junto. Como Simon Willison colocou no Hacker News:
"Bit of a discount if you're using caching... This should impact any long-running agent since subsequent calls can benefit from cached reads for previous transcripts."

A Anthropic apresentou números reais depois de medir quatro semanas de uso em agosto de 2026: cerca de 25% mais barato para cargas de trabalho típicas, e até aproximadamente 45% mais barato para as altamente agênticas. A diferença depende inteiramente de quão pesado em cache é o trabalho.
Aqui está o contrapeso honesto, porque um post de preços também deve algo aos céticos. A leitura de cache mais barata só faz diferença se as leituras de cache forem uma grande parte do seu gasto. Os tokens de saída ainda custam US$ 50 por milhão e não mudaram. Um comentarista do Hacker News, fastball, trabalhou um exemplo de 20 turnos: uma conversa que termina em 1M de tokens de contexto saiu por US$ 72,00 no Fable 5 e US$ 64,88 no Fable 5.1, porque os US$ 50 de tokens de saída eram idênticos nos dois. Mais barato, mas não os 25% que você poderia esperar se só ler o título por cima. E outro usuário foi mais direto: "This is just cache reads. In real usage it costs 15% more than Fable 5." A lição é fazer as contas com a sua própria mistura de tokens, e não assumir que a porcentagem do título é a sua.
Para facilitar isso, insira os seus próprios números:
Mythos e Fable custam o mesmo porque são o mesmo modelo
Este é o fato que reformula toda a questão de preços. O Mythos 5.1 e o Fable 5.1 são o mesmo modelo subjacente, com os mesmos pesos. A única diferença é a camada de segurança: o Fable 5.1 é avaliado com as salvaguardas de produção ativadas, e quando uma salvaguarda é acionada, ela passa a tarefa para um modelo diferente. O Mythos 5.1 roda sem essa intervenção.
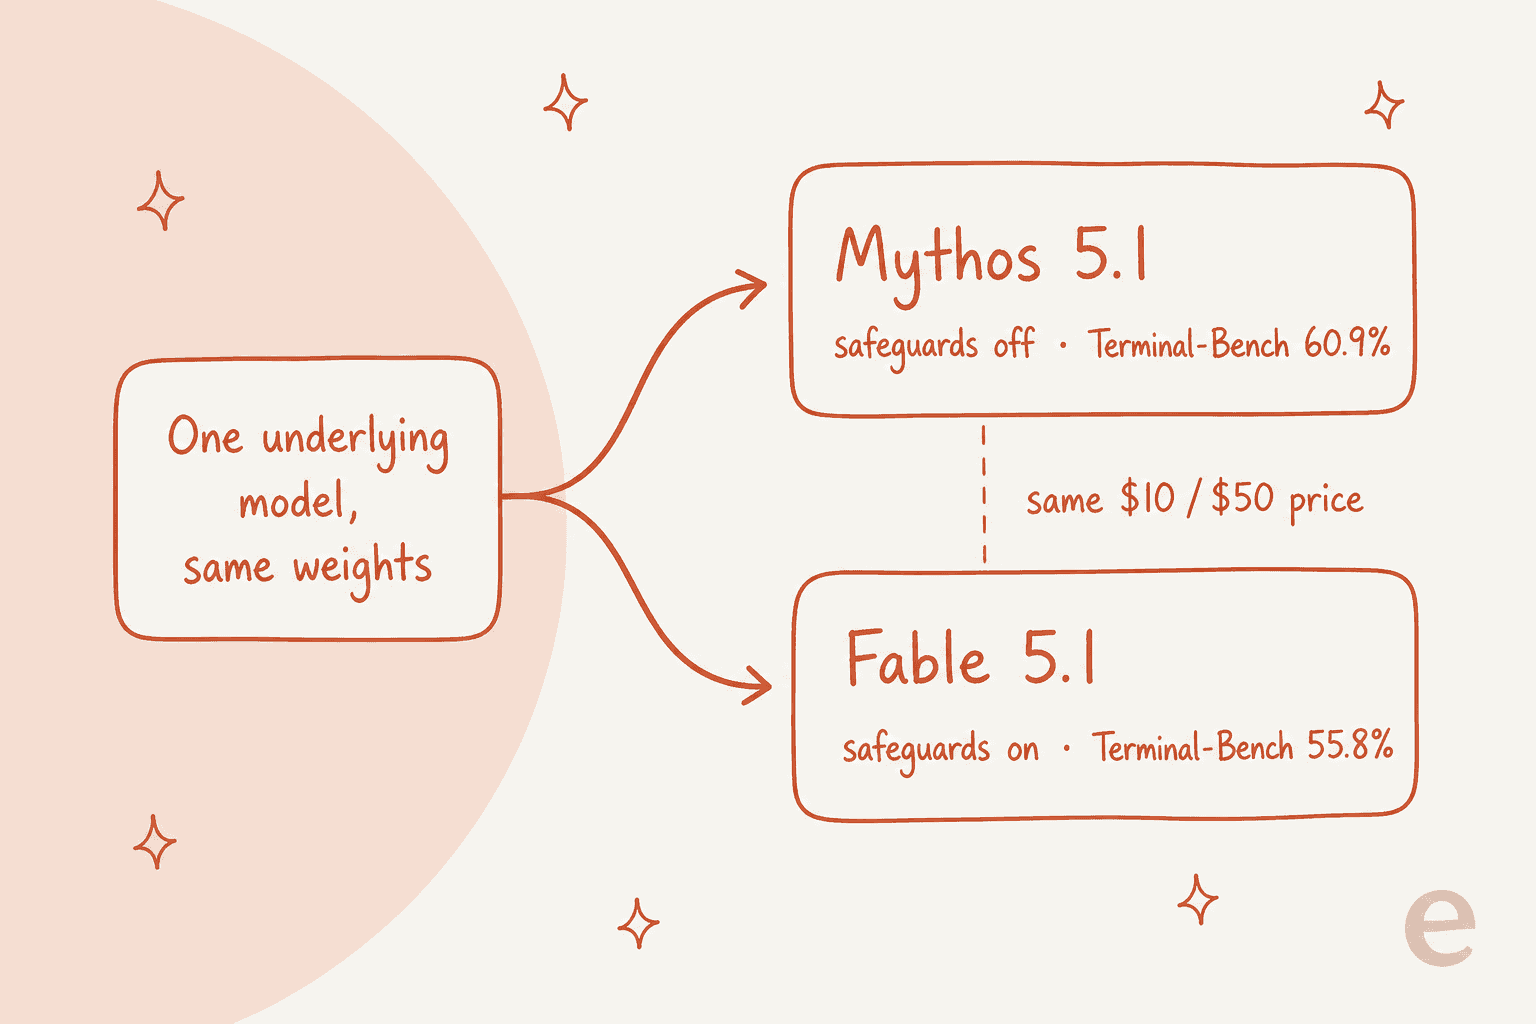
Então, quando você vê o Mythos 5.1 pontuar 60,9% no Terminal-Bench 4.0 contra os 55,8% do Fable 5.1, essa diferença não é um modelo mais inteligente. É a taxa que as salvaguardas cobram quando intervêm e desviam uma tarefa. A Anthropic espera que essa diferença diminua conforme as salvaguardas ficarem mais precisas. Precificá-los de forma idêntica é a atitude honesta, porque você paga pelos mesmos pesos de qualquer jeito.
Isso também explica por que a tarifa base não caiu mesmo sendo esta uma point release. No Hacker News, GodelNumbering interpretou o corte na leitura de cache como um sinal de demanda, e não de generosidade:
"This gives a lot of credit to the theory that Anthropic did not get much bite on Fable at its original pricing, which in turn likely places a ceiling on LLM pricing in general."
Essa leitura estando certa ou não, a conclusão prática para um comprador é clara: você não está escolhendo entre dois pontos de preço. Você está escolhendo entre duas configurações de salvaguarda no mesmo ponto de preço.
O preço com o qual você deve planejar é o do Fable, porque você não consegue rodar o Mythos
Aqui está a parte que a maioria dos textos sobre preços deixa de fora. Um número em uma tabela de preços só é real se você conseguir chamar o modelo. Para o Mythos 5.1, a maioria das equipes não consegue.
O acesso hoje é restrito aos EUA e chega por uma de três portas: o Cyber Verification Program da Anthropic (onde o acesso ao Mythos é prometido "em um futuro próximo", mas ainda não está ativo), o Life Sciences Verification Program (um beta apenas por convite, construído com o governo dos EUA), ou uma conversa direta com sua equipe de conta na Anthropic, AWS ou Google Cloud. Além disso, usar o Mythos 5.1 exige aceitar retenção de dados de 30 dias por padrão, o que é uma linha à parte em qualquer revisão de compras.
Para todo o resto, o modelo que você realmente consegue colocar em produção é o Fable 5.1, disponível na API da Claude, Bedrock, Google Cloud e Foundry sem nenhuma barreira de verificação. E como são os mesmos pesos, "qual oferece melhor custo-benefício" é a pergunta errada. Você compra o Fable 5.1, planeja com base no preço do Fable 5.1, e o fato de as duas tabelas de preços serem idênticas significa que você não perde nada por não ter acesso ao Mythos. A tabela de preços do Mythos é melhor lida como confirmação do que você vai pagar pelo Fable, não como algo separado para comparar.
Três mudanças de API que afetam sua fatura e seu fluxo de trabalho
Preço não é só a tarifa por token, é o que sua integração precisa fazer para alcançar essa tarifa. Três mudanças de API que quebram compatibilidade vêm com esta geração e também se aplicam ao Fable 5.1, então leve-as em conta em qualquer migração:
- O uso forçado de ferramenta agora retorna um erro. Se o seu agente dependia de forçar uma chamada de ferramenta específica, esse padrão quebra e você vai precisar reformular o fluxo de uso de ferramentas.
- Os blocos de thinking estão vinculados ao modelo que os produziu. Você não pode reproduzir livremente uma transcrição de thinking de outro modelo.
- Contas de API novas não conseguem editar contexto anterior preservando a transcrição de thinking. Isso é uma medida antidestilação, e muda como você pode estruturar loops de agentes longos.
Nenhuma dessas mudanças altera o preço de tabela, mas elas podem alterar o tempo de engenharia, que é o verdadeiro custo total de propriedade em qualquer migração de modelo. Reserve orçamento para a adaptação, não só para os tokens.
Como ele se compara ao resto da linha
Colocando o Mythos 5.1 ao lado dos modelos com os quais você realmente o compararia, o cenário é menos "camada premium, preço premium" do que a tarifa base sugere, uma vez que o cache entra em jogo.
| Modelo | Entrada / saída (por M) | Leitura de cache (por M) | Contexto |
|---|---|---|---|
| Mythos 5.1 / Fable 5.1 | US$ 10 / US$ 50 | US$ 0,25 | 1M |
| Opus 5 | US$ 5 / US$ 25 | US$ 0,50 | 1M |
| Sonnet 5 | US$ 2 / US$ 10 | US$ 0,20 | 1M |
| Haiku 4.5 | US$ 1 / US$ 5 | US$ 0,10 | 200K |
O Opus 5 tem a metade do preço base, mas sua leitura de cache é o dobro. Então, em uma carga de trabalho que é majoritariamente acertos de cache, a diferença efetiva entre o Opus 5 e o Mythos/Fable 5.1 se estreita bastante, que é exatamente o caso para o qual a Anthropic está otimizando. Para uma carga de trabalho que é majoritariamente entrada e saída novas, o Opus 5 continua claramente mais barato. Não existe uma única resposta de "modelo mais barato", e é por isso que a calculadora acima importa mais do que qualquer ranking.
Vale a pena nomear o elefante na sala, já que a thread do Hacker News o fez: modelos abertos e chineses mais baratos agora precificam leituras de cache em centavos de dígito único, e vários comentaristas argumentaram que isso coloca um teto no que os laboratórios de fronteira podem cobrar. O preço do Mythos 5.1 é uma resposta a essa pressão, não imunidade a ela.
Experimente a eesel
Se você está lendo uma página de preços de modelo, geralmente está tentando responder a uma pergunta mais adiante: quanto vai custar de fato resolver tickets de suporte ou escrever conteúdo. Essa é uma pergunta diferente de "qual é a tarifa por token", e é a que a eesel foi feita para responder.
O modelo é infraestrutura. A eesel é a funcionária que você contrata por cima dele. Você não provisiona Mythos ou Fable, não conta leituras de cache, nem reserva capacidade. Você contrata um colega de equipe de IA pronto para trabalhar em uma função específica, e hoje o time inclui uma colega de IA de helpdesk que entra na sua fila de suporte já existente e um redator de blog com IA. Cada um chega com as habilidades, integrações e contexto da empresa para sua função, e o preço é por resultado resolvido, não por token, então uma fatura que você consegue prever substitui o cálculo de tokens desta página.
E porque os engenheiros perguntam: a eesel pode ser controlada pela CLI da eesel, então a mesma colega que você configura no painel pode ser operada a partir de um terminal, automatizada em scripts, ou controlada por um agente de programação como Claude Code, Codex ou Cursor. Se o seu interesse no preço do Mythos 5.1 era, na verdade, sobre conectar um modelo a um fluxo de trabalho de suporte ou conteúdo, essa é a camada que transforma um modelo bruto em trabalho que realmente é feito. É grátis para testar.
Perguntas frequentes
Quanto custa o Claude Mythos 5.1?
Por que o Claude Mythos 5.1 custa o mesmo que o Fable 5.1?
Qual é o preço da leitura de cache do Claude Mythos 5.1?
Eu consigo realmente acessar o Claude Mythos 5.1?
O preço do Claude Mythos 5.1 vale a pena em relação ao Opus 5?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.