

O que o Claude Mythos 5.1 realmente é
A Anthropic lançou o Claude Mythos 5.1 em 1º de setembro de 2026, com o ID de modelo claude-mythos-5-1. É um modelo de fronteira voltado para trabalho verificado de segurança cibernética e ciências da vida, e a Anthropic afirmou que o próprio Claude Security agora roda sobre ele.
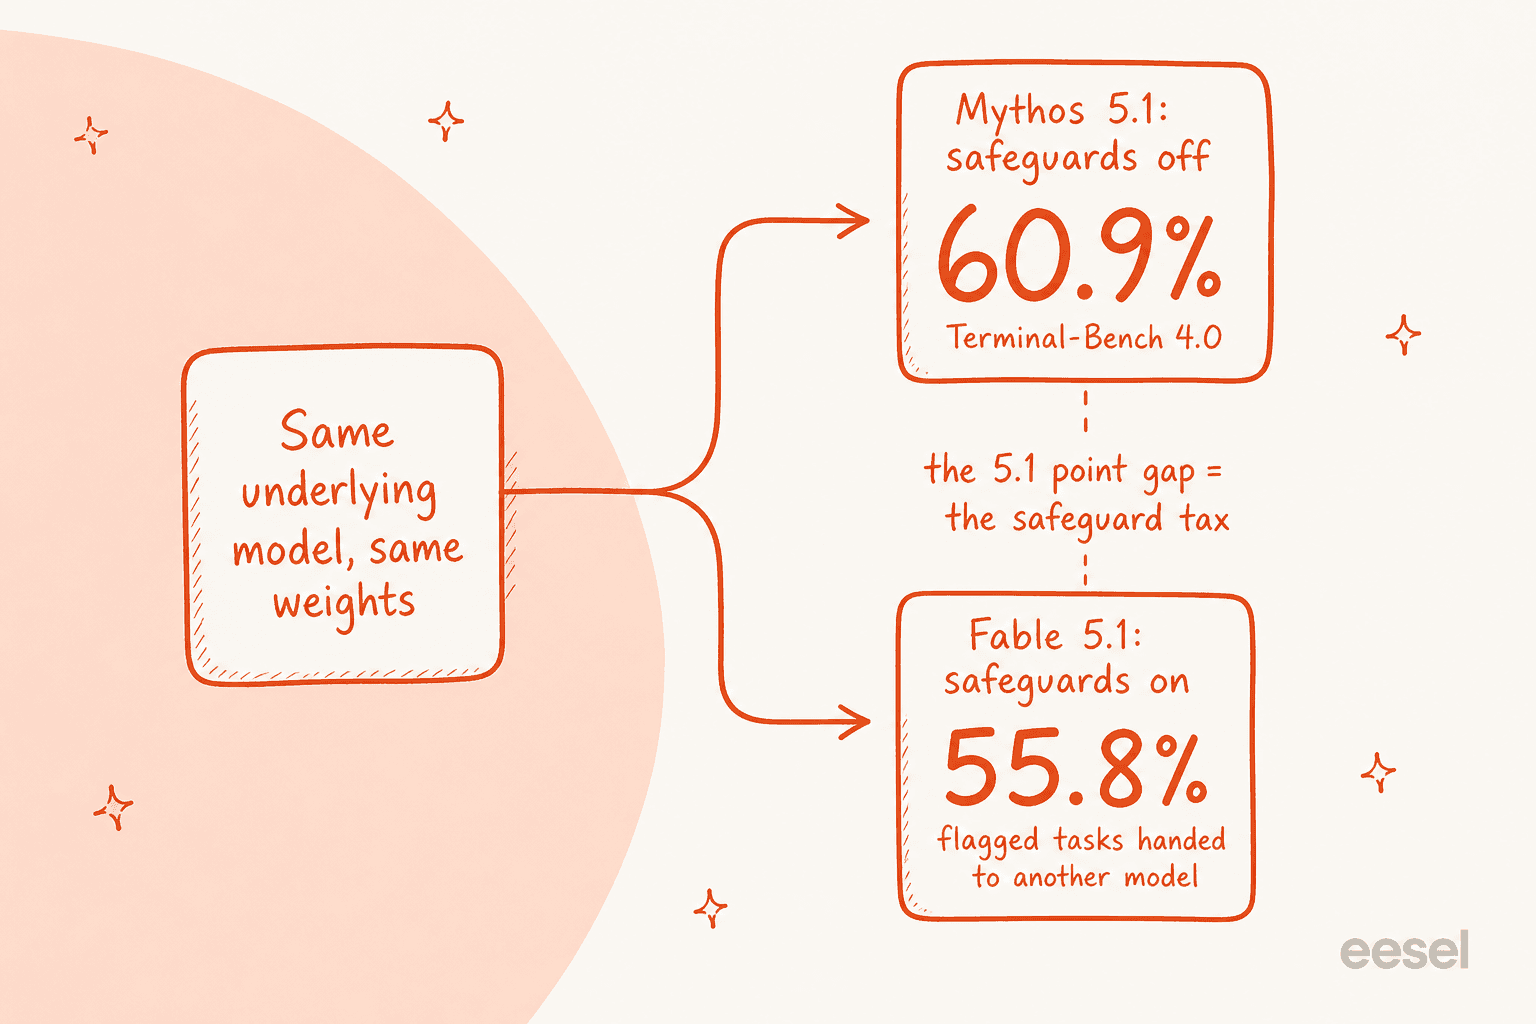
O que é preciso entender antes de qualquer conversa sobre benchmarks: Mythos 5.1 e Fable 5.1 são os mesmos pesos. A única diferença é a camada de proteção. O Fable 5.1 é a versão avaliada e lançada com as proteções de produção ligadas, e quando uma proteção é acionada, ela transfere a tarefa para outro modelo (trabalho cibernético vai para o Opus 4.8, biologia vai para o Opus 5). O Mythos é o mesmo modelo medido com essas proteções desligadas. Essa relação é toda a história, então vou voltar a ela o tempo todo.
Mythos 5.1 vs. Fable 5.1: a diferença é um imposto de segurança
Aqui está o número que todo mundo cita fora de contexto. No Terminal-Bench 4.0, o Mythos 5.1 marca 60,9% e o Fable 5.1 marca 55,8%. Parece que o Mythos é o modelo mais inteligente. Não é. A pontuação mais baixa do Fable é o que acontece quando as proteções interceptam uma tarefa e a redirecionam, e uma tarefa interceptada pode zerar totalmente. A diferença de 5,1 pontos é o custo das proteções, não uma diferença no cérebro subjacente.
Isso confundiu bastante gente no lançamento. Como um comentarista no Hacker News colocou:
"Espera, então é literalmente o mesmo modelo mas pontua mais alto porque você desligou o cinto de segurança? Isso não é um modelo novo, é uma nota de rodapé de benchmark."

A própria Anthropic espera que a diferença diminua conforme as proteções ficarem mais precisas, o que é uma admissão tácita de que a diferença está na camada de segurança e não na qualidade do modelo. Então, se você está comparando Mythos e Fable pela capacidade bruta, pare: eles são iguais. Onde o Fable justifica sua existência é no próprio trabalho de proteção. Ele agora consegue identificar vulnerabilidades de software no código-fonte, dispara cerca de 60% menos intervenções de segurança cibernética por sessão do Claude Code, e suas proteções de biologia disparam 85% menos em solicitações inofensivas. Testes de invasão, geração de exploits e varredura de vulnerabilidades binárias ainda vão para o Opus. Os dois modelos ficam ao lado do resto da linha, então, se você quer o mapa completo da família, os artigos sobre Claude Opus 5 e Claude Sonnet 5 cobrem os níveis abaixo.
Para registro, veja como o Fable 5.1 (seu substituto prático do Mythos) se posiciona frente à concorrência com base nos números publicados:
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6 | 24.7 | 29.0 | 22.4 |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| AutomationBench | 31.4 | 17.1 | 26.9 | 19.6 |
| CursorBench 3.2.0 | 73.4 | 70.5 | 70.0 | 67.2 |
| HLE with tools | 65.0 | 63.8 | 63.6 | - |
O salto no Terminal-Bench-Science, de 24,7 para 52,6, é o que eu realmente destacaria para um comprador. Para um confronto direto com o lado da OpenAI, os artigos sobre GPT-5.6 Sol e GPT-5.6 vs Claude vão mais a fundo do que uma única linha permite.
A verdadeira manchete é a leitura de cache a US$ 0,25
Se você só levar um número desta análise, leve este. Fable 5.1 e Mythos 5.1 cobram US$ 0,25 por milhão de tokens em um acerto de cache, o que equivale a 0,025x a tarifa base de entrada. Todos os outros modelos Claude cobram 0,1x, ou seja, US$ 1,00. Este é um modelo com o dobro do preço base do Opus 5 oferecendo uma leitura de cache pela metade do preço do Opus 5 (US$ 0,50).
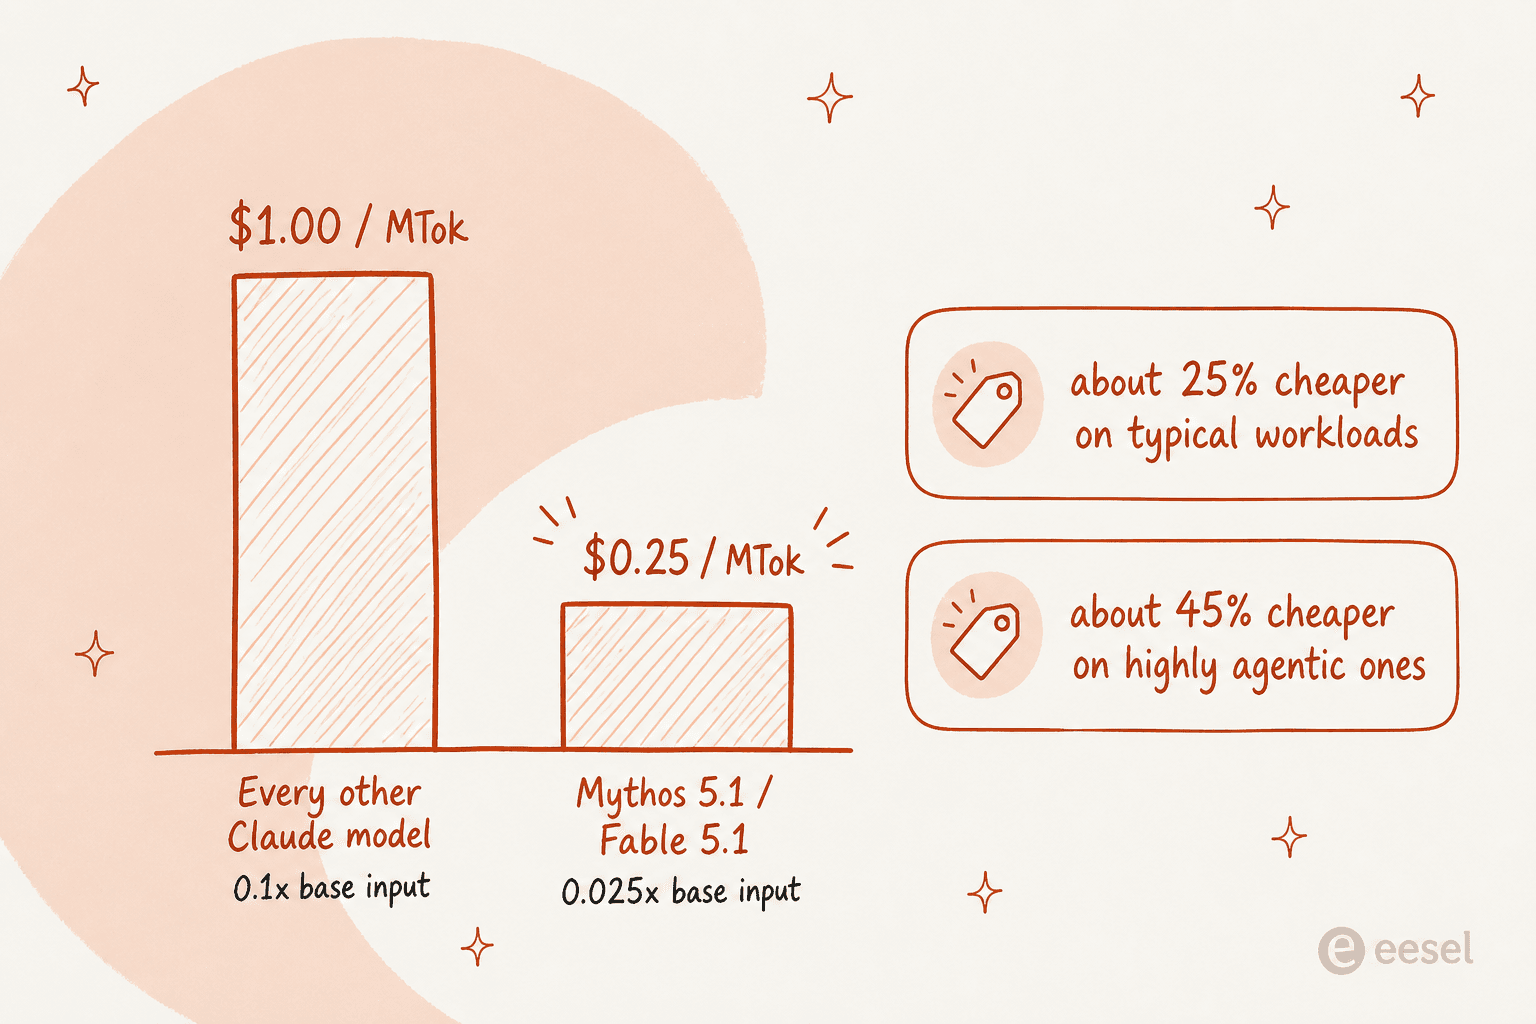
A Anthropic mediu o efeito ao longo de quatro semanas de uso em agosto de 2026: cerca de 25% mais barato em cargas de trabalho típicas e cerca de 45% mais barato nas altamente agênticas. A tarifa base (US$ 10 de entrada / US$ 50 de saída) não muda, o modo batch custa US$ 5 / US$ 25, a escrita de cache de cinco minutos custa US$ 12,50, e a de uma hora custa US$ 20. Se você roda agentes de contexto longo que releem a mesma base de conhecimento em cada turno, esse é o número que realmente move sua conta, muito mais do que a tarifa base. Um comentarista do Hacker News fez as contas em voz alta:
"A leitura de cache a 0,025x é absurda. Com uma taxa de acerto de 95%, o custo efetivo de entrada é basicamente o preço do cache, então você está pagando centavos para manter um contexto enorme aquecido."
Para ver como a economia de cache se traduz numa stack de agentes real, o guia de preços da API da Anthropic e o detalhamento de preços do Claude Code são os próximos que eu leria.
Quem realmente consegue rodar o Claude Mythos 5.1
Aqui é onde a análise se torna prática, e um pouco decepcionante. O Mythos 5.1 não é algo que você liga com uma chave de API. O acesso é restrito aos EUA hoje e passa por um de três portões: o Cyber Verification Program (a Anthropic diz que o acesso ao Mythos está chegando "num futuro próximo", então ainda não está no ar), uma beta do Life Sciences Program só por convite, construída com o governo dos EUA, ou uma conversa direta com sua equipe de conta na Anthropic, AWS ou GCP. Além disso, usar o Mythos 5.1 exige aceitar retenção de dados por 30 dias por padrão.
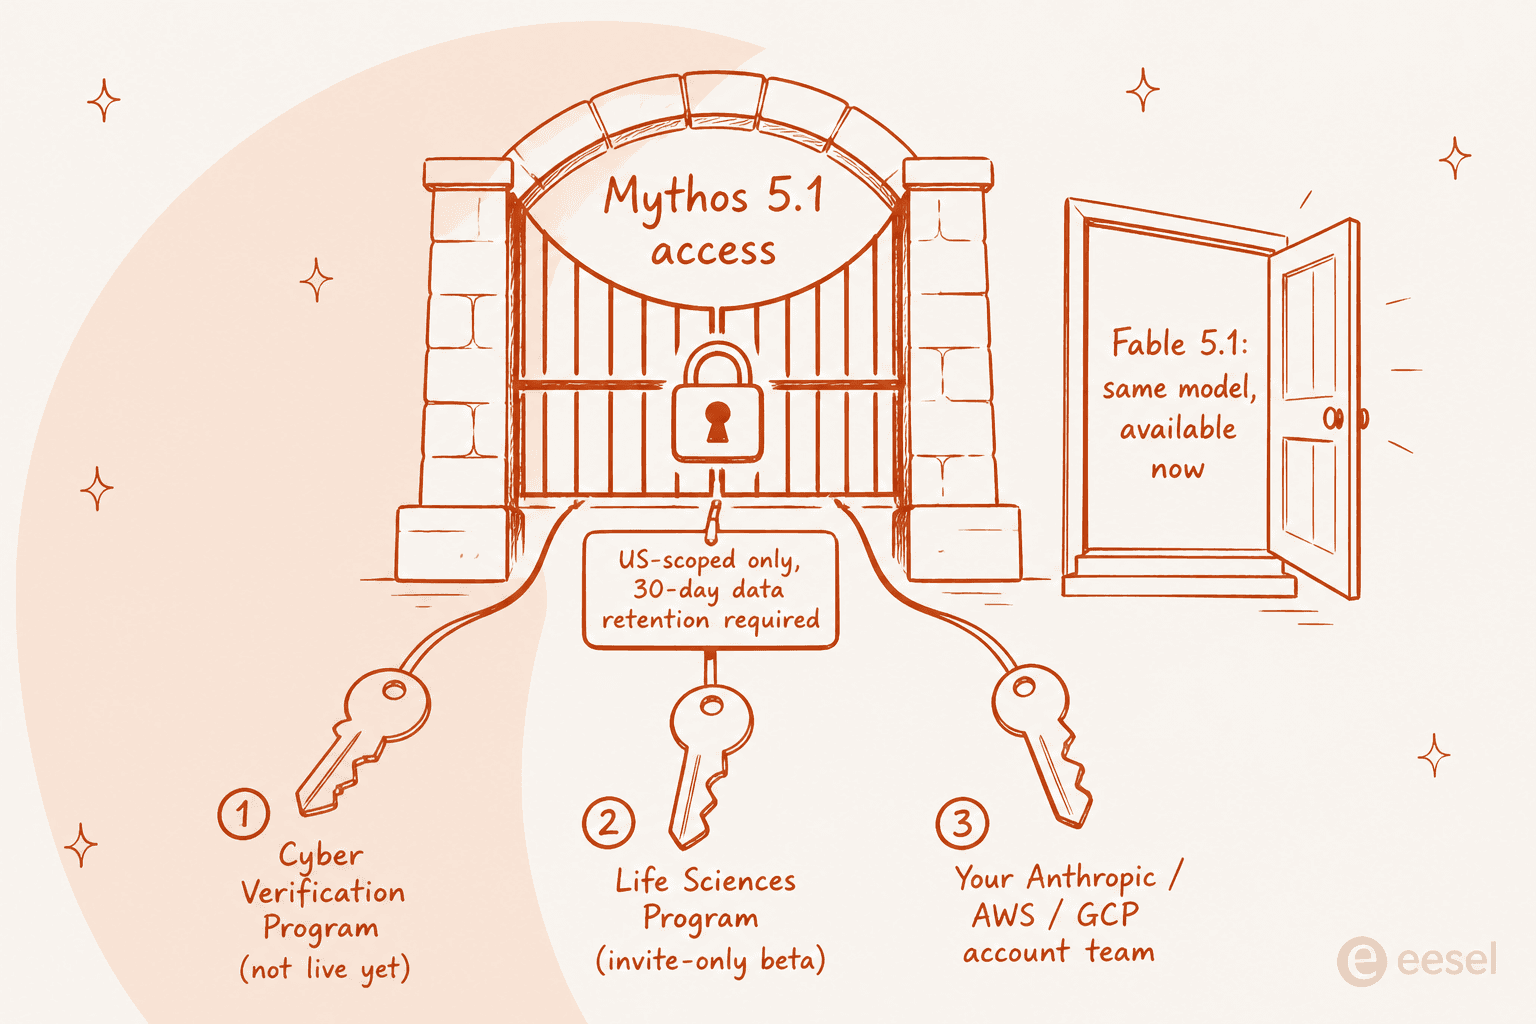
Então a resposta honesta para "devo rodar o Mythos 5.1" é que, para quase todo mundo, isso não está nem no radar, e a versão que você pode rodar, o Fable 5.1, é o mesmo modelo. Isso não é uma crítica ao modelo, é um motivo para direcionar sua avaliação para o irmão que você realmente pode implantar. Se você está escolhendo um modelo Claude para uma carga de trabalho real hoje, os guias de alternativas ao Claude e o melhor modelo de IA para tickets de suporte são as leituras mais pragmáticas.
A ficha técnica
Para quem quer todos os números em um só lugar, aqui está o que o Mythos 5.1 (e, portanto, o Fable 5.1) traz:
| Especificação | Valor |
|---|---|
| Janela de contexto | 1M tokens |
| Saída máxima | 128K tokens |
| Thinking | Adaptativo, sempre ativo; esforço padrão high |
| Corte de conhecimento | Junho de 2026 |
| Latência | Mais lenta |
| Modalidade | Texto + imagens para texto |
| Plataformas | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry |
| Descontinuação | Não antes de 1º de setembro de 2027 |
Duas mudanças voltadas para desenvolvedores vale a pena conhecer antes de programar. Existem três alterações de API que quebram compatibilidade e afetam os dois modelos: o uso forçado de ferramentas agora retorna um erro, os blocos de "thinking" ficam vinculados ao modelo que os produziu, e novas contas de API criadas a partir do dia do lançamento não conseguem editar contexto anterior mantendo a transcrição de "thinking", uma medida contra destilação. Também há uma peculiaridade do EU AI Act: modelos lançados após 2 de agosto de 2026 carregam uma marca de água invisível no texto, com uma API de detecção em pré-visualização privada. Essa marca de água foi o que gerou mais polêmica na discussão do lançamento. Se você está integrando um modelo Claude à sua própria stack, as notas sobre seleção de modelo no Claude Code e o artigo sobre agentes gerenciados da Claude são os próximos passos práticos.
O que eu realmente usaria
Aqui está minha conclusão depois de refletir sobre o lançamento. O Mythos 5.1 é um ótimo modelo que você provavelmente não pode usar, embrulhado em torno de uma mudança de preços genuinamente ótima que você pode. A jogada não é correr atrás do convite. É rodar o Fable 5.1, aproveitar a leitura de cache a US$ 0,25, e tratar toda essa narrativa de Mythos contra Fable como a nota de rodapé de segurança que ela realmente é.
E há um ponto maior escondido em "o modelo é a parte fácil". Um modelo de fronteira, seja Mythos ou Fable, é infraestrutura. Não é um agente de suporte, um pesquisador, ou um colega de equipe por conta própria. Colocar uma chave de API pura do Claude ao lado do seu helpdesk te dá um gerador de texto muito inteligente que não conhece sua política de reembolso, não consegue ver seus últimos 10.000 tickets, e não tem como ser testado antes de falar com um cliente. Fechar essa lacuna é o verdadeiro trabalho, e é o mesmo trabalho independentemente de o modelo por trás ser Mythos, Fable, ou Opus 5.
Experimente o eesel para a parte que o modelo não faz
Se o motivo pelo qual você está lendo uma análise do Claude Mythos 5.1 é que você quer uma IA mais inteligente na sua fila de suporte, aqui está a entrega honesta: o modelo não é o gargalo, a infraestrutura em torno dele é. É exatamente para isso que o eesel existe.
Pense nisso como uma nova contratação. O eesel é uma plataforma de colegas de equipe de IA, e o colega de equipe de IA para helpdesk entra na sua fila já existente já treinado nos seus tickets passados, na sua central de ajuda e nas suas macros, então a inteligência bruta do modelo é direcionada para o contexto real da sua empresa em vez da web aberta. Antes de responder a um cliente real, você pode simulá-lo contra seus tickets históricos para ver exatamente o que ele teria dito, que é o único hábito que já salvou minha equipe de enviar uma resposta errada com confiança mais vezes do que consigo contar. Ele se conecta ao seu helpdesk em minutos, seja Zendesk, Freshdesk, Front, Gorgias ou Help Scout.
E como boa parte de quem lê a análise de um modelo é formada por desenvolvedores, vale dizer que o eesel não é só um painel. Existe uma CLI real do eesel além de um servidor MCP, então você pode operar o mesmo colega de equipe a partir de um terminal, integrá-lo aos seus próprios fluxos de trabalho, ou deixar um agente de código como o Claude Code operá-lo. É o mesmo colega de equipe, seja você usando cliques ou rodando sem interface. Você pode experimentar o eesel de graça, e se preferir ver primeiro nos seus próprios tickets, agende uma demonstração.
Perguntas frequentes
O que é o Claude Mythos 5.1?
O Claude Mythos 5.1 é o modelo de fronteira da Anthropic lançado em 1º de setembro de 2026, avaliado em benchmarks com as proteções de produção desligadas. Ele compartilha os mesmos pesos subjacentes do Fable 5.1, a versão com as proteções ligadas que a maioria das pessoas realmente usa. Veja o guia completo do Claude Mythos para o contexto de toda a família.
Qual a diferença entre o Claude Mythos 5.1 e o Fable 5.1?
São o mesmo modelo com uma camada de proteção diferente. Na minha análise do Claude Mythos 5.1, a única diferença mensurável é que o Fable transfere tarefas sinalizadas para outro modelo, o que custa alguns pontos de benchmark. Para um olhar mais profundo sobre o modelo irmão, leia a análise do Claude Fable 5.1.
Quanto custa o Claude Mythos 5.1?
O preço base é de US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de saída, igual ao Fable 5.1. A grande novidade é a leitura de cache a US$ 0,25 por milhão de tokens. O detalhamento de preços do Claude Fable 5.1 e o guia mais amplo de preços do Claude cobrem o resto.
Qualquer pessoa pode usar o Claude Mythos 5.1?
Ainda não. O acesso é restrito aos EUA e passa pelo Cyber Verification Program, pelo Life Sciences Program ou pela sua equipe de conta na Anthropic, AWS ou GCP, e usá-lo exige aceitar retenção de dados por 30 dias. Se você quer um modelo Claude que já pode usar hoje, veja os guias de alternativas ao Claude e o melhor modelo de IA para tickets de suporte.
O Claude Mythos 5.1 é bom para atendimento ao cliente?
O modelo é forte, mas um modelo puro é infraestrutura, não um agente de suporte. Para colocar um modelo Claude na sua fila de atendimento, você ainda precisa de recuperação de informação, guardrails e testes, que é exatamente o que conectar o Claude ao seu helpdesk e um software de atendimento ao cliente com IA como o eesel fazem por você.