O que o Claude Opus 5.5 realmente é
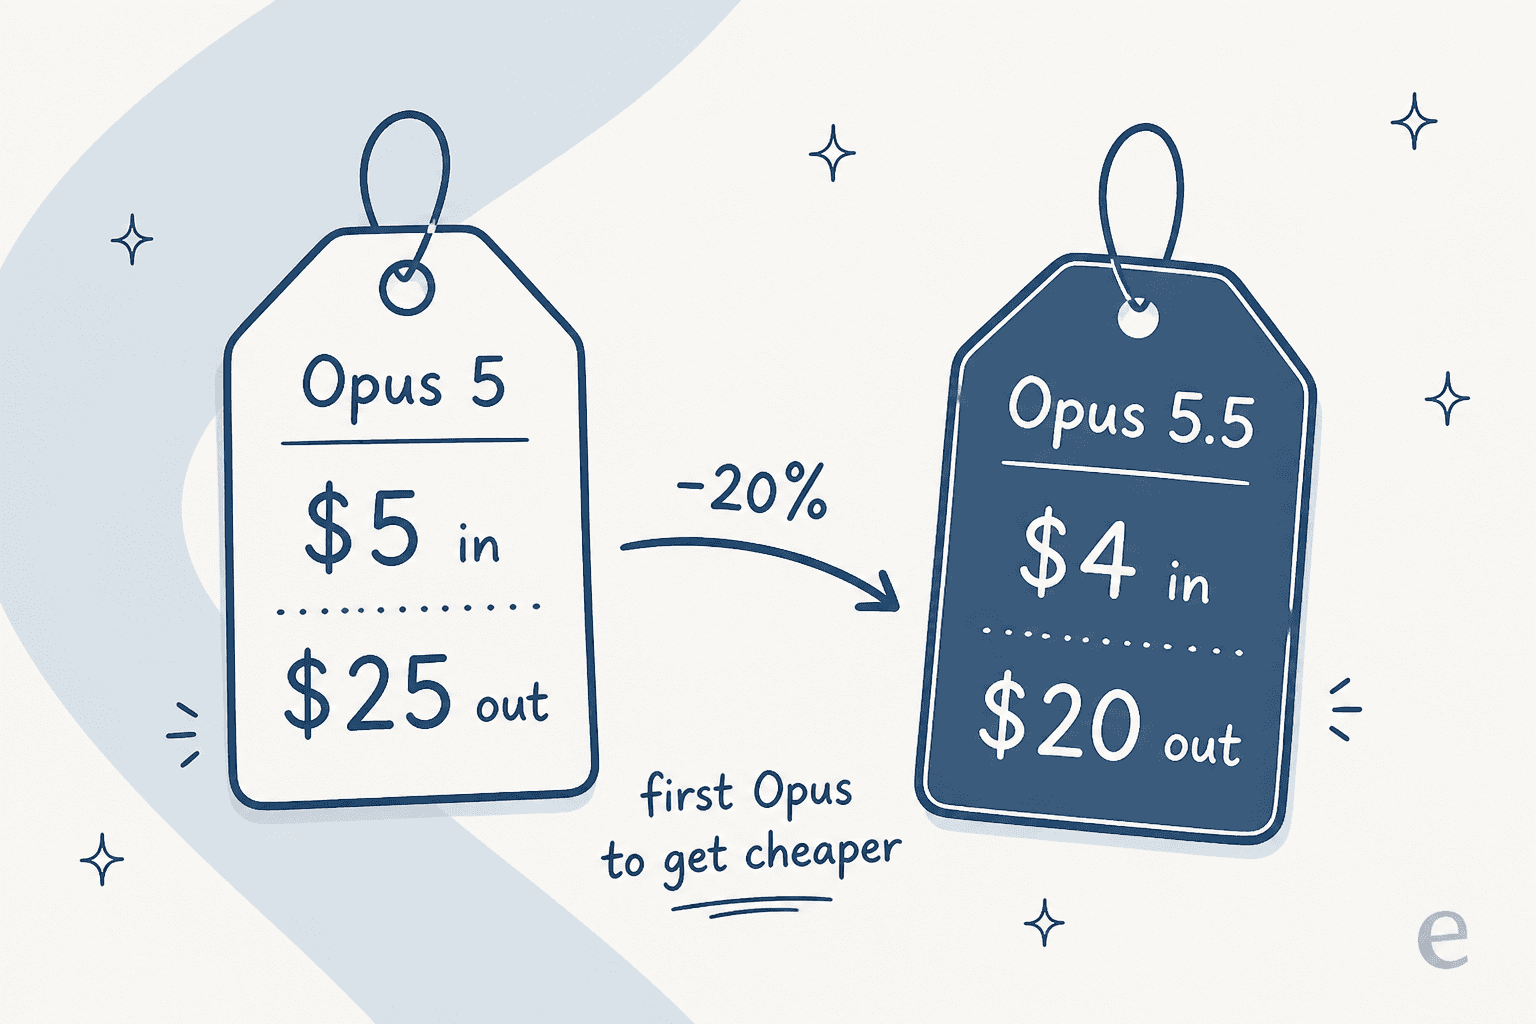
A Anthropic lançou o Claude Opus 5.5 a 22 de setembro de 2026, e entende-se melhor como um ajuste de eficiência sobre o Opus 5 do que como um modelo totalmente novo. A grande novidade é a inversão: todos os Opus anteriores foram lançados a preço premium, e este é o primeiro a ser lançado mais barato do que o modelo que substitui.
O preço passou dos $5/$25 do Opus 5 para $4/$20 por milhão de tokens, um corte plano de 20%. Isso soa a pouco até nos lembrarmos para que o Opus normalmente serve: trabalho longo, intensivo em tokens e autónomo, em que o lado da saída da conta domina. Um corte de 20% na taxa de $20 de saída é onde a maioria das equipas sente o impacto.
Além do preço, várias coisas mudaram nos bastidores. O esforço padrão desceu de high para medium, o thinking está sempre ativo, e a Anthropic diz agora para começar com o Opus 5.5 na maior parte do trabalho, em vez de tratar o Opus como o nível premium de último recurso. Tem uma janela de contexto de 1M de tokens, até 128K tokens de saída (300K em Batch), visão nativa e uma data de corte de conhecimento de junho de 2026. É o modelo padrão no Claude Max, o mais forte no Claude Pro, e é o que alimenta o Claude Code para programação agêntica.
O seletor de esforço é a análise inteira
Eu construo agentes de IA na eesel, por isso cada lançamento de fronteira significa a mesma rotina: correr novamente as minhas avaliações, olhar para o custo por trabalho concluído, decidir o que muda. O que mais me surpreendeu no Opus 5.5 não foi a qualidade, foi o quanto a definição de esforço domina tudo o resto na sua utilização.
Eis o mecanismo. O Opus 5.5 expõe um controlo de esforço com cinco níveis: low, medium (o novo padrão), high, very high e max. Um esforço maior não faz apenas com que "se esforce mais" de forma vaga; faz com que o modelo raciocine durante mais tempo e emita muitos mais tokens antes de responder. Com esforço máximo numa tarefa difícil, gastou cerca de 119k tokens de saída, contra uma execução muito mais enxuta com esforço baixo. Como a saída é cobrada a $20 por milhão, o seletor de esforço é, na prática, um seletor de custo disfarçado de rótulo de qualidade.
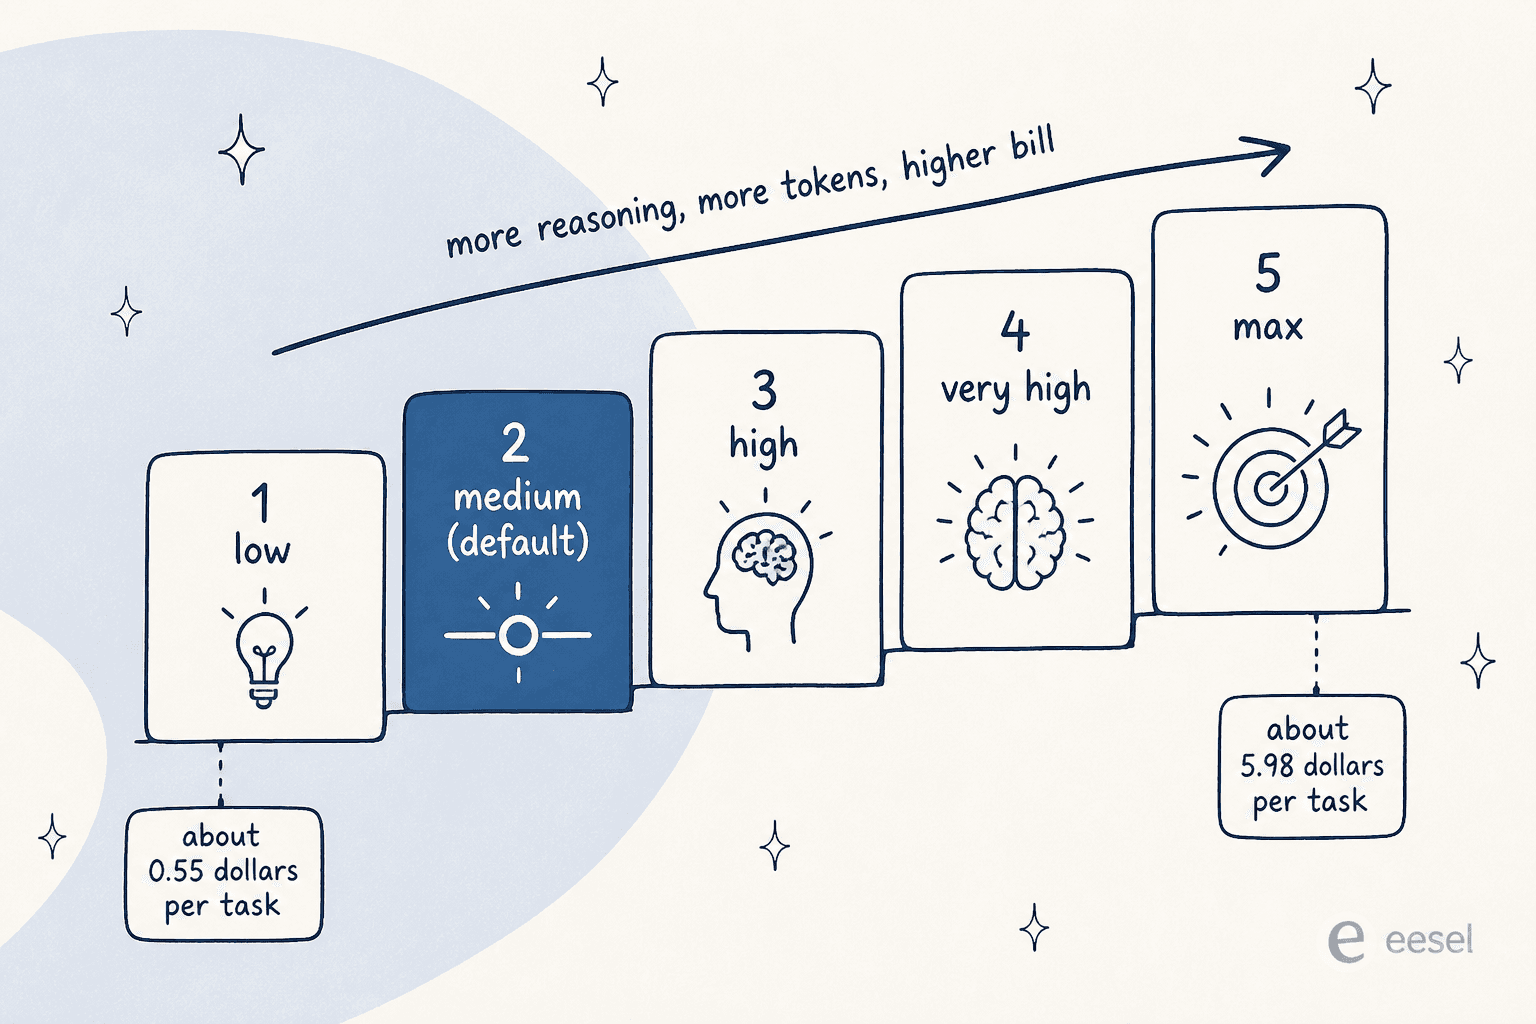
É por isso que a taxa por token é quase uma distração. Segundo a própria medição da Artificial Analysis, a mesma tarefa difícil custa cerca de $0,55 com esforço baixo, cerca de $1,34 com esforço médio e cerca de $5,98 com esforço máximo. A inteligência pela qual está a pagar sobe junto: a execução com esforço baixo pontua 42 no Intelligence Index, o médio atinge 51, e só no máximo chega aos 58 do título. Por isso, a pergunta real ao implementar o Opus 5.5 não é "consigo pagar isto", é "qual é o nível de esforço mais baixo que ainda passa a fasquia para esta tarefa". Na maioria das vezes, é o médio.
Este é também o maior senão para quem vem do Opus 5, onde o esforço padrão era high. Ao colocar a mesma carga de trabalho no Opus 5.5 sem tocar na definição, a conta por tarefa pode efetivamente descer, porque o padrão agora está um nível mais baixo. É um padrão genuinamente bem pensado, mas significa que não se pode deduzir o custo apenas pelo preço de tabela.
Os benchmarks: ganha em quase todas as categorias
Deixando o preço de lado por um momento, em capacidade pura o Opus 5.5 é o líder claro. No Intelligence Index da Artificial Analysis está no número um com 58, à frente de todo o campo de fronteira. E não é um acaso de um único benchmark: lidera no GDPval-AA (1846), no AutomationBench e nas avaliações de programação de longo alcance que mais importam para agentes.
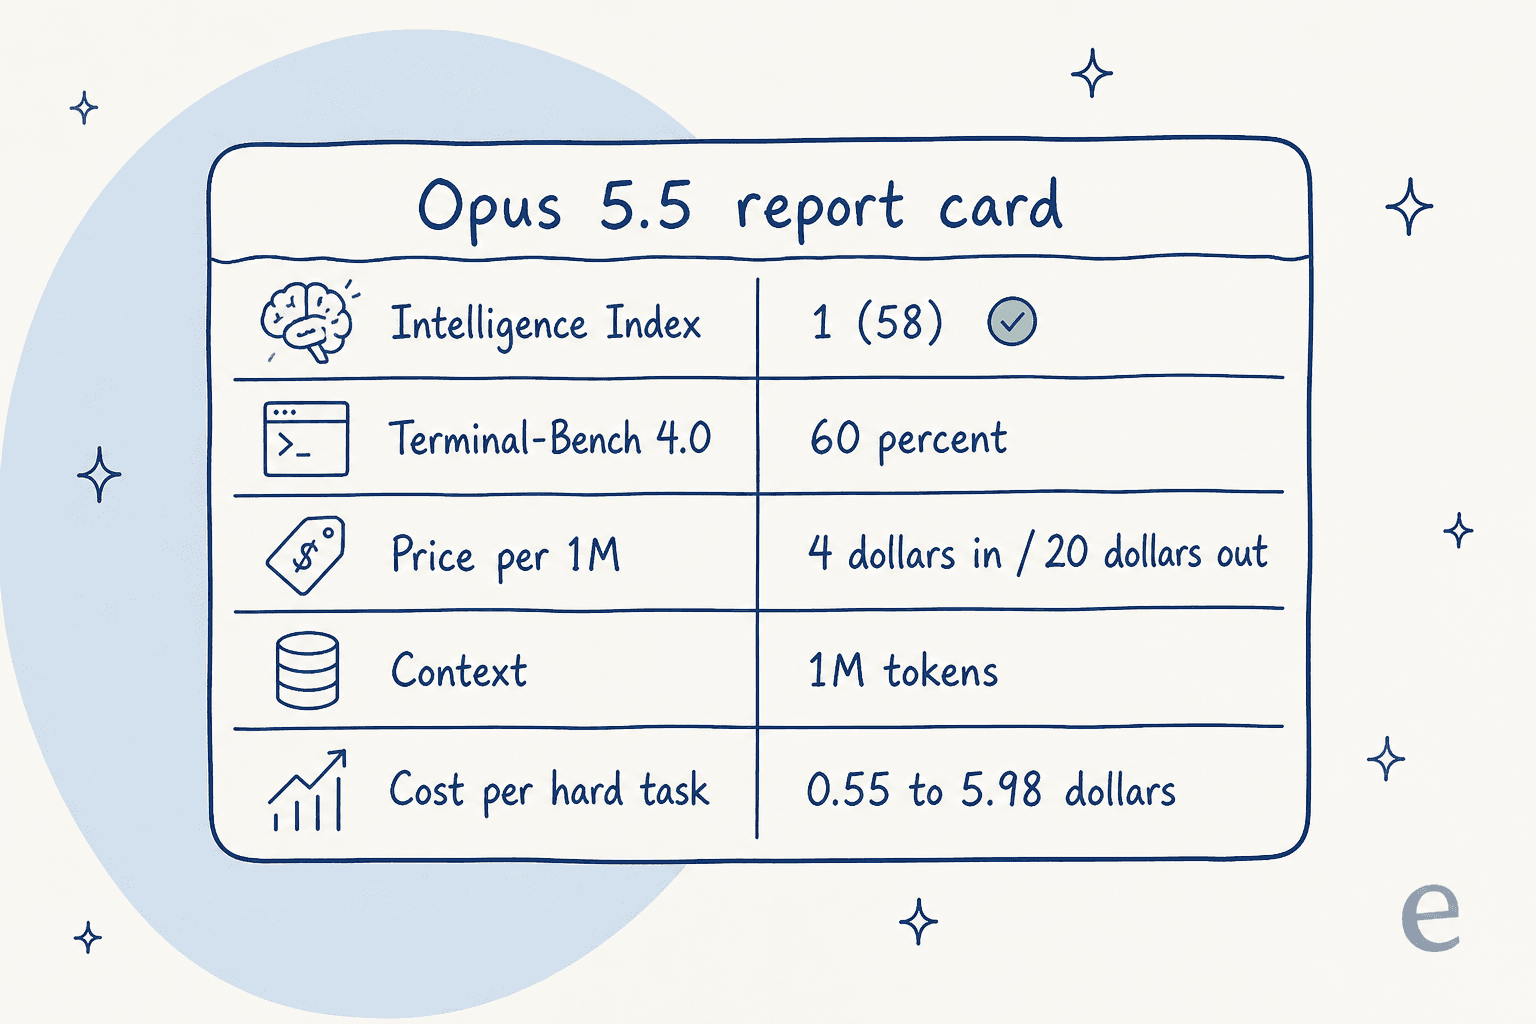
A história da programação é onde ele mais claramente se destaca. No Terminal-Bench 4.0, executado através do harness da Artificial Analysis a esforço máximo, o Opus 5.5 pontuou 60% contra 44% do seu rival mais próximo em preço. É o tipo de diferença que se traduz em menos becos sem saída numa execução longa de programação agêntica, exatamente a carga de trabalho para a qual a Anthropic o afinou. Se faz trabalho de engenharia difícil, autónomo e de vários passos, este é o modelo que termina tarefas em que outros modelos ficam presos.
Onde eu acrescentaria uma ressalva: a pontuação máxima é um número de esforço máximo, e esforço máximo é a definição de $5,98 por tarefa. Os benchmarks que coroam o Opus 5.5 medem-no no seu ponto mais caro. Isso é justo, todos os modelos são medidos no seu teto, mas significa que a vitória no leaderboard e a experiência do dia a dia não são a mesma coisa, a menos que esteja sempre a pagar pelo máximo.
O que o Claude Opus 5.5 realmente custa
Aqui está a tabela de preços completa, porque os preços "a partir de" escondem exatamente as partes que doem em trabalho intensivo em tokens.
| Item | Taxa |
|---|---|
| Entrada (por 1M de tokens) | $4 |
| Saída (por 1M de tokens) | $20 |
| Leitura de cache (por 1M de tokens) | $0,20 |
| Sobretaxa de contexto longo | Nenhuma |
| Janela de contexto | 1M de tokens |
| Saída máxima | 128K tokens (300K em Batch) |
| Custo por tarefa difícil (AA) | $0,55 (low) a $5,98 (max) |
Duas linhas merecem um segundo olhar. Primeiro, não há sobretaxa de contexto longo, o que distingue o Opus 5.5 de rivais que duplicam a taxa de entrada a partir de um determinado limiar; em trabalhos com contexto enorme, esse preço fixo fecha silenciosamente a diferença por token. Segundo, as leituras de cache a $0,20 por milhão significam que, se a sua carga de trabalho for um prompt de sistema grande e estável mais perguntas curtas, uma grande fatia da sua conta de entrada sai barata.
Um exemplo rápido. Digamos que corre 1.000 tarefas de agente difíceis por mês. Com esforço médio ($1,34 cada) isso dá cerca de $1.340. Se levar as mesmas 1.000 tarefas para esforço máximo em busca dos últimos pontos de inteligência, fica por cerca de $5.980. Essa oscilação de 4x é uma escolha de configuração, não uma mudança de plano, e é o custo por tarefa que eu colocaria no quadro antes de integrar o Opus 5.5 em qualquer coisa de alto volume. Para o detalhamento completo com Batch e taxas regionais, veja o meu guia de preços do Opus 5.5, e a comparação mais ampla OpenAI API vs Anthropic API mostra como ele se compara com a outra plataforma de fronteira.
Onde o Opus 5.5 justifica o preço, e onde não justifica
Deixe-me ser concreto quanto ao encaixe, porque "é o melhor modelo" é verdadeiro e inútil ao mesmo tempo.
Justifica o preço quando a tarefa é difícil, longa e cara de errar. Um agente de programação de várias horas a refatorizar uma base de código real, uma tarefa de investigação que precisa de manter um contexto enorme e raciocinar sobre ele, um problema ambíguo em que um modelo mais barato gira em círculos. Nesses casos, os tokens extra compram um resultado terminado em vez de um beco sem saída com aparência plausível, e a conta é barata face às horas de engenharia que poupa.
É a ferramenta errada quando a tarefa é bem definida e de alto volume: classificação, respostas curtas, tradução, pesquisas simples, os 80% enfadonhos da maioria das cargas de trabalho em produção. Pagar preços e latência de Opus por trabalho que um modelo intermédio resolve sem esforço é dinheiro e velocidade que não recupera. O Opus é deliberadamente pausado por conceção, por isso, para tudo o que um humano espera em direto, como uma resposta de chat, a capacidade de resposta importa mais do que os últimos pontos do Intelligence Index. É esse o argumento para uma configuração de dois modelos: encaminhar as tarefas genuinamente difíceis para o Opus 5.5 e tudo o resto para o Sonnet 5, ou recorrer a uma das opções mais baratas no meu resumo de alternativas ao Opus 5.5.
A conclusão honesta numa linha: o Opus 5.5 é o melhor modelo, e "melhor modelo" raramente é a mesma pergunta que "modelo certo para esta tarefa".
O que as pessoas estão realmente a dizer
A reação na thread de lançamento alinhou-se com os meus próprios testes: respeito genuíno pela capacidade, e um lembrete recorrente de que o rótulo no seletor de esforço importa mais do que o leaderboard. Um testador experiente, comparando-o com a concorrência de fronteira lançada no dia seguinte, chegou a esta conclusão:
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

Esse "at medium" está a fazer muito trabalho, e é essa a questão central desta análise. O outro tema que vale a pena realçar é o quão pouco um único benchmark deve decidir a sua escolha em 2026:
Only hands-on experience matters in the end, and these days it's very easy to switch models.
Essa última frase, "very easy to switch models", é a verdadeira história do ano, e leva diretamente à pergunta que a maioria das análises de modelos evita.
Experimente a eesel: o colega de equipa que corre em qualquer modelo
Toda análise de modelo assume silenciosamente que o trabalho do leitor é escolher um modelo, ligar a sua API, tratar do prompt engineering, ligá-lo às suas ferramentas e evitar que alucine com clientes reais. Para a maioria das equipas, esse não é o trabalho. O trabalho é uma taxa de resolução mais alta, ou publicações publicadas. Um modelo de fronteira como o Opus 5.5 é infraestrutura; é o motor, não o funcionário.

É assim que eu enquadraria a eesel. É uma plataforma de colegas de equipa de IA, e contrata-se colegas de equipa prontos a trabalhar para funções específicas. A equipa atual inclui um colega de equipa de IA para helpdesk que se junta à sua fila de suporte existente e uma redatora de blog com IA que redige publicações pesquisadas. Cada um chega já a conhecer a sua função, ligado às suas ferramentas e ancorado no contexto da sua empresa, por isso não é você quem escolhe entre níveis de esforço e vigia um prompt. Como o modelo fica por baixo do colega de equipa, um modelo mais barato ou mais inteligente lançado no próximo mês é uma atualização gratuita, não uma reconstrução, e o colega de equipa de IA para helpdesk é cobrado por ticket resolvido em vez de por token, por isso a matemática do seletor de esforço acima deixa de ser problema seu.
Se é do tipo de pessoa que lê uma análise de modelo até ao fim, vai gostar disto: tudo pode ser conduzido a partir do terminal. O CLI da eesel (npx @eesel/cli) liga integrações, edita as instruções permanentes do agente, simula uma implementação face aos seus tickets históricos, aprova ações e lê o registo de atividade de cada execução, tudo em JSON, com uma flag --dry-run que imprime a chamada exata que uma escrita faria antes de a enviar. Cada workspace é também um servidor MCP, por isso agentes de programação como o Claude Code, o Codex e o Cursor podem operar o mesmo colega de equipa. É o mesmo produto que o painel, exposto para pessoas e agentes que vivem num terminal. Pode experimentar a eesel gratuitamente.
Perguntas frequentes
Vale a pena o Claude Opus 5.5 em 2026?
Quanto custa o Claude Opus 5.5?
O que é o seletor de esforço no Claude Opus 5.5?
O Claude Opus 5.5 é bom para programar?
Preciso do Claude Opus 5.5 para construir um agente de suporte com IA?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.