

Quão rápido é "ultrarrápido"?
Velocidade é todo o argumento aqui, então começo pelos números que a TypeSafe de fato publica e depois os examino.
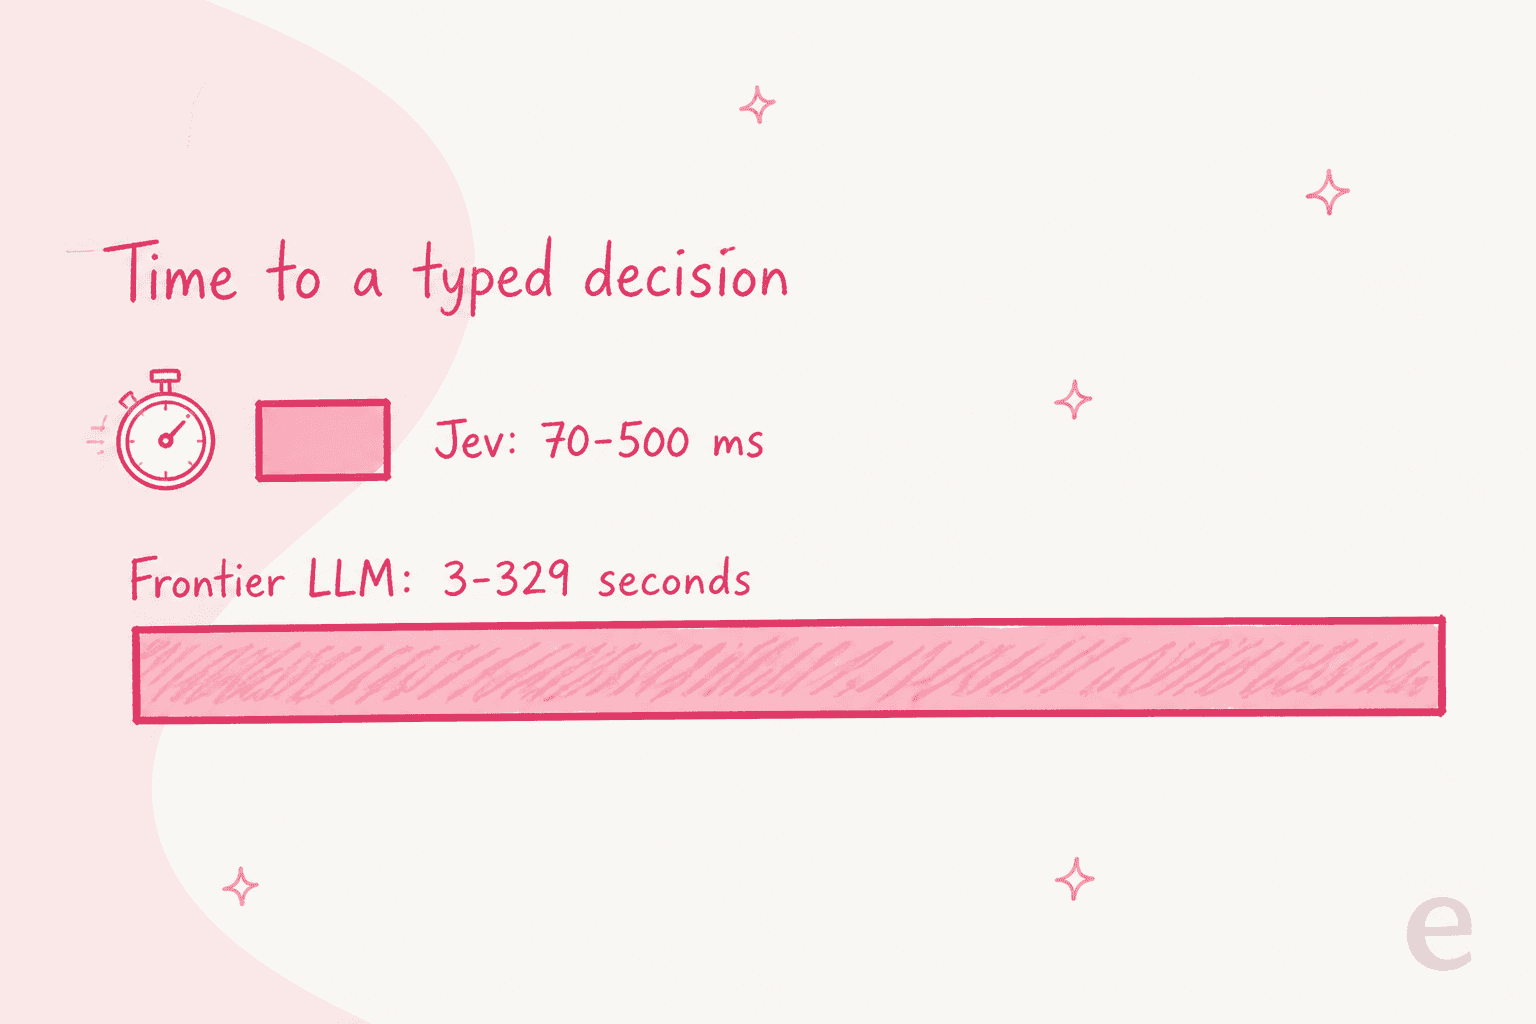
A TypeSafe diz que o tempo de resposta de ponta a ponta do Jev é de 70 ms a 500 ms, contra 3 a 329 segundos de LLMs de fronteira em consultas do tipo System One. Na página inicial ela vai mais longe, com um benchmark de fluxo de trabalho: 193,6x mais rápido e 444,6x mais barato, embora o post de lançamento admita com honestidade que esses números "estão na faixa alta dos ganhos do mundo real". Uma demo na mesma página marca uma única decisão em 0,114 segundo e US$ 0,000081, contra 8,566 segundos e US$ 0,013880 de uma referência com LLM.
Aqui está o mesmo conjunto com as ressalvas anexadas, porque as referências importam tanto quanto os números.
| Alegação | Jev | Referência declarada pela TypeSafe |
|---|---|---|
| Latência de ponta a ponta | 70 ms a 500 ms | 3 a 329 segundos para LLMs de fronteira |
| Múltiplo de velocidade | 40x a 200x mais rápido | em consultas do tipo System One |
| Manchete de fluxo de trabalho | 193,6x mais rápido | "na faixa alta dos ganhos do mundo real" |
| Demo de decisão única | 0,114 s | 8,566 s para a referência com LLM |
| Janela de contexto | 32.000 tokens | versão do modelo jev-1.13.0 |
A faixa de 70-500 ms é o número em que eu realmente me basearia, porque descreve uma requisição e não um fluxo de trabalho inteiro. Com essa latência, uma decisão cabe dentro de uma requisição que um usuário está esperando, o que não dá para fazer quando uma etapa de classificação leva oito segundos.
Por que o Jev é rápido: uma passagem paralela, não um fluxo de tokens
A velocidade não é um truque de ajuste, vem de um design diferente. Um LLM amostra um token por vez, em sequência, até produzir uma string para uma pessoa ler. O Jev gera todas as suas saídas em uma única passagem paralela e nunca produz texto livre.
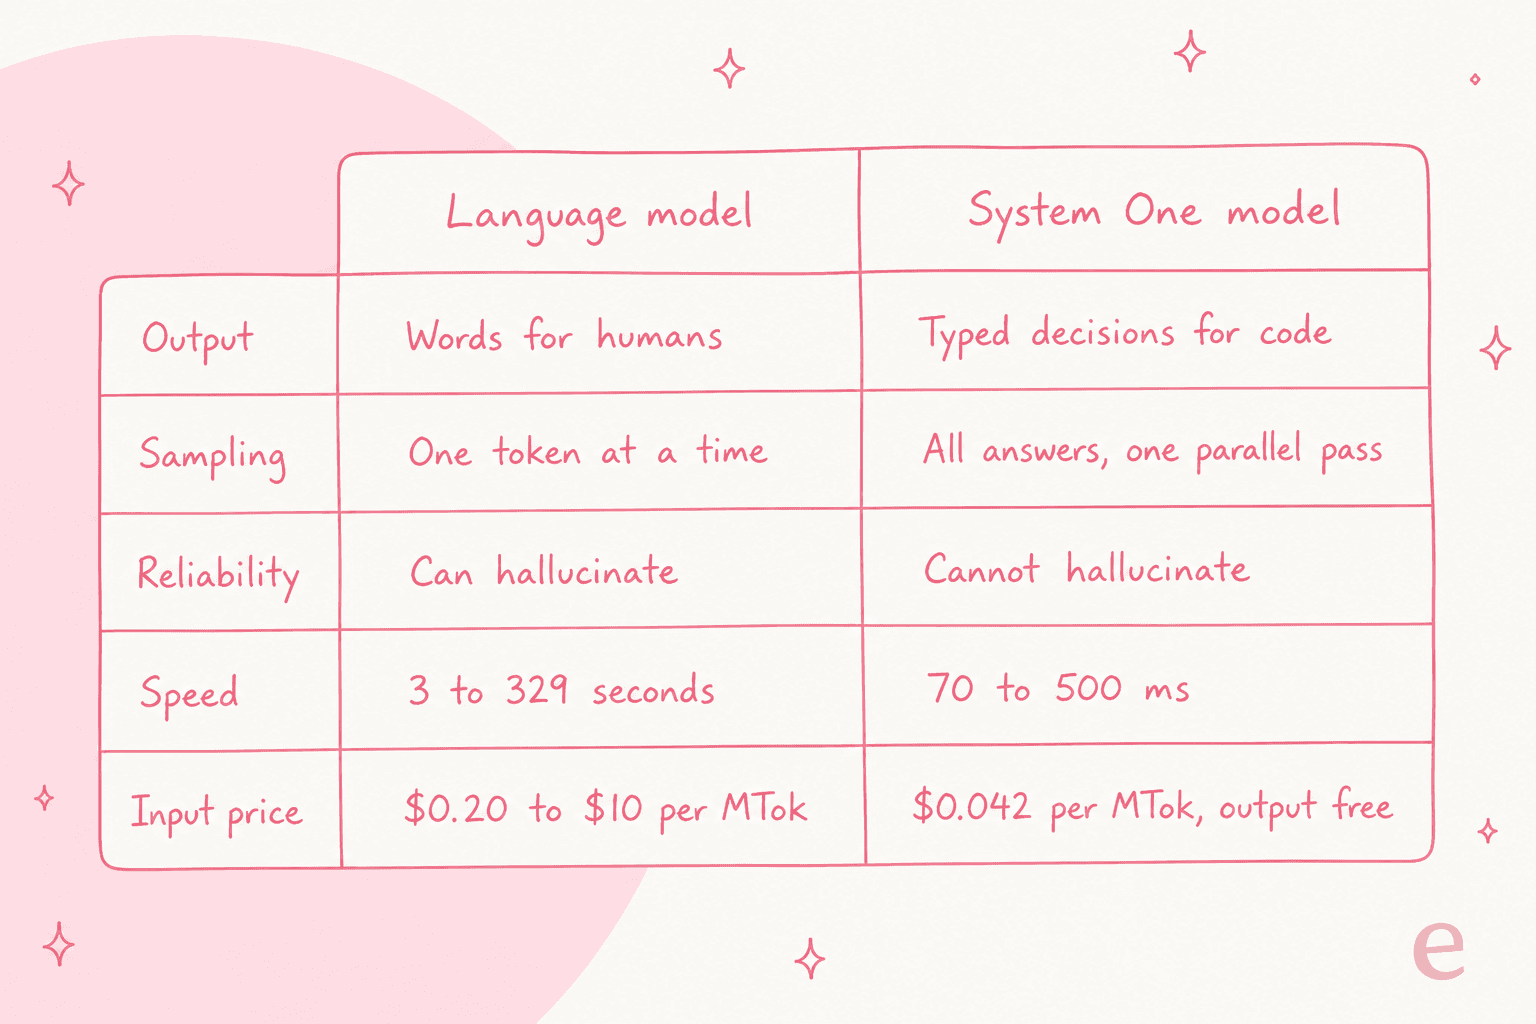
Você envia ao Jev um estado (uma string ou um objeto estruturado) mais um conjunto de perguntas tipadas. Ele avalia cada pergunta em paralelo contra esse mesmo estado e devolve respostas tipadas com probabilidades e uma pontuação de confiança. Como cada pergunta é pontuada separadamente, a TypeSafe diz que adicionar mais perguntas quase não muda o tempo de resposta, então você pode perguntar "é urgente?", "qual departamento?" e "quão frustrado?" em uma única chamada e ainda ficar dentro do seu orçamento de latência.
É por isso que descrever o Jev como uma primitiva rápida é mais justo que "um LLM mais rápido". Ele se encaixa onde hoje você força um modelo de linguagem a emitir um blob JSON que depois precisa parsear e torcer para ser válido, a mesma pergunta de "qual camada escolho" que aparece em AgentKit vs a API da Anthropic. Não se encaixa onde você precisa de redação, explicação ou raciocínio em várias etapas.
A comparação de velocidade não é exatamente equivalente
Esta é a parte que o pessoal do dia do lançamento percebeu em menos de uma hora, e vale ser direto. O Jev é rápido em parte porque faz menos. O comentário mais votado no tópico de 1.929 pontos do Hacker News reenquadrou todo o lançamento, e a crítica mais afiada sobre latência veio logo depois:
"'70-500ms vs 3-329 seconds' are apples-to-oranges unless the LLM baseline is doing comparable work... If Jev is skipping generation entirely for a narrow structured task, of course it's faster."

É uma crítica justa. Comparar um modelo que emite três valores tipados com um que escreve um parágrafo, e depois chamar o primeiro de 200x mais rápido, é medir duas coisas diferentes. A leitura honesta é que o Jev é extremamente rápido para a fatia de trabalho em formato de decisão que ele mira, e essa fatia é real e comum. Ele não é mais rápido nas tarefas que simplesmente não faz.
Então o número em que mais confio nem está no site da TypeSafe. Veio do CEO da Vercel, ao colocar o Jev em um produto em produção:
"We're seeing extraordinary results from @typesafeai... Jev is up to 18x faster (p95) and more accurate."
Um ganho de 18x no p95 em uma etapa real de revisão de segurança é menor e muito mais bem fundamentado que os 200x do marketing, e aponta exatamente onde o ultrarrápido compensa.
Onde a velocidade realmente compensa
A latência abaixo de um segundo só vale a pena quando uma decisão está no caminho crítico, com algo esperando a resposta. Esse é o padrão a procurar: um verificador rápido na frente de um sistema mais lento.
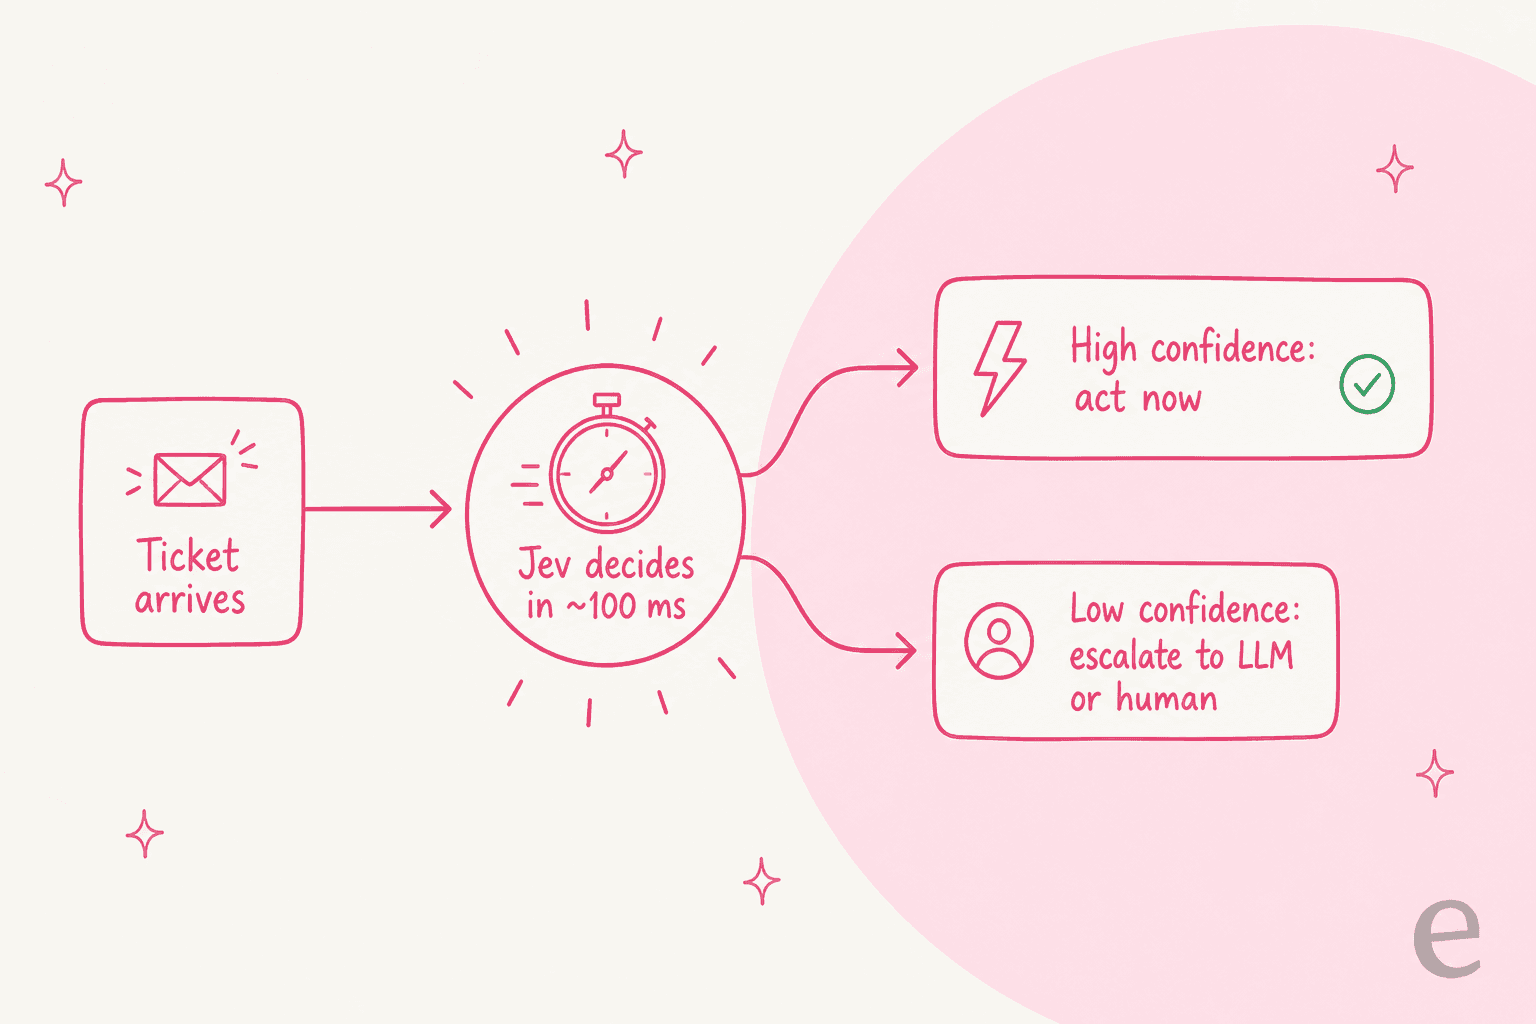
O exemplo prático que a Cloudflare publica é, de forma reveladora, um ticket de suporte: dê ao Jev "Help! My payouts have been failing for 3 days" e ele devolve is_urgent com 0,95, department como cobrança com 0,8 de confiança e uma pontuação de frustração, tudo em uma chamada. É triagem, roteamento e sentimento em uma única requisição, exatamente o tipo de etapa que um fluxo de triagem de tickets com IA executa milhares de vezes por dia. Quando cada chamada leva 100 ms em vez de 8 segundos, você pode executá-la de forma síncrona assim que o ticket chega, em vez de numa lenta fila em segundo plano.
O desenvolvedor que melhor resumiu o apetite já fazia isso à mão:
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing."
A pontuação de confiança é o que torna a velocidade utilizável em um laço assim: agir na hora sobre as respostas certas e encaminhar as duvidosas para um modelo maior ou uma pessoa. É a mesma disciplina por trás de um bom design de agentes de IA e de qualquer etapa séria de assistência ao agente, em que o objetivo é velocidade sem deixar uma decisão errada, mas confiante, chegar a um cliente.
Quanto custa rodar tão rápido
A outra metade do "ultrarrápido" é que ele é barato o bastante para ser chamado o tempo todo. A TypeSafe cobra pelo Jev US$ 0,042 por milhão de tokens de entrada com a saída gratuita, o que apresenta como 238x menos na entrada que o Claude Fable 5.1, e descreve a saída como "too cheap to meter". Ainda não há uma página de preços própria, e sobre sustentabilidade o post de lançamento é refrescantemente direto: "We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Barato por chamada mais rápido por chamada é o que destrava o argumento do paradoxo de Jevons que dá nome ao modelo: quando uma decisão custa uma fração de centavo e volta em 100 ms, você para de racioná-la e passa a chamá-la em todo lugar, do jeito que já se apoia em primitivas baratas na automação de fluxos de trabalho com IA. É uma postura bem diferente de pagar preço de LLM por cada classificação.
Vale construir em cima da velocidade do Jev?
Minha leitura depois de passar pela documentação, pelas demos e pelas críticas: use o Jev quando o trabalho for uma decisão estreita e bem delimitada que seu código consome e a latência estiver no caminho crítico, como roteamento, moderação, detecção de intenção, pontuação ou um portão de segurança rápido na frente de um modelo maior. É aí que os 70-500 ms e a saída gratuita realmente mudam o que você pode construir.
Não o use esperando um ChatGPT mais rápido. Ele não escreve, não explica nem mantém uma conversa, e uma ferramenta tão rápida convida ao uso excessivo em tarefas que um classificador simples ou uma regra deveria resolver. A linha a manter é que o Jev é uma primitiva: ele dá uma ótima decisão em milissegundos, e você continua dono do pipeline, da lógica de escalonamento, da estratégia de deflexão e de toda ação depois da decisão. Velocidade na decisão não compra nada disso.
Experimente a eesel
Se você cuida de suporte, a tradução honesta é esta: o Jev é um motor brilhante, não o carro. Ele dirá que um ticket é urgente, de cobrança e de um cliente frustrado em cerca de 114 milissegundos. Não abrirá o ticket, não redigirá uma resposta baseada na sua central de ajuda, não aplicará o reembolso nem passará para uma pessoa quando estiver em dúvida. Alguém ainda precisa construir essa camada.
A eesel é essa colega pronta. É uma colega de suporte com IA que você conecta ao seu helpdesk, e ela já toma as decisões de triagem, roteamento e escalonamento que o Jev expõe como primitivas, e depois age sobre elas de ponta a ponta. Ela aprende com seus tickets anteriores e sua central de ajuda, e você pode simular com tickets históricos antes que ela toque em um cliente real.

E se você gostou da ergonomia para desenvolvedores do Jev, vai gostar disto: a eesel não é só painel. A CLI da eesel (npx @eesel/cli) opera a mesma colega pelo terminal, uma pessoa pode rodar eesel chat ou eesel activity à mão, scripts podem automatizá-la no CI e agentes de código como Claude Code, Codex e Cursor podem conduzi-la, já que todo comando imprime JSON e --dry-run mostra a chamada exata antes de ela disparar. Todo workspace também é um servidor MCP. O Jev dá a decisão rápida; a eesel dá a colega que age sobre ela. Você pode experimentar a eesel grátis.
Perguntas frequentes
Qual é a velocidade do TypeSafe Jev?
A TypeSafe coloca o tempo de resposta de ponta a ponta do Jev em 70 ms a 500 ms, contra 3 a 329 segundos de um LLM de fronteira em trabalho do mesmo tipo. O porém é que o Jev só devolve decisões tipadas, não texto, então a comparação não é exatamente equivalente. Ele é realmente rápido nas tarefas de classificar e rotear por trás da deflexão de nível 1.
Por que o Jev é muito mais rápido que um modelo de IA comum?
Um LLM amostra um token por vez até escrever uma string que uma pessoa lê. O Jev avalia todas as suas perguntas em uma única passagem paralela e nunca gera texto livre, então pula a parte mais lenta. Isso também significa que ele é uma primitiva de decisão, não um substituto para um modelo que escreve ou raciocina, a mesma divisão que você vê entre um agente baseado em regras e um agente de IA.
A comparação de velocidade do Jev é justa?
Em parte. Um número real e bem fundamentado veio do CEO da Vercel, que mediu o Jev 18x mais rápido no p95 em uma etapa real de revisão de segurança. O número de marketing de 193,6x é de um fluxo de trabalho inteiro e, nas palavras da própria TypeSafe, está na faixa alta dos ganhos reais, ponto que o Hacker News apontou rapidamente.
Quanto custa o modelo ultrarrápido Jev?
A TypeSafe cobra pelo Jev US$ 0,042 por milhão de tokens de entrada com a saída gratuita, o que apresenta como um preço de entrada 238x menor que o do Claude Fable 5.1. Ainda não há tabela de planos e o acesso é por uma lista de espera de acesso antecipado. Ele também está disponível no Cloudflare Workers AI.
Posso usar o Jev para responder tickets de suporte sozinho?
Não sozinho. O Jev toma a decisão rápida, mas não abre o ticket, não redige uma resposta embasada nem aplica o reembolso. Uma colega pronta como a eesel toma essas decisões de atendimento ao cliente e age sobre elas no seu helpdesk, e você ainda pode conduzi-la pela CLI da eesel.