O que o TypeSafe Jev realmente é
A TypeSafe é um laboratório de IA de São Francisco que passou dois anos em modo stealth antes de lançar o Jev. Seu enquadramento é deliberadamente provocador: na página inicial da TypeSafe, os LLMs "produzem palavras para pessoas", enquanto "o Jev produz decisões tipadas e é mais parecido com código: confiável, rápido, autoconsistente e type-safe". O post de lançamento chama o Jev de "uma chamada de função com inteligência de fronteira: estado não estruturado entra, decisões probabilísticas tipadas saem".
O nome é uma piada interna em duas partes. "System One" toma emprestado de Rápido e Devagar: Duas Formas de Pensar, de Daniel Kahneman: a distinção que ele traçou entre o pensamento rápido e intuitivo do Sistema 1 e o raciocínio lento e deliberado do Sistema 2. Os modelos de chat perseguem o Sistema 2. O Jev foi construído para o Sistema 1: o julgamento instantâneo que uma pessoa experiente faz em poucos segundos. "Jev", por sua vez, tem o nome do economista William Stanley Jevons, cujo paradoxo a TypeSafe cita como sua tese: cada queda de uma ordem de grandeza no custo da inteligência libera ordens de grandeza a mais em casos de uso.
A premissa por trás de tudo isso é que o RLHF, a técnica que tornou os chatbots agradáveis para conversar, também os tornou pouco confiáveis para o consumo por máquinas. A proposta da TypeSafe é que ela "seguiu a direção de pesquisa oposta" e treinou uma nova classe de modelo com um novo algoritmo que chama de Reinforcement Learning for Calibrated Decisions (RLCD).
Como o Jev funciona: estado entra, decisões tipadas saem
O ciclo central é uma solicitação para uma resposta. Você envia um estado (uma string simples ou um objeto estruturado) mais um conjunto de perguntas tipadas. O Jev avalia cada pergunta em paralelo em relação a esse mesmo estado, e devolve respostas tipadas com probabilidades e confiança. Seu código então ramifica, ordena e encaminha com base nessas respostas.
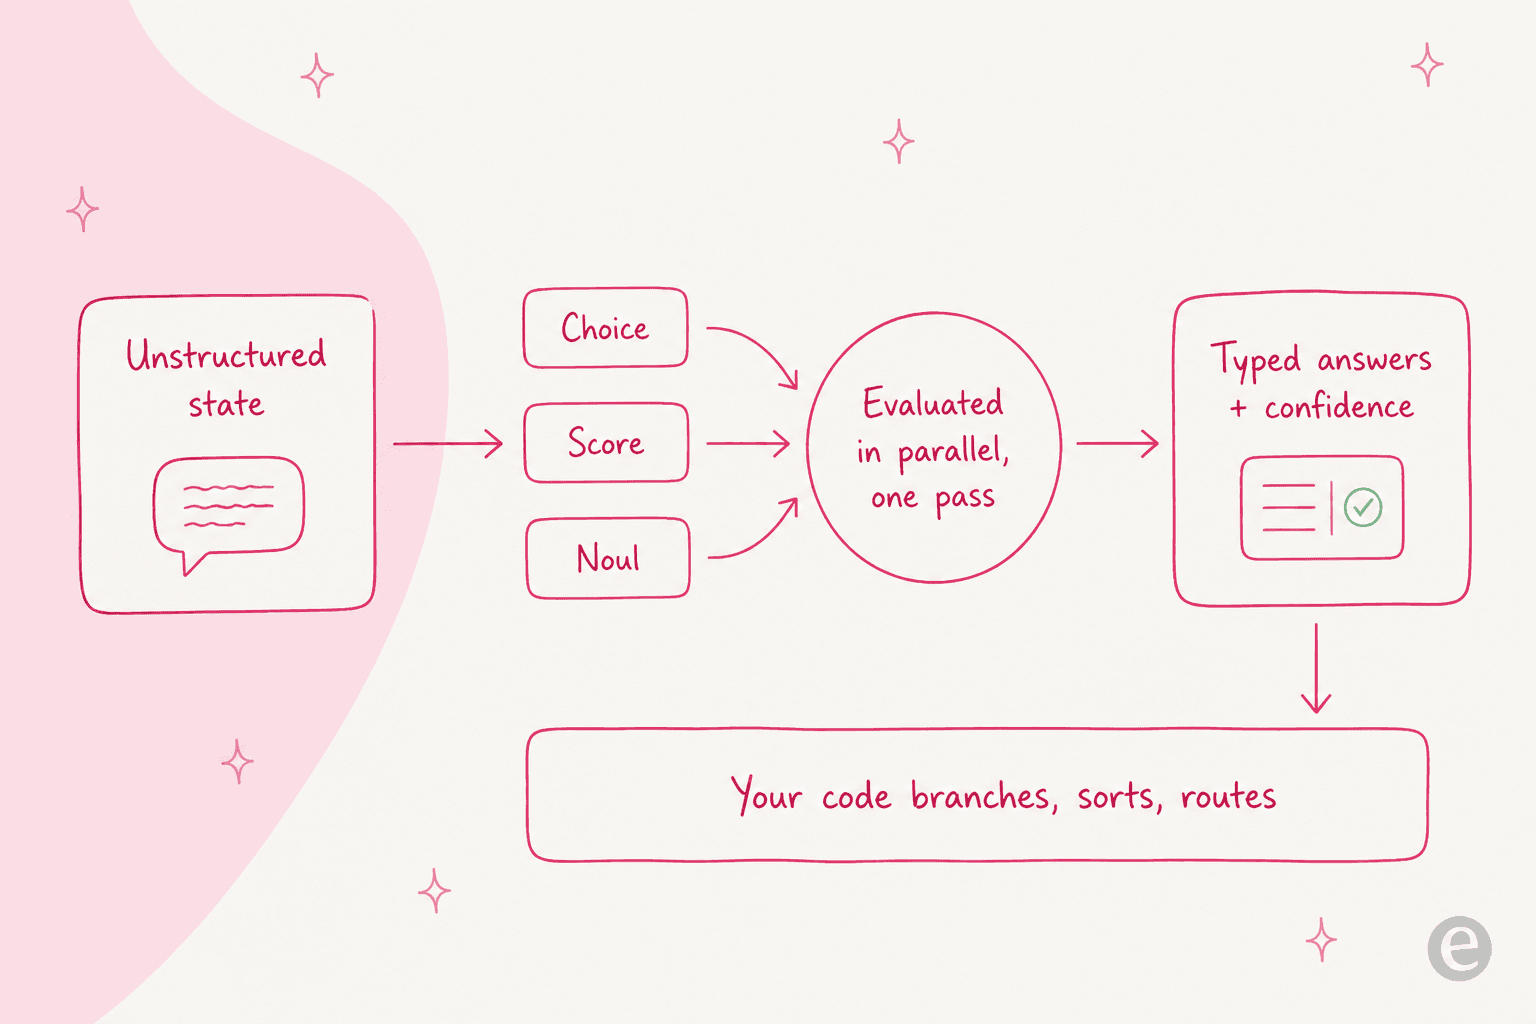
A decisão de design que mais importa: cada pergunta é avaliada de forma independente e isolada em relação ao mesmo estado. A TypeSafe diz que adicionar perguntas quase não altera o tempo de resposta, e como cada uma é pontuada isoladamente, você não tem o "context rot" que surge quando você amontoa uma dúzia de instruções em um único prompt.
O conselho da TypeSafe é manter cada pergunta atômica. Em vez de perguntar "avalie este pitch de startup", você pergunta cada dimensão separadamente (tamanho de mercado, viabilidade técnica, diferenciação) e combina as pontuações com sua própria fórmula. Quando as prioridades mudam, você altera um coeficiente no código em vez de reescrever um prompt. Se você já lutou contra um mega-prompt para fazê-lo se comportar, esse instinto de decomposição vai parecer familiar, e é a mesma lógica por trás de uma boa automação de fluxos de trabalho com IA.
Os três primitivos: Noul, Choice e Score
O Jev expõe exatamente três tipos de pergunta, e você pode misturar os três em uma única chamada de API.
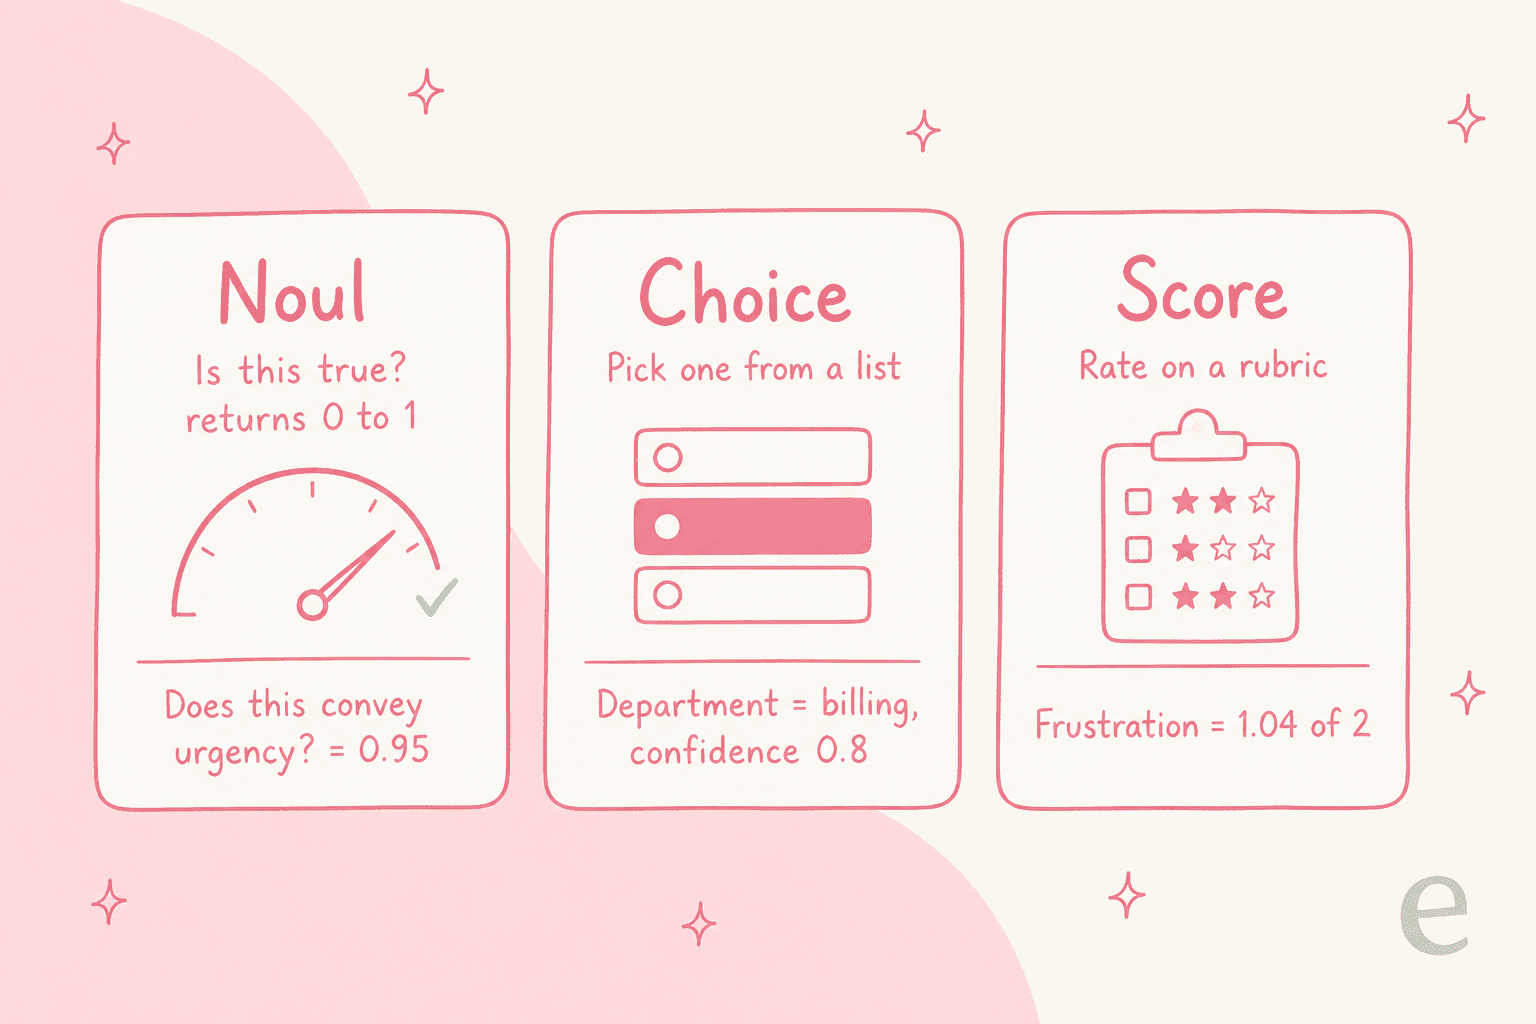
- Noul responde "esta afirmação é verdadeira?" e devolve uma única probabilidade de 0 a 1.
- Choice escolhe uma opção de uma lista que você define, e devolve a escolha, probabilidades por opção e um valor de confiança.
- Score avalia o estado segundo uma rubrica que você define, e devolve um valor numérico (pode cair entre níveis, como 1,04 de 2), probabilidades por nível e confiança.
O exemplo prático que a Cloudflare publica é, reveladoramente, um ticket de suporte. Forneça ao Jev a mensagem "Help! My payouts have been failing for 3 days" e três perguntas mistas, e ele retorna com is_urgent (Noul) em 0,95, department (Choice) como billing com 0,8 de confiança, e frustration (Score) em 1,04 em uma escala de calmo a muito irritado, tudo em uma única chamada. Isso é triagem, roteamento e sentimento em uma única solicitação, exatamente o tipo de decisão que uma etapa de triagem de tickets com IA precisa.
Onde o Jev se distancia de um LLM comum
Se você levar apenas um modelo mental, que seja este: um LLM escreve, o Jev decide.
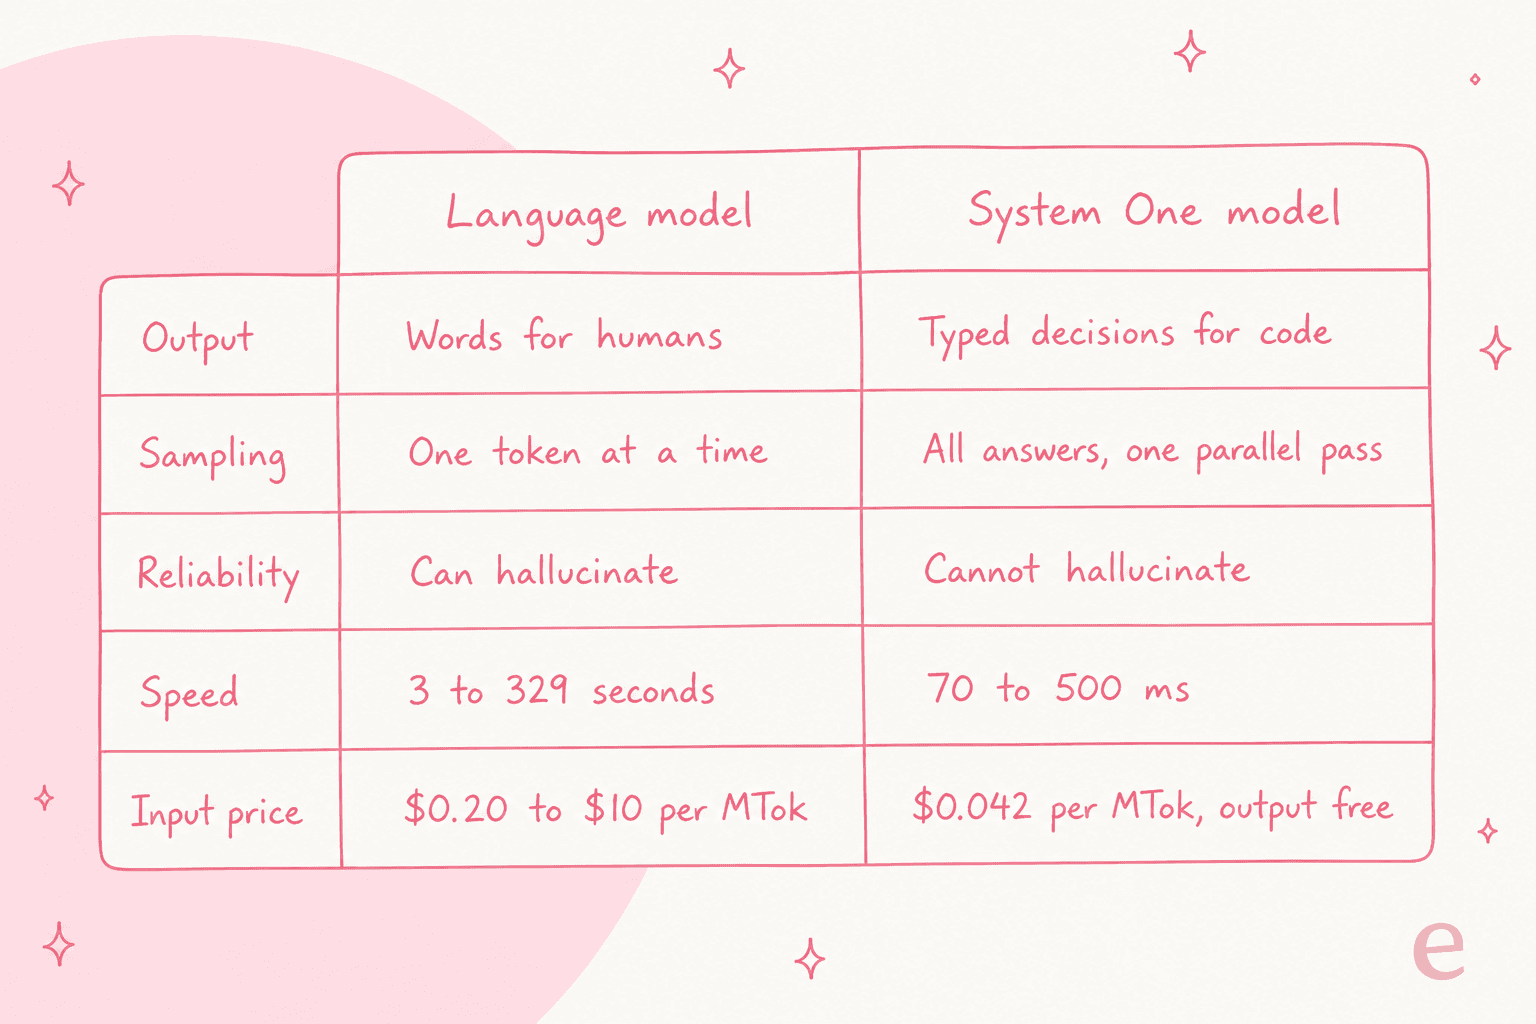
Um modelo de linguagem amostra um token de cada vez, em sequência, até produzir uma string que um humano lê. O Jev gera todas as suas saídas em uma única passagem paralela e nunca produz texto livre. É por isso que ele é rápido, e também por isso que a comparação não é exatamente justa, um ponto ao qual voltarei. A conclusão prática para quem constrói é que o Jev se encaixa em qualquer lugar onde você esteja atualmente forçando um LLM a emitir um blob JSON que depois você faz parse e espera que seja válido. É a mesma pergunta de "qual camada estou realmente escolhendo" que aparece em AgentKit vs. a API da Anthropic.
Os números que a TypeSafe afirma
A TypeSafe não é tímida com números, então aqui estão eles com as ressalvas.
| Afirmação | Jev | Referência declarada pela TypeSafe |
|---|---|---|
| Latência de ponta a ponta | 70 ms a 500 ms | 3 a 329 segundos para LLMs de fronteira |
| Múltiplo de velocidade | 40x a 200x mais rápido | em consultas com o formato System One |
| Destaque de fluxo de trabalho | 193,6x mais rápido, 444,6x mais barato | "na extremidade superior dos ganhos do mundo real" |
| Preço de entrada | 0,042 $ / MTok, saída gratuita | 238x menor que o Claude Fable 5.1 |
| Janela de contexto | 32.000 tokens | versão do modelo jev-1.13.0 |
O Jev já está ativo no Cloudflare Workers AI como typesafe/jev, e a TypeSafe está abrindo o acesso antecipado a partir de uma lista de espera. Ainda não há uma página de preços independente; o número de 0,042 $ vem da página inicial e do post de lançamento. Sobre sustentabilidade, a TypeSafe é refrescantemente direta em seu post de lançamento: "We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
O ponto de dado externo mais confiável veio do CEO da Vercel, que colocou o Jev em um produto real:
"We're seeing extraordinary results from @typesafeai. Default mode in 𝚏𝚡 is auto, with a safety reviewer analyzing every command. That reviewer runs on GPT Luna today. Jev is up to 18x faster (p95) and more accurate."
Uma aceleração de 18x em uma etapa real de revisão de segurança é uma afirmação muito mais fundamentada do que o número de marketing de 200x, e aponta para onde o Jev realmente brilha: o verificador rápido posicionado na frente de um sistema mais lento.
O que "não consegue alucinar" realmente significa
Esta é a afirmação que incendiou a thread de lançamento no Hacker News (1.929 pontos, 508 comentários), e vale a pena parar para pensar nisso, porque é a coisa que a maioria das pessoas vai entender errado.
O Jev não pode cometer um erro de tipo e não pode devolver uma opção que não estava na sua lista. Nesse sentido mecânico, ele "não consegue alucinar". Mas uma resposta tipada ainda pode estar confiantemente errada, e vários comentaristas fizeram esse ponto com clareza:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

A defesa é que o Jev sempre entrega um valor de confiança, para que você possa agir sobre as respostas certas e encaminhar as duvidosas para um humano:
"they mean they produce a confidence value for every result, so you could see for example it has 0.1 confidence, and you can disregard the result."
O verdadeiro teste é a calibração, não o slogan "não consegue alucinar". Como um comentarista colocou, se o modelo diz 0,9 em mil respostas, cerca de 900 delas deveriam estar corretas. Supõe-se que o RLCD seja otimizado exatamente para isso. Até que existam números de calibração independentes, trate "não consegue alucinar" como "não vai devolver uma saída malformada", não como "está sempre certo". Para quem implanta IA em perguntas reais de clientes, essa distinção é tudo, e é por isso que confiamos tanto em grounding e testes para prevenir alucinações de IA no suporte.
Quem está por trás do Jev
A TypeSafe tem um histórico difícil de ignorar. O fundador e CEO Diogo Almeida coinventou o RLHF e o InstructGPT na OpenAI, a linha de pesquisa que levou ao ChatGPT, e antes esteve no Google Brain. Ele é acompanhado pela COO Sasha Sheng (ex-Meta/FAIR) e pelo CTO Erik Gafni, com uma equipe vinda da OpenAI, Google Brain, Meta, Stripe, Airbnb e Docker.
A empresa diz ser "apoiada por investidores de primeira linha", mas não publicou um valor de financiamento em suas próprias páginas, então não vou colocar um número nisso. O slogan, "Build Prod, Not God", revela a postura: esta é uma equipe otimizando para lançar peças de produção confiáveis, não perseguindo AGI.
Você deveria realmente usar o Jev?
Aqui está a minha leitura depois de passar pelos documentos, pelas demos e pelas críticas.
Recorra ao Jev quando a tarefa for uma decisão estreita e bem delimitada que o seu código consome: roteamento, moderação, detecção de intenção, pontuação, filtros de extração, ou uma verificação de segurança rápida na frente de um modelo maior. A opinião de desenvolvedor mais convincente no Hacker News veio de alguém que já fazia isso manualmente:
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing. If this does at all what it claims, I think this is going to quickly become the new standard approach for agentic systems."
Não recorra ao Jev quando precisar de geração, explicação ou raciocínio em várias etapas. O comentário mais votado de toda a thread acertou o enquadramento honesto:
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference.'"
E os céticos mais barulhentos, incluindo o desenvolvedor Theo Browne, argumentaram que as demos virais o empurram para tarefas que um classificador simples ou uma regra deveria assumir. Essa é uma ressalva justa: uma ferramenta tão rápida convida ao uso excessivo. A linha a manter é que o Jev é uma peça primitiva. Ele te dá uma ótima decisão; você continua responsável pelo pipeline, pela lógica de escalonamento, pela estratégia de deflection e por toda ação que acontece depois da decisão.
Experimente o eesel
Se você dirige o suporte, a tradução honesta de tudo isso é: o Jev é um motor brilhante, não um carro. Ele vai te dizer que um ticket é urgente, é de faturamento e vem de um cliente frustrado em 114 milissegundos. Ele não vai abrir o ticket, redigir a resposta fundamentada na sua central de ajuda, aplicar o reembolso ou transferir para um humano quando estiver incerto. Alguém ainda precisa construir isso.
O eesel é esse colega de equipe pronto. É um colega de equipe de IA para suporte que você conecta ao seu helpdesk, e ele já toma as decisões de triagem, roteamento e escalonamento que o Jev expõe como primitivos, e depois age sobre elas de ponta a ponta. Ele se junta à sua fila de atendimento ao cliente existente, aprende com seus tickets anteriores e sua central de ajuda, e você pode simulá-lo contra tickets históricos antes que ele toque em um cliente real.

E se você gostou da ergonomia para desenvolvedores do Jev, vai gostar disto: o eesel não é apenas um painel. A CLI do eesel (npx @eesel/cli) opera o mesmo colega de equipe e workspace a partir de um terminal. Uma pessoa pode executar eesel chat, eesel activity ou eesel approvals manualmente; scripts podem automatizá-lo no CI; e agentes de programação como Claude Code, Codex e Cursor podem operá-lo, já que todo comando imprime JSON e --dry-run mostra a chamada exata antes de ela disparar. Todo workspace também é um servidor MCP. O Jev te dá a decisão; o eesel te dá o colega de equipe que age sobre ela, e permite que seus agentes o operem. Você pode experimentar o eesel gratuitamente.
Perguntas frequentes
O que é o TypeSafe Jev?
O TypeSafe Jev é o primeiro modelo System One público: em vez de gerar texto, ele avalia perguntas tipadas em relação a um estado e devolve decisões tipadas com probabilidades e uma pontuação de confiança. Foi criado para os julgamentos estreitos e estruturados que o software consome diretamente, como triagem de nível 1 e roteamento.
Quanto custa o TypeSafe Jev?
A TypeSafe cobra pelo Jev 0,042 $ por milhão de tokens de entrada, com a saída gratuita, o que a empresa apresenta como um preço de entrada 238 vezes menor que o Claude Fable 5.1. Ainda não há uma tabela de níveis de preços publicada, e o acesso é feito por meio de uma lista de espera de acesso antecipado.
O Jev realmente não consegue alucinar?
Ele não pode gerar um erro de tipo nem inventar uma opção fora da lista que você forneceu, mas uma resposta tipada ainda pode estar confiantemente errada, um ponto debatido no Hacker News. O verdadeiro teste é a calibração. Se você quer respostas fundamentadas em uma fila de suporte, aplica-se a mesma disciplina do nosso guia para prevenir alucinações de IA.
O Jev substitui um LLM?
Não. O Jev toma decisões tipadas rápidas, ele não escreve texto, não raciocina passo a passo nem mantém uma conversa. Muitas equipes o combinam com um LLM, usando o Jev para a etapa de classificar e encaminhar, de forma semelhante a como funciona na prática uma divisão entre um sistema baseado em regras e um agente de IA.
Em que o Jev difere de um agente de atendimento ao cliente de IA comum?
O Jev é infraestrutura: uma peça de decisão que você conecta ao seu próprio código. Um produto de atendimento ao cliente com IA como o eesel é o colega de equipe pronto que toma essas decisões e executa a ação dentro do seu helpdesk. Você pode até operá-lo a partir de um terminal com a CLI do eesel.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.