Resumo
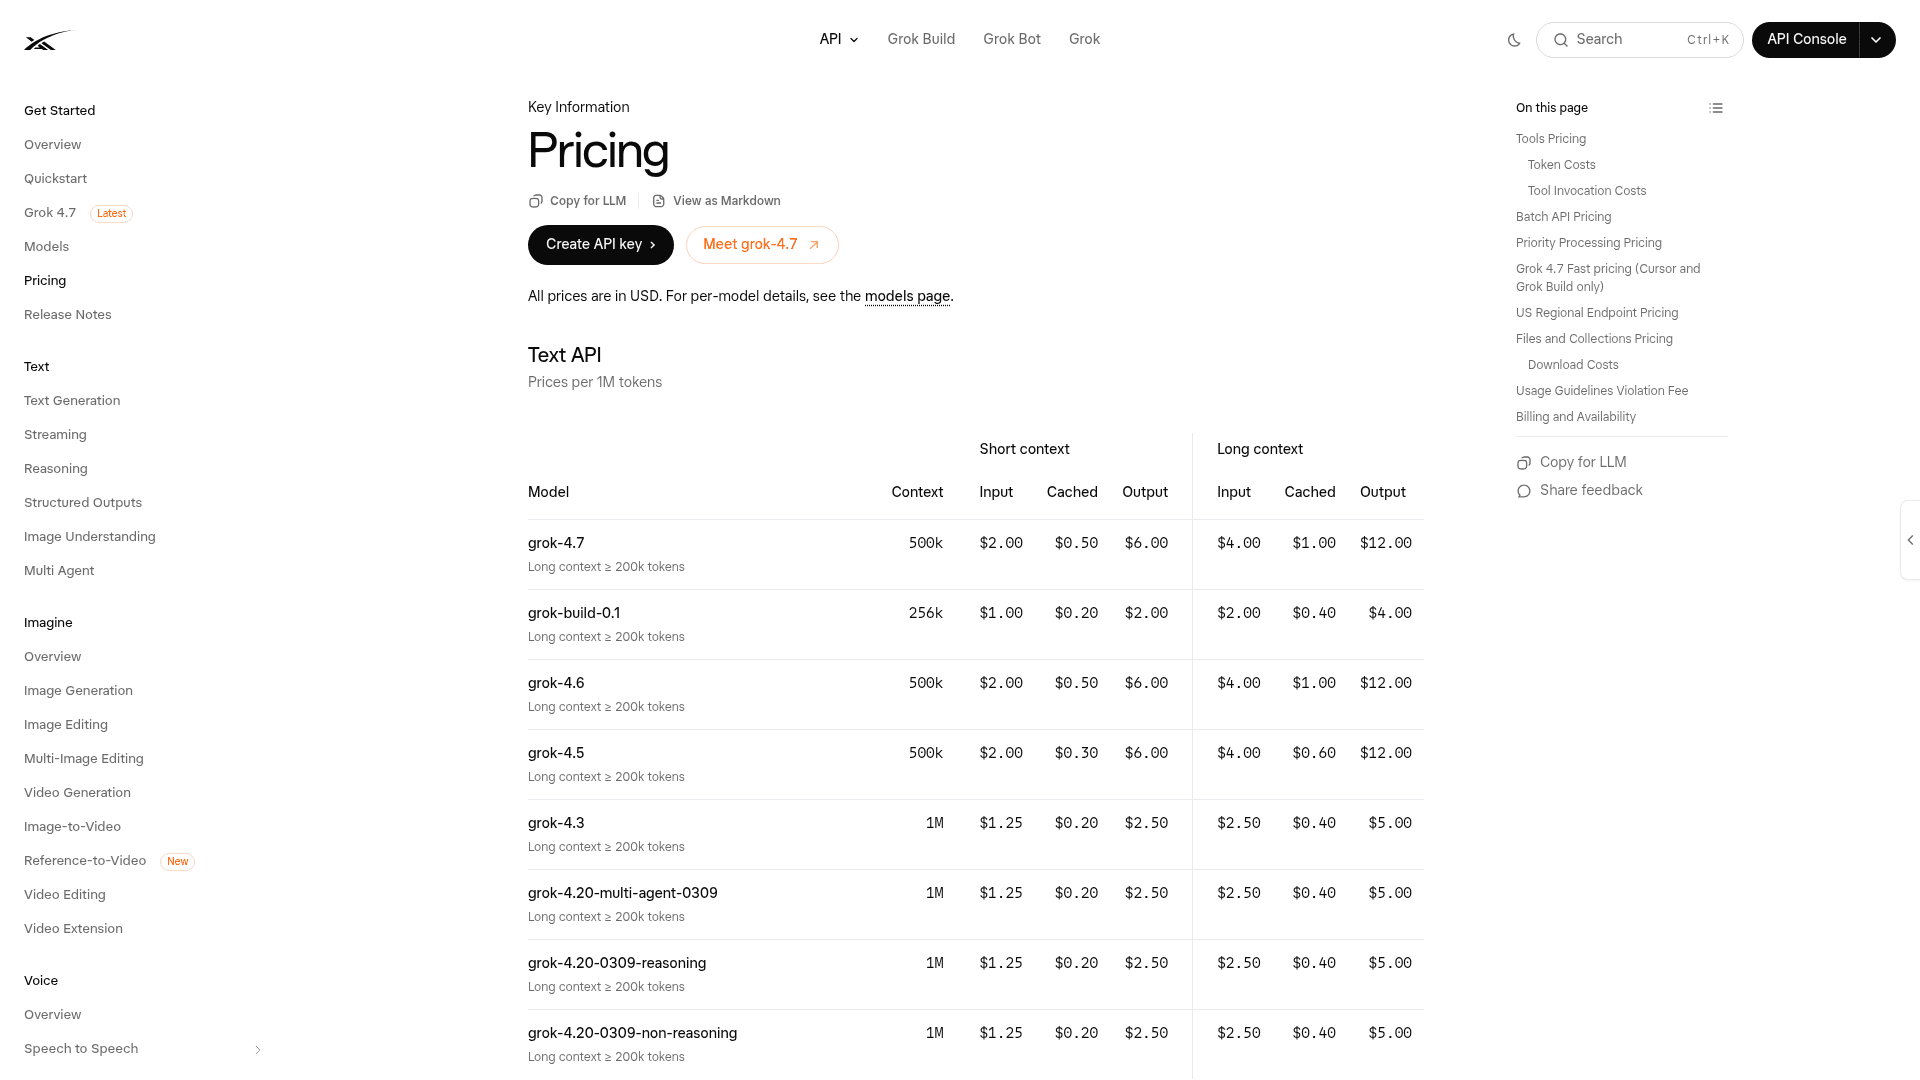
O Grok 4.7 tem preço pensado para rodar em volume. Na API da xAI, custa $2 por milhão de tokens de entrada e $6 por milhão de tokens de saída em solicitações padrão, saltando para $4 / $12 assim que um prompt ultrapassa 200 mil tokens. É exatamente a mesma tabela de preços do Grok 4.6, então a atualização adiciona capacidade sem elevar o medidor.
Frente à concorrência, esse preço de saída é a grande notícia. O Grok 4.7 empata com o GPT-6 Sol na entrada ($2), mas é 40% mais barato na saída ($6 contra $10), e representa apenas um quinto da taxa do Fable 5.1. A pegadinha está nas partes que não aparecem na etiqueta: o precipício de contexto longo em 200k que reprecifica toda a sua solicitação, a variante Fast que dobra o preço por token, e os medidores de chamadas de ferramentas que se acumulam silenciosamente quando um agente busca e executa em loop.
Passei os últimos três anos e meio colocando agentes de IA em filas reais de suporte, e o número que realmente decide qual modelo entra em produção nunca é o benchmark mais alto, é a fatura por token quando um agente está em loop processando milhares de tickets por dia. Então este artigo é sobre a fatura: a tabela de preços completa, os medidores que a maioria dos modelos de custo ignora, e como o Grok 4.7 se compara aos preços do GPT-6 Sol e aos preços do Fable 5.1 quando os tokens se acumulam.
Informe seu próprio volume mensal de tokens para ver onde o Grok 4.7 fica em relação ao GPT-6 Sol e ao Fable 5.1. O interruptor de contexto longo muda o Grok para suas taxas acima de 200k.
Preços do Grok 4.7 em resumo
Aqui está a tabela de preços, direto da fonte em vez de um número "a partir de".
| Nível | Entrada / 1 mi. | Entrada em cache / 1 mi. | Saída / 1 mi. |
|---|---|---|---|
grok-4.7, prompt abaixo de 200k | $2,00 | $0,50 | $6,00 |
grok-4.7, prompt a partir de 200k | $4,00 | $1,00 | $12,00 |
| Grok 4.7 Fast (apenas Cursor e Grok Build) | 2x as taxas acima | 2x | 2x |
A janela de contexto de 500k e as taxas por token estão ambas inalteradas em relação ao Grok 4.6, que é a manchete deste lançamento para um comprador: você obtém um modelo mais forte no mesmo medidor. Os ganhos vieram no trabalho agêntico de longo prazo, e o preço não se moveu para pagar por isso.
Um detalhe interessante para a API: o esforço de raciocínio pode ser configurado entre baixo, médio, alto e xhigh, então você pode ajustar o quanto o modelo pensa por solicitação. Como os tokens de saída custam 3x mais que os de entrada, e o raciocínio consome tokens de saída, o esforço é uma alavanca real de custo, não só de qualidade. Reduzir o esforço em chamadas fáceis é a otimização mais barata que você ainda não está fazendo.
O precipício de contexto longo em 200k
Este é o item mais caro de se perder nos preços do Grok 4.7. Assim que o prompt de uma solicitação ultrapassa 200 mil tokens, as taxas de contexto longo se aplicam a cada token da solicitação, não apenas ao excedente acima de 200k.
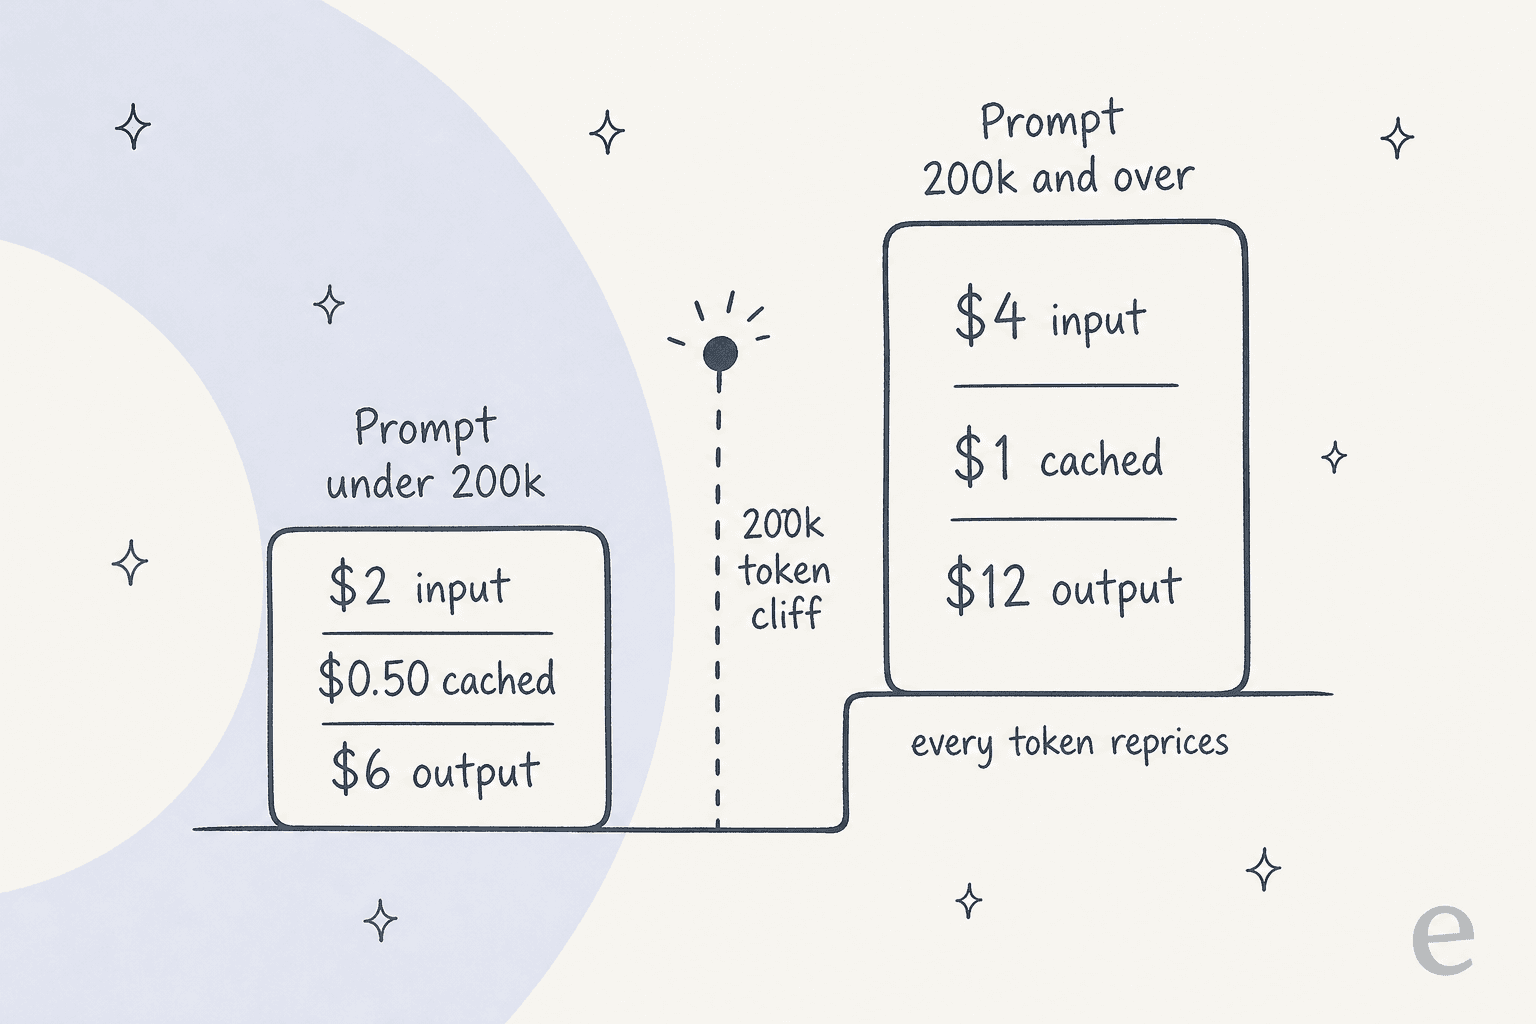
Assim, um prompt de 210 mil tokens é cobrado integralmente a $4 / $12, não em sua maior parte a $2 / $6. Isso é uma duplicação desencadeada pelos últimos 10 mil tokens. Para um loop de agente longo que vai acumulando contexto lentamente, mensagem após mensagem, o precipício é uma armadilha real: a execução fica silenciosamente duas vezes mais cara no momento em que ultrapassa o limite, e nada nos cabeçalhos da resposta avisa antes disso acontecer.
A xAI claramente sabe disso, pois lançou uma Context Compaction API especificamente para reduzir conversas antes que cruzem essa linha. Se você está executando algo longo, reserve tempo de engenharia para manter os prompts do lado mais barato dos 200k, ou aceite que algumas das suas solicitações serão cobradas silenciosamente em dobro. Esse é o tipo de detalhe que faz o preço por token parecer previsível em uma planilha e imprevisível na fatura.
Os medidores que a maioria dos modelos de custo ignora
As taxas por token são a manchete, mas não são toda a fatura. Na API, a página de preços da xAI lista uma série de medidores por chamada que se somam aos tokens, e que importam muito para agentes que fazem mais do que conversar:
- Busca na web, busca no X e execução de código: $5 por 1.000 chamadas cada.
- Busca em anexos de arquivo: $10 por 1.000 chamadas.
- Busca em coleções (a de recuperação estilo RAG): $2,50 por 1.000 chamadas.
- Priority Processing: dobra todas as taxas de tokens, e só é cobrado quando a resposta confirma que rodou no nível prioritário.
- Taxa por violação das diretrizes de uso: $0,05 por uma solicitação bloqueada antes de ser gerada.
Nenhum desses itens quebra o orçamento sozinho. Mas um agente que busca na web, recupera de uma base de conhecimento e executa código em cada ticket dispara três ou quatro chamadas cobráveis por turno, e esse é um item que sua conta de tokens não vai mostrar. Se você está modelando o custo de um agente de IA, é nesses medidores que a surpresa costuma se esconder.
Há também uma observação sobre lotes que vale a pena conhecer: o desconto de 20% para lotes da xAI não se aplica ao Grok 4.7. Ele cobre apenas as variantes mais antigas grok-4.3 e grok-4.20. Então, se você tem um trabalho volumoso e tolerante a latência, executá-lo no Grok 4.3 em lote pode sair mais barato por token do que o Grok 4.7 nas taxas padrão. Essa é uma bifurcação real para cargas de trabalho offline.
Grok 4.7 Fast, e a taxa 2x
O Grok 4.7 Fast é o mesmo modelo, servido a aproximadamente o dobro da velocidade de saída por o dobro do preço por token. Está disponível apenas dentro do Cursor e do Grok Build, não na API pública.
A troca é latência pura por dinheiro. Você paga $4 / $12 (ou $8 / $24 além do precipício) para cortar segundos da resposta. Isso vale a pena em uma sessão de programação interativa em que você está vendo o código sendo transmitido e cada segundo de espera quebra o fluxo. É um desperdício em tarefas em lote, execuções noturnas, ou qualquer tarefa em segundo plano em que ninguém está olhando para o cursor. Minha regra prática: Fast para o primeiro plano, padrão para o resto.
Onde você pode (e não pode) comprar o Grok 4.7
O caminho de compra muda o preço efetivo mais do que a maioria espera, então vale a pena mapeá-lo antes de se comprometer.
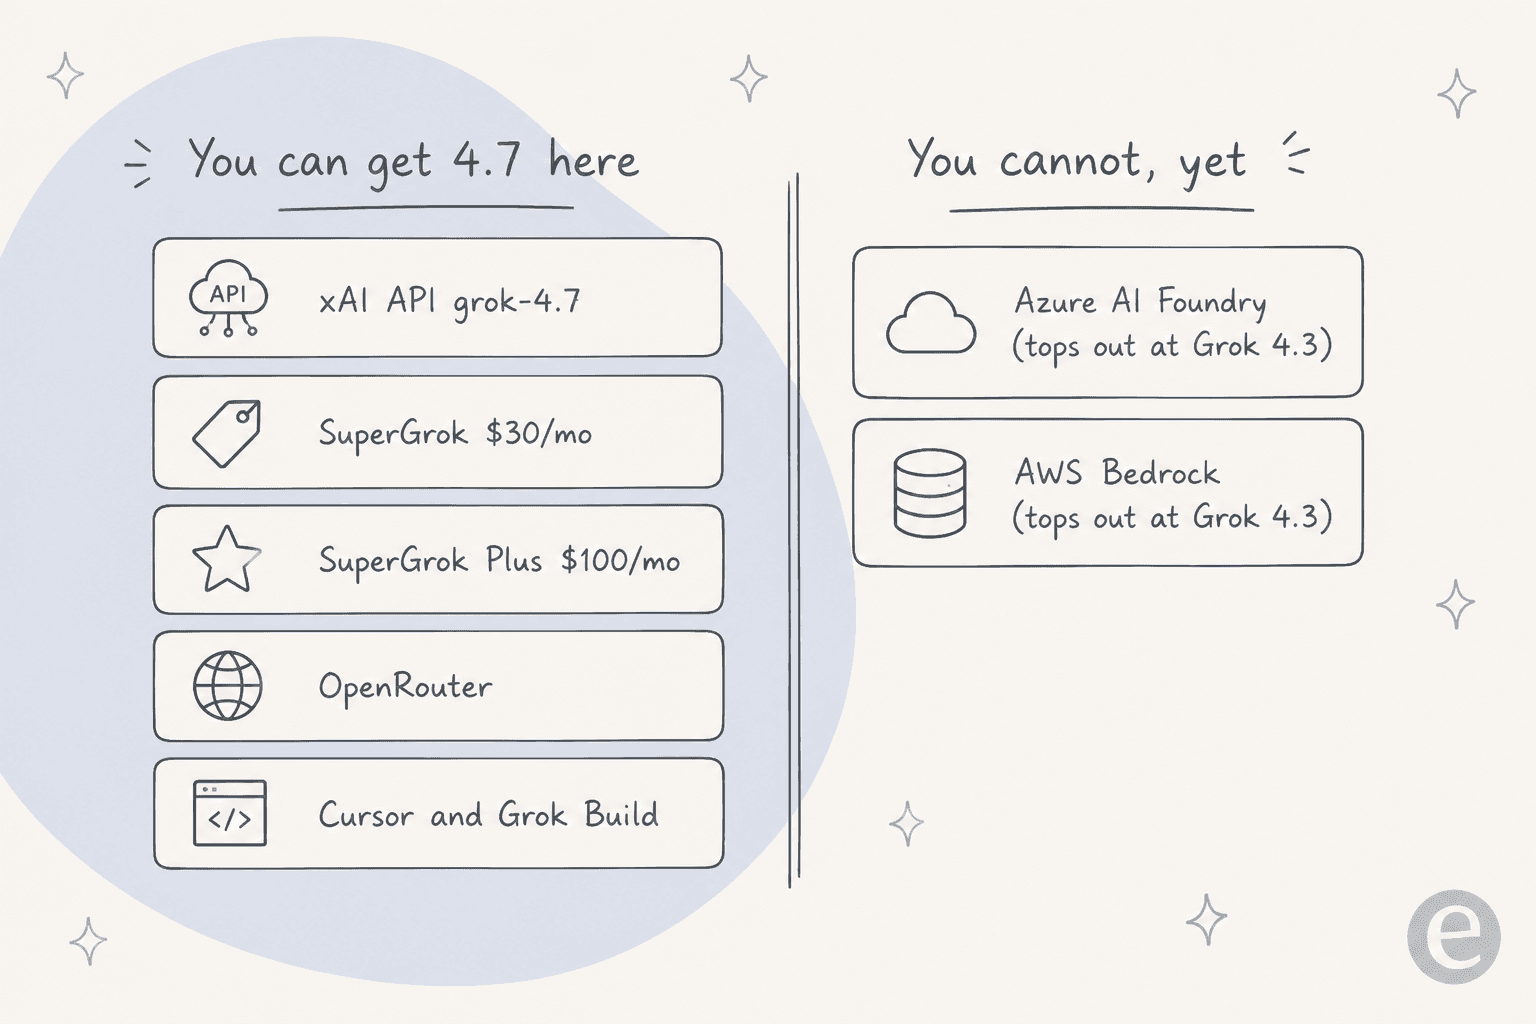
- API da xAI (
grok-4.7): o preço de referência, $2 / $6, e onde você deveria basear sua fatura. - SuperGrok e SuperGrok Plus: as assinaturas para consumidores, $30/mês e $100/mês. Boas para uma pessoa que usa o Grok no aplicativo, não para volume programático.
- OpenRouter: repassa os preços do provedor sem margem de inferência, mas cobra 5,5% nas compras de crédito (mínimo de $0,80), e os créditos expiram após um ano. Seu valor está no preço efetivo real e medido: no Grok 4.6, o uso intenso de cache derrubou o preço médio ponderado de entrada bem abaixo do preço de tabela, uma prévia de como o 4.7 será cobrado em tráfego favorável ao cache.
- Cursor e Grok Build: onde vive a variante Fast, e um bom lugar para testar o modelo antes de integrar a API.
A lacuna que vale destacar: tanto o Azure AI Foundry quanto a AWS Bedrock chegam no máximo ao Grok 4.3, com preços em torno de $1,25 / $2,50. Se sua empresa exige aquisição por meio de um marketplace de nuvem, você não consegue comprar o Grok 4.7 por lá de jeito nenhum, pelo menos não ainda. Essa é uma limitação real, não uma crítica, e é o tipo de detalhe que decide a escolha do modelo para compradores corporativos, independentemente da tabela de preços.
Grok 4.7 vs. GPT-6 Sol e Fable 5.1 no preço
Aqui está a comparação atual, usando as taxas publicadas por cada fornecedor. Vale notar que o próprio material de lançamento da xAI comparava com o GPT-5.6 Sol mais antigo, a $4 / $20, mas a OpenAI já lançou o GPT-6 Sol pela metade desse preço, então este é o panorama real que um comprador enfrenta hoje.
| Modelo | Entrada / 1 mi. | Em cache / 1 mi. | Saída / 1 mi. |
|---|---|---|---|
| Grok 4.7 | $2,00 | $0,50 | $6,00 |
| GPT-6 Sol | $2,00 | $0,20 | $10,00 |
| Fable 5.1 | $10,00 | n/d | $50,00 |
O padrão é claro. O Grok 4.7 empata com o GPT-6 Sol na entrada e o supera em 40% na saída, que é onde um agente falante gasta a maior parte do seu dinheiro. Contra o Fable 5.1, o Grok custa cerca de um quinto por token. O Fable ainda lidera em codificação de ponta e trabalho de terminal de longo prazo, então a pergunta real nunca é "qual é mais inteligente" (frequentemente o Fable), e sim "quanto estou disposto a pagar por cada ponto marginal".
Em termos por tarefa: um único turno de agente com 50 mil de entrada e 10 mil de saída custa cerca de $0,16 no Grok 4.7, $0,40 no GPT-6 Sol, e $1,00 no Fable 5.1. Repita isso dez mil vezes por dia e a diferença é toda a razão pela qual cargas de trabalho de alto volume optam por padrão pelo modelo de saída barata. Uma ressalva que aprendi da forma difícil: mais barato por token nem sempre é mais barato por tarefa, porque um modelo que emite mais tokens de raciocínio para concluir o mesmo trabalho pode anular sua vantagem de taxa. Modele isso no seu próprio tráfego com a calculadora acima antes de trocar. Se você está pesando isso contra um modelo premium, nossa análise de preços do Claude Opus 5.5 faz o mesmo ponto por tarefa com mais detalhes.
Vale a pena o preço do Grok 4.7?
Para quem escreve código, constrói agentes de IA, ou opera na API onde o custo por token se acumula, sim, com folga. A combinação de pontuações próximas de ponta com os preços do Grok 4.6 é todo o argumento, e os ganhos de longo prazo significam que ele se sustenta bem em trabalhos que se estendem no tempo, não apenas em prompts únicos. Se você quiser uma leitura mais aprofundada sobre capacidade, nossa visão geral do Grok 4.7 cobre os benchmarks.
Usuários intensos confirmam o ângulo de "deixar rodando o tempo todo". Um assinante de longa data do Grok descreveu como o incorporou em tarefas cotidianas e nunca chegou perto de atingir seus limites:
"Tenho um bot do Grok monitorando meu e-mail a cada 15 minutos e arquivando coisas para mim. Tenho outro bot que monitora resultados de exames de sangue... e nunca sequer chego perto de usar minha cota."

Essa é a cara de um modelo com preço pensado para volume: ele convida você a deixá-lo rodando. Onde eu ajustaria as expectativas é nos medidores e no precipício. O preço de tabela é baixo, mas um agente que busca, recupera e executa código a cada turno, sobre prompts que se aproximam dos 200 mil tokens, vai cobrar bem acima dos "$2 / $6" orçados. O Grok 4.7 é barato para começar e fácil de subestimar, a mesma armadilha que todo modelo cobrado por token arma.
O preço por token é um medidor, não uma fatura previsível
Aqui está a reformulação, porque é exatamente o que uma simples comparação de preços deixa passar. Todo número neste artigo é uma leitura de medidor, não uma fatura. O Grok 4.7 é infraestrutura: um motor brilhante que você aluga por token, que chega sem saber nada sobre sua empresa, seus tickets, seu tom ou suas ferramentas. Para transformá-lo em algo que realiza um trabalho de verdade, alguém precisa construir a estrutura, conectar o conhecimento, cablear as integrações, escrever as barreiras de proteção, lidar com a escalação, e então continuar de olho em um medidor que se reprecifica sozinho em 200 mil tokens e adiciona $5 a cada mil buscas.
Essa lacuna é toda a ideia por trás da eesel. Em vez de um modelo e uma estrutura vazia, a eesel é uma plataforma de colegas de equipe de IA em que você contrata colegas prontos para trabalhar para uma função específica. O time atual inclui um colega de equipe de IA para helpdesk que entra na sua fila de suporte e um redator de blog de IA que pesquisa e escreve textos longos. Cada um chega já com as habilidades, integrações e contexto de empresa que sua função exige, rodando por baixo dos panos em modelos de ponta como este, então você obtém a capacidade sem precisar ser dono do encanamento, nem do medidor.

A diferença de preço é o ponto central: a eesel cobra por ticket resolvido, não por token, então o custo reflete o trabalho realizado em vez de o quanto o modelo foi verboso naquele dia. Você não está projetando tokens de saída nem escapando de um precipício de contexto longo, você está pagando por resultados.
E se você gostou do Grok 4.7 por viver no terminal, a eesel te encontra lá também. A CLI da eesel opera o mesmo colega de equipe e o mesmo espaço de trabalho do painel, mas pela linha de comando: uma pessoa pode executá-la, scripts podem automatizá-la, e agentes de programação como Claude Code, Codex e Cursor podem controlá-la. Você pode inspecionar as instruções de um colega de equipe, enviar uma mensagem de teste, ler de volta o resultado em JSON e a atividade, e propor uma mudança limitada para um responsável aprovar, tudo sem sair do seu terminal. É o mesmo apelo de "operar o agente de forma programática" que torna uma API de modelo bruta atraente, direcionado a um funcionário que já conhece o trabalho. Você pode testar a eesel gratuitamente.
Perguntas frequentes
Quanto custa o Grok 4.7?
O preço do Grok 4.7 é de $2 por milhão de tokens de entrada, $0,50 por milhão de tokens de entrada em cache e $6 por milhão de tokens de saída para qualquer solicitação cujo prompt esteja abaixo de 200 mil tokens, segundo a página de preços da xAI. Ao ultrapassar 200 mil tokens de prompt, as taxas dobram para $4 / $1 / $12 em cada token daquela solicitação. É exatamente a mesma tabela de preços do Grok 4.6.
Qual é o preço da API do Grok 4.7 por milhão de tokens?
Na API da xAI, o grok-4.7 custa $2 de entrada e $6 de saída por milhão de tokens no nível padrão de contexto curto. Esse é o número para basear sua fatura. A página de preços do Grok 4.7 também lista medidores de chamadas de ferramentas (busca na web e no X, execução de código a $5 por 1.000 chamadas) que se somam aos tokens em cargas de trabalho agênticas.
O que é o precipício de preços de contexto longo do Grok 4.7?
Assim que o prompt de uma solicitação atinge 200 mil tokens ou mais, a xAI cobra toda a solicitação na taxa de contexto longo de $4 / $1 / $12 por milhão, não apenas os tokens acima de 200 mil. Um prompt de 210 mil tokens é cobrado integralmente na taxa mais alta. A xAI oferece uma Context Compaction API para reduzir conversas antes que elas ultrapassem esse limite.
O que é o Grok 4.7 Fast e quanto ele custa a mais?
O Grok 4.7 Fast é o mesmo modelo servido a aproximadamente o dobro da velocidade de saída por o dobro do preço por token. Está disponível apenas dentro do Cursor e do Grok Build, não na API pública. Vale o adicional quando a latência importa, como ao ver o código sendo transmitido em tempo real, e é um desperdício em tarefas em lote ou em segundo plano.
O Grok 4.7 é mais barato que o GPT-6 Sol ou o Fable 5.1?
Em tokens de saída, sim. O Grok 4.7 custa $2 / $6, o GPT-6 Sol custa $2 / $10, e o Fable 5.1 custa $10 / $50. O Grok empata com o GPT-6 Sol na entrada e o supera em 40% na saída, sendo apenas uma fração da taxa do Fable. Para trabalho de agentes de alto volume, o Grok 4.7 costuma ser a opção de classe de ponta mais barata.
Quanto custa o Grok 4.7 para consumidores?
Em x.ai/pricing, o nível pago mais barato que inclui o Grok mais recente é o SuperGrok, por $30/mês, com o SuperGrok Plus a $100/mês. Há um nível gratuito com limites. Se você quiser chamar o Grok 4.7 de forma programática, esse é o preço de API de $2 / $6, não a assinatura.
Posso usar o Grok 4.7 no Azure ou na AWS Bedrock?
Ainda não. Tanto o Azure AI Foundry quanto a AWS Bedrock chegam no máximo ao Grok 4.3 no momento em que este texto foi escrito, então um comprador com mandato de nuvem não consegue adquirir o Grok 4.7 por lá. Você pode acessá-lo na API da xAI, pelo OpenRouter, ou dentro do Cursor e do Grok Build.
Os preços do Grok 4.7 valem a pena em comparação a pagar por resultado?
O preço por token recompensa quem otimiza os prompts e penaliza o contexto longo, então sua fatura só é tão previsível quanto o seu tráfego. Se você prefere pagar por ticket resolvido em vez de por token, um colega de equipe de IA como a eesel roda por baixo dos panos em modelos de ponta, mas cobra por resultado, de modo que o custo reflete o trabalho realizado.

Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.