O que o Grok 4.7 realmente é
O Grok 4.7 é o modelo de ponta da xAI para programação, tarefas agênticas e trabalho de conhecimento. Na API, ele é oferecido como grok-4.7, com uma janela de contexto de 500k, entradas de texto e imagem, e saída somente em texto sem limite de saída, segundo as notas de lançamento da xAI. O esforço de raciocínio pode ser configurado entre baixo, médio, alto (o padrão) e xhigh, para que você ajuste o quanto o modelo pensa em cada solicitação.
Por baixo do capô, a xAI diz que o Grok 4.7 usa um modelo base novo e maior que o Grok 4.6. Quero ser preciso aqui, porque boa parte da cobertura atribuiu uma contagem exata de parâmetros a ele: o próprio material da xAI o descreve como um modelo base maior sem publicar um número, então o número específico que circula não é algo que a empresa realmente declarou. O que a xAI de fato afirma é a forma da mudança, e essa forma é a parte interessante.
O treinamento foi voltado para problemas difíceis que levam muitas horas para serem concluídos, e depois reforçado ao longo de uma execução mais longa. A xAI também treinou o modelo para entender nativamente seu arnês Grok Bot, que é a estrutura que permite ao modelo conversar, chamar ferramentas e avançar em uma tarefa. Em termos simples, eles otimizaram menos para responder bem a uma única pergunta e mais para avançar em um trabalho longo e de várias etapas sem perder o fio.
O que mudou em relação ao Grok 4.6
A forma mais clara de ver o salto é colocar os dois modelos lado a lado nos benchmarks publicados pela xAI. Os ganhos não são uniformes, e onde eles se concentram diz muito sobre do que este lançamento realmente trata.
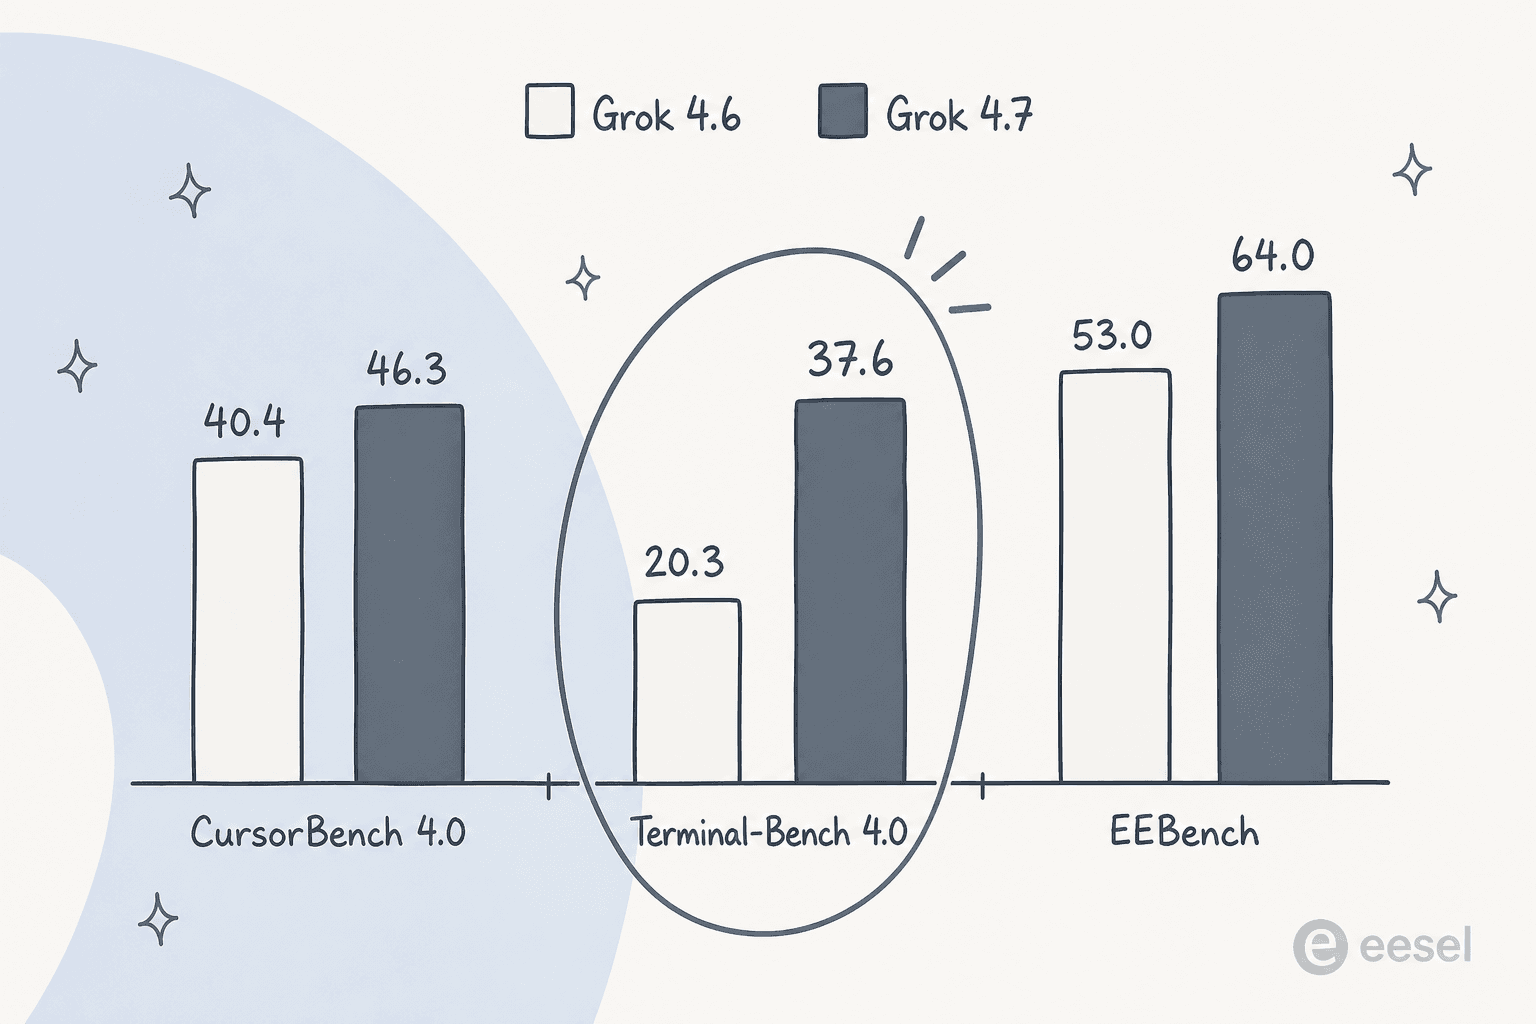
O maior salto individual está no Terminal-Bench 4.0, que mede trabalho de várias horas em um terminal real: o Grok 4.6 obteve 20,3% e o Grok 4.7 quase dobra esse valor para 37,6%. Esse é exatamente o tipo de tarefa de longo horizonte para a qual a execução de RL mais longa foi criada, e é onde o lançamento se justifica. Programação e engenharia seguem a mesma história: o CursorBench 4.0 sobe de 40,4% para 46,3%, e o EEBench (engenharia elétrica) salta de 53,0% para 64,0%.
Aqui está a tabela mais completa, com o GPT-5.6 Sol e o Fable 5.1 ao lado para dar contexto aos números. Todos os números do Grok 4.7 estão em esforço xHigh, o Grok 4.6 em High.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Preço de entrada / 1M | $2 | $2 | $4 | $10 |
| Preço de saída / 1M | $6 | $6 | $20 | $50 |
| CursorBench 4.0 (programação) | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0%* | 65,2% | 72,7% | 70,0% |
| Terminal-Bench 4.0 | 37,6% | 20,3% | 37,3% | 57,9% |
| EEBench (engenharia elétrica) | 64,0% | 53,0% | 39,4% | 56,4% |
| AA Briefcase v1.1 (Elo) | 1.657 | 1.546 | 1.487 | 1.678 |
| Harvey Legal Agent | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
*A pontuação do Grok 4.7 no DeepSWE é medida com esforço alto. Números do anúncio do Grok 4.7 da xAI.
Duas ressalvas honestas antes que alguém interprete isso como uma vitória completa. O Fable 5.1 ainda lidera no CursorBench, Terminal-Bench e raciocínio clínico, então se você só se importa com a pontuação máxima e custo não é problema, ele está à frente. E no HealthBench Professional, tanto o GPT-5.6 Sol (60,5%) quanto o Fable 5.1 (62,1%) superam os 56,7% do Grok 4.7. A história do Grok 4.7 não é "o melhor em tudo". É "muito perto do melhor, por uma fração do preço".
Preços do Grok 4.7 e a taxa Fast
Os preços são onde este modelo fica interessante, então vale a pena detalhar em vez de simplesmente citar um número "a partir de".
| Nível | Entrada / 1M | Entrada em cache / 1M | Saída / 1M |
|---|---|---|---|
grok-4.7, prompt abaixo de 200 mil tokens | $2,00 | $0,50 | $6,00 |
grok-4.7, prompt de 200 mil ou mais | $4,00 | $1,00 | $12,00 |
| Grok 4.7 Fast (somente Cursor e Grok Build) | 2x as tarifas acima | 2x | 2x |
A primeira pegadinha é o nível de contexto longo. Assim que uma solicitação ultrapassa 200 mil tokens de prompt, as tarifas mais altas se aplicam a cada token da solicitação inteira, não apenas ao excedente acima de 200 mil. Assim, um prompt de 210 mil tokens é cobrado integralmente a US$ 4 / US$ 12, não majoritariamente a US$ 2 / US$ 6. Para loops longos de agentes que acumulam contexto lentamente, esse penhasco é real, e é por isso que a xAI lançou uma API de compactação de contexto para reduzir conversas antes que elas ultrapassem o limite.
A segunda é a variante Fast. O Grok 4.7 Fast é o mesmo modelo servido com o dobro da velocidade de saída pelo dobro do preço por token, e está disponível apenas dentro do Cursor e do Grok Build, não na API pública. É uma troca de latência por dinheiro, útil quando você está vendo o código sendo transmitido em tempo real e cada segundo conta, e dispensável para trabalho em lote ou em segundo plano, onde a velocidade não importa.
Depois há os medidores que a maioria das matérias ignora. Na API, a página de preços da xAI lista as chamadas de ferramentas separadamente: busca na web, busca no X e execução de código custam US$ 5 por 1.000 chamadas, a busca em anexos de arquivo custa US$ 10 por 1.000, e a busca de coleções no estilo RAG custa US$ 2,50 por 1.000. O Priority Processing dobra todas as tarifas de tokens. Nenhum desses itens quebra o orçamento, mas se você está modelando o custo de um agente que busca e executa constantemente, o preço do token não é toda a conta.
A conclusão: o Grok 4.7 tem preço pensado para ser usado em alto volume. Esse é um posicionamento deliberado, e é a razão mais clara para escolhê-lo em vez de um modelo de ponta mais caro para qualquer coisa que rode em loop.
Onde o Grok 4.7 se posiciona frente ao GPT-5.6 Sol e ao Fable 5.1
Se você traçar capacidade versus custo, o Grok 4.7 cai em um canto que está ficando mais cheio, mas ainda é valioso: pontuações fortes, preço baixo.
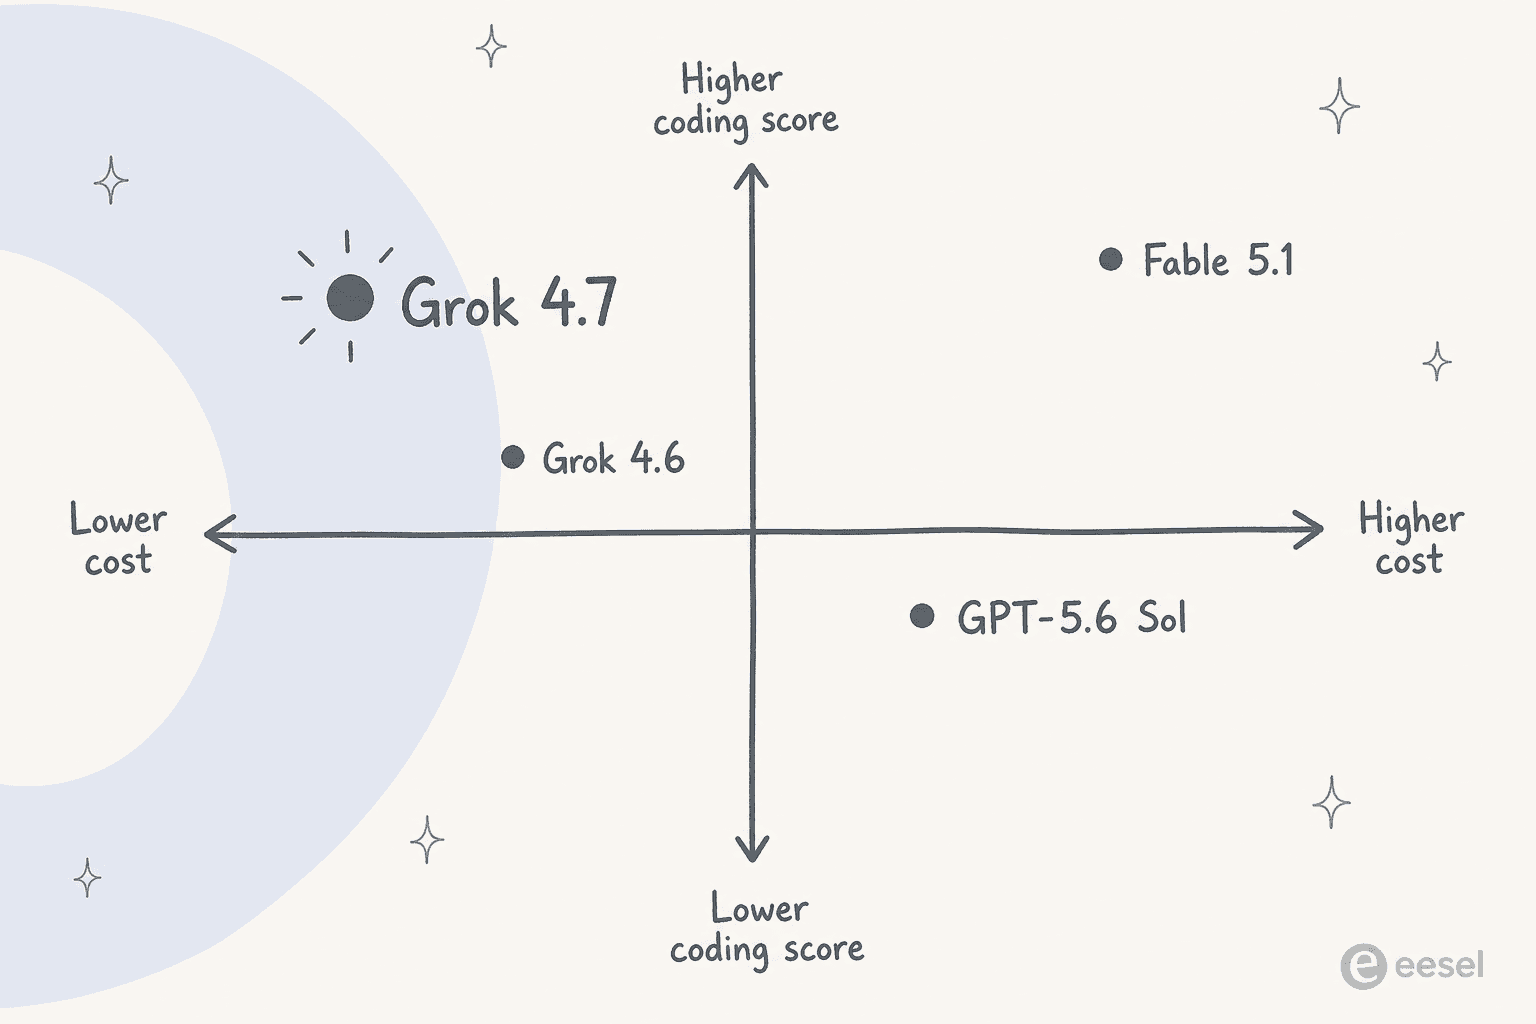
Frente ao GPT-5.6 Sol, o Grok 4.7 é a melhor escolha na maior parte do trabalho agêntico e de engenharia: supera o Sol no CursorBench, EEBench, Terminal-Bench, no benchmark jurídico da Harvey e no AA Briefcase, pela metade do preço de entrada e menos de um terço do preço de saída. O Sol mantém uma vantagem real em raciocínio clínico e uma vantagem estreita no DeepSWE, então não é uma vitória total, mas a diferença de preço faz do Grok 4.7 a escolha padrão para trabalho agêntico sensível a custo.
Frente ao Fable 5.1, a leitura honesta é que o Fable ainda é o modelo mais forte em programação pura e trabalho de terminal de longo horizonte, e seu Elo de conhecimento profissional GDPval de 1.735 supera os 1.695 do Grok 4.7. Mas o Fable cobra US$ 10 / US$ 50 por milhão de tokens, de cinco a oito vezes as tarifas do Grok. Então a pergunta não é "qual é mais inteligente" (geralmente o Fable), mas "quanto você está disposto a pagar por ponto adicional". Para muitas cargas de trabalho em produção, o Grok 4.7 é a resposta que mantém a conta sensata.
Segurança e cibersegurança
A xAI deu peso real à segurança neste ciclo, e essa é uma das partes mais concretas do lançamento. O Grok 4.7 foi construído com uma pilha de proteções totalmente nova, e a xAI o chama de o modelo mais robusto que já testou em recusas e resistência a jailbreak.
Os detalhes são o que tornam essa afirmação verificável. No HackerBench v0.3, o benchmark da xAI para tarefas cibernéticas de risco, o Grok 4.7 deixa passar apenas 3,3% dos prompts de duplo uso arriscados, enquanto, segundo a xAI, raramente bloqueia trabalho de segurança legítimo. Ele também lidera o benchmark de biossegurança da LatchBio com 62,4%. A proposta é um modelo que permanece útil para trabalho real de segurança e pesquisa sem ser uma ferramenta fácil para a versão perigosa da mesma tarefa, e a xAI começou a dar a parceiros de cibersegurança selecionados acesso somente por convite às capacidades de red-team do modelo para pesquisa de defesa. Os benchmarks são do próprio fornecedor, então trate-os como ponto de partida, mas a direção é clara.
Para quem o Grok 4.7 realmente serve
Depois de analisar os números, aqui é onde chego. O Grok 4.7 é uma escolha forte se você escreve código, constrói agentes ou lança qualquer coisa na API onde o custo de tokens se acumula. A combinação de pontuações próximas da fronteira com os preços do Grok 4.6 é toda a razão para se importar com ele, e os ganhos de longo horizonte significam que ele se sai melhor que o 4.6 em trabalhos que duram um tempo.
Usuários reais confirmam o argumento de "rodar constantemente". Um assinante intenso do Grok descreveu como o incorporou em tarefas cotidianas e ainda assim nunca chegou perto dos limites:
"Tenho um bot do Grok que monitora meu e-mail a cada 15 minutos e arquiva coisas para mim. Tenho outro bot que monitora resultados de exames de sangue... e nunca chego nem perto de usar minha cota."

Onde eu ajustaria as expectativas é em código profundo e complicado. Os modelos de ponta estão todos melhorando em resolver um script de uma só vez, e isso é real, mas não é o mesmo que sustentar uma base de código grande. Como colocou um desenvolvedor no mesmo tópico:
"Os modelos estão cada vez melhores em acertar tudo de primeira. Isso é útil em muitas situações, como para pequenos scripts pontuais... Mas para o trabalho de código em si, não me ajuda muito."
Essa é uma leitura justa para qualquer modelo dessa categoria, incluindo o Grok 4.7. Use-o para o volume de trabalho de dificuldade média onde o preço dele vence, e recorra ao modelo mais caro apenas para as tarefas que realmente precisam daqueles últimos pontos.
Um modelo de ponta é o motor, não o funcionário
Aqui está a reformulação que prometi no TL;DR, porque é o que a maioria dos artigos de "qual modelo devo usar" deixa de lado.
O Grok 4.7 é infraestrutura. É um motor brilhante que você aluga por token, e ele chega sem saber nada sobre sua empresa, seus tickets, seu tom ou suas ferramentas. Para transformá-lo em algo que realiza um trabalho de verdade, alguém precisa construir o arnês: conectar o conhecimento, cabear as integrações, escrever as barreiras de proteção, lidar com escalonamento e manter tudo funcionando. Isso é um projeto de verdade, não um simples botão de configuração.
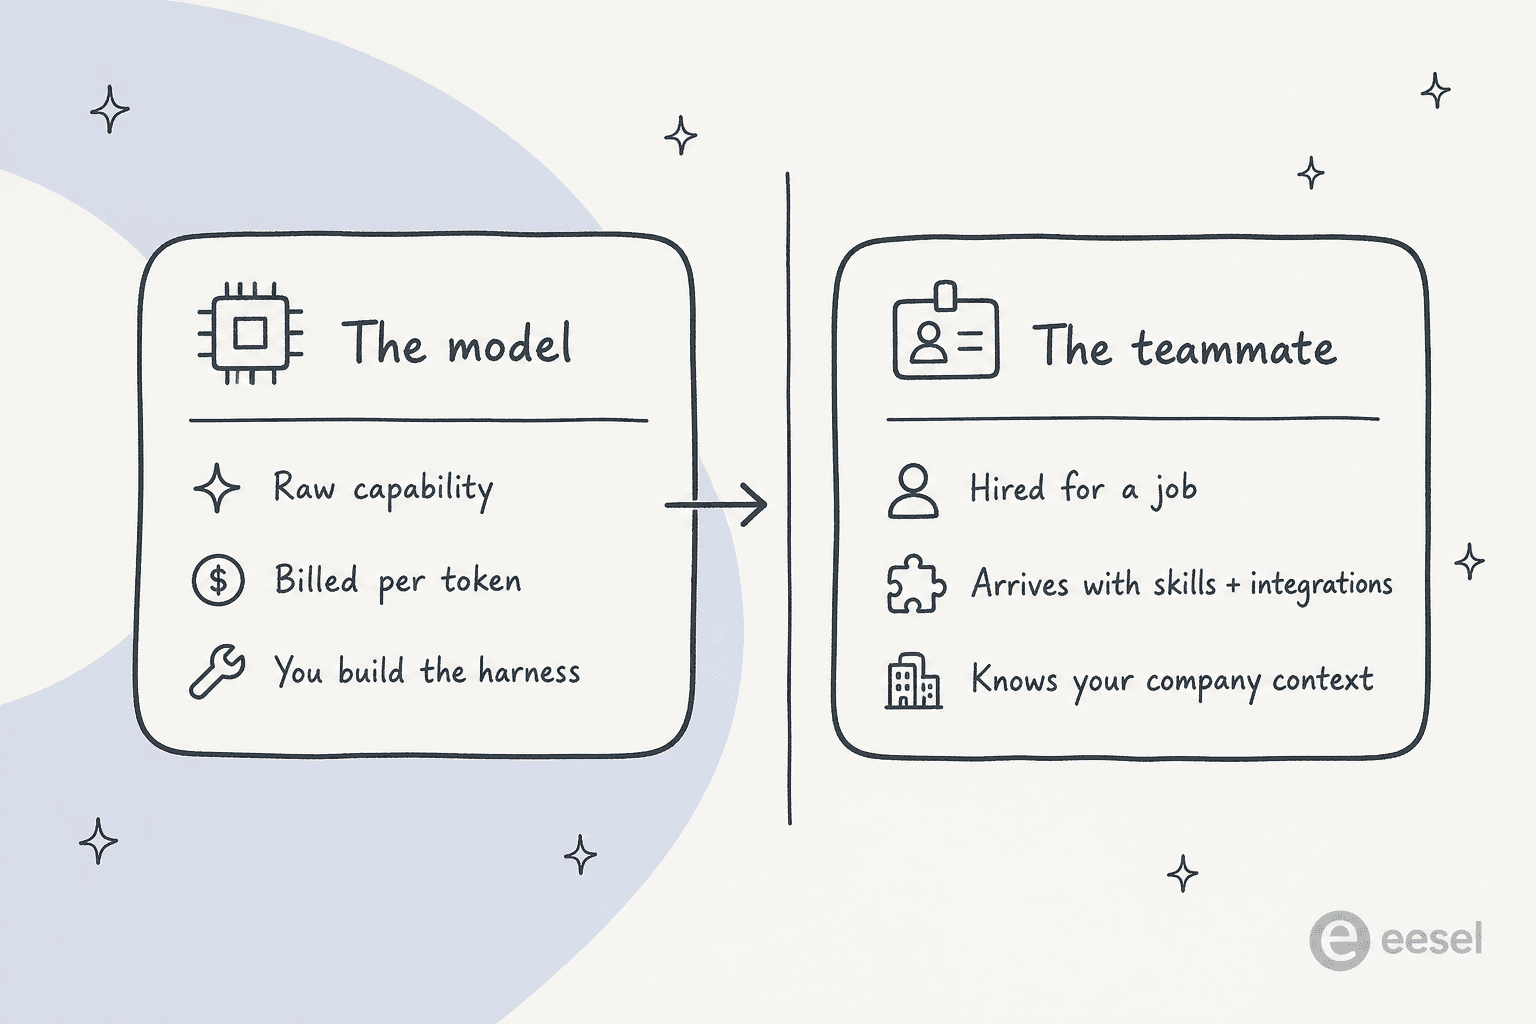
Essa lacuna é toda a ideia por trás da eesel. Em vez de entregar a você um modelo e um arnês vazio, a eesel é uma plataforma de colegas de equipe de IA em que você contrata colegas prontos para trabalhar para uma função específica. A escalação atual é um colega de equipe de IA para helpdesk que entra na sua fila de suporte e um redator de blog com IA que pesquisa e redige posts longos. Cada um chega já carregando as habilidades, integrações e contexto de empresa que sua função exige, rodando por baixo em modelos de ponta, para que você obtenha a capacidade sem ter que ser dono da infraestrutura.
E se você gostou do Grok 4.7 porque vive no terminal, a eesel também te encontra lá. A CLI da eesel opera o mesmo colega de equipe e espaço de trabalho que o painel, mas a partir da linha de comando: uma pessoa pode executá-la, scripts podem automatizá-la, e agentes de código como Claude Code, Codex e Cursor podem operá-la. Você pode inspecionar as instruções de um colega de equipe, enviar uma mensagem de teste, ler de volta o resultado em JSON e a atividade, e propor uma mudança limitada para um responsável aprovar, tudo sem sair do seu shell. É o mesmo padrão de "operar o agente de forma programática" que torna atraente uma API de modelo bruto, mas voltado a um funcionário que já conhece o trabalho. Você pode experimentar a eesel grátis.
Perguntas frequentes
O que é o Grok 4.7?
O Grok 4.7 é o modelo de ponta da xAI para programação, tarefas agênticas e trabalho de conhecimento, lançado em 21 de setembro de 2026. Ele funciona sobre um modelo base novo e maior que o Grok 4.6, mantém a janela de contexto de 500k e é oferecido na API da xAI como grok-4.7. É o mesmo tipo de motor de modelo bruto sobre o qual um produto como um colega de equipe de IA é construído.
Quanto custa o Grok 4.7?
O preço do Grok 4.7 é de US$ 2 por milhão de tokens de entrada, US$ 0,50 de entrada em cache e US$ 6 de saída abaixo de 200 mil tokens de prompt, dobrando para US$ 4 / US$ 1 / US$ 12 quando uma solicitação ultrapassa 200 mil, segundo a página de preços da xAI. Isso corresponde exatamente ao Grok 4.6, então a atualização acrescenta capacidade sem aumento de preço.
Qual é a diferença entre o Grok 4.7 e o Grok 4.6?
O Grok 4.7 usa um modelo base maior e uma execução de aprendizado por reforço mais longa, voltada para tarefas de várias horas, e registra os maiores ganhos em benchmarks agênticos de longa duração como o Terminal-Bench 4.0. Ambos compartilham a janela de contexto de 500k e os mesmos preços por token.
O Grok 4.7 é bom para programação?
Sim, programação é seu ponto forte principal. Ele obtém 46,3% no CursorBench 4.0 e supera o Grok 4.6 em todos os benchmarks de software publicados pela xAI, e é oferecido dentro do Cursor e do Grok Build. Para trabalho de código mais profundo, as equipes muitas vezes ainda o combinam com um modelo mais caro para as tarefas mais difíceis.
Como acesso o Grok 4.7?
Você pode chamar o Grok 4.7 pela API da xAI como grok-4.7, usá-lo gratuitamente no Grok Build, ou acessá-lo dentro do Cursor. Se você quer que essa inteligência realize um trabalho definido em vez de tokens brutos, uma plataforma de colegas de equipe de IA como a eesel empacota um modelo de ponta com as habilidades, integrações e contexto da empresa para uma função real.
O Grok 4.7 é melhor que o GPT-5.6 Sol ou o Fable 5.1?
Depende do que você mais valoriza. O Grok 4.7 supera o GPT-5.6 Sol na maioria dos benchmarks de programação e agênticos por uma fração do preço, enquanto o Fable 5.1 ainda lidera em programação de ponta e trabalho de terminal, mas custa de cinco a oito vezes mais por token. Para trabalho sensível a custo e de alto volume, o Grok 4.7 costuma ser a melhor opção.
O que é o Grok 4.7 Fast?
O Grok 4.7 Fast é o mesmo modelo servido com o dobro da velocidade de saída pelo dobro do preço por token, disponível apenas dentro do Cursor e do Grok Build, não na API pública. Vale a pena quando a baixa latência importa, como ao ver o código sendo transmitido em tempo real, e é dispensável para trabalhos em lote ou em segundo plano.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.