O que é o Grok 4.7
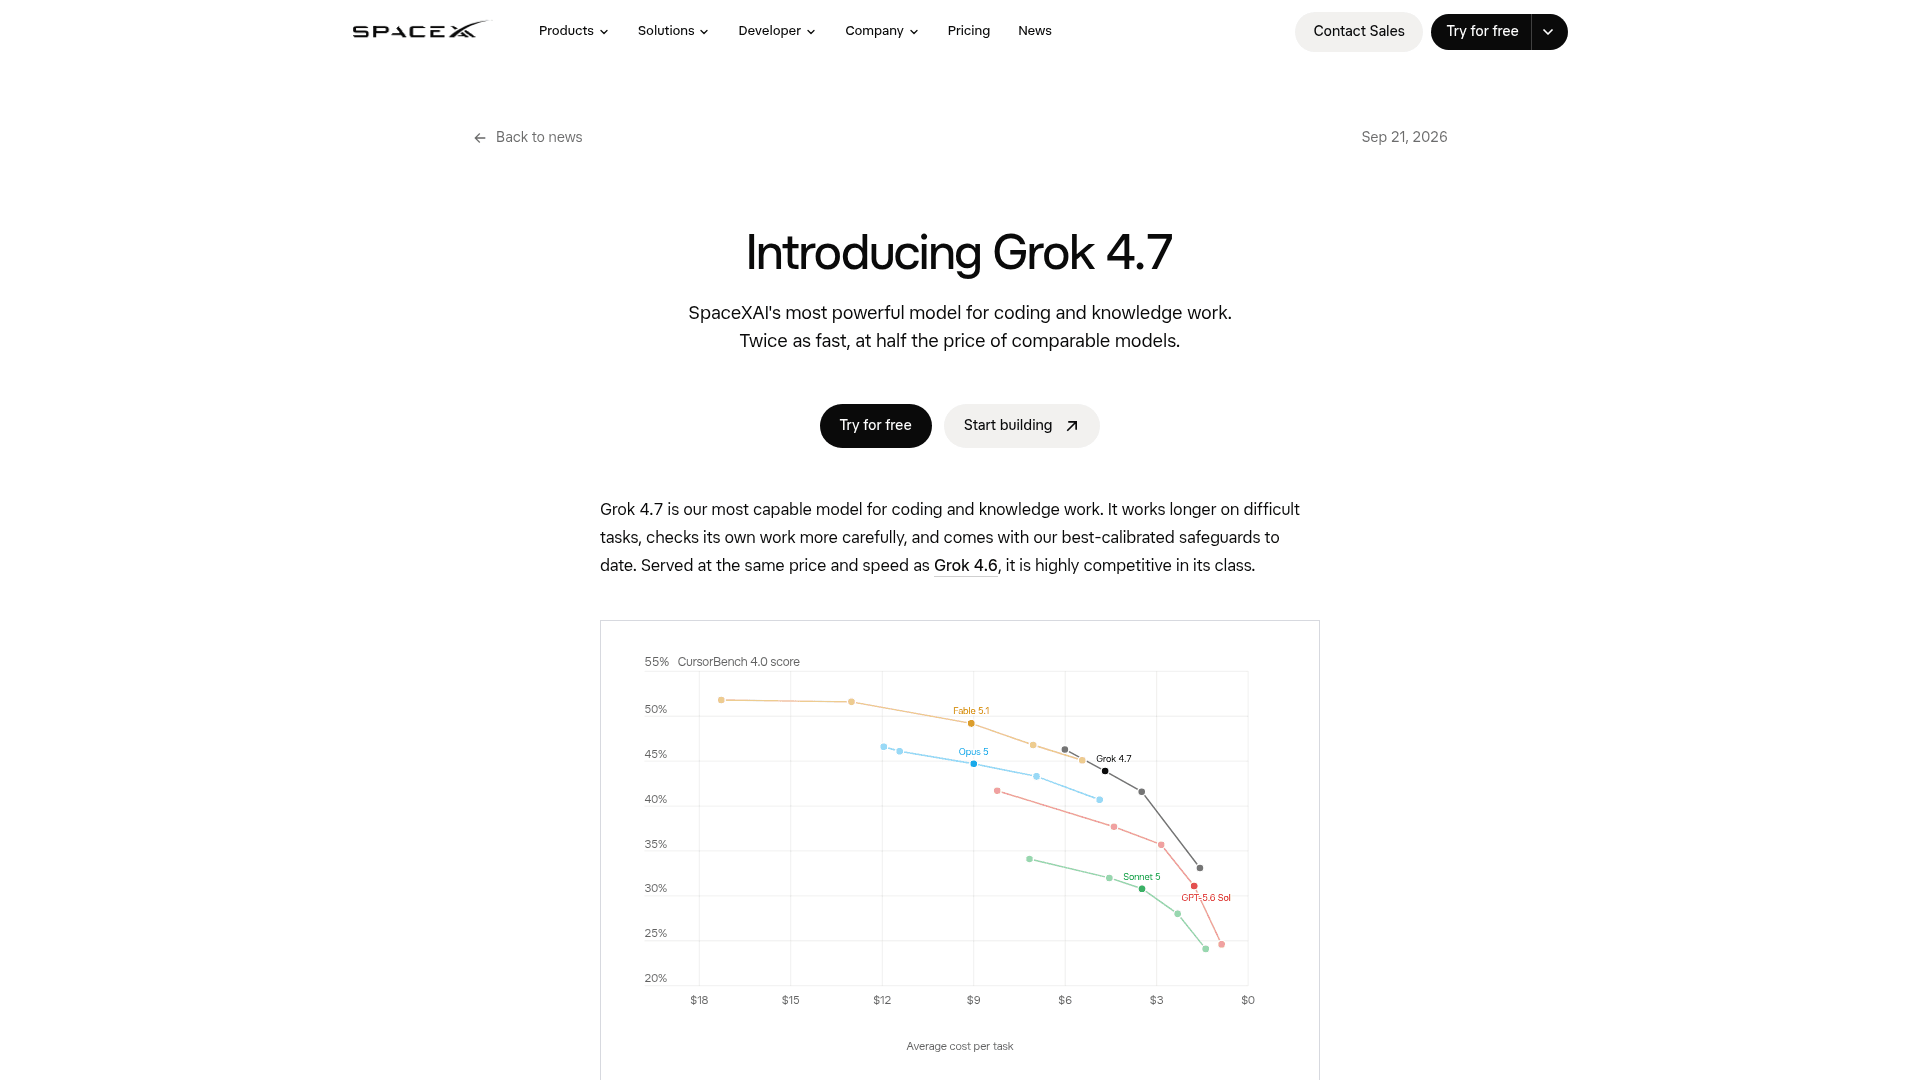
O Grok 4.7 é o modelo principal da xAI para código, agentes e trabalho de conhecimento, lançado como grok-4.7 na API da xAI. Ele mantém a janela de contexto de 500 mil tokens do Grok 4.6, aceita texto e imagem como entrada e retorna texto, e expõe um esforço de raciocínio configurável em baixo, médio, alto e xAlto. Seu corte de conhecimento é maio de 2026, e, como todo modelo Grok, não tem consciência de eventos ao vivo a menos que você ative as ferramentas de busca na web e no X do lado do servidor.
A própria construção é a parte interessante. A xAI treinou o 4.7 sobre um modelo base novo e maior que o 4.6, e depois rodou um treinamento de aprendizado por reforço mais longo em uma combinação de tarefas mais difícil, voltada para problemas que levam muitas horas. Ele também foi treinado para entender nativamente o ambiente do Grok Bot, o que explica por que ele parece mais fluido em trabalhos de múltiplas etapas com chamadas de ferramentas do que um modelo de chat bruto costuma ser. Um recurso de API totalmente novo chega junto: uma API de compactação de contexto para manter históricos longos abaixo do limite de preço.
O Grok 4.7 é o cérebro de texto e código de uma linha mais ampla, e esta análise trata apenas desse modelo. Se você procurava as outras partes, a xAI as separa: o Grok Imagine cuida de imagem e vídeo, a API do Grok Voice cuida da fala, e o lado do criador de agentes fica no Grok Bot. Tudo abaixo trata apenas do grok-4.7.
O que realmente mudou em relação ao Grok 4.6
A atualização do Grok 4.5 para o 4.6 foi incremental, como observou a análise do Grok 4.5. O salto para o 4.7 não é, pelo menos em um ponto. A forma mais clara de ver isso são as diferenças de benchmarks publicadas pela xAI.
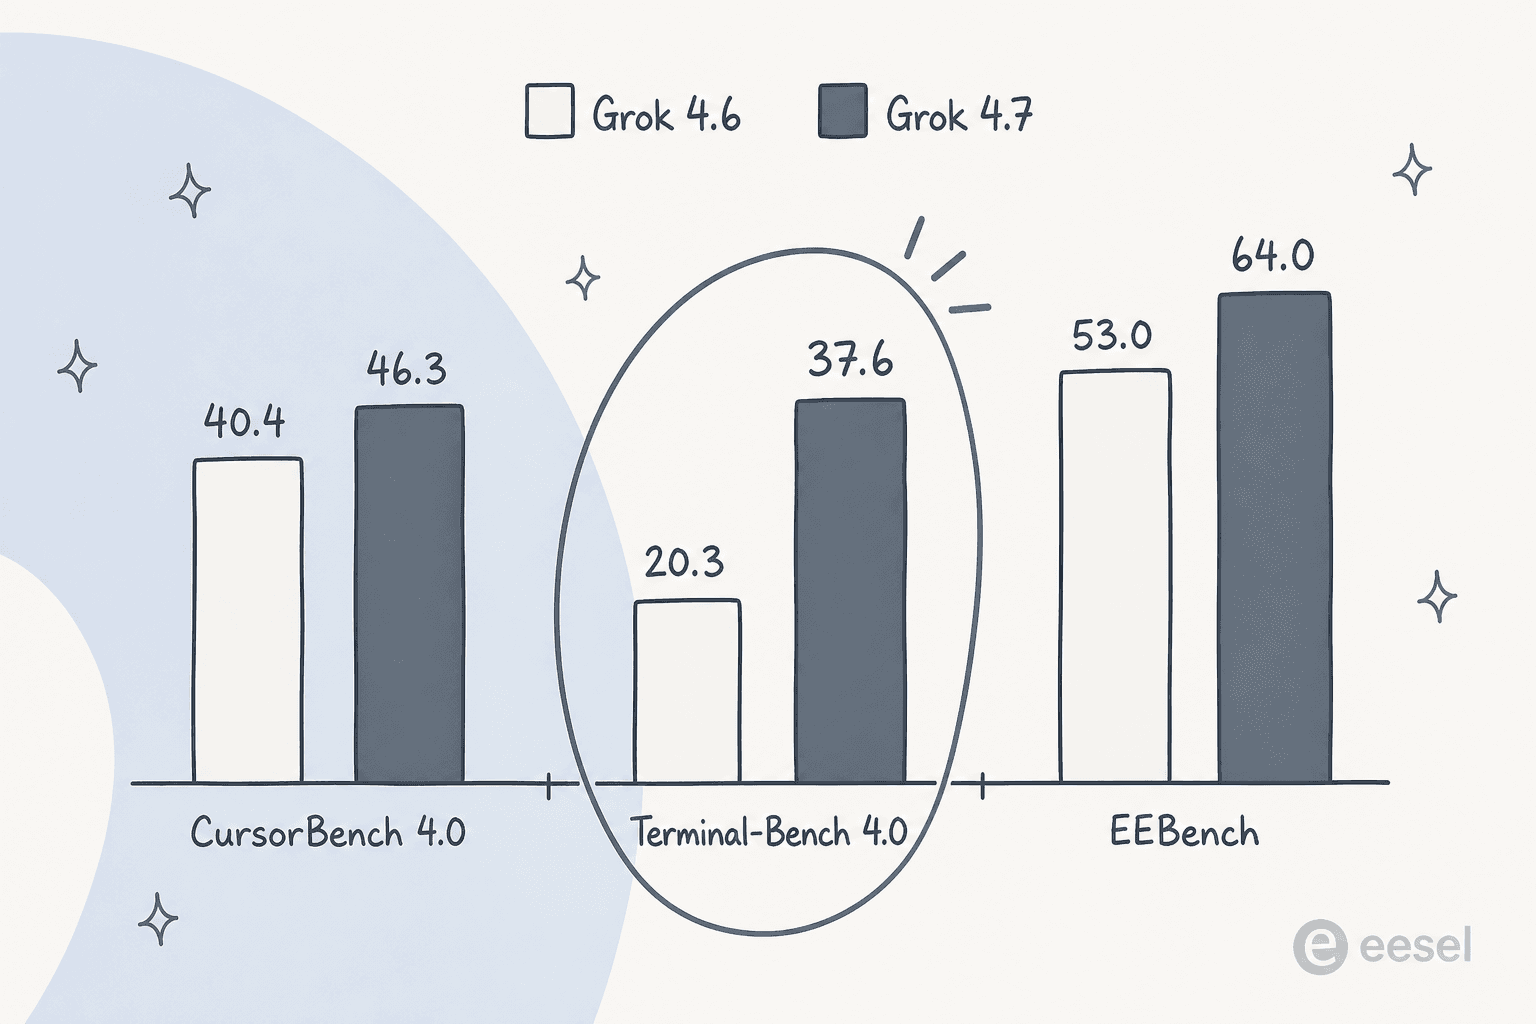
O CursorBench 4.0 passou de 40,4 para 46,3, e o EEBench (engenharia elétrica) de 53,0 para 64,0. São ganhos sólidos. O destaque é o Terminal-Bench 4.0, que quase dobrou, de 20,3 para 37,6, o maior ganho isolado entre o 4.6 e o 4.7, e uma medida direta de quão bem o modelo sustenta um trabalho de terminal longo e de múltiplas etapas sem perder o fio. Se o seu caso de uso é um agente avançando por uma lista de tarefas real em vez de responder a um único prompt, esse é o número que importa, e é o número que a análise do Grok 4.6 ainda não podia mostrar.
O restante das melhorias é mais discreto: melhor autoverificação, tratamento mais estável de contexto longo e saída mais forte de documentos e apresentações, o que aparece como ganhos nos benchmarks de trabalho profissional GDPval e AA Briefcase. Nada disso é gratuito em outros lugares, e aqui chega pelo mesmo preço.
Os benchmarks, lidos com honestidade
A xAI comparou o Grok 4.7 xHigh com o Grok 4.6 High, o GPT-5.6 Sol Max e o Fable 5.1 Max. Aqui está a tabela principal, direto da página de lançamento, para você ver tanto onde o 4.7 vence quanto onde não vence.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Entrada $/1M | $2 | $2 | $4 | $10 |
| Saída $/1M | $6 | $6 | $20 | $50 |
| CursorBench 4.0 | 46.3 | 40.4 | 41.7 | 51.8 |
| DeepSWE v1.1 | 71.0* | 65.2 | 72.7 | 70.0 |
| Terminal-Bench 4.0 | 37.6 | 20.3 | 37.3 | 57.9 |
| EEBench | 64.0 | 53.0 | 39.4 | 56.4 |
| AA Briefcase v1.1 (Elo) | 1657 | 1546 | 1487 | 1678 |
| Harvey Legal Agent | 19.6 | 15.8 | 2.5 | 6.7 |
| HealthBench Professional | 56.7 | 48.5 | 60.5 | 62.1 |
*pontuação com esforço alto. Fonte: xAI, lançamento do Grok 4.7.
Lida com justiça, a imagem é clara. O Grok 4.7 vence de forma clara no EEBench e no benchmark Harvey Legal Agent, onde mais que dobra a pontuação do Fable, e é competitivo em tudo o mais. Mas o Fable 5.1 lidera em CursorBench, Terminal-Bench e AA Briefcase, o GPT-5.6 Sol o supera por pouco no DeepSWE, e no HealthBench Professional o Grok 4.7 perde para ambos. Então, se o seu trabalho é precisão máxima de programação ou raciocínio clínico e o orçamento não é problema, o Grok 4.7 não é a escolha. Se o seu trabalho é rodar essa capacidade em grande volume, o próximo gráfico é o que decide.
O preço é todo o argumento
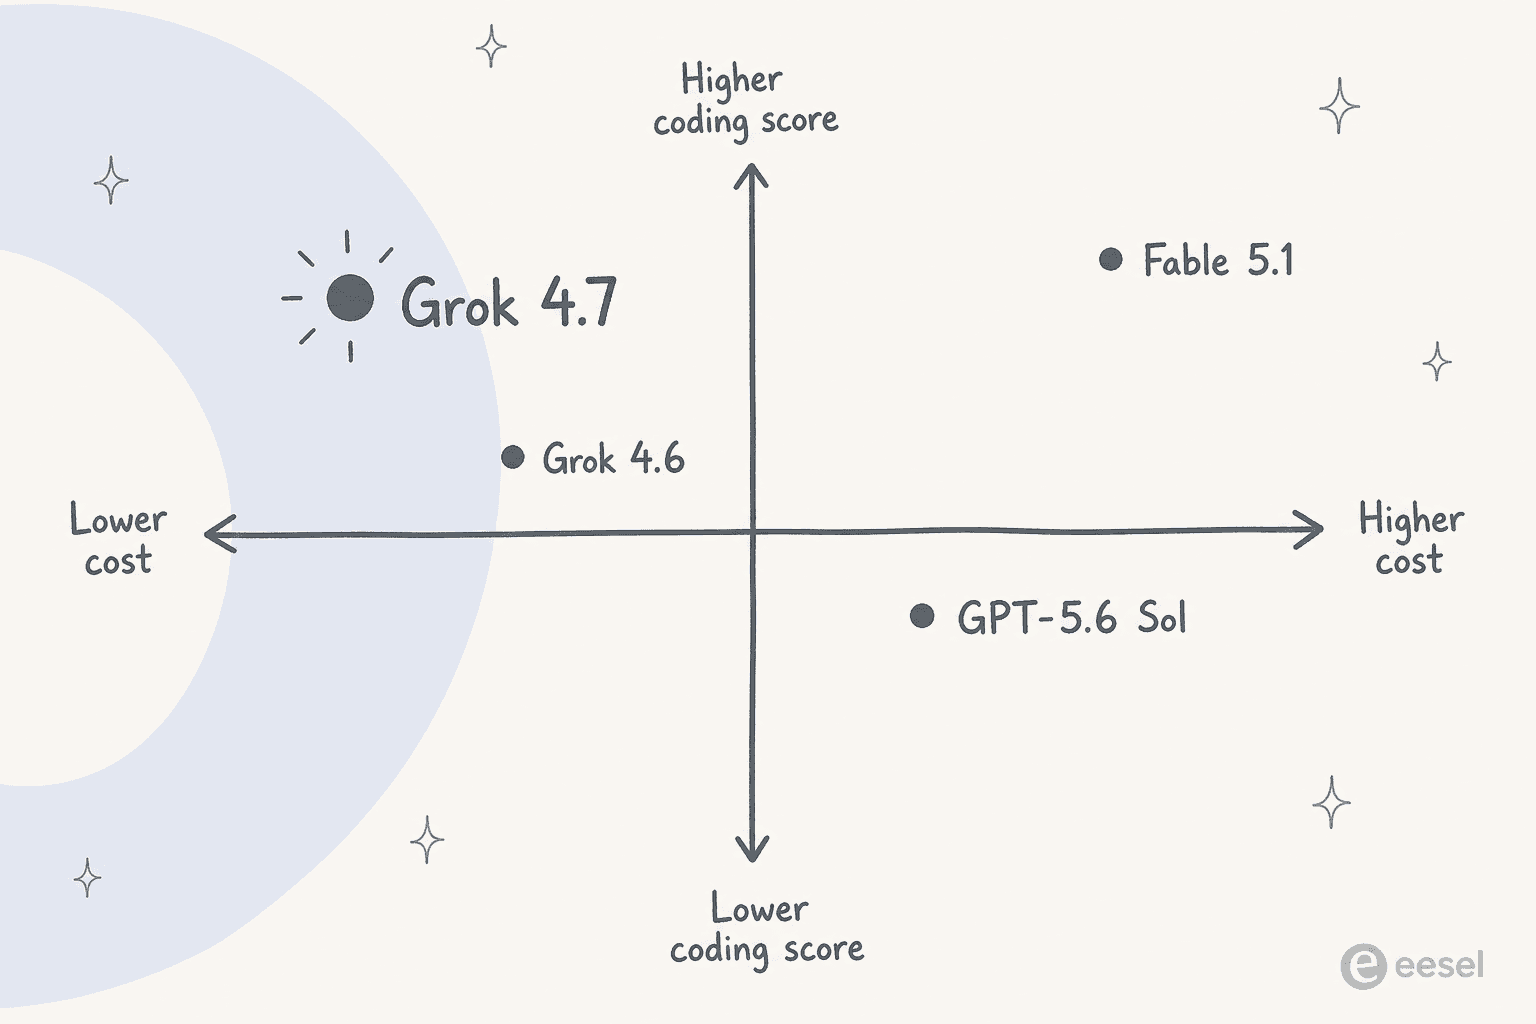
O Grok 4.7 entrega uma capacidade próxima do Fable pelo preço do Grok 4.6. Concretamente, uma tarefa que lê 50 mil tokens e escreve 10 mil custa cerca de 0,16 $ no Grok 4.7 contra 0,40 $ no GPT-5.6 Sol e 1,00 $ no Fable 5.1. Multiplique isso por um agente que faz milhares de execuções por dia, e a escolha do modelo deixa de ser sobre uma casa decimal de benchmark e passa a ser sobre a sua conta.
Duas ressalvas para manter isso honesto. Primeiro, o limite de 200 mil: ultrapassar 200 mil tokens de prompt dobra a taxa para 4 $ / 1 $ / 12 $, aplicada a todos os tokens da solicitação, não apenas ao excedente, que é exatamente o que a API de compactação de contexto existe para evitar. Segundo, o gráfico de lançamento comparava com o antigo GPT-5.6 Sol a 4 $ / 20 $, mas a OpenAI lançou o GPT-6 Sol a 2 $ / 10 $ no dia seguinte, então a diferença real de preço de saída é de 40%, não os 70% que o gráfico sugere. Os preços da xAI continuam os mais fortes da categoria, só que não com uma margem tão grande quanto o slide sugere. O detalhamento completo, medidor por medidor, está no guia de preços do Grok 4.7.
Há também a sobretaxa da variante Fast que vale a pena conhecer. O Grok 4.7 Fast é o mesmo modelo com o dobro da velocidade de saída pelo dobro do preço por token, e existe apenas dentro do Cursor e do Grok Build, não na API pública. Vale a pena pagar quando você está acompanhando código sendo gerado em tempo real e a latência incomoda; é dinheiro jogado fora em trabalhos em lote ou noturnos em que ninguém está esperando.
Eu rodo agentes em alto volume (chamadas de ferramentas, trabalho de terminal)
Sim, mude. Esse é o ponto ideal. O salto no Terminal-Bench somado ao preço de 2 $ / 6 $ é exatamente o que um loop de agentes precisa. Fique de olho no limite de 200 mil e use o Context Compaction.
Preciso da melhor precisão de programação, custo à parte
Fique com o Fable 5.1 para as tarefas mais difíceis. Muitas equipes direcionam a maior parte do trabalho ao Grok 4.7 e só escalam os casos mais extremos para um modelo mais caro.
Eu faço raciocínio clínico ou sensível à saúde
Não é a escolha certa. O Grok 4.7 fica atrás do GPT-5.6 Sol e do Fable 5.1 no HealthBench Professional. Decida com base nesse benchmark, não no preço.
Quero que a IA responda tickets de suporte ou escreva meu blog
Um modelo bruto é a camada errada. Você quer um colega de equipe que já conheça seu produto e se conecte às suas ferramentas. Pule para a última seção.
Segurança, algo que a xAI levou a sério desta vez
Merece um parágrafo porque é uma mudança real. O Grok 4.7 foi lançado com uma pilha de segurança inteiramente nova e é, segundo os próprios testes da xAI, seu modelo mais forte em recusas e resistência a jailbreaks. No HackerBench v0.3, ele deixa passar apenas 3,3% dos prompts arriscados de duplo uso, enquanto raramente bloqueia trabalho legítimo de segurança, e lidera o benchmark de biossegurança da LatchBio com 62,4%. A xAI também começou a dar a parceiros de cibersegurança selecionados acesso por convite às capacidades de red team do modelo. Para uma empresa cujos modelos anteriores receberam críticas exatamente nesse ponto, essa é uma melhoria significativa e verificável, não apenas uma frase de comunicado de imprensa.
O que dizem quem realmente constrói com ele
Benchmarks são a narrativa da xAI. Aqui está o que desenvolvedores independentes relatam. O sinal mais útil que encontrei foi sobre escopo: o modelo resolve coisas pequenas lindamente em uma única tentativa, e o entusiasmo esfria em bases de código grandes já existentes.
"I agree, the models keep getting better at one shotting. That's useful in a lot of situations, like for small one-off scripts that filter/transform some tool call, or make a clever bash call. For the code itself, it doesn't help me much though."

Isso está de acordo com o formato dos benchmarks: forte em tarefas delimitadas e bem especificadas, menos mágico quando o trabalho é "entender este repositório de 200 mil linhas". O outro tema recorrente é que usuários intensos do dia a dia raramente atingem o teto de uso, o que importa se você já se queimou com limites de crédito em outras ferramentas.
"I use the crap out of Grok in my daily life, including to build a couple self-hosted apps as an amateur. I have a Grok bot monitor my email every 15 minutes and file things away for me... and I never even get close to using my quota."
Ambos se alinham com o fio condutor desta análise: como um motor barato e de alto rendimento em que você pode confiar o dia todo, o Grok 4.7 entrega. O que nenhum dos dois comentaristas está descrevendo é um sistema que já chega conhecendo a empresa deles, exatamente a lacuna que quero fechar na última seção.
Quem deveria usar o Grok 4.7
Recorra a ele se você escreve código, roda agentes ou constrói sobre a API e se importa com o custo por tarefa, o que descreve a maioria das pessoas que constroem produtos de IA em 2026. É a escolha padrão natural para loops de agentes de alto volume, e uma camada base inteligente mesmo que você escale os 5% de tarefas mais difíceis para o Claude Opus 5 ou o Fable. Comparado ao restante do campo de ponta barato, é um modelo mais versátil em trabalho agêntico do que o Kimi K3 ou o DeepSeek V4 Flash.
Ele também supera o Qwen em tarefas de terminal e é mais barato que o GPT-5.6 Sol no preço, enquanto empata com ele na maior parte da programação. Dentro de um editor, ele roda no Cursor, então, no dia a dia, compete com as mesmas ferramentas sobre as quais essa comunidade já discute.
Deixe-o de lado, ou pelo menos não o coloque em primeiro plano, se você precisa de precisão máxima de programação independentemente do orçamento, se o seu trabalho é clínico, ou se o que você realmente quer não é um modelo, mas um trabalho concluído. Esse último caso é mais comum do que o enquadramento de análise de modelo costuma admitir, e é aí que eu quero ser direto.
A parte que uma análise de modelo geralmente ignora: um motor não é um funcionário
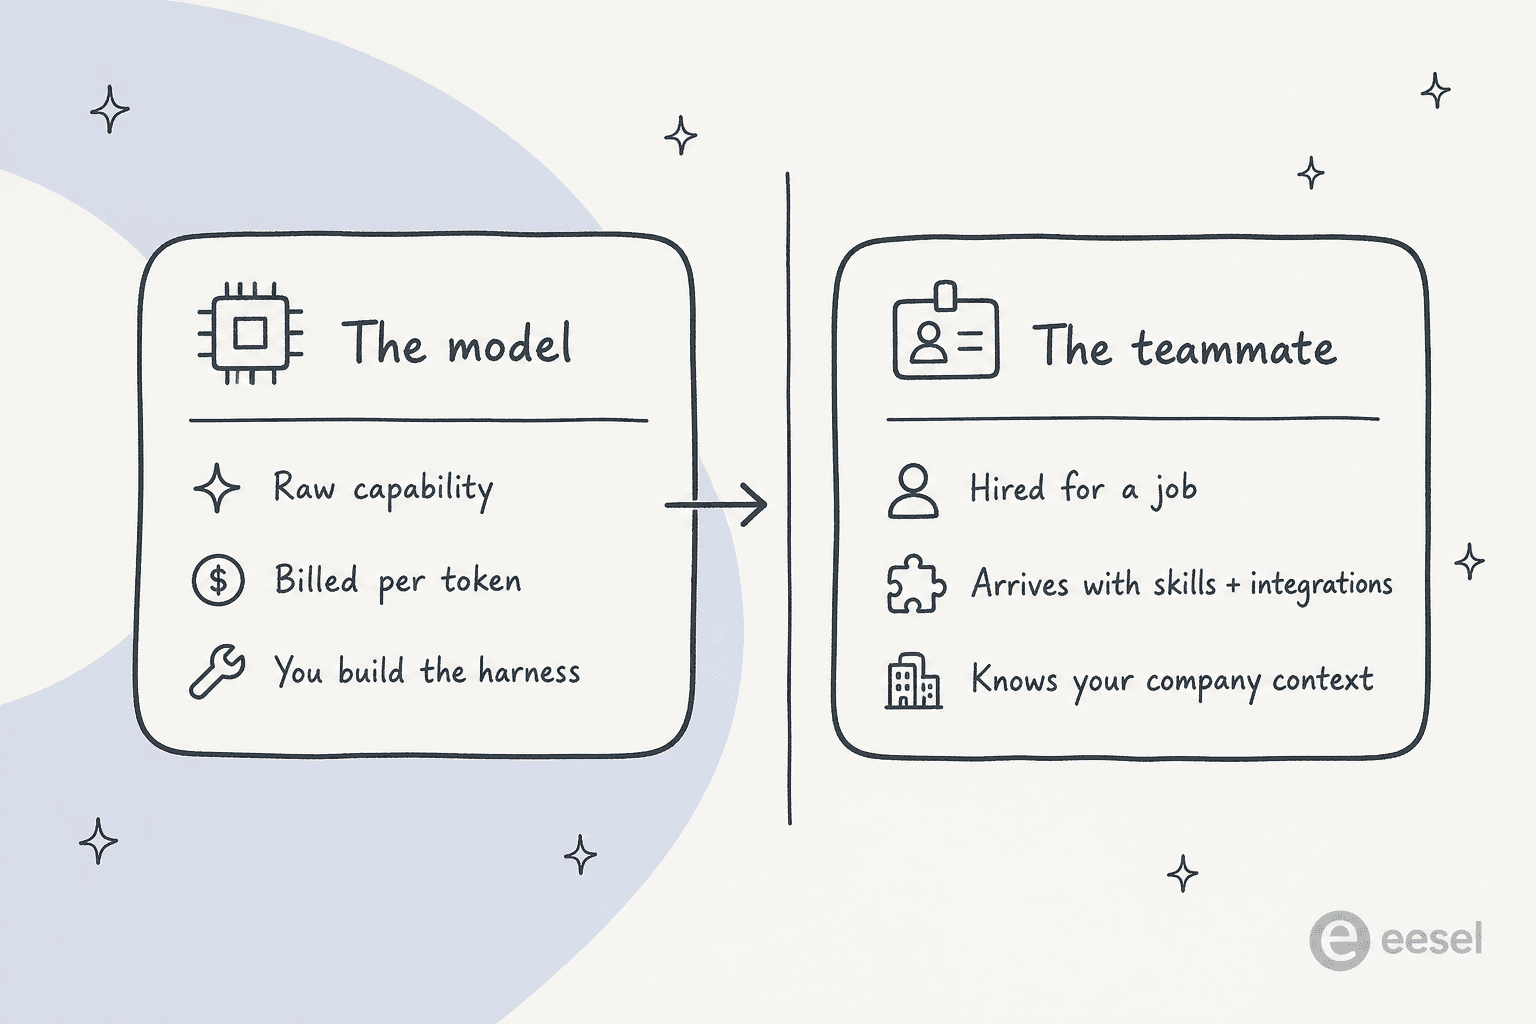
Eis o que três anos colocando IA em filas de suporte reais me ensinaram. Um modelo de ponta é um motor incrivelmente capaz, e um motor não é a mesma coisa que um funcionário. O Grok 4.7 te dá inteligência bruta por token. Ele não conhece sua política de reembolso, não está conectado ao seu helpdesk, nunca viu seus tickets anteriores, e não vai, por conta própria, decidir quais perguntas tem confiança suficiente para responder e quais deixar para um humano. Conectar tudo isso é um projeto de verdade, e é a parte sobre a qual a pontuação de benchmark é silenciosa.
Essa é uma decisão de construir versus comprar que chega para toda equipe eventualmente. Um cliente, uma empresa de infraestrutura, colocou isso de forma direta:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Essa é a lacuna que a eesel foi construída para fechar. A eesel é uma plataforma de colegas de equipe de IA, e você contrata colegas de equipe prontos para trabalhar em funções específicas em vez de alugar tokens crus. O portfólio atual inclui um colega de equipe de IA para helpdesk que se junta à sua fila de suporte existente, e um redator de blog com IA que fica ao lado das melhores ferramentas de escrita com IA para conteúdo com qualidade de pesquisa. Cada um chega já construído sobre modelos de ponta, e já carregando as habilidades, integrações e contexto da empresa para sua função.
O colega de equipe de suporte treina com seus tickets históricos, redige rascunhos ou responde totalmente no seu tom, e só assume o que tem confiança para tratar, exatamente o controle que a abordagem de modelo por token te obriga a construir sozinho. Essa diferença é todo o argumento em agente de IA versus chatbot baseado em regras, e é por isso que IA para atendimento ao cliente é uma categoria de produto, não apenas um prompt.
A prova está na fila, não no benchmark. Um cliente, uma plataforma de mobilidade, viu a eesel resolver 73% das solicitações de nível 1 no primeiro mês, e outro relatou até 80% de economia de tempo no suporte. Esses são números que você obtém de um colega de equipe que conhece o trabalho, não de um modelo que teve boa pontuação no Terminal-Bench. Se você ainda está avaliando o lado do custo, o detalhamento de agente de IA versus custo de agente humano e o panorama mais amplo de software de atendimento ao cliente com IA são as próximas leituras que eu recomendaria.
Se você realmente quer pilotar o modelo você mesmo
Para os desenvolvedores a quem o Grok 4.7 se destina, existe um caminho intermediário que vale a pena conhecer. A eesel oferece uma interface de linha de comando e um servidor MCP que expõem o mesmo colega de equipe e espaço de trabalho de uma forma amigável a agentes. Uma pessoa pode pilotá-lo a partir de um terminal, scripts podem automatizá-lo, e agentes de programação como Claude Code, Codex e Cursor podem operá-lo diretamente. Assim, você obtém o controle programável e sem interface que despertou seu interesse por uma API bruta em primeiro lugar, mas direcionado a um colega de equipe que já conhece sua empresa, em vez de um modelo em branco que você precisa ensinar do zero a cada execução. É o mesmo raciocínio por trás de automatizar a triagem de tickets a partir do código em vez de clicar em um painel.
Quer ver isso funcionando nos seus próprios tickets? A eesel se conecta ao seu helpdesk em minutos, treina com seu histórico e permite simular contra milhares de tickets passados antes de responder um único ticket ao vivo. Grátis para testar.

Meu veredito
O Grok 4.7 é um modelo fácil de recomendar pelo que é: o melhor custo-benefício na ponta, especialmente para agentes e programação de alto volume. Não é o modelo mais inteligente em todos os eixos, e o gráfico de lançamento superestima a diferença de preço agora que o GPT-6 Sol existe, mas para trabalho sensível a custo é o primeiro ao qual eu recorreria. Só lembre do que você está comprando. Um modelo te dá capacidade por token. Se o que você precisa é um trabalho feito de forma confiável, isso exige um colega de equipe, e essa é uma compra completamente diferente.
Perguntas frequentes
O Grok 4.7 é bom?
Para programação e trabalho agêntico com baixo custo, sim. Nesta análise do Grok 4.7, ele registra o maior salto entre os lançamentos recentes da xAI em tarefas de terminal de longa duração e mantém uma posição de ponta em custo-benefício. Não é o modelo mais inteligente em todos os quesitos, já que o Fable 5.1 da Claude ainda lidera em programação de alto nível e trabalho de terminal, mas é o melhor custo-benefício da sua categoria.
Quanto custa o Grok 4.7?
O Grok 4.7 custa 2 $ por milhão de tokens de entrada, 0,50 $ em cache e 6 $ de saída abaixo de 200 mil tokens de prompt, passando para 4 $ / 1 $ / 12 $ quando uma solicitação ultrapassa 200 mil, de acordo com a página de preços da xAI. É idêntico ao Grok 4.6. O detalhamento completo, incluindo os medidores de busca e execução de código, está no guia de preços do Grok 4.7.
O Grok 4.7 é melhor que o GPT-5.6 Sol?
No conjunto de benchmarks da própria xAI, o Grok 4.7 supera o GPT-5.6 Sol na maioria das tarefas de programação e agênticas por uma fração do preço, embora o Sol saia na frente em raciocínio clínico. Vale notar que a OpenAI já lançou o GPT-6 Sol a 2 $ / 10 $, então a diferença de preço real é menor do que o gráfico de lançamento sugere.
Qual é a diferença entre o Grok 4.7 e o Grok 4.6?
O Grok 4.7 roda sobre um modelo base maior e um treinamento de aprendizado por reforço mais longo, voltado a tarefas de várias horas. Ele registra os maiores ganhos no Terminal-Bench 4.0, quase dobrando a pontuação do 4.6. Ambos mantêm a janela de contexto de 500 mil tokens e o mesmo preço, então é um ganho de capacidade gratuito. A análise do Grok 4.6 cobre o lançamento anterior.
O Grok 4.7 é bom para programação?
Programação é seu principal ponto forte. Ele marca 46,3% no CursorBench 4.0 e supera o Grok 4.6 em todos os benchmarks de software publicados pela xAI. Ele roda dentro do Cursor e do Grok Build, e desenvolvedores da comunidade relatam que ele é forte em criar scripts pequenos em uma única tentativa, embora seja menos transformador em bases de código grandes já existentes.
O que é o Grok 4.7 Fast?
O Grok 4.7 Fast é o mesmo modelo com o dobro da velocidade de saída pelo dobro do preço por token, disponível apenas no Cursor e no Grok Build, não na API pública. Vale a sobretaxa quando a latência importa, como ao acompanhar código sendo gerado em tempo real, e é dispensável em trabalhos em lote ou noturnos. Veja a visão geral dos preços da xAI.
Como faço para acessar o Grok 4.7?
Você pode chamá-lo na API da xAI como grok-4.7, usá-lo gratuitamente no Grok Build, ou acessá-lo dentro do Cursor. Se você quer que essa inteligência realize um trabalho definido em vez de tokens crus, um colega de equipe de IA reúne um modelo de ponta com as habilidades, integrações e contexto da empresa para uma função real, como a automação de suporte.


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.