Por que as pessoas procuram uma alternativa ao Grok 4.7
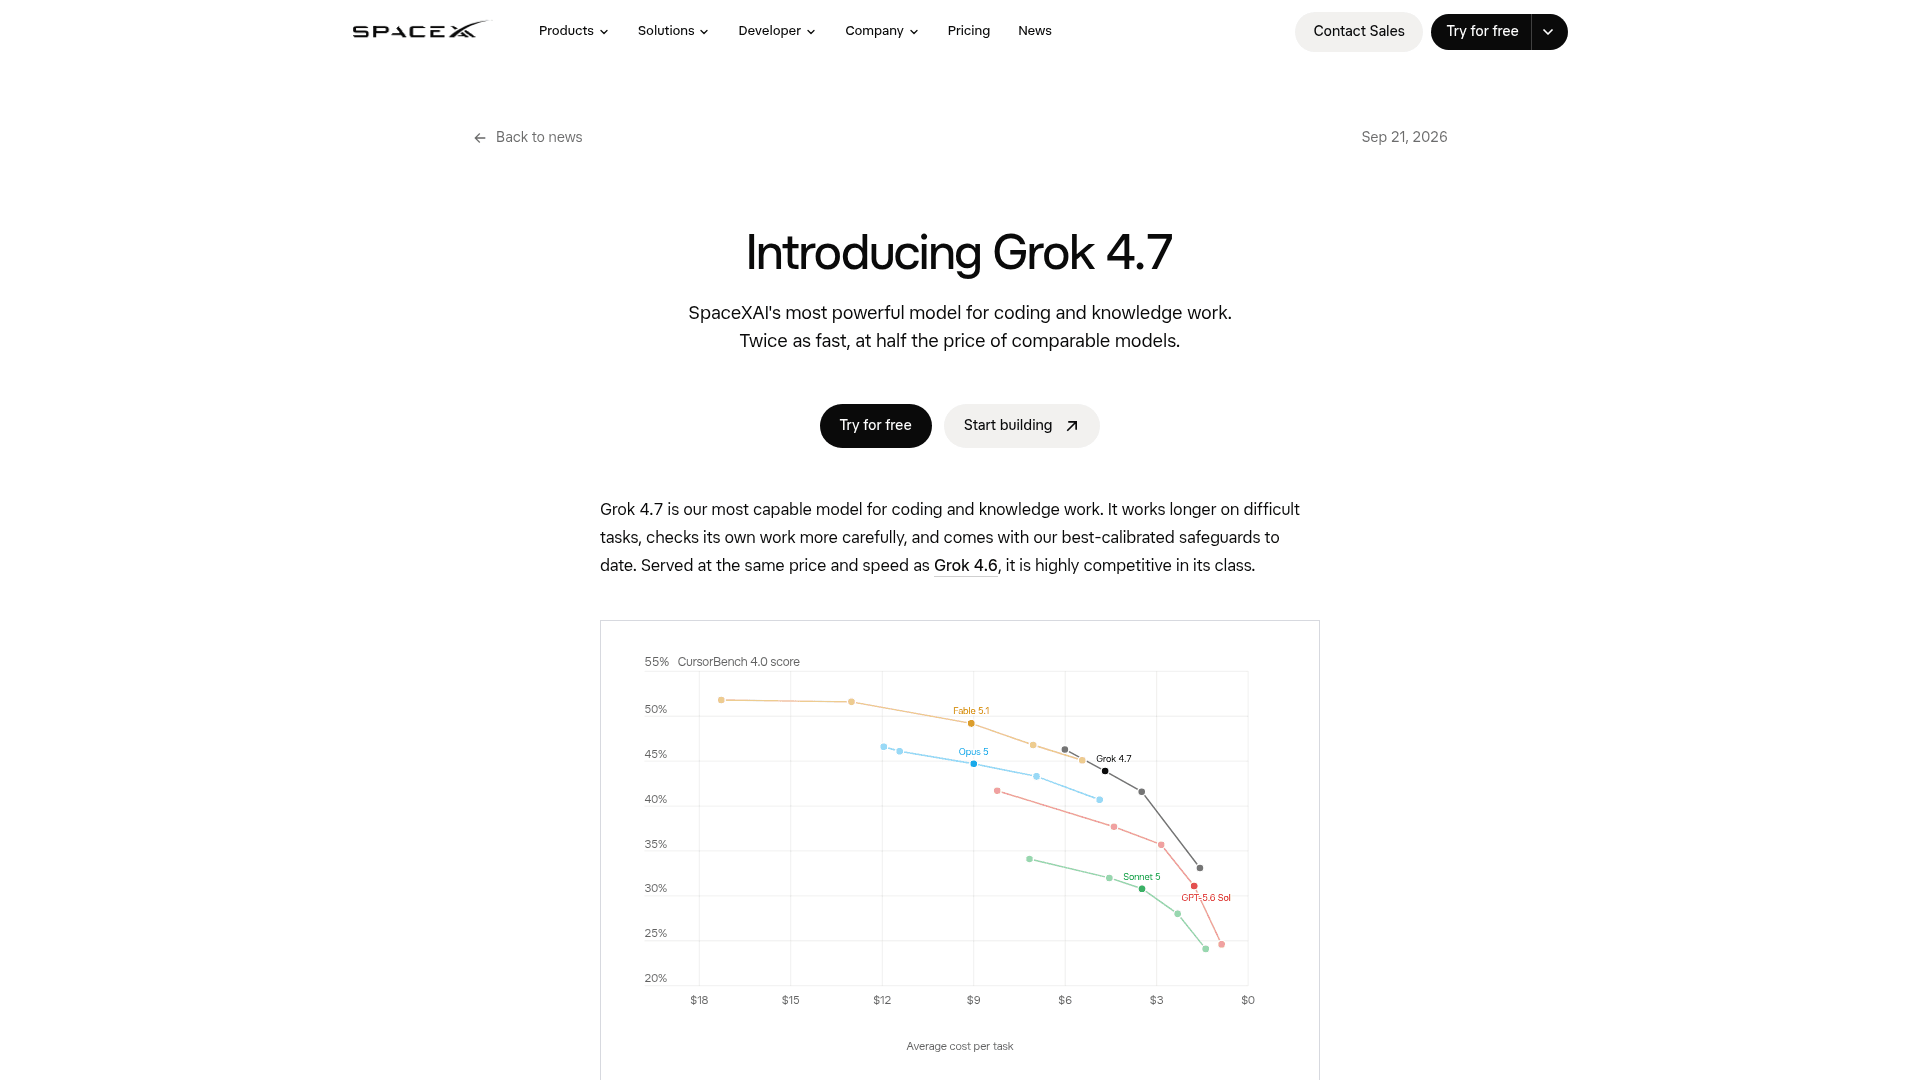
O Grok 4.7 é uma escolha padrão forte, então os motivos para procurar outra coisa costumam ser específicos. O mais comum que ouço é o salto de preço dos 200k tokens: assim que uma requisição ultrapassa 200k tokens de prompt, o Grok 4.7 cobra cada token dessa requisição a 4 $ / 12 $ em vez de 2 $ / 6 $, segundo a página de preços da xAI. Se sua carga de trabalho envolve documentos longos ou bases de código grandes, essa duplicação muda a conta, e algumas alternativas simplesmente não a cobram.
Os outros motivos são de política e capacidade. O Grok é fechado, então se você precisa de pesos abertos, ele fica de fora. Ele recebe texto e imagem como entrada e produz texto, então se você precisa de compreensão nativa de áudio ou vídeo, olhe para o Gemini. E algumas equipes simplesmente querem o topo absoluto dos rankings de inteligência, onde a Claude ainda vive. Usuários do Grok 4.6 também podem ler a análise do Grok 4.6 para o contexto da geração anterior.
Como comparei esses modelos
Fiquei com fontes primárias: as próprias páginas de modelo e preço de cada fornecedor, além das tabelas de benchmark publicadas pelos próprios fabricantes. Os preços são os valores em vigor nas páginas de documentação em setembro de 2026, então, se alguma promoção expirar (a do Gemini expira em 1º de janeiro de 2027), sinalizei isso. Onde cito rankings de inteligência, eles vêm dos próprios gráficos dos fabricantes e do índice independente Artificial Analysis, não de uma lista de terceiros reescrevendo outra lista.
Dei bastante peso a duas coisas, porque são as que os compradores costumam ignorar: o salto de preço dos 200k, e se o número "barato" é o número que você realmente paga. Um modelo que é barato por token mas verboso por tarefa não é barato. Sinalizei isso onde se aplica.
As melhores alternativas ao Grok 4.7 num relance
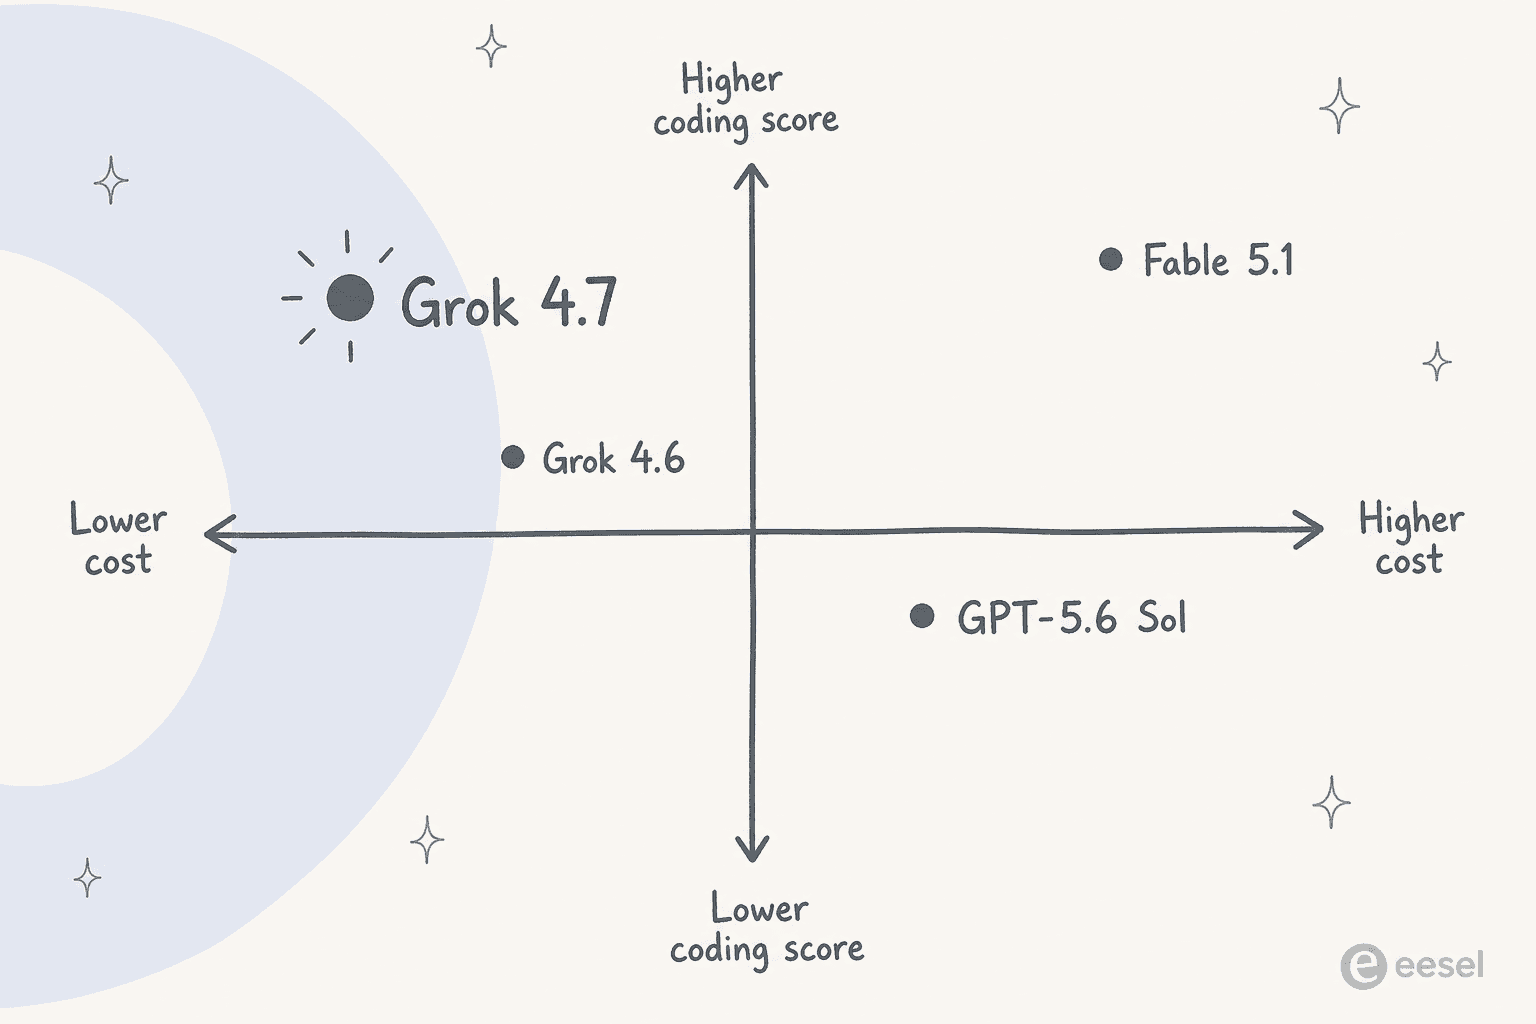
Aqui está todo o campo em uma única tela. Os preços são por milhão de tokens, da documentação ao vivo de cada fornecedor.
| Modelo | Fabricante | Entrada / Saída | Contexto | Salto dos 200k | Pesos abertos | Visão nativa | Melhor para |
|---|---|---|---|---|---|---|---|
| Grok 4.7 | xAI | 2 $ / 6 $ | 500k | Sim (2x) | Não | Imagem | Programação de fronteira barata |
| Claude Fable 5.1 | Anthropic | 10 $ / 50 $ | 1M | Não (fixo) | Não | Imagem | Inteligência máxima |
| Claude Opus 5.5 | Anthropic | 4 $ / 20 $ | 1M | Não (fixo) | Não | Imagem | Programação agêntica longa |
| GPT-6 Sol | OpenAI | 2 $ / 10 $ | Grande | Sim (2x) | Não | Imagem | Ecossistema + equilíbrio |
| Gemini 3.8 Flash | 0,75 $ / 3,75 $ | 1M | Não (fixo) | Não | Imagem, áudio, vídeo | Multimodal + barato | |
| DeepSeek V4.1 Flash | DeepSeek | ~0,22 $ / 0,66 $ | 1M | Não | Sim (MIT) | Não | Mais barato, autoalojável |
| Kimi K3 | Moonshot | 3 $ / 15 $ | 1M | Não | Sim | Imagem, vídeo | Fronteira de pesos abertos |
| Qwen 3.8 Max | Alibaba | 2 $ / 6 $ | 1M | Não | Só a base | Imagem, vídeo | Preço do Grok, base aberta |
Uma nota de justiça antes da lista: os 0,75 $ / 3,75 $ do Gemini são a tarifa promocional até 31 de dezembro de 2026, depois ela dobra. A tarifa fora de pico do DeepSeek aproximadamente dobra durante o horário comercial chinês. E a base aberta do Qwen 3.8 Max não é equivalente em recursos à versão hospedada. Os detalhes estão em cada item.
1. Claude (Fable 5.1 e Opus 5.5)
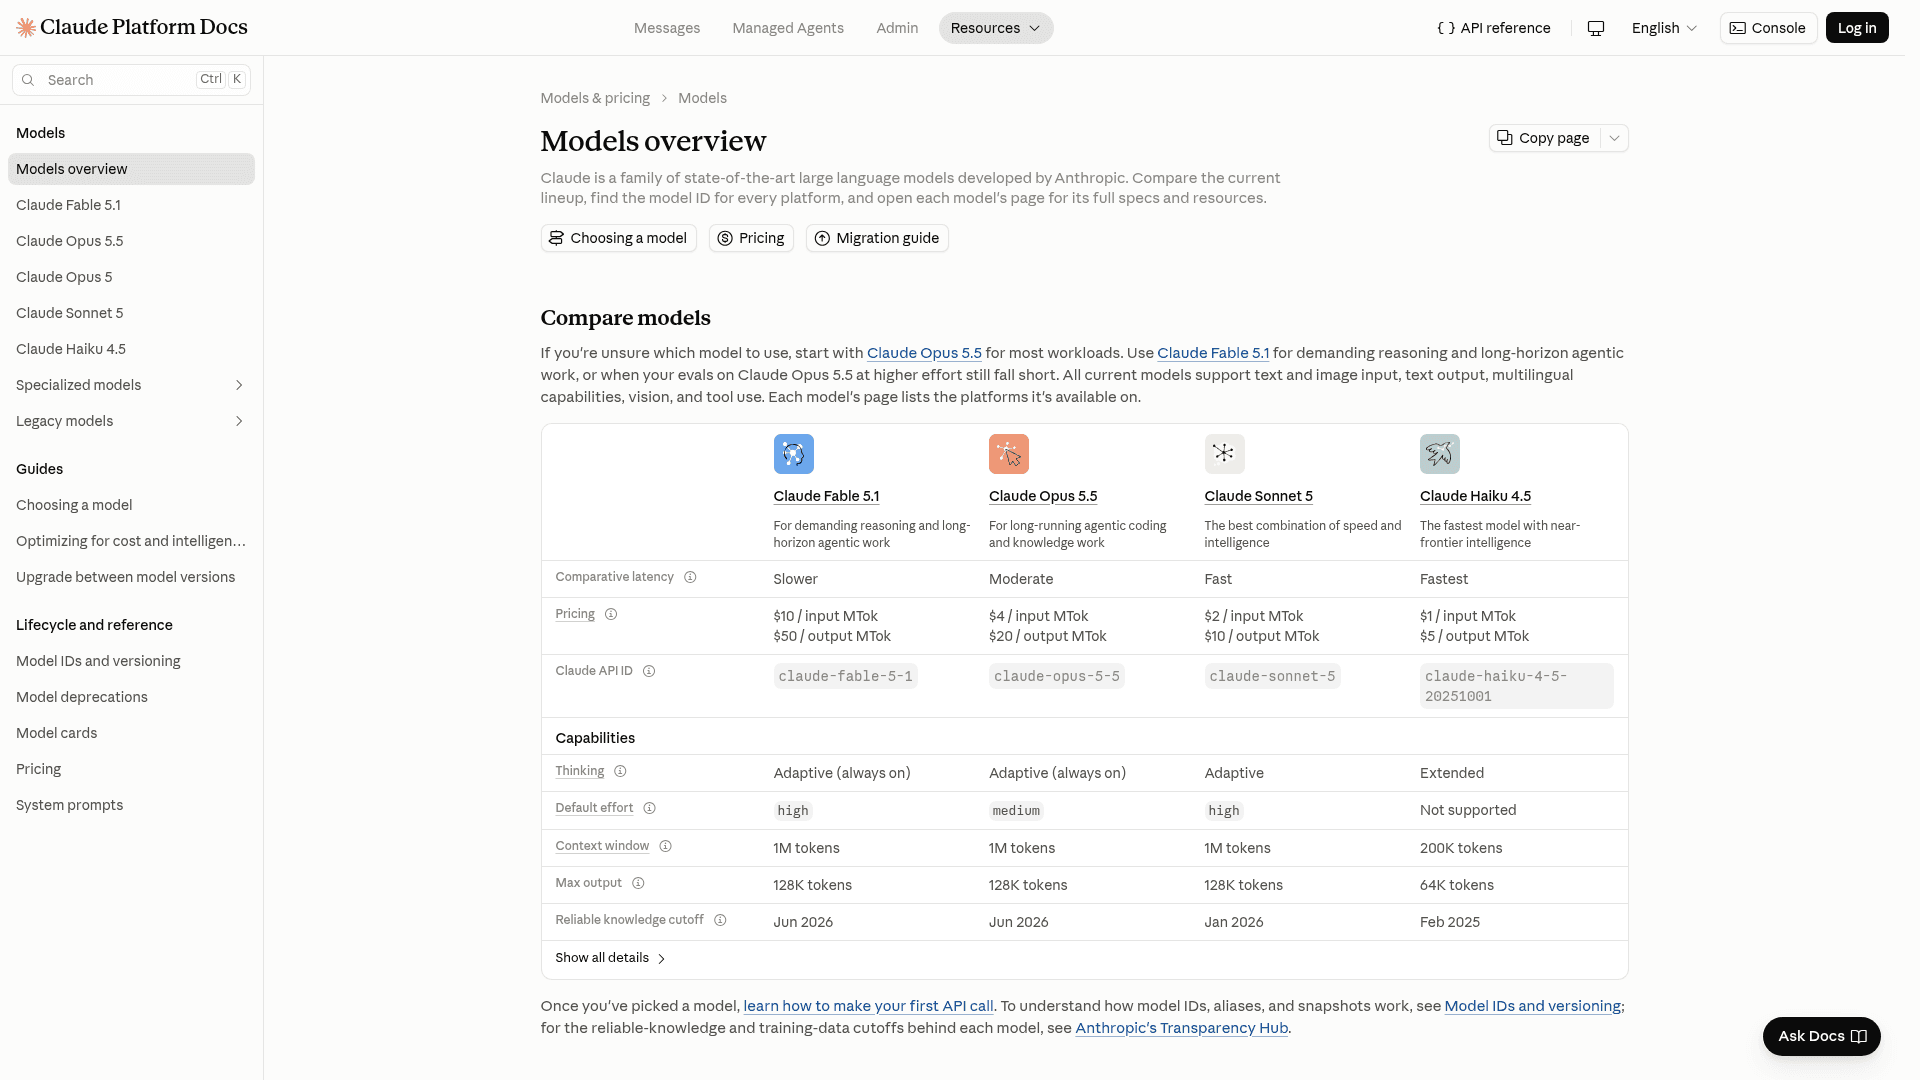
Se o argumento de venda do Grok 4.7 é "perto da fronteira por pouco", o da Claude é "de fato a fronteira". O Fable 5.1 da Anthropic é o modelo a ser batido na maioria dos rankings públicos, e o Opus 5.5 fica logo abaixo como o cavalo de batalha para programação agêntica longa.
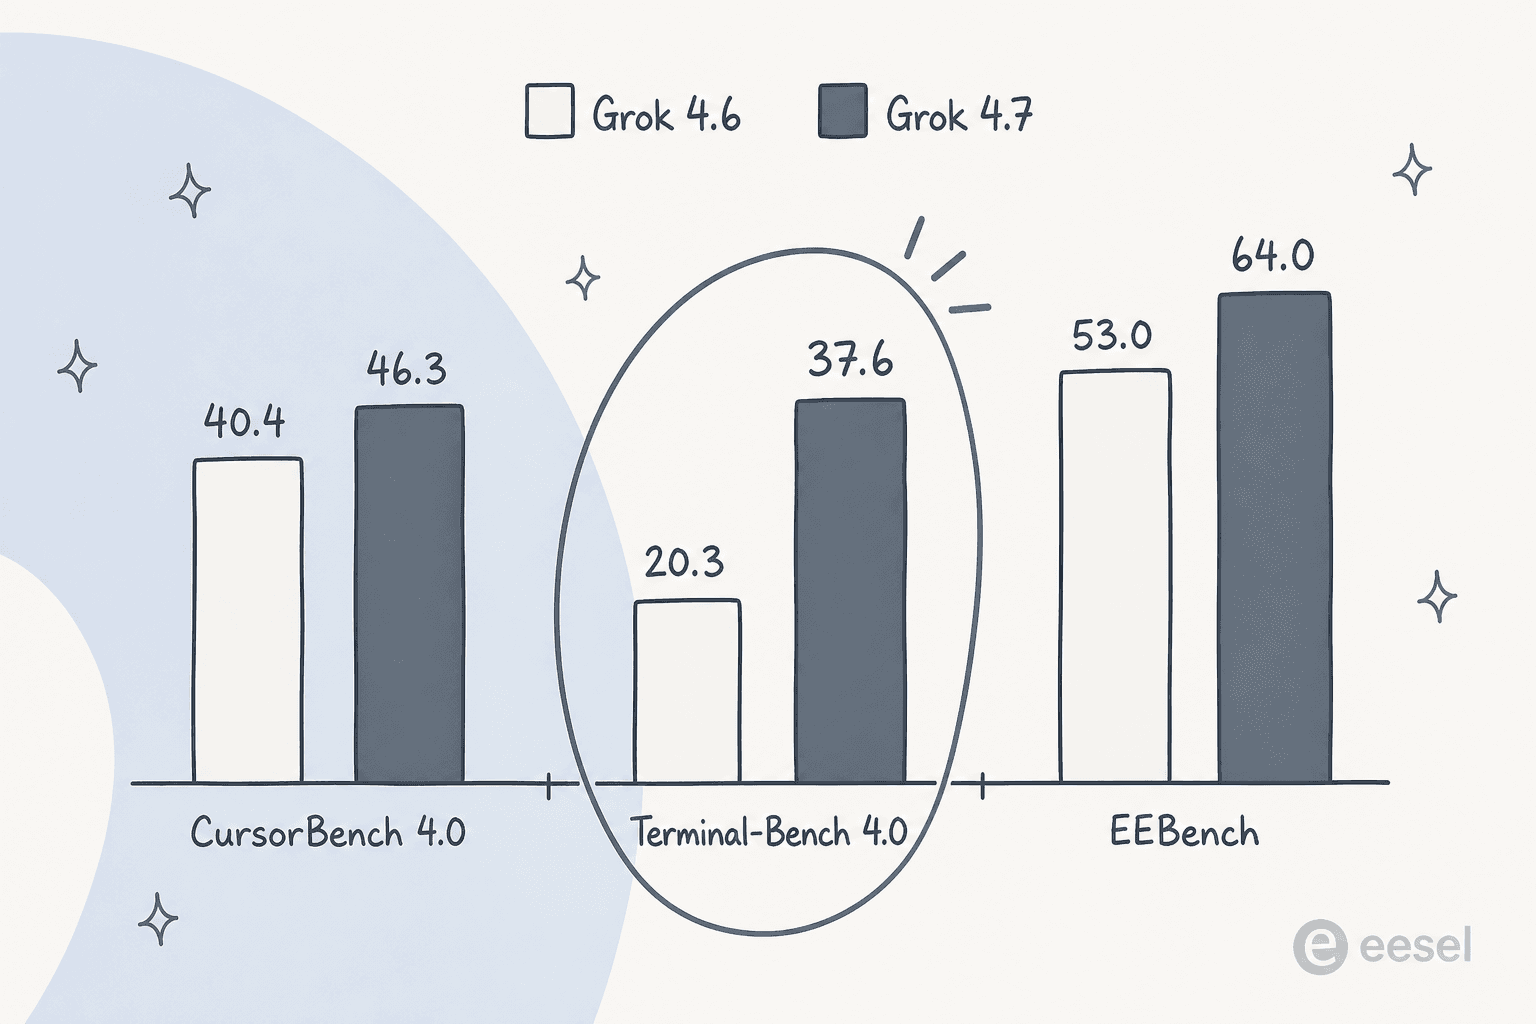
Destaques. O Fable 5.1 supera o Grok 4.7 no CursorBench, no Terminal-Bench e no ranking AA Briefcase, e lidera o índice GDPval de trabalho profissional. Ambos os modelos Claude têm uma janela de contexto de 1M sem salto de preço nos 200k, então trabalho com documentos longos é cobrado a uma única tarifa fixa. As leituras de cache do Fable são incomumente baratas, a 0,25 $ por milhão, o que torna chamadas agênticas repetidas muito menos dolorosas do que o preço de tabela sugere.
Prós. A maior inteligência medida neste panorama. Preço fixo em toda a janela de contexto. Uso de ferramentas robusto e bem documentado, e um SDK maduro.
Contras. É caro. O Fable 5.1 custa cerca de cinco vezes a tarifa do Grok 4.7, e até o Opus 5.5 custa o dobro. Relatos da comunidade também apontam que as salvaguardas do Fable podem disparar erroneamente no seu próprio código de segurança, e agora ele carrega uma marca d'água estatística de texto na saída.
Preços. O Fable 5.1 custa 10 $ / 50 $; o Opus 5.5 custa 4 $ / 20 $; o Sonnet 5, o irmão mais barato, custa 2 $ / 10 $. Os três têm contexto de 1M e tarifa fixa.
Meu veredito. Escolha a Claude quando os últimos pontos de capacidade valerem a pena pagar, ou quando você já estava batendo num teto com o Grok em esforço alto. O artigo do Claude Opus 5 cobre as contrapartidas do controle de esforço.
2. GPT-6 Sol
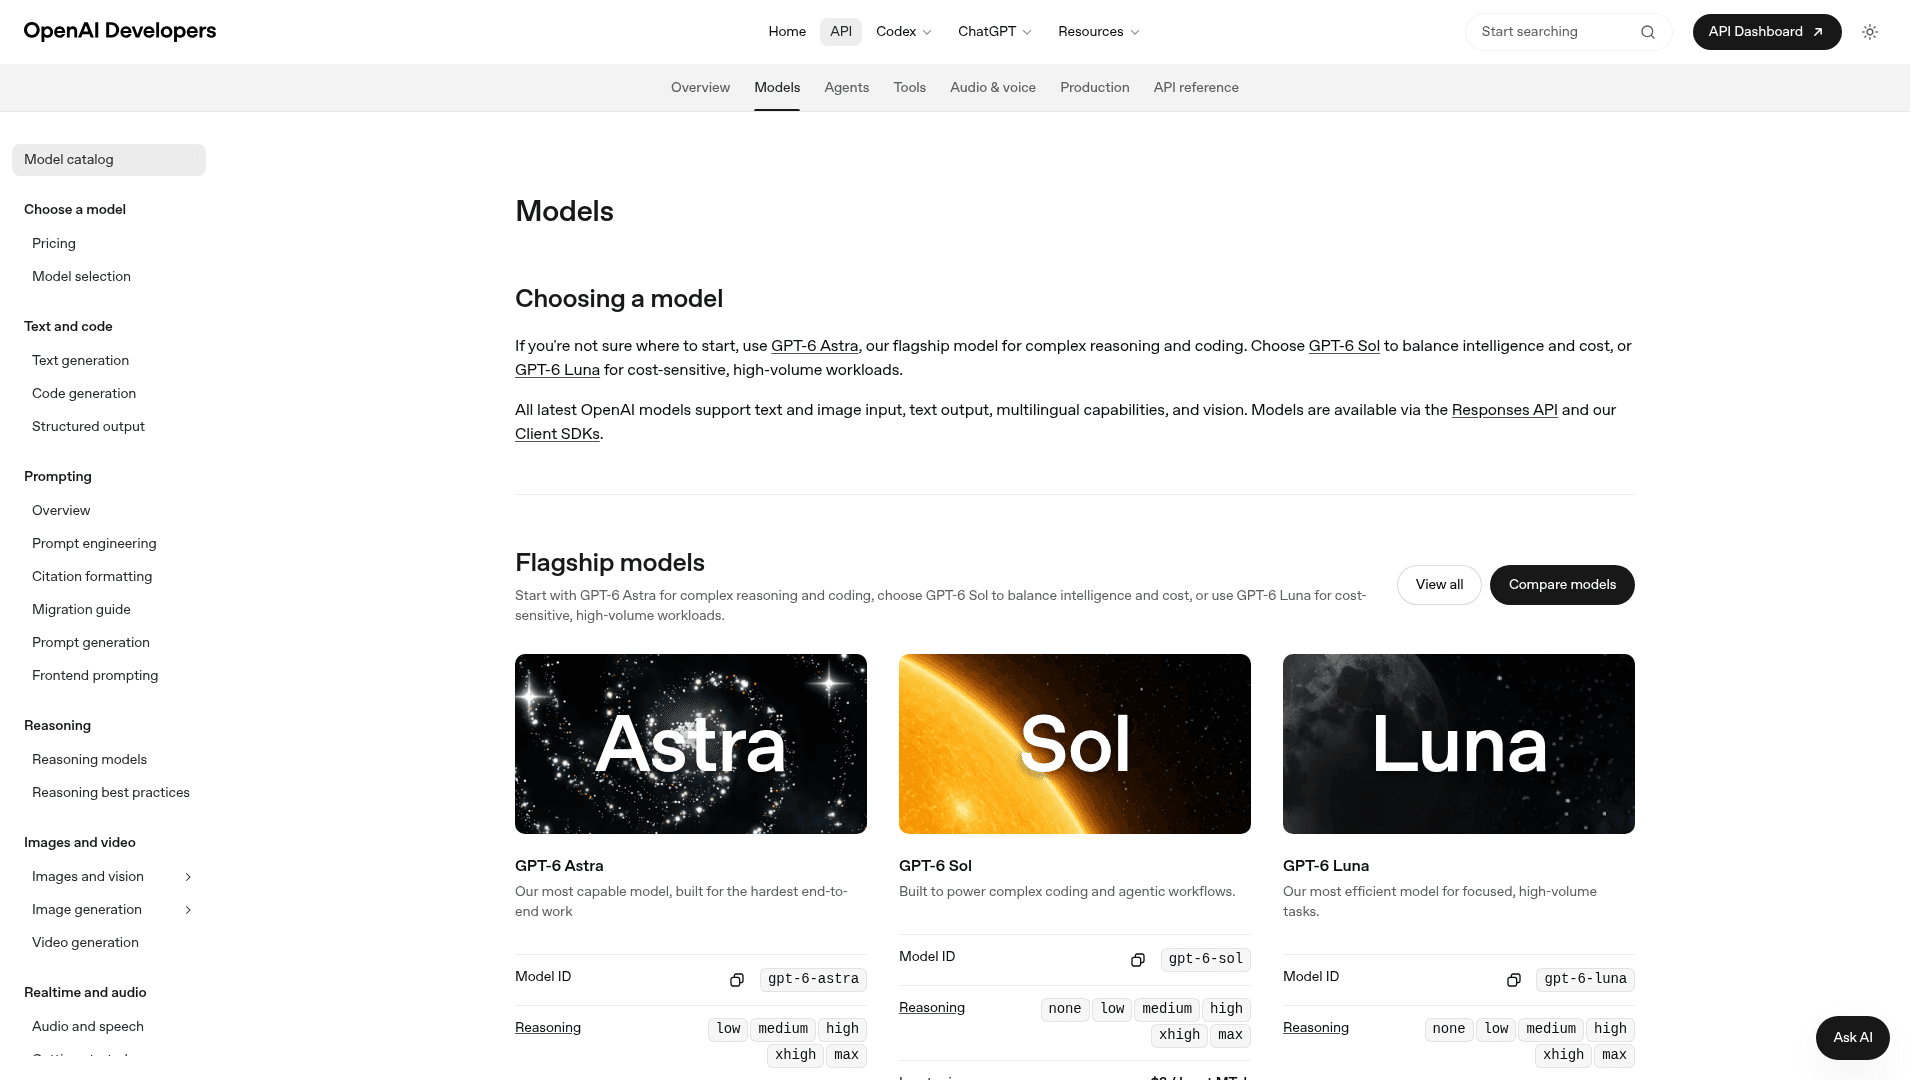
O GPT-6 Sol da OpenAI é o modelo que a xAI persegue com mais afinco, e é o substituto mais direto: um modelo fechado de preço médio construído, nas palavras da própria OpenAI, "para viabilizar fluxos de trabalho complexos de programação e agentes". Foi lançado em 22 de setembro de 2026, no mesmo dia que o Claude Opus 5.5.
Destaques. O ecossistema. O Sol se integra a mais ferramentas, SDKs e produtos derivados do que qualquer outro modelo aqui, o que costuma ser o verdadeiro motivo pelo qual as equipes o escolhem. Ele é consideravelmente mais barato por tarefa do que as Claudes mais inteligentes porque gasta menos tokens de saída para concluir um trabalho, mesmo com sua tarifa de saída por token sendo maior que a do Grok.
Prós. Enorme superfície de ferramentas e integrações. Fica num meio-termo sensato entre preço e inteligência. Raciocínio configurável de nenhum até máximo.
Contras. Ele carrega o mesmo salto de preço dos 200k que o Grok, dobrando em requisições longas. No índice de inteligência da Artificial Analysis, sua pontuação em esforço máximo fica atrás das melhores Claudes. E ele é um quinto mais caro em saída do que o Grok 4.7 na tarifa de contexto curto.
Preços. 2 $ / 10 $ para o nível principal Sol, com a duplicação em contexto longo acima do salto. Seus irmãos mais baratos são Terra e Luna; a geração anterior GPT-5.6 também ainda está disponível.
Meu veredito. A escolha padrão segura se sua stack já fala OpenAI. Se você é sensível a custo e está começando do zero, o Grok 4.7 ou o Qwen o superam no preço de saída.
3. Gemini 3.8 Flash
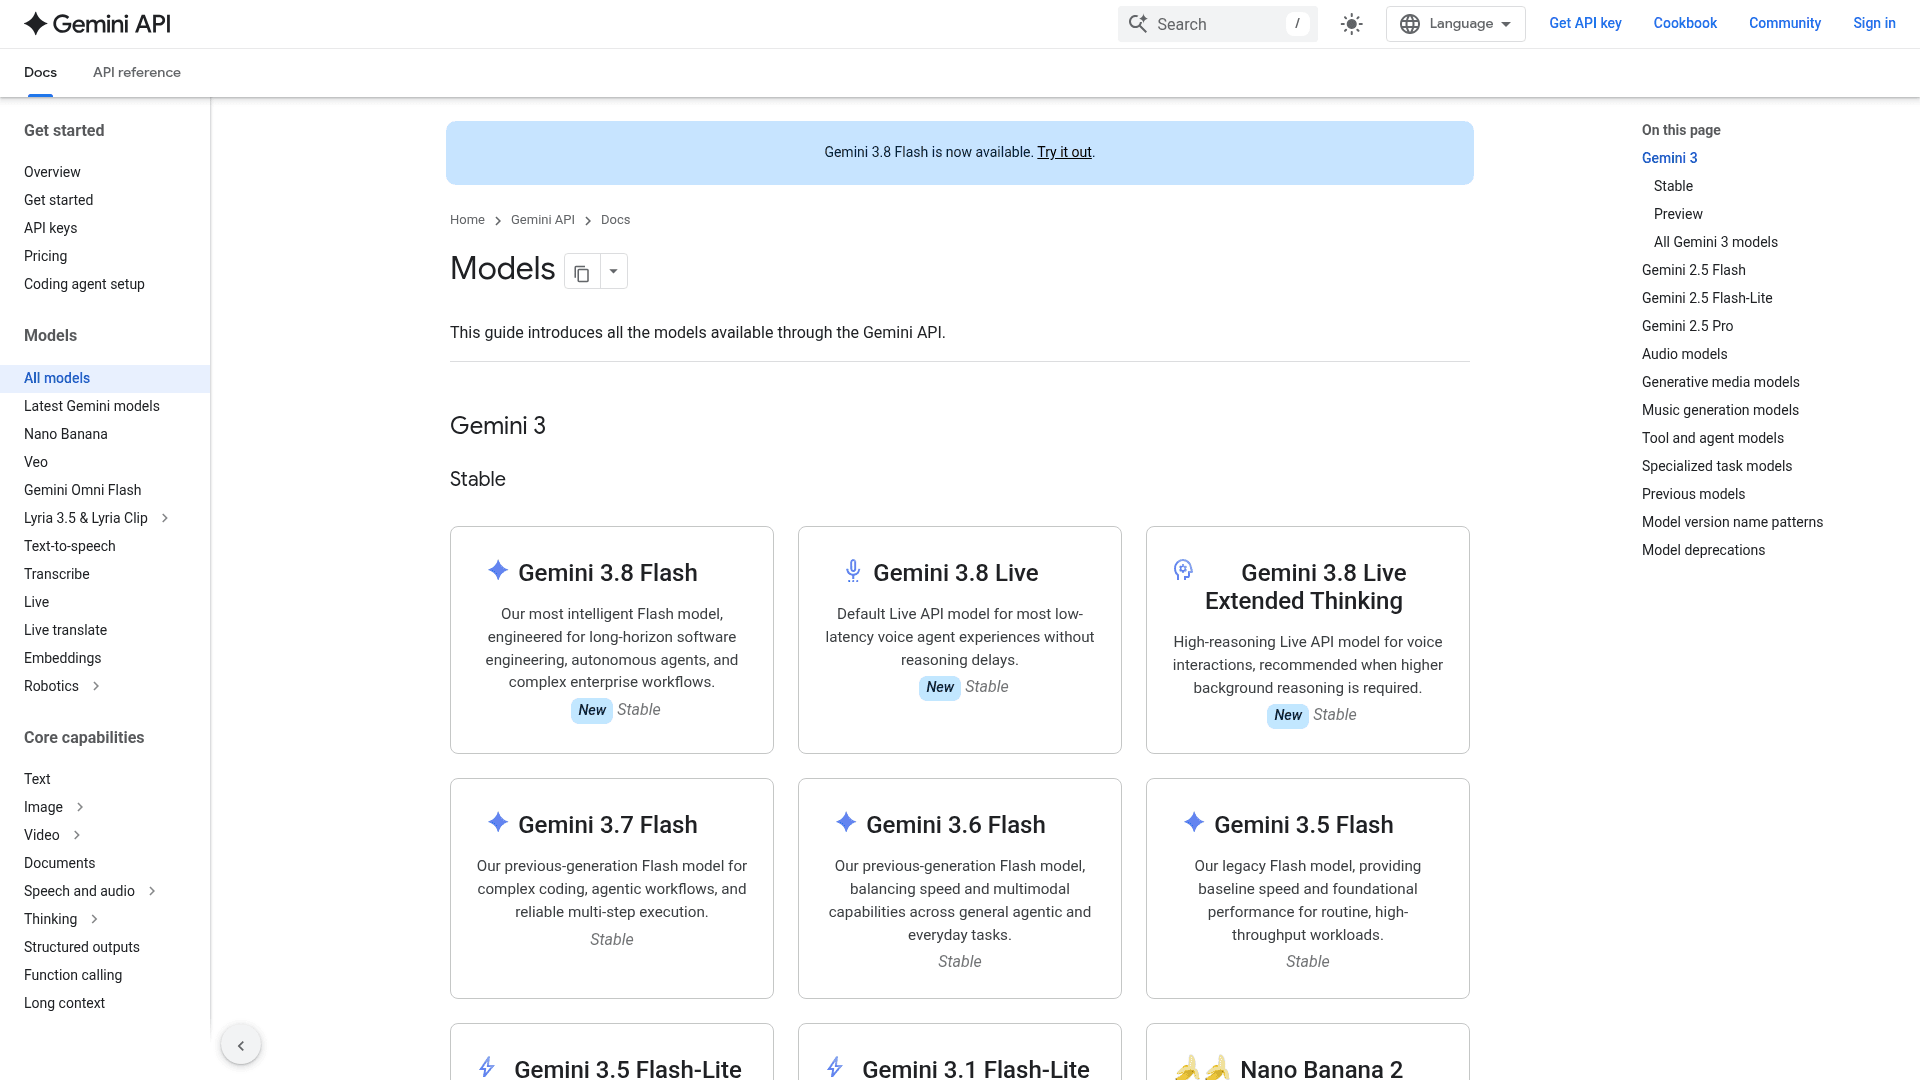
O Gemini 3.8 Flash do Google é o canto multimodal e barato deste campo. É o único modelo aqui que recebe áudio e vídeo nativamente como entrada, e seu preço de tabela fica abaixo de tudo, exceto o DeepSeek.
Destaques. Entrada nativa de texto, imagem, áudio, vídeo e PDF, tudo por uma única API. Uma janela de contexto de 1M de tokens sem salto de preço. E a 0,75 $ / 3,75 $, é uma fração do custo do Grok, com um nível gratuito para começar.
Prós. Melhor cobertura multimodal do panorama. Muito barato para a inteligência que entrega; pontua bem no índice da Artificial Analysis. Se conecta diretamente ao grounding do Google Search.
Contras. A responsividade é o problema. A Artificial Analysis mede um tempo até o primeiro token de 13,3 segundos contra uma mediana de categoria próxima de 3 segundos, o que o desqualifica para qualquer coisa que um humano espere ao vivo, embora sirva bem para trabalho em lote durante a noite. Também é verboso, então a tarifa barata por token pode inflar por tarefa. E o preço promocional dobra para 1,50 $ / 7,50 $ em 1º de janeiro de 2027. O próprio Google sugere permanecer no 3.7 Flash para cargas de trabalho focadas em eficiência.
Preços. 0,75 $ / 3,75 $ até 31 de dezembro de 2026, depois 1,50 $ / 7,50 $. Batch e Flex custam metade do preço.
Meu veredito. A escolha quando suas entradas são multimodais ou suas tarefas são em lote e sensíveis a preço. Evite-o para qualquer coisa dependente de latência, como um widget de chat.
4. DeepSeek V4.1 Flash
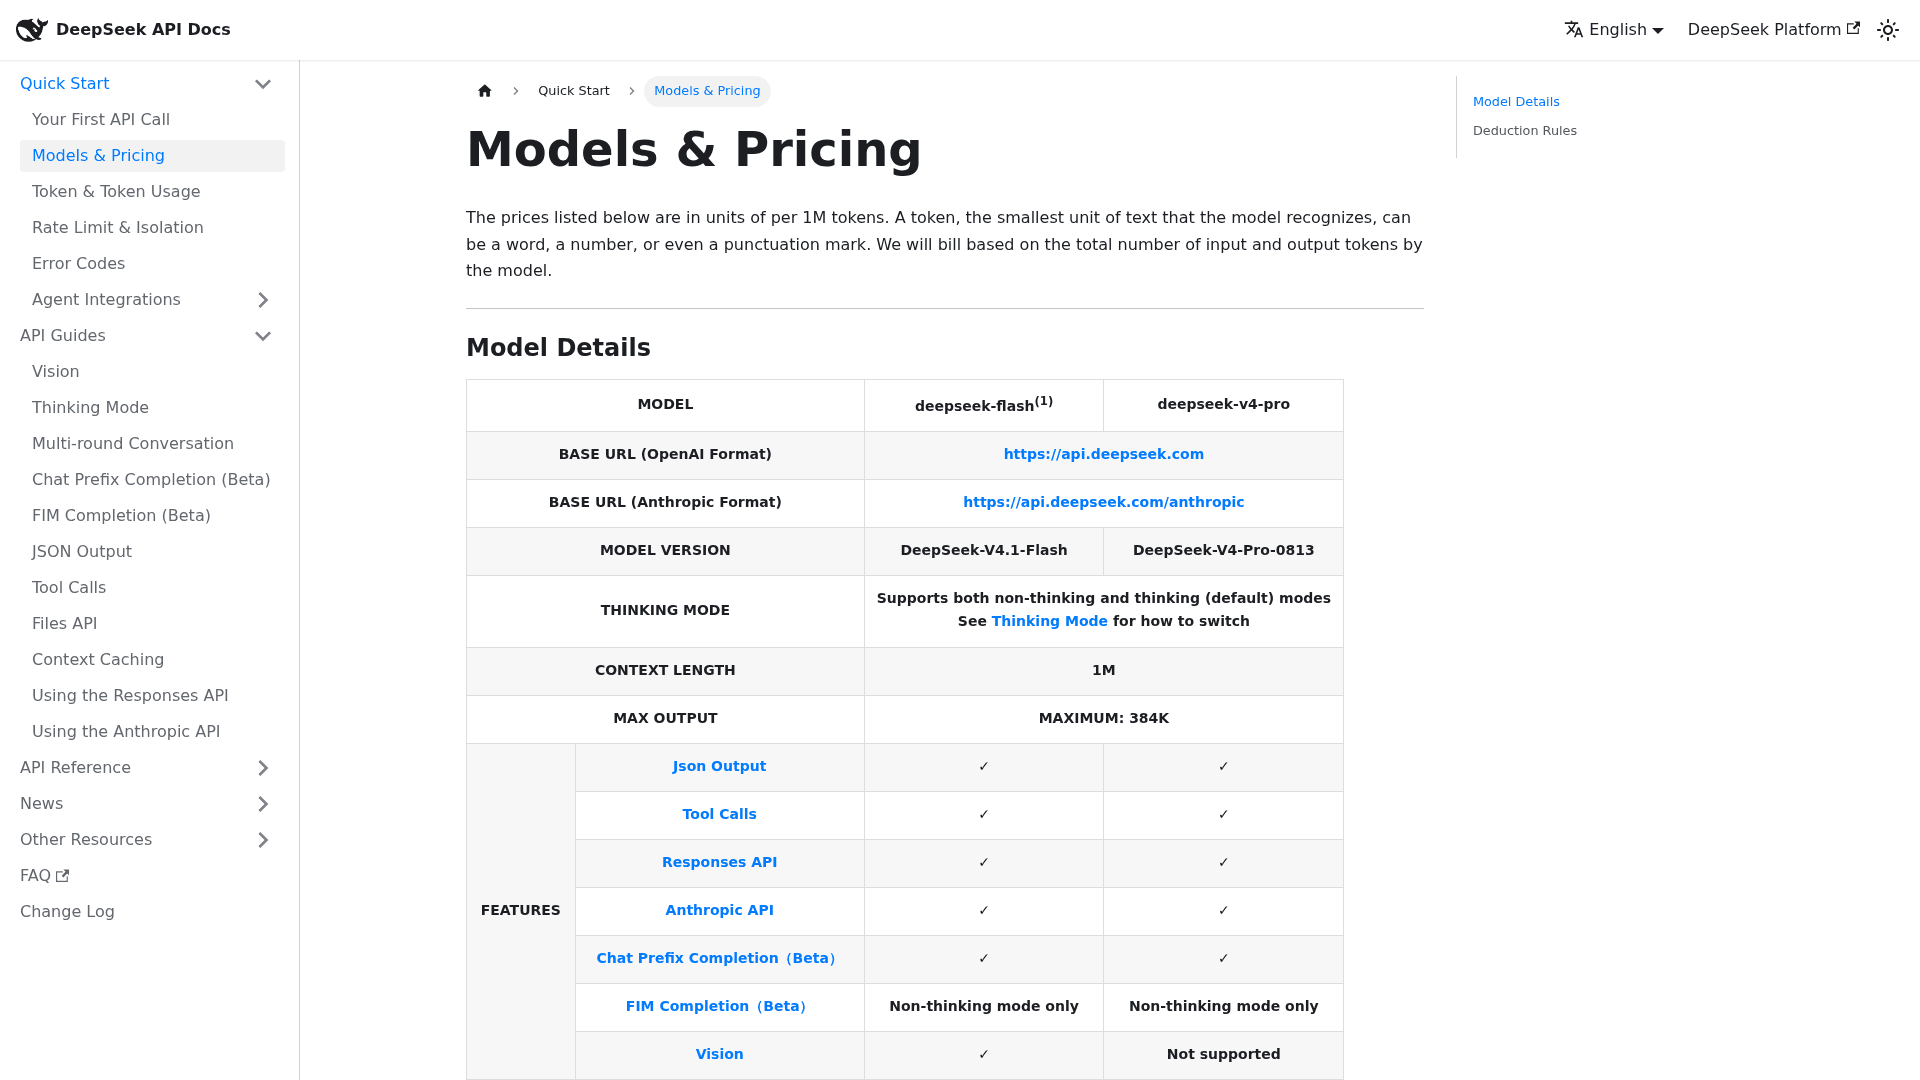
O DeepSeek V4.1 Flash é a resposta econômica e aberta ao Grok. É distribuído sob licença MIT, então você pode baixar os pesos e rodá-los você mesmo, e a tarifa hospedada é a mais barata entre qualquer modelo confiável aqui.
Destaques. O preço. Fora do pico, roda em torno de 0,22 $ de entrada e 0,66 $ de saída por milhão, uma fração do Grok 4.7. Pesos abertos MIT significam nenhuma cobrança por token se você se autoalojar, e ele mantém uma janela de contexto de 1M com saída máxima de 384k.
Prós. A opção confiável mais barata, hospedada ou autoalojada. Licença genuinamente aberta, algo incomum nesse nível de capacidade. Endpoints de API tanto no formato Anthropic quanto no formato OpenAI.
Contras. A configuração barata e a configuração boa são execuções diferentes dos mesmos pesos; avaliações independentes o colocam em torno de 50 em esforço máximo contra 29 sem raciocínio, e os tokens de raciocínio são cobrados na tarifa de saída. É apenas texto, sem entrada de imagem documentada. A tarifa fora de pico aproximadamente dobra durante o horário comercial chinês. E os termos da API hospedada são silenciosos quanto ao uso para treinamento, e os dados ficam na RPC, então não é um substituto direto para dados regulados de clientes.
Preços. Cerca de 0,22 $ / 0,66 $ fora de pico, dobrando no horário de pico (01h00 às 04h00 e 06h00 às 10h00 UTC). O Pro é um nível acima.
Meu veredito. O vencedor claro em custo puro, especialmente autoalojado. Leia as letras miúdas sobre residência de dados antes de enviar qualquer coisa sensível.
5. Kimi K3
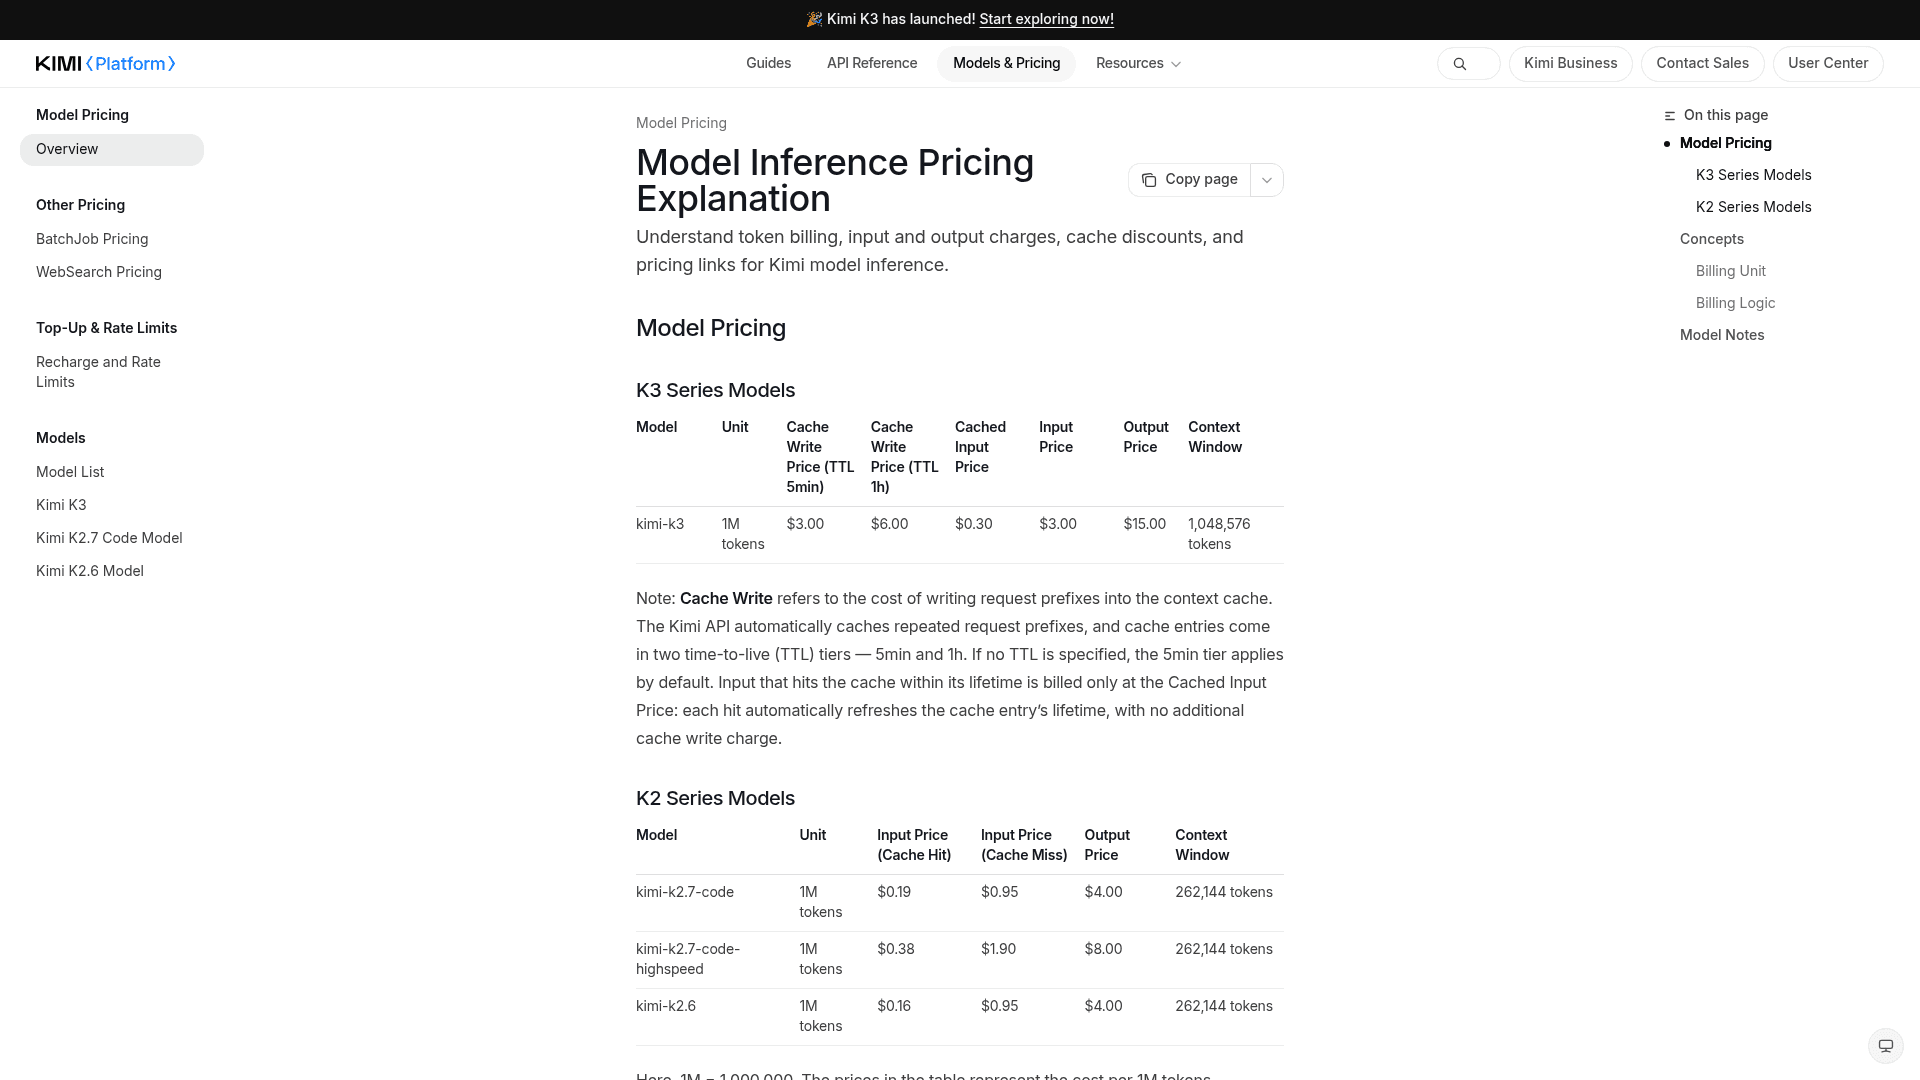
O Kimi K3 da Moonshot é o modelo de pesos abertos com a maior pontuação em benchmarks independentes. É um modelo de mistura de especialistas com 2,8 trilhões de parâmetros e 104 bilhões ativos, e a Moonshot publicou os pesos no Hugging Face conforme planejado.
Destaques. Ele fica em torno de 57 no índice de inteligência da Artificial Analysis, à frente da maioria dos modelos abertos e atrás apenas da fronteira fechada. Visão nativa, contexto de 1M de tokens e um lançamento de pesos genuinamente aberto o tornam o modelo mais capaz aqui que você realmente pode hospedar.
Prós. A inteligência de pesos abertos mais forte deste panorama. Contexto real de 1M com esforço de raciocínio configurável. Os pesos são públicos, com quantizações da comunidade já disponíveis.
Contras. A API hospedada não é barata: 3 $ / 15 $ o coloca na faixa do Claude Sonnet, não no nível econômico. O raciocínio não pode ser desligado, apenas acelerado, então não há um modo ultraeconômico. E URLs de imagem públicas não são aceitas; você precisa enviar base64 ou um ID de arquivo.
Preços. 3 $ de entrada, 15 $ de saída, 0,30 $ em cache, com um contexto de 1.048.576 tokens.
Meu veredito. A escolha quando você quer qualidade quase de fronteira e pesos abertos juntos, e pode absorver a tarifa hospedada mais alta ou rodá-lo você mesmo.
6. Qwen 3.8 Max
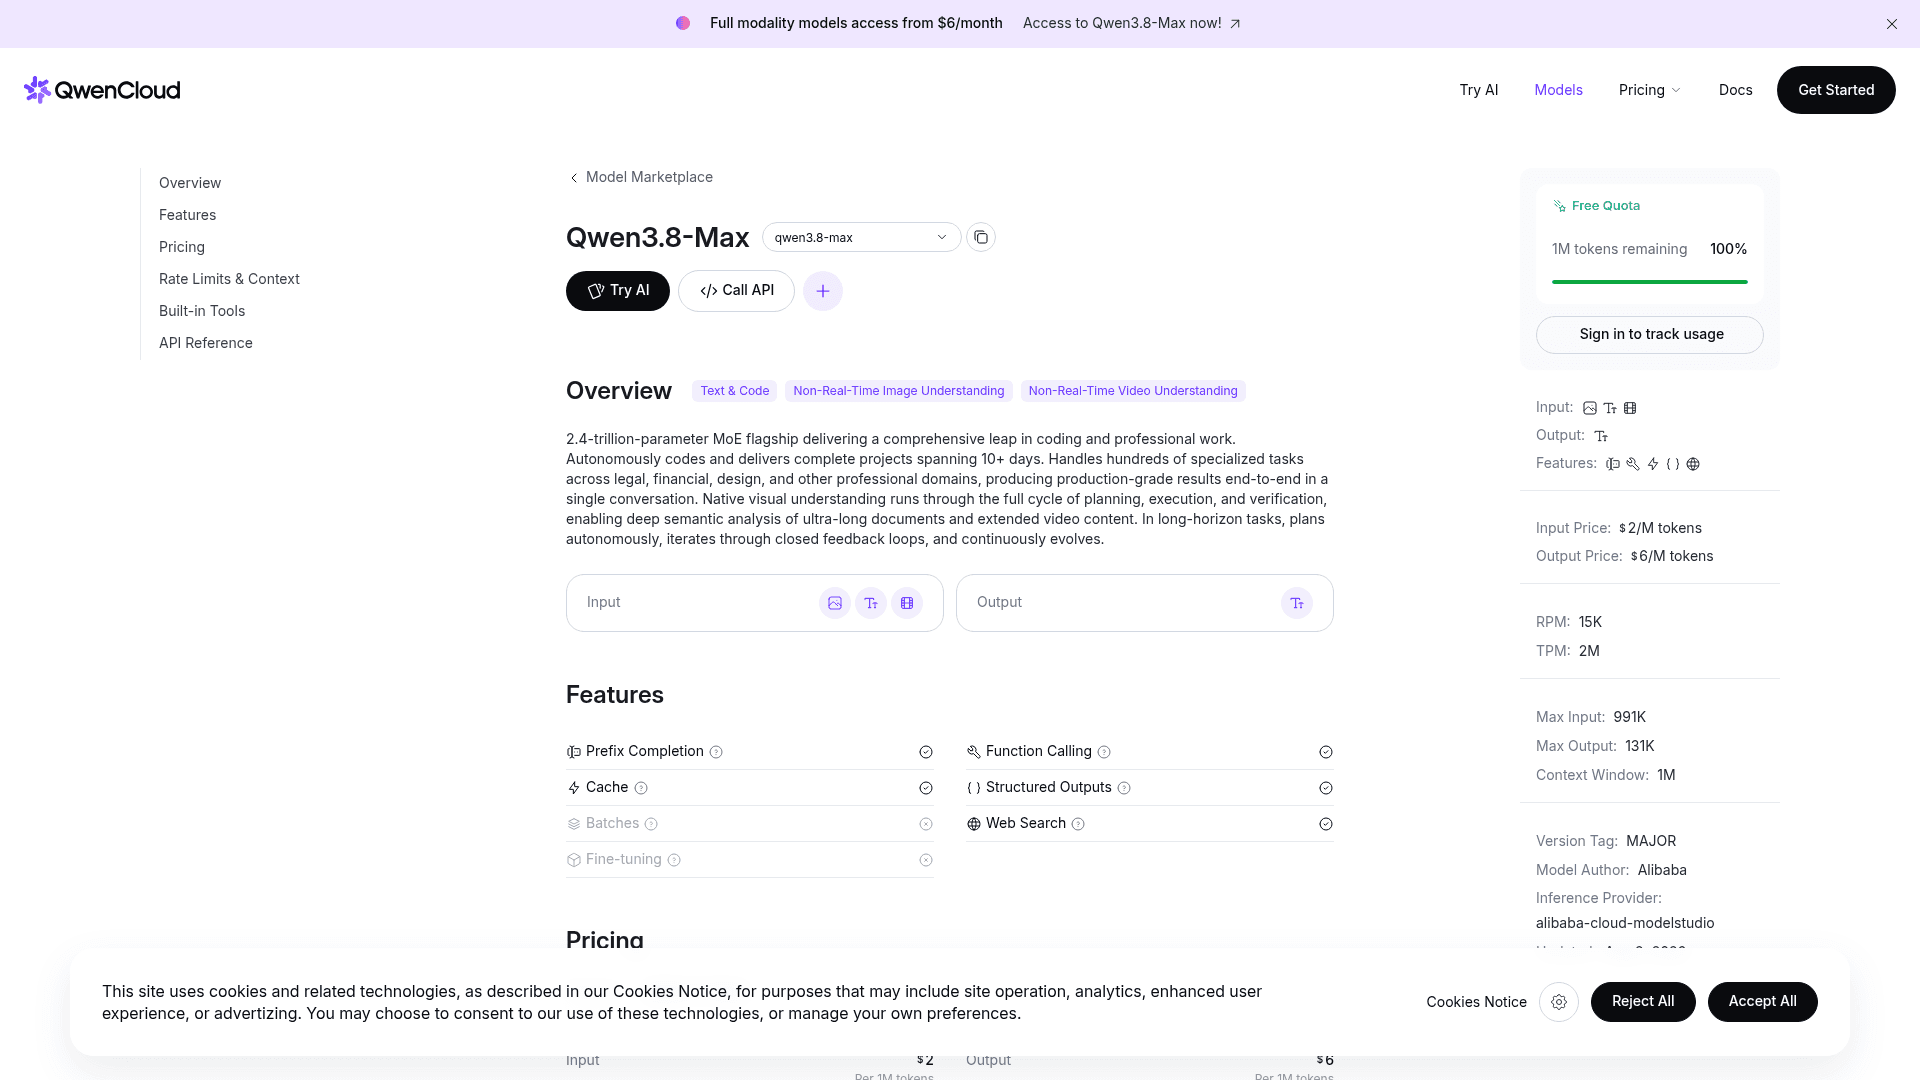
O Qwen 3.8 Max da Alibaba é a correspondência de preço mais direta: ele cobra exatamente os mesmos 2 $ / 6 $ do Grok 4.7, com uma janela de contexto fixa maior e com um modelo base aberto por baixo.
Destaques. Mesma tarifa do Grok, sem salto nos 200k, e um forte ranking independente (em torno da posição 6, índice ~58 na Artificial Analysis). É um MoE de 2,4 trilhões de parâmetros com compreensão nativa de imagem e vídeo e ferramentas embutidas, e a Alibaba também publicou um modelo base aberto.
Prós. Iguala o preço do Grok com cobrança fixa numa janela de contexto de 1M. Entrada multimodal nativa. Uma base aberta para equipes que queiram autoalojar parte da stack.
Contras. A base aberta não é equivalente em recursos ao Max hospedado: visão, modo sem raciocínio e ferramentas embutidas são exclusivos da versão hospedada. Seu próprio harness de programação limita a saída bem abaixo do teto de 131k, então o limite de saída anunciado é teórico para a maioria dos usuários. E a licença do grande checkpoint aberto é uma licença Qwen personalizada, não Apache.
Preços. 2 $ / 6 $ por milhão, leitura de cache implícita em torno de 0,25 $, com contexto de 1M e saída máxima de 131k.
Meu veredito. Se você gosta do preço do Grok mas quer cobrança fixa em contexto longo e uma opção multimodal, o Qwen é o substituto mais próximo desta lista.
7. eesel: quando você quer um colega de equipe, não um modelo

Aqui vai a parte honesta. Todo modelo acima é um motor. Nenhum deles, sozinho, resolve um ticket de suporte, redige uma resposta de central de ajuda ou escreve um post de blog que vai ao ar. Você não compra um modelo para fazer um trabalho; você compra um modelo para construir algo que faça um trabalho, e essa segunda etapa é onde a maior parte do custo e do risco realmente está.
Um dos nossos clientes, Karel, da GENERAL BYTES, colocou a decisão de construir versus comprar de forma direta:
"Poderíamos ter tentado escrever nossa própria aplicação de LLM, mas não queríamos investir nosso tempo nisso. Queríamos algo que não precisássemos manter."
Karel, GENERAL BYTES
Essa é a lacuna que a eesel preenche. A eesel é uma plataforma de colegas de equipe de IA: em vez de alugar tokens e montar o resto, você contrata um colega de equipe pronto para trabalhar em uma função definida. O time atual conta com um colega de equipe de helpdesk de IA e um redator de blog de IA. Cada um chega já conectado às integrações, habilidades e contexto da empresa que sua função exige, rodando por baixo dos panos em modelos de fronteira como os deste panorama.
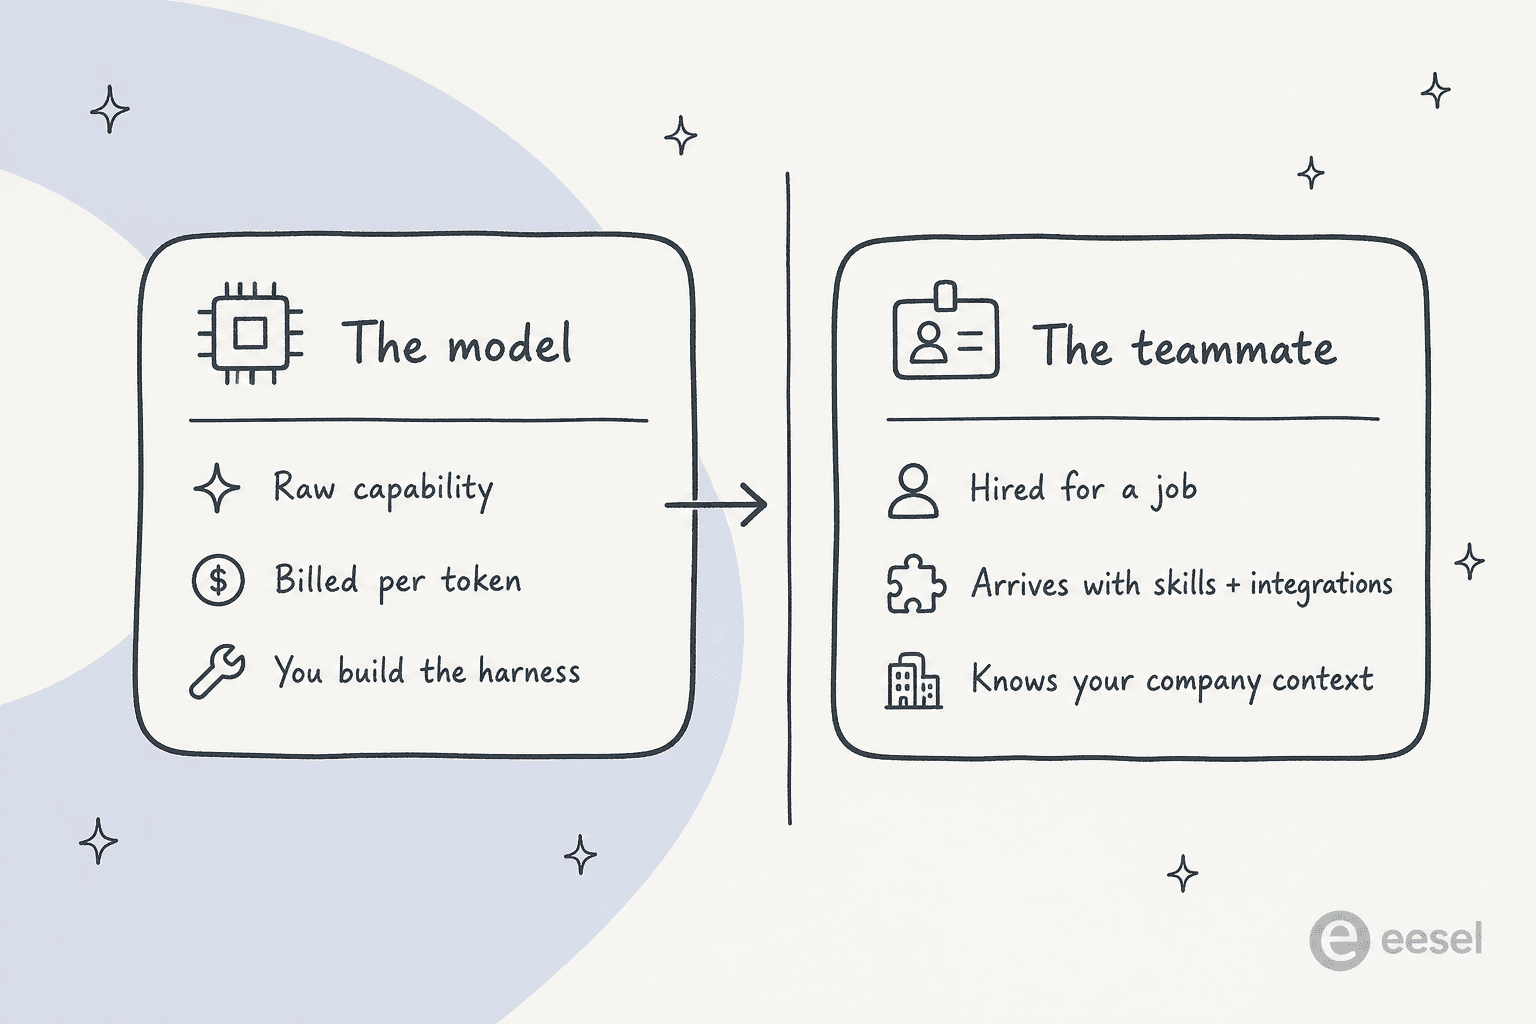
Para engenheiros que gostam de linha de comando, esse colega de equipe é programável via script. A CLI da eesel permite operar o mesmo colega de equipe e workspace a partir de um terminal, conectá-lo a scripts, ou controlá-lo a partir de um agente de programação como Claude Code, Codex ou Cursor. Então o instinto de "eu quero acesso programático a um modelo" que leva as pessoas à API da xAI é atendido um nível acima: você ganha acesso programático a um colega de equipe que já tem seu contexto, não um endpoint de conclusão nu sobre o qual você ainda precisa construir um produto.
A parte que mais me importa, depois de anos construindo essa infraestrutura, é que você pode simular uma implantação contra seus próprios tickets históricos antes que ela toque em um cliente sequer. Uma pontuação de benchmark não pode dizer se um modelo vai dar com confiança uma resposta errada nos seus dados. Uma simulação sobre seus tickets reais do passado pode. Essa é a diferença entre escolher um modelo e implantar um.
Qual alternativa ao Grok 4.7 você deveria escolher?
Escolha a prioridade que mais importa e leia a recomendação.
Conclusão
O Grok 4.7 é difícil de superar em custo-benefício, então a alternativa vencedora é a que corresponde à sua prioridade real. Claude para inteligência, DeepSeek ou Gemini para custo, Kimi K3 ou Qwen para pesos abertos, GPT-6 Sol para o ecossistema. Se você está escolhendo entre as gerações do Grok 4.5, o artigo do Grok 4.6 cobre as anteriores.
Mas se o que você realmente precisa é de um trabalho concluído, resolver tickets ou entregar conteúdo, nenhum deles é a resposta sozinho. Essa é a diferença entre alugar um motor e contratar um colega de equipe.
Comparar modelos é a parte fácil
Todo modelo neste panorama vende a você inteligência por token. A parte difícil é transformar isso em algo que realize de forma confiável um trabalho real com seus dados. A eesel empacota um modelo de fronteira em um colega de equipe de IA que já conhece seu helpdesk e seus documentos, e permite que você simule com seus próprios tickets passados antes de colocá-lo no ar, para que você não aposte uma interação com o cliente numa pontuação de benchmark.
Experimente a eesel grátis, ou agende uma demo para vê-la rodando com seus próprios dados.

Perguntas frequentes
Qual é a melhor alternativa ao Grok 4.7?
Depende do que você mais valoriza. Para inteligência máxima, o Fable 5.1 da Claude lidera a maioria dos rankings. Para um modelo fechado mais barato com um ecossistema enorme, o GPT-6 Sol é a escolha segura. Para um modelo de pesos abertos que você pode hospedar você mesmo, o DeepSeek V4.1 Flash é o mais barato entre as alternativas confiáveis ao Grok 4.7. O Qwen 3.8 Max iguala exatamente a tarifa de 2 $ / 6 $ do Grok.
Existe uma alternativa mais barata ao Grok 4.7?
Sim. O Grok 4.7 custa 2 $ por milhão de tokens de entrada e 6 $ de saída, mas o DeepSeek V4.1 Flash roda em torno de 0,22 $ / 0,66 $ fora do horário de pico e é de pesos abertos, e o Gemini 3.8 Flash lista 0,75 $ / 3,75 $ até o fim de 2026. Ambos são consideravelmente mais baratos que o Grok 4.7, com as contrapartidas usuais em inteligência e, no caso do DeepSeek, em residência de dados.
Qual é a melhor alternativa de pesos abertos ao Grok 4.7?
O Grok 4.7 é fechado. Se você precisa de pesos abertos que possa hospedar você mesmo, as opções mais fortes são o Kimi K3 (2,8 trilhões de parâmetros, MoE), a base aberta do Qwen 3.8 Max, e o DeepSeek V4.1 Flash sob licença MIT. O DeepSeek é o mais barato de rodar; o Kimi K3 tem a pontuação mais alta dos três em benchmarks independentes.
Grok 4.7 ou Claude, qual é melhor?
Em inteligência pura, a Claude vence. O Fable 5.1 supera o Grok 4.7 no CursorBench, no Terminal-Bench e no ranking AA Briefcase. Mas o Grok 4.7 custa cerca de um quinto do preço do Fable 5.1, então a pergunta real é se vale a pena pagar pelos últimos pontos de capacidade. A análise do Grok 4.7 cobre esse confronto direto em detalhes.
Quanto custa o Grok 4.7 comparado às alternativas?
O Grok 4.7 custa 2 $ / 6 $ por milhão de tokens abaixo de 200k, igualando exatamente o Qwen 3.8 Max. O GPT-6 Sol custa 2 $ / 10 $, o Claude Opus 5.5 custa 4 $ / 20 $, e o Fable 5.1 custa 10 $ / 50 $. A ponta mais barata é formada pelo DeepSeek e pelo Gemini Flash. Os números completos estão no guia de preços do Grok 4.7 e no panorama de preços da xAI.
Alguma alternativa ao Grok 4.7 evita o salto de preço dos 200k?
Sim. O Grok 4.7 dobra sua tarifa assim que uma requisição ultrapassa 200k tokens de prompt, e o GPT-6 Sol faz o mesmo. A Claude e o Gemini cobram uma única tarifa fixa em toda a janela de contexto, então, para trabalho com documentos longos ou bases de código grandes, eles podem acabar mais baratos do que o preço de tabela sugere.
Qual é a melhor alternativa ao Grok 4.7 para atendimento ao cliente?
Nenhum desses modelos é uma ferramenta de suporte por si só; são motores. Se o trabalho é resolver tickets, uma plataforma de IA para atendimento ao cliente como a eesel empacota um modelo de fronteira com seu helpdesk, sua base de conhecimento e um fluxo de automação de suporte, então você está contratando um colega de equipe em vez de alugar tokens.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.