

O Mercury 3 é o modelo mais recente da Inception, lançado em 19 de outubro de 2026. É um modelo de linguagem de difusão: em vez de digitar um token por vez, ele redige a resposta inteira e a refina em algumas passagens. A Inception o cronometra em 1,068 tokens por segundo, com janela de contexto de 1M de tokens, chamada de ferramentas e saídas estruturadas.
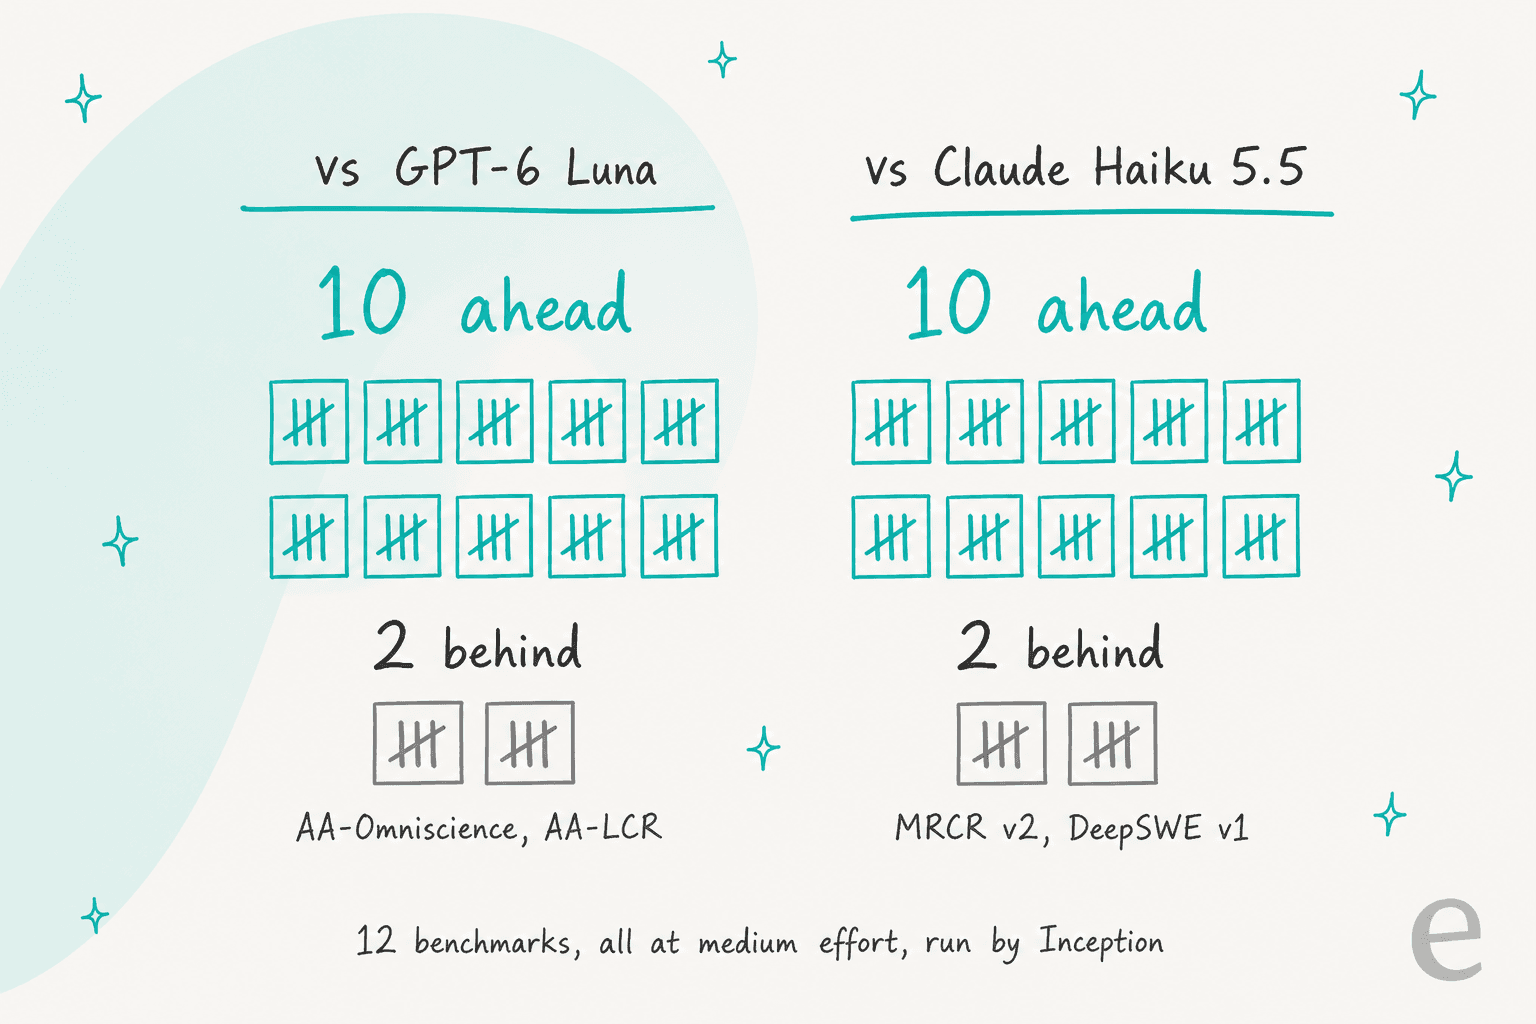
Na tabela de benchmarks da própria Inception, ele supera o GPT-6 Luna e o Claude Haiku 5.5 em 10 de 12 testes, todos com esforço médio. Custa $0.20 de entrada e $0.70 de saída por milhão de tokens, metade disso no lançamento ($0.10 / $0.35), e novas chaves recebem 100 milhões de tokens grátis.
O porém é a velocidade que você realmente verá. O OpenRouter, que envia toda requisição do Mercury 3 para a Inception, mediu uma mediana de 160 a 254 tokens por segundo na semana de lançamento, rápido, mas longe de 1,068, e testadores do Hacker News apontaram um primeiro token lento. Use em loops de agentes e subagentes, onde a espera se acumula. Para equipes de suporte é um motor forte, mas é infraestrutura: a eesel é a funcionária, e seu colega de IA para o helpdesk é o que transforma um modelo como este em tickets respondidos.
Por que olhei este lançamento de perto
Passo boa parte da semana lendo o que as pessoas pesquisam e o que realmente querem dizer com isso. "Mercury 3" é uma busca por velocidade: as pessoas querem saber se o número de 1.000 tokens por segundo sobrevive ao contato com uma API real. Então li o lançamento assim, com as páginas da Inception abertas ao lado dos números ao vivo do OpenRouter e do tópico de lançamento no Hacker News.
Há um segundo motivo. A eesel coloca modelos de IA em filas de suporte reais há anos, e a lição que sempre se repete é que os números de laboratório de um modelo nunca decidem se ele funciona nos seus tickets. Por isso a eesel simula cada implantação com os tickets históricos do cliente antes de a IA responder a qualquer pessoa. Apliquei o mesmo hábito aqui: confira a afirmação com uma medição externa antes de planejar em cima dela.
O que é o Inception Mercury 3?
O Mercury 3 é o modelo principal da Inception, um laboratório que constrói o que chama de LLMs de difusão (dLLMs). O post de lançamento da Inception o chama de "the most capable diffusion-based LLM released to date" e diz que é mais de 40 vezes maior que o Mercury 1, rodando na mesma velocidade. Ele substitui o Mercury 2.5, lançado apenas no mês passado.
Eis o que você recebe, direto da documentação de modelos da Inception:
| Especificação | Mercury 3 |
|---|---|
| Data de lançamento | 19 de outubro de 2026 |
| Tipo | LLM de difusão, pesos fechados |
| Velocidade de saída (número da Inception) | 1,068 tokens por segundo em GPUs NVIDIA |
| Janela de contexto | 1M de tokens (contra 260K no Mercury 2.5) |
| Saída máxima | 131,072 tokens |
| Esforço de raciocínio | instant, low, medium, high |
| Recursos | Chamada de ferramentas, saídas estruturadas |
| Entrada e saída | Somente texto |
| API | Compatível com OpenAI, ID do modelo mercury-3 |
| Preço (tabela) | $0.20 entrada / $0.70 saída por 1M de tokens |
| Preço (lançamento, 50% de desconto) | $0.10 entrada / $0.35 saída por 1M de tokens |
| Franquia gratuita | 100 milhões de tokens em novas chaves de API |
Duas coisas que a tabela não diz. A Inception não divulgou a contagem de parâmetros; seu cofundador escreveu no Hacker News que eles estão "not publicly announcing the model size right now." E não há pesos para baixar. Se isso importa para você, o DiffusionGemma do Google é o modelo de difusão aberto para comparar.
Como um LLM de difusão é diferente?
Quase todos os modelos que você usa hoje, do GPT-6.1 Sol ao DeepSeek V4.1 Flash, são autorregressivos. Eles preveem o próximo token, o anexam e repetem, da esquerda para a direita. É por isso que respostas longas demoram: uma resposta de 2,000 tokens são 2,000 passos em sequência, não importa a rapidez de cada passo.
Um modelo de difusão funciona ao contrário. Ele parte de um rascunho grosseiro e ruidoso da resposta inteira e refina tudo em paralelo ao longo de um pequeno número de passagens. O post de lançamento do Mercury 2 da Inception resumiu bem: "Less typewriter, more editor revising a full draft at once." Se você já viu geradores de imagem tirarem uma figura nítida do ruído, é a mesma ideia aplicada ao texto. Meu explicativo sobre modelos de IA baseados em difusão aprofunda o lado das imagens.
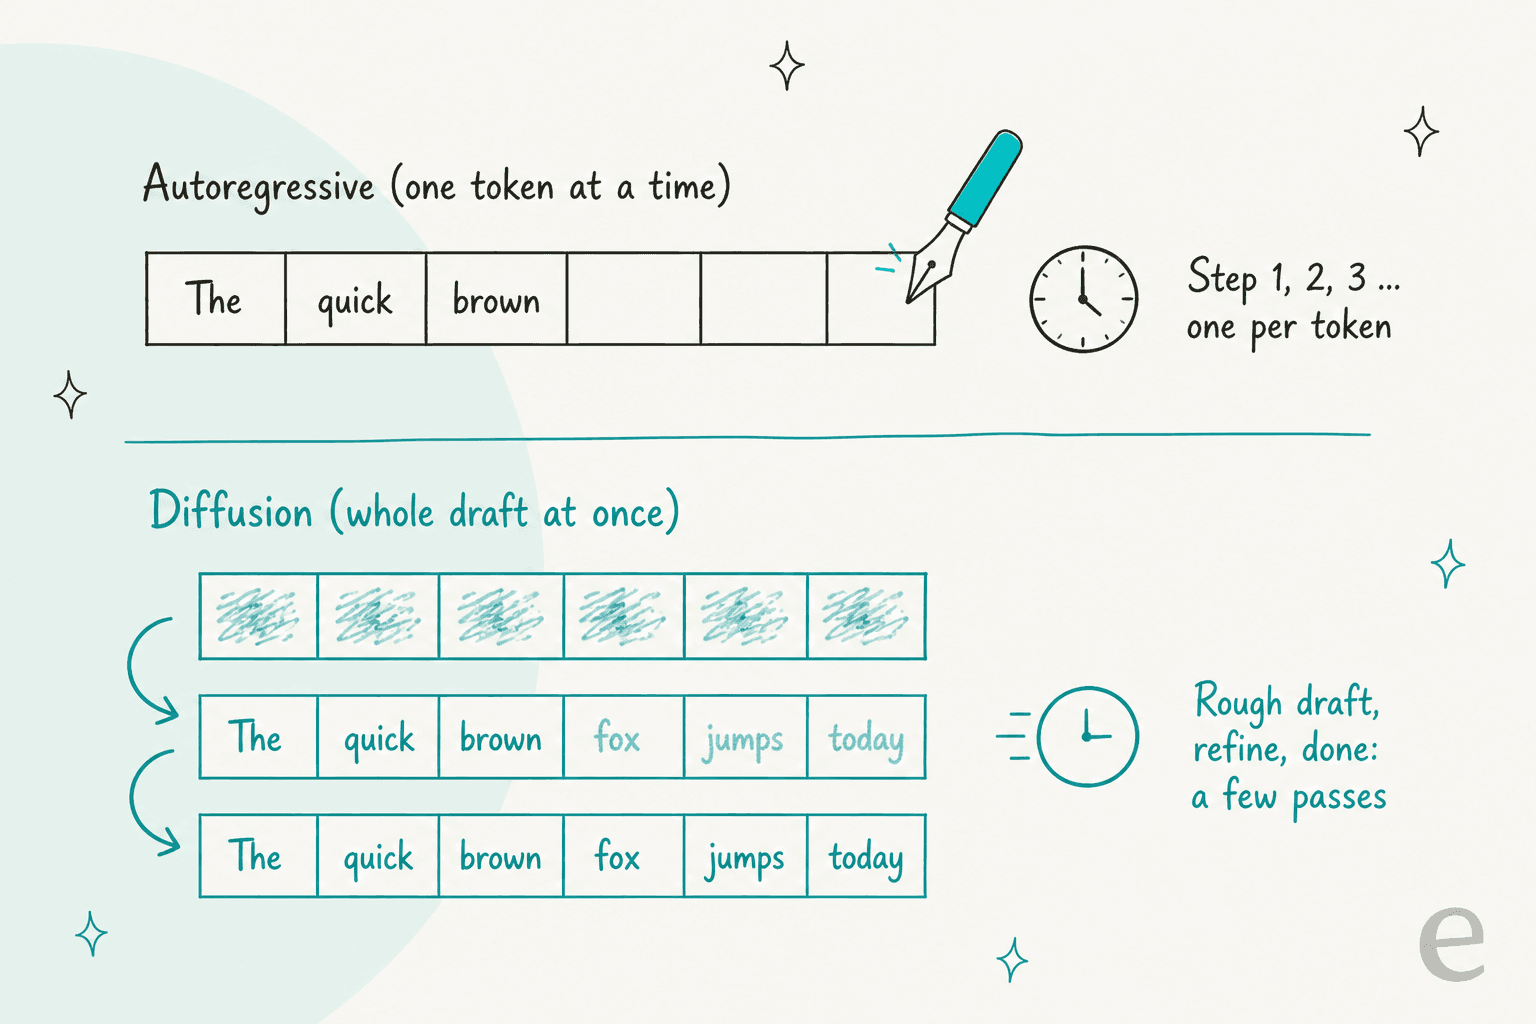
Por que isso importa mais agora: modelos de raciocínio pensam antes de responder, e pensar são tokens de saída. O cofundador e cientista-chefe da Inception, Volodymyr Kuleshov, destacou no tópico de lançamento que, como a difusão escreve tokens em paralelo, a diferença de velocidade cresce quanto mais os modelos pensam.
"Diffusion generates tokens in parallel through iterative denoising rather than one at a time, so as reasoning models think longer per answer, the speed advantage over autoregressive models of the same size grows."

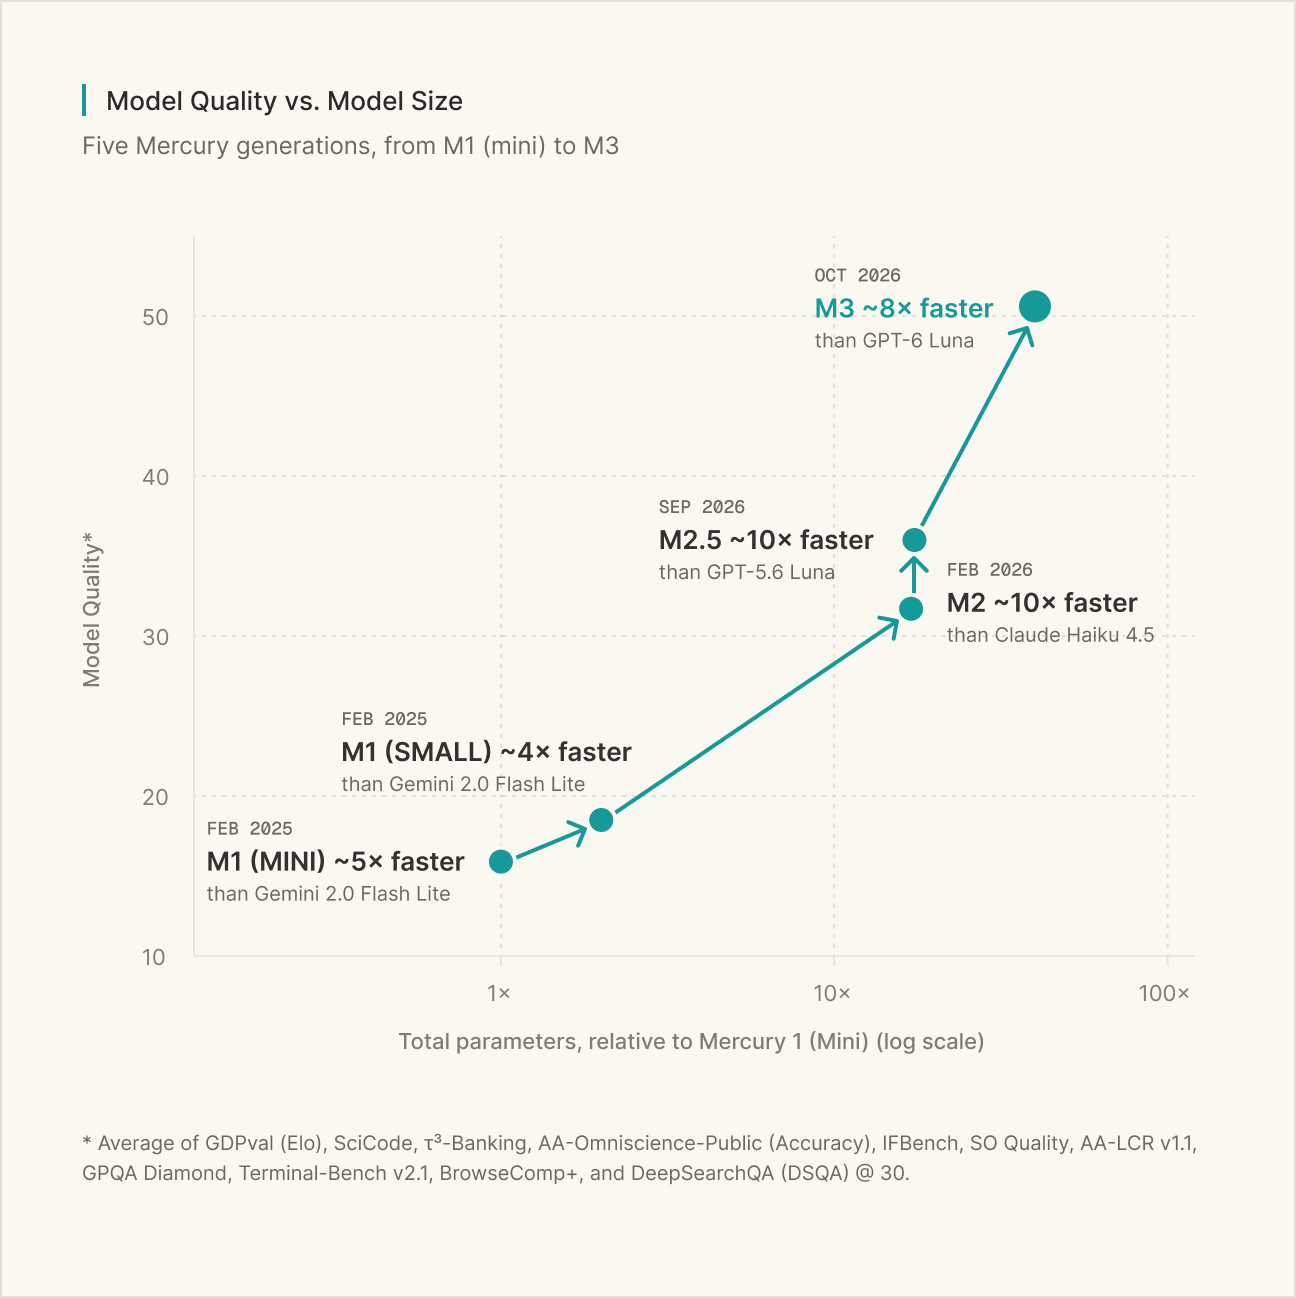
A pergunta em aberto por anos era se LLMs de difusão poderiam ficar inteligentes, não só rápidos. A resposta da Inception é um gráfico de escala: cinco gerações do Mercury, do início de 2025 até agora, com a qualidade subindo conforme o modelo cresce.
Benchmarks do Mercury 3: o que a tabela da Inception mostra
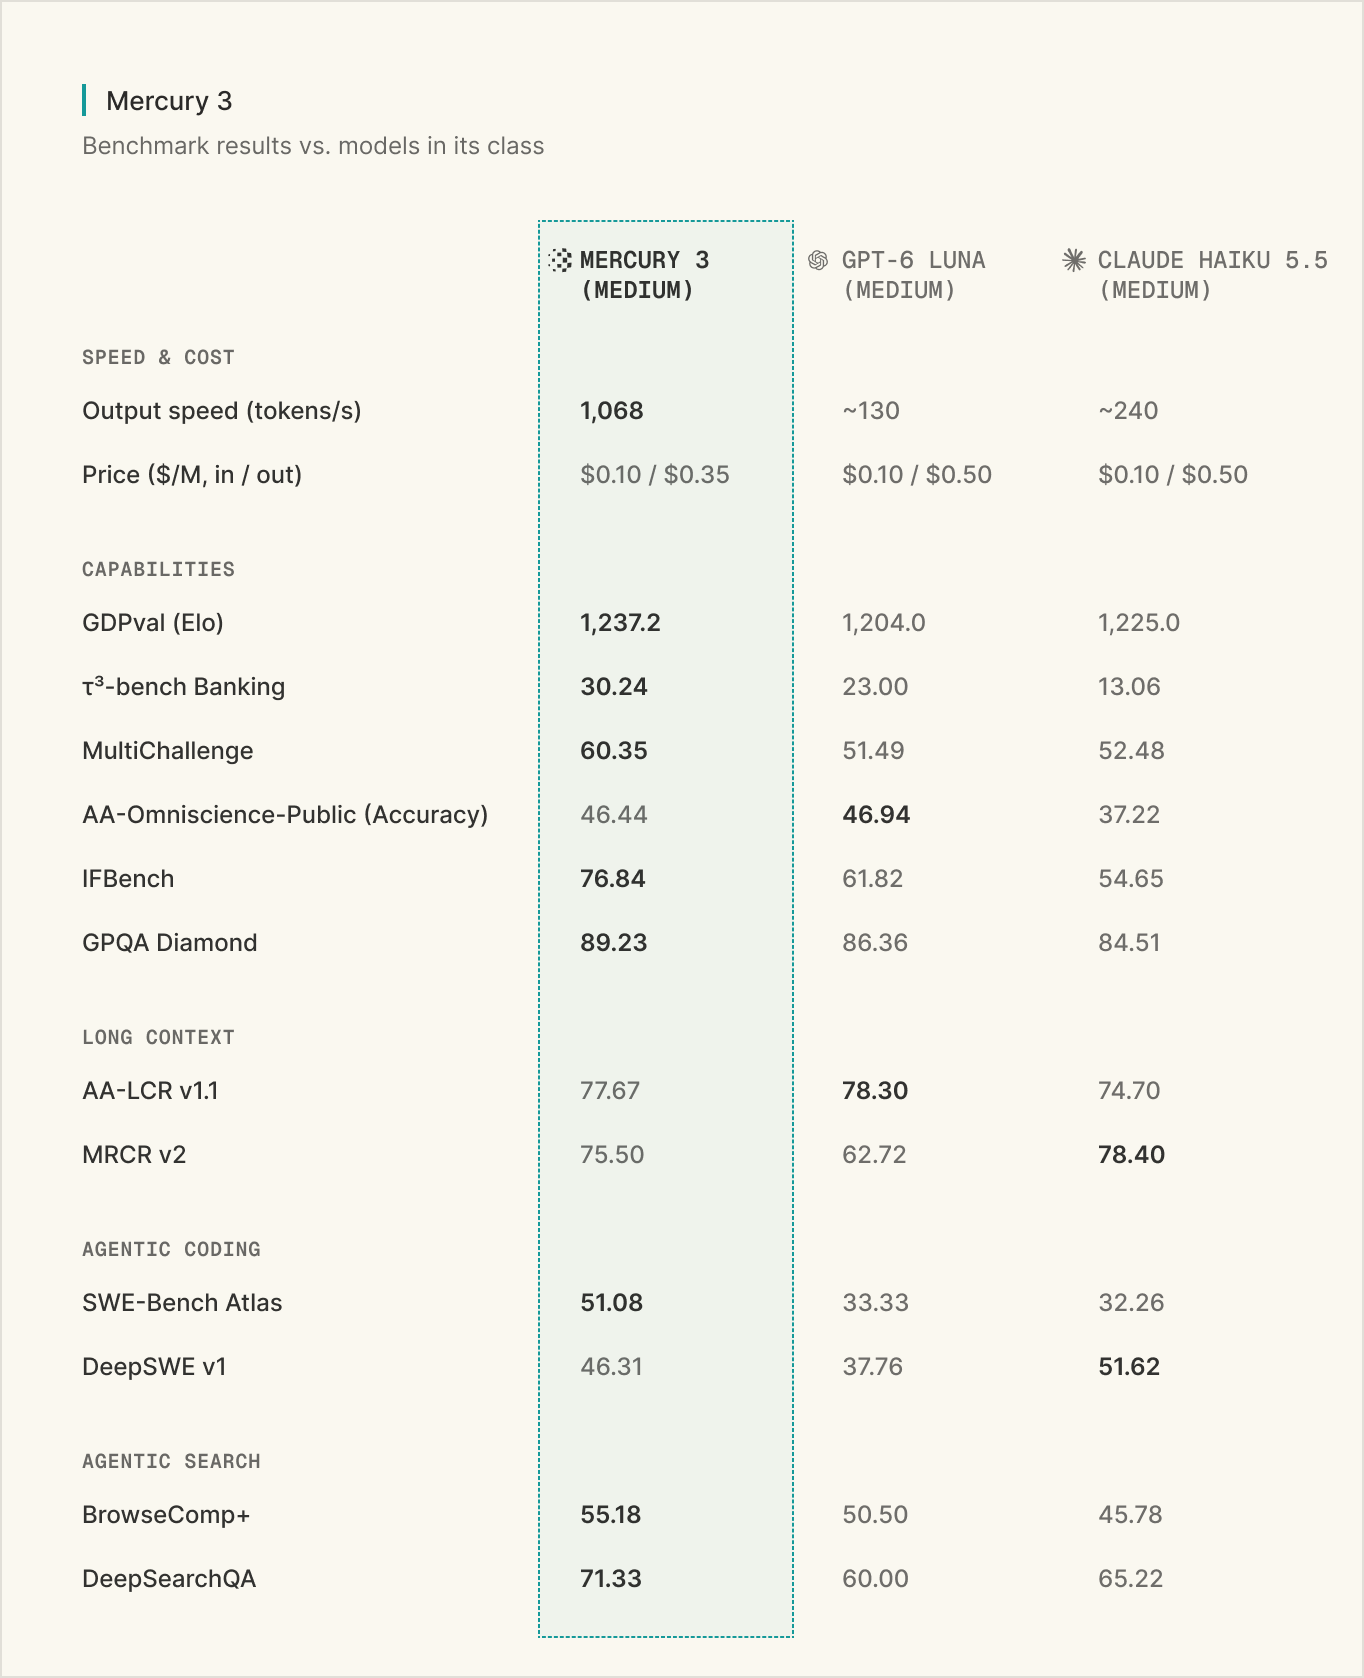
A Inception compara o Mercury 3 com os dois modelos que ele foi precificado para substituir: o GPT-6 Luna da OpenAI e o Claude Haiku 5.5 da Anthropic, ambos com esforço médio. Aqui está a tabela completa do post de lançamento:
| Benchmark | O que testa | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|---|
| GDPval (Elo) | Tarefas de trabalho reais | 1,237.2 | 1,204.0 | 1,225.0 |
| τ³-bench Banking | Agente de atendimento ao cliente | 30.24 | 23.00 | 13.06 |
| MultiChallenge | Chat de vários turnos | 60.35 | 51.49 | 52.48 |
| AA-Omniscience (Accuracy) | Recordação de fatos | 46.44 | 46.94 | 37.22 |
| IFBench | Seguimento de instruções | 76.84 | 61.82 | 54.65 |
| GPQA Diamond | Ciência de nível de pós-graduação | 89.23 | 86.36 | 84.51 |
| AA-LCR v1.1 | Raciocínio em contexto longo | 77.67 | 78.30 | 74.70 |
| MRCR v2 | Recordação em contexto longo | 75.50 | 62.72 | 78.40 |
| SWE-Bench Atlas | Programação agêntica | 51.08 | 33.33 | 32.26 |
| DeepSWE v1 | Programação agêntica | 46.31 | 37.76 | 51.62 |
| BrowseComp+ | Busca agêntica | 55.18 | 50.50 | 45.78 |
| DeepSearchQA | Busca agêntica | 71.33 | 60.00 | 65.22 |
Lendo a tabela toda, o Mercury 3 tem a maior pontuação em 8 de 12 linhas. No confronto direto, ele supera cada rival em 10 de 12.
Três coisas que eu levaria em conta antes de citar isso:
- Todo número vem da execução da Inception. Ainda não há página do Artificial Analysis para o Mercury 3, e Kuleshov disse no Hacker News que os benchmarks de terceiros ainda estão em andamento.
- Tudo é com esforço médio. Um comentarista perguntou por quê, já que muita gente roda modelos baratos com esforço alto ou máximo. Não há curva de baixo a alto, então não dá para saber o quanto Luna ou Haiku diminuem a distância com mais raciocínio.
- As maiores vitórias estão em testes de agentes. SWE-Bench Atlas (51 contra 33) e τ³-bench Banking (30 contra 23 e 13) são diferenças grandes. As derrotas estão na recordação em contexto longo e em um teste de programação, em que o Haiku 5.5 está à frente.
O resumo honesto vem da própria Inception. Perguntado por que o Haiku venceu o DeepSWE, Kuleshov não exagerou:
"overall we have found the model to be Haiku- or Luna-level in our own daily usage. That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
Esse é o enquadramento que eu usaria: inteligência da classe Luna, saída muito mais rápida. Os resultados de parceiros no post de lançamento apontam na mesma direção. A TinyFish diz que o Mercury 3 concluiu metade de 50 tarefas reais de navegação na web do Mind2Web, "significantly more than GPT-6.1-Sol", e a Octen mediu um tempo mediano de geração de 0.9 segundo em seus testes de busca para óculos inteligentes.
Qual é a velocidade do Mercury 3 na prática?
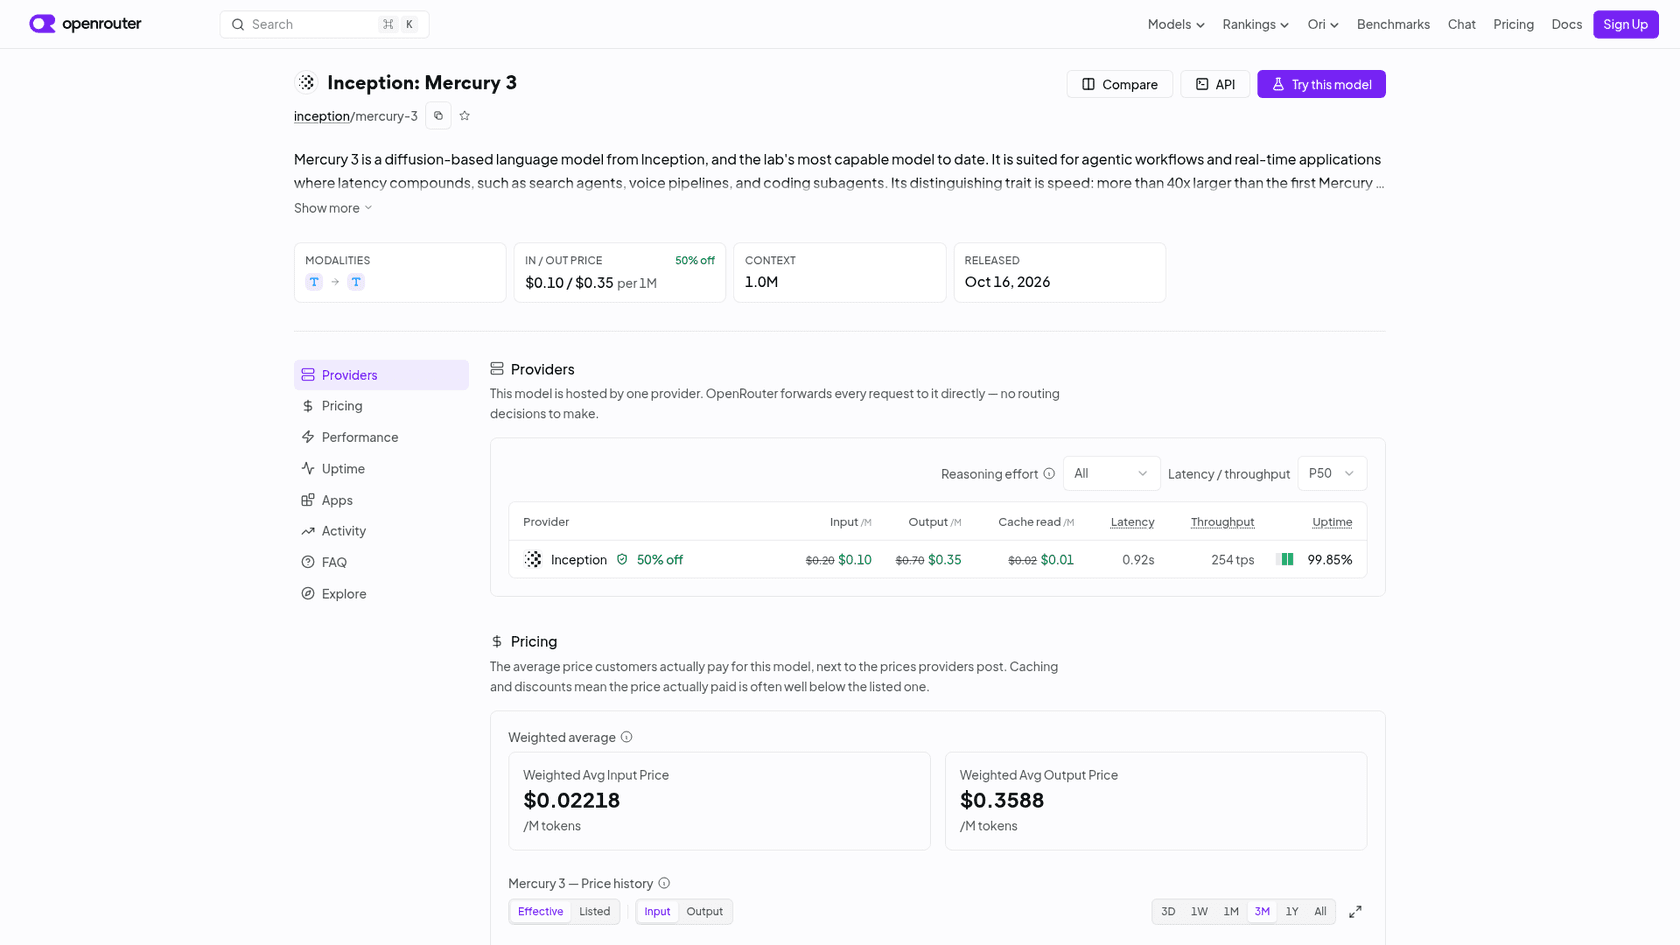
Esta é a parte que a maioria da cobertura do lançamento pula. O número 1,068 é a medição da Inception no próprio hardware NVIDIA. O único número independente que encontrei vem do OpenRouter, que tem um único provedor para o Mercury 3 (a própria Inception) e publica a vazão ao vivo.
Quando conferi em 20 de outubro de 2026, o OpenRouter mostrava uma mediana de 160 tokens por segundo, e uma segunda captura no mesmo dia mostrava 254. Sua média semanal da mediana é 203, com latência mediana de cerca de um segundo. Ainda é mais rápido que os ~130 que a Inception lista para o Luna, mas é cerca de um quinto da manchete.
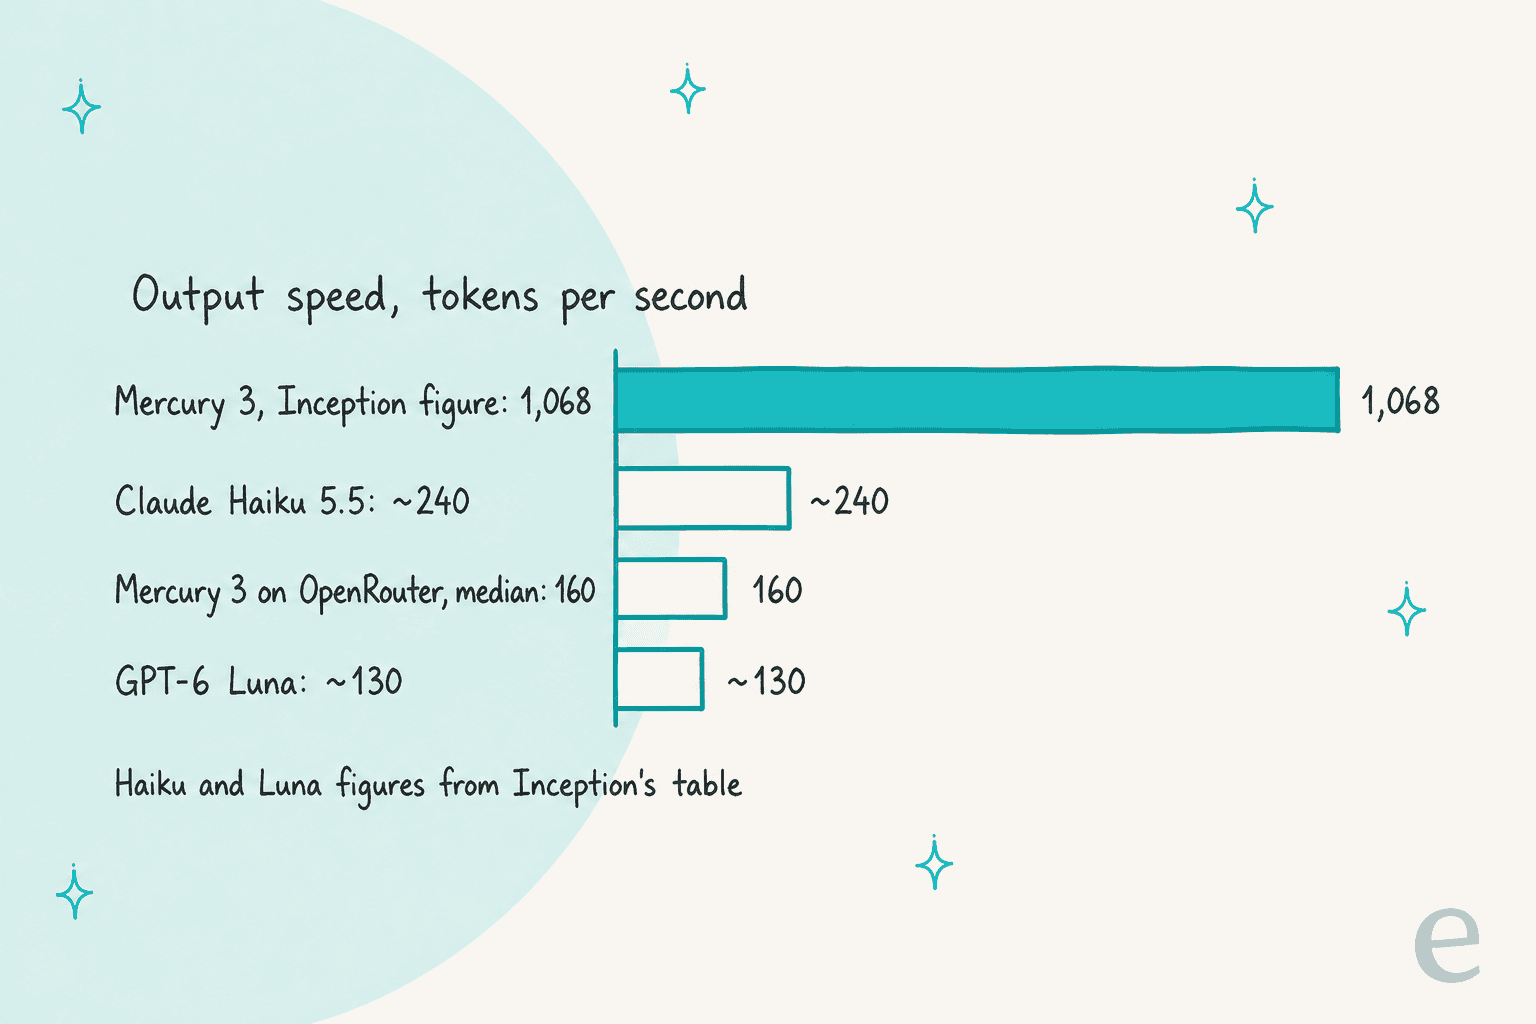
Por que a diferença? A vazão do OpenRouter é medida em tráfego real, no esforço de raciocínio que cada chamador escolhe, sob a carga que os servidores tiverem. A vantagem de velocidade da difusão é maior com baixa concorrência, o compromisso que um comentarista descreveu para o modelo de difusão experimental do Google:
"It doesn't benefit from batching to reduce memory bandwidth in the same way that a "standard" autoregressive model does, which ends up meaning that it's great at reducing latency for individual/low-concurrency users and delivers better outcomes on certain tasks but much more expensive per token at scale."
Kuleshov diz que o Mercury escalou bem com o tamanho do lote, e os preços da Inception sugerem que ele pode ser servido em volume. Mas Simon Willison, que rodou seu teste habitual do pelicano, achou a velocidade "a bit disappointing", e chamar a API da Inception diretamente em vez do OpenRouter "didn't seem to speed it up."
A velocidade real ainda importa? Depende de quantas chamadas ao modelo ficam em sequência. Um chatbot que faz uma chamada por mensagem mal nota 1,068 contra 160. Um agente que faz 12 chamadas em sequência sente cada uma delas. Coloque sua própria tarefa na calculadora abaixo para ver onde a diferença de velocidade deixa de importar.
Mude o número de passos e de tokens por passo para ver quanta espera do modelo o Mercury 3 economiza por tarefa, na velocidade da Inception e na mediana medida pelo OpenRouter.
Com os valores padrão (12 chamadas de 600 tokens), o Mercury 3 termina de gerar em 6.7 segundos na velocidade da Inception e em 45 segundos na mediana do OpenRouter, contra 55 segundos do Luna. Mesmo o número mais lento economiza tempo em cadeias longas. Com uma única chamada, toda a diferença cai para menos de um segundo, e é por isso que o Mercury 3 é uma escolha para loops, não para respostas isoladas.
Preços do Mercury 3 em resumo
A Inception publica uma única tabela de preços, a mesma na sua API e no OpenRouter. A página de modelos lista a família toda:
| Modelo | Entrada (tabela → lançamento) | Entrada em cache | Saída (tabela → lançamento) | Contexto | Melhor para |
|---|---|---|---|---|---|
| Mercury 3 | $0.20 → $0.10 | $0.02 → $0.01 | $0.70 → $0.35 | 1M | Raciocínio geral, agentes |
| Mercury Voice | $0.40 → $0.20 | $0.04 → $0.02 | $1.50 → $0.75 | 128K | Agentes de voz, TTFT abaixo de 170 ms |
| Mercury Decide | $0.04 → $0.02 | $0 | $0 (não cobrado) | n/d | Classificação, pontuação |
| Mercury Edit 2 | $0.25 | $0.025 | $0.75 | 32K | Autocompletar código, próxima edição |
Todos os preços são por milhão de tokens. O acesso vem em três planos: Free (100 milhões de tokens, todos os modelos), Developer (por uso) e Enterprise (limites de taxa personalizados, SLA, preços por volume). A Inception não disse quando o desconto de lançamento termina.
Como isso se compara aos modelos que ele persegue, usando a tabela de preços de cada fornecedor:
| Modelo | Entrada por 1M | Saída por 1M | Observação |
|---|---|---|---|
| Mercury 3 (lançamento) | $0.10 | $0.35 | 50% de desconto por enquanto |
| Mercury 3 (tabela) | $0.20 | $0.70 | Após o desconto |
| GPT-6 Luna | $0.10 | $0.50 | API padrão da OpenAI |
| Claude Haiku 5.5 | $0.10 | $0.50 | Prompts de até 100K tokens; 5x acima disso |
| DeepSeek V4.1 Flash | $0.15 | $0.60 | Fora do horário de pico, sem cache; em horário de pico dobra |
Então, no lançamento, o Mercury 3 é o token de saída mais barato deste grupo. No preço de tabela, é o mais caro na saída. Um comentarista do Hacker News colocou a preocupação com clareza: "I'm wondering if it'll still be useful once the discount is lifted?" Minha opinião: se você o compra pela velocidade, $0.70 ainda é barato. Se o compra porque é barato, faça o orçamento pelo preço de tabela. Meu guia de preços do GPT-6 Luna cobre o lado da OpenAI por inteiro, e as regras de horário de pico da DeepSeek estão detalhadas no meu post sobre os preços do V4.1 Flash.
Mais um detalhe de preço que vale conhecer: o Mercury 2 e o Mercury 2.5 estão fechados para novos usuários. Clientes existentes mantêm o acesso até 15 de novembro de 2026, então, se você usa um deles, planeje a troca agora.
Como acessar o Mercury 3
Você tem quatro caminhos, segundo o post de lançamento:
- Inception API Platform. Cadastre-se em platform.inceptionlabs.ai, crie uma chave e ganhe 100 milhões de tokens grátis.
- OpenRouter. Mesmo preço, encaminhado para a Inception, útil se você já fatura pelo OpenRouter.
- Baseten. Listado na biblioteca de modelos da Baseten, mas é preciso contatar a Baseten para ter acesso. Minha avaliação da Baseten cobre a plataforma.
- Vercel. A Inception também lista a Vercel como parceira de lançamento.
A API é compatível com OpenAI, então trocar é basicamente mudar a URL base e o nome do modelo. Esta é a chamada da documentação da Inception:
curl https://api.inceptionlabs.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $INCEPTION_API_KEY" \
  -d '{
    "model": "mercury-3",
    "messages": [{"role": "user", "content": "What is a diffusion model?"}],
    "reasoning_effort": "medium",
    "max_completion_tokens": 8192
  }'
A documentação de integrações da Inception cobre ferramentas de programação (Cursor, Kilo Code, OpenCode), frameworks como o LangChain e plataformas de voz como ElevenLabs e Vapi.
Para programação, o próprio conselho de Kuleshov é usá-lo como auxiliar, não como líder. Um modelo rápido combina com subagentes do Claude Code e tarefas paralelas enquanto um modelo maior conduz o trabalho principal.
O que os primeiros usuários estão dizendo
O tópico de lançamento no Hacker News teve 85 comentários no primeiro dia. O clima foi de impressão, mas com ceticismo sobre a afirmação de velocidade.
As opiniões positivas vieram de quem testou em trabalho real:
"If their benchmarks are to be believed they've made some real progress. [...] EDIT: just trying this out on a repo and it's actually pretty good so far. Pleasantly surprised."
A reclamação mais comum foi a espera antes do primeiro token, que um número de tokens por segundo não captura:
"Hmm at least in Openrouter, deepseek v4.1 flash via together/baseten/fireworks still beat mercury 3 on latency and intelligence Ttft is quite slow with mercury"
Outro testador viu o mesmo, mas ainda gostou do preço: "the issue with speed seems to be that ttft is still high," escreveu, acrescentando que "was as cheap as deepseek for a few tasks I tried." E um comentarista questionou a economia: "Pricing can always be set at a loss, however, particularly for a private company." É uma pergunta justa, sem resposta pública ainda.
Onde o Mercury 3 deixa a desejar
- Ainda sem benchmarks independentes. Toda pontuação é da Inception, apenas com esforço médio.
- A velocidade real é menor que a manchete. A mediana do OpenRouter foi de 160 a 254 tokens por segundo na semana de lançamento, e testadores relatam um primeiro token lento.
- Somente texto. Sem entrada de imagem ou áudio. A Inception diz ter protótipos multimodais internos, abertos a testadores iniciais por e-mail.
- Pesos fechados, tamanho não divulgado. Você não pode hospedá-lo por conta própria nem inspecioná-lo.
- Atrás do Haiku 5.5 em dois testes. Recordação em contexto longo (MRCR v2) e programação DeepSWE, então teste com documentos longos antes de confiar nele aí.
- O preço é promocional. A saída a preço de tabela custa $0.70, o dobro da taxa de lançamento, sem data de término anunciada.
- A saída estruturada não é perfeita. O OpenRouter mostra uma taxa de erro de saída estruturada de 2.78% no seu tráfego, então mantenha uma verificação de esquema no seu pipeline.
O Mercury 3 é bom para atendimento ao cliente?
Suporte é um dos quatro usos em produção que a Inception cita no lançamento, e a maior diferença de benchmark para o trabalho de suporte é o τ³-bench Banking, que simula um agente atendendo clientes de banco: 30.24 para o Mercury 3 contra 23.00 para o Luna e 13.06 para o Haiku 5.5. A Lorikeet, fornecedora de IA para suporte, disse à Inception que, nos primeiros testes, "Mercury 3 beat other models on latency while also performing higher on evals and in production." Se você está comparando fornecedores de suporte, meu post de alternativas à Lorikeet cobre esse mercado.
A velocidade importa mais em canais ao vivo. No chat do site e em agentes de voz, o cliente fica olhando os pontinhos ou ouvindo silêncio. Em tickets por e-mail, alguns segundos não mudam nada. É aí que o Mercury Voice, com tempo até o primeiro token abaixo de 170 milissegundos, mira, e vale a pena compará-lo com as ferramentas do meu apanhado dos melhores agentes de voz com IA.
Mas uma resposta rápida e errada continua sendo uma resposta errada. O que a eesel aprendeu rodando IA em filas reais é que você não pode confiar em nenhum modelo numa fila ao vivo até ter visto como ele lida com seus próprios tickets passados. Uma pontuação de 30 no benchmark bancário também significa que ele falhou na maioria dessas tarefas, então o modelo precisa de proteções, escalonamento e testes ao redor. Meu guia de prevenção de alucinações de IA cobre essas proteções, e a classificação de tickets com IA é um primeiro trabalho de baixo risco para um modelo barato e rápido como este.
Quem deve usar o Mercury 3?
Eis como eu decidiria:
- Quem constrói agentes com longas cadeias de chamadas. Agentes de navegador, de busca, subagentes de programação. É onde a velocidade se acumula e onde os resultados de parceiros da Inception são mais fortes. Experimente primeiro.
- Equipes de voz e chat em tempo real. Olhe o Mercury Voice pela latência do primeiro token e teste o Mercury 3 para as etapas de raciocínio por trás. Compare com a Retell AI se quiser uma pilha de voz completa.
- Equipes que pagam Luna ou Haiku em chamadas de alto volume e baixo risco. No preço de lançamento, é mais barato na saída e mais rápido. Refaça a conta no preço de tabela antes de se comprometer.
- Quem precisa de visão, pesos ou recordação de documentos longos. Espere, ou escolha outro modelo. O Gemini 3.8 Flash lida com imagens, e o DeepSeek V4.1 Flash tem pesos abertos.
- Equipes cujo gargalo não é o modelo. Se uma única resposta leva um segundo de qualquer jeito, a velocidade não vai mexer nos seus números. Olhe primeiro sua configuração de API de agente de IA ou a recuperação de informação.
Se você ainda está mapeando o cenário, meu apanhado dos melhores agentes de IA e o guia do melhor modelo para tickets de suporte são boas próximas leituras.
Experimente a eesel
O Mercury 3 é infraestrutura: um modelo rápido, uma API e uma cobrança por token. Para colocá-lo na sua fila de suporte, você ainda teria de construir a conexão com o helpdesk, a recuperação sobre a sua central de ajuda, as regras de escalonamento e o ambiente de testes. A eesel é a funcionária. Seu colega de IA para o helpdesk entra na fila que você já opera, aprende com seus tickets e documentos passados, e você pode reproduzi-lo nas suas conversas históricas antes que ele responda a um único cliente.
A SamCart é um bom exemplo de onde velocidade e canais se encontram. Ela roda um agente da eesel em tickets do Freshdesk e outro, separado, no balão de chat do site, cada um com sua própria saudação e tom, ambos respondendo a partir de cerca de 280 artigos da central de ajuda. O agente de tickets responde apenas até que um colega assuma o ticket, e um vendedor pedindo uma pessoa encerra a participação dele.
Se você é do tipo que testa modelos novos pelo terminal, a CLI da eesel controla o mesmo colega. eesel init chat-bubble --site https://your-site.com configura um agente de chat para site que lê suas páginas, eesel instructions edita suas regras permanentes, e eesel approvals lista ações aguardando uma pessoa. Todo comando imprime JSON, então um agente de programação como o Claude Code pode executar a configuração por você. Mais sobre isso no meu guia da CLI de agente de IA.
Os planos começam em $299 por mês por 500 créditos, em que um ticket ou um chat é um crédito, e o teste gratuito dá 100 créditos sem cartão. Experimente a eesel nos tickets do mês passado, ou veja primeiro a página de preços. Se você escreve conteúdo em vez de responder tickets, a equipe também tem um redator de blog com IA.