O que o TypeSafe Jev realmente é
A TypeSafe AI é um laboratório de San Francisco que passou dois anos em modo stealth antes de lançar o Jev em 15 de setembro de 2026. O enquadramento na página inicial é deliberadamente provocador: os LLMs “produzem palavras para pessoas”, enquanto “o Jev produz decisões tipadas e é mais parecido com código”. O post de lançamento tem uma frase mais direta, chamando o Jev de “uma chamada de função com inteligência de fronteira: entra estado não estruturado, saem decisões probabilísticas tipadas”.
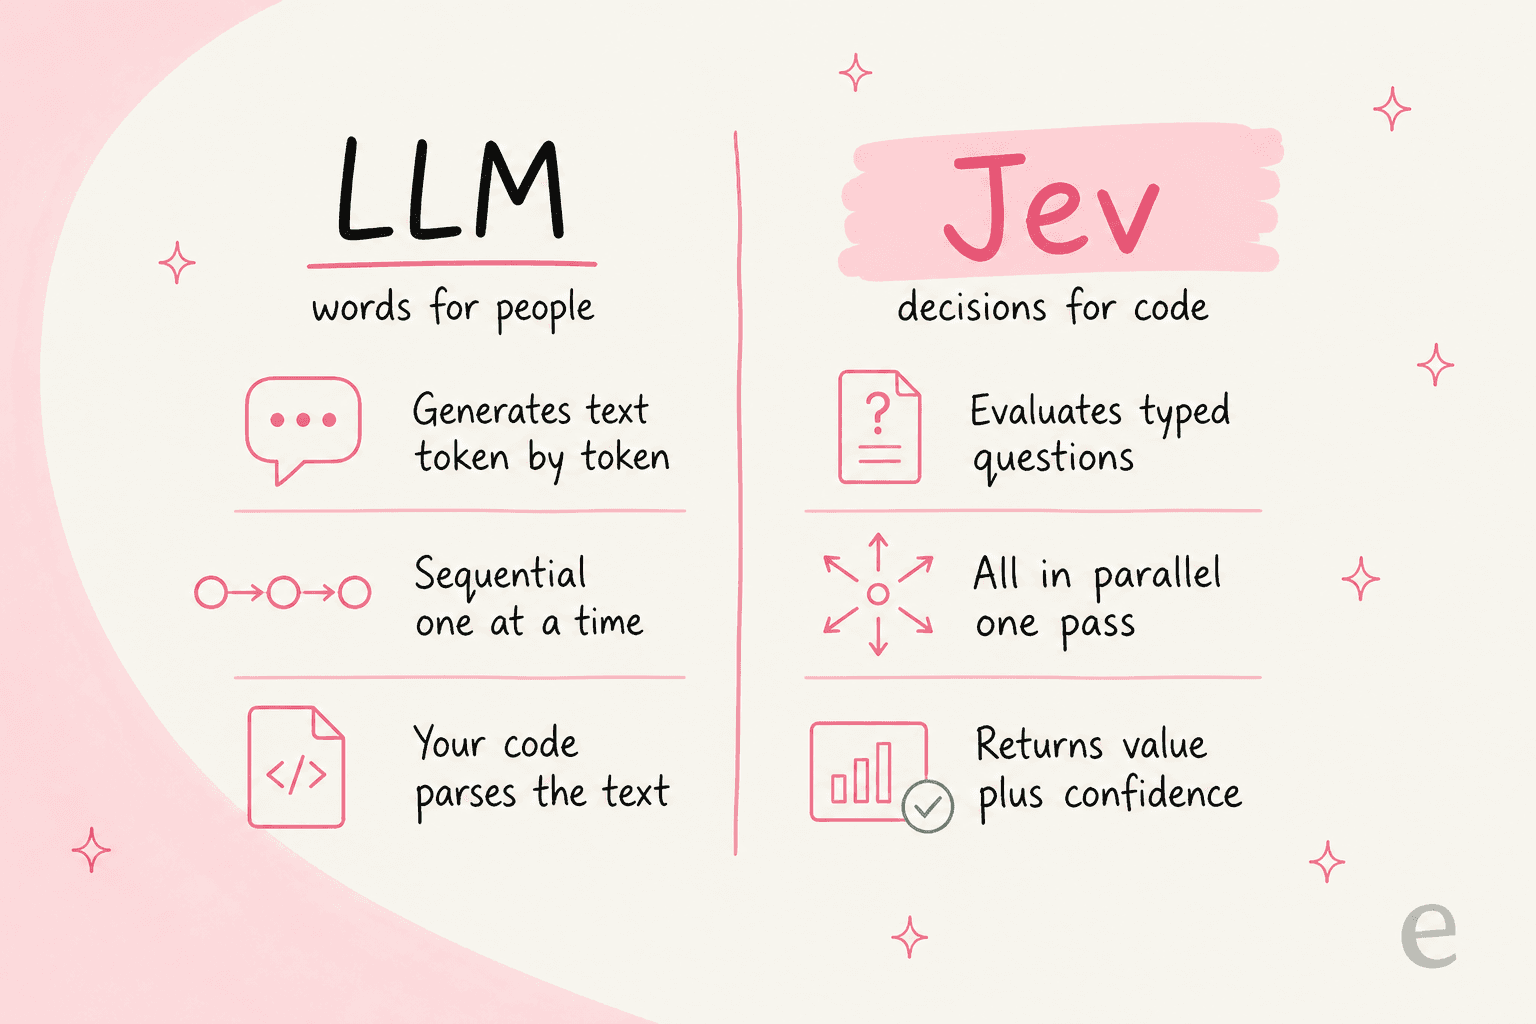
O nome entrega toda a filosofia. “System One” faz referência ao pensamento rápido e intuitivo do Sistema 1 de Daniel Kahneman, e “Jev” vem do economista William Stanley Jevons, cujo paradoxo diz que toda queda no custo de um recurso desbloqueia um uso muito maior dele. A TypeSafe está apostando que decisões tipadas, baratas e rápidas passarão a ser usadas em todo lugar onde uma chamada generativa lenta ainda é cara demais hoje.
A empresa também diz que tomou “a direção de pesquisa oposta” à do chat. Em vez de mais RLHF, treinou com um novo objetivo que chama de Reinforcement Learning for Calibrated Decisions (RLCD), com uma nova arquitetura e um novo amostrador. O discurso se resume a três ideias: decisões, não strings; confiança calibrada; mais parecido com código. O slogan deles, “Build Prod, Not God”, diz muito sobre com quem estão falando.
Como funciona: estado mais perguntas, avaliadas em paralelo
Esta é a parte que fez tudo fazer sentido para mim, e vale a pena entendê-la antes de qualquer uma das afirmações. A documentação descreve o descompasso que o Jev foi construído para eliminar:
"you are coercing a text-generation system into outputting structured decisions, then parsing the results back into something your code can depend on."
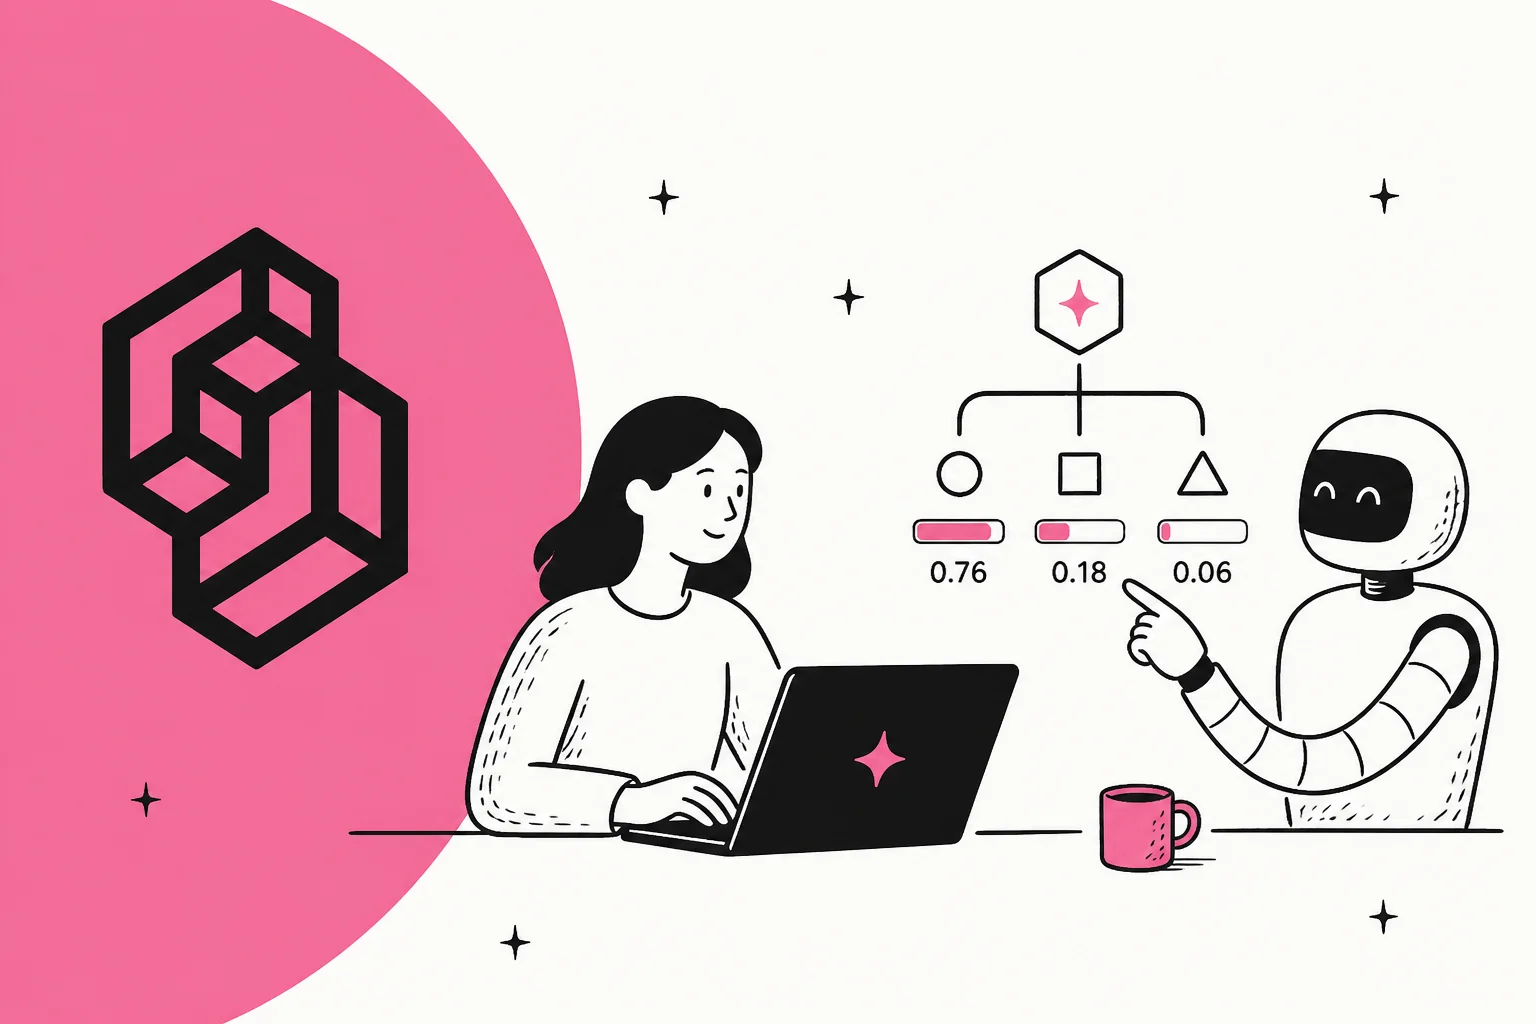
Qualquer pessoa que já tenha lançado um recurso com LLM já sentiu exatamente essa dor. O modelo do Jev é diferente: você envia um estado (uma string, ou um objeto estruturado) mais um conjunto de perguntas tipadas, e ele avalia cada pergunta em relação a esse estado, em paralelo, em uma única passagem. Seu código então ramifica, ordena e roteia com base nas respostas tipadas que retornam.
Existem apenas três primitivas, e elas correspondem exatamente às formas de que você precisa:
| Tipo de pergunta | O que ela pergunta | O que ela devolve |
|---|---|---|
| Noul | Esta afirmação é verdadeira? | uma única probabilidade, de 0 a 1 |
| Choice | Escolher uma opção de uma lista | a escolha, probabilidades por opção e uma confiança |
| Score | Pontuar o estado segundo uma rubrica | uma pontuação numérica, probabilidades por nível e uma confiança |
A decisão de design de que mais gosto: como cada pergunta é avaliada de forma independente em relação ao mesmo estado, adicionar mais perguntas quase não afeta a latência e nunca cria “context-rot”. A orientação de composição da TypeSafe é manter cada pergunta atômica, “o tipo de julgamento que uma pessoa experiente conseguiria fazer em poucos segundos”, e compor as coisas difíceis no código, em vez de em um único prompt gigante. Em vez de “avalie este pitch de startup”, você pergunta separadamente sobre tamanho de mercado, viabilidade e diferenciação, e depois combina as pontuações com sua própria fórmula.
A página do modelo na Cloudflare torna isso concreto com um exemplo de suporte que, honestamente, parece a nossa própria especificação de produto. Envie o estado "Help! My payouts have been failing for 3 days." com três perguntas, e você recebe de volta:
is_urgent(Noul):0.95department(Choice):"billing", confiança0.8, probabilidades {billing 0.87, technical 0.13}frustration(Score):1.04em uma escala Calm/Frustrated/Very angry, confiança0.94
Isso é triagem de tickets em uma única chamada. É também o retrato mais nítido do que o Jev é: um classificador muito rápido com probabilidades calibradas, não algo que fala.
As afirmações, verificadas uma a uma
O marketing da TypeSafe é ousado, então vou passar pelas afirmações principais em ordem e separar o que se sustenta do que é exagerado.
Velocidade: rápido, para as tarefas para as quais foi moldado
A TypeSafe afirma 70-500 ms ponta a ponta contra 3-329 segundos para LLMs de fronteira, enquadrado como 40x a 200x mais rápido. A passagem única em paralelo é um motivo arquitetônico real para a velocidade, e as evidências externas são animadoras. O CEO da Vercel relatou isso em produção:
"Jev is up to 18x faster (p95) and more accurate. It's coming to @vercel AI Gateway and likely new default."
A ressalva justa, levantada repetidamente no Hacker News, é que a comparação não é equivalente. Um modelo generativo que produz todos os nomes de tipo, o esquema e a prosa está fazendo mais trabalho do que um modelo que apenas emite uma decisão restrita. A velocidade é real; o multiplicador depende do que está sendo comparado.
Preço: barato, com um asterisco honesto
A 0,042 $ por milhão de tokens de entrada com saída gratuita, o Jev tem preço de infraestrutura, não de modelo de fronteira. A TypeSafe afirma que isso é 238 vezes menor que o preço de entrada do Claude Fable 5.1. Mérito reconhecido: eles enfrentam de frente a questão do subsídio em vez de fugir dela.
"We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Vale saber antes de planejar em cima disso: não há página de preços (toda URL /pricing retorna 404 hoje), não há níveis de plano ou limites de taxa publicados, e o acesso está travado atrás de uma lista de espera. Este é um preço de lançamento em um produto de acesso antecipado, então trate-o como algo indicativo. Se você está modelando custos, nosso guia sobre preços do Qwen mostra o quão rápido os números de lançamento mudam. A mesma lição aparece no nosso detalhamento de preços do Gemini 3, e se a lista de espera for um obstáculo, nossa lista de alternativas ao Qwen tem opções abertas hoje.
“Não pode alucinar”: meia verdade, e exagerado
Essa é a frase que recebeu mais resistência, e acho que com razão. O Jev não consegue cometer um erro de tipo porque a saída é matematicamente restrita ao seu esquema. Essa parte é real e útil. Mas o marketing desliza de “sem erros de tipo” para “não pode alucinar”, e o topo do tópico no Hacker News não aceitou isso:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

Os defensores tinham uma resposta razoável: uma pontuação de confiança calibrada significa que você pode ver um 0.1 e descartá-lo, o que é diferente de um modelo que erra com total confiança. Outro comentarista definiu a régua com que a afirmação deveria ser medida:
"What we would want to see is a confidence value that is in line with the actual correctness. If the value is 0.9 for 1000 different answers, then approximately 900 of those answers should be correct."
Esse é o teste certo, e é exatamente o que o RLCD deveria otimizar. Minha leitura: confiança calibrada é um recurso de segurança genuíno que eu gostaria de ver exposto em mais modelos. “Não pode alucinar” é uma promessa mais forte do que o modelo realmente cumpre, e a TypeSafe estaria em terreno mais firme dizendo “type-safe com confiança calibrada”.
O benchmark: um gráfico que vale a pena ler com atenção
As próprias avaliações de fluxo de trabalho da TypeSafe destacam um chamativo “193,6x mais rápido, 444,6x mais barato”, que o próprio blog admite estar “na ponta mais alta dos ganhos do mundo real”. O gráfico logo abaixo é mais honesto que a manchete, e é a coisa mais útil que eles publicaram.
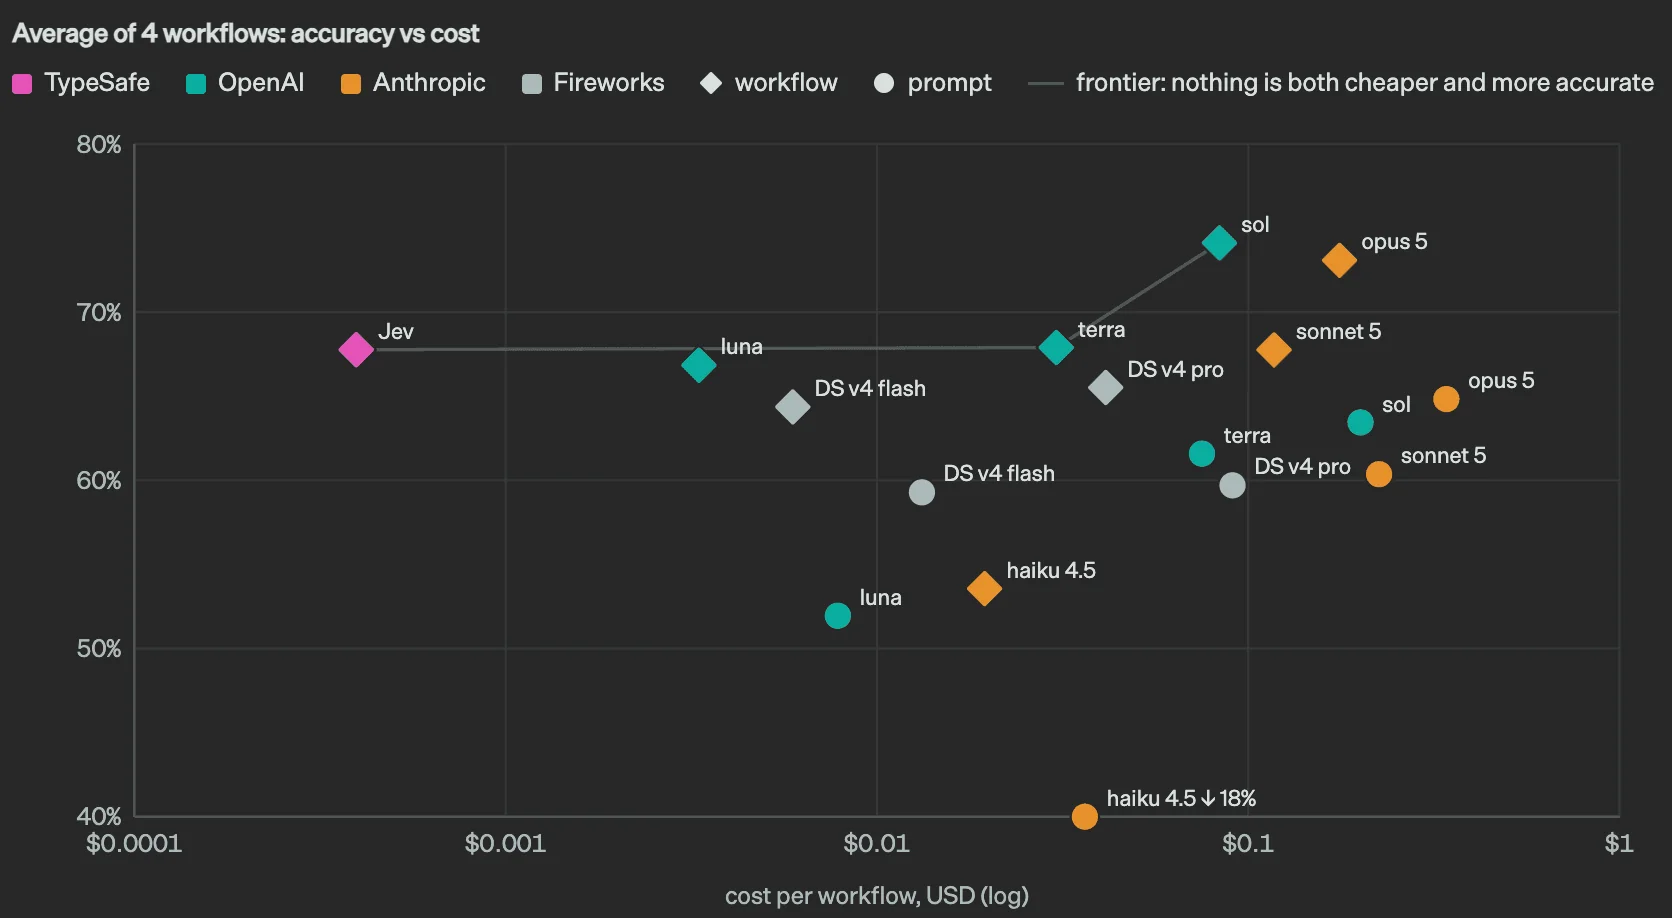
Lendo com atenção, a afirmação real fica clara: o Jev fica na fronteira com aproximadamente a precisão de um modelo de raciocínio de nível intermediário, a uma fração do custo por fluxo de trabalho. Não é o ponto mais preciso do gráfico. É o ponto mais barato que ainda é competitivo, o que para trabalho de decisão de alto volume costuma ser o que importa. A avaliação ponderada de um comentarista de destaque resume bem:
"Seems like a more accurate title would be "Jev: Trading general purpose generation for fast typed inference"."
O que os desenvolvedores estão realmente fazendo com ele
A reação no X foi o que mais me convenceu de que há algo real ali, porque eram demos, não opiniões. Os dois maiores posts eram ambos sobre espremer o contexto do agente. Um desenvolvedor usou o Jev para compactação instantânea:
"in 2026, why is compaction still a summarization prompt? Jev can make it instant by scoring every tool call and dropping what's irrelevant"
Outro o conectou ao Claude como revisor de chamadas de ferramentas e relatou ter levado uma sessão “de quase 1 milhão para 86 mil tokens” em cerca de um segundo. Essas são exatamente o formato de tarefa em que o Jev é bom: um julgamento rápido, barato e de alto volume que um modelo grande estava extremamente superqualificado para fazer. É o mesmo instinto por trás de boas ferramentas de agent-assist, pequenas verificações que não precisam de um cérebro de fronteira.
Não é um amor unânime, e vale a pena ouvir as críticas. A resposta direta do desenvolvedor Theo Browne, “Please don't do this”, capturou uma preocupação real: que as pessoas recorram a um classificador System One em situações em que o raciocínio de um modelo geral realmente importava. As duas coisas são verdadeiras ao mesmo tempo. O Jev é excelente para a decisão pontual, seja triagem de relatos de bugs ou uma decisão de escalonamento, e errado para a questão aberta. A disciplina está em saber qual é qual.
Onde um modelo de decisões tipadas se encaixa, e onde não se encaixa
Aqui está o limite honesto, porque uma análise que diz “use para tudo” não serve para nada.
O Jev se encaixa quando a tarefa é uma decisão que o seu código consome: roteamento e triagem, pontuação de urgência e sentimento, sinalizações de spam e abuso, marcação de tickets, ou uma revisão de uma chamada de ferramenta antes de ela ser executada. Em qualquer lugar onde você forçaria um LLM a gerar JSON, um modelo de decisões tipadas é uma primitiva mais limpa, e a confiança calibrada te dá uma alavanca real para decidir quando agir automaticamente versus escalar.
Não se encaixa quando a saída em si é o ponto. O Jev não escreve a resposta, não explica seu raciocínio, não mantém uma conversa nem lida com a longa cauda de uma pergunta verdadeiramente inédita. Ele também tem uma janela de contexto de 32.000 tokens e, como produto na semana de lançamento, uma lista de espera de acesso antecipado em vez de disponibilidade aberta. Para a resposta em si, você ainda precisa de um modelo geral, do tipo que comparamos no nosso panorama do melhor construtor de chatbot com IA, e se você é uma equipe menor, no nosso guia de agentes de IA para pequenas empresas.
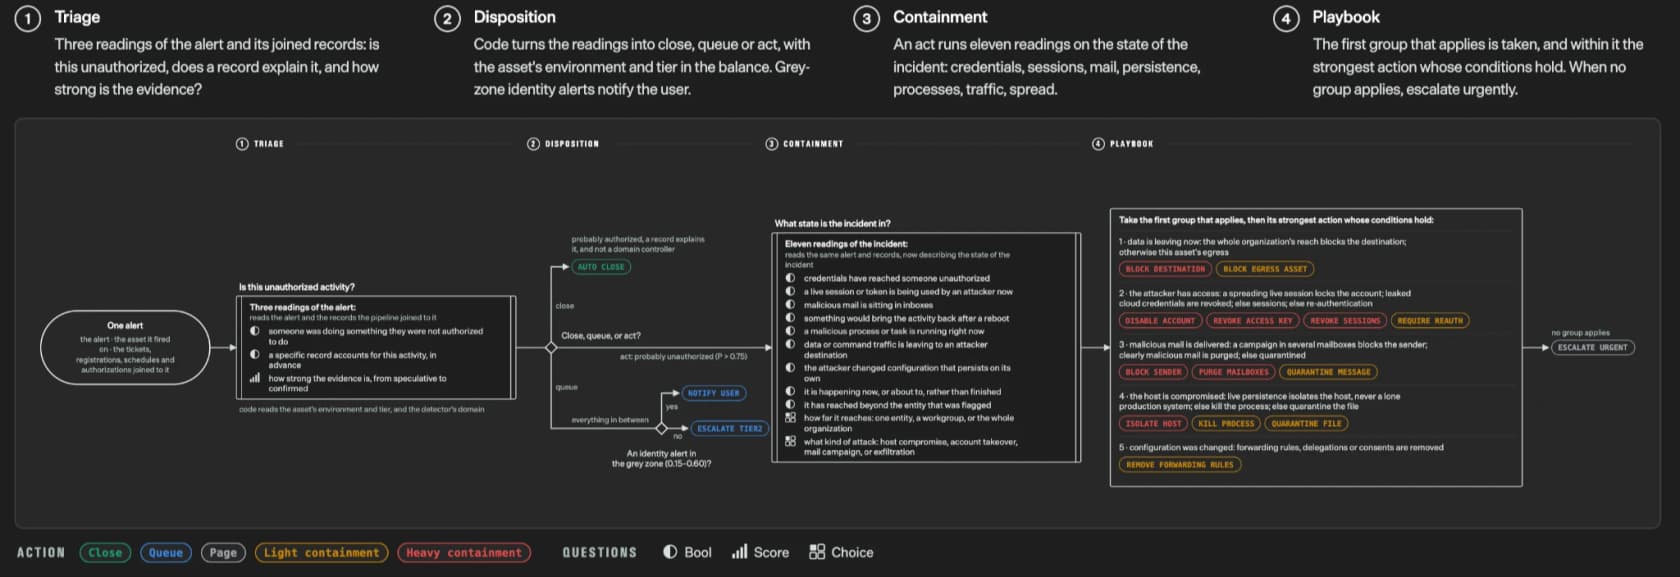
O modelo mental mais útil ao qual cheguei: o Jev é o reflexo rápido, não a deliberação. O próprio diagrama de fluxo de segurança da TypeSafe mostra bem o padrão, um pipeline de pequenas perguntas Bool, Score e Choice, com o seu código escolhendo a ação entre elas.
Para tornar a decisão mais rápida, aqui está o raciocínio que eu de fato seguiria:
O Jev em resumo
| Modelo | Jev (jev-1.13.0), o primeiro modelo System One público |
| O que devolve | decisões tipadas (Noul / Choice / Score) com confiança calibrada |
| Latência | 70-500 ms ponta a ponta, uma passagem em paralelo |
| Preço | 0,042 $ / MTok de entrada, saída gratuita (preço de lançamento, sem níveis) |
| Janela de contexto | 32.000 tokens |
| Acesso | lista de espera de acesso antecipado, além de typesafe/jev na Cloudflare Workers AI |
| Melhor para | decisões estruturadas de alto volume, revisão de chamadas de ferramentas, compactação |
| Não é para | escrever respostas, raciocinar em prosa, conversa aberta |
O que isso significa se você lidera uma equipe de suporte
A própria demo principal do Jev é um ticket de suporte, o que não é coincidência: triagem é a tarefa de livro-texto para o System One. Já passei tempo suficiente em filas ao vivo para conhecer a armadilha: uma ótima decisão de triagem é só o primeiro passo da automação de atendimento ao cliente. Essa é uma distinção de desenvolvedor à qual sempre volto. A classificação é onde a IA já é confiável; a resposta gerada, e a conta de custo agente humano vs. IA, é onde ela ainda escorrega.
Vimos exatamente essa divisão em um teste que ajudei a conduzir para uma marca de bens de consumo, ao longo de 284 chats e uma validação cruzada de 100 tickets. As decisões tipadas foram excelentes, com 93% de precisão na triagem e 100% de detecção de spam com zero falsos positivos. As respostas redigidas ainda tinham uma taxa de erro factual de 7%, e apenas 12% estavam limpas o suficiente para serem enviadas como estavam.
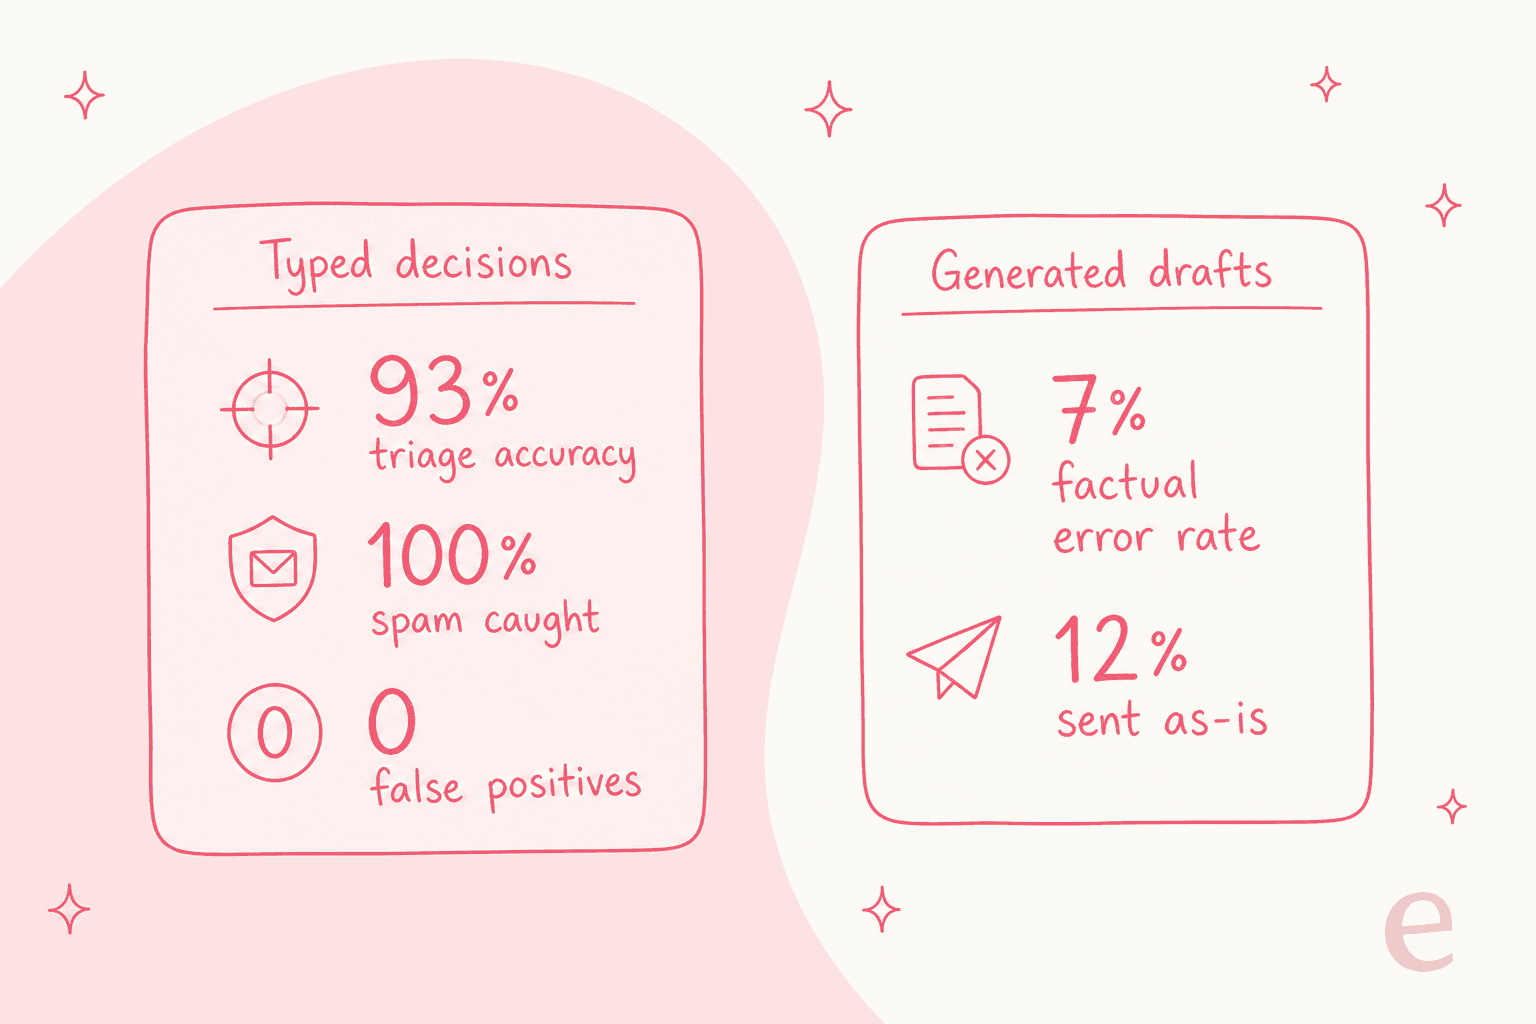
Essa é toda a razão pela qual um modelo como o Jev é empolgante, e também a razão pela qual ele não é a linha de chegada. Um modelo de decisões tipadas é infraestrutura. O trabalho de suporte construído em cima dele, conectar-se ao helpdesk, ler sua base de conhecimento, redigir a resposta, executar a ação, saber quando escalar e provar que funciona antes de entrar no ar, é trabalho de um funcionário.
É nessa linha que o eesel está. Onde o Jev é uma peça rápida, o colega de equipe de IA para helpdesk do eesel é a contratação pronta para trabalhar: ele se conecta às principais integrações de helpdesk (Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot) e depois triagem, redige e resolve na sua fila ao vivo.
Fundamentalmente, ele simula em cima de tickets passados antes de responder a um único cliente, então você vê a precisão nos seus próprios dados em vez de em um gráfico de lançamento. Ele cobra por ticket atendido, não por assento, então a economia acompanha o trabalho real.
E para os desenvolvedores a quem este post realmente se destina, o eesel não é só um painel. O mesmo colega de equipe pode ser operado pela CLI do eesel (npx @eesel/cli): uma pessoa pode executá-lo pelo terminal, scripts podem automatizá-lo em CI com um token de API, e agentes de programação como Claude Code, Codex e Cursor podem operá-lo diretamente. Você pode conectar uma integração, editar as instruções permanentes, listar e aprovar ações com humano no loop, e ler o log de atividade execução por execução, tudo em JSON, com --dry-run para pré-visualizar uma gravação antes de ela ser disparada. Cada workspace também é um servidor MCP, então o mesmo agente que você apontaria para o Jev pode apontar para o seu colega de equipe de suporte. A escalação não para no suporte; há também um colega de equipe redator de blog com IA para conteúdo. Se você gosta do Jev porque ele trata inteligência como código, esse é o mesmo motivo para gostar de operar um colega de equipe pelo terminal.
Meu veredito
O Jev é um dos lançamentos de modelo mais interessantes do ano justamente porque não está atrás de um chatbot melhor. É uma primitiva real e útil: decisões rápidas, baratas e type-safe com confiança calibrada, e um modelo mental limpo para compô-las em código. A velocidade e o preço se sustentam para o que se propõem, a afirmação “não pode alucinar” está exagerada, e a manchete do benchmark é mais alta que a realidade (ainda boa) por baixo dela.
Se você é desenvolvedor e está construindo sistemas agênticos, entre na lista de espera e use exatamente onde ele é forte: as decisões de alto volume que você vinha forçando um modelo grande a tomar. Para o panorama mais amplo de como esses sistemas se parecem em produção, nossos panoramas de exemplos de agentes de IA e os melhores colegas de equipe com IA são uma boa próxima leitura.
Só não confunda o reflexo com todo o sistema nervoso. A decisão é a polegada fácil; o trabalho de ponta a ponta ainda é a milha.
Perguntas frequentes
O que é o TypeSafe Jev?
O Jev é o primeiro modelo System One da TypeSafe AI, lançado em 15 de setembro de 2026. Em vez de gerar texto como um chatbot, ele avalia perguntas tipadas em relação a um estado e devolve decisões estruturadas com pontuações de confiança. Está mais próximo de um classificador rápido do que de um LLM geral, que é justamente o ponto central desta análise do TypeSafe Jev.
O Jev é um LLM?
Não, e a TypeSafe faz questão de deixar isso claro. O Jev não raciocina em prosa nem escreve explicações. Ele devolve um valor tipado mais uma probabilidade, e qualquer coisa mais complexa é dividida em perguntas separadas e recombinada no seu próprio código. Se você precisa de respostas conversacionais, um modelo geral ou um agente de IA de suporte são a ferramenta certa.
O Jev realmente não consegue alucinar?
Ele não consegue cometer um erro de tipo, porque a saída é restrita ao seu esquema. Ainda assim, pode errar com total confiança em um julgamento, que foi o ponto mais criticado pelos comentaristas do Hacker News. A leitura honesta: uma pontuação de confiança calibrada é um recurso de segurança real, mas “não pode alucinar” é uma promessa mais forte do que o modelo realmente garante.
Quanto custa o Jev?
A TypeSafe cobra a entrada a 0,042 $ por milhão de tokens e lista os tokens de saída como gratuitos. Ainda não há uma página de preços própria nem níveis de plano, e o acesso passa por uma lista de espera de acesso antecipado. Na Cloudflare Workers AI, a cobrança é feita pelo painel da Cloudflare.
O que dá para construir com um modelo System One?
Decisões estruturadas que o seu código consome diretamente: classificação de tickets, roteamento, pontuação de urgência e sentimento, revisão de chamadas de ferramentas e compactação de contexto. Encaixa bem em qualquer lugar onde você estivesse forçando um LLM a gerar JSON e depois fazendo o parsing de volta. Para o trabalho de suporte de ponta a ponta em cima dessas decisões, veja os melhores agentes de IA para atendimento ao cliente.
O Jev é melhor que o GPT ou o Claude para suporte?
São tarefas diferentes. O Jev é mais rápido e mais barato para a decisão pontual (isso é urgente? qual fila?), enquanto um modelo como o melhor LLM para casos de uso de suporte continua sendo quem escreve a resposta. A maioria dos sistemas em produção usará os dois, ou entregará todo o fluxo de trabalho a um colega de equipe que já conecta as peças.
Como faço para acessar o TypeSafe Jev?
Inscreva-se no acesso antecipado em console.typesafe.ai, use-o pelo id de modelo typesafe/jev da Cloudflare Workers AI, ou envolva um LLM existente com o adaptador System One de código aberto da TypeSafe. Todos os detalhes estão na documentação.


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.