Por que olhar além do Fable 5.1
Deixe-me ser justo com o favorito primeiro, porque o Fable 5.1 é um modelo forte. Foi lançado em 1º de setembro de 2026, está no topo da família Claude 5, e nas próprias avaliações da Anthropic lidera todos os benchmarks que publica, com os maiores saltos em trabalho agêntico e científico de longo alcance. Ele oferece uma janela de contexto de 1M de tokens com preço fixo por token em toda a janela, saída máxima de 128k, e raciocínio adaptativo que está sempre ativo. A única mudança de preço em 2026 foi boa: as leituras de cache caíram 75%, de US$ 1 para US$ 0,25 por milhão de tokens, o que reduz os custos típicos em cerca de 25% e os fortemente agênticos em até 45%.
Então, por que alguém pesquisaria outras opções? Alguns motivos concretos surgiram repetidamente.
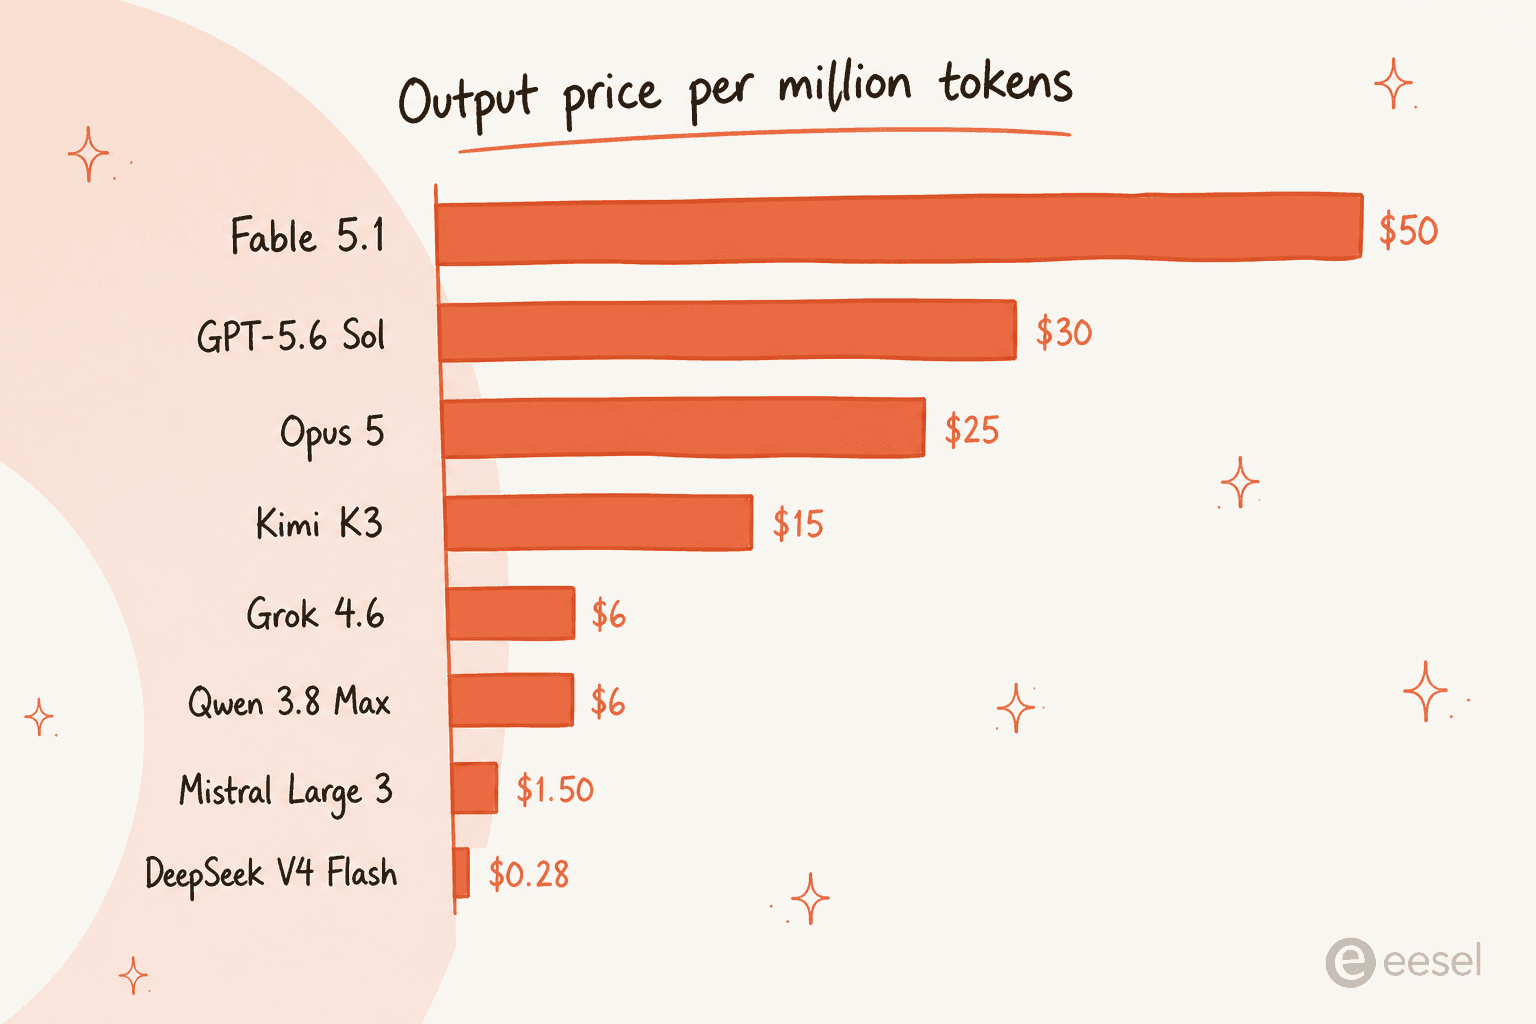
- Preço. A taxa base ainda é US$ 10/US$ 50, o preço mais alto desta coletânea. Se sua carga de trabalho não é do tipo longo, confuso e multi-ferramenta para o qual o Fable foi construído, você está pagando um prêmio por margem que não vai usar.
- Recusas. Vários desenvolvedores no Hacker News relataram recusas falso-positivas, incluindo em revisão de segurança do próprio código. A Anthropic diz que usuários do Claude Code devem ver cerca de 60% menos intervenções de ciber-segurança do que no Fable 5, mas é uma reclamação real e atual.
- A marca d'água. Toda saída do Fable 5.1 carrega uma marca d'água estatística de texto para conformidade com a Lei de IA da UE. Isso é aceitável para a maioria das pessoas e uma questão de confiança para algumas, e gerou a maior polêmica no lançamento.
- Talvez você não precise de um modelo bruto. Este é o grande ponto, e vou voltar a ele. Se o objetivo final é um agente de suporte ou um redator de conteúdo, comprar um modelo de fronteira significa que você ainda precisa construir o trabalhador em torno dele.
Como engenheiro que passa a maioria dos dias conectando modelos a um produto real na eesel, o que continuo notando é que a pergunta "qual modelo" geralmente é secundária a uma pergunta "qual camada" que as pessoas ignoraram. Mais sobre isso depois da lista.
Como escolhi estas alternativas
Não existe um único modelo "melhor", então esta lista está organizada pela tarefa que você realmente está fazendo. Pesei quatro coisas para cada opção: o preço real publicado (taxas base, não o "a partir de" do marketing), pontuações independentes onde existem (principalmente o Artificial Analysis Intelligence Index, que é agnóstico a modelo), se os pesos são abertos, e a contrapartida honesta que o ranking esconde. Cada modelo aqui é uma opção real, geralmente disponível, que você pode usar hoje, não uma prévia.
Uma nota sobre os números: os preços são por milhão de tokens (MTok), entrada e saída listadas separadamente, porque a saída é onde o dinheiro vai em trabalho generativo. Mantive cada número fiel à página principal do próprio fornecedor.
As 8 melhores alternativas ao Claude Fable 5.1 em 2026
Aqui está a lista resumida rapidamente, depois o detalhe de cada uma.
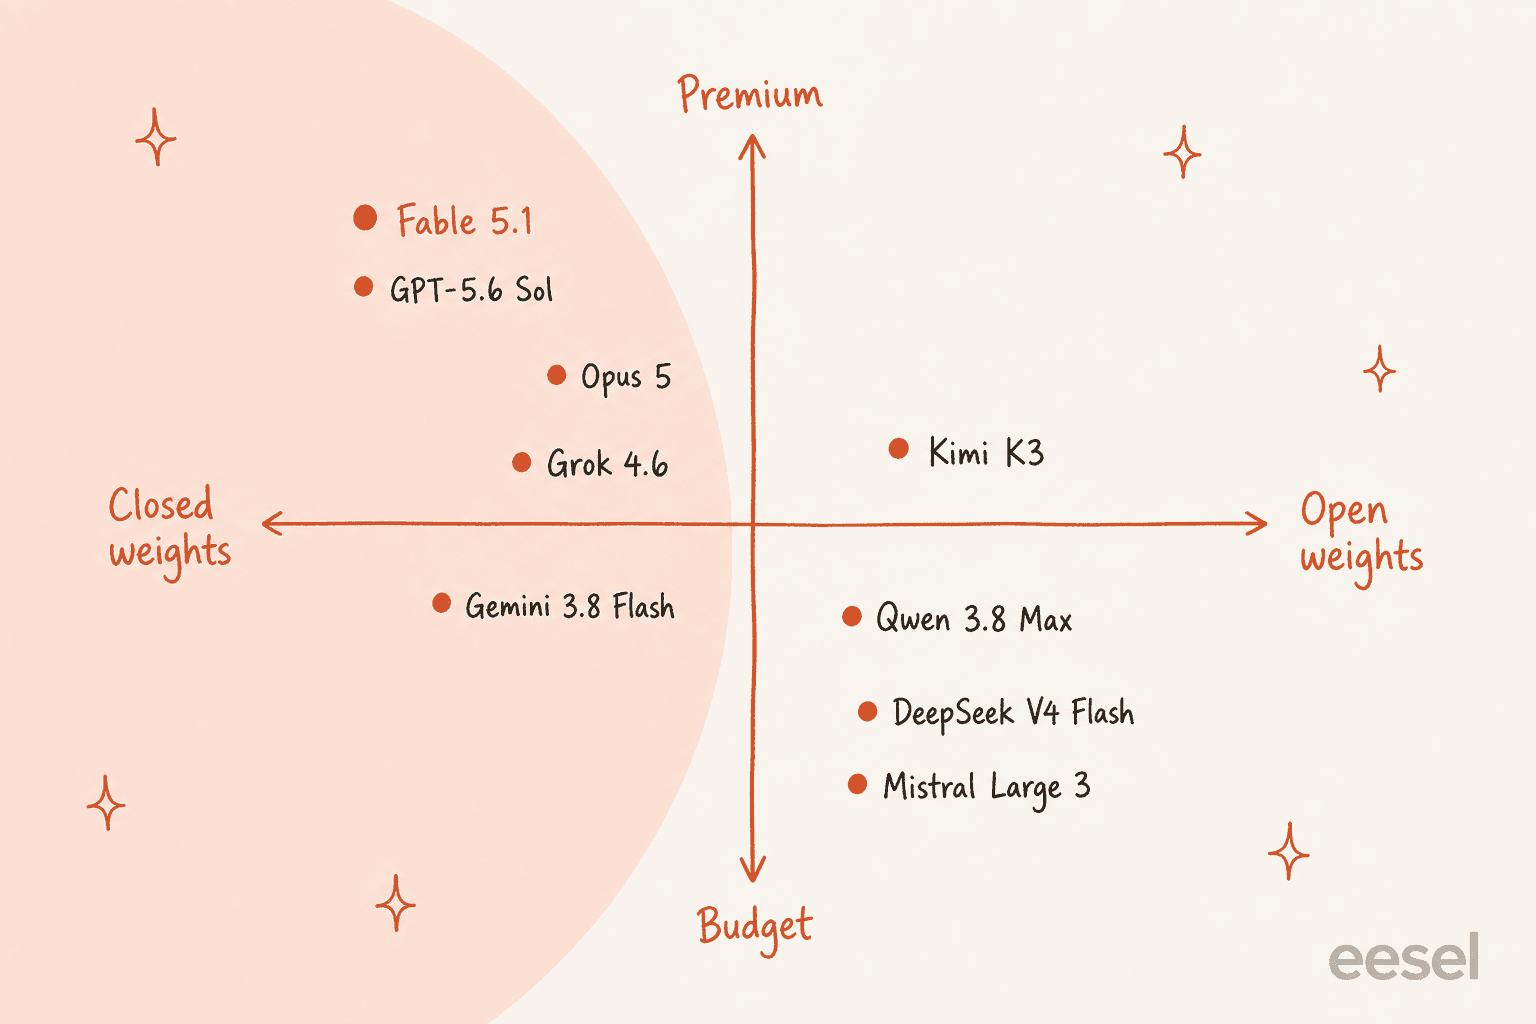
| Modelo | Melhor para | Preço (entrada/saída, $/MTok) | Contexto | Pesos abertos? | vs. Fable 5.1 |
|---|---|---|---|---|---|
| Claude Opus 5 | A substituição padrão | US$ 5 / US$ 25 | 1M | Não | Metade do preço, ponto de partida recomendado pela Anthropic |
| OpenAI GPT-5.6 Sol | Pilhas nativas da OpenAI | US$ 5 / US$ 30 (contexto curto) | 400k | Não | Base mais barata, mas nível de contexto longo reprecificado 2x após 200k |
| Google Gemini 3.8 Flash | Lotes de alto volume baratos | US$ 0,75 / US$ 3,75 | 1M | Não | Muito mais barato, mas 13,3s de tempo até o primeiro token e dobra em jan/2027 |
| Kimi K3 | Carro-chefe de pesos abertos | US$ 3 / US$ 15 | 1M | Sim | Pontuação quase no topo, auto-hospedável, metade do preço de saída do Fable |
| Qwen 3.8 Max | Multilíngue + forte preferência humana | US$ 2 / US$ 6 | 1M | Pesos base | Top 5 no LMArena Text, um quinto do custo de saída |
| DeepSeek V4 Flash | A escolha de orçamento | US$ 0,14 / US$ 0,28 | 128k | Sim (MIT) | Saída ~180x mais barata, licenciado MIT |
| xAI Grok 4.6 | Tempo real + dados do X | US$ 2 / US$ 6 (contexto curto) | 500k | Não | Base mais barata, mas cobranças por chamada de ferramenta e um limite em 200k |
| Mistral Large 3 | Residência de dados na UE, barato | US$ 0,50 / US$ 1,50 | 256k | Sim | Fornecedor europeu, menor preço de saída de nível premium aqui |
1. Claude Opus 5
Melhor para: quem quer um Claude classe Fable sem a conta classe Fable.
A alternativa mais honesta ao Fable 5.1 é o modelo bem abaixo dele na própria linha da Anthropic. O Opus 5 foi lançado em 24 de julho de 2026, opera a US$ 5/US$ 25 por milhão de tokens, e a orientação da Anthropic é incomumente direta: comece com o Opus 5 para a maioria das tarefas, e recorra ao Fable 5.1 apenas quando o Opus 5 com mais esforço ainda ficar abaixo do esperado. Isso é o fornecedor dizendo que o modelo mais barato é o padrão.
Ele compartilha as melhores características estruturais do Fable: uma janela de 1M de tokens com preço fixo, sem sobretaxa de contexto longo, e leituras de cache a US$ 0,50 (ainda barato, se não os US$ 0,25 do Fable). No Artificial Analysis Intelligence Index independente, ele está no topo do grupo, um triz atrás dos lançamentos mais recentes.
A pegadinha a considerar: testes da comunidade descobriram que o Opus 5 tende a gastar aproximadamente o dobro de tokens de saída do Opus anterior com esforço equivalente, então o custo por tarefa pode subir mesmo com o preço menor, e sua taxa de alucinação em um conjunto independente subiu notavelmente em relação a Claudes mais antigos. É brilhante e um pouco prolixo. Para times já no Claude que querem uma redução real de custo sem saírem da família, porém, é o movimento óbvio.
Nossa opinião: a escolha padrão. Se você está no Fable 5.1 "só por precaução", experimente primeiro o Opus 5, você provavelmente nunca notará a diferença no trabalho do dia a dia.
2. OpenAI GPT-5.6 Sol
Melhor para: times cuja pilha já é construída sobre a OpenAI.
O GPT-5.6 Sol é o carro-chefe de alto raciocínio da OpenAI e o par natural entre fornecedores para o Fable. A taxa base é de US$ 5 de entrada / US$ 30 de saída para o nível de contexto curto, o que fica abaixo do Fable na entrada e chega perto na saída. A OpenAI também oferece irmãos mais baratos na mesma família: o GPT-5.6 Terra a US$ 2/US$ 12 e o Luna a US$ 0,20/US$ 1,20, então você pode ajustar o custo dentro de uma única API.
Aqui está a contrapartida que a Anthropic não tem: a OpenAI cobra um nível de contexto longo. Ao cruzar 200k tokens, o Sol é reprecificado para US$ 10/US$ 45, e isso se aplica a toda a solicitação, não só ao excedente. Então uma execução agêntica com prompt grande pode custar silenciosamente o dobro do preço anunciado. O Fable e o Opus cobram toda a janela em taxa fixa, o que é uma vantagem genuína para trabalho de contexto longo.
Nossa opinião: a escolha certa se você é nativo da OpenAI e seus prompts ficam abaixo de 200k. Se seu trabalho é intenso em contexto longo, faça as contas desse limite antes de trocar.
3. Google Gemini 3.8 Flash
Melhor para: trabalhos de lote de alto volume e baratos, onde ninguém está esperando a resposta.
O Gemini 3.8 Flash é a história de preço desta lista. A US$ 0,75 de entrada / US$ 3,75 de saída, é mais de uma ordem de grandeza mais barato que o Fable, oferece uma janela de 1M de tokens, e pontua um respeitável 59 no Artificial Analysis Index. Para enriquecimento noturno, classificação ou geração em massa, essa combinação é difícil de contestar.
Duas ressalvas honestas. Primeiro, a responsividade: a Artificial Analysis mede um tempo até o primeiro token de 13,3 segundos contra uma mediana de classe de 2,99 segundos. O throughput é excelente (top três em velocidade de saída), mas o modelo é lento para começar, o que o exclui de qualquer coisa em que um humano esteja esperando, como uma resposta de chat em tempo real, e não é um problema para um agente em lote. Segundo, o preço dobra: a taxa de US$ 0,75/US$ 3,75 vale até 31 de dezembro de 2026, depois sobe para US$ 1,50/US$ 7,50 em 1º de janeiro de 2027. O próprio Google sugere ficar no 3.7 Flash mais antigo para cargas de trabalho focadas em eficiência, já que o 3.8 "pode usar mais tokens para maximizar o desempenho".
Nossa opinião: a jogada de valor para trabalho offline e de alto volume. Não o coloque atrás de um widget de chat, e marque na agenda a mudança de preço de janeiro.
4. Kimi K3 (Moonshot AI)
Melhor para: times que querem uma pontuação de topo com pesos abertos que possam realmente baixar.
O Kimi K3 é o carro-chefe da Moonshot AI, um modelo de mistura de especialistas de 2,8 trilhões de parâmetros (104B ativos) com uma janela de contexto de 1M de tokens. Opera a US$ 3 de entrada / US$ 15 de saída, então sua saída custa menos de um terço da do Fable, e ocupa o #4 no Artificial Analysis Intelligence Index, na frente das gerações anteriores de Claude e GPT. O diferencial é que a Moonshot publicou os pesos abertos no prazo, então você pode hospedá-lo você mesmo.
Uma peculiaridade para planejar: o raciocínio não pode ser desligado. O K3 vem com níveis de reasoning_effort (baixo, alto, e o padrão máximo), mas mesmo a configuração baixa ainda raciocina, e todos os níveis são cobrados na mesma taxa, então o controle regula a latência, não o custo. Isso o torna mais caro do que sua manchete sugere para chamadas simples, sem raciocínio, onde um modelo mais barato bastaria.
Nossa opinião: o carro-chefe de pesos abertos mais forte para times que precisam se auto-hospedar por conformidade ou controle. Se você só quer uma API hospedada e não se importa com pesos, Qwen e DeepSeek o superam em preço.
5. Qwen 3.8 Max (Alibaba)
Melhor para: trabalho multilíngue e quem confia mais na preferência humana cega do que em pontuações automatizadas.
O Qwen 3.8 Max ficou geralmente disponível em 2 de agosto de 2026. É um MoE de 2,4 trilhões de parâmetros (95B ativos) com uma janela de 1M de tokens, precificado a US$ 2 de entrada / US$ 6 de saída com uma leitura de cache implícita de US$ 0,25. Isso é aproximadamente um quinto do custo de saída do Fable para um modelo que fica próximo do topo dos rankings de preferência humana.
A reviravolta interessante é que os rankings automatizados e humanos discordam para o Qwen. No LMArena ele é #5 em Text e #2 em Vision, ou seja, as pessoas gostam de suas respostas; no Intelligence Index automatizado ele fica no meio, por volta de 58. Nenhum está errado, medem coisas diferentes, então não tire um veredito de número único disso. A Alibaba também publica um irmão menor com licença permissiva, embora o Max hospedado adicione visão, ferramentas e um contexto padrão mais longo que a base aberta não inclui.
Nossa opinião: uma escolha forte e barata para texto multilíngue e voltado ao consumidor, onde sua vantagem de preferência humana se mostra. Para uso agêntico de ferramentas, verifique nas suas próprias tarefas em vez do ranking.
6. DeepSeek V4 Flash
Melhor para: a linha de orçamento, quando o custo por token é a restrição.
Se o preço é toda a decisão, o DeepSeek V4 Flash encerra a conversa. A US$ 0,14 de entrada / US$ 0,28 de saída, sua saída é aproximadamente 180 vezes mais barata que a do Fable, e é distribuído sob licença MIT, a mais permissiva de qualquer modelo aqui. Foi retreinado em 31 de julho de 2026, e essa nova versão na verdade supera o próprio V4 Pro mais caro do DeepSeek em todo benchmark agêntico que a empresa publica.
Ele não vai empatar com o Fable no raciocínio de longo alcance mais difícil ou na memória profunda sobre um contexto enorme, e sua janela (128k) é menor do que a dos modelos de 1M de tokens acima. Mas no Artificial Analysis Index ele registra uma pontuação real a cerca de US$ 0,03 por tarefa, o tipo de número que torna viável de novo toda uma classe de ideias "caras demais para executar".
Nossa opinião: o padrão quando você está executando algo em escala e o nível de fronteira é overkill. Faça um prototipo com ele antes de assumir que precisa de um modelo de US$ 50 de saída.
7. xAI Grok 4.6
Melhor para: produtos que vivem de dados em tempo real e do X.
O Grok 4.6 opera a US$ 2 de entrada / US$ 6 de saída para seu nível de contexto curto de 500k tokens, mais barato que o Fable em todos os tokens, com forte uso de ferramentas e acesso nativo a dados em tempo real do X que nenhum outro modelo aqui tem.
Mas leia o medidor antes de se comprometer. Assim como a OpenAI, a xAI cobra um nível de contexto longo: ao cruzar 200k tokens, cada token da solicitação é cobrado a US$ 4/US$ 12. E o Grok adiciona cobranças por chamada que a taxa por token esconde, busca web e no X custam US$ 5 por 1.000 chamadas, busca de arquivos US$ 10 por 1.000, então um agente que pesquisa muito custa mais do que o preço anunciado sugere. Uma pegadinha de compras: se você é obrigado a usar a nuvem, Azure e Bedrock oferecem no máximo o Grok 4.3, então você não pode comprar o 4.6 por lá de forma alguma.
Nossa opinião: vale a pena quando tempo real ou dados do X são o recurso real. Se não for, os medidores de chamada de ferramenta tornam um modelo de fronteira simples mais fácil de orçar.
8. Mistral Large 3
Melhor para: residência de dados europeia e uma conta baixa de nível premium.
O Mistral Large 3 é a entrada europeia, e é o modelo "classe carro-chefe" mais barato desta lista, a US$ 0,50 de entrada / US$ 1,50 de saída. Para times que precisam de um fornecedor sediado na UE por motivos de residência de dados ou regulatórios, é frequentemente a única opção quase-de-fronteira que passa pelas compras, e ainda por cima oferece pesos abertos.
A contrapartida é direta: ele não está competindo pelo topo dos rankings de inteligência como Fable, Opus 5 ou GPT-5.6 Sol. Para o trabalho agêntico e de raciocínio mais difícil, ele fica um passo atrás, e seu contexto de 256k é menor que o dos modelos de 1M de tokens. Mas para muita geração e extração prática, nesse preço e com hospedagem na UE, é um piso bem razoável. O assistente para consumidores da Mistral, agora sob a marca Vibe, roda nos mesmos modelos se você quiser uma interface de chat.
Nossa opinião: a escolha pragmática para a UE. Escolha-o por residência e custo, não para ganhar um benchmark.
A reformulação: um modelo é um motor, não um funcionário
Aqui está o que toda lista de "melhor modelo" esconde. Escolher entre o Fable 5.1 e esses oito é a pergunta certa só se o próprio modelo for o que você está entregando. Para a maioria dos times, não é. Você não quer tokens, você quer tickets resolvidos ou posts escritos.
Um modelo de fronteira bruto é infraestrutura. Ele chega sem saber nada sobre seu produto, sem estar conectado a nada, sem lembrar de nada entre chamadas. Para transformá-lo em um agente de suporte, você ainda precisa construir busca sobre sua central de ajuda, conectá-lo ao seu helpdesk, escrever as barreiras de proteção, adicionar a lógica de escalonamento e, se for cuidadoso, encontrar uma forma de testá-lo antes que ele fale com um cliente real. Isso são meses de trabalho, e a escolha do modelo é uma pequena parte disso.
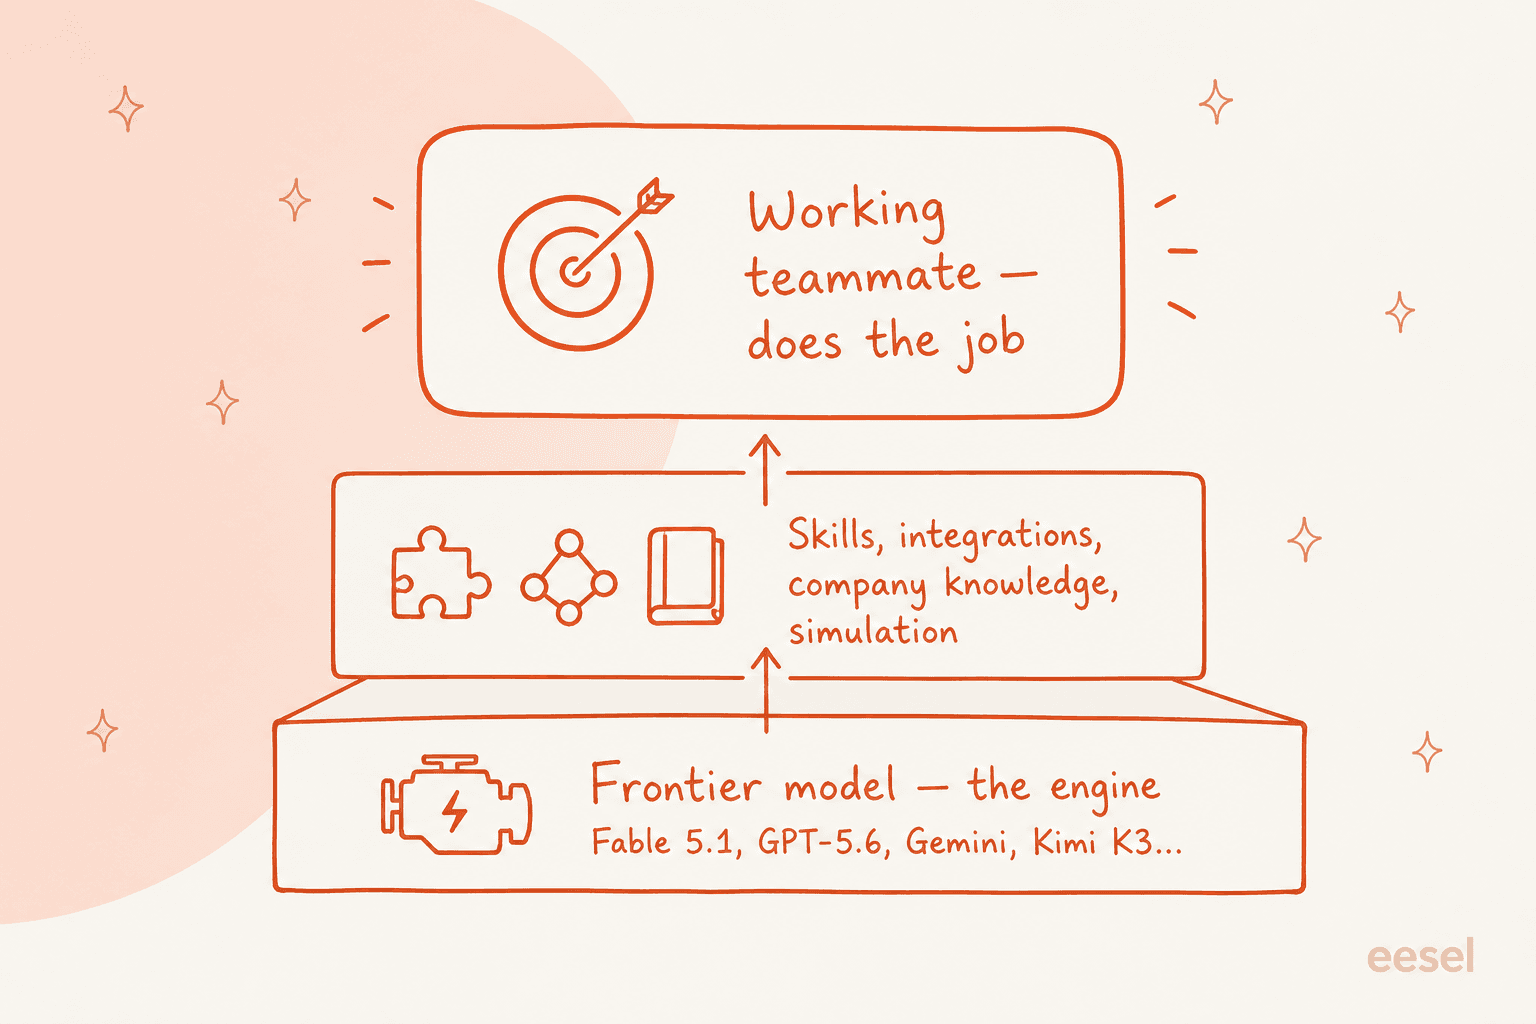
Foi aqui que ganhei algumas cicatrizes. Eu construo as integrações e APIs na eesel, e passamos os últimos três anos e meio colocando agentes de IA em filas de suporte reais, em milhares de tickets de verdade. A lição que ficou: o modelo raramente é o que quebra. O que quebra é um bot que parece confiante dando uma resposta errada porque ninguém o testou contra a realidade primeiro, e é exatamente por isso que toda implantação agora é simulada com os tickets históricos de uma empresa antes de se aproximar de um cliente. Nenhuma quantidade de "o Fable é melhor que o Opus?" responde isso.
Então, antes de passar uma semana comparando modelos, pergunte qual camada você está realmente comprando. Se você está construindo uma plataforma e o modelo é o seu produto, esta lista é para você, escolha pela tarefa. Se você quer um trabalhador, compre o trabalhador.
Experimente a eesel
Se a tarefa que você realmente está tentando fazer é suporte ou conteúdo, a eesel é a camada que fica acima de todos esses modelos. A eesel é uma plataforma de colegas de equipe com IA: em vez de te dar um modelo e uma tela em branco, você contrata um colega de equipe pronto para trabalhar em uma tarefa definida. O time atual conta com um colega de equipe de helpdesk com IA que entra na sua fila de suporte existente, e um redator de blog com IA, cada um chegando com as habilidades, integrações e contexto de empresa que sua função precisa.
A parte que importa para uma coletânea de modelos: a eesel é agnóstica a modelo por baixo dos panos, então você obtém a capacidade de um modelo de fronteira sem precisar escolher, precificar ou conectar um, e sem refazer esse trabalho toda vez que um novo Fable ou Opus chega. Antes de responder um único ticket real, você pode simular o colega de equipe nos seus tickets passados para ver exatamente como ele os teria tratado, o passo de teste que a maioria das construções de modelo bruto pula e depois se arrepende.
E se você vive em um terminal, a CLI da eesel opera o mesmo colega de equipe e espaço de trabalho de forma programática. Ela é feita para ser amigável a agentes: uma pessoa pode executá-la manualmente, scripts podem automatizá-la, e agentes de codificação como Claude Code, Codex e Cursor podem operá-la diretamente, então você pode gerenciar instruções, iniciar simulações, acionar o agente e ler sua atividade sem nunca abrir o painel. É o mesmo colega de equipe, exposto como uma superfície que uma automação ou uma IA pode operar. Experimentar é gratuito, e você pode ver funcionando com seus próprios dados antes de se comprometer.
Qual alternativa você deve realmente escolher
Para fechar o ciclo, a versão resumida por tarefa:
- Fique na família Claude, gaste menos: Opus 5. É o próprio padrão da Anthropic.
- Nativo OpenAI ou Google: GPT-5.6 Sol (cuidado com o limite de 200k) ou Gemini 3.8 Flash (só em lote, preço dobra em janeiro).
- Pesos abertos: Kimi K3 para um carro-chefe auto-hospedável, Qwen 3.8 Max para multilíngue, DeepSeek V4 Flash para o piso de orçamento.
- Tempo real ou UE: Grok 4.6 para dados do X, Mistral Large 3 para residência europeia.
- Você queria um trabalhador, não um modelo: eesel.
Os modelos vão continuar se superando, e os preços vão continuar mudando. O que não muda é a questão da camada, decida primeiro se está comprando um motor ou um funcionário, e o resto da escolha fica muito menor.
Perguntas frequentes
Qual é a melhor alternativa ao Claude Fable 5.1?
Quanto custa o Claude Fable 5.1 comparado às alternativas?
Existe uma alternativa mais barata ao Claude Fable 5.1 que ainda seja capaz?
Existem alternativas de pesos abertos ao Claude Fable 5.1?
Preciso do Claude Fable 5.1 para construir um agente de suporte com IA?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.