Alternativas ao TypeSafe Jev: 8 formas de obter decisões de IA rápidas e tipadas

Alicia Kirana Utomo

Katelin Teen
Última edição September 21, 2026
O que realmente conta como uma alternativa ao TypeSafe Jev?
A proposta do Jev é estreita e específica: envie a ele estado não estruturado mais perguntas tipadas, receba de volta decisões tipadas com probabilidades calibradas, rápido. No Hacker News o lançamento atraiu 1.929 pontos, e o comentário mais afiado reformulou tudo com clareza:
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference'... Jev can only generate structured output, right?"

Essa reformulação é a lente certa para comparar alternativas. Qualquer coisa que transforme a saída de um modelo em uma forma garantida está competindo com o Jev na parte tipada. A parte realmente difícil de copiar é a parte calibrada, sem geração, e é por isso que a lista se divide conforme o quão perto cada opção chega disso.
Agrupei as oito opções nas três famílias acima. Aqui está o conjunto completo de relance antes de eu passar ferramenta por ferramenta.
| Ferramenta | Tipo | O que retorna | Garantia de esquema | Pontuação de confiança | Hospedagem | Preço | Melhor para |
|---|---|---|---|---|---|---|---|
| eesel | Colega de suporte | Um ticket resolvido, não só uma decisão | Ações no seu helpdesk | Simulado em tickets passados | SaaS (SOC 2, GDPR) | Baseado em uso, ~$0,40/ticket | Rodar o suporte de ponta a ponta |
| TypeSafe Jev | Modelo System One | Decisão tipada + probabilidade | Sim, nativo | Sim, calibrado com RLCD | API + Cloudflare | ~$0,042/MTok de entrada, saída grátis | Decisões rápidas e estreitas em escala |
| OpenAI Structured Outputs | Recurso de API gerenciado | JSON que corresponde ao seu esquema | Sim, JSON Schema | Via logits (aproximado) | API da OpenAI | Tarifa normal de tokens do modelo | Equipes já na OpenAI |
| Gemini structured output | Recurso de API gerenciado | JSON que corresponde ao seu esquema | Sim, JSON Schema | Via logits (aproximado) | API do Google | Tarifa normal de tokens do modelo | Classificação barata no Flash-Lite |
| Cloudflare Workers AI | Gateway de modelos | Modo JSON / chamadas de função | Sim, por modelo | Depende do modelo | Edge + serverless | Baseado em uso (Neurons), camada grátis | Apps de edge, e rodar o próprio Jev |
| BAML | DSL de esquema + biblioteca | Objetos tipados de qualquer LLM | Sim, ao analisar | Depende do modelo | Auto-hospedado / OSS | Grátis (código aberto) | Melhor DX para prompt-para-tipo |
| Instructor | Biblioteca (Pydantic) | Objetos tipados validados | Sim, com tentativas | Via logits (aproximado) | Auto-hospedado / OSS | Grátis (código aberto) | Extração em Python, início rápido |
| Outlines | Biblioteca de geração | Estrutura imposta durante a decodificação | Sim, no momento da decodificação | Depende do modelo | Auto-hospedado / OSS | Grátis (OSS) + API hospedada | Modelos locais, gramáticas estritas |
| Hugging Face AutoTrain | Classificador treinado | Rótulo de classe + probabilidade | Conjunto de rótulos fixo | Sim, softmax | HF Hub / auto-hospedado | Custo de computação | Classificação estreita e de alto volume |
Uma nota sobre tom antes da lista: nenhuma dessas ferramentas é ruim, e algumas são excelentes. Onde eu aponto um limite, é um fato sobre escopo, não uma crítica. Vamos passar por elas.
1. eesel: a camada de colega de equipe, não um primitivo de decisão
Serei direto: esta é um tipo diferente de resposta. Muita gente que busca um modelo de decisão tipada está na verdade tentando resolver um problema de suporte ou operações, e recorreu a um primitivo porque era a novidade brilhante. Se esse é o seu caso, a recomendação honesta é pular o primitivo.

O que é. eesel é uma plataforma de colegas de equipe com IA. Os clientes contratam colegas de equipe prontos para trabalhar em uma função específica, e o time atual inclui um colega de IA para helpdesk e um redator de blog com IA. O colega de helpdesk entra na sua fila existente, lê sua central de ajuda e tickets passados, e toma as mesmas decisões de triagem, roteamento e escalonamento que um modelo de decisão tomaria, e então redige e resolve.
Onde se encaixa. Quando a decisão é um meio para um fim e o fim é um ticket resolvido. O Jev te dá "urgente, faturamento, 0,94". O eesel pega esse julgamento e de fato responde, etiqueta, roteia e fecha, conectado ao seu fluxo de atendimento ao cliente com IA. Ele se comporta menos como um truque de decodificação e mais como um agente de IA com seu contexto carregado, e fica dentro do seu software de atendimento ao cliente em vez de ao lado.
Pontos de atenção. O eesel não é uma API de decisão de uso geral. Se você quer um primitivo puro para incorporar em um produto não relacionado, precisa de uma das ferramentas abaixo, não de um colega de equipe.
Se você vive num terminal: o eesel também traz uma CLI pública mais um servidor MCP, então o mesmo colega de equipe e workspace podem ser controlados a partir de scripts e de agentes de codificação como Claude Code, Codex e Cursor. É o mesmo agente do painel, não um brinquedo separado, o que importa se seu instinto com o Jev era escriptar tudo. Veja como se compara a uma integração MCP do Claude Code.
Preço. Baseado em uso, cerca de $0,40 por ticket resolvido, sem taxa de IA por assento. Você pode simular nos seus tickets históricos antes de ir ao ar, o passo de calibração que toda outra ferramenta desta página pula.
2. OpenAI Structured Outputs
Se sua stack já está na OpenAI, essa é a alternativa ao Jev com menor atrito, porque é um recurso, não um novo fornecedor.
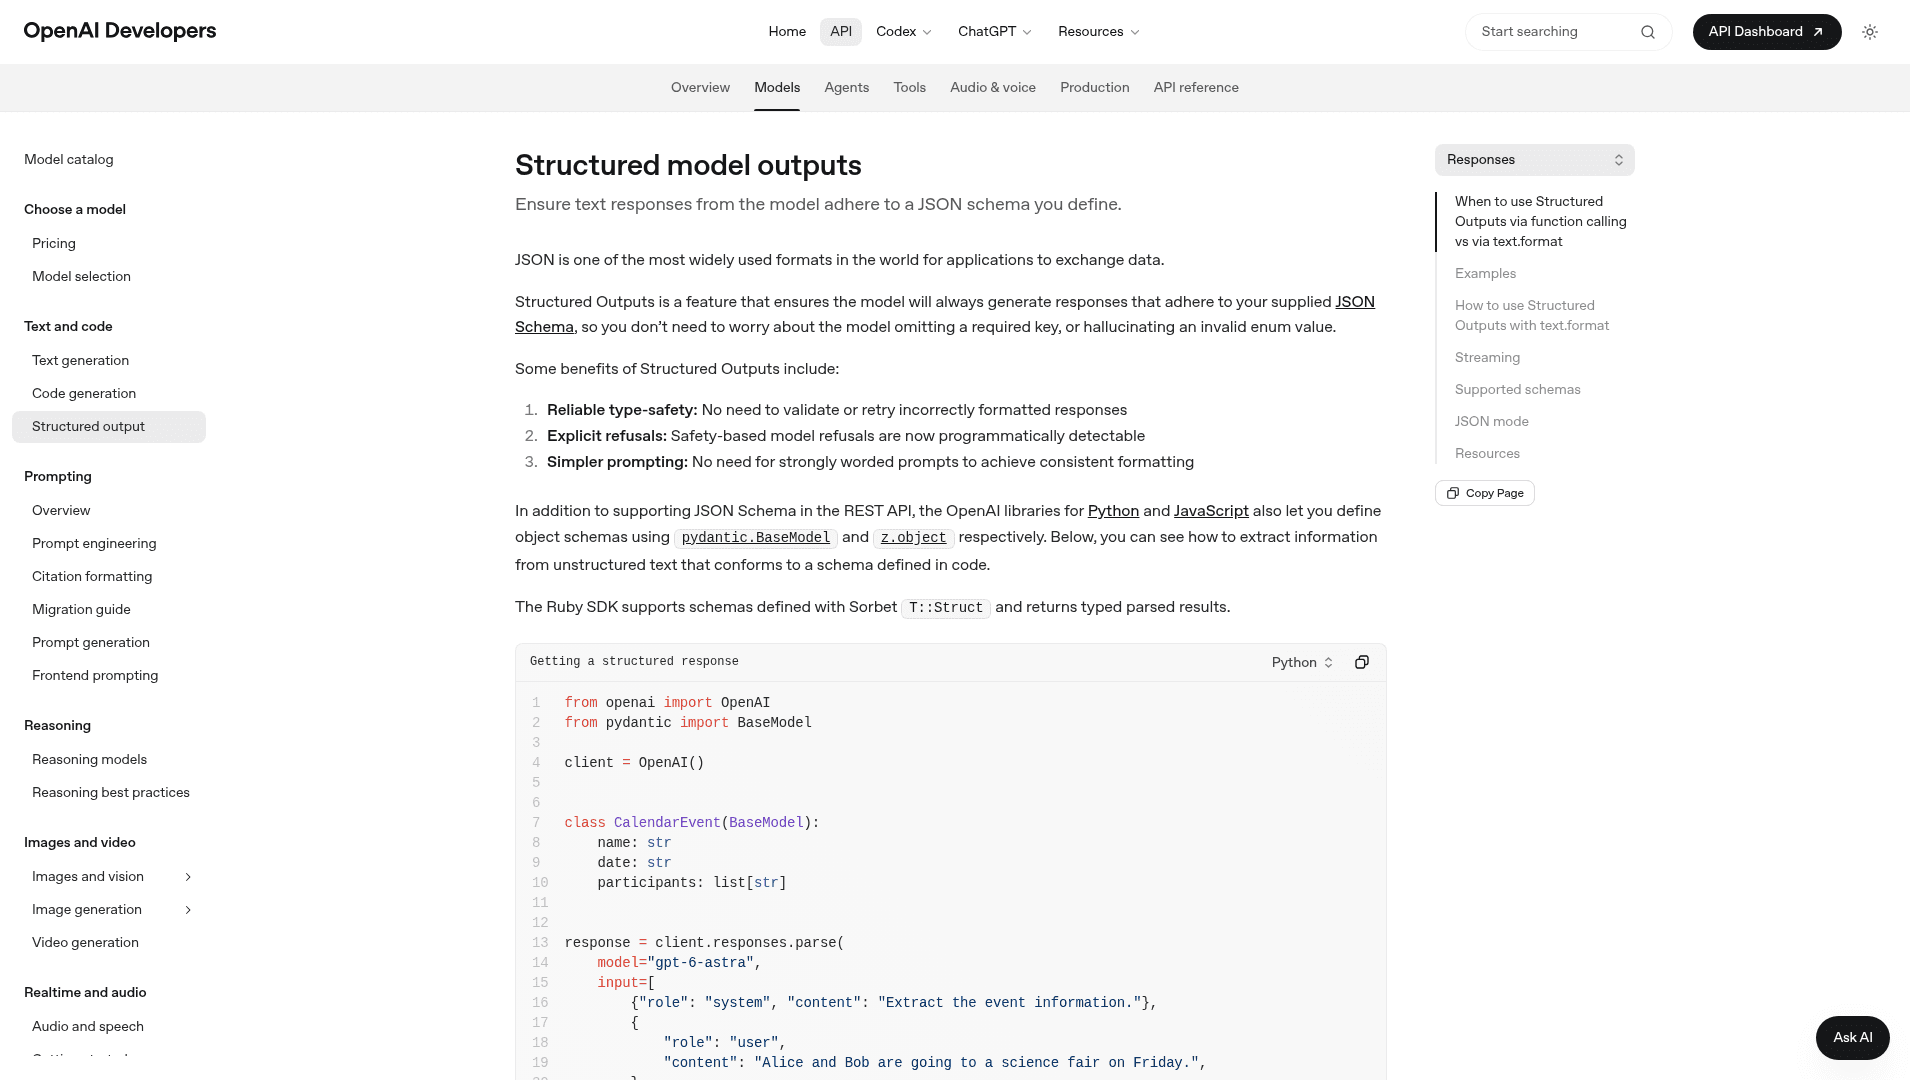
O que é. O Structured Outputs faz um modelo sempre retornar respostas que aderem a um JSON Schema que você define, então ele não vai omitir uma chave obrigatória nem inventar um valor de enum inválido. Também torna as recusas de segurança detectáveis de forma programática, e aceita esquemas definidos com pydantic.BaseModel ou z.object.
Onde se encaixa. Extração de dados, classificação de tickets e roteamento quando você quer todo o raciocínio do modelo por trás da decisão, e consegue conviver com a latência de geração. É uma base sólida para um pipeline de automação de tickets feito em casa.
Pontos de atenção. Isso é uma restrição sobre um modelo generativo, então você ainda paga pela geração de tokens e espera por ela. Ele te dá uma forma válida, não uma pontuação de confiança calibrada, então se você quer especificamente a calibração para a qual o Jev é treinado, precisa derivá-la você mesmo a partir dos logits.
Preço. Recurso gratuito; você paga a tarifa normal de tokens do modelo que chamar.
3. Gemini structured output
A versão do Google, e a que eu uso quando a tarefa é classificação barata e de alto volume.
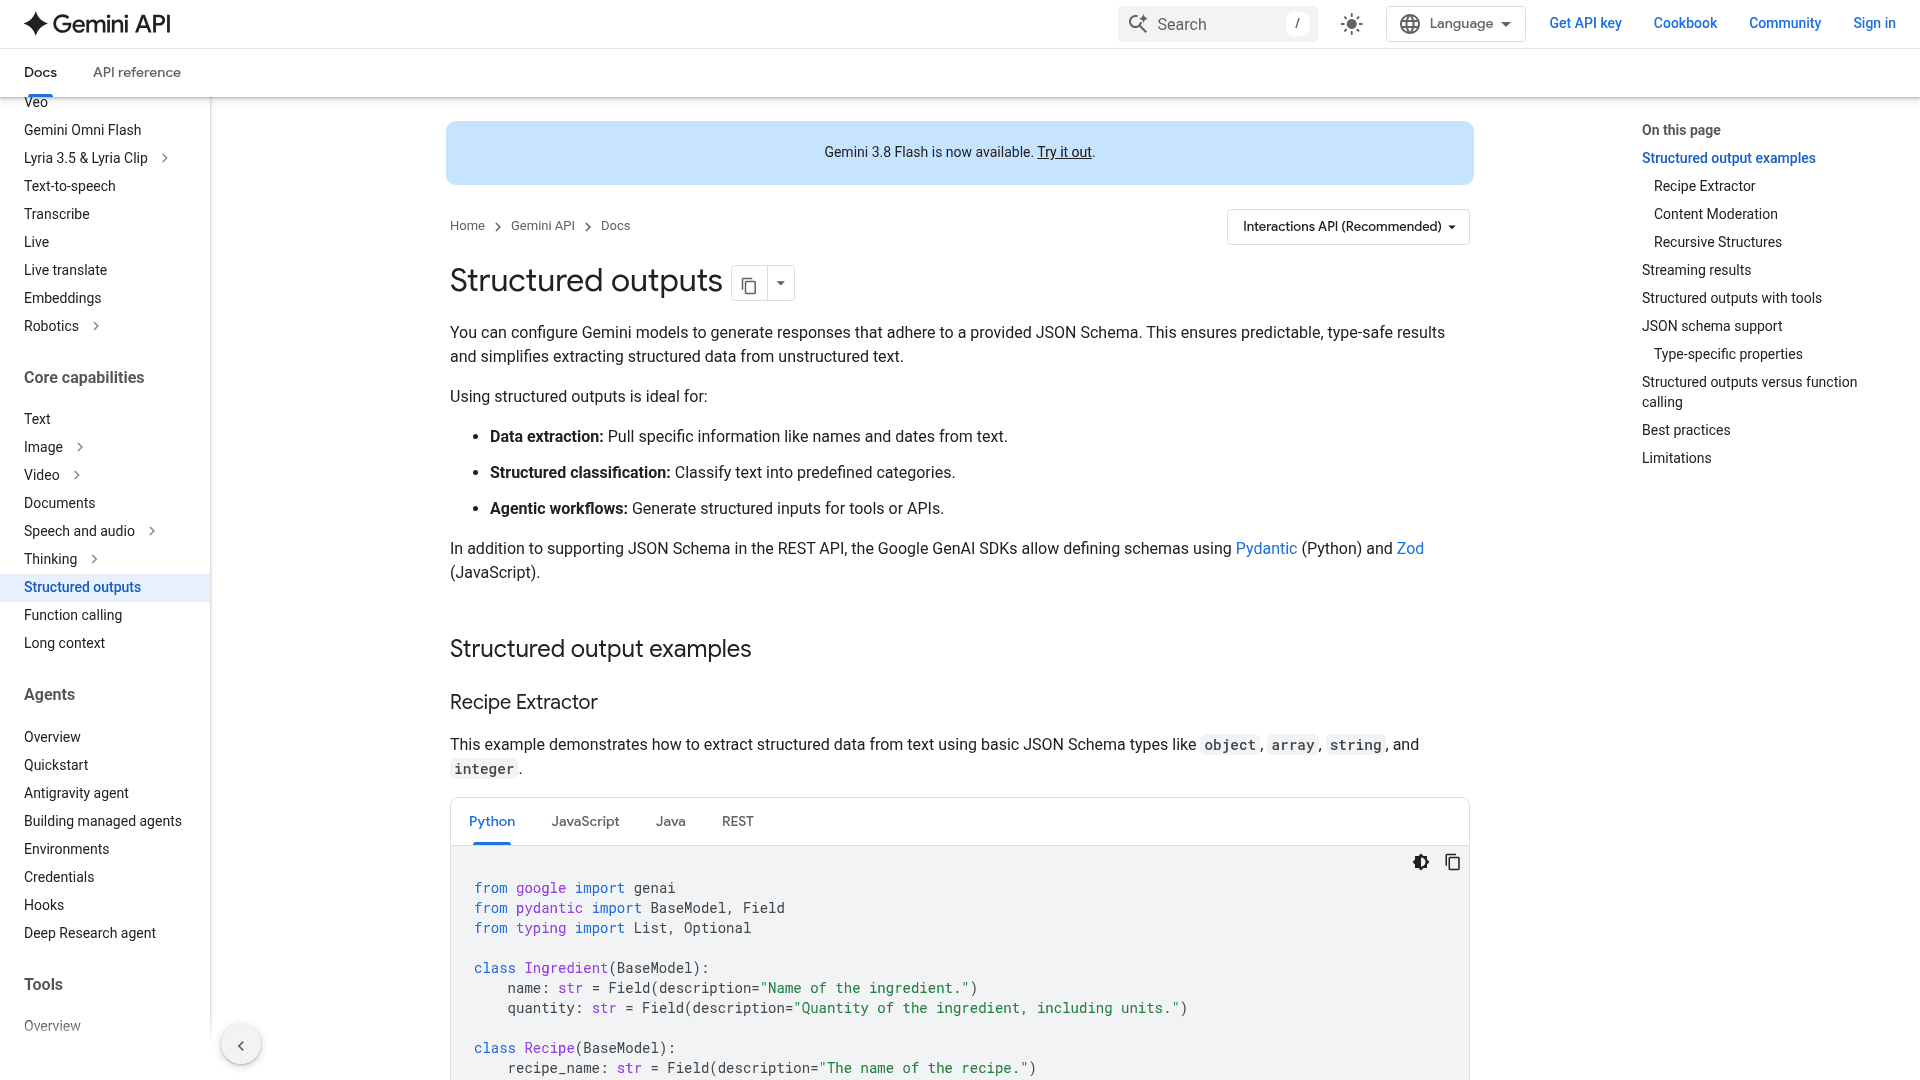
O que é. O Gemini structured output configura modelos Gemini para gerar respostas que aderem a um JSON Schema, e a documentação nomeia três usos ideais: extração de dados, classificação estruturada e geração de entradas estruturadas para fluxos de trabalho agênticos. Suporta esquemas Pydantic e Zod.
Onde se encaixa. Classificação e extração em volume, incluindo o tipo de automação de tickets de suporte que antes precisava de um motor de regras ajustado manualmente. No nível mais barato (Flash-Lite) o custo por chamada chega perto do território do Jev, que é a real vantagem competitiva aqui.
Pontos de atenção. Mesma ressalva central da OpenAI: é geração com uma restrição de esquema, não um motor de decisão construído para o propósito, então a latência e a confiança se comportam como as de um LLM, não como as do Jev.
Preço. Recurso gratuito; você paga as tarifas de tokens do Gemini, e escolher o nível de modelo certo é onde o custo mora.
4. Cloudflare Workers AI
A reviravolta interessante: isso é ao mesmo tempo uma alternativa ao Jev e o lugar onde o Jev realmente roda.
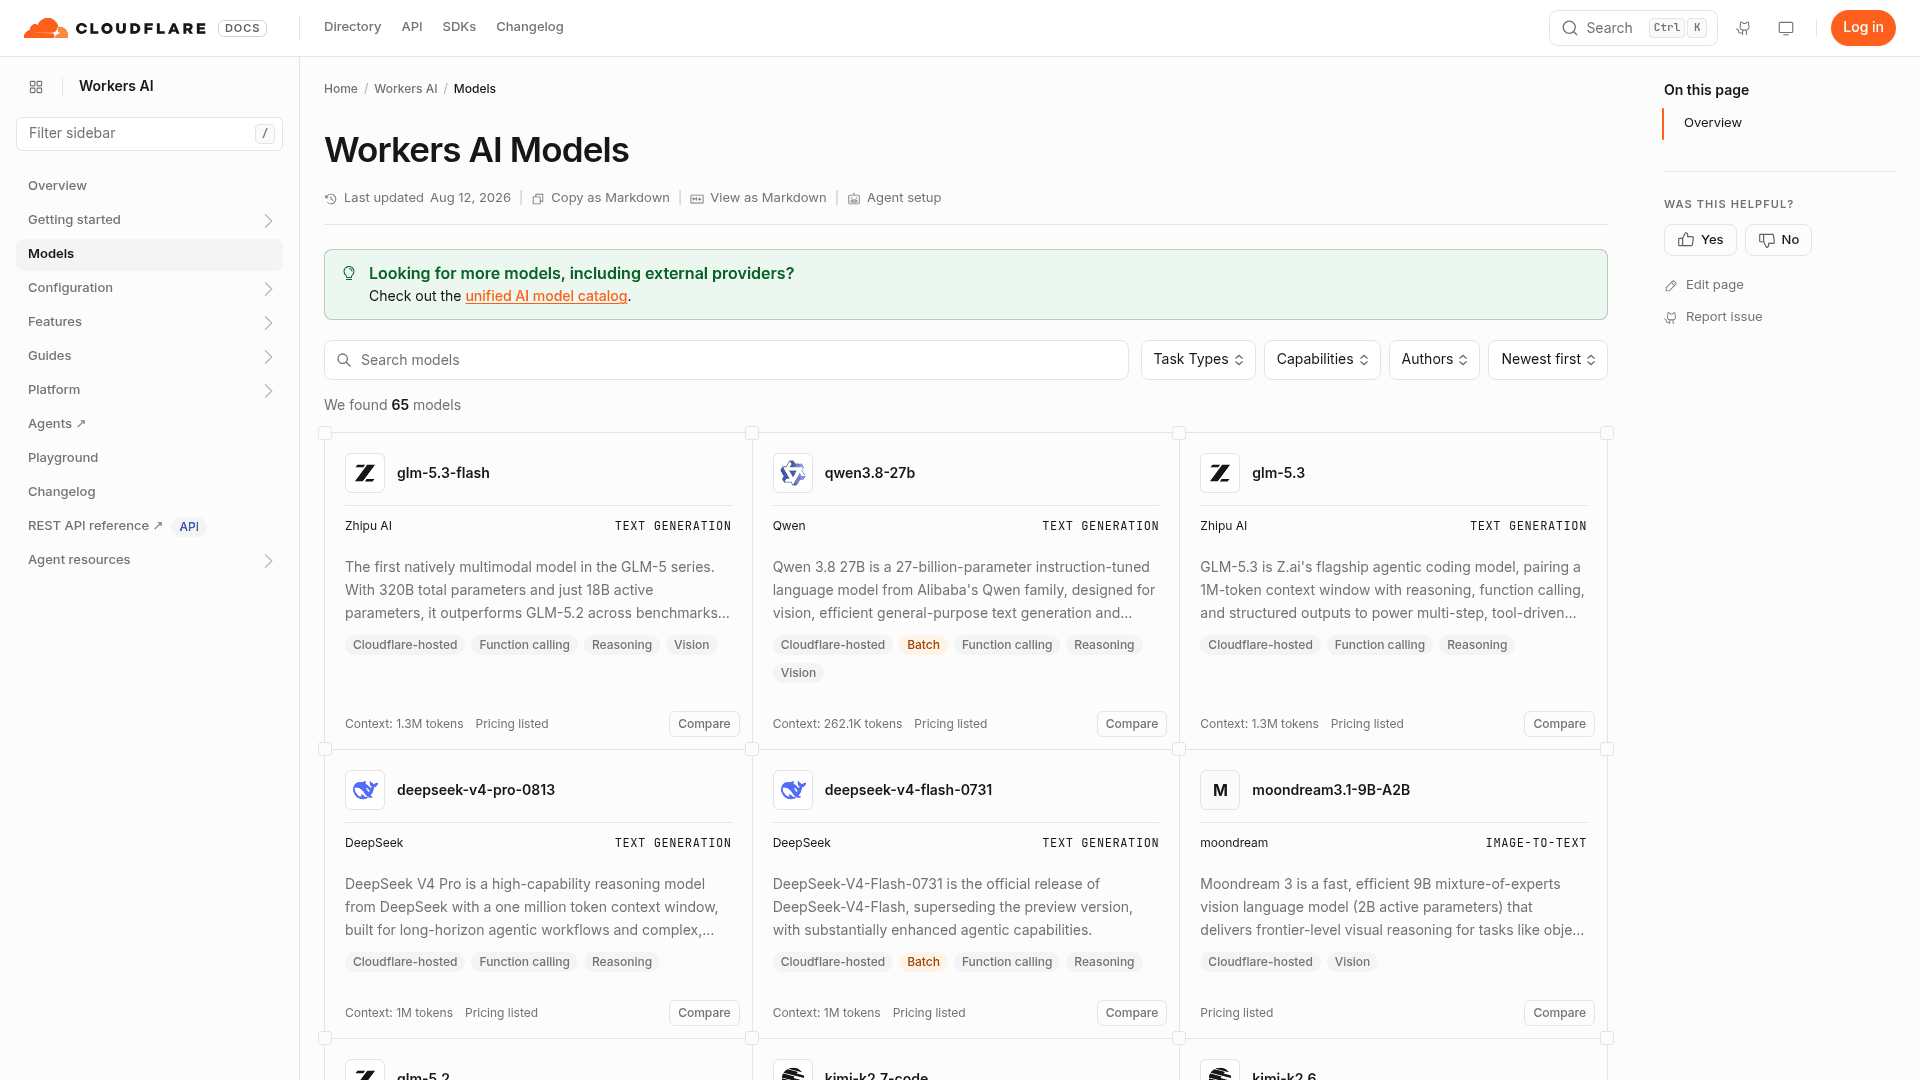
O que é. O Workers AI é o gateway de modelos serverless da Cloudflare, com um catálogo de mais de 65 modelos, muitos marcados para chamada de função e saídas estruturadas, rodando na edge. O Jev também está listado aqui, sob o id de modelo typesafe/jev.
Onde se encaixa. Apps de edge que querem um modelo pequeno e rápido perto do usuário, e equipes que querem uma única superfície de faturamento tanto para um modelo geral quanto para decisões no estilo Jev.
Pontos de atenção. A garantia de saída estruturada depende do modelo específico que você escolher, não do Workers AI em si. Trate-o como uma camada de distribuição e escolha o modelo pelos méritos.
Preço. Baseado em uso (cobrado em "Neurons") com uma alocação diária gratuita, e o faturamento do Jev na Cloudflare fica a cargo do painel da Cloudflare.
5. BAML
A melhor experiência de desenvolvedor entre as opções de biblioteca, e a que eu daria a uma equipe que odeia ficar mexendo em prompts.
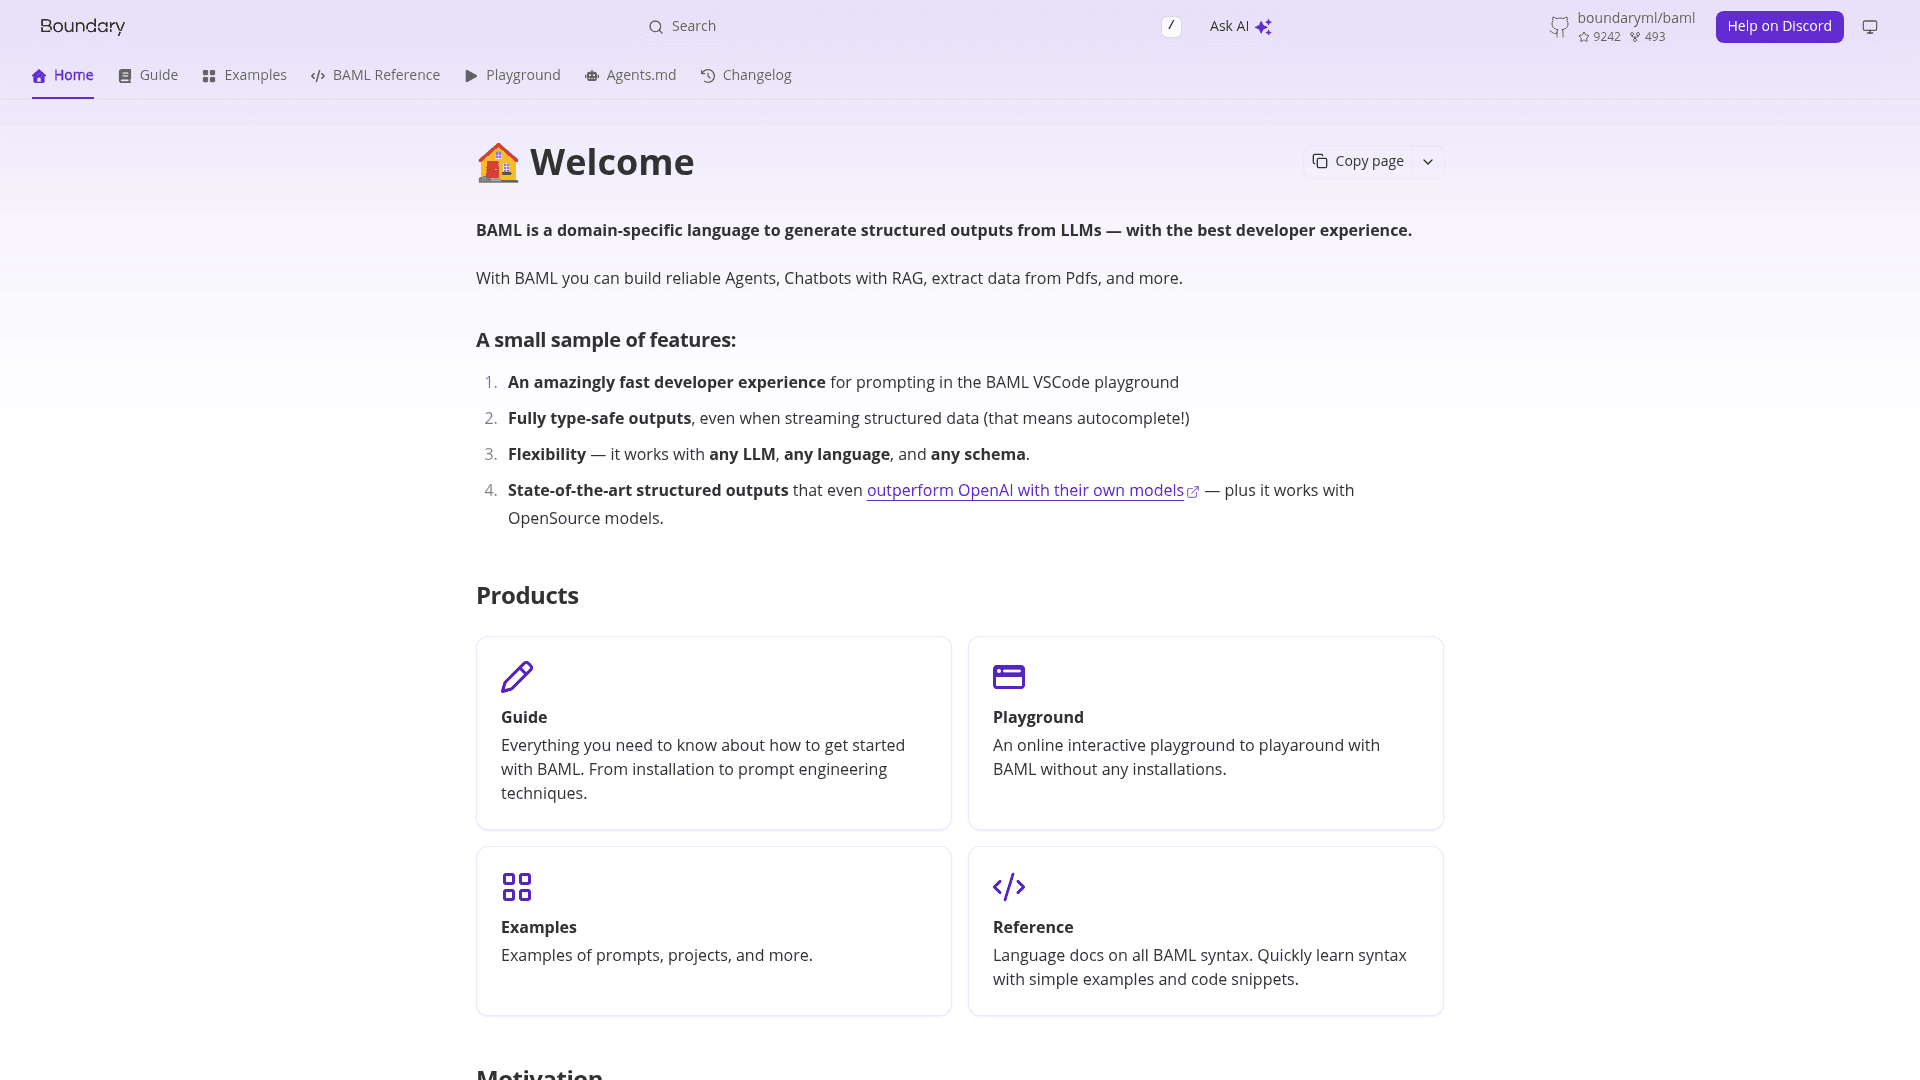
O que é. O BAML é uma linguagem específica de domínio para gerar saídas estruturadas de LLMs. Ele entrega saídas totalmente type-safe (mesmo durante o streaming), um playground interativo do VSCode, e funciona com qualquer LLM, qualquer linguagem e qualquer esquema. Tem cerca de 9.200 estrelas no GitHub.
Onde se encaixa. Equipes que querem prompt-para-objeto-tipado com autocompletar de verdade e um ciclo de edição rápido, seja qual for o modelo escolhido. Se você está construindo seu próprio agente de IA para helpdesk, o BAML é a camada que mantém a saída do modelo fiel aos seus tipos.
Pontos de atenção. O BAML dá segurança de tipos no momento da análise, mas o comportamento de confiança é herdado do modelo subjacente, então não é um mecanismo de decisão calibrado como o Jev afirma ser.
Preço. Grátis e de código aberto.
6. Instructor
A biblioteca mais adotada nesse espaço, e a forma mais rápida de ter extração tipada funcionando em Python.
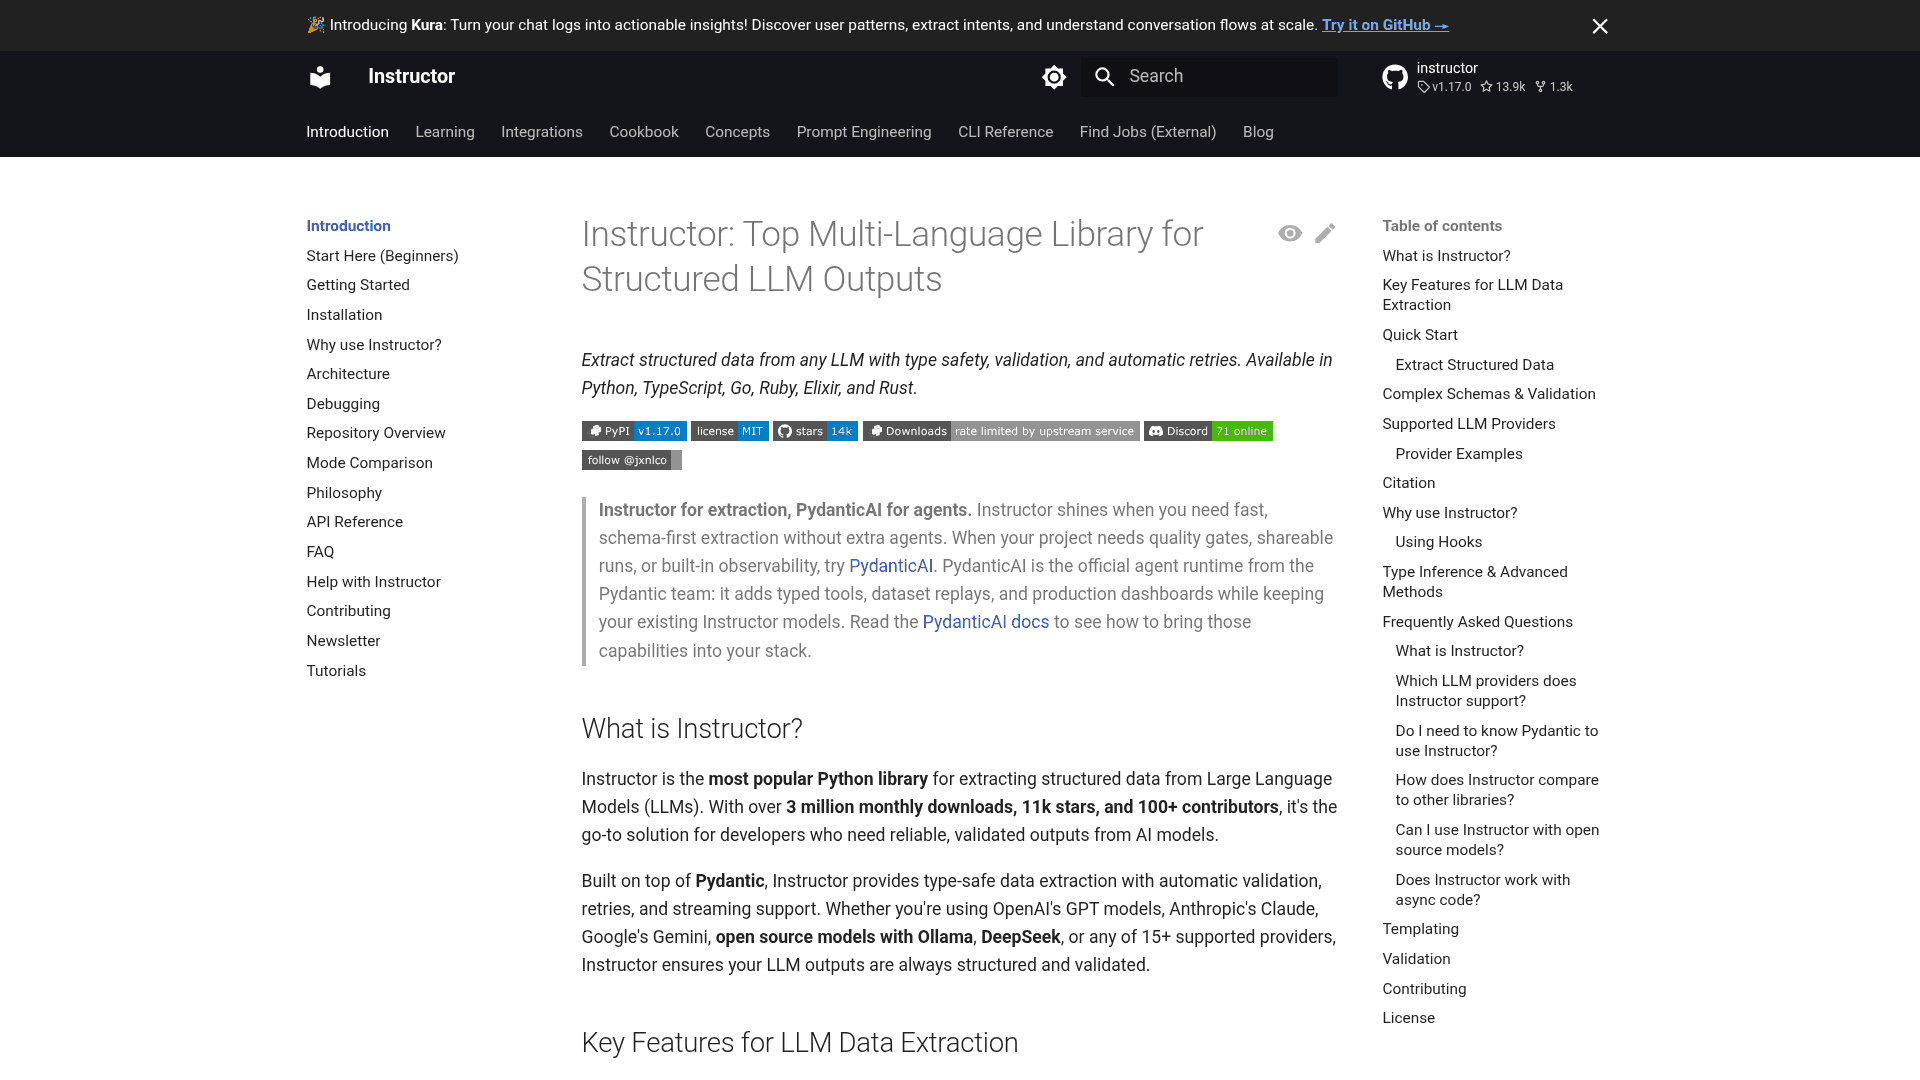
O que é. O Instructor extrai dados estruturados de qualquer LLM com segurança de tipos, validação e novas tentativas automáticas. É construído sobre o Pydantic, na v1.17.0, com cerca de 14 mil estrelas, 3 milhões de downloads mensais, mais de 100 colaboradores, e mais de 15 provedores suportados, incluindo Ollama e DeepSeek. Roda em Python, TypeScript, Go, Ruby, Elixir e Rust.
Onde se encaixa. Extração rápida e centrada em esquema, onde você quer validação e novas tentativas sem arrastar um framework de agentes.
Pontos de atenção. A própria documentação do Instructor é refrescantemente honesta ao dizer que ele é para extração; para runtimes de agentes mais pesados, ela indica o PydanticAI. E, como toda biblioteca aqui, ele padroniza a forma da saída, não a veracidade da resposta.
Preço. Grátis, licenciado sob MIT.
7. Outlines
A opção para quando você roda seus próprios modelos e quer a estrutura imposta no nível do token.
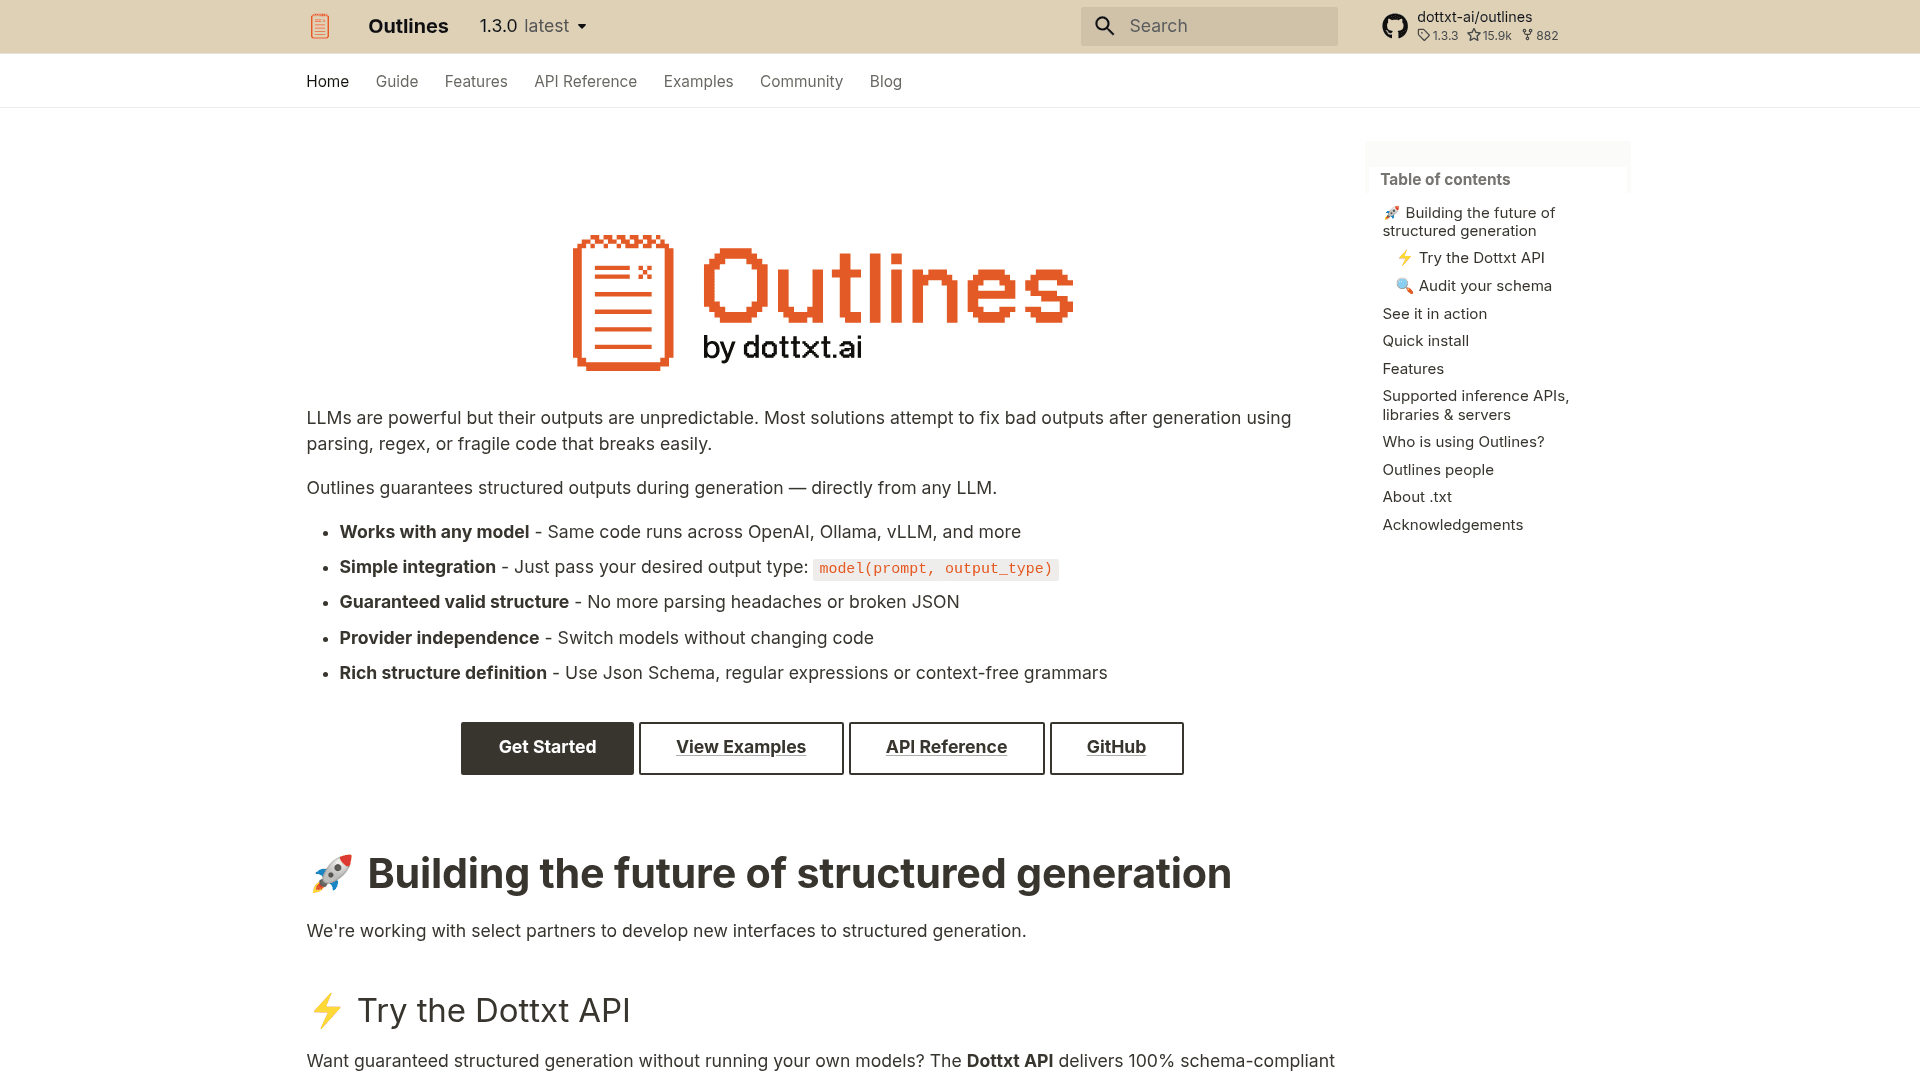
O que é. O Outlines garante saídas estruturadas durante a geração, diretamente de qualquer LLM, em vez de analisar ou corrigir com regex uma saída ruim depois. Funciona com OpenAI, Ollama e vLLM, suporta JSON Schema, expressões regulares e gramáticas livres de contexto, está na v1.3.0 com cerca de 15,9 mil estrelas, e se combina com uma API hospedada da Dottxt para geração 100% conforme ao esquema sem rodar seus próprios modelos.
Onde se encaixa. Modelos locais e auto-hospedados, e casos em que você precisa de uma gramática estrita, não só JSON.
Pontos de atenção. Impor estrutura no momento da decodificação é poderoso, mas de nível mais baixo; você está mais perto do metal do que com um recurso gerenciado, o que é exatamente o ponto ou um fardo, dependendo da sua equipe.
Preço. Código aberto e gratuito; a API hospedada da Dottxt é a opção paga.
8. Hugging Face AutoTrain
Se sua decisão é realmente estreita e de alto volume, a resposta mais barata a longo prazo pode ser um modelo que você treina e possui.
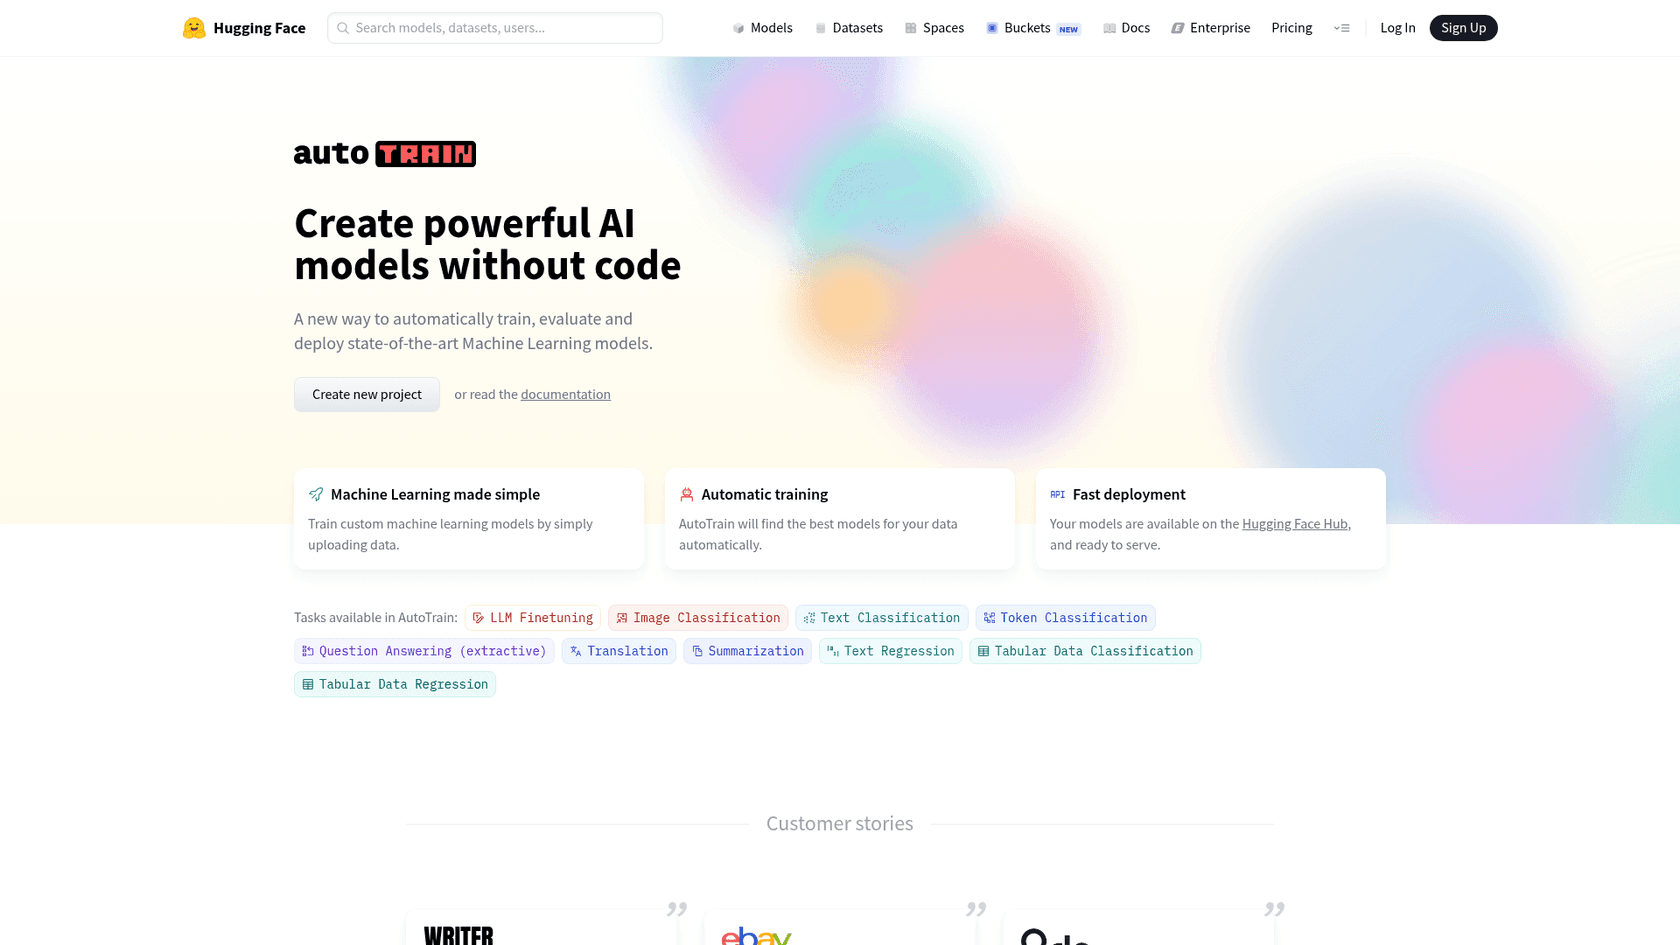
O que é. O AutoTrain é a forma sem código do Hugging Face de treinar, avaliar e implantar modelos ao fazer upload de dados. Sua lista de tarefas inclui Text Classification e Token Classification, e os modelos resultantes vivem no Hugging Face Hub, prontos para servir.
Onde se encaixa. Um conjunto de rótulos fixo e bem definido para o qual você tem dados de treinamento, como etiquetar tickets por código de motivo ou rotear por fila. Essa é a opção para a qual os comentaristas do HN sempre apontavam, argumentando que o Jev está perto de um pequeno classificador que você poderia reproduzir:
"It's a heavily constrained, tiny model that can only produce a probability score or a yes/no answer over pre-defined selections... I suspect someone will be able to recreate this within a week."
Pontos de atenção. Você é dono de todo o ciclo de vida: rotulagem, treinamento, drift, reimplantações. Um classificador treinado te dá uma probabilidade softmax limpa, mas ele só conhece as classes que você ensinou a ele, e o retreinamento fica por sua conta.
Preço. Você paga por tempo de computação; não há licença por decisão.
Qual você deveria realmente escolher?
Aqui está a decisão do jeito que eu guiaria um colega de equipe por ela.
O que cada uma dessas ainda te deve
Qualquer que seja a ferramenta escolhida, fique atento à diferença entre uma resposta válida e uma correta. Esse foi o ponto mais debatido na thread de lançamento do Jev, e se aplica às oito alternativas:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"
A reformulação útil da mesma thread é que uma pontuação de confiança só vale alguma coisa se estiver calibrada:
"What we would want to see is a confidence value that is in line with the actual correctness. If the value is 0.9 for 1000 different answers, then approximately 900 of those answers should be correct."
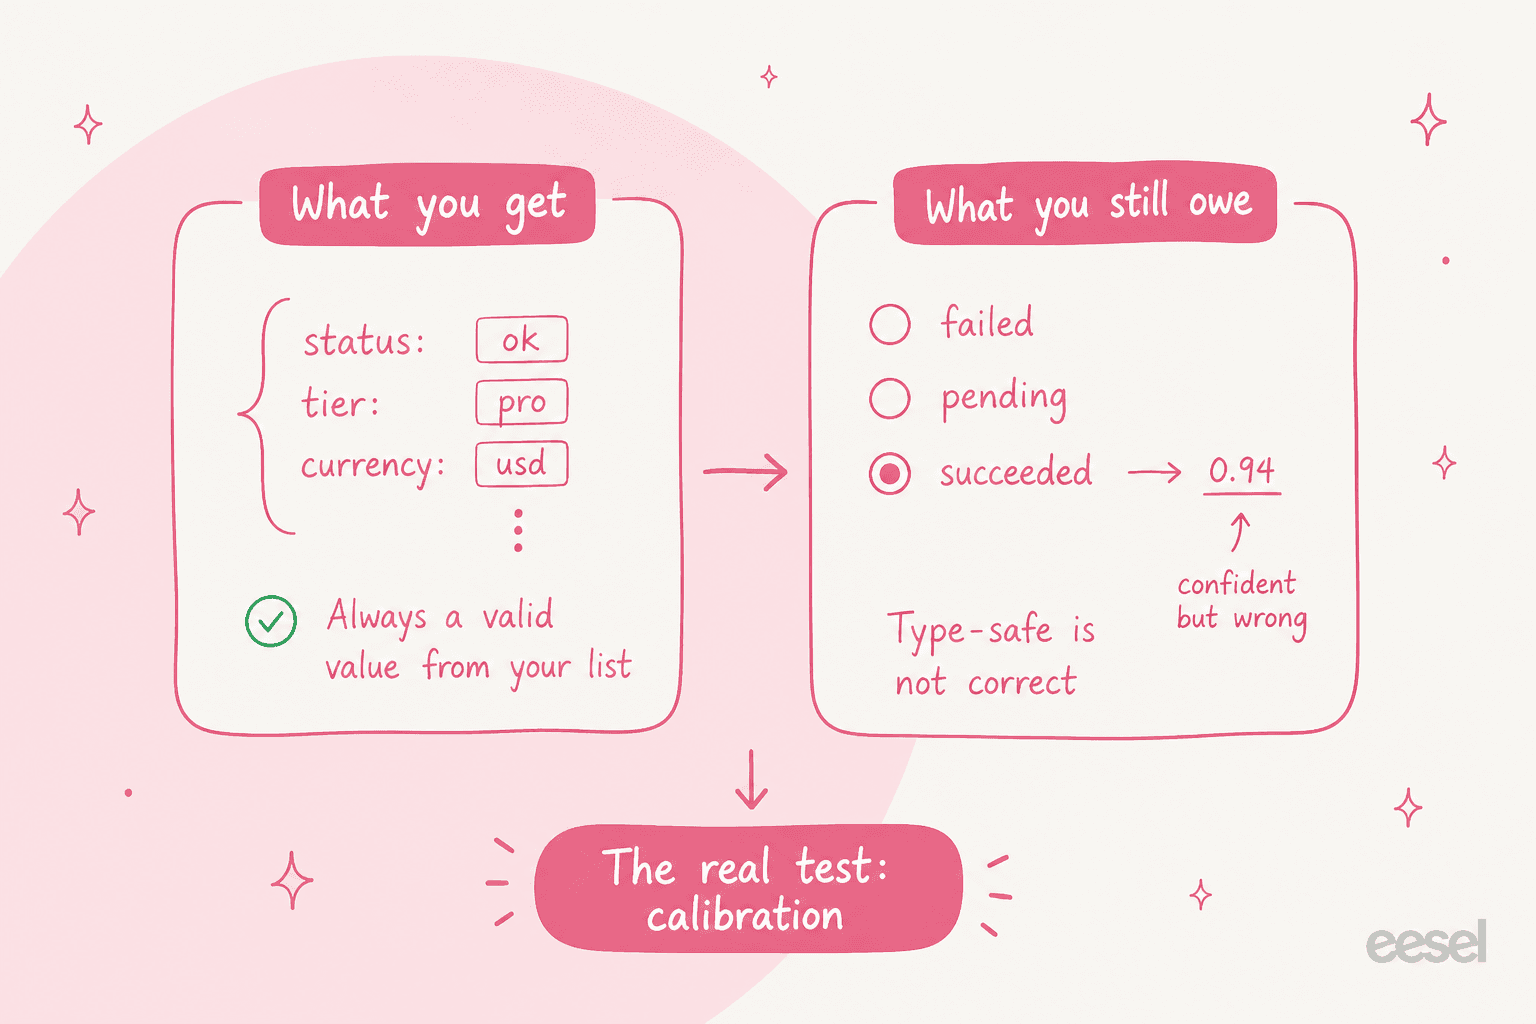
É por isso que, no lado do suporte, eu não confio em nenhuma camada de decisão até que ela tenha sido rodada contra os próprios tickets passados de uma equipe, a mesma disciplina que eu aplicaria ao escolher um LLM para suporte ou ao pré-selecionar os melhores agentes de suporte com IA. Um modelo que pontua 0,94 em uma chamada de roteamento não significa nada até você verificar que chamadas com 0,94 de confiança estão realmente certas 94% das vezes nos seus dados. Ainda assim, a empolgação é real, e onde ela aterrissa as pessoas são francas sobre isso:
"After much fumbling around with prompts and evals, this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... I think this is going to quickly become the new standard approach for agentic systems."
E em produção, a velocidade não é só hype. O CEO da Vercel reportou números reais:
"Jev is up to 18x faster (p95) and more accurate. It's coming to Vercel AI Gateway and likely new default."
Onde o eesel se encaixa em tudo isso
Toda ferramenta desta página é infraestrutura. Elas entregam ao seu código uma decisão tipada, e então seu código precisa fazer algo com ela. Essa é a forma certa se você está construindo um produto. É a forma errada se o seu trabalho é rodar uma fila de suporte e você esperava que um modelo de decisão fizesse isso.
O eesel é o funcionário, não o primitivo. O colega de IA para helpdesk lê sua central de ajuda e tickets passados, toma as mesmas decisões de triagem e roteamento que o Jev tomaria, e então redige, etiqueta, roteia e resolve dentro do seu helpdesk com IA existente. Você pode apontá-lo para o seu histórico e simular o lançamento antes de ele responder a um único cliente ao vivo, então a calibração é um passo que você dá, não uma afirmação em que você confia. E se o seu instinto é escriptar tudo, o mesmo colega de equipe pode ser controlado pela CLI do eesel e MCP.
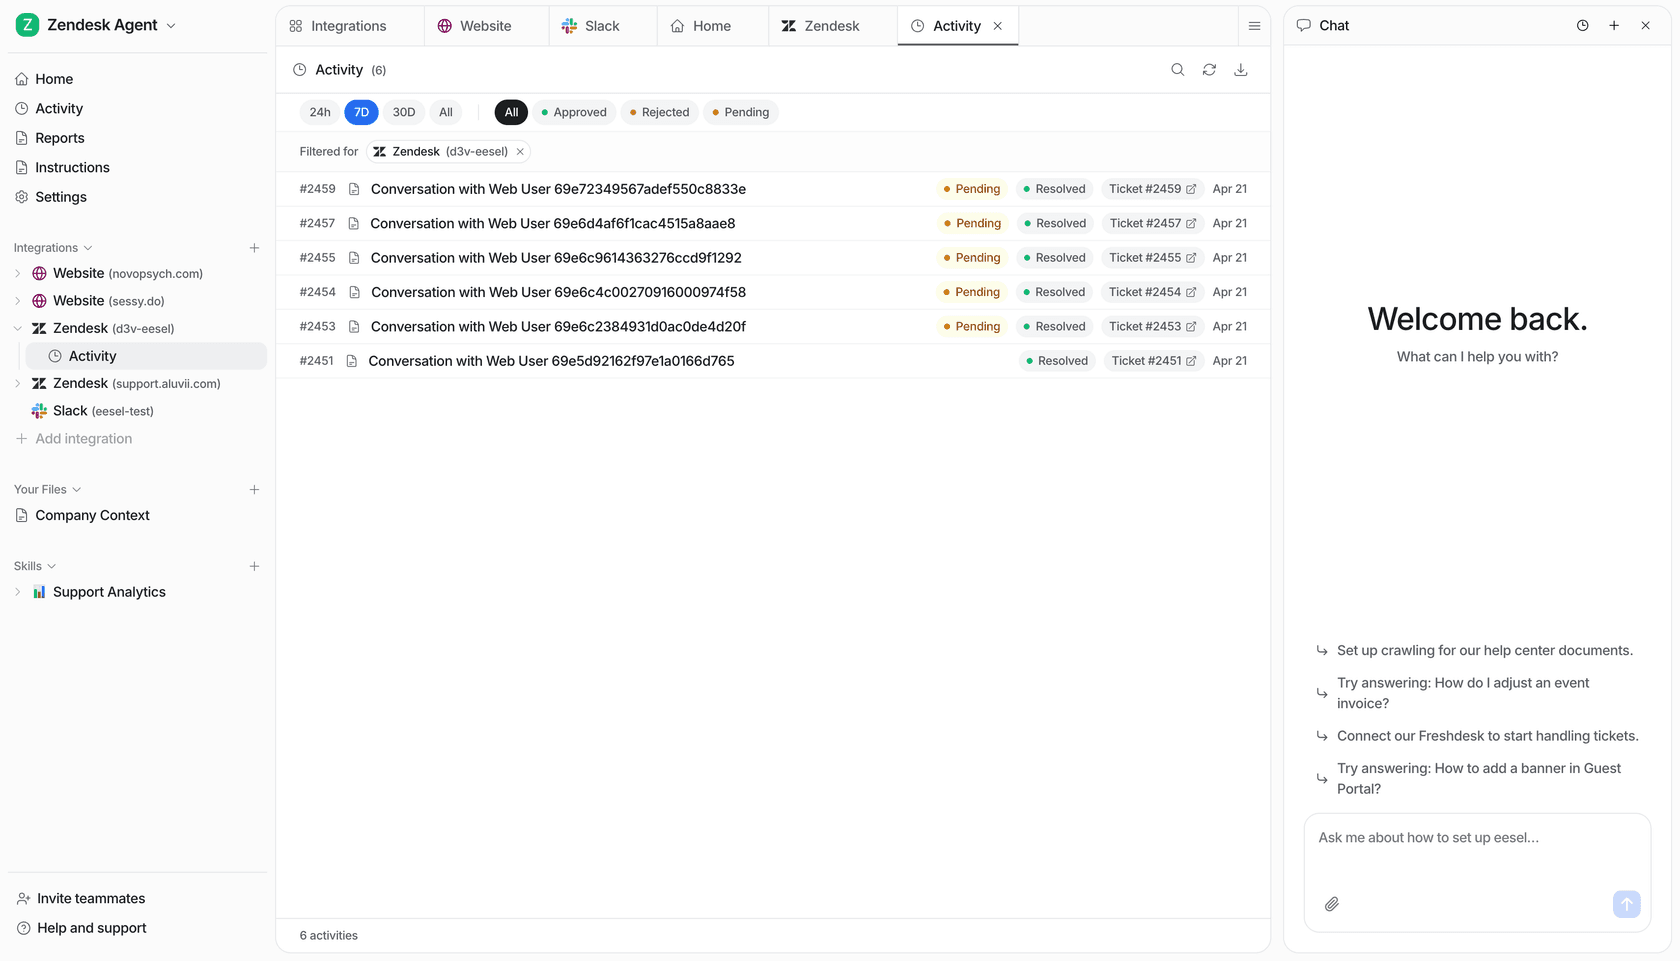
Se você está pesando entre o Jev ou uma de suas alternativas porque quer decisões de suporte mais rápidas e confiáveis, o caminho mais curto é experimentar a camada que já transforma essas decisões em tickets resolvidos, da mesma forma que um copiloto de IA redige ao lado dos seus agentes. Experimente o eesel grátis, ou agende uma demo e veja funcionando nos seus próprios tickets.
Perguntas frequentes
Perguntas frequentes
Quais são as melhores alternativas ao TypeSafe Jev?
As alternativas mais próximas do TypeSafe Jev são recursos de saída estruturada gerenciados como OpenAI Structured Outputs e Gemini structured output, bibliotecas de código aberto como BAML, Instructor e Outlines, e um classificador treinado via Hugging Face AutoTrain. Se você quer a decisão e a ação em um helpdesk, um agente de IA para atendimento ao cliente é a camada acima de todos eles.
Existe uma alternativa gratuita ao TypeSafe Jev?
Sim. Instructor (MIT) e Outlines (Apache-2.0) são bibliotecas gratuitas de código aberto, e as saídas estruturadas na OpenAI e no Gemini são um recurso gratuito além do preço normal por token. Você ainda paga pelo modelo que roda por baixo, então "grátis" se refere à camada de esquema, não à inferência.
Qual é a diferença entre o Jev e o OpenAI Structured Outputs?
O Jev é um modelo System One construído especificamente para pular a geração de texto e retornar uma decisão tipada mais uma pontuação de confiança calibrada em uma única passagem paralela. O OpenAI Structured Outputs é uma restrição aplicada sobre um modelo generativo normal, então você ainda paga a latência e o custo de geração, mas obtém todo o raciocínio de um LLM de fronteira. O Jev troca esse raciocínio por velocidade.
Quanto custam as alternativas ao TypeSafe Jev?
Varia conforme o tipo. As bibliotecas de código aberto são gratuitas e você paga apenas a tarifa de token do modelo subjacente. Recursos gerenciados como Gemini structured output custam a tarifa normal de tokens do Gemini (Flash-Lite é o nível mais barato). Um classificador treinado no Hugging Face custa tempo de computação. Para contexto, o próprio Jev lista a entrada a $0,042 por milhão de tokens com saída gratuita.
Essas alternativas conseguem rodar o atendimento ao cliente como o Jev?
Nenhuma delas roda o suporte sozinha, e o Jev também não. Todas retornam uma decisão sobre a qual seu próprio código precisa agir. Para transformar "este ticket é urgente, encaminhar para faturamento" em um ticket resolvido, você precisa de uma camada que também leia sua classificação de tickets, redija a resposta e execute a ação. Esse é o trabalho de um agente de IA para helpdesk, não de um primitivo de decisão.
Todas as alternativas ao TypeSafe Jev fornecem pontuações de confiança?
Não da mesma forma. O Jev é treinado com RLCD (Reinforcement Learning for Calibrated Decisions) para que suas probabilidades reflitam a precisão real. As opções baseadas em LLM expõem logits de token que você pode ler como uma confiança aproximada, e um classificador treinado fornece uma probabilidade softmax. O teste honesto para qualquer uma delas é a calibração com seus próprios dados, não o número em si.
Qual alternativa ao TypeSafe Jev é melhor para classificação?
Para classificação estreita e de alto volume, um classificador ajustado do Hugging Face é o mais barato por chamada, enquanto o Gemini structured output no Flash-Lite é o mais rápido de colocar em produção. Para trabalho específico de suporte, como triagem e roteamento, um fluxo de atendimento ao cliente com IA que já conecta a classificação a ações economiza o código de ligação.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.