8 melhores alternativas ao Claude Opus 5.5 em 2026 (mais baratas, mais rápidas, abertas)

Kurnia Kharisma Agung Samiadjie

Katelin Teen
Última edição September 23, 2026
Por que as pessoas olham além do Claude Opus 5.5
Primeiro, a parte justa. O Opus 5.5 merece a sua reputação. É construído para programação agêntica de longa duração e trabalho de conhecimento, lida com ambiguidade sem muita ajuda, e ocupa o número um do Artificial Analysis Intelligence Index com uma pontuação de 58. A Anthropic até baixou o preço dos $5/$25 do Opus 5 para $4/$20, uma concessão genuína e não forçada aos compradores. Se já está profundamente envolvido no Claude Code e o trabalho é genuinamente difícil, manter-se é uma decisão defensável.
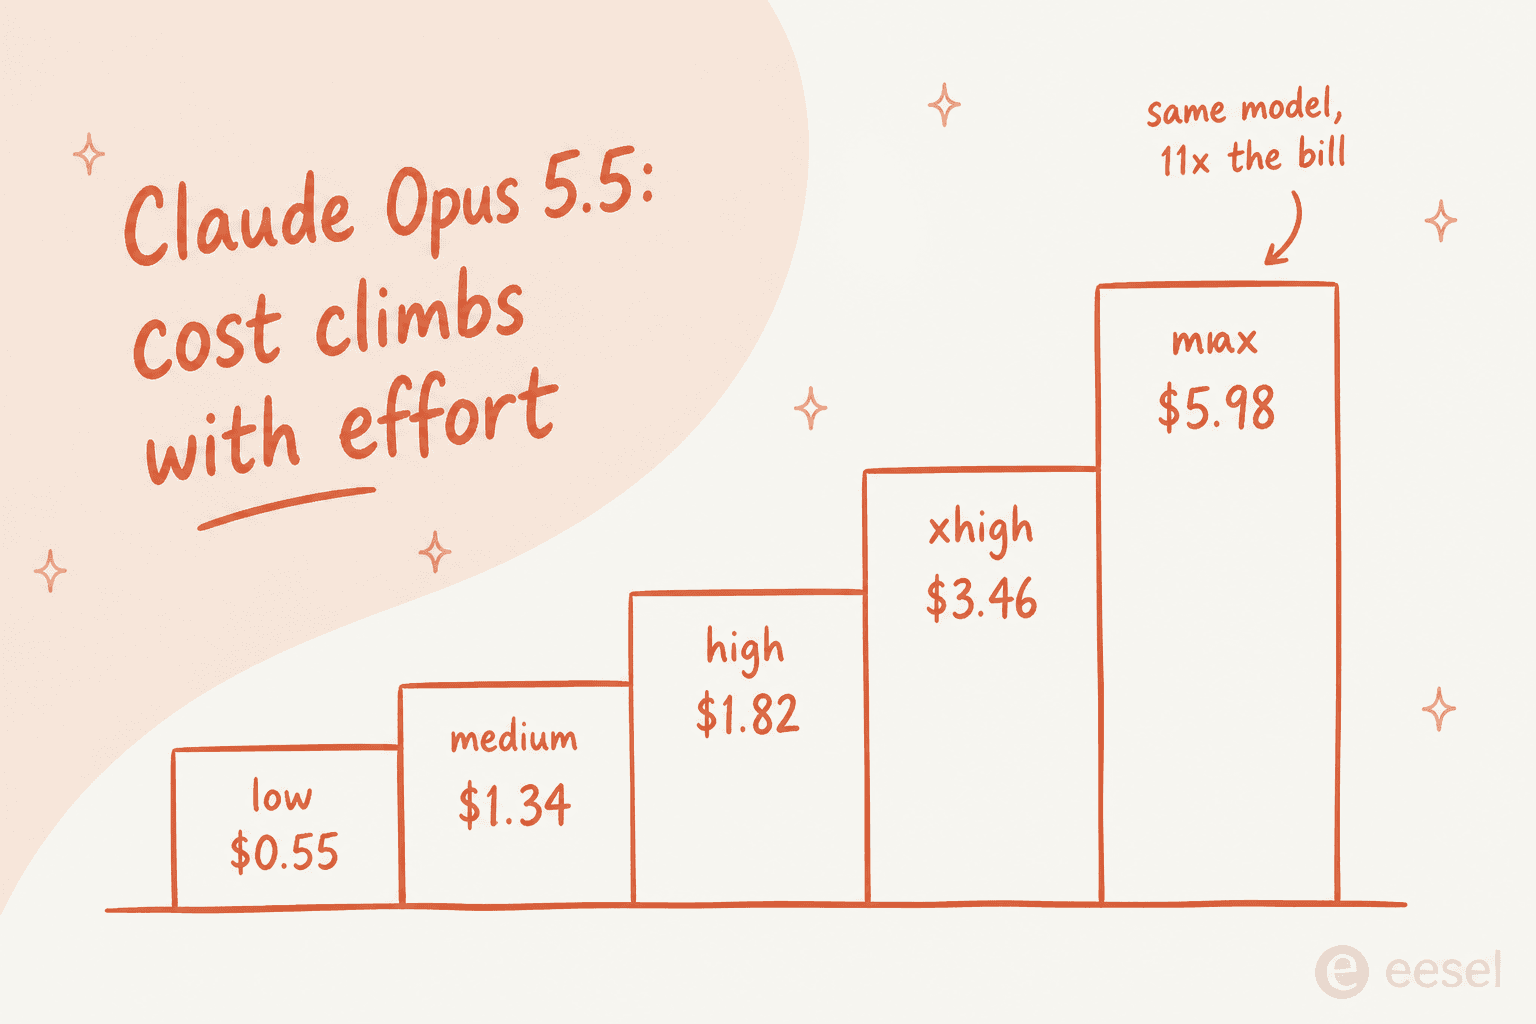
Passei os últimos anos a colocar IA em filas de suporte ao cliente ao vivo, e o que mais me surpreendeu nos modelos de fronteira não foi a qualidade, foi que a conta acompanha muito mais o seletor de esforço do que o preço de tabela. O Opus 5.5 é um exemplo perfeito. A tarifa por token está na média, mas o custo por tarefa oscila entre cerca de $0.55 com esforço baixo e $5.98 no máximo, porque com esforço alto raciocina por mais tempo e emite mais tokens.
Assim, os motivos pelos quais as pessoas vão às compras costumam ser um de quatro:
- Custo por tarefa concluída. Um modelo que pontua alguns pontos abaixo mas custa uma quinta parte por tarefa é a melhor compra para a maioria das cargas de trabalho.
- Velocidade. O Opus é ponderado. Para qualquer coisa em que um humano espera, como uma resposta de chat, a latência importa mais do que um benchmark.
- Pesos abertos. Algumas equipas precisam de autoalojamento por privacidade, soberania ou controlo de custos.
- Amplitude multimodal ou contexto. Áudio, vídeo, ou uma janela de contexto genuinamente enorme pode ser a característica decisiva.
Eis como as oito alternativas que eu realmente consideraria se comparam antes de entrarmos em cada uma delas.
As alternativas ao Claude Opus 5.5 num relance
| Modelo | Melhor para | Preço /1M (entrada / saída) | Contexto | Pesos abertos | Visão nativa |
|---|---|---|---|---|---|
| Claude Opus 5.5 (atual) | Programação agêntica mais difícil | $4 / $20 | ~1M | Não | Sim |
| GPT-6 Sol | Qualidade de fronteira, mais barato por tarefa | $2 / $10 | 1,05M | Não | Sim |
| Gemini 3.8 Flash | Multimodal barato em escala | $0.75 / $3.75 | 1M | Não | Sim (+ áudio/vídeo/PDF) |
| Grok 4.7 | Loops de agentes de alto volume | $2 / $6 | 500K | Não | Sim |
| Qwen 3.8 Max | Valor multimodal, base aberta | $2 / $6 | 1M | Só a base | Sim |
| Kimi K3 | Pesos abertos com visão | $3 / $15 | 1M | Sim | Sim |
| DeepSeek V4 Flash | O piso de custo | ~$0.22 / $0.66 | 1M | Sim (MIT) | Não |
| GPT-6 Luna | O mais barato em escala | $0.10 / $0.50 | 1,05M | Não | Sim |
| Claude Sonnet 5 | Ficar na família Claude | $2 / $10 | ~1M | Não | Sim |
Os preços são as tarifas de tabela padrão para contexto curto por milhão de tokens, verificadas em setembro de 2026. O número do DeepSeek é a tarifa fora de pico para entrada com falha de cache e a tarifa de saída padrão. A tarifa do Gemini 3.8 Flash é promocional até 31 de dezembro de 2026, depois duplica.
Uma nota rápida sobre como escolhi. Isto é uma lista curta, não um catálogo, por isso pesei três coisas: um preço real e verificável (por token e, onde a Artificial Analysis mediu, por tarefa), como o modelo se comporta de facto face ao seu marketing, e se preenche uma lacuna que o Opus 5.5 deixa em aberto. Tudo o que era apenas "Opus mas ligeiramente pior ao mesmo preço" não entrou.
1. GPT-6 Sol: o rival de fronteira mais próximo, a um quinto do custo
Melhor para: equipas que querem qualidade quase de fronteira mas não conseguem suportar a conta por tarefa do Opus 5.5.
O GPT-6 Sol foi lançado a 23 de setembro de 2026, um dia depois do Opus 5.5, e é a comparação mais direta desta lista. Tem uma janela de contexto de 1.050.000 tokens, entrada de imagem nativa, e o conjunto completo de ferramentas OpenAI Responses, incluindo pesquisa web, interpretador de código, shell alojada, uso do computador e MCP.
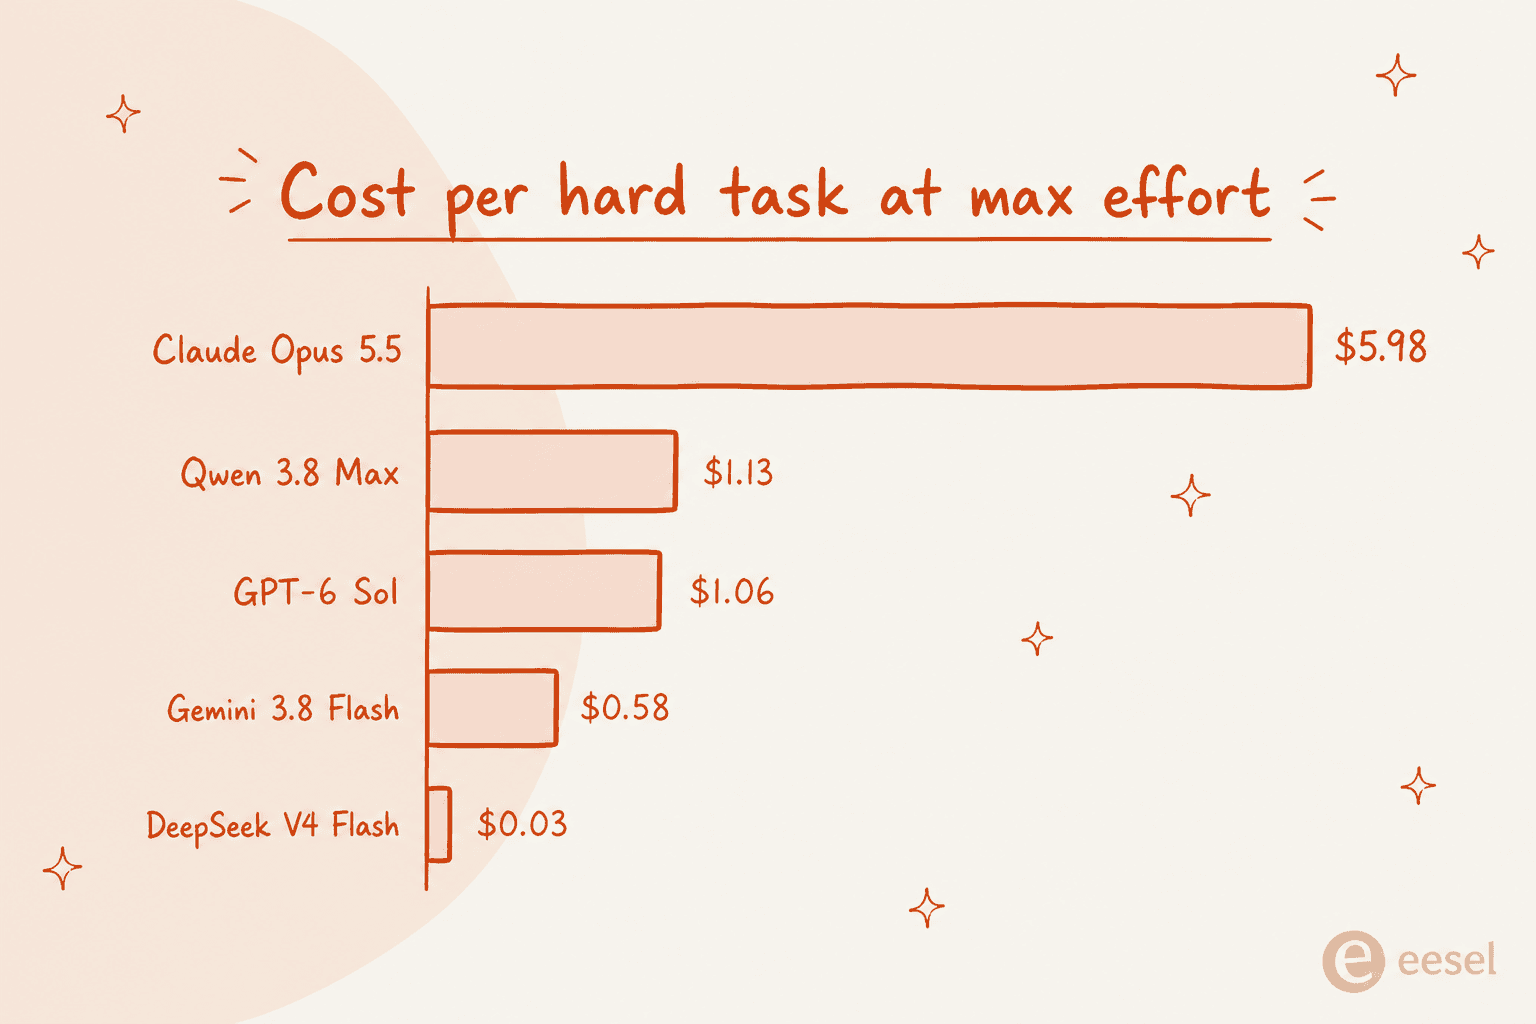
Em inteligência bruta, o Opus vence: a Artificial Analysis pontua o Sol em 48 no seu Intelligence Index contra os 58 do Opus 5.5. Mas veja o que custa cada ponto. O Sol custa $2/$10 por milhão de tokens, metade do Opus, e no esforço máximo termina uma tarefa difícil por cerca de $1.06 contra os $5.98 do Opus, em parte porque emite muito menos tokens de saída. Esse é o número mais marcante de todo este artigo.
Há um debate real sobre se essa diferença vale a pena, e a comunidade está dividida. Eis um testador experiente no tópico de lançamento:
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

Prós: cerca de 5 vezes mais barato por tarefa no esforço máximo, prosa padrão mais limpa, uma janela de contexto enorme, e uma melhoria genuína na factualidade (a OpenAI reporta cerca de metade dos erros do Sol anterior; a taxa de alucinação no esforço máximo caiu de 92% para 60% segundo a Artificial Analysis).
Contras: um teto de raciocínio mais baixo do que o Opus 5.5, e não está no plano gratuito do ChatGPT, por isso o acesso casual implica um plano pago.
Veredicto: para a maioria das cargas de trabalho de construir um agente, o Sol é a compra mais inteligente. Abdica-se de uma fatia do raciocínio máximo e recupera-se a maior parte em velocidade e orçamento. Se está a correr muitas tarefas e a vigiar a fatura, comece por aqui.
2. Gemini 3.8 Flash: a opção barata e genuinamente multimodal
Melhor para: trabalhos de alto rendimento que precisam de entrada de áudio, vídeo ou PDF com orçamento apertado.
O Gemini 3.8 Flash é o terceiro lançamento Flash da Google em seis semanas, e faz algo curioso: supera o Opus 5.5 no Artificial Analysis Intelligence Index (59 contra 58) enquanto custa uma fração, a $0.75/$3.75 por milhão de tokens até ao final de 2026. É também o único modelo aqui que ingere nativamente imagem, áudio, vídeo e PDF, com uma janela de entrada de 1M de tokens.
As ressalvas honestas importam, contudo. O tempo até ao primeiro token é de 13,30s contra uma mediana de classe perto de 3s, por isso fica desqualificado para qualquer coisa em que um humano espera ao vivo e é perfeito para um lote noturno. Também é verboso, e a própria Google diz no post de lançamento que cargas de trabalho focadas em eficiência devem ficar no 3.7 Flash. Em preço e alcance multimodal é excelente; em capacidade de resposta, não é.
Prós: pontuação de Intelligence Index ao nível de fronteira, os tipos de entrada mais amplos da lista, muito barato, e um plano gratuito para testar.
Contras: primeiro token lento, saída verbosa que corrói a vantagem de preço, e uma duplicação de preço para $1.50/$7.50 já agendada para 1 de janeiro de 2027.
Veredicto: se a sua carga de trabalho é assíncrona e multimodal, este é possivelmente o melhor custo-benefício da página. Só não o coloque atrás de um widget de chat ao vivo onde o atraso de 13s no primeiro token se vai notar. Para a diferença entre um agente assíncrono e um em tempo real, o nosso artigo sobre agentes de IA versus chatbots baseados em regras é um enquadramento útil.
3. Grok 4.7: precificado para viver dentro de loops de agentes
Melhor para: programação agêntica de alto volume e várias horas onde o custo por token se acumula.
O Grok 4.7 foi lançado a 21 de setembro de 2026, construído sobre um modelo base maior do que o 4.6 com uma execução de aprendizagem por reforço mais longa orientada para tarefas de várias horas. Custa $2/$6 por milhão de tokens abaixo de um prompt de 200K, a tarifa de saída mais barata de qualquer modelo de nível fronteira aqui, e tem uma janela de contexto de 500K mais uma nova API de Context Compaction para sessões longas.
A história dos benchmarks é "adjacente à fronteira a preços do ano passado". Na própria tabela da xAI, o Grok 4.7 regista um Terminal-Bench 4.0 de 37.6 (quase o dobro do 20.3 do 4.6), EEBench 64.0, e uma pontuação de Harvey Legal Agent de 19.6 que na verdade supera tanto o Sol como modelos de classe Opus. No entanto, não vence em tudo. No HealthBench Professional pontua 56.7, atrás tanto do GPT-6 Sol como do nível superior da Anthropic.
Prós: a tarifa de saída baixa torna-o bem adequado para loops que consomem tokens, um salto real nos benchmarks de programação e terminal, e a stack de segurança mais forte da xAI até agora.
Contras: uma janela de contexto de 500K que é metade da dos rivais de 1M de tokens, a sobretaxa de contexto longo ($4/$12) aplica-se a cada token do pedido assim que se ultrapassam os 200K, e perde para a fronteira em saúde e alguns testes de raciocínio.
Veredicto: se está a montar um agente de programação que corre durante horas e se importa mais com o medidor por token do que com os últimos pontos de raciocínio, o Grok 4.7 é uma escolha sólida e honesta. Há também uma CLI da xAI se quiser conduzi-lo a partir do terminal.
4. Qwen 3.8 Max: Intelligence Index de nível fronteira, metade do preço
Melhor para: equipas que querem uma pontuação de Intelligence de classe Opus com uma base descarregável como reserva.
O Qwen 3.8 Max tornou-se disponível ao público a 2 de agosto de 2026, e é discretamente um dos modelos de fronteira com melhor custo-benefício. É um modelo de mistura de especialistas de 2,4T total / 95B ativos com contexto de 1M de tokens, precificado a $2/$6 por milhão de tokens na cloud da Alibaba. No painel da Artificial Analysis ocupa agora a sexta posição com um Intelligence Index de 58.08, praticamente ao nível do número principal do Opus 5.5, por uma fração do custo.
A nuance é que os índices automatizados e a preferência humana discordam aqui. No LMArena, o Qwen 3.8 Max é forte em preferência cega: Texto #5, WebDev #4 e Vision #2. Mas o índice composto e os votos humanos apontam em direções ligeiramente diferentes, por isso nunca daria um veredito de número único sobre ele. Note também que os pesos base abertos existem mas não são equivalentes em funcionalidades ao Max alojado, que adiciona visão, modo sem raciocínio e ferramentas integradas.
Prós: Intelligence Index de nível fronteira a $2/$6, excelentes classificações multimodais no LMArena, e uma base aberta para equipas que querem uma opção de autoalojamento.
Contras: os pesos abertos têm uma licença que não é Apache e não têm as funcionalidades do modelo alojado, e a diferença entre pontuação automatizada e humana significa que deve testar nas suas próprias tarefas.
Veredicto: uma escolha subestimada. Se quer algo que pontue perto do Opus 5.5 por menos, e se sente confortável a fazer as suas próprias avaliações em vez de confiar num único número, o Qwen 3.8 Max merece um lugar na sua lista curta.
5. Kimi K3: pesos abertos que realmente veem
Melhor para: equipas que querem um modelo de fronteira genuinamente aberto e capaz de visão.
O Kimi K3 é o carro-chefe da Moonshot AI, um modelo de mistura de especialistas de 2,8T total / 104B ativos com contexto de 1M de tokens e visão nativa (imagem e vídeo). Crucialmente, os pesos abertos foram lançados a tempo, a 27 de julho de 2026, e o índice de safetensors confirma a contagem de 2,8T de parâmetros de forma independente do comunicado de imprensa. No Artificial Analysis Intelligence Index situa-se em 57, na mesma vizinhança do Opus 5.5.
A precificação é de $3/$15 por milhão de tokens, o que corresponde à faixa do Claude Sonnet em vez do nível de saldo. Uma peculiaridade que vale a pena conhecer: o raciocínio não pode ser desativado. O controlo reasoning_effort tem agora níveis low e high, mas são um controlo de latência, não um nível de custo, já que cada nível é faturado da mesma forma. Também não é aceite um URL de imagem público; passa-se base64 ou um ID de ficheiro.
Prós: pesos verdadeiramente abertos com visão, uma pontuação de Intelligence próxima da fronteira, e sólidos resultados agênticos e de BrowseComp.
Contras: precificado como o Sonnet em vez de como os modelos abertos baratos, raciocínio que não pode ser desativado, e manuseamento de imagens que precisa de base64 em vez de URLs.
Veredicto: a escolha quando "pesos abertos" e "lida com imagens" têm de ser ambos verdadeiros. Se só precisa de um deles, o DeepSeek é mais barato e o Qwen pontua mais alto, por isso o Kimi K3 é uma escolha específica em vez de uma opção padrão.
6. DeepSeek V4: o piso de custo, com um asterisco
Melhor para: o custo por token mais baixo absoluto, e equipas que querem pesos com licença MIT.
O DeepSeek V4 Flash é a forma mais barata de correr um modelo capaz nesta lista, ponto final. É um modelo de mistura de especialistas de 284B total / 13B ativos com contexto de 1M de tokens e pesos abertos MIT, e na Artificial Analysis pontua um Intelligence Index de 50 por cerca de $0.03 por tarefa no esforço máximo, o que não é um erro de escrita.
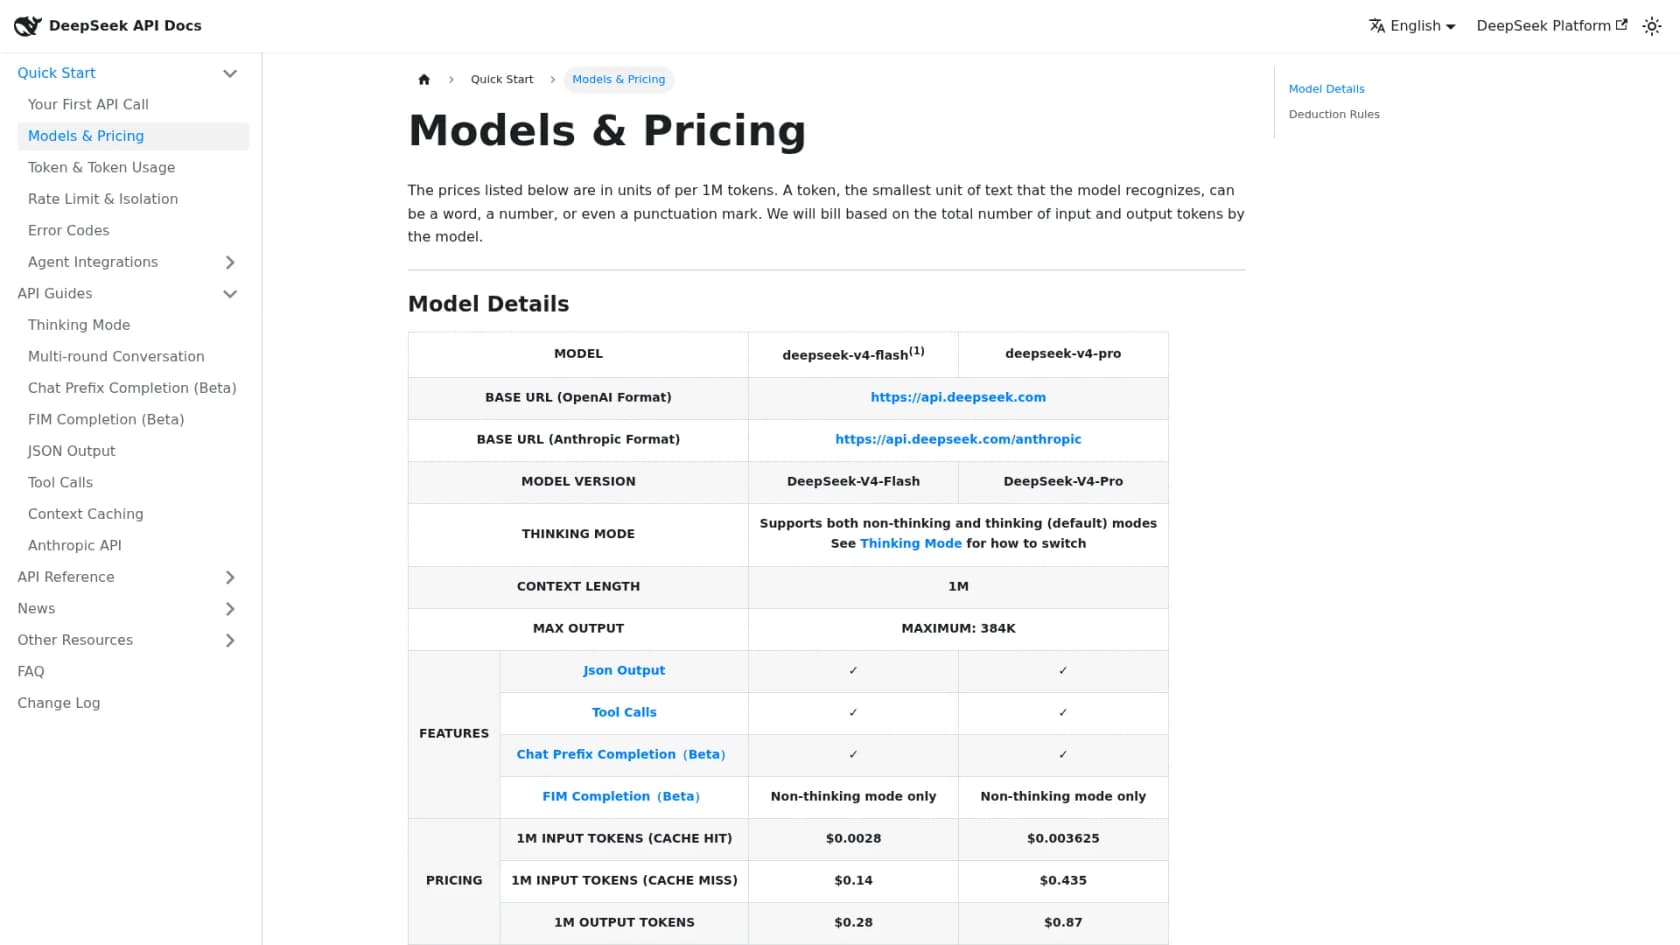
Os asteriscos são reais e vale a pena declará-los com clareza. A precificação tem uma sobretaxa de pico/fora de pico: a entrada com falha de cache é $0.22/$0.44 e a saída $0.66/$1.32 por milhão (fora de pico / pico), onde o pico corresponde ao horário comercial chinês, por isso uma fila dos EUA ou da UE é maioritariamente faturada fora de pico. O modelo é apenas texto, sem entrada de imagem documentada. E os seus dados residem na RPC sob a lei da RPC, enquanto os termos da API paga são omissos, não permissivos, quanto ao uso para treino. Essa combinação torna-o uma má opção de substituição direta para dados de clientes regulados, mesmo sendo um motor fantástico para código e ferramentas internas. Um developer colocou o caso prático sem rodeios:
I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it. I use it as a coding assistant in my IDE so the results end up at the same quality I would write by hand.
Prós: o custo por tarefa mais baixo de qualquer lugar, pesos abertos com licença MIT, e um contexto de 1M de tokens.
Contras: apenas texto, verboso com uma alta taxa de alucinação, uma peculiaridade frágil de preços de pico, e residência de dados na RPC que o exclui para dados sensíveis de clientes.
Veredicto: o campeão de custo-benefício para código e trabalho interno onde os dados não são sensíveis. Combine-o com o nosso guia sobre alucinações de IA antes de o apontar a algo de contacto com o cliente.
7. GPT-6 Luna: a forma mais barata de escalar
Melhor para: trabalho de alto volume e menor risco onde alguns pontos de inteligência não mudam o resultado.
O GPT-6 Luna é o nível económico da OpenAI, e é agressivamente barato a $0.10/$0.50 por milhão de tokens, um corte plano de 50% face ao GPT-5.6 Luna. Partilha o contexto de 1.050.000 tokens do Sol e a entrada de imagem nativa, e é o único modelo GPT-6 disponível nos planos gratuito e Go ($8) do ChatGPT. O próprio enquadramento da OpenAI é "construa com o Sol, escale com o Luna", e o mercado parece concordar; o Luna anterior já era o modelo mais usado no OpenRouter.
6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model.
O contraponto honesto é que "mais barato por token" e "mais barato por tarefa" não são a mesma coisa. Em fluxos de programação fortemente cacheados, alguns developers descobrem que modelos abertos como o DeepSeek acabam por sair mais baratos devido ao diferencial de leitura de cache, por isso faça as suas próprias contas se o caching domina o seu uso.
Prós: a opção mais barata da família fronteira fechada, uma janela de contexto grande, e acesso gratuito para testar.
Contras: o teto de raciocínio mais baixo da linha GPT-6, e contas por tarefa que podem perder para modelos abertos em trabalhos intensivos em cache.
Veredicto: a ferramenta certa para volume, classificação, tradução e passos de agente simples. Não é o modelo a que entrega a sua tarefa de raciocínio mais difícil, mas é um excelente cavalo de batalha e uma ótima opção padrão para os 80% aborrecidos.
8. Claude Sonnet 5: fique na família, pague metade
Melhor para: equipas que gostam do tooling e do ecossistema Claude mas não precisam do Opus em cada chamada.
Se o motivo pelo qual está no Opus 5.5 é o ecossistema Claude, o Claude Sonnet 5 é a alternativa interna óbvia. Custa $2/$10 por milhão de tokens, exatamente metade do Opus, e a Anthropic posiciona-o como o melhor equilíbrio entre velocidade e inteligência. Mantém a mesma API, a mesma integração com o Claude Code e o mesmo ecossistema de ferramentas; apenas deixa de pagar tarifas do Opus por tarefas que não precisam do raciocínio do Opus.
O padrão mais sensato que já vi é uma configuração de dois modelos: encaminhar as tarefas difíceis e ambíguas para o Opus 5.5 e tudo o resto para o Sonnet 5. Isso capta a maior parte do teto do Opus nas tarefas que precisam dele, enquanto corta a conta nas que não precisam.
Prós: metade do preço do Opus, sem mudança de ecossistema, e o nível da Anthropic ajustado para a velocidade.
Contras: um teto de raciocínio mais baixo do que o Opus 5.5, e continua dentro dos preços de um único fornecedor.
Veredicto: a alternativa com menos fricção desta lista. Se está satisfeito com o Claude e só quer gastar menos, esta é a mudança a fazer antes de procurar noutro lugar.
Como eu realmente escolheria
Retire a tabela de classificação e a decisão resume-se a algumas perguntas honestas. Não há um único vencedor, porque "melhor" depende da forma da sua carga de trabalho.
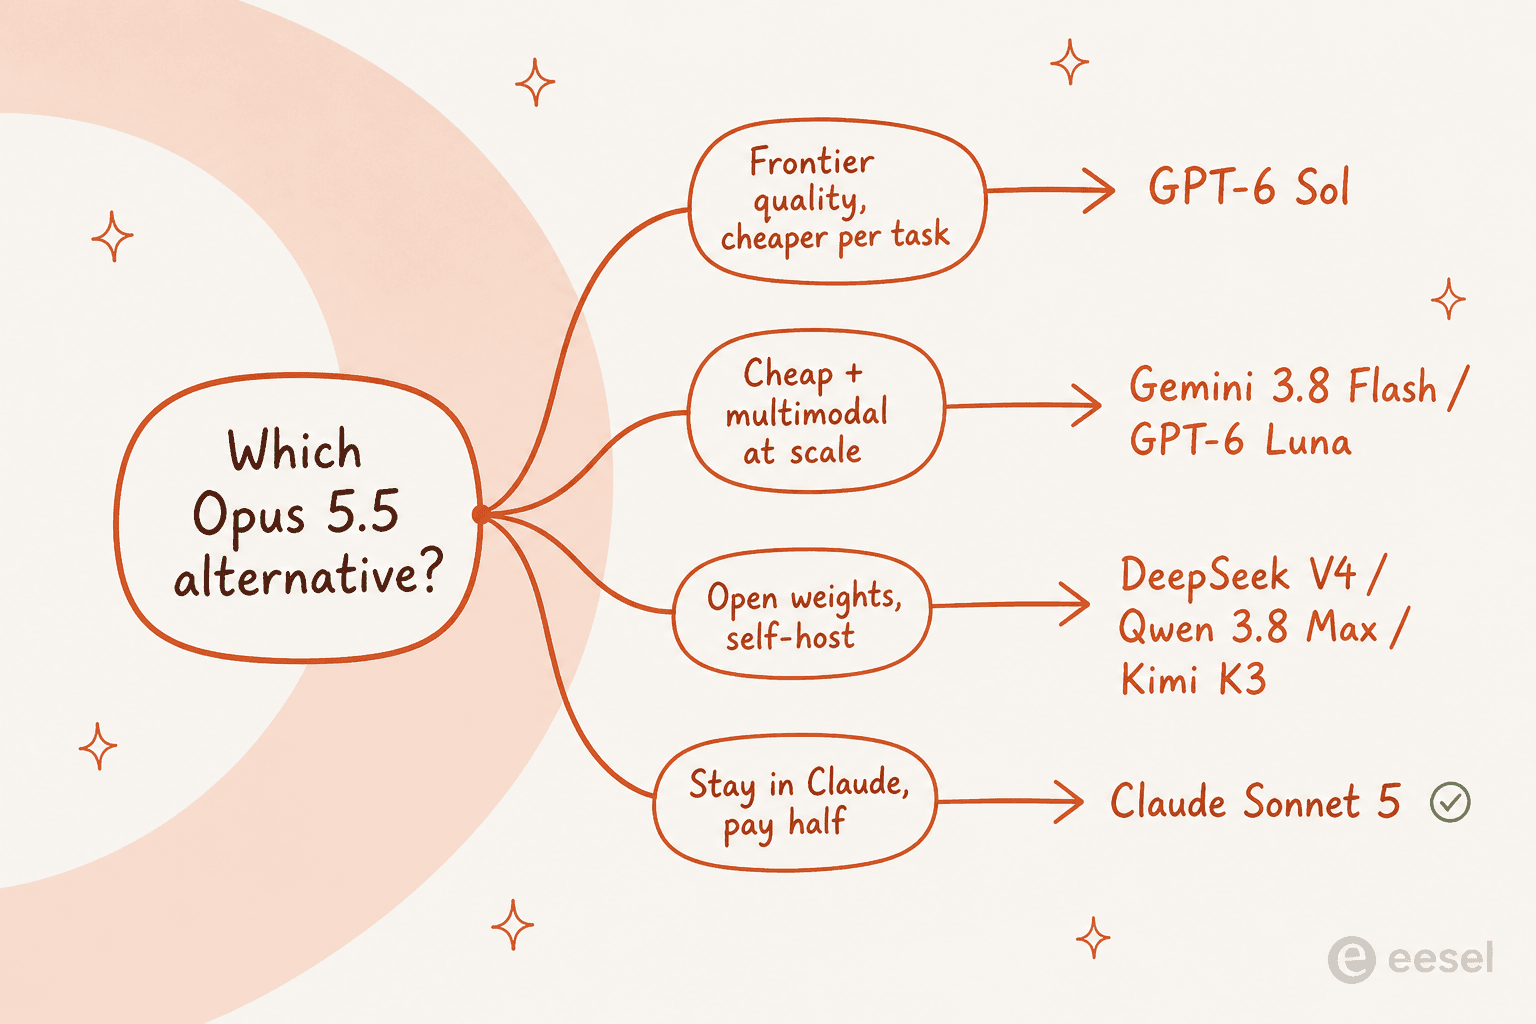
- Quer o mais próximo do Opus por muito menos? GPT-6 Sol. Qualidade quase de fronteira, cerca de um quinto do custo por tarefa.
- Está a correr trabalhos assíncronos e multimodais em escala? Gemini 3.8 Flash pelo alcance e preço, ou GPT-6 Luna pela tarifa mais barata por token.
- Precisa de pesos abertos? DeepSeek V4 pelo piso de custo, Qwen 3.8 Max pelo benchmark mais alto, Kimi K3 se também precisar de visão.
- Satisfeito com o Claude? Sonnet 5 a metade do preço, idealmente encaminhado junto com o Opus para as tarefas difíceis.
E há um ponto mais silencioso por baixo de tudo isto, ao qual developers experientes voltam sempre. Os benchmarks são um tiro de partida, não um veredito:
Only hands-on experience matters in the end, and these days it's very easy to switch models.
Essa última frase, "very easy to switch models", é a verdadeira história de 2026. O que leva à pergunta que a maioria destas comparações ignora.
Experimente a eesel: o colega de equipa que funciona em qualquer um destes modelos
Eis o que toda publicação de modelo contra modelo assume silenciosamente: que o seu trabalho é escolher um modelo, ligar a sua API, tratar da engenharia de prompts, conectá-lo às suas ferramentas, e impedir que tudo isso alucine com clientes reais. Para a maioria das equipas, esse não é o trabalho. O trabalho é uma taxa de resolução mais alta, ou publicações publicadas. O modelo é apenas o motor.
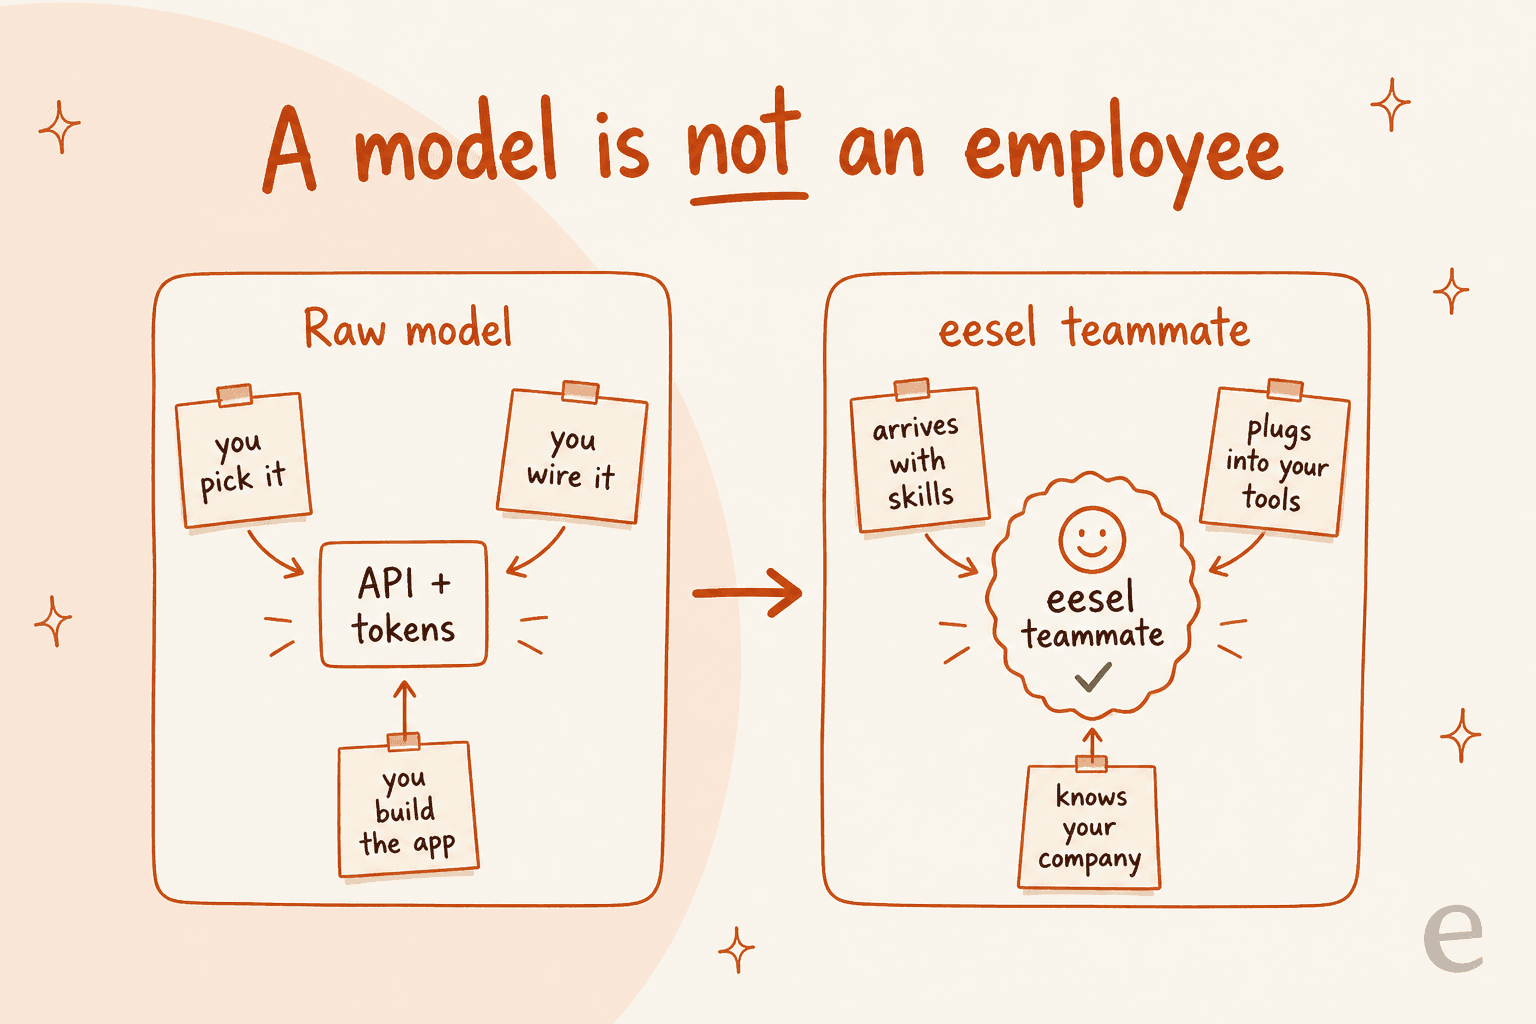
É assim que eu enquadraria a eesel. É uma plataforma de colegas de equipa de IA, e você contrata colegas prontos a trabalhar para tarefas específicas. A equipa atual é um colega de equipa de IA para helpdesk que se junta à sua fila de suporte existente e um escritor de blog com IA que redige publicações pesquisadas. Cada um chega já a saber como fazer o seu trabalho, ligado às suas ferramentas, e ancorado no contexto da sua empresa, por isso não é você quem escolhe entre o Opus 5.5 e o Sol e cuida de um prompt. Como o modelo está por baixo do colega de equipa, um modelo mais barato ou melhor lançado no mês seguinte é uma atualização gratuita, não uma reconstrução.

Se é do tipo de pessoa que lê uma publicação de alternativas de modelos, vai gostar desta parte: tudo pode ser conduzido a partir do terminal. A CLI da eesel (npx @eesel/cli) permite-lhe ligar integrações, editar as instruções permanentes do agente, simular um lançamento contra os seus tickets históricos, aprovar ações, e ler o registo de atividade de cada execução, tudo como JSON, com uma flag --dry-run que imprime a chamada exata que uma escrita faria antes de a enviar. Cada workspace é também um servidor MCP, por isso agentes de programação como o Claude Code, o Codex e o Cursor podem operar o mesmo colega de equipa. É o mesmo produto que o painel de controlo, exposto para pessoas e agentes que vivem num terminal. Pode experimentar a eesel grátis.
Perguntas frequentes
Qual é a melhor alternativa ao Claude Opus 5.5?
Quanto custa o Claude Opus 5.5, e as alternativas são mais baratas?
Existem alternativas de código aberto ao Claude Opus 5.5?
Qual alternativa ao Claude Opus 5.5 é melhor para agentes de programação?
Tenho de escolher um único modelo para construir um agente de suporte com IA?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.