As 8 melhores alternativas ao Xiaomi MiMo V2.6 em 2026

Rama Adi Nugraha

Katelin Teen
Última edição September 23, 2026
Por que procurar uma alternativa ao MiMo V2.6
Deixe-me ser justo com o MiMo primeiro, porque ele mereceu a atenção. O modelo Pro de 1T de parâmetros supera o modelo de 2,8T de parâmetros Kimi K3 em 14 dos 15 benchmarks que um comentarista contou manualmente, com uma fração do tamanho, e a Xiaomi manteve o preço igual ao da V2.5. Ele tem licença MIT, é nativamente omnimodal e vem com um contexto de 1M de tokens. A reação da comunidade foi incomumente calorosa, e principalmente sobre a transparência, e não sobre as pontuações.
Então por que procurar alternativas? Algumas razões honestas:
- A vantagem no benchmark é mais estreita justo onde mais importa. No Terminal Bench 4.0, o MiMo-V2.6-Pro pontua 34,9, bem abaixo dos 59,6 do GPT-6 Astra e dos 49,0 do Claude Opus 5. Nas tabelas de código real mais difíceis, o MiMo lidera o campo aberto de forma barata, mas fica atrás dos modelos de topo. Se o seu trabalho depende dessas tarefas, o gasto extra em um modelo de fronteira pode valer a pena.
- A residência de dados é uma restrição real. A API hospedada do MiMo roda sob a lei da RPC, e hospedar o checkpoint Pro por conta própria exige uma máquina de 2 nós e 16 GPUs. Para dados regulados ou de clientes, isso é um bloqueio genuíno, não um detalhe menor.
- Ceticismo sobre "benchmaxxing". Uma preocupação recorrente na comunidade é que as lideranças em índices não sobrevivem ao contato com código de produção. Como um comentarista do Hacker News colocou, sem rodeios:
"No chinese lab has caught up yet... the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."

Essa é uma visão, e o oposto também é bem argumentado (muitos engenheiros relatam que os modelos chineses baratos mais um modelo de fronteira supervisor superam os modelos caros dos EUA em ROI). Mas a própria divergência é a razão para conhecer suas alternativas.
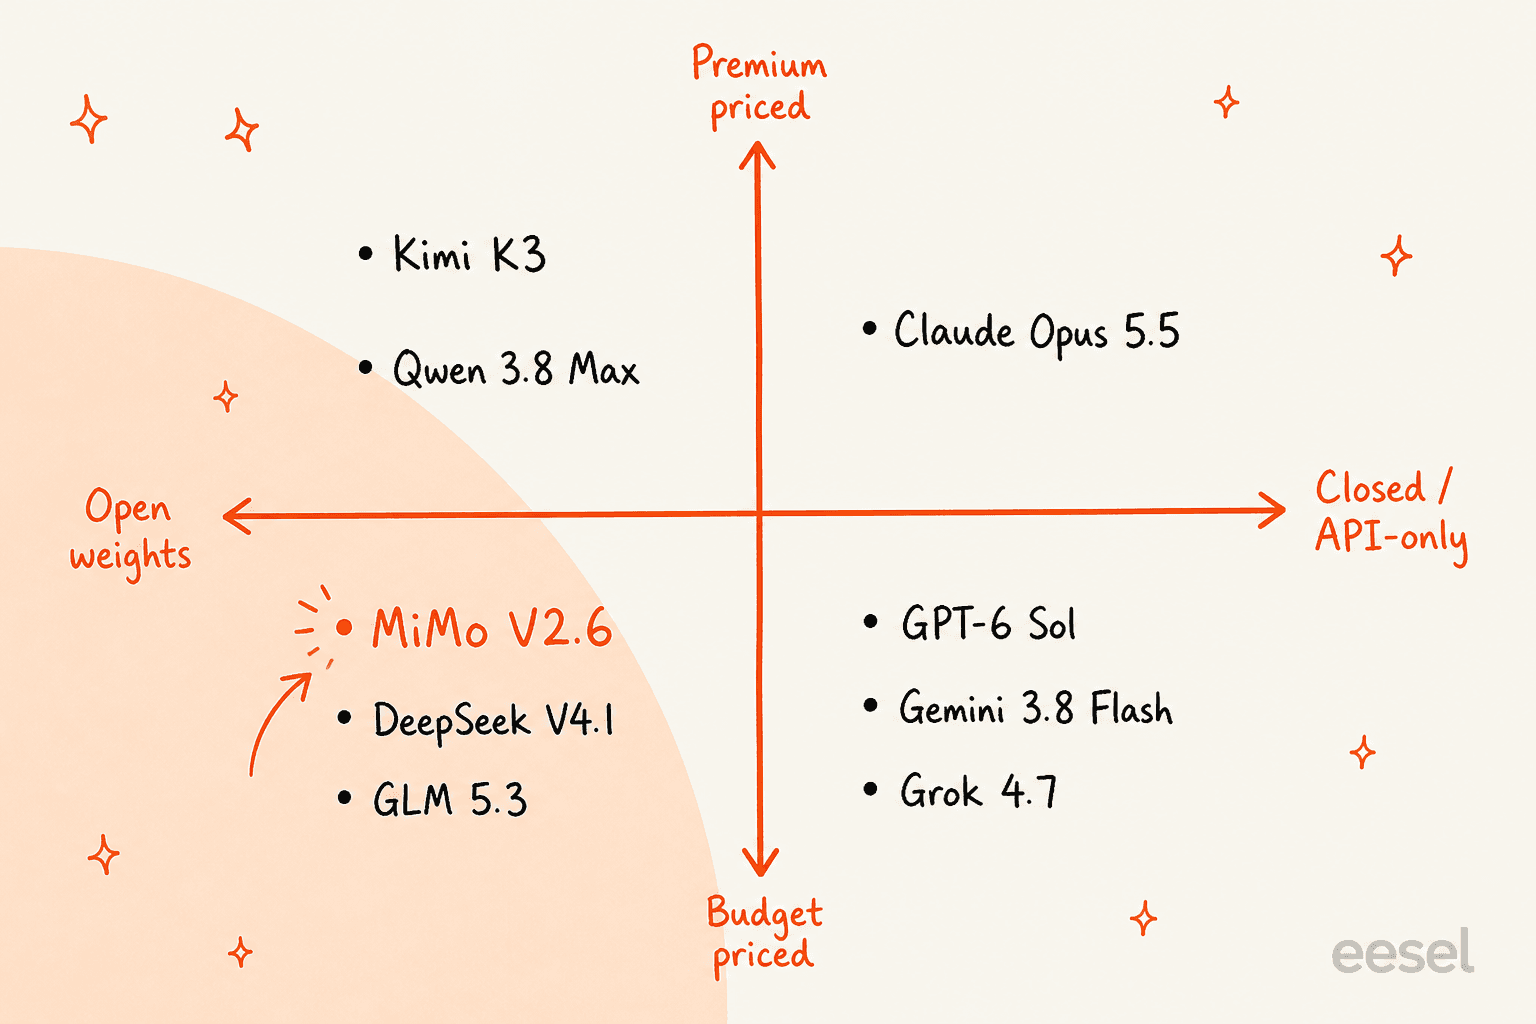
Como escolhi essas alternativas
Mantive a lista curta em modelos que estão realmente disponíveis e que uma equipe de verdade consideraria ao lado do MiMo V2.6. Isso significou três filtros: atuais (todos lançados ou reprecificados nos últimos meses de 2026), comparáveis (aparecem nas mesmas tabelas de benchmarks contra as quais o MiMo é medido) e distintos (cada um vence em um eixo diferente, para que a lista não sejam oito versões da mesma troca).
Me apoiei em fontes primárias para cada número: as próprias fichas de modelo e páginas de preços dos fornecedores, as listagens da OpenRouter, e o índice da Artificial Analysis para uma leitura neutra de inteligência versus custo. Quando a comunidade tinha um ponto afiado e verificável, eu o citei com um link permanente. Os preços abaixo são por 1M de tokens, salvo indicação contrária.
Alternativas ao MiMo V2.6 de relance
| Modelo | Tipo | Parâmetros | Contexto | Preço /1M (entrada / saída) | AA Intelligence | Melhor para |
|---|---|---|---|---|---|---|
| MiMo V2.6 Pro | Aberto (MIT) | 1.02T / 42B ativos | 1M | $0.435 / $0.87 | 46 | Melhor modelo aberto mais barato |
| DeepSeek V4.1 | Aberto (MIT) | 552B MoE | 1M | $0.15 / $0.60 (fora do pico) | nível workhorse | Cavalo de batalha barato que usa ferramentas |
| Kimi K3 | Aberto | 2.8T / 104B ativos | 1M | $3 / $15 | 57 | Maior modelo aberto |
| Qwen 3.8 Max | Aberto (hospedado) | 2.4T / 95B ativos | 1M | $2 / $6 | 58 | Variantes pequenas amigáveis ao uso local |
| GLM 5.3 Flash | Aberto | 320B / 18B ativos | 1M | $0.15 / $0.50 | 57 | Modelo aberto barato para código real |
| Claude Opus 5.5 | Fechado | Não divulgado | 1M | $5 / $25 | 58 | Maior teto de raciocínio |
| GPT-6 Sol | Fechado | Não divulgado | 1.05M | $2 / $10 | 48 | Mais barato por tarefa concluída |
| Gemini 3.8 Flash | Fechado | Não divulgado | 1M | $0.75 / $3.75 | 59 | Contexto multimodal enorme |
| Grok 4.7 | Fechado | Modelo base maior | 500K | $2 / $6 | 46 | Loops de agentes em volume, dados ao vivo do X |
1. DeepSeek V4.1
Melhor para: equipes que querem o modelo aberto capaz mais barato com um histórico real.
O DeepSeek V4.1 Flash tornou-se disponível de forma geral em 10-09-2026, e a DeepSeek aposentou o antigo V4 Pro nele, roteando esses pedidos para o V4.1 Flash às taxas do Flash. É o modelo aberto chinês de referência, e o MiMo é repetidamente enquadrado como o backup mais barato dele, e não o contrário. A arquitetura é genuinamente nova: um codificador-decodificador causal de 552B de parâmetros que usa 8B de parâmetros ativos para entrada e 16B para saída, com um cache KV cerca de 4x menor que a geração anterior. Os pesos têm licença MIT, com visão nativa embutida.
Na própria tabela da DeepSeek, o V4.1 lidera no Terminal-Bench 2.1 (90,6), DeepSWE (74,2) e HLE-com-ferramentas (63,9, logo acima do Opus 5). Benchmarks da comunidade cronometram entre 250-400 tokens por segundo, destronando o Gemini Flash como a opção mais rápida que muitos haviam experimentado.
Prós:
- Modelo aberto sério mais barato: entrada fora do pico com cache-miss custa $0,15, saída $0,60 por 1M, e o horário fora do pico cobre a maior parte do horário comercial dos EUA e da UE.
- Pesos MIT, visão multimodal nativa, contexto de 1M.
- Um cavalo de batalha comprovado e amplamente implantado, não um lançamento de primeira semana.
Contras:
- O raciocínio bruto é o ponto fraco: um HLE de 36,8 fica abaixo do GPT-6 Sol e do Opus 5. É um usuário de ferramentas, não um campeão de raciocínio.
- As taxas de horário de pico (01:00-04:00 e 06:00-10:00 UTC) dobram o preço, então o custo é um alvo em movimento.
- Os termos da API paga são silenciosos, não permissivos, sobre uso para treinamento, e os dados são processados na RPC, então pense duas vezes antes de enviar dados de clientes por ele.
Veredito: se o preço do MiMo foi o que te atraiu, o DeepSeek V4.1 é a troca mais direta, e possivelmente a aposta mais segura em maturidade. Escolha-o quando quiser um motor barato para trabalho intensivo em ferramentas e puder conviver com a ressalva de residência de dados.
2. Kimi K3
Melhor para: equipes que querem o maior modelo aberto do mercado e estão dispostas a pagar pelo teto.
O Kimi K3 da Moonshot foi lançado em 16-07-2026 como um modelo de 2,8T de parâmetros com 104B ativos, e a Moonshot lançou os pesos abertos no prazo, algo que nem todo laboratório faz. Ele pontua 57 no índice da Artificial Analysis, um bom quarto lugar geral, e é o modelo com o qual o MiMo é mais frequentemente comparado para ilustrar o argumento tamanho-versus-desempenho.
O problema é que o K3 é onde a lição "maior não é mais barato" morde. Sua API custa $3 de entrada e $15 de saída por 1M, a mesma faixa de um modelo fechado de nível médio, e o raciocínio não pode ser desligado em nenhum nível. Essa contagem da GodelNumbering vale a pena citar porque captura exatamente essa tensão:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!"
Prós:
- Pesos abertos, contexto de 1M, visão nativa, inteligência geral forte (índice AA 57).
- Genuinamente capaz em raciocínio difícil, onde o MiMo é mais fraco.
Contras:
- Cerca de 50x o preço de saída do MiMo, a $15 por 1M, e aproximadamente igual à faixa de preço do Claude Sonnet.
- O raciocínio está sempre ativo, então é um custo de latência que você não consegue reduzir.
- 1.561 GB de pesos tornam a hospedagem própria um projeto de hardware sério.
Veredito: o K3 é o modelo aberto para o qual você recorre quando quer capacidade máxima e o tamanho não te assusta, mas em preço puro por inteligência, tanto o MiMo quanto o DeepSeek o superam. Escolha o K3 quando o teto importar mais que a conta.
3. Qwen 3.8 Max
Melhor para: equipes que querem uma família aberta com variantes pequenas genuinamente amigáveis ao uso local.
O Qwen 3.8 Max da Alibaba tornou-se disponível de forma geral em 02-08-2026, um MoE de 2,4T / 95B ativos com contexto de 1M. No ranking da Artificial Analysis, ele ocupa a posição 6 com um índice de 58, e também é forte no LMArena (Texto #5, Visão #2). O preço da API é $2 de entrada e $6 de saída por 1M via Qwen Cloud.
A razão pela qual o Qwen continua aparecendo como alternativa ao MiMo é a família, não só o carro-chefe. O favorito da comunidade para inferência local são os modelos Qwen menores, que um comentarista chamou de "crazy good for how small it is" e que rodam indefinidamente em uma máquina de classe workstation. Os pesos Max hospedados foram lançados, mas sob uma licença não-Apache; a opção permissiva e verdadeiramente local é o Qwen3.8-27B menor (Apache 2.0).
Prós:
- Inteligência geral forte (AA 58) e excelentes pontuações de preferência humana.
- Uma escada real de tamanhos, incluindo um modelo pequeno com licença permissiva para execuções locais.
- Preços hospedados sensatos de $2 / $6.
Contras:
- O Max hospedado e a base aberta não são equivalentes em recursos (visão, modo sem raciocínio e contexto padrão de 1M são apenas hospedados).
- Seu próprio ambiente de codificação limita a saída a 65K tokens, então nunca pede o teto completo de 131K de fábrica.
- Pontuações compostas automatizadas e preferência humana apontam em direções diferentes, então não confie em um único número como veredito.
Veredito: o Qwen 3.8 Max é a escolha quando você quer uma família aberta na qual crescer, de um modelo pequeno amigável a notebooks até um carro-chefe quase de fronteira. Se "local" é um requisito rígido, o Qwen te dá o caminho mais limpo de qualquer modelo aqui.
4. GLM 5.3 Flash
Melhor para: equipes que querem o modelo aberto mais barato que se sustenta em código real.
O GLM 5.3 Flash da Z.ai foi lançado em 26-08-2026 como o primeiro modelo GLM-5 nativamente multimodal, um MoE de 320B / 18B ativos com contexto de 1M e pesos abertos. Ele pontua um índice da Artificial Analysis de 57 a cerca de $0,045 por tarefa, o que o coloca bem na faixa de orçamento do MiMo. O preço da API é $0,15 de entrada e $0,50 de saída por 1M (a promoção de lançamento de $0,075 / $0,25 já acabou).
O GLM é o modelo aberto que as pessoas citam especificamente quando a conversa vira para código real em vez de benchmarks. Nesse mesmo tópico cético do Hacker News, o contra-argumento foi que o GLM mais um modelo de fronteira supervisor já supera os modelos caros dos EUA na prática:
"I mean DSv4.1 Flash and GLM 5.3 kept in check by a supervising frontier like Astra or Fable already in my experience clowns massively on ever using Opus or Sonnet."
Prós:
- Muito barato ($0,15 / $0,50) com um índice AA forte (57), pesos abertos, contexto de 1M.
- Uma reputação real de se sustentar em tarefas de codificação de produção.
- Um carro-chefe separado apenas de texto (GLM-5.3 a $1,40 / $4,40) para codificação mais pesada e trabalho cibernético.
Contras:
- A API própria é lenta (~49 tokens por segundo); você precisa de um host de terceiros como o Databricks para vazão real.
- O modo de pensamento não pode ser desativado.
- Como com os outros modelos abertos chineses, as mesmas questões de residência de dados e uso para treinamento se aplicam.
Veredito: o GLM 5.3 Flash é a escolha de valor-mais-código. Se o DeepSeek é o generalista barato e o Kimi é o grande, o GLM é o que vale testar quando sua carga de trabalho é majoritariamente código e a conta ainda precisa ser minúscula.
5. Claude Opus 5.5
Melhor para: equipes que precisam do maior teto de raciocínio no trabalho agêntico mais difícil.
Se o ponto fraco do MiMo é o topo da curva de dificuldade, o Claude Opus 5.5 é o modelo que domina isso. O carro-chefe da Anthropic ocupa o #1 no Intelligence Index da Artificial Analysis (58) e lidera confortavelmente sobre o MiMo no Terminal Bench 4.0 e nas tabelas de agentes de codificação mais difíceis. Ele custa $5 de entrada e $25 de saída por 1M com um contexto plano de 1M (sem sobretaxa de contexto longo), e leituras de cache custam um décimo disso.
O contrapeso honesto é o custo por tarefa. O Opus gasta muitos tokens de saída: no índice da Artificial Analysis, ele fica em torno de $5,98 por tarefa em esforço máximo, contra os $0,13 do MiMo. Você paga preços de fronteira por um teto de fronteira.
Prós:
- Pontuações máximas de raciocínio e agênticas; o teto que o MiMo não alcança nas tabelas mais difíceis.
- Preços planos de contexto de 1M, ferramentas maduras, e uma postura clara de tratamento de dados para trabalho regulado.
Contras:
- Caro por token, e ainda mais por tarefa concluída porque é verboso em alto esforço.
- Tempo lento até o primeiro token em esforço máximo, o que prejudica qualquer coisa que uma pessoa espere.
- Pesos fechados, então hospedagem própria e inferência local real estão fora de cogitação.
Veredito: o Opus 5.5 é o anti-MiMo: não a jogada de valor, mas a jogada de capacidade. Recorra a ele quando a tarefa realmente precisar do melhor raciocínio disponível e o orçamento puder absorver isso, e combine-o com um modelo mais barato para os 80% rotineiros.
6. GPT-6 Sol
Melhor para: equipes que querem um modelo de fronteira hospedado pelo menor custo por tarefa concluída.
O GPT-6 Sol da OpenAI foi lançado em 22-09-2026, no mesmo dia que o MiMo, e toda a sua história é sobre valor. Foi precificado em $2 de entrada e $10 de saída por 1M, um corte plano de 50% em relação ao GPT-5.6 Sol, com um contexto de 1,05M. Seu Intelligence Index da Artificial Analysis (48) está no nível da geração anterior, então isso é um corte de preço disfarçado de salto de versão, não um salto de capacidade, mas é exatamente isso que o torna uma forte alternativa ao MiMo para trabalho hospedado.
O número que importa é o custo por tarefa, onde o Sol é incomumente eficiente porque usa muito menos tokens de saída que o Opus. No índice da Artificial Analysis, ele fica em torno de $1,06 por tarefa em esforço máximo, contra os $5,98 do Opus 5.5, cerca de 5,6x mais barato para um modelo apenas um degrau abaixo em inteligência. A factualidade também melhorou, com a alucinação em esforço máximo caindo de 92% para 60%.
Prós:
- Barato para um modelo de fronteira hospedado: $2 / $10, e dramaticamente mais barato por tarefa concluída que o Opus.
- Contexto enorme de 1,05M, conjunto completo de ferramentas Responses, e uma grande melhoria de factualidade em relação ao 5.6.
- A confiabilidade e postura de dados de um laboratório de fronteira dos EUA.
Contras:
- A inteligência fica estagnada em relação à geração anterior, então se você precisava de um salto real, não vai encontrá-lo aqui.
- Pesos fechados e sem camada gratuita específica para o Sol.
- Requisições de contexto longo são cobradas em um nível mais alto ($4 / $15), o mesmo precipício de estilo 200K que tanto a OpenAI quanto a xAI cobram.
Veredito: o GPT-6 Sol é o mais próximo de "a economia do MiMo com a confiabilidade de um laboratório de fronteira". Se você quer um modelo hospedado, se importa com a conta total e não precisa do raciocínio de nível Opus, o Sol é a escolha de valor padrão.
7. Gemini 3.8 Flash
Melhor para: equipes que querem contexto multimodal massivo de um laboratório de fronteira, de forma barata.
O Gemini 3.8 Flash do Google saiu em 02-09-2026, seu terceiro lançamento Flash em seis semanas. Não é um modelo base novo (a ficha diz quatro vezes que é baseado no 3.7 Flash), por isso o preço não mudou: $0,75 de entrada e $3,75 de saída por 1M até o final de 2026, depois $1,50 / $7,50 a partir de janeiro. Ele carrega um Intelligence Index de topo da Artificial Analysis de 59 e recebe texto, imagem, áudio, vídeo e PDF.
O problema pouco reportado é a responsividade. A Artificial Analysis mede um tempo até o primeiro token de 13,30 segundos contra uma mediana de classe de 2,99 segundos, mesmo enquanto se classifica em #3 de 196 em velocidade de saída bruta. Vazão não é o mesmo que latência, o que o desqualifica para qualquer coisa que uma pessoa espere ao vivo, mas serve bem para um agente em lote durante a madrugada. Curiosamente, o próprio Google diz aos desenvolvedores focados em eficiência para permanecerem no 3.7 Flash.
Prós:
- Índice de inteligência de topo (59) a um preço genuinamente barato para um modelo de fronteira.
- O input multimodal nativo mais amplo de qualquer modelo aqui, com contexto de 1M.
- Uma camada gratuita e descontos generosos de lote e flex.
Contras:
- Lento até o primeiro token, então é uma má escolha para chat ao vivo ou respostas de suporte.
- Verboso (cerca de 120M de tokens de saída para rodar o índice, contra uma mediana de 71M), o que infla a conta real.
- O próprio conselho do Google é que o 3.7 Flash é a escolha de eficiência, o que embaça o argumento de atualização.
Veredito: o Gemini 3.8 Flash é o cavalo de batalha multimodal em lote. Se o seu caso de uso do MiMo é intensivo em documentos, imagens ou vídeo e roda de forma assíncrona, essa é a alternativa de fronteira a superar. Se uma pessoa está esperando a saída, procure em outro lugar.
8. Grok 4.7
Melhor para: equipes que rodam loops de agentes de alto volume e querem dados ao vivo do X e qualidade quase de fronteira.
O Grok 4.7 da xAI foi lançado em 21-09-2026, construído sobre um modelo base maior e treinado para tarefas agênticas de várias horas. É o espelho interessante do MiMo no índice da Artificial Analysis: ambos ficam em 46, e a coincidência de datas de lançamento é a razão pela qual "MiMo mogged Grok" viralizou. O preço é $2 de entrada e $6 de saída por 1M abaixo de 200K tokens de prompt, e $4 / $12 acima disso, onde as taxas longas se aplicam à requisição inteira.
A vantagem real do Grok sobre os modelos abertos aqui é seu conjunto de ferramentas nativas: busca ao vivo na web e no X, execução de código, e um design ajustado para execuções longas de agentes, além da pilha de segurança mais forte que a xAI já lançou. É quase de fronteira em vez de líder de fronteira (o Fable ainda lidera em codificação de ponta e trabalho de terminal), mas tem preço pensado para realmente rodar em volume.
Prós:
- Mesma inteligência AA que o MiMo (46), mas com as ferramentas hospedadas de um laboratório de fronteira e busca ao vivo no X e na web.
- Preço pensado para volume em loops de agentes a $2 / $6, com uma pilha de segurança e recusa nova e forte.
- Grandes melhorias em terminal e codificação em relação ao Grok 4.6.
Contras:
- O contexto de 500K é o menor do grupo, e o precipício de preço acima de 200K se aplica a todos os tokens de uma requisição.
- Perde para o GPT-6 Sol e o Fable em alguns benchmarks profissionais como o HealthBench.
- Pesos fechados, e nenhum teste com histórico de tickets para testes ao estilo suporte.
Veredito: o Grok 4.7 é a escolha "quase de fronteira em volume", especialmente se dados ao vivo do X ou da web fazem parte do trabalho. Se você foi atraído pelo preço do MiMo, mas quer ferramentas hospedadas e pode conviver com o contexto menor, é uma troca justa.
O que todos esses benchmarks deixam passar
Aqui está o que três anos colocando IA em filas de suporte ao vivo nos ensinaram: o modelo é o de menos. Cada opção acima é um motor, e um bom motor não é um carro pronto. Sozinho, um modelo bruto não conhece seu produto, não consegue ver seu helpdesk, não consegue realizar uma ação e não pode ser testado com segurança contra seu histórico real antes de falar com um cliente.
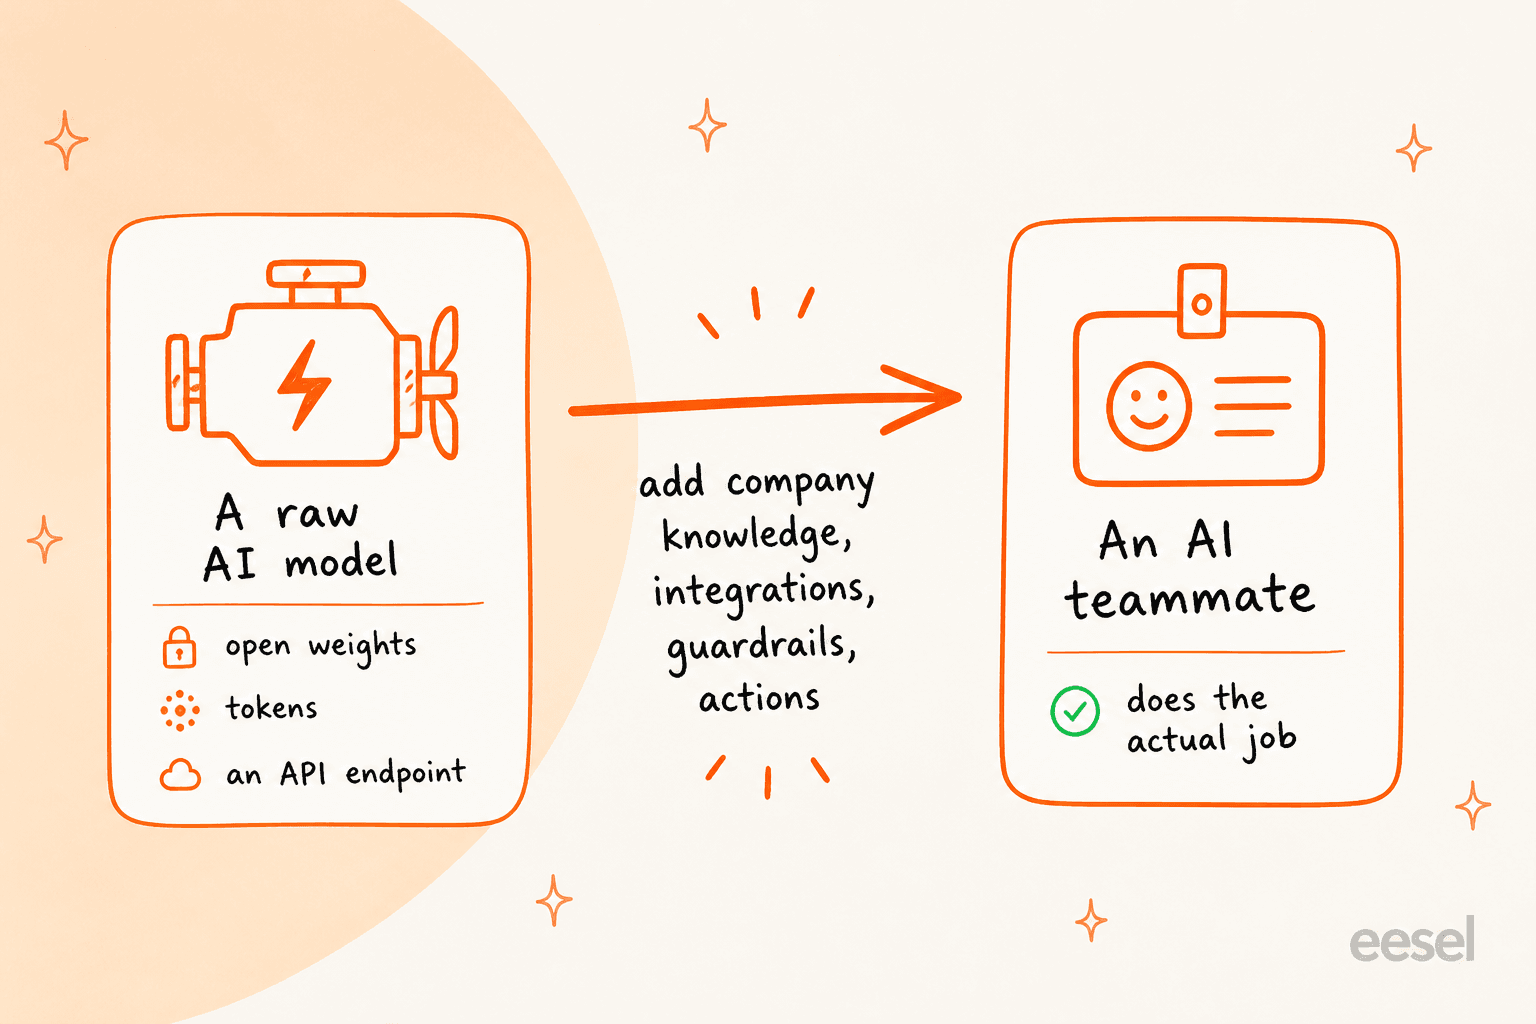
Aprendemos isso da maneira difícil, vendo um bot de fala confiante dar respostas erradas silenciosamente, por isso agora simulamos cada lançamento contra tickets históricos antes de ele entrar em produção. Essa lacuna entre "um modelo inteligente" e "um colega de equipe que faz o trabalho" é exatamente o que os benchmarks não medem, e é onde a maior parte do trabalho real acontece: conectar conhecimento, cabear integrações, definir salvaguardas e provar que funciona nos seus próprios dados primeiro.
Então a pergunta mais útil muitas vezes não é "qual modelo?" mas "quem vai fazer o trabalho?". Se a resposta é sua equipe de engenharia, envolvendo um modelo em tudo isso, então escolha entre os oito acima com base em preço, teto e licenciamento. Se a resposta é "eu só quero o resultado", o modelo se torna um detalhe de implementação.
Experimente a eesel
A eesel trabalha na outra ponta dessa decisão. Em vez de te dar um motor e um projeto de construção, ela te dá um colega de equipe de IA pronto para trabalhar no seu helpdesk que já conhece suas integrações e o contexto da sua empresa, e deixa o modelo por baixo permanecer intercambiável. Esse é todo o ponto da visão de que "o modelo é infraestrutura": você contrata o colega de equipe, não o motor.
Na prática, o colega de equipe de IA do helpdesk se junta à sua fila existente em minutos, aprende com seus tickets passados e sua central de ajuda, e, de forma crucial, simula contra seu histórico real de tickets antes de responder a um cliente ao vivo pela primeira vez, então você vê a resolução e qualidade projetadas de antemão em vez de simplesmente apertar um botão e torcer. E como a eesel foi construída para ser operada de forma programática, também há um eesel CLI completo: você pode operar o mesmo colega de equipe e espaço de trabalho a partir de um terminal, automatizá-lo em scripts, ou deixar um agente de codificação como o Claude Code ou o Cursor operá-lo, o que é o encaixe natural se você já estava procurando um modelo bruto para rodar scripts, para começo de conversa.
Se você está avaliando o MiMo V2.6 ou alguma de suas alternativas para potencializar a automação de suporte, vale a pena dar uma olhada antes de se comprometer com uma construção. Experimente a eesel gratuitamente, e deixe o modelo ser a parte fácil.
Perguntas frequentes
Qual é a melhor alternativa ao Xiaomi MiMo V2.6?
Existem alternativas mais baratas ao Xiaomi MiMo V2.6?
Quais alternativas ao MiMo V2.6 têm pesos abertos?
O Xiaomi MiMo V2.6 é bom o suficiente para dispensar as alternativas?
Preciso escolher um modelo para automatizar o suporte?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.