

A resposta curta: o que o Xiaomi MiMo V2.6 realmente custa
Passei dois anos observando páginas de preços de IA, e a maioria dos lançamentos de modelos enterra o número que você realmente veio buscar. A Xiaomi fez o oposto: abriu o código de toda a família MiMo V2.6 em 22 de setembro de 2026, sob a MIT, e manteve os preços da API estáveis em relação à geração anterior.
Então há realmente dois preços a considerar. Há o zero, se você baixar os pesos e rodá-los no seu próprio hardware. E há o preço por token da API, se preferir que outra pessoa hospede as GPUs. Aqui está a lista completa de preços hospedados, do OpenRouter, verificada no dia do lançamento:
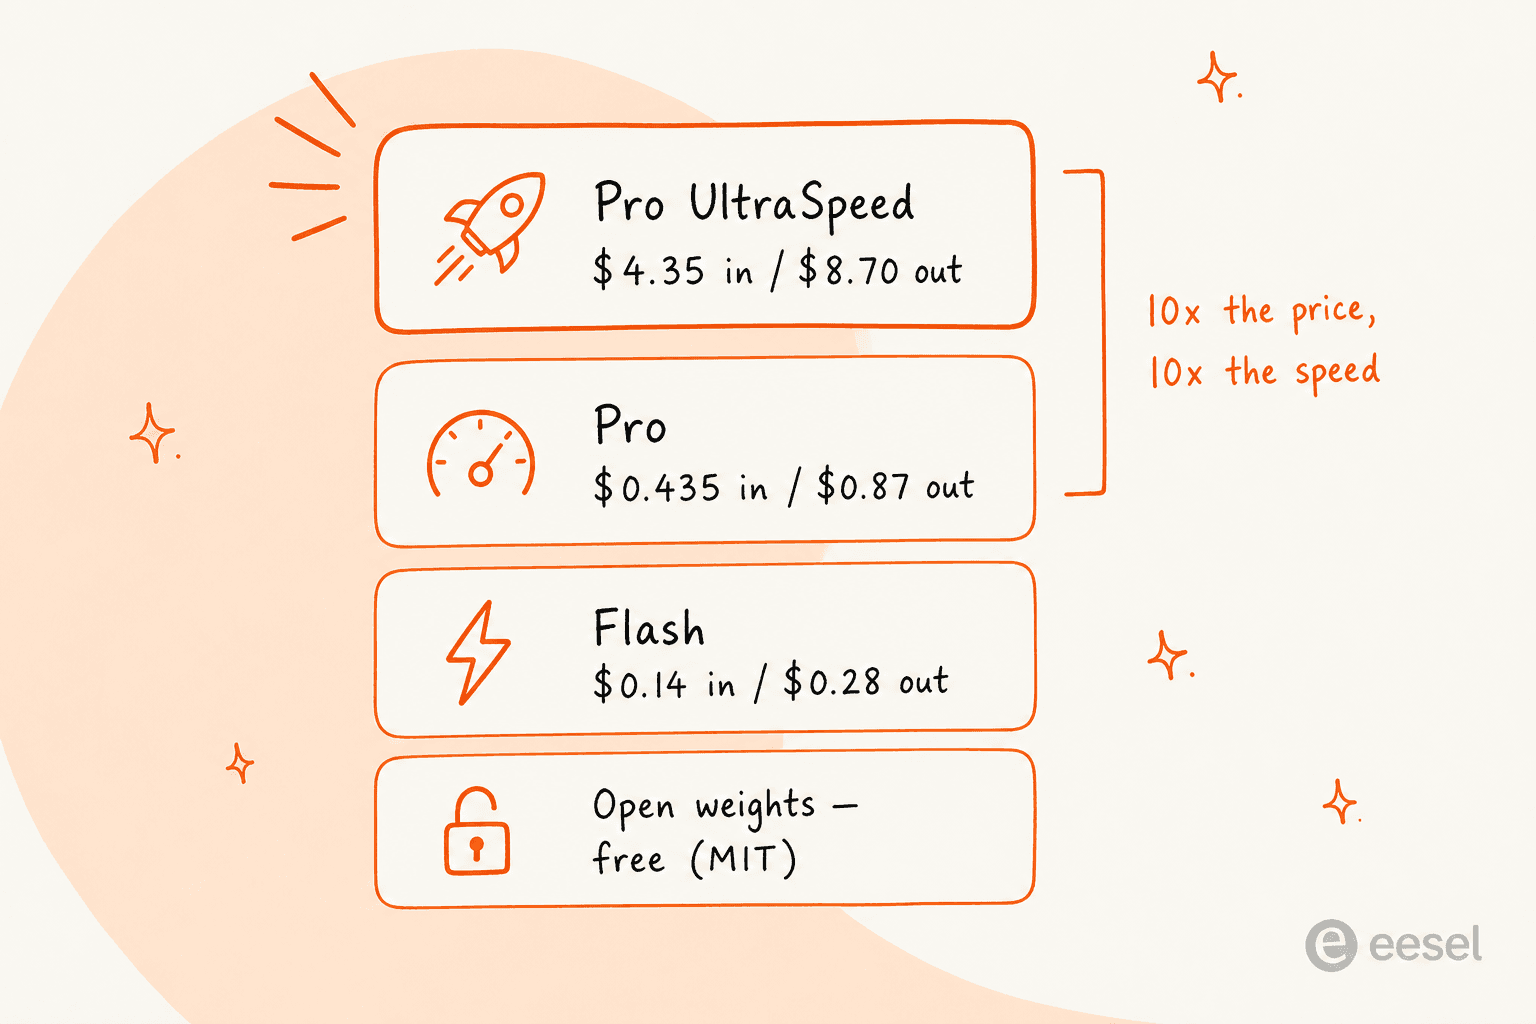
Cada variante traz a mesma janela de contexto de 1M de tokens e é nativamente omnimodal (texto, imagem, vídeo, áudio), então você não paga um adicional pelo contexto longo ou pelas modalidades extras. Isso é incomum, e é uma grande parte do motivo pelo qual os preços soam agressivos.
As quatro variantes e para que cada uma serve
O MiMo V2.6 não é um modelo com um único preço. É uma família de quatro checkpoints, e escolher o errado é a forma mais rápida de pagar a mais. Veja como eles se comparam.
MiMo V2.6 Pro ($0,435 entrada / $0,87 saída)
O Pro é o carro-chefe: um modelo de mistura esparsa de especialistas com 1,02 trilhão de parâmetros totais e 42B ativos. É o que lidera os benchmarks de pesos abertos, e o que você quer para trabalho agêntico genuíno, programação de longo alcance, uso de ferramentas em múltiplas etapas. A $0,435 de entrada / $0,87 de saída, é mais barato que a maioria dos modelos fechados de ponta com os quais compete, o que resume toda a história deste lançamento.
MiMo V2.6 Flash ($0,14 entrada / $0,28 saída)
O Flash é o checkpoint de eficiência: 309B no total, 15B ativos, descrito pela Xiaomi como o melhor equilíbrio entre inteligência, eficiência e custo. A $0,14 de entrada / $0,28 de saída, custa um terço do Pro e, pelos próprios números da Xiaomi, perde surpreendentemente pouco. No AutomationBench marca 52,3 contra 53,1 do Pro. Para a maioria dos trabalhos de alto volume e bem delimitados, o Flash é a escolha de melhor custo-benefício.
MiMo V2.6 Pro UltraSpeed ($4,35 entrada / $8,70 saída)
O UltraSpeed é confuso até você perceber que não está comprando mais inteligência. É exatamente o mesmo checkpoint do Pro, servido a aproximadamente 10x a velocidade de saída (cerca de 116 tokens por segundo). A Xiaomi cobra 10x a tarifa do Pro por isso. Então é um imposto puro de latência: pague apenas quando a velocidade for realmente o gargalo, como um agente de chat ao vivo que um cliente está observando digitar. Para um trabalho em lote que roda da noite para o dia, é 10x dinheiro desperdiçado.
MiMo V2.6 Distill-Qwen-9B (apenas pesos gratuitos)
O distill de 9B é um ajuste fino supervisionado denso do Qwen3.5-9B sobre dados gerados pelo MiMo. Não está na API paga; existe como um ponto de partida pequeno, de GPU única, para inferência local e pesquisa aberta. Já existem quantizações GGUF da comunidade para llama.cpp, LM Studio e Ollama, então é o que dá para rodar numa workstation.
O desconto de cache que a maioria não percebe
Os preços de tabela acima não são o que os usuários intensos realmente pagam. O MiMo V2.6 Pro lista os tokens de leitura de cache a cerca de $0,0036 por milhão, um desconto de 99% sobre a tarifa de entrada de $0,435. O parceiro de benchmark da Xiaomi resumiu assim:
"Despite the improvement, it retains the same attractive pricing at $0.435 per 1M input tokens (with a 99% cache-hit discount) and $0.87 per 1M output tokens."
Por que isso importa para o preço? Porque qualquer carga de trabalho real envia o mesmo contexto repetidamente. Um agente de programação relê o mesmo repositório. Um agente de suporte relê as mesmas políticas e macros a cada ticket. Uma vez que esse contexto está em cache, você paga centavos pelos tokens de entrada. Se o seu caso de uso reutiliza prompts, seu preço de entrada efetivo fica bem abaixo do de tabela, e essa diferença é onde o custo total do MiMo realmente se distancia da ponta.
Como os preços do MiMo V2.6 se comparam à ponta do mercado
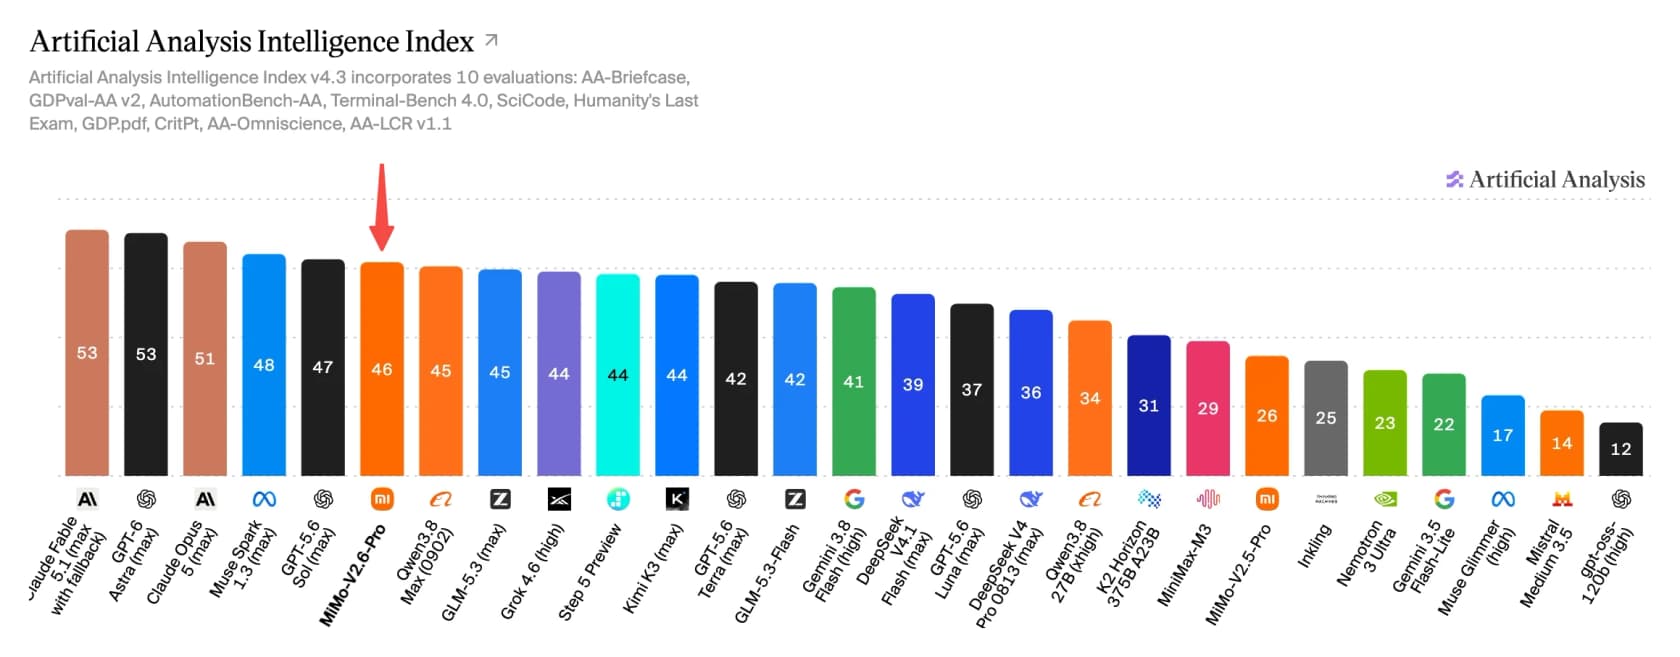
Esta é a comparação para a qual o lançamento foi construído. No Índice de Inteligência da Artificial Analysis, o MiMo V2.6 Pro marcou 46, o melhor modelo de pesos abertos, empatando com o lançamento do Grok 4.7 no mesmo dia e ficando logo atrás dos líderes fechados.
A pontuação sozinha não conta toda a história do preço, porém. O gráfico que importa para o custo é o de inteligência versus custo por tarefa, em que o MiMo V2.6 Pro cai no "quadrante mais atraente", em verde, a cerca de $0,13 por tarefa, enquanto o Claude Opus 5 e o GPT-6 Astra ficam na extremidade de $3 a $8 do mesmo eixo.
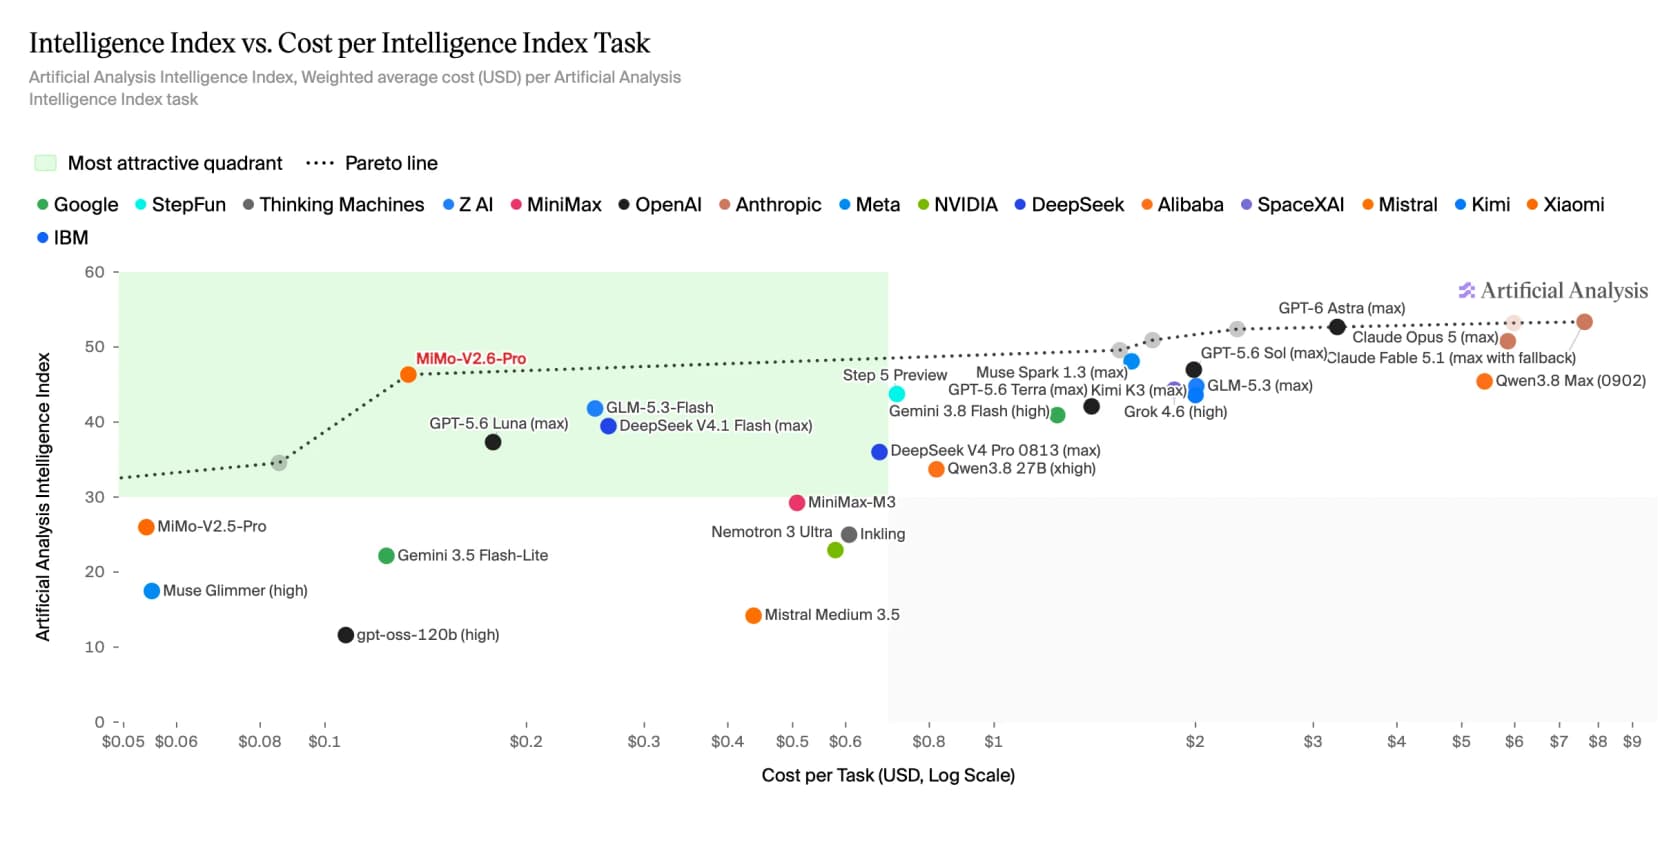
Contra o campo aberto, é igualmente afiado. O Flash iguala os níveis mais baratos como o DeepSeek V4.1 Flash, e o Pro de 1,02T supera o muito maior Kimi K3, de 2,8T, enquanto o lidera na maioria das tabelas. Um comentarista do Hacker News, que havia usado o modelo intensamente, resumiu a conta de valor assim:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."

Aviso justo, porque um post sobre preços deve ser honesto quanto ao teto: o MiMo fica atrás dos melhores modelos fechados nas tabelas mais difíceis. No Terminal Bench 4.0 marca 34,9 contra 59,6 do GPT-6 Astra, e no ExploitBench fica em 47,9 contra mais de 70 do GPT-5.6 Sol e do Claude. Se o seu trabalho vive nessas fronteiras, o preço barato do token não é toda a decisão. Para tudo o mais, a relação custo-benefício é difícil de contestar.
Exemplos práticos: quanto você realmente pagaria
Preços de tabela por milhão de tokens são abstratos. Aqui está o que três cargas de trabalho realistas custam no MiMo V2.6, para que os números façam sentido.
- Um desenvolvedor solo no Flash. Digamos que você consome 20M de tokens de entrada e 5M de saída por mês programando com o Flash. Isso é 20 × $0,14 + 5 × $0,28 = $4,20 por mês. Erro de arredondamento.
- Uma equipe pequena rodando um agente de programação no Pro. 300M de entrada, 80M de saída por mês no Pro: 300 × $0,435 + 80 × $0,87 = $200,10 por mês, antes de qualquer desconto de cache. Com reutilização intensa de prompts, a conta real fica bem abaixo disso.
- Uma carga de trabalho de suporte de alto volume no Flash. 10.000 tickets por mês, cerca de 8K de entrada e 1K de saída cada, então 80M de entrada e 10M de saída: 80 × $0,14 + 10 × $0,28 = $14 por mês em tokens brutos.
Esse último número é o que vale a pena parar para pensar. Dez mil conversas de suporte por $14 em tokens de modelo. Se esse fosse o custo real do suporte com IA, todo mundo já teria lançado isso há anos. Não é, e a lacuna entre "$14 em tokens" e "um agente de suporte que funciona" é exatamente o ponto da próxima seção.
Pesos gratuitos não são gratuitos de rodar
O MiMo V2.6 é genuinamente aberto sob a MIT, então "simplesmente hospede você mesmo" é um conselho real, não marketing. Mas os pesos serem gratuitos não torna rodá-los gratuito. A conta de hardware é o item oculto.
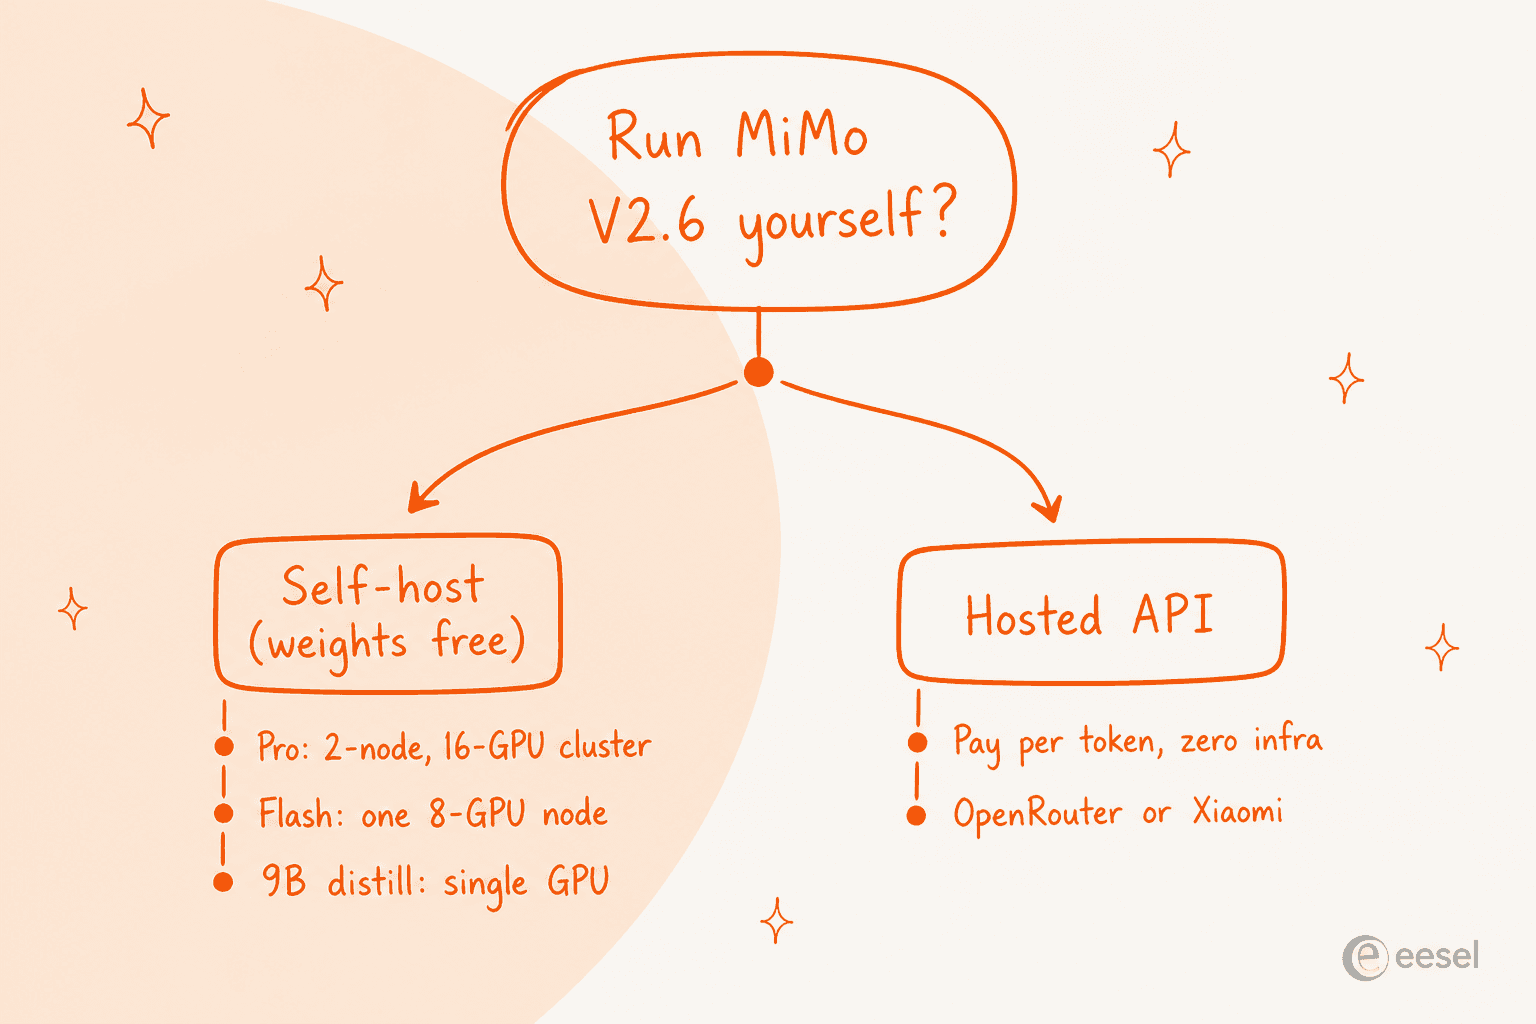
Veja o que cada variante precisa, segundo as fichas do modelo:
- Pro (1,02T / 42B ativos): o lançamento de referência com SGLang usa um cluster de 2 nós, 16 GPUs (tensor-paralelo 16). É um compromisso sério de hardware.
- Flash (309B / 15B ativos): roda em um único nó de 8 GPUs.
- Distill-Qwen-9B: pequeno o bastante para uma única GPU, e já existem quantizações GGUF para ferramentas locais.
Todos os checkpoints são distribuídos em FP8, o que mantém a pegada de memória razoável, mas a leitura honesta é esta: a auto-hospedagem só vence a API quando você tem volume alto e constante e GPUs ociosas para preencher. Para volume intermitente ou baixo, a API hospedada a $0,14 a $0,87 por milhão de tokens é quase sempre mais barata do que manter um cluster aquecido. Faça as contas da sua própria utilização antes de assumir que "pesos gratuitos" significa "gratuito".
A parte que a etiqueta de preço nunca mostra
Aqui eu preciso dar um passo atrás, porque construo e opero IA para helpdesk profissionalmente, e a conversa sobre preços quase sempre ignora a conta real.
O custo em tokens do MiMo V2.6, ou do DeepSeek, ou do Qwen, ou de qualquer um deles, é a menor linha do orçamento de um sistema em produção. A parte cara é tudo o que envolve o modelo.
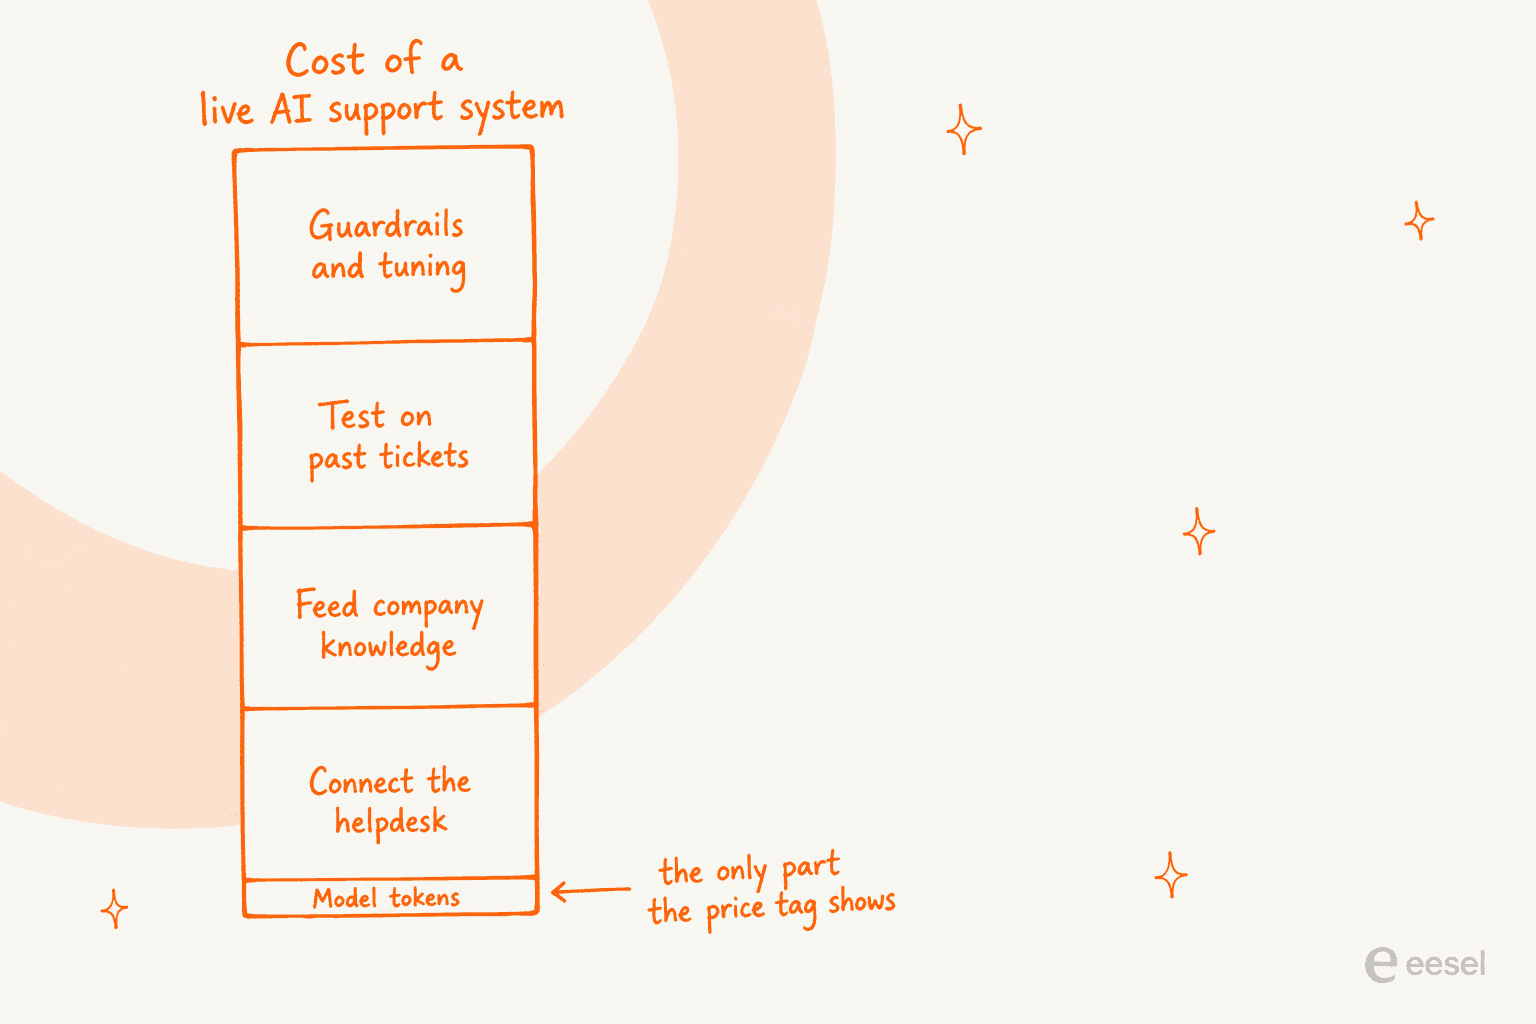
Passamos os últimos anos colocando agentes de IA em filas de suporte ao vivo, e a lição recorrente é que um modelo puro, por mais barato e inteligente que seja, não é um agente de suporte. Para ir de "$14 em tokens" a "um agente em que confio com um cliente", é preciso conectá-lo ao seu helpdesk, alimentá-lo com sua base de conhecimento e tickets passados, ensinar suas políticas, dar a ele ações que pode executar com segurança e, acima de tudo, testá-lo antes de colocá-lo no ar. Já vimos bots de fala confiante darem respostas erradas silenciosamente, e é exatamente por isso que todo lançamento deveria ser simulado contra tickets históricos primeiro.
Nada disso aparece numa página de preços do OpenRouter. É a diferença entre um modelo e um colega de equipe que funciona, e é onde mora o verdadeiro custo do suporte com IA.
Experimente a eesel
Um modelo como o MiMo V2.6 é um motor. A eesel é o colega de equipe que você contrata para dirigi-lo. A eesel é uma plataforma de colegas de equipe com IA, e o agente de helpdesk com IA é um colega de suporte pronto para trabalhar: ele se conecta ao seu helpdesk em minutos, já lê seus tickets passados e sua base de conhecimento, e você pode simulá-lo em milhares das suas conversas históricas reais antes que ele responda a um único cliente ao vivo. Em vez de cobrar por assento a preço fixo, a eesel fatura por uso, então o custo acompanha o trabalho realmente feito.

E se você vive num terminal, a eesel tem uma CLI pública mais um servidor MCP, então o mesmo colega de equipe e workspace que você gerencia no painel pode ser conduzido por scripts ou por agentes de programação como Claude Code, Codex e Cursor. É a forma amigável a agentes de operar a eesel: uma pessoa opera manualmente, um script automatiza, ou um agente de IA chama, tudo contra o mesmo colega de helpdesk. É essa camada que transforma um modelo barato e capaz em algo que de fato resolve tickets. Experimente grátis.