Como eu analisei
Passo meus dias pensando em intenção de busca e no olhar de quem constrói produto por trás do marketing, então meu processo para um lançamento como esse é propositalmente sem graça. Pulei a página de imprensa da Xiaomi e fui direto às fichas do modelo no Hugging Face, cruzei as pontuações com o índice independente da Artificial Analysis, e depois li cerca de 670 comentários nos tópicos de lançamento, painel de treinamento e análise de preços no Hacker News para ver o que as pessoas que realmente usam o modelo no dia a dia estavam relatando.
Não passei um ano vivendo dentro do MiMo como vivo dentro das ferramentas que construo diariamente, então vou deixar claro onde estou relatando pesquisa e onde estou relatando uso real. Essa distinção importa para um modelo com apenas alguns dias, e a maioria das "análises" que aparecem horas depois de um lançamento omite isso silenciosamente.
O que o MiMo V2.6 realmente é
O MiMo V2.6 é uma família de modelos de linguagem de pesos abertos, nativamente onimodais, da equipe MiMo da Xiaomi, lançada em 22 de setembro de 2026. "Nativamente onimodal" faz sentido aqui: o mesmo modelo processa texto, imagens, vídeo e áudio, em vez de acoplar um adaptador de visão a um modelo de texto. Todo checkpoint vem com uma janela de contexto de 1M de tokens sob licença MIT.
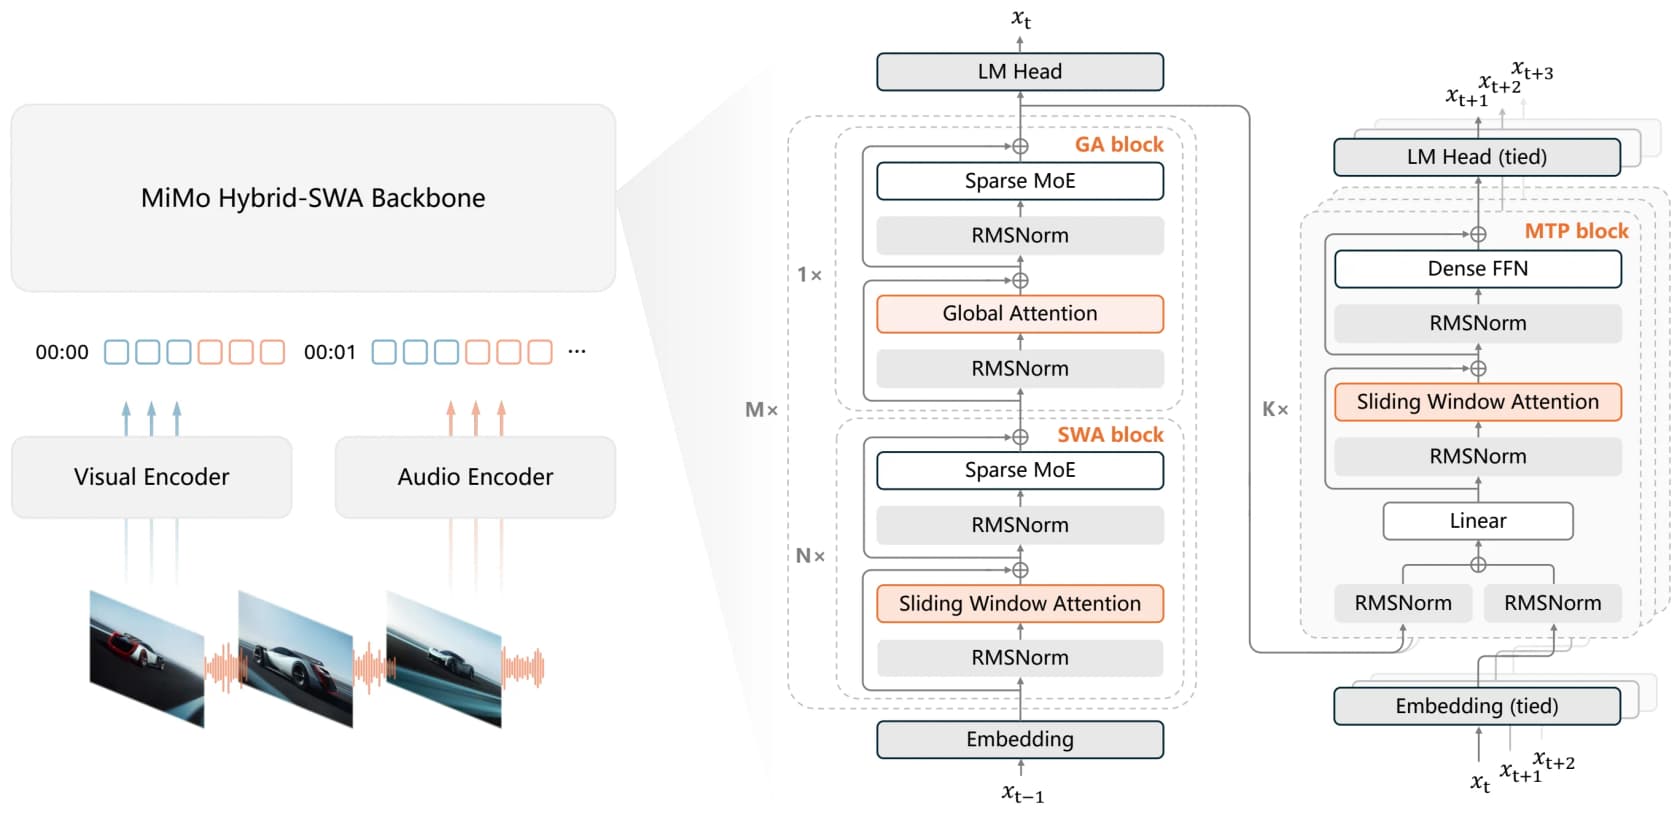
O resumo de quem constrói produto em um parágrafo: o Pro é uma mistura de especialistas esparsa, com 1,02T de parâmetros totais, mas apenas 42B ativos por token, com uma espinha dorsal de atenção híbrida (70 camadas alternando janela deslizante local e atenção global), 384 especialistas roteados dos quais 8 disparam por token, um codificador de visão de 681M, codificadores de áudio, e um decodificador de predição multi-token de 5 camadas. Você não precisa saber nada disso para usá-lo, mas isso explica como um modelo de "um trilhão de parâmetros" continua barato: o que você paga é o número de parâmetros ativos, não o total.
Ele vem em quatro checkpoints, e é daí que vem boa parte da confusão online:
| Modelo | Parâmetros totais | Parâmetros ativos | Contexto | Melhor para |
|---|---|---|---|---|
| MiMo V2.6 Pro | 1,02T | 42B | 1M | O trabalho agêntico mais exigente de longo prazo |
| MiMo V2.6 Flash | 309B | 15B | 1M | O melhor equilíbrio entre inteligência, velocidade e custo |
| MiMo V2.6 Pro UltraSpeed | ~1T | 42B | 1M | Qualidade Pro quando você precisa de saída rápida |
| MiMo V2.6 Distill-Qwen-9B | 9B | 9B | n/a | Uso em uma única GPU e pesquisa de RL agêntico aberta |
O Flash é o que a maioria vai escolher. O UltraSpeed é o mesmo checkpoint Pro servido com uma saída cerca de 10x mais rápida pelo preço 10x maior, então é um sobrepreço de latência, não um modelo mais inteligente. A destilação de 9B é um ajuste fino supervisionado do Qwen3.5-9B sobre dados gerados pelo MiMo, um ponto de partida para pesquisa, e não para produção.
Os benchmarks, lidos com honestidade
Todo lançamento escolhe a dedo seus gráficos, então fui até a tabela de avaliação na ficha do modelo e a dividi em vitórias e derrotas. É preciso reconhecer que a Xiaomi publica ambas.
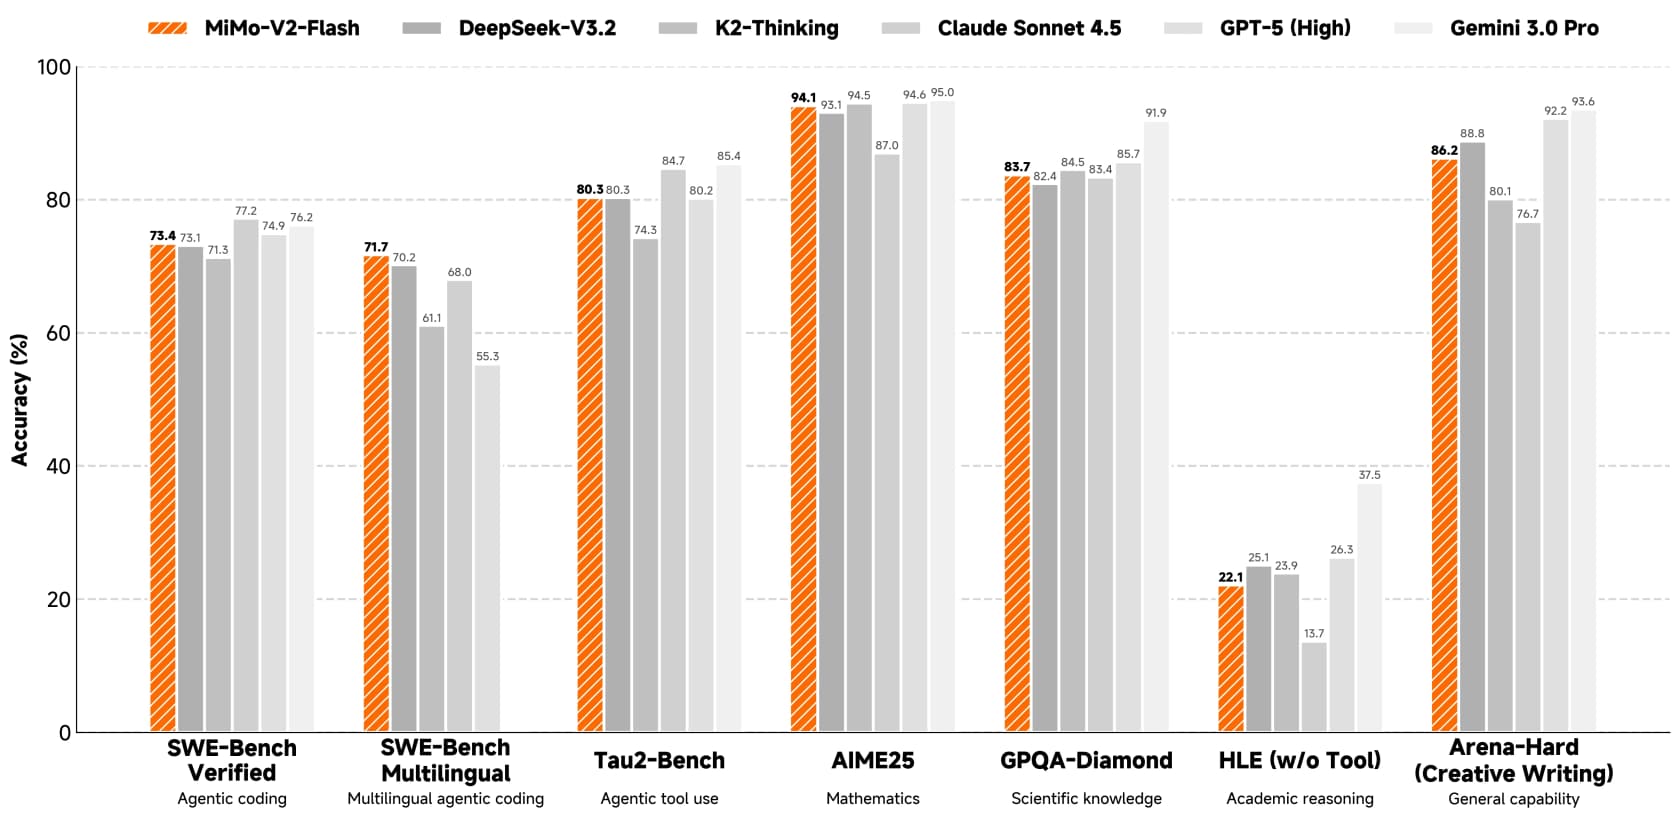
Onde o Pro lidera a fronteira fechada segundo os números da Xiaomi:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| AutomationBench v1.0.6 | 53,1 | 50,3 | 45,8 |
| Terminal Bench 2.1 | 89,9 | 89,1 | 88,8 |
| Agents' Last Exam | 31,6 | 31,6 | 30,8 |
| CyberGym | 94,0 | - | - |
E onde ele fica atrás, algo que o ranking do Terminal Bench 4.0 deixa claro:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 74,0 | 73,0 |
| ProgramBench | 26,5 | 37,0 | 25,0 |
| Terminal Bench 4.0 | 34,9 | 49,0 | 39,9 |
| ExploitBench | 47,9 | 70,0 | 78,5 |
O padrão é consistente e, na minha opinião, crível: o Pro está lado a lado com a fronteira em tarefas gerais de agentes e uso de ferramentas, e fica atrás nos benchmarks de codificação e exploração de longo prazo mais difíceis. Quando a Xiaomi ampliou a comparação para incluir o GPT-6 Astra, o mesmo padrão se manteve: o Pro fica perto do topo no AutomationBench e no Terminal Bench 2.1, e atrás do Astra no Terminal Bench 4.0 (59,6).
O salto geracional é a parte que realmente me impressionou. O MiMo V2.5 Pro anterior marcou 19,0 no DeepSWE v1.1; o V2.6 Pro marca 71,9. No Terminal Bench 4.0, foi de 1,5 para 34,9. Isso não é incremental, é o tipo de salto que só se vê quando um laboratório muda sua abordagem de treinamento.
Um número merece um sinal de alerta em vez de um aplauso. O Pro marca 94,0 no CyberGym, onde o V2.5 mal chegava a 40,0, mas o ExploitBench, mais adversarial, conta uma história mais modesta com 47,9. Eu leria o resultado do CyberGym como impressionante, não como consolidado.
A conta de custo-benefício é a verdadeira história
Rankings isolados são ruidosos. O número que eu realmente acompanho é o índice agregado da Artificial Analysis, porque ele combina muitas avaliações em uma pontuação comparável e a coloca em gráfico contra o custo.
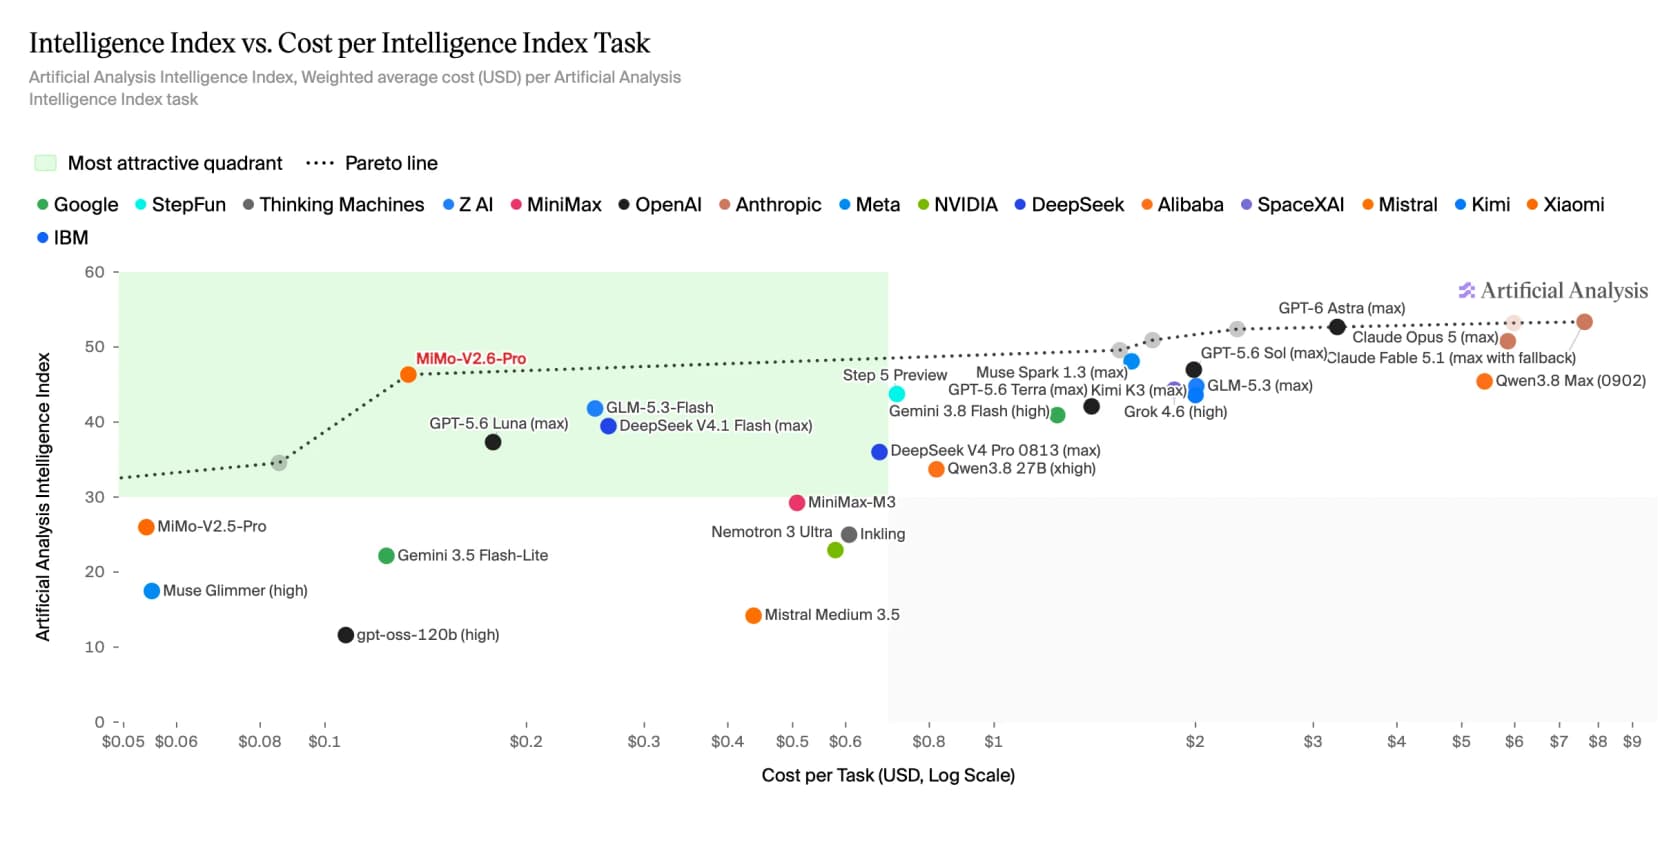
O MiMo V2.6 Pro chega a um Intelligence Index de 46, o melhor modelo de pesos abertos do mercado, exatamente no que a Artificial Analysis chama literalmente de "quadrante mais atraente". A fronteira fechada pontua mais alto em inteligência bruta (Astra, Opus 5 e Fable 5.1 ficam entre 50 e poucos e a metade dos 50), mas a $3-$8 por tarefa. O MiMo alcança seu 46 por cerca de $0,13.
Essa relação preço-inteligência é todo o argumento de venda. Aqui estão os preços hospedados da OpenRouter, por milhão de tokens, verificados na semana de lançamento:
| Modelo | Entrada / 1M | Saída / 1M | Contexto |
|---|---|---|---|
| MiMo V2.6 Flash | $0,14 | $0,28 | 1M |
| MiMo V2.6 Pro | $0,435 | $0,87 | 1M |
| MiMo V2.6 Pro UltraSpeed | $4,35 | $8,70 | 1M |
O Flash, com $0,14 de entrada / $0,28 de saída, é notavelmente barato para um modelo onimodal com contexto de 1M. Para a maioria das equipes, o Flash é o padrão e o Pro é para onde você escala.
Qual checkpoint do MiMo V2.6 combina com você
A grade de quatro checkpoints é, de longe, a coisa mais confusa desse lançamento, então aqui está uma ferramenta rápida de decisão. Responda às três perguntas e ela vai apontar o checkpoint certo (ou te afastar do MiMo por completo).
O que quem realmente usou disse
Benchmarks são a história da Xiaomi; eu queria a história dos usuários. A reação dominante no tópico de lançamento não foi sobre as pontuações. Foi sobre o quão abertamente a Xiaomi treinou o modelo.
"I really like how transparent they've been about the training of this model. The realtime dashboard they shared during training was an incredible learning and teaching tool for me, and they've been unusually comprehensive in sharing details about their methodology... and benchmark scores (even the stuff they didn't do well on)."

"The best thing they did is being open about all the setbacks they had to deal with. They logged every restart with a reason, talked about dropping a cyber dataset after it degraded coding benchmarks. Also published real time training loss, benchmark scores after every checkpoint and running cost estimates."
Esse detalhe sobre descartar um conjunto de dados de ciber-segurança por ele prejudicar as pontuações de codificação é o tipo de coisa que laboratórios quase nunca admitem, e é uma grande parte do motivo pelo qual o lançamento conquistou boa vontade até de céticos. A leitura técnica mais afiada veio de um usuário de longa data do MiMo que contou os rankings manualmente:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."
Nem tudo foi elogio. A preocupação que acompanha todo modelo aberto forte vindo da China é o benchmaxxing, boas pontuações e trabalho real decepcionante:
"No chinese lab has caught up yet. They've tried to fake it by distilling and overfitting on benchmarks to make their models look better than they are, the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."
O contrapeso veio de gente que já roda a linha em produção. A reflexão sobre custo-benefício é a que mais fica na minha cabeça, embora seja sobre o V2.5 anterior, que várias pessoas também chamaram de rápido, mas burro em tarefas difíceis:
"I been using MiMo-V2.5 to do most of my work as software engineer... I been VERY happy with ROI. The model is very powerful!... The cost is unbelievably low, and the quality of intelligence I get is equivalent to when I was working mostly with Anthropic models... but when I add cost of M-token in the ROI math, Jeez! MiMo is an order of magnitude better."
No X, o lançamento foi lido principalmente como uma provocação ao Grok 4.7, lançado no mesmo dia, com reações que vão de "Better than Grok 4.7" a um comedido "let's wait for real-world test performance first." Essa ressalva sobre o mundo real é a correta, e é exatamente por isso que a reputação do V2.5 de "rápido, mas burro em tarefas difíceis" é a régua que o V2.6 precisa superar no uso diário, não só nos gráficos.
Meu veredito: o melhor custo-benefício em pesos abertos, não o modelo mais inteligente
É aqui que eu chego depois de uma semana com a pesquisa.
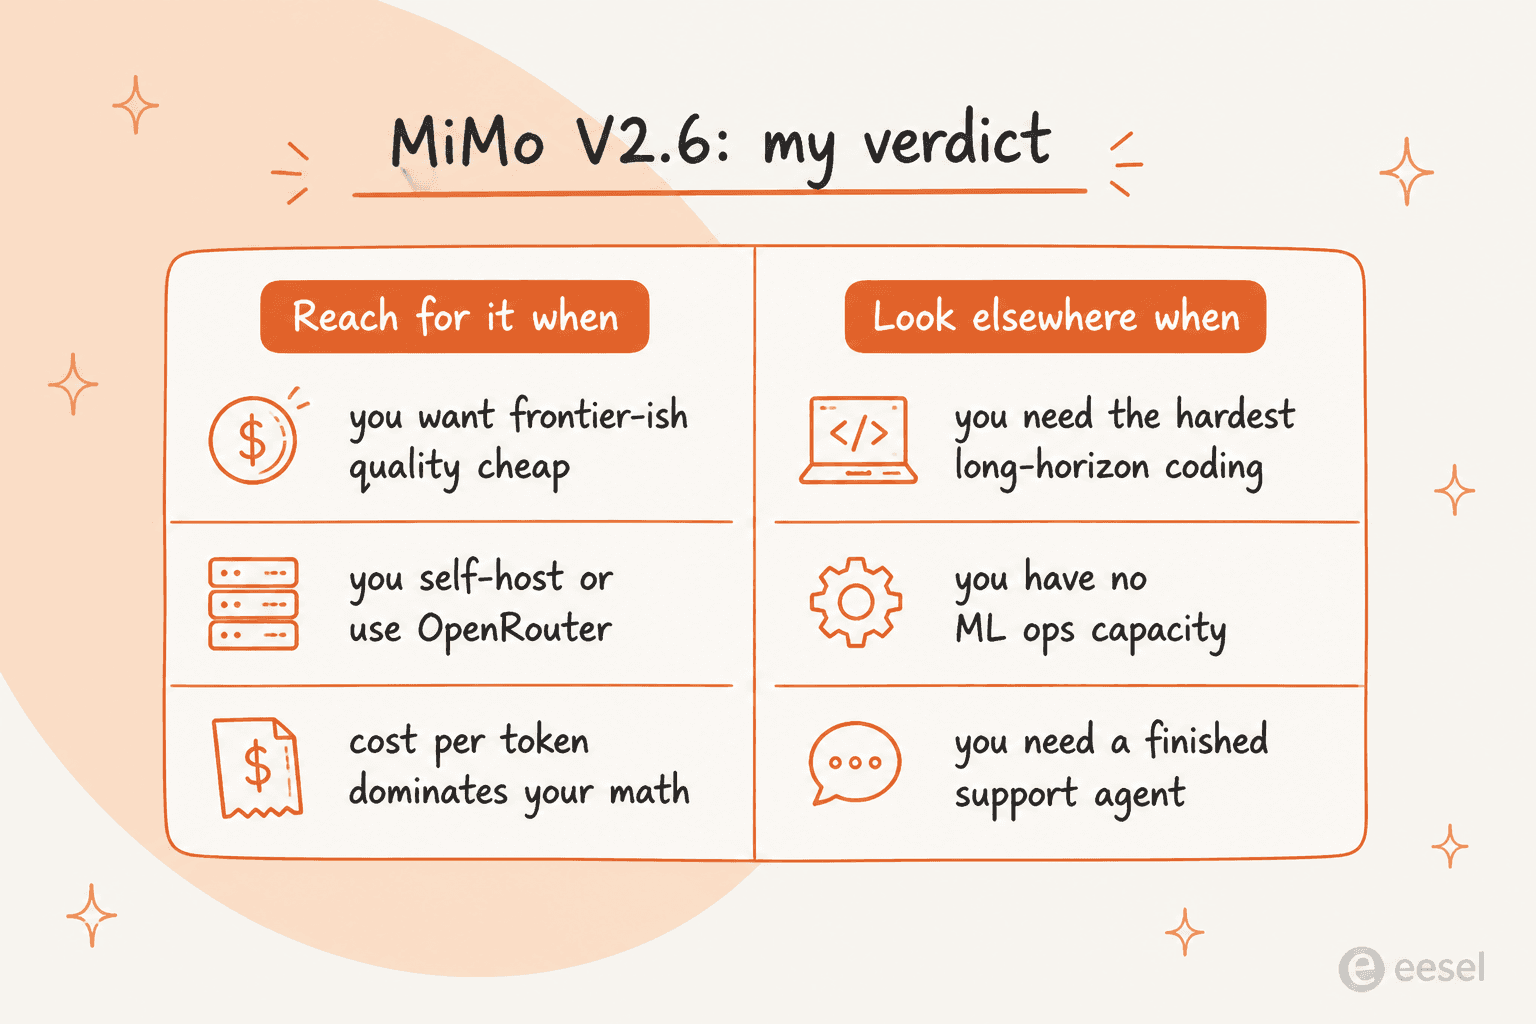
Recorra ao MiMo V2.6 quando o custo por token dominar suas contas, você estiver confortável hospedando por conta própria ou usando a OpenRouter, e quiser qualidade quase de ponta em trabalho geral de agentes e uso de ferramentas. O Flash em particular é uma escolha padrão forte para tarefas do dia a dia de alto volume, onde o preço por token da fronteira fechada doeria.
Procure outra opção quando sua carga de trabalho for a codificação ou o trabalho de exploração de longo prazo mais difícil, em que o Pro fica mensuravelmente atrás do Astra e do Opus 5; quando você não tiver capacidade de operar infraestrutura de modelos nem um plano para a conta de serviço; ou quando você realmente precisar de um agente pronto que faça um trabalho, não de um modelo bruto. Nesse último ponto, o MiMo não é a ferramenta, e nenhum outro modelo sozinho também não é.
Em termos de avaliação, como aposta de custo-benefício entre pesos abertos, eu o colocaria perto do topo do pelotão atual, ao lado do DeepSeek V4.1 Flash e do Qwen 3.8 Max. Quanto à alegação de "superar a fronteira fechada", a resposta honesta é: em preço, sim; nos benchmarks mais difíceis, ainda não. Para um panorama mais amplo, nosso resumo dos melhores agentes de IA de código aberto é uma boa próxima leitura.
A parte que uma análise de modelo costuma pular: um motor não é um funcionário
Passei os últimos anos ajudando a colocar IA em filas de suporte reais, e o lançamento do MiMo V2.6 confirma o que aprendemos da maneira mais difícil: o modelo não é mais o gargalo.
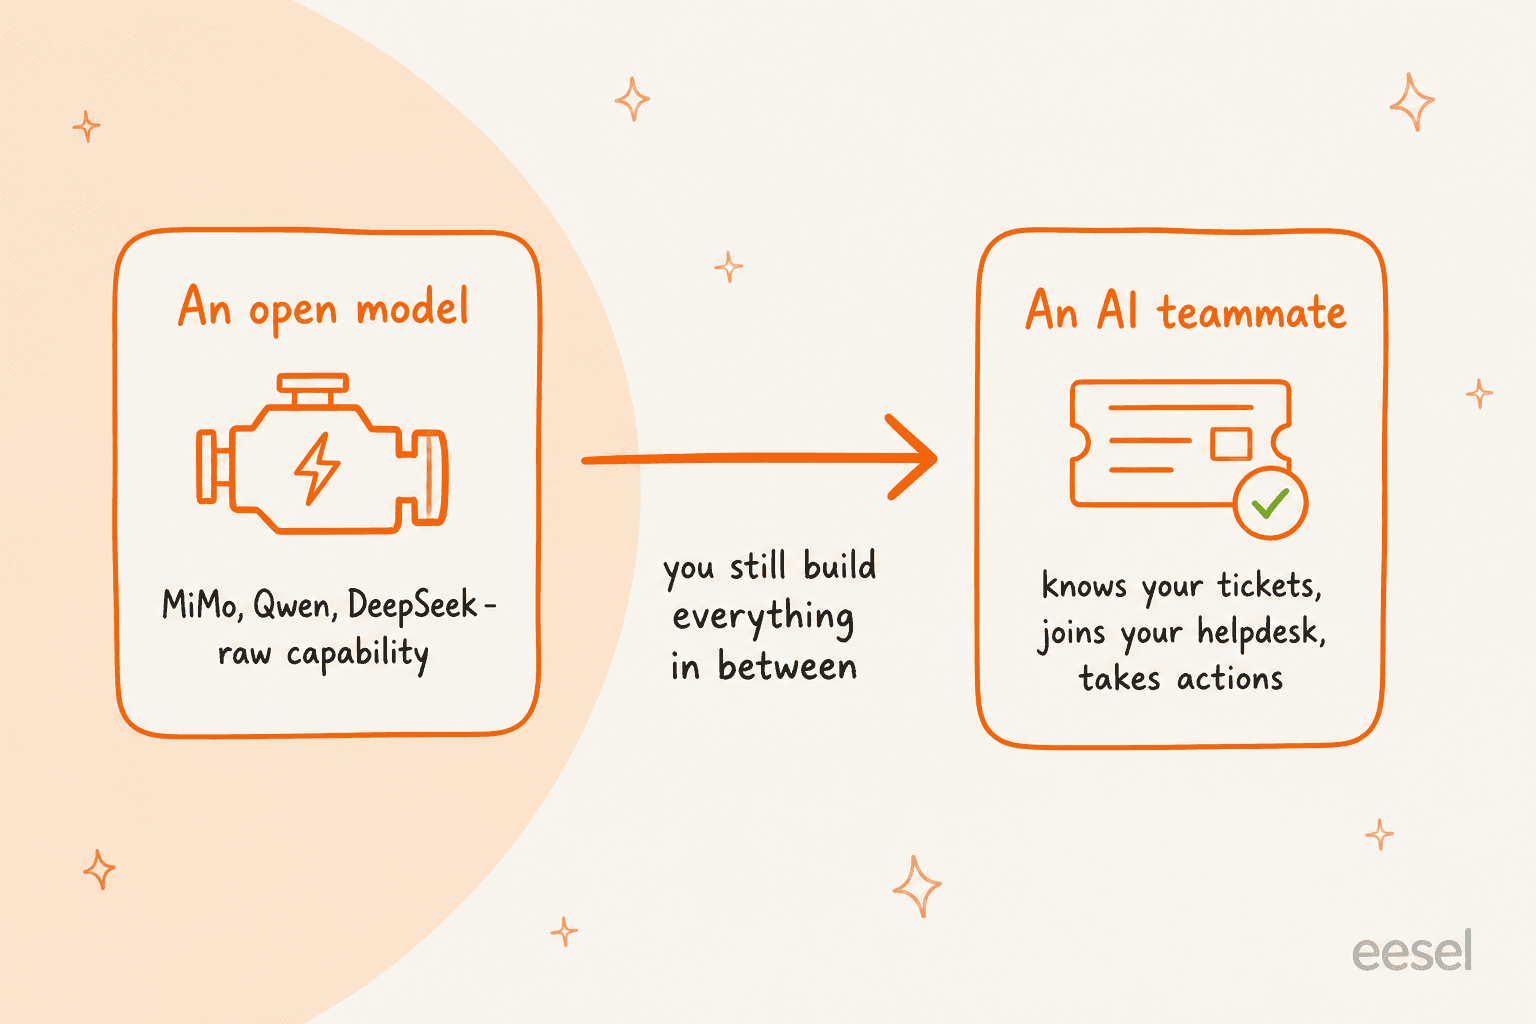
MiMo V2.6, DeepSeek, Qwen, Claude, GPT: qualquer um deles consegue escrever uma resposta fluente e com aparência correta para uma pergunta de cliente. Isso era a parte assustadora há dois anos. Está resolvido. O que nenhum deles faz de fábrica é o trabalho de verdade: ler seu centro de ajuda específico e os tickets passados, seguir sua política de reembolso em vez de uma inventada, mas plausível, consultar um pedido, marcar e rotear o ticket, saber quando escalar, e ser testado antes de responder a um cliente real.
Esse último ponto é aquele em que eu não abriria mão. Já vimos modelos que soam confiantes darem respostas erradas em filas reais, por isso todo lançamento é simulado primeiro contra tickets históricos. Um 46 no índice AA não te diz nada sobre como um modelo lida com sua política de devolução esquisita e fora do padrão. Uma simulação sobre seus últimos 5.000 tickets, sim. Se você está escolhendo um modelo especificamente para suporte, nosso guia sobre o melhor modelo de IA para tickets de suporte e o detalhamento de custo de agente de IA vs. agente humano são as duas próximas leituras que eu recomendaria.
Experimente a eesel
O ponto central desta análise é que um modelo aberto como o MiMo V2.6 é infraestrutura, capacidade bruta que você ainda precisa transformar em algo que faça um trabalho. A eesel é a camada que transforma um modelo em um colega de equipe funcional. Você contrata um agente de IA para helpdesk pronto para trabalhar que se conecta ao helpdesk que você já usa (Zendesk, Freshdesk, Gorgias, Help Scout, e mais de 1000 integrações), treina com seus tickets passados e sua base de conhecimento, e começa a redigir ou enviar respostas sem precisar de operações de modelo.

O diferencial é aquele que os próprios benchmarks do MiMo não conseguem te dar: antes de um agente eesel responder a um único cliente ao vivo, você o simula com seu histórico real de tickets e vê a taxa exata de resolução e as respostas que teria obtido. E como a eesel é uma plataforma de colegas de equipe, a mesma conta também roda um redator de blog com IA. Para desenvolvedores que gostaram da afinidade do MiMo com o terminal, a eesel expõe o mesmo colega de equipe por meio de uma CLI, API e MCP públicos, de modo que uma pessoa, um script ou um agente de codificação podem operá-lo pelo terminal.
Você pode começar de graça, sem cartão de crédito e sem ligação de vendas, e ter um colega de equipe no ar em minutos. O modelo ficou barato. Fazer com que ele realmente faça o trabalho ainda é a parte interessante.
Perguntas frequentes
O Xiaomi MiMo V2.6 é bom?
Quanto custa rodar o Xiaomi MiMo V2.6?
O Xiaomi MiMo V2.6 é melhor que o Kimi K3 ou o DeepSeek?
Posso hospedar o Xiaomi MiMo V2.6 por conta própria?
Qual modelo do MiMo V2.6 devo usar?
Devo usar o Xiaomi MiMo V2.6 para atendimento ao cliente?
A transparência de benchmarks do Xiaomi MiMo V2.6 é real?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.