O que o Gemini 3.8 Flash realmente é
O Gemini 3.8 Flash é o mais novo modelo multimodal rápido e barato do Google, disponível como gemini-3.8-flash na API do Gemini e como modelo padrão no ambiente de desenvolvimento agêntico Antigravity do Google. Ele recebe texto, imagens, áudio, vídeo e PDFs, e produz texto, com uma janela de entrada de 1M de tokens e 64K de saída. Se você quiser o detalhamento completo do lançamento, eu cobri isso no meu panorama do Gemini 3.8 Flash, e o lado financeiro está no post sobre os preços do Gemini 3.8 Flash. Este aqui é a análise: vale o seu tempo, e onde ele realmente se encaixa.
O fato mais útil para uma análise é um que ninguém colocou numa manchete: este não é um modelo novo. A ficha do modelo afirma, textualmente e em quatro seções separadas, que "Gemini 3.8 Flash is based on Gemini 3.7 Flash." Arquitetura, dados de treinamento, hardware e política de segurança todos remetem à ficha do 3.7 Flash. Então o 3.8 é uma passagem de pós-treinamento sobre a base do 3.7. Isso explica o ritmo de três semanas, e explica por que o preço não mudou nem um centavo. Leia esta análise como a resposta a "vale a pena migrar por causa do pós-treinamento extra", porque essa é a pergunta real.
O único número que decide esta análise
Todo post de lançamento destacou a velocidade. Aqui está o número que reformula isso. A Artificial Analysis mede o Gemini 3.8 Flash em 305,1 tokens por segundo, na posição #3 de 195 modelos. Isso é real e impressionante. Mas a mesma página de medição também reporta um tempo até o primeiro token de 13,30 segundos, enquanto o modelo de raciocínio mediano na sua faixa de preço fica em 2,99s.
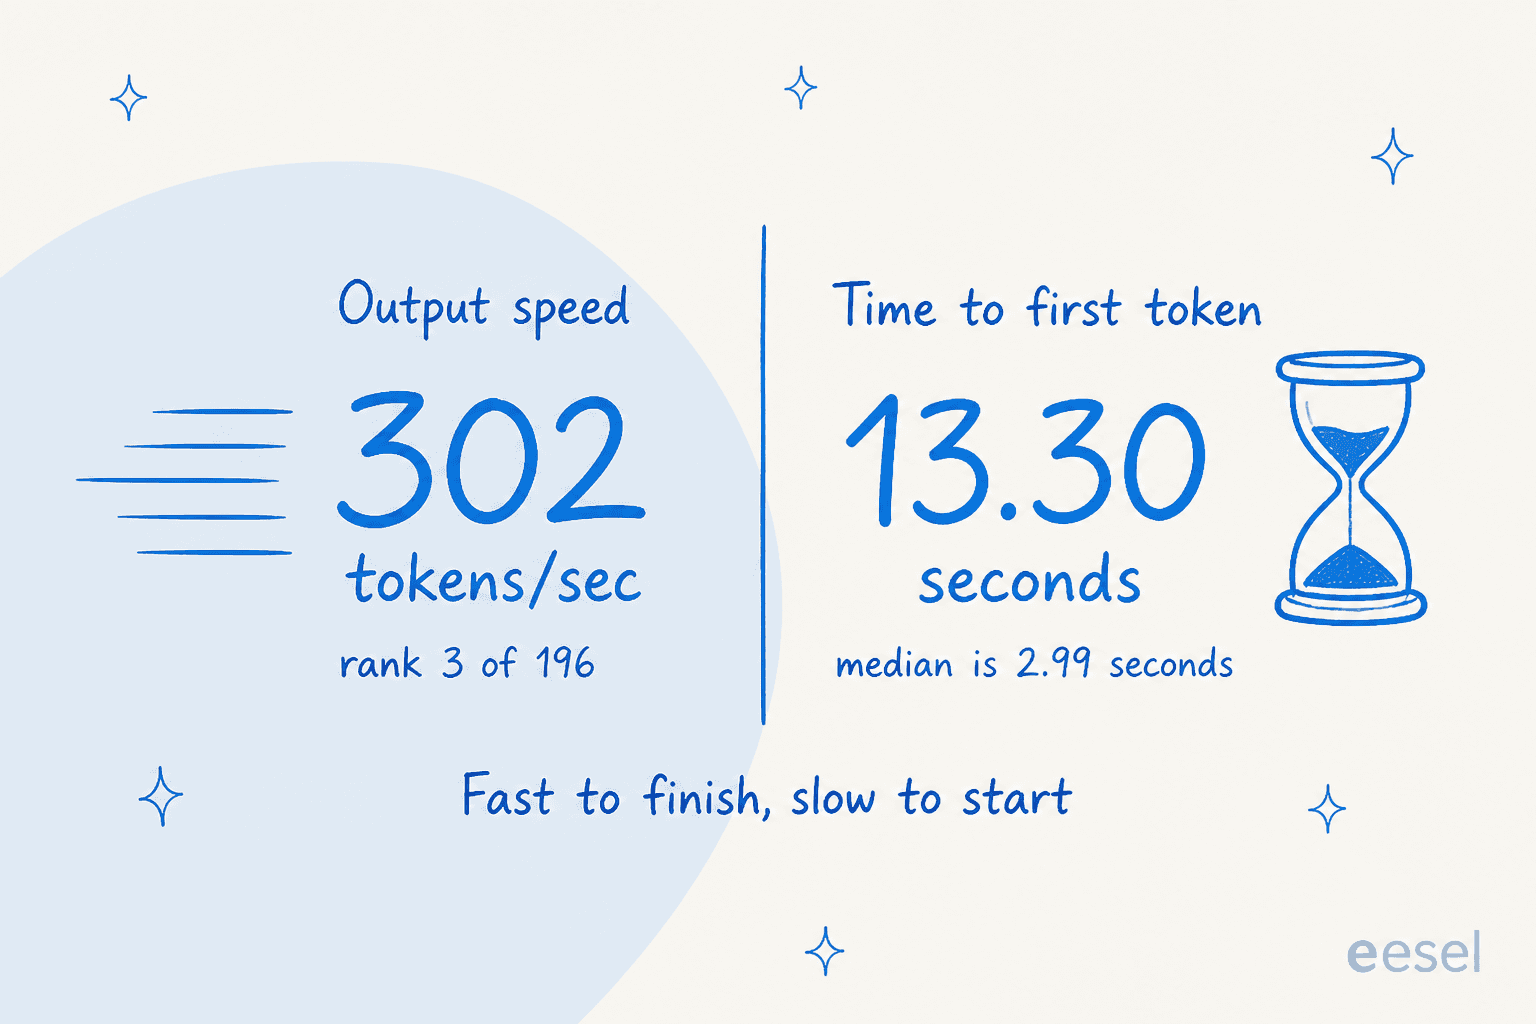
Esses dois números descrevem experiências completamente diferentes. Throughput é a velocidade com que o texto flui depois que começa. Tempo até o primeiro token é quanto tempo a pessoa que lê fica olhando para uma caixa vazia antes que qualquer coisa apareça. Para um agente em lote trabalhando durante a noite em um repositório, 13 segundos de pensamento inicial são invisíveis e o throughput é tudo. Para uma pessoa olhando um widget de chat, ou um agente de suporte esperando por uma resposta sugerida, 13 segundos de silêncio são toda a experiência, e nenhuma velocidade posterior salva isso.
É por isso que eu continuo questionando a ideia de que "3.8 Flash is the fast one". Ele é o rápido para máquinas e o lento para humanos. Essa única distinção classifica quase todos os casos de uso que consigo imaginar, e é o motivo pelo qual os benchmarks abaixo importam menos do que parecem.
Onde ele é realmente bom
Dê a ele uma tarefa longa de codificação agêntica e o 3.8 Flash ganha seu lugar. Pelos próprios números do Google, ele lidera o HLE-Verified com 54,9% (na frente do GPT-5.6 Sol, Claude Opus 5 e do seu próprio antecessor), vence o benchmark Vals Finance Agent v2 com 61,4%, e fica no topo do DeepSWE para trabalho de software de longo alcance. O fornecedor de benchmarks david resumiu o apelo com clareza: "5x cheaper and 2x faster than Opus 5 for similar intelligence."
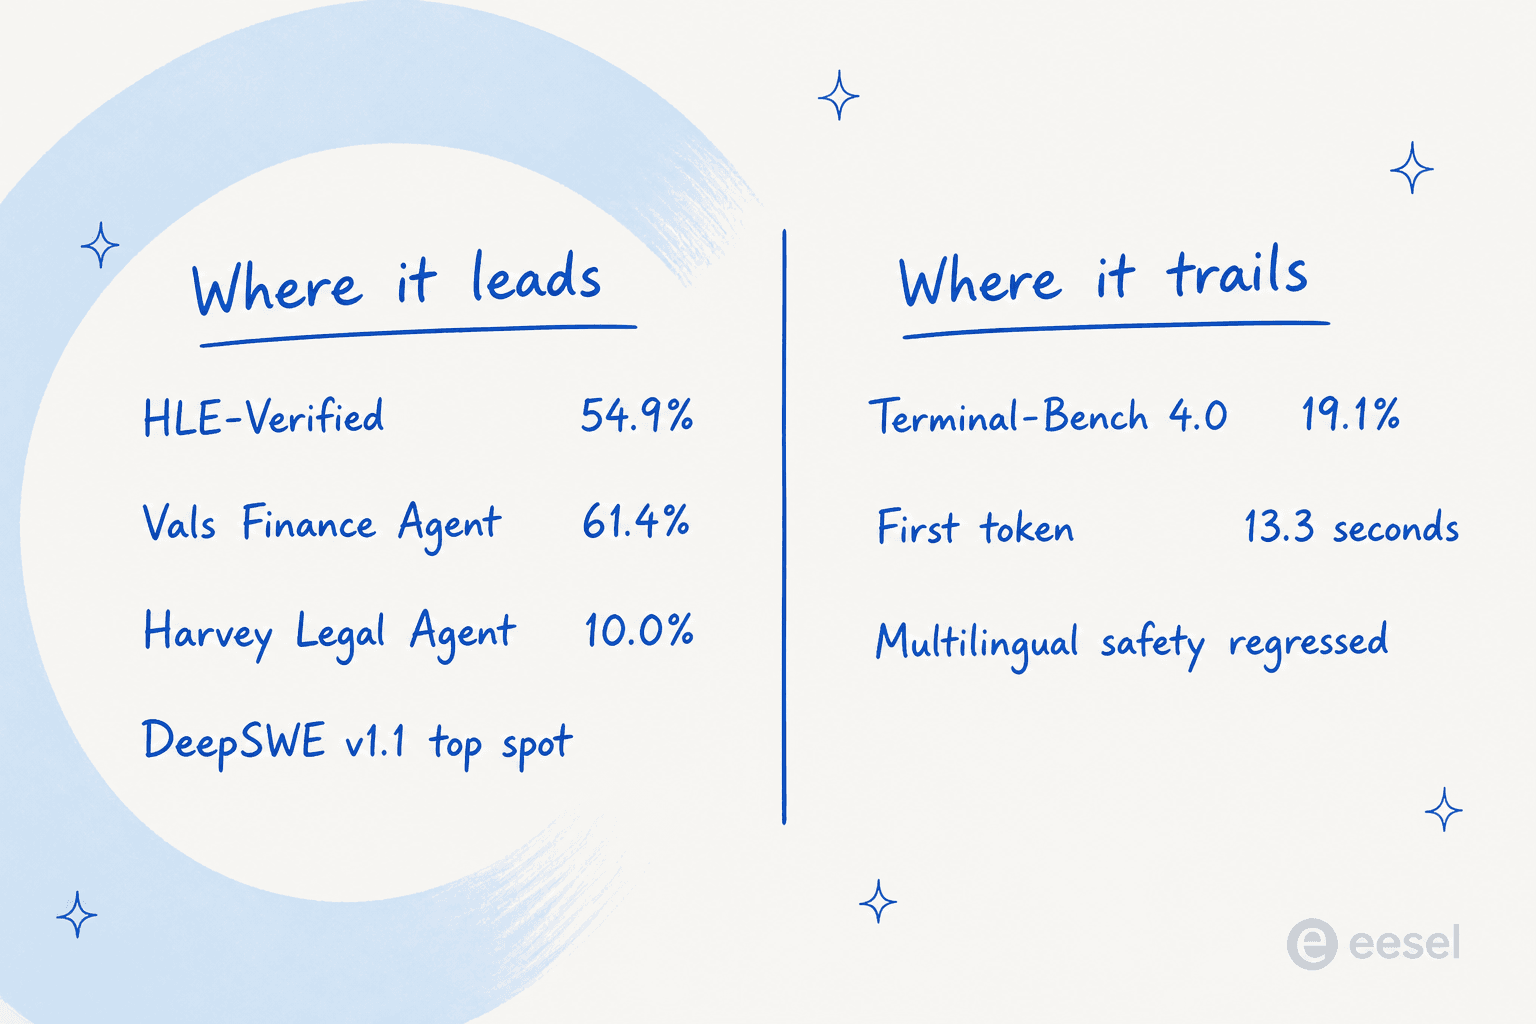
O Intelligence Index sustenta a história da codificação: 59 pontos na Artificial Analysis, empatando com o Claude Opus 5 em esforço médio, o que para um modelo da classe Flash é um resultado forte. E o comportamento de longo alcance é real, não um artefato de benchmark. O parceiro de design Thai Tran, da Glean relatou que ele conseguiu "completing more than three times as many tasks as Gemini 3.7 Flash in our evaluations" em fluxos de trabalho intensos em documentos. No Hacker News, simonw gerou uma visualização em HTML em 13 segundos por 1,8 centavos e chamou a combinação de velocidade e qualidade de frontend de "pretty exciting."
Meu padrão favorito do mundo real veio de panarky, que usa o Flash como auditor em vez de construtor:
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus. Can't wait to try 3.8 Flash. If it's good enough, maybe I'll switch Flash to primary and make Opus the auditor."

Esse é o tipo de carga de trabalho para o qual o 3.8 Flash foi construído: barato, rápido, incansável, disposto a encarar uma tarefa longa. Se isso é você, ele merece um lugar na sua lista curta junto com as outras melhores ferramentas de assistente de IA para codificação.
Onde ele falha
O mesmo design "works harder" que vence os benchmarks de codificação é o que o torna estranho em todo o resto. O Google é incomumente honesto sobre isso no post de lançamento: o 3.8 Flash "exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance." Traduzindo: ele pensa muito, e você paga por esse pensamento.
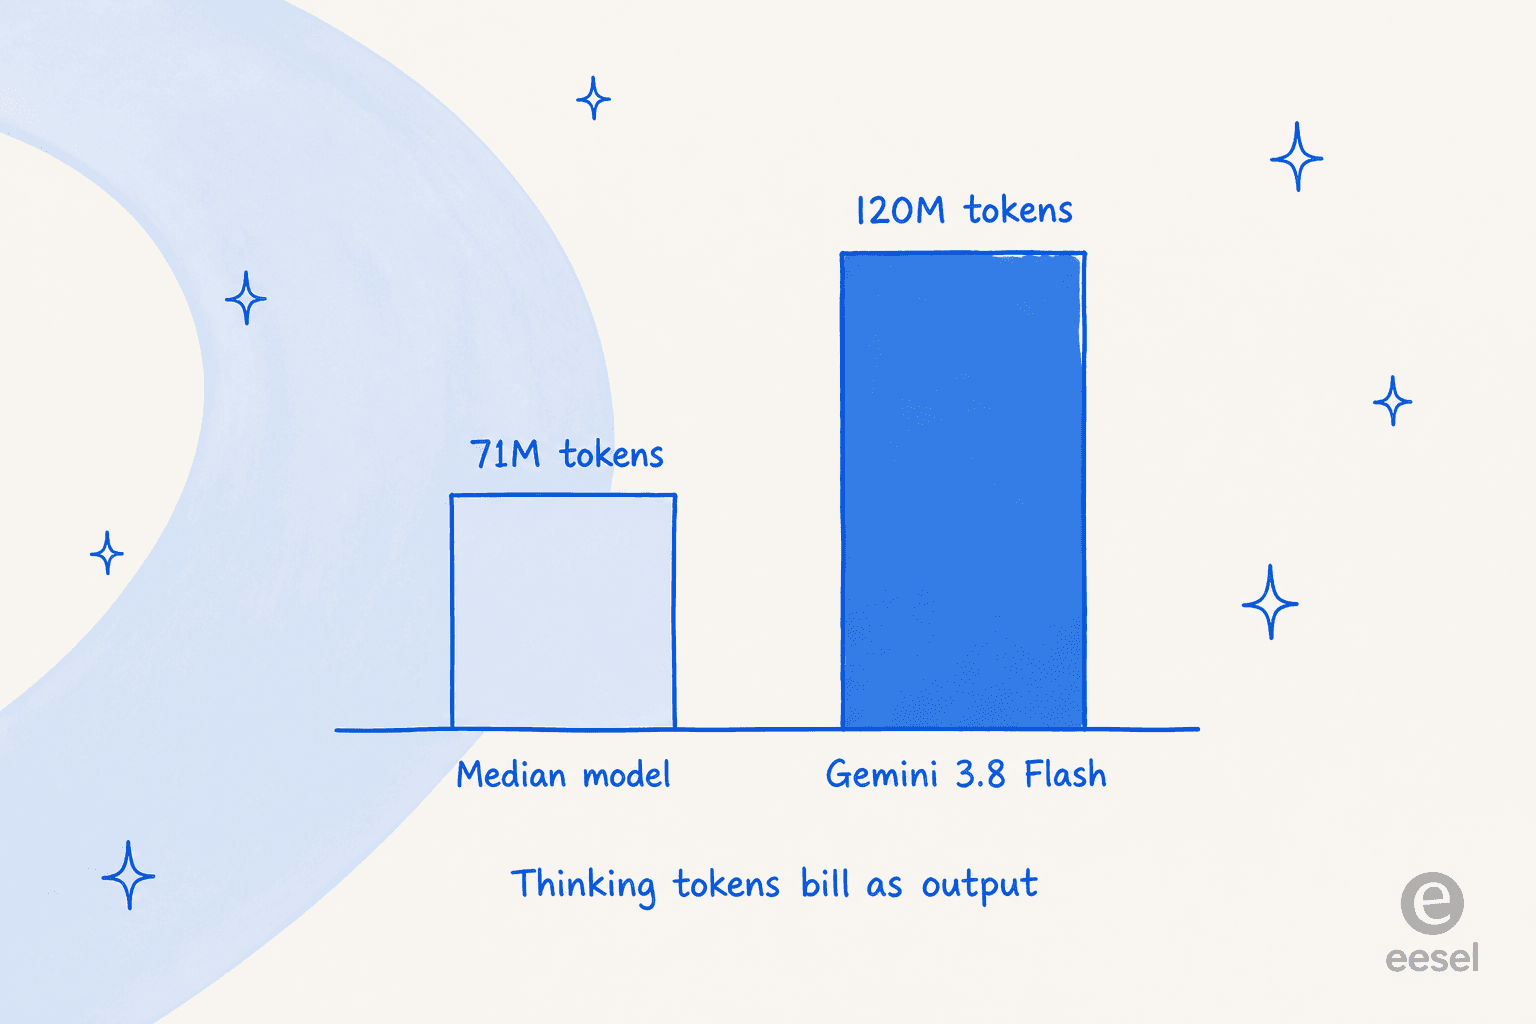
A Artificial Analysis o marcou como "very verbose": 120M de tokens de saída para executar o Index contra uma mediana de 71M. Como o Gemini cobra tokens de raciocínio na tarifa de saída de $3,75, essa prolixidade é um multiplicador de custo direto que o preço de tabela esconde. O usuário do HN bermudi colocou um número nisso, cerca de 11 mil tokens a mais por tarefa do que o 3.7 no mesmo benchmark, "making it more expensive and slower in practice than the headline rate suggests." Meu post sobre os preços do Gemini 3.8 Flash tem a aritmética completa, mas a versão curta é que uma tarifa por 1M mente quando o modelo escolhe emitir mais desses milhões.
Depois tem a babá. mythz capturou uma frustração que compartilho:
"Whilst it's a fast model, having to baby sit through and approve prompts every few seconds ends up making it slower than the Auto approve modes of Claude/ChatGPT."
E ele pode exagerar em prompts simples. refulgentis relatou ter digitado "Hi" e receber um app de quatro painéis com um widget de clima falso e uma lista de tarefas. É uma coisa pequena, mas é o sinal de um modelo ajustado para fazer o máximo de trabalho, que é exatamente o que você não quer numa tarefa estreita e bem definida.
Mais dois alertas honestos. No Terminal-Bench 4.0 ele marca 19,1% contra os 51,8% do Opus 5, então "matches Opus 5" só é verdade nos benchmarks que o Google escolheu mostrar. E a ficha do modelo registra duas métricas de segurança que regrediram: segurança multilíngue em 5,4 pontos percentuais e recusas injustificadas em 1,1 ponto percentual, com o Google afirmando claramente que "safety performance across non-English languages regressed slightly." A avaliação completa de Frontier Safety nem foi refeita; foi herdada do 3.7 por inferência. Nenhum desses pontos é decisivo por si só, mas são o tipo de detalhe que uma análise justa precisa mencionar.
O que as pessoas realmente disseram depois de testar
A leitura da comunidade está dividida de uma forma útil, e se encaixa quase exatamente na divisão máquina-versus-humano acima.
As pessoas que rodam tarefas longas de codificação geralmente gostaram. Selta chamou de "quite a big update," destacando os ganhos no raciocínio de codificação e menos alucinações mantendo a velocidade. Conor Dart disse "Google is back... this model takes its time to think and work through the tasks." E scrlk levantou um ponto que os benchmarks ignoram completamente: "Gemini's speed and quality doesn't degrade badly during weekday working hours compared to OAI, and especially Anthropic." Consistência sob carga é uma vantagem real.
As pessoas que esperavam um salto ficaram mais frias. markasoftware notou que na Artificial Analysis ele só empata com "opus 5 medium effort," e que "opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference." zuzululu chegou à mesma conclusão que eu: "i might consider 3.8 flash for simple side hobby projects or quick scaffolding but would not trust it for long agentic tasks." E pkos98 ofereceu o ceticismo mais saudável sobre qualquer benchmark de dia de lançamento: "Wait a week with your judgement, most likely, Google is just bench-maxing very hard."
Há também uma reclamação estrutural que vale destacar. Kol Tregaskes apontou que este é o quarto modelo Flash seguido "with no Pro model." Isso não é uma crítica ao 3.8 Flash em si, mas é o contexto: reportagens sugerem que o 3.5 Pro está sendo pulado completamente, então o Flash está carregando a carga de topo de linha enquanto falta um modelo de nível Pro na formação. Se você está comparando entre fornecedores, ChatGPT vs Gemini e meu panorama de alternativas ao Gemini são os dois pontos de partida mais úteis.
O veredito: você deve migrar do 3.7 Flash?
Como o preço é idêntico, essa é a única comparação que importa, e ela é mais clara do que a maioria das decisões de upgrade.
| Se sua carga de trabalho é... | A escolha | Por quê |
|---|---|---|
| Codificação agêntica de longo alcance, tarefas intensas em documentos, um agente em lote noturno | Gemini 3.8 Flash | Genuinamente melhor nos benchmarks que importam aqui, pelo mesmo preço; o pensamento extra compensa |
| Sensível à latência, com humano no loop (chat, assistência em tempo real) | Gemini 3.7 Flash | O custo de 13,30s até o primeiro token afeta uma pessoa diretamente; a prolixidade extra é overhead puro |
| Voltado a custo, alto volume, chamadas simples (classificação, OCR, extração) | Gemini 3.7 Flash | O Google diz isso claramente: "remains fully supported for efficiency-first workloads" |
| Um auditor para verificar o trabalho de um modelo maior | Qualquer um dos Flash | Barato e rápido o suficiente para que usá-lo como revisor seja um padrão inteligente |
O veredito é que o 3.8 Flash é um upgrade real para exatamente um tipo de trabalho, e um downgrade disfarçado para outro. O Google entregar os dois pelo mesmo preço não é generosidade, é uma admissão de que o modelo mais novo troca eficiência por diligência, e só você sabe em qual lado dessa troca sua carga de trabalho está. Mais uma coisa para considerar no orçamento: a tarifa de $0,75 é uma promoção que dobra para $1,50 em 1º de janeiro de 2027. Quem está orçando com o número de hoje está orçando com um desconto.
O que isso significa se você vai colocar IA em uma fila de suporte
Aqui é onde eu preciso ser direto, porque testo esses modelos especificamente para responder à pergunta que as equipes de suporte não param de me fazer: "which model should we point at our tickets?"
A resposta honesta é que o modelo é a coisa errada para se buscar. Uma carga de trabalho de suporte é o quase-perfeito inverso do que o 3.8 Flash faz bem. Tickets são de contexto curto, não de longo alcance. O volume é alto, então a latência se acumula, e um atraso de 13 segundos até o primeiro token multiplicado por milhares de conversas é um custo real. E um modelo bruto não te dá nenhuma das partes que realmente fazem a automação de suporte funcionar: ele não conhece sua central de ajuda, não consegue ler seus tickets anteriores, não se integra ao Zendesk ou Freshdesk, e não tem como te mostrar o que teria dito antes de dizer isso a um cliente.
Já vi bots de voz confiante darem respostas erradas silenciosamente em filas em tempo real, que é a falha que uma pontuação de benchmark nunca pode te alertar sobre. É por isso que o que me importa não é o Intelligence Index do modelo, mas sim se o sistema em torno dele pode ser simulado contra seus tickets reais primeiro. Um modelo é infraestrutura. O que uma equipe de suporte realmente precisa é do funcionário, conectado ao helpdesk com o contexto e as salvaguardas já em vigor. A escolha do modelo por baixo disso é um detalhe que a plataforma deveria cuidar, não uma decisão que você deveria tomar lendo benchmarks de lançamento.
Experimente a eesel
Se o que você realmente quer é IA respondendo tickets em vez de um modelo para você mesmo integrar, a eesel é onde eu começaria. A eesel vende colegas de equipe de IA prontos para trabalhar em vez de infraestrutura bruta, e o colega de helpdesk com IA entra na sua fila existente no Zendesk, Freshdesk ou Gorgias, treinado com sua central de ajuda e seus tickets anteriores, em poucos minutos.

O diferencial é a parte que os benchmarks de modelo não conseguem te dar. Todo lançamento da eesel é simulado contra seus tickets históricos reais primeiro, para você ver o que a IA teria dito a clientes que você já atendeu, antes de dizer qualquer coisa a um cliente ao vivo. Ela também cuida do trabalho nada glamouroso, como classificação de tickets e marcação de suporte, e é gratuita para testar. O colega redator de blog com IA roda na mesma plataforma se conteúdo, não suporte, for o seu gargalo.
No lado dos números, economia de custos com IA em suporte tem a matemática, e custo de agente versus humano é a comparação que as equipes financeiras realmente pedem. E se você ainda está comprando modelos em vez de produtos, os melhores agentes de IA e os melhores agentes de IA para pequenas empresas são os dois panoramas que eu leria a seguir.
Perguntas frequentes
Vale a pena migrar para o Gemini 3.8 Flash a partir do 3.7 Flash?
Quanto custa o Gemini 3.8 Flash?
Por que o Gemini 3.8 Flash é tão prolixo?
O Gemini 3.8 Flash é bom para um chatbot de atendimento ao cliente?
Como o Gemini 3.8 Flash se compara ao Claude Opus 5?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.