

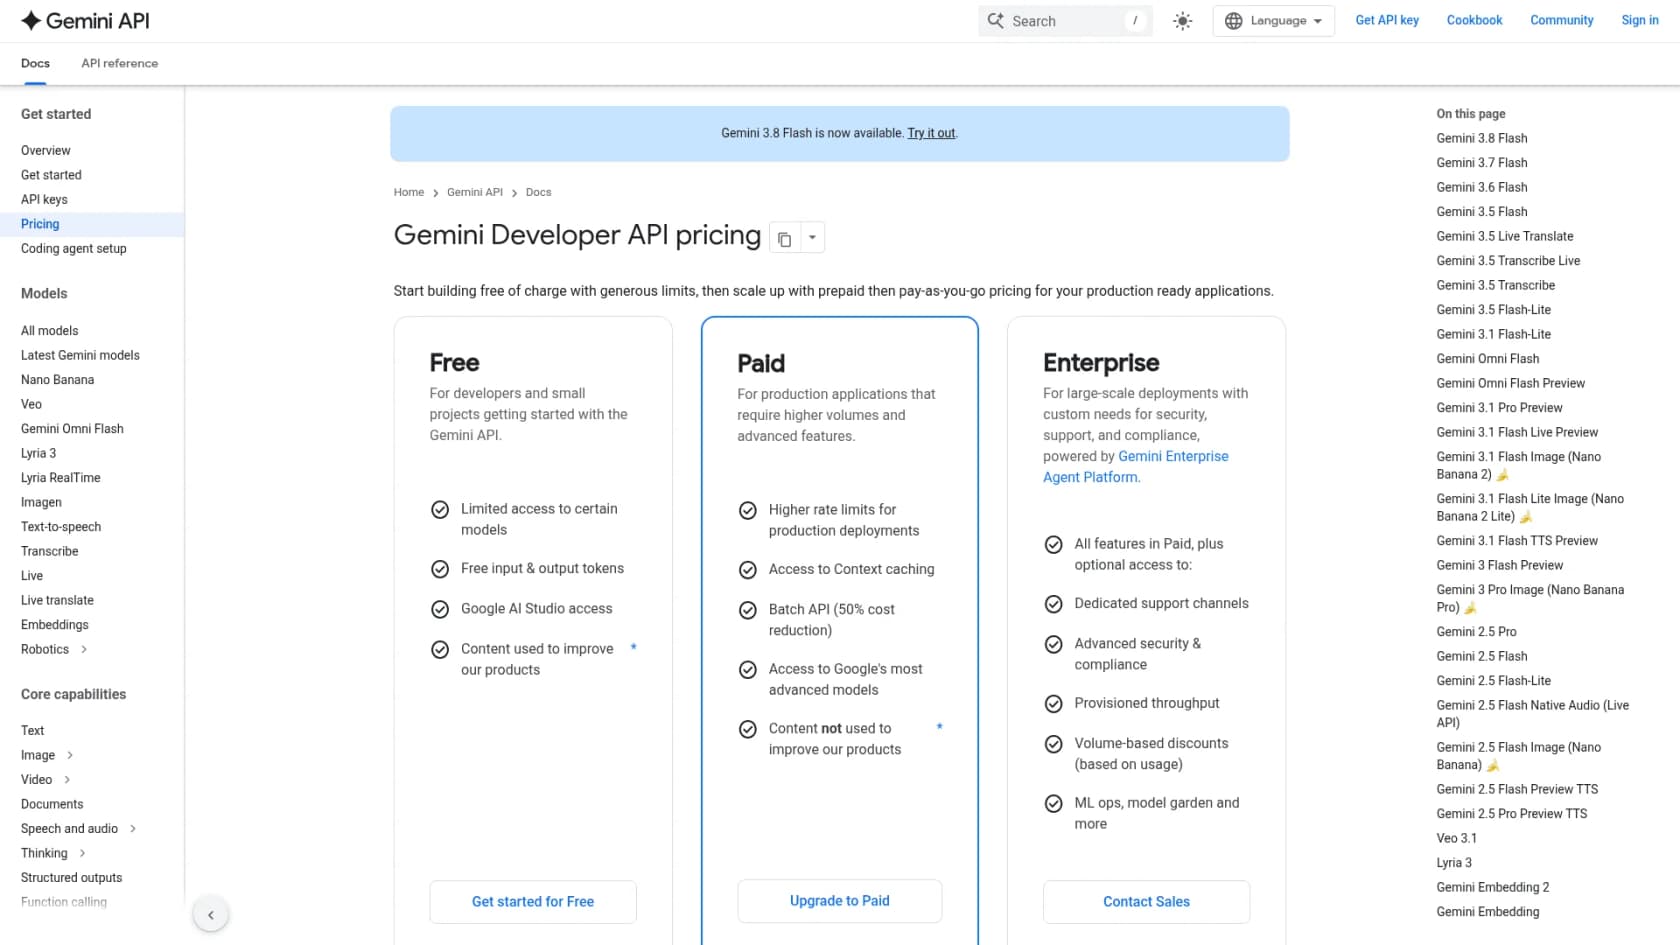
Gemini 3.8 Flash custa US$ 0,75 por 1 milhão de tokens de entrada e US$ 3,75 por 1 milhão de saída no nível padrão pago. Isso é exatamente o que o 3.7 Flash custa, ponto por ponto, porque a própria ficha técnica do Google diz que o 3.8 é construído sobre o 3.7 em vez de um novo modelo base.
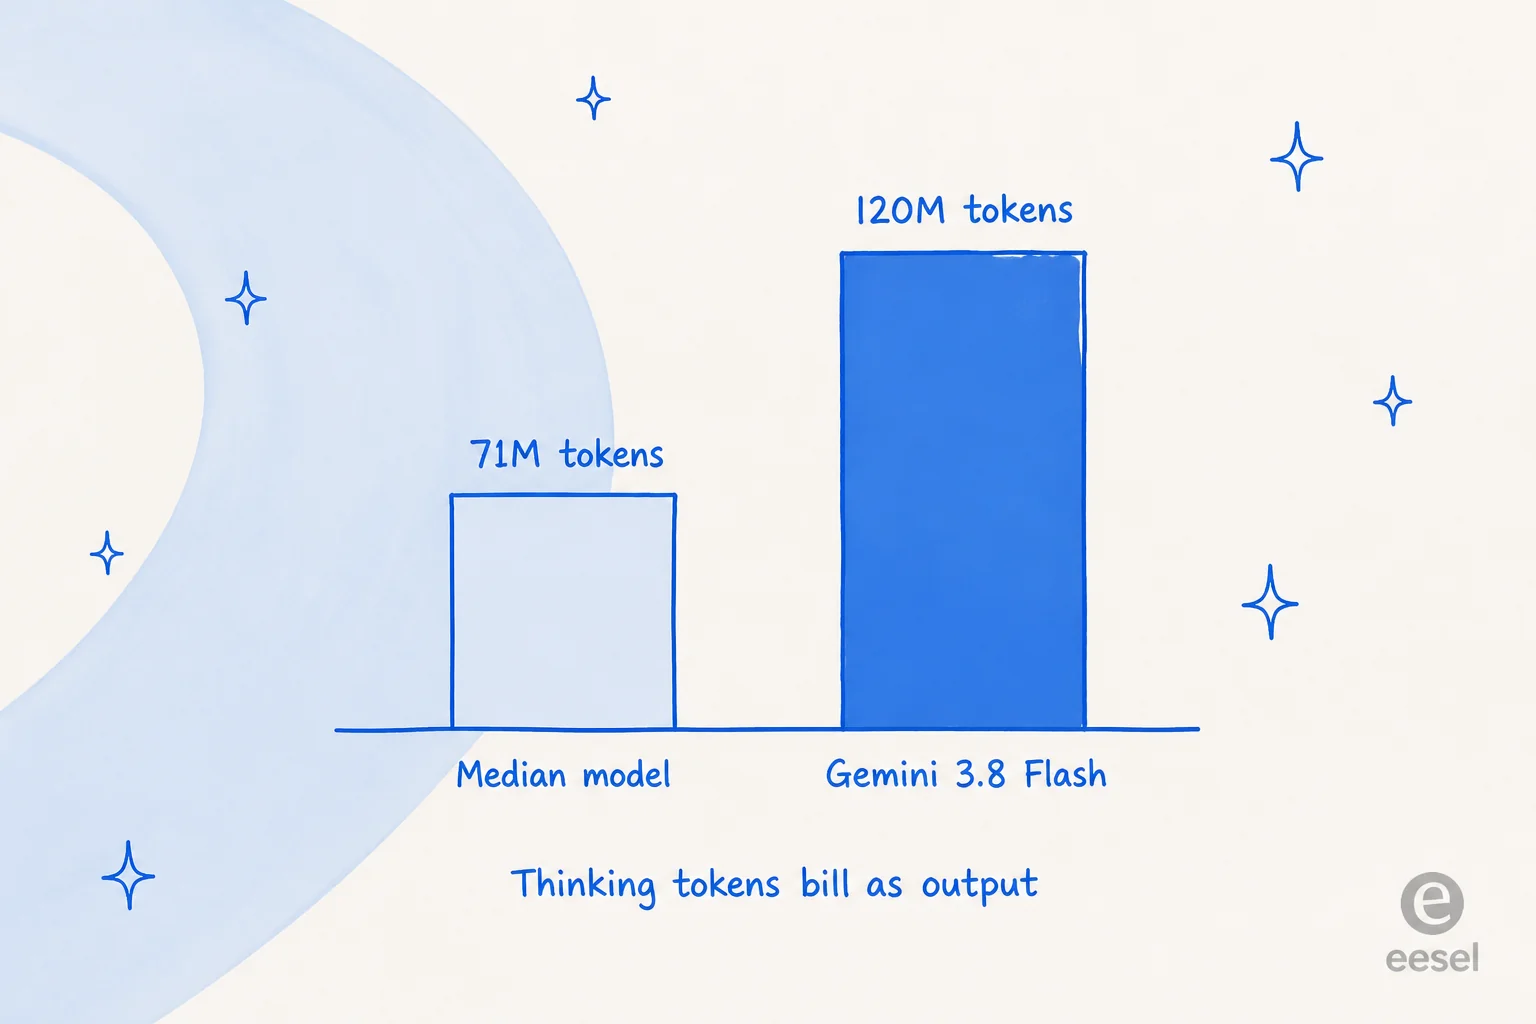
Duas coisas o preço de tabela esconde. Primeiro, os dois valores dobram em 1º de janeiro de 2027, para US$ 1,50 e US$ 7,50, então a tarifa de hoje é uma promoção. Segundo, os tokens de saída incluem os tokens de raciocínio, e o 3.8 Flash é verboso por design: ele consumiu 120 milhões de tokens de saída, enquanto o modelo mediano usou 71 milhões no índice da Artificial Analysis. Um modelo que "trabalha mais" cobra de você por esse trabalho extra.
Minha leitura: a tarifa é muito barata para tarefas longas de codificação agêntica, e trocar do 3.7 é grátis, já que o preço é idêntico. Mas se você está calculando o preço de uma carga de trabalho de alto volume e sensível à latência, dimensione seu orçamento com base no consumo real de tokens e na tarifa de 2027, não na manchete de US$ 0,75. E se a carga de trabalho é responder tickets de clientes, a tarifa do modelo não é o seu gargalo, algo que eu abordo no final.
Preços do Gemini 3.8 Flash em resumo
Aqui estão todas as tarifas publicadas para gemini-3.8-flash na API do Gemini, nível padrão pago, por 1 milhão de tokens. Coloquei a coluna de 2027 logo ao lado da de hoje para que a promoção seja impossível de não notar.
| Medida | Até 31 dez 2026 | A partir de 1º jan 2027 |
|---|---|---|
| Entrada | US$ 0,75 | US$ 1,50 |
| Saída (inclui raciocínio) | US$ 3,75 | US$ 7,50 |
| Cache de contexto, leitura | US$ 0,075 | US$ 0,15 |
| Cache de contexto, armazenamento (por 1M/hora) | US$ 0,50 | US$ 1,00 |
| Batch e Flex, entrada | US$ 0,375 | US$ 0,75 |
| Batch e Flex, saída | US$ 1,875 | US$ 3,75 |
| Prioridade, entrada | US$ 1,35 | US$ 2,70 |
| Prioridade, saída | US$ 6,75 | US$ 13,50 |
Algumas coisas fáceis de não notar ao ler a página do Google de cima a baixo:
- O preço da saída inclui os tokens de raciocínio. Você paga a tarifa de US$ 3,75 pelo raciocínio do modelo, mesmo que a API só devolva um resumo dele. Em um modelo ajustado para raciocinar mais, essa é a linha que move sua fatura.
- Batch e Flex custam exatamente a metade. Se seu trabalho não é interativo, um job em batch durante a noite reduz à metade cada token gasto.
- O grounding é cobrado separadamente. O Google Search como ferramenta dá 5.000 solicitações gratuitas por mês, compartilhadas entre todos os modelos Gemini 3.x que você usa, depois US$ 14 por 1.000. O grounding do Google Maps usa a mesma cota.
- Existe um nível gratuito de verdade. Entrada, saída e cache são gratuitos para uso padrão, o suficiente para prototipar antes de gastar qualquer coisa.
Teste os números na sua própria carga de trabalho
A tarifa de manchete só conta parte da história. O que importa é o seu volume mensal, sua proporção de entrada para saída e em qual nível você opera. Insira seus próprios números abaixo para ver o custo mensal de hoje comparado ao que a mesma carga de trabalho custaria após o aumento de janeiro de 2027.
O custo oculto: o 3.8 Flash é verboso de propósito
O número que muda a decisão de compra não está na página de preços. Está em quantos tokens o modelo gasta para fazer uma tarefa.
O Google expõe essa troca abertamente no post de lançamento: o 3.8 Flash "trabalha mais", executando etapas de raciocínio extras e chamando ferramentas iterativamente, e "às vezes, o modelo pode usar mais tokens para maximizar o desempenho". Isso é um recurso para a qualidade, e um custo para sua fatura, porque os tokens de raciocínio são cobrados à tarifa de saída de US$ 3,75.
A medição independente confirma isso. A Artificial Analysis precisou de 120 milhões de tokens de saída para executar todo o seu Intelligence Index no 3.8 Flash, contra uma mediana de 71 milhões para a classe. O veredito de uma palavra da própria AA foi "very verbose" (muito verboso).
No Hacker News, um comentarista apresentou um número mais contundente do que o marketing:
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

Portanto, o custo real por unidade de trabalho é mais alto do que os US$ 3,75 por 1 milhão sugerem, porque o 3.8 Flash gasta mais unidades por tarefa. A Artificial Analysis situou o custo combinado em US$ 0,58 por tarefa em seu índice, o que o coloca na 59ª posição entre 195 modelos em eficiência de custo, longe do topo que a tarifa bruta por token sugeriria. Se você quiser acompanhar isso no seu próprio tráfego, é exatamente para isso que servem as ferramentas de rastreamento de LLM.
Mesmo preço do 3.7 Flash, então qual comprar?
Essa é a decisão real, e o Google a responde por você. Como o 3.8 e o 3.7 Flash custam exatamente o mesmo, o preço não pode ser o critério de decisão. A orientação do próprio Google é: para cargas de trabalho "em que a eficiência computacional é a principal restrição", os desenvolvedores devem "continuar confiando no Gemini 3.7 Flash, que permanece totalmente suportado para cargas de trabalho focadas em eficiência".
Em termos simples:
- Codificação agêntica longa, qualidade acima do custo: 3.8 Flash. Ele supera o 3.7 em todos os benchmarks publicados pelo Google, e a troca é gratuita. Se você está pesquisando a categoria mais ampla, meu levantamento de assistentes de codificação com IA cobre o campo todo.
- Alto volume, sensível à latência, custo em primeiro lugar: fique com o 3.7 Flash. Ele consome menos tokens pelo mesmo preço, e um funcionário do Google confirmou, na thread de lançamento, que o maior consumo de tokens do 3.8 é um comportamento intencional, não um bug.
Há também uma pegadinha de latência. O 3.8 Flash ocupa a 3ª posição entre 195 em velocidade bruta de saída, mas seu tempo até o primeiro token é de 13,30 segundos, contra uma mediana de 2,99 segundos. Para qualquer coisa que um humano espera, o modelo "rápido" é o que demora mais para começar a responder. Isso é throughput, não responsividade, e é fácil interpretar mal isso a partir da manchete de velocidade.
Como a tarifa se compara a outros modelos de ponta
Se você está comparando opções, aqui está onde o Gemini 3.8 Flash se posiciona em relação aos modelos com os quais realmente compete em preço, por 1 milhão de tokens, nível padrão, hoje.
| Modelo | Entrada | Saída | Observação |
|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | Dobra em jan. 2027 |
| Gemini 3.7 Flash | $0.75 | $3.75 | Idêntico, menos tokens por tarefa |
| Claude Opus 5 | ~$5.00 | ~$25.00 | 4x menos tokens de saída por tarefa |
| Claude Sonnet 5 | menor que o Opus | menor que o Opus | Nível Claude mais barato |
A abordagem honesta da mesma thread do HN: um desenvolvedor observou que o Gemini Flash, junto com alguns outros modelos baratos, entrega "90% do desempenho por uma pequena fração do custo" do nível de ponta. Esse é o verdadeiro apelo, e é justo. Só lembre que essa fração é medida na tarifa bruta, antes de você somar a taxa de verbosidade e o aumento de janeiro. Meu levantamento de alternativas ao Gemini cobre o resto do campo, e se você está pesando Google contra OpenAI, a comparação ChatGPT vs. Gemini é o ponto de partida, com a lista completa de modelos da OpenAI para o outro lado dessa comparação.
Onde você pode realmente usá-lo
- Nível gratuito: entrada, saída e cache gratuitos pelo Google AI Studio. Suficiente para prototipar.
- Padrão no Antigravity: o 3.8 Flash é o modelo padrão no Google Antigravity, com cotas generosas, algo que vários desenvolvedores no HN apontaram como a forma mais barata de submetê-lo a trabalho real.
- Apps para consumidores: o app Gemini, o AI Mode na Busca e o Gemini no Sheets, mas somente com Google AI Pro ou Ultra. Se você está decidindo entre eles, veja os planos do Google AI.
- Como ativar ou desativar: se você gerencia o acesso ao Gemini em um Workspace, aqui está como ativar e desativar o Gemini.
O que isso significa se você está precificando um bot de suporte
Passo a maior parte do meu tempo pensando em como os compradores buscam e precificam a IA para o helpdesk, então aqui está a parte que importa se o motivo pelo qual você está lendo uma página de preços de modelo é automatizar o atendimento ao cliente.
Uma tarifa de US$ 0,75 por token parece irresistível ao lado de um complemento de helpdesk cobrado por resolução. Mas três coisas quebram essa comparação. Um modelo de suporte responde a tickets curtos e de alto volume, em que o tempo até o primeiro token de 13,30 segundos é sentido em cada resposta. A verbosidade que faz o 3.8 Flash ser bom em tarefas longas de codificação é o formato errado para desviar tickets (ticket deflection), e ela é cobrada na tarifa de saída. E a tarifa por token é apenas uma pequena fração do custo real de operar a automação de suporte, que é dominado pelo trabalho de recuperação e testes em torno do modelo, não pela chamada ao modelo em si.
Passei os últimos três anos e meio observando agentes de IA operando em filas de suporte reais, e o padrão é consistente: um modelo que soa confiante pode, discretamente, dar respostas erradas, e nenhum preço por token resolve isso. É por isso que todo rollout da eesel é simulado com seus tickets reais anteriores antes de responder a qualquer cliente, para que você veja a taxa de resolução e o custo por ticket antecipadamente, em vez de descobrir os dois na fatura.
Se você está escolhendo um modelo para construir a automação de suporte por conta própria, precifique-o honestamente, já incluindo a taxa de verbosidade e a tarifa de 2027. Se você preferir não conectar um modelo manualmente ao seu helpdesk, a eesel oferece um parceiro de IA para helpdesk que se integra às suas ferramentas existentes, aprende com seus tickets anteriores e é gratuito para testar, sem necessidade de cálculos de tokens. É a diferença entre comprar um motor e contratar alguém que já sabe dirigir.