O que o Gemini 3.8 Flash realmente é
O Gemini 3.8 Flash é o modelo de trabalho do Google, lançado como gemini-3.8-flash e direcionado precisamente para programação de longo alcance e agentes autônomos, e não para chat.
As especificações não mudam em relação à geração anterior. Ele recebe texto, imagem, áudio, vídeo e PDF, entrega texto e mantém uma janela de contexto de 1M de tokens com um teto de saída de 64K. Faz chamadas de função, busca como ferramenta e uso de computador. O Google publica tudo isso na ficha de modelo.
Onde você pode realmente acessá-lo varia por público. Desenvolvedores o têm no Google AI Studio, na API do Gemini, no Android Studio e no Google Antigravity, onde agora é o modelo padrão. Esse último ponto importa se você está em busca de assistentes de codificação com IA, pois significa que você já pode estar usando o 3.8 sem tê-lo escolhido.
Empresas o obtêm pelo Gemini Enterprise. Consumidores o têm no app Gemini, no AI Mode da Busca e no Google Sheets, mas apenas no Google AI Pro ou Ultra. Se você está avaliando esses níveis de consumidor, eu os analisei no artigo do Google AI Plus, e há um guia separado sobre como desativar o Gemini no Workspace, caso ele tenha se ativado sozinho para sua equipe.
Há um segundo modelo no mesmo anúncio, e a maior parte da cobertura o enterrou. O Gemini 3.8 Flash Cyber é uma variante de segurança com mitigações deliberadamente mais soltas para trabalho cibernético, e é restrito a defensores confiáveis através do novo Fairwind Program. Mais sobre isso abaixo, porque os números são a parte mais impressionante de todo o lançamento.
A parte que o Google fala em voz alta, e que quase ninguém citou
Aqui está a frase que reenquadra o lançamento. Da ficha de modelo, repetida em quatro seções distintas:
"Gemini 3.8 Flash is based on Gemini 3.7 Flash."
Essa não é uma frase descartável. As seções Architecture, Training Dataset, Hardware, Software, Safety Policies e Acceptable Usage todas remetem à ficha de modelo do Gemini 3.7 Flash em vez de descrever algo novo. O 3.8 Flash é o 3.7 Flash treinado mais, não um novo modelo base.
Uma vez que você sabe disso, o restante do lançamento deixa de surpreender. Isso explica o ritmo de três semanas. Explica por que o preço não se moveu um centavo. E estabelece uma expectativa realista: isso é uma iteração, e se comporta como uma.
O blog do Google é igualmente direto sobre o mecanismo por trás dos ganhos. Vale a pena ler a frase com atenção, porque é uma contrapartida disfarçada de recurso:
"These performance gains stem from a core design choice: 3.8 Flash works harder. On complex tasks, it exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance, especially at higher effort levels."
Depois vem a frase que deveria decidir sua atualização: o Google recomenda que desenvolvedores preocupados com eficiência computacional "continue to rely on Gemini 3.7 Flash, which remains fully supported for efficiency-first workloads." Um fornecedor dizer que seu modelo antigo ainda é a escolha certa é raro o suficiente para ser levado ao pé da letra.
Preços: idênticos ao 3.7 Flash, e dobram em janeiro
Não há um adicional pelo modelo mais novo. A página de preços da API do Gemini lista o 3.8 Flash e o 3.7 Flash com as mesmas taxas, linha por linha.
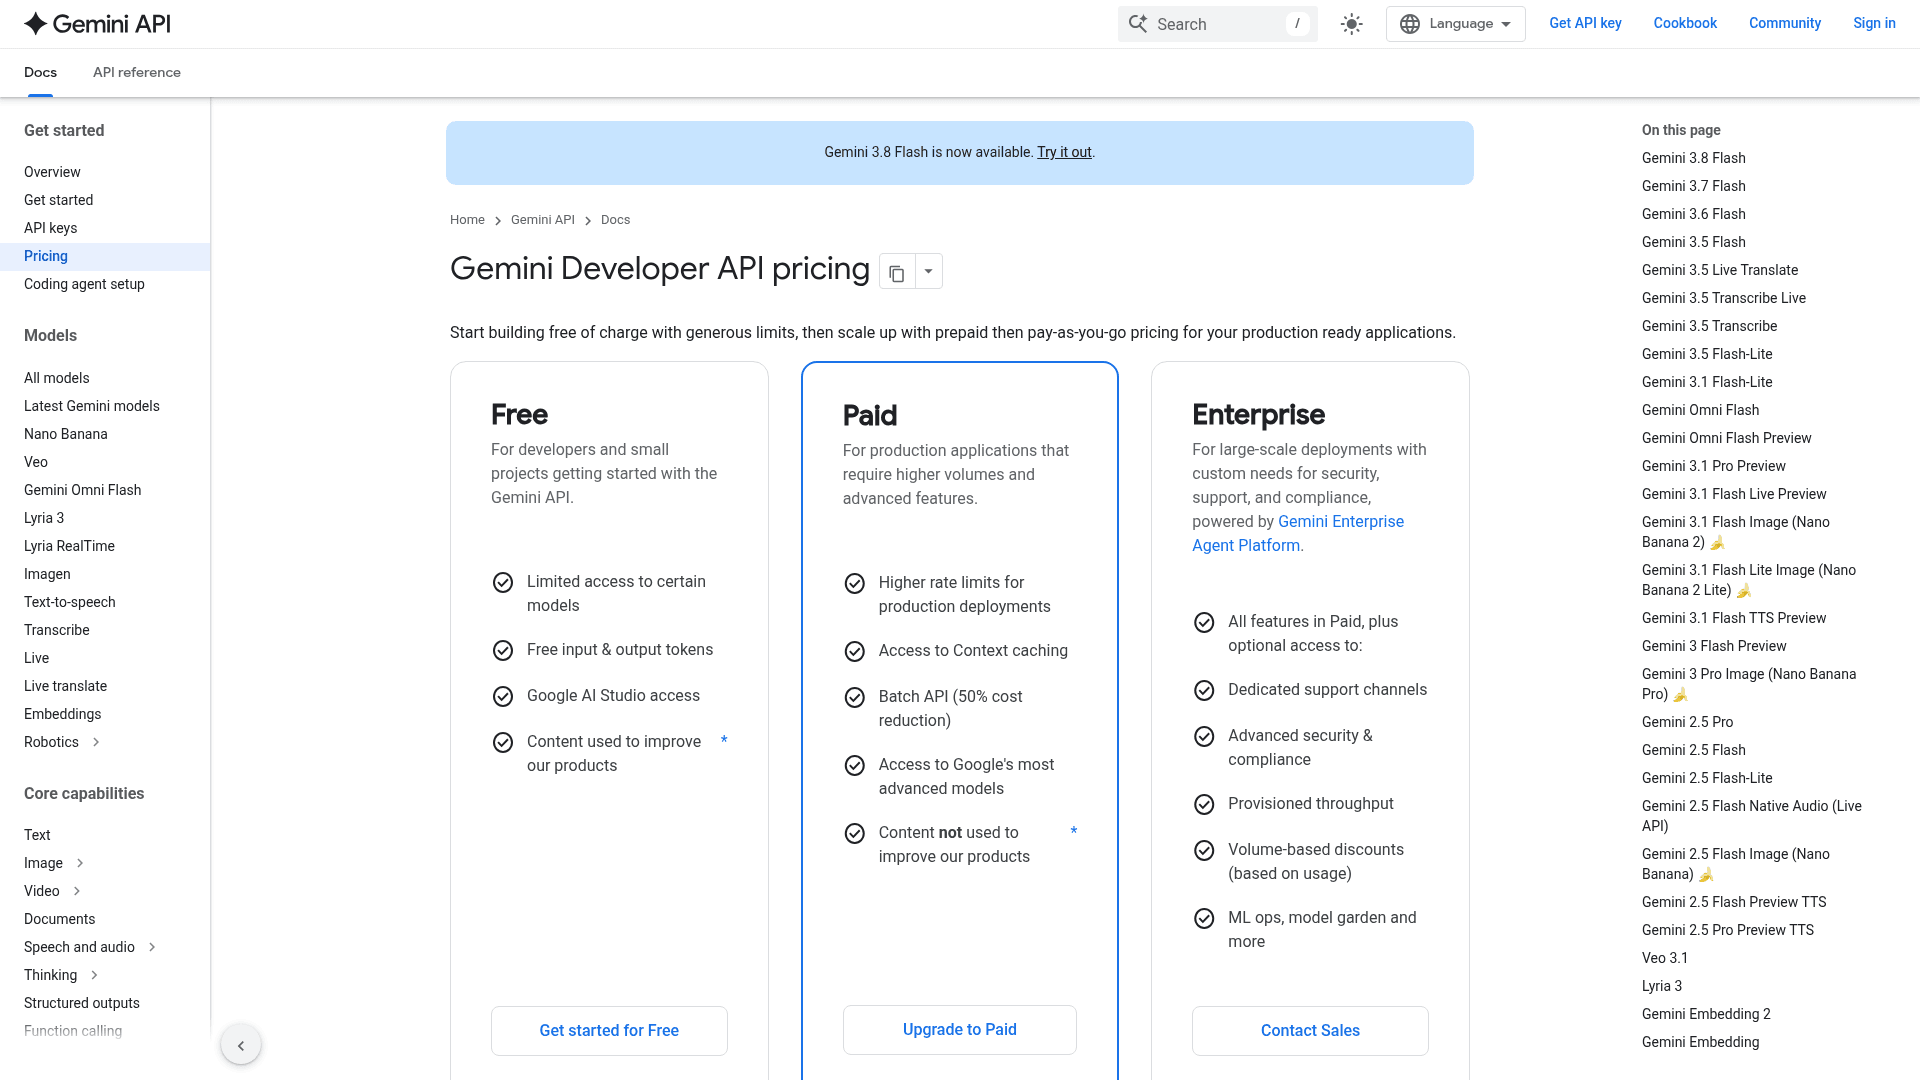
| Nível | Entrada / 1M | Saída / 1M (incl. raciocínio) | Leitura de cache / 1M | A partir de 1º jan. 2027 |
|---|---|---|---|---|
| Free | $0 | $0 | $0 | inalterado |
| Standard | $0.75 | $3.75 | $0.075 | $1.50 / $7.50 |
| Batch | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Flex | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Priority | $1.35 | $6.75 | $0.135 | $2.70 / $13.50 |
Três coisas nessa tabela merecem mais atenção do que costumam receber.
O preço de saída inclui tokens de raciocínio. Você paga $3,75 por milhão por um raciocínio que nunca vê, apenas um resumo dele. Em um modelo cujo recurso principal é pensar mais, esse é o medidor que se move.
O armazenamento em cache é cobrado separadamente. Leituras custam $0,075 por milhão, mas o armazenamento custa $0,50 por 1M de tokens por hora, também dobrando em janeiro.
O grounding é compartilhado, não por modelo. Você recebe 5.000 solicitações gratuitas de busca no Google por mês somadas entre todos os modelos Gemini 3.x, depois $14 por 1.000. Mesma cota para o grounding do Google Maps.
E o número de destaque é uma promoção. Toda taxa aqui dobra em 1º de janeiro de 2027. Se você está dimensionando um orçamento de 2027 com base em $0,75, está dimensionando com o número errado, um erro que já vi equipes cometerem com custos de LLM mais de uma vez. Vale a pena combinar com ferramentas reais de rastreamento de LLM em vez de uma planilha, porque a sobrecarga de tokens de raciocínio é a parte que ninguém projeta corretamente.
Para contexto sobre o que a concorrência cobra, preços do Claude Opus e limites de taxa da OpenAI são as duas comparações mais frequentes quando equipes avaliam uma migração.
Os benchmarks com os quais o Google se destaca
O Google publicou quatro resultados principais, e o 3.8 Flash lidera em todos os quatro. Aqui está o conjunto completo da página de modelos do DeepMind, que é a fonte primária em vez de um resumo de imprensa.
| Benchmark | Gemini 3.8 Flash | Gemini 3.7 Flash | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Terra | Claude Sonnet 5 |
|---|---|---|---|---|---|---|
| HLE-Verified | 54.9% | 53.6% | 54.4% | 54.5% | 51.1% | 31.0% |
| Vals Finance Agent v2 | 61.4% | 59.0% | 58.6% | 53.8% | 54.4% | 53.9% |
| Harvey's Legal Agent | 10.0% | 8.8% | 6.7% | 2.5% | 0.8% | 5.0% |
| DeepSWE v1.1 | primeiro lugar | menor | menor | n/a | n/a | n/a |
Duas ressalvas honestas antes de alguém tirar um print dessa tabela.
A linha do Harvey Legal Agent parece uma goleada, mas a pontuação vencedora é 10,0%. Todo modelo naquela coluna falha no benchmark; o 3.8 Flash é o que falha menos. Superar o Opus 5 por 3,3 pontos em um teste que ninguém passa é um resultado real e pequeno ao mesmo tempo.
E no HLE-Verified, a diferença sobre o Opus 5 é de meio ponto. O Google está reivindicando um empate com um modelo de fronteira a uma fração do preço, que é a história real, não um nocaute. Se você quiser a versão geração-contra-geração desse argumento, Gemini vs Claude Opus e ChatGPT vs Gemini ambos se sustentam.
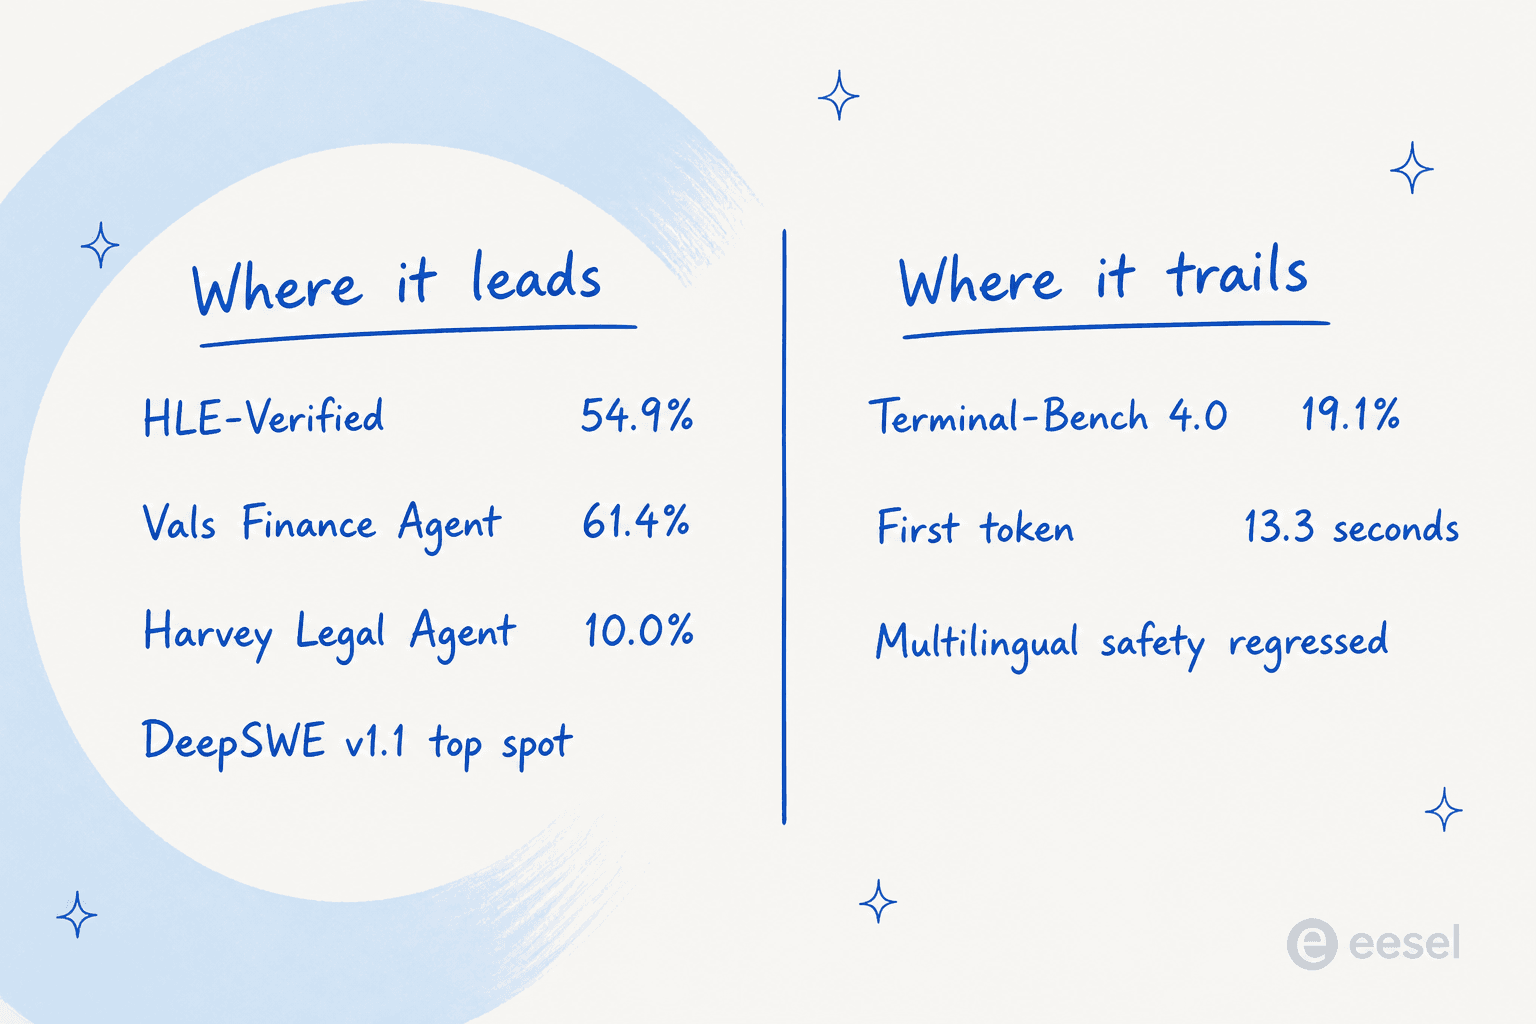
A coluna da direita é a parte que a publicação do Google não cobre, e ela vem de pessoas que executaram o modelo em vez de apenas anunciá-lo.
Os números independentes contam uma história mais útil
A Artificial Analysis executou o 3.8 Flash com esforço alto em seu Intelligence Index de nove benchmarks, e os quatro cartões de resumo são mais úteis para decisão do que qualquer coisa no post de lançamento.
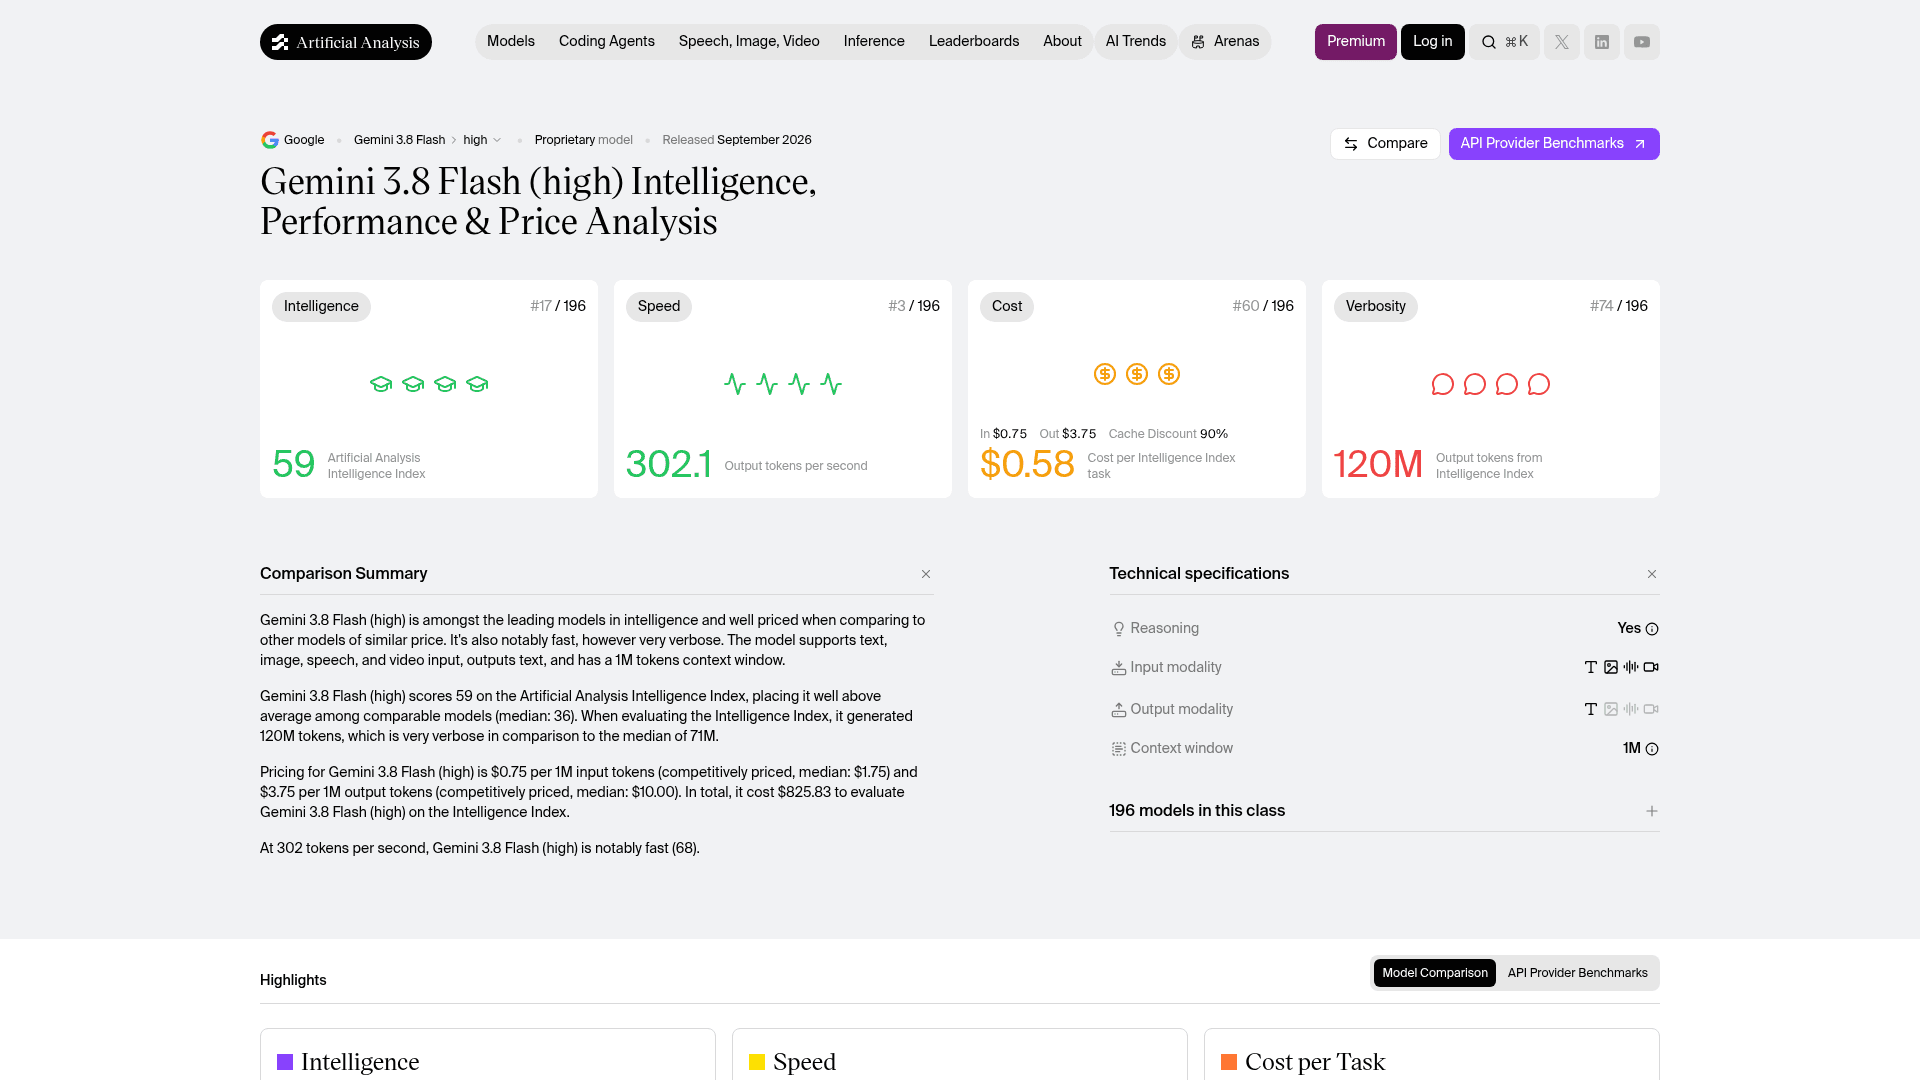
Inteligência de 59, classificado em 17º de 196, contra uma mediana de classe de 36. Custo de $0,58 por tarefa do índice, classificado em 60º. Velocidade de 302,1 tokens de saída por segundo, classificado em 3º. E verbosidade de 120M de tokens de saída para completar o índice, classificado em 74º, contra uma mediana de 71M. A Artificial Analysis o chama de "very verbose" em seu próprio resumo. Executar o índice completo com ele custou $825,83.
Esse número de verbosidade é a história dos preços resumida em um único valor.
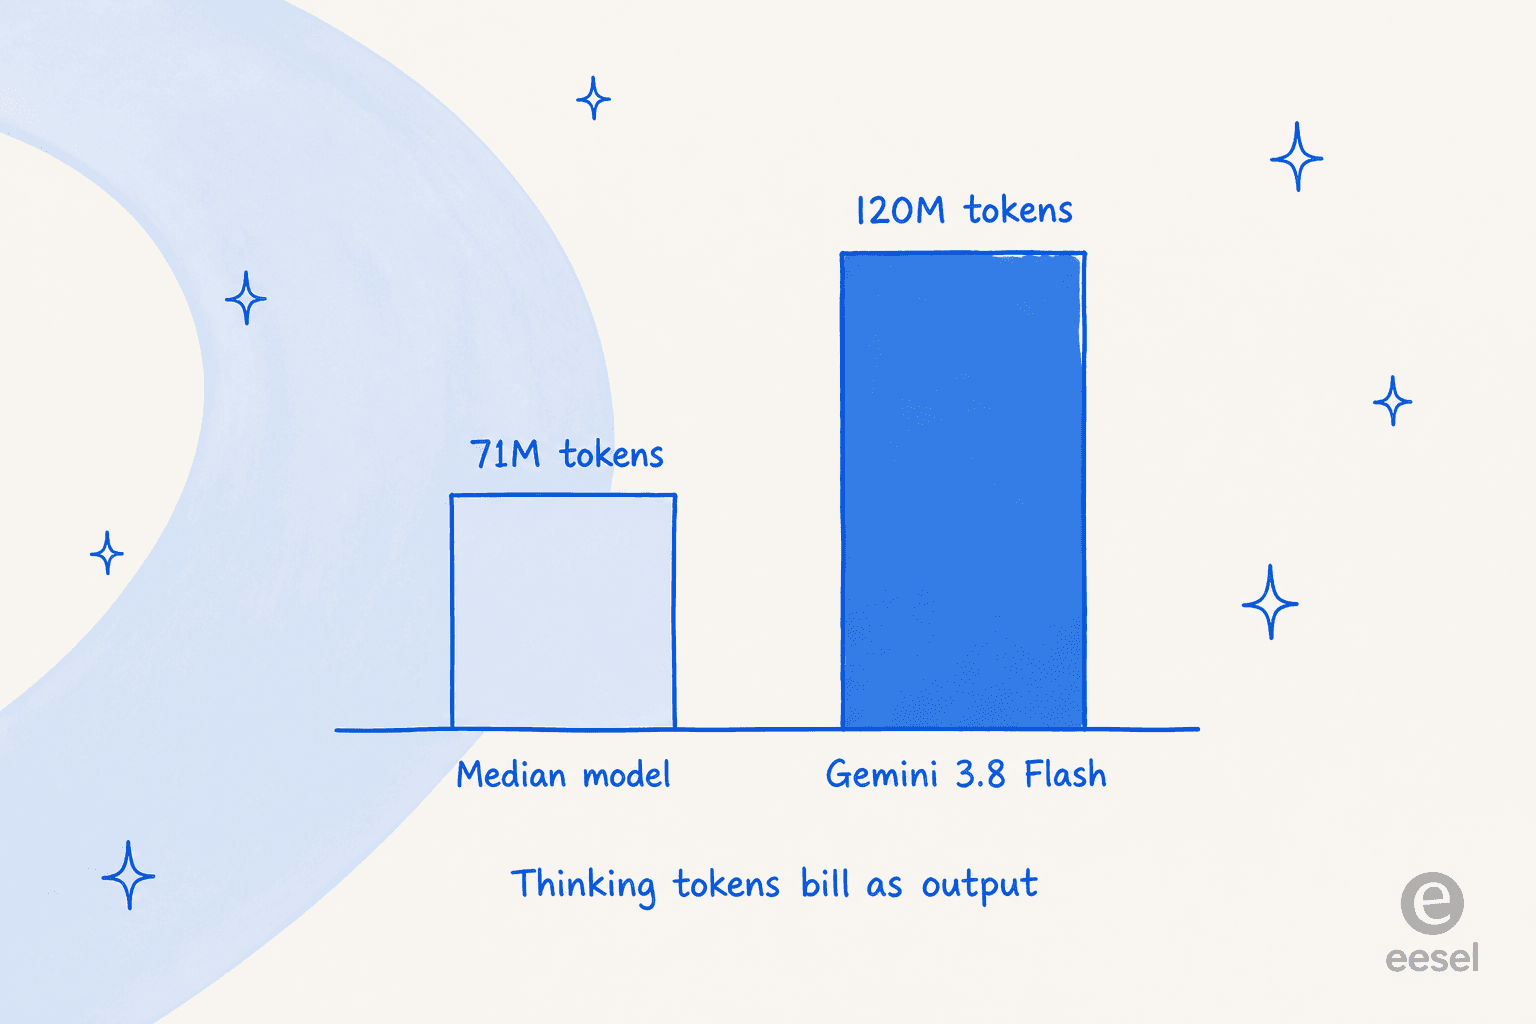
Um modelo que usa 70% mais tokens de saída do que a mediana, a $3,75 por milhão, não é tão barato quanto sua tabela de preços sugere. Essa foi a correção mais afiada no tópico do Hacker News, que chegou a 775 pontos no dia do lançamento:
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

Depois há o número que eu acho que quase todo mundo perdeu, e é o que mudaria minha própria decisão de arquitetura.
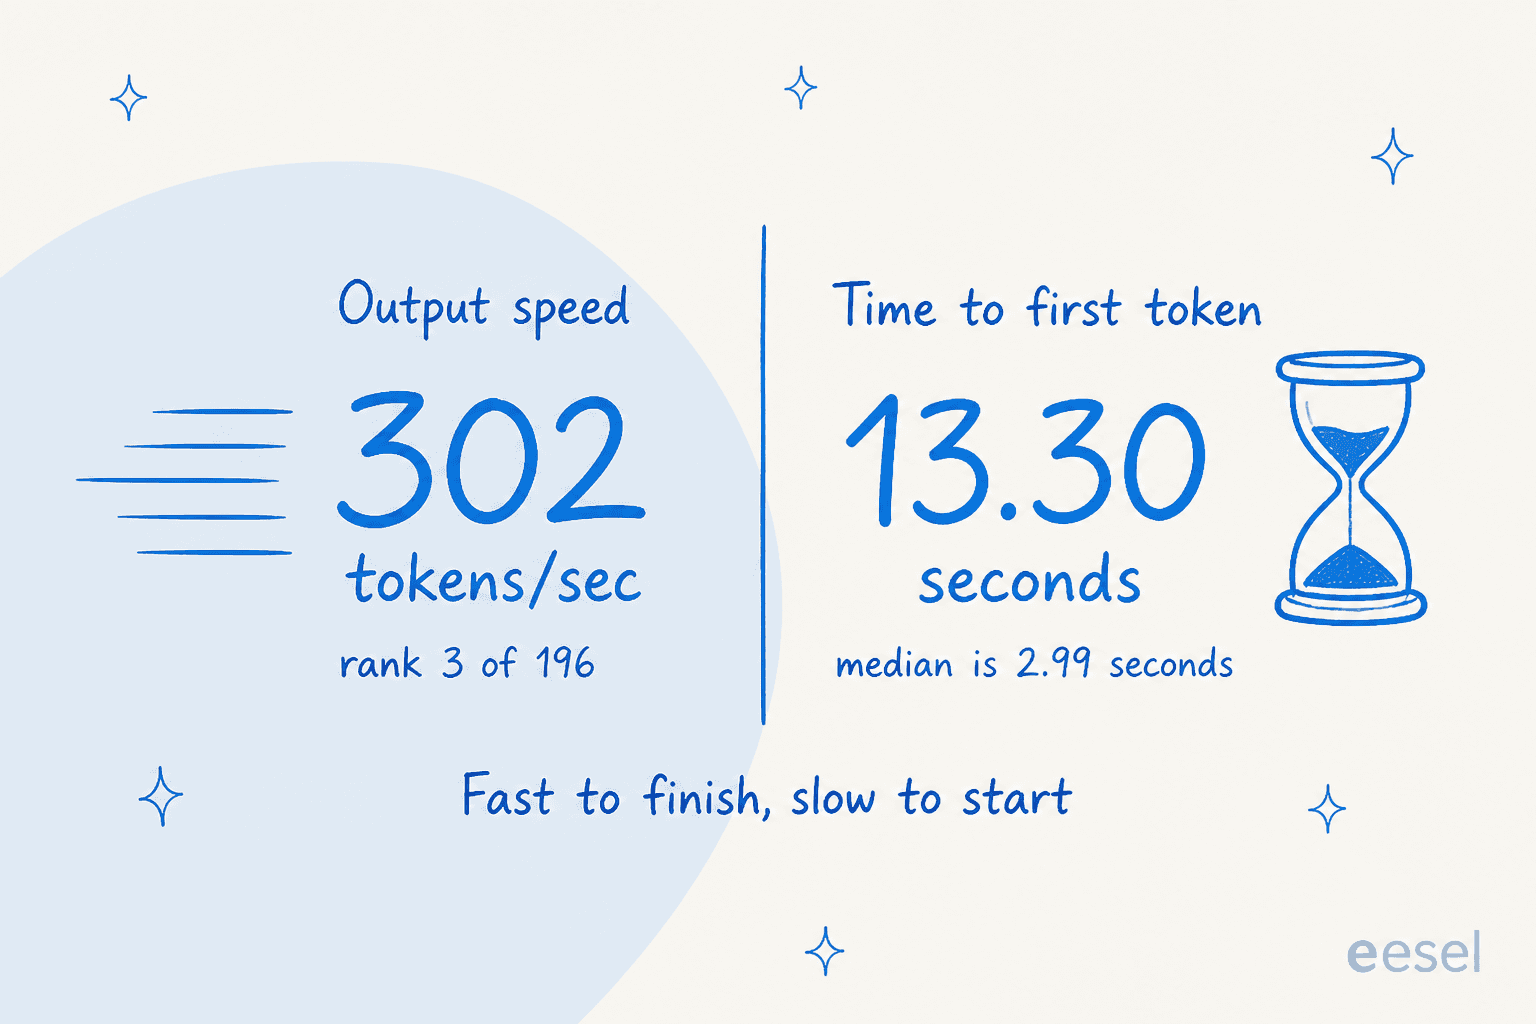
A Artificial Analysis mede o tempo até o primeiro token em 13,30 segundos, contra uma mediana de classe de 2,99 segundos. O terceiro modelo mais rápido do mundo em throughput é aproximadamente quatro vezes e meia mais lento que o típico para dizer sua primeira palavra, porque está pensando primeiro.
Essa distinção importa enormemente e é achatada constantemente. Throughput é a rapidez com que um trabalho longo é concluído. Tempo até o primeiro token é quanto tempo uma pessoa fica olhando para uma tela vazia. Para um agente em lote processando um repositório durante a noite, o throughput vence e o TTFT é irrelevante. Para qualquer coisa que uma pessoa esteja esperando, como uma resposta de suporte ou um widget de chat, esses 13 segundos são toda a experiência do usuário.
O que as pessoas disseram depois de realmente testá-lo
A reação do dia de lançamento se dividiu claramente, e a divisão coincide com essa diferença entre throughput e latência.
O próprio defensor de desenvolvedores do Google enquadrou o consumo de tokens como um recurso em vez de um custo, que é a versão mais honesta do argumento do fornecedor:
"It takes smaller steps and verifies its work more often. This can leads to higher token usage but it uses those extra tokens effectively to run tests and verify changes, giving you much higher quality work overall, especially for more complex and long-running goals."
Vale notar que ele trabalha no Google DeepMind, então trate isso como o enquadramento do fornecedor, e não como um teste independente. Sua publicação recebeu 308 curtidas e, duas respostas abaixo, uma contradição direta de alguém que havia testado em trabalho real:
"Do not want to be negative, but it is absolutely not usable for SWE. Same very negative experience as it is with Gemini 3.7 Flash. Cost more than Fable on a really simple SWE tasks."
A análise mais útil que encontrei veio de um desenvolvedor que passou um prompt longo de benchmark por ele e publicou uma lista clara de pontos positivos e negativos na mesma noite:
"This model takes its time to think and work through the tasks you have given it, at a really great price and speed. Plus - long thinking, not a airhead model anymore there is subsistence here. Cons - I want to be able to have a better chat with the model before it begins it work, can't test its own work, and cant run and view in its own browser in antigravity."
Para chat em vez de código, a leitura foi mais positiva, e especificamente sobre aquilo em que os modelos Flash historicamente eram fracos:
"The context window remains the same at 1 million tokens, but its coding reasoning ability has improved significantly, and hallucinations have been greatly reduced, so the issues where it would hallucinate or make grammatical missteps have decreased a lot."
No Hacker News, a ideia de fluxo de trabalho mais prática do tópico não era sobre substituir nada. Era sobre combinar:
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green. Then I tell Opus to read the audit report and implement what it agrees with. Flash is really good at this, and it is blazing fast in Antigravity CLI."
Os críticos tinham uma objeção específica e verificável, em vez de apenas uma impressão. Um comentarista apontou o benchmark que o Google deixou de fora:
"There are important gaps in that hot take. For example, it's not even close to Opus 5 on Terminal-bench 4.0, 19.1% vs. 51.8%."
E vários apontaram saturação de benchmark no DeepSWE, o que é justo dado quão rápido todo laboratório agora o supera. Como um deles colocou, o benchmark já foi "claramente 'resolvido'". Meu próprio conselho é o mesmo do zuzululu nesse tópico: mantenha seu próprio conjunto de avaliação, porque os rankings públicos já pararam de diferenciar esses modelos há algum tempo.
Duas coisas na ficha de modelo que ninguém está citando
Li a ficha de modelo com atenção, e dois detalhes ali não apareceram em nenhuma cobertura que eu tenha visto.
Duas métricas de segurança regrediram. A própria tabela do Google lista Multilingual Safety em +5,4pp, onde menor é melhor, e Unjustified-refusals em +1,1pp, também onde menor é melhor. O Google afirma isso claramente, em vez de escondê-lo: "Safety performance across non-English languages regressed slightly relative to 3.7 Flash." Se você atende usuários que não falam inglês, isso é uma consideração real, e é o tipo de coisa que só aparece em produção.
Relacionado, e vale saber: o Google não refez a avaliação completa de Frontier Safety no 3.8 Flash. A ficha diz que a equipe avaliou o 3.7 Flash e depois concluiu que, como o 3.8 Flash não tem "meaningful new capabilities", os resultados do 3.7 se mantêm válidos. Razoável dada a base compartilhada, mas é inferência, não medição.
A tabela de comparação tem uma linha de base rotulada incorretamente. A tabela de segurança tem o título "Gemini 3.8 Flash vs. Gemini 3.7 Flash", mas a nota de rodapé 1 diz que a linha de Tone é medida "compared to Gemini 3 Flash". Esse é um modelo diferente e mais antigo sentado em uma coluna que afirma ser uma comparação com o 3.7. Um leitor do Hacker News percebeu isso primeiro e chamou de "Chartcrime, the major AI lab tradition". Eu verifiquei a ficha ao vivo e a nota de rodapé ainda diz isso.
Nenhum dos dois é um escândalo. Ambos são o tipo de detalhe que separa a leitura da fonte primária da reescrita do comunicado de imprensa.
Gemini 3.8 Flash Cyber, o lançamento mais impressionante
A variante de segurança recebeu uma fração da atenção e tem os números mais fortes.
No CyberGym, o benchmark padrão para descoberta autônoma de vulnerabilidades, o Google diz que o 3.8 Flash Cyber supera tanto o 3.5 Flash Cyber quanto "significantly larger frontier models". Em um benchmark interno que abrange 20 linguagens de programação, ele supera uma taxa de sucesso de 70%. No CWE-Bench, um benchmark externo de correção executado pela Collinear, ele marca 47,2% pass@1 contra 47,8% de um modelo de fronteira líder, a um custo muito menor.
Os números de implantação são melhores que os benchmarks. A equipe de Segurança do Chrome do Google descobriu que ele produziu 2,6 vezes mais correções corretas para vulnerabilidades do Chrome do que os melhores modelos comerciais, muito maiores. A Wiz mediu recall de 7,5 a 9,7 pontos percentuais mais alto em seu benchmark interno de testes de penetração, a um custo de 2,3 a 5,2 vezes menor. E a equipe de Pesquisa de Vulnerabilidades da Nuvem do Google o usou para encontrar uma vulnerabilidade fundamental crítica em menos de duas horas, um trabalho que normalmente leva meses, segundo eles próprios afirmam.
O problema é o acesso. Você não pode comprá-lo. Ele é distribuído apenas a defensores confiáveis através do Fairwind Program, ou seja, autoridades governamentais, operadores de infraestrutura crítica e mantenedores de software que se candidatam e são aprovados. Todos os outros recebem o modelo padrão com as salvaguardas de CBRN e ciberofensivas intactas.
Então você deveria realmente migrar?
Como o preço é idêntico, isso é puramente uma questão da forma da sua carga de trabalho.
Migre para o 3.8 Flash se você executa programação agêntica de longo alcance, pesquisa em múltiplas etapas ou trabalho pesado em documentos, onde qualidade importa mais que quantidade de tokens. O líder de produto de IA da Glean relatou que ele "completing more than three times as many tasks as Gemini 3.7 Flash" em fluxos de trabalho de documentos de longa duração em suas avaliações. Ele já é o padrão no Antigravity, então você pode já estar usando-o.
Fique no 3.7 Flash se sua carga de trabalho é de alto volume, contexto curto ou sensível à latência. O próprio Google diz isso. A diferença de verbosidade significa que o 3.8 pode custar mais por tarefa concluída apesar da taxa idêntica, e os 13,30 segundos de TTFT desqualificam qualquer coisa interativa.
Não considere nenhum dos dois se você está escolhendo um modelo para alimentar um recurso de produto em vez de para programar com ele. Vale a pena deixar isso explícito, e é a mesma conclusão a que cheguei ao escrever sobre os melhores agentes de IA e agentes de IA para pequenas empresas: o modelo raramente decide o resultado.
O que isso significa se você está colocando IA em uma fila de suporte
É aqui que eu quero ser direto, porque é o erro que vejo com mais frequência.
Equipes avaliando IA para atendimento ao cliente passam semanas comparando benchmarks de modelos, e depois lançam algo que dá respostas erradas com total confiança de qualquer forma. Uma equipe de suporte com quem trabalhei viveu exatamente isso. O bot deles dizia aos clientes "yes, we support your car model" para marcas de veículos que não estavam no banco de dados deles, porque a base de conhecimento dizia "we support all models". Nenhuma pontuação de benchmark corrige isso. Nunca foi uma falha do modelo. Foi uma falha de recuperação de informação e de escopo, e um modelo mais inteligente teria dado a resposta errada com mais fluência.
O padrão se repete. Um cliente colocou o requisito de forma tão clara quanto qualquer um poderia:
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
a DTC supplements CX lead, eesel customer research
Isso é um requisito de produto, não de modelo. Controle de confiança, regras de escalonamento, cobertura de tópicos delimitada e um teste contra tickets que você já respondeu são o que decide se o suporte com IA funciona. Nada disso aparece em um ranking. Se você quiser a versão mais longa, escrevi separadamente sobre por que chatbots de IA respondem incorretamente.
O trabalho anterior importa igualmente. Acertar a classificação de tickets e a marcação de suporte é o que permite que um bot saiba em quais tickets não deve tocar, e uma base de conhecimento bem mantida é o que o impede de inventar uma resposta desde o início.
A versão de construir versus comprar disso também surge constantemente:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES
Modelos como o 3.8 Flash são infraestrutura. São o motor, não o funcionário. Conectar um a um helpdesk significa construir recuperação de informação sobre seus documentos e tickets passados, chamadas de ferramentas para seu sistema de tickets, limites de confiança, caminhos de escalonamento e uma forma de testar tudo isso antes de um cliente ver. Esse é o projeto real, e é o mesmo projeto independentemente de o modelo por baixo ser o Gemini, o Claude ou um modelo da OpenAI.
Experimente a eesel
Se o que você realmente quer é IA respondendo tickets em vez de conectar um modelo você mesmo, a eesel é onde eu começaria. A eesel vende colegas de equipe de IA prontos para trabalhar em vez de infraestrutura bruta, e o agente de helpdesk com IA entra na sua fila existente no Zendesk, Freshdesk ou Gorgias, treinado no seu centro de ajuda e nos seus tickets passados, em poucos minutos.

O diferencial é a parte que os benchmarks de modelos não conseguem te dar. Cada implantação da eesel é simulada primeiro contra seus tickets históricos reais, então você vê o que a IA teria dito a clientes que você já atendeu, antes que ela diga algo a um cliente ao vivo. Essa é a verificação que detecta a falha do "we support all models", e ela existe porque a eesel observa há anos bots confiantes errarem em filas reais. É gratuito para testar, e o colega escritor de blog com IA roda na mesma plataforma se o conteúdo for o seu gargalo em vez do suporte.
Para mais sobre as decisões relacionadas, meu panorama de software de helpdesk com IA cobre o mercado, e automação de tickets cobre a camada de fluxo de trabalho por baixo disso.
No lado financeiro, economia de custos em suporte com IA tem as contas, e custo de agente versus humano é a comparação que as equipes financeiras realmente pedem.
E se você ainda está comprando modelo em vez de comprando produto, alternativas ao Gemini e os melhores agentes de IA são os dois pontos de partida mais úteis.
Perguntas frequentes
O que é o Gemini 3.8 Flash?
gemini-3.8-flash. Ele processa entradas de texto, imagem, áudio, vídeo e PDF com uma janela de contexto de 1M de tokens e 64K de saída, e é ajustado para programação de longo alcance e agentes autônomos. A própria ficha de modelo do Google diz que ele é construído sobre o Gemini 3.7 Flash em vez de um novo modelo base. Se você está comparando com o restante do mercado, meu panorama de alternativas ao Gemini cobre o resto.Quanto custa o Gemini 3.8 Flash?
O Gemini 3.8 Flash é melhor que o Gemini 3.7 Flash?
O Gemini 3.8 Flash é melhor que o Claude Opus 5?
O que é o Gemini 3.8 Flash Cyber e posso usá-lo?
O Gemini 3.8 Flash é bom para suporte ao cliente?
Onde posso testar o Gemini 3.8 Flash gratuitamente?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.