As 8 melhores alternativas ao Gemini 3.8 Flash em 2026

Rama Adi Nugraha

Katelin Teen
Última edição September 8, 2026
Por que sequer olhar além do Gemini 3.8 Flash?
O Gemini 3.8 Flash é um bom modelo. Ele fica em #3 de 196 em velocidade de saída com 302 tokens/segundo e obtém 59 pontos no Intelligence Index da Artificial Analysis, bem acima da mediana. Para um job em lote noturno que processa um grande acúmulo, é difícil superar no preço.
O problema é o que esse "trabalho mais duro" custa. A própria nota de lançamento do Google é incomumente direta sobre isso:
"Esses ganhos de desempenho vêm de uma escolha de design central: o 3.8 Flash trabalha mais. Em tarefas complexas, ele exibe maior diligência, executando etapas extras de raciocínio e chamando ferramentas iterativamente. Às vezes, o modelo pode usar mais tokens para maximizar o desempenho, especialmente em níveis de esforço mais altos."
Depois vem a frase que deveria decidir sua atualização: o Google recomenda que desenvolvedores preocupados com eficiência computacional "continuem confiando no Gemini 3.7 Flash, que permanece totalmente suportado para cargas de trabalho focadas em eficiência." Um fornecedor te dizendo que seu modelo anterior ainda é a escolha certa é raro o suficiente para ser levado ao pé da letra.
Dois números transformam isso em um motivo real para procurar alternativas. Primeiro, a Artificial Analysis registra 13,3 segundos até o primeiro token contra uma mediana de classe de cerca de 3 segundos. Throughput não é o mesmo que responsividade, e 13 segundos de silêncio morto são um fator decisivo para um widget de chat ou uma resposta de suporte. Segundo, ele consome 120M de tokens de saída para completar o AA Index contra uma mediana de 71M, algo que a própria AA classifica como "muito verboso". Uma saída mais prolixa significa uma conta maior exatamente na taxa de saída que dobra em janeiro de 2027.
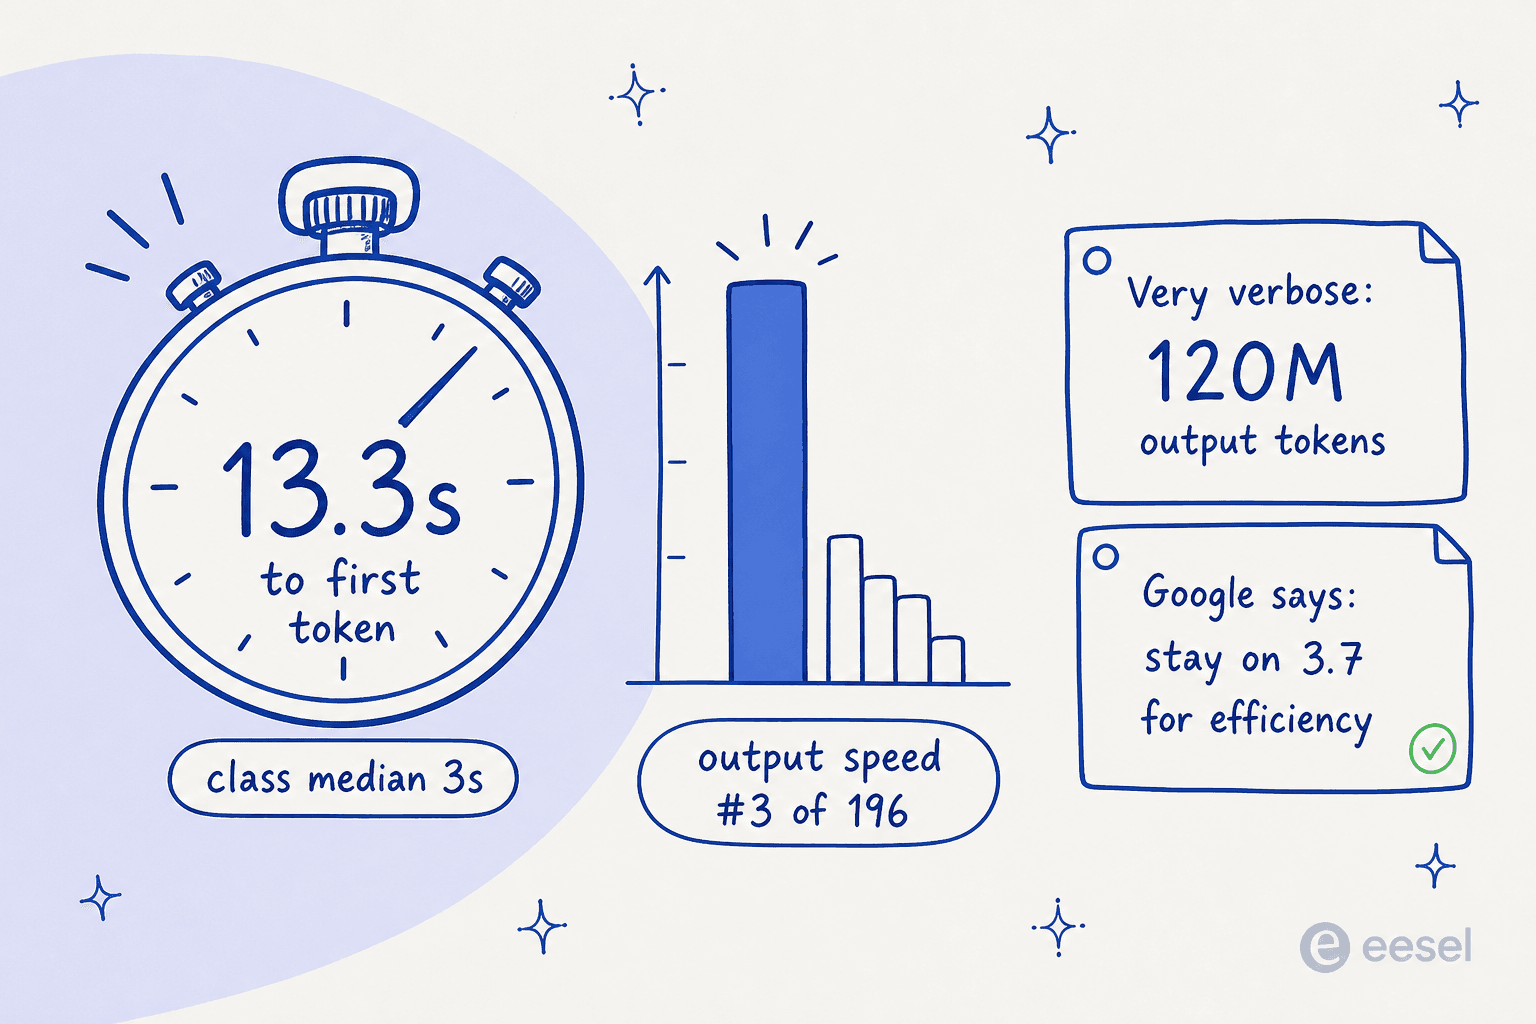
Então não é que "o 3.8 Flash é ruim". É que "rápido e barato" esconde um muro de latência e um imposto de inchaço de tokens, e para muitas cargas de trabalho, um modelo diferente, às vezes o próprio modelo mais antigo do Google, é a melhor troca.
Como escolhi essas alternativas
Mantive a lista em modelos que estão realmente na mesma função que o Flash: cavalos de trabalho rápidos, acessíveis e de alto volume aos quais você recorreria para alimentar um agente, um classificador ou um assistente de código, não carros-chefe de $30 por milhão. Para cada um, pesei quatro coisas:
- Custo real por tarefa, não apenas a taxa de etiqueta. Um modelo que custa metade por token, mas é duas vezes mais prolixo, não é mais barato. Verbosidade é onde muitos modelos "econômicos" silenciosamente recuperam o dinheiro.
- Latência com a qual você consegue viver. O tempo até o primeiro token importa mais que o throughput máximo no momento em que há um humano do outro lado.
- Aberto vs. fechado. Vários desses entregam pesos abertos que você pode hospedar você mesmo, o que muda completamente a equação de residência de dados e custo.
- O que usuários reais relatam, de threads do Hacker News e Reddit, não os posts de benchmark do dia de lançamento.
Os preços abaixo são por 1M de tokens, nível padrão, conforme listado na página de preços de cada fornecedor. Tokens de raciocínio e pensamento são cobrados na taxa de saída em todos os modelos aqui, então a coluna de saída geralmente é o que decide sua conta.
Alternativas ao Gemini 3.8 Flash de um olhar
| Modelo | Melhor para | Entrada / Saída ($/1M) | Pesos abertos | Contexto | A principal pegadinha |
|---|---|---|---|---|---|
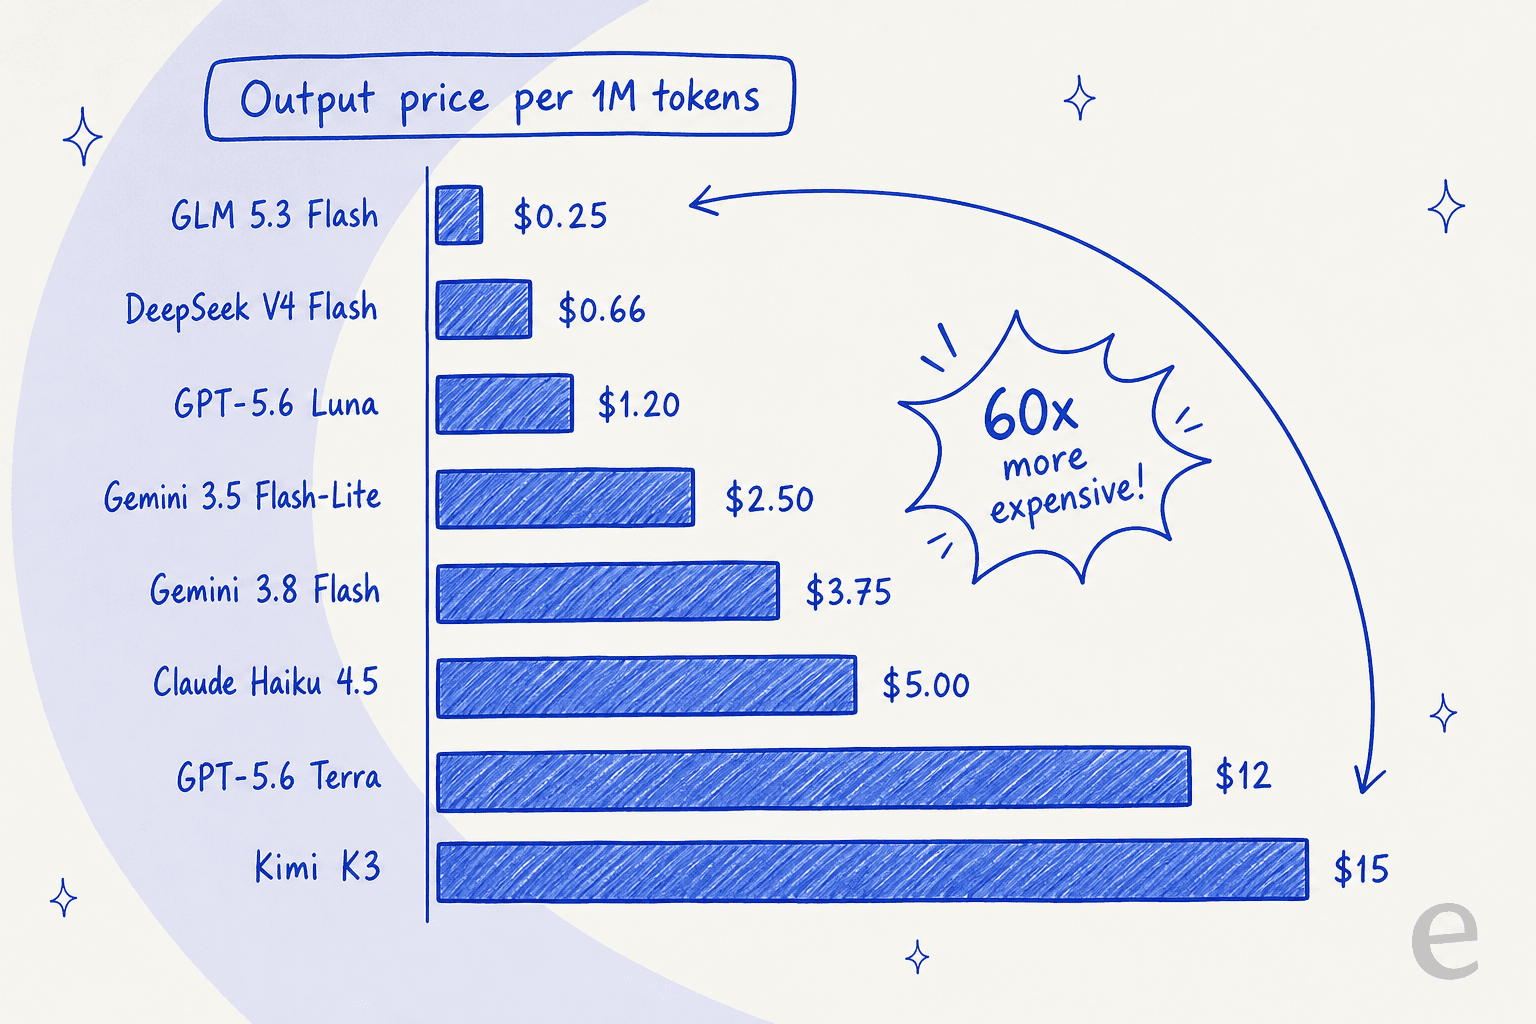
| Gemini 3.7 Flash | Focado em eficiência, mesmo preço | $0.75 / $3.75 | Não | 1M | Dobra em jan/2027; removeu minimal |
| OpenAI GPT-5.6 (Terra) | Troca de fronteira mais leve | $2.00 / $12.00 | Não | 400K | Nível de contexto longo custa 2x |
| DeepSeek V4 Flash | Menor custo real | $0.22 / $0.66 (fora do pico) | Sim (MIT) | 1M | Sobretaxa no pico; alucina; só texto |
| Kimi K3 | Raciocínio de pesos abertos | $3.00 / $15.00 | Sim | 1M | Caro por token; não consegue parar de pensar |
| Qwen 3.8 Flash-Next | Contexto longo, prévia aberta | ~$0.03-$0.20 in / $0.13-$0.80 out | Sim | 1M | Prévia subtreinada; provedor único |
| Claude Haiku 4.5 | Confiabilidade + segurança | $1.00 / $5.00 | Não | 200K | Mais caro que o pacote econômico |
| GLM 5.3 Flash | Multimodal mais barato | $0.075 / $0.25 (promo) | Sim | 200K | Promoção termina; ecossistema menor |
| Gemini 3.5 Flash-Lite | OCR / classificação de alto volume | $0.30 / $2.50 | Não | 1M | Mais fraco em raciocínio difícil |
A dispersão na coluna de saída é toda a história: de $0,25 a $15 por milhão, uma diferença de 60x para modelos que todos ficam mais ou menos na mesma categoria "rápido e barato".
1. Gemini 3.7 Flash
Melhor para: equipes que querem tudo que o Flash faz bem, menos o gasto extra de tokens, pelo mesmo preço.
A alternativa mais honesta ao Gemini 3.8 Flash é o modelo sobre o qual ele foi construído, e é o próprio Google quem te diz isso. Como o 3.8 é simplesmente o 3.7 Flash treinado mais, eles são cobrados de forma idêntica, e a única diferença real é que o 3.8 faz mais trabalho (e gasta mais tokens) por tarefa. Se você não está atrás dos últimos pontos em um benchmark de raciocínio difícil, o 3.7 Flash te dá a mesma velocidade e uma conta menor.
Desenvolvedores que o usam como um auditor barato e incansável o avaliam muito bem:
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus."

Vantagens: preço idêntico ao 3.8 Flash, menos inchaço de tokens, uma janela de contexto completa de 1M de tokens, e a mesma entrada multimodal ampla (texto, imagem, áudio, vídeo, PDF).
Desvantagens: a taxa introdutória dobra para $1,50/$7,50 em 1º de janeiro de 2027, igual ao 3.8. E o 3.7 removeu o nível de pensamento minimal, então o piso mais barato para OCR e classificação de tickets desapareceu; low agora é o novo mínimo.
Preços: $0,75 de entrada / $3,75 de saída por 1M até o fim de 2026.
Veredito: se você já está recorrendo ao 3.8 Flash, teste primeiro o 3.7 Flash nos seus próprios prompts. Nove em cada dez vezes ele faz o trabalho por menos, e é exatamente por isso que o Google continua recomendando-o.
2. OpenAI GPT-5.6
Melhor para: equipes que querem um modelo de fronteira não Google que chega à resposta com menos tokens.
O GPT-5.6 vem em três variantes, e o nível que realmente compete com o Flash é o Terra, não o mais barato Luna. O motivo para considerá-lo em vez do Gemini é eficiência: os modelos GPT tendem a chegar à mesma resposta com muito menos saída, o que compensa uma taxa de etiqueta mais alta em qualquer trabalho intensivo em saída. Um desenvolvedor colocou a troca de forma direta:
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens."
Essa é toda a decisão GPT vs. Gemini Flash em uma linha. Tokens/segundo brutos favorecem o Gemini; tokens por tarefa concluída frequentemente favorecem a OpenAI. Se sua conta é dominada pela saída, faça as contas com ambos. Para o detalhamento completo dos níveis, nossa lista de modelos da OpenAI os detalha.
Vantagens: raciocínio de fronteira real, um enorme ecossistema de ferramentas, e menos verbosidade que o Gemini Flash em tarefas comparáveis. Luna ($0,20/$1,20) é um piso econômico real se você quiser trocar para baixo.
Desvantagens: a OpenAI cobra um nível de contexto longo que dobra a taxa além da janela de contexto curto, o mesmo penhasco tipo 200K que a xAI usa. Gemini e Anthropic não fazem isso. Também fique atento aos seus limites de taxa se estiver operando alto volume.
Preços: Terra $2,00 de entrada / $12,00 de saída; Luna $0,20 / $1,20; Sol $5,00 / $30,00 por 1M (contexto curto).
Veredito: a alternativa geral mais forte se você não estiver atrelado ao Google, especialmente quando sua carga de trabalho é intensiva em saída e a contagem de tokens, não o preço por token, é o que está te matando.
3. DeepSeek V4 Flash
Melhor para: o menor custo real por token de qualquer modelo hospedado aqui, e para quem quer pesos abertos.
O DeepSeek V4 Flash é o disruptor de preços. Um modelo de mistura de especialistas com 284B no total / 13B ativos e pesos com licença MIT (~167GB, roda em casa por menos de $10k), é listado em $0,22 de entrada / $0,66 de saída fora do pico, uma fração do Gemini Flash. E ele se sustenta em trabalho real, não apenas em custo:
"I benched DS4 flash and Pro vs opus 4.8 xhigh on 16 work-related tasks a month ago across 4 days. Opus 4.8 came out as a winner by 1 task only [...] But flash performed as well or better (as in being more thorough) in 13 out if 16."
Existem duas pegadinhas honestas. A DeepSeek reajustou os preços em agosto de 2026 e agora aplica uma sobretaxa de pico/fora do pico, com horários de pico de 01:00-04:00 e 06:00-10:00 UTC, então uma fila dos EUA ou da UE em sua maioria fatura fora do pico, mas um job em lote agendado no horário comercial chinês paga o dobro. E ele alucina mais do que você gostaria:
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
Mais uma coisa a saber: o Flash é só texto, sem entrada de imagem documentada, então se sua carga de trabalho envolve capturas de tela, isso decide a questão. E quanto aos dados, os termos da API paga da DeepSeek são silenciosos sobre o uso para treinamento em vez de protetores, e os dados ficam na RPC sob a lei da RPC, então não é um substituto direto para dados regulados de clientes.
Vantagens: o menor custo real por token aqui, pesos abertos MIT, um perfil forte de uso de ferramentas, e texto de raciocínio totalmente visível que você pode direcionar.
Desvantagens: a sobretaxa de pico, uma taxa real de alucinação, sem entrada de imagem, e residência de dados na RPC.
Preços: $0,22 de entrada / $0,66 de saída por 1M fora do pico (o dobro no pico). O nível Pro custa mais.
Veredito: a melhor jogada de custo puro nesta lista, e mais forte do que "barato significa fraco" sugeriria. Combine com recuperação (retrieval) e testes intensos para manter as alucinações sob controle, do mesmo jeito que você faria com qualquer configuração baseada em RAG.
4. Kimi K3
Melhor para: raciocínio de pesos abertos que compete com os carros-chefe, se você conseguir absorver o custo por token.
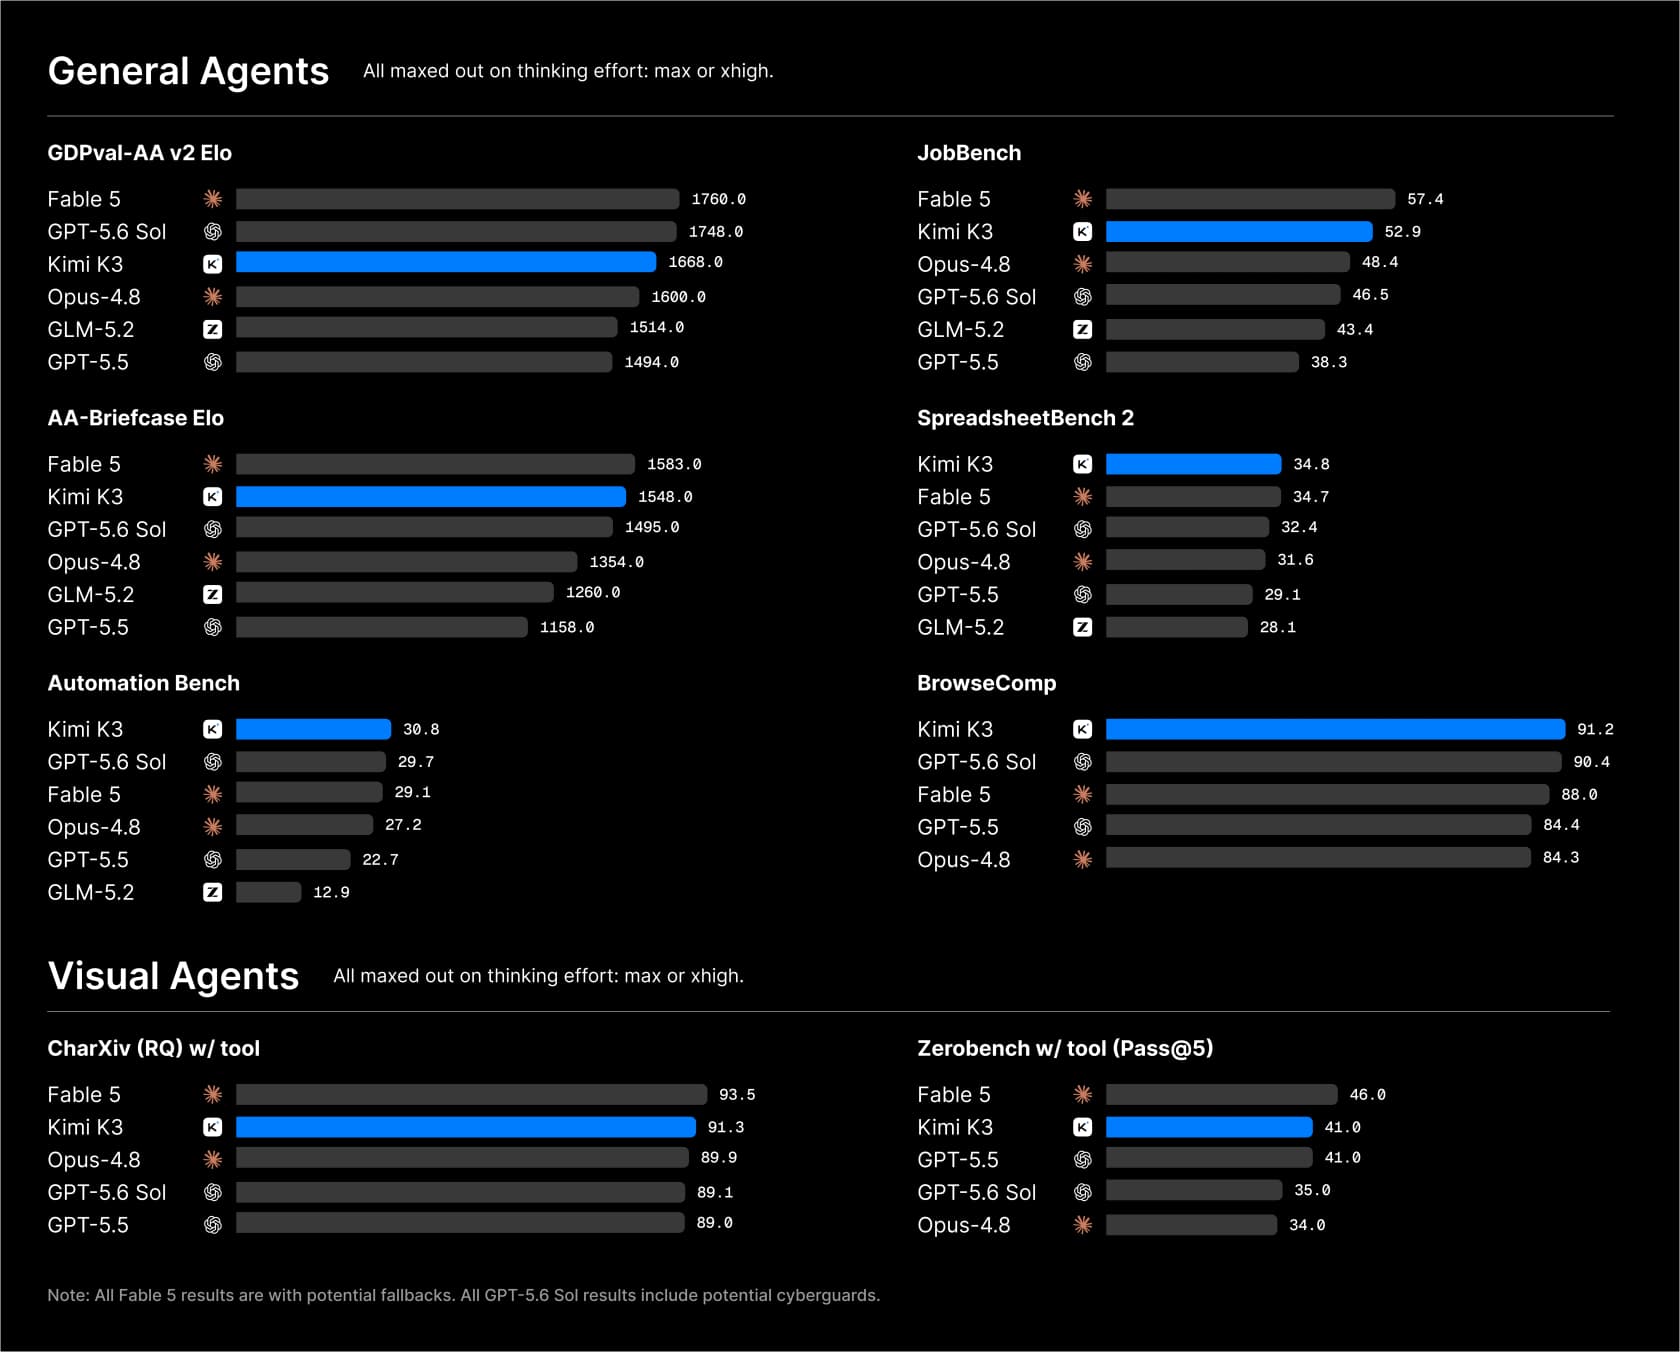
O Kimi K3 da Moonshot AI é o peso-pesado de raciocínio do mundo de pesos abertos: 2,8T no total / 104B parâmetros ativos, um contexto de 1M de tokens, visão nativa, e pesos abertos que saíram no prazo. Na Artificial Analysis, ele alcança um Intelligence Index de 57, território top cinco, e lidera abertamente vários benchmarks de agentes como o BrowseComp.
O problema é o preço e o pensamento. A $3 de entrada / $15 de saída, ele fica na faixa do Claude Sonnet, aproximadamente 50x a taxa de saída do DeepSeek Flash, e não consegue parar de raciocinar. Existe uma configuração low, mas é um controle de latência, não um nível de custo, e ela pontua pior que o DeepSeek Flash enquanto custa 8x mais. Os usuários sentem a lentidão:
"Faster iterations are way better for me, I hate waiting for 5-10 minutes on small changes. I tried to use recent versions of Kimi and GLM, but they use too much thinking for no reason and are pretty slow because of it."
Vantagens: raciocínio de nível carro-chefe, entrada nativa de imagem e vídeo, uma janela de 1M de tokens, e pesos abertos com quants da comunidade já disponíveis.
Desvantagens: caro por token, sem forma de desativar o raciocínio, e mais lento do que se esperaria de um concorrente do "Flash" (não é um; é um modelo de fronteira). URLs de imagens públicas também não são aceitas, apenas base64 ou um id de arquivo enviado.
Preços: $3,00 de entrada / $15,00 de saída por 1M ($0,30 de entrada com cache-hit).
Veredito: a escolha quando você precisa de raciocínio real e quer a opção de auto-hospedar, não quando você precisa de barato e rápido. Se sua régua é "tão bom quanto um carro-chefe, mas eu possuo os pesos", o K3 a supera; se sua régua é "substituir o Flash em custo", ele não. Análise completa em nossa revisão do Kimi K3.
5. Qwen 3.8 Flash-Next
Melhor para: cargas de trabalho de contexto longo e alto cache onde throughput em escala importa, em pesos abertos.
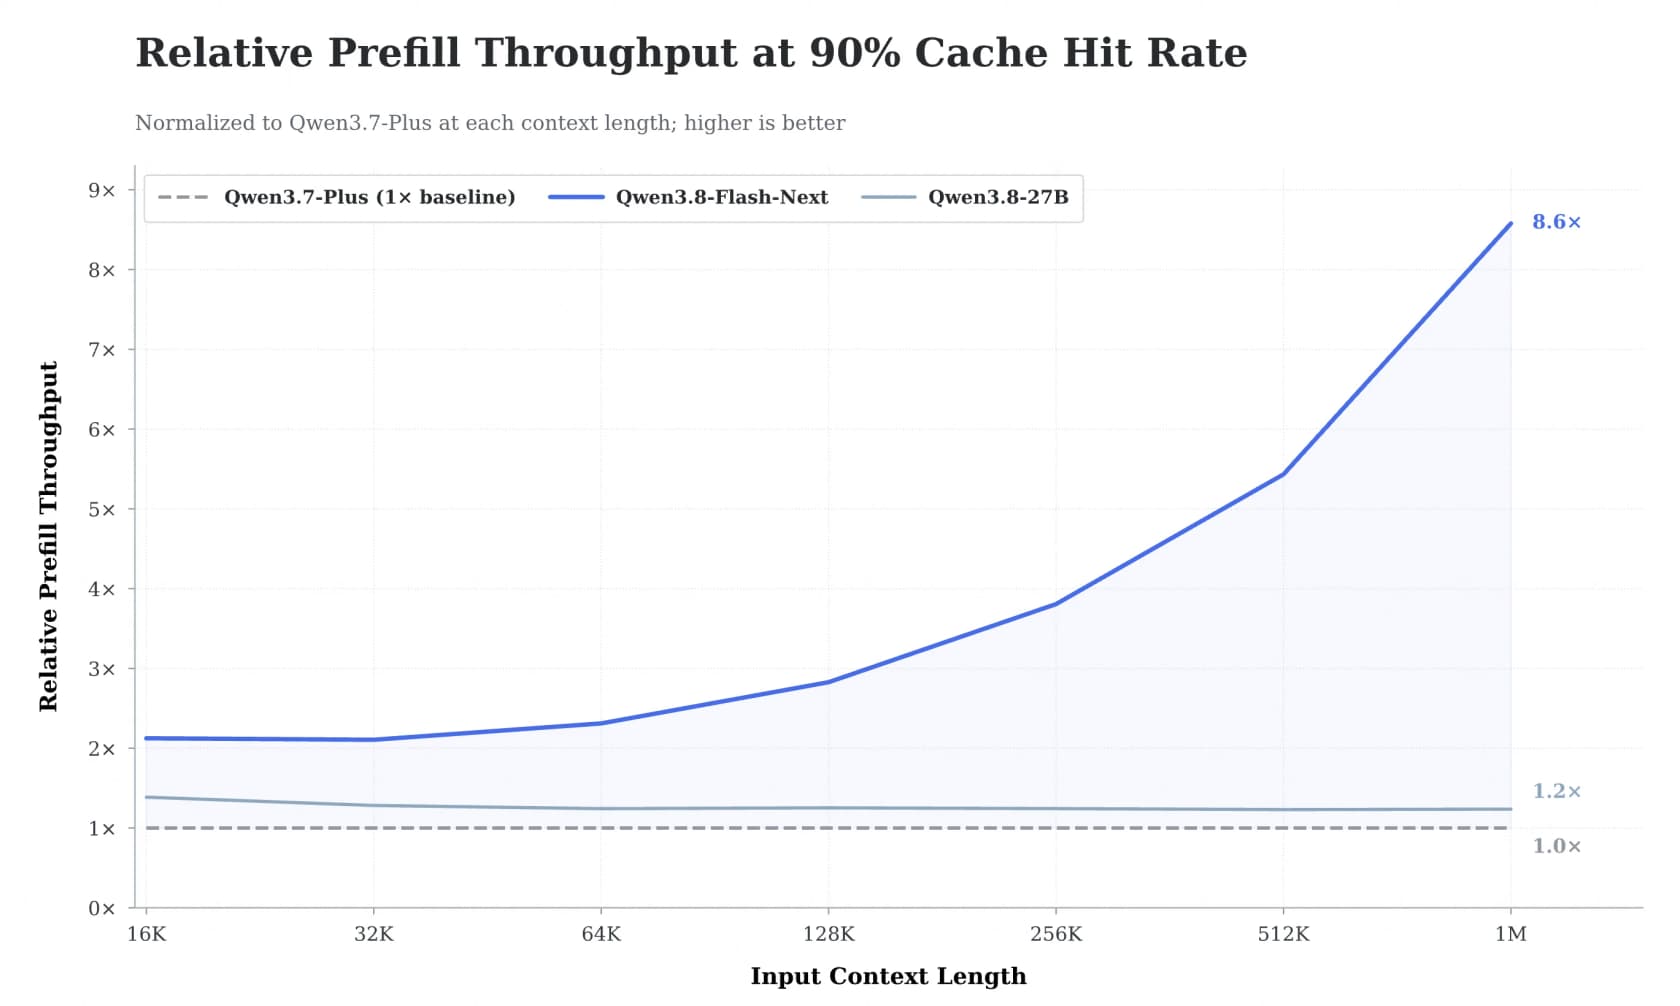
O Qwen 3.8 Flash-Next da Alibaba é a raridade mais interessante aqui. É uma prévia da próxima arquitetura da Qwen, e seu truque de festa é o throughput de prefill: com o Qwen Sparse Attention ele alcança 8,6x o throughput do Qwen3.7-Plus em um contexto de 1M de tokens. Para uma carga de trabalho pesada de contexto longo e alto acerto de cache, essa escala é real e difícil de igualar. Ele entrega pesos abertos e cobra em faixas, de cerca de $0,03/$0,13 por 1M em prompts curtos até $0,20/$0,80 nos maiores.
A pegadinha é o que "prévia" significa. Está deliberadamente inacabado:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."
Além disso, Simon Willison o testou e acabou preferindo um modelo denso menor, culpando a quantização de baixo bit necessária para caber, e a API hospedada atualmente tem um único provedor, então não há failover. A Artificial Analysis também o classifica como "muito verboso", 200M de tokens de saída para completar seu Index contra uma mediana de 110M.
Vantagens: throughput excepcional em contexto longo, pesos abertos, muito barato em prompts curtos, e uma prévia de para onde a Qwen está indo. Nosso guia de preços da Qwen tem a tabela completa de faixas.
Desvantagens: deliberadamente subtreinado, um golpe de qualidade por quantização, hospedagem de provedor único, e saída verbosa que infla a conta.
Preços: em faixas, aproximadamente $0,03-$0,20 de entrada / $0,13-$0,80 de saída por 1M dependendo do tamanho do prompt.
Veredito: uma prévia de nível de pesquisa, não um padrão de produção. Recorra a ele se o throughput de contexto longo é seu obstáculo e você pode auto-hospedar; caso contrário, espere pela linha Qwen4 finalizada. Mais opções em nosso resumo de alternativas à Qwen.
6. Claude Haiku 4.5
Melhor para: equipes que vão trocar um preço um pouco mais alto por confiabilidade e um histórico de segurança mais limpo.
O Claude Haiku 4.5 é o modelo rápido e pequeno da Anthropic, e é aquele que eu escolho quando a prioridade é um modelo que se comporta de forma previsível em vez do token absolutamente mais barato. A $1 de entrada / $5 de saída ele custa mais que o pacote econômico, mas vem com o preço fixo da Anthropic (sem sobretaxa de contexto longo), um perfil forte de seguimento de instruções, e a maturidade de ferramentas do ecossistema mais amplo do Claude.
Isso importa aqui porque duas métricas de segurança realmente regrediram no Gemini 3.8 Flash: segurança multilíngue e recusas injustificadas se moveram na direção errada em relação ao 3.7, e o Google observou que a segurança em idiomas não ingleses "regrediu levemente". Se você atende um público multilíngue ou regulado, um modelo com um histórico de segurança mais estável vale o prêmio.
Vantagens: preço fixo sem penhasco de contexto, seguimento de instruções confiável, um ecossistema maduro, e uma postura de segurança forte. Boa opção para quem já está construindo sobre o Claude.
Desvantagens: mais caro que o DeepSeek Flash, o GLM, ou a linha Gemini Flash, pesos fechados, e uma janela de contexto menor de 200K comparada aos modelos de 1M de tokens aqui.
Preços: $1,00 de entrada / $5,00 de saída por 1M.
Veredito: a escolha "o imposto de confiabilidade vale a pena". Se você já se queimou com um modelo barato alucinando na frente de clientes, o Haiku 4.5 recompra muita tranquilidade. Veja como ele se compara em nosso guia de alternativas ao Claude.
7. GLM 5.3 Flash
Melhor para: o modelo multimodal verdadeiro mais barato aqui.
O GLM 5.3 Flash da Z.ai é o primeiro modelo multimodal nativo da série GLM-5, e em sua promoção de lançamento é o modelo pago mais barato aqui: $0,075 de entrada / $0,25 de saída por 1M (lista $0,15/$0,50). Ele entrega pesos abertos e, diferente do DeepSeek Flash, realmente aceita imagens. Testadores iniciais avaliam muito bem a relação preço-qualidade:
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Também existe um GLM Coding Plan ($18/$80/$168 por mês) que funciona dentro do Claude Code, Cursor, Cline e mais de 20 ferramentas de agentes, o que o torna um backend de código muito barato se você vive em uma IDE.
Vantagens: qualidade de nível de produção a um preço muito baixo, entrada multimodal nativa, pesos abertos, e uma assinatura dedicada de código. Os níveis gratuitos GLM-4.7-Flash e 4.5-Flash são uma boa rampa de entrada.
Desvantagens: o desconto de lançamento de 50% termina, depois a taxa dobra para $0,15/$0,50 (ainda barato). O ecossistema é menor que o da OpenAI ou do Google, e o modelo de raciocínio principal GLM-5.3 é um SKU separado e mais caro.
Preços: $0,075 de entrada / $0,25 de saída por 1M em promoção; $0,15/$0,50 na lista.
Veredito: o campeão de valor para trabalho multimodal. Se o limite apenas-texto do DeepSeek Flash o descarta para você, o GLM 5.3 Flash é a forma mais barata de manter a entrada de imagem sem pagar as taxas do Gemini Flash.
8. Gemini 3.5 Flash-Lite
Melhor para: classificação de alto volume, marcação e OCR onde o Flash completo é overkill.
Às vezes a alternativa certa ao Gemini 3.8 Flash é um Gemini menor. O Gemini 3.5 Flash-Lite é o modelo econômico e de alto throughput do Google: $0,30 de entrada / $2,50 de saída, um contexto de 1M de tokens, e entrada multimodal. É a resposta quando você está fazendo muito trabalho barato e bem delimitado, extraindo campos, marcando tickets, executando OCR, onde você não precisa de um raciocinador pesado gastando 120M de tokens para pensar sobre isso.
Ele também é o modelo que manteve o piso barato que o 3.7 e o 3.8 Flash abandonaram. O Flash-Lite ainda suporta as configurações de pensamento ultra baixas que fazem a economia de classificação funcionar, exatamente a carga de trabalho que se tornou mais cara quando os modelos Flash mais novos removeram o minimal.
Vantagens: mais barato que o Flash completo, um enorme contexto de 1M de tokens, throughput forte (~490 tokens/segundo), entrada multimodal, e permanece dentro do ecossistema Google/Vertex que você talvez já use.
Desvantagens: mais fraco em raciocínio difícil e tarefas agênticas que os modelos Flash completos, sem uso de computador, e o mesmo padrão de preço introdutório-depois-mais-alto em toda a linha Gemini 3.x.
Preços: $0,30 de entrada / $2,50 de saída por 1M (padrão).
Veredito: o downgrade certo, não um compromisso. Para trabalhos de alto volume e baixa complexidade, o Flash-Lite faz o trabalho por um terço do preço e te mantém na infraestrutura do Google.
A camada em que você realmente está comprando
Aqui está o que eu continuo voltando a pensar, porque construo isso para viver. Se você está escolhendo um modelo rápido e barato para alimentar um agente de atendimento ao cliente, comparar Flash contra DeepSeek contra GLM é a pergunta errada. O modelo é o motor. Não é o carro.
Uma API de modelo puro te dá um endpoint texto-entra, texto-sai. Para transformar isso em algo que resolve tickets, você ainda precisa conectar sua base de conhecimento, construir recuperação (retrieval) para que ele pare de alucinar, escrever regras de escalação, testá-lo contra casos reais antes que toque em um cliente, e monitorá-lo e retreiná-lo para sempre. Isso são semanas de engenharia, e você é dono de tudo isso, incluindo troca do modelo a cada seis semanas quando o próximo Flash é lançado.
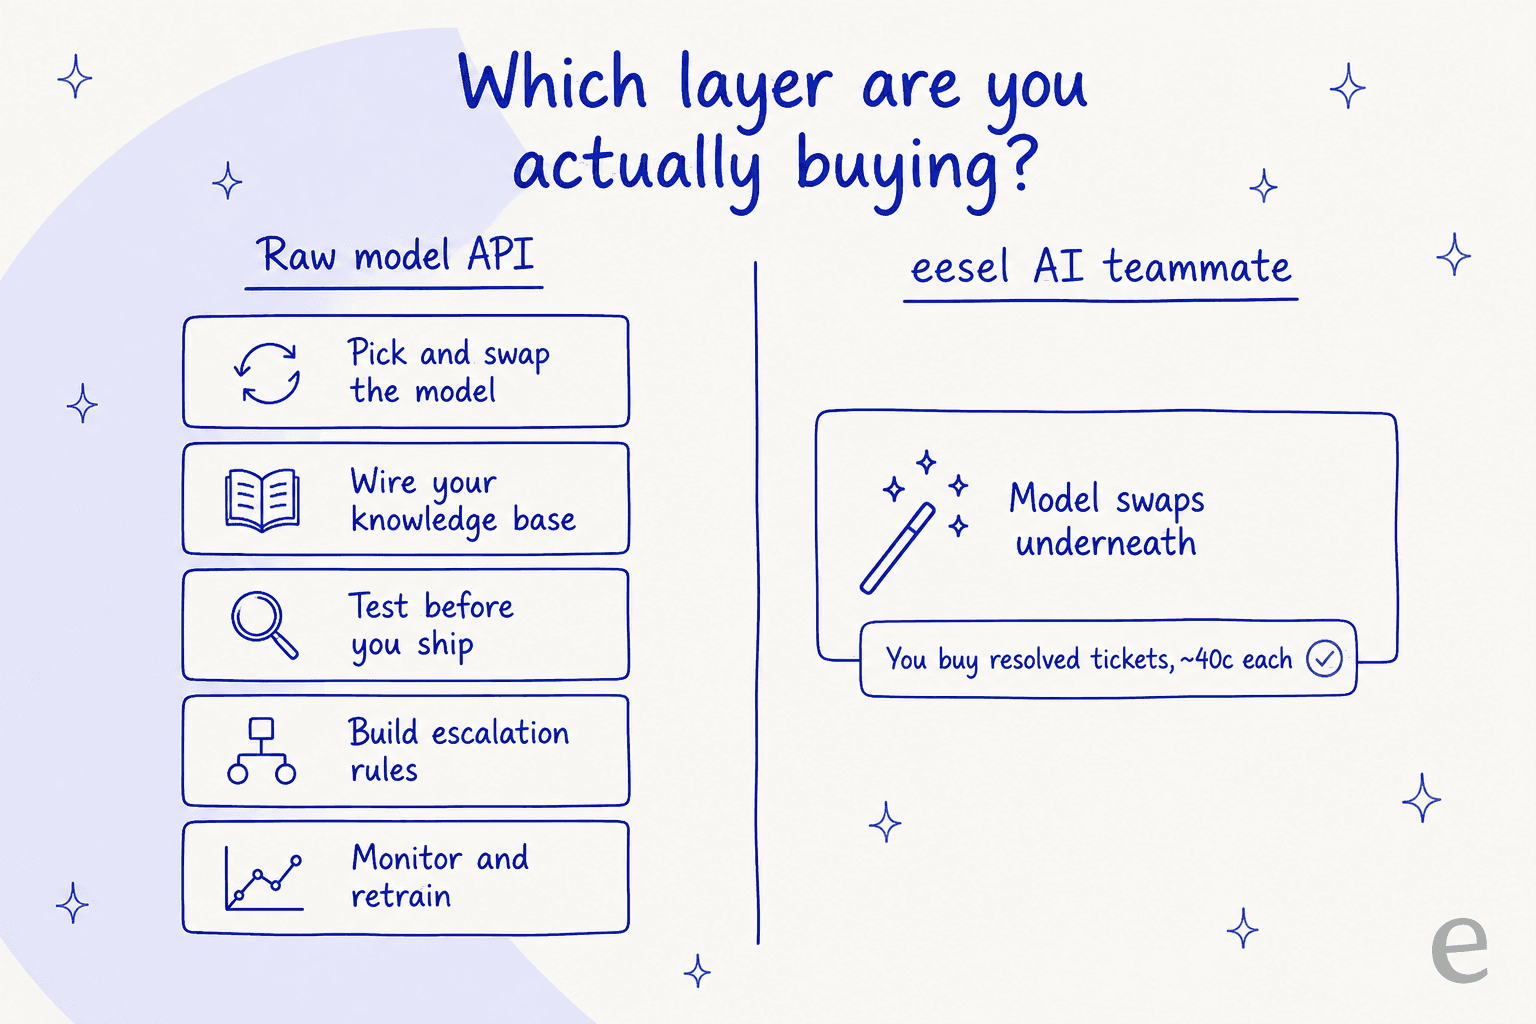
Esta é a distinção que vale a pena guardar: um modelo é infraestrutura; um colega de equipe é o funcionário. Se seu objetivo é um assistente de código com IA que funcione ou um pipeline de pesquisa, então sim, escolha o melhor modelo e construa. Mas se seu objetivo é "responder bem os tickets de suporte", o caminho mais rápido e barato é comprar o colega finalizado e deixar outra pessoa se preocupar com qual Flash está ganhando este mês.
Experimente a eesel para atendimento ao cliente
Se você chegou aqui porque quer um modelo rápido e barato para lidar com suporte, a eesel é a camada acima do modelo que realmente faz o trabalho. É uma plataforma de colegas de IA, e o colega pronto para trabalhar para isso é o agente de helpdesk com IA: ele entra na sua fila existente, treina com seus tickets passados e sua base de conhecimento, e começa a resolver conversas, sem necessidade de manipular modelos.
Duas coisas o tornam adequado para esse problema exato. Primeiro, ele é agnóstico de modelo por design, então a pergunta "o Gemini 3.8 Flash ou o DeepSeek Flash é melhor?" se torna problema da eesel, não seu; nós escolhemos e trocamos o modelo subjacente conforme eles melhoram. Segundo, e essa é a cicatriz que cada um desses modelos rápidos te ensina, a eesel simula cada implantação contra seus tickets históricos antes de ir ao ar, então você vê a taxa de resolução real e detecta as respostas confiantes-mas-erradas antes que um cliente o faça. Prefere operá-la a partir de um terminal ou um script? Existe um CLI da eesel completo para que agentes de código e pipelines de CI possam operar o mesmo colega. A cobrança é baseada em uso, cerca de 40 centavos por ticket resolvido, então você paga por resultados, não por tokens. É gratuito para testar.
Perguntas frequentes
Qual é a melhor alternativa ao Gemini 3.8 Flash para baixo custo?
O Gemini 3.7 Flash é uma boa alternativa ao Gemini 3.8 Flash?
Quanto custa o Gemini 3.8 Flash comparado às alternativas?
Qual alternativa ao Gemini 3.8 Flash é melhor para atendimento ao cliente?
Existem alternativas de pesos abertos ao Gemini 3.8 Flash?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.