

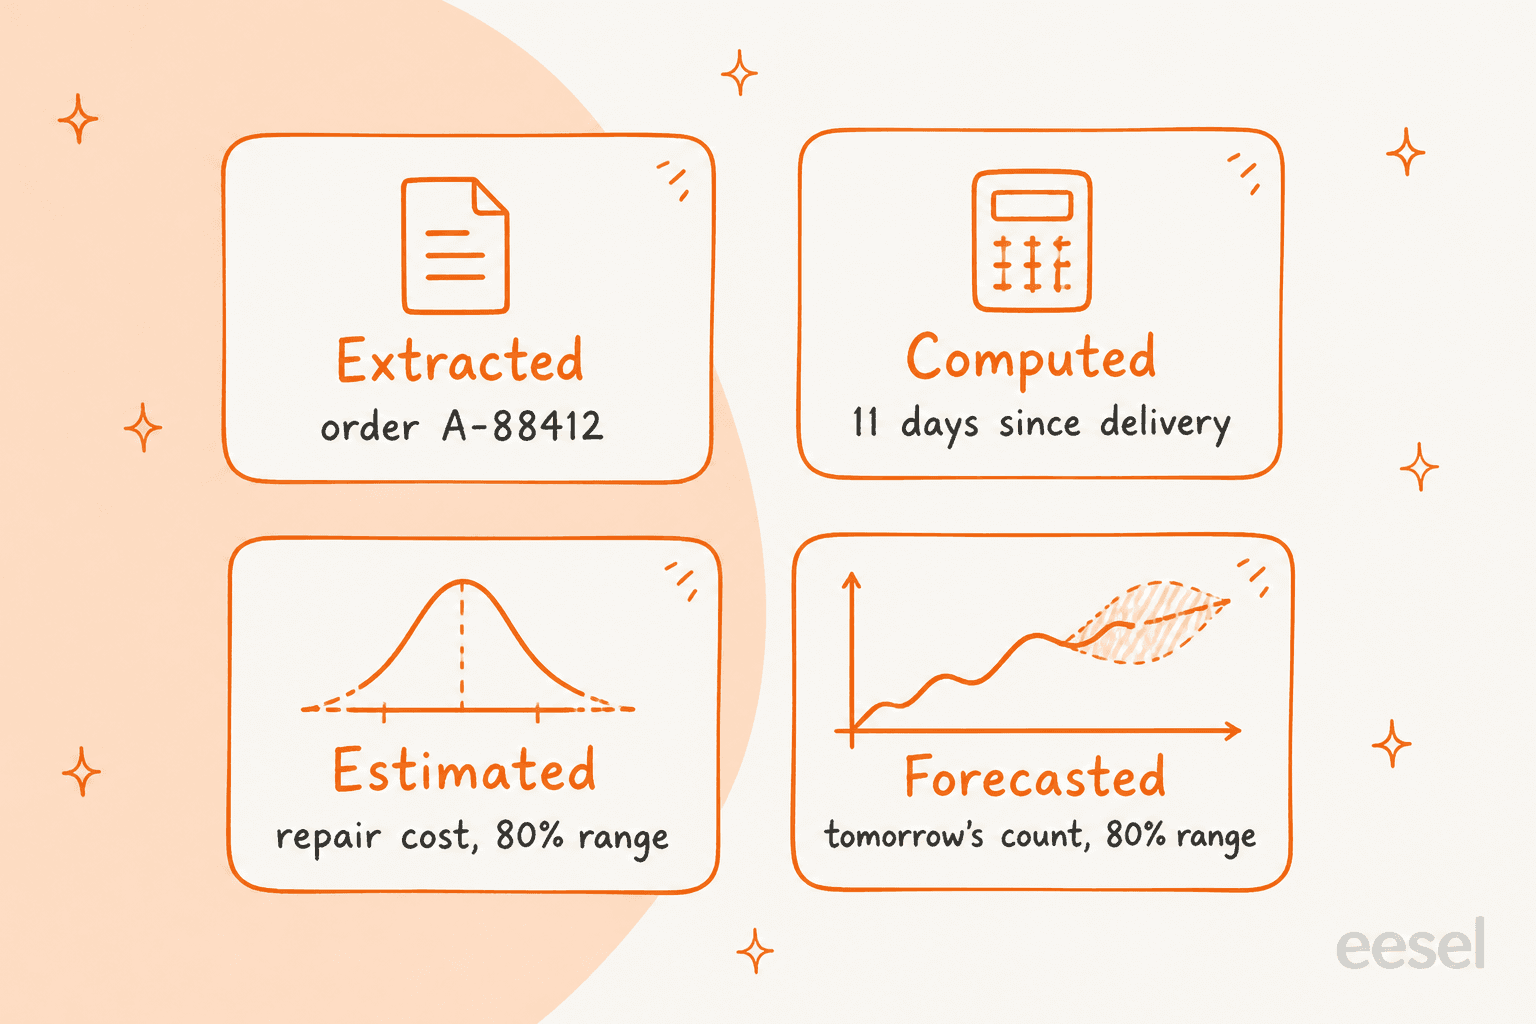
O Cloudflare Clairic é um novo modelo de extração que a Cloudflare lançou em pré-visualização no Workers AI em 19 de outubro de 2026. Você entrega uma entrada bagunçada (um e-mail, a foto de um recibo, um CSV) mais uma lista de campos tipados, e ele devolve um valor tipado por campo, com uma pontuação de confiança, em uma única passada e sem gerar texto. Ele pode copiar um valor (um número de pedido), calculá-lo (dias desde a entrega), estimá-lo com um intervalo de 80% (um custo de reparo) ou prever os próximos passos de uma série.
Custa US$ 0,10 por milhão de tokens de entrada, sem cobrança de saída, e os pesos abertos foram prometidos «em breve». Na demo do pedido danificado da Cloudflare, o Clairic fez a extração em 0,46 segundo, enquanto o GLM-5.3 levou 16,1, e todo o fluxo Clairic, Clef e LLM custou 49% menos do que usar um LLM em cada etapa.
Para equipes de suporte, o Clairic é um ótimo analisador e nada além disso. Ele transforma «o pedido A-88412 chegou rachado» em campos em que seu código pode confiar. Não consulta o pedido, não responde e não reembolsa. Se você quer a leitura e o trabalho que vem depois, o colega de IA da eesel para o helpdesk faz as duas coisas dentro do seu helpdesk, e é assim que a Rúngne tem todo ticket do Gorgias confirmado, etiquetado e com rascunho antes de uma pessoa abri-lo.
O que é o Cloudflare Clairic?
Eu trabalho a fila de suporte da eesel todos os dias, e a parte lenta da maioria dos tickets não é escrever a resposta. É copiar. O número do pedido do segundo parágrafo, a data de entrega do e-mail de rastreamento, o total da foto borrada de um recibo. O Cloudflare Clairic é um modelo feito exatamente para essa cópia, e é a coisa mais prática que saiu até agora da onda «System One».
O Clairic foi lançado no blog da Cloudflare em 19 de outubro de 2026, escrito por Alex Reneau, Michelle Chen e Kevin Flansburg, da equipe do Workers AI. Ele vive no Workers AI como @cf/cloudflare/clairic, está marcado como pré-visualização, e a Cloudflare diz que pretende publicar os pesos mais tarde.
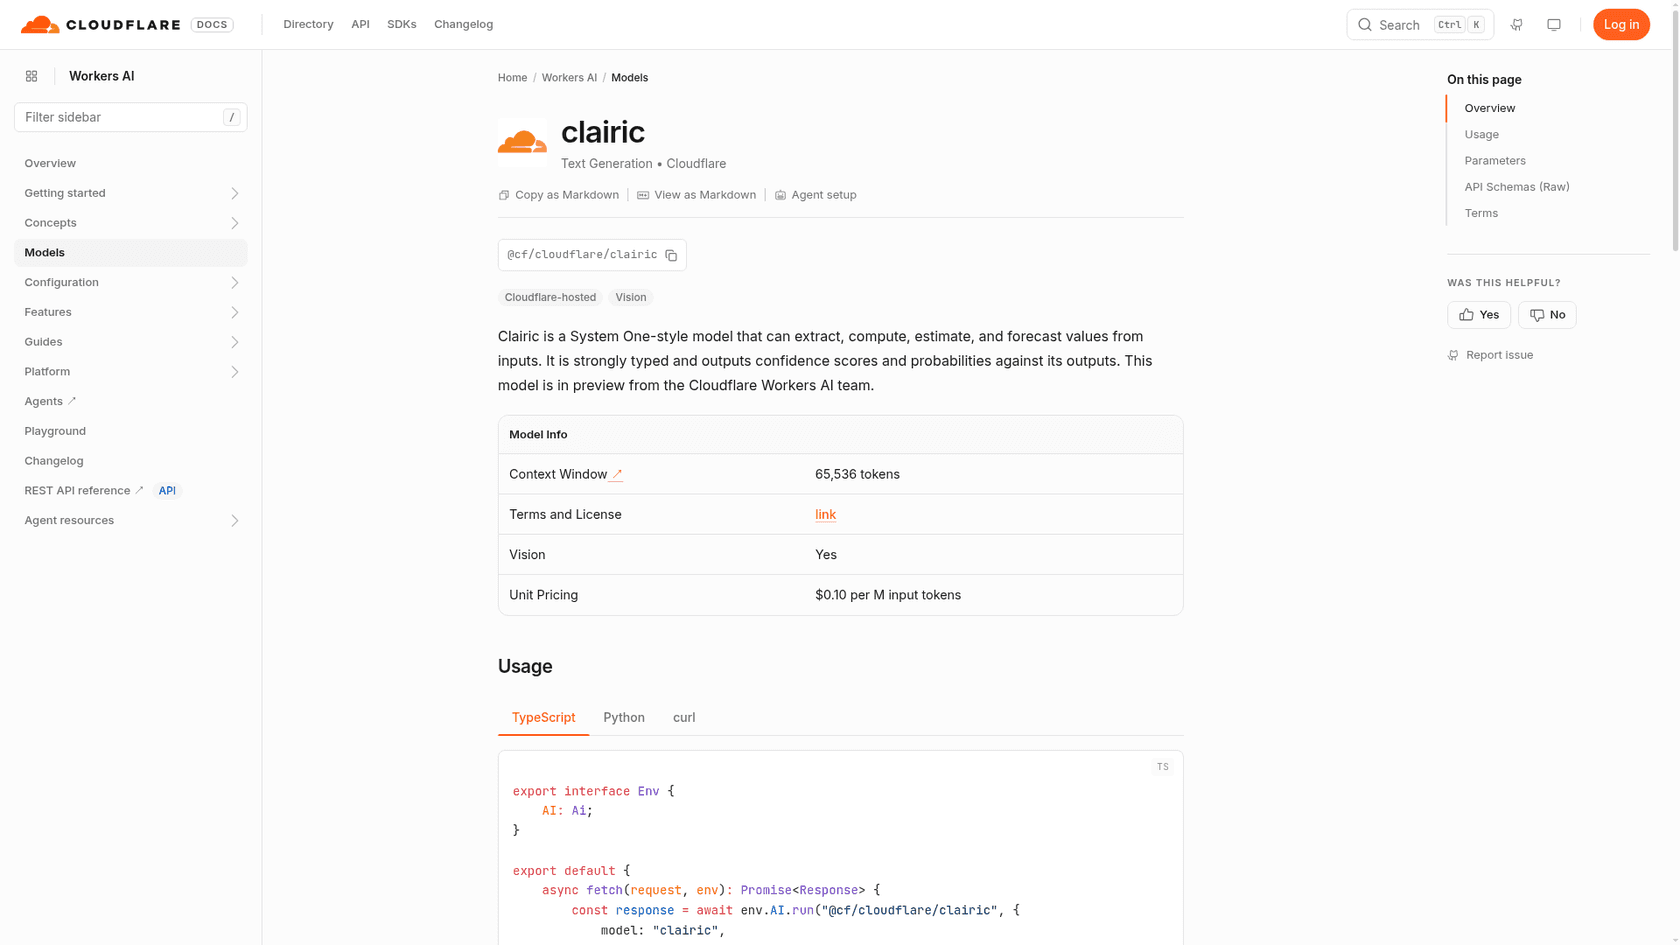
A ficha do modelo é curta. Uma janela de contexto de 65.536 tokens, suporte a visão (até quatro imagens por requisição) e uma única linha de preço. O nome, segundo a Cloudflare, mistura «clerical» (de escritório), «clairvoyance» (clarividência) e Cloudflare AI Regression model, o que resume bem o que ele faz: digitação de dados chata mais um pouco de previsão. Ele fecha algumas semanas movimentadas para a equipe de IA da Cloudflare, depois do navegador para agentes Kitesurf e de uma API de busca na web.
Por que a Cloudflare criou um modelo de extração?
Um mês antes do Clairic, a TypeSafe apresentou o Jev e a ideia dos modelos System One, emprestada do pensamento rápido e lento de Daniel Kahneman. A Cloudflare seguiu em 1º de outubro com o Clef, seu próprio modelo de decisão. Ambos respondem a perguntas em que dá para listar de antemão as respostas possíveis: é urgente, qual equipe cuida disso, reembolso ou reparo.
O argumento da Cloudflare é que muitas das chamadas de saída estruturada enviadas a LLMs de ponta têm respostas que não dá para listar de antemão. Qual é o total da fatura? Quando foi entregue? Quantos dias de atraso? Um modelo de decisão não ajuda aí, porque não há um conjunto fixo de opções para distribuir probabilidades. O Clairic é o primeiro modelo da segunda classe, que a Cloudflare chama de modelos de extração System One.
Veja como a Cloudflare organiza as três classes, condensado do post de lançamento:
| System One: extrair | System One: decidir | System Two | |
|---|---|---|---|
| Modelos de exemplo | Clairic | Jev, Clef | GPT, Claude, Gemini, DeepSeek |
| Como roda | Uma passada paralela | Uma passada paralela | Um token por vez |
| Saída | Valores tipados: trechos, números, datas, listas, distribuições | Uma das suas opções listadas, com probabilidades | Texto livre |
| O que responde | Qual é o valor? Quando aconteceu? Quanto vai ser? | Qual categoria? Qual ação? | Por que aconteceu? Como corrigir? |
| Sempre uma resposta válida? | Sim, um valor do seu tipo ou null | Sim, uma das suas opções | Não, o texto precisa ser analisado e verificado |
A frase do post da Cloudflare a que sempre volto é esta: modelos de extração transformam entrada bruta em valores tipados, modelos de decisão transformam valores em decisões e LLMs transformam decisões em palavras. É uma forma limpa de dividir um fluxo de suporte, e está mais perto de como um bom agente trabalha um ticket do que «mandar tudo para um modelo grande e torcer».
Como funciona o Cloudflare Clairic?
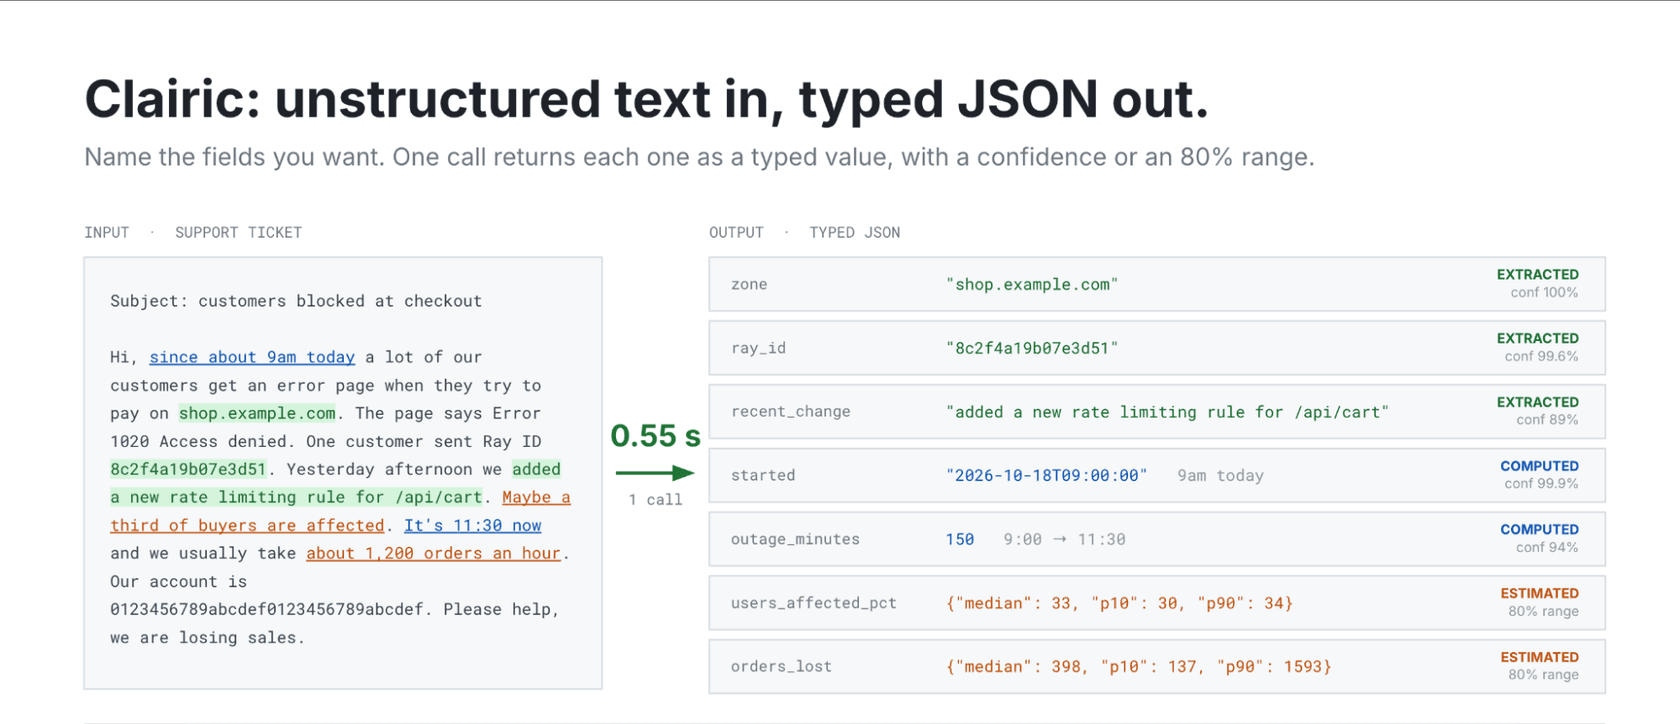
Uma requisição tem duas partes. O state é o texto que você quer que seja lido (mais até quatro imagens PNG, JPEG ou WebP, enviadas inline). O mapa fields é o seu esquema: cada campo recebe um nome, um tipo e instructions opcionais em linguagem simples. O Clairic lê tudo em uma única passada direta e responde todos os campos de uma vez, então pedir trinta campos custa quase o mesmo que pedir três.
Não há limite máximo de campos. A documentação do modelo diz que os campos que não cabem ao lado do state em uma passada de 8.192 tokens são divididos em passadas paralelas que veem toda a entrada e depois são mesclados.
| Tipo de campo | O que você recebe |
|---|---|
text | Um trecho exato da entrada, com suas posições de caracteres |
number | Um número lido ou calculado, respeitando integer e decimals |
date, time, datetime | Datas de calendário reais e horas válidas, no formato ISO |
duration | Um intervalo de tempo na unidade que você escolher |
list | Todos os textos, números ou datas correspondentes, na ordem da entrada |
estimate | Uma distribuição dentro dos seus min e max, na sua grade step, em escala linear ou logarítmica |
forecast | Uma estimativa por passo futuro de uma série, até 64 passos |
Toda resposta de valor único vem com p_null (a probabilidade de a entrada não conter o valor) e uma pontuação confidence. Estimativas e previsões vêm com uma mediana e um intervalo de 80%, de p10 a p90, e você pode pedir os 99 percentis com options.include_quantiles. Se um campo depende da data de hoje, a entrada do changelog diz para definir reference_date ou adicionar ao state uma linha como «Today: 2026-10-19».
Valores extraídos e calculados
O exemplo principal da Cloudflare é um e-mail de suporte, e por isso prestei atenção. Um cliente escreve que o pedido A-88412 chegou em 28 de setembro com a tela rachada e um canto amassado, que pagou US$ 649,00 mais US$ 52,10 de imposto, e que hoje é 9 de outubro. Pedem-se seis campos ao Clairic, e as respostas mostram a ideia toda de uma vez:
order_idvolta como"A-88412"com seu trecho no e-mail e confiança de 0,999957.amount_paidvolta como701.1, um número que não está escrito em lugar nenhum. O Clairic somou o preço e o imposto.days_since_deliveryvolta como11, calculado a partir de duas datas do texto.damagevolta como uma lista,["cracked screen", "dented corner"], com os dois trechos para você poder destacá-los.tracking_numbervolta comonull, porque o e-mail não traz nenhum. Oguessdo modelo foi «$52.10», com confiança de 0,416 ep_nullde 1.
Essa última parte é a que o pessoal de suporte deveria notar. Um LLM a quem se pede um código de rastreamento às vezes entrega uma sequência com cara de plausível. O Clairic entrega null e diz o que teria chutado, para que seu código possa perguntar ao cliente em vez de procurar na transportadora um número que não existe. É o mesmo instinto da prevenção de alucinações em um bot de suporte, embutido no formato de saída.
A Cloudflare também passou pelo modelo a foto de um recibo real e meio torto. O Clairic leu o número do pedido, o carimbo de data e hora, a quantidade, o preço unitário, o subtotal, o imposto e a gorjeta, e devolveu null para o desconto porque nenhum estava impresso. A confiança foi menor nas leituras mais difíceis (0,78 no número do pedido, 0,83 no carimbo de data e hora) e acima de 0,99 nas limpas, que é o comportamento que você quer.
Valores estimados
Alguns valores não estão na entrada, mas a entrada traz indícios deles. O exemplo da Cloudflare é o preço de uma casa: cinco vendas comparáveis e um imóvel-alvo, com um campo sale_price do tipo estimate entre US$ 50.000 e US$ 5.000.000 em escala logarítmica. O Clairic devolveu uma mediana de US$ 415.000 e um intervalo de 80% de US$ 370.000 a US$ 470.000.
A largura desse intervalo é a parte útil. O guia de modelos de extração da Cloudflare diz que um intervalo estreito indica que a entrada sustenta a estimativa e um largo indica que não. No suporte, isso é a estimativa de custo de reparo no exemplo do pedido danificado, e é o que permite ao passo seguinte decidir «reparo» ou «reembolso» sem uma pessoa chutar.
Valores previstos
Um campo forecast recebe um histórico em texto simples e devolve uma estimativa por passo futuro, cada uma com um intervalo de 80%. A Cloudflare testou com o número diário de pessoas triadas nos pontos de segurança de aeroportos dos EUA, pedindo toda manhã a contagem do dia seguinte por 21 dias seguidos.
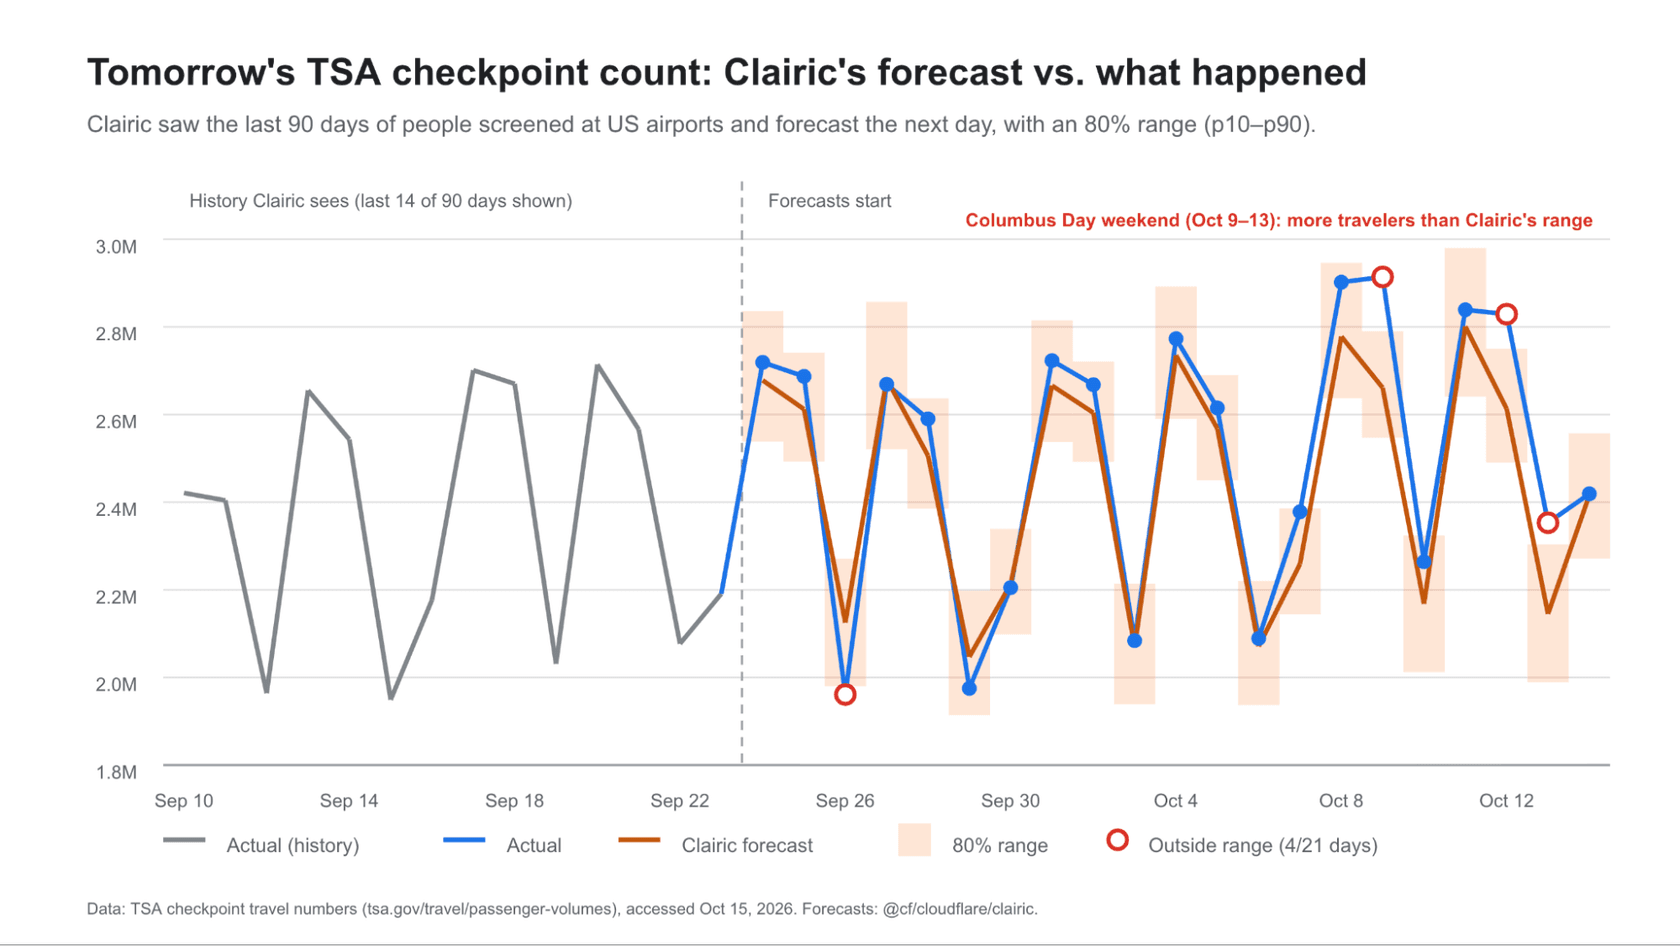
As previsões erraram 3,3% em média, e 17 das 21 contagens reais ficaram dentro do intervalo de 80%, que é mais ou menos o que um intervalo de 80% deve fazer. Três dos quatro erros caíram no fim de semana do Columbus Day, porque o Clairic lê padrões da série e não conhece feriados que a série não mostra. A Cloudflare é franca em dizer que isso não substitui um modelo de séries temporais dedicado, então eu não planejaria uma escala de feriados com isso. Para isso, uma boa previsão de força de trabalho de suporte continua sendo a ferramenta.
Clairic vs Clef vs um LLM: qual é a diferença?
A forma mais clara de ver onde o Clairic se encaixa é o fluxo que a Cloudflare montou para o lançamento. O mesmo e-mail de pedido danificado passa por duas configurações. Em uma, o Clairic extrai os fatos, o Clef decide entre reembolso e reparo gratuito com base em uma política escrita e o GLM-5.3 redige a resposta. Na outra, o GLM-5.3 faz as três etapas.
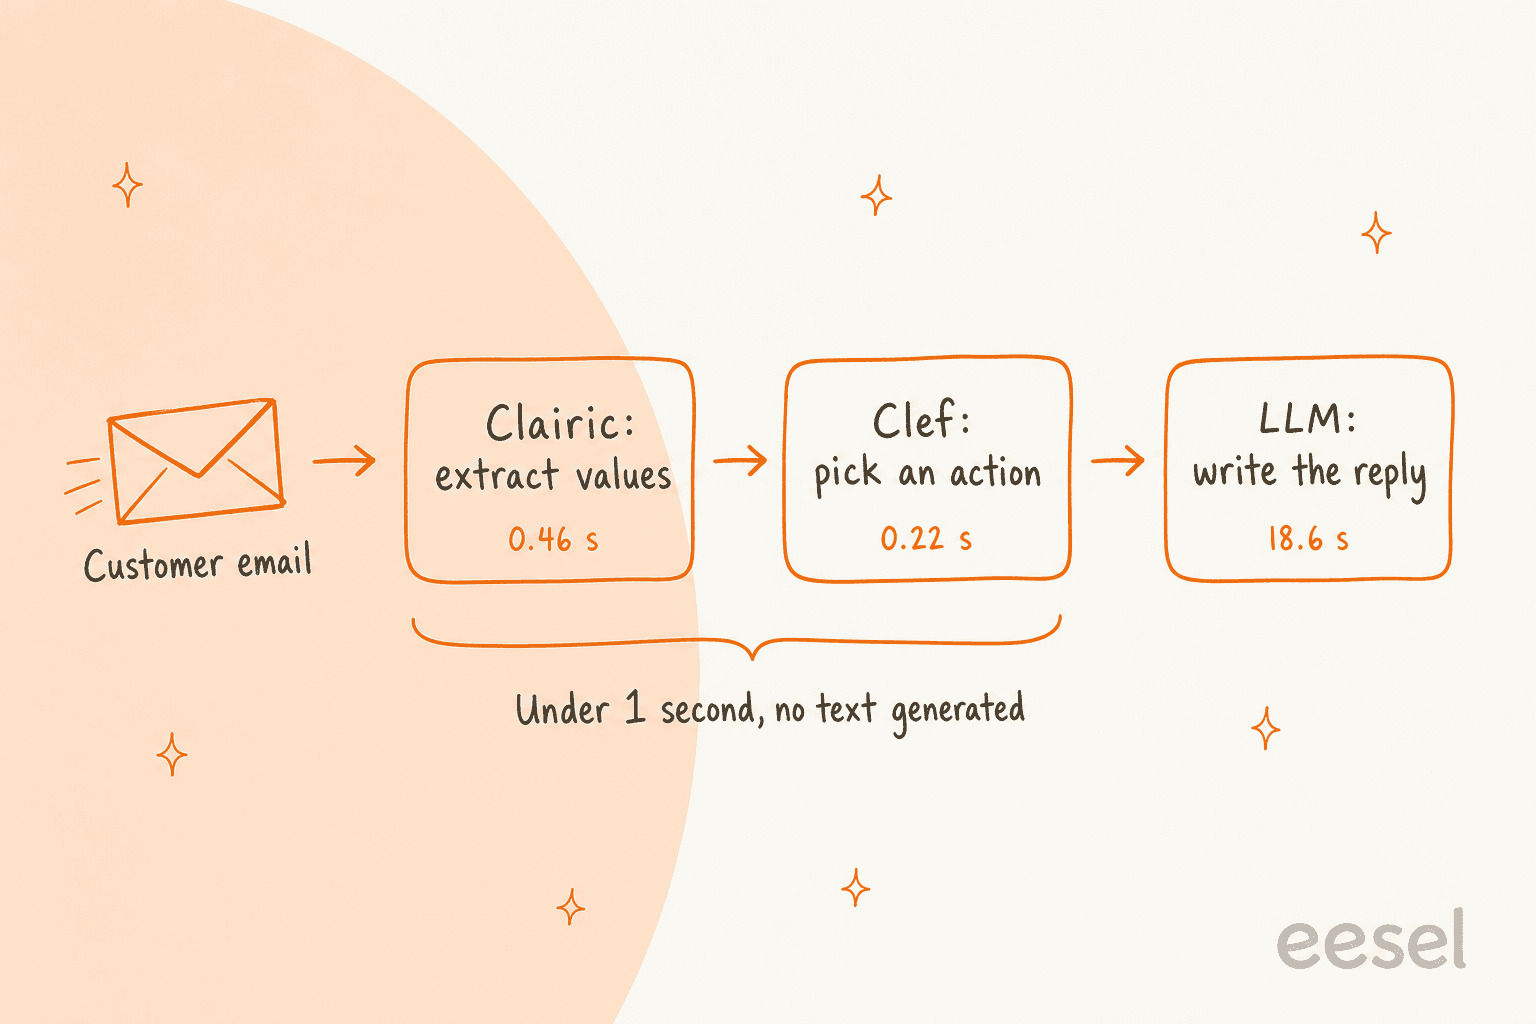
| Clairic, depois Clef, depois GLM-5.3 | GLM-5.3 em todas as etapas | |
|---|---|---|
| Latência de ponta a ponta | 19,3 s | 61,7 s |
| 1. Extrair | Clairic: 0,46 s | GLM-5.3: 16,1 s |
| 2. Decidir | Clef: 0,22 s | GLM-5.3: 21,9 s |
| 3. Responder | GLM-5.3: 18,6 s | GLM-5.3: 16,4 s |
| Custo por milhão de reclamações | US$ 6.032 | US$ 11.740 |
Isso é 3,2 vezes mais rápido e 49% mais barato, e quase todo o tempo e custo restantes vêm da única etapa que escreve texto. Os dois fluxos acertaram os fatos e a decisão em todas as execuções, então não é uma história de «o LLM falhou». A diferença que a Cloudflare aponta é a consistência: a estimativa de reparo do Clairic foi idêntica em todas as execuções, enquanto a do GLM-5.3 saiu como US$ 250, US$ 250 e US$ 220. A Cloudflare também observa que, quando Gemma 4 e Qwen rodaram a versão só com LLM, não conseguiram produzir o custo de reparo.
Há também um ângulo de segurança escondido nesse desenho. O Clef decide a partir de um resumo de cinco linhas de valores tipados em vez do e-mail bruto, e o LLM nunca vê o e-mail. Uma mensagem de cliente que tenta convencer o modelo a dar um reembolso tem muito mais dificuldade de passar por campos tipados, o que importa para quem pensa em automação de reembolsos com IA.
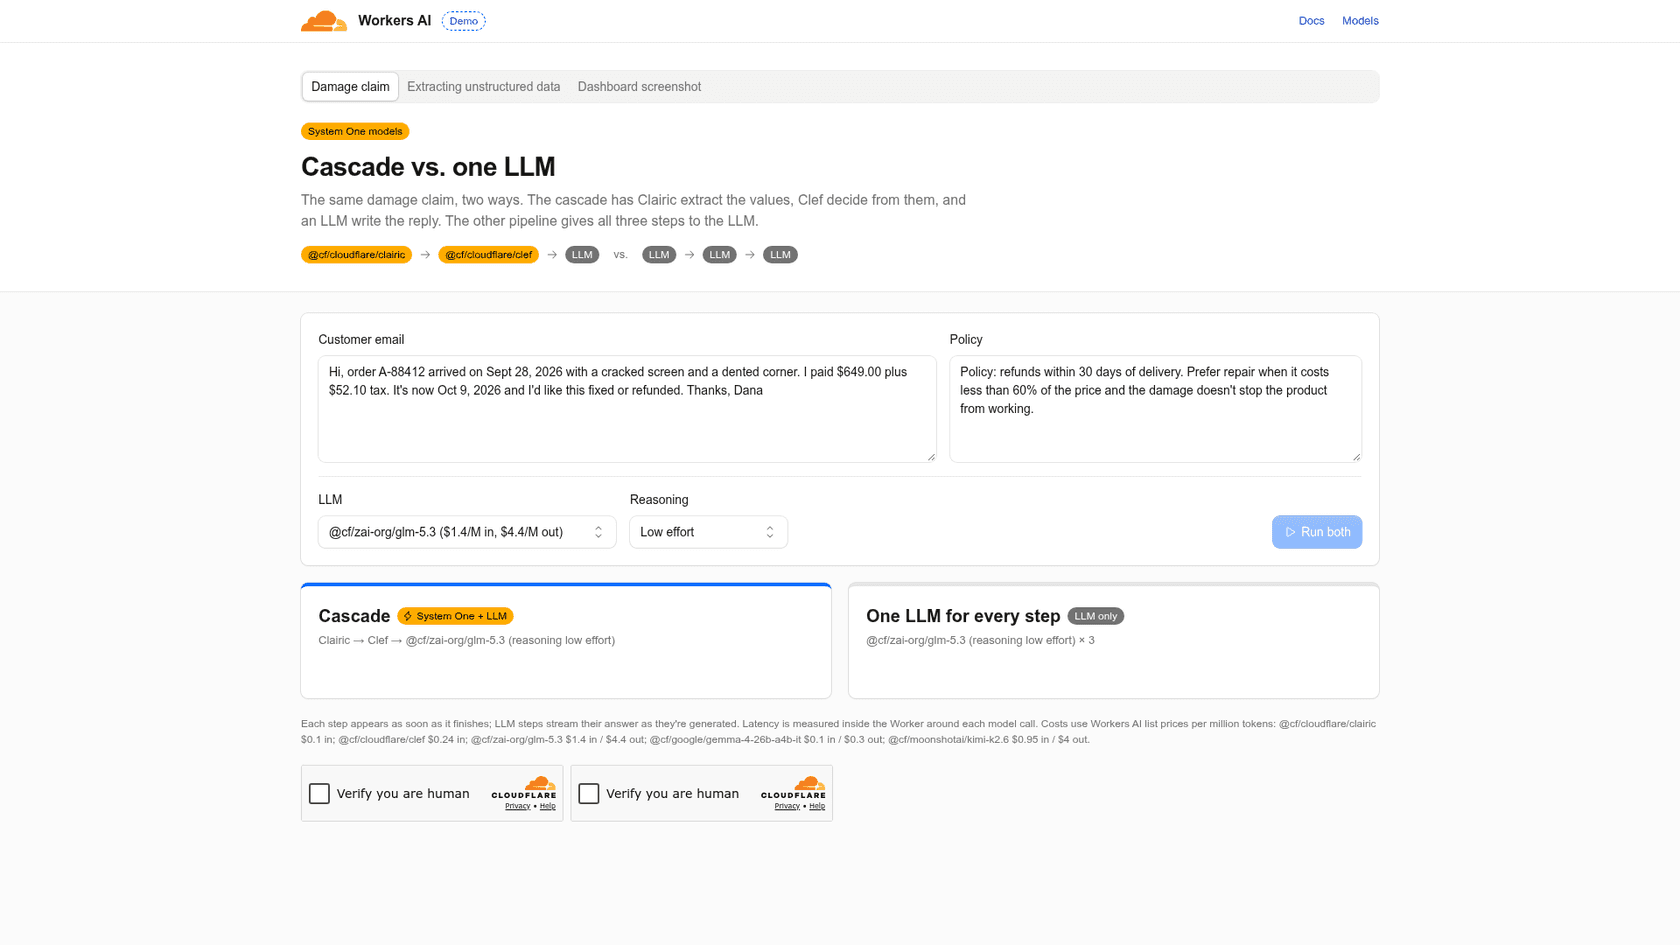
Você pode rodar a comparação por conta própria na demo ao vivo do fluxo da Cloudflare, com seu próprio e-mail e texto de política.
Quanto custa o Cloudflare Clairic?
O Clairic é cobrado como todos os outros modelos do Workers AI, em neurons, e a página de preços do Workers AI o lista ao lado dos irmãos. Como ele não gera tokens, só existe preço de entrada.
| Modelo | Preço por M de tokens de entrada | Neurons por M de tokens de entrada | Preço de saída |
|---|---|---|---|
Clairic (@cf/cloudflare/clairic) | US$ 0,100 | 9.091 | Nenhum |
Clef (@cf/cloudflare/clef) | US$ 0,240 | 21.818 | Nenhum |
Clef-omni (@cf/cloudflare/clef-omni) | US$ 0,150 | 13.636 | Nenhum |
Clef-flash (@cf/cloudflare/clef-flash) | US$ 0,038 | 3.455 | Nenhum |
O próprio Workers AI custa US$ 0,011 por 1.000 neurons, e toda conta recebe 10.000 neurons grátis por dia, reiniciados às 00:00 UTC. Passar da cota gratuita exige o plano Workers Paid.
Para ser concreto, o exemplo de fatura da página do modelo usou 655 tokens de entrada (61 do texto da fatura, 472 do esquema de seis campos, o resto de sobrecarga) em três passadas. A US$ 0,10 por milhão, isso dá cerca de US$ 0,000066 por chamada, ou mais ou menos US$ 6,55 para 100.000 faturas. Os 10.000 neurons grátis equivalem a cerca de 1,1 milhão de tokens de entrada do Clairic por dia, então nesse exemplo umas 1.680 chamadas por dia não custam nada. Repare que o esquema era maior que o documento. instructions longas em cada campo é o que faz sua conta de tokens crescer, então mantenha-as curtas.
Para comparar com o LLM que você talvez use hoje, o guia de preços do Clef tem uma calculadora para o lado da decisão, e o detalhamento do custo do suporte com IA cobre quanto a stack inteira custa por ticket.
Quais são os limites do Clairic hoje?
Isto é uma pré-visualização, e a Cloudflare é incomumente direta sobre o que ainda não funciona. Do post de lançamento e do changelog:
- A aritmética para em dois passos. Totais, diferenças, conversões e contas de data são confiáveis. Longas cadeias de passos dependentes e somas sobre muitas linhas de tabela, não. O conselho da Cloudflare: deixe o Clairic extrair as entradas e deixe seu código fazer a conta.
- Estimativas precisam de evidência. Peça um valor sobre o qual a entrada não dá pistas e você receberá um intervalo largo.
- A calibração é medida, não garantida. Os intervalos são treinados para ficarem calibrados e estão na maioria dos conjuntos de teste, mas podem ficar estreitos em dados desconhecidos.
- A previsão é básica. Previsões do próximo passo seguem os padrões recentes, horizontes mais longos tendem à média, e feriados que a série não mostra serão perdidos.
- Bem formado não é correto. Os tipos garantem a forma. Use
confidence,p_nulle os intervalos para decidir o que automatizar e o que enviar para revisão.
Há também limites práticos. As imagens vão até quatro por requisição, 4 MiB cada e 8 MiB no total, e URLs remotas não são aceitas, então você envia os bytes inline. O Clairic está listado em Text Generation, e a página de limites do Workers AI define o padrão para esse tipo de tarefa em 300 requisições por minuto.
A lacuna que as pessoas notaram no dia do lançamento são os benchmarks. A Cloudflare publicou exemplos práticos e a comparação de fluxos, mas ainda não há pontuações em benchmarks padrão de extração:
"It's interesting that they haven't published any benchmarks yet."

Outros na mesma discussão estavam mais interessados em até onde ele poderia ir:
"Seems like it might excel at NER and intent-slot tasks, too."
É a minha leitura também. Até a Cloudflare publicar números, a forma honesta de avaliar o Clairic é rodá-lo em algumas centenas dos seus próprios tickets e comparar os campos com o que sua equipe realmente preencheu.
Onde o Clairic se encaixa em uma fila de suporte?
Do lado do suporte, é aqui que acho que o modelo se paga. Boa parte do que um agente faz no primeiro minuto de um ticket é extração: achar o número do pedido, conferir a data de entrega, ver se está dentro do prazo de devolução, anotar o que está danificado. Em uma call de demo no início do ano, uma equipe B2B de telemática no Zendesk disse aos meus colegas de vendas que as duas primeiras coisas que queriam eram etiquetar a partir de uma lista fixa de etiquetas e preencher automaticamente os campos do ticket. O Clairic é uma forma limpa de construir você mesmo a segunda.
Veja como eu dividiria tarefas comuns de suporte entre as três classes de modelo. Escolha uma tarefa para ver qual se encaixa:
Qual classe de modelo cuida desta tarefa de suporte?
Extração (Clairic), decisão (Clef) ou geração (um LLM)
Toque em uma tarefa acima.
text. Devolve o trecho exato com posições de caracteres, ou null com uma pontuação p_null se o cliente não informou, para você perguntar em vez de chutar.duration. Um valor calculado a partir de duas datas. Adicione a data de hoje ao state ou defina reference_date, ou a conta não terá onde se ancorar.estimate. Devolve uma mediana e um intervalo de 80% dentro dos limites que você definir. Um intervalo largo é o sinal de que a entrada ainda não sustenta um número.forecast, com cuidado. Serve para um número aproximado do próximo passo. A Cloudflare diz que ele perde eventos que o histórico não mostra, como feriados, então não dimensione uma semana de pico com isso.O que o Clairic oferece e uma chamada de LLM em modo JSON ou com function calling não oferece é uma forma embutida de decidir no que confiar. Toda resposta traz uma confiança e uma probabilidade de estar ausente, o que se traduz bem em três faixas:
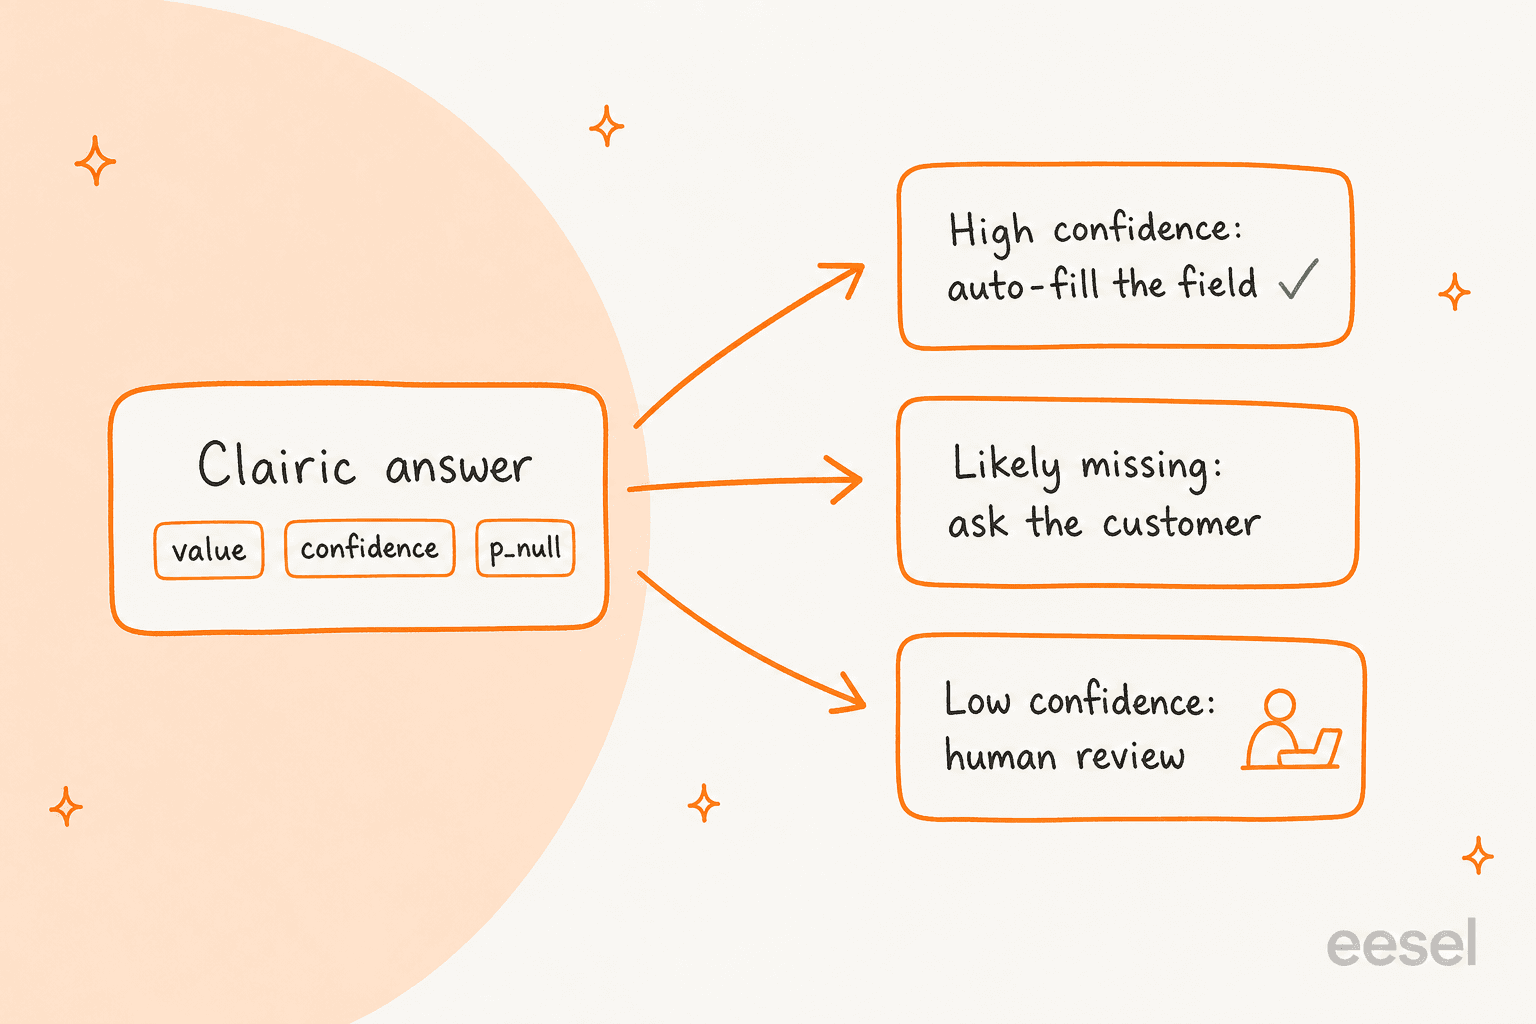
É a mesma lógica que a maioria dos helpdesks já usa para a classificação de tickets, e cabe atrás de ferramentas que você talvez já use. A própria extração de entidades do Zendesk faz uma versão disso dentro do helpdesk, e a versão de IA avançada adiciona entidades personalizadas. O Clairic é a opção de construir você mesmo: mais controle sobre o esquema e os limites, e mais código para manter.
O que o Clairic não faz é o trabalho. Ele não vai abrir o Shopify para conferir o pedido, aplicar sua matriz de aprovação de reembolsos, escrever de volta no ticket nem saber quando um item danificado precisa de uma pessoa. Alguém tem que escrever o Worker que faz tudo isso, cuidar da escalação e mantê-lo funcionando quando a API do helpdesk mudar. Para uma equipe com engenheiros que querem um analisador rápido e barato dentro do seu próprio fluxo de triagem de tickets, é uma troca justa. Para uma equipe de suporte que quer a fila resolvida esta semana, é um componente, não uma resposta.
Quem deve usar o Cloudflare Clairic?
Eu recorreria ao Clairic em três situações:
- Você já roda no Workers. Chamá-lo é uma linha
env.AI.run()ao lado do seu código atual, e os neurons diários gratuitos cobrem muita extração de baixo volume. - Você analisa sempre os mesmos formatos. Faturas, recibos, e-mails de pedido, avisos de envio. Campos fixos, alto volume, e uma resposta tipada vence revalidar o JSON de um LLM a cada chamada.
- Você precisa saber quando o modelo não tem certeza. As pontuações
confidenceep_nulldão de graça um sinal de roteamento, que é a maior parte do trabalho de uma automação segura.
Eu esperaria se você precisa rodá-lo no seu próprio hardware (ainda sem pesos), se precisa de números de precisão auditados antes de uma revisão de lançamento (ainda sem benchmarks) ou se a tarefa é principalmente matemática de vários passos sobre tabelas grandes (a própria Cloudflare diz para fazer isso em código). E se o que você quer de verdade é menos tickets na fila em vez de campos mais limpos, um agente de IA para helpdesk pronto leva você até lá sem construir nada.
A eesel para o ticket depois da extração
O Clairic é infraestrutura. A eesel é a funcionária. A eesel é uma plataforma de colegas de IA, e o colega que importa aqui é o colega de IA para o helpdesk. Ele entra na sua fila do Zendesk, Freshdesk, Gorgias ou Front, aprende com seus tickets antigos e sua central de ajuda e faz a leitura que o Clairic faz como parte de trabalhar o ticket: achar o pedido, conferir as datas, notar o que está danificado. Depois age. Etiqueta, redige, responde ou passa adiante, e tudo o que você marcar como «perguntar antes» espera a aprovação de uma pessoa.
A Rúngne, uma marca norueguesa de roupas de escalada no Gorgias e no Shopify, roda três agentes da eesel: um confirma e etiqueta todo ticket, um consulta pedido, rastreamento e estoque no Shopify e deixa um rascunho, e um responde diretamente perguntas simples. Entre 8 de agosto e 8 de setembro de 2026, isso somou cerca de 2.100 tickets tratados, 580 rascunhos deixados para a equipe e 150 consultas de pedidos. Itens danificados, pacotes perdidos e cancelamentos vão direto para pessoas, que é a mesma linha que eu traçaria para qualquer automação baseada em extração. A Dokument 24 faz a versão mais leve no Zendesk: toda primeira mensagem recebe uma etiqueta de produto e um rascunho em dinamarquês como nota interna.

Se o Clairic atrai você por ser programável, dê uma olhada na CLI da eesel. É o mesmo colega do painel, comandado de um terminal, e todo comando imprime JSON, então um script ou um agente de código como Claude Code, Cursor ou Codex pode executar toda a configuração. Para um fluxo no estilo extração, fica assim:
npx @eesel/cli initinicia um workspace sem precisar de conta (Node 18.17 ou mais recente), eeesel logino mantém.eesel integrations connect <platform>conecta Zendesk, Freshdesk ou Gorgias, eeesel integrations <platform> actionslista toda ação que o colega pode executar ali com sua configuração de aprovação.eesel instructionsguarda as regras permanentes em linguagem simples, como «preencha o campo do número do pedido; se não houver, peça».eesel approvals listeeesel approvals approve <id>liberam ações retidas a partir de um script, e--dry-runimprime a chamada exata que uma escrita faria antes de acontecer.eesel activitymostra o que o colega fez, do mais recente ao mais antigo, que é a sua trilha de auditoria.
O workspace também é um servidor MCP (eesel mcp token imprime a linha do claude mcp add), e o post do meu colega sobre a CLI de agente de IA aprofunda como operar o suporte de um terminal.
A unidade de preço é diferente porque compra outra coisa. Os preços da eesel começam com 100 créditos grátis, depois planos mensais fixos a partir de US$ 299 por 500 créditos, em que um crédito cobre um ticket ou chat inteiro, não importa quantas consultas e ações ele exija. Se você quer construir a camada de extração por conta própria, o Clairic é um componente rápido, barato e honesto. Se quer e-mails de pedido lidos, consultados e respondidos no seu helpdesk esta semana, experimente a eesel na sua própria fila e leia os rascunhos antes de pagar qualquer coisa.
Perguntas frequentes
O que é o Cloudflare Clairic?
O Cloudflare Clairic é um modelo de extração que a Cloudflare lançou em pré-visualização no Workers AI em 19 de outubro de 2026, como @cf/cloudflare/clairic. Você envia texto (mais até quatro imagens) e uma lista de campos tipados, e ele devolve um valor tipado por campo com uma pontuação de confiança. Ele fica ao lado dos modelos de decisão, como o Clef, no que a Cloudflare chama de modelos System One.
Como o Cloudflare Clairic se diferencia do Clef?
O Clef escolhe entre as opções que você lista e devolve uma probabilidade para cada uma, então responde «qual equipe?» ou «reembolso ou reparo?». O Clairic responde com valores que não dá para listar de antemão, como um número de pedido, uma data, um total ou um custo de reparo estimado. A própria demo da Cloudflare encadeia os dois: o Clairic extrai, o Cloudflare Clef decide e um LLM escreve a resposta.
Quanto custa o Cloudflare Clairic?
O Clairic custa US$ 0,10 por milhão de tokens de entrada, sem cobrança por tokens de saída, porque ele não gera tokens. É cobrado em neurons do Workers AI (9.091 por milhão de tokens de entrada) e toda conta recebe 10.000 neurons grátis por dia. Para o panorama completo do Workers AI, veja o guia de preços do Clef.
O Cloudflare Clairic é de código aberto?
Ainda não. No lançamento, o Clairic é uma pré-visualização hospedada apenas no Workers AI, e a Cloudflare diz que pretende liberar o modelo com pesos abertos em breve. Se você precisa de algo que possa hospedar por conta própria hoje, os modelos de linguagem pequenos no Hugging Face são o caminho habitual.
O Cloudflare Clairic pode alucinar?
Ele pode errar, mas não consegue inventar uma resposta malformada. Cada valor volta no tipo que você pediu ou como null, e as respostas de texto são trechos da sua entrada com posições de caracteres. A documentação da Cloudflare deixa claro que bem formado não é o mesmo que correto, então use as pontuações confidence e p_null como você usaria limites de confiança em outros lugares.
Posso usar o Cloudflare Clairic em tickets de suporte ao cliente?
Sim, os exemplos de lançamento da própria Cloudflare são um e-mail de pedido danificado e um ticket de queda no checkout. O Clairic extrai da mensagem o ID do pedido, as datas, os valores e a lista de danos para que seu código ou um modelo como o Clef possa agir. Ele não responde nem mexe no seu helpdesk, e é aí que entra um agente de IA para helpdesk como a eesel.
Como chamo o Cloudflare Clairic?
De dentro de um Worker, chame env.AI.run("@cf/cloudflare/clairic", { model: "clairic", state, fields }). De qualquer outro lugar, envie o mesmo corpo por POST para /accounts/{account_id}/ai/run/@cf/cloudflare/clairic com um token de API. Se for integrá-lo a uma stack de suporte, o post do meu colega sobre a API de helpdesk com IA cobre a parte técnica ao redor.
O Cloudflare Clairic é bom em previsão?
Para um número rápido do próximo passo, sim: no teste TSA de 21 dias da Cloudflare, as previsões erraram 3,3% em média. A Cloudflare, porém, chama a previsão de básica e diz que ela não substitui um modelo de séries temporais treinado com os seus dados. Para dimensionar uma equipe de suporte, uma boa previsão de força de trabalho continua sendo a melhor ferramenta.